ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-6.1-sol.
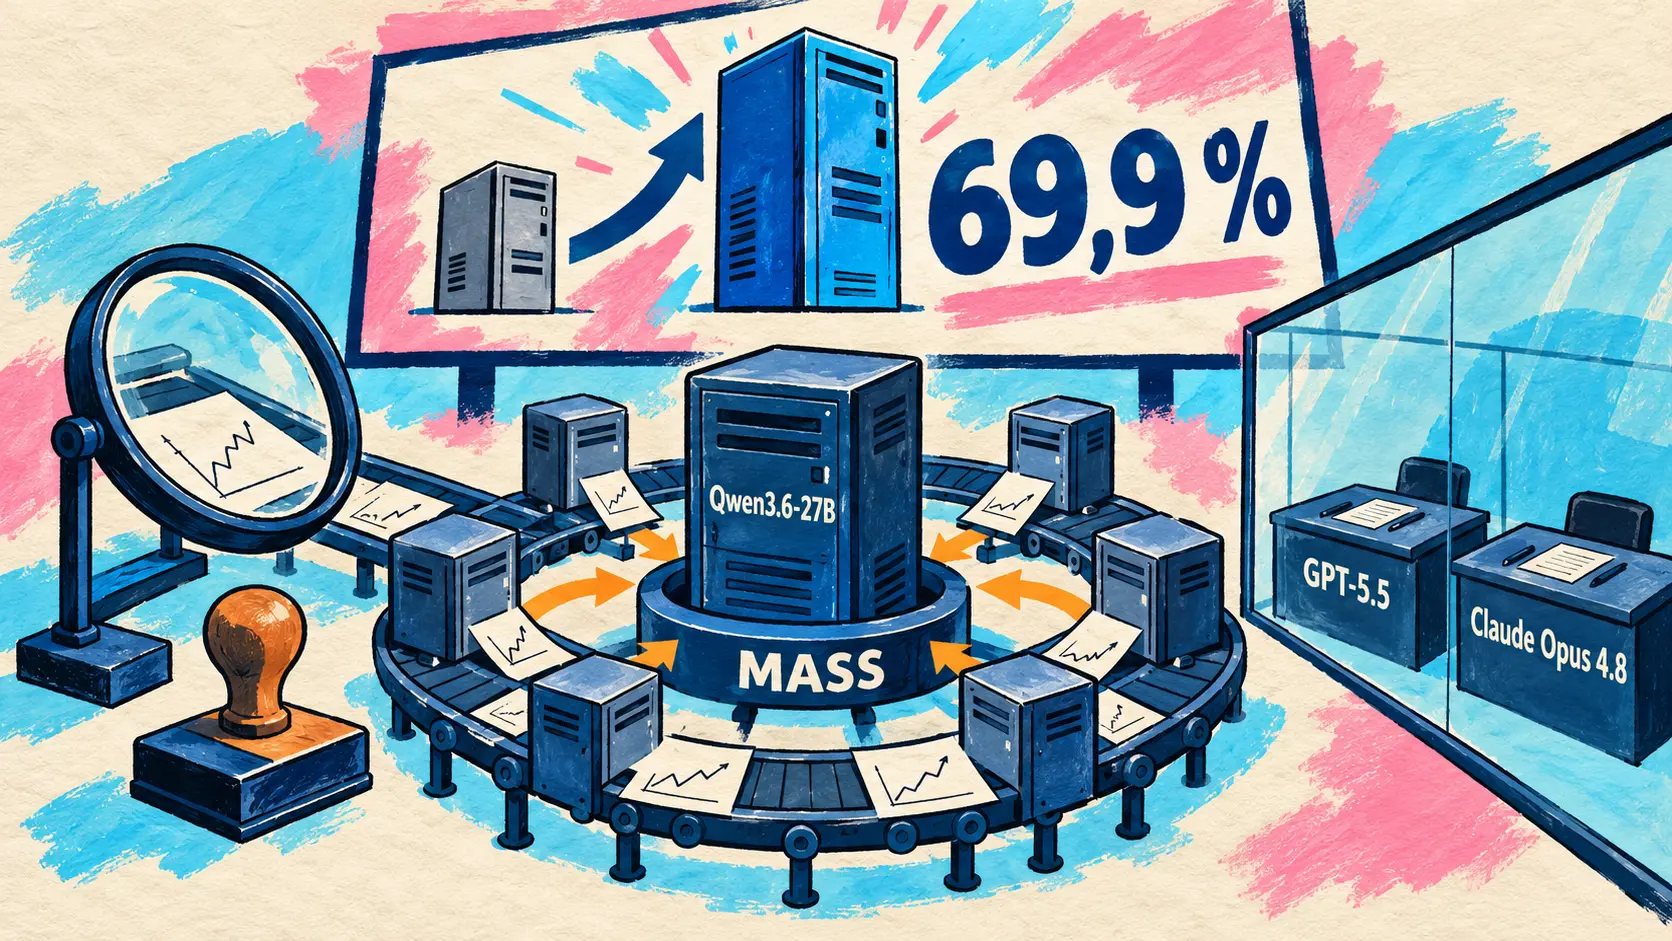
Sakana AI och forskare vid UC Berkeley presenterar MASS, en metod där Qwen3.6-27B finjusteras med de bästa körningarna från sitt eget agentteam: efter två omgångar slår den sin basversion i 69,9 % av jämförelserna på uppgifter som hållits utanför träningen. Bland kortnyheterna lanserar FINAL-Bench Open Quantum Challenge, en tävling i kvantsimulering och felkorrigering som genomförs med en enda GPU, och Qwen Code v0.25.1 blir en stabil version.
MASS: Sakana AI och UC Berkeley förbättrar Qwen3.6-27B med arbetet från dess eget agentteam
11 oktober — Sakana AI och UC Berkeley presenterar MASS, en metod för rekursiv självförbättring: Qwen3.6-27B löser forskningsuppgifter i ett team av underagenter, skriver om teamets workflow och bedömer själv resultaten, och finjusteras sedan med LoRA på sina bästa körningar. Två externa bedömare, GPT-5.5 och Claude Opus 4.8, mäter framstegen.
| Rapporterat mått | Publicerat värde |
|---|---|
| Vinster mot basmodellen efter två omgångar, uppgifter som hållits utanför träningen | 69,9 % |
| Poäng per token i utdata, fyra benchmark för forskning | 1,2 till 1,6 gånger basmodellen |
| Samma mått, Terminal-Bench 2.0 och SWE-bench Verified | 0,96 och 0,94 gånger basmodellen |
Författarna bedömer själva att förbättringen varierar mellan benchmark och tror att de kan åtgärda detta genom att lägga till uppgifter inom mjukvaruutveckling. Koden publiceras utan angiven licens, och artikeln finns på arXiv sedan 8 oktober.
🔗 Blogginlägg om MASS · Artikel på arXiv · Kod på GitHub
Kortnyheter
- Open Quantum Challenge — På Hugging Face öppnar FINAL-Bench (VIDRAFT) två säsonger som genomförs med en enda GPU, utan kvantdator: uppskatta grundtillståndsenergin hos Fermi-Hubbard-system fram till den 28 februari 2027, och utforma en avkodare för felkorrigering (QEC) fram till den 31 mars 2027, med 1 000 dollar per säsong. 🔗 källa · 🔗 tävlingssida
- Qwen Code v0.25.1 — Den stabila versionen samlar de tre förhandsversioner som presenterats här sedan den 6 oktober och lägger bara till 17 poster, däribland en knapp för omedelbar sändning (Skicka nu) av köade meddelanden i Web Shell. Versionsinformationen omfattar totalt 57 funktioner och 85 buggfixar sedan v0.25.0, utan kända bakåtinkompatibla ändringar. 🔗 källa
Vad det betyder
MASS utgår från en iakttagelse: för en öppen forskningsuppgift finns ingen automatisk regel som avgör om ett svar är bra, och modellen själv kan bli den mest kompetenta handledare som finns tillgänglig. Sakana AI lyfter fram säkerhetsfrågan som följer med detta: när en modell är sin egen utvärderare kan gemensamma blinda fläckar få fel att framstå som framsteg och sedan förstärka dem under träningen. För att mäta framstegen utan att påverka loopen förlitar sig protokollet på externa bedömare, vars omdömen inte återförs till MASS; överensstämmelsen mellan utvärderaren och dessa bedömare ökar från 73 % för basmodellen till 93 % efter den andra omgången.
Experimentet säger också något om agentdata. Enligt författarna ger teamens förlopp bättre träning än en ensam agents förlopp: en modell som tränats på de förstnämnda vinner 68,3 % av sina jämförelser med basmodellen med 28,8 miljoner övervakade tokens, jämfört med 64,0 % med 42 miljoner för en modell som tränats på de sistnämnda. Experimentet körs dessutom i Qwen Code, kodagenten vars v0.25.1 blir stabil samma dag: ett utvecklarverktyg fungerar här som en laboratoriebänk för forskningen.
Open Quantum Challenge tar sig an problemet från andra hållet. Varje bidrag poängsätts automatiskt mot ett fast referenssvar, och deltagarguiden är utformad för att överlämnas till en kodagent som Codex eller Claude Code. När en uppgift kan verifieras räcker en beräknad poäng för att skilja deltagarna åt; när den inte kan verifieras gör MASS modellen till sin egen bedömare, under externa bedömares uppsikt.