ai-powered-markdown-translator本文由 gpt-6.1-sol 从法语翻译成中文。
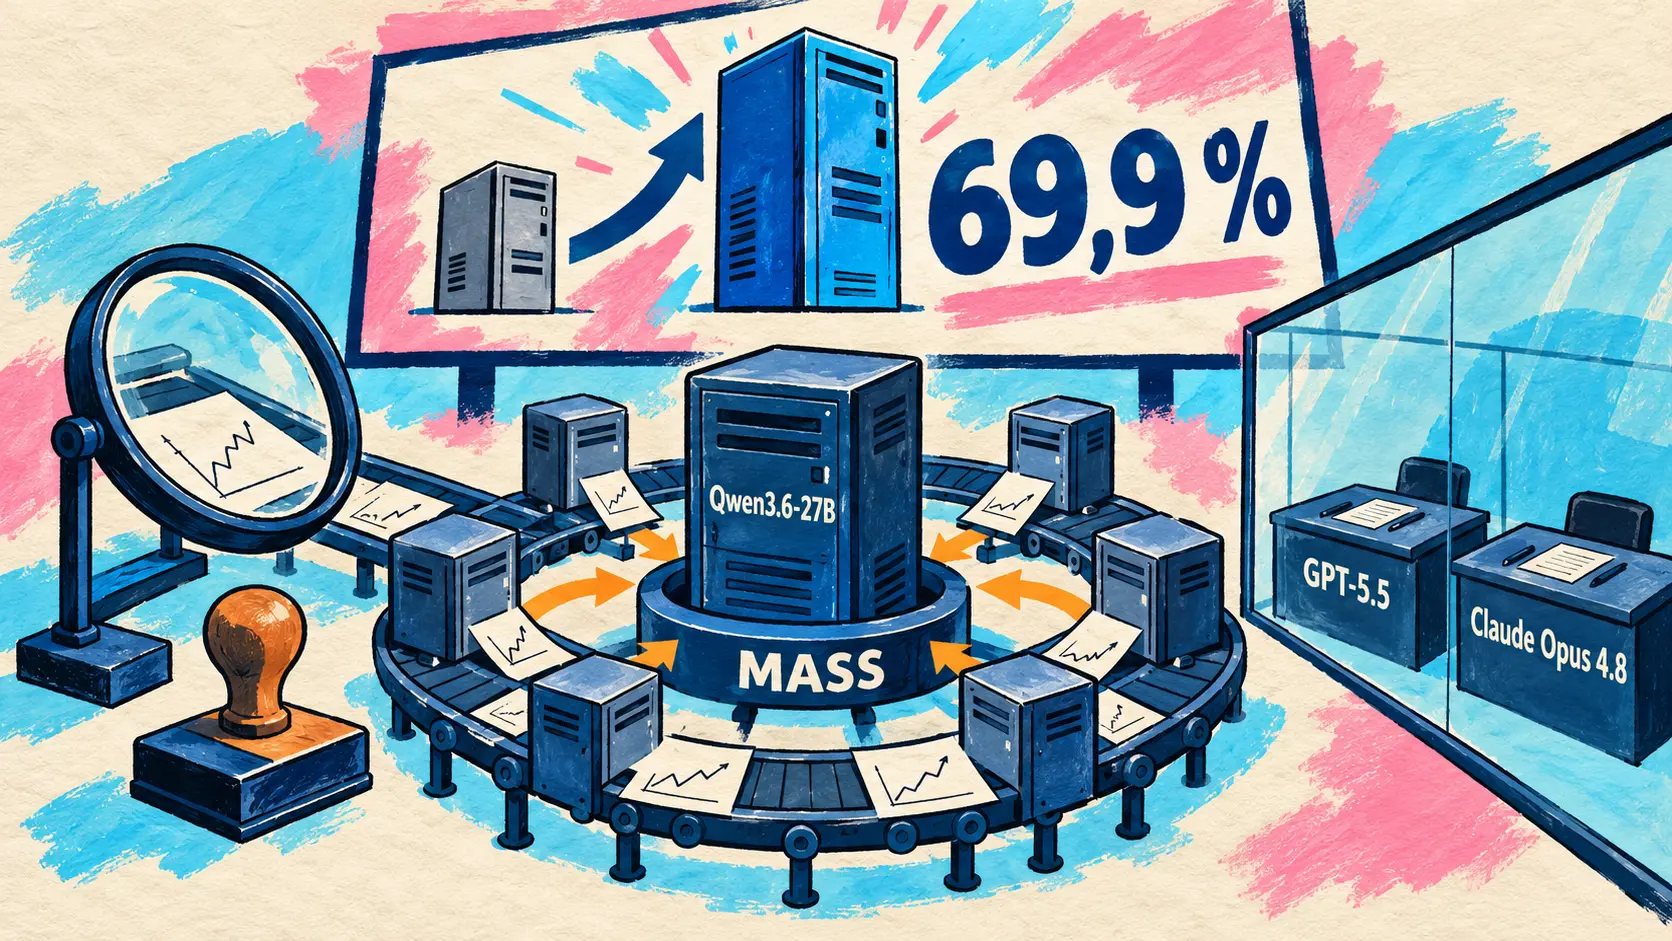
Sakana AI 与 UC Berkeley 的研究人员推出 MASS,这种方法让 Qwen3.6-27B 利用自身智能体团队的最佳执行过程进行微调:经过两轮训练后,在未参与训练的任务上,它在与基础版本的比较中取得了 69,9 % 的胜率。简讯方面,FINAL-Bench 启动 Open Quantum Challenge,这是一项仅需一块 GPU 即可参与的量子模拟与纠错竞赛;Qwen Code v0.25.1 则发布了稳定版。
MASS:Sakana AI 与 UC Berkeley 让 Qwen3.6-27B 通过自身智能体团队的工作成果取得进步
10月11日 — Sakana AI 与 UC Berkeley 推出 MASS,这是一种递归式自我改进方法:Qwen3.6-27B 通过子智能体团队解决研究任务,重写团队的工作流程并自行评判结果,随后利用最佳执行过程进行 LoRA 微调。GPT-5.5 和 Claude Opus 4.8 两个外部评委负责衡量进步。
| 报告指标 | 公布数值 |
|---|---|
| 两轮后相较基线的胜率,未参与训练的任务 | 69,9 % |
| 每个输出 token 的得分,四项研究基准 | 基线的 1,2 至 1,6 倍 |
| 同一指标,Terminal-Bench 2.0 和 SWE-bench Verified | 基线的 0,96 和 0,94 倍 |
作者自己也认为,各项基准上的提升并不均衡,并计划通过增加软件工程任务加以改善。代码已发布,但未声明许可证;论文自 10月8日 起已在 arXiv 上公开。
🔗 MASS 博文 · arXiv 论文 · GitHub 上的代码
简讯
- Open Quantum Challenge — FINAL-Bench(VIDRAFT)在 Hugging Face 上启动两个赛季,仅用一块 GPU 即可参赛,无需量子计算机:第一项是在 2027年2月28日之前估算 Fermi-Hubbard 系统的基态能量,第二项是在 2027年3月31日之前设计纠错解码器(QEC),每个赛季设有 1 000 美元奖金。🔗 来源 · 🔗 竞赛空间
- Qwen Code v0.25.1 — 稳定版整合了此处自 10月6日以来介绍的三个预发布版本,仅新增 17 项记录,其中包括为 Web Shell 中排队的消息提供立即发送按钮(立即发送)。发布说明总计列出自 v0.25.0 以来的 57 项功能和 85 项修复,暂无已知破坏性变更。🔗 来源
这意味着什么
MASS 的出发点是一个观察:对于开放式研究任务,没有自动规则能够判断答案是否正确,而模型本身可能成为现有条件下最有能力的监督者。Sakana AI 强调了随之而来的安全问题:当模型担任自己的评估者时,共同的盲点可能让错误被视为进步,并在训练中得到强化。为衡量进步而不影响这一循环,实验方案依赖外部评委,其评判结果不会反馈给 MASS;评估者与这些外部评委的判断一致率,从基础模型的 73 % 提升到第二轮之后的 93 %。
这项实验也揭示了智能体数据的特点。作者认为,团队轨迹比单个智能体的轨迹更有助于训练:以团队轨迹训练的模型使用了 28,8 百万个监督训练 token,在与基线的比较中取得了 68,3 % 的胜率;而以单智能体轨迹训练的模型使用了 42 百万个 token,胜率为 64,0 %。实验实际上运行在 Qwen Code 中,这个编程智能体的 v0.25.1 也在同一天发布稳定版:开发者工具在这里成了研究的实验台。
Open Quantum Challenge 则从另一端切入这个问题。每份提交都会依据固定的参考答案自动评分,参赛指南也专门设计成可交给 Codex 或 Claude Code 这样的编程智能体执行。当任务结果可以验证时,计算出的分数足以区分参赛者的表现;当任务结果无法验证时,MASS 让模型担任自己的评委,同时接受外部评委的审视。