ai-powered-markdown-translatorArtikel, übersetzt aus dem Französischen ins Deutsche mit gpt-5.6-sol.
An diesem Sonntag gibt es kein neues Modell, dafür aber zwei konkrete Neuerungen für Entwickler. DeepSeek V4.1 Flash, das am 10. September veröffentlicht wurde, kommt zum Hauptzeittarif von DeepSeek zu Together AI, und Together bezeichnet es als dreimal günstiger pro Aufgabe als GPT-5.6 Sol – eine Behauptung, die differenziert betrachtet werden sollte; Perplexity ermöglicht seinerseits, einen MCP-Server ein für alle Mal in seiner Agent API zu registrieren. Sakana AI blickt auf eine Sonderausgabe der Royal Society zurück, und drei Autoren des Community-Blogs von Hugging Face befassen sich auf jeweils eigene Weise mit der Überprüfung von Ergebnissen.
Together AI stellt DeepSeek V4.1 Flash bereit und bezeichnet es als dreimal günstiger pro Aufgabe als GPT-5.6 Sol
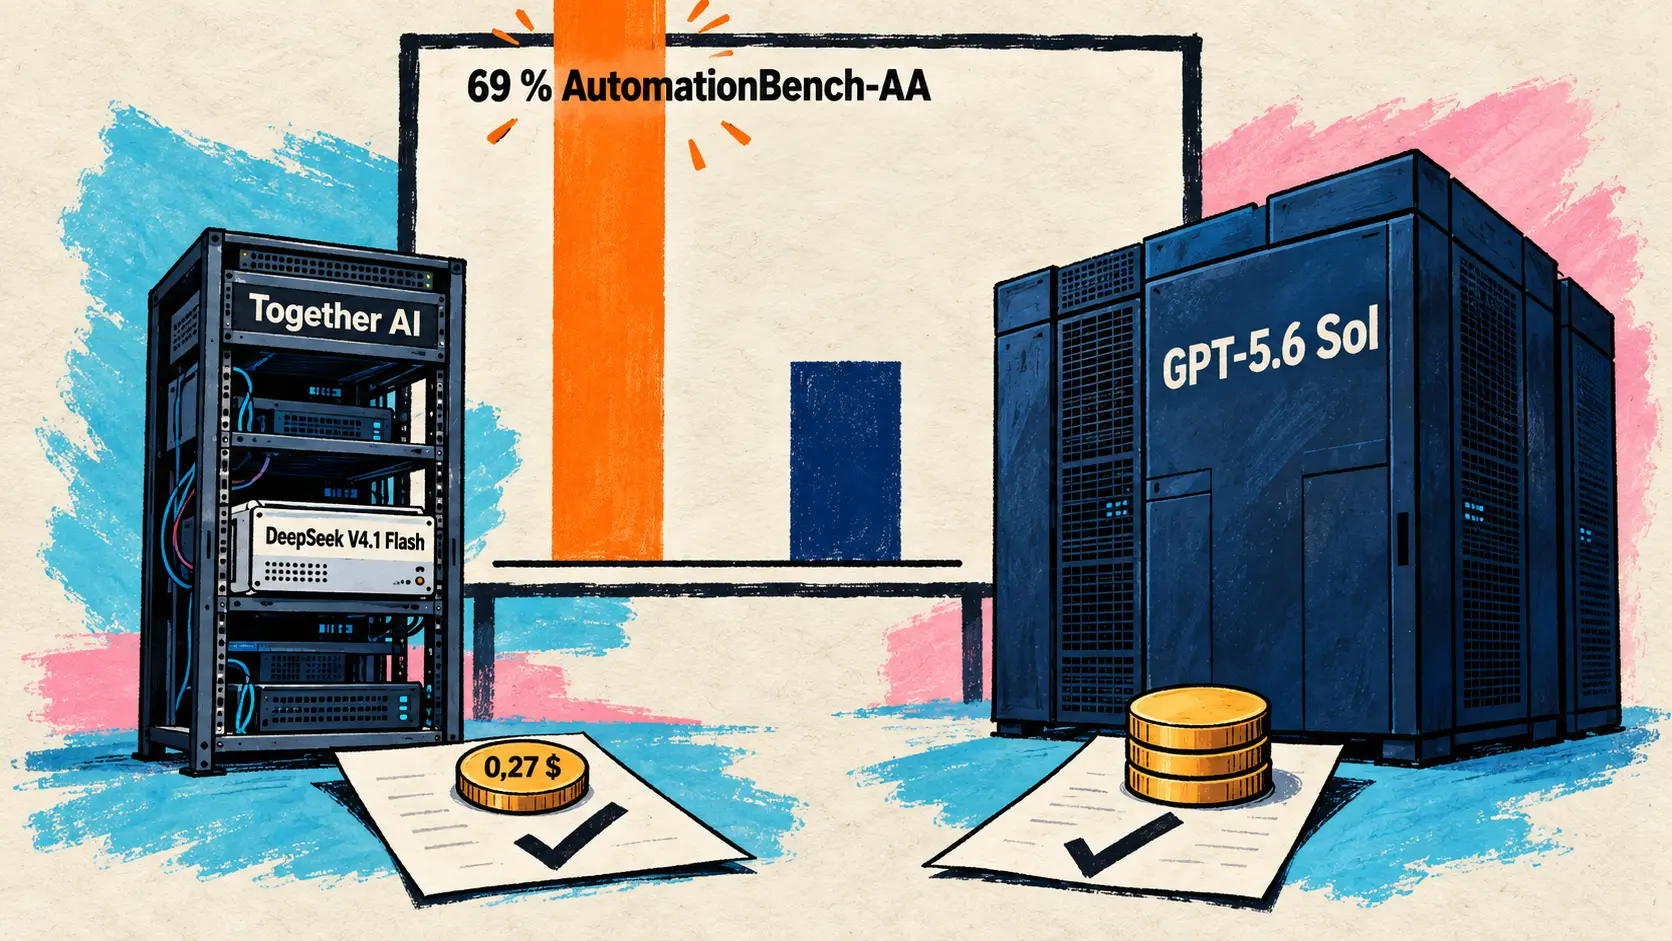
13. September — DeepSeek V4.1 Flash kommt sowohl serverless als auch als dediziertes Deployment zu Together AI, für 0,30 Dollar pro Million Eingabe-Token und 1,20 Dollar für die Ausgabe: genau die Preise der DeepSeek-API zu Hauptzeiten, die DeepSeek außerhalb der Hauptzeiten halbiert.
Together behauptet unter Berufung auf Messungen von Artificial Analysis, dass das Modell GPT-5.6 Sol bei agentischen Benchmarks zu einem Drittel der Kosten pro Aufgabe schlägt:
| Vergleichswert | DeepSeek V4.1 Flash | GPT-5.6 Sol (high) |
|---|---|---|
| AutomationBench-AA | 69 % | 55 % |
| Terminal-Bench v4.0 | 27 % | 21 % |
| GDPval-AA v2 | 1632 | 1524 |
| Durchschnittliche Kosten pro Aufgabe (Intelligence Index) | 0,27 Dollar | 0,81 Dollar |
Zwei Einschränkungen: Together selbst stuft V4.1 Flash beim Schlussfolgern hinter GPT-5.6 Sol ein (90,9 gegenüber 94,1 % bei GPQA Diamond, 36,8 gegenüber 47 % bei HLE), und bei Terminal-Bench v4.0 kehrt sich der von Artificial Analysis gemessene Vorsprung in der von DeepSeek am 10. September veröffentlichten Tabelle um, die V4.1 Flash mit 31,2 und GPT-5.6 Sol mit 39,9 bewertete.
🔗 Ankündigung von Together AI auf X
Perplexity öffnet seine Agent API für benutzerdefinierte Konnektoren: ein einmalig registrierter MCP-Server
13. September — Perplexity ergänzt seine Agent API um benutzerdefinierte Konnektoren (custom connectors). Ein Administrator registriert einen entfernten MCP-Server einmalig in den Konnektoren seines Projekts (Project): Name, URL, Authentifizierung per API-Schlüssel oder keine Authentifizierung sowie Streamable HTTP oder SSE als Transport. Perplexity speichert den Zugriffsschlüssel des Servers, und Anfragen mit jedem API-Schlüssel des Projekts müssen lediglich die Kennung des Konnektors mit type: "connector" angeben.
Bei einem in der Anfrage übergebenen MCP-Server (type: "mcp") werden seine URL und Zugangsdaten dagegen bei jedem Aufruf mitgesendet, ausschließlich über Streamable HTTP. Diese Konnektoren erweitern die am 27. August eingeführten verwalteten Konnektoren (managed connectors) für GitHub, Slack, Google Drive und Datadog, von denen es mit Linear und Notion inzwischen sechs gibt. Bei der standardmäßig verzögerten Tool-Erkennung sucht das Modell zunächst, bevor es die benötigten Schemas lädt, weshalb ein ausreichend hoher Wert für max_steps vorgesehen werden sollte. Ein spezieller Preis wird nicht genannt.
🔗 Dokumentation der Perplexity-Konnektoren 🔗 Changelog der Perplexity-API
Kurzmeldungen
- Sakana AI blickt auf eine Sonderausgabe über Weltmodelle (world models) zurück — Japanischsprachiger Beitrag vom 12. September über die am 14. Mai 2026 erschienene Ausgabe der Philosophical Transactions of the Royal Society A, deren Einleitung David Ha, CEO von Sakana AI, gemeinsam mit dreizehn weiteren Koautoren verfasst hat. Neu ist der Beitrag, nicht die Veröffentlichung der Ausgabe. 🔗 Quelle
- REINFORCE entkommt einer Falle, in der der exakte Gradientenanstieg stecken bleibt — Individueller Beitrag im Community-Blog von Hugging Face und keine Veröffentlichung eines Labors: Nach zweiundvierzig Überprüfungsrunden durch denselben Prüfer zeigt RDTvlokip, dass der exakte Anstieg nach 20 000 Schritten in keinem der 12 Versuche zu einem eindeutigen Code (einer Bijektion) führt, gegenüber 11 von 12 bei REINFORCE. All diese Zahlen hängen allerdings vom Adam-Optimierer ab. 🔗 Quelle
- Phionyx schlägt einen Nachweisvertrag für KI-Audits vor — Ein weiterer individueller Beitrag: Ali Toygar Abak will verhindern, dass ein Dashboard oder Bericht stillschweigend über das hinausgeht, was ein Nachweis tatsächlich belegt, etwa wenn ein abgelehnter Tool-Aufruf am Ende als ein durch die Schutzvorrichtung gestoppter Vorfall dargestellt wird. Sein Vorschlag, acht Gruppen von Metadaten, die jeder Aussage zugeordnet werden, bleibt ein Entwicklungs- und Testplan ohne experimentelle Ergebnisse. 🔗 Quelle
- darkc0de schlägt vor, Agentenmodelle anhand der Zeit bis zu einem validierten Ergebnis zu bewerten — Dritter individueller Beitrag: Sonny DeSorbo argumentiert, dass sich ein schwächeres, aber schnelleres Modell mehrmals korrigieren kann, bevor ein langsames Modell seinen ersten Versuch abgeschlossen hat, und skizziert einen Benchmark namens Persistent Challenge Completion, der die validierte Arbeit pro Sekunde misst. Eine Überlegung ohne Experimente, die man nach Einladung des Autors nicht allzu ernst nehmen sollte. 🔗 Quelle
Was das bedeutet
Beim ersten Themenstrang geht es um die Werkzeuge für Agenten. Mit benutzerdefinierten Konnektoren wird ein MCP-Server zu einer Projektressource statt zu einem Parameter, der in jeder Anfrage wiederholt wird: Ein Administrator registriert ihn einmal, Perplexity speichert seinen Zugriffsschlüssel, und der Code, der die Agent API aufruft, muss ihn nicht mehr mitführen. Perplexity überträgt damit die Logik der Ende August eingeführten verwalteten Konnektoren auf die MCP-Server der Nutzer, die entweder durch einen API-Schlüssel geschützt sind oder keine Authentifizierung verwenden, und unterstützt dabei zusätzlich zu Streamable HTTP auch SSE als Transport. Der Nachteil liegt in der verzögerten Tool-Erkennung, die genügend Schritte für das Modell erfordert, damit es vor dem Handeln suchen kann. Das Einbinden eines Tools wird so eher zu einem einmaligen administrativen Vorgang für ein gesamtes Projekt als zu einer Einstellung, die bei jedem Aufruf erneut vorgenommen werden muss.
Der zweite Themenstrang betrifft Preis und Messung. Together AI berechnet für ein offenes, unter der MIT-Lizenz veröffentlichtes Modell genau den Hauptzeittarif von DeepSeek: Wer seine Aufrufe auf die Nebenzeiten konzentrieren kann, zahlt bei der DeepSeek-API weiterhin nur halb so viel. Auch die hervorgehobenen Kosten pro Aufgabe müssen unter Berücksichtigung der Abweichungen betrachtet werden. Togethers Behauptung bezieht sich auf agentische Benchmarks, nicht auf das Schlussfolgern, bei dem V4.1 Flash hinter GPT-5.6 Sol bleibt, und selbst bei einem agentischen Test wie Terminal-Bench v4.0 hängt die Rangfolge von der Quelle ab: Bei Artificial Analysis liegt V4.1 Flash vor GPT-5.6 Sol (27 gegenüber 21 %), in der Tabelle von DeepSeek jedoch dahinter (31,2 gegenüber 39,9). Die drei heutigen Community-Beiträge greifen jeweils dieses Erfordernis der Überprüfung auf: RDTvlokip ließ seine Ergebnisse zweiundvierzig Überprüfungsrunden durch denselben Prüfer durchlaufen, Phionyx will verhindern, dass ein Bericht stillschweigend über das hinausgeht, was ein Nachweis belegt, und darkc0de schlägt vor, statt des Erfolgs beim ersten Versuch die validierte Arbeit pro Sekunde zu messen. Ob es um einen Score, Kosten oder das Ergebnis eines Audits geht: Entscheidend bleibt die Frage, unter welchen Bedingungen die Zahl ermittelt wurde.
Quellen
- Together AI auf X, DeepSeek V4.1 Flash
- Together AI, Modellseite zu DeepSeek V4.1 Flash
- DeepSeek, API-Seite Models & Pricing
- DeepSeek, API-Changelog
- Perplexity, Dokumentation der Konnektoren der Agent API
- Perplexity, API-Changelog
- Sakana AI, Beitrag über die Sonderausgabe der Royal Society
- Hugging Face, Zweiundvierzig weitere Runden mit demselben Prüfer
- Hugging Face, Zugang bedeutet noch keine Überprüfbarkeit
- Hugging Face, Ich liebe Geschwindigkeit. Wir alle lieben Geschwindigkeit