ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-5.6-sol.
Niciun model nou în această duminică, dar două noutăți concrete pentru dezvoltatori. DeepSeek V4.1 Flash, lansat pe 10 septembrie, ajunge pe Together AI la tariful DeepSeek din orele de vârf, iar Together susține că este de trei ori mai ieftin per sarcină decât GPT-5.6 Sol, o afirmație care trebuie interpretată cu anumite nuanțe; la rândul său, Perplexity permite înregistrarea o singură dată pentru totdeauna a unui server MCP în Agent API. Sakana AI revine asupra unui număr special al Royal Society, iar trei colaboratori ai blogului comunitar Hugging Face abordează, fiecare în felul său, verificarea rezultatelor.
Together AI oferă DeepSeek V4.1 Flash și susține că este de trei ori mai ieftin per sarcină decât GPT-5.6 Sol
13 septembrie — DeepSeek V4.1 Flash ajunge pe Together AI, atât în regim serverless, cât și prin implementare dedicată, la 0,30 dolari per milion de tokeni de intrare și 1,20 dolari pentru ieșire: exact prețurile API-ului DeepSeek în orele de vârf, pe care DeepSeek le înjumătățește în afara acestora.
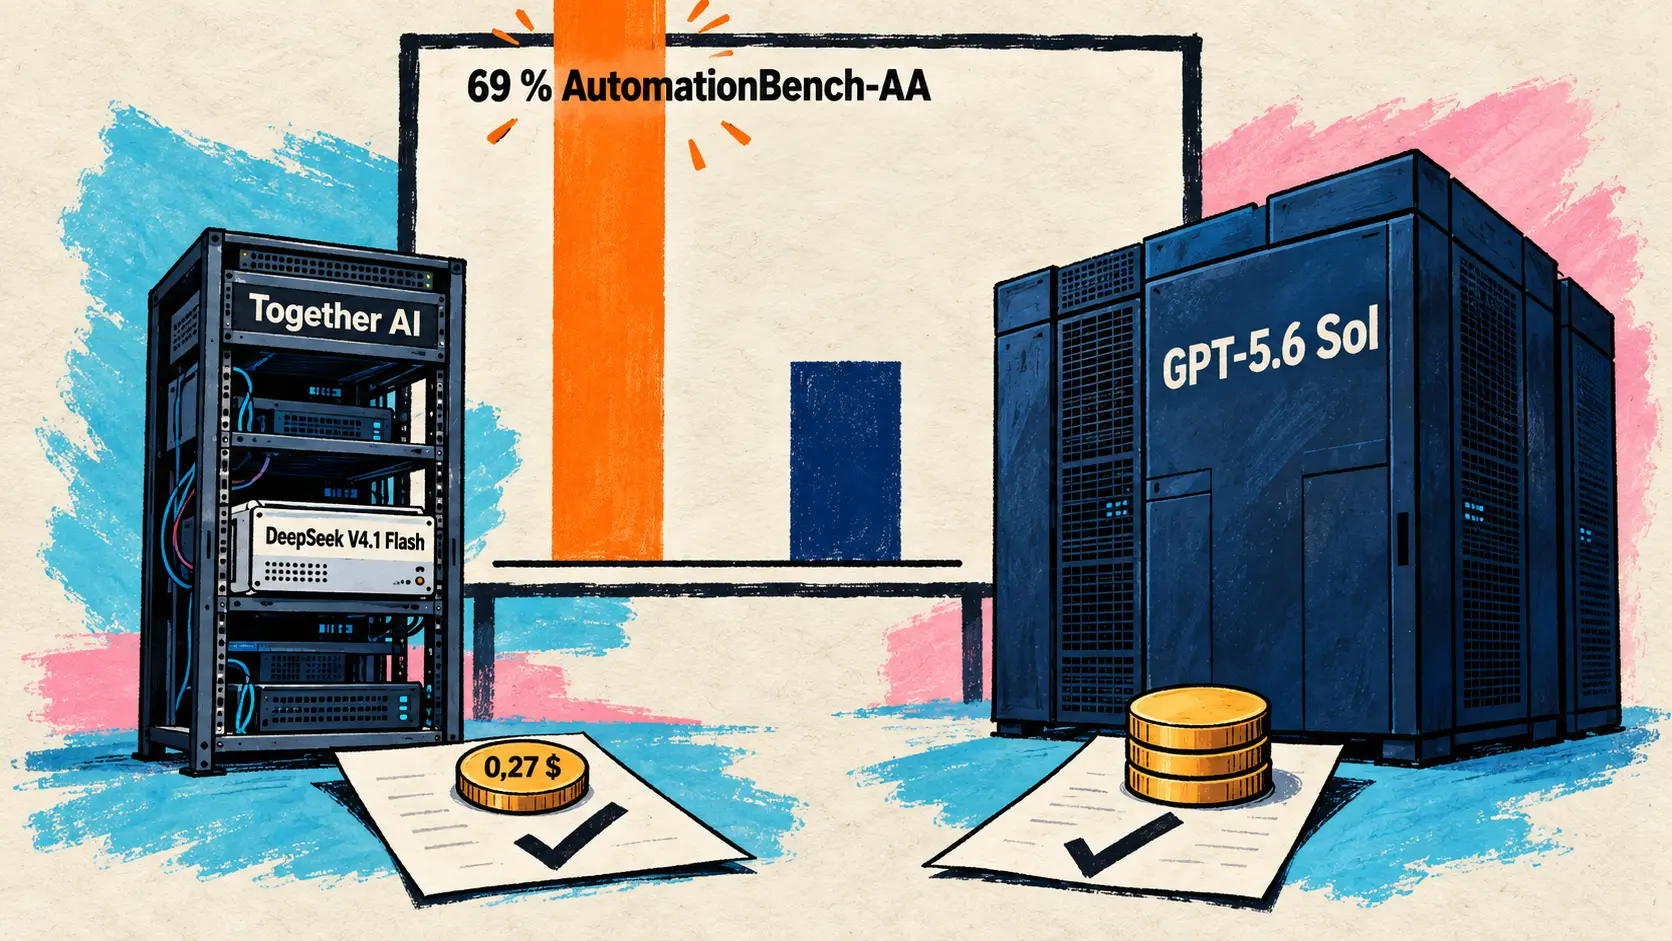
Together afirmă, pe baza măsurătorilor Artificial Analysis, că modelul depășește GPT-5.6 Sol în benchmarkurile agentice la o treime din costul per sarcină:
| Măsură comparată | DeepSeek V4.1 Flash | GPT-5.6 Sol (high) |
|---|---|---|
| AutomationBench-AA | 69 % | 55 % |
| Terminal-Bench v4.0 | 27 % | 21 % |
| GDPval-AA v2 | 1632 | 1524 |
| Cost mediu per sarcină (Intelligence Index) | 0,27 dolari | 0,81 dolari |
Două nuanțe: chiar fișa Together plasează V4.1 Flash în urma GPT-5.6 Sol la raționament (90,9 față de 94,1 % pe GPQA Diamond, 36,8 față de 47 % pe HLE), iar pe Terminal-Bench v4.0, avantajul măsurat de Artificial Analysis se inversează în tabelul publicat de DeepSeek pe 10 septembrie, care indica 31,2 pentru V4.1 Flash față de 39,9 pentru GPT-5.6 Sol.
Perplexity își deschide Agent API pentru conectori personalizați, cu un server MCP înregistrat o singură dată pentru totdeauna
13 septembrie — Perplexity adaugă conectori personalizați (custom connectors) în Agent API. Un administrator înregistrează o singură dată un server MCP la distanță în conectorii proiectului său (Project): nume, URL, autentificare prin cheie API sau fără autentificare, transport Streamable HTTP sau SSE. Perplexity păstrează cheia de acces a serverului, iar solicitările efectuate cu orice cheie API a proiectului trebuie doar să indice identificatorul conectorului prin type: "connector".
În schimb, când un server MCP este transmis în solicitare (type: "mcp"), URL-ul și datele sale de autentificare însoțesc fiecare apel, exclusiv prin Streamable HTTP. Acești conectori extind conectorii gestionați (managed connectors) introduși pe 27 august pentru GitHub, Slack, Google Drive și Datadog, acum șase la număr odată cu Linear și Notion. Descoperirea instrumentelor, amânată în mod implicit, determină modelul să caute înainte de a încărca schemele utile, motiv pentru care trebuie prevăzută o valoare suficient de mare pentru max_steps. Nu este indicat niciun tarif specific.
🔗 Documentația conectorilor Perplexity 🔗 Changelogul API-ului Perplexity
Pe scurt
- Sakana AI revine asupra unui număr special dedicat modelelor lumii (world models) — articol în japoneză din 12 septembrie despre numărul revistei Philosophical Transactions of the Royal Society A apărut pe 14 mai 2026, a cărui introducere este cosemnată de David Ha, CEO-ul Sakana AI, împreună cu alți treisprezece coautori. Noutatea este articolul, nu apariția numărului. 🔗 sursă
- REINFORCE scapă dintr-o capcană în care ascensiunea exactă a gradientului rămâne blocată — contribuție individuală pe blogul comunitar Hugging Face, nu o publicație de laborator: după patruzeci și două de runde de verificare efectuate de același cititor, RDTvlokip arată că, la 20 000 de pași, ascensiunea exactă nu ajunge la un cod neambiguu (o bijecție) în niciuna dintre cele 12 încercări, față de 11 din 12 pentru REINFORCE. Totuși, toate aceste cifre depind de optimizatorul Adam. 🔗 sursă
- Phionyx propune un contract de dovadă pentru auditurile de AI — o altă contribuție individuală: Ali Toygar Abak vrea să împiedice un dashboard sau un raport să extindă pe nesimțite ceea ce demonstrează o dovadă, de exemplu ca un apel de instrument refuzat să ajungă să fie prezentat drept un incident oprit de mecanismul de protecție. Propunerea sa, opt grupuri de metadate atașate fiecărei afirmații, rămâne un plan de inginerie și testare, fără rezultate experimentale. 🔗 sursă
- darkc0de propune evaluarea modelelor de agenți după timpul necesar pentru obținerea unui rezultat validat — a treia contribuție individuală: Sonny DeSorbo susține că un model mai slab, dar mai rapid, se poate corecta de mai multe ori înainte ca un model lent să-și termine prima încercare și schițează un benchmark, Persistent Challenge Completion, care măsoară munca validată pe secundă. O reflecție fără experimentare, pe care autorul invită cititorii să nu o ia prea în serios. 🔗 sursă
Ce înseamnă acest lucru
Primul fir privește instrumentele agenților. Cu ajutorul conectorilor personalizați, un server MCP devine o resursă a proiectului, nu un parametru repetat în fiecare solicitare: un administrator îl înregistrează o singură dată, Perplexity îi păstrează cheia de acces, iar codul care apelează Agent API nu mai trebuie să o transporte. Perplexity extinde astfel la serverele MCP ale fiecăruia, protejate printr-o cheie API sau fără autentificare, logica conectorilor gestionați introduși la sfârșitul lunii august și acceptă totodată transportul SSE pe lângă Streamable HTTP. Compromisul constă în descoperirea amânată a instrumentelor, care impune să i se lase modelului suficienți pași pentru a căuta înainte de a acționa. Conectarea unui instrument devine mai degrabă o operațiune administrativă, efectuată o singură dată pentru un proiect întreg, decât o configurare care trebuie reprodusă la fiecare apel.
Al doilea fir privește prețul și măsurarea. Together AI taxează un model deschis, publicat sub licență MIT, exact la tariful DeepSeek din orele de vârf: pentru cei care își pot concentra apelurile în afara orelor de vârf, API-ul DeepSeek rămâne de două ori mai ieftin. La rândul său, costul per sarcină evidențiat trebuie interpretat ținând cont de diferențe. Afirmația Together se referă la benchmarkurile agentice, nu la raționament, unde V4.1 Flash rămâne în urma GPT-5.6 Sol, iar chiar și într-un test agentic precum Terminal-Bench v4.0, clasamentul depinde de sursă: V4.1 Flash depășește GPT-5.6 Sol conform Artificial Analysis (27 față de 21 %), dar rămâne în urma sa în tabelul DeepSeek (31,2 față de 39,9). Cele trei articole comunitare ale zilei revin fiecare la această cerință de verificare: RDTvlokip și-a supus rezultatele la patruzeci și două de runde de recitire de către același cititor, Phionyx vrea să împiedice un raport să extindă pe nesimțite ceea ce stabilește o dovadă, iar darkc0de propune măsurarea muncii validate pe secundă în locul reușitei de la prima încercare. Fie că este vorba despre un scor, un cost sau concluzia unui audit, întrebarea rămâne în ce condiții a fost obținută cifra.
Surse
- Together AI pe X, DeepSeek V4.1 Flash
- Together AI, fișa modelului DeepSeek V4.1 Flash
- DeepSeek, pagina Models & Pricing a API-ului
- DeepSeek, changelogul API-ului
- Perplexity, documentația conectorilor Agent API
- Perplexity, changelogul API-ului
- Sakana AI, articolul despre numărul special al Royal Society
- Hugging Face, Încă patruzeci și două de runde cu același cititor
- Hugging Face, Accesul nu înseamnă încă verificabilitate
- Hugging Face, Îmi place viteza. Tuturor ne place viteza