ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-5.6-sol.
Ingen ny modell denna söndag, men två konkreta nyheter för utvecklare. DeepSeek V4.1 Flash, som släpptes den 10 september, blir tillgänglig på Together AI till DeepSeeks pris under högtrafik, och Together säger att den är tre gånger billigare per uppgift än GPT-5.6 Sol, ett påstående som bör läsas med vissa förbehåll. Perplexity gör det samtidigt möjligt att en gång för alla registrera en MCP-server i sitt Agent API. Sakana AI återkommer till ett specialnummer av Royal Society, och tre skribenter på Hugging Faces communityblogg intresserar sig, var och en på sitt sätt, för verifiering av resultat.
Together AI erbjuder DeepSeek V4.1 Flash och säger att den är tre gånger billigare per uppgift än GPT-5.6 Sol
13 september — DeepSeek V4.1 Flash blir tillgänglig på Together AI, både serverless och som dedikerad driftsättning, för 0,30 dollar per miljon tokens i input och 1,20 dollar i output: exakt samma priser som DeepSeeks API under högtrafik, vilka DeepSeek halverar under lågtrafik.
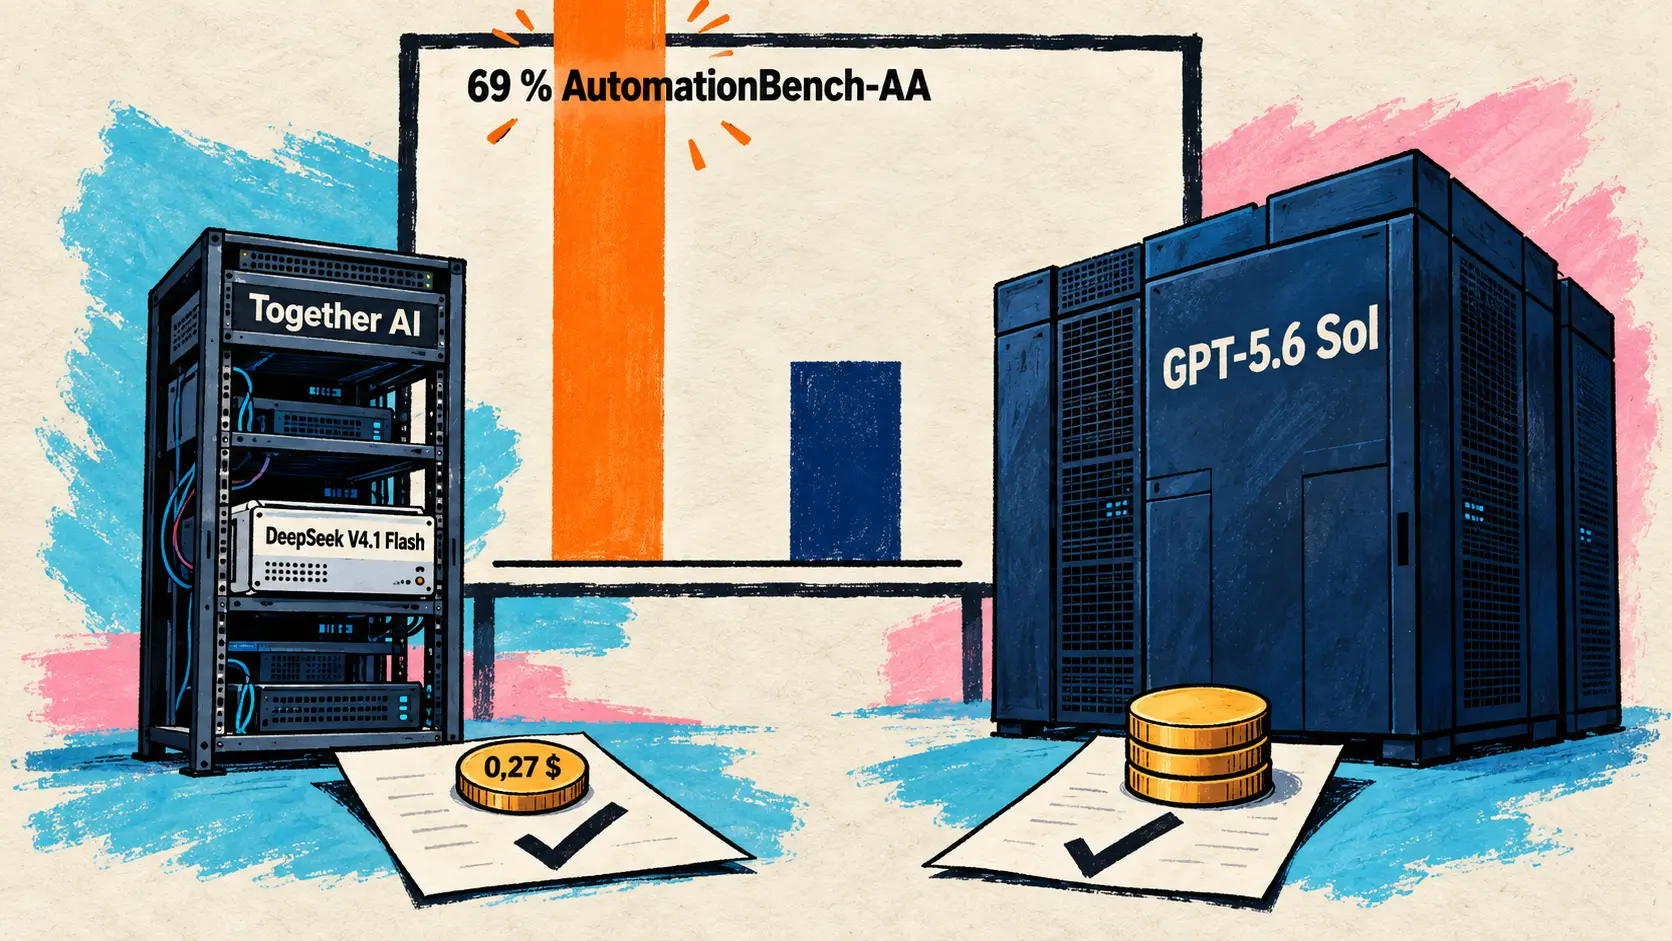
Together hävdar, med stöd av mätningar från Artificial Analysis, att modellen slår GPT-5.6 Sol på agentbaserade benchmarks till en tredjedel av kostnaden per uppgift:
| Jämförd mätning | DeepSeek V4.1 Flash | GPT-5.6 Sol (high) |
|---|---|---|
| AutomationBench-AA | 69 % | 55 % |
| Terminal-Bench v4.0 | 27 % | 21 % |
| GDPval-AA v2 | 1632 | 1524 |
| Genomsnittlig kostnad per uppgift (Intelligence Index) | 0,27 dollar | 0,81 dollar |
Två förbehåll: Togethers egen modellsida placerar V4.1 Flash bakom GPT-5.6 Sol i resonemang (90,9 mot 94,1 % på GPQA Diamond, 36,8 mot 47 % på HLE), och på Terminal-Bench v4.0 är det uppmätta försprånget enligt Artificial Analysis omvänt i tabellen som DeepSeek publicerade den 10 september, där V4.1 Flash fick 31,2 mot 39,9 för GPT-5.6 Sol.
🔗 Together AI:s tillkännagivande på X
Perplexity öppnar sitt Agent API för anpassade anslutningar, med en MCP-server som registreras en gång för alla
13 september — Perplexity lägger till anpassade anslutningar (custom connectors) i sitt Agent API. En administratör registrerar en fjärransluten MCP-server en enda gång bland projektets anslutningar (Project): namn, URL, autentisering med API-nyckel eller ingen autentisering, samt transport via Streamable HTTP eller SSE. Perplexity lagrar serverns åtkomstnyckel, och förfrågningar med valfri API-nyckel för projektet behöver bara ange anslutningens identifierare med type: "connector".
När en MCP-server i stället skickas med i förfrågningen (type: "mcp"), följer dess URL och inloggningsuppgifter med varje anrop, och då stöds endast Streamable HTTP. Dessa anslutningar utökar de hanterade anslutningar (managed connectors) som lanserades den 27 augusti för GitHub, Slack, Google Drive och Datadog, nu sex stycken genom tillägget av Linear och Notion. Verktygsidentifieringen, som är uppskjuten som standard, gör att modellen söker innan den läser in de relevanta schemana, vilket innebär att max_steps bör sättas tillräckligt högt. Ingen särskild prissättning anges.
🔗 Dokumentation för Perplexitys anslutningar 🔗 Ändringslogg för Perplexitys API
Kortfattat
- Sakana AI återkommer till ett specialnummer om världsmodeller (world models) — japanskspråkigt blogginlägg från den 12 september om numret av Philosophical Transactions of the Royal Society A som publicerades den 14 maj 2026, vars introduktion medförfattades av Sakana AI:s vd David Ha tillsammans med tretton andra författare. Nyheten är blogginlägget, inte publiceringen av numret. 🔗 källa
- REINFORCE tar sig ur en fälla där exakt gradientstigning förblir blockerad — ett individuellt bidrag till Hugging Faces communityblogg, inte en laboratoriepublikation: efter fyrtiotvå verifieringsrundor med samma läsare visar RDTvlokip att den exakta stigningen efter 20 000 steg inte leder till en entydig kod (en bijektion) i något av de 12 försöken, jämfört med 11 av 12 för REINFORCE. Alla dessa siffror är dock beroende av Adam-optimeraren. 🔗 källa
- Phionyx föreslår ett beviskontrakt för AI-revisioner — ännu ett individuellt bidrag: Ali Toygar Abak vill förhindra att en dashboard eller rapport i tysthet utvidgar vad ett bevis faktiskt fastställer, till exempel att ett avvisat verktygsanrop framställs som en incident som stoppats av skyddsmekanismen. Hans förslag, åtta grupper av metadata kopplade till varje påstående, är fortfarande en plan för utveckling och tester, utan experimentella resultat. 🔗 källa
- darkc0de föreslår att agentmodeller ska bedömas utifrån tiden det tar att uppnå ett validerat resultat — ett tredje individuellt bidrag: Sonny DeSorbo hävdar att en svagare men snabbare modell kan korrigera sig själv flera gånger innan en långsam modell har slutfört sitt första försök, och skisserar ett benchmark, Persistent Challenge Completion, som mäter validerat arbete per sekund. En tanke utan experiment, som författaren uppmanar läsaren att inte ta alltför allvarligt. 🔗 källa
Vad det innebär
Den första röda tråden gäller agenternas verktyg. Med anpassade anslutningar blir en MCP-server en projektresurs i stället för en parameter som upprepas i varje förfrågan: en administratör registrerar den en gång, Perplexity lagrar dess åtkomstnyckel och koden som anropar Agent API behöver inte längre skicka med den. Perplexity utvidgar därmed principen bakom de hanterade anslutningar som lanserades i slutet av augusti till att omfatta användarnas egna MCP-servrar, skyddade med en API-nyckel eller utan autentisering, och stöder samtidigt transport via SSE utöver Streamable HTTP. Nackdelen är den uppskjutna verktygsidentifieringen, som kräver att modellen får tillräckligt många steg för att söka innan den agerar. Att ansluta ett verktyg blir mer av en administrativ åtgärd som utförs en gång för ett helt projekt än en inställning som måste upprepas vid varje anrop.
Den andra röda tråden gäller pris och mätning. Together AI tar för en öppen modell, publicerad under MIT-licensen, exakt samma pris som DeepSeek under högtrafik: för den som kan koncentrera sina anrop till lågtrafik är DeepSeeks API fortfarande hälften så dyrt. Den framhävda kostnaden per uppgift måste i sin tur ses mot bakgrund av skillnaderna. Togethers påstående gäller agentbaserade benchmarks, inte resonemang där V4.1 Flash fortfarande ligger efter GPT-5.6 Sol, och även på ett agentbaserat test som Terminal-Bench v4.0 beror rangordningen på källan: V4.1 Flash ligger före GPT-5.6 Sol hos Artificial Analysis (27 mot 21 %), men efter i DeepSeeks tabell (31,2 mot 39,9). Dagens tre communityinlägg återkommer vart och ett till detta krav på verifiering: RDTvlokip lät sina resultat genomgå fyrtiotvå granskningsrundor med samma läsare, Phionyx vill förhindra att en rapport i tysthet utvidgar vad ett bevis fastställer, och darkc0de föreslår att validerat arbete per sekund ska mätas i stället för framgång vid första försöket. Oavsett om det gäller ett resultat, en kostnad eller en revisionsslutsats kvarstår frågan under vilka förutsättningar siffran togs fram.
Källor
- Together AI på X, DeepSeek V4.1 Flash
- Together AI, modellsida för DeepSeek V4.1 Flash
- DeepSeek, API-sidan Models & Pricing
- DeepSeek, API-ändringslogg
- Perplexity, dokumentation för anslutningar i Agent API
- Perplexity, API-ändringslogg
- Sakana AI, blogginlägg om Royal Societys specialnummer
- Hugging Face, Forty-two more rounds with the same reader
- Hugging Face, Access Is Not Yet Verifiability
- Hugging Face, I love speed. We all love speed