ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-5.6-sol.
Deze zondag geen nieuw model, maar wel twee concrete vernieuwingen voor ontwikkelaars. DeepSeek V4.1 Flash, uitgebracht op 10 september, komt naar Together AI tegen het piekurtarief van DeepSeek, en Together noemt het per taak drie keer goedkoper dan GPT-5.6 Sol, een claim die enige nuance vereist; Perplexity maakt het op zijn beurt mogelijk om een MCP-server eenmalig in zijn Agent API te registreren. Sakana AI blikt terug op een speciaal nummer van de Royal Society, en drie bijdragers aan de communityblog van Hugging Face richten zich ieder op hun eigen manier op de verificatie van resultaten.
Together AI biedt DeepSeek V4.1 Flash aan en noemt het per taak drie keer goedkoper dan GPT-5.6 Sol
13 september — DeepSeek V4.1 Flash komt naar Together AI, zowel serverless als via een dedicated deployment, voor 0,30 dollar per miljoen inputtokens en 1,20 dollar per miljoen outputtokens: precies de prijzen van de DeepSeek-API tijdens piekuren, die DeepSeek tijdens daluren halveert.
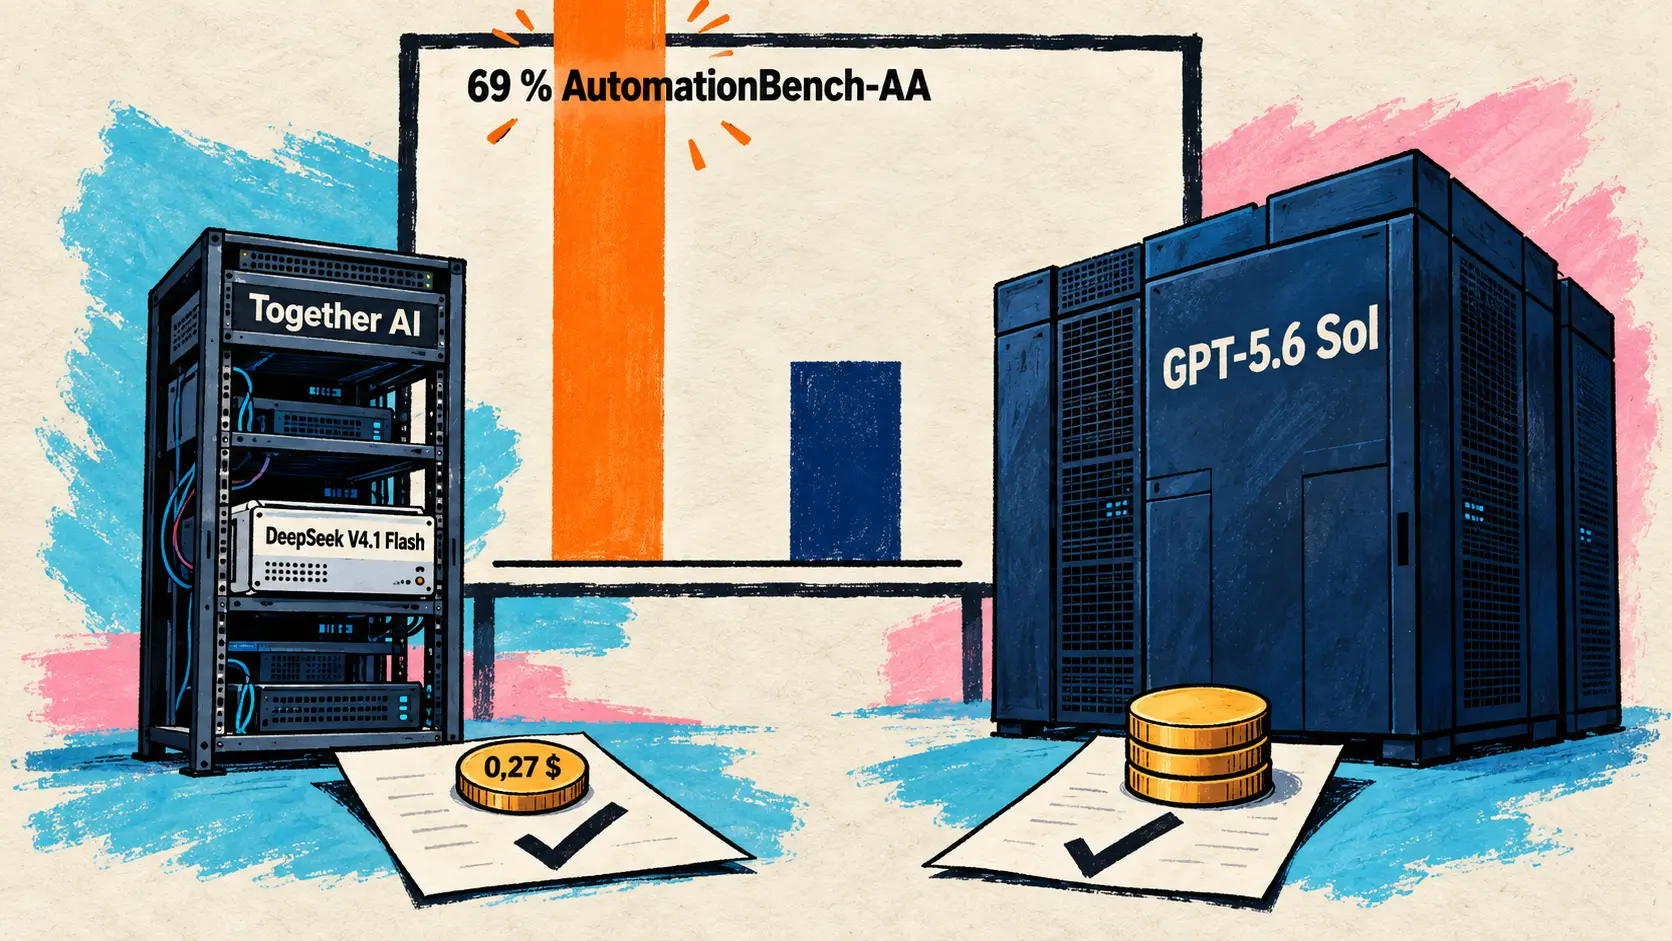
Together stelt, onder verwijzing naar metingen van Artificial Analysis, dat het model GPT-5.6 Sol op agentic benchmarks verslaat tegen een derde van de kosten per taak:
| Vergeleken meting | DeepSeek V4.1 Flash | GPT-5.6 Sol (high) |
|---|---|---|
| AutomationBench-AA | 69 % | 55 % |
| Terminal-Bench v4.0 | 27 % | 21 % |
| GDPval-AA v2 | 1632 | 1524 |
| Gemiddelde kosten per taak (Intelligence Index) | 0,27 dollar | 0,81 dollar |
Twee nuances: Together plaatst V4.1 Flash op zijn eigen modelpagina achter GPT-5.6 Sol wat betreft reasoning (90,9 tegenover 94,1 % op GPQA Diamond, 36,8 tegenover 47 % op HLE), en bij Terminal-Bench v4.0 is het door Artificial Analysis gemeten voordeel omgekeerd in de tabel die DeepSeek op 10 september publiceerde: daarin kreeg V4.1 Flash 31,2 tegenover 39,9 voor GPT-5.6 Sol.
🔗 Aankondiging van Together AI op X
Perplexity stelt zijn Agent API open voor aangepaste connectors, met een MCP-server die eenmalig wordt geregistreerd
13 september — Perplexity voegt aangepaste connectors (custom connectors) toe aan zijn Agent API. Een beheerder registreert een externe MCP-server eenmalig bij de connectors van zijn project (Project): naam, URL, authenticatie via een API key of geen authenticatie, en Streamable HTTP of SSE als transport. Perplexity bewaart de toegangssleutel van de server, waarna verzoeken met elke API key van het project alleen de connector-ID hoeven te vermelden met type: "connector".
Wanneer een MCP-server rechtstreeks in het verzoek wordt meegegeven (type: "mcp"), worden de URL en inloggegevens daarentegen bij iedere aanroep meegestuurd, en is alleen Streamable HTTP mogelijk. Deze connectors vormen een uitbreiding op de beheerde connectors (managed connectors) die op 27 augustus beschikbaar kwamen voor GitHub, Slack, Google Drive en Datadog, inmiddels zes met Linear en Notion erbij. Bij de standaard uitgestelde tool discovery zoekt het model voordat het de benodigde schema’s laadt, waardoor max_steps voldoende hoog moet worden ingesteld. Er wordt geen specifiek tarief vermeld.
🔗 Documentatie over de connectors van Perplexity 🔗 Changelog van de Perplexity-API
Kort nieuws
- Sakana AI blikt terug op een speciaal nummer over world models (world models) — Japanstalige blogpost van 12 september over het nummer van Philosophical Transactions of the Royal Society A dat op 14 mei 2026 verscheen en waarvan David Ha, CEO van Sakana AI, samen met dertien andere coauteurs de inleiding schreef. Het nieuws is de blogpost, niet de publicatie van het nummer. 🔗 bron
- REINFORCE ontsnapt aan een val waarin exacte gradient ascent vastloopt — een individuele bijdrage aan de communityblog van Hugging Face, geen publicatie van een laboratorium: na tweeënveertig verificatierondes door dezelfde lezer laat RDTvlokip zien dat exacte gradient ascent na 20.000 stappen in geen van de 12 pogingen tot een ondubbelzinnige code (een bijectie) leidt, tegenover 11 van de 12 pogingen voor REINFORCE. Al deze cijfers zijn echter afhankelijk van de Adam optimizer. 🔗 bron
- Phionyx stelt een bewijscontract voor AI-audits voor — nog een individuele bijdrage: Ali Toygar Abak wil voorkomen dat een dashboard of rapport stilzwijgend ruimere conclusies trekt dan het bewijs rechtvaardigt, bijvoorbeeld wanneer een geweigerde tool call uiteindelijk wordt voorgesteld als een incident dat door de guardrail is tegengehouden. Zijn voorstel, acht groepen metadata die aan elke bewering worden gekoppeld, blijft een plan voor engineering en tests, zonder experimenteel resultaat. 🔗 bron
- darkc0de stelt voor agentmodellen te beoordelen op de tijd die nodig is om een gevalideerd resultaat te verkrijgen — een derde individuele bijdrage: Sonny DeSorbo betoogt dat een zwakker maar sneller model zichzelf meerdere keren kan corrigeren voordat een traag model zijn eerste poging heeft voltooid, en schetst een benchmark, Persistent Challenge Completion, die gevalideerd werk per seconde meet. Een gedachtegang zonder experimenten, die de auteur naar eigen zeggen niet al te serieus genomen wil zien. 🔗 bron
Wat dit betekent
De eerste rode draad betreft de tooling voor agents. Met aangepaste connectors wordt een MCP-server een projectresource in plaats van een parameter die in elk verzoek wordt herhaald: een beheerder registreert hem eenmalig, Perplexity bewaart de toegangssleutel en de code die de Agent API aanroept hoeft deze niet langer mee te sturen. Zo breidt Perplexity de logica van de eind augustus geïntroduceerde beheerde connectors uit naar ieders MCP-servers, beveiligd met een API key of zonder authenticatie, en ondersteunt het bovendien SSE als transport naast Streamable HTTP. Daar staat tegenover dat de uitgestelde tool discovery vereist dat het model voldoende stappen krijgt om te zoeken voordat het handelt. Het aansluiten van een tool wordt zo vooral een beheerhandeling die eenmalig voor een heel project wordt uitgevoerd, in plaats van een instelling die bij elke aanroep opnieuw moet worden opgegeven.
De tweede rode draad draait om prijs en meting. Together AI rekent voor een open model dat onder de MIT-licentie is gepubliceerd exact het piekurtarief van DeepSeek: voor wie zijn aanroepen tijdens daluren kan concentreren, blijft de API van DeepSeek twee keer goedkoper. Ook de uitgelichte kosten per taak moeten met oog voor de verschillen worden gelezen. De claim van Together gaat over agentic benchmarks, niet over reasoning, waar V4.1 Flash achter GPT-5.6 Sol blijft, en zelfs bij een agentic test als Terminal-Bench v4.0 hangt de rangschikking af van de bron: bij Artificial Analysis ligt V4.1 Flash vóór GPT-5.6 Sol (27 tegenover 21 %), maar in de tabel van DeepSeek erachter (31,2 tegenover 39,9). De drie communityposts van vandaag komen elk terug op deze behoefte aan verificatie: RDTvlokip onderwierp zijn resultaten aan tweeënveertig beoordelingsrondes door dezelfde lezer, Phionyx wil voorkomen dat een rapport stilzwijgend ruimere conclusies trekt dan het bewijs rechtvaardigt, en darkc0de stelt voor om gevalideerd werk per seconde te meten in plaats van succes bij de eerste poging. Of het nu om een score, kostenpost of auditconclusie gaat, de vraag blijft onder welke omstandigheden het cijfer is verkregen.
Bronnen
- Together AI op X, DeepSeek V4.1 Flash
- Together AI, modelpagina van DeepSeek V4.1 Flash
- DeepSeek, API-pagina Models & Pricing
- DeepSeek, changelog van de API
- Perplexity, documentatie over de connectors van de Agent API
- Perplexity, changelog van de API
- Sakana AI, blogpost over het speciale nummer van de Royal Society
- Hugging Face, Forty-two more rounds with the same reader
- Hugging Face, Access Is Not Yet Verifiability
- Hugging Face, I love speed. We all love speed