ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-5.6-sol.
Nessun nuovo modello questa domenica, ma due novità concrete per gli sviluppatori. DeepSeek V4.1 Flash, uscito il 10 settembre, arriva su Together AI alla tariffa di punta di DeepSeek, e Together afferma che costa tre volte meno per attività rispetto a GPT-5.6 Sol, una dichiarazione da leggere con le dovute precisazioni; Perplexity, dal canto suo, consente di registrare una volta per tutte un server MCP nella sua Agent API. Sakana AI torna su un numero speciale della Royal Society e tre collaboratori del blog della community di Hugging Face si interessano, ciascuno a modo proprio, alla verifica dei risultati.
Together AI offre DeepSeek V4.1 Flash e afferma che costa tre volte meno per attività rispetto a GPT-5.6 Sol
13 settembre — DeepSeek V4.1 Flash arriva su Together AI, sia in modalità serverless sia come deployment dedicato, a 0,30 dollari per milione di token in input e 1,20 dollari in output: esattamente i prezzi dell’API di DeepSeek nelle ore di punta, che DeepSeek dimezza nelle ore non di punta.
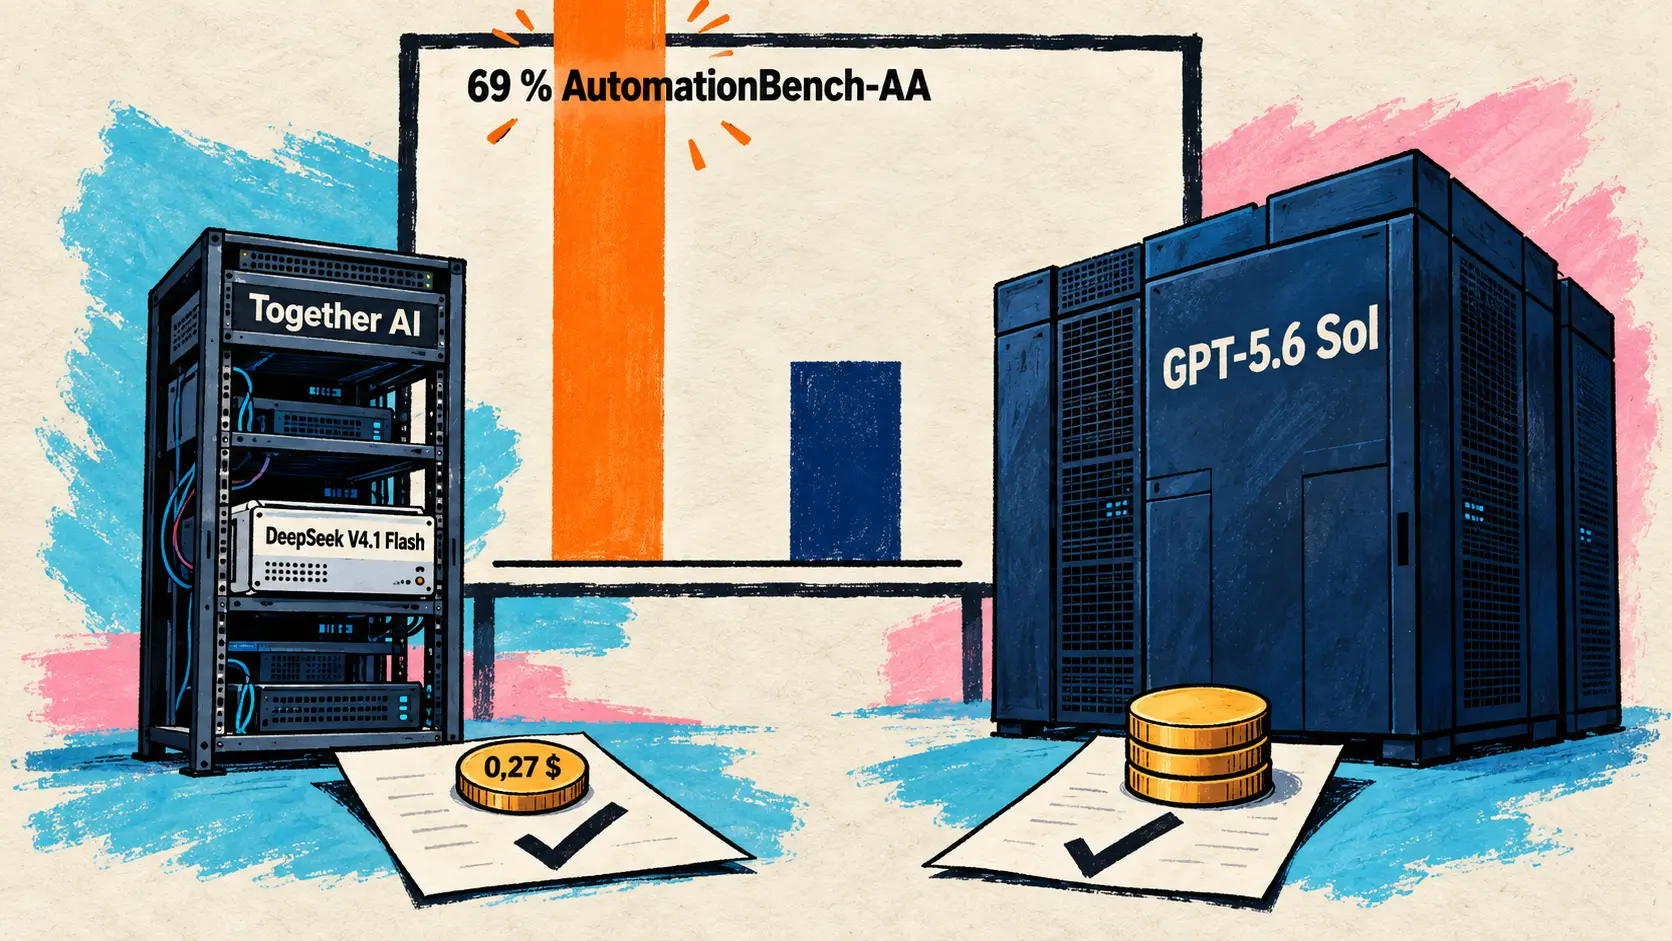
Together afferma, sulla base delle misurazioni di Artificial Analysis, che il modello supera GPT-5.6 Sol nei benchmark agentici a un terzo del costo per attività:
| Misura confrontata | DeepSeek V4.1 Flash | GPT-5.6 Sol (high) |
|---|---|---|
| AutomationBench-AA | 69 % | 55 % |
| Terminal-Bench v4.0 | 27 % | 21 % |
| GDPval-AA v2 | 1632 | 1524 |
| Costo medio per attività (Intelligence Index) | 0,27 dollari | 0,81 dollari |
Due precisazioni: la scheda di Together colloca essa stessa V4.1 Flash dietro GPT-5.6 Sol nel ragionamento (90,9 contro 94,1 % su GPQA Diamond, 36,8 contro 47 % su HLE) e, su Terminal-Bench v4.0, il vantaggio misurato da Artificial Analysis si inverte nella tabella pubblicata da DeepSeek il 10 settembre, che assegnava 31,2 a V4.1 Flash contro 39,9 a GPT-5.6 Sol.
🔗 Annuncio di Together AI su X
Perplexity apre la sua Agent API ai connettori personalizzati, con un server MCP registrato una volta per tutte
13 settembre — Perplexity aggiunge alla sua Agent API i connettori personalizzati (custom connectors). Un amministratore registra una sola volta un server MCP remoto nei connettori del proprio progetto (Project): nome, URL, autenticazione tramite chiave API oppure nessuna autenticazione, trasporto Streamable HTTP o SSE. Perplexity conserva la chiave di accesso del server e le richieste effettuate con qualsiasi chiave API del progetto devono soltanto indicare l’identificatore del connettore tramite type: "connector".
Con un server MCP incluso nella richiesta (type: "mcp"), il suo URL e le sue credenziali accompagnano invece ogni chiamata, esclusivamente tramite Streamable HTTP. Questi connettori ampliano i connettori gestiti (managed connectors) arrivati il 27 agosto per GitHub, Slack, Google Drive e Datadog, ora diventati sei con Linear e Notion. La scoperta degli strumenti, differita per impostazione predefinita, fa sì che il modello effettui una ricerca prima di caricare gli schemi utili, da cui la necessità di impostare max_steps su un valore sufficientemente alto. Non viene indicata alcuna tariffa specifica.
🔗 Documentazione dei connettori di Perplexity 🔗 Changelog dell’API di Perplexity
In breve
- Sakana AI torna su un numero speciale dedicato ai modelli del mondo (world models) — post in giapponese del 12 settembre sul numero di Philosophical Transactions of the Royal Society A pubblicato il 14 maggio 2026, la cui introduzione è firmata da David Ha, CEO di Sakana AI, insieme ad altri tredici coautori. La novità riguarda il post, non la pubblicazione del numero. 🔗 fonte
- REINFORCE sfugge a una trappola in cui l’ascesa esatta del gradiente rimane bloccata — contributo individuale al blog della community di Hugging Face, e non pubblicazione di un laboratorio: dopo quarantadue cicli di verifica condotti dallo stesso lettore, RDTvlokip mostra che, a 20.000 passaggi, l’ascesa esatta non produce un codice privo di ambiguità (una biiezione) in nessuna delle 12 prove, contro 11 su 12 per REINFORCE. Tutti questi risultati dipendono tuttavia dall’ottimizzatore Adam. 🔗 fonte
- Phionyx propone un contratto di prova per gli audit dell’IA — un altro contributo individuale: Ali Toygar Abak vuole impedire che una dashboard o un report estenda tacitamente ciò che una prova dimostra, per esempio presentando infine una chiamata a uno strumento rifiutata come un incidente bloccato dal guardrail. La sua proposta, composta da otto gruppi di metadati associati a ciascuna affermazione, resta un piano di ingegneria e test, senza risultati sperimentali. 🔗 fonte
- darkc0de propone di valutare i modelli agentici in base al tempo necessario per ottenere un risultato validato — terzo contributo individuale: Sonny DeSorbo sostiene che un modello più debole ma più veloce possa correggersi più volte prima che un modello lento abbia terminato il suo primo tentativo e abbozza un benchmark, Persistent Challenge Completion, che misura il lavoro validato al secondo. Una riflessione priva di sperimentazione, che l’autore invita a non prendere troppo sul serio. 🔗 fonte
Che cosa significa
Il primo filo conduttore riguarda gli strumenti degli agenti. Con i connettori personalizzati, un server MCP diventa una risorsa del progetto anziché un parametro ripetuto in ogni richiesta: un amministratore lo registra una volta, Perplexity ne conserva la chiave di accesso e il codice che chiama l’Agent API non deve più trasportarla. Perplexity estende così ai server MCP di ciascuno, protetti da una chiave API oppure privi di autenticazione, la logica dei connettori gestiti arrivati a fine agosto e accetta inoltre il trasporto SSE oltre a Streamable HTTP. La contropartita è la scoperta differita degli strumenti, che impone di lasciare al modello abbastanza passaggi per effettuare la ricerca prima di agire. Collegare uno strumento diventa un’operazione amministrativa, eseguita una volta per un intero progetto, più che un’impostazione da riprodurre in ogni chiamata.
Il secondo filo conduttore riguarda il prezzo e la misurazione. Together AI fattura un modello aperto, pubblicato con licenza MIT, esattamente alla tariffa di punta di DeepSeek: per chi può concentrare le chiamate nelle ore non di punta, l’API di DeepSeek rimane due volte più economica. Il costo per attività messo in evidenza va invece letto tenendo conto delle differenze. L’affermazione di Together riguarda i benchmark agentici, non il ragionamento, ambito nel quale V4.1 Flash rimane dietro GPT-5.6 Sol; persino in un test agentico come Terminal-Bench v4.0, la classifica dipende dalla fonte: V4.1 Flash precede GPT-5.6 Sol secondo Artificial Analysis (27 contro 21 %), ma lo segue nella tabella di DeepSeek (31,2 contro 39,9). I tre post della community pubblicati oggi richiamano ciascuno questa esigenza di verifica: RDTvlokip ha sottoposto i propri risultati a quarantadue cicli di revisione da parte dello stesso lettore, Phionyx vuole impedire che un report estenda tacitamente ciò che una prova dimostra e darkc0de propone di misurare il lavoro validato al secondo anziché il successo al primo tentativo. Che si tratti di un punteggio, di un costo o della conclusione di un audit, la questione rimane capire in quali condizioni sia stato ottenuto il dato.
Fonti
- Together AI su X, DeepSeek V4.1 Flash
- Together AI, scheda del modello DeepSeek V4.1 Flash
- DeepSeek, pagina Models & Pricing dell’API
- DeepSeek, changelog dell’API
- Perplexity, documentazione dei connettori dell’Agent API
- Perplexity, changelog dell’API
- Sakana AI, post sul numero speciale della Royal Society
- Hugging Face, Quarantadue altri cicli con lo stesso lettore
- Hugging Face, L’accesso non è ancora verificabilità
- Hugging Face, Amo la velocità. Tutti amiamo la velocità