ai-powered-markdown-translatorArtigo traduzido do francês para o português com o gpt-5.6-sol.
Nenhum modelo novo neste domingo, mas há duas novidades concretas para os desenvolvedores. DeepSeek V4.1 Flash, lançado em 10 de setembro, chega à Together AI pelo preço do horário de pico da DeepSeek, e a Together afirma que custa três vezes menos por tarefa do que GPT-5.6 Sol, uma alegação que deve ser lida com algumas ressalvas; por sua vez, a Perplexity permite registrar de uma vez por todas um servidor MCP em sua Agent API. A Sakana AI retoma uma edição especial da Royal Society, e três colaboradores do blog comunitário da Hugging Face abordam, cada um à sua maneira, a verificação dos resultados.
Together AI disponibiliza DeepSeek V4.1 Flash e afirma que custa três vezes menos por tarefa do que GPT-5.6 Sol
13 de setembro — DeepSeek V4.1 Flash chega à Together AI, tanto em serverless quanto em implantação dedicada, por 0,30 dólar por milhão de tokens de entrada e 1,20 dólar de saída: exatamente os preços da API da DeepSeek no horário de pico, que a DeepSeek reduz pela metade fora desse horário.
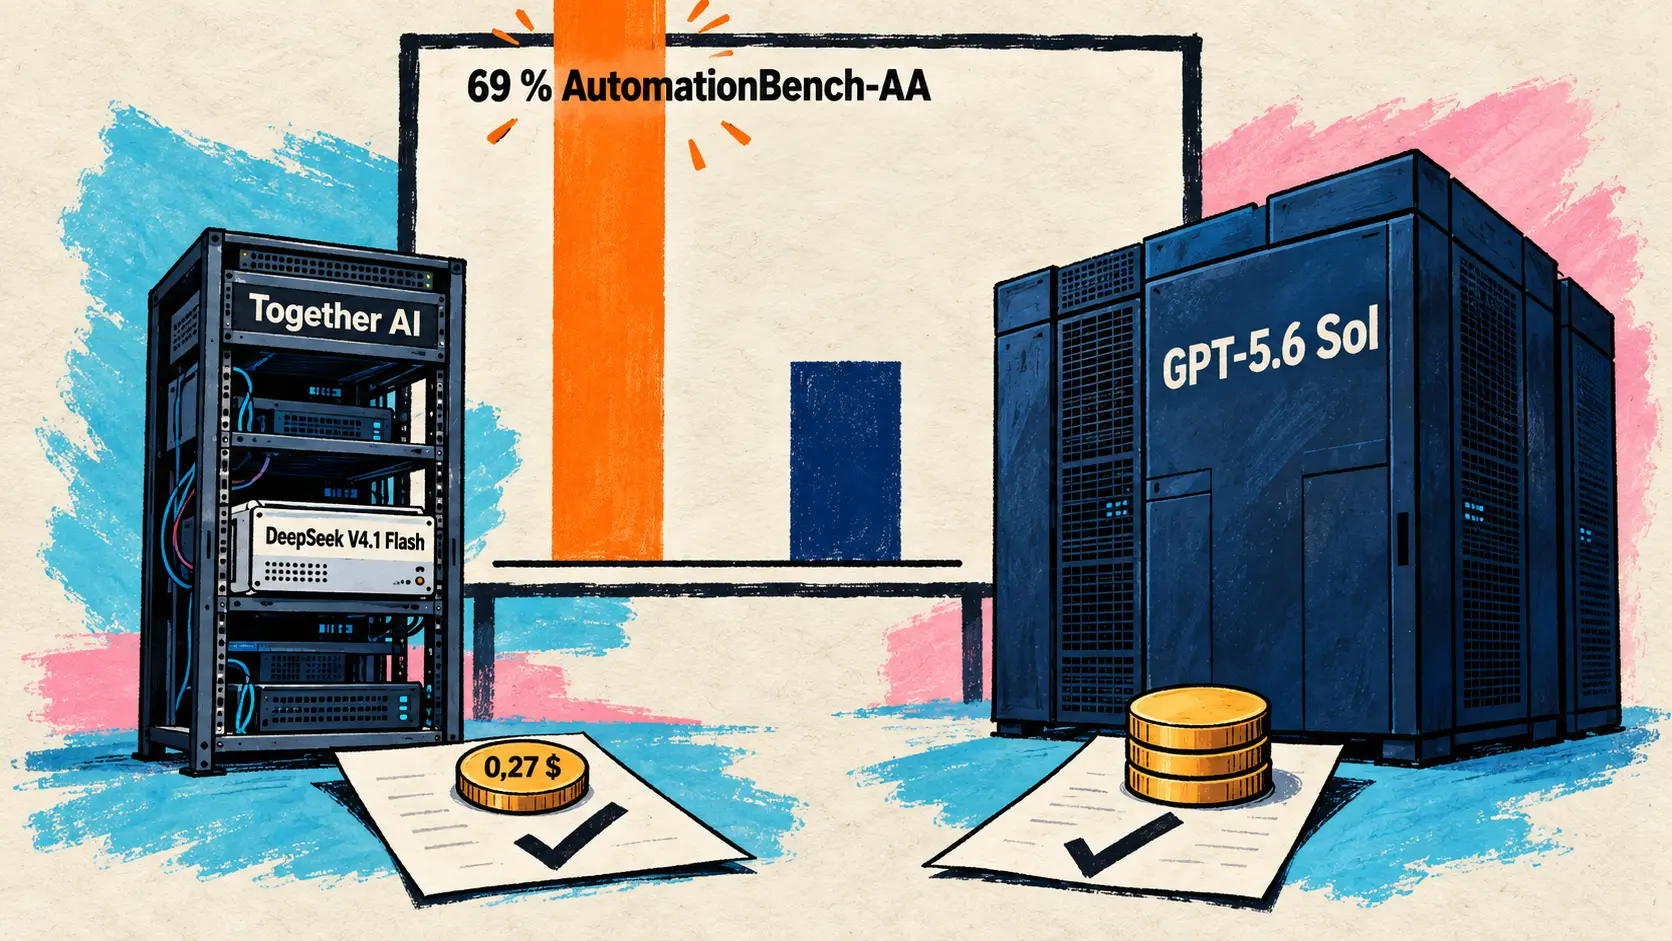
A Together afirma, com base em medições da Artificial Analysis, que o modelo supera GPT-5.6 Sol nos benchmarks agênticos por um terço do custo por tarefa:
| Medida comparada | DeepSeek V4.1 Flash | GPT-5.6 Sol (high) |
|---|---|---|
| AutomationBench-AA | 69 % | 55 % |
| Terminal-Bench v4.0 | 27 % | 21 % |
| GDPval-AA v2 | 1632 | 1524 |
| Custo médio por tarefa (Intelligence Index) | 0,27 dólar | 0,81 dólar |
Duas ressalvas: a própria página da Together coloca V4.1 Flash atrás de GPT-5.6 Sol em raciocínio (90,9 contra 94,1% no GPQA Diamond, 36,8 contra 47% no HLE), e, no Terminal-Bench v4.0, a vantagem medida pela Artificial Analysis se inverte na tabela publicada pela DeepSeek em 10 de setembro, que atribuía 31,2 a V4.1 Flash contra 39,9 a GPT-5.6 Sol.
Perplexity abre sua Agent API a conectores personalizados, com um servidor MCP registrado de uma vez por todas
13 de setembro — A Perplexity adiciona conectores personalizados (custom connectors) à sua Agent API. Um administrador registra uma única vez um servidor MCP remoto nos conectores de seu projeto (Project): nome, URL, autenticação por chave de API ou nenhuma, transporte Streamable HTTP ou SSE. A Perplexity armazena a chave de acesso do servidor, e as solicitações feitas com qualquer chave de API do projeto precisam apenas indicar o identificador do conector com type: "connector".
Com um servidor MCP incluído na solicitação (type: "mcp"), por outro lado, sua URL e suas credenciais acompanham cada chamada, exclusivamente por Streamable HTTP. Esses conectores ampliam os conectores gerenciados (managed connectors) lançados em 27 de agosto para GitHub, Slack, Google Drive e Datadog, agora seis com Linear e Notion. A descoberta de ferramentas, adiada por padrão, faz com que o modelo pesquise antes de carregar os esquemas necessários, sendo portanto recomendável definir max_steps suficientemente alto. Nenhum preço específico é indicado.
🔗 Documentação dos conectores da Perplexity 🔗 Changelog da API da Perplexity
Notícias breves
- Sakana AI retoma uma edição especial dedicada aos modelos de mundo (world models) — publicação em japonês de 12 de setembro sobre a edição de Philosophical Transactions of the Royal Society A publicada em 14 de maio de 2026, cuja introdução David Ha, CEO da Sakana AI, assina com outros treze coautores. A novidade é a publicação no blog, não a edição da revista. 🔗 fonte
- REINFORCE escapa de uma armadilha na qual a subida exata do gradiente permanece bloqueada — contribuição individual ao blog comunitário da Hugging Face, e não uma publicação de laboratório: após quarenta e duas rodadas de verificação pelo mesmo leitor, RDTvlokip mostra que, em 20.000 passos, a subida exata não chega a um código inequívoco (uma bijeção) em nenhum dos 12 testes, contra 11 de 12 para REINFORCE. Todos esses números dependem, contudo, do otimizador Adam. 🔗 fonte
- Phionyx propõe um contrato de prova para auditorias de IA — outra contribuição individual: Ali Toygar Abak quer impedir que um painel ou relatório amplie silenciosamente aquilo que uma prova estabelece, por exemplo, que uma chamada de ferramenta recusada acabe sendo apresentada como um incidente interrompido pela proteção. Sua proposta, oito grupos de metadados associados a cada afirmação, permanece um plano de engenharia e testes, sem resultados experimentais. 🔗 fonte
- darkc0de propõe avaliar modelos de agentes pelo tempo necessário para obter um resultado validado — terceira contribuição individual: Sonny DeSorbo argumenta que um modelo mais fraco, porém mais rápido, pode se corrigir várias vezes antes que um modelo lento termine sua primeira tentativa, e esboça um benchmark, Persistent Challenge Completion, que mede o trabalho validado por segundo. Uma reflexão sem experimentação, que o autor recomenda não levar muito a sério. 🔗 fonte
O que isso significa
O primeiro tema diz respeito às ferramentas dos agentes. Com os conectores personalizados, um servidor MCP torna-se um recurso do projeto em vez de um parâmetro repetido em cada solicitação: um administrador o registra uma vez, a Perplexity armazena sua chave de acesso, e o código que chama a Agent API não precisa mais transportá-la. Assim, a Perplexity estende aos servidores MCP de cada usuário, protegidos por uma chave de API ou sem autenticação, a lógica dos conectores gerenciados lançados no fim de agosto, passando também a aceitar o transporte SSE além do Streamable HTTP. A contrapartida está na descoberta adiada das ferramentas, que exige deixar etapas suficientes para que o modelo pesquise antes de agir. Conectar uma ferramenta torna-se uma operação administrativa, realizada uma única vez para todo um projeto, mais do que uma configuração a ser reproduzida em cada chamada.
O segundo tema envolve preço e medição. A Together AI cobra por um modelo aberto, publicado sob a licença MIT, exatamente o preço da DeepSeek no horário de pico: para quem consegue concentrar suas chamadas fora desse horário, a API da DeepSeek continua sendo duas vezes mais barata. Já o custo por tarefa destacado deve ser interpretado considerando suas discrepâncias. A alegação da Together refere-se aos benchmarks agênticos, não ao raciocínio, no qual V4.1 Flash continua atrás de GPT-5.6 Sol, e mesmo em um teste agêntico como o Terminal-Bench v4.0, a classificação depende da fonte: V4.1 Flash supera GPT-5.6 Sol segundo a Artificial Analysis (27 contra 21%), mas fica atrás dele na tabela da DeepSeek (31,2 contra 39,9). As três publicações comunitárias do dia retomam, cada uma, essa exigência de verificação: RDTvlokip submeteu seus resultados a quarenta e duas rodadas de revisão pelo mesmo leitor, Phionyx quer impedir que um relatório amplie silenciosamente aquilo que uma prova estabelece, e darkc0de propõe medir o trabalho validado por segundo em vez do sucesso na primeira tentativa. Seja um resultado, um custo ou uma conclusão de auditoria, a questão continua sendo saber em que condições o número foi obtido.
Fontes
- Together AI no X, DeepSeek V4.1 Flash
- Together AI, página do modelo DeepSeek V4.1 Flash
- DeepSeek, página Models & Pricing da API
- DeepSeek, changelog da API
- Perplexity, documentação dos conectores da Agent API
- Perplexity, changelog da API
- Sakana AI, publicação sobre a edição especial da Royal Society
- Hugging Face, Forty-two more rounds with the same reader
- Hugging Face, Access Is Not Yet Verifiability
- Hugging Face, I love speed. We all love speed