OpenAI fait entrer ses modèles de frontière et Codex dans le Model Garden de Google Cloud, en préversion privée pour une sélection d’entreprises, et Google revendique désormais d’être le seul grand cloud à proposer les trois principaux LLM fermés. Anthropic ouvre l’aperçu de Claude Duet, un agent qui travaille seul dans sa propre machine virtuelle et demande l’accord avant de payer ou de signer, tandis qu’OpenAI dresse le bilan de PHP2Shell, deux failles critiques de PHP dont l’une a été trouvée avec GPT-5.6 Sol. À GTC Berlin, NVIDIA présente une architecture de référence pour confiner les agents et des usines IA livrées en conteneurs ; Recursive publie Flint, un modèle ouvert pour coder en local, et Cohere lance Rerank 5.
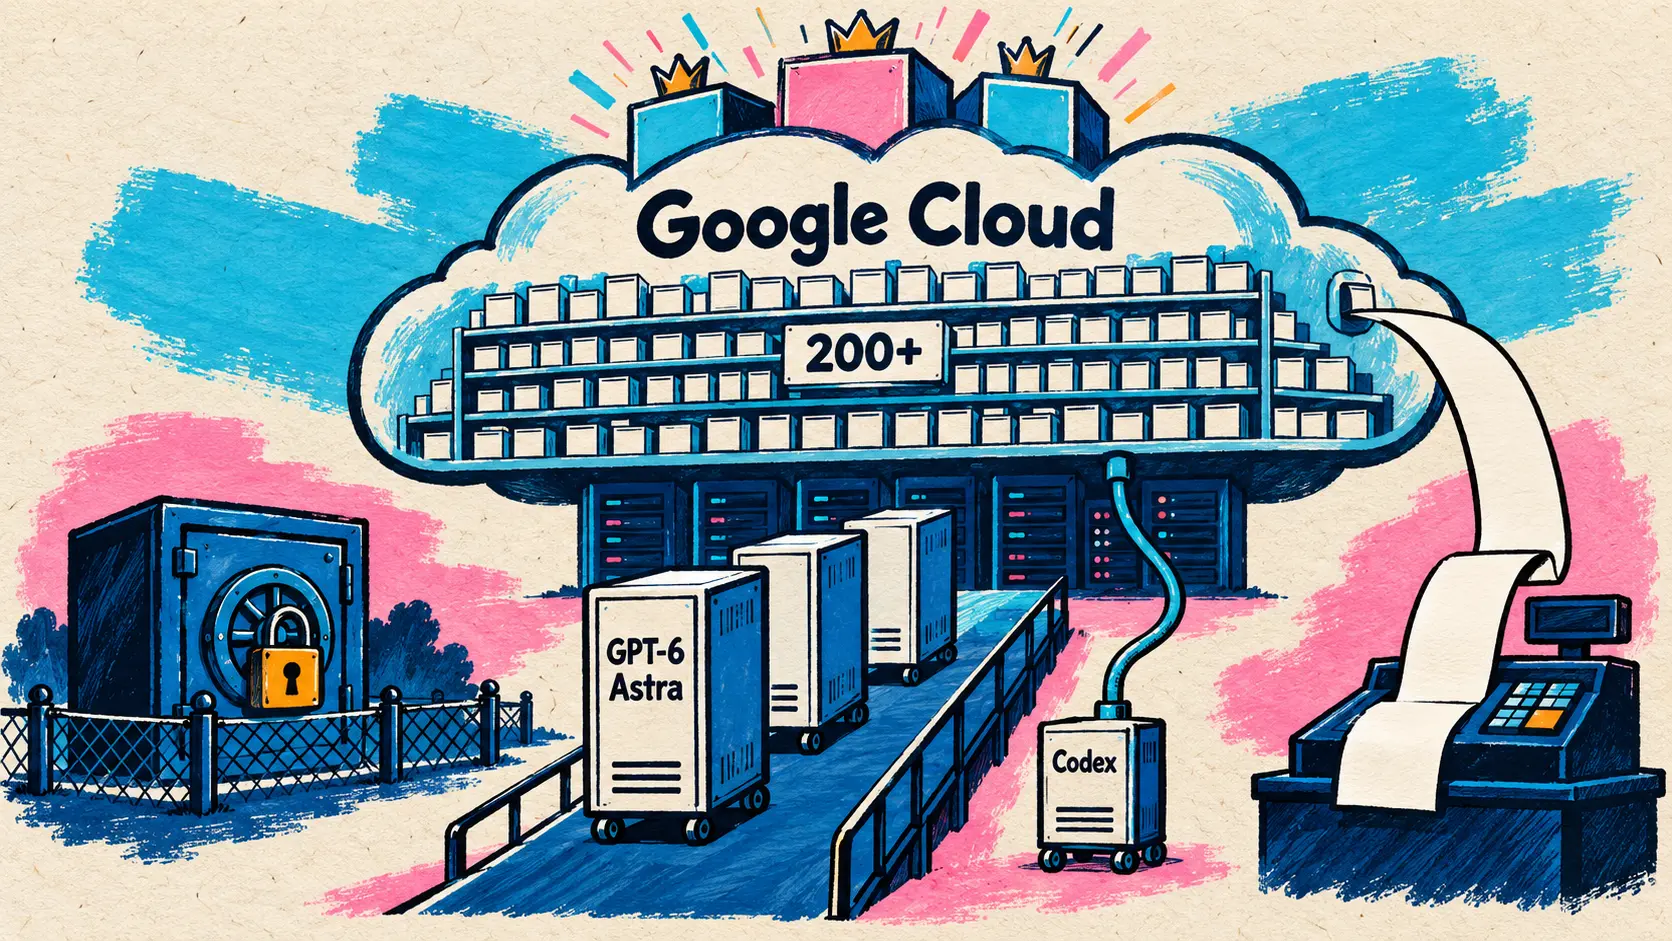
Les modèles d’OpenAI et Codex arrivent sur Google Cloud, en préversion privée dans le Model Garden
21 octobre — OpenAI et Google Cloud annoncent l’arrivée des modèles de frontière d’OpenAI et des flux de travail agentiques de Codex dans le Model Garden, le catalogue de modèles de Google Cloud. Le billet de Google, signé Michael Gerstenhaber, vice-président produit Gemini, nomme les trois modèles concernés : GPT-6 Astra pour le travail le plus exigeant (code, utilisation de l’ordinateur, tâches professionnelles, recherche scientifique), GPT-6.1 Sol, présenté comme une intelligence proche d’Astra pour un coût moindre, et GPT-6 Luna, le modèle rapide et économique du travail courant à grande échelle.
Le calendrier se lit en plusieurs temps, et les deux éditeurs ne le formulent pas de la même façon :
| Élément annoncé | Calendrier indiqué | Source du calendrier |
|---|---|---|
| GPT-6 Astra, GPT-6.1 Sol et GPT-6 Luna dans le Model Garden | Préversion privée pour des clients entreprise sélectionnés, sur formulaire | Google Cloud |
| Appels par les API de Google Cloud, Codex CLI et Codex Desktop branchés sur la plateforme Gemini pour l’inférence | Dès le 21 octobre, pour ces clients | Google Cloud |
| Disponibilité générale | Dans les prochaines semaines | OpenAI |
| Non-conservation des données (Zero Data Retention) et Confidential Compute | Bientôt | Google Cloud |
| Modèles d’OpenAI dans Google Antigravity et dans l’agent Gemini (Gemini for business selon Google) | À venir, sans date | Les deux éditeurs |
Côté achat, les modèles passent par le Model Garden et Google Cloud Marketplace : une seule facture Google Cloud, une consommation imputée sur les engagements de dépense déjà souscrits auprès de Google et comptée dans les Flexible Savings Plans, sans contrat fournisseur séparé. OpenAI avait déjà proposé ce décompte d’engagements avec Oracle Cloud en juin. Google insiste aussi sur la gouvernance : prompts, contexte et réponses restent dans le périmètre de données du client et ne servent jamais à entraîner des modèles de fondation, et les modèles tournent sur une infrastructure Google Cloud dédiée, derrière des passerelles isolées, avec VPC Service Controls et journaux d’audit unifiés. Aucun tarif n’est publié. Google en tire une revendication :
Google Cloud is now the only hyperscale cloud provider offering access to all three leading closed source LLMs, alongside more than 200 first-party, third-party, and open models on a unified enterprise AI platform.
🇫🇷 Google Cloud est désormais le seul fournisseur de cloud à très grande échelle à donner accès aux trois principaux LLM fermés, aux côtés de plus de 200 modèles maison, tiers et ouverts, sur une plateforme d’IA d’entreprise unifiée. — Michael Gerstenhaber, vice-président produit Gemini chez Google Cloud
OpenAI précise de son côté que Microsoft reste son principal partenaire cloud. Après Amazon Bedrock le 1er juin et Oracle Cloud le 10 juin, Google Cloud rejoint les clouds qui distribuent ses modèles, Codex compris. Les SDK officiels publiés le même jour, openai-python 3.36.0 et openai-node 7.41.0, prennent déjà en charge Vertex AI pour la Responses API.
🔗 Le billet d’OpenAI · Le billet de Google Cloud · Le tweet de @OpenAI
Claude Duet : Anthropic ouvre en aperçu un agent proactif, et Grok Bot tient ses tableaux de bord à jour
21 octobre — Anthropic ouvre l’aperçu de recherche (research preview) de Claude Duet, une nouvelle application dans laquelle Claude travaille comme un agent proactif : il signale ce qui demande l’attention de l’utilisateur, exécute les tâches qu’on lui confie, continue de travailler en son absence et demande l’accord avant d’agir en son nom. L’accès se fait sur liste d’attente, d’abord pour les abonnés Pro et Max aux États-Unis. Duet est une application autonome, distincte de l’application Claude principale, sur iOS, Android et claude.ai ; pendant l’aperçu, il est inclus dans les forfaits Pro et Max et puise dans les mêmes limites d’usage.
Conçu autour de Claude Opus 5.5, Duet reprend la mémoire, les skills et les applications connectées du compte Claude. Chaque matin, il envoie un court résumé des points importants ; dans la journée, il consulte les comptes connectés toutes les quelques heures, une surveillance continue épuisant plus vite les limites du forfait. On lui parle par écrit ou à la voix, dans un fil unique, et il travaille dans sa propre machine virtuelle, avec son propre navigateur : ni l’ordinateur ni le téléphone n’ont besoin de rester allumés. Il s’appuie sur plus de 6 000 connecteurs et plugins du Claude Marketplace (Gmail, Slack, QuickBooks, Stripe, Gusto, Docusign, Shopify…) et peut acheter pour l’entreprise avec Link, le portefeuille numérique de Stripe, qui paie par carte virtuelle sans transmettre le vrai numéro.
| Type d’action demandée | Ce que fait Claude Duet |
|---|---|
| Lire, rédiger, préparer un travail | Seul, en arrière-plan |
| Envoyer un message, payer, signer, supprimer | Montre l’action et attend l’approbation |
| Négocier des titres, virer de l’argent entre comptes | Interdit, même avec approbation |
| Numéros de carte bancaire, pièces d’identité | Partage refusé par un nouveau classifieur |
| Santé, finances personnelles | Transmises seulement sur instruction explicite |
La sécurité reprend des briques existantes : les identifiants sont gérés comme dans Claude Managed Agents, les actions passent par le classifieur du mode auto, les défenses contre l’injection de prompt viennent des travaux sur browser use, et Duet entre dans le programme public de primes aux bogues (bug bounty) après des tests d’intrusion menés par des red teams et une société externe.
Claude Duet draws on years of our safety and security work on agents. It never directly sees your passwords, a new classifier guards against sharing sensitive information, and the important decisions stay with you. We’ll share more on our approach to safety in Claude Duet soon.
🇫🇷 Claude Duet s’appuie sur des années de notre travail de sûreté et de sécurité sur les agents. Il ne voit jamais directement vos mots de passe, un nouveau classifieur empêche le partage d’informations sensibles, et les décisions importantes vous reviennent. Nous en dirons bientôt plus sur notre approche de la sécurité dans Claude Duet. — @claudeai sur X
Anthropic reconnaît les limites de cette première version : Duet peut mal lire un fil ou mal juger l’urgence, les démarches personnelles comme la réservation de billets sont moins abouties, et il ne peut pas encore montrer son navigateur. Les vérifications en arrière-plan comptent dans les limites du forfait, et les grosses tâches, comme un modèle financier ou une présentation, en consomment davantage.
Grok Bot construit désormais des rapports et des tableaux de bord qu’il tient à jour
21 octobre — Même idée d’un agent qui travaille entre deux demandes chez SpaceXSI : Grok Bot sait désormais produire des rapports, des mémos et des tableaux de bord. On lui demande une page, puis on la retravaille avec lui ou on lui confie sa mise à jour au fil du temps. La fonction se déploie le jour même pour les utilisateurs des dernières versions des applications mobiles et de bureau.
L’annonce tient en deux tweets et une vidéo de démonstration, sans billet sur x.ai : ni les formules concernées, ni les limites, ni les sources de données qu’un tableau de bord peut suivre ne sont précisées. Elle prolonge une série de nouveautés de Grok Bot en octobre (adresse e-mail le 9, connecteurs et vitesse le 16, bouton Action de l’iPhone le 19) et rappelle Claude Dashboards, les tableaux de bord qu’Anthropic fait tenir à jour par Claude, en bêta depuis début octobre.
PHP2Shell : OpenAI coordonne la réponse à deux failles critiques de PHP, Claude Security passe au scan continu
21 octobre — OpenAI publie le bilan de deux mois de coordination autour de PHP2Shell, deux vulnérabilités critiques du cœur de PHP. Selon le billet, la société de sécurité Calif a identifié l’une d’elles avec GPT-5.6 Sol, dans le cadre de Patch the Planet, l’initiative open source de Daybreak, et Wiz a découvert et signalé les deux de son côté. Les mainteneurs de PHP ont mené les correctifs, avec l’appui d’OpenAI, de Wiz, de Cloudflare et d’autres ; OpenAI estime qu’à sa connaissance, l’IA de frontière a trouvé ces failles avant les attaquants. L’enjeu se mesure à la diffusion du langage : PHP fait tourner environ 70 % des sites web.
Le site de divulgation php2shell.com détaille les deux CVE, d’une sévérité qui atteint CVSS 9,2 : un attaquant non authentifié peut exécuter du code sur le serveur ou lire la mémoire du processus PHP (mots de passe, jetons, clés d’API). Le code vulnérable se trouve dans PHP lui-même, si bien qu’une application sans défaut peut être touchée.
| Identifiant CVE | Classe de vulnérabilité | Démonstration selon php2shell.com |
|---|---|---|
| CVE-2026-109618 | Corruption liée au manque de mémoire (out-of-memory) | Exécution de code sans authentification sur WordPress, Drupal et Joomla |
| CVE-2026-109619 | État global périmé d’une requête à l’autre, use-after-free | Exécution de code sans authentification sur WordPress et Drupal, lecture de mémoire quelle que soit l’application |
Les versions touchées remontent à PHP 5.4. La seule correction complète consiste à passer à PHP 8.2.35, 8.3.36, 8.4.27 ou 8.5.12, puis à redémarrer Apache, PHP-FPM et les workers PHP. Pour aider les exploitants, OpenAI publie une skill Codex, openai/php2shell-checker, qui lit la version de PHP d’un site depuis son URL ou directement sur le serveur ; son dépôt prévient qu’elle ne voit que la version annoncée par les en-têtes HTTP ou par php -v, et qu’un résultat inconnu ne signifie pas que la cible est corrigée.
Given the severity of these flaws and PHP’s widespread use, we consider this one of the most impactful security issues in recent memory.
🇫🇷 Vu la gravité de ces failles et la diffusion de PHP, nous considérons qu’il s’agit de l’un des problèmes de sécurité les plus lourds de conséquences de ces dernières années. — OpenAI, billet du 21 octobre
OpenAI en tire un cadre de réponse en cinq étapes, de la validation du correctif en amont, avec des tests adversariaux menés par des modèles de frontière, jusqu’à la publication des consignes, en passant par un préavis aux organisations concernées et une coordination avec les autorités (pour PHP, la Super Intelligence Force de la Maison Blanche, l’ONCD et la CISA), et soumet quatre questions à la communauté, dont la durée des fenêtres de divulgation. L’entreprise ouvre des abonnements Codex for OSS à tous les mainteneurs, parraine directement des projets comme la Rust Foundation et s’attend à une forte hausse de ce type de découvertes dans les prochains mois. Le même jour, elle a publié un plan pour équiper les cyberdéfenseurs (voir les Brèves).
🔗 Le billet d’OpenAI · Le site php2shell.com · La skill php2shell-checker
Claude Security passe au scan continu et suit les correctifs, en bêta publique pour Claude Enterprise
21 octobre — Chez Anthropic, Claude Security ne dépend plus de scans lancés à la main : il suit désormais les dépôts au fil des changements. Un projet regroupe un ou plusieurs dépôts, connectés par l’application GitHub de Claude (GitHub Enterprise Server compris) ou par jeton d’accès pour GitLab et les autres fournisseurs Git ; Claude lance un scan de référence approfondi, puis analyse les changements selon leur risque et leur complexité. Un constat est marqué corrigé quand le correctif est livré, même en dehors de Claude Security, et se rouvre si le problème revient. Selon Anthropic, des milliers d’organisations ont trouvé plus d’un million de vulnérabilités avec l’outil depuis sa bêta publique d’avril.
Chaque projet reçoit une base de connaissances et un modèle de menace (threat model) que Claude rédige à partir du code et que l’équipe peut modifier ; la sévérité de chaque constat en dépend, avec l’explication du chemin d’attaque, parfois sous forme de diagramme. Une API, des webhooks, un connecteur MCP dans Claude.ai et Claude Code et des contrôles d’accès par rôle complètent l’ensemble. Cette version est en bêta publique pour Claude Enterprise, activable par les administrateurs, sur toute la famille de modèles, Claude Mythos compris, sans passer par le Cyber Verification Program. Les organisations éligibles reçoivent 25 000 dollars de crédits d’usage par mois pendant deux mois, pour un usage jusqu’au 31 décembre 2026.
🔗 L’annonce de Claude Security
Infrastructure de calcul : DSX POD en conteneurs, instances A5X de Google Cloud et Confidential Bare Metal
21 octobre — À GTC Berlin, où Jensen Huang a déclaré pendant sa keynote que Vera Rubin était en pleine production, NVIDIA présente DSX POD, une conception de référence pour des usines IA Vera Rubin complètes, fabriquées par des partenaires dans des conteneurs modulaires. Calcul, réseau, câblage de baie à baie, tuyauterie, alimentation au niveau des baies et refroidissement liquide sont intégrés et validés en usine, puis livrés prêts à être raccordés à un site déjà équipé.
L’argument est le délai : sur un site dont l’alimentation, le refroidissement et le réseau sont prêts, NVIDIA annonce un déploiement ramené de six mois à 14 jours au plus court. Pour Jensen Huang, une usine IA crée de la valeur quand elle commence à produire des tokens, pas quand le chantier se termine. Dix-sept partenaires (Dell, HPE, Lenovo, Foxconn, Schneider Electric, Vertiv, Bull, Crusoe, Anduril…) doivent livrer ces usines dans le monde début 2027 ; aucun prix n’est donné.
| Élément annoncé par NVIDIA | Chiffre annoncé |
|---|---|
| Mise en service d’un DSX POD | De six mois à 14 jours au plus court |
| Partenaires constructeurs | 17 |
| Premières livraisons | Début 2027 |
| Eau de refroidissement économisée (site de 2 GW) | Jusqu’à 54 millions de litres par jour |
| Énergie avec le logiciel DSX MaxLPS | Jusqu’à 30 % de moins pour le même nombre de tokens |
Un communiqué compagnon chiffre l’efficacité de la plateforme DSX : un refroidissement liquide en circuit fermé avec aéroréfrigérants, pour une consommation d’eau de refroidissement quasi nulle, économise jusqu’à 54 millions de litres par jour sur un site de 2 gigawatts, soit la consommation quotidienne de 180 000 foyers ; le logiciel DSX MaxLPS produirait le même nombre de tokens avec jusqu’à 30 % d’énergie en moins, et CoreWeave, Google Cloud, Lambda ou Nebius prévoient de l’utiliser. La veille, NVIDIA avait aussi détaillé l’adoption de ses CPU Vera en Europe, par Nebius, Nscale et Verda.
🔗 Le communiqué DSX POD · L’écosystème DSX en Europe
Google Cloud annonce ses instances A5X sur Vera Rubin NVL72, disponibles le mois prochain
21 octobre — Google Cloud et NVIDIA présentent les instances A5X, qui associent des systèmes Vera Rubin NVL72, des cartes réseau ConnectX-9, le réseau Virgo de Google Cloud et son refroidissement liquide de quatrième génération, pour l’inférence agentique et l’apprentissage par renforcement à grande échelle. Malgré un titre qui parle de disponibilité générale, le billet de NVIDIA précise qu’elle arrive le mois prochain, avec une extension prévue en Europe. Google Cloud prévoit à terme jusqu’à 960 000 GPU Rubin sur plusieurs sites.
Le premier client est Ineffable Intelligence, la société londonienne de David Silver, le créateur d’AlphaGo, qui veut entraîner des systèmes capables d’apprendre en continu de leur propre expérience. WPP affirme, d’après ses premiers tests, avoir fait tenir sur une seule instance A5X des charges d’agents créatifs qui demandaient jusque-là une grappe de plusieurs nœuds.
🔗 Le billet de NVIDIA sur les instances A5X
Confidential Bare Metal : NVIDIA protège les modèles des laboratoires sur des machines qu’ils ne possèdent pas
21 octobre — NVIDIA élargit son calcul confidentiel avec Confidential Bare Metal, une option pensée pour les laboratoires qui entraînent ou servent des modèles de pointe sur une infrastructure tierce dédiée, chez un cloud, un neocloud ou une entreprise. Ils y installent leur propre pile logicielle, logiciels d’hôte et de plateforme compris, tout en gardant le contrôle de leurs modèles et de leurs données, grâce à de nouveaux contrôles : protection des données en transit, mesure de l’intégrité de la plateforme et restrictions d’accès appliquées par le matériel.
L’offre compte désormais trois modes (bare metal, conteneurs Kubernetes, machines virtuelles), s’étend aux systèmes Grace Blackwell et Rubin et sera intégrée à DSX OS, l’architecture de référence des clouds qui bâtissent des usines IA. Cohere prévoit de l’utiliser dans Cohere Model Vault, et Google Cloud l’étend à ses instances A4X Max, à base de GB300 NVL72, tout en passant le Confidential Computing en disponibilité générale sur ses VM G4. En septembre, NVIDIA avait montré une inférence confidentielle sur B200 qui conservait de 96,1 à 98,2 % du débit.
🔗 Le billet de NVIDIA sur Confidential Bare Metal
Agents d’entreprise chez NVIDIA : l’OpenShell Reference Architecture, Agent Toolkit et les modèles Kumo
21 octobre — À GTC Berlin, NVIDIA a présenté l’OpenShell Reference Architecture, une architecture de référence pour construire, confiner, observer et encadrer des agents en entreprise, disponible dès maintenant. Elle prolonge OpenShell, le runtime open source qui place un agent dans un bac à sable contrôlé par des politiques au niveau du noyau, en une pile matérielle et logicielle complète. Jensen Huang en résume le découpage : les agents pensent sur Rubin, agissent sur Vera et sont gouvernés sur BlueField. Pour lui, capacités et sécurité de l’IA doivent progresser ensemble, au moment où les entreprises s’apprêtent à déployer des milliards d’agents.
| Composant de la pile | Rôle annoncé | Chiffre avancé par NVIDIA |
|---|---|---|
| Vera Rubin NVL72 | Inférence des modèles, fermés ou ouverts bâtis avec Nemotron | 30 fois plus de débit par mégawatt sur les charges agentiques |
| CPU Vera | Harnais d’agents et appels d’outils | 2 fois les performances des processeurs x86 |
| DPU BlueField-4 avec NVIDIA Sentry | Surveillance hors bande, politiques appliquées dans le silicium | Arrêt d’un agent en quelques millisecondes, jusqu’à 20 % de capacité en agents en plus |
Si un agent tente de sortir de son périmètre, Sentry le met en quarantaine et l’arrête en quelques millisecondes, selon NVIDIA. L’architecture descend jusqu’aux postes RTX Spark, DGX Spark et DGX Station, et fonctionne sous Linux et Kubernetes (Canonical, SUSE, Red Hat) comme sous Windows, avec Microsoft Execution Containers, sur AWS, Google Cloud et Azure.
Les agents des modèles d’Anthropic, Cohere, Google, Meta, OpenAI, Perplexity, Reflection et SpaceX Super Intelligence peuvent y être exécutés. Onze éditeurs de sécurité, dont CrowdStrike, Palo Alto Networks, Zscaler, Okta et 1Password, l’intègrent, BBVA et Santander l’explorent, et Cadence, Dassault Systèmes, IBM, SAP, Siemens et Synopsys bâtissent dessus. SAP la branche sur le runtime de Joule Studio, et ServiceNow en profite pour passer en disponibilité générale ServiceNow Arc, un agent personnel de longue durée dont les actions sont appliquées par OpenShell ; son AI Passport transmet ses politiques à OpenShell et à Sentry pour révoquer l’accès d’un agent en quelques secondes.
🔗 Le communiqué de NVIDIA · Le tweet de @NVIDIAAI
Agent Toolkit : Agent Knowledge Foundation et la famille de modèles ouverts Kumo
21 octobre — Dans la même pile, NVIDIA élargit son Agent Toolkit open source avec une brique dédiée aux données d’entreprise, Agent Knowledge Foundation. Elle réunit les bibliothèques CUDA-X (cuDF, cuGraph, cuML, cuOpt, cuVS), une nouvelle bibliothèque Auto-Ontology qui traduit les données brutes en concepts métier (clients, produits, commandes) et en relations, sans déplacer les données ni changer les contrôles de gouvernance, les modèles de recherche Nemotron Retriever et la famille de modèles ouverts Kumo, qui prédit à partir de données tabulaires, relationnelles ou temporelles (Kumo Tabular, Relational, Time Series et Forecast). Le kit comprend aussi le runtime OpenShell et les blueprints NemoClaw, dont un nouveau consacré à l’optimisation des agents.
NVIDIA cite des premiers résultats chez ses partenaires : le reranker affiné de SAP tourne près de 3 fois plus vite, ServiceNow réduit sa latence de reranking de près d’un quart, et Amazon OpenSearch Service gagne en pertinence avec pratiquement aucune latence ajoutée. Databricks associe Kumo Anomaly à Genie Ontology, Snowflake ouvre Kumo Engine et Kumo Relational dans ses notebooks, et NVIDIA s’en sert pour sa propre chaîne d’approvisionnement, avec Palantir. La famille Kumo avait été inaugurée fin septembre avec Kumo Tabular.
🔗 Le billet de NVIDIA sur Agent Toolkit
Flint : Recursive publie un MoE ouvert de 40 milliards de paramètres pour coder en local, Base Labs ses modèles de décision
21 octobre — Recursive, la société de Richard Socher, publie Flint, son premier modèle : un mélange d’experts (mixture-of-experts) conçu pour le code agentique sur du matériel local. Il compte 39,8 milliards de paramètres au total mais n’en active qu’environ 2,5 milliards par token, ce qui lui permet de tourner sur un ordinateur portable. Les poids sont publiés sous licence Apache 2.0 sur Hugging Face, en BF16 et en versions quantifiées INT4 et NVFP4 (GGUF), et le modèle s’utilise avec Ollama, LM Studio, Unsloth ou exo, ou gratuitement dans OpenCode et Pi.
| Banc ou caractéristique | Valeur selon la fiche de Flint |
|---|---|
| Terminal-Bench 2.1 | 54,9 % |
| SWE-bench Pro v2 | 89,7 % |
| SWE-bench Verified | 74,2 % |
| Paramètres totaux et actifs | 39,8 milliards, dont environ 2,5 milliards actifs par token |
| Experts par couche MoE | 256 routés, dont 6 actifs, plus 1 partagé |
| Contexte documenté | 262 144 tokens |
Les scores sont des pass@1 moyens sur au moins cinq essais, mesurés par Recursive ; sur Terminal-Bench, les solutions trouvées par recherche web comptent comme des échecs, et les scores des concurrents sont en partie ceux annoncés par leurs développeurs, avec des protocoles différents. Selon Recursive, aucun autre MoE de moins de 50 milliards de paramètres ne fait mieux sur ces trois bancs, et Flint rivalise avec des modèles denses de 25 à 40 milliards de paramètres en allant plus de cinq fois plus vite. L’entreprise annonce plus de 125 tokens par seconde sur un MacBook Pro M4 Pro et plus de 150 sur une NVIDIA RTX Spark de 64 Go. Le billet évoque jusqu’à 512k tokens de contexte, en recommandant de rester sous 256k, et conseille de découper les tâches complexes : Flint peut demander plus de guidage que les grands modèles fermés.
Flint sert aussi de démonstration à l’Eureka Machine, le système de recherche automatisée de Recursive, qui enchaîne propositions d’idées, implémentation, tests et choix de la piste suivante. Selon l’entreprise, ce système a contribué aux données, aux optimiseurs, aux recettes d’entraînement, à l’infrastructure et à l’inférence, et a permis à une petite équipe de bâtir le modèle de zéro en moins de quatre mois.
🔗 Le billet de Recursive · RecursiveSI/flint sur Hugging Face
Base Labs, le laboratoire de Baseten, publie les modèles de décision mammoth-1 et elephant-1
21 octobre — Baseten publie deux modèles de décision entraînés par son laboratoire de recherche, Base Labs : mammoth-1, de 27 milliards de paramètres, et elephant-1, de 9 milliards. Un modèle de décision ne rédige pas de réponse : il renvoie une probabilité pour chaque réponse possible à une question de choix, de note ou de oui ou non, ce qui permet de fixer des seuils de confiance au-delà desquels on passe la main à un humain. Selon Baseten, il peut répondre jusqu’à 10 fois plus vite qu’un modèle de raisonnement. Les deux modèles sont des versions post-entraînées de Qwen3.5-27B et de Qwen3.5-9B, sur 6,21 millions d’exemples, dont des cas où il faut savoir répondre « je ne sais pas ».
| Modèle de décision | Modèle de base | Jev Decision Index 0.4 | Artificial Analysis Decision Index |
|---|---|---|---|
| mammoth-1 | Qwen3.5-27B | 71,24, premier sur 208 | 65,9 |
| elephant-1 | Qwen3.5-9B | Meilleur modèle de 9B, 8e ex aequo | 65,2 |
Les deux modèles sont gratuits pendant une semaine sur les Model APIs de Baseten, sans conservation des données par défaut. Baseten les présente comme open source : leurs fiches sur Hugging Face indiquent une licence MIT.
Recherche documentaire pour agents : Cohere lance Rerank 5, NVIDIA publie Nemotron 3.5 Embed, Rerank et Parse
21 octobre — Cohere lance Rerank 5, la nouvelle génération de ses modèles de reclassement (reranking) pour la recherche d’entreprise, en deux versions : Rerank 5 Pro (rerank-v5.0-pro) vise la meilleure qualité, notamment sur les requêtes qui demandent du raisonnement et sur les documents longs ou spécialisés, et Rerank 5 Fast (rerank-v5.0-fast) la latence et le volume, par exemple pour des agents qui lancent beaucoup de recherches par tâche. Les deux sont disponibles dès le 21 octobre sur l’API Cohere, à 0,05 dollar par million de tokens pour Pro et 0,02 dollar pour Fast, ainsi que dans Model Vault, Microsoft Foundry, Amazon SageMaker et North. Ils acceptent plus de 100 langues, 32k tokens de contexte et des données semi-structurées, et la migration se limite au paramètre model, sans réindexation.
La principale nouveauté s’appelle Context Focus. Désactivée par défaut, cette option renvoie dans le même appel les passages les plus pertinents de chaque document, sous forme d’intervalles de caractères notés, pour n’envoyer au LLM que ces extraits. Cohere l’a testée avec un agent de recherche (glm-5-3-flash, 17 jeux de 50 questions) :
| Pile de recherche testée par Cohere | Bonnes réponses | Tokens consommés |
|---|---|---|
| BM25 seul | 46 % | Référence |
| BM25 et Rerank 5 Pro | 49 % | Non chiffré |
| Avec Context Focus, seuil par défaut de 0,1 | 57 % | 19 % de moins que sans Context Focus |
| Avec Context Focus, seuil de 0,4 | 58 % | 34 % de moins que sans Context Focus, 35 % de moins que BM25 seul |
| Six bancs de recherche approfondie, seuil de 0,4 | 52 %, contre 39 % avec BM25 seul | 41 % de moins que BM25 seul |
C’est ce dernier chiffre, mesuré face à BM25 seul, que le fil de Cohere résume en « jusqu’à 41 % » de tokens en moins. Deuxième changement : les scores sont calibrés. Un score de pertinence de 0,7 se lit désormais comme 70 % de chances que le document soit utile, et le seuil « plus probablement utile que non » se situe à 0,50 pour Pro et 0,45 pour Fast, ce qui permet de filtrer par seuil ou de repérer qu’aucun résultat pertinent n’est revenu. Face à deux jeux de jugements humains indépendants, l’erreur de calibration attendue (ECE) est d’environ 0,06 pour les deux modèles, contre 0,23 à 0,38 pour Rerank 4 Pro et les deux modèles Voyage AI testés.
Sur les bancs publics, évalués avec RCP-nDCG@10, la méthode de mesure maison de Cohere, Rerank 5 Pro arrive premier sur 39 des 46 jeux composites et obtient 82,2 sur BRIGHT, qui teste la recherche demandant du raisonnement : 5,8 points de plus que Voyage AI Rerank 3 et 12,4 de plus que Rerank 4 Pro. Fast traite environ 187 documents de 1 000 tokens par seconde sur un GPU A100, 2,9 fois le débit de Pro. Rerank 5 arrive trois semaines après Embed 5 et une semaine après la courte vidéo où Cohere l’opposait déjà à Rerank 4.
🔗 Le billet de Cohere · Les notes de version de Cohere
Nemotron 3.5 Embed, Rerank et Parse : la recherche documentaire multimodale de NVIDIA pour les agents
21 octobre — Le même jour, NVIDIA élargit sa collection Nemotron Retriever (anciennement Nemotron RAG) avec des modèles d’embeddings, de reclassement et d’extraction de documents, présentés comme ouverts et utilisables commercialement, et publiés sur Hugging Face sous licence OpenMDW 1.1. Nemotron 3.5 Embed existe en 8B, en 1B distillé du 8B et en 1B NVFP4, et cherche dans le texte comme dans les images de documents (tableaux, graphiques, schémas) ; Nemotron 3.5 Rerank 8B note les paires requête-document en texte et en image, et Nemotron 3.5 Parse, de 631 millions de paramètres, convertit des pages en texte structuré.
Sur ViDoRe v3.1, Embed 8B atteint 61,17 de nDCG@10, premier des modèles denses au 20 octobre, et Rerank 8B obtient 60,49 contre 59,17 pour Qwen-3-VL-Reranker-8B. Parse est premier de ParseBench parmi les modèles de moins d’un milliard de paramètres, avec 75,20 à 10,5 pages par seconde sur un H100. Comme Cohere, NVIDIA met en avant le coût des agents, mais avec d’autres bancs et d’autres références :
| Point de comparaison | Cohere Rerank 5 | NVIDIA Nemotron 3.5 Rerank |
|---|---|---|
| Distribution | API payante, Model Vault, Foundry, SageMaker | Poids sur Hugging Face, licence OpenMDW 1.1 |
| Économie de tokens annoncée | Jusqu’à 41 %, face à BM25 seul sur six bancs | Environ 14 % par requête d’agent, avec Embed 8B |
| Score mis en avant | 82,2 sur BRIGHT (RCP-nDCG@10) | 60,49 sur ViDoRe v3.1 (nDCG@10) |
Les deux chiffres d’économie ne se comparent pas directement : Cohere mesure sa pile complète avec Context Focus face à une recherche par mots-clés seule, NVIDIA l’ajout de Rerank derrière ses propres embeddings, sur ViDoRe v3, BRIGHT et BrowseComp-Plus. Côté déploiement, la version NVFP4 d’Embed 1B traite 27,1 % de documents en plus par seconde sur GB200 en gardant 99,85 % de son exactitude.
🔗 Le billet de NVIDIA sur Nemotron Retriever
ChatGPT Ads : 26 pays de plus, 89 au total, et une régie pilotée par un LLM orchestrateur
21 octobre — OpenAI étend ChatGPT Ads à 26 pays supplémentaires, ce qui porte sa régie publicitaire à 89 pays. Après le Mexique et le Brésil, 14 autres pays d’Amérique latine sont concernés, dont l’Argentine, le Chili, la Colombie et le Pérou, ainsi que de nouveaux marchés en Europe, au Moyen-Orient, en Afrique et en Asie, comme le Nigeria, l’Afrique du Sud, la Serbie, l’Ukraine, le Cambodge, le Bangladesh et le Pakistan. Plus de 100 000 annonceurs ont lancé des campagnes depuis l’ouverture des publicités, il y a un peu plus de huit mois, et plus de 1,2 milliard de personnes utilisent ChatGPT chaque semaine. Les publicités restent réservées aux offres Free et Go ; Plus, Pro et Enterprise en restent exemptes. Fin août, la régie revendiquait un milliard de dollars de revenu annualisé et plus de 40 pays.
Le même jour, deux ingénieurs d’OpenAI, Ritendra Datta et Karthik Gopalratnam, décrivent la pile technique de cette régie. Dans une conversation, l’intention commerciale se construit sur plusieurs tours, ce que les systèmes classiques, pensés pour une requête ou une page vue, gèrent mal. OpenAI a donc retenu des sessions publicitaires avec état, qui se souviennent d’un tour et d’une conversation à l’autre, un LLM de frontière post-entraîné, l’« orchestrateur », qui pilote tout le flux par appels d’outils, et un service de sélection séparé de la génération des réponses, avec ses propres modèles et son propre code.
| Étape de la chaîne publicitaire | Ce qui s’y passe |
|---|---|
| Intention | L’orchestrateur résume la conversation en une ou plusieurs requêtes |
| Recherche | Embeddings sémantiques et recherche approximative des plus proches voisins sur plusieurs index |
| Filtrage | Budget, rythme de dépense, ciblage, règles, déduplication par annonceur |
| Notation | Pertinence, engagement prédit, performances passées |
| Enchère | Choix de l’annonce et de son prix, hors de l’orchestrateur |
ChatGPT ne dépend pas de ce système : s’il est lent ou en panne, la réponse s’affiche normalement, une publicité arrivée trop tard n’est pas montrée, et ne renvoyer aucune publicité est une issue normale. L’annonce retenue apparaît sous la réponse, signalée comme sponsorisée, avec un court préambule neutre généré par un modèle. Les modèles les plus puissants d’OpenAI évaluent l’ensemble et entraînent des modèles plus petits pour l’orchestration ou la recherche, et Codex a servi de multiplicateur de force pour bâtir la pile, alors qu’OpenAI n’avait encore aucun système publicitaire il y a un an.
🔗 L’extension à 26 pays · La pile publicitaire de ChatGPT
IA pour la biologie et la médecine : GPT-Rosalind lit un atlas CRISPR, RFD4-Proteina et Cosmos3-H-Dreams
Trois annonces appliquent l’IA au vivant : des agents d’OpenAI qui analysent un atlas génétique, un modèle de conception de protéines ouvert dans le navigateur, et un simulateur de chirurgie qui génère l’image en temps réel.
Des milliers d’agents GPT-Rosalind analysent en 32 minutes un atlas CRISPR du cerveau de souris
21 octobre — OpenAI, PerturbAI et Scripps Research ont confié à des milliers d’agents propulsés par GPT-Rosalind l’analyse d’un atlas CRISPR du cerveau entier de la souris, qui mesure l’effet de perturbations génétiques sur des millions de cellules. Chaque agent étudie une perturbation, examine les réponses cellulaires, cherche dans la littérature et propose une explication ; l’ensemble forme un atlas de raisonnement (reasoning atlas) publié sur GitHub, avec une prépublication sur bioRxiv.
| Mesure rapportée par l’équipe | Valeur publiée |
|---|---|
| Durée de l’analyse par les agents | 32 minutes |
| Analyse humaine comparable (estimation) | Des mois à un an |
| Références citées au plus gros volume de travail | Plus de 700, contre 11 pour un agent unique |
| Préférence des experts à l’aveugle | 75 % pour les rapports des agents distribués |
Deux pistes ressortent. Dans le cervelet, perturber Tsc2 modifie l’activité de dizaines de gènes liés à la communication neuronale, alors que perturber Tsc1 ne change presque rien, un résultat à rapprocher de la sclérose tubéreuse. Et la perturbation de Dctn1, gène du syndrome de Perry, augmente l’expression de gènes de fabrication du cholestérol, d’où une hypothèse jugée nouvelle par les experts, à tester en laboratoire : rétablir la distribution du cholestérol dans les neurones pourrait-il les protéger de la dégénérescence ?
🔗 Le billet de recherche d’OpenAI · La prépublication sur bioRxiv
RFD4-Proteina : le modèle de conception de protéines de NVIDIA et du Baker Lab, gratuit sur GPU dédiés jusqu’au 4 novembre
21 octobre — NVIDIA met RFD4-Proteina à portée de navigateur. Ce modèle ouvert de conception de protéines, développé avec le Baker Lab de l’Institute for Protein Design de l’Université de Washington, génère ensemble la séquence et la structure tout-atome d’une protéine autour d’une contrainte : la cible qu’un liant doit accrocher, ou le motif catalytique qu’une enzyme doit contenir. Il gère des contextes moléculaires variés, des petites molécules aux acides nucléiques en passant par les glycanes et les ions métalliques.
Les poids sont sur Hugging Face depuis le 6 octobre, sous licence BSD-3-Clause ; la nouveauté est l’accès par deux Spaces, l’un sur GPU RTX PRO 6000 dédiés, gratuit du 21 octobre au 4 novembre aux frais de NVIDIA, l’autre sur ZeroGPU, qui reste gratuit ensuite. Le modèle propose un réglage de réflexion (thinking setting), comme les LLM : sur un banc de 24 cibles, en réflexion haute, il produit 76,40 designs distincts par heure-GPU qui passent les critères de validation in silico, contre 13,24 pour Proteina-Complexa, la deuxième méthode. Dans son billet sur les modèles ouverts présentés à GTC Berlin, NVIDIA le dit aussi en tête sur plus de dix tâches de conception et environ 13 fois plus rapide que RFdiffusion3 sur des protéines de 200 acides aminés. NVIDIA suggère de s’en servir pour la compétition de design de protéines parrainée par Anthropic et Adaptyv.
🔗 Le billet RFD4-Proteina sur Hugging Face · Les poids de RFD4-Proteina
Cosmos3-H-Dreams : un simulateur de chirurgie génératif qui répond en temps réel aux gestes de l’utilisateur
20 octobre — NVIDIA présente Cosmos3-H-Dreams, un simulateur génératif qui reproduit en temps réel une scène de chirurgie abdominale : l’utilisateur déplace une pince, saisit la vésicule biliaire et la soulève, et le modèle génère l’image correspondante. Plutôt que de modéliser la géométrie et la déformation des tissus, ce modèle de monde (world foundation model) apprend la dynamique visuelle à partir des vidéos et de la cinématique de vraies cholécystectomies réalisées avec le robot Versius de CMR Surgical. Selon NVIDIA, c’est le premier simulateur chirurgical génératif temps réel entraîné sur des interventions cliniques à accepter un contrôle cinématique en direct.
Le modèle part de Cosmos3-H-Embodied-Nano, de 16 milliards de paramètres, spécialisé avec 28 dimensions d’action (pose et pince des deux bras, commandes d’énergie, axes et boutons des manettes), puis distillé en versions à quatre et deux étapes qui tournent de façon interactive sur une seule RTX PRO 6000, grâce à la bibliothèque FlashDreams. Les deux points de contrôle sont sur Hugging Face, sous la NVIDIA Open Model License, avec le code et une recette pour adapter le modèle à ses propres données.
🔗 Le billet Cosmos3-H-Dreams sur Hugging Face
Robotique et IA physique : l’humanoïde Agile ONE SN, Isaac Lab 3.0, Alpamayo 2 Edge et Cosmos Data Factory
NVIDIA a consacré une large part de sa keynote à l’IA physique : un humanoïde de référence pour les laboratoires, une plateforme d’apprentissage des robots en disponibilité générale, et de nouveaux modèles et outils pour la conduite autonome et les données d’entraînement. Des Microducks de Pollen Robotics et Hugging Face sont même montés sur scène (voir les Brèves).
Isaac : l’humanoïde de référence Agile ONE SN, Isaac Lab 3.0 et Isaac OS
21 octobre — NVIDIA élargit sa plateforme de robotique Isaac avec un humanoïde de référence destiné à la recherche. Construit par Agile Robots, Agile ONE SN arrive préconfiguré avec les modèles Isaac GR00T, et le système de sûreté Halos doit y être intégré. Il doit être disponible début 2027, avec pour objectif de faire passer la mise en place d’un laboratoire de quelques semaines à quelques jours ; Stanford et l’ETH Zurich s’y intéressent.
| Caractéristique d’Agile ONE SN | Valeur annoncée |
|---|---|
| Taille et poids | 1,40 m, 40 kg |
| Degrés de liberté | 31, plus 20 pour chacune des deux mains |
| Charge utile | 3 kg par bras |
| Calcul embarqué | Jetson Thor, 2 070 téraflops FP4, 128 Go de mémoire unifiée |
| Disponibilité | Début 2027 |
Le reste de la plateforme avance aussi : Isaac Lab 3.0, le cadre open source d’apprentissage des robots, passe en disponibilité générale avec les moteurs physiques Newton et PhysX, et un nouveau runtime open source, Isaac OS, bâti sur Holoscan, relie modèles, capteurs et commandes. Trois flux de travail de référence pour DGX Station montrent comment affiner GR00T 1.7 par apprentissage par renforcement, entraîner la manipulation dextre ou post-entraîner des modèles Cosmos pour produire des données synthétiques. NVIDIA publie enfin sur Hugging Face une bibliothèque de plus de 2 000 objets prêts pour la simulation et Human 1M, un jeu de vidéos synchronisées sous trois angles avec suivi 3D des mains, dont la version complète est réservée aux partenaires de la Cosmos Coalition. Pour Jensen Huang, le moment ChatGPT de la robotique approche vite.
🔗 Le communiqué Isaac de NVIDIA
Alpamayo 2 Edge et Cosmos Data Factory : la conduite autonome à bord et les données des robots
21 octobre — Dans le billet qui présente ses modèles ouverts de GTC Berlin, NVIDIA ajoute Alpamayo 2 Edge, un modèle de raisonnement compact qui tourne à bord du véhicule, sur DRIVE AGX Thor, pour comprendre la scène et planifier la trajectoire en temps réel ; il repose sur NVIDIA Cosmos. Côté données, Cosmos Data Factory rassemble des blueprints et des skills d’agents pour sélectionner, annoter, générer et évaluer des jeux d’entraînement, avec de nouveaux outils pour améliorer les modèles de monde avec moins de calcul. Porsche l’utilise avec Voxel51, ANYbotics avec Encord, Zalando et CEVA Logistics avec Sereact, ainsi que Siemens. Le même billet présente RFD4-Proteina et annonce l’arrivée d’Ising, la famille de modèles de NVIDIA pour le calcul quantique, dans AWS Parallel Computing Service.
🔗 Le billet de NVIDIA sur ses modèles ouverts
Industrie et télécoms : Mistral et NVIDIA pour l’ingénierie, T-Mobile passe le premier appel AI-RAN
Deux annonces portent l’IA hors du centre de données : dans les bureaux d’études de l’industrie, et dans les antennes des réseaux mobiles.
Mistral et NVIDIA s’associent pour l’IA en ingénierie industrielle, avec des benchmarks ouverts
21 octobre — Mistral annonce une collaboration avec NVIDIA pour appliquer l’IA à l’ingénierie industrielle. Les deux entreprises veulent bâtir des flux de travail d’ingénierie nativement IA (AI-native engineering workflows) : Mistral Large 4 et les pipelines de génération de données et de modélisation physique de Mistral, accélérés par les bibliothèques CUDA-X et Warp de NVIDIA, doivent raccourcir les simulations et relier en boucle fermée simulation, développement des modèles et conception. Les modèles de Mistral seront aussi intégrés aux bibliothèques Omniverse, pour générer des scènes 3D sur GPU et des objets 3D SimReady.
Le cœur du projet porte sur l’évaluation : des benchmarks publics et des jeux de données ouverts pour comparer la précision des modèles de physique et valider des chaînes automatisées de la CAO à la simulation, et des évaluations de l’IA agentique en ingénierie assistée par ordinateur (CAE) et en conception électronique (EDA), pour l’aéronautique, l’automobile et les semi-conducteurs. Elles mesureront si un agent sait utiliser les outils d’ingénierie, enchaîner des tâches en plusieurs étapes et rendre un résultat techniquement juste, avec le temps d’exécution et le coût de calcul. Aucun nom de benchmark, aucun jeu de données, aucune date ni aucun montant ne sont donnés. Le billet rappelle que les poids de Mistral Large 4 (environ 1 000 milliards de paramètres, dont 49 milliards actifs), entraîné sur 3 800 GPU Grace Blackwell en Europe, restent prévus pour fin octobre. Pour Neil Ashton, vice-président de l’ingénierie computationnelle chez Mistral, le rythme de l’ingénierie est depuis trop longtemps dicté par celui de la simulation.
🔗 Le billet de Mistral · Le tweet de @MistralAI
T-Mobile passe le premier appel AI-RAN sur un réseau commercial, avec NVIDIA et Nokia
21 octobre — NVIDIA annonce que T-Mobile a passé, à Bellevue (Washington), le premier appel AI-RAN sur un réseau commercial, avec Nokia. L’AI-RAN fait tourner le traitement du réseau radio sur des GPU, qui peuvent aussi servir des modèles d’IA au plus près des utilisateurs. Jensen Huang a résumé l’étape d’une formule : CUDA passe désormais des coups de fil, après près de huit ans de travail selon lui.
En Europe, Elisa revendique le premier essai terrain AI-RAN du continent, qui fait passer voix, données mobiles et IA de vision sur une même plateforme accélérée, BT prépare des essais au Royaume-Uni, et Nokia installe son logiciel anyRAN, accéléré par CUDA, sur l’Aerial RAN Computer de NVIDIA pour des tests chez BT, Deutsche Telekom, Elisa et Orange. Neuf opérateurs de la zone EMEA construisent ou étendent une infrastructure NVIDIA, et Nokia comme Cisco intègrent les modèles Nemotron à leurs logiciels de réseaux autonomes.
🔗 Le communiqué de NVIDIA sur l’AI-RAN
Voix et vidéo génératives : Eleven Realtime Translation, HeyGen Voice Turbo et l’API de Kling 4.0
Trois éditeurs de médias génératifs avancent côté développeurs : une traduction vocale en direct, un modèle de voix moins cher et une API vidéo attendue depuis une semaine.
Eleven Realtime Translation : ElevenLabs ouvre en alpha la traduction vocale en direct pendant les appels
21 octobre — Au lendemain d’Eleven Realtime, ses modèles de parole à parole pour agents vocaux, ElevenLabs ouvre une alpha limitée d’Eleven Realtime Translation, un modèle de traduction vocale en direct. Pendant un appel, chaque personne parle sa propre langue et entend son interlocuteur dans la sienne, avec une voix naturelle. ElevenLabs résume la différence : Eleven Realtime sert aux agents qui parlent aux gens, Realtime Translation aux personnes qui ont besoin de se parler entre elles.
Le modèle couvre plus de 90 langues et détecte automatiquement celle de chaque interlocuteur. La voix de sortie se choisit parmi plus de 17 500 voix de la bibliothèque, ou peut être un clone de la sienne, et un réglage d’empressement (eagerness control) arbitre entre la latence et la qualité de traduction. L’accès est réservé aux entreprises pendant l’alpha, via ElevenAPI, sans tarif ni billet de blog.
🔗 L’annonce de @ElevenLabsDevs
HeyGen Voice Turbo : premier de la vue Controlled Voice d’Artificial Analysis, devant HeyGen Voice
21 octobre — Douze jours après HeyGen Voice, son premier modèle vocal maison, HeyGen en lance une variante Turbo, plus rapide et moins chère, disponible sur son API ; le point d’accès Turbo de l’API est gratuit jusqu’au 30 novembre. HeyGen dit occuper les deux premières places du classement de synthèse vocale d’Artificial Analysis. Il s’agit de la vue Controlled Voice, qui compare les modèles avec les mêmes voix clonées, où Qwen-Audio-3.1-TTS-Plus complète le podium et où les marges d’incertitude laissent les trois premiers au coude-à-coude.
| Modèle de synthèse vocale | Elo en vue Controlled Voice | Prix affiché par Artificial Analysis |
|---|---|---|
| HeyGen Voice Turbo | 1 202 (±19) | 4 dollars par million de caractères |
| HeyGen Voice | 1 195 (±15) | 30 dollars par million de caractères |
Comme le 9 octobre, HeyGen n’apparaît pas en tête de la vue Provider Voice, qui compare les voix fournies par chaque éditeur.
🔗 L’annonce de HeyGen · La vue Controlled Voice d’Artificial Analysis
Kling ouvre l’API de Kling 4.0, aussi proposé sur fal, Higgsfield et Runway
21 octobre — Six jours après la disponibilité complète de Kling 4.0 sur son site, Kling déploie officiellement l’API de son modèle vidéo, promise pour bientôt le 15 octobre, afin de l’intégrer à des produits et à des flux de travail. L’annonce ne donne ni tarif ni lien vers la documentation. Le modèle arrive le même jour chez plusieurs plateformes tierces : fal et Higgsfield l’ajoutent, Kling le met en avant sur Magnific, et Runway offre trois jours d’utilisation illimitée de Kling 4 à tout nouvel abonné Max ou Team.
🔗 L’annonce de @Kling_ai · L’offre de Runway
GitHub a copié 99,99999 % de ses dépôts dans Azure et passe à un quorum par référence
21 octobre — Deux semaines après avoir exposé les principes de sa future infrastructure Git, GitHub raconte l’étape intermédiaire, dictée par le virage agentique. Désormais, 99,99999 % de ses dépôts vivent à la fois dans ses propres centres de données et dans Azure, où la première copie est arrivée en août 2025 ; la plupart y ont deux de leurs cinq répliques, et Azure sert déjà environ la moitié du trafic Git. Restent les 0,00001 % les plus sollicités, que retient un aller-retour réseau d’environ 25 ms vers une région Azure située à environ 1 000 miles.
Le blocage vient du quorum de Spokes, le système qui réplique chaque dépôt : une écriture attend toutes les répliques saines et verrouille le dépôt entier, si bien que la réplique la plus lente fixe le rythme. GitHub passe donc d’un quorum par dépôt à un quorum par référence : deux écritures ne s’attendent plus que si elles touchent la même branche, ce qui est rare quand agents et développeurs poussent chacun sur la leur. En tests internes, les écritures sur des références différentes ont obtenu un débit 3 à 4 fois supérieur. Azure Blob Storage entre aussi dans le quorum par une « réplique virtuelle » d’écriture, le premier nœud entièrement éphémère de GitHub, et des répliques virtuelles de lecture peuvent être créées à la demande pour des dépôts qui reçoivent de 100 à 1 000 lectures par écriture. Le dernier volet de la série est attendu à GitHub Universe, la semaine prochaine.
🔗 Le billet d’ingénierie de GitHub
JOLT : Perplexity Research et NVIDIA font jouer à un même modèle l’enseignant et l’élève
21 octobre — Perplexity publie avec NVIDIA JOLT (Joint On-policy Learning and Teaching, apprentissage et enseignement conjoints), une méthode de post-entraînement où un seul modèle tient deux rôles. L’apprentissage par renforcement classique, comme GRPO, ne donne qu’une récompense par tentative ; l’auto-distillation ajoute un retour token par token, le même modèle jouant l’enseignant, qui dispose d’une information privilégiée comme une solution vérifiée, et l’élève, qui ne l’a pas. Mais avec ses indices, l’enseignant peut prendre des raccourcis hors de portée de l’élève : JOLT entraîne donc aussi l’enseignant, sur ses propres récompenses, avec une pénalité quand il s’éloigne de ce que ferait l’élève.
| Banc évalué | Modèle de base | Gain de JOLT+ sur GRPO |
|---|---|---|
| GSM8K | DeepSeek-V2-Lite | +1,5 point |
| MATH | Qwen3-0.6B | +4,2 points |
| LiveCodeBench v6 | Qwen3-8B | +3,0 points |
| AppWorld | Qwen3-4B-Instruct | +9,9 points |
| Terminal-Bench 2.1 (pass@1) | Qwen3-30B-A3B-Instruct | +2,7 points |
La variante JOLT+, qui ajoute la récompense propre de l’élève, devance GRPO, la meilleure référence testée, sur les cinq bancs ; sans elle, JOLT fait mieux que GRPO en mathématiques et en code, mais reste derrière lui sur AppWorld et Terminal-Bench. Le gain le plus net porte sur le coût : sur MATH, à précision égale (63,44 %), GRPO a consommé 8,40 millions de tokens d’entraînement, contre 1,30 million selon la courbe ajustée de JOLT, soit 6,5 fois moins. L’article complet est sur arXiv depuis le 7 octobre, et le billet ne relie la méthode à aucun produit de Perplexity.
🔗 Le billet de Perplexity · L’article sur arXiv
Agents de code : Claude Code 2.1.305, Gemini CLI 0.65 à 0.67, Delta 0.21, Replit Agent avec Stripe Atlas et PDD Kit
Les CLI d’agents corrigent leurs régressions et s’ouvrent aux réseaux d’entreprise, Delta se branche sur Claude Code, Replit Agent apprend à créer une société et GitHub Next promet de prouver le code des agents plutôt que de le relire. Côté OpenAI, aucune version stable de Codex CLI n’est sortie depuis la 0.163.0 du 15 octobre ; Copilot CLI 1.0.102, Qwen Code, la CLI mistral et les autres outils du jour sont en Brèves.
Claude Code 2.1.305 répare les requêtes bloquées par la recherche d’outils sur Vertex et Bedrock
20 octobre — Claude Code 2.1.305 (38 entrées, dont 22 correctifs) répare d’abord une régression de la 2.1.304 : sur Vertex, Bedrock et d’autres fournisseurs, toutes les requêtes échouaient quand le point d’accès ou une passerelle refusait la recherche d’outils (tool search), ou quand une passerelle interdisait ToolSearch ou l’omettait de --tools. Claude Code réessaie désormais sans elle. Sous Linux, sandbox.allowNestedUserNamespaces autorise les commandes du bac à sable à créer des espaces de noms utilisateur, pour Chromium ou podman sans root ; les notes préviennent que cela leur permet de contourner les protections de fichiers du bac à sable.
/usage transforme chaque avertissement en correctif d’une ligne qui nomme sa source, applicable avec la touche f. Côté administrateurs, allowedMcpServers ne filtre plus les serveurs stdio de managed-mcp.json qui n’utilisent ${VAR} que dans env : un serveur laissé hors de la liste se chargera après la mise à jour, et deniedMcpServers permet de le garder désactivé. La reprise d’un Workflow ne relance plus les agents pipeline() et parallel() déjà terminés. Publiée le 21 octobre, la 2.1.306 ajoute deux correctifs, dont claude -p qui se disait non connecté dans une session cloud lancée sans ses variables d’environnement.
🔗 Les notes de Claude Code 2.1.305
Gemini CLI : stable v0.65.0, preview v0.66.0 et l’OAuth MCP sur réseau privé
20 octobre — Gemini CLI a bouclé son cycle hebdomadaire le soir du 20 octobre, avec la preview v0.66.0-preview.0 à 21 h 04 UTC et la stable v0.65.0 à 21 h 17 UTC ; la nightly v0.67.0 du 21 octobre ouvre ensuite la série 0.67.0. La stable ne fait que promouvoir des correctifs déjà présentés (en-têtes OTLP personnalisés, filtrage plus rapide des fichiers ignorés, fin des boucles OAuth), mais la preview et la nightly ajoutent quatre PR inédites.
La plus utile en entreprise est le réglage oauth.allowPrivateNetwork, à activer serveur par serveur dans settings.json, qui permet de joindre des serveurs MCP et des fournisseurs OAuth 2.0 hébergés sur un réseau interne (plages RFC 1918, RFC 6598 et RFC 4193, domaines .internal et .local), jusqu’ici rejetés par la validation des adresses. L’outil shell n’écrase plus la configuration Git de l’utilisateur, qui faisait échouer git commit faute d’identité, et un message d’erreur contenant simplement 401, comme le port localhost:4012, ne déclenche plus à tort la détection OAuth. Gemini 4 Argon n’arrive toujours pas : le robot du dépôt a annoncé que la PR communautaire qui l’ajoute serait fermée sous 7 jours, faute de ticket marqué help wanted.
| Version publiée de Gemini CLI | Date et heure (UTC) | Contenu inédit |
|---|---|---|
| v0.66.0-preview.0 | 20 octobre, 21 h 04 | 4 PR, dont l’OAuth MCP sur réseau privé |
| v0.65.0 (stable) | 20 octobre, 21 h 17 | Aucun, promotion de la série 0.65.0 |
| v0.67.0-nightly.20261021 | 21 octobre, 01 h 33 | Les mêmes 4 PR, ouverture de la série 0.67.0 |
🔗 Gemini CLI v0.66.0-preview.0 · Gemini CLI v0.65.0
Delta 0.21 ouvre les fils partagés dans Claude Code et se connecte au serveur MCP de Figma
21 octobre — Delta, l’environnement multijoueur de Zed pour coder avec des agents, passe en version 0.21.0, avec 12 nouveautés, 14 améliorations et 48 correctifs. La commande Open in Claude Code ouvre un fil partagé dans Claude Code, sur le bureau comme sur le web, dès lors que le plugin Delta pour Claude Code est installé, et les collaborateurs qui rejoignent un fil depuis un outil externe, Claude Code compris, apparaissent dans la barre des participants avec le nom de leur outil. Delta se branche aussi sur le serveur MCP de Figma, une semaine après que Figma l’a cité parmi ses nouveaux partenaires MCP.
La CLI gagne delta update, la compaction manuelle reste disponible pendant qu’un agent local travaille, et les commandes slash prennent des noms orientés action (/change-model, /fork, /set-thinking-level). Parmi les correctifs, Grok 4.7 exploite enfin toute sa fenêtre de 500k tokens avec un abonnement Grok, et les agents ne s’arrêtent plus en silence quand ils appellent un outil indisponible. Les commandes delta daemon disparaissent : Delta démarre désormais à la demande.
🔗 Les notes de version de Delta 0.21.0
Replit Agent peut constituer une société avec Stripe Atlas, désormais dans le MCP et la CLI de Stripe
21 octobre — Replit annonce que son agent peut désormais constituer une société pour l’utilisateur, via l’intégration MCP de Stripe et Stripe Atlas, le service de création d’entreprise de Stripe ; l’annonce ne précise ni tarif ni condition propre à Replit. Elle s’appuie sur une nouveauté annoncée une demi-heure plus tôt par le compte @atlas : Atlas est disponible dans le serveur MCP et dans la CLI de Stripe.
| Interface Stripe utilisée | Rôle dans une demande Atlas |
|---|---|
| Serveur MCP | Parcours conversationnel depuis un agent : exigences, informations sur la société, validations |
| Stripe CLI | Parcours en terminal par invites structurées, lançable par un agent de code |
| Tableau de bord Stripe | Identité, paiement, revue des documents, signatures et soumission |
Selon le billet du blog développeurs de Stripe, daté du 19 octobre, une même demande se reprend d’une interface à l’autre. Atlas prend en charge les C corporations et les LLC du Delaware, y compris à plusieurs fondateurs : il constitue la société, obtient le numéro d’identification d’employeur (EIN), lance l’acquisition progressive des parts des fondateurs (vesting) et dépose les élections fiscales 83(b). Le billet cite Claude Code et Cursor parmi les environnements configurés automatiquement, mais pas Replit, qui fait sa propre annonce.
🔗 L’annonce de Replit · L’annonce de Stripe Atlas · Le billet stripe.dev
PDD Kit : GitHub Next et Microsoft Research veulent prouver le code Rust des agents, intégré à Chopin
21 octobre — GitHub Next et Microsoft Research présentent le Proof Driven Development Kit (PDD Kit), qui transforme le plan d’un développeur en spécification formelle, puis prouve que le code écrit par l’agent la respecte pour toutes les entrées possibles. Sur l’exemple du parcours de connexion d’une application, PDD Kit discute du code, déduit l’intention au fil de l’échange et propose une spécification en Verus, un langage de preuve pour Rust ; une fois la spécification approuvée, le vérificateur Verus prouve automatiquement que le code y est conforme. Là où la preuve n’est pas possible, l’outil se replie sur des tests et des agents d’utilisation d’ordinateur (computer-use agents). Il ne fonctionne aujourd’hui que sur Rust.
GitHub le présente comme une préversion de recherche qui doit permettre de livrer en production du code généré par IA sans le relire ligne à ligne, Microsoft Research comme l’exploration d’une approche plus rigoureuse ; GitHub Next vise une usine logicielle vérifiée, où les ingénieurs relisent des spécifications plutôt que du code. Le kit est intégré à Chopin, l’éditeur de plans multijoueur que GitHub Next a publié en open source, sous licence MIT, en septembre. Aucun billet, dépôt ni documentation de PDD Kit n’accompagne l’annonce : démonstration à GitHub Universe, les 28 et 29 octobre.
🔗 L’annonce de @GitHubNext · Le dépôt de Chopin
Brèves
Agents et outils de code
- Copilot CLI 1.0.102 — La stable de GitHub, sans nouvelle fonction majeure, fait respecter au mode prompt la sélection automatique du modèle imposée par l’entreprise, et aux sous-agents les approbations d’outils personnalisés et MCP ; le bac à sable suit
NO_PROXYetALL_PROXY; le même jour, le serveur MCP de GitHub passe en 2.0.3. 🔗 source - Qwen Code v0.25.4 en préversion — 173 changements depuis la v0.25.3, dont
qwen daemon startpour piloter un démon local, un Managed Agent installable sur un seul serveur avec des unités systemd, et un Web Shell qui affiche le temps jusqu’au premier token de chaque modèle ; la stable n’est pas encore sortie. 🔗 source - La CLI mistral 0.10.0 — Au lendemain de la 0.9.0,
mistral apps deletesupprime une application déployée avec ses modules et ses bases de données, derrière un indicateur de fonctionnalité (feature flag), et les mises à jour de registres fusionnent à trois voies les fichiers de modèle modifiés ; changement cassant, les anciennes versions rejettent le nouveau champversion. 🔗 source - v0 et Slack — Via le serveur MCP de Slack, v0 lit les fils et les fichiers d’un espace de travail, s’en sert comme contexte pour une modification et y publie l’avancement, limité aux canaux accessibles au compte, sur toutes les formules. 🔗 source
- Conversations partagées chez Replit — Une conversation, un élément isolé ou les devURLs d’une discussion se partagent avec les membres de son espace de travail, en lecture seule ; ni billet ni formule précisée. 🔗 source
- Les extensions d’Agents CLI — Google détaille le système d’extensions de son outil d’agents, ouvert depuis la 1.5.0 du 1er septembre : l’extension LangChain officielle remplace les 6 commandes propres à ADK, sur environ 24, et une équipe plateforme peut imposer sa propre règle, comme une analyse SBOM avant chaque déploiement. 🔗 source
- Manus Game Dev — Manus prend désormais en charge le squelette d’animation (rigging) et l’animation des personnages 3D, et rend la génération 3D plusieurs fois plus rapide, sans chiffre précis ni coût en crédits. 🔗 source
Assistants et entreprises
- Kimi Work 3.2.18 — Les utilisateurs Enterprise de l’application agentique de Moonshot AI peuvent créer des plugins personnalisés et les publier sur la place de marché, et passer d’un espace de travail à l’autre, regroupés par entreprise. 🔗 source
- Viktor passe à Grok 4.7 — L’agent présenté comme un employé IA, qui revendique plus de 70 000 équipes et a levé 75 millions de dollars en mai, fonctionne désormais avec le modèle de SpaceXSI, sans dire s’il devient le modèle par défaut. 🔗 source
- HCLTech dans le Claude Partner Network — Le groupe de plus de 230 000 personnes devient partenaire Global Premier, avec une Anthropic Business Unit, Claude dans HCL BigFix et HCL AppScan, et Claude Code dans sa plateforme AI Force ; aucun montant. 🔗 source
- Terminal X — Dans une étude de cas d’OpenAI publiée le 20 octobre, l’agent d’évaluation de cette startup rejoint le relecteur senior d’un fonds dans 88,6 % de 500 jugements avec GPT-6.1 Sol, contre 86,4 % pour le meilleur modèle suivant, non nommé. 🔗 source
- AT&T et OpenAI — Le service juridique d’AT&T prolonge son équipe LegalEdge pour bâtir une couche de connaissances commune et, en projet, un guichet de demandes en langage naturel ; la décision restera aux juristes, selon son directeur juridique David McAtee, et aucun chiffre n’est donné. 🔗 source
Gouvernance et sécurité
- Le premier Public Benefit Report d’Anthropic — Le rapport annuel de la société à mission s’organise autour de cinq piliers définis avec les membres du Long-Term Benefit Trust, de la sûreté technique au partage des bénéfices, et recense 166 travaux en 2026, contre 114 en 2025. 🔗 source
- Christopher Stubbs au Long-Term Benefit Trust — L’ancien doyen des sciences de Harvard, membre en 1998 de l’équipe qui a découvert l’accélération de l’expansion de l’univers, devient le premier physicien du Trust selon Anthropic, aux côtés notamment de Ben Bernanke. 🔗 source
- Le plan d’OpenAI pour les cyberdéfenseurs — Second volet de sa gouvernance démocratique de l’IA de frontière, il propose aux gouvernements et à l’industrie des contrôles d’arrêt fiables pour les agents, la modernisation des défenses et des évaluations indépendantes, dans ce qu’OpenAI appelle une fenêtre du défenseur. 🔗 source
- x402 Agent Safety Bench — Sur ce banc communautaire de paiements par agents, Claude Sonnet 5.5, GPT-6.1 Sol et Gemini 4 Argon évitent seuls 24 à 26 pièges sur 39, DeepSeek V4 Pro 12 seulement, pour 142,31 dollars perdus ; avec les skills du banc, aucun ne perd d’argent. 🔗 source
- Passkeys sur Hugging Face — Le Hub accepte la connexion par clé d’accès (empreinte, visage, verrouillage d’écran ou clé de sécurité) au lieu du mot de passe, et comme second facteur d’authentification. 🔗 source
- Jetons expirants dans GitHub CLI 2.103.0 — En préversion publique,
gh auth login --expiringconserve un jeton d’accès de courte durée renouvelé en arrière-plan, si bien qu’un jeton divulgué devient inutilisable en quelques heures ; ce sera le défaut des nouvelles connexions dans une future version. 🔗 source
API et cloud
- Niveaux de service par projet dans l’API OpenAI — Les paramètres de la Platform permettent de choisir les niveaux de service, comme Ultrafast, que chaque projet peut utiliser, et l’organisation peut les restreindre pour tous ses projets. 🔗 source
- Vertex AI dans les SDK d’OpenAI — openai-python 3.36.0 et openai-node 7.41.0 prennent en charge Vertex AI pour la Responses API, avec des compteurs d’usage pour les écritures de cache de 30 minutes et la gestion du consentement des voix personnalisées. 🔗 source
- Gemini sur Google Distributed Cloud — À GTC Berlin, Google ajoute Gemini 3.5 Flash à la version coupée d’Internet (air-gapped) de son cloud installé chez le client, met en préversion une recherche d’entreprise par RAG (100 Mo par fichier, 500 Mo par conversation) et passe les systèmes HGX B300 en disponibilité générale. 🔗 source · 🔗 recherche RAG
- Les dépenses en tokens selon Perplexity — Un guide liste cinq sources de surconsommation et détaille les réglages d’Enterprise : 500 crédits par mois en Enterprise Pro, 15 000 en Enterprise Max, sans report, et des limites nommées par groupe ; aucune nouveauté n’est annoncée. 🔗 source
NVIDIA : robotique, industrie et matériel
- Microduck dans Isaac Lab 3.0 — NVIDIA, Pollen Robotics et Hugging Face publient un tutoriel pour apprendre à marcher au petit robot bipède, avec le moteur Newton et jusqu’à 1,25 million de pas de simulation par seconde sur 16 GPU, le jour où des Microducks montent sur la scène de la keynote. 🔗 source
- SimReady Central — Plus de 2 000 objets 3D OpenUSD dotés des propriétés qu’exige une simulation (collisions, masse, friction) arrivent en accès libre sur Hugging Face, des bras robotiques aux systèmes de refroidissement. 🔗 source
- Halos SAFE, FOX et cuDSS — NVIDIA lance Halos SAFE, un cadre de preuves de sûreté pour l’automobile, Volvo Cars adopte Hyperion et Alpamayo, le blueprint d’agents d’usine FOX arrive en accès anticipé (Siemens en attend environ 20 % d’économies) et cuDSS passe en disponibilité générale. 🔗 source · 🔗 FOX et cuDSS
- Les capacités des fournisseurs de NVIDIA — Substrats multipliés par 2,5 en trois ans, plus de 300 % de conditionnement avancé en plus chez Amkor d’ici fin 2028 et une avance de 1,1 milliard de dollars à KYEC pour de nouvelles installations aux États-Unis. 🔗 source
- DGX Station pour Windows en décembre — NVIDIA date la version Windows annoncée sans date le 7 octobre, et NVIDIA Sync pourra regrouper jusqu’à huit DGX Spark, contre deux annoncés début octobre. 🔗 source
- NVIDIA et l’UER — À l’approche de GTC Berlin, le 19 octobre, NVIDIA et l’Union européenne de radio-télévision, qui fédère plus de 115 médias publics, ouvrent leurs standards souverains pour les agents aux clouds souverains, aux éditeurs de modèles ouverts et aux intégrateurs. 🔗 source
Modèles ouverts et recherche
- Kumo Forecast et Kumo Anomaly — NVIDIA range sous la marque Kumo ses modèles de séries temporelles NV-Tesseract, sous Apache 2.0 et sur Hugging Face depuis avril ; affiné sur 50 000 observations normales, Kumo Anomaly passe de 0,016 à 0,201 de précision moyenne. 🔗 source · 🔗 Kumo Anomaly
- bekko-static-embedding-v1 — Yuichi Tateno publie sous licence MIT des embeddings statiques multilingues qui tournent sans GPU : 43,76 sur MNanoBEIR, environ 11 points devant les autres modèles statiques, à environ 1 point de multilingual-e5-small en recherche. 🔗 source
- MemoProAgent — Des chercheurs de Meta et de trois universités publient sans annonce le code d’un assistant proactif qui retrouve un souvenir personnel et ne parle que si celui-ci appelle une action, sans résultat chiffré. 🔗 source
Ce que ça signifie
Les modèles de frontière deviennent un catalogue que chaque grand cloud veut afficher complet. Après Amazon Bedrock et Oracle Cloud en juin, OpenAI entre dans le Model Garden de Google Cloud, Codex compris, et Google revendique d’être le seul grand cloud à proposer les trois principaux LLM fermés ; Antigravity, qui accueille déjà Claude Opus 5.5 et Sonnet 5.5, recevra aussi les modèles d’OpenAI. Pour une entreprise, le choix du modèle se détache de celui du cloud, puisque la consommation s’impute sur des engagements déjà signés ; pour OpenAI, chaque cloud est un canal de vente de plus, même si Microsoft reste son partenaire principal. GTC Berlin suit la même logique : l’OpenShell Reference Architecture fait tourner sur une même pile les agents d’Anthropic, d’OpenAI, de Google ou de Meta.
Les agents travaillent désormais sans qu’on les sollicite, et leurs garde-fous descendent dans le produit, jusque dans le matériel. Claude Duet consulte les comptes toutes les quelques heures et agit dans sa propre machine virtuelle, mais attend l’approbation avant de payer ou de signer, et refuse certaines actions même approuvées ; Grok Bot tient seul des tableaux de bord à jour. Chez NVIDIA, Sentry surveille les agents hors bande depuis un DPU BlueField-4 et les arrête en quelques millisecondes, et ServiceNow peut révoquer l’accès d’un agent en quelques secondes. La question n’est plus seulement ce qu’un agent sait faire, mais qui peut l’arrêter, et à quel étage de la pile.
La recherche de failles par l’IA va plus vite que leur correction. PHP2Shell touche un langage qui fait tourner environ 70 % des sites web, avec des versions vulnérables depuis PHP 5.4, et OpenAI s’attend à une forte hausse de ces découvertes ; Claude Security revendique plus d’un million de vulnérabilités trouvées depuis avril et passe au scan continu pour suivre les correctifs. Le goulot se déplace vers la coordination : préavis aux exploitants, autorités, mainteneurs à soutenir, comme le propose le cadre en cinq étapes d’OpenAI, publié le même jour que son plan pour les cyberdéfenseurs. Même l’outil de vérification de PHP2Shell prévient qu’un résultat inconnu ne prouve pas qu’un serveur est corrigé.
Le coût d’un agent se compte en tokens, et chaque étage de la pile promet d’en réduire la facture. Context Focus de Cohere retire jusqu’à 41 % des tokens face à une recherche par mots-clés seule, Nemotron 3.5 Rerank environ 14 % par requête d’agent, Flint n’active qu’environ 2,5 milliards de paramètres par token pour coder sur un portable, et JOLT atteint la précision de GRPO sur MATH avec 6,5 fois moins de tokens d’entraînement. En dessous, NVIDIA promet des usines IA en service en 14 jours et jusqu’à 30 % d’énergie en moins pour le même nombre de tokens, et GitHub refond la réplication de Git pour un trafic que les agents multiplient.
Sources
- OpenAI models are coming to Google Cloud (OpenAI)
- Google Cloud brings OpenAI models to customers (Google Cloud)
- L’annonce de @OpenAI
- Claude Duet (Anthropic)
- Le fil de @claudeai sur Claude Duet
- Grok Bot et ses tableaux de bord (@bot)
- Coordinated disclosure of critical vulnerabilities (OpenAI)
- php2shell.com
- openai/php2shell-checker (GitHub)
- Claude Security scanne en continu (Anthropic)
- DSX POD (NVIDIA)
- L’écosystème européen DSX (NVIDIA)
- Les instances A5X de Google Cloud (blog NVIDIA)
- Confidential Bare Metal (blog NVIDIA)
- OpenShell Reference Architecture (NVIDIA)
- L’annonce d’OpenShell (@NVIDIAAI)
- Agent Toolkit et Agent Knowledge Foundation (blog NVIDIA)
- Introducing Flint (Recursive)
- RecursiveSI/flint (Hugging Face)
- mammoth-1 et elephant-1 (Baseten)
- Introducing Rerank 5 (Cohere)
- Notes de version de la documentation Cohere
- Nemotron Retriever (blog Hugging Face)
- ChatGPT Ads dans 26 nouveaux pays (OpenAI)
- Building the ChatGPT ad stack (OpenAI)
- GPT-Rosalind et l’atlas CRISPR (OpenAI)
- La prépublication sur bioRxiv
- RFD4-Proteina et les Spaces Hugging Face (blog Hugging Face)
- nvidia/RFD4-Proteina (Hugging Face)
- Cosmos3-H-Dreams (blog Hugging Face)
- La plateforme Isaac (NVIDIA)
- Les modèles ouverts de NVIDIA pour l’industrie européenne (blog NVIDIA)
- Mistral Advances AI for Engineering with NVIDIA (Mistral)
- L’annonce de @MistralAI
- Le premier appel AI-RAN (NVIDIA)
- Eleven Realtime Translation (@ElevenLabsDevs)
- HeyGen Voice Turbo (@HeyGen)
- Classement Controlled Voice (Artificial Analysis)
- L’API de Kling 4.0 (@Kling_ai)
- Kling 4 illimité chez Runway (@runwayml)
- The bridge to agent-scale Git infrastructure (GitHub Blog)
- A good teacher meets the student where they are (Perplexity)
- L’article JOLT sur arXiv
- Claude Code 2.1.305 (GitHub)
- Gemini CLI v0.66.0-preview.0 (GitHub)
- Gemini CLI v0.65.0 (GitHub)
- Delta 0.21.0 (notes de version)
- Replit Agent et Stripe Atlas (@Replit)
- Atlas dans le MCP et la CLI de Stripe (@atlas)
- Go from idea to company with Atlas (stripe.dev)
- PDD Kit (@GitHubNext)
- githubnext/chopin (GitHub)
- Copilot CLI 1.0.102 (GitHub)
- Qwen Code v0.25.4-preview.1 (GitHub)
- CLI mistral 0.10.0 (GitHub)
- Slack MCP dans v0 (@v0)
- Partage des conversations Replit (@Replit)
- Les extensions d’Agents CLI (Google Developers)
- Manus Game Dev (@ManusAI)
- Kimi Work 3.2.18 (notes de version)
- Viktor et Grok 4.7 (@viktor_com)
- HCLTech rejoint le Claude Partner Network (Anthropic)
- Terminal X (OpenAI)
- AT&T Legal (OpenAI)
- Public Benefit Report (Anthropic)
- Christopher Stubbs rejoint le Long-Term Benefit Trust (Anthropic)
- Empowering cyber defenders (OpenAI)
- x402 Agent Safety Bench (blog Hugging Face)
- Passkeys pour le Hub (Hugging Face)
- Jetons OAuth expirants dans GitHub CLI (GitHub Changelog)
- Changelog de l’API OpenAI
- openai-python 3.36.0 (GitHub)
- Google Cloud à GTC Berlin 2026 (Google Cloud)
- La recherche RAG de Gemini sur GDC (Google Cloud)
- How to track and control team token spend (Perplexity)
- Microduck et Isaac Lab 3.0 (blog Hugging Face)
- SimReady Central (blog Hugging Face)
- Halos SAFE et Hyperion (NVIDIA)
- FOX et cuDSS pour l’industrie européenne (blog NVIDIA)
- Les capacités de la chaîne d’approvisionnement (NVIDIA)
- DGX Station, DGX Spark et NVIDIA Sync (blog NVIDIA)
- NVIDIA et l’UER (blog NVIDIA)
- Kumo Forecast (blog Hugging Face)
- Kumo Anomaly (blog Hugging Face)
- bekko-static-embedding-v1 (blog Hugging Face)
- facebookresearch/Memo-Pro-Agent (GitHub)