ai-powered-markdown-translatorgpt-5.6-sol के साथ fr से hi में अनुवादित लेख।
30 और 31 अगस्त की अठारह घोषणाएँ, जिनका वितरण बेहद असंतुलित रहा: रविवार को कोई आधिकारिक प्रकाशन नहीं हुआ और लगभग पूरी सामग्री सोमवार की है। 30 तारीख के संस्करण में बताई गई X की सेवा-बाधा की भरपाई कर ली गई: उस दिन अनुपलब्ध रहे खातों को तीन दिनों की अवधि के लिए दोबारा देखा गया, लेकिन कोई छूटी हुई घोषणा नहीं मिली।
तीन प्रमुख दिशाएँ सामने आती हैं। पहली, एक अभूतपूर्व मॉडल—Runway का दुनिया का पहला interface model। फिर दो आर्थिक पड़ाव: OpenAI के विज्ञापन मंच द्वारा हासिल की गई एक अरब डॉलर की वार्षिकीकृत राजस्व दर और Together AI द्वारा किया गया 250 MW का infrastructure अनुबंध। अंत में GitHub, NVIDIA और Amp के developer tools का एक चक्र, जिसे Hugging Face के सामुदायिक blog पर प्रकाशित तीन शोध अध्ययनों ने पूरा किया।
Runway ने Solaris लॉन्च किया, अपना पहला interface world model
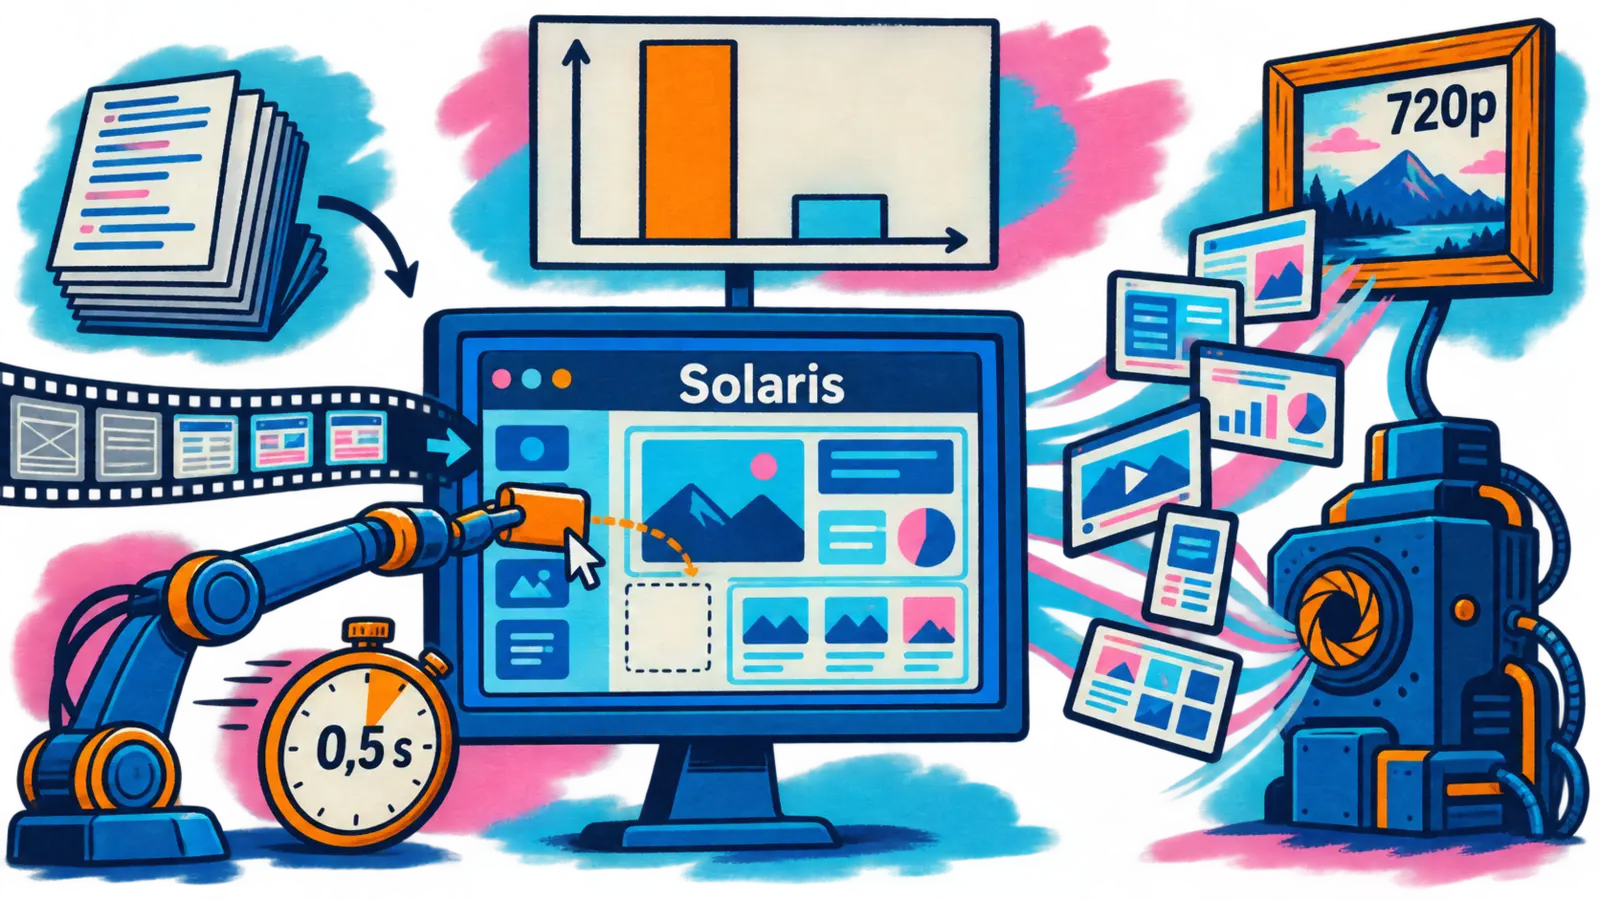
31 अगस्त — Runway ने Solaris पेश किया, जो ऐसे मॉडल-परिवार का पहला सदस्य है जिसे प्रयोगशाला Interface World Models कहती है। इसका सिद्धांत एक वाक्य में समझा जा सकता है: बाद में interface दिखाने वाला code बनाने के बजाय, मॉडल सीधे छवि-दर-छवि interface बनाता है और clicks तथा drag-and-drop पर real time में प्रतिक्रिया देता है।
यह तर्क software निर्माण-श्रृंखला के एक अवलोकन से शुरू होता है। किसी mockup को कुछ भी करने योग्य बनने से पहले code में बदलना पड़ता है, और इस रूपांतरण की दोहरी कीमत चुकानी पड़ती है: हर व्यवहार पहले से परिभाषित करना होता है, जिससे पहले उपयोगकर्ता के आने से पहले ही software स्थिर हो जाता है, और मूल design की दृश्य समृद्धि रास्ते में खो जाती है। Solaris मध्यवर्ती चरण हटा देता है और पूरी छवि ही interface बन जाती है।
तकनीकी रूप से यह मॉडल Runway के video model Gen-4.5 पर आधारित है और उसके general-purpose world model GWM-1 को आगे बढ़ाता है। उपयोगकर्ता के inputs अगली छवि को उसी तरह निर्धारित करते हैं जैसे कोई text या image करता है, जिससे किसी action और उसके visual result के बीच संबंध बिना किसी व्यवहार को program किए सीखा जाता है। real time तक पहुँचने के लिए तीन चरण आवश्यक थे: generation को छवि-दर-छवि autoregressive बनाना, multi-step denoising को कुछ ही चरणों में distill करना और फिर तेज़ मॉडल को उसके अपने outputs पर प्रशिक्षित करना। एक LLM दृश्य के विकास का निर्णय लेता है, जबकि world model rendering करता है।
| प्रतिभागियों द्वारा आँका गया मानदंड | Solaris | code से बना interface (Claude Opus 5) | समान निर्णय |
|---|---|---|---|
| माँगे गए निर्देश का पालन | 61 % | 24 % | 13 % |
| दृश्य में व्यवहार की स्वाभाविकता | 71 % | 21 % | 6 % |
| तकनीकी विशेषता | मापा गया मान |
|---|---|
| मूल मॉडल | Gen-4.5, GWM-1 का विस्तार |
| बरकरार रखा गया resolution | 720p |
| interactivity की सीमा | लगभग 0,5 s की latency |
| उपयोगकर्ता अध्ययन | 250 प्रतिभागी, 30 उदाहरण, लगभग 7 500 युग्मित निर्णय |
| reconstruction benchmark | 30 interfaces, structural similarity (SSIM) और DINOv3 descriptors |
अंतर केवल निर्देशों के पालन की तुलना में व्यवहार की स्वाभाविकता में कहीं अधिक स्पष्ट है, और Runway इसे दोनों दृष्टिकोणों के बीच मूलभूत अंतर मानता है: code से बना interface अक्सर माँगा गया बदलाव दोहरा सकता है, लेकिन उसे एक अलग-थलग update की तरह संभालता है, जबकि objects का व्यवहार सीख चुका मॉडल शेष दृश्य के अनुरूप प्रतिक्रिया उत्पन्न करता है। प्रयोगशाला एक दूसरा, कम अपेक्षित उपयोग भी सुझाती है: agents का प्रशिक्षण, जिन्हें निरंतर पुनर्जीवित होने वाला environment लगातार बदलते interfaces उपलब्ध कराएगा, जिनमें ऐसी व्यवस्थाएँ भी शामिल होंगी जो पहले कभी अस्तित्व में नहीं थीं।
Runway यह भी दर्ज करता है कि Solaris अभी क्या नहीं कर सकता, और सूची लंबी है: स्थिर और पठनीय text अब भी video generation की सबसे कठिन समस्याओं में से एक है, जबकि interfaces किसी भी अन्य क्षेत्र से अधिक उस पर निर्भर हैं; तथ्यात्मक आधार के लिए generation को सत्यापित data से निर्धारित करना आवश्यक है; लंबे sessions में consistency अभी शोध का विषय है; और generated interface को अभी सहायक technologies तथा accessibility API के साथ भी काम करना होगा। साझेदारों के साथ सार्वजनिक launch की तैयारी चल रही है और early access एक form के माध्यम से मिलेगा।
Today, we’re sharing new research on Solaris, our first Interface World Model. Solaris is a new kind of operating system that generates interactive interfaces frame by frame, in real time, with no code.
🇮🇳 आज हम Solaris पर नया शोध साझा कर रहे हैं, जो हमारा पहला Interface World Model है। Solaris एक नए प्रकार का operating system है, जो बिना code के real time में छवि-दर-छवि interactive interfaces बनाता है। — X पर @runwayml
ChatGPT Ads की वार्षिकीकृत राजस्व दर एक अरब डॉलर पहुँची और उसकी self-service सुविधा चार नए क्षेत्रों में खुली
31 अगस्त — OpenAI ने ChatGPT में एकीकृत अपने विज्ञापन मंच ChatGPT Ads पर केंद्रित एक लेख प्रकाशित किया और घोषणा की कि platform ने launch के 200 से कम दिनों में एक अरब डॉलर की वार्षिकीकृत राजस्व दर (annualized revenue run rate) हासिल कर ली है। यह अंतर आरंभ में ही स्पष्ट कर देना आवश्यक है: यह प्राप्त किया जा चुका एक अरब डॉलर नहीं, बल्कि हाल की अवधि के राजस्व का बारह महीनों के लिए अनुमान है। दो सौ दिनों से भी कम समय से मौजूद कोई विज्ञापन मंच स्वाभाविक रूप से इस दर पर पूरे एक वर्ष का राजस्व प्राप्त नहीं कर सकता। Ads Manager के माध्यम से self-service खरीदारी भारत, यूरोप, मध्य पूर्व और उत्तरी अफ्रीका के लिए दिन में बाद में खोले जाने की घोषणा की गई है।
OpenAI विज्ञापन को अपने आर्थिक model के स्तंभों में से एक के रूप में प्रस्तुत करता है, जिसके साथ consumer subscriptions, enterprise offerings और usage के आधार पर बिल किए जाने वाले API शामिल हैं। कंपनी इसे स्पष्ट रूप से उस free tier के वित्तपोषण से जोड़ती है, जो ChatGPT को एक अरब से अधिक weekly active users के लिए सुलभ बनाए रखता है। चार प्रतिबद्धताएँ इस व्यवस्था की सीमाएँ निर्धारित करती हैं: विज्ञापन हमेशा स्पष्ट रूप से पहचाने जाते हैं और उत्तरों से अलग रखे जाते हैं, विज्ञापन दिए गए उत्तरों को प्रभावित नहीं करते, advertisers को निजी conversations तक पहुँच नहीं मिलती और उपयोगकर्ता अपने विज्ञापन अनुभव के personalization की सीमा नियंत्रित करता है।
| OpenAI द्वारा प्रकाशित metric | घोषित मान |
|---|---|
| वार्षिकीकृत राजस्व दर (अनुमान) | 1 अरब डॉलर |
| launch के बाद बीता समय | 200 दिनों से कम |
| platform पर advertisers | दसियों हज़ार |
| पहले से शामिल देश | 40 से अधिक |
| self-service के लिए खोले गए नए बाज़ार | भारत, यूरोप, मध्य पूर्व, उत्तरी अफ्रीका |
| technology और measurement partners | 50 से अधिक |
| ChatGPT के weekly active users | 1 अरब से अधिक |
| 28 दिनों में विज्ञापन खर्च पर उद्धृत return | 3x, एक e-commerce advertiser के यहाँ |
| नए ग्राहकों से आने वाला विज्ञापन traffic | 80 % से अधिक, एक technology partner के यहाँ |
वर्णित दिशा managed sales से open-access platform की ओर संक्रमण की है। शुरुआती model agencies और partners पर आधारित था; मई में Ads Manager के आगमन ने विज्ञापन मंच को छोटे और मध्यम आकार के व्यवसायों के लिए खोल दिया, जो अब गतिविधि का एक महत्वपूर्ण हिस्सा हैं। tools के स्तर पर CPC bidding और outcome-optimized bidding अधिकांश campaigns का हिस्सा हैं, जबकि Pixel और Conversions API measurement की नींव बनाते हैं। OpenAI यह भी बताता है कि अमेरिका से बाहर के advertisers राजस्व के बढ़ते हिस्से का प्रतिनिधित्व करते हैं।
आगे के लिए कंपनी नए markets, formats, objectives और purchasing options की घोषणा करती है और कहती है कि वह ChatGPT के भीतर व्यवसायों के उपभोक्ताओं से संवाद करने के अधिक स्वाभाविक तरीकों का पता लगाना चाहती है—अर्थात ऐसे formats जो मौजूदा विज्ञापनों की तुलना में conversation से कम अलग हों।
🔗 OpenAI — AI तक पहुँच के विस्तार में एक महत्वपूर्ण पड़ाव
Together AI: सऊदी अरब में 250 MW, agentic index में GLM-5.3 शीर्ष पर और एक नया ग्राहक
31 अगस्त — Together AI ने HUMAIN के साथ सऊदी अरब में बनाए जाने वाले 250 MW के data center से संबंधित infrastructure समझौते पर हस्ताक्षर करने की घोषणा की। प्रयोगशाला को इस केंद्र की गतिविधि से प्रति वर्ष 5 अरब डॉलर के राजस्व की उम्मीद है और वह इस सौदे को open source के लिए किए गए सबसे बड़े AI infrastructure समझौतों में से एक बताती है। संदेश को प्रयोगशाला के खाते पर pin किया गया, जो इसे models पर होने वाले उसके सामान्य संचार से अलग बनाता है।
इस आँकड़े को सावधानी से पढ़ना आवश्यक है, क्योंकि घोषणा-संदेश बिना क्रिया वाले तीन अंशों को साथ रखता है और 5 अरब के संदर्भ को अस्पष्ट छोड़ देता है। New York Times की coverage इसे स्पष्ट करती है: यह राशि कंपनी के नहीं, बल्कि इस data center के अपेक्षित राजस्व को दर्शाती है। परिमाण भी इसकी पुष्टि करता है, क्योंकि वही लेख जुलाई 2026 में Together AI का valuation 8,3 अरब डॉलर बताता है—इस स्तर पर मूल्यांकित कंपनी सालाना 5 अरब डॉलर का कारोबार नहीं करती।
इस व्यवस्था पर स्वयं भी ध्यान देना आवश्यक है, क्योंकि यह capacity की खरीद नहीं है। New York Times के अनुसार, HUMAIN 250 MW के अतिरिक्त 120 000 semiconductors उपलब्ध कराता है और बदले में Together AI इन chips को संचालित करते हुए अपने राजस्व का एक हिस्सा उसे देता है। इसलिए प्रयोगशाला infrastructure को वित्तपोषित नहीं करती: वह अपने कारोबार के एक अंश के बदले उसका उपयोग करती है। thread ठीक यही दावा करता है, जहाँ compute उपलब्ध कराने वाली partnerships की तुलना ऐसी दौड़ से की गई है जिसमें हर कोई अपने अरबों जुटाए। पिछले वर्ष युवराज Mohammed bin Salman की पहल पर बनाई गई HUMAIN, AI industry खड़ी करने और तेल पर देश की निर्भरता कम करने के सऊदी प्रयास का हिस्सा है।
thread में दिया गया तर्क मात्रा की तुलना में बाधा की प्रकृति पर अधिक केंद्रित है। Together AI ऊर्जा को इस समय की वास्तविक bottleneck बताता है और समझौते को ऐसे पैमाने तक पहुँचने का माध्यम मानता है, जिसे उसके आकार की कंपनी अपनी balance sheet से वित्तपोषित नहीं कर सकती। प्रयोगशाला इस व्यवस्था की तुलना स्पष्ट रूप से closed labs के model से करती है, जिनका infrastructure लंबे समय तक hyperscalers ने वित्तपोषित किया था।
यह व्याख्या ecosystem में Together AI की विशिष्ट जगह स्पष्ट करती है: प्रयोगशाला frontier models प्रकाशित नहीं करती, बल्कि दूसरों के models—DeepSeek, GLM, Kimi, MiniMax, Nemotron—उपलब्ध कराती है। इसलिए उसकी बाधा research नहीं, बल्कि proprietary API से कम कीमत पर open-weight models उपलब्ध कराने के लिए मौजूद compute capacity है। 250 MW का अनुबंध सीधे इसी आवश्यकता को पूरा करता है।
| समझौते का घटक | बताई गई मात्रा |
|---|---|
| data center की क्षमता | 250 MW |
| HUMAIN द्वारा उपलब्ध कराए गए semiconductors | 120 000 |
| data center का अपेक्षित वार्षिक राजस्व | 5 अरब डॉलर |
| HUMAIN को दिया जाने वाला प्रतिफल | Together AI के राजस्व का एक हिस्सा |
| जुलाई 2026 में Together AI का valuation | 8,3 अरब डॉलर |
| industrial partner | HUMAIN |
| स्थान | सऊदी अरब |
| घोषणा की तारीख और समय | 31 अगस्त 2026, 13:26 UTC |
एक अंतिम बिंदु, जिस पर Together AI अपने thread में टिप्पणी नहीं करता: वही लेख बताता है कि सऊदी अरब में स्थापना से अमेरिका में data centers स्थापित करने के दौरान सामने आने वाले विरोधों से बचा जा सकता है।
We just signed one of the largest AI infrastructure deals for open source, period. 250MW data center. $5B+ in annualized revenue. Built with @HUMAIN in Saudi Arabia.
🇮🇳 हमने अभी-अभी open source के लिए सबसे बड़े AI infrastructure समझौतों में से एक पर हस्ताक्षर किए हैं, बस। 250 MW का data center। 5 अरब डॉलर से अधिक की वार्षिकीकृत राजस्व दर। सऊदी अरब में @HUMAIN के साथ निर्मित। — X पर @togethercompute
GLM-5.3, Artificial Analysis के agentic index में संयुक्त रूप से पहले स्थान पर पहुँचा
31 अगस्त — लगातार छठा दिन जब GLM-5.3 समाचारों में है: 28 अगस्त को Z.ai द्वारा weights खोलने और 29 अगस्त को Together AI के serverless API पर मॉडल उपलब्ध कराने के बाद, इस बार एक third-party ranking ने इसे अलग पहचान दी है। Artificial Analysis के agentic index में मॉडल ने 59 अंक हासिल किए। Together AI परिणाम को सटीकता से व्यक्त करता है: GLM-5.3 पहले स्थान पर बराबरी पर है (ties for the top spot) और GPT-5.6 Sol तथा Claude Fable 5 से आगे है (beating)। इसलिए बढ़त इन दोनों models पर है; 59 अंक वाले Claude Opus 5 के साथ GLM-5.3 शीर्ष स्थान साझा करता है।
सबसे शिक्षाप्रद बिंदु इसकी पद्धति है। Z.ai ने किसी नए base model को प्रशिक्षित नहीं किया: GLM-5.2 का आधार बरकरार रखा गया और पूरा सुधार post-training से आया, जिसे एक साथ तीन दिशाओं में बढ़ाया गया—अधिक long-horizon environments, tasks की अधिक विविधता और RL के लिए अधिक compute।
| मूल्यांकित मॉडल | agentic index पर score |
|---|---|
| GLM-5.3 (max) | 59 |
| Claude Opus 5 (max) | 59 |
| GLM-5.3 Flash | 58 |
| GPT-5.6 Sol (max) | 58 |
| Claude Fable 5 (fallback सहित) | 57 |
Greptile ने Together AI को अपना मुख्य inference provider चुना
31 अगस्त — दिन का अंतिम, अपेक्षाकृत छोटा संकेत: 11 000 से अधिक teams द्वारा इस्तेमाल किए जाने वाले AI code review tool Greptile ने Together AI को अपना मुख्य inference provider चुना है। यह tool repository के पूरे context के साथ pull requests का विश्लेषण करता है; इसका workload profile लंबे contexts और बड़ी token volumes से बना है—ठीक वही उपयोग जहाँ open-weight models और proprietary API के बीच लागत का अंतर निर्णायक हो जाता है।
VS Code में GitHub Copilot: अगस्त के चार संस्करणों का एक changelog में सारांश
31 अगस्त — GitHub ने Visual Studio Code में Copilot का अगस्त 2026 का सारांश प्रकाशित किया है, जिसमें संपादक के v1.132 से v1.135 तक के चार संस्करण शामिल हैं। इस चक्र का मुख्य विषय कई agents के साथ काम को व्यवस्थित करना है: Agents विंडो अब केवल वार्तालापों की सूची नहीं रह गई है, बल्कि ऐसी जगह बन गई है जहाँ कई sessions साथ-साथ मौजूद रहते हैं और अपनी पिछली अवस्था में फिर मिलते हैं।
Sessions के संदर्भ में, chats क्षैतिज या लंबवत समूहों में साथ-साथ रखे जा सकते हैं और लौटने पर उनका विन्यास पुनर्स्थापित हो जाता है। /btw कमांड एक सहायक वार्तालाप खोलती है, जो मुख्य वार्तालाप के चलते रहने के दौरान उसका संदर्भ और prompt cache साझा करता है: इससे चल रहे agent को बाधित किए बिना कोई अतिरिक्त प्रश्न पूछा जा सकता है। Transcript की gutter से उपलब्ध prompts का chronology नियंत्रण सीधे किसी prompt पर जाने और उससे हुए फ़ाइल परिवर्तनों की समीक्षा करने देता है। Agent Host कई VS Code विंडो को एक ही session से जुड़ने की अनुमति देता है, और एक प्रयोगात्मक /rubber-duck कमांड छूटे हुए विवरणों और सीमांत मामलों को सामने लाने के लिए एक पूरक model से सहायता लेती है।
दो बिंदु सीधे संपादक में Claude की भूमिका से जुड़े हैं: एक प्रयोगात्मक setting, API key के साथ Claude कॉन्फ़िगर होते ही, GitHub में sign-in किए बिना Agents विंडो खोल देती है; और Claude sessions किसी भी समय Anthropic subscription के models तथा Copilot subscription के models के बीच स्विच करने देते हैं। इसके अतिरिक्त, VS Code Agent Plugins 1.0 मानक के अनुरूप portable agent plugins की स्थापना स्वीकार करता है, जिन्हें अन्य संगत agent clients में भी उपयोग किया जा सकता है।
| Changelog क्षेत्र | उल्लेखनीय नई सुविधाएँ |
|---|---|
| Sessions और workflows | साथ-साथ chats, /btw, prompts की chronology, Agent Plugins 1.0, /rubber-duck, Agent Host |
| VS Code में Claude | API key के माध्यम से GitHub sign-in के बिना Agents विंडो, Anthropic और Copilot models के बीच स्विच |
| Chat और समीक्षा | Transcript में खोज, sticky scrolling, hybrid Markdown editor, प्रति model tokens |
| अंतर्निहित browser | HTML elements का batch annotation, स्वचालित reload, default HTML editor |
| Dictation | device पर multilingual संचालन, cleanup निर्देश, shell-अनुकूल cleanup |
अंततः chat को वे पठन उपकरण मिल गए हैं जिनकी लंबी हो चुकी वार्तालापों में आवश्यकता थी: पूरे transcript में case sensitivity, पूरे शब्दों और regular expressions के साथ text search; sticky scrolling, जो वर्तमान prompt को दिखाई देता रखता है; और response footer पर hover करने पर प्रति model token खपत का प्रदर्शन, जिसमें input, cached input और output अलग-अलग दिखते हैं—यह दृश्यता तब से उपयोगी है जब से billing cache पर निर्भर हुई है। अंतर्निहित browser किसी page के कई HTML elements को चुनने और annotate करने देता है, ताकि interface feedback को batch में संसाधित किया जा सके; और dictation कई भाषाओं में device पर चलती है तथा terminal में बोलकर लिखते समय बोले गए विराम-चिह्न जोड़ने के बजाय commands की syntax सुरक्षित रखती है।
🔗 GitHub Changelog — VS Code में Copilot, अगस्त 2026 के संस्करण
NVIDIA ने अपने software building blocks को biology और autonomous vehicles में उतारा
31 अगस्त — NVIDIA ने Anthropic के साथ किए गए integration कार्य का दस्तावेज़ीकरण करने वाला एक tutorial प्रकाशित किया है: BioNeMo Agent Toolkit अब Anthropic की scientific research workshop Claude Science से उपयोग किया जा सकता है। यह specialized tooling की समस्या को संबोधित करता है—एक general-purpose agent पहचान सकता है कि किसी कार्य के लिए protein folding आवश्यक है, लेकिन जरूरी नहीं कि उसे पता हो कि कौन-सा model चलाना है, request को कैसे format करना है या कौन-से parameters महत्वपूर्ण हैं। Toolkit एक दशक से अधिक समय के BioNeMo models, libraries और workflows—biology, chemistry, genomics, drug discovery—को agent द्वारा बुलाए जा सकने वाले skills में पैकेज करता है। अपने internal benchmarks पर NVIDIA के अनुसार task accuracy 60 से बढ़कर 100% हो गई और token efficiency लगभग दोगुनी हुई।
Tutorial तीन NIM microservices को क्रम से जोड़ता है: evolutionary context बनाने के लिए पहले MSA Search, फिर स्वतंत्र रूप से structure का अनुमान लगाने के लिए OpenFold3 और Boltz-2। सबसे स्पष्ट demonstration multiple sequence alignment की भूमिका पर केंद्रित है—इसके बिना दोनों models में interface confidence ध्वस्त हो जाता है और अधिक उदार sampling budget से भी कोई अंतर नहीं पड़ता। दो सावधानियाँ उल्लेखनीय हैं: hardware की बाधा, जिसमें L40S या H100 GPU और लगभग 700 GB storage चाहिए; तथा NVIDIA द्वारा व्याख्या में बरती गई सावधानी, जो याद दिलाती है कि confidence score किसी interaction को सिद्ध नहीं करता और दो स्वतंत्र models के convergence को ठोस hypothesis के रूप में प्रस्तुत करती है, प्रमाण के रूप में नहीं।
| Interface confidence माप (iPTM) | OpenFold3 | Boltz-2 |
|---|---|---|
| MSA alignment वाला heteromer | 0,85 | 0,82 |
| MSA alignment के बिना heteromer | 0,14 | 0,19 |
| core का Cα RMSD, monomer बनाम heteromer | 0,68 Å | 0,65 Å |
🔗 NVIDIA tutorial — Claude Science में BioNeMo NIM
Omniverse NuRec ने perception stack को ऐसे वाहन के अनुरूप बनाया जो अभी अस्तित्व में नहीं है
31 अगस्त — उसी दिन NVIDIA ने autonomous driving पर केंद्रित दूसरा technical tutorial प्रकाशित किया। प्रारंभिक निष्कर्ष यह है कि perception stack उस वाहन के अनुसार आकार लेता है जो उसे वहन करता है: SUV से sedan में स्थानांतरित करने पर वह दुनिया को उसी तरह नहीं देखता, क्योंकि sensors की स्थिति, calibration, fields of view, occlusions और body geometry—सभी बदल जाते हैं। प्रत्येक vehicle line के लिए वास्तविक dataset एकत्र करना और annotate करना महँगा है तथा development की शुरुआत में अक्सर असंभव रहता है।
Omniverse NuRec पहले से रिकॉर्ड किए गए routes का पुनः उपयोग करने का प्रस्ताव देता है: यह प्रत्येक scene का reconstruction करता है और फिर उसे target vehicle के sensor configuration के दृष्टिकोण से प्रस्तुत करता है। तब टीमें जान सकती हैं कि नए camera setup से कोई scenario कैसा दिखाई देगा और geometry के बदलाव कहाँ blind spots पैदा करेंगे। NVIDIA स्पष्ट करता है कि performance को आधार देने और validate करने के लिए वास्तविक driving data अनिवार्य रहता है: synthetic data का उद्देश्य dedicated dataset उपलब्ध होने से पहले models को अनुकूलित करना है, उसे बदलना नहीं। Scenes को Hugging Face पर USDZ format में वितरित किया गया है और उनके साथ code agents के लिए skills repository दी गई है।
🔗 NVIDIA tutorial — Omniverse NuRec
Amp ने प्रत्येक thread के साथ एक audio और video call room जोड़ा
31 अगस्त — Amp प्रत्येक thread के साथ एक live conversation room जोड़ता है। Space to Talk नामक यह सुविधा thread से ही जुड़ा audio और video space खोलती है: Enter key दबाकर उसमें प्रवेश किया जा सकता है, camera चालू किया जा सकता है और screen साझा की जा सकती है, जबकि agent उसी thread में अपना काम जारी रखता है।
प्रमुख तर्क बीच के चरणों को हटाना है, और यह सोच गर्मियों से Amp द्वारा अपनाई गई collaborative दिशा को आगे बढ़ाती है: teammates के बीच orb का shared control (Multiplayer, 22 जुलाई), फिर किसी thread में सीधे mention द्वारा invitation (Pass the Orb to the Left Hand Side, 19 अगस्त)। Thread टीम और agent का एकमात्र meeting point बन जाता है। Amp यह भी स्वीकार करता है कि दायरा अभी खुला है: brainstorming, whiteboard या Puck और अन्य agents के साथ वार्तालाप को भविष्य की संभावनाओं के रूप में बताया गया है, उपलब्ध सुविधाओं के रूप में नहीं।
No links to paste, no calendar invite, no other app. The call lives where the work lives.
🇮🇳 चिपकाने के लिए कोई link नहीं, कोई calendar invitation नहीं, कोई अन्य application नहीं। Call वहीं होती है जहाँ काम मौजूद है। — Amp, Space to Talk टिप्पणी
VLANeXt, vision-language-action models के लिए एक unified codebase
31 अगस्त — एक टीम ने Hugging Face blog पर VLANeXt प्रकाशित किया है, जो vision-language-action models (vision-language-action, VLA) को समर्पित research codebase है। इन models का सिद्धांत सरल है: vision-language model robot द्वारा देखी गई चीज़ों को natural-language instruction से जोड़ता है और फिर उससे भौतिक दुनिया में की जाने वाली action निकालता है।
लक्षित समस्या methodological है। यह क्षेत्र तेज़ी से आगे बढ़ रहा है, लेकिन खंडित हो रहा है: एक publication से दूसरे तक backbone, policy head, action representation, training strategy और evaluation protocol बदल जाते हैं। Results को व्यापक रूप से मजबूत बताया जाता है, लेकिन variables को अलग-अलग जाँच पाने के अभाव में यह तय करना कठिन रहता है कि वास्तव में VLA model को performant क्या बनाता है।
एक और architecture जोड़ने के बजाय, लेखकों ने RT-2 / OpenVLA प्रकार के reference base से शुरुआत की और design space का व्यवस्थित रूप से अध्ययन करके एक recipe निकाली; इसी काम से ICML paper « VLANeXt: Recipes for Building Strong VLA Models » तैयार हुआ। तब से codebase को इस study से आगे बढ़ाकर विभिन्न आकारों के backbones, latent action learning, latent-space predictive modeling और world-action modeling तक विस्तारित किया गया है। यह छह starting points प्रदान करता है: VLANeXt-LAM, -S, -L, -XL, -JEPA और -WAM।
संक्षिप्त समाचार
- Claude Code 2.1.252, केवल सुधारों वाला संस्करण — चार fixes और कोई नई सुविधा नहीं: कुछ Mac पर विफल होने वाली Bash commands,
.claude/settings.local.jsonफ़ाइल से रहित project में save न होने वाला “always allow” विकल्प, claude.ai से connection खराब होने पर किसी tool के समाप्त होने के बाद कई मिनट तक जमे रहने वाले Remote Control sessions, और बड़े output वाली background task notifications के कारण API requests की size limit पार होना। 🔗 Claude Code CHANGELOG - Flow ने desktop पर first और last frame control उपलब्ध कराया — Google Flow के अनुसार Gemini Omni 1.1 Flash का first और last frame control, जिसे model के साथ 27 अगस्त को प्रस्तुत किया गया था, अब desktop पर उपलब्ध है। प्रमुख उपयोग: loop बनाने के लिए दोनों सिरों पर एक ही image देना। 🔗 @FlowbyGoogle का संदेश
- Grok Imagine पुरस्कार प्रतियोगिता का अंतिम दिन — xAI ने याद दिलाया कि 17 अगस्त को शुरू हुई video competition की deadline उसी दिन थी। प्रतिभागियों को Homer की Odyssey से लिया गया ऐसा scene बनाना था जो model की video और voice capabilities को प्रदर्शित करे; शीर्ष तीन creations के बीच 175 000 dollars बाँटे जाने हैं—क्रमशः 100 000, 50 000 और 25 000 dollars। 🔗 @grok का संदेश
- QwenCloud ने अपना Arena बंद किया और Bangkok session की घोषणा की — cross-border e-commerce के लिए content-generation agents पर केंद्रित Qwen Cloud Arena challenge ने 800 से अधिक प्रतिभागियों के बाद Beijing समयानुसार आधी रात को submissions बंद कर दिए और review phase अगले दिन शुरू हुआ। कुछ घंटे पहले QwenCloud ने 4 सितंबर को Bangkok की Qwen Conference में एक session की घोषणा की थी, जिसमें वही तीन entry points—website, Skills, CLI—वाला positioning था जिसे Hong Kong में पहले ही प्रस्तुत किया जा चुका था। 🔗 Arena का समापन · 🔗 Bangkok session
- GitHub ने developers के accessibility adaptations पर survey शुरू किया — कंपनी उन tools, product settings और personal adaptations का दस्तावेज़ बनाना चाहती है जो अच्छी परिस्थितियों में काम करना संभव बनाते हैं, बिना disability घोषित करने या स्वयं को accessibility tools का user मानने की आवश्यकता के। उत्तर 30 सितंबर तक अपेक्षित हैं। विषय का AI से कोई संबंध नहीं है। 🔗 @github का संदेश
- otoSpeech Task, अपने task के साथ प्रकाशित full-duplex corpus — दो वक्ताओं की 20 घंटे की अंग्रेज़ी वार्तालाप, सात collaborative tasks में 58 sessions और 11 025 timestamped events, CC BY 4.0 license के अंतर्गत। इसकी विशेषता यह है कि प्रत्येक वक्ता द्वारा देखी गई images, उनकी actions और reference responses, audio के साथ उसी timeline पर मौजूद हैं। 🔗 Hugging Face पर लेख
- YOLO26-RGB, depth head से निकला rain-removal model — YOLO26-depth के 1-channel depth head को 3-channel RGB restoration head से बदलकर बनाए गए दो rain-removal models: 1080p पर लगभग 109 images/s के साथ 5,25 M parameters, और 0,1 dB अधिक quality के लिए लगभग 92 images/s के साथ 12,13 M। 🔗 Hugging Face पर लेख
इसका क्या अर्थ है
इसे बनाने वाले कोड के बजाय इंटरफ़ेस उत्पन्न करना। Solaris डिज़ाइन और निष्पादन के बीच की सीमा को स्थानांतरित करता है। वर्तमान की पूरी सॉफ़्टवेयर शृंखला अनुवाद पर टिकी है—एक मॉकअप कोड बनता है, कोड एक दृश्य प्रस्तुत करता है—और Runway मापता है कि इस अनुवाद की क्या कीमत चुकानी पड़ती है: स्क्रीनशॉट से दोबारा बनाए जाने वाले 30 इंटरफ़ेस पर, परीक्षण किए गए सभी multimodal models जानकारी खो देते हैं और दृश्य समृद्धि के साथ गिरावट बढ़ती जाती है। मध्यवर्ती चरण को हटाना एक आमूलचूल प्रस्ताव है, और प्रयोगशाला स्वयं जिन सीमाओं को गिनाती है, वे बताती हैं कि यह कहाँ अटकता है: ऐसा टेक्स्ट जो अपनी जगह स्थिर नहीं रहता, तथ्यों से जुड़ाव की कोई गारंटी नहीं, और पूरी तरह निर्मित की जाने वाली accessibility, क्योंकि उत्पन्न की गई छवि screen readers को कोई संरचना उपलब्ध नहीं कराती। ये मूलभूत बाधाएँ हैं, केवल अंतिम रूप देने से जुड़ी कमियाँ नहीं।
गणना की कीमत चुकाने के दो तरीके, जिनकी घोषणा एक ही दिन हुई। OpenAI अपने विज्ञापन व्यवसाय के लिए एक अरब डॉलर की वार्षिकीकृत राजस्व दर दिखाता है—यह बारह महीनों का अनुमान है, वास्तविक प्राप्ति नहीं—और इसे subscriptions के समान स्तर का आर्थिक स्तंभ मानता है: विज्ञापन उस सेवा के निःशुल्क स्तर को वित्तपोषित करता है जो प्रति सप्ताह एक अरब से अधिक उपयोगकर्ताओं का दावा करती है। दूसरी ओर, Together AI न तो किसी audience से कमाई करता है और न ही अपनी क्षमता और अधिक खरीदता है: वह अपने राजस्व में हिस्सेदारी के बदले सऊदी अरब में 250 MW और 120,000 chips प्राप्त करता है और ऊर्जा को इस क्षेत्र की वास्तविक अड़चन बताता है। दोनों कंपनियाँ शृंखला के दो विपरीत सिरों से एक ही बाधा का उत्तर देती हैं, और दोनों में से कोई भी उत्तर तटस्थ नहीं है: एक उत्पाद में व्यावसायिक हित जोड़ता है, जबकि दूसरा infrastructure को ऐसी जगह ले जाता है जहाँ उसे कम राजनीतिक प्रतिरोध मिलता है।
Agentic प्रतिस्पर्धा अब pre-training के बाद तय होती है। Artificial Analysis के agentic index पर GLM-5.3 का परिणाम मुख्यतः उसे हासिल करने के तरीके के कारण महत्त्वपूर्ण है: Z.ai ने GLM-5.2 base को बनाए रखा और केवल post-training का स्तर बढ़ाया—लंबी अवधि वाले environments, tasks की विविधता और RL compute। यदि agentic ranking में शीर्ष पर पहुँचने के लिए अब किसी base को दोबारा प्रशिक्षित करना आवश्यक नहीं है, तो सबसे भारी लागत वाला मद ranking का एकमात्र निर्धारक नहीं रह जाता और model का update cycle भी उतना ही छोटा हो जाता है। यही इस model के छह दिनों के घटनाक्रम की सबसे किफ़ायती व्याख्या भी है—28 तारीख को open weights जारी होने से लेकर 31 तारीख को इस ranking तक।
Developer tooling एक साथ कई agents के इर्द-गिर्द पुनर्गठित हो रही है। Copilot का changelog पूरा एक cycle Agents window को workspace के रूप में विकसित करने में लगाता है—साथ-साथ chats, prompt cache साझा करने वाली पार्श्व conversation, prompts की timeline, एक ही session से जुड़ी कई windows—अब यह केवल conversations की सूची नहीं है। Amp thread के साथ एक call room जोड़ता है, ताकि मानवीय चर्चा वहीं हो जहाँ agent काम करता है। अंततः NVIDIA दस वर्षों की scientific libraries को कॉल किए जा सकने वाले skills में पैकेज करता है और driving scenes के reconstruction के लिए skills का दूसरा repository उपलब्ध कराता है। तीन बहुत अलग-अलग संस्थाएँ एक ही विचार पर पहुँचती हैं: agent में अब model की क्षमता की कमी नहीं है, बल्कि shared context और वे specialized tools कम हैं जो उसे उपलब्ध कराए जा सकते हैं।
स्रोत
- Runway — Solaris का परिचय
- Runway — X पर Solaris की घोषणा
- OpenAI — AI तक पहुँच के विस्तार में एक उपलब्धि
- Together AI — HUMAIN के साथ 250 MW का infrastructure समझौता
- Together AI — Artificial Analysis के agentic index पर GLM-5.3
- Together AI — मुख्य inference provider के रूप में Greptile
- GitHub Changelog — VS Code में Copilot, अगस्त 2026 के versions
- NVIDIA — Claude Science में protein structure की भविष्यवाणी के लिए BioNeMo NIM
- NVIDIA — Omniverse NuRec और multi-vehicle perception
- Amp — बातचीत के लिए जगह
- VLANeXt, vision-language-action models के लिए एकीकृत codebase
- Claude Code का CHANGELOG
- Google Flow — desktop पर पहली और अंतिम images
- xAI — Grok Imagine प्रतियोगिता का अंतिम दिन
- QwenCloud — Qwen Cloud Arena का समापन
- QwenCloud — Bangkok की Qwen Conference में session
- GitHub — accessibility tools और adaptations पर सर्वेक्षण
- otoSpeech Task, full-duplex conversation corpus
- YOLO26-RGB, वर्षा हटाने वाला model