ai-powered-markdown-translatorArtículo traducido del fr al es con gpt-5.6-sol.
Dieciocho anuncios para los días 30 y 31 de agosto, con una distribución muy desequilibrada: el domingo no produjo ninguna publicación oficial y casi todo el material está fechado el lunes. La caída de X señalada en la edición del día 30 quedó subsanada: las cuentas que permanecieron inaccesibles aquel día se revisaron durante tres jornadas, sin que apareciera ningún anuncio omitido.
Se perfilan tres ejes. En primer lugar, un modelo inédito: el primer modelo del mundo de interfaces de Runway. A continuación, dos hitos económicos: el ritmo de ingresos anualizado de 1.000 millones de dólares alcanzado por la plataforma publicitaria de OpenAI y un contrato de infraestructura de 250 MW firmado por Together AI. Por último, un ciclo de herramientas para desarrolladores en GitHub, NVIDIA y Amp, complementado por tres trabajos de investigación publicados en el blog comunitario de Hugging Face.
Runway lanza Solaris, su primer modelo del mundo de interfaces
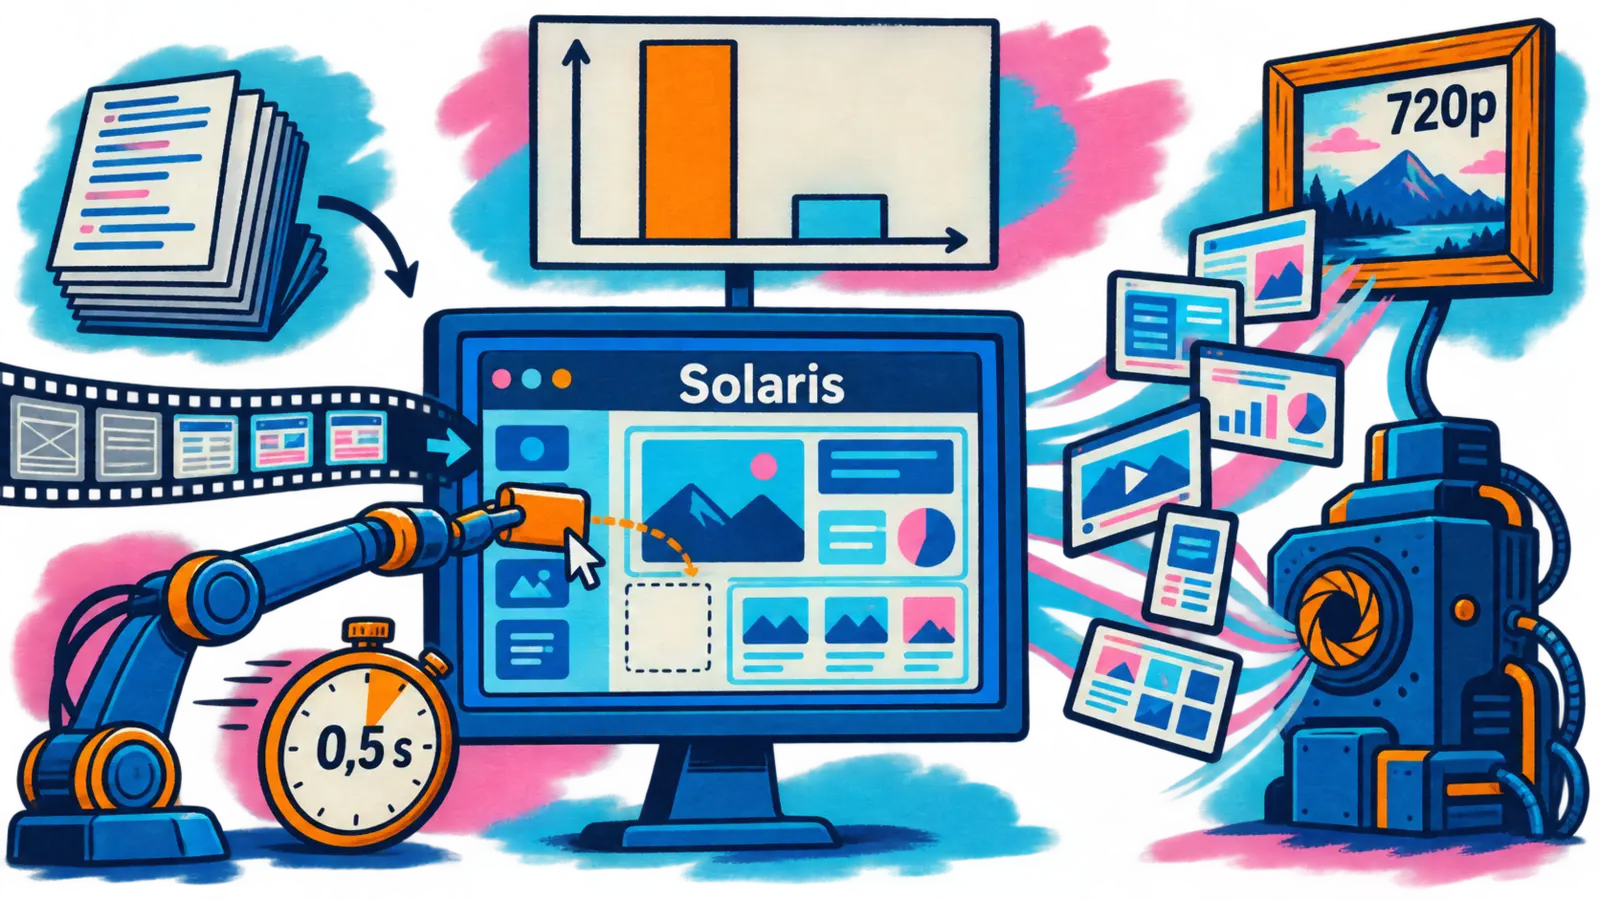
31 de agosto — Runway ha presentado Solaris, el primer modelo de una familia que el laboratorio denomina modelos del mundo de interfaces (Interface World Models). El principio se resume en una frase: en lugar de producir código que luego mostrará una interfaz, el modelo genera directamente la interfaz, imagen por imagen, y reacciona en tiempo real a los clics y a las acciones de arrastrar y soltar.
El razonamiento parte de una observación sobre la cadena de producción de software. Primero hay que traducir una maqueta a código antes de que pueda hacer nada, y esa traducción tiene un doble coste: cada comportamiento debe definirse de antemano, de modo que el software queda fijado antes de la llegada del primer usuario, y la riqueza visual del diseño original se pierde por el camino. Solaris elimina la etapa intermedia y la imagen completa se convierte en la interfaz.
Técnicamente, el modelo se basa en Gen-4.5, el modelo de vídeo de Runway, y prolonga GWM-1, su modelo del mundo de propósito general. Las entradas del usuario condicionan la siguiente imagen del mismo modo que un texto o una imagen, por lo que el vínculo entre una acción y su resultado visual se aprende sin programar ningún comportamiento. El paso al tiempo real requirió tres etapas: hacer que la generación fuera autorregresiva imagen por imagen, destilar la eliminación de ruido de múltiples etapas en unas pocas etapas y, a continuación, entrenar el modelo rápido con sus propias salidas. Un LLM decide la evolución de la escena mientras el modelo del mundo realiza el renderizado.
| Criterio evaluado por los participantes | Solaris | Interfaz codificada (Claude Opus 5) | Evaluaciones equivalentes |
|---|---|---|---|
| Cumplimiento de la instrucción solicitada | 61 % | 24 % | 13 % |
| Naturalidad del comportamiento en la escena | 71 % | 21 % | 6 % |
| Característica técnica | Valor medido |
|---|---|
| Modelo base | Gen-4.5, como continuación de GWM-1 |
| Resolución mantenida | 720p |
| Umbral de interactividad | aproximadamente 0,5 s de latencia |
| Estudio con usuarios | 250 participantes, 30 ejemplos, cerca de 7.500 evaluaciones por pares |
| Benchmark de reconstrucción | 30 interfaces, similitud estructural (SSIM) y descriptores DINOv3 |
La diferencia es claramente más marcada en la naturalidad del comportamiento que en el mero cumplimiento de la instrucción, y Runway considera que ahí reside la diferencia fundamental entre ambos enfoques: una interfaz codificada suele saber reproducir el cambio solicitado, pero lo trata como una actualización aislada, mientras que un modelo que ha aprendido el comportamiento de los objetos produce una reacción coherente con el resto de la escena. El laboratorio propone un segundo uso, menos esperado: el entrenamiento de agentes, a los que un entorno que se regenera continuamente ofrecería interfaces en constante cambio, incluidos diseños que nunca antes hayan existido.
Runway también documenta lo que Solaris todavía no sabe hacer, y la lista es considerable: el texto estable y legible sigue siendo uno de los problemas más difíciles de la generación de vídeo, pese a que las interfaces dependen de él más que cualquier otro ámbito; el anclaje factual exige condicionar la generación a datos verificados; la coherencia durante sesiones largas sigue siendo un campo de investigación; y una interfaz generada aún debe funcionar con las tecnologías de asistencia y las API de accesibilidad. El lanzamiento público se está preparando con varios socios y el acceso anticipado se solicita mediante un formulario.
Today, we’re sharing new research on Solaris, our first Interface World Model. Solaris is a new kind of operating system that generates interactive interfaces frame by frame, in real time, with no code.
🇪🇸 Hoy compartimos nuevos trabajos de investigación sobre Solaris, nuestro primer Interface World Model. Solaris es un nuevo tipo de sistema operativo que genera interfaces interactivas imagen por imagen, en tiempo real y sin código. — @runwayml en X
🔗 Runway — Presentación de Solaris
ChatGPT Ads alcanza un ritmo de ingresos anualizado de 1.000 millones de dólares y abre su autoservicio en cuatro nuevas regiones
31 de agosto — OpenAI ha publicado una entrada dedicada a ChatGPT Ads, su plataforma publicitaria integrada en ChatGPT, y anuncia que la plataforma alcanzó un ritmo de ingresos anualizado (annualized revenue run rate) de 1.000 millones de dólares menos de 200 días después de su lanzamiento. Conviene aclarar de entrada este matiz: no se trata de 1.000 millones ya ingresados, sino de los ingresos del periodo reciente proyectados a doce meses. Por definición, una plataforma publicitaria que no lleva ni doscientos días operativa no puede haber ingresado un año completo a ese ritmo. La apertura de la compra mediante autoservicio a través de Ads Manager en India, Europa, Oriente Medio y el norte de África está anunciada para más tarde ese mismo día.
OpenAI presenta la publicidad como uno de los pilares de su modelo económico, junto con las suscripciones para el público general, las ofertas empresariales y las API facturadas según el uso, y la vincula explícitamente con la financiación del nivel gratuito que mantiene ChatGPT accesible para más de 1.000 millones de usuarios activos semanales. El sistema se rige por cuatro compromisos: los anuncios siempre están claramente identificados y separados de las respuestas, la publicidad no influye en las respuestas proporcionadas, los anunciantes no tienen acceso a las conversaciones privadas y el usuario controla el grado de personalización de su experiencia publicitaria.
| Métrica publicada por OpenAI | Valor anunciado |
|---|---|
| Ritmo de ingresos anualizado (proyección) | 1.000 millones de dólares |
| Tiempo transcurrido desde el lanzamiento | menos de 200 días |
| Anunciantes en la plataforma | decenas de miles |
| Países ya cubiertos | más de 40 |
| Nuevos mercados abiertos al autoservicio | India, Europa, Oriente Medio, norte de África |
| Socios tecnológicos y de medición | más de 50 |
| Usuarios activos semanales de ChatGPT | más de 1.000 millones |
| Retorno de la inversión publicitaria en 28 días | 3x, para un anunciante de comercio electrónico |
| Tráfico publicitario procedente de nuevos clientes | más del 80 %, para un socio tecnológico |
La trayectoria descrita es la de una transición de la venta gestionada a una plataforma de libre acceso. El modelo inicial se apoyaba en agencias y socios; la llegada de Ads Manager en mayo abrió la plataforma publicitaria a las pequeñas y medianas empresas, que ya representan una parte significativa de la actividad. En cuanto a las herramientas, las pujas de CPC y las pujas optimizadas para resultados (outcome-optimized bidding) constituyen la mayoría de las campañas, mientras que Pixel y la API Conversions sirven de base para la medición. OpenAI también señala que los anunciantes de fuera de Estados Unidos representan una proporción creciente de los ingresos.
De cara al futuro, la empresa anuncia nuevos mercados, formatos, objetivos y opciones de compra, y afirma que quiere explorar maneras más nativas de que las empresas interactúen con los consumidores dentro de ChatGPT; es decir, formatos menos separados de la conversación que los anuncios actuales.
🔗 OpenAI — Un hito en la ampliación del acceso a la IA
Together AI: 250 MW en Arabia Saudí, GLM-5.3 encabeza el índice de agentes y un nuevo cliente
31 de agosto — Together AI ha anunciado la firma de un acuerdo de infraestructura para un centro de datos de 250 MW en Arabia Saudí, construido con HUMAIN. El laboratorio espera que la actividad de este centro genere ingresos de 5.000 millones de dólares anuales y presenta la operación como uno de los mayores acuerdos de infraestructura de IA cerrados para el open source. El mensaje se fijó en la cuenta del laboratorio, lo que lo distingue de sus comunicaciones habituales sobre modelos.
La cifra requiere cautela al interpretarla, porque el mensaje del anuncio yuxtapone tres fragmentos sin verbo y deja ambiguo a qué corresponden los 5.000 millones. La cobertura del New York Times resuelve la cuestión: la suma describe los ingresos previstos de este centro de datos, no los de la empresa. La magnitud lo confirma, ya que el mismo artículo sitúa la valoración de Together AI en 8.300 millones de dólares en julio de 2026: una empresa valorada a ese nivel no factura 5.000 millones al año.
La propia estructura del acuerdo merece atención, porque no se trata de una compra de capacidad. También según el New York Times, HUMAIN aporta 120.000 semiconductores además de los 250 MW, y Together AI opera esos chips a cambio de entregarle una parte de sus ingresos. Por tanto, el laboratorio no financia la infraestructura: la utiliza a cambio de una fracción de su facturación. Eso es exactamente lo que sostiene el hilo al contraponer los acuerdos que permiten acceder a capacidad de cómputo con una carrera en la que cada empresa tendría que recaudar sus propios miles de millones. HUMAIN, creada el año pasado por iniciativa del príncipe heredero Mohammed bin Salman, forma parte del esfuerzo saudí por construir una industria de IA y reducir la dependencia del país respecto al petróleo.
El argumento desarrollado en el hilo se centra menos en el volumen que en la naturaleza del obstáculo. Together AI describe la energía como el verdadero cuello de botella del momento y el acuerdo como una forma de acceder a una escala que una empresa de su tamaño no podría financiar con su propio balance. El laboratorio contrapone explícitamente esta estructura al modelo de los laboratorios cerrados, cuya infraestructura ha sido financiada durante mucho tiempo por los hyperscalers.
Esta interpretación aclara la posición particular de Together AI en el ecosistema: el laboratorio no publica modelos de frontera, sino que presta servicio para los de otros —DeepSeek, GLM, Kimi, MiniMax, Nemotron—. Por tanto, su limitación no es la investigación, sino la capacidad de cómputo disponible para servir modelos de pesos abiertos por debajo del precio de las API propietarias. Un contrato de 250 MW responde directamente a esa necesidad.
| Elemento del acuerdo | Valor comunicado |
|---|---|
| Capacidad del centro de datos | 250 MW |
| Semiconductores suministrados por HUMAIN | 120.000 |
| Ingresos anuales previstos del centro | 5.000 millones de dólares |
| Contrapartida abonada a HUMAIN | una parte de los ingresos de Together AI |
| Valoración de Together AI en julio de 2026 | 8.300 millones de dólares |
| Socio industrial | HUMAIN |
| Ubicación | Arabia Saudí |
| Fecha y hora del anuncio | 31 de agosto de 2026, 13:26 UTC |
Un último punto que Together AI no comenta en su hilo: el mismo artículo señala que la implantación en Arabia Saudí permite eludir la oposición encontrada en Estados Unidos a la instalación de centros de datos.
We just signed one of the largest AI infrastructure deals for open source, period. 250MW data center. $5B+ in annualized revenue. Built with @HUMAIN in Saudi Arabia.
🇪🇸 Acabamos de firmar uno de los mayores acuerdos de infraestructura de IA para el open source, y punto. Centro de datos de 250 MW. Más de 5.000 millones de dólares de ingresos anualizados. Construido con @HUMAIN en Arabia Saudí. — @togethercompute en X
GLM-5.3 alcanza el primer puesto del índice de agentes de Artificial Analysis
31 de agosto — Sexto día consecutivo en el que GLM-5.3 es noticia: tras la publicación de los pesos por parte de Z.ai el 28 de agosto y la disponibilidad del modelo en la API serverless de Together AI el día 29, esta vez es un ranking externo el que lo destaca. En el índice de agentes de Artificial Analysis, el modelo alcanza 59 puntos. Together AI formula el resultado con precisión: GLM-5.3 empata en el primer puesto (ties for the top spot) y supera (beating) a GPT-5.6 Sol y Claude Fable 5. Por tanto, el adelantamiento se refiere a esos dos modelos; con Claude Opus 5, que también obtiene 59 puntos, GLM-5.3 comparte el liderato.
El aspecto más instructivo reside en el método. Z.ai no entrenó un nuevo modelo base: conservó la base GLM-5.2 y toda la mejora procede del post-entrenamiento, ampliado simultáneamente en tres ejes: más entornos de horizonte largo, una mayor diversidad de tareas y más compute dedicado al RL.
| Modelo evaluado | Puntuación en el índice de agentes |
|---|---|
| GLM-5.3 (max) | 59 |
| Claude Opus 5 (max) | 59 |
| GLM-5.3 Flash | 58 |
| GPT-5.6 Sol (max) | 58 |
| Claude Fable 5 (con repliegue) | 57 |
Greptile elige Together AI como principal proveedor de inferencia
31 de agosto — Última señal del día, más modesta: Greptile, una herramienta de revisión de código mediante IA utilizada por más de 11.000 equipos, ha elegido Together AI como su principal proveedor de inferencia. La herramienta analiza las pull requests con el contexto completo del repositorio, un perfil de carga compuesto por contextos largos y grandes volúmenes de tokens: exactamente el tipo de uso en el que la diferencia de coste entre los modelos de pesos abiertos y las API propietarias se vuelve decisiva.
GitHub Copilot en VS Code: cuatro versiones de agosto resumidas en un changelog
31 de agosto — GitHub publica el resumen de agosto de 2026 de Copilot en Visual Studio Code, que abarca cuatro versiones del editor, de la v1.132 a la v1.135. El hilo conductor del ciclo es la organización del trabajo con varios agentes: la ventana Agents deja de ser una simple lista de conversaciones para convertirse en un espacio donde varias sesiones coexisten y se recuperan en el mismo estado.
En cuanto a las sesiones, los chats se organizan uno al lado del otro en grupos horizontales o verticales y la disposición se restaura al volver. El comando /btw abre una conversación lateral que comparte el contexto y la caché del prompt de la conversación principal mientras esta continúa ejecutándose: así se puede formular una pregunta secundaria sin interrumpir a un agente en ejecución. Un control de cronología de los prompts, accesible desde el margen del transcript, permite saltar directamente a un prompt y revisar las modificaciones de archivos resultantes. Agent Host permite que varias ventanas de VS Code se conecten a la misma sesión, y un comando experimental /rubber-duck solicita a un modelo complementario que saque a la luz los detalles omitidos y los casos límite.
Dos puntos afectan directamente al lugar de Claude en el editor: un ajuste experimental abre la ventana Agents sin iniciar sesión en GitHub cuando Claude está configurado con una clave API, y las sesiones de Claude permiten cambiar en cualquier momento entre los modelos de la suscripción de Anthropic y los de la suscripción de Copilot. VS Code también permite instalar plugins de agentes portátiles compatibles con el estándar Agent Plugins 1.0, que pueden utilizarse en otros clientes de agentes compatibles.
| Área del changelog | Novedades destacadas |
|---|---|
| Sesiones y workflows | Chats en paralelo, /btw, cronología de prompts, Agent Plugins 1.0, /rubber-duck, Agent Host |
| Claude en VS Code | Ventana Agents sin iniciar sesión en GitHub mediante clave API, cambio entre modelos Anthropic y Copilot |
| Chat y revisión | Búsqueda en el transcript, desplazamiento fijo, editor Markdown híbrido, tokens por modelo |
| Navegador integrado | Anotación por lotes de elementos HTML, recarga automática, editor HTML predeterminado |
| Dictado | Multilingüe en el dispositivo, instrucciones de limpieza, limpieza adaptada al shell |
Por último, el chat incorpora las herramientas de lectura que exigían unas conversaciones cada vez más largas: búsqueda de texto en todo el transcript con distinción entre mayúsculas y minúsculas, palabras completas y expresiones regulares; desplazamiento fijo que mantiene visible el prompt actual; y visualización del consumo de tokens por modelo al pasar el cursor sobre el pie de la respuesta, distinguiendo entre entrada, entrada en caché y salida, una visibilidad útil desde que la facturación depende de la caché. El navegador integrado permite seleccionar y anotar varios elementos HTML de una página para procesar por lotes los comentarios sobre la interfaz, y el dictado se ejecuta en el dispositivo, en varios idiomas, preservando la sintaxis de los comandos cuando se dicta en un terminal en lugar de insertar la puntuación pronunciada.
🔗 GitHub Changelog — Copilot en VS Code, versiones de agosto de 2026
NVIDIA incorpora sus componentes de software a la biología y al vehículo autónomo
31 de agosto — NVIDIA ha publicado un tutorial que documenta un trabajo de integración realizado con Anthropic: BioNeMo Agent Toolkit ya puede utilizarse desde Claude Science, el entorno de investigación científica de Anthropic. El problema abordado es el de las herramientas especializadas: un agente generalista puede reconocer que una tarea requiere plegar una proteína sin saber necesariamente qué modelo ejecutar, cómo dar formato a la solicitud ni qué parámetros son importantes. El toolkit empaqueta más de una década de modelos, bibliotecas y workflows de BioNeMo —biología, química, genómica y descubrimiento de fármacos— en skills que un agente puede invocar. En sus benchmarks internos, NVIDIA anuncia que la precisión de las tareas pasa del 60 al 100 % y que la eficiencia en tokens prácticamente se duplica.
El tutorial encadena tres microservicios NIM: MSA Search para construir el contexto evolutivo, seguido de OpenFold3 y Boltz-2 para predecir la estructura de manera independiente. La demostración más reveladora se centra en el papel del alineamiento múltiple de secuencias: sin él, la confianza de la interfaz se desploma en ambos modelos, y ni siquiera un presupuesto de muestreo más generoso cambia el resultado. Cabe señalar dos reservas: la barrera del hardware, con una GPU L40S o H100 y unos 700 GB de almacenamiento, y la cautela interpretativa expresada por NVIDIA, que recuerda que una puntuación de confianza no demuestra una interacción y presenta la convergencia de dos modelos independientes como una hipótesis sólida, no como una prueba.
| Medida de confianza de la interfaz (iPTM) | OpenFold3 | Boltz-2 |
|---|---|---|
| Heterómero con alineamiento MSA | 0,85 | 0,82 |
| Heterómero sin alineamiento MSA | 0,14 | 0,19 |
| RMSD Cα del núcleo, monómero frente a heterómero | 0,68 Å | 0,65 Å |
🔗 Tutorial de NVIDIA — BioNeMo NIM en Claude Science
Omniverse NuRec adapta una pila de percepción a un vehículo que aún no existe
31 de agosto — Ese mismo día, NVIDIA publica un segundo tutorial técnico, dedicado esta vez a la conducción autónoma. El punto de partida es que una pila de percepción está determinada por el vehículo que la lleva: al trasladarla de un SUV a un sedán, deja de percibir el mundo de la misma manera, ya que cambian la posición de los sensores, la calibración, los campos de visión, las oclusiones y la geometría de la carrocería. Recopilar y anotar un conjunto de datos reales para cada línea de vehículos es costoso y a menudo resulta imposible al inicio del desarrollo.
Omniverse NuRec propone reutilizar los trayectos ya registrados: reconstruye cada escena y después la reproduce desde la configuración de sensores del vehículo de destino. De este modo, los equipos pueden saber cómo se vería un escenario desde la nueva disposición de cámaras y dónde los cambios de geometría crean puntos ciegos. NVIDIA aclara que los datos de conducción reales siguen siendo indispensables para fundamentar y validar el rendimiento: los datos sintéticos sirven para adaptar los modelos antes de que exista un conjunto de datos específico, no para sustituirlo. Las escenas se distribuyen en Hugging Face en formato USDZ, acompañadas de un repositorio de skills destinado a los agentes de código.
🔗 Tutorial de NVIDIA — Omniverse NuRec
Amp vincula una sala de llamadas de audio y vídeo a cada thread
31 de agosto — Amp vincula una sala de conversación en directo a cada thread. La función, denominada Space to Talk, abre un espacio de audio y vídeo asociado al propio thread: basta con pulsar la tecla Intro para entrar, activar la cámara y compartir la pantalla, mientras el agente continúa trabajando en el mismo hilo.
El argumento destacado es la eliminación de los pasos intermedios, y esta lógica prolonga la trayectoria colaborativa seguida por Amp desde el verano: control compartido de un orb entre compañeros de equipo (Multiplayer, 22 de julio), seguido de la invitación mediante una mención directamente en un thread (Pass the Orb to the Left Hand Side, 19 de agosto). El thread se convierte en el único punto de encuentro del equipo y del agente. Amp también reconoce que el alcance sigue abierto: el brainstorming, la pizarra o la conversación con Puck y otros agentes se mencionan como posibles vías futuras, no como funciones ya disponibles.
No links to paste, no calendar invite, no other app. The call lives where the work lives.
🇪🇸 Ningún enlace que pegar, ninguna invitación de calendario, ninguna otra aplicación. La llamada tiene lugar allí donde está el trabajo. — Amp, nota Space to Talk
VLANeXt, una base de código unificada para los modelos visión-lenguaje-acción
31 de agosto — Un equipo publica en el blog de Hugging Face VLANeXt, una base de código de investigación dedicada a los modelos visión-lenguaje-acción (vision-language-action, VLA). El principio de estos modelos es sencillo: un modelo visión-lenguaje relaciona lo que ve el robot con una instrucción en lenguaje natural y, a partir de ello, deriva una acción en el mundo físico.
El problema abordado es metodológico. El campo avanza con rapidez, pero se fragmenta: de una publicación a otra cambian el backbone, la cabeza de política, la representación de las acciones, la estrategia de entrenamiento y el protocolo de evaluación. Los resultados se presentan ampliamente como sólidos, pero sigue siendo difícil determinar qué hace que un modelo VLA sea realmente eficaz, porque no es posible aislar las variables.
En lugar de añadir otra arquitectura, los autores partieron de una base de referencia del tipo RT-2 / OpenVLA y exploraron metódicamente el espacio de diseño para extraer una receta, un trabajo que dio lugar al artículo de ICML «VLANeXt: Recipes for Building Strong VLA Models». Desde entonces, la base de código se ha ampliado más allá de este estudio para incluir backbones de varios tamaños, aprendizaje de acciones latentes, modelado predictivo en el espacio latente y modelado mundo-acción. Proporciona seis puntos de partida: VLANeXt-LAM, -S, -L, -XL, -JEPA y -WAM.
Breves
- Claude Code 2.1.252, una versión exclusivamente correctiva — Cuatro correcciones y ninguna novedad: comandos Bash que fallaban en algunos Mac, la opción «always allow» que no se guardaba en un proyecto sin archivo
.claude/settings.local.json, sesiones de Remote Control bloqueadas durante varios minutos después de que finalizara una herramienta cuando la conexión con claude.ai se degradaba, y notificaciones de tareas en segundo plano con una salida voluminosa que hacían superar el límite de tamaño de las solicitudes API. 🔗 CHANGELOG de Claude Code - Flow habilita el control de la primera y la última imagen en el escritorio — Google Flow indica que el control de la primera y la última imagen de Gemini Omni 1.1 Flash, presentado junto con el modelo el 27 de agosto, ya está disponible en el escritorio. El uso destacado consiste en proporcionar la misma imagen en ambos extremos para producir un bucle. 🔗 Mensaje de @FlowbyGoogle
- Último día para competir por el premio Grok Imagine — xAI recordó que el plazo del concurso de vídeo lanzado el 17 de agosto vencía ese mismo día. Los participantes debían producir una escena extraída de La Odisea de Homero que destacara las capacidades de vídeo y voz del modelo; las tres mejores obras se reparten 175 000 dólares, con premios de 100 000, 50 000 y 25 000 dólares, respectivamente. 🔗 Mensaje de @grok
- QwenCloud cierra su Arena y anuncia una sesión en Bangkok — El challenge Qwen Cloud Arena, dedicado a los agentes de generación de contenido para el comercio electrónico transfronterizo, cerró las inscripciones a medianoche, hora de Pekín, después de reunir a más de 800 participantes; la fase de revisión comenzó al día siguiente. Unas horas antes, QwenCloud había anunciado una sesión en la Qwen Conference de Bangkok del 4 de septiembre, con el mismo posicionamiento basado en tres puntos de acceso —sitio web, Skills y CLI— que ya había presentado en Hong Kong. 🔗 Cierre de la Arena · 🔗 Sesión de Bangkok
- GitHub abre una encuesta sobre las adaptaciones de accesibilidad de los desarrolladores — La empresa quiere documentar las herramientas, los ajustes del producto y las adaptaciones personales que permiten trabajar en buenas condiciones, sin exigir que los participantes declaren tener una discapacidad ni que se consideren usuarios de herramientas de accesibilidad. Se aceptan respuestas hasta el 30 de septiembre. Tema no relacionado con la IA. 🔗 Mensaje de @github
- otoSpeech Task, un corpus full-duplex publicado junto con su tarea — Veinte horas de conversación en inglés con dos hablantes, 58 sesiones sobre siete tareas colaborativas y 11 025 eventos con marca de tiempo, bajo licencia CC BY 4.0. La particularidad es que las imágenes vistas por cada hablante, sus acciones y las respuestas de referencia figuran en la misma línea de tiempo que el audio. 🔗 Artículo en Hugging Face
- YOLO26-RGB, un modelo para eliminar la lluvia derivado de una cabeza de profundidad — Dos modelos de eliminación de lluvia obtenidos al sustituir la cabeza de profundidad de 1 canal de YOLO26-depth por una cabeza de restauración RGB de 3 canales: 5,25 M de parámetros a unas 109 imágenes/s en 1080p, y 12,13 M a unas 92 imágenes/s para obtener 0,1 dB más de calidad. 🔗 Artículo en Hugging Face
Qué significa
Generar la interfaz en lugar del código que la produce. Solaris desplaza la frontera entre diseño y ejecución. Toda la cadena de software actual se basa en una traducción —una maqueta se convierte en código, el código produce una visualización— y Runway mide el coste de esa traducción: en 30 interfaces que debían reconstruirse a partir de una captura de pantalla, todos los modelos multimodales probados pierden información, y la degradación se acentúa con la riqueza visual. Eliminar el paso intermedio es una propuesta radical, y las limitaciones que el propio laboratorio enumera muestran dónde tropieza: texto que no se mantiene en su sitio, ninguna garantía de anclaje factual y una accesibilidad que debe construirse por completo, puesto que una imagen generada no expone ninguna estructura a los lectores de pantalla. Son obstáculos fundamentales, no simples acabados.
Dos formas de pagar el cómputo, anunciadas el mismo día. OpenAI presenta para su negocio publicitario un ritmo de ingresos anualizado de mil millones de dólares —una proyección a doce meses, no ingresos ya percibidos— y lo asume como un pilar económico al mismo nivel que las suscripciones: la publicidad financia el nivel gratuito de un servicio que afirma tener más de mil millones de usuarios semanales. Together AI, por su parte, no monetiza una audiencia ni compra más capacidad: obtiene 250 MW y 120 000 chips en Arabia Saudí a cambio de una parte de sus ingresos, señalando la energía como el verdadero cuello de botella del sector. Ambas empresas responden a la misma limitación desde extremos opuestos de la cadena, y ninguna de las dos respuestas es neutral: una inserta un interés comercial en el producto; la otra traslada la infraestructura allí donde encuentra menos resistencia política.
La competición de agentes se disputa ahora después del preentrenamiento. El resultado de GLM-5.3 en el índice de agentes de Artificial Analysis destaca sobre todo por cómo se obtuvo: Z.ai conservó la base GLM-5.2 y solo amplió el postentrenamiento —entornos de horizonte largo, diversidad de tareas, cómputo de RL—. Si alcanzar la cabeza de una clasificación de agentes ya no exige volver a entrenar una base, entonces la partida de costes más pesada deja de ser el único factor determinante de la clasificación, y el ciclo de actualización de un modelo se acorta en la misma medida. También es la explicación más económica de la secuencia de seis días que vivió este modelo, desde los pesos abiertos el día 28 hasta esta clasificación el 31.
Las herramientas para desarrolladores se están reorganizando en torno a varios agentes simultáneos. El changelog de Copilot dedica un ciclo entero a tratar la ventana Agents como un espacio de trabajo —chats en paralelo, conversación lateral que comparte la caché de prompts, cronología de prompts, varias ventanas conectadas a una misma sesión— y ya no como una lista de conversaciones. Amp vincula una sala de llamadas al thread para que la conversación humana tenga lugar allí donde trabaja el agente. NVIDIA, por último, empaqueta diez años de bibliotecas científicas como skills invocables y publica un segundo repositorio de skills para reconstruir escenas de conducción. Tres actores muy diferentes convergen en la misma idea: lo que le falta al agente ya no es la capacidad del modelo, sino el contexto compartido y las herramientas especializadas que se le pueden proporcionar.
Fuentes
- Runway — Presentación de Solaris
- Runway — anuncio de Solaris en X
- OpenAI — Un hito en la ampliación del acceso a la IA
- Together AI — acuerdo de infraestructura de 250 MW con HUMAIN
- Together AI — GLM-5.3 en el índice de agentes de Artificial Analysis
- Together AI — Greptile como proveedor principal de inferencia
- GitHub Changelog — Copilot en VS Code, versiones de agosto de 2026
- NVIDIA — BioNeMo NIM para la predicción de estructuras proteicas en Claude Science
- NVIDIA — Omniverse NuRec y la percepción multivehículo
- Amp — Espacio para hablar
- VLANeXt, base de código unificada para modelos de visión-lenguaje-acción
- CHANGELOG de Claude Code
- Google Flow — primera y última imágenes en escritorio
- xAI — último día del concurso Grok Imagine
- QwenCloud — cierre de Qwen Cloud Arena
- QwenCloud — sesión en la Qwen Conference de Bangkok
- GitHub — encuesta sobre herramientas y adaptaciones de accesibilidad
- otoSpeech Task, corpus de conversaciones full-duplex
- YOLO26-RGB, modelo de eliminación de lluvia