ai-powered-markdown-translatorArtikel vertaald van fr naar nl met gpt-5.6-sol.
Achttien aankondigingen voor 30 en 31 augustus, met een zeer onevenwichtige verdeling: op zondag verscheen geen enkele officiële publicatie en vrijwel al het materiaal dateert van maandag. De in de editie van de 30e gemelde storing van X is ingehaald: de accounts die die dag ontoegankelijk bleven, zijn over een periode van drie dagen opnieuw doorgenomen, zonder dat daarbij een ontbrekende aankondiging aan het licht kwam.
Er tekenen zich drie hoofdlijnen af. Allereerst een ongekend model, met Runways eerste interfacewereldmodel. Vervolgens twee economische mijlpalen: het geannualiseerde omzettempo van één miljard dollar dat OpenAI’s advertentieplatform heeft bereikt, en een infrastructuurcontract van 250 MW dat Together AI heeft getekend. Tot slot een cyclus van ontwikkelaarstools bij GitHub, NVIDIA en Amp, aangevuld met drie onderzoeksprojecten die op de communityblog van Hugging Face zijn gepubliceerd.
Runway lanceert Solaris, zijn eerste interfacewereldmodel
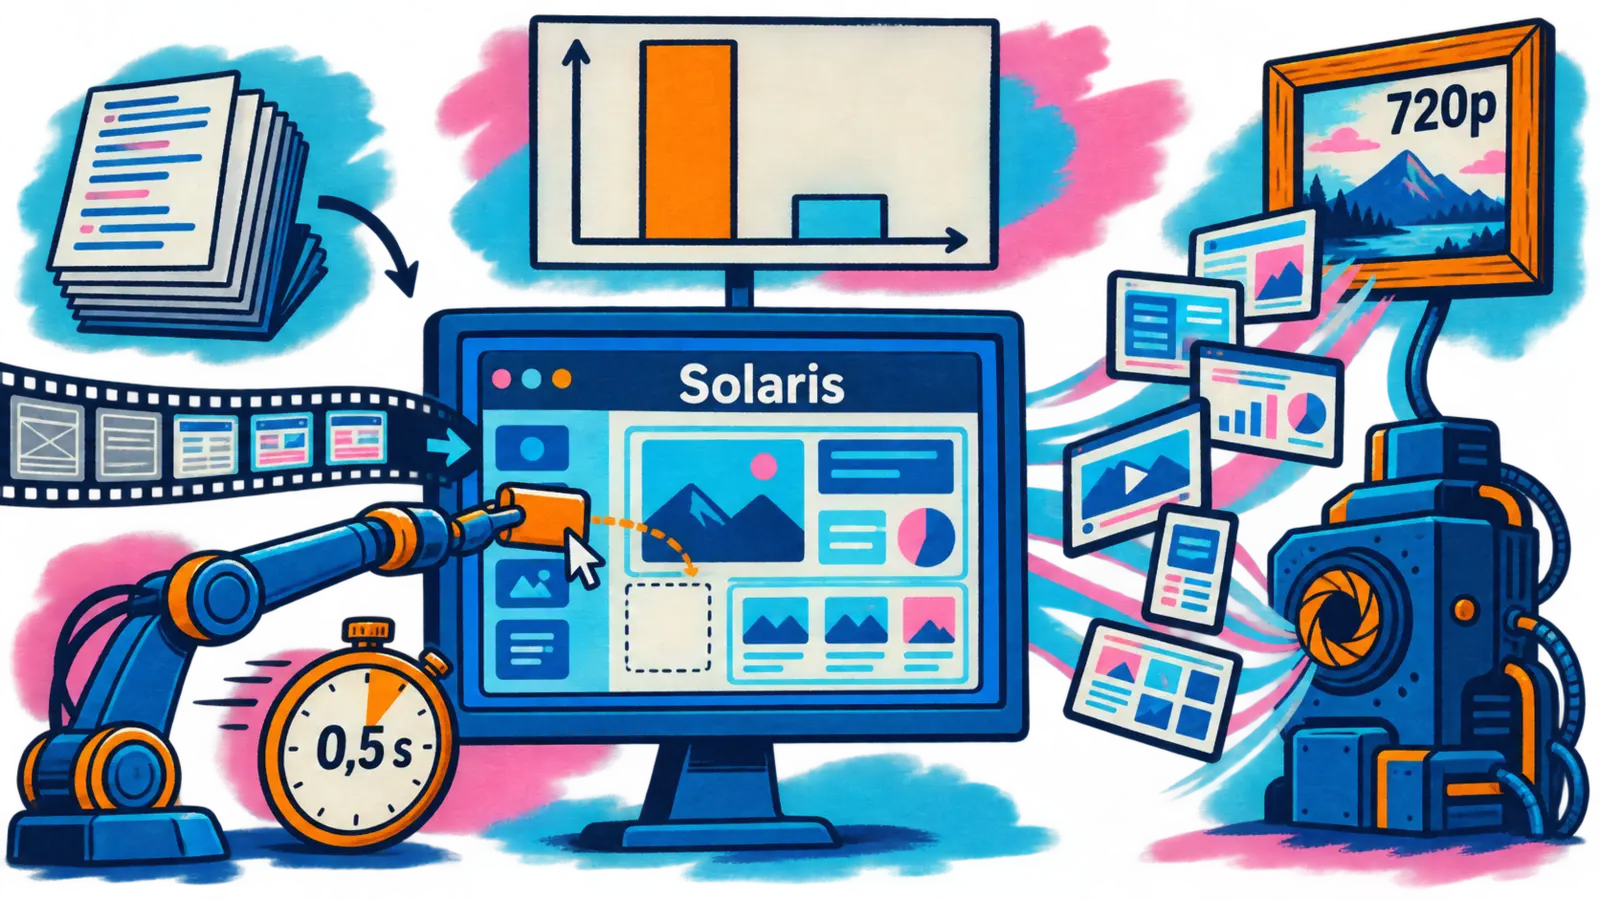
31 augustus — Runway heeft Solaris gepresenteerd, het eerste model van een familie die het laboratorium interfacewereldmodellen (Interface World Models) noemt. Het principe kan in één zin worden samengevat: in plaats van code te produceren die vervolgens een interface weergeeft, genereert het model rechtstreeks de interface, beeld voor beeld, en reageert het in realtime op klikken en slepen.
De redenering vertrekt vanuit een vaststelling over de softwareproductieketen. Een ontwerp moet eerst in code worden vertaald voordat het iets kan doen, en die vertaling brengt twee kosten met zich mee: elk gedrag moet vooraf worden gedefinieerd, waardoor de software al vastligt voordat de eerste gebruiker arriveert, en de visuele rijkdom van het oorspronkelijke ontwerp gaat onderweg verloren. Solaris schrapt de tussenstap, waardoor het volledige beeld de interface wordt.
Technisch steunt het model op Gen-4.5, Runways videomodel, en bouwt het voort op GWM-1, zijn algemene wereldmodel. De invoer van de gebruiker bepaalt het volgende beeld op dezelfde manier als tekst of een afbeelding, waardoor het verband tussen een actie en het visuele resultaat ervan wordt aangeleerd zonder dat enig gedrag wordt geprogrammeerd. De overgang naar realtime vereiste drie stappen: de generatie beeld voor beeld autoregressief maken, het uit meerdere stappen bestaande ontruisingsproces distilleren tot enkele stappen en vervolgens het snelle model trainen op zijn eigen uitvoer. Een LLM bepaalt hoe de scène zich ontwikkelt, terwijl het wereldmodel de rendering uitvoert.
| Door de deelnemers beoordeeld criterium | Solaris | Gecodeerde interface (Claude Opus 5) | Gelijkwaardige beoordelingen |
|---|---|---|---|
| Naleving van de gevraagde instructie | 61 % | 24 % | 13 % |
| Natuurlijk gedrag binnen de scène | 71 % | 21 % | 6 % |
| Technisch kenmerk | Gemeten waarde |
|---|---|
| Basismodel | Gen-4.5, voortbouwend op GWM-1 |
| Behaalde resolutie | 720p |
| Interactiviteitsdrempel | ongeveer 0,5 s latentie |
| Gebruikersonderzoek | 250 deelnemers, 30 voorbeelden, bijna 7.500 paarsgewijze beoordelingen |
| Reconstructiebenchmark | 30 interfaces, structurele gelijkenis (SSIM) en DINOv3-descriptoren |
Het verschil is aanzienlijk groter bij de natuurlijkheid van het gedrag dan bij de eenvoudige naleving van de instructie, en Runway ziet daarin het fundamentele onderscheid tussen beide benaderingen: een gecodeerde interface kan de gevraagde wijziging vaak reproduceren, maar behandelt die als een geïsoleerde update, terwijl een model dat het gedrag van objecten heeft geleerd een reactie produceert die samenhangt met de rest van de scène. Het laboratorium noemt een tweede, minder voor de hand liggende toepassing: het trainen van agents, waaraan een omgeving die zichzelf voortdurend regenereert steeds veranderende interfaces zou bieden, inclusief lay-outs die nooit eerder hebben bestaan.
Runway documenteert ook wat Solaris nog niet kan, en de lijst is aanzienlijk: stabiele en leesbare tekst blijft een van de moeilijkste problemen bij videogeneratie, terwijl interfaces daar sterker van afhankelijk zijn dan welk ander domein ook; feitelijke verankering vereist dat de generatie wordt geconditioneerd op geverifieerde gegevens; consistentie tijdens lange sessies blijft onderwerp van onderzoek; en een gegenereerde interface moet nog steeds kunnen werken met ondersteunende technologieën en toegankelijkheids-API’s. De publieke lancering wordt samen met partners voorbereid; vroege toegang verloopt via een formulier.
Today, we’re sharing new research on Solaris, our first Interface World Model. Solaris is a new kind of operating system that generates interactive interfaces frame by frame, in real time, with no code.
🇳🇱 Vandaag delen we nieuw onderzoek naar Solaris, ons eerste Interface World Model. Solaris is een nieuw type besturingssysteem dat in realtime, beeld voor beeld, interactieve interfaces zonder code genereert. — @runwayml op X
🔗 Runway — Introductie van Solaris
ChatGPT Ads bereikt een geannualiseerd omzettempo van één miljard dollar en opent zijn selfserviceplatform in vier nieuwe regio’s
31 augustus — OpenAI heeft een bericht gepubliceerd over ChatGPT Ads, zijn in ChatGPT geïntegreerde advertentieplatform, en meldt dat het platform minder dan 200 dagen na de lancering een geannualiseerd omzettempo (annualized revenue run rate) van één miljard dollar heeft bereikt. Die nuance moet meteen worden benadrukt: het gaat niet om één miljard aan ontvangen inkomsten, maar om de omzet van de recente periode, geëxtrapoleerd naar twaalf maanden. Een advertentieplatform dat nog geen tweehonderd dagen bestaat, kan per definitie niet al een volledig jaar omzet in dit tempo hebben ontvangen. De openstelling van selfservice-inkoop via Ads Manager voor India, Europa, het Midden-Oosten en Noord-Afrika wordt voor later op de dag aangekondigd.
OpenAI presenteert advertenties als een van de pijlers van zijn bedrijfsmodel, naast consumentenabonnementen, zakelijke aanbiedingen en naar gebruik gefactureerde API’s, en koppelt ze uitdrukkelijk aan de financiering van het gratis niveau dat ChatGPT toegankelijk houdt voor meer dan één miljard wekelijks actieve gebruikers. Vier toezeggingen bakenen het systeem af: advertenties worden altijd duidelijk aangeduid en van antwoorden gescheiden, advertenties beïnvloeden de gegeven antwoorden niet, adverteerders krijgen geen toegang tot privégesprekken en de gebruiker bepaalt zelf hoe sterk zijn advertentie-ervaring wordt gepersonaliseerd.
| Door OpenAI gepubliceerde statistiek | Aangekondigde waarde |
|---|---|
| Geannualiseerd omzettempo (prognose) | 1 miljard dollar |
| Tijd verstreken sinds de lancering | minder dan 200 dagen |
| Adverteerders op het platform | tienduizenden |
| Reeds gedekte landen | meer dan 40 |
| Nieuwe markten die voor selfservice worden geopend | India, Europa, Midden-Oosten, Noord-Afrika |
| Technologie- en meetpartners | meer dan 50 |
| Wekelijks actieve gebruikers van ChatGPT | meer dan 1 miljard |
| Genoemd rendement op advertentie-uitgaven over 28 dagen | 3x, bij een e-commerceadverteerder |
| Advertentieverkeer afkomstig van nieuwe klanten | meer dan 80 %, bij een technologiepartner |
Het beschreven traject is dat van een overgang van beheerde verkoop naar een vrij toegankelijk platform. Het oorspronkelijke model steunde op bureaus en partners; met de komst van Ads Manager in mei werd het advertentieplatform opengesteld voor kleine en middelgrote ondernemingen, die inmiddels een aanzienlijk deel van de activiteit vertegenwoordigen. Wat de tooling betreft, vormen CPC-biedingen en op resultaten geoptimaliseerde biedingen (outcome-optimized bidding) het merendeel van de campagnes, terwijl de Pixel en de Conversions API de basis voor metingen vormen. OpenAI merkt ook op dat adverteerders buiten de Verenigde Staten een groeiend deel van de omzet vertegenwoordigen.
Voor de toekomst kondigt het bedrijf nieuwe markten, formaten, doelstellingen en inkoopopties aan, en zegt het meer native manieren te willen verkennen waarop bedrijven binnen ChatGPT met consumenten kunnen communiceren — oftewel formaten die minder losstaan van het gesprek dan de huidige advertenties.
🔗 OpenAI — Een mijlpaal in het uitbreiden van de toegang tot AI
Together AI: 250 MW in Saoedi-Arabië, GLM-5.3 bovenaan de agentindex en een nieuwe klant
31 augustus — Together AI heeft aangekondigd een infrastructuurovereenkomst te hebben getekend voor een datacenter van 250 MW in Saoedi-Arabië, dat samen met HUMAIN wordt gebouwd. Het laboratorium verwacht dat dit centrum jaarlijks 5 miljard dollar omzet zal genereren en presenteert de operatie als een van de grootste AI-infrastructuurovereenkomsten die voor open source zijn gesloten. Het bericht werd vastgezet op het account van het laboratorium, wat het onderscheidt van zijn gebruikelijke communicatie over modellen.
Het cijfer vereist enige voorzichtigheid bij de interpretatie, omdat het aankondigingsbericht drie zinsfragmenten zonder werkwoord naast elkaar zet en daardoor onduidelijk laat waarop de 5 miljard betrekking heeft. De berichtgeving van The New York Times geeft uitsluitsel: het bedrag beschrijft de verwachte omzet van dit datacenter, niet die van het bedrijf. De orde van grootte bevestigt dit, aangezien hetzelfde artikel de waardering van Together AI in juli 2026 op 8,3 miljard dollar schat — een bedrijf met een dergelijke waardering behaalt geen jaarlijkse omzet van 5 miljard dollar.
De constructie zelf verdient aandacht, want het gaat niet om de aankoop van capaciteit. Nog steeds volgens The New York Times levert HUMAIN naast de 250 MW ook 120.000 halfgeleiders, en exploiteert Together AI deze chips in ruil voor een deel van zijn omzet. Het laboratorium financiert de infrastructuur dus niet: het gebruikt die in ruil voor een deel van zijn omzet. Dat is precies wat de thread betoogt door partnerschappen die rekenkracht vrijmaken af te zetten tegen een wedloop waarin iedereen zijn eigen miljarden zou ophalen. HUMAIN, vorig jaar opgericht op initiatief van kroonprins Mohammed bin Salman, maakt deel uit van de Saoedische inspanningen om een AI-industrie op te bouwen en de afhankelijkheid van het land van olie te verminderen.
Het in de thread uitgewerkte argument gaat minder over het volume dan over de aard van het knelpunt. Together AI beschrijft energie als de echte bottleneck van dit moment en de overeenkomst als een manier om toegang te krijgen tot een schaal die een bedrijf van zijn omvang niet vanuit zijn eigen balans zou kunnen financieren. Het laboratorium plaatst deze constructie uitdrukkelijk tegenover het model van gesloten laboratoria, waarvan de infrastructuur lange tijd door hyperscalers werd gefinancierd.
Deze interpretatie verduidelijkt de bijzondere positie van Together AI binnen het ecosysteem: het laboratorium publiceert geen frontiermodellen, maar bedient die van anderen — DeepSeek, GLM, Kimi, MiniMax, Nemotron. Zijn beperking ligt dus niet bij onderzoek, maar bij de beschikbare rekencapaciteit om modellen met open gewichten goedkoper aan te bieden dan propriëtaire API’s. Een contract van 250 MW speelt daar rechtstreeks op in.
| Onderdeel van de overeenkomst | Gerapporteerde waarde |
|---|---|
| Capaciteit van het datacenter | 250 MW |
| Door HUMAIN geleverde halfgeleiders | 120 000 |
| Verwachte jaarlijkse omzet van het datacenter | 5 miljard dollar |
| Aan HUMAIN betaalde tegenprestatie | een deel van de omzet van Together AI |
| Waardering van Together AI in juli 2026 | 8,3 miljard dollar |
| Industriële partner | HUMAIN |
| Locatie | Saoedi-Arabië |
| Datum en tijd van de aankondiging | 31 augustus 2026, 13:26 UTC |
Nog één punt waarover Together AI in zijn thread geen commentaar geeft: hetzelfde artikel merkt op dat het bedrijf zich dankzij de vestiging in Saoedi-Arabië kan onttrekken aan de weerstand die het in de Verenigde Staten ondervindt bij het installeren van datacenters.
We just signed one of the largest AI infrastructure deals for open source, period. 250MW data center. $5B+ in annualized revenue. Built with @HUMAIN in Saudi Arabia.
🇳🇱 We hebben zojuist een van de grootste AI-infrastructuurovereenkomsten voor open source getekend, punt uit. Datacenter van 250 MW. Meer dan 5 miljard dollar aan geannualiseerde omzet. Gebouwd met @HUMAIN in Saoedi-Arabië. — @togethercompute op X
GLM-5.3 bereikt een gedeelde eerste plaats in de agentindex van Artificial Analysis
31 augustus — Voor de zesde opeenvolgende dag is GLM-5.3 in het nieuws: nadat Z.ai op 28 augustus de gewichten had vrijgegeven en het model op 29 augustus beschikbaar was gesteld via de serverless API van Together AI, is het ditmaal een externe ranglijst die het model onderscheidt. In de agentindex van Artificial Analysis behaalt het model 59 punten. Together AI formuleert het resultaat nauwkeurig: GLM-5.3 deelt de eerste plaats (ties for the top spot) en verslaat (beating) GPT-5.6 Sol en Claude Fable 5. De voorsprong geldt dus voor deze twee modellen; met Claude Opus 5, dat eveneens 59 punten behaalt, deelt GLM-5.3 de koppositie.
Het meest leerzame punt betreft de methode. Z.ai heeft geen nieuw basismodel getraind: de basis van GLM-5.2 bleef behouden en de volledige winst komt voort uit post-training, die gelijktijdig op drie assen is opgeschaald — meer omgevingen met een lange horizon, een grotere diversiteit aan taken en meer compute voor RL.
| Beoordeeld model | Score op de agentindex |
|---|---|
| GLM-5.3 (max) | 59 |
| Claude Opus 5 (max) | 59 |
| GLM-5.3 Flash | 58 |
| GPT-5.6 Sol (max) | 58 |
| Claude Fable 5 (met fallback) | 57 |
🔗 Bericht van @togethercompute
Greptile kiest Together AI als primaire inferenceprovider
31 augustus — Het laatste signaal van de dag is bescheidener: Greptile, een AI-tool voor codereviews die door meer dan 11.000 teams wordt gebruikt, heeft Together AI gekozen als primaire inferenceprovider. De tool analyseert pull requests met de volledige context van de repository, een belastingsprofiel met lange contexten en grote hoeveelheden tokens — precies het gebruik waarbij het kostenverschil tussen modellen met open gewichten en propriëtaire API’s doorslaggevend wordt.
🔗 Bericht van @togethercompute
GitHub Copilot in VS Code: vier augustusversies samengevat in één changelog
31 augustus — GitHub publiceert het overzicht van Copilot in Visual Studio Code voor augustus 2026, dat vier versies van de editor omvat, van v1.132 tot en met v1.135. De rode draad van deze cyclus is de organisatie van werk met meerdere agents: het Agents-venster is niet langer slechts een lijst met gesprekken, maar wordt een ruimte waarin meerdere sessies naast elkaar bestaan en in hun bestaande staat kunnen worden hervat.
Wat sessies betreft, worden chats naast elkaar geplaatst in horizontale of verticale groepen en wordt de indeling bij terugkeer hersteld. De opdracht /btw opent een zijgesprek dat de context en promptcache van het hoofdgesprek deelt terwijl dat gesprek blijft draaien: zo kan een aanvullende vraag worden gesteld zonder een actieve agent te onderbreken. Met een tijdlijnbediening voor prompts, toegankelijk vanuit de marge van het transcript, kan rechtstreeks naar een prompt worden gesprongen en kunnen de daaruit voortvloeiende bestandswijzigingen opnieuw worden bekeken. Met Agent Host kunnen meerdere VS Code-vensters verbinding maken met dezelfde sessie, en een experimentele opdracht /rubber-duck schakelt een aanvullend model in om gemiste details en randgevallen naar boven te halen.
Twee punten hebben rechtstreeks betrekking op de plaats van Claude in de editor: met een experimentele instelling kan het Agents-venster zonder GitHub-verbinding worden geopend zodra Claude met een API-sleutel is geconfigureerd, en in Claude-sessies kan op elk moment worden gewisseld tussen de modellen van het Anthropic-abonnement en die van het Copilot-abonnement. Daarnaast ondersteunt VS Code de installatie van overdraagbare agentplugins die voldoen aan de standaard Agent Plugins 1.0 en in andere compatibele agentclients kunnen worden gebruikt.
| Onderdeel van de changelog | Opvallende vernieuwingen |
|---|---|
| Sessies en workflows | Chats naast elkaar, /btw, prompttijdlijn, Agent Plugins 1.0, /rubber-duck, Agent Host |
| Claude in VS Code | Agents-venster zonder GitHub-verbinding via API-sleutel, wisselen tussen Anthropic- en Copilot-modellen |
| Chat en beoordeling | Zoeken in het transcript, vastgezette scrolling, hybride Markdown-editor, tokens per model |
| Geïntegreerde browser | HTML-elementen in bulk annoteren, automatisch herladen, standaard HTML-editor |
| Dicteren | Meertalig op het apparaat, opschooninstructies, aan de shell aangepaste opschoning |
De chat krijgt ten slotte de leesfuncties die door steeds langere gesprekken noodzakelijk werden: tekst zoeken in het volledige transcript met hoofdlettergevoeligheid, hele woorden en reguliere expressies, vastgezette scrolling die de huidige prompt zichtbaar houdt, en bij het aanwijzen van de antwoordvoet een weergave van het tokenverbruik per model, met onderscheid tussen invoer, gecachete invoer en uitvoer — nuttige transparantie nu de facturering van de cache afhangt. In de geïntegreerde browser kunnen meerdere HTML-elementen op een pagina worden geselecteerd en geannoteerd om interfacefeedback in bulk te verwerken, en dicteren gebeurt op het apparaat, in meerdere talen, waarbij de syntaxis van opdrachten behouden blijft wanneer in een terminal wordt gedicteerd in plaats van uitgesproken leestekens in te voegen.
🔗 GitHub Changelog — Copilot in VS Code, versies van augustus 2026
NVIDIA brengt zijn softwarebouwstenen naar de biologie en de autonome auto
31 augustus — NVIDIA heeft een tutorial gepubliceerd over integratiewerk dat samen met Anthropic is uitgevoerd: de BioNeMo Agent Toolkit kan voortaan worden gebruikt vanuit Claude Science, de wetenschappelijke onderzoeksomgeving van Anthropic. Het aangepakte probleem is dat van gespecialiseerde tooling — een generalistische agent kan herkennen dat een taak het vouwen van een eiwit vereist, zonder daarom te weten welk model moet worden uitgevoerd, hoe het verzoek moet worden geformatteerd of welke parameters van belang zijn. De toolkit bundelt meer dan tien jaar aan BioNeMo-modellen, -bibliotheken en -workflows — biologie, chemie, genomica en geneesmiddelenonderzoek — in skills die door een agent kunnen worden aangeroepen. Op zijn interne benchmarks meldt NVIDIA dat de nauwkeurigheid van taken stijgt van 60 naar 100% en dat de tokenefficiëntie ongeveer verdubbelt.
De tutorial koppelt drie NIM-microservices aan elkaar: eerst MSA Search om de evolutionaire context op te bouwen, vervolgens OpenFold3 en Boltz-2 om de structuur onafhankelijk van elkaar te voorspellen. De duidelijkste demonstratie betreft de rol van multiple sequence alignment — zonder deze uitlijning stort het vertrouwen in de interface bij beide modellen in, en een ruimer samplingbudget verandert daar niets aan. Twee kanttekeningen verdienen vermelding: de hardwaredrempel, met een L40S- of H100-GPU en ongeveer 700 GB opslagruimte, en de terughoudendheid bij de interpretatie die NVIDIA zelf benadrukt. Het bedrijf herinnert eraan dat een betrouwbaarheidsscore geen interactie bewijst en presenteert de convergentie van twee onafhankelijke modellen als een sterke hypothese, niet als bewijs.
| Maatstaf voor betrouwbaarheid van de interface (iPTM) | OpenFold3 | Boltz-2 |
|---|---|---|
| Heteromeer met MSA-uitlijning | 0,85 | 0,82 |
| Heteromeer zonder MSA-uitlijning | 0,14 | 0,19 |
| Cα-RMSD van de kern, monomeer versus heteromeer | 0,68 Å | 0,65 Å |
🔗 NVIDIA-tutorial — BioNeMo NIM in Claude Science
Omniverse NuRec past een perceptiestack aan een nog niet bestaande auto aan
31 augustus — Diezelfde dag publiceert NVIDIA een tweede technische tutorial, ditmaal over autonoom rijden. Het uitgangspunt is dat een perceptiestack wordt gevormd door het voertuig waarop deze draait: wanneer de stack van een SUV naar een sedan wordt overgezet, neemt hij de wereld niet meer op dezelfde manier waar, omdat de positie van de sensoren, de kalibratie, de gezichtsvelden, de occlusies en de geometrie van de carrosserie allemaal veranderen. Het verzamelen en annoteren van een echte dataset voor elke voertuiglijn is duur en in het begin van de ontwikkeling vaak onmogelijk.
Met Omniverse NuRec kunnen reeds opgenomen ritten worden hergebruikt: het reconstrueert elke scène en geeft die vervolgens weer vanuit de sensorconfiguratie van het doelvoertuig. Teams kunnen zo vaststellen hoe een scenario eruit zou zien met de nieuwe cameraopstelling en waar geometrische veranderingen dode hoeken veroorzaken. NVIDIA benadrukt dat echte rijgegevens onmisbaar blijven om de prestaties te verankeren en te valideren: synthetische gegevens dienen om modellen aan te passen voordat er een specifieke dataset bestaat, niet om die te vervangen. De scènes worden via Hugging Face verspreid in USDZ-formaat, samen met een repository met skills voor code-agents.
🔗 NVIDIA-tutorial — Omniverse NuRec
Amp koppelt aan elke thread een ruimte voor audio- en videogesprekken
31 augustus — Amp koppelt aan elke thread een ruimte voor livegesprekken. De functie, Space to Talk genoemd, opent een audio- en videoruimte die aan de thread zelf is gekoppeld: één druk op Enter volstaat om binnen te komen, de camera in te schakelen en het scherm te delen, terwijl de agent in dezelfde thread verder werkt.
Het benadrukte voordeel is dat tussenstappen verdwijnen, en deze aanpak zet het samenwerkingstraject voort dat Amp sinds de zomer volgt: eerst het delen van de besturing van een orb met teamgenoten (Multiplayer, 22 juli), daarna uitnodigen via een vermelding rechtstreeks in een thread (Pass the Orb to the Left Hand Side, 19 augustus). De thread wordt het centrale trefpunt voor het team en de agent. Amp erkent bovendien dat de reikwijdte nog openligt: brainstormen, een whiteboard of gesprekken met Puck en andere agents worden genoemd als toekomstige mogelijkheden, niet als reeds geleverde functies.
No links to paste, no calendar invite, no other app. The call lives where the work lives.
🇳🇱 Geen link om te plakken, geen agenda-uitnodiging, geen andere app. Het gesprek vindt plaats waar het werk zich bevindt. — Amp, notitie Space to Talk
VLANeXt, één uniforme codebase voor vision-language-action-modellen
31 augustus — Een team publiceert op de Hugging Face-blog VLANeXt, een codebase voor onderzoek naar vision-language-action-modellen (vision-language-action, VLA). Het principe van deze modellen is eenvoudig: een vision-language-model koppelt wat de robot ziet aan een instructie in natuurlijke taal en leidt daar vervolgens een handeling in de fysieke wereld uit af.
Het beoogde probleem is methodologisch. Het vakgebied ontwikkelt zich snel, maar raakt versnipperd: van de ene publicatie tot de andere veranderen de backbone, de policy head, de representatie van acties, de trainingsstrategie en het evaluatieprotocol. Resultaten worden vaak als sterk gepresenteerd, maar door het onvermogen om variabelen te isoleren blijft het moeilijk om vast te stellen wat een VLA-model werkelijk goed laat presteren.
In plaats van nog een architectuur toe te voegen, zijn de auteurs opnieuw begonnen met een referentiebasis van het type RT-2 / OpenVLA en hebben ze de ontwerpruimte methodisch verkend om daaruit een recept af te leiden. Dit werk leidde tot de ICML-paper „VLANeXt: Recipes for Building Strong VLA Models”. De codebase is sindsdien verder uitgebreid dan deze studie, met backbones van uiteenlopende grootte, het leren van latente acties, voorspellende modellering in de latente ruimte en wereld-actiemodellering. De codebase biedt zes uitgangspunten: VLANeXt-LAM, -S, -L, -XL, -JEPA en -WAM.
Kort nieuws
- Claude Code 2.1.252, een versie met uitsluitend bugfixes — Vier oplossingen en geen nieuwe functies: Bash-opdrachten die op sommige Macs mislukten, een keuze voor „always allow” die niet werd opgeslagen in een project zonder bestand
.claude/settings.local.json, Remote Control-sessies die na afloop van een tool enkele minuten vastliepen wanneer de verbinding met claude.ai verslechterd was, en meldingen van achtergrondtaken met omvangrijke uitvoer waardoor de maximale grootte voor API-verzoeken werd overschreden. 🔗 CHANGELOG van Claude Code - Flow brengt controle over het eerste en laatste beeld naar de desktop — Google Flow meldt dat de controle over het eerste en laatste beeld van Gemini Omni 1.1 Flash, die op 27 augustus samen met het model werd gepresenteerd, nu beschikbaar is op de desktop. Het uitgelichte gebruik: aan beide uiteinden hetzelfde beeld gebruiken om een lus te maken. 🔗 Bericht van @FlowbyGoogle
- Laatste dag om mee te dingen naar de Grok Imagine-prijs — xAI herinnerde eraan dat de deadline van de op 17 augustus gestarte videowedstrijd diezelfde dag verstreek. Deelnemers moesten een scène uit de Odyssee van Homerus maken die de video- en stemmogelijkheden van het model in de kijker zette; de drie beste inzendingen delen 175.000 dollar, met prijzen van respectievelijk 100.000, 50.000 en 25.000 dollar. 🔗 Bericht van @grok
- QwenCloud sluit zijn Arena en kondigt een sessie in Bangkok aan — De Qwen Cloud Arena-challenge, gericht op agents voor het genereren van content voor grensoverschrijdende e-commerce, sloot na meer dan 800 deelnemers om middernacht Pekingse tijd de inzendingen, waarna de beoordelingsfase de volgende dag begon. Enkele uren eerder had QwenCloud een sessie aangekondigd op de Qwen Conference in Bangkok op 4 september, met dezelfde positionering rond drie toegangspunten — website, Skills, CLI — die eerder al in Hongkong was gepresenteerd. 🔗 Sluiting van de Arena · 🔗 Sessie in Bangkok
- GitHub start een onderzoek naar toegankelijkheidsaanpassingen van ontwikkelaars — Het bedrijf wil in kaart brengen welke tools, productinstellingen en persoonlijke aanpassingen het mogelijk maken om onder goede omstandigheden te werken, zonder dat mensen hoeven te verklaren dat ze een beperking hebben of zichzelf als gebruiker van toegankelijkheidstools hoeven te beschouwen. Reacties worden tot en met 30 september verwacht. Onderwerp zonder verband met AI. 🔗 Bericht van @github
- otoSpeech Task, een full-duplex-corpus dat samen met zijn taak is gepubliceerd — Twintig uur Engelstalige gesprekken met twee sprekers, 58 sessies verdeeld over zeven samenwerkingstaken en 11.025 gebeurtenissen met tijdstempels, onder de licentie CC BY 4.0. Kenmerkend is dat de beelden die elke spreker ziet, hun handelingen en de referentieantwoorden op dezelfde tijdlijn staan als de audio. 🔗 Blogbericht op Hugging Face
- YOLO26-RGB, een model voor het verwijderen van regen afgeleid van een depth head — Twee modellen voor het verwijderen van regen, verkregen door de 1-kanaals depth head van YOLO26-depth te vervangen door een 3-kanaals RGB restoration head: 5,25 M parameters bij ongeveer 109 beelden/s in 1080p, en 12,13 M bij ongeveer 92 beelden/s voor 0,1 dB extra kwaliteit. 🔗 Blogbericht op Hugging Face
Wat dit betekent
De interface genereren in plaats van de code die haar produceert. Solaris verlegt de grens tussen ontwerp en uitvoering. De volledige huidige softwareketen berust op een vertaling — een mock-up wordt code, de code produceert een weergave — en Runway meet wat die vertaling kost: bij 30 interfaces die op basis van een schermafbeelding moesten worden gereconstrueerd, verliezen alle geteste multimodale modellen informatie, en de kwaliteitsvermindering neemt toe naarmate de visuele rijkdom groter wordt. De tussenstap weglaten is een radicaal voorstel, en de beperkingen die het lab zelf opsomt, laten zien waar het op stukloopt: tekst die niet op zijn plaats blijft, geen gegarandeerde feitelijke verankering, en toegankelijkheid die volledig moet worden opgebouwd omdat een gegenereerde afbeelding geen enkele structuur aan schermlezers biedt. Dit zijn fundamentele obstakels, geen afwerkingsdetails.
Twee manieren om voor rekenkracht te betalen, aangekondigd op dezelfde dag. OpenAI meldt voor zijn advertentieplatform een geannualiseerd omzettempo van één miljard dollar — een prognose over twaalf maanden, geen daadwerkelijk ontvangen bedrag — en beschouwt dit als een economische pijler op hetzelfde niveau als abonnementen: advertenties financieren het gratis niveau van een dienst die naar eigen zeggen meer dan één miljard wekelijkse gebruikers heeft. Together AI, van zijn kant, maakt geen publiek te gelde en koopt evenmin extra capaciteit: het krijgt 250 MW en 120.000 chips in Saudi-Arabië in ruil voor een deel van zijn omzet, waarbij energie wordt aangewezen als het werkelijke knelpunt van de sector. Beide bedrijven reageren vanaf tegenovergestelde uiteinden van de keten op dezelfde beperking, en geen van beide antwoorden is neutraal: het ene brengt een commercieel belang in het product, het andere verplaatst de infrastructuur naar een plek waar die op minder politieke weerstand stuit.
De concurrentiestrijd rond agents speelt zich voortaan na de pre-training af. Het resultaat van GLM-5.3 op de agent-index van Artificial Analysis is vooral van belang door de manier waarop het werd behaald: Z.ai behield de GLM-5.2-basis en schaalde uitsluitend de post-training op — omgevingen met een lange horizon, diversiteit aan taken, RL-compute. Als aansluiten bij de top van een agent-ranking niet langer vereist dat een basismodel opnieuw wordt getraind, is de zwaarste kostenpost niet meer de enige bepalende factor voor de rangschikking en wordt de updatecyclus van een model navenant korter. Dit is ook de meest economische verklaring voor de zesdaagse opeenvolging die dit model doormaakte, van de open weights op de 28e tot deze ranking op de 31e.
Ontwikkelaarstools worden geherstructureerd rond meerdere agents tegelijk. De changelog van Copilot besteedt een volledige cyclus aan het behandelen van het Agents-venster als een werkruimte — chats naast elkaar, een zijgesprek dat de promptcache deelt, een tijdlijn van prompts, meerdere vensters die met dezelfde sessie zijn verbonden — en niet langer als een lijst met gesprekken. Amp koppelt een gespreksruimte aan de thread, zodat de menselijke discussie plaatsvindt waar de agent werkt. NVIDIA verpakt ten slotte tien jaar aan wetenschappelijke bibliotheken in aanroepbare skills en levert een tweede repository met skills voor de reconstructie van verkeersscènes. Drie zeer verschillende spelers komen tot hetzelfde idee: wat de agent mist, is niet langer de capaciteit van het model, maar de gedeelde context en de gespecialiseerde tools die hem kunnen worden aangereikt.
Bronnen
- Runway — Introductie van Solaris
- Runway — aankondiging van Solaris op X
- OpenAI — Een mijlpaal in het uitbreiden van de toegang tot AI
- Together AI — infrastructuurovereenkomst van 250 MW met HUMAIN
- Together AI — GLM-5.3 op de agent-index van Artificial Analysis
- Together AI — Greptile als belangrijkste inference-provider
- GitHub Changelog — Copilot in VS Code, versies van augustus 2026
- NVIDIA — BioNeMo NIM voor de voorspelling van eiwitstructuren in Claude Science
- NVIDIA — Omniverse NuRec en waarneming met meerdere voertuigen
- Amp — Ruimte om te praten
- VLANeXt, uniforme codebase voor vision-language-action-modellen
- CHANGELOG van Claude Code
- Google Flow — eerste en laatste beelden op de desktop
- xAI — laatste dag van de Grok Imagine-wedstrijd
- QwenCloud — afsluiting van de Qwen Cloud Arena
- QwenCloud — sessie op de Qwen Conference in Bangkok
- GitHub — enquête over tools en toegankelijkheidsaanpassingen
- otoSpeech Task, corpus van full-duplexgesprekken
- YOLO26-RGB, model voor het verwijderen van regen