ai-powered-markdown-translatorArtikel översatt från franska till svenska med gpt-5.6-sol.
Arton tillkännagivanden för 30 och 31 augusti, med en mycket ojämn fördelning: söndagen gav inte upphov till någon officiell publicering, och nästan allt material är daterat måndagen. X-avbrottet som rapporterades i utgåvan den 30:e har följts upp: kontona som förblev otillgängliga den dagen granskades på nytt över tre dagar, utan att något saknat tillkännagivande upptäcktes.
Tre huvudlinjer framträder. Först en helt ny modell, med Runways första världsmodell för gränssnitt. Därefter två ekonomiska milstolpar: OpenAI:s annonsverksamhet har nått en annualiserad intäktstakt på en miljard dollar, och Together AI har tecknat ett infrastrukturavtal om 250 MW. Slutligen en våg av utvecklarverktyg hos GitHub, NVIDIA och Amp, kompletterad med tre forskningsarbeten som publicerats på Hugging Faces communityblogg.
Runway lanserar Solaris, sin första världsmodell för gränssnitt
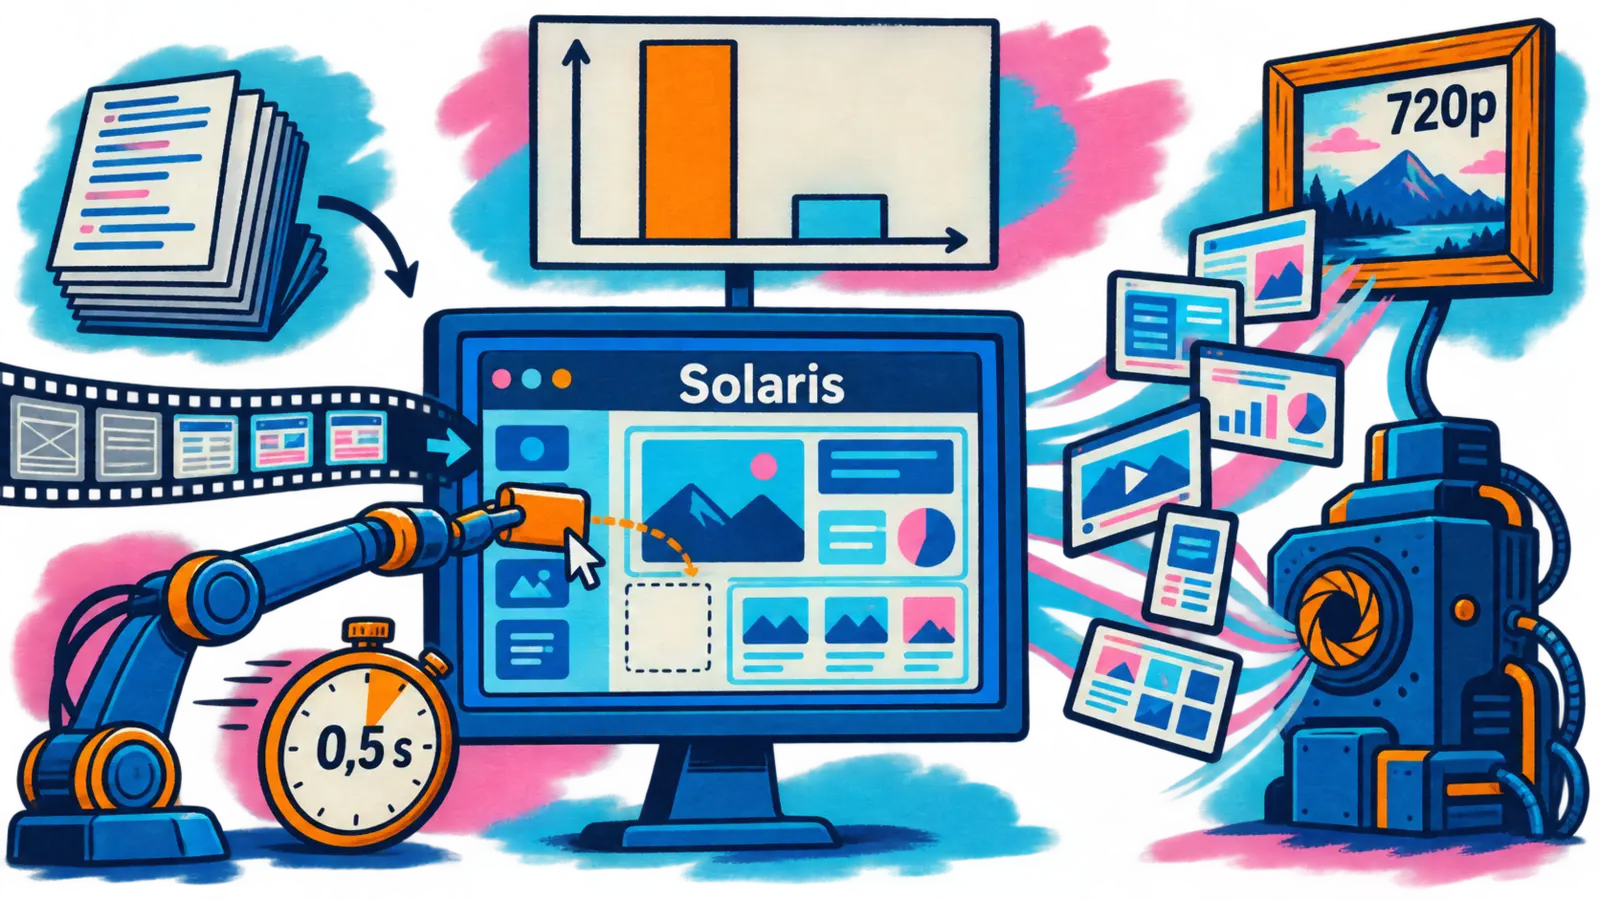
31 augusti — Runway har presenterat Solaris, den första modellen i en familj som laboratoriet kallar världsmodeller för gränssnitt (Interface World Models). Principen kan sammanfattas i en mening: i stället för att producera kod som sedan visar ett gränssnitt genererar modellen gränssnittet direkt, bild för bild, och reagerar på klick och dra-och-släpp i realtid.
Resonemanget utgår från ett konstaterande om processen för mjukvaruutveckling. En designskiss måste först översättas till kod innan den kan göra någonting alls, och den översättningen har två kostnader: varje beteende måste definieras i förväg, vilket innebär att mjukvaran är fastlåst innan den första användaren anländer, samtidigt som den ursprungliga designens visuella rikedom går förlorad på vägen. Solaris tar bort mellansteget, och hela bilden blir gränssnittet.
Tekniskt bygger modellen på Gen-4.5, Runways videomodell, och vidareutvecklar GWM-1, företagets generella världsmodell. Användarens indata styr nästa bild på samma sätt som text eller en bild, vilket gör att sambandet mellan en handling och dess visuella resultat kan läras in utan att något beteende programmeras. Övergången till realtid krävde tre steg: att göra genereringen autoregressiv bild för bild, destillera den flerstegade avbrusningen till ett fåtal steg och sedan träna den snabba modellen på dess egna utdata. En LLM avgör hur scenen ska utvecklas medan världsmodellen utför renderingen.
| Kriterium bedömt av deltagarna | Solaris | Kodat gränssnitt (Claude Opus 5) | Likvärdiga bedömningar |
|---|---|---|---|
| Efterlevnad av den begärda instruktionen | 61 % | 24 % | 13 % |
| Naturligt beteende i scenen | 71 % | 21 % | 6 % |
| Teknisk egenskap | Uppmätt värde |
|---|---|
| Basmodell | Gen-4.5, som en vidareutveckling av GWM-1 |
| Bibehållen upplösning | 720p |
| Interaktivitetströskel | cirka 0,5 s latens |
| Användarstudie | 250 deltagare, 30 exempel, närmare 7 500 parvisa bedömningar |
| Rekonstruktionsbenchmark | 30 gränssnitt, strukturell likhet (SSIM) och DINOv3-deskriptorer |
Skillnaden är betydligt större när det gäller hur naturligt beteendet är än när det gäller att helt enkelt följa instruktionen, och Runway ser detta som den grundläggande skillnaden mellan de två metoderna: ett kodat gränssnitt kan ofta återge den begärda förändringen, men behandlar den som en isolerad uppdatering, medan en modell som har lärt sig hur objekt beter sig producerar en reaktion som är konsekvent med resten av scenen. Laboratoriet lyfter även fram ett andra, mindre väntat användningsområde: träning av agenter, där en miljö som kontinuerligt återskapas skulle kunna erbjuda ständigt föränderliga gränssnitt, inklusive layouter som aldrig tidigare har existerat.
Runway dokumenterar också vad Solaris ännu inte kan göra, och listan är omfattande: stabil och läsbar text är fortfarande ett av de svåraste problemen inom videogenerering, trots att gränssnitt är mer beroende av text än något annat område; faktamässig förankring kräver att genereringen styrs av verifierade data; konsekvens under långa sessioner är fortfarande ett forskningsområde; och ett genererat gränssnitt måste ännu kunna fungera med hjälpmedelsteknik och tillgänglighets-API:er. Den offentliga lanseringen förbereds tillsammans med partner, och tidig åtkomst erbjuds via ett formulär.
Today, we’re sharing new research on Solaris, our first Interface World Model. Solaris is a new kind of operating system that generates interactive interfaces frame by frame, in real time, with no code.
🇸🇪 I dag delar vi med oss av ny forskning om Solaris, vår första Interface World Model. Solaris är en ny typ av operativsystem som genererar interaktiva gränssnitt bild för bild, i realtid och utan kod. — @runwayml på X
🔗 Runway — Vi presenterar Solaris
ChatGPT Ads når en annualiserad intäktstakt på en miljard dollar och öppnar sin självbetjäning i fyra nya regioner
31 augusti — OpenAI har publicerat ett inlägg om ChatGPT Ads, företagets annonsplattform integrerad i ChatGPT, och meddelar att plattformen har nått en annualiserad intäktstakt (annualized revenue run rate) på en miljard dollar mindre än 200 dagar efter lanseringen. En viktig nyans bör klargöras direkt: det handlar inte om en miljard dollar som redan har tjänats in, utan om intäkterna under den senaste perioden omräknade till tolv månader. En annonsplattform som har funnits i mindre än tvåhundra dagar kan per definition inte ha tjänat in ett helt års intäkter i denna takt. Självbetjäningsköp via Ads Manager ska senare under dagen öppnas i Indien, Europa, Mellanöstern och Nordafrika.
OpenAI framställer annonsering som en av pelarna i sin affärsmodell, vid sidan av konsumentabonnemang, företagserbjudanden och användningsbaserat fakturerade API:er, och kopplar den uttryckligen till finansieringen av gratisnivån som håller ChatGPT tillgängligt för fler än en miljard aktiva användare i veckan. Fyra åtaganden sätter ramarna för systemet: annonser identifieras alltid tydligt och hålls åtskilda från svaren, annonseringen påverkar inte de svar som ges, annonsörer får inte tillgång till privata konversationer och användaren styr hur personligt anpassad annonsupplevelsen ska vara.
| Mätvärde publicerat av OpenAI | Angivet värde |
|---|---|
| Annualiserad intäktstakt (prognos) | 1 miljard dollar |
| Tid sedan lanseringen | mindre än 200 dagar |
| Annonsörer på plattformen | tiotusentals |
| Länder som redan omfattas | fler än 40 |
| Nya marknader som öppnas för självbetjäning | Indien, Europa, Mellanöstern, Nordafrika |
| Teknik- och mätpartner | fler än 50 |
| Aktiva ChatGPT-användare per vecka | fler än 1 miljard |
| Angiven avkastning på annonsutgifter över 28 dagar | 3x, hos en e-handelsannonsör |
| Annonstrafik från nya kunder | mer än 80 %, hos en teknikpartner |
Den beskrivna utvecklingen innebär en övergång från hanterad försäljning till en plattform med fri åtkomst. Den ursprungliga modellen byggde på byråer och partner; lanseringen av Ads Manager i maj öppnade annonsplattformen för små och medelstora företag, som nu står för en betydande del av verksamheten. När det gäller verktyg utgör CPC-budgivning och resultatoptimerad budgivning (outcome-optimized bidding) merparten av kampanjerna, medan Pixel och Conversions API fungerar som grund för mätningen. OpenAI noterar också att annonsörer utanför USA står för en växande andel av intäkterna.
Framöver tillkännager företaget nya marknader, format, mål och köpalternativ och uppger att det vill utforska mer integrerade sätt för företag att interagera med konsumenter inuti ChatGPT — det vill säga format som är mindre åtskilda från konversationen än dagens annonser.
🔗 OpenAI — En milstolpe i arbetet med att bredda tillgången till AI
Together AI: 250 MW i Saudiarabien, GLM-5.3 i toppen av agentindexet och en ny kund
31 augusti — Together AI har meddelat att företaget har tecknat ett infrastrukturavtal om ett datacenter på 250 MW i Saudiarabien, byggt tillsammans med HUMAIN. Laboratoriet förväntar sig att verksamheten vid centret ska generera intäkter på 5 miljarder dollar per år och beskriver affären som ett av de största AI-infrastrukturavtalen som slutits för open source. Inlägget har fästs högst upp på laboratoriets konto, vilket skiljer det från företagets vanliga kommunikation om modeller.
Siffran kräver en försiktig tolkning, eftersom tillkännagivandet radar upp tre fragment utan verb och lämnar det oklart vad de 5 miljarderna avser. New York Times rapportering ger svaret: beloppet beskriver de förväntade intäkterna från datacentret, inte företagets intäkter. Storleksordningen bekräftar detta, eftersom samma artikel värderar Together AI till 8,3 miljarder dollar i juli 2026 — ett företag med den värderingen omsätter inte 5 miljarder dollar om året.
Själva upplägget förtjänar uppmärksamhet eftersom det inte handlar om ett kapacitetsköp. Enligt New York Times tillhandahåller HUMAIN 120 000 halvledare utöver de 250 MW, och Together AI driver dessa chip i utbyte mot att en del av intäkterna betalas tillbaka. Laboratoriet finansierar alltså inte infrastrukturen: det använder den i utbyte mot en andel av sin omsättning. Det är precis vad tråden framhåller genom att ställa partnerskap som frigör beräkningskapacitet mot en kapplöpning där alla skulle behöva ta in sina egna miljarder. HUMAIN, som skapades förra året på initiativ av kronprins Mohammed bin Salman, ingår i Saudiarabiens satsning på att bygga upp en AI-industri och minska landets beroende av olja.
Argumentet som utvecklas i tråden handlar mindre om volymen än om flaskhalsens natur. Together AI beskriver energi som den verkliga flaskhalsen just nu och avtalet som ett sätt att få tillgång till en skala som ett företag av dess storlek inte skulle kunna finansiera med sin egen balansräkning. Laboratoriet ställer uttryckligen detta upplägg mot modellen för slutna laboratorier, vars infrastruktur länge har finansierats av hyperscalers.
Denna tolkning belyser Together AI:s särskilda roll i ekosystemet: laboratoriet publicerar inga frontier-modeller, utan tillhandahåller andras — DeepSeek, GLM, Kimi, MiniMax och Nemotron. Dess begränsning är därför inte forskningen utan den beräkningskapacitet som finns tillgänglig för att köra modeller med öppna vikter till ett lägre pris än proprietära API:er. Ett avtal om 250 MW svarar direkt mot detta behov.
| Del av avtalet | Rapporterat värde |
|---|---|
| Datacentrets kapacitet | 250 MW |
| Halvledare som tillhandahålls av HUMAIN | 120 000 |
| Förväntad årlig intäkt från datacentret | 5 miljarder dollar |
| Ersättning som betalas till HUMAIN | en andel av Together AI:s intäkter |
| Together AI:s värdering i juli 2026 | 8,3 miljarder dollar |
| Industripartner | HUMAIN |
| Plats | Saudiarabien |
| Datum och tid för tillkännagivandet | 31 augusti 2026, 13:26 UTC |
En sista punkt som Together AI inte kommenterar i sin tråd: samma artikel noterar att etableringen i Saudiarabien gör det möjligt att kringgå det motstånd som datacenteretableringar möter i USA.
We just signed one of the largest AI infrastructure deals for open source, period. 250MW data center. $5B+ in annualized revenue. Built with @HUMAIN in Saudi Arabia.
🇸🇪 Vi har just tecknat ett av de största AI-infrastrukturavtalen för open source, punkt slut. Ett datacenter på 250 MW. Mer än 5 miljarder dollar i annualiserade intäkter. Byggt tillsammans med @HUMAIN i Saudiarabien. — @togethercompute på X
GLM-5.3 delar förstaplatsen i Artificial Analysis agentindex
31 augusti — För sjätte dagen i rad är GLM-5.3 aktuell: efter att Z.ai öppnade modellvikterna den 28 augusti och modellen gjordes tillgänglig via Together AI:s serverless-API den 29 augusti är det denna gång en oberoende rankning som lyfter fram den. I Artificial Analysis agentindex når modellen 59 poäng. Together AI formulerar resultatet precist: GLM-5.3 delar förstaplatsen (ties for the top spot) och överträffar (beating) GPT-5.6 Sol och Claude Fable 5. Övertaget gäller alltså dessa två modeller; med Claude Opus 5, som också har 59 poäng, delar GLM-5.3 ledningen.
Den mest lärorika aspekten är metoden. Z.ai har inte tränat någon ny basmodell: GLM-5.2-basen har behållits, och hela förbättringen kommer från efterträningen, som skalades upp längs tre axlar samtidigt — fler miljöer med lång tidshorisont, större variation av uppgifter och mer compute till RL.
| Utvärderad modell | Poäng i agentindexet |
|---|---|
| GLM-5.3 (max) | 59 |
| Claude Opus 5 (max) | 59 |
| GLM-5.3 Flash | 58 |
| GPT-5.6 Sol (max) | 58 |
| Claude Fable 5 (med fallback) | 57 |
🔗 Inlägg från @togethercompute
Greptile väljer Together AI som huvudsaklig inferensleverantör
31 augusti — Dagens sista signal är mer blygsam: Greptile, ett AI-baserat kodgranskningsverktyg som används av fler än 11 000 team, har valt Together AI som sin huvudsakliga inferensleverantör. Verktyget analyserar pull requests med hela kodbasens kontext, en belastningsprofil som består av långa kontexter och stora tokenvolymer — precis det användningsområde där kostnadsskillnaden mellan modeller med öppna vikter och proprietära API:er blir avgörande.
🔗 Inlägg från @togethercompute
GitHub Copilot i VS Code: fyra augustiversioner sammanfattade i en ändringslogg
31 augusti — GitHub publicerar sammanfattningen för augusti 2026 av Copilot i Visual Studio Code, som omfattar fyra versioner av redigeraren, från v1.132 till v1.135. Den röda tråden för cykeln är organiseringen av arbete med flera agenter: fönstret Agents upphör att vara en enkel lista över konversationer och blir en arbetsyta där flera sessioner samexisterar och återställs i befintligt skick.
När det gäller sessioner placeras chattar sida vid sida i horisontella eller vertikala grupper, och layouten återställs när man återvänder. Kommandot /btw öppnar en sidokonversation som delar kontext och promptcache med huvudkonversationen medan den fortsätter att köras: på så sätt går det att ställa en sidofråga utan att avbryta en agent som arbetar. En kontroll för prompthistorik, tillgänglig från transkriptets marginal, gör det möjligt att hoppa direkt till en prompt och granska de filändringar som följde av den. Agent Host låter flera VS Code-fönster ansluta till samma session, och ett experimentellt kommando, /rubber-duck, anropar en kompletterande modell för att lyfta fram missade detaljer och gränsfall.
Två punkter gäller direkt Claudes plats i redigeraren: en experimentell inställning öppnar fönstret Agents utan GitHub-inloggning när Claude har konfigurerats med en API-nyckel, och Claude-sessioner gör det möjligt att när som helst växla mellan modellerna i Anthropic-abonnemanget och modellerna i Copilot-abonnemanget. VS Code stöder dessutom installation av portabla agentplugins som följer standarden Agent Plugins 1.0 och kan användas i andra kompatibla agentklienter.
| Område i ändringsloggen | Viktiga nyheter |
|---|---|
| Sessioner och workflows | Chattar sida vid sida, /btw, prompthistorik, Agent Plugins 1.0, /rubber-duck, Agent Host |
| Claude i VS Code | Fönstret Agents utan GitHub-inloggning via API-nyckel, växling mellan Anthropic- och Copilot-modeller |
| Chatt och granskning | Sökning i transkriptet, fäst rullning, hybrid Markdown-redigerare, tokens per modell |
| Integrerad webbläsare | Gruppvis annotering av HTML-element, automatisk omladdning, HTML-redigerare som standard |
| Diktering | Flerspråkig på enheten, rensningsinstruktioner, rensning anpassad för shell |
Chatten får slutligen de läsverktyg som behövs när konversationerna blivit långa: textsökning i hela transkriptet med skiftlägeskänslighet, hela ord och reguljära uttryck, fäst rullning som håller den aktuella prompten synlig samt visning av tokenförbrukningen per modell när man håller pekaren över svarsfoten, uppdelad i input, cachad input och output — en värdefull insyn sedan debiteringen började bero på cachen. Den integrerade webbläsaren gör det möjligt att markera och annotera flera HTML-element på en sida för att behandla återkoppling om gränssnittet gruppvis, och dikteringen körs på enheten på flera språk och bevarar kommandonas syntax när man dikterar i en terminal i stället för att infoga den uttalade interpunktionen.
🔗 GitHub Changelog — Copilot i VS Code, versionerna från augusti 2026
NVIDIA för in sina programvarukomponenter i biologin och autonoma fordon
31 augusti — NVIDIA har publicerat en handledning som dokumenterar ett integrationsarbete med Anthropic: BioNeMo Agent Toolkit kan nu användas från Claude Science, Anthropics forskningsmiljö för vetenskap. Problemet som behandlas är specialiserade verktyg — en generell agent kan inse att en uppgift kräver att ett protein veckas utan att veta vilken modell som ska köras, hur begäran ska formateras eller vilka parametrar som är viktiga. Verktygslådan paketerar mer än ett årtionde av BioNeMo-modeller, bibliotek och workflows — inom biologi, kemi, genomik och läkemedelsutveckling — som skills en agent kan anropa. I sina interna benchmarks uppger NVIDIA att uppgiftsnoggrannheten ökar från 60 till 100 % och att tokeneffektiviteten ungefär fördubblas.
Handledningen kedjar samman tre NIM-mikrotjänster: MSA Search för att bygga upp det evolutionära sammanhanget, följt av OpenFold3 och Boltz-2 för att oberoende av varandra förutsäga strukturen. Den tydligaste demonstrationen gäller betydelsen av multipel sekvensinpassning — utan den kollapsar tillförlitligheten för gränssnittet i båda modellerna, och en generösare samplingsbudget förändrar inte detta. Två förbehåll förtjänar att lyftas fram: hårdvarutröskeln, med en L40S- eller H100-GPU och omkring 700 GB lagringsutrymme, samt den försiktiga tolkning som NVIDIA förespråkar genom att påminna om att ett konfidensvärde inte bevisar en interaktion och beskriva överensstämmelsen mellan två oberoende modeller som en stark hypotes, inte som ett bevis.
| Konfidensmått för gränssnittet (iPTM) | OpenFold3 | Boltz-2 |
|---|---|---|
| Heteromer med MSA-inpassning | 0,85 | 0,82 |
| Heteromer utan MSA-inpassning | 0,14 | 0,19 |
| Cα-RMSD för kärnan, monomer jämfört med heteromer | 0,68 Å | 0,65 Å |
🔗 NVIDIA-handledning — BioNeMo NIM i Claude Science
Omniverse NuRec anpassar en perceptionsstack till ett fordon som ännu inte finns
31 augusti — Samma dag publicerar NVIDIA en andra teknisk handledning, den här gången om autonom körning. Utgångspunkten är att en perceptionsstack formas av fordonet som bär den: när den flyttas från en SUV till en sedan uppfattar den inte längre världen på samma sätt, eftersom sensorernas placering, kalibrering, synfält, ocklusioner och karossens geometri förändras. Att samla in och annotera en verklig datamängd för varje fordonsserie är dyrt och ofta omöjligt i början av utvecklingen.
Omniverse NuRec föreslår att redan inspelade körningar återanvänds: systemet rekonstruerar varje scen och återger den sedan ur målfordonets sensorkonfiguration. Teamen kan då se hur ett scenario skulle se ut med den nya kamerauppsättningen och var geometriska förändringar skapar döda vinklar. NVIDIA betonar att verkliga kördata fortfarande är nödvändiga för att förankra och validera prestandan: syntetiska data används för att anpassa modellerna innan en särskild datamängd finns, inte för att ersätta den. Scenerna distribueras på Hugging Face i USDZ-format tillsammans med ett repository med skills avsedda för kodagenter.
🔗 NVIDIA-handledning — Omniverse NuRec
Amp kopplar ett ljud- och videosamtalsrum till varje thread
31 augusti — Amp kopplar ett rum för livekonversation till varje thread. Funktionen, som kallas Space to Talk, öppnar ett ljud- och videorum knutet till själva threaden: ett tryck på Enter räcker för att gå in, aktivera kameran och dela skärmen, medan agenten fortsätter sitt arbete i samma tråd.
Det främsta argumentet är att mellanstegen försvinner, och upplägget fortsätter på den samarbetsinriktade väg som Amp följt sedan sommaren: delad kontroll över en orb mellan lagkamrater (Multiplayer, 22 juli), följt av inbjudan genom ett omnämnande direkt i en thread (Pass the Orb to the Left Hand Side, 19 augusti). Threaden blir den gemensamma mötesplatsen för teamet och agenten. Amp medger samtidigt att omfattningen fortfarande är öppen: brainstorming, whiteboard eller samtal med Puck och andra agenter nämns som framtida möjligheter, inte som levererade funktioner.
No links to paste, no calendar invite, no other app. The call lives where the work lives.
🇸🇪 Ingen länk att klistra in, ingen kalenderinbjudan, ingen annan applikation. Samtalet äger rum där arbetet finns. — Amp, meddelandet Space to Talk
VLANeXt, en enhetlig kodbas för vision-language-action-modeller
31 augusti — Ett team publicerar VLANeXt på Hugging Faces blogg, en kodbas för forskning om vision-language-action-modeller (vision-language-action, VLA). Principen för dessa modeller är enkel: en vision-language-modell kopplar det roboten ser till en instruktion på naturligt språk och härleder sedan en handling i den fysiska världen.
Problemet är metodologiskt. Området utvecklas snabbt men fragmenteras: från en publikation till nästa förändras backbone, policyhuvud, handlingsrepresentation, träningsstrategi och utvärderingsprotokoll. Resultaten rapporteras ofta som starka, men det är fortfarande svårt att avgöra vad som faktiskt gör en VLA-modell effektiv eftersom variablerna inte går att isolera.
I stället för att lägga till ännu en arkitektur utgick författarna återigen från en referensbas av typen RT-2 / OpenVLA och utforskade systematiskt designrymden för att ta fram ett recept, ett arbete som resulterade i ICML-artikeln ”VLANeXt: Recipes for Building Strong VLA Models”. Kodbasen har därefter utökats bortom denna studie till backbones av olika storlek, inlärning av latenta handlingar, prediktiv modellering i latent rum och world-action-modellering. Den erbjuder sex utgångspunkter: VLANeXt-LAM, -S, -L, -XL, -JEPA och -WAM.
Kortfattat
- Claude Code 2.1.252, en version med enbart korrigeringar — Fyra korrigeringar och inga nyheter: Bash-kommandon som misslyckades på vissa Mac-datorer, valet ”always allow” som inte sparades i ett projekt utan filen
.claude/settings.local.json, Remote Control-sessioner som frös i flera minuter efter att ett verktyg avslutats när anslutningen till claude.ai var försämrad samt aviseringar från bakgrundsuppgifter med stora mängder output som fick API-begäran att överskrida storleksgränsen. 🔗 CHANGELOG för Claude Code - Flow inför kontroll över första och sista bilden på datorn — Google Flow meddelar att kontrollen över den första och sista bilden i Gemini Omni 1.1 Flash, som presenterades tillsammans med modellen den 27 augusti, nu är tillgänglig på datorn. Det framhävda användningsfallet är att ange samma bild i båda ändarna för att skapa en loop. 🔗 Inlägg från @FlowbyGoogle
- Sista dagen att tävla om Grok Imagine-priset — xAI påminde om att tidsfristen för videotävlingen som lanserades den 17 augusti löpte ut samma dag. Deltagarna skulle skapa en scen ur Homeros Odysséen som lyfte fram modellens video- och röstfunktioner; de tre bästa bidragen delar på 175 000 dollar, med 100 000, 50 000 respektive 25 000 dollar i prispengar. 🔗 Inlägg från @grok
- QwenCloud stänger sin Arena och tillkännager en session i Bangkok — Qwen Cloud Arena-utmaningen, som ägnades åt agenter för innehållsgenerering inom gränsöverskridande e-handel, stängde för bidrag vid midnatt Pekingtid efter fler än 800 deltagare, och granskningsfasen inleddes dagen därpå. Några timmar tidigare hade QwenCloud tillkännagett en session vid Qwen Conference i Bangkok den 4 september, med samma upplägg kring tre ingångar — webbplats, Skills och CLI — som redan presenterats i Hongkong. 🔗 Stängningen av Arena · 🔗 Sessionen i Bangkok
- GitHub inleder en undersökning om utvecklares tillgänglighetsanpassningar — Företaget vill dokumentera de verktyg, produktinställningar och personliga anpassningar som gör det möjligt att arbeta under goda förhållanden, utan krav på att uppge en funktionsnedsättning eller identifiera sig som användare av tillgänglighetsverktyg. Svar tas emot till och med den 30 september. Ämnet saknar koppling till AI. 🔗 Inlägg från @github
- otoSpeech Task, en full-duplex-korpus publicerad tillsammans med sin uppgift — Tjugo timmars engelskspråkiga samtal mellan två talare, 58 sessioner fördelade på sju samarbetsuppgifter och 11 025 tidsstämplade händelser, under licensen CC BY 4.0. Det utmärkande är att bilderna som varje talare ser, deras handlingar och referenssvaren finns på samma tidslinje som ljudet. 🔗 Inlägg på Hugging Face
- YOLO26-RGB, en modell för borttagning av regn härledd från ett djuphuvud — Två modeller för borttagning av regn som skapats genom att ersätta det enkanaliga djuphuvudet i YOLO26-depth med ett trekanaligt RGB-restaureringshuvud: 5,25 M parametrar vid omkring 109 bilder/s i 1080p och 12,13 M vid omkring 92 bilder/s för 0,1 dB högre kvalitet. 🔗 Inlägg på Hugging Face
Vad det innebär
Generera gränssnittet i stället för koden som skapar det. Solaris flyttar gränsen mellan design och exekvering. Hela dagens programvarukedja bygger på en översättning — en mockup blir kod, koden producerar en visuell rendering — och Runway mäter vad denna översättning kostar: för 30 gränssnitt som skulle återskapas från en skärmbild förlorade samtliga testade multimodala modeller information, och försämringen ökade med den visuella detaljrikedomen. Att ta bort mellansteget är ett radikalt förslag, och de begränsningar som laboratoriet självt räknar upp visar var det stöter på patrull: text som inte håller sig på plats, inga garanterade faktamässiga förankringar och tillgänglighet som måste byggas helt från grunden eftersom en genererad bild inte exponerar någon struktur för skärmläsare. Det är grundläggande hinder, inte detaljer som återstår att finslipa.
Två sätt att betala för beräkningskapacitet, tillkännagivna samma dag. OpenAI uppger att dess annonsverksamhet har en annualiserad intäktstakt på en miljard dollar — en tolvmånadersprognos, inte faktiska inbetalningar — och betraktar den som en ekonomisk pelare jämbördig med abonnemangen: annonser finansierar gratisnivån i en tjänst som uppger sig ha fler än en miljard användare varje vecka. Together AI, å sin sida, tjänar inte pengar på en publik och köper inte heller ytterligare kapacitet: företaget får 250 MW och 120 000 chip i Saudiarabien i utbyte mot en andel av sina intäkter och pekar ut energi som sektorns verkliga flaskhals. De båda företagen möter samma begränsning från varsin motsatt ände av kedjan, och inget av svaren är neutralt: det ena för in ett kommersiellt intresse i produkten, det andra flyttar infrastrukturen dit den möter mindre politiskt motstånd.
Konkurrensen mellan agenter avgörs numera efter förträningen. GLM-5.3:s resultat på Artificial Analysis agentindex är framför allt betydelsefullt på grund av hur det uppnåddes: Z.ai behöll GLM-5.2 som bas och skalade endast upp efterträningen — miljöer med lång tidshorisont, mångfald av uppgifter och RL-beräkningskapacitet. Om det inte längre krävs att en basmodell tränas om för att nå toppen av en agentrankning, upphör den tyngsta kostnadsposten att vara den enda avgörande faktorn för placeringen, samtidigt som modellens uppdateringscykel förkortas i motsvarande grad. Det är också den mest ekonomiska förklaringen till modellens sex dagar långa förlopp, från öppna vikter den 28:e till denna placering den 31:a.
Utvecklarverktygen omorganiseras kring flera agenter samtidigt. Copilots changelog ägnar en hel cykel åt att behandla fönstret Agents som en arbetsyta — chattar sida vid sida, en sidokonversation som delar promptcache, en tidslinje över prompter och flera fönster anslutna till samma session — och inte längre som en lista över konversationer. Amp kopplar ett samtalsrum till tråden så att den mänskliga diskussionen äger rum där agenten arbetar. Slutligen paketerar NVIDIA tio års vetenskapliga bibliotek som anropbara skills och levererar ett andra skill-repositorium för rekonstruktion av körscener. Tre mycket olika aktörer närmar sig samma idé: det agenten saknar är inte längre modellkapacitet, utan den delade kontexten och de specialiserade verktyg som kan tillhandahållas.
Källor
- Runway — Solaris presenteras
- Runway — tillkännagivandet av Solaris på X
- OpenAI — En milstolpe i arbetet med att bredda tillgången till AI
- Together AI — infrastrukturavtal på 250 MW med HUMAIN
- Together AI — GLM-5.3 på Artificial Analysis agentindex
- Together AI — Greptile som primär leverantör av inferens
- GitHub Changelog — Copilot i VS Code, versionerna från augusti 2026
- NVIDIA — BioNeMo NIM för prediktion av proteinstruktur i Claude Science
- NVIDIA — Omniverse NuRec och perception med flera fordon
- Amp — Utrymme att prata
- VLANeXt, en enhetlig kodbas för vision-språk-handlingsmodeller
- Claude Codes CHANGELOG
- Google Flow — första och sista bilderna på datorn
- xAI — sista dagen i Grok Imagine-tävlingen
- QwenCloud — avslutningen av Qwen Cloud Arena
- QwenCloud — session vid Qwen Conference i Bangkok
- GitHub — undersökning om verktyg och tillgänglighetsanpassningar
- otoSpeech Task, korpus för full duplex-konversationer
- YOLO26-RGB, modell för borttagning av regn