ai-powered-markdown-translatorArtigo traduzido do fr para o pt com gpt-5.6-sol.
Dezoito anúncios para 30 e 31 de agosto, com uma distribuição muito desequilibrada: o domingo não produziu nenhuma publicação oficial, e quase todo o conteúdo está datado de segunda-feira. A falha do X assinalada na edição do dia 30 foi compensada: as contas que permaneceram inacessíveis nesse dia foram novamente consultadas ao longo de três dias, sem revelar qualquer anúncio em falta.
Destacam-se três eixos. Primeiro, um modelo inédito, com o primeiro modelo do mundo de interfaces da Runway. Depois, dois marcos económicos: o ritmo de receitas anualizado de mil milhões de dólares atingido pela plataforma publicitária da OpenAI e um contrato de infraestrutura de 250 MW assinado pela Together AI. Por fim, um ciclo de ferramentas para programadores na GitHub, NVIDIA e Amp, complementado por três trabalhos de investigação publicados no blogue comunitário da Hugging Face.
Runway lança Solaris, o seu primeiro modelo do mundo de interfaces
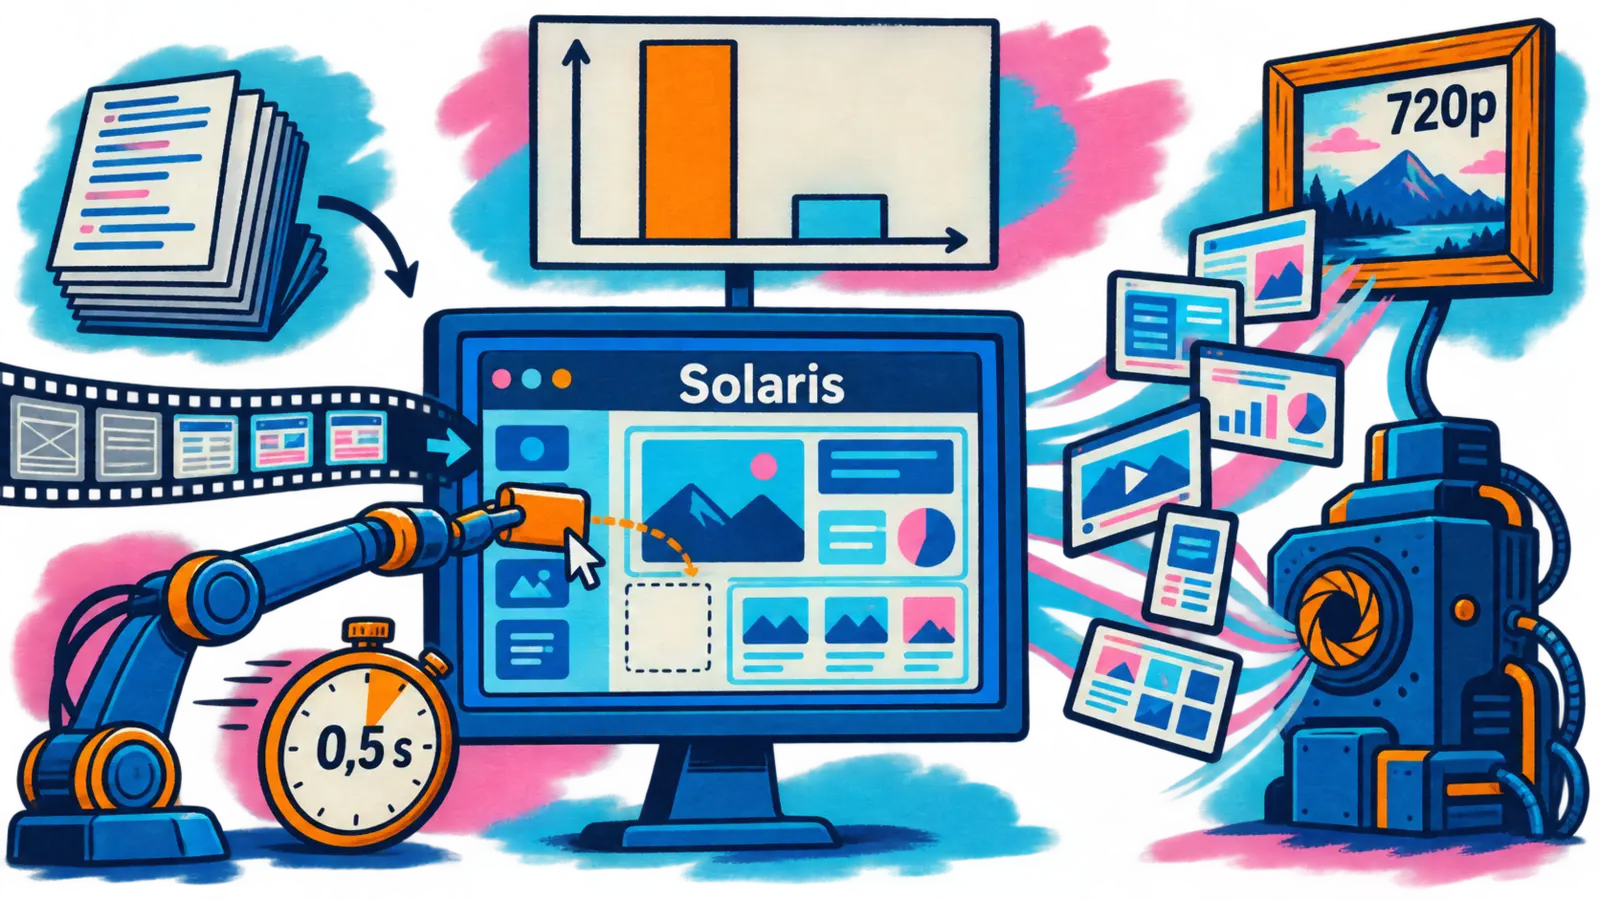
31 de agosto — A Runway apresentou Solaris, o primeiro modelo de uma família a que o laboratório chama modelos do mundo de interfaces (Interface World Models). O princípio resume-se numa frase: em vez de produzir código que depois exibirá uma interface, o modelo gera diretamente a interface, imagem a imagem, e reage a cliques e ações de arrastar e largar em tempo real.
O raciocínio parte de uma constatação sobre a cadeia de produção de software. Uma maquete tem primeiro de ser traduzida em código antes de poder fazer seja o que for, e essa tradução tem um custo duplo: cada comportamento tem de ser definido antecipadamente, pelo que o software fica congelado antes da chegada do primeiro utilizador, e a riqueza visual da conceção original perde-se pelo caminho. Solaris elimina a etapa intermédia, e a imagem inteira torna-se a interface.
Tecnicamente, o modelo baseia-se no Gen-4.5, o modelo de vídeo da Runway, e dá continuidade ao GWM-1, o seu modelo do mundo generalista. As entradas do utilizador condicionam a imagem seguinte da mesma forma que um texto ou uma imagem, pelo que a relação entre uma ação e o seu resultado visual é aprendida sem que qualquer comportamento seja programado. A passagem para o tempo real exigiu três etapas: tornar a geração autorregressiva imagem a imagem, destilar a remoção de ruído em várias etapas para apenas algumas etapas e, depois, treinar o modelo rápido com os seus próprios resultados. Um LLM decide a evolução da cena enquanto o modelo do mundo efetua a renderização.
| Critério avaliado pelos participantes | Solaris | Interface programada (Claude Opus 5) | Avaliações equivalentes |
|---|---|---|---|
| Cumprimento da instrução solicitada | 61 % | 24 % | 13 % |
| Naturalidade do comportamento na cena | 71 % | 21 % | 6 % |
| Característica técnica | Valor medido |
|---|---|
| Modelo de base | Gen-4.5, na continuidade do GWM-1 |
| Resolução mantida | 720p |
| Limiar de interatividade | cerca de 0,5 s de latência |
| Estudo com utilizadores | 250 participantes, 30 exemplos, cerca de 7 500 avaliações por pares |
| Benchmark de reconstrução | 30 interfaces, similaridade estrutural (SSIM) e descritores DINOv3 |
A diferença é claramente mais acentuada na naturalidade do comportamento do que no simples cumprimento da instrução, e a Runway vê aí a diferença fundamental entre as duas abordagens: uma interface programada consegue frequentemente reproduzir a alteração solicitada, mas trata-a como uma atualização isolada, ao passo que um modelo que aprendeu o comportamento dos objetos produz uma reação coerente com o resto da cena. O laboratório propõe uma segunda utilização, menos esperada: o treino de agentes, aos quais um ambiente que se regenera continuamente proporcionaria interfaces em constante mudança, incluindo disposições que nunca existiram.
A Runway também documenta aquilo que Solaris ainda não consegue fazer, e a lista é substancial: o texto estável e legível continua a ser um dos problemas mais difíceis da geração de vídeo, embora as interfaces dependam dele mais do que qualquer outro domínio; a fundamentação factual exige que a geração seja condicionada por dados verificados; a coerência em sessões longas continua a ser um tema de investigação; e uma interface gerada ainda tem de funcionar com tecnologias de apoio e API de acessibilidade. O lançamento público está a ser preparado com parceiros, sendo o acesso antecipado disponibilizado através de um formulário.
Today, we’re sharing new research on Solaris, our first Interface World Model. Solaris is a new kind of operating system that generates interactive interfaces frame by frame, in real time, with no code.
🇵🇹 Hoje, partilhamos novos trabalhos de investigação sobre Solaris, o nosso primeiro Interface World Model. Solaris é um novo tipo de sistema operativo que gera interfaces interativas imagem a imagem, em tempo real e sem código. — @runwayml no X
🔗 Runway — Apresentação de Solaris
ChatGPT Ads atinge um ritmo de receitas anualizado de mil milhões de dólares e abre o seu autosserviço a quatro novas regiões
31 de agosto — A OpenAI publicou um artigo dedicado ao ChatGPT Ads, a sua plataforma publicitária integrada no ChatGPT, e anunciou que a plataforma atingiu um ritmo de receitas anualizado (annualized revenue run rate) de mil milhões de dólares menos de 200 dias após o lançamento. Importa esclarecer desde já uma nuance: não se trata de mil milhões efetivamente recebidos, mas da receita do período recente projetada para doze meses. Uma plataforma publicitária com menos de duzentos dias de existência não pode, por definição, ter recebido um ano inteiro de receitas a esse ritmo. A abertura das compras em autosserviço através do Ads Manager na Índia, Europa, Médio Oriente e Norte de África está anunciada para mais tarde nesse dia.
A OpenAI apresenta a publicidade como um dos pilares do seu modelo económico, a par das subscrições para o público em geral, das ofertas empresariais e das API faturadas conforme a utilização, e associa-a explicitamente ao financiamento do nível gratuito que mantém o ChatGPT acessível a mais de mil milhões de utilizadores ativos semanais. Quatro compromissos enquadram o sistema: os anúncios são sempre claramente identificados e separados das respostas, a publicidade não influencia as respostas fornecidas, os anunciantes não têm acesso às conversas privadas e o utilizador controla o grau de personalização da sua experiência publicitária.
| Métrica publicada pela OpenAI | Valor anunciado |
|---|---|
| Ritmo de receitas anualizado (projeção) | mil milhões de dólares |
| Tempo decorrido desde o lançamento | menos de 200 dias |
| Anunciantes na plataforma | dezenas de milhares |
| Países já abrangidos | mais de 40 |
| Novos mercados abertos em autosserviço | Índia, Europa, Médio Oriente, Norte de África |
| Parceiros tecnológicos e de medição | mais de 50 |
| Utilizadores ativos semanais do ChatGPT | mais de mil milhões |
| Retorno sobre o investimento publicitário citado em 28 dias | 3x, num anunciante de e-commerce |
| Tráfego publicitário proveniente de novos clientes | mais de 80 %, num parceiro tecnológico |
A trajetória descrita é a de uma passagem das vendas geridas para uma plataforma de livre acesso. O modelo inicial assentava em agências e parceiros; a chegada do Ads Manager em maio abriu a plataforma publicitária às pequenas e médias empresas, que representam agora uma parte significativa da atividade. No que toca às ferramentas, os leilões CPC e os leilões otimizados para resultados (outcome-optimized bidding) constituem a maioria das campanhas, enquanto o Pixel e a API Conversions servem de base à medição. A OpenAI observa também que os anunciantes fora dos Estados Unidos representam uma parcela crescente da receita.
Para o futuro, a empresa anuncia novos mercados, formatos, objetivos e opções de compra, e afirma querer explorar formas mais nativas de as empresas interagirem com os consumidores dentro do ChatGPT — ou seja, formatos menos separados da conversa do que os anúncios atuais.
🔗 OpenAI — Um marco na expansão do acesso à IA
Together AI: 250 MW na Arábia Saudita, GLM-5.3 no topo do índice agêntico e um novo cliente
31 de agosto — A Together AI anunciou a assinatura de um acordo de infraestrutura relativo a um centro de dados de 250 MW na Arábia Saudita, construído com a HUMAIN. O laboratório espera que a atividade deste centro gere receitas de 5 mil milhões de dólares por ano e apresenta a operação como um dos maiores acordos de infraestrutura de IA celebrados para o open source. A mensagem foi afixada no perfil do laboratório, o que a distingue da sua comunicação habitual sobre modelos.
O número exige cautela na leitura, pois a mensagem de anúncio justapõe três fragmentos sem verbo e deixa ambíguo o sujeito dos 5 mil milhões. É a cobertura do New York Times que esclarece a questão: o montante descreve a receita esperada deste centro de dados, não a da empresa. A ordem de grandeza confirma-o, uma vez que o mesmo artigo situa a avaliação da Together AI em 8,3 mil milhões de dólares em julho de 2026 — uma empresa avaliada nesse nível não gera 5 mil milhões de dólares de volume de negócios anual.
A própria estrutura do acordo merece atenção, pois não se trata de uma compra de capacidade. Ainda segundo o New York Times, a HUMAIN fornece 120 000 semicondutores, além dos 250 MW, e a Together AI opera esses chips, cedendo em troca uma parte da sua receita. O laboratório não financia, portanto, a infraestrutura: utiliza-a em troca de uma fração do seu volume de negócios. É exatamente isso que a thread reivindica ao contrapor as parcerias que disponibilizam capacidade computacional a uma corrida em que cada interveniente teria de angariar os seus próprios milhares de milhões. A HUMAIN, criada no ano passado por iniciativa do príncipe herdeiro Mohammed bin Salman, insere-se no esforço saudita para construir uma indústria de IA e reduzir a dependência do país em relação ao petróleo.
O argumento desenvolvido na thread incide menos sobre o volume do que sobre a natureza do estrangulamento. A Together AI descreve a energia como o verdadeiro fator limitante do momento e o acordo como uma forma de aceder a uma escala que uma empresa da sua dimensão não conseguiria financiar com o seu próprio balanço. O laboratório contrapõe explicitamente esta estrutura ao modelo dos laboratórios fechados, cuja infraestrutura foi durante muito tempo financiada pelos hyperscalers.
Esta interpretação esclarece a posição particular da Together AI no ecossistema: o laboratório não publica modelos de fronteira, disponibiliza os de outros — DeepSeek, GLM, Kimi, MiniMax, Nemotron. A sua limitação não é, portanto, a investigação, mas a capacidade computacional disponível para disponibilizar modelos de pesos abertos abaixo do preço das API proprietárias. Um contrato de 250 MW responde diretamente a essa necessidade.
| Elemento do acordo | Valor comunicado |
|---|---|
| Capacidade do centro de dados | 250 MW |
| Semicondutores fornecidos pela HUMAIN | 120 000 |
| Receita anual esperada do centro de dados | 5 mil milhões de dólares |
| Contrapartida paga à HUMAIN | uma parte da receita da Together AI |
| Avaliação da Together AI em julho de 2026 | 8,3 mil milhões de dólares |
| Parceiro industrial | HUMAIN |
| Localização | Arábia Saudita |
| Data e hora do anúncio | 31 de agosto de 2026, 13:26 UTC |
Um último ponto, que a Together AI não comenta na sua thread: o mesmo artigo observa que a implantação saudita permite contornar a resistência encontrada nos Estados Unidos à instalação de centros de dados.
We just signed one of the largest AI infrastructure deals for open source, period. 250MW data center. $5B+ in annualized revenue. Built with @HUMAIN in Saudi Arabia.
🇵🇹 Acabámos de assinar um dos maiores acordos de infraestrutura de IA para o open source, ponto final. Centro de dados de 250 MW. Mais de 5 mil milhões de dólares de receita anualizada. Construído com a @HUMAIN na Arábia Saudita. — @togethercompute no X
GLM-5.3 alcança o primeiro lugar do índice agêntico da Artificial Analysis
31 de agosto — Sexto dia consecutivo em que GLM-5.3 é notícia: depois da abertura dos pesos pela Z.ai em 28 de agosto e da disponibilização do modelo na API serverless da Together AI no dia 29, é desta vez uma classificação independente que o distingue. No índice agêntico da Artificial Analysis, o modelo atinge 59 pontos. A Together AI formula o resultado com precisão: GLM-5.3 está empatado no primeiro lugar (ties for the top spot) e supera (beating) GPT-5.6 Sol e Claude Fable 5. A vantagem refere-se, portanto, a estes dois modelos; com Claude Opus 5, também com 59 pontos, GLM-5.3 partilha a liderança.
O aspeto mais instrutivo reside no método. A Z.ai não treinou um novo modelo de base: a base GLM-5.2 foi mantida, e todo o ganho provém do pós-treino, ampliado simultaneamente em três eixos — mais ambientes de horizonte longo, uma maior diversidade de tarefas e mais compute dedicado ao RL.
| Modelo avaliado | Pontuação no índice agêntico |
|---|---|
| GLM-5.3 (max) | 59 |
| Claude Opus 5 (max) | 59 |
| GLM-5.3 Flash | 58 |
| GPT-5.6 Sol (max) | 58 |
| Claude Fable 5 (com fallback) | 57 |
🔗 Mensagem de @togethercompute
Greptile escolhe a Together AI como principal fornecedor de inferência
31 de agosto — Último sinal do dia, mais modesto: a Greptile, ferramenta de revisão de código por IA utilizada por mais de 11 000 equipas, escolheu a Together AI como principal fornecedor de inferência. A ferramenta analisa pull requests com o contexto completo do repositório, um perfil de carga composto por contextos longos e grandes volumes de tokens — precisamente a utilização em que a diferença de custo entre modelos de pesos abertos e API proprietárias se torna determinante.
🔗 Mensagem de @togethercompute
GitHub Copilot no VS Code: quatro versões de agosto resumidas num changelog
31 de agosto — O GitHub publica o resumo de agosto de 2026 do Copilot no Visual Studio Code, que abrange quatro versões do editor, da v1.132 à v1.135. O fio condutor do ciclo é a organização do trabalho com vários agentes: a janela Agents deixa de ser uma simples lista de conversas para se tornar um espaço onde várias sessões coexistem e são retomadas no estado em que ficaram.
Quanto às sessões, os chats são dispostos lado a lado em grupos horizontais ou verticais, e a disposição é restaurada ao regressar. O comando /btw abre uma conversa lateral que partilha o contexto e a cache de prompts da conversa principal enquanto esta continua em execução: assim, é possível fazer uma pergunta paralela sem interromper um agente em execução. Um controlo da cronologia dos prompts, acessível a partir da margem do transcript, permite saltar diretamente para um prompt e rever as alterações de ficheiros resultantes. O Agent Host permite que várias janelas do VS Code se liguem à mesma sessão, e um comando experimental /rubber-duck solicita a um modelo complementar que identifique detalhes ignorados e casos-limite.
Dois pontos dizem respeito diretamente ao lugar do Claude no editor: uma definição experimental abre a janela Agents sem ligação ao GitHub quando o Claude está configurado com uma chave de API, e as sessões Claude permitem alternar a qualquer momento entre os modelos da subscrição Anthropic e os da subscrição Copilot. Além disso, o VS Code permite instalar plugins de agentes portáteis em conformidade com a norma Agent Plugins 1.0, utilizáveis noutros clientes de agentes compatíveis.
| Área do changelog | Novidades de destaque |
|---|---|
| Sessões e workflows | Chats lado a lado, /btw, cronologia dos prompts, Agent Plugins 1.0, /rubber-duck, Agent Host |
| Claude no VS Code | Janela Agents sem ligação ao GitHub através de chave de API, alternância entre modelos Anthropic e Copilot |
| Chat e revisão | Pesquisa no transcript, deslocamento fixo, editor Markdown híbrido, tokens por modelo |
| Navegador integrado | Anotação em lote de elementos HTML, recarregamento automático, editor HTML predefinido |
| Ditado | Multilingue no dispositivo, instruções de limpeza, limpeza adaptada ao shell |
Por fim, o chat ganha as ferramentas de leitura exigidas por conversas cada vez mais longas: pesquisa de texto em todo o transcript com distinção entre maiúsculas e minúsculas, palavras inteiras e expressões regulares; deslocamento fixo que mantém visível o prompt atual; e visualização do consumo de tokens por modelo ao passar o cursor sobre o rodapé da resposta, distinguindo entrada, entrada em cache e saída — uma visibilidade útil desde que a faturação passou a depender da cache. O navegador integrado permite selecionar e anotar vários elementos HTML de uma página para processar em lote o feedback sobre a interface, e o ditado é executado no dispositivo, em vários idiomas, preservando a sintaxe dos comandos quando se dita num terminal, em vez de inserir a pontuação pronunciada.
🔗 GitHub Changelog — Copilot no VS Code, versões de agosto de 2026
NVIDIA leva os seus componentes de software para a biologia e os veículos autónomos
31 de agosto — A NVIDIA publicou um tutorial que documenta um trabalho de integração realizado com a Anthropic: o BioNeMo Agent Toolkit pode agora ser utilizado a partir do Claude Science, o ambiente de investigação científica da Anthropic. O problema abordado é o das ferramentas especializadas — um agente generalista pode reconhecer que uma tarefa exige dobrar uma proteína sem, no entanto, saber qual modelo executar, como formatar o pedido ou quais parâmetros são importantes. O toolkit reúne mais de uma década de modelos, bibliotecas e workflows BioNeMo — biologia, química, genómica e descoberta de medicamentos — em skills que podem ser acionadas por um agente. Nos seus benchmarks internos, a NVIDIA anuncia um aumento da precisão das tarefas de 60 para 100% e uma eficiência de tokens aproximadamente duplicada.
O tutorial encadeia três microserviços NIM: MSA Search para construir o contexto evolutivo, seguido de OpenFold3 e Boltz-2 para preverem a estrutura de forma independente. A demonstração mais elucidativa aborda o papel do alinhamento múltiplo de sequências — sem ele, a confiança na interface cai drasticamente nos dois modelos, e nem mesmo um orçamento de amostragem mais generoso altera o resultado. Duas ressalvas merecem destaque: a barreira de hardware, com uma GPU L40S ou H100 e cerca de 700 GB de armazenamento, e a prudência interpretativa demonstrada pela NVIDIA, que recorda que uma pontuação de confiança não comprova uma interação e apresenta a convergência de dois modelos independentes como uma hipótese sólida, não como uma prova.
| Medida de confiança da interface (iPTM) | OpenFold3 | Boltz-2 |
|---|---|---|
| Heterómero com alinhamento MSA | 0,85 | 0,82 |
| Heterómero sem alinhamento MSA | 0,14 | 0,19 |
| RMSD Cα do núcleo, monómero contra heterómero | 0,68 Å | 0,65 Å |
🔗 Tutorial da NVIDIA — BioNeMo NIM no Claude Science
Omniverse NuRec adapta uma stack de perceção a um veículo que ainda não existe
31 de agosto — No mesmo dia, a NVIDIA publica um segundo tutorial técnico, desta vez dedicado à condução autónoma. O ponto de partida é que uma stack de perceção é moldada pelo veículo que a transporta: quando transferida de um SUV para um sedan, deixa de perceber o mundo da mesma forma, pois a posição dos sensores, a calibração, os campos de visão, as oclusões e a geometria da carroçaria são todos diferentes. Recolher e anotar um conjunto de dados real para cada linha de veículos é dispendioso e, muitas vezes, continua a ser impossível no início do desenvolvimento.
O Omniverse NuRec propõe reutilizar os trajetos já registados: reconstrói cada cena e depois reprodu-la a partir da configuração de sensores do veículo de destino. As equipas podem então perceber como seria um cenário visto através da nova disposição das câmaras e onde as alterações de geometria criam ângulos mortos. A NVIDIA salienta que os dados reais de condução continuam a ser indispensáveis para fundamentar e validar o desempenho: os dados sintéticos servem para adaptar os modelos antes de existir um conjunto de dados dedicado, não para o substituir. As cenas são distribuídas no Hugging Face no formato USDZ, acompanhadas por um repositório de skills destinado a agentes de código.
🔗 Tutorial da NVIDIA — Omniverse NuRec
Amp associa uma sala de chamadas de áudio e vídeo a cada thread
31 de agosto — O Amp associa uma sala de conversação em direto a cada thread. A funcionalidade, denominada Space to Talk, abre um espaço de áudio e vídeo ligado ao próprio thread: basta premir a tecla Enter para entrar, ativar a câmara e partilhar o ecrã, enquanto o agente prossegue o trabalho no mesmo fio.
O argumento apresentado é a eliminação das etapas intermédias, e esta lógica prolonga a trajetória colaborativa seguida pelo Amp desde o verão: partilha do controlo de um orb entre colegas de equipa (Multiplayer, 22 de julho), seguida do convite por menção diretamente num thread (Pass the Orb to the Left Hand Side, 19 de agosto). O thread torna-se o ponto de encontro único da equipa e do agente. O Amp reconhece, além disso, que o âmbito permanece em aberto: brainstorming, quadro branco ou conversas com Puck e outros agentes são mencionados como possibilidades futuras, não como funcionalidades já disponibilizadas.
No links to paste, no calendar invite, no other app. The call lives where the work lives.
🇵🇹 Nenhum link para colar, nenhum convite de calendário, nenhuma outra aplicação. A chamada acontece onde está o trabalho. — Amp, nota Space to Talk
VLANeXt, uma base de código unificada para modelos de visão-linguagem-ação
31 de agosto — Uma equipa publica no blog do Hugging Face o VLANeXt, uma base de código de investigação dedicada aos modelos de visão-linguagem-ação (vision-language-action, VLA). O princípio destes modelos é simples: um modelo de visão-linguagem relaciona aquilo que o robô vê com uma instrução em linguagem natural e, em seguida, deriva daí uma ação no mundo físico.
O problema visado é metodológico. A área avança rapidamente, mas fragmenta-se: de uma publicação para outra, mudam o backbone, a cabeça da política, a representação das ações, a estratégia de treino e o protocolo de avaliação. Os resultados são frequentemente apresentados como sólidos, mas continua a ser difícil determinar o que torna realmente eficaz um modelo VLA, devido à impossibilidade de isolar as variáveis.
Em vez de acrescentarem mais uma arquitetura, os autores retomaram uma base de referência do tipo RT-2 / OpenVLA e exploraram metodicamente o espaço de design para daí extraírem uma receita, trabalho que deu origem ao artigo da ICML «VLANeXt: Recipes for Building Strong VLA Models». Desde então, a base de código foi alargada para além deste estudo, abrangendo backbones de diferentes dimensões, aprendizagem de ações latentes, modelação preditiva no espaço latente e modelação mundo-ação. Disponibiliza seis pontos de partida: VLANeXt-LAM, -S, -L, -XL, -JEPA e -WAM.
Notícias breves
- Claude Code 2.1.252, uma versão exclusivamente corretiva — Quatro correções e nenhuma novidade: comandos Bash que falhavam em alguns Mac, escolha «always allow» não guardada num projeto sem ficheiro
.claude/settings.local.json, sessões Remote Control bloqueadas durante vários minutos após a conclusão de uma ferramenta quando a ligação ao claude.ai estava degradada e notificações de tarefas em segundo plano com saídas volumosas que faziam ultrapassar o limite de tamanho dos pedidos à API. 🔗 CHANGELOG do Claude Code - Flow disponibiliza o controlo da primeira e da última imagem no desktop — O Google Flow informa que o controlo da primeira e da última imagem do Gemini Omni 1.1 Flash, apresentado com o modelo em 27 de agosto, já está disponível no desktop. A utilização destacada: fornecer a mesma imagem nas duas extremidades para produzir um loop. 🔗 Publicação de @FlowbyGoogle
- Último dia para concorrer ao prémio Grok Imagine — A xAI recordou que o prazo do concurso de vídeo lançado em 17 de agosto terminava nesse mesmo dia. Os participantes tinham de produzir uma cena retirada de A Odisseia, de Homero, que destacasse as capacidades de vídeo e voz do modelo; os três melhores trabalhos partilham 175 000 dólares, recebendo respetivamente 100 000, 50 000 e 25 000 dólares. 🔗 Publicação de @grok
- QwenCloud encerra a sua Arena e anuncia uma sessão em Banguecoque — O desafio Qwen Cloud Arena, dedicado a agentes de geração de conteúdo para o comércio eletrónico transfronteiriço, encerrou as submissões à meia-noite, hora de Pequim, após mais de 800 participantes, com a fase de avaliação a começar no dia seguinte. Algumas horas antes, a QwenCloud tinha anunciado uma sessão na Qwen Conference de Banguecoque, em 4 de setembro, com o mesmo posicionamento em três pontos de entrada — site, Skills e CLI — já apresentado em Hong Kong. 🔗 Encerramento da Arena · 🔗 Sessão de Banguecoque
- GitHub lança um inquérito sobre as adaptações de acessibilidade dos programadores — A empresa pretende documentar as ferramentas, definições de produto e adaptações pessoais que permitem trabalhar em boas condições, sem exigir que os participantes se declarem pessoas com deficiência nem que se considerem utilizadores de ferramentas de acessibilidade. Respostas aceites até 30 de setembro. Tema sem relação com a IA. 🔗 Publicação de @github
- otoSpeech Task, um corpus full-duplex publicado com a respetiva tarefa — Vinte horas de conversas em inglês com dois interlocutores, 58 sessões em sete tarefas colaborativas e 11 025 eventos com marca temporal, sob licença CC BY 4.0. A particularidade reside no facto de as imagens vistas por cada interlocutor, as suas ações e as respostas de referência figurarem na mesma linha temporal que o áudio. 🔗 Publicação no Hugging Face
- YOLO26-RGB, um modelo de remoção de chuva derivado de uma cabeça de profundidade — Dois modelos de remoção de chuva obtidos através da substituição da cabeça de profundidade de 1 canal do YOLO26-depth por uma cabeça de restauração RGB de 3 canais: 5,25 M de parâmetros a cerca de 109 imagens/s em 1080p, e 12,13 M a cerca de 92 imagens/s para uma melhoria adicional de 0,1 dB na qualidade. 🔗 Publicação no Hugging Face
O que isso significa
Gerar a interface em vez do código que a produz. Solaris desloca a fronteira entre conceção e execução. Toda a cadeia de software atual assenta numa tradução — uma maquete transforma-se em código, o código produz uma visualização — e a Runway mede o custo dessa tradução: em 30 interfaces a reconstruir a partir de uma captura de ecrã, todos os modelos multimodais testados perdem informação, e a degradação acentua-se com a riqueza visual. Eliminar a etapa intermédia é uma proposta radical, e as limitações que o próprio laboratório enumera indicam onde ela esbarra: texto que não permanece no lugar, nenhuma ancoragem factual garantida e uma acessibilidade inteiramente por construir, uma vez que uma imagem gerada não apresenta qualquer estrutura aos leitores de ecrã. São obstáculos fundamentais, não meros acabamentos.
Duas formas de pagar pelo processamento, anunciadas no mesmo dia. A OpenAI apresenta, na sua plataforma publicitária, uma receita anualizada de mil milhões de dólares — uma projeção para doze meses, não um montante efetivamente recebido — e assume-a como um pilar económico ao mesmo nível das subscrições: a publicidade financia o nível gratuito de um serviço que afirma ter mais de mil milhões de utilizadores semanais. A Together AI, por sua vez, não monetiza uma audiência nem compra capacidade adicional: obtém 250 MW e 120 000 chips na Arábia Saudita em troca de uma parte da sua receita, apontando a energia como o verdadeiro estrangulamento do setor. As duas empresas respondem à mesma restrição pelas duas extremidades opostas da cadeia, e nenhuma das respostas é neutra: uma insere um interesse comercial no produto, enquanto a outra desloca a infraestrutura para onde encontra menos resistência política.
A competição entre agentes joga-se agora depois do pré-treino. O resultado do GLM-5.3 no índice de agentes da Artificial Analysis é sobretudo relevante pela forma como foi obtido: a Z.ai manteve a base GLM-5.2 e aumentou apenas a escala do pós-treino — ambientes de longo horizonte, diversidade de tarefas, compute de RL. Se chegar ao topo de uma classificação de agentes já não exige voltar a treinar uma base, então a rubrica de custos mais pesada deixa de ser o único fator determinante da classificação, e o ciclo de atualização de um modelo encurta na mesma medida. É também a explicação mais económica para a sequência de seis dias vivida por este modelo, desde os pesos abertos no dia 28 até esta classificação no dia 31.
As ferramentas para programadores estão a reorganizar-se em torno de vários agentes em simultâneo. O changelog do Copilot dedica um ciclo inteiro a transformar a janela Agents num espaço de trabalho — chats lado a lado, conversa lateral que partilha a cache de prompts, cronologia dos prompts, várias janelas ligadas à mesma sessão — e já não numa lista de conversas. O Amp associa uma sala de chamada ao thread para que a discussão humana decorra onde o agente trabalha. Por fim, a NVIDIA reúne dez anos de bibliotecas científicas em skills invocáveis e disponibiliza um segundo repositório de skills para a reconstrução de cenas de condução. Três intervenientes muito diferentes convergem na mesma ideia: o que falta ao agente já não é a capacidade do modelo, mas o contexto partilhado e as ferramentas especializadas que lhe podem ser disponibilizadas.
Fontes
- Runway — Apresentação do Solaris
- Runway — anúncio do Solaris no X
- OpenAI — Um marco na expansão do acesso à AI
- Together AI — acordo de infraestrutura de 250 MW com a HUMAIN
- Together AI — GLM-5.3 no índice de agentes da Artificial Analysis
- Together AI — Greptile como principal fornecedor de inferência
- GitHub Changelog — Copilot no VS Code, versões de agosto de 2026
- NVIDIA — BioNeMo NIM para a previsão de estruturas proteicas no Claude Science
- NVIDIA — Omniverse NuRec e a perceção multiveículo
- Amp — Espaço para conversar
- VLANeXt, base de código unificada para modelos de visão-linguagem-ação
- CHANGELOG do Claude Code
- Google Flow — primeira e última imagens no computador
- xAI — último dia do concurso Grok Imagine
- QwenCloud — encerramento do Qwen Cloud Arena
- QwenCloud — sessão na Qwen Conference de Banguecoque
- GitHub — inquérito sobre ferramentas e adaptações de acessibilidade
- otoSpeech Task, corpus de conversação full-duplex
- YOLO26-RGB, modelo de remoção de chuva