ai-powered-markdown-translatorgpt-5.6-solを使用してフランス語から日本語に翻訳された記事。
8月30日と31日の発表は18件だが、その分布は大きく偏っている。日曜日には公式発表が一件もなく、ほぼすべての情報が月曜日付けだった。30日版で報告したXの障害については追跡を完了した。当日アクセスできなかったアカウントを3日分さかのぼって確認したが、見落としていた発表はなかった。
大きく3つの軸が浮かび上がる。まず、Runwayによる世界初のインターフェース・ワールドモデルという前例のないモデル。次に、OpenAIの広告事業が達成した年換算収益ランレート10億ドルと、Together AIが締結した250 MWのインフラ契約という2つの経済的な節目。そして最後に、GitHub、NVIDIA、Ampによる開発者向けツールの動きと、Hugging Faceのコミュニティブログで公開された3件の研究成果である。
Runwayが初のインターフェース・ワールドモデルSolarisを発表
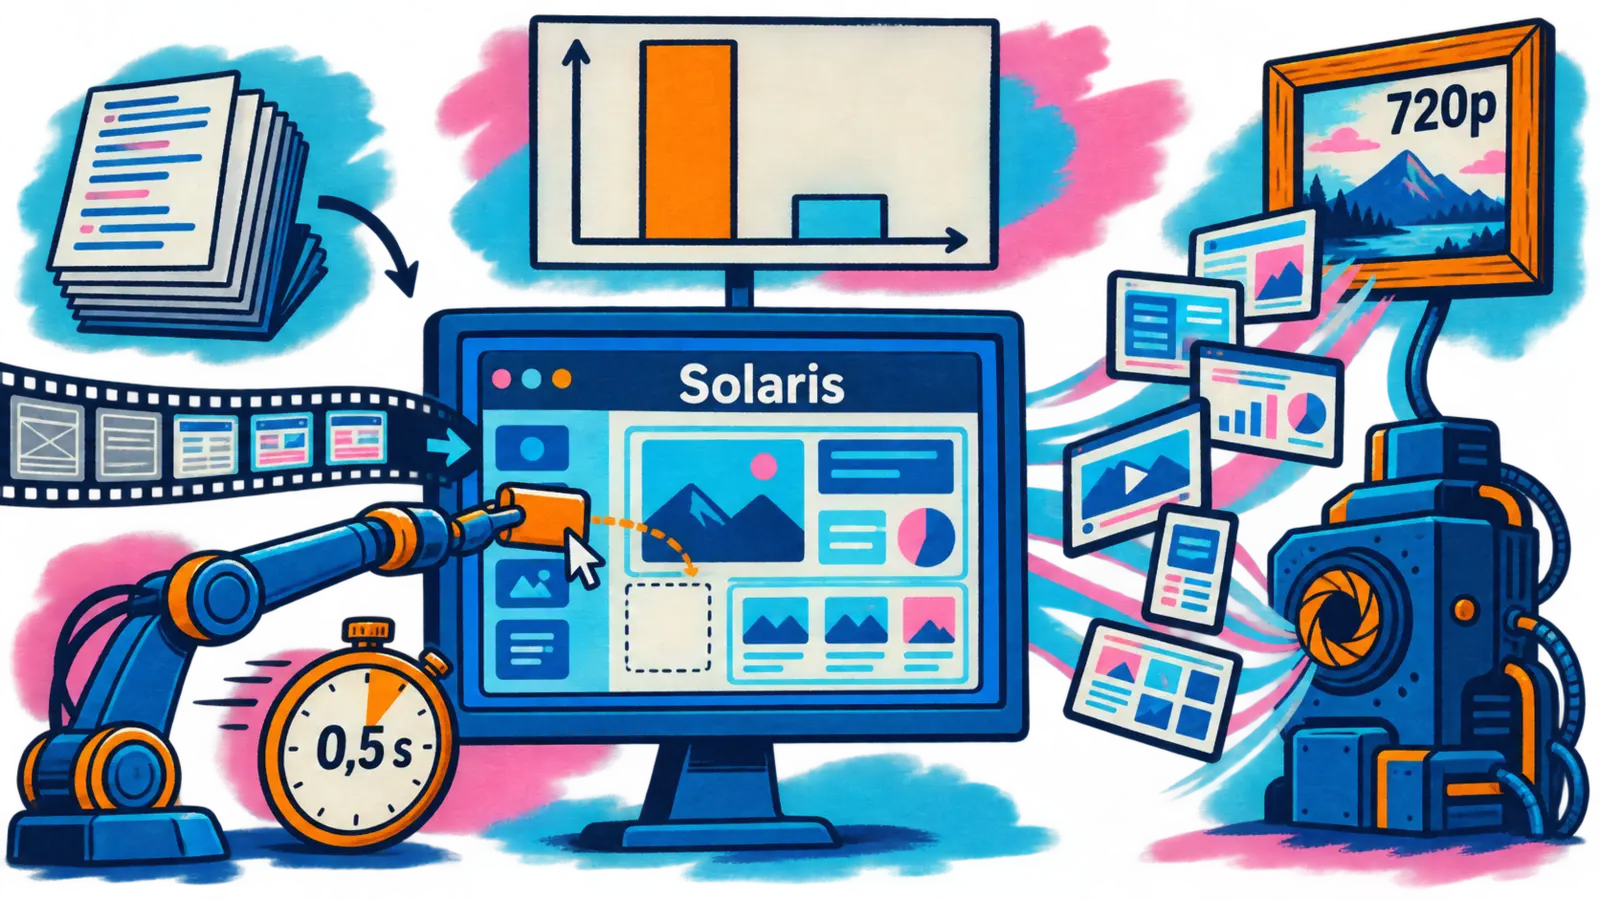
8月31日 — Runwayは、同研究所がインターフェース・ワールドモデル(Interface World Models)と呼ぶモデル群の第1弾、Solarisを発表した。その原理は一文で説明できる。後からインターフェースを表示するコードを生成するのではなく、モデルがインターフェースそのものを画像ごとに直接生成し、クリックやドラッグ&ドロップにリアルタイムで反応する。
この発想は、ソフトウェア制作工程に関する一つの認識から出発している。モックアップは何らかの動作をする前に、まずコードへ変換しなければならず、この変換には二重の代償が伴う。あらゆる挙動を事前に定義する必要があるため、最初のユーザーが訪れる前からソフトウェアが固定されてしまい、さらに元のデザインが持つ視覚的な豊かさも途中で失われる。Solarisはこの中間工程をなくし、画像全体をインターフェースにする。
技術的には、Runwayの動画モデルGen-4.5を基盤とし、汎用ワールドモデルGWM-1を発展させている。ユーザーの入力はテキストや画像と同じように次の画像を条件付けるため、動作とその視覚的な結果との関係を、挙動を一切プログラムすることなく学習できる。リアルタイム化には3つの工程が必要だった。生成を画像単位の自己回帰方式にし、複数段階のノイズ除去を少数の段階へ蒸留したうえで、高速モデルを自身の出力で訓練した。LLMがシーンの展開を決定する一方、ワールドモデルがレンダリングを担う。
| 参加者による評価基準 | Solaris | コード化されたインターフェース(Claude Opus 5) | 同等との判定 |
|---|---|---|---|
| 指示内容への適合度 | 61 % | 24 % | 13 % |
| シーン内における挙動の自然さ | 71 % | 21 % | 6 % |
| 技術的特性 | 測定値 |
|---|---|
| 基盤モデル | Gen-4.5、GWM-1の発展版 |
| 維持される解像度 | 720p |
| インタラクティブ性の基準 | レイテンシ約0.5秒 |
| ユーザー調査 | 参加者250人、例30件、約7 500件の一対比較 |
| 再構築ベンチマーク | インターフェース30件、構造的類似度(SSIM)およびDINOv3記述子 |
単なる指示への適合度よりも、挙動の自然さで差が明確に大きくなっており、Runwayはここに両アプローチの本質的な違いがあるとみている。コード化されたインターフェースでも、要求された変化を再現できることは多いが、それを個別の更新として処理する。一方、物体の挙動を学習したモデルは、シーンのほかの部分と整合する反応を生成する。同研究所は、もう一つの意外な用途としてエージェントの訓練も挙げている。継続的に再生成される環境によって、過去に一度も存在しなかった配置を含む、絶えず変化するインターフェースをエージェントへ提供できるという。
Runwayは、Solarisがまだできないことも詳しく説明しており、その一覧は相当なものだ。安定して読みやすいテキストは動画生成における最難関の一つであり、インターフェースはほかのどの分野よりもテキストに依存している。事実への根拠付けには、検証済みデータで生成を条件付ける必要がある。長時間のセッションにおける一貫性も依然として研究課題であり、生成されたインターフェースは支援技術やアクセシビリティAPIにも対応しなければならない。パートナーとともに一般公開を準備しており、早期アクセスはフォームから申し込める。
Today, we’re sharing new research on Solaris, our first Interface World Model. Solaris is a new kind of operating system that generates interactive interfaces frame by frame, in real time, with no code.
🇯🇵 本日、私たちは初のInterface World ModelであるSolarisについて、新たな研究成果を公開します。Solarisは、コードを使わず、インタラクティブなインターフェースを画像ごとにリアルタイムで生成する、新しい種類のオペレーティングシステムです。 — Xの@runwayml
ChatGPT Adsの年換算収益ランレートが10億ドルに到達し、セルフサービスを新たに4地域へ拡大
8月31日 — OpenAIは、ChatGPTに統合された広告プラットフォームChatGPT Adsに関する記事を公開し、サービス開始から200日未満で年換算収益ランレート(annualized revenue run rate)が10億ドルに達したと発表した。ここで最初に明確にすべき点がある。これは10億ドルを実際に受け取ったという意味ではなく、直近期間の収益を12か月分に換算した数字である。開設から200日も経っていない広告事業が、そのペースで1年分の収益をすでに得ているはずはない。Ads Managerを通じたセルフサービス購入は、同日中にインド、ヨーロッパ、中東、北アフリカへ拡大される予定だ。
OpenAIは広告を、一般消費者向けサブスクリプション、企業向けサービス、従量課金APIと並ぶビジネスモデルの柱の一つと位置付け、週に10億人を超えるアクティブユーザーがChatGPTを利用できる無料プランの資金源と明確に結び付けている。この仕組みには4つの原則が設けられている。広告は常に明確に表示され、回答とは区別される。広告が回答内容に影響することはない。広告主は非公開の会話へアクセスできない。そして、ユーザーは広告体験のパーソナライズの度合いを管理できる。
| OpenAIが公表した指標 | 発表値 |
|---|---|
| 年換算収益ランレート(予測) | 10億ドル |
| サービス開始からの経過期間 | 200日未満 |
| プラットフォーム上の広告主 | 数万社 |
| すでに対象となっている国 | 40か国超 |
| セルフサービスを新たに開放する市場 | インド、ヨーロッパ、中東、北アフリカ |
| 技術・測定パートナー | 50社超 |
| ChatGPTの週間アクティブユーザー | 10億人超 |
| 28日間の広告費用対効果として紹介された数値 | 3x、ある電子商取引広告主 |
| 新規顧客による広告トラフィック | 80 %超、ある技術パートナー |
説明されている道筋は、担当者による広告販売から、誰でも利用できるプラットフォームへの移行である。当初のモデルは代理店とパートナーを基盤としていたが、5月のAds Manager導入によって中小企業にも広告事業が開放され、現在ではその活動の大きな部分を占めている。ツール面では、CPC入札と成果最適化入札(outcome-optimized bidding)がキャンペーンの大半を占め、PixelとConversions APIが測定の基盤となっている。OpenAIは、米国外の広告主による収益の割合も増加していると述べている。
今後について、同社は新たな市場、形式、目標、購入オプションを発表するとともに、企業がChatGPT内で消費者と交流するための、よりネイティブな方法を模索したいとしている。つまり、現在の広告よりも会話から切り離されていない形式である。
Together AI:サウジアラビアで250 MW、エージェント指標でGLM-5.3が首位、新規顧客も獲得
8月31日 — Together AIは、HUMAINと共同で建設するサウジアラビアの250 MWデータセンターに関するインフラ契約を締結したと発表した。同研究所は、このデータセンターの事業から年間50億ドルの収益を見込んでおり、この取引をオープンソース向けとしては最大級のAIインフラ契約の一つと位置付けている。この投稿は同研究所のアカウントで固定され、通常のモデル関連の発信とは一線を画している。
この数字を読む際には注意が必要だ。発表文は動詞を伴わない3つの断片を並べており、50億ドルの主体が曖昧だからである。この点について、New York Timesの報道は明確だ。この金額は企業全体ではなく、このデータセンターから期待される収益を示している。その規模感からも裏付けられる。同記事によると、2026年7月時点のTogether AIの評価額は83億ドルであり、その規模で評価される企業が年間50億ドルの売上高を計上しているとは考えにくい。
契約の仕組み自体も注目に値する。これは単なる計算能力の購入ではない。引き続きNew York Timesによると、HUMAINは250 MWに加えて半導体120 000個を提供し、Together AIはそのチップを運用する代わりに収益の一部を支払う。したがって同研究所はインフラへ資金を提供するのではなく、売上高の一部と引き換えに利用する。これはまさに、計算資源を確保するパートナーシップと、各社がそれぞれ数十億ドルを調達する競争とを対比したスレッドの主張そのものだ。皇太子Mohammed ben Salmaneの主導で昨年設立されたHUMAINは、AI産業を構築し、石油への依存を減らそうとするサウジアラビアの取り組みの一環を担っている。
スレッドで展開されている論点は、規模よりもボトルネックの性質に重点を置いている。Together AIは現在の真のボトルネックをエネルギーだと説明し、この契約を自社規模の企業が単独の貸借対照表では資金を賄えない規模へアクセスするための手段と位置付けている。同研究所はこの仕組みを、長年にわたりhyperscalerからインフラ資金の提供を受けてきたクローズドな研究所のモデルと明確に対比している。
この見方は、エコシステムにおけるTogether AIの特別な立場を浮き彫りにする。同研究所はフロンティアモデルを公開するのではなく、DeepSeek、GLM、Kimi、MiniMax、Nemotronといった他社のモデルを提供している。したがって、その制約は研究ではなく、オープンウェイトモデルを独自APIより安価に提供するために利用できる計算能力にある。250 MWの契約は、この課題へ直接応えるものだ。
| 契約の要素 | 報告された値 |
|---|---|
| データセンターの容量 | 250 MW |
| HUMAINが提供する半導体 | 120 000 |
| データセンターの年間予想収益 | 50億ドル |
| HUMAINへ支払う対価 | Together AIの収益の一部 |
| 2026年7月時点のTogether AIの評価額 | 83億ドル |
| 産業パートナー | HUMAIN |
| 所在地 | サウジアラビア |
| 発表日時 | 2026年8月31日、13:26 UTC |
Together AIがスレッドで触れていない点がもう一つある。同じ記事は、サウジアラビアへの設置によって、米国でデータセンターを建設する際に直面した反発を回避できると指摘している。
We just signed one of the largest AI infrastructure deals for open source, period. 250MW data center. $5B+ in annualized revenue. Built with @HUMAIN in Saudi Arabia.
🇯🇵 私たちは、オープンソース向けとしては文句なしに最大級のAIインフラ契約の一つを締結しました。250 MWのデータセンター。年換算収益50億ドル超。サウジアラビアで@HUMAINと共同建設します。 — Xの@togethercompute
GLM-5.3がArtificial Analysisのエージェント指標で同率首位に
8月31日 — GLM-5.3がニュースとなるのは6日連続だ。8月28日にZ.aiがウェイトを公開し、29日にTogether AIのserverless APIでモデルが利用可能になったのに続き、今回は第三者ランキングで高く評価された。Artificial Analysisのエージェント指標で、このモデルは59点を記録した。Together AIは結果を正確に表現している。GLM-5.3は首位タイ(ties for the top spot)であり、GPT-5.6 SolとClaude Fable 5を上回った(beating)。したがって、上回った対象はこの2モデルであり、同じく59点のClaude Opus 5とは首位を分け合っている。
最も示唆に富むのは、その手法だ。Z.aiは新しい基盤モデルを訓練していない。GLM-5.2の基盤を維持し、性能向上のすべてをポストトレーニングによって実現した。その規模を、より多くの長期的環境、さらに多様なタスク、RLへ投入するcomputeの増加という3つの軸で同時に拡大した。
| 評価対象モデル | エージェント指標のスコア |
|---|---|
| GLM-5.3 (max) | 59 |
| Claude Opus 5 (max) | 59 |
| GLM-5.3 Flash | 58 |
| GPT-5.6 Sol (max) | 58 |
| Claude Fable 5(フォールバックあり) | 57 |
GreptileがTogether AIを主要推論プロバイダーに採用
8月31日 — この日最後の、やや小規模な動きとして、11 000を超えるチームが利用するAIコードレビューツールGreptileが、Together AIを主要推論プロバイダーに採用した。同ツールはリポジトリ全体のコンテキストを使ってpull requestsを分析する。その負荷特性は、長いコンテキストと大量のtokensで構成されており、まさにオープンウェイトモデルと独自APIのコスト差が決定的になる用途だ。
VS Code の GitHub Copilot:8月の4バージョンを1つの changelog に要約
8月31日 — GitHub は、v1.132からv1.135までの4つのエディターバージョンを網羅した、Visual Studio Code における Copilot の2026年8月のまとめを公開した。このサイクルを貫くテーマは、複数のエージェントを用いた作業の整理だ。Agents ウィンドウは単なる会話一覧ではなくなり、複数のセッションが共存し、それぞれの状態を保ったまま再開できる空間になった。
セッション面では、チャットを横方向または縦方向のグループとして並べて表示でき、戻った際にはレイアウトが復元される。/btw コマンドは、メインの会話が動き続けている間、そのコンテキストとプロンプトキャッシュを共有するサイド会話を開く。これにより、実行中のエージェントを中断せずに補足的な質問ができる。トランスクリプトのガターから利用できるプロンプト履歴コントロールでは、特定のプロンプトへ直接移動し、そこから生じたファイル変更を確認できる。Agent Host を使うと、複数の VS Code ウィンドウから同じセッションに接続できる。また、実験的な /rubber-duck コマンドは補助モデルに問い合わせ、見落とされた詳細やエッジケースを洗い出す。
エディター内での Claude の位置付けに直接関係する点も2つある。実験的な設定により、Claude に API キーが設定されていれば、GitHub に接続せずに Agents ウィンドウを開ける。また、Claude セッションでは、Anthropic サブスクリプションのモデルと Copilot サブスクリプションのモデルをいつでも切り替えられる。さらに VS Code は、Agent Plugins 1.0標準に準拠し、ほかの互換エージェントクライアントでも利用できるポータブルなエージェントプラグインのインストールに対応した。
| changelog の領域 | 主な新機能 |
|---|---|
| セッションとワークフロー | チャットの並列表示、/btw、プロンプト履歴、Agent Plugins 1.0、/rubber-duck、Agent Host |
| VS Code の Claude | API キーによる GitHub 接続なしの Agents ウィンドウ、Anthropic と Copilot のモデル切り替え |
| チャットとレビュー | トランスクリプト内検索、固定スクロール、ハイブリッド Markdown エディター、モデル別トークン数 |
| 統合ブラウザー | HTML 要素の一括注釈、自動再読み込み、既定の HTML エディター |
| 音声入力 | デバイス上での多言語処理、クリーンアップ指示、シェルに適応したクリーンアップ |
長くなった会話に必要とされていた閲覧機能も、ついにチャットへ追加された。トランスクリプト全体を対象とし、大文字と小文字の区別、単語単位、正規表現に対応するテキスト検索、現在のプロンプトを表示したままにする固定スクロール、さらに応答フッターへカーソルを合わせると、入力、キャッシュ済み入力、出力を区別したモデル別のトークン消費量が表示される。課金がキャッシュに左右されるようになった現在、この可視性は有用だ。統合ブラウザーでは、ページ内の複数の HTML 要素を選択して注釈を付け、インターフェースに関するフィードバックをまとめて処理できる。音声入力はデバイス上で複数言語に対応し、ターミナルで音声入力する際には、発音した句読点を挿入するのではなくコマンド構文を維持する。
🔗 GitHub Changelog — VS Code の Copilot、2026年8月版
NVIDIA、ソフトウェア基盤を生物学と自動運転へ展開
8月31日 — NVIDIA は、Anthropic と進めた統合作業を解説するチュートリアルを公開した。BioNeMo Agent Toolkit が、Anthropic の科学研究ワークスペースである Claude Science から利用可能になった。対象となる課題は専門ツールの扱いだ。汎用エージェントは、ある作業にタンパク質のフォールディングが必要だと認識できても、どのモデルを実行すべきか、リクエストをどう整形すべきか、どのパラメーターが重要かまでは把握できない場合がある。この toolkit は、生物学、化学、ゲノミクス、創薬にわたる10年以上分の BioNeMo のモデル、ライブラリ、ワークフローを、エージェントから呼び出せる skills としてパッケージ化する。NVIDIA は社内ベンチマークにおいて、タスクの正確性が60%から100%に向上し、トークン効率がおよそ2倍になったとしている。
チュートリアルでは、3つの NIM マイクロサービスを連携させる。まず MSA Search で進化的コンテキストを構築し、続いて OpenFold3 と Boltz-2 でそれぞれ独立に構造を予測する。最も説得力のある実演は、多重配列アラインメントの役割に関するものだ。これがない場合、両モデルとも界面の信頼度が急落し、サンプリング予算を増やしても結果は変わらない。注意すべき点が2つある。1つは、L40S または H100 GPU と約700 GBのストレージを必要とするハードウェア上の障壁だ。もう1つは、NVIDIA 自身が示す解釈上の慎重さである。同社は、信頼度スコアだけでは相互作用を証明できないと注意を促し、2つの独立したモデルの収束を、証拠ではなく有力な仮説として位置付けている。
| 界面信頼度指標(iPTM) | OpenFold3 | Boltz-2 |
|---|---|---|
| MSA アラインメントありのヘテロマー | 0,85 | 0,82 |
| MSA アラインメントなしのヘテロマー | 0,14 | 0,19 |
| コアの Cα RMSD、モノマー対ヘテロマー | 0,68 Å | 0,65 Å |
🔗 NVIDIA チュートリアル — Claude Science の BioNeMo NIM
Omniverse NuRec、まだ存在しない車両向けに知覚スタックを適応
8月31日 — 同日、NVIDIA は自動運転を扱う2本目の技術チュートリアルを公開した。出発点となる認識は、知覚スタックが搭載先の車両に合わせて形作られるというものだ。SUV からセダンへ移植すると、センサーの位置、キャリブレーション、視野、遮蔽、車体形状がすべて変わるため、世界の見え方も同じではなくなる。車種ラインごとに実データセットを収集して注釈を付けるには多額の費用がかかり、開発初期には不可能なことも多い。
Omniverse NuRec は、すでに記録された走行データの再利用を提案する。各シーンを再構築し、対象車両のセンサー構成から見た形で再現する。これによりチームは、新しいカメラ配置からシナリオがどう見えるか、形状の変更によってどこに死角が生じるかを把握できる。NVIDIA は、性能の基準設定と検証には実際の走行データが引き続き不可欠だと明記している。合成データは、専用データセットが存在する前にモデルを適応させるためのものであり、実データを置き換えるものではない。シーンは USDZ 形式で Hugging Face 上に配布され、コーディングエージェント向けの skills リポジトリも付属する。
🔗 NVIDIA チュートリアル — Omniverse NuRec
Amp、各 thread に音声・ビデオ通話ルームを接続
8月31日 — Amp は、各 thread にライブ会話ルームを接続した。Space to Talk と名付けられたこの機能は、thread 自体にひも付いた音声・ビデオ空間を開く。Enter キーを押すだけで参加し、カメラを有効にして画面を共有でき、その間もエージェントは同じ thread 内で作業を続ける。
打ち出されている利点は、中間的な手順をなくせることだ。この考え方は、Amp が夏から進めてきた共同作業機能の流れを延長している。チームメンバー間で orb の操作権を共有する Multiplayer(7月22日)、続いて thread 内でのメンションによる直接招待機能 Pass the Orb to the Left Hand Side(8月19日)が登場した。thread は、チームとエージェントが集まる唯一の場所になる。一方、Amp は機能の範囲がまだ開かれていることも認めている。ブレインストーミング、ホワイトボード、Puck やほかのエージェントとの会話は、提供済みの機能ではなく、将来の方向性として挙げられている。
No links to paste, no calendar invite, no other app. The call lives where the work lives.
🇯🇵 貼り付けるリンクも、カレンダーへの招待も、別のアプリケーションも必要ありません。通話は、仕事があるその場所で行われます。 — Amp、Space to Talk の発表
VLANeXt、視覚・言語・行動モデル向けの統一コードベース
8月31日 — あるチームが Hugging Face のブログで、視覚・言語・行動モデル(vision-language-action、VLA)の研究に特化したコードベース VLANeXt を公開した。この種のモデルの原理は単純だ。視覚言語モデルが、ロボットの見ているものと自然言語の指示を結び付け、そこから物理世界での行動を導き出す。
対象となるのは方法論上の問題だ。この分野は急速に進歩する一方で、断片化も進んでいる。論文ごとに backbone、ポリシーヘッド、行動表現、学習戦略、評価プロトコルが異なる。高性能だとする結果は数多く報告されているものの、変数を切り分けられないため、VLA モデルの性能を本当に左右している要素を特定するのは依然として難しい。
著者らは新たなアーキテクチャを追加する代わりに、RT-2 / OpenVLA 型の参照ベースラインへ立ち返り、設計空間を体系的に探索してレシピを抽出した。この成果が、ICML 論文「VLANeXt: Recipes for Building Strong VLA Models」につながった。その後、コードベースはこの研究の範囲を超え、さまざまな規模の backbone、潜在行動学習、潜在空間での予測モデリング、世界・行動モデリングへと拡張されている。VLANeXt-LAM、-S、-L、-XL、-JEPA、-WAM の6つの出発点が提供される。
短報
- Claude Code 2.1.252、不具合修正のみのリリース — 新機能はなく、4件の修正が含まれる。一部の Mac で Bash コマンドが失敗する問題、
.claude/settings.local.jsonファイルのないプロジェクトで「always allow」の選択が保存されない問題、claude.ai への接続状態が悪い場合にツール終了後も Remote Control セッションが数分間停止する問題、大量の出力を伴うバックグラウンドタスクの通知によって API リクエストのサイズ上限を超える問題が修正された。🔗 Claude Code の CHANGELOG - Flow、デスクトップで開始画像と終了画像の制御を提供 — Google Flow は、8月27日のモデル発表時に紹介された Gemini Omni 1.1 Flash の開始画像と終了画像の制御機能が、デスクトップで利用可能になったと発表した。強調されている用途は、両端に同じ画像を指定してループを生成することだ。🔗 @FlowbyGoogle の投稿
- Grok Imagine 賞への応募最終日 — xAI は、8月17日に開始した動画コンテストの締め切りが当日であることを改めて告知した。参加者は、モデルの動画・音声機能を際立たせる、ホメロスの『オデュッセイア』に基づく場面を制作する必要があった。上位3作品には合計175,000ドルが贈られ、内訳はそれぞれ100,000ドル、50,000ドル、25,000ドルとなる。🔗 @grok の投稿
- QwenCloud、Arena を終了しバンコクでのセッションを発表 — 越境 eコマース向けコンテンツ生成エージェントをテーマとする Qwen Cloud Arena challenge は、800人を超える参加者を集め、北京時間の午前0時に応募を締め切った。審査は翌日に開始される。QwenCloud はその数時間前、9月4日にバンコクで開催される Qwen Conference でのセッションも発表していた。内容は香港ですでに示されたものと同じく、ウェブサイト、Skills、CLI という3つの入口を軸にしている。🔗 Arena の締め切り · 🔗 バンコクでのセッション
- GitHub、開発者のアクセシビリティ対応に関する調査を開始 — 同社は、障害があると申告することも、アクセシビリティツールの利用者だと認識することも求めず、快適に働くために役立つツール、製品設定、個人的な工夫を把握しようとしている。回答期限は9月30日。AI とは無関係の話題。🔗 @github の投稿
- otoSpeech Task、タスクとともに公開された全二重対話コーパス — 2人の話者による20時間の英語会話、7つの共同作業タスクにまたがる58セッション、11,025件のタイムスタンプ付きイベントを収録し、CC BY 4.0ライセンスで提供される。特徴は、各話者が見た画像、行動、参照回答が、音声と同じタイムライン上に記録されていることだ。🔗 Hugging Face の記事
- YOLO26-RGB、深度ヘッドから派生した雨除去モデル — YOLO26-depth の1チャンネル深度ヘッドを3チャンネルの RGB 復元ヘッドへ置き換えて得られた2つの雨除去モデル。1つはパラメーター数5,25 Mで、1080pにおいて約109画像/秒。もう1つは12,13 Mで約92画像/秒となり、品質が0,1 dB向上する。🔗 Hugging Face の記事
これが意味すること
インターフェースを生成するコードではなく、インターフェース自体を生成する。 Solaris は、設計と実行の境界を移動させる。現在のソフトウェアチェーン全体は変換に依存している。モックアップがコードになり、そのコードが表示を生み出す。そして Runway は、その変換による損失を測定した。スクリーンショットから再構築する30のインターフェースにおいて、テストされたすべてのマルチモーダルモデルが情報を失い、視覚表現が豊かになるほど劣化が深刻になった。中間段階を取り除くことは急進的な提案であり、研究所自身が列挙する限界は、それがどこで行き詰まるかを示している。位置が安定しないテキスト、事実に基づくことを保証する手段の欠如、そして生成画像にはスクリーンリーダーが読み取れる構造がないため、全面的に構築しなければならないアクセシビリティである。これらは仕上げの問題ではなく、本質的な障害だ。
同じ日に発表された、計算資源の費用を賄う2つの方法。 OpenAI は広告事業について、年間換算で10億ドルの収益ペースを掲げている。これは実際の入金額ではなく、12か月に換算した予測である。同社はこれをサブスクリプションと同格の経済的支柱と位置づけている。週間ユーザー数が10億人を超えるというサービスの無料利用枠を、広告が支える。対する Together AI は、利用者層を収益化するのでも、設備容量を追加購入するのでもない。収益の一部と引き換えにサウジアラビアで250 MWと120,000個のチップを確保し、エネルギーこそが業界の真のボトルネックだと位置づけている。両社は同じ制約に対し、チェーンの正反対の両端から応えているが、どちらの答えも中立ではない。一方は製品に商業的利害を組み込み、もう一方は政治的抵抗の少ない場所へインフラを移す。
エージェント分野の競争は、いまや事前学習後の段階で繰り広げられている。 Artificial Analysis のエージェント指標における GLM-5.3 の結果で特に重要なのは、それを達成した方法だ。Z.ai は GLM-5.2 の基盤を維持し、長期的な実行環境、タスクの多様性、RL の計算資源といった事後学習だけを拡張した。エージェント分野のランキング上位に入るために基盤モデルを再学習する必要がなくなったなら、最大のコスト項目だけで順位が決まることはなくなり、モデルの更新サイクルもそれだけ短くなる。これはまた、28日のオープンウェイト公開から31日のこの順位まで、このモデルが経験した6日間の展開を最も無理なく説明するものでもある。
開発者向けツールは、複数のエージェントを同時に扱う形へ再編されつつある。 Copilot の変更履歴は、1回のリリースサイクル全体を費やして、Agents ウィンドウを単なる会話の一覧ではなく作業空間として扱っている。チャットを横並びにし、プロンプトキャッシュを共有するサイド会話を設け、プロンプトの時系列を表示し、同じセッションに複数のウィンドウを接続する。Amp は、人間同士の話し合いをエージェントが作業する場所で行えるよう、スレッドに通話ルームを結び付ける。さらに NVIDIA は、10年分の科学ライブラリを呼び出し可能な skills としてまとめ、自動車運転シーンの再構築向けに2つ目の skills リポジトリを提供している。まったく異なる3社が、同じ考えに収束している。エージェントに欠けているのは、もはやモデルの能力ではなく、共有コンテキストと、必要に応じて与えられる専門ツールなのだ。
出典
- Runway — Solaris の紹介
- Runway — X での Solaris 発表
- OpenAI — AI へのアクセス拡大における節目
- Together AI — HUMAIN との250 MWインフラ契約
- Together AI — Artificial Analysis のエージェント指標における GLM-5.3
- Together AI — Greptile の主要推論プロバイダー採用
- GitHub Changelog — VS Code の Copilot、2026年8月版
- NVIDIA — Claude Science におけるタンパク質構造予測用 BioNeMo NIM
- NVIDIA — Omniverse NuRec と複数車両の認識
- Amp — 話すための空間
- VLANeXt、視覚・言語・行動モデル向け統一コードベース
- Claude Code の変更履歴
- Google Flow — デスクトップでの最初と最後の画像
- xAI — Grok Imagine コンテスト最終日
- QwenCloud — Qwen Cloud Arena の終了
- QwenCloud — バンコクの Qwen Conference でのセッション
- GitHub — アクセシビリティ向けツールと調整に関する調査
- otoSpeech Task、全二重会話コーパス
- YOLO26-RGB、雨滴除去モデル