ai-powered-markdown-translatorArtikel, mit gpt-5.6-sol aus dem Französischen ins Deutsche übersetzt.
Achtzehn Ankündigungen für den 30. und 31. August, mit einer sehr ungleichmäßigen Verteilung: Am Sonntag gab es keine einzige offizielle Veröffentlichung, und nahezu das gesamte Material stammt vom Montag. Der in der Ausgabe vom 30. gemeldete Ausfall von X wurde aufgearbeitet: Die Konten, die an diesem Tag nicht erreichbar waren, wurden über einen Zeitraum von drei Tagen erneut geprüft, ohne dass dabei eine fehlende Ankündigung entdeckt wurde.
Drei Schwerpunkte zeichnen sich ab. Zunächst ein neuartiges Modell: Runways erstes Interface World Model. Danach zwei wirtschaftliche Meilensteine: die von OpenAIs Werbeplattform erreichte annualisierte Umsatzrate von einer Milliarde US-Dollar und ein von Together AI unterzeichneter Infrastrukturvertrag über 250 MW. Schließlich eine Runde neuer Entwicklerwerkzeuge bei GitHub, NVIDIA und Amp, ergänzt durch drei auf dem Community-Blog von Hugging Face veröffentlichte Forschungsarbeiten.
Runway stellt Solaris vor, sein erstes Interface World Model
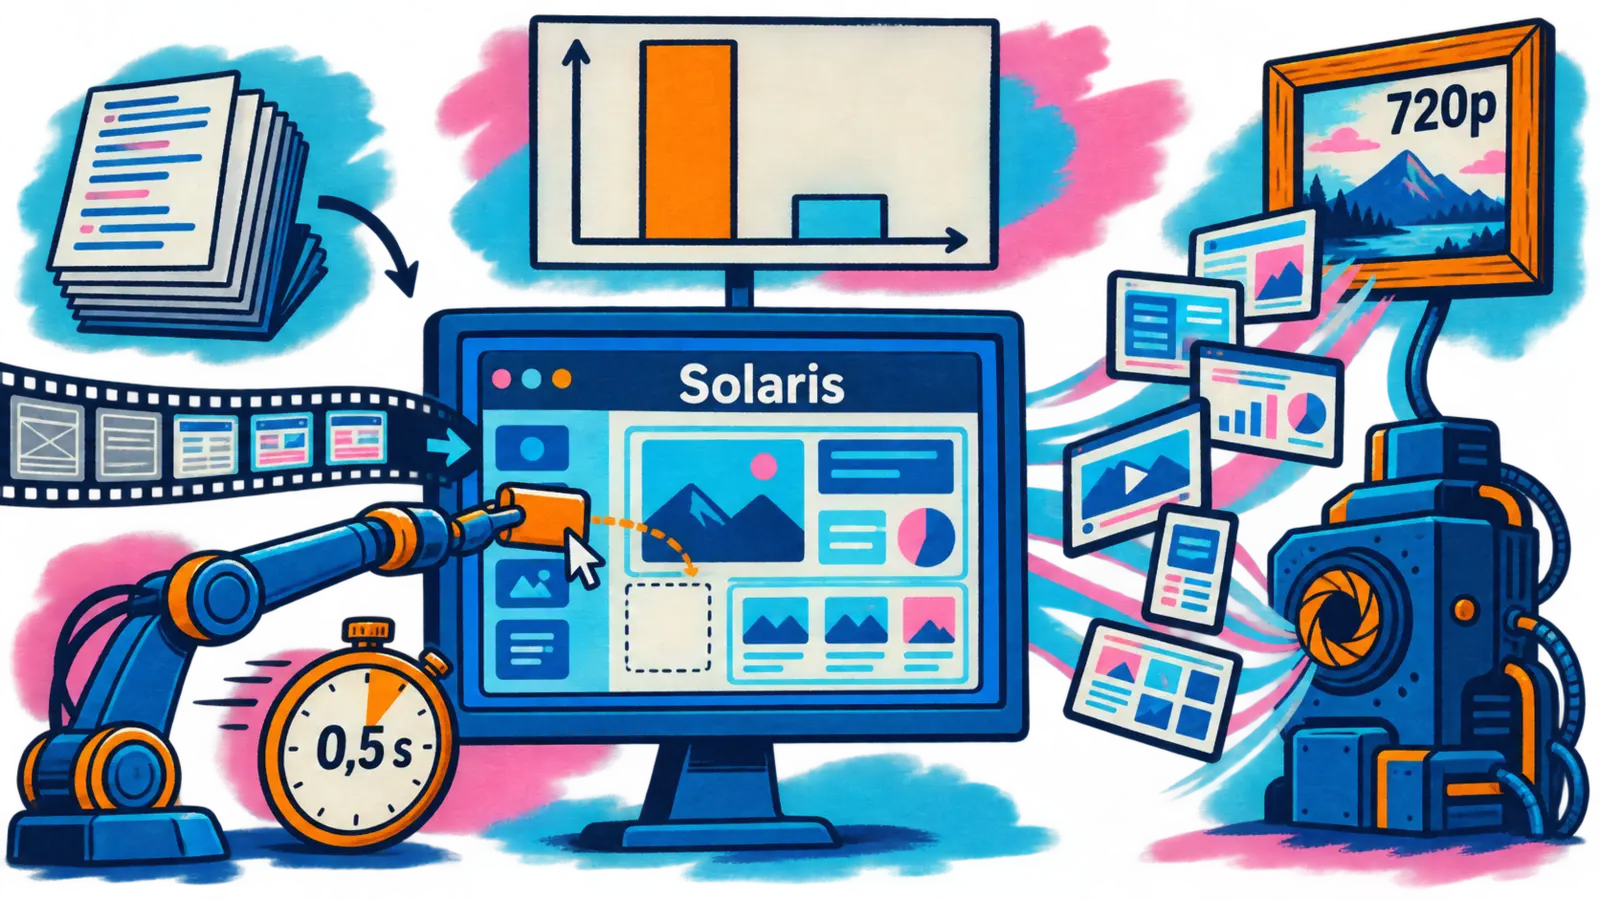
31. August — Runway hat Solaris vorgestellt, das erste Modell einer Familie, die das Labor als Interface World Models bezeichnet. Das Prinzip lässt sich in einem Satz zusammenfassen: Statt Code zu erzeugen, der anschließend ein Interface darstellt, generiert das Modell direkt das Interface, Bild für Bild, und reagiert in Echtzeit auf Klicks und Drag-and-drop-Aktionen.
Ausgangspunkt ist eine Feststellung über die Softwareentwicklungskette. Ein Entwurf muss zunächst in Code übersetzt werden, bevor er irgendetwas tun kann, und diese Übersetzung verursacht doppelte Kosten: Jedes Verhalten muss im Voraus definiert werden, sodass die Software bereits vor dem Eintreffen des ersten Nutzers festgelegt ist, und der visuelle Reichtum des ursprünglichen Designs geht auf dem Weg verloren. Solaris beseitigt den Zwischenschritt, und das gesamte Bild wird zum Interface.
Technisch basiert das Modell auf Gen-4.5, Runways Videomodell, und führt GWM-1, sein universelles World Model, fort. Nutzereingaben konditionieren das nächste Bild ebenso wie Text oder ein Bild, sodass die Verbindung zwischen einer Aktion und ihrem visuellen Ergebnis erlernt wird, ohne dass irgendein Verhalten programmiert werden muss. Der Übergang zur Echtzeit erforderte drei Schritte: die Generierung Bild für Bild autoregressiv zu machen, das mehrstufige Entrauschen auf wenige Schritte zu destillieren und anschließend das schnelle Modell mit seinen eigenen Ausgaben zu trainieren. Ein LLM entscheidet über die Entwicklung der Szene, während das World Model das Rendering übernimmt.
| Von den Teilnehmern bewertetes Kriterium | Solaris | Codiertes Interface (Claude Opus 5) | Gleichwertige Bewertungen |
|---|---|---|---|
| Befolgung der gestellten Anweisung | 61 % | 24 % | 13 % |
| Natürlichkeit des Verhaltens in der Szene | 71 % | 21 % | 6 % |
| Technisches Merkmal | Gemessener Wert |
|---|---|
| Basismodell | Gen-4.5, als Fortführung von GWM-1 |
| Erreichte Auflösung | 720p |
| Interaktivitätsschwelle | etwa 0,5 s Latenz |
| Nutzerstudie | 250 Teilnehmer, 30 Beispiele, fast 7 500 paarweise Bewertungen |
| Rekonstruktions-Benchmark | 30 Interfaces, strukturelle Ähnlichkeit (SSIM) und DINOv3-Deskriptoren |
Der Abstand ist bei der Natürlichkeit des Verhaltens deutlich größer als bei der bloßen Befolgung der Anweisung, und Runway sieht darin den grundlegenden Unterschied zwischen den beiden Ansätzen: Ein codiertes Interface kann die gewünschte Änderung häufig nachbilden, behandelt sie jedoch als isolierte Aktualisierung, während ein Modell, das das Verhalten von Objekten erlernt hat, eine mit dem Rest der Szene konsistente Reaktion erzeugt. Das Labor nennt einen zweiten, weniger erwarteten Anwendungsfall: das Training von Agenten, denen eine sich kontinuierlich regenerierende Umgebung ständig wechselnde Interfaces bieten würde, einschließlich Anordnungen, die noch nie zuvor existiert haben.
Runway dokumentiert auch, was Solaris noch nicht kann, und die Liste ist umfangreich: Stabiler und lesbarer Text gehört weiterhin zu den schwierigsten Problemen der Videogenerierung, obwohl Interfaces stärker als jeder andere Bereich davon abhängen; faktische Verankerung erfordert, die Generierung mit verifizierten Daten zu konditionieren; die Konsistenz über lange Sitzungen hinweg bleibt ein Forschungsgebiet; und ein generiertes Interface muss noch mit assistiven Technologien und Accessibility-APIs funktionieren. Der öffentliche Start wird gemeinsam mit Partnern vorbereitet, der Early Access erfolgt über ein Formular.
Today, we’re sharing new research on Solaris, our first Interface World Model. Solaris is a new kind of operating system that generates interactive interfaces frame by frame, in real time, with no code.
🇩🇪 Heute stellen wir neue Forschungsarbeiten zu Solaris vor, unserem ersten Interface World Model. Solaris ist eine neue Art von Betriebssystem, das interaktive Interfaces Bild für Bild in Echtzeit und ohne Code generiert. — @runwayml auf X
🔗 Runway — Einführung in Solaris
ChatGPT Ads erreicht eine annualisierte Umsatzrate von einer Milliarde US-Dollar und öffnet seinen Self-Service für vier neue Regionen
31. August — OpenAI hat einen Beitrag über ChatGPT Ads, seine in ChatGPT integrierte Werbeplattform, veröffentlicht und bekannt gegeben, dass die Plattform weniger als 200 Tage nach ihrem Start eine annualisierte Umsatzrate (annualized revenue run rate) von einer Milliarde US-Dollar erreicht hat. Die Einschränkung sollte gleich zu Beginn klargestellt werden: Es handelt sich nicht um eine tatsächlich eingenommene Milliarde, sondern um den auf zwölf Monate hochgerechneten Umsatz des jüngsten Zeitraums. Eine Werbeplattform, die noch keine zweihundert Tage existiert, kann naturgemäß nicht bereits ein ganzes Jahr lang Umsätze in dieser Höhe erzielt haben. Die Öffnung des Self-Service-Einkaufs über den Ads Manager für Indien, Europa, den Nahen Osten und Nordafrika ist für einen späteren Zeitpunkt am selben Tag angekündigt.
OpenAI stellt Werbung neben Verbraucherabonnements, Unternehmensangeboten und nutzungsabhängig abgerechneten APIs als eine der Säulen seines Geschäftsmodells dar und verknüpft sie ausdrücklich mit der Finanzierung der kostenlosen Stufe, durch die ChatGPT für mehr als eine Milliarde wöchentlich aktive Nutzer zugänglich bleibt. Vier Zusagen bilden den Rahmen des Systems: Anzeigen werden stets deutlich gekennzeichnet und von den Antworten getrennt, Werbung beeinflusst die bereitgestellten Antworten nicht, Werbetreibende erhalten keinen Zugriff auf private Unterhaltungen, und die Nutzer kontrollieren den Grad der Personalisierung ihres Werbeerlebnisses.
| Von OpenAI veröffentlichte Kennzahl | Angegebener Wert |
|---|---|
| Annualisierte Umsatzrate (Projektion) | 1 Milliarde US-Dollar |
| Seit dem Start verstrichene Zeit | weniger als 200 Tage |
| Werbetreibende auf der Plattform | Zehntausende |
| Bereits abgedeckte Länder | mehr als 40 |
| Neue für den Self-Service geöffnete Märkte | Indien, Europa, Naher Osten, Nordafrika |
| Technologie- und Messpartner | mehr als 50 |
| Wöchentlich aktive Nutzer von ChatGPT | mehr als 1 Milliarde |
| Genannter Return on Ad Spend über 28 Tage | 3x, bei einem E-Commerce-Werbetreibenden |
| Anteil des Werbe-Traffics von Neukunden | mehr als 80 %, bei einem Technologiepartner |
Die beschriebene Entwicklung führt vom betreuten Vertrieb zu einer frei zugänglichen Plattform. Das ursprüngliche Modell stützte sich auf Agenturen und Partner; die Einführung des Ads Managers im Mai öffnete die Werbeplattform für kleine und mittlere Unternehmen, die inzwischen einen bedeutenden Teil des Geschäfts ausmachen. Bei den Werkzeugen bilden CPC-Gebote und ergebnisoptimierte Gebote (outcome-optimized bidding) den Großteil der Kampagnen, während Pixel und Conversions API die Grundlage für die Messung bilden. OpenAI weist außerdem darauf hin, dass Werbetreibende außerhalb der Vereinigten Staaten einen wachsenden Anteil am Umsatz ausmachen.
Für die Zukunft kündigt das Unternehmen neue Märkte, Formate, Ziele und Einkaufsoptionen an und erklärt, es wolle nativere Möglichkeiten erkunden, wie Unternehmen innerhalb von ChatGPT mit Verbrauchern interagieren können — also Formate, die weniger stark von der Unterhaltung getrennt sind als die derzeitigen Anzeigen.
🔗 OpenAI — Ein Meilenstein beim Ausbau des Zugangs zu KI
Together AI: 250 MW in Saudi-Arabien, GLM-5.3 an der Spitze des Agentic Index und ein neuer Kunde
31. August — Together AI hat die Unterzeichnung eines Infrastrukturvertrags für ein gemeinsam mit HUMAIN errichtetes 250-MW-Rechenzentrum in Saudi-Arabien bekannt gegeben. Das Labor erwartet aus dem Betrieb dieses Rechenzentrums einen Jahresumsatz von 5 Milliarden US-Dollar und bezeichnet die Transaktion als einen der größten jemals für Open Source abgeschlossenen KI-Infrastrukturverträge. Die Nachricht wurde auf dem Konto des Labors angeheftet, wodurch sie sich von dessen üblicher Kommunikation über Modelle abhebt.
Die Zahl ist mit Vorsicht zu lesen, da die Ankündigung drei Fragmente ohne Verb aneinanderreiht und unklar lässt, worauf sich die 5 Milliarden beziehen. Die Berichterstattung der New York Times schafft Klarheit: Die Summe bezeichnet den erwarteten Umsatz dieses Rechenzentrums, nicht den des Unternehmens. Auch die Größenordnung bestätigt dies, denn derselbe Artikel beziffert die Bewertung von Together AI im Juli 2026 auf 8,3 Milliarden US-Dollar — ein mit diesem Betrag bewertetes Unternehmen erzielt keinen Jahresumsatz von 5 Milliarden US-Dollar.
Die Konstruktion selbst verdient Beachtung, denn es handelt sich nicht um einen Kapazitätskauf. Ebenfalls laut der New York Times stellt HUMAIN neben den 250 MW auch 120 000 Halbleiter bereit, und Together AI betreibt diese Chips und führt im Gegenzug einen Teil seines Umsatzes ab. Das Labor finanziert die Infrastruktur also nicht: Es nutzt sie gegen einen Anteil seines Umsatzes. Genau dies betont der Thread, indem er Partnerschaften, die Rechenleistung erschließen, einem Wettlauf gegenüberstellt, bei dem jeder seine eigenen Milliarden einwerben müsste. HUMAIN wurde im vergangenen Jahr auf Initiative von Kronprinz Mohammed bin Salman gegründet und ist Teil der saudischen Bemühungen, eine KI-Industrie aufzubauen und die Abhängigkeit des Landes vom Erdöl zu verringern.
Das im Thread dargelegte Argument betrifft weniger den Umfang als die Art des Engpasses. Together AI bezeichnet Energie als den derzeit eigentlichen Flaschenhals und die Vereinbarung als Möglichkeit, eine Größenordnung zu erreichen, die ein Unternehmen seiner Größe nicht aus der eigenen Bilanz finanzieren könnte. Das Labor stellt dieses Modell ausdrücklich dem der geschlossenen Labore gegenüber, deren Infrastruktur lange Zeit von Hyperscalern finanziert wurde.
Diese Lesart verdeutlicht die besondere Stellung von Together AI im Ökosystem: Das Labor veröffentlicht keine Frontier-Modelle, sondern stellt die Modelle anderer bereit — DeepSeek, GLM, Kimi, MiniMax, Nemotron. Seine Beschränkung liegt daher nicht in der Forschung, sondern in der verfügbaren Rechenkapazität, um Open-Weight-Modelle günstiger als proprietäre APIs anzubieten. Ein Vertrag über 250 MW setzt genau dort an.
| Bestandteil der Vereinbarung | Gemeldeter Wert |
|---|---|
| Kapazität des Rechenzentrums | 250 MW |
| Von HUMAIN bereitgestellte Halbleiter | 120 000 |
| Erwarteter Jahresumsatz des Rechenzentrums | 5 Milliarden US-Dollar |
| An HUMAIN gezahlte Gegenleistung | ein Anteil am Umsatz von Together AI |
| Bewertung von Together AI im Juli 2026 | 8,3 Milliarden US-Dollar |
| Industriepartner | HUMAIN |
| Standort | Saudi-Arabien |
| Datum und Uhrzeit der Ankündigung | 31. August 2026, 13:26 UTC |
Ein letzter Punkt, den Together AI in seinem Thread nicht kommentiert: Derselbe Artikel weist darauf hin, dass der Standort in Saudi-Arabien es ermöglicht, die in den Vereinigten Staaten bestehenden Widerstände gegen die Errichtung von Rechenzentren zu umgehen.
We just signed one of the largest AI infrastructure deals for open source, period. 250MW data center. $5B+ in annualized revenue. Built with @HUMAIN in Saudi Arabia.
🇩🇪 Wir haben gerade einen der größten KI-Infrastrukturverträge für Open Source überhaupt unterzeichnet. Punkt. Ein 250-MW-Rechenzentrum. Mehr als 5 Milliarden US-Dollar annualisierter Umsatz. Gemeinsam mit @HUMAIN in Saudi-Arabien errichtet. — @togethercompute auf X
GLM-5.3 erreicht gemeinsam den ersten Platz im Agentic Index von Artificial Analysis
31. August — Der sechste Tag in Folge, an dem GLM-5.3 Schlagzeilen macht: Nachdem Z.ai am 28. August die Gewichte veröffentlicht und Together AI das Modell am 29. August auf seiner Serverless API bereitgestellt hatte, hebt es diesmal ein unabhängiges Ranking hervor. Im Agentic Index von Artificial Analysis erreicht das Modell 59 Punkte. Together AI formuliert das Ergebnis präzise: GLM-5.3 liegt gemeinsam auf dem ersten Platz (ties for the top spot) und übertrifft (beating) GPT-5.6 Sol und Claude Fable 5. Der Vorsprung bezieht sich somit auf diese beiden Modelle; mit Claude Opus 5, das ebenfalls 59 Punkte erreicht, teilt sich GLM-5.3 die Spitzenposition.
Der aufschlussreichste Punkt betrifft die Methode. Z.ai hat kein neues Basismodell trainiert: Die GLM-5.2-Basis wurde beibehalten, und der gesamte Zuwachs stammt aus dem Post-Training, das gleichzeitig in drei Bereichen skaliert wurde — mehr Umgebungen mit langem Zeithorizont, eine größere Vielfalt an Aufgaben und mehr für RL eingesetzte Rechenleistung.
| Bewertetes Modell | Punktzahl im Agentic Index |
|---|---|
| GLM-5.3 (max) | 59 |
| Claude Opus 5 (max) | 59 |
| GLM-5.3 Flash | 58 |
| GPT-5.6 Sol (max) | 58 |
| Claude Fable 5 (mit Fallback) | 57 |
🔗 Beitrag von @togethercompute
Greptile wählt Together AI als primären Inference-Anbieter
31. August — Das letzte, etwas bescheidenere Signal des Tages: Greptile, ein von mehr als 11 000 Teams eingesetztes Werkzeug für KI-gestützte Code-Reviews, hat Together AI als primären Inference-Anbieter ausgewählt. Das Werkzeug analysiert Pull Requests mit dem vollständigen Kontext des Repositorys, einem Lastprofil aus langen Kontexten und großen Token-Mengen — genau der Anwendungsfall, bei dem der Kostenunterschied zwischen Open-Weight-Modellen und proprietären APIs entscheidend wird.
🔗 Beitrag von @togethercompute
GitHub Copilot in VS Code: vier August-Versionen in einem Changelog zusammengefasst
31. August — GitHub veröffentlicht den Rückblick für August 2026 zu Copilot in Visual Studio Code, der vier Versionen des Editors von v1.132 bis v1.135 abdeckt. Der rote Faden dieses Zyklus ist die Organisation der Arbeit mit mehreren Agenten: Das Agents-Fenster ist nicht länger nur eine Liste von Unterhaltungen, sondern wird zu einem Arbeitsbereich, in dem mehrere Sitzungen nebeneinander bestehen und in ihrem jeweiligen Zustand wieder aufgerufen werden können.
Bei den Sitzungen lassen sich Chats nebeneinander in horizontalen oder vertikalen Gruppen anordnen, wobei das Layout bei der Rückkehr wiederhergestellt wird. Der Befehl /btw öffnet eine seitliche Unterhaltung, die den Kontext und den Prompt-Cache der Hauptunterhaltung teilt, während diese weiterläuft: So kann eine Nebenfrage gestellt werden, ohne einen laufenden Agenten zu unterbrechen. Über die Randleiste des Transkripts ist eine Zeitleistensteuerung für Prompts zugänglich, mit der man direkt zu einem Prompt springen und die daraus resultierenden Dateiänderungen überprüfen kann. Der Agent Host ermöglicht mehreren VS-Code-Fenstern, sich mit derselben Sitzung zu verbinden, und ein experimenteller Befehl /rubber-duck zieht ein ergänzendes Modell hinzu, um übersehene Details und Grenzfälle aufzudecken.
Zwei Punkte betreffen unmittelbar die Stellung von Claude im Editor: Eine experimentelle Einstellung öffnet das Agents-Fenster ohne GitHub-Anmeldung, sobald Claude mit einem API-Schlüssel konfiguriert ist, und in Claude-Sitzungen kann jederzeit zwischen den Modellen des Anthropic-Abonnements und denen des Copilot-Abonnements gewechselt werden. VS Code unterstützt außerdem die Installation portabler Agent-Plugins, die dem Standard Agent Plugins 1.0 entsprechen und in anderen kompatiblen Agent-Clients verwendet werden können.
| Changelog-Bereich | Bemerkenswerte Neuerungen |
|---|---|
| Sitzungen und Workflows | Chats nebeneinander, /btw, Prompt-Zeitleiste, Agent Plugins 1.0, /rubber-duck, Agent Host |
| Claude in VS Code | Agents-Fenster ohne GitHub-Anmeldung per API-Schlüssel, Wechsel zwischen Anthropic- und Copilot-Modellen |
| Chat und Überprüfung | Suche im Transkript, fixiertes Scrollen, hybrider Markdown-Editor, Tokens pro Modell |
| Integrierter Browser | Sammelannotation von HTML-Elementen, automatisches Neuladen, standardmäßiger HTML-Editor |
| Diktierfunktion | Mehrsprachig auf dem Gerät, Bereinigungsanweisungen, an die Shell angepasste Bereinigung |
Der Chat erhält schließlich die Lesewerkzeuge, die für immer längere Unterhaltungen nötig geworden sind: eine Textsuche über das gesamte Transkript mit Optionen für Groß- und Kleinschreibung, ganze Wörter und reguläre Ausdrücke, fixiertes Scrollen, das den aktuellen Prompt sichtbar hält, sowie eine Anzeige des Token-Verbrauchs je Modell beim Überfahren der Antwortfußzeile, aufgeschlüsselt nach Eingabe, zwischengespeicherter Eingabe und Ausgabe — eine hilfreiche Transparenz, seit die Abrechnung vom Cache abhängt. Im integrierten Browser können mehrere HTML-Elemente einer Seite ausgewählt und annotiert werden, um gebündeltes Feedback zur Benutzeroberfläche zu verarbeiten. Die Diktierfunktion läuft auf dem Gerät und unterstützt mehrere Sprachen; beim Diktieren in einem Terminal bewahrt sie die Befehlssyntax, statt die gesprochene Interpunktion einzufügen.
🔗 GitHub Changelog — Copilot in VS Code, Versionen vom August 2026
NVIDIA bringt seine Softwarebausteine in Biologie und autonomes Fahren ein
31. August — NVIDIA hat ein Tutorial veröffentlicht, das eine gemeinsam mit Anthropic durchgeführte Integrationsarbeit dokumentiert: Das BioNeMo Agent Toolkit kann nun aus Claude Science heraus verwendet werden, der wissenschaftlichen Forschungsumgebung von Anthropic. Das behandelte Problem betrifft spezialisierte Werkzeuge — ein allgemeiner Agent kann erkennen, dass eine Aufgabe die Faltung eines Proteins erfordert, ohne jedoch zu wissen, welches Modell ausgeführt werden muss, wie die Anfrage zu formatieren ist oder welche Parameter relevant sind. Das Toolkit bündelt mehr als ein Jahrzehnt an BioNeMo-Modellen, -Bibliotheken und -Workflows — für Biologie, Chemie, Genomik und Arzneimittelforschung — in Skills, die von einem Agenten aufgerufen werden können. In seinen internen Benchmarks gibt NVIDIA an, dass die Aufgabengenauigkeit von 60 auf 100 % steigt und sich die Token-Effizienz ungefähr verdoppelt.
Das Tutorial verknüpft drei NIM-Microservices: zunächst MSA Search zum Aufbau des evolutionären Kontexts, anschließend OpenFold3 und Boltz-2 zur unabhängigen Vorhersage der Struktur. Die aussagekräftigste Demonstration betrifft die Rolle des multiplen Sequenzalignments — ohne dieses bricht die Zuverlässigkeit der Schnittstelle bei beiden Modellen ein, und auch ein großzügigeres Sampling-Budget ändert daran nichts. Zwei Einschränkungen sind erwähnenswert: die Hardwarehürde mit einer L40S- oder H100-GPU und rund 700 GB Speicher sowie die von NVIDIA selbst betonte Vorsicht bei der Interpretation. Das Unternehmen weist darauf hin, dass ein Konfidenzwert keine Interaktion beweist, und stellt die Übereinstimmung zweier unabhängiger Modelle als solide Hypothese dar, nicht als Beweis.
| Konfidenzmaß der Schnittstelle (iPTM) | OpenFold3 | Boltz-2 |
|---|---|---|
| Heteromer mit MSA-Alignment | 0,85 | 0,82 |
| Heteromer ohne MSA-Alignment | 0,14 | 0,19 |
| Cα-RMSD des Kerns, Monomer gegenüber Heteromer | 0,68 Å | 0,65 Å |
🔗 NVIDIA-Tutorial — BioNeMo NIM in Claude Science
Omniverse NuRec passt einen Wahrnehmungs-Stack an ein noch nicht existierendes Fahrzeug an
31. August — Am selben Tag veröffentlicht NVIDIA ein zweites technisches Tutorial, diesmal zum autonomen Fahren. Ausgangspunkt ist die Feststellung, dass ein Wahrnehmungs-Stack durch das Fahrzeug geprägt wird, das ihn trägt: Wird er von einem SUV auf eine Limousine übertragen, nimmt er die Welt nicht mehr auf dieselbe Weise wahr, da sich Sensorpositionen, Kalibrierung, Sichtfelder, Verdeckungen und Karosseriegeometrie verändern. Einen realen Datensatz für jede Fahrzeuglinie zu erfassen und zu annotieren ist teuer und zu Beginn der Entwicklung häufig noch nicht möglich.
Omniverse NuRec ermöglicht die Wiederverwendung bereits aufgezeichneter Fahrten: Jede Szene wird rekonstruiert und anschließend aus der Sensorkonfiguration des Zielfahrzeugs wiedergegeben. Teams können so erkennen, wie ein Szenario mit der neuen Kameraanordnung aussehen würde und an welchen Stellen Geometrieänderungen tote Winkel erzeugen. NVIDIA betont, dass reale Fahrdaten weiterhin unverzichtbar sind, um die Leistung zu verankern und zu validieren: Synthetische Daten dienen dazu, Modelle anzupassen, bevor ein eigener Datensatz existiert, nicht dazu, diesen zu ersetzen. Die Szenen werden auf Hugging Face im USDZ-Format zusammen mit einem Repository von Skills für Coding-Agenten bereitgestellt.
🔗 NVIDIA-Tutorial — Omniverse NuRec
Amp verknüpft jeden Thread mit einem Audio- und Videoanrufraum
31. August — Amp verknüpft jeden Thread mit einem Raum für Live-Unterhaltungen. Die Funktion namens Space to Talk öffnet einen direkt mit dem Thread verbundenen Audio- und Videoraum: Ein Druck auf die Eingabetaste genügt, um beizutreten, die Kamera einzuschalten und den Bildschirm zu teilen, während der Agent seine Arbeit im selben Thread fortsetzt.
Als Hauptargument wird der Wegfall von Zwischenschritten angeführt, und das Konzept setzt Amps kollaborative Entwicklung seit dem Sommer fort: zunächst die gemeinsame Steuerung eines Orb durch Teammitglieder (Multiplayer, 22. Juli), dann die Einladung per Erwähnung direkt in einem Thread (Pass the Orb to the Left Hand Side, 19. August). Der Thread wird zum zentralen Treffpunkt für Team und Agent. Amp lässt den künftigen Umfang ausdrücklich offen: Brainstorming, Whiteboards oder Unterhaltungen mit Puck und anderen Agenten werden als mögliche zukünftige Entwicklungen genannt, nicht als bereits bereitgestellte Funktionen.
No links to paste, no calendar invite, no other app. The call lives where the work lives.
🇩🇪 Kein Link zum Einfügen, keine Kalendereinladung, keine andere Anwendung. Der Anruf findet dort statt, wo sich die Arbeit befindet. — Amp, Mitteilung Space to Talk
VLANeXt, eine einheitliche Codebasis für Vision-Language-Action-Modelle
31. August — Ein Team stellt im Hugging-Face-Blog VLANeXt vor, eine Forschungs-Codebasis für Vision-Language-Action-Modelle (vision-language-action, VLA). Das Prinzip dieser Modelle ist einfach: Ein Vision-Language-Modell verbindet das, was der Roboter sieht, mit einer natürlichsprachlichen Anweisung und leitet daraus anschließend eine Handlung in der physischen Welt ab.
Das behandelte Problem ist methodischer Natur. Das Feld entwickelt sich schnell, fragmentiert jedoch zunehmend: Von einer Veröffentlichung zur nächsten ändern sich Backbone, Policy Head, Aktionsrepräsentation, Trainingsstrategie und Evaluierungsprotokoll. Die Ergebnisse werden vielfach als robust dargestellt, doch mangels isolierbarer Variablen lässt sich nur schwer bestimmen, was ein VLA-Modell tatsächlich leistungsfähig macht.
Statt eine weitere Architektur hinzuzufügen, gingen die Autoren von einer Referenzbasis nach Art von RT-2 / OpenVLA aus und untersuchten den Gestaltungsraum systematisch, um daraus ein Erfolgsrezept abzuleiten. Aus dieser Arbeit entstand das ICML-Paper „VLANeXt: Recipes for Building Strong VLA Models“. Die Codebasis wurde seitdem über diese Studie hinaus erweitert und umfasst Backbones unterschiedlicher Größe, das Lernen latenter Aktionen, prädiktive Modellierung im latenten Raum und World-Action-Modellierung. Sie bietet sechs Ausgangspunkte: VLANeXt-LAM, -S, -L, -XL, -JEPA und -WAM.
Kurzmeldungen
- Claude Code 2.1.252, eine reine Fehlerbehebungsversion — Vier Korrekturen und keine Neuerungen: fehlschlagende Bash-Befehle auf bestimmten Macs, eine in einem Projekt ohne Datei
.claude/settings.local.jsonnicht gespeicherte Auswahl von „always allow“, mehrere Minuten lang eingefrorene Remote-Control-Sitzungen nach Abschluss eines Tools bei beeinträchtigter Verbindung zu claude.ai sowie Benachrichtigungen von Hintergrundaufgaben mit umfangreicher Ausgabe, durch die das Größenlimit für API-Anfragen überschritten wurde. 🔗 CHANGELOG von Claude Code - Flow führt auf dem Desktop die Steuerung des ersten und letzten Bildes ein — Google Flow teilt mit, dass die zusammen mit dem Modell am 27. August vorgestellte Steuerung des ersten und letzten Bildes von Gemini Omni 1.1 Flash nun auf dem Desktop verfügbar ist. Der hervorgehobene Anwendungsfall: An beiden Enden dasselbe Bild verwenden, um eine Schleife zu erzeugen. 🔗 Beitrag von @FlowbyGoogle
- Letzter Tag für die Teilnahme am Grok Imagine-Preis — xAI erinnerte daran, dass die Frist für den am 17. August gestarteten Videowettbewerb noch am selben Tag endete. Die Teilnehmenden sollten eine Szene aus Homers Odyssee produzieren, die die Video- und Sprachfähigkeiten des Modells hervorhebt; die drei besten Beiträge teilen sich 175.000 Dollar und erhalten jeweils 100.000, 50.000 beziehungsweise 25.000 Dollar. 🔗 Beitrag von @grok
- QwenCloud schließt seine Arena und kündigt eine Veranstaltung in Bangkok an — Die Qwen Cloud Arena Challenge zu Agenten für die Inhaltserstellung im grenzüberschreitenden E-Commerce schloss nach mehr als 800 Teilnehmenden um Mitternacht Pekinger Zeit die Einreichungsphase; die Begutachtung begann am folgenden Tag. Wenige Stunden zuvor hatte QwenCloud für den 4. September eine Veranstaltung auf der Qwen Conference in Bangkok angekündigt, mit derselben bereits in Hongkong vorgestellten Positionierung über drei Zugangspunkte — Website, Skills, CLI. 🔗 Abschluss der Arena · 🔗 Veranstaltung in Bangkok
- GitHub startet eine Umfrage zu Barrierefreiheitsanpassungen von Entwicklern — Das Unternehmen möchte die Werkzeuge, Produkteinstellungen und persönlichen Anpassungen dokumentieren, die gute Arbeitsbedingungen ermöglichen, ohne dass sich Teilnehmende als Menschen mit Behinderung bezeichnen oder als Nutzer von Barrierefreiheitswerkzeugen verstehen müssen. Antworten werden bis zum 30. September entgegengenommen. Das Thema steht nicht mit KI in Zusammenhang. 🔗 Beitrag von @github
- otoSpeech Task, ein zusammen mit seiner Aufgabe veröffentlichter Full-Duplex-Korpus — Zwanzig Stunden englischsprachiger Gespräche mit jeweils zwei Sprechern, 58 Sitzungen zu sieben kollaborativen Aufgaben und 11.025 Ereignisse mit Zeitstempeln unter der Lizenz CC BY 4.0. Die Besonderheit besteht darin, dass die von jedem Sprecher gesehenen Bilder, ihre Aktionen und die Referenzantworten auf derselben Zeitleiste wie das Audio erfasst sind. 🔗 Beitrag auf Hugging Face
- YOLO26-RGB, ein aus einem Depth Head abgeleitetes Modell zur Regenentfernung — Zwei Modelle zur Regenentfernung, die entstanden, indem der einkanalige Depth Head von YOLO26-depth durch einen dreikanaligen RGB Restoration Head ersetzt wurde: 5,25 M Parameter bei etwa 109 Bildern/s in 1080p und 12,13 M bei etwa 92 Bildern/s für 0,1 dB zusätzliche Qualität. 🔗 Beitrag auf Hugging Face
Was das bedeutet
Die Benutzeroberfläche statt des Codes erzeugen, der sie hervorbringt. Solaris verschiebt die Grenze zwischen Design und Ausführung. Die gesamte heutige Softwarekette beruht auf einer Übersetzung — aus einem Mockup wird Code, der Code erzeugt eine Darstellung — und Runway misst, was diese Übersetzung kostet: Bei 30 Benutzeroberflächen, die anhand eines Screenshots rekonstruiert werden sollten, verlieren alle getesteten multimodalen Modelle Informationen, wobei die Beeinträchtigung mit zunehmendem visuellem Reichtum stärker wird. Den Zwischenschritt zu entfernen, ist ein radikaler Vorschlag, und die Einschränkungen, die das Labor selbst aufzählt, zeigen, woran er scheitert: Text, der nicht an seinem Platz bleibt, keine garantierte faktische Verankerung und eine Barrierefreiheit, die vollständig neu entwickelt werden muss, da ein generiertes Bild Screenreadern keinerlei Struktur bereitstellt. Das sind grundlegende Hindernisse, keine Schönheitsfehler.
Zwei Arten, für Rechenleistung zu bezahlen, am selben Tag angekündigt. OpenAI weist in seinem Werbegeschäft einen annualisierten Umsatz von einer Milliarde Dollar aus — eine Hochrechnung auf zwölf Monate, keine tatsächlichen Einnahmen — und betrachtet ihn als wirtschaftliche Säule auf derselben Ebene wie Abonnements: Werbung finanziert die kostenlose Stufe eines Dienstes, der nach eigenen Angaben mehr als eine Milliarde wöchentliche Nutzer hat. Together AI wiederum monetarisiert weder ein Publikum noch kauft es zusätzliche Kapazitäten: Das Unternehmen erhält in Saudi-Arabien 250 MW und 120.000 Chips im Austausch gegen einen Anteil an seinem Umsatz und bezeichnet Energie als den eigentlichen Engpass der Branche. Beide Unternehmen begegnen derselben Einschränkung an den beiden entgegengesetzten Enden der Kette, und keine der beiden Antworten ist neutral: Die eine bringt ein kommerzielles Interesse in das Produkt ein, die andere verlagert die Infrastruktur dorthin, wo sie auf weniger politischen Widerstand stößt.
Der Wettbewerb um agentische Systeme findet inzwischen nach dem Pre-Training statt. Das Ergebnis von GLM-5.3 im agentischen Index von Artificial Analysis ist vor allem wegen der Art und Weise bemerkenswert, wie es erzielt wurde: Z.ai behielt die Basis GLM-5.2 bei und skalierte nur das Post-Training hoch — Umgebungen mit langem Zeithorizont, Aufgabenvielfalt und RL-Compute. Wenn es nicht mehr erforderlich ist, ein Basismodell neu zu trainieren, um die Spitze einer agentischen Rangliste zu erreichen, dann ist der größte Kostenblock nicht länger der einzige bestimmende Faktor für die Platzierung, und der Aktualisierungszyklus eines Modells verkürzt sich entsprechend. Das ist auch die wirtschaftlichste Erklärung für die sechstägige Entwicklung dieses Modells, von den offenen Gewichten am 28. bis zu dieser Platzierung am 31.
Entwicklerwerkzeuge organisieren sich neu und richten sich dabei auf mehrere gleichzeitig arbeitende Agenten aus. Das Copilot-Changelog widmet einen ganzen Zyklus der Behandlung des Agents-Fensters als Arbeitsbereich — Chats nebeneinander, eine seitliche Unterhaltung mit gemeinsamem Prompt-Cache, eine Chronik der Prompts, mehrere mit derselben Sitzung verbundene Fenster — und nicht mehr als bloße Liste von Unterhaltungen. Amp bindet einen Gesprächsraum an den Thread, damit die menschliche Diskussion dort stattfindet, wo der Agent arbeitet. NVIDIA schließlich bündelt zehn Jahre wissenschaftlicher Bibliotheken in aufrufbaren Skills und stellt ein zweites Skill-Repository für die Rekonstruktion von Fahrszenen bereit. Drei sehr unterschiedliche Akteure nähern sich derselben Idee an: Was dem Agenten fehlt, ist nicht mehr die Leistungsfähigkeit des Modells, sondern der gemeinsame Kontext und die spezialisierten Werkzeuge, die man ihm an die Hand geben kann.
Quellen
- Runway — Vorstellung von Solaris
- Runway — Ankündigung von Solaris auf X
- OpenAI — Ein Meilenstein beim Ausbau des Zugangs zu AI
- Together AI — Infrastrukturvereinbarung über 250 MW mit HUMAIN
- Together AI — GLM-5.3 im agentischen Index von Artificial Analysis
- Together AI — Greptile als primärer Inferenzanbieter
- GitHub Changelog — Copilot in VS Code, Versionen vom August 2026
- NVIDIA — BioNeMo NIM zur Vorhersage von Proteinstrukturen in Claude Science
- NVIDIA — Omniverse NuRec und die Multi-Fahrzeug-Wahrnehmung
- Amp — Raum zum Reden
- VLANeXt, einheitliche Codebasis für Vision-Language-Action-Modelle
- CHANGELOG von Claude Code
- Google Flow — erste und letzte Bilder auf dem Desktop
- xAI — letzter Tag des Grok-Imagine-Wettbewerbs
- QwenCloud — Abschluss der Qwen Cloud Arena
- QwenCloud — Sitzung auf der Qwen Conference in Bangkok
- GitHub — Umfrage zu Tools und Anpassungen für Barrierefreiheit
- otoSpeech Task, Full-Duplex-Gesprächskorpus
- YOLO26-RGB, Modell zur Entfernung von Regen aus Bildern