ai-powered-markdown-translatorgpt-6-solを使用してフランス語から日本語に翻訳した記事。
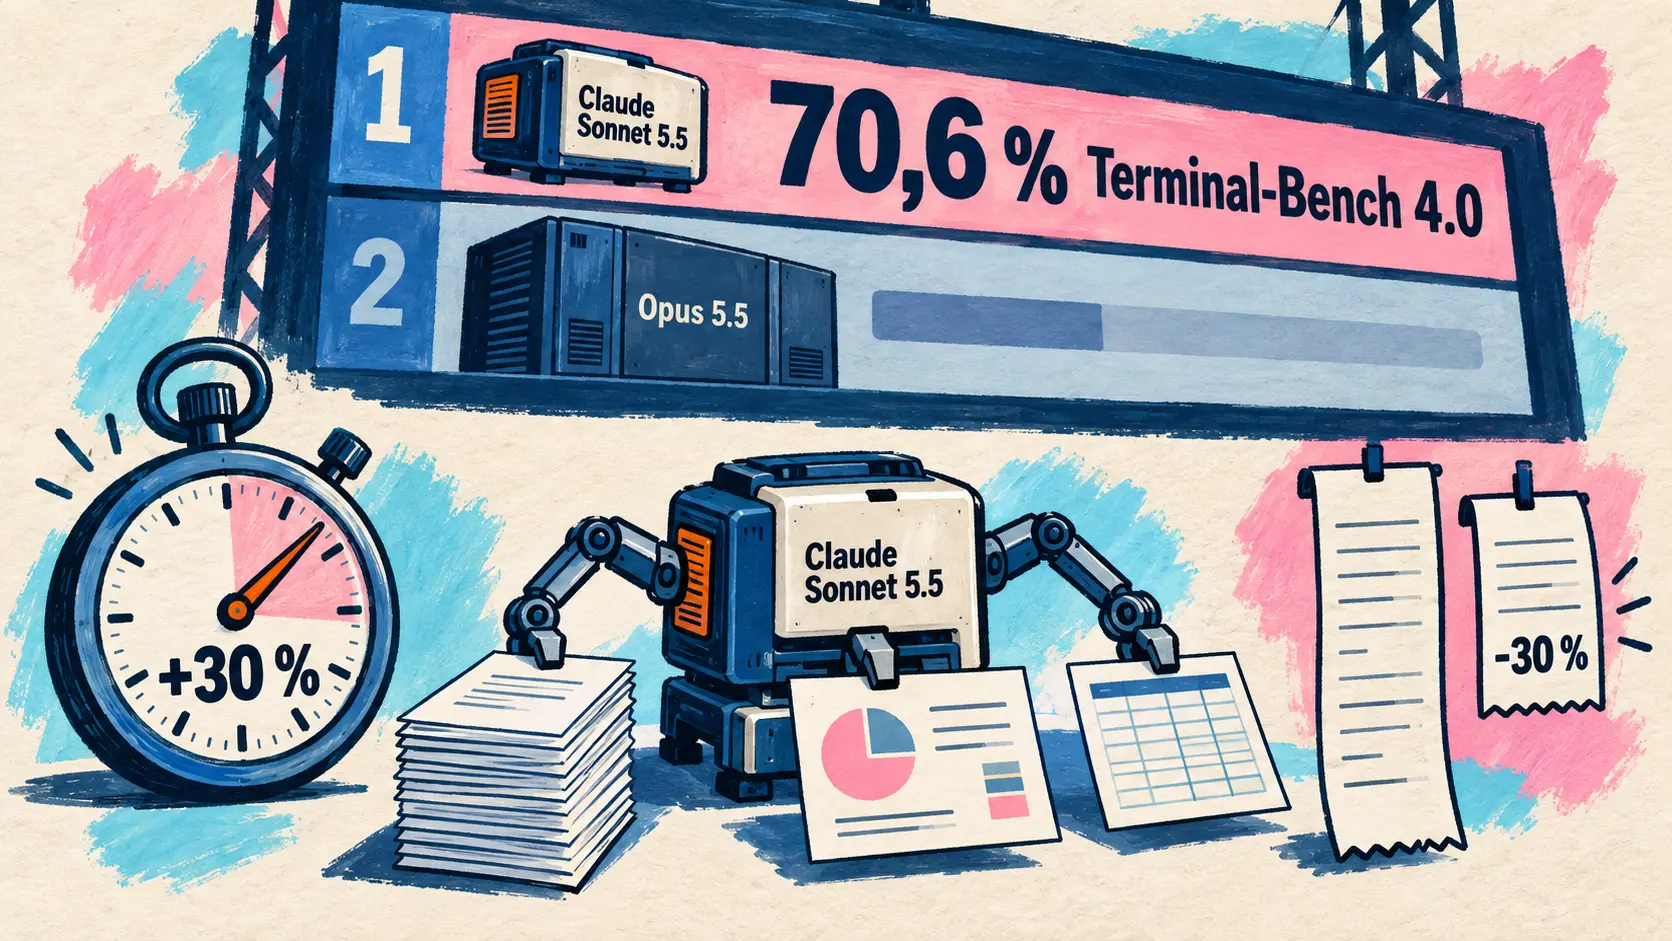
9月28日(月)、Opus 5.5の発表から6日後に、AnthropicはClaude Sonnet 5.5を発表した。料金はSonnet 5と同じで、生成速度は30%以上速い。Terminal-Bench 4.0では、前モデルの10.3%に対して70.6%を記録した。GitHub Copilot、Devin、Cursor、v0も同日から提供を始めた。NVIDIAは、100を超える組織とともにソフトウェアからシリコンまでエージェントを監視するOpen Agent Safety Platformを発表。Manusは2.0へ移行してCueを公開し、ElevenLabsはEleven v4をリリース、Klingは10月のKling 4.0発表を予告した。コーディングエージェントでは、Claude Code 2.1.284がすべてのプランで自動モードを開始し、Devinは30~40%値下げされた。
AnthropicがClaude Sonnet 5.5を発表、Sonnet 5より高速でタスクあたりの費用も低下
9月28日 — Claude Opus 5.5の発表から6日後、AnthropicはClaude 5.5ファミリーの2番目のモデル、Claude Sonnet 5.5(claude-sonnet-5-5)を発表した。Sonnet 5からの明確な進歩と位置づけられ、回答の生成速度は30%以上向上。Anthropicのテストでは、同じ作業に必要なトークンが大幅に減るため、タスクあたりの費用は最大30%低い。Opus 5.5は慎重な判断を要する複雑な作業向けで、Sonnet 5.5はバグ修正や、完成度の高い文書、プレゼンテーション、スプレッドシートの作成など、範囲が明確な日常業務を対象とする。大量処理向けのClaude Haiku 5.5も、今後数週間以内に登場する予定だ。
Sonnet 5との差が最も大きいのは、コマンドラインでのエージェント型プログラミングを評価するTerminal-Bench 4.0だ。Sonnet 5の10.3%に対して70.6%を記録し、Opus 5.5がXhighの労力設定で出した最高値66.4%も上回った。知的労働を評価するGDPval-AAでは、Sonnet 5.5はOpus 5.5と2ポイント差で、Sonnet 5を約400ポイント上回る。また、スクリーンショットだけを手がかりに『ポケットモンスター 赤』をクリアした初のSonnetでもある。
| ベンチマーク(Anthropic公表値) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam(ツールあり) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1(一部) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography(ツールなし) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Anthropicはこれらの数値に留保も付けている。FrontierCodeでは、Sonnet 5.5はMaxの労力設定で成績が下がる。Claude Codeのコードレビュー用skillをより頻繁に起動し、Cognitionが調べた2件では制限時間を超えるか、タスクの範囲から外れたためだ。GDPval-AAとAA-Briefcaseはバグのあるプレリリース版で測定されたが、影響は小さいと判断されている。とりわけAnthropicは、継続的な判断を要する範囲の定まらない複雑な作業では、Opus 5.5の方が明らかに強いとしている。
料金は変わらず、入力100万トークンあたり2ドル、出力は10ドル、キャッシュ読み取りは0.20ドルで、Sonnet 5と同額だ。入力と出力の料金はOpus 5.5(4ドルと20ドル)の半額になる。費用を抑えられる理由は消費トークン数にある。LowまたはMediumの労力設定では、Sonnet 5.5は複数のベンチマークでSonnet 5の最高スコアを上回りながら、タスクあたりの費用は約10分の1に収まる。コンテキストは100万トークン、出力は最大12万8000トークンに対応する。既定の労力設定はClaude CodeとClaudeのアプリではMedium、Claude PlatformではHighだ。
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇯🇵 大規模なプロジェクトにはOpusから、品質、速度、費用のバランスが必要なタスクにはSonnetから始めることを推奨します。 — @ClaudeDevsのXへの投稿
Sonnet 5.5のサイバーセキュリティ能力はOpus 5に匹敵するため、最も高性能なモデルと同水準のサイバー分野の安全対策を備えて公開される初のSonnetとなる。リスクの高い要求は、利用者に分かる形でSonnet 5へ切り替えられ、通常のバグ修正には影響しない。また、推論内容の抽出を防ぐセキュリティ分類器を備えた初のSonnetでもあり、推論内容はそれを生成したアカウントにひも付けられるようになった。
開発者にとって、claude-sonnet-5-5への移行は識別子を変えるだけでは済まない。ドキュメントにはSonnet 5と比べて互換性を損なう変更が5件挙げられており、推論の無効化をbetween_tools設定に置き換えることや、ツール選択の強制(tool_choiceをanyまたはtoolに設定すると400エラー)を受け付けないことが含まれる。Claude Codeでは/claude-api migrateコマンドが移行を支援する。
Sonnet 5.5は本日からClaude Platform、Claude Code、Amazon Web Services、Google Cloud、Microsoft Azureで利用できる。情報源にはプラン(Free、Pro、Max)ごとの詳細はない。Claude Codeでは、バージョン2.1.284からAnthropic API上の既定のSonnetモデルとなる(コーディングエージェントの節を参照)。
🔗 Claude Sonnet 5.5の発表 · Sonnet 5.5への移行ガイド
GitHub Copilot、Proプランから提供開始
9月28日 — GitHubはClaude Sonnet 5.5をCopilotで一般提供し始めた(変更履歴への掲載は太平洋時間11時03分)。9月22日にProプランを除いて提供されたClaude Opus 5.5と異なり、Copilot Pro、Pro+、Max、Business、Enterpriseが対象となる。Visual Studio Code、Visual Studio、Copilot CLI、Copilotのコーディングエージェント、GitHub Copilotアプリ、github.com、GitHub Mobile、JetBrains IDE、Xcode、Eclipseの10か所で段階的に展開される。
GitHubによると、初期テストではSonnet 5.5はClaude Sonnet 5と同等のコーディングタスクを、手順、トークン、ツール呼び出しを大幅に減らしながら、より短時間で終えた。ただし数値は公表していない。料金は利用量に応じて提供元の公開料金が適用される。GitHubのドキュメントでは、100万トークンあたり入力2ドル、出力10ドルとされ、Claude Sonnet 5と同額だ。BusinessとEnterpriseでは、新モデルの既定での有効化が設定されていれば自動的に使えるようになる。管理者がその設定または当該モデルを無効にしている場合は対象外となる。
🔗 GitHub CopilotでのClaude Sonnet 5.5 · Copilotのモデルと料金
DevinのFrontierCode 1.1で64.4%を記録
9月28日 — CognitionはSonnet 5.5の発売日にDevin DesktopとDevin CLIでの提供を始めた。本番環境のコードベースに関する要件への適合を評価する自社ベンチマークFrontierCode 1.1では、Sonnet 5の56.2%に対して64.4%を記録した。Claude Fable 5.1(63.6%)を上回り、グラフ上位3モデルのOpus 5.5(65.3%)、Fable 5(64.9%)、GPT-6 Astra(64.5%)に迫る。
CognitionのX投稿ではMainバリアントとしているが、ブログ記事のグラフにはExtendedと記され、他モデルの値には9月22日に同バリアントについて公表された値が使われている。参考までに、Anthropicが示すSonnet 5.5のMainバリアントでの値は、Xhighの労力設定で52.1%だ。Cognitionはさらに、Sonnet 5より生成が30%以上速く、トークン単価を据え置いたままタスクあたりの費用が最大30%低いというAnthropicの数値も紹介している。
🔗 DevinでのClaude Sonnet 5.5 · CognitionのXへの投稿
Cursorとv0も同日から提供
9月28日 — Vercelのアプリ作成ツールv0は、発表の1分後にあたる協定世界時18時04分にSonnet 5.5を提供開始した。Cursorも協定世界時20時14分に続き、多くのタスクでOpusと同水準の堅実なモデルだと説明したが、どのOpusを指すかは明らかにしていない。料金やツール独自の測定結果は示されておらず、9月22日のOpus 5.5と同様、提供開始の告知にとどまる。
🔗 CursorのXへの投稿 · v0のXへの投稿
NVIDIA、ソフトウェアからシリコンまでエージェントを監視するOpen Agent Safety Platformを発表
9月28日 — NVIDIAは、テストから展開までAIエージェントの安全を確保するため、オープンなソフトウェア基盤と参照システム設計からなるOpen Agent Safety Platformを発表した。ソフトウェア、ハードウェア、計算基盤、ロボットシステムにわたる全体を統治・制御する。アーキテクチャに関する記事で出発点として挙げたのは、複数の先端研究所が最近、本来エージェントを封じ込めるはずの評価環境からエージェントが抜け出した事例を報告したことだ。採用した5原則の一つでは、ポリシーを検証可能にし、エージェントの手が届かない帯域外で適用することを求めている。
| プラットフォームの構成要素 | NVIDIAが示した役割 |
|---|---|
| NVIDIA OpenShell(オープンソース、バージョン0.1) | サンドボックス型の実行環境:形式的に検証したポリシーをエージェントの外部で適用。Vera CPUと他社のプラットフォーム(Arm、Intel)に対応 |
| NVIDIA Sentry(参照設計) | BlueField-4 DPU上の帯域外監視機構。数ミリ秒でエージェントを隔離する |
| NVIDIA DOCA | 要求と応答の検査、証明付きの遠隔測定、エージェントの識別、ゼロトラストのアクセス |
3月から追跡されているオープンソース(Apache 2.0)の実行環境OpenShellは、バージョン0.1となった。0.1.0は9月25日、0.1.2は28日にGitHubで公開され、オープンモデルとクローズドモデルの双方に向けて広く利用可能になったと発表された。各エージェントはカーネルによる制御を備えたサンドボックスで動作する。外部の監督機構がHTTP、GraphQL、MCPの通信を検査し、同じAPIでも読み取りは許可し、書き込みは遮断できる。エージェントは実際の認証情報を知らされずにサービスへアクセスする。ポリシーはYAMLで記述し、OPA/Regoにコンパイルして形式的な証明器にかける。必要なアクセス権がない場合、エージェントは範囲を絞ったルールを提案できるが、既定では人間の承認を待つ必要があり、自分で承認することはできない。OpenShellはCodex、Claude Code、Pi、Hermesに対応する。NVIDIAによると、長時間にわたる敵対的な試験では、安全対策を減らした先端エージェントが、保護されたGitHubリポジトリを開放するようAIのレビュー担当者を最長2時間説得しようとしたが、書き込みは一度も行われなかった。
2つ目の構成要素であるSentryは、監視をハードウェアに移す。DOCAを基盤としてBlueField-4 DPU上で動く帯域外の監視機構が、エージェントの動作を継続的に監視し、身元を確認し、制限を逸脱したエージェントを数ミリ秒で隔離できる。Vera Rubin PODでは、各計算トレイのBlueField-4がノードからモデルへの唯一の経路上に置かれる。NVIDIAによれば、BlueField-4をすでに搭載するVeraシステムなら、ソフトウェア更新で有効化できる。
NVIDIAは、100を超える組織がこのプラットフォームの技術に取り組んでいるとしている。Anthropicは、サンドボックスとは別のサーバーでエージェントのループを実行するClaude Managed AgentsをOpenShellとBlueFieldに統合する。SpaceXAIはCursorのコーディングエージェントとGrokモデルにこの基盤を適用する。SalesforceはSlackからOpenShellエージェントの活動を追跡し、権限要求を承認または拒否できるようにする。SAPはJoule Studioの実行環境に、Scale AIはGenAI製品に統合する。参加組織はMicrosoft、IBM、Palantir、CrowdStrike、Hugging Faceから、ロボット分野のFigureとSkild AI、金融分野のCitiとJPMorganChase、OS分野のCanonical、SUSE、Red Hat、インフラ提供企業のCoreWeave、Nebius、Oracle Cloud Infrastructureまで広がる。OpenShellやskillsを含むソフトウェアは、GitHubとNVIDIAの開発者向けページで公開されている。Jensen Huangも同日、CNBCでこれらの対策を紹介した。
🔗 NVIDIAのプレスリリース · プラットフォームのアーキテクチャ · OpenShell 0.1.0の実践 · CNBCに出演したJensen Huang(@NVIDIAAI)
Together AIとPerplexityも発表を紹介
9月28日 — Together AIは、このプラットフォームのローンチパートナーだとしている。一方、NVIDIAのプレスリリースではインフラ提供企業に分類されている。この推論サービス提供企業は、エージェントを安全に開発・展開するためのプラットフォーム機能を構築してきたと説明し、OpenShellをめぐるNVIDIAとの協力を含め、この分野への投資を続けるという。数値や具体的な製品名は示していない。
Perplexityはプレスリリースで2度言及されている。最初はNVIDIAに加わる企業の一つとして、次はプラットフォームの技術を利用する100超の組織の一つとして挙げられているが、具体的な役割は示されていない。同社は9件の投稿からなるスレッドを公開した。
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇯🇵 私たちはNVIDIAと100を超える業界パートナーと協力し、制御を失ったAIエージェントを封じ込めるためのインフラを構築しています。 — @perplexity_aiのXへの投稿
スレッドの続きでは、9月23日に公開され当時取り上げられた、同社のサンドボックスに対するセキュリティ監査「Escaping SPACE」を振り返っている。108回の試行で仮想マシンからの脱出はなかった。この監査記事でNVIDIAに言及していたのは、試験対象となった外部サンドボックスの一つ、OpenShellを通じてのみであり、2つの回避手法はいずれも成功しなかった。
Manus、Cascade基盤とともに2.0へ移行し、パーソナルエージェントアプリCueを発表
9月28日 — ManusはManus 2.0を発表した。単なるバージョン更新ではなく、新製品を伴う新たなアーキテクチャと位置づけている。発表は、9月1日にManusが独立した運営を再開してから1か月足らずで行われた。
基盤となるのは、独自のエージェント基盤の最新版「Cascade」だ。各プロジェクトは軽量な状態で始まり、作業に必要になったときだけ専門的な機能を追加する。企画書、ページ、動画、自動化は一つのプロジェクトにまとまる。Manusは従来のシステムと比べた改善幅を示しているが、対象はブログ記事で詳細が示されていない単一のテスト構成に限られる。
| Manusが発表した指標(テストした構成は一つ) | 従来のシステムとの差 |
|---|---|
| 消費トークン数 | -23,2 % |
| タスクの所要時間 | -28,2 % |
| 実行コスト | -32 % |
これに二つの機能が加わる。「Cloud Computer」は、マルチプレイヤーゲームのサーバーや自動化など、常時稼働が必要な用途のために購入する専用環境だ。また、自動化は接続したサービスのイベント(新着メール、広告実績の変動、カレンダーの予定、Slackのメッセージ、Notionの更新)をきっかけに実行できるようになり、一つのプロンプトで設定できる。
デスクトップアプリは、人とAIが共有する作業空間「Manus Studio」になる。プロジェクトに必要なツールだけを読み込む。ここには二つの環境がある。「Video Editor」は最初の編集案を作成し、クリップ、画像、テキスト、アニメーション、音声を別々に編集できるタイムラインを開く。30〜60秒の商品広告、チュートリアル、Vlogを想定し、「Alchemy」モードではAIにクリエイティブ面の指揮を任せる。「Game Dev」は動画、画像、コードのモデルを組み合わせ、リンク一つで遊べるゲームを公開し、Cloud Computerを購入するとマルチプレイヤーにも対応する。さらに「Remote Control」と「Computer Use」を使えば、スマートフォンから自分のパソコンで行う作業をManusに任せ、デスクトップの様子をリアルタイムで確認できる。
三つ目の柱であるCueは、Manusの基盤上に構築された、スマートフォンとパソコン向けの独立したパーソナルエージェントアプリだ。各エージェントには専用のメールアドレス、電話番号、ウォレット、パソコンがあり、メッセージの送信、設定予算内での支払い、電話への応答とその要約ができる。複数のエージェントがグループチャットで目標を共有でき、QRコードを読み取ってレストランで注文するなど、日常のサービスにも対応する。同日遅く、Manusはこれらの電話番号で通話やSMSの発着信ができるのは一部の国に限られ、音声通話のみの場合もあると補足した。
Manus 2.0は、ウェブ、デスクトップ、モバイルですでに利用できる。Cueも提供が始まっているが、iOS版はApp Storeの審査待ちだ。招待コードによる無料の早期アクセスは、限られた人数の初期ユーザーを対象とする。ブログ記事にはCloud Computerを含め料金の記載がなく、基盤となるモデルの名前も外部評価も示されていない。
🔗 Manus 2.0の紹介 · XでのCue発表 · エージェントの電話番号
ElevenLabs、最も表現力の高い音声モデルEleven v4とエージェント向けTurbo版を発表
9月28日 — ElevenLabsは、同社で最も感情表現に優れた音声合成(TTS)モデルとするEleven v4と、会話型エージェント向けに遅延を抑えたEleven v4 Turboを発表した。Eleven v4は全面的に新しいアーキテクチャを採用し、文章の語調、リズム、感情、文脈を解釈して、声の個性を保ちながら、劇的、優しい、切迫した、あるいはコミカルな話し方を生み出すという。ElevenLabsは、Artificial AnalysisのProvider Voice Arenaランキングで首位(2026年9月)を獲得し、Cartesia Sonic 3.6、Inworld TTS-2、Googleの二つのGemini 3.8 TTSモデルとのブラインドテストで、引き分けを半分ずつ数えた場合、約75 %の聴取者に選ばれたとしている。
発話は自然言語や、テキストに挿入するタグ(笑い声、フランス語なまりで怒って話す台詞、小雨、振動する電話)で指示できる。ElevenLabsによれば、Eleven v4は従来モデルより忠実に指示に従う。国際音声記号(IPA)への対応も大きく向上し、複数の声による対話もより自然になった。声の特徴を捉える新しい方法により、エージェント、オーディオブック、広告で声の一貫性を保つという。
| ElevenLabsが公表した指標 | 発表値 |
|---|---|
| Artificial AnalysisのProvider Voice Arenaランキング(9月) | 1位 |
| 競合4モデルとのブラインドテストでの選好率 | 約75 % |
| Eleven v4 Turboの推論遅延の中央値 | 約100 ms |
| Eleven v4 Turboが最初に発話するまでの時間の中央値 | 約150 ms |
| 対応言語数 | 90超(Eleven v3:70超) |
| Eleven v4の1リクエスト当たりの上限 | 10 000文字(Eleven v3:5 000) |
| 即時音声クローンに必要な最短音声 | 10秒 |
最初の発話までの時間は、Cartesia、xAI、Google、OpenAIを比較対象に、WebSocketストリーミングでネットワーク遅延を除いて測定された。Eleven v4 TurboはElevenAgentsプラットフォームと合わせて最適化されている。ある言語で録音した声は、ほかの言語もその言語に自然なアクセントで話す。Eleven v4はプロ仕様の音声クローン(Professional Voice Clones)にも対応し、StudioやReaderアプリで役立つ長時間の音声生成の連結も、より安定した。
両モデルはElevenAgents、ElevenCreative、API(eleven_v4とeleven_v4_turbo)で利用できる。今後2週間、APIの料金は100万文字当たりEleven v4が22ドル、Eleven v4 Turboが11ドルに割り引かれる。また、ElevenCreativeのCreator以上のプランでは、月間クレジットの2倍を上限にEleven v4を無料で利用できる。通常価格は公表されていない。今回の発表は、2026年2月に商用提供が始まったEleven v3に続くものだ。
Kling、10月公開予定のKling 4.0を発表し、Kling 4.0 Flashの早期アクセスを開始
9月28日 — Kling AIは、新世代の動画モデルKling 4.0を発表した。正式公開は10月の予定だ。最初の派生版Kling 4.0 Flashは、9月28日から限られたユーザーに早期アクセスを提供している。発表ツイートによると、対象はUltraの年間契約者だ。Klingは、映像のリアリズム、創作上の制御、物語の完結性(narrative completeness)の三つを重点として挙げている。
発表された仕様では、Kling 4.0は最大4K、2チャンネルのステレオ音声付きで、3〜30秒の連続した動画を生成する。最大10枚のキーフレームと最大8 000トークンのプロンプトで物語を制御できる。「Omni Reference」は生成ごとに最大15件の参照を受け付ける。内訳は画像10枚、合計30秒以内の動画5本、被写体7件(うち3件は動画から)で、音声の参照は声に限られる。テクスチャのない模型や深度マップを動きや構図の調整に使うこともでき、最大5本のクリップについて表情、しぐさ、カメラ、スタイル、背景を編集できる。Klingは、映像内の読みやすい文字に加え、広東語、四川方言、インド英語など、対応する言語、アクセント、方言が増えたとしている。
| 技術仕様 | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| 提供状況 | 10月に正式公開 | 9月28日から限定的な早期アクセス |
| 生成モード | テキストから動画、画像から動画、最初と最後の画像、10枚のキーフレーム、Omni Reference | テキストから動画、画像から動画、Omni Reference |
| 1回の生成時間 | 3〜30秒 | 3〜20秒 |
| 最大解像度 | 4K(720pと1080pにも対応) | 720p |
| ダイナミックレンジ | 1080pと4Kの10ビットHDR、後日提供予定 | 8ビットSDR |
すべての機能がそろったわけではない。リリースノートでは、発表ツイートでKling 4.0の機能に含まれている1080pと4Kの10ビットHDR出力を、後日提供予定(coming soon)としている。動画を最大2分まで延長する機能も後日提供予定だ。Klingは制作ページも刷新し、すべての参照を一つの入力欄にまとめ、エージェントが依頼された作業を実行するキャンバスを追加する。料金、APIへのアクセス、ベンチマークはいずれも発表されていない。発表にはKling 4.0で制作した短編映画「THE BEAT」が添えられた。
コーディングエージェント:Claude Code 2.1.284、Codex CLI 0.158.0、Copilot CLI 1.0.89とそのSDK、Devin、Delta、Gemini CLI
Claude Code 2.1.284、すべてのプランとプロバイダーで自動モードを初期設定に
9月28日 — モデル発表の少し前、UTC 18時02分に公開されたClaude Code 2.1.284は、Claude Sonnet 5.5を追加した。これがAnthropic APIにおけるSonnetの標準モデルとなる。このバージョンには100件の変更があり、内訳は修正57件、改善18件、追加14件、変更11件だ。
最も目立つ変更は権限に関するものだ。モードが設定されていない場合、ターミナルとVS Codeの対話セッションは、すべてのプランとプロバイダーで自動モードで開始する。9月25日の2.1.283では、サードパーティーのプロバイダーとテレメトリーのないセッションにすでに適用されていた。2.1.284では対象が全体に広がり、permissions.defaultModeの設定が引き続き優先される。新しい応答「はい。ただし次回は再度確認する」(Yes, but ask again next time)を選ぶと、作業ディレクトリ外の読み取りを1回だけ許可し、その後は再び確認を求める。
Ultracodeは処理強度のスライダーから独立し、/effort内の個別の切り替え項目になった(Tabキー、または/effort ultracode onとoff)。選択した処理強度にかかわらず有効にでき、xhighを強制しなくなった。VS Codeにも処理強度のスライダーの下に同等のスイッチがある。
| 2.1.284の新機能 | コマンドまたは設定 |
|---|---|
| すべてのプランとプロバイダーで自動モードを初期設定に | permissions.defaultModeが優先される |
| Ultracodeを独立して切り替え可能に | /effortでTabキー、または/effort ultracode onとoff |
| 接続に失敗したMCPサーバーをまとめて再接続 | /mcp reconnect all |
| Claudeアプリ向けゲートウェイの支出額をドルで表示 | /usageとステータス行(フィールド:used_usd、limit_usd、period) |
| 「Prompt is too long」が続く場合に2回目の圧縮 | 自動 |
セキュリティ面では、管理側が管理対象のルールだけを許可する場合(allowManagedPermissionRulesOnly)、マーケットプレイス、claude.ai、npmから導入したプラグインは自分のツールを事前承認できなくなった。プロジェクト外からシンボリックリンクで参照する.claude/rulesのルールには承認が必要となり、メモリの読み込み時には、MEMORY.md内の不可視文字やClaude Codeのマークアップを模倣するタグが無効化される。信頼性の面では、応答ストリームが破損した場合、「JSON Parse error」を表示せず再試行する。また、再開したセッションのMCP呼び出しは、サーバーの応答を最大10秒待つ。さらに、Sonnetモデルのガードレールがメッセージを検知した場合、通知により詳しい説明を表示し、依頼を修正して再送する選択肢を示す。
Codex CLI 0.158.0:選択時のコピーとMCP向けOAuthクライアントシークレット
9月28日 — UTC 05時07分に公開されたCodex CLI 0.158.0は、9月26日の0.157.1以来、初の安定版だ。リリースノートには0.157.0以降のプルリクエスト188件が記載されている。全画面インターフェース(fullscreen TUI)では、選択時のコピー(copy-on-select)と右クリックでの貼り付けを設定できるようになった。会話記録からコピーした部分はMarkdownの書式を保つ。
| 対象の機能 | 設定または詳細 |
|---|---|
| 選択時のコピー | tui.copy_on_select:初期値はauto(tmux、Zellij、GhosttyとKittyを除くmacOSの直接接続ターミナル)、always、never |
| 右クリックでの貼り付け | tui.right_click_paste:auto(Windows、Linux、WSL)、on(macOSも対象)、off |
| OAuthを使用するMCPサーバー | codex mcp add --oauth-client-secret、キーoauth.client_secret |
| Exec-server | 直接のWebSocket接続に使うベアラートークン |
| 画像生成 | 透明背景の明示的な指定(transparent_background)、会話中の画像の編集 |
Codexは、シークレット付きの事前登録済みOAuthクライアントを要求するMCPサーバーに接続できるようになった。Exec-serverへの直接のWebSocket接続は、App-server経由の場合も含め、ベアラートークンで保護できる。セキュリティ面では、ターミナルに送る入力の承認機能が安定版となり、昇格した権限で実行するコマンドでは標準で有効になる。修正は主にサンドボックスに関するもので、Windows 10の通常のパス、保存済み認証情報の拒否、書き込み可能なルートが入れ子になっているLinux環境での起動、LinuxとmacOSでのGitメタデータの保護に対応する。
Copilot CLI 1.0.89が安定版に、Copilot SDK 1.0.15が型付き出力に対応
9月28日 — GitHubはCopilot CLI 1.0.89の安定版を公開した(UTC 19時20分)。9月27日に紹介されたプレビュー版1.0.89-5は、すでに.claude/rulesファイルに対応していたが、リリースノートの35項目には新たな変更も複数ある。Autoルーティングが推奨レベルを提示するようになり、ショートカットまたはクリックで変更できる。一方、サポートされていなかったFastプロファイルは廃止され、保存済みのFast設定はBalanceに切り替わる。プルリクエストの作成時には、必須セクションやチェックリストを含むリポジトリのテンプレートが使われる。ローカルセッションでは、空の入力欄でEscを2回押すと、まだ処理が始まっていないプロンプトを再開できる。また、直接インストールしたプラグインを有効化・無効化できる(copilot plugin enable)。サンドボックスでは、ラップされたghとgitのコマンド(timeout 60 gh …)が動作し、ローカルネットワークへのアクセスを有効にしたWindowsではlocalhostに接続できる。
続いてUTC 19時38分、Copilotのエージェント実行環境をアプリケーションに組み込むGitHub Copilot SDKが、5つのプレビュー版を経て1.0.15になった。主な新機能は、6つのSDK(TypeScript、Python、Go、Java、C#、Rust)における型付きの構造化出力だ。開発者がJSONスキーマまたは各言語に適した型を指定すると、モデルは自由形式のテキストに代えて、検証済みの型付き出力を返す。実験的な管理機能により、アプリケーションはMCPサーバーやskillのインストール前に人によるレビューを必須にでき、確認・拒否・キャンセルを明示的に選べる。Rustでは、この実行環境のインストールに伴うメモリ保持量が約99%減った。
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devinの利用コストが30~40%低下、Devin FusionがFrontierCode 1.1 Extendedで首位に
9月28日 — Cognitionは、Devinの利用コストを大幅に引き下げたと発表した。FusionモードとNormalモードでは30~40%、Ultraモードでは15~20%、コードレビュー用ツールのDevin Reviewでは最大70%安くなる。同社は、独自のSWE-2を含む最新モデルの導入と、Devinのクラウド実行基盤(cloud harness)の改善が寄与したとしている。具体的には、フォーマット・解析・テストなどの操作を1回のツール呼び出しにまとめ、独立した呼び出しを並列実行し、プロンプトキャッシュをより効果的に再利用する。この実行基盤について示された効果の規模は、測定値ではなく説明用の例に基づく。
Cognitionは、各モードの能力を維持または改善したとしている。Fusionは高性能な主モデルと、より低コストの補助モデル(sidekick)を組み合わせる。記事中のグラフでは、FrontierCode 1.1 Extendedで首位となっている。
| Cognitionによる評価構成 | FrontierCode 1.1 Extendedのスコア | タスクあたりの平均コスト |
|---|---|---|
| Devin Fusion | 68,8 | 0,60ドル |
| Opus 5.5 (high) | 65,2 | 0,90ドル |
| Fable 5.1 (medium) | 63,6 | 2,68ドル |
| GPT-6 Astra (high) | 63,1 | 2,62ドル |
| SWE-2 (high) | 60,1 | 0,64ドル |
| GPT-6 Sol (high) | 59,6 | 0,87ドル |
highの推論労力で示されたOpus 5.5(65,2)とGPT-6 Astra(63,1)の値は、同日に公開されたSonnet 5.5のグラフにある値(65,3と64,5)とは異なる。後者のグラフでは推論労力が明記されていない。コストを抑えたDevinは本日から利用できるが、新しい料金表は公開されていない。
Devinの9月25日付リリースノートとDevin Mobileのベータ版
9月25日 — これまで取り上げられていなかったDevinの9月25日付リリースノートによると、MarketplaceにBuildkite、Brex、Expo、Vanta、WorkOS、Wixなど57のホスト型MCP連携(hosted MCP)が追加された。グラフ、表、図などを含むインタラクティブなレポートが適した依頼では、形式を指定しなくてもDevinがHTMLレポートを作成する。子セッションは親セッションの要約を引き継いで開始し、その要約は入力欄に取り外し可能なチップとして表示される。マシンがスリープしたセッションは、プレビューURLを開くかSSHで接続すると再開する。自動化は共有Outpost上で実行でき、DevinはAzure DevOpsのプルリクエストで失敗したチェックについてAzure Pipelinesのログを読めるようになった。
9月28日には、CognitionがDevin Mobileのベータ版のウェイトリストも開設した。登録ページでは、Devinはクラウドまたはユーザーのマシンで動作し、専用ブラウザーでテストを行い、プルリクエストがマージ可能になるまで作業を続けると説明している。一般公開日も料金も発表されていない。
🔗 Devinのリリースノート · XでのDevin Mobile
ZedがDelta 0.18を予告、Gemini CLIは変更のないnightly版を公開
9月28日 — Zedは、エージェントと協力してコーディングするためのマルチプレイヤー環境Deltaについて、バージョン0.18では既存のGit worktree内でDeltaのスレッド(threads)を動かせるようになると予告した。公開日は示していない。9月23日公開の0.17では、並列タスクごとに専用の作業領域がすでに設けられていた。一方、Googleが9月28日に公開したGemini CLIのnightly版には変更がない。9月26日版と同じコミットに基づいており、安定版v0.61.0とプレビュー版v0.62.0-preview.0にも変更はない。
🔗 XでのZed · Gemini CLI v0.63.0-nightly.20260928
PerplexityのAgent APIでエージェントを再利用可能に:Profiles、バージョン管理されたSkills、共有コネクター
9月28日 — PerplexityはAgent APIに、チーム向けの再利用可能でバージョン管理された設定機能を追加した。中心となるProfileは、モデル、指示、ツール、Skills、コネクター、実行設定など、エージェントを定義するすべての要素を、バージョン付きの単一IDで保存する。プロジェクト管理者がエージェントを一度設定すれば、権限を持つ開発者が利用できる。各アプリケーションが用意するのは、それぞれ固有のデータだけになる。
カスタムSkillsは、指示、手順、補助ファイルをバージョン管理された形でまとめる。たとえばプラットフォームチームは、デプロイ時の確認項目、ロールバック(rollback)の基準、レポート形式を格納し、各アプリケーションを修正する代わりに新しいバージョンを公開できる。8月末に導入された管理対象コネクター(managed connectors)は、管理者がプロジェクト全体で共有するリソースになった。各アプリケーションは、認証情報やツール定義を個別に保存せずに参照できる。
| 追加されたリソース | Agent APIでの役割 | 発表された提供状況 |
|---|---|---|
| Profiles | モデル、指示、ツール、Skills、コネクター、実行設定をバージョン付きIDで管理 | 利用可能 |
| カスタムSkills | プロジェクトメンバーが呼び出す、バージョン管理された指示、手順、補助ファイル | 利用可能 |
| 管理対象コネクター | 管理者が共有する承認済みの連携(GitHub、Slack、Google Drive、Datadog、Linear、Notion) | プレビュー版 |
設定はすべてAPI Consoleから行い、メンバーは同じプロジェクトのAPIキーでこれらのリソースを呼び出す。記事では料金は発表されていない。同日付のAPI変更履歴では、Agent APIのxhighプリセットがGPT-5.6 Sol(openai/gpt-5.6-sol)からClaude Opus 5.5(anthropic/claude-opus-5-5)に変更された。プロンプト、推論労力、ツール、トークン予算、ステップ数の上限は変わらない。その3日前には、low、medium、highのプリセットがGPT-6に切り替わっていた。
🔗 Agent APIが再利用可能なエージェントに対応 · Perplexity APIの変更履歴
SpaceXAIがTeam Botsを公開、チーム全体で共有するGrok Bots
9月28日 — SpaceXAIは、チームの役割や業務の流れに合わせて構築し、全メンバーで共有するGrok Bots、Team Botsを公開した。メンバーはそれぞれBotと個別に作業することもできる。Bot自体は共有される一方、会話は非公開のままだ。コンテキストと記憶はユーザーごとに分離され、skillsはチームで共有される。各Team BotはSlack上で固有のIDを持ち、チーム全員が質問できるチャンネルに招待できる。
| Botの構成要素 | SpaceXAIが説明する役割 |
|---|---|
| コンテキスト | ファイル、指示、skills |
| Plugins | 各自またはチームで接続したSalesforce、Notion、GitHubでの作業 |
| 認証情報 | プラグインのない外部APIへのアクセス |
| 記憶 | Botが役割を果たすために保持する情報。ユーザーごとに分離 |
SpaceXAIは自社での使い方も紹介している。大口顧客ごとにTeam Botを設け、夜間に顧客関連のニュース、Gongの通話、Notionの文書、Slackのスレッドを分析し、朝にSlackへ報告を投稿する。Notion、Linear、Hex、Datadog、Cursorと連携したエンジニアリング用Botは、数百のCloud Agentsを指揮した。その結果、5人のチームが1日に100件以上のプルリクエストを届け、数週間でTeam Botsを公開したという。顧客企業では、保険会社Harperが、失効した保険契約の復旧を顧客に案内するTeam Botを24時間で構築したと述べている。同社CEOによると、顧客の節約額は12万ドルを超えた。
Team Botsは本日からTeamsプランとEnterpriseプランで公開ベータ版として利用できる。営業、製品管理、マーケティング、データ分析向けの設定済みTeam Botsも用意されている。SpaceXAIは料金も利用枠も発表していない。
🔗 Team Bots(SpaceXAI) · Xでの@botの発表
H CompanyがHolo4を公開、27Bと35B-A3Bのオープンウェイト型エージェントモデル
9月28日 — H Companyは、エージェントモデルの新シリーズHolo4を2つの規模で公開した。パラメーター数270億の高密度モデルと、混合エキスパート(Mixture of Experts)方式の35B-A3Bモデルだ。どちらもH Models APIから提供され、Hugging FaceではBF16、FP8、NVFP4、4ビットGGUF形式で公開されている。さらにHは、NVIDIAのNemotron 3 Nano Omniに自社の追加学習手法を適用したHolotron4 Nanoも加えた。同じモデルが、パソコン、ウェブ、Android、コードサンドボックス上で、グラフィカルインターフェース、コード、MCP、APIを介して操作する。Hは教師あり学習に続いて強化学習を実施した。強化学習には、簡単なドキュメントからAgentic Task Factoryが生成した約1万件の検証可能なタスクなどを用いている。
| 評価対象モデル | ベースモデルとライセンス | 公表スコア |
|---|---|---|
| Holo4 27B | Qwen3.8-27B、CC-BY-NC-4.0(非商用) | OSWorld 2.0で61,7%、OSWorldで85,2%(タスクあたり0,08ドル) |
| Holo4 35B-A3B | Qwen3.6-35B-A3B、Apache-2.0 | OSWorld 2.0で30,9% |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni、NVIDIA Open Model Agreement | ベースモデルからの改善はグラフのみで提示 |
| Claude Opus 5.5(Hが引用した比較対象) | 非公開モデル | OSWorld 2.0で81,8% |
Hは評価条件を明記している。Holo4は自社の実行基盤で測定し、OSWorld 2.0では1回だけ実行した結果を、異なる実行基盤や推論労力で得られた公開スコアと比較している。またAutomationBenchでは、公開タスク600件のうち480件が、学習データの収集に使われた分割に含まれる。Hは公開スコアの根拠となる全実行過程を公開し、段階ごとに閲覧したりHugging Faceからダウンロードしたりできるようにした。数日以内には、推論を高速化するDSparkのドラフトも公開する予定だ。
🔗 Hugging FaceのHolo4記事 · H Companyの発表
ロボティクス:Sakana AIのSAILは成功率を25%から73%に向上、ProjectSimはシミュレーションでの測定に疑問を提起
9月28日 — Sakana AIは、東京大学と共同で進め、IROS 2026に採択された研究SAIL(Scaling In-Context Imitation Learning)を紹介した。論文のarXiv識別子は2026年3月のもので、今回の新しい動きは研究の一般向け発表だ。研究の問いは、既存の視覚言語モデル(VLM)に推論時の計算量を追加することで、再学習なしに信頼できるロボットの動作を生成できるか、というものだ。
SAILは、文脈として与えた少数の成功例から動作軌道全体を生成し、シミュレーションで実行する。次に別のVLMが動画からタスクの進捗を推定し、その結果を使ってモンテカルロ木探索(MCTS)を進める。実機のロボットに送るのは選ばれた軌道だけだ。Gemini Robotics-ER 1.5が、重みを変更せずに両方の役割を担う。
| 評価した手法 | 探索ノード数 | シミュレーションした6タスクの平均成功率 |
|---|---|---|
| 1回だけ生成 | 1 | 25 % |
| 深さ優先探索 | 15 | 37 % |
| 幅優先探索 | 15 | 51 % |
| SAIL | 6 | 55 % |
| SAIL | 15 | 65 % |
| SAIL | 45 | 73 % |
これらの成功率は、各タスク20の設定について、定められた探索予算内に成功する軌道が見つかった割合を示す。評価にはALOHAシミュレーターを使い、成功はVLMではなくシミュレーターが検証した。LeRobot SO-101のアームでブロックをボウルに入れる実験では、候補軌道15本の予算で6回中5回成功した。見つかった軌道で学習させた模倣ポリシーも、より速く動作しながら6回中5回成功した。Sakanaは、開ループでの実行、探索に必要な追加計算、実機評価が1タスクかつ各手法6試行に限られることを制約として認めている。
🔗 Sakana AIの記事 · SAILのプロジェクトページ
ProjectSim、ロボット工学のベンチマークの現状を整理
9月28日 — シミュレーションでのスコアと実環境でのスコアの差こそ、ProjectSimの最初の実験のテーマだ。Luca Cilioは、独自の結果を示さない総説記事で、MetaWorldやLIBEROなどの操作ベンチマークから、RoboChallengeのような共同の実機テストまでを概観している。また、RoboCasa365の数値を引き、30,000件のデモでファインチューニングしたGR00T N1.5は、個別のスキルでは43%の成功率を達成する一方、ファインチューニングに含まれなかった組み合わせでは4.4%に落ちると指摘する。ProjectSimの実験は、形状、外観、物理特性を再構築した忠実度の高いシミュレーション環境によって、シミュレーションのスコアが実機で測定したスコアに近づくかを調べるものだ。結果はまだ公表されていない。
Mistral、産業向けAIと物理学向けAIの拠点をミュンヘンに開設
9月28日 — Mistralがミュンヘンに拠点を開設する。物理学向けAI(Physics AI)と産業向けAI(Industrial AI)の研究チームに加え、提携企業のために直接働く応用エンジニアが入る。Mistralはここで、自社をソフトウェア提供会社ではなく、長期的な技術パートナーと位置づけている。
| Mistralが挙げたパートナー | 発表された取り組み |
|---|---|
| BMW | 衝突シミュレーションとエンジニアリング向けAI |
| Siemens Energy | 産業向けAIの応用 |
| ミュンヘン工科大学(TUM) | 自動車の空気力学に向けた風洞のデジタルツイン |
この拠点は、Mistralが2026年5月にEmmi AIを買収した流れを引き継ぐものだ。この買収により、数値流体力学(CFD)、構造力学、マルチフィジックスシミュレーションを専門とする物理学者、研究者、エンジニア30人以上がMistralに加わった。MistralはTUMおよびNikolaus A. Adams教授とともに、風洞センサーのリアルタイム測定値と、オフラインで計算したCFDシミュレーションを融合し、自動車の空気力学に関するデジタルツインを開発する。狙いは、空気力学に関する高精度な予測をリアルタイムで得ることだ。
記事は、顧客がモデルの重みを利用でき、自社のインフラ上で欧州法の下にモデルを実行でき、データを組織外に出さずに済むという主権に関する主張を繰り返している。また、Mistralが2030年までに欧州で1ギガワットの計算能力を構築するとしている。ドイツ連邦デジタル変革相のKarsten Wildbergerと、バイエルン州首相府長官のFlorian Herrmannの発言も引用している。Mistralはミュンヘン地域で採用を進めているが、採用人数や投資額は示していない。
🔗 Hallo, Deutschland!(Mistral AI)
NVIDIAとNscaleがDSX MaxLPSを測定:同じ電力予算でGPUが37%、スループットが49%増加
9月27日 — NVIDIAはNscaleと共同で実施した、DSX MaxLPSの数値評価を公開した。DSX MaxLPSは、運用者の方針に従ってAIファクトリー内のリソースに電力を配分するソフトウェアだ。NVIDIAによれば、承認済みの同じ電力予算で最大40%多くのGPUを導入できる。記事は、これは拠点への給電量を増やすことではなく、電力配分を協調して行うことだと強調する。
テストは、アイスランドのケプラヴィークにあるVerneキャンパス内のNscaleデータセンターで、GB300 NVL72を使って実施された。この施設は全電力を再生可能エネルギーで賄っている。使用したのは、FP4のKimi K2.5、NVIDIA Dynamo、TensorRT LLMだ。割り当て済みの電力予算264.4 kWはそのままで、既存インスタンスのスループットを落とさずにGPU数を140基から192基へ増やした。
| 測定指標 | 固定配分の基準値 | DSX MaxLPS使用時 | 測定された差 |
|---|---|---|---|
| 管理対象GPU | 140 | 192 | +37,1 % |
| 正規化された合計スループット | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| 測定された総消費電力 | 166,2 kW | 198,9 kW | +19,7 % |
| 電力予算の使用率 | 62,9 % | 75,2 % | +12,3ポイント |
| 割り当て電力1ワット当たりのスループット | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
記事は代償も明示している。レイテンシーの中央値とP75は基準値から5%以内に収まる一方、最初のtokenが出るまでの時間のP99は、基準値の15.7秒から17%増えた。NVIDIAは運用者に対し、電力の適用範囲の定義から本番環境の上限設定まで、5段階で検証することを勧めている。この評価は、9月15日に発表されたLambdaによるHGX B200での検証(16ノード分の予算で19ノード)に続くものだ。入口で45 °Cの液冷を用いるVera Rubinについての予測は、別途示されている。
短報
- DeepSeek Harness 0.2.0-rc.1 — 0.2.0系列で最初のリリース候補であり、DeepSeekのエージェント用ハーネスとして23番目のプレリリース。安定版はまだない。DeepSeekアカウントのモデルとの会話では追加のAPIキーなしでウェブ検索ができ、自動化タスクは任意のプラグインパッケージに移された。🔗 出典
- Vercel AI GatewayのPixel Canary — Vercelは9月25日から、名称を明かしていない開発元によるこのコード生成モデルを、ステルス期間中に無料で提供している。Next.jsの31タスク中28件をpass@4で達成し、GPT-6 Astra(high)と同率だった。AGENTS.md経由でドキュメントを与えると31件中30件を達成した。データのゼロ保持には対応していない。🔗 出典
- GitHub Actionsのセルフホストランナー — GitHub Enterprise Cloudでは、最小バージョン要件の全面適用が9月29日に始まる。バージョン2.329.0未満のランナーは登録できなくなり、実行に必要な最小バージョンを下回るランナーはジョブを受け付けなくなる。新しいREST APIではサポート終了日を確認できる。GitHub Enterprise Serverは対象外だ。🔗 出典
- NexteraBERT — Rikka Botanが、2億1,260万パラメータの双方向エンコーダーを公開した。事前学習に使ったのは1,300億tokensで、ModernBERTの約15分の1だ。本人の測定によれば、GLUEでは87.90でModernBERT-baseの87.97に近く、MTEB v2では54.70で同モデルの53.63を上回り、65,536 tokensでのスループットは5.22倍だった。コードはMITライセンスで公開されている。🔗 出典
- リアルタイムのLTX-2.5 — コミュニティの記事によると、220億パラメータのこの音声・動画モデルは、クリップ当たり90秒かかっていた生成を再生速度より速くした。96 GBのカードで5秒のクリップを1.83秒で生成できるという。8ステップを4ステップに減らし、NVFP4での計算とCUDA Graphを利用した。コードはApache-2.0ライセンスで公開されている。🔗 出典
- SCRIBE — インドの裁判所向けに音声認識を開発するAdalat AIが、このオープンソース評価ツールをPyPIで公開した。Interspeech 2026に論文がある。単語誤り率では、校正者なら誰も直さないマラヤーラム語の文にも100%の誤り率が付く場合があるのに対し、SCRIBEは単語、数字、句読点、専門用語を別々に採点する。🔗 出典
- 228件のJEVプロジェクト — Awesome JEVのリストを管理するEric Kangは、GitHubで「jev」を検索して返された13,473件のリポジトリから、オープンソースの228プロジェクトを選んだ。10種類に分け、最低50スターを条件とし、それぞれ特定のコミットで固定している。検索結果の総数には無関係なプロジェクトも含まれるため、これは手作業の選定であり、独立した全数調査ではない。🔗 出典
- HeyGenとJev — HeyGenはXで、TypeSafe AIの意思決定モデルJevを同社のMCPサーバーの前段に置くガイドを公開した。Jevが約40件の見込み客を動画の要否、切り口、言語、適合性で分類し、Claudeが台本を書き、最後にHeyGenのMCPが一括生成する。クレジットを消費し、承認を待つのは最後の段階だけだ。🔗 出典
- Gemini 3.8 Flashで作った4作品 — Googleのブログは、9月2日に公開されたモデルを使った4つの制作例を紹介した。Antigravityで構築した衛星のライブ追跡、アニメーション化した青海波、ティラノサウルスの3D骨格、10視点のカメラを備えた自動変速機だ。数値や新しい製品機能の発表はない。🔗 出典
- ブルックリンのケータリング事業者とGemini — Googleのブログは、グリーンポイントの食料品店Edy’s Grocerのオーナー、Edy MassihがGeminiを使い、レシピを200人分に調整し、買い物リストを作り、食事制限に合わせてメニューを変える様子を紹介した。新機能の発表はない。🔗 出典
- Lenfest Institute — OpenAIは、Lenfest InstituteのAIフェローシッププログラムの次の段階に500万ドルを拠出し、さらにソフトウェアクレジットとエンジニアリング支援を最大500万ドル相当提供する。2024年に米国の11の報道機関で始まったプログラムで、支援規模は前回の2倍となる。🔗 出典
- ChatGPTの「Health」タブ — Healthタブでグラフ、指標、記録を選ぶと、プロンプトを書かなくても、場合によってはインタラクティブなグラフを伴う個別の説明が表示されるようになった。Healthの提供対象は引き続き米国の18歳以上で、Free、Go、Plus、Proの各プランのウェブ版とiOS版に限られる。🔗 出典
- WebMCP Challengeの受賞作品 — OpenAI Developersは、8月末に始まったハッカソンの受賞10作品(MASIL、Alza、ArchMorph、Aisle、Roque Nights、Mandate、Observatory、Bouquet Studio、Faraday、JupyterLite WebMCP)を紹介した。順位や作品ごとの賞金額は示していない。🔗 出典
- macOSのセキュリティ修正 — 9月25日、macOS向けデスクトップアプリのバージョン26.924.20706で、Patrick Wardle(Objective-See Foundation)が報告した脆弱性CVE-2026-100754が修正された。ChatGPTとCodexの変更履歴ではCodexアプリの項目に記載されているが、脆弱性の詳細は説明されていない。🔗 出典
これが意味すること
tokenの単価は変わらず、使うtokenの数が減っている。Sonnet 5.5の料金はSonnet 5と同じだが、Anthropicによれば、消費tokenが少ないためタスク当たりの費用は最大30%下がる。Devinは、SWE-2を含む最新モデルの導入とツール呼び出しの一括処理によって、30~40%安くなる。Manusは、新しいハーネスを使ったテスト構成で実行コストが32%減ったと発表した。費用を左右するのは表示上の単価よりも、モデルとハーネスが消費する処理量になっている。そして中位モデルは上位モデルに迫る。Terminal-Bench 4.0では、Sonnet 5.5がXhighの推論量で測定したOpus 5.5のスコアを上回った。
エージェントは標準でより自律的になり、安全策はエージェントの手が届かない場所へ移っている。Claude Codeは現在、全プランで自動モードで起動する。一方、NVIDIAはエージェントがアクセスできないDPUに監視機能を設置し、エージェントが提案するアクセスルールには標準で人間の承認を求める。ツールも同じ方向に進む。Codex CLIは高い権限を要するコマンドのターミナル入力を承認対象とし、Copilot SDKではMCPサーバーやskillをインストールする前に人間による確認を必須にできる。エージェントが単独で行動するほど、制御はエージェントの外に置く必要がある。
エージェントは固有の身元を持つチームメンバーにもなっている。PerplexityのProfilesでは、エージェントをプロジェクト全体で再利用できる、バージョン管理された設定として扱う。SpaceXAIのTeam Botsにはそれぞれ固有のSlack IDがあり、ユーザーごとに別々の記憶を保持する。Cueのエージェントには、メールアドレス、電話番号、ウォレットが与えられる。誰かに代わって支払い、電話、書き込みができるエージェントは、NVIDIAが同じ日に提起した制御の問題を具体的なものにする。
最後に、この日の数字は慎重に読む必要がある。DevinはSonnet 5.5をFrontierCodeの派生版で測定したが、ツイートとグラフではその名称が一致していない。同じ日に公開されたCognitionの2つのグラフでも、Opus 5.5のスコアが異なる。Holo4の測定はHのハーネスを使い、OSWorld 2.0で1回だけ実行した結果だ。SAILの73%はシミュレーションで得られた数値であり、シミュレーションと実環境の差こそProjectSimの最初の実験が扱う問題だ。メディア分野では、Eleven v4は外部ランキングとブラインドテストを根拠にしている一方、Kling 4.0はベンチマークも料金も示さずに登場し、一部の機能は後日の提供とされている。
出典
- Claude Sonnet 5.5の紹介(Anthropic)
- Claude Sonnet 5.5への移行ガイド
- @ClaudeDevs:Sonnet 5.5の推論量に関する推奨設定
- GitHub CopilotのClaude Sonnet 5.5
- GitHub Copilotのモデルと料金
- DevinのClaude Sonnet 5.5
- @cognition:FrontierCode 1.1 MainでのSonnet 5.5
- @cursor_ai:CursorのSonnet 5.5
- @v0:v0のSonnet 5.5
- NVIDIAがOpen Agent Safety Platformを発表(プレスリリース)
- Open Agent Safety Platformのアーキテクチャ(NVIDIA)
- NVIDIA OpenShellでAIエージェントに実行時制御を追加
- @NVIDIAAI:CNBCでのJensen Huang
- @togethercompute:ローンチパートナー
- @perplexity_ai:NVIDIAとの提携
- Manus 2.0の紹介
- @ManusAI:Cueの発表
- @ManusAI:エージェントの電話番号
- Eleven v4の紹介(ElevenLabs)
- @ElevenLabs:Eleven v4発表の投稿スレッド
- Kling 4.0のリリースノート
- @Kling_ai:Kling 4.0の発表
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- Devinの費用対効果が最大40%向上
- 9月25日のDevinリリースノート
- @cognition:Devin Mobileのベータ版
- @zeddotdev:Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- Agent APIが再利用可能なエージェントに対応(Perplexity)
- Perplexity APIの変更履歴
- Team Bots(SpaceXAI)
- @bot:Team Botsの発表
- Hugging FaceブログのHolo4
- Holo4(H Company)
- SAIL(Sakana AI)
- SAILのプロジェクトページ
- ロボット工学のベンチマーク:現状と今後(ProjectSim)
- Hallo, Deutschland!(Mistral AI)
- NVIDIA DSX MaxLPSがAIファクトリーのスループットと効率を最大化する方法
- DeepSeek Harness 0.2.0-rc.1
- Vercel AI GatewayのPixel Canary
- セルフホストランナーのバージョン要件適用日が変更(GitHub)
- NexteraBERTの技術レポート
- 220億パラメータの動画拡散モデルによるリアルタイムの会話キャラクター
- SCRIBE(Adalat AI)
- JEV:選定された228プロジェクト(Eric Kang)
- @HeyGen:JevとHeyGen MCPのガイド
- Gemini 3.8 Flashで4人の開発者が制作したもの(Google)
- この食料品店がGeminiを使って200人分を調理する3つの方法(Google)
- Lenfest AI Collaborative:新たな段階(OpenAI)
- ChatGPTのリリースノート
- @OpenAIDevs:WebMCP Challengeの受賞作品
- ChatGPTとCodexの変更履歴:CVE-2026-100754