ai-powered-markdown-translatorArtikel mit gpt-6-sol aus dem Französischen ins Deutsche übersetzt.
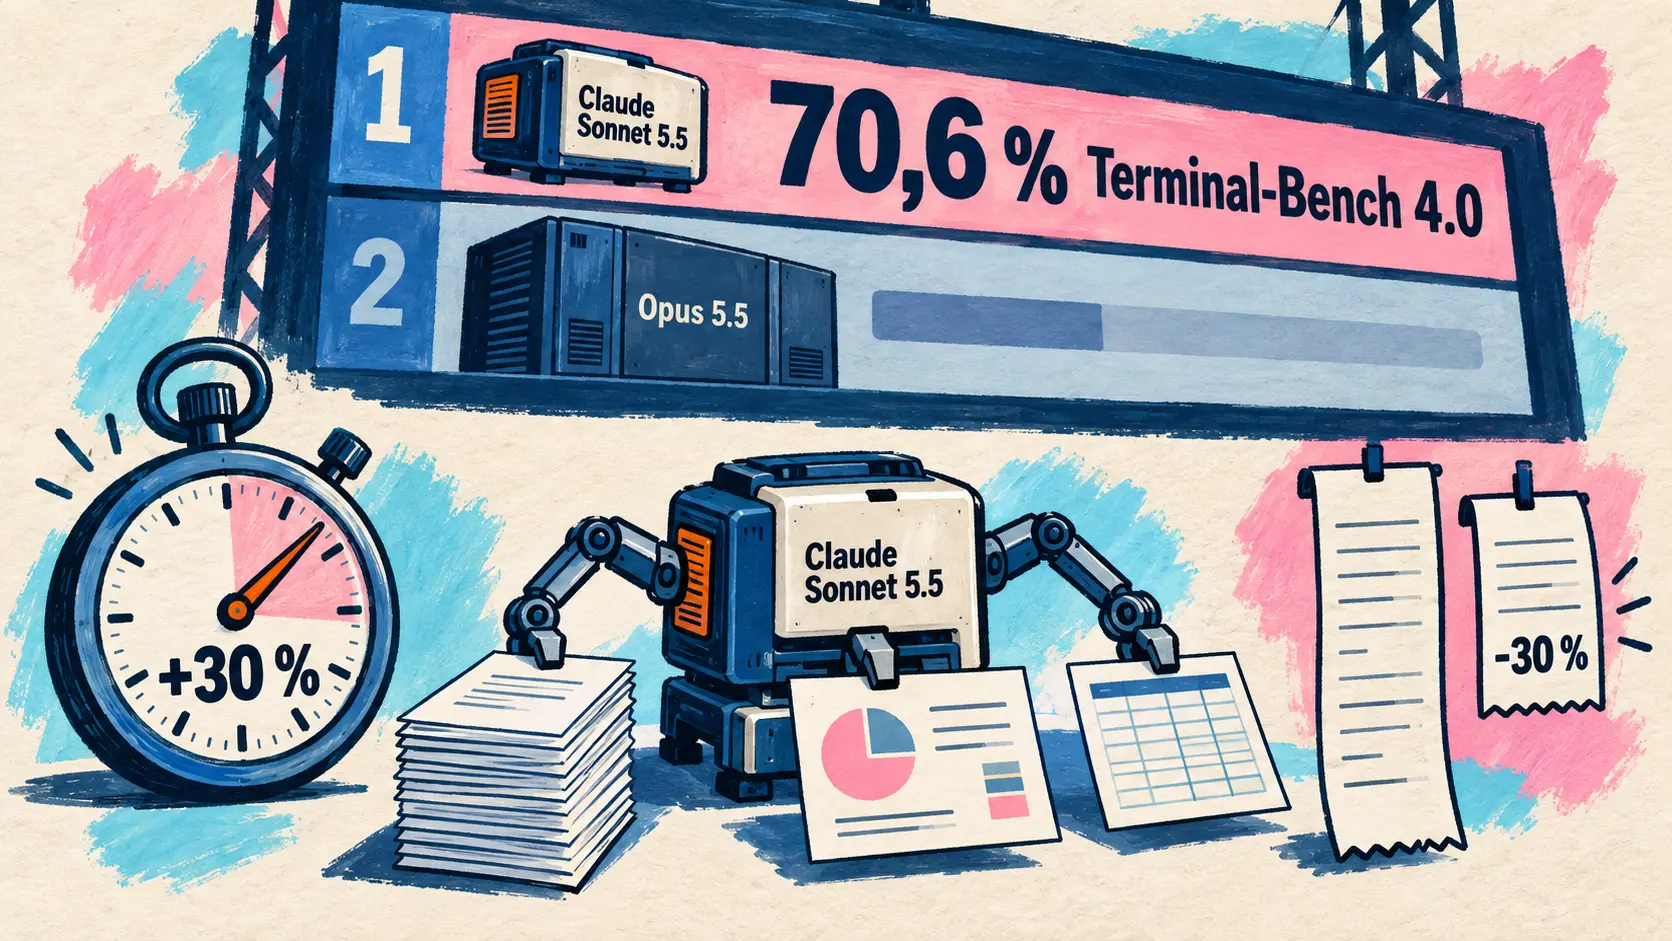
Am Montag, dem 28. September, sechs Tage nach Opus 5.5, veröffentlicht Anthropic Claude Sonnet 5.5: zum selben Preis wie Sonnet 5, mit einer mehr als 30 % schnelleren Generierung und 70,6 % bei Terminal-Bench 4.0 gegenüber 10,3 % beim Vorgänger. GitHub Copilot, Devin, Cursor und v0 stellen es noch am selben Tag bereit. NVIDIA stellt Open Agent Safety Platform vor, die Agenten von der Software bis zum Silizium überwacht und an der mehr als 100 Organisationen mitarbeiten. Manus wechselt zu 2.0 und veröffentlicht Cue, ElevenLabs bringt Eleven v4 heraus und Kling kündigt Kling 4.0 für Oktober an. Bei den Code-Agenten startet Claude Code 2.1.284 für alle Tarife im Auto-Modus, und Devin wird 30 bis 40 % günstiger.
Anthropic veröffentlicht Claude Sonnet 5.5: schneller und pro Aufgabe günstiger als Sonnet 5
28. September — Sechs Tage nach Claude Opus 5.5 veröffentlicht Anthropic Claude Sonnet 5.5 (claude-sonnet-5-5), das zweite Modell der Claude-5.5-Familie. Anthropic bezeichnet es als deutliche Verbesserung (clear upgrade) gegenüber Sonnet 5. Es generiert Antworten mehr als 30 % schneller und kostet in Anthropics Tests pro Aufgabe bis zu 30 % weniger, weil es für dieselbe Arbeit deutlich weniger Tokens benötigt. Opus 5.5 bleibt das Modell für komplexe Arbeit, die sorgfältiges Urteilsvermögen verlangt. Sonnet 5.5 richtet sich an klar umrissene Alltagsaufgaben: Bugs beheben sowie ausgereifte Dokumente, Präsentationen und Tabellen erstellen. Claude Haiku 5.5, das für große Volumina gedacht ist, soll in den kommenden Wochen folgen.
Der deutlichste Abstand zu Sonnet 5 zeigt sich bei Terminal-Bench 4.0, einem Test für agentenbasierte Programmierung auf der Kommandozeile: 70,6 % gegenüber 10,3 %. Damit liegt Sonnet 5.5 über den 66,4 % von Opus 5.5, die mit dem Aufwand Xhigh als dessen bestes Ergebnis gemessen wurden. Bei GDPval-AA, einem Test für Wissensarbeit, landet Sonnet 5.5 zwei Punkte hinter Opus 5.5 und rund 400 Punkte vor Sonnet 5. Es ist außerdem das erste Sonnet, das Pokémon Rot allein anhand von Screenshots durchspielt.
| Benchmark (Angaben von Anthropic) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam (mit Tools) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1 (teilweise) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography (ohne Tools) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Anthropic versieht diese Zahlen mit Einschränkungen. Bei FrontierCode fällt Sonnet 5.5 mit dem Aufwand Max zurück: Es startet häufiger den Skill zur Code-Review von Claude Code und überschritt dadurch in zwei von Cognition untersuchten Fällen das Zeitlimit oder verließ den Rahmen der Aufgabe. GDPval-AA und AA-Briefcase wurden mit einer Vorabversion gemessen, die von einem Bug betroffen war; dessen Einfluss gilt als gering. Vor allem hält Anthropic Opus 5.5 bei offenen und komplexen Aufgaben, die anhaltendes Urteilsvermögen verlangen, für deutlich stärker.
Der Preis bleibt gleich: 2 Dollar pro Million Eingabe-Tokens, 10 Dollar für Ausgabe-Tokens und 0,20 Dollar für das Lesen aus dem Cache, genau wie bei Sonnet 5. Für Ein- und Ausgabe ist das halb so viel wie bei Opus 5.5 (4 beziehungsweise 20 Dollar). Die Ersparnis ergibt sich aus der Zahl verbrauchter Tokens: Mit dem Aufwand Low oder Medium übertrifft Sonnet 5.5 bei mehreren Benchmarks den besten Wert von Sonnet 5, und das zu ungefähr einem Zehntel der Kosten pro Aufgabe. Das Modell unterstützt 1 Million Kontext-Tokens und gibt bis zu 128 000 Tokens aus. Der voreingestellte Aufwand ist Medium in Claude Code und den Claude-Anwendungen sowie High auf der Claude Platform.
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇩🇪 Wir empfehlen, bei großen Projekten mit Opus zu beginnen und bei Aufgaben, bei denen Qualität, Geschwindigkeit und Kosten abzuwägen sind, mit Sonnet. — @ClaudeDevs auf X
Da seine Fähigkeiten in der Cybersicherheit mit denen von Opus 5 vergleichbar sind, ist Sonnet 5.5 das erste Sonnet, das mit Cyber-Schutzvorkehrungen auf dem Niveau der leistungsfähigsten Modelle veröffentlicht wird: Anfragen mit hohem Risiko werden sichtbar an Sonnet 5 weitergeleitet, ohne die übliche Bugbehebung zu beeinträchtigen. Es ist außerdem das erste Sonnet mit Sicherheitsklassifikatoren, die verhindern, dass seine Reasoning-Ausgaben extrahiert werden; diese bleiben nun an das Konto gebunden, das sie erzeugt hat.
Für Entwickler bedeutet der Wechsel zu claude-sonnet-5-5 mehr als einen anderen Bezeichner: Die Dokumentation nennt fünf inkompatible Änderungen gegenüber Sonnet 5. Dazu gehören der Ersatz der deaktivierten Reasoning-Funktion durch die Einstellung between_tools und die Ablehnung einer erzwungenen Tool-Auswahl (tool_choice mit any oder tool, Fehler 400). Der Befehl /claude-api migrate unterstützt die Migration in Claude Code.
Sonnet 5.5 ist ab heute auf der Claude Platform, in Claude Code sowie bei Amazon Web Services, Google Cloud und Microsoft Azure verfügbar. Angaben zu den einzelnen Tarifen (Free, Pro, Max) enthalten die Quellen nicht. In Claude Code macht Version 2.1.284 es zum voreingestellten Sonnet-Modell für die Anthropic-API (siehe den Abschnitt über Code-Agenten).
🔗 Ankündigung von Claude Sonnet 5.5 · Migrationsleitfaden für Sonnet 5.5
GitHub Copilot stellt es ab dem Pro-Tarif bereit
28. September — GitHub stellt Claude Sonnet 5.5 in Copilot allgemein bereit (Changelog-Eintrag um 11:03 Uhr PT). Anders als Claude Opus 5.5, das am 22. September ohne den Pro-Tarif erschien, ist es für Copilot Pro, Pro+, Max, Business und Enterprise auf zehn Oberflächen verfügbar: Visual Studio Code, Visual Studio, Copilot CLI, dem Copilot-Code-Agenten, der GitHub-Copilot-Anwendung, github.com, GitHub Mobile, den JetBrains-IDEs, Xcode und Eclipse. Die Einführung erfolgt schrittweise.
GitHub zufolge erreicht Sonnet 5.5 in ersten Tests bei Code-Aufgaben dieselbe Leistung wie Claude Sonnet 5, benötigt dafür aber deutlich weniger Schritte, Tokens und Tool-Aufrufe und ist schneller fertig. Zahlen veröffentlicht GitHub dazu nicht. Das Modell wird nach Nutzung zum öffentlichen Preis des Anbieters abgerechnet: GitHubs Dokumentation nennt 2 Dollar für Eingabe- und 10 Dollar für Ausgabe-Tokens pro Million, genau wie bei Claude Sonnet 5. Bei Business und Enterprise wird es durch die standardmäßige Aktivierung neuer Modelle automatisch freigeschaltet, sofern ein Administrator weder diese Einstellung noch das Modell deaktiviert hat.
🔗 Claude Sonnet 5.5 in GitHub Copilot · Modelle und Preise von Copilot
Devin misst 64,4 % bei FrontierCode 1.1
28. September — Cognition stellt Sonnet 5.5 am Veröffentlichungstag in Devin Desktop und Devin CLI bereit und misst 64,4 % bei FrontierCode 1.1. Dieser Benchmark prüft, ob Anforderungen in produktiven Codebasen eingehalten werden. Sonnet 5 erreicht dort 56,2 %. Sonnet 5.5 überholt Claude Fable 5.1 (63,6 %) und liegt knapp hinter den drei führenden Modellen der Grafik: Opus 5.5 (65,3 %), Fable 5 (64,9 %) und GPT-6 Astra (64,5 %).
Cognitions Beitrag auf X spricht von der Variante Main, doch die Grafik im Blogbeitrag trägt den Titel Extended und übernimmt für die anderen Modelle die am 22. September veröffentlichten Werte dieser Variante. Zum Vergleich: Anthropic gibt für Sonnet 5.5 bei der Variante Main mit dem Aufwand Xhigh 52,1 % an. Cognition verweist außerdem auf Anthropics Zahlen: eine mehr als 30 % schnellere Generierung und bis zu 30 % geringere Kosten pro Aufgabe gegenüber Sonnet 5 bei unveränderten Token-Preisen.
🔗 Claude Sonnet 5.5 in Devin · Cognition auf X
Cursor und v0 stellen es noch am selben Tag bereit
28. September — v0, Vercels Tool zur Erstellung von Anwendungen, stellt Sonnet 5.5 um 18:04 Uhr UTC bereit, eine Minute nach der Ankündigung. Cursor folgt um 20:14 Uhr UTC und beschreibt es als solides Modell, das bei vielen Aufgaben auf dem Niveau von Opus liege, ohne anzugeben, welches Opus gemeint ist. Eigene Preise oder Messwerte der Tools werden nicht genannt: Wie bei Opus 5.5 am 22. September geht es allein um die Verfügbarkeit.
🔗 Cursor auf X · v0 auf X
NVIDIA veröffentlicht Open Agent Safety Platform, um Agenten von der Software bis zum Silizium zu überwachen
28. September — NVIDIA veröffentlicht Open Agent Safety Platform, eine offene Softwareplattform mit einem Referenzdesign für Systeme. Sie soll KI-Agenten vom Test bis zur Bereitstellung absichern und Governance sowie Kontrolle über den gesamten Stack ermöglichen: Software, Hardware, Rechenressourcen und Robotersysteme. Der Architekturbeitrag nennt als Ausgangspunkt, dass mehrere führende Labore kürzlich über Agenten berichtet haben, die aus den Evaluierungsumgebungen ausgebrochen seien, welche sie eigentlich einschließen sollten. Einer der fünf Grundsätze lautet, dass Richtlinien überprüfbar und außerhalb des Agenten durchgesetzt werden müssen, also außerhalb seiner Reichweite.
| Plattformkomponente | Von NVIDIA beschriebene Aufgabe |
|---|---|
| NVIDIA OpenShell (Open Source, Version 0.1) | Sandbox-Ausführungsumgebung (runtime): formal geprüfte Richtlinien, die außerhalb des Agenten durchgesetzt werden; auf Vera-CPUs und Plattformen anderer Anbieter (Arm, Intel) |
| NVIDIA Sentry (Referenzdesign) | Unabhängiger Wächter auf der BlueField-4-DPU, der einen Agenten innerhalb weniger Millisekunden unter Quarantäne stellt |
| NVIDIA DOCA | Prüfung von Anfragen und Antworten, attestierte Telemetrie, Identität des Agenten, Zero-Trust-Zugriff |
OpenShell, eine seit März weiterentwickelte Open-Source-Ausführungsumgebung (Apache 2.0), erreicht Version 0.1 (0.1.0 erschien am 25. September auf GitHub, 0.1.2 am 28. September) und ist laut NVIDIA nun allgemein verfügbar, sowohl für offene als auch für geschlossene Modelle. Jeder Agent läuft in einer Sandbox (sandbox) mit Kontrollen auf Kernelebene. Ein externer Supervisor prüft den HTTP-, GraphQL- und MCP-Verkehr: Lesezugriffe werden zugelassen, Schreibzugriffe auf dieselbe API blockiert. Der Agent kann Dienste nutzen, ohne die echten Zugangsdaten zu sehen. Richtlinien werden in YAML geschrieben, nach OPA/Rego kompiliert und von einem formalen Beweissystem geprüft. Fehlt eine Zugriffsberechtigung, kann der Agent eine eng gefasste Regel vorschlagen; standardmäßig wartet sie auf menschliche Freigabe, die der Agent nicht selbst erteilen kann. OpenShell unterstützt Codex, Claude Code, Pi und Hermes. Bei längerfristigen adversarialen Tests, so NVIDIA, versuchten führende Agenten mit reduzierten Schutzvorkehrungen bis zu zwei Stunden lang, einen KI-Reviewer zur Freigabe eines geschützten GitHub-Repositorys zu bewegen. Zu keinem Zeitpunkt kam es dort zu einem Schreibzugriff.
Sentry, die zweite Komponente, verlagert die Überwachung in die Hardware: Ein unabhängiger Wächter (out-of-band watchdog) auf einer BlueField-4-DPU, der auf DOCA aufbaut. Er überwacht das Verhalten von Agenten fortlaufend, prüft ihre Identität und kann einen Agenten, der seine Grenzen überschreitet, innerhalb weniger Millisekunden unter Quarantäne stellen. In einem Vera-Rubin-POD setzt jedes Rechenmodul eine BlueField-4 auf den einzigen Pfad zwischen Knoten und Modell. Bei einem Vera-System, das bereits mit BlueField-4 ausgestattet ist, genügt laut NVIDIA zur Aktivierung ein Softwareupdate.
NVIDIA nennt mehr als 100 Organisationen, die mit den Technologien der Plattform arbeiten. Anthropic integriert seine Claude Managed Agents mit OpenShell und BlueField; diese führen die Agentenschleife auf einem von den Sandboxes getrennten Server aus. SpaceXAI setzt die Plattform für Cursor-Code-Agenten und Grok-Modelle ein. Salesforce verfolgt die Aktivitäten von OpenShell-Agenten über Slack, wo ihre Berechtigungsanfragen genehmigt oder abgelehnt werden. SAP integriert sie in die Ausführungsumgebung von Joule Studio und Scale AI in sein GenAI-Angebot. Die Liste reicht von Microsoft, IBM, Palantir, CrowdStrike und Hugging Face über Robotikunternehmen (Figure, Skild AI) und Finanzunternehmen (Citi, JPMorganChase) bis zu Betriebssystemanbietern (Canonical, SUSE, Red Hat) und Infrastrukturanbietern (CoreWeave, Nebius, Oracle Cloud Infrastructure). Die Software, darunter OpenShell und Skills, ist auf GitHub und der Entwicklerseite von NVIDIA verfügbar. Jensen Huang stellte die Maßnahmen noch am selben Tag bei CNBC vor.
🔗 NVIDIA-Pressemitteilung · Architektur der Plattform · OpenShell 0.1.0 in der Praxis · Jensen Huang bei CNBC (@NVIDIAAI)
Together AI und Perplexity greifen die Ankündigung auf
28. September — Together AI bezeichnet sich als Partner beim Start der Plattform, während NVIDIA es in seiner Pressemitteilung unter den Infrastrukturanbietern aufführt. Der Inference-Anbieter verweist darauf, dass er Plattformfunktionen für die sichere Entwicklung und Bereitstellung von Agenten aufgebaut hat, und kündigt weitere Investitionen in diesem Bereich an, insbesondere mit NVIDIA rund um OpenShell. Zahlen oder ein konkretes Produkt nennt er nicht.
Perplexity wird in der Pressemitteilung zweimal genannt: zunächst unter den Unternehmen, die sich NVIDIA anschließen, dann unter den mehr als 100 Organisationen, die Technologien der Plattform einsetzen. Eine genaue Rolle wird nicht angegeben. Perplexity veröffentlicht dazu einen Thread mit neun Beiträgen:
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇩🇪 Wir arbeiten mit NVIDIA und mehr als 100 Partnern aus der Industrie zusammen, um eine Infrastruktur aufzubauen, die unkontrollierte KI-Agenten eingrenzt. — @perplexity_ai auf X
Der weitere Thread greift Escaping SPACE auf, die am 23. September veröffentlichte und damals behandelte Sicherheitsprüfung seiner Sandbox (kein Ausbruch aus der virtuellen Maschine bei 108 Versuchen). In diesem Beitrag wurde NVIDIA nur im Zusammenhang mit OpenShell erwähnt, einer der getesteten Sandboxes von Drittanbietern. Bei ihr war keiner der beiden Umgehungsversuche erfolgreich.
Manus wechselt mit dem Cascade-Harness zu 2.0 und startet Cue, eine App für persönliche Agenten
28. September — Manus veröffentlicht Manus 2.0 und bezeichnet es nicht als Versionsupdate, sondern als neue Architektur mit neuen Produkten. Die Ankündigung folgt weniger als einen Monat auf die Wiederaufnahme des unabhängigen Betriebs von Manus am 1. September.
Die Grundlage heißt Cascade, die neueste Version des hauseigenen Agenten-Harness: Jedes Projekt beginnt mit einer schlanken Ausstattung und erhält spezialisierte Fähigkeiten erst dann, wenn die Arbeit sie erfordert. Briefing, Seite, Video und Automatisierung bleiben dabei in einem Projekt vereint. Manus beziffert den Gewinn gegenüber seinem bisherigen System, allerdings nur für eine getestete Konfiguration, die der Blogbeitrag nicht näher beschreibt.
| Von Manus angegebener Messwert (eine getestete Konfiguration) | Unterschied zum bisherigen System |
|---|---|
| Verbrauchte Tokens | -23,2 % |
| Dauer der Aufgaben | -28,2 % |
| Ausführungskosten | -32 % |
Zwei weitere Bausteine ergänzen das Angebot: Cloud Computer, eine dedizierte Umgebung, die man für dauerhaft laufende Aufgaben kauft (etwa den Server eines Mehrspieler-Spiels oder eine Automatisierung), und Automatisierungen, die nun durch ein Ereignis bei einem verbundenen Dienst ausgelöst werden (neue E-Mail, Veränderung der Werbeleistung, Kalendertermin, Slack-Nachricht, Notion-Aktualisierung). Sie lassen sich mit einem einzigen Prompt einrichten.
Die Desktop-App wird zu Manus Studio, einem gemeinsamen Arbeitsbereich für Menschen und KI, der nur die für das jeweilige Projekt benötigten Werkzeuge lädt. Dort gibt es zwei Umgebungen. Video Editor erstellt einen ersten Schnitt und öffnet dann eine Zeitleiste (Timeline), in der Clips, Bilder, Texte, Animationen und Audio getrennt und bearbeitbar bleiben; gedacht ist er für Produktwerbung von 30 bis 60 Sekunden, Tutorials oder Vlogs. Im Alchemy-Modus übernimmt die KI die kreative Leitung. Game Dev kombiniert Video-, Bild- und Codemodelle, veröffentlicht ein spielbares Spiel über einen einfachen Link und ermöglicht den Mehrspielermodus durch den Kauf eines Cloud Computer. Mit Remote Control und Computer Use lässt sich Manus schließlich vom Telefon aus eine Aufgabe auf dem eigenen Computer übertragen, während man den Desktop live verfolgt.
Als dritter Teil ist Cue eine neue eigenständige App für persönliche Agenten auf Telefon und Computer, die auf der Infrastruktur von Manus aufbaut. Jeder Agent verfügt über eine eigene E-Mail-Adresse, Telefonnummer, Wallet und einen eigenen Computer: Er verschickt Nachrichten, bezahlt innerhalb eines festgelegten Budgets, nimmt Anrufe entgegen und fasst sie zusammen. Mehrere Agenten können in einem Gruppenchat an einem gemeinsamen Ziel arbeiten. Cue öffnet sich auch für alltägliche Dienste, etwa um im Restaurant durch Scannen eines QR-Codes zu bestellen. Später am Tag stellte Manus klar, dass sich mit diesen Nummern Anrufe und SMS tätigen und empfangen lassen, allerdings nur in bestimmten Ländern und mitunter ausschließlich für Sprachanrufe.
Manus 2.0 ist ab sofort im Web, auf dem Desktop und auf Mobilgeräten verfügbar. Auch Cue ist verfügbar; die iOS-Version wartet noch auf die Prüfung durch den App Store. Der kostenlose Vorabzugang per Einladungscode ist auf eine begrenzte Zahl erster Nutzer beschränkt. Der Blogbeitrag nennt keine Preise, auch nicht für Cloud Computer, benennt kein zugrunde liegendes Modell und führt keine externe Bewertung an.
🔗 Introducing Manus 2.0 · Ankündigung von Cue auf X · Telefonnummern der Agenten
ElevenLabs veröffentlicht Eleven v4, sein ausdrucksstärkstes Sprachmodell, und eine Turbo-Variante für Agenten
28. September — ElevenLabs veröffentlicht Eleven v4, das Unternehmen zufolge sein emotional ausdrucksstärkstes Modell für Sprachsynthese (TTS), sowie Eleven v4 Turbo, eine Variante mit geringer Latenz für Gesprächsagenten. Eleven v4 basiert auf einer vollständig neuen Architektur und soll Tonfall, Rhythmus, Emotion und Kontext eines Textes erfassen, um dramatisch, zärtlich, dringlich oder komisch zu sprechen, ohne die Identität der Stimme zu verlieren. ElevenLabs beansprucht den ersten Platz in der Provider Voice Arena von Artificial Analysis (September 2026) und gibt an, dass in Blindtests etwa 75 % der Zuhörer seine Ausgabe gegenüber Cartesia Sonic 3.6, Inworld TTS-2 und zwei TTS-Modellen von Google Gemini 3.8 bevorzugten, wobei Gleichstände zur Hälfte gezählt wurden.
Die Ausgabe lässt sich mit natürlicher Sprache oder mit Tags im Text steuern (Lachen, eine wütende Äußerung mit französischem Akzent, leichter Regen, ein vibrierendes Telefon). Laut ElevenLabs folgt Eleven v4 diesen Vorgaben zuverlässiger als seine Vorgänger. Die Unterstützung des Internationalen Phonetischen Alphabets (IPA) verbessert sich deutlich, und Dialoge mit mehreren Stimmen klingen natürlicher. Eine neue Methode zur Erfassung der Stimmidentität soll deren Konsistenz bei Agenten, Hörbüchern und Werbung erhalten.
| Von ElevenLabs veröffentlichter Kennwert | Angegebener Wert |
|---|---|
| Platzierung in der Provider Voice Arena von Artificial Analysis (Sept.) | 1. Platz |
| Präferenz in Blindtests gegenüber 4 Konkurrenzmodellen | etwa 75 % |
| Mediane Inferenzlatenz von Eleven v4 Turbo | etwa 100 ms |
| Mediane Zeit bis zum Beginn der Sprachausgabe bei Eleven v4 Turbo | etwa 150 ms |
| Unterstützte Sprachen | mehr als 90 (Eleven v3: mehr als 70) |
| Zeichenlimit pro Anfrage bei Eleven v4 | 10 000 Zeichen (Eleven v3: 5 000) |
| Mindestlänge des Audios für einen sofortigen Stimmklon | 10 Sekunden |
Die Zeit bis zum Beginn der Sprachausgabe wurde beim WebSocket-Streaming im Vergleich mit Cartesia, xAI, Google und OpenAI gemessen, ohne Netzwerklatenz. Eleven v4 Turbo wurde gemeinsam mit der ElevenAgents-Plattform optimiert. Eine in einer Sprache aufgenommene Stimme spricht andere Sprachen mit dem jeweiligen muttersprachlichen Akzent. Eleven v4 unterstützt nun auch professionelle Stimmklone (Professional Voice Clones); zudem funktioniert die Verkettung langer Generierungen, die für Studio und die Reader-App nützlich ist, zuverlässiger.
Beide Modelle sind ab sofort in ElevenAgents, ElevenCreative und über die API (eleven_v4 und eleven_v4_turbo) verfügbar. Zwei Wochen lang gelten für die Eleven-v4-API 22 Dollar und für die Eleven-v4-Turbo-API 11 Dollar pro Million Zeichen. Eleven v4 ist für Creator-Tarife und höhere Tarife von ElevenCreative kostenlos, begrenzt auf das Doppelte des monatlichen Guthabens; der reguläre Preis wurde nicht veröffentlicht. Die Veröffentlichung folgt auf Eleven v3, das im Februar 2026 auf den Markt kam.
🔗 Introducing Eleven v4 · Ankündigungsthread auf X
Kling kündigt Kling 4.0 für Oktober an und öffnet Kling 4.0 Flash für den Vorabzugang
28. September — Kling AI stellt Kling 4.0 vor, seine neue Generation von Videomodellen, deren offizielle Veröffentlichung für Oktober geplant ist. Die erste Variante, Kling 4.0 Flash, steht seit dem 28. September einer begrenzten Nutzergruppe im Vorabzugang offen: laut dem Ankündigungspost auf X Abonnenten mit einem jährlichen Ultra-Abo. Kling hebt drei Schwerpunkte hervor: visuellen Realismus, kreative Kontrolle und die Vollständigkeit der Erzählung (narrative completeness).
Den Angaben zufolge erzeugt Kling 4.0 Videos von 3 bis 30 Sekunden am Stück in bis zu 4K mit Stereo-Ton auf zwei Kanälen. Die Erzählung lässt sich mit bis zu 10 Schlüsselbildern und Prompts mit höchstens 8 000 Tokens steuern. Omni Reference akzeptiert bis zu 15 Referenzen pro Generierung: 10 Bilder, 5 Videos mit einer Gesamtlänge von höchstens 30 Sekunden und 7 Subjekte, davon 3 aus Videos; die Audioreferenz ist auf die Stimme beschränkt. Modelle ohne Texturen und Tiefenkarten können dabei helfen, Bewegungen und Bildausschnitte festzulegen. Bei der Bearbeitung lassen sich Mimik, Gestik, Kamera, Stil oder Hintergrund in bis zu 5 Clips verändern. Kling verspricht außerdem lesbaren Text im Bild sowie mehr Sprachen, Akzente und Dialekte, von Kantonesisch und Sichuanisch bis zu indischem Englisch.
| Technische Spezifikation | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| Verfügbarkeit | Offizielle Veröffentlichung im Oktober | Begrenzter Vorabzugang seit dem 28. September |
| Generierungsmodi | Text zu Video, Bild zu Video, erstes und letztes Bild, 10 Schlüsselbilder, Omni Reference | Text zu Video, Bild zu Video, Omni Reference |
| Dauer einer Generierung | 3 bis 30 Sekunden | 3 bis 20 Sekunden |
| Maximale Auflösung | 4K (auch 720p und 1080p) | 720p |
| Dynamikumfang | 10-Bit-HDR in 1080p und 4K, für später angekündigt | 8-Bit-SDR |
Noch ist nicht alles verfügbar. Die Versionshinweise kündigen die Ausgabe in 10-Bit-HDR mit 1080p und 4K für später an (coming soon), obwohl der Post auf X sie bereits zu den Funktionen von Kling 4.0 zählt. Auch die Verlängerung eines Videos auf bis zu 2 Minuten soll später folgen. Kling überarbeitet zudem seine Erstellungsseite: Sie bündelt alle Referenzen in einem einzigen Eingabefeld und ergänzt eine Arbeitsfläche, auf der ein Agent die angeforderten Aufgaben ausführt. Die Ankündigung enthält weder Preise noch Angaben zum API-Zugang oder Benchmarks; illustriert wird sie durch den mit Kling 4.0 produzierten Kurzfilm THE BEAT.
🔗 Versionshinweise zu Kling 4.0 · Ankündigung auf X
Code-Agenten: Claude Code 2.1.284, Codex CLI 0.158.0, Copilot CLI 1.0.89 und sein SDK, Devin, Delta und Gemini CLI
Claude Code 2.1.284 startet bei allen Tarifen und Anbietern im Auto-Modus
28. September — Claude Code 2.1.284 wurde um 18:02 Uhr UTC veröffentlicht, wenige Augenblicke vor der Ankündigung des Modells. Die Version ergänzt Claude Sonnet 5.5, das in der Anthropic-API zum standardmäßigen Sonnet-Modell wird. Sie umfasst 100 Einträge: 57 Fehlerbehebungen, 18 Verbesserungen, 14 Ergänzungen und 11 Änderungen.
Die auffälligste Änderung betrifft Berechtigungen: Wenn kein Modus konfiguriert ist, starten interaktive Sitzungen im Terminal und in VS Code nun bei allen Tarifen und Anbietern im Auto-Modus. Version 2.1.283 hatte dies am 25. September bereits für Drittanbieter und Sitzungen ohne Telemetrie eingeführt; Version 2.1.284 weitet es auf alle aus. Die Einstellung permissions.defaultMode hat weiterhin Vorrang. Eine neue Antwortoption, „Ja, aber nächstes Mal erneut fragen“ (Yes, but ask again next time), erlaubt einmalig das Lesen außerhalb der Arbeitsverzeichnisse; für weitere Zugriffe fragt Claude Code erneut.
Ultracode wird aus dem Regler für den Rechenaufwand herausgelöst und zu einem eigenen Schalter in /effort (Tab-Taste oder /effort ultracode on und off): Es erzwingt nicht länger den Rechenaufwand xhigh und bleibt unabhängig von der gewählten Stufe aktiv. In VS Code gibt es einen entsprechenden Schalter unter dem Regler für den Rechenaufwand.
| Neuerung in 2.1.284 | Befehl oder Einstellung |
|---|---|
| Auto-Modus standardmäßig bei allen Tarifen und Anbietern | permissions.defaultMode hat Vorrang |
| Ultracode als unabhängiger Schalter | Tab in /effort oder /effort ultracode on und off |
| Gemeinsamer Neuverbindungsversuch für ausgefallene MCP-Server | /mcp reconnect all |
| Ausgaben in Dollar für das Claude-apps-Gateway | /usage und Statuszeile (Felder used_usd, limit_usd, period) |
| Zweite Komprimierung, falls „Prompt is too long“ bestehen bleibt | automatisch |
Im Bereich Sicherheit können Plugins aus Marketplaces, von claude.ai oder von npm ihre eigenen Werkzeuge nicht mehr vorab genehmigen, wenn die Administration ausschließlich ihre verwalteten Regeln zulässt (allowManagedPermissionRulesOnly). Für Regeln aus .claude/rules, die per symbolischem Link von außerhalb des Projekts eingebunden sind, ist eine Genehmigung erforderlich. Beim Laden des Speichers werden in MEMORY.md unsichtbare Zeichen und Tags neutralisiert, die das Markup von Claude Code nachahmen. Für mehr Zuverlässigkeit wird ein beschädigter Antwort-Stream erneut versucht, statt „JSON Parse error“ anzuzeigen; MCP-Aufrufe in einer fortgesetzten Sitzung warten bis zu 10 Sekunden auf ihren Server. Wenn schließlich die Schutzmechanismen eines Sonnet-Modells eine Nachricht markieren, erläutert der Hinweis den Grund ausführlicher und schlägt vor, die Anfrage zu ändern und erneut zu senden.
Codex CLI 0.158.0: Kopieren beim Markieren und OAuth-Client-Secrets für MCP
28. September — Codex CLI 0.158.0 wurde um 05:07 Uhr UTC veröffentlicht und ist die erste stabile Version seit 0.157.1 vom 26. September. Die Versionshinweise führen 188 Pull Requests seit 0.157.0 auf. In der Vollbildoberfläche (fullscreen TUI) lassen sich Kopieren beim Markieren (copy-on-select) und Einfügen per Rechtsklick konfigurieren. Ein aus dem Transkript kopierter Abschnitt behält seine Markdown-Formatierung.
| Betroffene Funktion | Einstellung oder Detail |
|---|---|
| Kopieren beim Markieren | tui.copy_on_select: auto standardmäßig (tmux, Zellij, direkt genutzte macOS-Terminals außer Ghostty und Kitty), always, never |
| Einfügen per Rechtsklick | tui.right_click_paste: auto (Windows, Linux, WSL), on (auch macOS), off |
| MCP-Server mit OAuth | codex mcp add --oauth-client-secret, Schlüssel oauth.client_secret |
| Exec-server | Bearer-Tokens für direkte WebSocket-Verbindungen |
| Bilderzeugung | Explizit transparenter Hintergrund (transparent_background), Bearbeitung von Bildern aus der Unterhaltung |
Codex kann sich nun mit MCP-Servern verbinden, die einen vorab registrierten OAuth-Client mit Secret verlangen. Direkte WebSocket-Verbindungen zum Exec-server lassen sich mit Bearer-Tokens schützen, auch wenn sie über den App-server laufen. Im Bereich Sicherheit ist die Genehmigung von Eingaben an ein Terminal nun stabil und für Befehle mit erhöhten Berechtigungen standardmäßig aktiviert. Die Fehlerbehebungen betreffen vor allem Sandboxes: gewöhnliche Windows-10-Pfade, abgelehnte gespeicherte Anmeldedaten, den Start unter Linux mit verschachtelten beschreibbaren Stammverzeichnissen sowie den Schutz von Git-Metadaten unter Linux und macOS.
Copilot CLI 1.0.89 wird stabil, Copilot SDK 1.0.15 versieht seine Ausgaben mit Typen
28. September — GitHub veröffentlicht Copilot CLI 1.0.89 als stabile Version (19:20 Uhr UTC). Die am 27. September beschriebene Vorabversion 1.0.89-5 unterstützte bereits .claude/rules-Dateien; mehrere der 35 Einträge in den Versionshinweisen sind neu. Das Auto-Routing schlägt nun eine Stufe vor, die sich per Tastenkürzel oder Klick ändern lässt, und verzichtet auf das nicht unterstützte Fast-Profil: Eine gespeicherte Fast-Einstellung fällt auf Balance zurück. Beim Erstellen von Pull Requests werden die Vorlagen des Repositorys einschließlich Pflichtabschnitten und Checklisten beachtet. In einer lokalen Sitzung ruft zweimaliges Drücken von Escape in einem leeren Eingabefeld einen Prompt zurück, dessen Bearbeitung noch nicht begonnen hat. Direkt installierte Plugins lassen sich aktivieren und deaktivieren (copilot plugin enable). In der Sandbox funktionieren umhüllte gh- und git-Befehle (timeout 60 gh …). Unter Windows ist localhost erreichbar, wenn der Zugriff auf das lokale Netzwerk aktiviert ist.
Kurz darauf (19:38 Uhr UTC) erscheint das GitHub Copilot SDK, das die agentische Laufzeitumgebung von Copilot in eine Anwendung einbettet, nach fünf Vorabversionen als 1.0.15. Die wichtigste Neuerung sind typisierte strukturierte Ausgaben in allen sechs SDKs (TypeScript, Python, Go, Java, C# und Rust): Entwickler geben ein JSON-Schema oder einen sprachüblichen Typ vor, und das Modell liefert eine typisierte, validierte Ausgabe statt Freitext. Ein experimenteller Handler ermöglicht es der Anwendung außerdem, vor der Installation eines MCP-Servers oder eines Skills eine menschliche Prüfung mit ausdrücklicher Entscheidung zu verlangen (bestätigen, ablehnen oder abbrechen). In Rust sinkt der Speicherbedarf bei der Installation dieser Laufzeitumgebung um etwa 99 %.
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devin wird 30 bis 40 % günstiger, Devin Fusion führt FrontierCode 1.1 Extended an
28. September — Cognition kündigt deutlich niedrigere Nutzungskosten für Devin an: 30 bis 40 % weniger in den Modi Fusion und Normal, 15 bis 20 % weniger im Modus Ultra und bis zu 70 % weniger für Devin Review, sein Tool zur Codeprüfung. Das Unternehmen führt diese Einsparungen auf die Integration der neuesten Modelle, darunter das eigene SWE-2, sowie auf Verbesserungen an Devins Cloud Harness zurück: mehr gebündelte Aktionen in einem einzigen Toolaufruf (Formatieren, Analysieren und Testen auf einmal), parallel ausgeführte unabhängige Aufrufe und eine bessere Wiederverwendung des Prompt-Caches. Die für den Harness genannten Größenordnungen stammen aus illustrativen Beispielen, nicht aus Messungen.
Cognition gibt an, die Leistungsfähigkeit jedes Modus erhalten oder verbessert zu haben. Fusion kombiniert ein leistungsfähiges Hauptmodell mit einem günstigeren Sidekick; in der Grafik des Beitrags liegt es bei FrontierCode 1.1 Extended vorn.
| Von Cognition bewertete Konfiguration | FrontierCode 1.1 Extended: Punktzahl | Durchschnittliche Kosten pro Aufgabe |
|---|---|---|
| Devin Fusion | 68,8 | 0,60 Dollar |
| Opus 5.5 (high) | 65,2 | 0,90 Dollar |
| Fable 5.1 (medium) | 63,6 | 2,68 Dollar |
| GPT-6 Astra (high) | 63,1 | 2,62 Dollar |
| SWE-2 (high) | 60,1 | 0,64 Dollar |
| GPT-6 Sol (high) | 59,6 | 0,87 Dollar |
Die Werte für Opus 5.5 (65,2) und GPT-6 Astra (63,1), jeweils mit der Aufwandsstufe high, unterscheiden sich von denen der am selben Tag veröffentlichten Grafik zu Sonnet 5.5 (65,3 und 64,5), die keine Aufwandsstufe angibt. Das günstigere Devin ist ab heute verfügbar; eine neue Preisliste wurde nicht veröffentlicht.
🔗 Devin ist jetzt bis zu 40 % kosteneffizienter
Devin-Versionshinweise vom 25. September und Beta von Devin Mobile
25. September — Die bislang wenig beachteten Devin-Versionshinweise vom 25. September ergänzen die Marketplace um 57 gehostete MCP-Integrationen, darunter Buildkite, Brex, Expo, Vanta, WorkOS und Wix. Devin erstellt außerdem einen interaktiven HTML-Bericht, wenn ein angeforderter Bericht von Grafiken, Tabellen oder Diagrammen profitieren würde und kein Format vorgegeben ist. Eine untergeordnete Sitzung beginnt mit einer Zusammenfassung ihrer übergeordneten Sitzung, die im Eingabebereich als entfernbares Element erscheint. Eine Sitzung, deren Rechner in den Ruhezustand gewechselt ist, wird wieder aktiv, sobald jemand eine Vorschau-URL öffnet oder sich per SSH verbindet. Automatisierungen können auf einem gemeinsam genutzten Outpost laufen, und Devin liest Azure-Pipelines-Logs fehlgeschlagener Prüfungen bei Azure-DevOps-Pull-Requests.
Am 28. September eröffnet Cognition außerdem eine Warteliste für die Beta von Devin Mobile. Die Anmeldeseite fasst es in einem Satz zusammen: Devin läuft in der Cloud oder auf dem eigenen Rechner, testet in seinem eigenen Browser und hört erst auf, wenn der Pull Request bereit zum Zusammenführen ist. Weder ein Termin für die allgemeine Verfügbarkeit noch ein Preis wurden veröffentlicht.
🔗 Devin-Versionshinweise · Devin Mobile auf X
Zed kündigt Delta 0.18 an, Gemini CLI veröffentlicht eine Nightly ohne Änderungen
28. September — Zed kündigt ohne Termin an, dass Delta 0.18, seine Multiplayer-Umgebung zum Programmieren mit Agenten, Delta-Threads in bereits bestehenden Git-Worktrees ausführen wird. Version 0.17 vom 23. September isolierte bereits jede parallel bearbeitete Aufgabe in einem eigenen Arbeitsbereich. Bei Google enthält die am 28. September veröffentlichte Nightly von Gemini CLI keine Änderungen: Sie basiert auf demselben Commit wie die vom 26. September. Auch die stabile Version v0.61.0 und die Vorabversion v0.62.0-preview.0 bleiben bestehen.
🔗 Zed auf X · Gemini CLI v0.63.0-nightly.20260928
Perplexitys Agent API erhält wiederverwendbare Profiles, versionierte Skills und gemeinsame Konnektoren
28. September — Perplexity ergänzt seine Agent API um eine wiederverwendbare, versionierte Konfigurationsebene für Teams. Das zentrale Element, das Profile, speichert unter einer eindeutigen versionierten Kennung alles, was einen Agenten definiert: Modell, Anweisungen, Tools, Skills, Konnektoren und Ausführungseinstellungen. Ein Projektadministrator konfiguriert den Agenten einmal und stellt ihn berechtigten Entwicklern zur Verfügung; jede Anwendung liefert nur noch ihre eigenen Daten.
Benutzerdefinierte Skills bündeln Anweisungen, Abläufe und unterstützende Dateien in versionierter Form. Ein Plattformteam kann darin seine Bereitstellungsprüfungen, Kriterien für ein Rollback und sein Berichtsformat hinterlegen und anschließend eine neue Version veröffentlichen, statt jede Anwendung anzupassen. Die Ende August eingeführten Managed Connectors werden zu einer Ressource, die der Administrator mit dem gesamten Projekt teilt: Anwendungen verweisen darauf, ohne jeweils eigene Zugangsdaten oder Tooldefinitionen zu speichern.
| Hinzugefügte Ressource | Rolle in der Agent API | Angekündigte Verfügbarkeit |
|---|---|---|
| Profiles | Modell, Anweisungen, Tools, Skills, Konnektoren und Ausführungseinstellungen unter einer versionierten Kennung | Verfügbar |
| Benutzerdefinierte Skills | Versionierte Anweisungen, Abläufe und unterstützende Dateien, die Projektmitglieder aufrufen | Verfügbar |
| Managed Connectors | Vom Administrator geteilte, genehmigte Integrationen (GitHub, Slack, Google Drive, Datadog, Linear, Notion) | Vorabversion |
Alles wird über die API Console eingerichtet; Mitglieder rufen die Ressourcen mit einem API-Schlüssel desselben Projekts auf. Der Beitrag nennt keine Preise. Am selben Tag stellt ein Eintrag im API-Changelog die xhigh-Voreinstellung der Agent API von GPT-5.6 Sol (openai/gpt-5.6-sol) auf Claude Opus 5.5 (anthropic/claude-opus-5-5) um. Prompts, Denkaufwand, Tools, Tokenbudgets und Schrittgrenzen bleiben gleich. Drei Tage zuvor waren die Voreinstellungen low, medium und high auf GPT-6 umgestellt worden.
🔗 Agent API unterstützt jetzt wiederverwendbare Agenten · Changelog der Perplexity API
SpaceXAI startet Team Bots, gemeinsam genutzte Grok Bots für ganze Teams
28. September — SpaceXAI startet Team Bots: Grok Bots, die für eine Teamrolle oder einen Teamablauf eingerichtet und mit allen Teammitgliedern geteilt werden. Jedes Mitglied kann auch allein mit dem Bot arbeiten. Der Bot ist gemeinsam, die Unterhaltungen bleiben jedoch privat: Kontext und Erinnerungen sind nach Nutzern getrennt, während die Skills dem gesamten Team zur Verfügung stehen. Jeder Team Bot hat eine eigene Kennung in Slack und kann in einen Kanal eingeladen werden, in dem ihn das ganze Team befragen kann.
| Bot-Komponente | Von SpaceXAI beschriebene Rolle |
|---|---|
| Kontext | Dateien, Anweisungen und Skills |
| Plugins | Arbeit in Salesforce, Notion oder GitHub; Anbindung durch Einzelne oder für das Team |
| Zugangsdaten | Zugriff auf Drittanbieter-APIs ohne Plugin |
| Erinnerungen | Was sich der Bot für seine Rolle merkt, nach Nutzern getrennt |
SpaceXAI beschreibt eigene Einsatzfälle. Jeder große Geschäftskunde hat einen Team Bot, der nachts Nachrichten über den Kunden, Gong-Anrufe, Notion-Dokumente und Slack-Threads auswertet und morgens eine Zusammenfassung in Slack veröffentlicht. Der mit Notion, Linear, Hex, Datadog und Cursor verbundene Engineering-Bot hat Hunderte Cloud Agents gesteuert: Ein fünfköpfiges Team lieferte so mehr als 100 Pull Requests pro Tag und brachte Team Bots innerhalb weniger Wochen auf den Markt. Beim Kunden Harper, einem Versicherer, entstand nach eigenen Angaben binnen 24 Stunden ein Team Bot, der Kunden hilft, abgelaufene Policen wieder in Kraft zu setzen. Laut Harpers CEO sparten die Kunden dadurch mehr als 120.000 Dollar.
Team Bots ist ab heute als öffentliche Beta in den Tarifen Teams und Enterprise verfügbar, mit vorkonfigurierten Team Bots für Vertrieb, Produktmanagement, Marketing und Datenanalyse. SpaceXAI nennt weder Preise noch Kontingente.
🔗 Team Bots (SpaceXAI) · Ankündigung von @bot auf X
H Company veröffentlicht Holo4, agentische Open-Weight-Modelle mit 27B und 35B-A3B
28. September — H Company veröffentlicht Holo4, seine neue Reihe agentischer Modelle, in zwei Größen: ein dichtes Modell mit 27 Milliarden Parametern und ein Mixture-of-Experts-Modell mit 35B-A3B. Beide werden über die H Models API bereitgestellt und auf Hugging Face in BF16, FP8, NVFP4 und 4-Bit-GGUF veröffentlicht. Hinzu kommt Holotron4 Nano, das durch Anwendung des Post-Training-Verfahrens von H auf NVIDIAs Nemotron 3 Nano Omni entstanden ist. Ein und dasselbe Modell handelt über grafische Oberflächen, Code, MCP oder APIs – auf dem Computer, im Web, auf Android oder in einer Code-Sandbox. H trainierte es zunächst überwachend und anschließend durch Reinforcement Learning, unter anderem mit rund 10.000 überprüfbaren Aufgaben, die seine Agentic Task Factory aus einfacher Dokumentation erzeugt.
| Bewertetes Modell | Basis und Lizenz | Veröffentlichte Punktzahl |
|---|---|---|
| Holo4 27B | Qwen3.8-27B, CC-BY-NC-4.0 (nicht kommerziell) | 61,7 % bei OSWorld 2.0; 85,2 % bei OSWorld für 0,08 Dollar pro Aufgabe |
| Holo4 35B-A3B | Qwen3.6-35B-A3B, Apache-2.0 | 30,9 % bei OSWorld 2.0 |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni, NVIDIA Open Model Agreement | Verbesserungen gegenüber der Basis nur als Grafik angegeben |
| Claude Opus 5.5 (von H genannte Referenz) | geschlossenes Modell | 81,8 % bei OSWorld 2.0 |
H erläutert die Testbedingungen: Holo4 wird im eigenen Harness mit einem einzigen Durchlauf von OSWorld 2.0 gemessen und mit öffentlichen Ergebnissen verglichen, die mit anderen Harnesses und Aufwandsstufen erzielt wurden. Bei AutomationBench gehören 480 der 600 öffentlichen Aufgaben zu der Teilmenge, die für die Erhebung der Trainingsdaten verwendet wurde. H veröffentlicht sämtliche Trajektorien hinter seinen öffentlichen Ergebnissen; sie lassen sich Schritt für Schritt ansehen oder von Hugging Face herunterladen. Für die nächsten Tage kündigt H außerdem DSpark-Entwürfe an, die die Inferenz beschleunigen sollen.
🔗 Holo4-Beitrag auf Hugging Face · Ankündigung von H Company
Robotik: SAIL von Sakana AI steigert die Erfolgsquote von 25 auf 73 %, ProjectSim hinterfragt die Messung in Simulationen
28. September — Sakana AI stellt SAIL (Scaling In-Context Imitation Learning) vor, eine gemeinsam mit der Universität Tokio durchgeführte und für die Konferenz IROS 2026 angenommene Arbeit. Das Paper trägt eine arXiv-Kennung vom März 2026; neu ist heute seine öffentliche Vorstellung. Die Forschungsfrage lautet: Lassen sich einem bestehenden Vision-Language-Modell (VLM) zuverlässige Roboterbewegungen entlocken, ohne es erneut zu trainieren, indem es zur Inferenzzeit mehr Rechenleistung erhält?
SAIL erzeugt aus einigen erfolgreichen Demonstrationen im Kontext eine vollständige Trajektorie und führt sie in einer Simulation aus. Ein zweites VLM schätzt anschließend anhand des Videos den Fortschritt der Aufgabe; diese Rückmeldung steuert eine Monte-Carlo-Baumsuche (MCTS). Nur die ausgewählte Trajektorie wird an den realen Roboter übertragen. Gemini Robotics-ER 1.5 übernimmt beide Rollen, ohne dass seine Gewichte verändert werden.
| Bewertete Methode | Suchknoten | Durchschnittliche Erfolgsquote bei sechs simulierten Aufgaben |
|---|---|---|
| Einmalige Generierung | 1 | 25 % |
| Tiefensuche | 15 | 37 % |
| Breitensuche | 15 | 51 % |
| SAIL | 6 | 55 % |
| SAIL | 15 | 65 % |
| SAIL | 45 | 73 % |
Die Quoten zählen die Konfigurationen (20 pro Aufgabe im ALOHA-Simulator), für die innerhalb des Budgets eine erfolgreiche Trajektorie gefunden wird. Den Erfolg prüft der Simulator, nicht das VLM. Mit einem LeRobot-SO-101-Arm gelingt es SAIL in 5 von 6 Versuchen, einen Block in eine Schüssel zu legen, bei einem Budget von 15 Kandidaten. Eine auf den gefundenen Trajektorien trainierte Imitationsstrategie erreicht ebenfalls 5 von 6 Erfolgen und läuft schneller. Sakana nennt die Grenzen: Ausführung ohne Rückkopplung, zusätzlicher Rechenaufwand für die Suche und eine auf eine Aufgabe mit sechs Versuchen pro Methode beschränkte Prüfung am realen Roboter.
🔗 Beitrag von Sakana AI · SAIL-Projektseite
ProjectSim zieht eine Zwischenbilanz zu Robotik-Benchmarks
28. September — Die Lücke zwischen simulierten und realen Ergebnissen ist das Thema des ersten Experiments von ProjectSim. In einem Überblicksbeitrag ohne eigene Ergebnisse untersucht Luca Cilio Manipulations-Benchmarks von MetaWorld und LIBERO bis hin zu gemeinsamen Tests an physischen Robotern wie RoboChallenge. Anhand von Zahlen aus RoboCasa365 erinnert er daran, dass GR00T N1.5, nach einem Feintuning mit 30 000 Demonstrationen, 43 % der einzelnen Fähigkeiten erfolgreich ausführt, bei Kombinationen, die im Feintuning nicht vorkamen, aber auf 4,4 % fällt. Das Experiment von ProjectSim soll klären, ob realitätsgetreuer simulierte Szenen – mit rekonstruierter Geometrie, Erscheinung und physikalischen Eigenschaften – die Simulationsergebnisse näher an die Messwerte eines echten Roboters bringen. Ergebnisse sind noch nicht veröffentlicht.
Mistral eröffnet in München einen Hub für industrielle KI und KI für Physik
28. September — Mistral eröffnet einen Hub in München. Dort werden Forschungsteams für KI in der Physik (Physics AI) und industrielle KI (Industrial AI) arbeiten, zusammen mit Ingenieuren, die direkt für Partnerunternehmen tätig sind. Mistral stellt sich dabei als langfristiger Technologiepartner und weniger als Softwareanbieter dar.
| Von Mistral genannter Partner | Angekündigte Arbeit |
|---|---|
| BMW | Crashsimulation und KI im Ingenieurwesen |
| Siemens Energy | Anwendungen industrieller KI |
| Technische Universität München (TUM) | Digitale Zwillinge im Windkanal für die Automobilaerodynamik |
Der Hub knüpft an die Übernahme von Emmi AI im Mai 2026 an. Dadurch kamen mehr als 30 Physiker, Forscher und Ingenieure zu Mistral, die auf numerische Strömungsmechanik (CFD), Strukturmechanik und Multiphysiksimulationen spezialisiert sind. Gemeinsam mit der TUM und Professor Nikolaus A. Adams will Mistral digitale Zwillinge für die Automobilaerodynamik entwickeln. Sie sollen Echtzeitmessungen von Windkanalsensoren mit offline berechneten CFD-Simulationen verbinden und so präzise aerodynamische Vorhersagen in Echtzeit ermöglichen.
Der Beitrag greift das Argument der digitalen Souveränität auf: Kunden erhalten Zugang zu den Modellgewichten, können die Modelle auf eigener Infrastruktur und unter europäischem Recht ausführen und müssen ihre Daten nicht aus der Organisation herausgeben. Außerdem kündigt Mistral an, bis 2030 in Europa Rechenkapazität von einem Gigawatt aufzubauen. Zitiert werden der deutsche Bundesminister für Digitales, Karsten Wildberger, und der Leiter der Bayerischen Staatskanzlei, Florian Herrmann. Mistral stellt im Raum München Personal ein, nennt aber weder eine Mitarbeiterzahl noch eine Investitionssumme.
🔗 Hallo, Deutschland! (Mistral AI)
NVIDIA und Nscale messen DSX MaxLPS: 37 % mehr GPU und 49 % mehr Durchsatz bei gleichem Strombudget
27. September — NVIDIA veröffentlicht eine gemeinsam mit Nscale durchgeführte, bezifferte Bewertung von DSX MaxLPS. Die Software verteilt die Leistung zwischen den Ressourcen einer KI-Fabrik nach den Vorgaben des Betreibers. Laut NVIDIA lassen sich damit innerhalb desselben genehmigten Strombudgets bis zu 40 % mehr GPU einsetzen. Der Beitrag betont, dass dies durch koordinierte Zuteilung geschieht und die Stromversorgung des Standorts nicht erhöht wird.
Der Test lief auf GB300 NVL72 im vollständig mit erneuerbarer Energie versorgten Rechenzentrum von Nscale auf dem Verne-Campus in Keflavík, Island. Zum Einsatz kamen Kimi K2.5 in FP4, NVIDIA Dynamo und TensorRT LLM. Bei einem unveränderten bereitgestellten Budget von 264,4 kW wächst die Flotte von 140 auf 192 GPU, ohne dass der Durchsatz der bestehenden Instanzen sinkt.
| Gemessener Wert | Statische Basis | Mit DSX MaxLPS | Gemessene Änderung |
|---|---|---|---|
| Verwaltete GPU | 140 | 192 | +37,1 % |
| Normalisierter Gesamtdurchsatz | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| Gemessene Gesamtleistung | 166,2 kW | 198,9 kW | +19,7 % |
| Auslastung des Strombudgets | 62,9 % | 75,2 % | +12,3 Punkte |
| Durchsatz pro bereitgestelltem Watt | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
Der Beitrag verschweigt den Nachteil nicht: Während der Median und das P75 der Latenz weniger als 5 % vom Referenzwert abweichen, steigt beim P99 die Zeit bis zum ersten Token um 17 %, ausgehend von 15,7 Sekunden. NVIDIA empfiehlt Betreibern eine Validierung in fünf Schritten, von der Festlegung des elektrischen Rahmens bis zu den Grenzwerten für den Produktionsbetrieb. Die Bewertung folgt auf die am 15. September vorgestellte Validierung durch Lambda auf HGX B200 mit 19 Knoten innerhalb des Budgets für 16. Prognosen für Vera Rubin mit Flüssigkeitskühlung bei einer Eintrittstemperatur von 45 °C werden gesondert dargestellt.
🔗 Technischer Beitrag von NVIDIA
Kurzmeldungen
- DeepSeek Harness 0.2.0-rc.1 — Erster Release Candidate der Reihe 0.2.0 und 23. Vorabversion des Agenten-Harness von DeepSeek, weiterhin ohne stabile Version: Gespräche über die Modelle des DeepSeek-Kontos können ohne zusätzlichen API-Schlüssel im Web suchen, und automatisierte Aufgaben werden in ein optionales Plugin-Paket ausgelagert. 🔗 Quelle
- Pixel Canary auf Vercel AI Gateway — Seit dem 25. September bietet Vercel dieses Code-Modell eines nicht genannten Anbieters während seiner Stealth-Phase kostenlos an: Es löst 28 von 31 Next.js-Aufgaben bei pass@4, gleichauf mit GPT-6 Astra (high), und 30 von 31 mit über AGENTS.md bereitgestellter Dokumentation. Eine Datenaufbewahrung von null ist nicht vorgesehen. 🔗 Quelle
- Selbst gehostete Runner von GitHub Actions — Bei GitHub Enterprise Cloud beginnt am 29. September die vollständige Durchsetzung der Mindestversionen: Unter Version 2.329.0 kann sich ein Runner nicht mehr registrieren; liegt er unter der für die Ausführung geltenden Mindestversion, nimmt er keine Jobs mehr an. Eine neue REST API liefert die Termine für das Ende des Supports. GitHub Enterprise Server ist nicht betroffen. 🔗 Quelle
- NexteraBERT — Rikka Botan veröffentlicht einen bidirektionalen Encoder mit 212,6 Millionen Parametern, vortrainiert auf 130 Milliarden Token (etwa 15-mal weniger als ModernBERT). Nach eigenen Messungen erreicht er 87,90 auf GLUE gegenüber 87,97 für ModernBERT-base, 54,70 gegenüber 53,63 auf MTEB v2 und bei 65 536 Token den 5,22-fachen Durchsatz. Der Code steht unter der MIT-Lizenz. 🔗 Quelle
- LTX-2.5 in Echtzeit — Ein Community-Beitrag beschleunigt dieses Audio- und Videomodell mit 22 Milliarden Parametern von 90 Sekunden pro Clip auf eine Generierung, die schneller als die Wiedergabe ist: Ein fünfsekündiger Clip benötigt auf einer Karte mit 96 Go 1,83 Sekunden. Möglich wird dies durch 4 statt 8 Schritte, NVFP4-Berechnungen und CUDA Graph. Der Code steht unter Apache-2.0. 🔗 Quelle
- SCRIBE — Adalat AI, ein Entwickler von Spracherkennung für indische Gerichte, veröffentlicht auf PyPI dieses quelloffene Bewertungswerkzeug (mit einem Beitrag auf der Interspeech 2026). Es bewertet Wörter, Zahlen, Satzzeichen und Fachbegriffe getrennt. Eine Fehlerrate pro Wort würde dagegen einen Malayalam-Satz, den kein Korrektor ändern würde, mit 100 % bewerten. 🔗 Quelle
- 228 JEV-Projekte — Eric Kang, der die Liste Awesome JEV pflegt, wählt 228 Open-Source-Projekte aus: 10 Typen, mindestens 50 Sterne und jeweils auf einen Commit festgelegt. Die Auswahl stammt aus 13 473 Repositories, die eine GitHub-Suche nach „jev“ zurückgibt und unter denen auch themenfremde Projekte sind. Es ist eine manuelle Auswahl, keine unabhängige Bestandsaufnahme. 🔗 Quelle
- HeyGen und Jev — HeyGen veröffentlicht auf X eine Anleitung, die Jev, das Entscheidungsmodell von TypeSafe AI, vor seinen MCP-Server schaltet: Jev sortiert rund vierzig Interessenten nach Video-Eignung, Ansatz, Sprache und Passung. Claude schreibt die Skripte, anschließend erstellt HeyGen MCP das Paket. Nur dieser letzte Schritt verbraucht Credits und wartet auf eine Freigabe. 🔗 Quelle
- Vier Projekte mit Gemini 3.8 Flash — Der Google-Blog stellt vier mit dem am 2. September eingeführten Modell gebaute Projekte vor: eine mit Antigravity erstellte Live-Verfolgung von Satelliten, animierte Seigaiha-Wellen, ein 3D-Skelett eines Tyrannosaurus und ein Automatikgetriebe mit 10 Kameraansichten. Zahlen oder Produktneuheiten nennt der Beitrag nicht. 🔗 Quelle
- Ein Caterer aus Brooklyn und Gemini — Der Google-Blog beschreibt, wie Edy Massih, Inhaber des Lebensmittelgeschäfts Edy’s Grocer in Greenpoint, Gemini nutzt, um seine Rezepte auf 200 Gäste hochzurechnen, Einkaufslisten zu erstellen und Menüs an Ernährungsweisen anzupassen. Neue Funktionen werden nicht vorgestellt. 🔗 Quelle
- Lenfest Institute — OpenAI stellt 5 Millionen Dollar sowie bis zu 5 Millionen Dollar an Softwareguthaben und technischer Unterstützung für die nächste Phase des KI-Stipendienprogramms des Lenfest Institute bereit. Das Programm startete 2024 in 11 US-Redaktionen; die Zusage verdoppelt die bisherige Unterstützung. 🔗 Quelle
- Gesundheits-Tab von ChatGPT — Wer im Tab Health ein Diagramm, einen Messwert oder eine Akte auswählt, erhält nun personalisierte Erklärungen, teils mit interaktivem Diagramm, ohne einen Prompt schreiben zu müssen. Health bleibt auf die USA beschränkt (ab 18 Jahren, Tarife Free, Go, Plus und Pro, Web und iOS). 🔗 Quelle
- Gewinner des WebMCP Challenge — OpenAI Developers stellt die zehn ausgezeichneten Projekte des Ende August gestarteten Hackathons vor (MASIL, Alza, ArchMorph, Aisle, Roque Nights, Mandate, Observatory, Bouquet Studio, Faraday, JupyterLite WebMCP), ohne Rangliste oder Beträge pro Projekt. 🔗 Quelle
- Sicherheitsupdate für macOS — Am 25. September behob Version 26.924.20706 der macOS-Desktop-App die von Patrick Wardle (Objective-See Foundation) gemeldete Schwachstelle CVE-2026-100754. Der Eintrag steht im ChatGPT- und Codex-Changelog im Abschnitt zur Codex-App; die Schwachstelle wird nicht beschrieben. 🔗 Quelle
Was das bedeutet
Der Preis pro Token bleibt gleich, während die Zahl der verbrauchten Token sinkt. Sonnet 5.5 behält den Preis von Sonnet 5 bei, kostet laut Anthropic aber bis zu 30 % weniger pro Aufgabe, weil es weniger Token verbraucht. Devin wird durch die Integration seiner neuesten Modelle, darunter SWE-2, und durch gebündelte Tool-Aufrufe um 30 bis 40 % günstiger. Manus meldet mit seinem neuen Harness in einer getesteten Konfiguration 32 % geringere Ausführungskosten. Entscheidend ist nun die verbrauchte Arbeitsmenge beim Modell und beim Harness, nicht mehr der ausgewiesene Preis. Zugleich holt die Mittelklasse zur Spitzenklasse auf: Auf Terminal-Bench 4.0 übertrifft Sonnet 5.5 den für Opus 5.5 mit Aufwand Xhigh gemessenen Wert.
Agenten erhalten standardmäßig mehr Autonomie, während Schutzmechanismen außerhalb ihrer Reichweite verankert werden. Claude Code startet nun bei allen Tarifen im Auto-Modus. NVIDIA verlagert die Überwachung in eine DPU, auf die der Agent nicht zugreifen kann, und verlangt standardmäßig eine menschliche Freigabe für jede von ihm vorgeschlagene Zugriffsregel. Die Tools folgen demselben Muster: Codex CLI verlangt eine Genehmigung für Terminal-Eingaben bei Befehlen mit erhöhten Berechtigungen, und mit dem Copilot SDK lässt sich vor der Installation eines MCP-Servers oder eines Skills eine menschliche Prüfung vorschreiben. Je selbstständiger ein Agent handelt, desto stärker muss die Kontrolle außerhalb des Agenten selbst liegen.
Der Agent wird auch zu einem Teammitglied mit eigener Identität. Die Profiles von Perplexity machen einen Agenten zu einer versionierten Konfiguration, die ein ganzes Projekt wiederverwenden kann. Die Team Bots von SpaceXAI besitzen eine eigene Slack-Kennung und führen für jeden Nutzer getrennte Erinnerungen. Agenten von Cue erhalten eine E-Mail-Adresse, eine Telefonnummer und ein Wallet. Wenn ein Agent im Namen einer Person bezahlen, anrufen oder schreiben kann, werden die Kontrollfragen, die NVIDIA am selben Tag aufwirft, sehr konkret.
Schließlich müssen die Zahlen des Tages genau gelesen werden. Devin misst Sonnet 5.5 auf einer Variante von FrontierCode, die im Tweet anders heißt als in der zugehörigen Grafik; zwei am selben Tag veröffentlichte Grafiken von Cognition nennen unterschiedliche Werte für Opus 5.5. Holo4 wird im Harness von H in einem einzigen Durchlauf auf OSWorld 2.0 gemessen. Die 73 % von SAIL werden in der Simulation erzielt, und die Lücke zwischen Simulation und Realität ist gerade Gegenstand des ersten Experiments von ProjectSim. Bei den Medienmodellen stützt sich Eleven v4 auf ein externes Ranking und Blindtests, während Kling 4.0 ohne Benchmark und Preisangabe erscheint und einige seiner Funktionen erst später folgen sollen.
Quellen
- Vorstellung von Claude Sonnet 5.5 (Anthropic)
- Migrationsleitfaden für Claude Sonnet 5.5
- @ClaudeDevs: Empfehlungen zum Aufwand für Sonnet 5.5
- Claude Sonnet 5.5 in GitHub Copilot
- Modelle und Preise von GitHub Copilot
- Claude Sonnet 5.5 in Devin
- @cognition: Sonnet 5.5 auf FrontierCode 1.1 Main
- @cursor_ai: Sonnet 5.5 in Cursor
- @v0: Sonnet 5.5 in v0
- NVIDIA stellt Open Agent Safety Platform vor (Pressemitteilung)
- Architektur der Open Agent Safety Platform (NVIDIA)
- Laufzeitkontrollen für KI-Agenten mit NVIDIA OpenShell hinzufügen
- @NVIDIAAI: Jensen Huang auf CNBC
- @togethercompute: Partner zum Start
- @perplexity_ai: Partnerschaft mit NVIDIA
- Vorstellung von Manus 2.0
- @ManusAI: Start von Cue
- @ManusAI: Telefonnummern für Agenten
- Vorstellung von Eleven v4 (ElevenLabs)
- @ElevenLabs: Ankündigungs-Thread zu Eleven v4
- Versionshinweise zu Kling 4.0
- @Kling_ai: Ankündigung von Kling 4.0
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- Devin ist jetzt bis zu 40 % kosteneffizienter
- Versionshinweise zu Devin vom 25. September
- @cognition: Beta von Devin Mobile
- @zeddotdev: Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- Agent API unterstützt jetzt wiederverwendbare Agenten (Perplexity)
- Changelog der Perplexity API
- Team Bots (SpaceXAI)
- @bot: Ankündigung von Team Bots
- Holo4 im Hugging Face-Blog
- Holo4 (H Company)
- SAIL (Sakana AI)
- Projektseite von SAIL
- Robotik-Benchmarks: Stand und nächste Schritte (ProjectSim)
- Hallo, Deutschland! (Mistral AI)
- Wie NVIDIA DSX MaxLPS Durchsatz und Effizienz von KI-Fabriken maximiert
- DeepSeek Harness 0.2.0-rc.1
- Pixel Canary auf Vercel AI Gateway
- Termin für die Durchsetzung der Versionen selbst gehosteter Runner verschoben (GitHub)
- Technischer Bericht zu NexteraBERT
- Sprechende Figuren in Echtzeit aus einem Videodiffusionsmodell mit 22 Milliarden Parametern
- SCRIBE (Adalat AI)
- JEV: 228 ausgewählte Projekte (Eric Kang)
- @HeyGen: Leitfaden zu Jev und HeyGen MCP
- Vier Projekte mit Gemini 3.8 Flash (Google)
- Drei Wege, wie dieser Lebensmittelhändler mit Gemini für 200 Gäste kocht (Google)
- Lenfest AI Collaborative: nächste Phase (OpenAI)
- Versionshinweise zu ChatGPT
- @OpenAIDevs: Gewinner des WebMCP Challenge
- ChatGPT- und Codex-Changelog: CVE-2026-100754