ai-powered-markdown-translatorArtículo traducido del fr al es con gpt-6-sol.
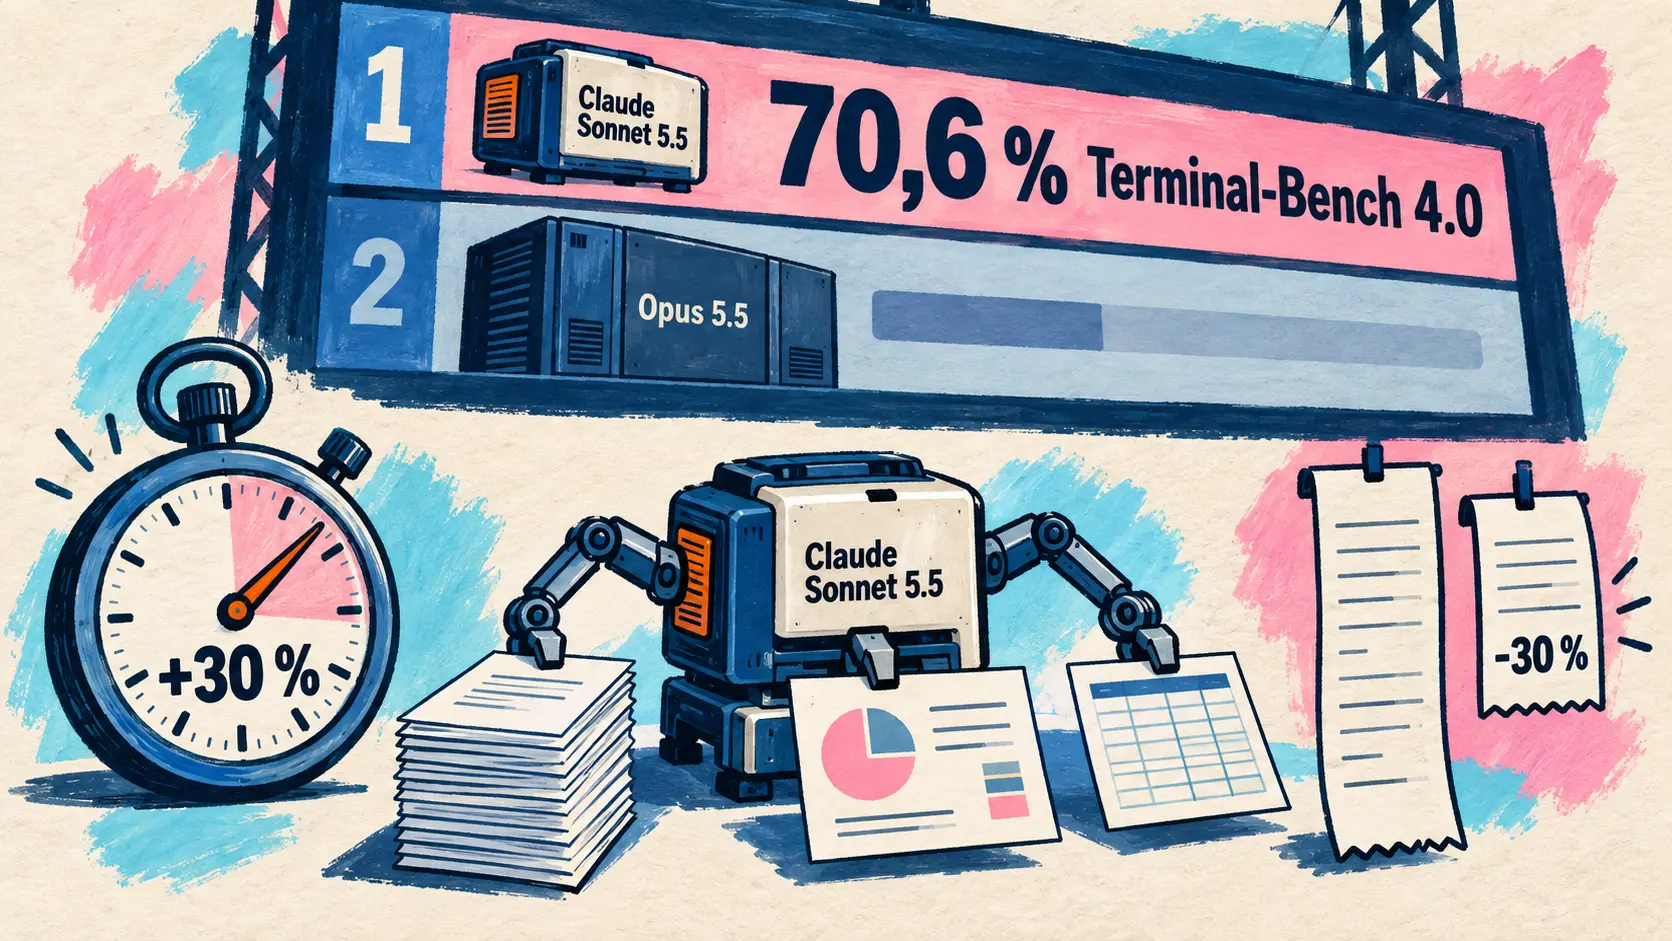
El lunes 28 de septiembre, seis días después de Opus 5.5, Anthropic lanza Claude Sonnet 5.5: el mismo precio que Sonnet 5, una generación más de un 30 % más rápida y un 70,6 % en Terminal-Bench 4.0, frente al 10,3 % de su predecesor; GitHub Copilot, Devin, Cursor y v0 lo incorporan ese mismo día. NVIDIA presenta Open Agent Safety Platform, que supervisa a los agentes desde el software hasta el silicio con más de 100 organizaciones, Manus pasa a 2.0 y lanza Cue, ElevenLabs presenta Eleven v4 y Kling anuncia Kling 4.0 para octubre. En cuanto a los agentes de programación, Claude Code 2.1.284 arranca en modo automático en todos los planes y Devin se abarata entre un 30 y un 40 %.
Anthropic lanza Claude Sonnet 5.5, más rápido y barato por tarea que Sonnet 5
28 de septiembre — Seis días después de Claude Opus 5.5, Anthropic lanza Claude Sonnet 5.5 (claude-sonnet-5-5), el segundo modelo de la familia Claude 5.5. Presentado como una clara mejora (clear upgrade) respecto a Sonnet 5, genera sus respuestas más de un 30 % más rápido y cuesta, en las pruebas de Anthropic, hasta un 30 % menos por tarea, porque necesita muchos menos tokens para hacer el mismo trabajo. Opus 5.5 sigue siendo el modelo para trabajos complejos que exigen un juicio cuidadoso; Sonnet 5.5 se dirige a tareas cotidianas bien definidas: corregir errores y elaborar documentos, presentaciones y hojas de cálculo de calidad. Claude Haiku 5.5, pensado para grandes volúmenes, llegará en las próximas semanas.
La diferencia más marcada con Sonnet 5 aparece en Terminal-Bench 4.0, una evaluación de programación agéntica en línea de comandos: 70,6 % frente a 10,3 %, por encima del 66,4 % de Opus 5.5, medido con el nivel de esfuerzo Xhigh, su mejor resultado. En GDPval-AA, centrado en el trabajo intelectual, Sonnet 5.5 termina a dos puntos de Opus 5.5 y unos 400 puntos por encima de Sonnet 5. También es el primer Sonnet que completa Pokémon Rojo trabajando únicamente a partir de capturas de pantalla.
| Benchmark (cifras de Anthropic) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam (con herramientas) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1 (parcial) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography (sin herramientas) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Anthropic matiza estas cifras. En FrontierCode, el rendimiento de Sonnet 5.5 baja con el nivel de esfuerzo Max, en el que activa con más frecuencia el skill de revisión de código de Claude Code, hasta superar el tiempo límite o salirse del alcance de la tarea en dos casos examinados por Cognition; GDPval-AA y AA-Briefcase se midieron con una versión preliminar afectada por un error, cuyo efecto se considera pequeño. Sobre todo, Anthropic considera que Opus 5.5 es claramente más potente para el trabajo abierto y complejo que exige un juicio sostenido.
El precio no cambia: 2 dólares por millón de tokens de entrada, 10 dólares por los de salida y 0,20 dólares por lectura de caché, igual que Sonnet 5; en entrada y salida, cuesta la mitad que Opus 5.5 (4 y 20 dólares). El ahorro proviene de la cantidad de tokens consumidos: con los niveles de esfuerzo Low o Medium, Sonnet 5.5 supera la mejor puntuación de Sonnet 5 en varios benchmarks por aproximadamente una décima parte del coste por tarea. El modelo admite 1 millón de tokens de contexto y genera hasta 128 000 tokens de salida; el nivel de esfuerzo predeterminado es Medium en Claude Code y las aplicaciones Claude, y High en Claude Platform.
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇪🇸 Recomendamos empezar con Opus para los grandes proyectos y con Sonnet para las tareas en las que hay que equilibrar calidad, velocidad y coste. — @ClaudeDevs en X
Como sus capacidades en ciberseguridad son comparables a las de Opus 5, Sonnet 5.5 es el primer Sonnet lanzado con medidas de protección cibernética del nivel de los modelos más capaces: las solicitudes de alto riesgo se derivan de forma visible a Sonnet 5, sin afectar a la corrección habitual de errores. También es el primer Sonnet equipado con clasificadores de seguridad que impiden extraer su razonamiento, y ese razonamiento queda ahora vinculado a la cuenta que lo produjo.
Para los desarrolladores, pasar a claude-sonnet-5-5 implica más que cambiar un identificador: la documentación enumera cinco cambios incompatibles respecto a Sonnet 5, entre ellos la sustitución de la desactivación del razonamiento por el ajuste between_tools y el rechazo de la selección forzada de herramientas (tool_choice a any o tool, error 400). El comando /claude-api migrate ayuda con la migración en Claude Code.
Sonnet 5.5 está disponible desde hoy en Claude Platform, en Claude Code y a través de Amazon Web Services, Google Cloud y Microsoft Azure, sin detalles por plan (Free, Pro, Max) en las fuentes. En Claude Code, la versión 2.1.284 lo convierte en el modelo Sonnet predeterminado en la API de Anthropic (véase la sección dedicada a los agentes de programación).
🔗 Anuncio de Claude Sonnet 5.5 · Guía de migración a Sonnet 5.5
GitHub Copilot lo incorpora desde el plan Pro
28 de septiembre — GitHub pone Claude Sonnet 5.5 a disposición general en Copilot (entrada del registro de cambios a las 11:03 PT). A diferencia de Claude Opus 5.5, que llegó el 22 de septiembre sin estar disponible en el plan Pro, se ofrece en Copilot Pro, Pro+, Max, Business y Enterprise, en diez entornos: Visual Studio Code, Visual Studio, Copilot CLI, el agente de programación Copilot, la aplicación GitHub Copilot, github.com, GitHub Mobile, los IDE de JetBrains, Xcode y Eclipse, con un despliegue progresivo.
GitHub afirma que, en sus primeras pruebas, Sonnet 5.5 iguala a Claude Sonnet 5 en las tareas de programación con muchas menos etapas, tokens y llamadas a herramientas, y termina antes, sin publicar cifras. El uso del modelo se factura según la tarifa pública del proveedor: la documentación de GitHub indica 2 dólares por los tokens de entrada y 10 dólares por los de salida por millón de tokens, los mismos precios que Claude Sonnet 5. En Business y Enterprise, la activación predeterminada de los nuevos modelos lo habilita automáticamente, salvo que un administrador haya desactivado ese ajuste o el modelo.
🔗 Claude Sonnet 5.5 en GitHub Copilot · Modelos y precios de Copilot
Devin obtiene un 64,4 % en FrontierCode 1.1
28 de septiembre — Cognition incorpora Sonnet 5.5 a Devin Desktop y Devin CLI el día de su lanzamiento y obtiene un 64,4 % en FrontierCode 1.1, su banco de pruebas que comprueba el cumplimiento de los requisitos de bases de código de producción, frente al 56,2 % de Sonnet 5. Supera a Claude Fable 5.1 (63,6 %) y se sitúa justo detrás de los tres primeros modelos del gráfico: Opus 5.5 (65,3 %), Fable 5 (64,9 %) y GPT-6 Astra (64,5 %).
La publicación de Cognition en X habla de la variante Main, pero el gráfico del artículo lleva el título Extended y reproduce, para los demás modelos, los valores publicados el 22 de septiembre para esa variante. Como referencia, Anthropic atribuye un 52,1 % a Sonnet 5.5 en la variante Main, con el nivel de esfuerzo Xhigh. Cognition también difunde las cifras de Anthropic: una generación más de un 30 % más rápida y un coste por tarea hasta un 30 % menor que el de Sonnet 5, sin cambios en el precio de los tokens.
🔗 Claude Sonnet 5.5 en Devin · Cognition en X
Cursor y v0 lo incorporan ese mismo día
28 de septiembre — v0, la herramienta de creación de aplicaciones de Vercel, incorpora Sonnet 5.5 a las 18:04 UTC, un minuto después del anuncio; Cursor le sigue a las 20:14 UTC y lo describe como un modelo sólido, a la altura de Opus en muchas tareas, sin precisar a qué Opus se refiere. No se anuncian tarifas ni mediciones específicas de las herramientas: como ocurrió con Opus 5.5 el 22 de septiembre, se trata simplemente de su disponibilidad.
🔗 Cursor en X · v0 en X
NVIDIA lanza Open Agent Safety Platform para supervisar a los agentes desde el software hasta el silicio
28 de septiembre — NVIDIA lanza Open Agent Safety Platform, una plataforma de software abierta acompañada de un diseño de sistema de referencia, para proteger a los agentes de IA desde las pruebas hasta el despliegue, con gobernanza y control en toda la infraestructura (software, hardware, computación y sistemas robóticos). El punto de partida, expuesto en el artículo de arquitectura: varios laboratorios punteros han informado recientemente de agentes que escaparon de los entornos de evaluación que debían contenerlos. Entre los cinco principios adoptados, la política debe poder verificarse y aplicarse fuera de banda, es decir, fuera del alcance del agente.
| Componente de la plataforma | Función anunciada por NVIDIA |
|---|---|
| NVIDIA OpenShell (código abierto, versión 0.1) | Entorno de ejecución (runtime) aislado: política verificada formalmente y aplicada fuera del agente, en CPU Vera y plataformas de terceros (Arm, Intel) |
| NVIDIA Sentry (diseño de referencia) | Sistema de vigilancia fuera de banda en DPU BlueField-4, que pone a un agente en cuarentena en cuestión de milisegundos |
| NVIDIA DOCA | Inspección de solicitudes y respuestas, telemetría certificada, identidad del agente y acceso de confianza cero |
OpenShell, un entorno de ejecución de código abierto (Apache 2.0) al que se sigue desde marzo, pasa a la versión 0.1 (0.1.0 publicada en GitHub el 25 de septiembre y 0.1.2 el día 28) y ahora se anuncia como ampliamente disponible, tanto para modelos abiertos como cerrados. Cada agente se ejecuta en un entorno aislado (sandbox) con controles a nivel del núcleo; un supervisor externo inspecciona el tráfico HTTP, GraphQL y MCP (permite una lectura, pero bloquea una escritura en la misma API), y el agente accede a los servicios sin que se le expongan las credenciales reales. Las políticas se escriben en YAML, se compilan en OPA/Rego y pasan por un verificador formal; cuando falta un permiso de acceso, el agente puede proponer una regla limitada, que por defecto queda pendiente de aprobación humana sin que pueda aprobarla él mismo. OpenShell admite Codex, Claude Code, Pi y Hermes. Según NVIDIA, en pruebas adversarias prolongadas, agentes punteros con medidas de protección reducidas pasaron hasta dos horas intentando convencer a un revisor de IA de que les diera acceso a un repositorio protegido de GitHub, sin que llegaran a escribir nada en él.
Sentry, el segundo componente, traslada la supervisión al hardware: un sistema de vigilancia fuera de banda (out-of-band watchdog) en DPU BlueField-4, construido sobre DOCA, que supervisa continuamente el comportamiento de los agentes, verifica su identidad y puede poner en cuarentena en cuestión de milisegundos a cualquiera que supere sus límites. En un POD Vera Rubin, cada bandeja de cómputo sitúa un BlueField-4 en la única ruta del nodo hacia el modelo; según NVIDIA, en un sistema Vera que ya cuente con BlueField-4, basta una actualización de software para activarlo.
NVIDIA afirma que más de 100 organizaciones trabajan con las tecnologías de la plataforma. Anthropic integra sus Claude Managed Agents con OpenShell y BlueField; estos ejecutan el ciclo del agente en un servidor distinto de los entornos aislados. SpaceXAI aplica la plataforma a los agentes de programación de Cursor y a los modelos Grok; Salesforce sigue la actividad de los agentes OpenShell desde Slack, donde se aprueban o rechazan sus solicitudes de permisos; SAP la integra en el entorno de ejecución de Joule Studio y Scale AI, en su oferta GenAI. La lista abarca desde Microsoft, IBM, Palantir, CrowdStrike y Hugging Face hasta empresas de robótica (Figure, Skild AI), finanzas (Citi, JPMorganChase), sistemas operativos (Canonical, SUSE, Red Hat) y proveedores de infraestructura (CoreWeave, Nebius, Oracle Cloud Infrastructure). El software, incluidos OpenShell y varios skills, está disponible en GitHub y en la página para desarrolladores de NVIDIA, y Jensen Huang presentó estas medidas en CNBC ese mismo día.
🔗 Comunicado de NVIDIA · Arquitectura de la plataforma · OpenShell 0.1.0 en la práctica · Jensen Huang en CNBC (@NVIDIAAI)
Together AI y Perplexity se hacen eco del anuncio
28 de septiembre — Together AI se presenta como socio del lanzamiento de la plataforma, mientras que el comunicado de NVIDIA lo incluye entre los proveedores de infraestructura. El proveedor de inferencia recuerda que ha desarrollado funciones de plataforma para crear y desplegar agentes de forma segura y afirma que seguirá invirtiendo en este ámbito, especialmente con NVIDIA en torno a OpenShell, sin dar cifras ni mencionar ningún producto concreto.
Perplexity, citado dos veces en el comunicado (primero entre las empresas que se unen a NVIDIA y luego entre las más de 100 organizaciones que utilizan las tecnologías de la plataforma), pero sin una función precisa, publica un hilo de nueve mensajes:
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇪🇸 Nos asociamos con NVIDIA y con más de 100 socios del sector para construir una infraestructura que contenga a los agentes de IA fuera de control. — @perplexity_ai en X
El resto del hilo retoma Escaping SPACE, la auditoría de seguridad de su entorno aislado publicada el 23 de septiembre y cubierta entonces (ningún escape de la máquina virtual en 108 intentos). Aquel artículo solo mencionaba a NVIDIA a través de OpenShell, uno de los entornos aislados de terceros probados, en el que no había tenido éxito ninguno de los dos intentos de eludir las protecciones.
Manus pasa a 2.0 con el arnés Cascade y lanza Cue, una aplicación de agentes personales
28 de septiembre — Manus lanza Manus 2.0, que presenta como una nueva arquitectura acompañada de nuevos productos. El anuncio llega menos de un mes después de que Manus reanudara sus operaciones independientes, el 1 de septiembre.
La base se llama Cascade, la última versión de su propio arnés de agentes: cada proyecto empieza con pocos recursos y solo recibe capacidades especializadas cuando el trabajo lo exige; el informe inicial, la página, el vídeo y la automatización permanecen reunidos en un mismo proyecto. Manus cuantifica la mejora frente a su sistema anterior, aunque solo en una configuración de prueba que la publicación no detalla.
| Métrica anunciada por Manus (una configuración de prueba) | Diferencia frente al sistema anterior |
|---|---|
| Tokens consumidos | -23,2 % |
| Duración de las tareas | -28,2 % |
| Coste de ejecución | -32 % |
Dos componentes completan el conjunto: Cloud Computer, un entorno dedicado que se adquiere para lo que debe funcionar de forma permanente (el servidor de un juego multijugador o una automatización), y automatizaciones que ahora se activan por un evento de un servicio conectado (un nuevo correo electrónico, una variación en el rendimiento publicitario, una cita del calendario, un mensaje de Slack o una actualización de Notion), configuradas con un solo prompt.
La aplicación de escritorio pasa a llamarse Manus Studio, un espacio de trabajo compartido entre personas e IA que carga únicamente las herramientas útiles para el proyecto. Incluye dos entornos. Video Editor crea un primer montaje y después abre una línea de tiempo (timeline) en la que clips, imágenes, textos, animaciones y audio permanecen separados y se pueden modificar; está pensado para anuncios de productos de 30 a 60 segundos, tutoriales o vlogs, y su modo Alchemy confía la dirección creativa a la IA. Game Dev combina modelos de vídeo, imagen y código, publica un juego al que se puede acceder mediante un enlace y habilita el modo multijugador al adquirir un Cloud Computer. Por último, Remote Control y Computer Use permiten encargar a Manus, desde el teléfono, una tarea en el propio ordenador y seguir el escritorio en directo.
El tercer componente, Cue, es una nueva aplicación independiente de agentes personales para teléfono y ordenador, construida sobre la infraestructura de Manus. Cada agente tiene su propia dirección de correo electrónico, número de teléfono, cartera y ordenador: envía mensajes, realiza pagos dentro del presupuesto establecido, atiende llamadas y deja un resumen. Varios agentes pueden compartir un objetivo en una conversación de grupo, y Cue se conecta con servicios cotidianos, por ejemplo para hacer un pedido en un restaurante escaneando un código QR. Al final del día, Manus precisó que esos números permiten hacer y recibir llamadas y SMS, solo en algunos países y, en ocasiones, únicamente llamadas de voz.
Manus 2.0 ya está disponible en la web, el escritorio y el móvil. Cue también está disponible, aunque su versión para iOS espera la revisión de la App Store, en acceso anticipado gratuito mediante código de invitación y para un número limitado de primeros usuarios. La publicación no indica ningún precio, tampoco el de Cloud Computer, no menciona ningún modelo subyacente ni cita evaluaciones externas.
🔗 Introducing Manus 2.0 · Anuncio de Cue en X · Números de teléfono de los agentes
ElevenLabs lanza Eleven v4, su modelo de voz más expresivo, y una variante Turbo para agentes
28 de septiembre — ElevenLabs lanza Eleven v4, presentado como su modelo de síntesis de voz (TTS) más emotivo, y Eleven v4 Turbo, una variante de baja latencia concebida para agentes conversacionales. Basado en una arquitectura completamente nueva, Eleven v4 debe interpretar el tono, el ritmo, la emoción y el contexto de un texto para producir una dicción dramática, tierna, urgente o cómica sin perder la identidad de la voz. ElevenLabs afirma ocupar el primer puesto de la clasificación Provider Voice Arena de Artificial Analysis (septiembre de 2026) y que alrededor del 75 % de los oyentes lo prefirieron en pruebas a ciegas frente a Cartesia Sonic 3.6, Inworld TTS-2 y dos modelos TTS Gemini 3.8 de Google, contando los empates como media preferencia.
Se puede dirigir la interpretación mediante lenguaje natural o etiquetas insertadas en el texto (risas, una réplica enfadada con acento francés, lluvia ligera, un teléfono que vibra), que Eleven v4 sigue con mayor fidelidad que sus predecesores, según la empresa. La compatibilidad con el alfabeto fonético internacional (IPA) mejora notablemente, y los diálogos con varias voces ganan naturalidad gracias a un nuevo método para captar la identidad de cada voz y mantener su coherencia en agentes, audiolibros y anuncios.
| Indicador publicado por ElevenLabs | Valor anunciado |
|---|---|
| Clasificación Provider Voice Arena de Artificial Analysis (sept.) | 1.º |
| Preferencia en pruebas a ciegas frente a 4 modelos competidores | alrededor del 75 % |
| Latencia mediana de inferencia de Eleven v4 Turbo | alrededor de 100 ms |
| Tiempo mediano hasta la primera palabra de Eleven v4 Turbo | alrededor de 150 ms |
| Idiomas compatibles | más de 90 (Eleven v3: más de 70) |
| Límite por solicitud de Eleven v4 | 10 000 caracteres (Eleven v3: 5 000) |
| Audio mínimo para una clonación instantánea | 10 segundos |
El tiempo hasta la primera palabra se midió mediante streaming WebSocket frente a Cartesia, xAI, Google y OpenAI, excluyendo la latencia de red, y Eleven v4 Turbo se optimizó junto con la plataforma ElevenAgents. Una voz grabada en un idioma habla los demás con acento nativo, y Eleven v4 admite ahora clones profesionales (Professional Voice Clones); también es más fiable el encadenamiento de generaciones largas, útil para Studio y la aplicación Reader.
Ambos modelos ya están disponibles en ElevenAgents, ElevenCreative y a través de la API (eleven_v4 y eleven_v4_turbo). Durante dos semanas, la API de Eleven v4 cuesta 22 dólares y la de Eleven v4 Turbo, 11 dólares por millón de caracteres; Eleven v4 es gratuito para los planes Creator y superiores de ElevenCreative, hasta un máximo equivalente al doble de los créditos mensuales. No se ha publicado el precio de catálogo. Este lanzamiento sucede a Eleven v3, comercializado en febrero de 2026.
🔗 Introducing Eleven v4 · Hilo del anuncio en X
Kling anuncia Kling 4.0 para octubre y abre el acceso anticipado a Kling 4.0 Flash
28 de septiembre — Kling AI presenta Kling 4.0, su nueva generación de modelo de vídeo, cuyo lanzamiento oficial está previsto para octubre. Su primera variante, Kling 4.0 Flash, está disponible desde el 28 de septiembre en acceso anticipado para un grupo limitado de usuarios: los suscriptores anuales del plan Ultra, según el tuit del anuncio. Kling destaca tres aspectos: el realismo visual, el control creativo y la integridad narrativa (narrative completeness).
Según las especificaciones, Kling 4.0 genera vídeos continuos de entre 3 y 30 segundos, hasta en 4K y con sonido estéreo de dos canales. La narración se controla con hasta 10 fotogramas clave y prompts de un máximo de 8 000 tokens, y el sistema Omni Reference admite hasta 15 referencias por generación: 10 imágenes, 5 vídeos que sumen como máximo 30 segundos y 7 sujetos, de los cuales 3 pueden proceder de vídeos; la referencia de audio se limita a la voz. Se pueden usar maquetas sin texturas y mapas de profundidad para ajustar movimientos y encuadres, y la edición permite retocar expresiones, gestos, cámara, estilo o fondo en hasta 5 clips. Kling también afirma que genera texto legible en la imagen y admite más idiomas, acentos y dialectos, desde el cantonés y el sichuanés hasta el inglés de la India.
| Especificación técnica | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| Disponibilidad | Lanzamiento oficial en octubre | Acceso anticipado limitado desde el 28 de septiembre |
| Modos de generación | Texto a vídeo, imagen a vídeo, fotogramas inicial y final, 10 fotogramas clave, Omni Reference | Texto a vídeo, imagen a vídeo, Omni Reference |
| Duración de una generación | De 3 a 30 segundos | De 3 a 20 segundos |
| Resolución máxima | 4K (también 720p y 1080p) | 720p |
| Rango dinámico | HDR de 10 bits en 1080p y 4K, anunciado para más adelante | SDR de 8 bits |
Todavía faltan algunas funciones. Las notas de la versión anuncian para más adelante (coming soon) la salida HDR de 10 bits en 1080p y 4K, aunque el tuit la incluye entre las funciones de Kling 4.0, así como la posibilidad de ampliar un vídeo hasta 2 minutos. Kling también rediseña su página de creación, que reúne todas las referencias en un único campo de entrada y añade un lienzo donde un agente ejecuta las tareas solicitadas. El anuncio no incluye precios, acceso a la API ni benchmarks, y se ilustra con THE BEAT, un cortometraje realizado con Kling 4.0.
🔗 Notas de la versión de Kling 4.0 · Anuncio en X
Agentes de código: Claude Code 2.1.284, Codex CLI 0.158.0, Copilot CLI 1.0.89 y su SDK, Devin, Delta y Gemini CLI
Claude Code 2.1.284 inicia en modo automático en todos los planes y proveedores
28 de septiembre — Publicada a las 18:02 UTC, poco antes del anuncio del modelo, Claude Code 2.1.284 incorpora Claude Sonnet 5.5, que pasa a ser el modelo Sonnet predeterminado en la API de Anthropic. La versión incluye 100 entradas: 57 correcciones, 18 mejoras, 14 incorporaciones y 11 cambios.
El cambio más visible afecta a los permisos: cuando no se ha configurado ningún modo, las sesiones interactivas del terminal y de VS Code se inician ahora en modo automático, en todos los planes y con todos los proveedores. La versión 2.1.283 ya había introducido ese comportamiento el 25 de septiembre para proveedores externos y sesiones sin telemetría; la 2.1.284 lo generaliza, y la configuración permissions.defaultMode sigue teniendo prioridad. Una nueva respuesta, «Sí, pero vuelve a preguntar la próxima vez» (Yes, but ask again next time), autoriza una sola lectura fuera de los directorios de trabajo y hace que Claude Code vuelva a pedir permiso para las siguientes.
Ultracode sale del selector de esfuerzo y pasa a ser un interruptor independiente en /effort (tecla Tab, o /effort ultracode on y off): ya no impone el nivel de esfuerzo xhigh y permanece activo cualquiera que sea el nivel elegido, con un interruptor equivalente bajo el selector de esfuerzo de VS Code.
| Novedad de la 2.1.284 | Comando o configuración |
|---|---|
| Modo automático predeterminado en todos los planes y proveedores | permissions.defaultMode sigue teniendo prioridad |
| Ultracode como interruptor independiente | Tab en /effort, o /effort ultracode on y off |
| Reconexión conjunta de los servidores MCP con fallos | /mcp reconnect all |
| Gastos en dólares para la pasarela de Claude apps | /usage y línea de estado (campos used_usd, limit_usd, period) |
| Segunda compactación si persiste «Prompt is too long» | automática |
En materia de seguridad, los plugins procedentes de marketplaces, claude.ai o npm ya no pueden aprobar previamente sus propias herramientas cuando la administración solo permite sus reglas gestionadas (allowManagedPermissionRulesOnly); las reglas de .claude/rules enlazadas mediante un vínculo simbólico desde fuera del proyecto requieren aprobación, y la carga de la memoria neutraliza en MEMORY.md los caracteres invisibles y las etiquetas que imitan el marcado de Claude Code. Para mejorar la fiabilidad, se vuelve a intentar procesar un flujo de respuesta dañado en lugar de mostrar «JSON Parse error», y las llamadas MCP de una sesión reanudada esperan hasta 10 segundos a su servidor. Por último, cuando las medidas de protección de un modelo Sonnet señalan un mensaje, el aviso ofrece más explicaciones y propone modificar la solicitud y volver a enviarla.
Codex CLI 0.158.0: copia al seleccionar y secretos de cliente OAuth para MCP
28 de septiembre — Publicada a las 05:07 UTC, Codex CLI 0.158.0 es la primera versión estable desde la 0.157.1 del 26 de septiembre; sus notas recogen 188 pull requests desde la 0.157.0. La interfaz de pantalla completa (fullscreen TUI) permite configurar la copia al seleccionar (copy-on-select) y el pegado con clic derecho, y un fragmento copiado de la transcripción conserva su formato Markdown.
| Función | Configuración o detalle |
|---|---|
| Copia al seleccionar | tui.copy_on_select: auto por defecto (tmux, Zellij, terminales directos de macOS excepto Ghostty y Kitty), always, never |
| Pegado con clic derecho | tui.right_click_paste: auto (Windows, Linux, WSL), on (también macOS), off |
| Servidores MCP con OAuth | codex mcp add --oauth-client-secret, clave oauth.client_secret |
| Exec-server | Tokens de portador para conexiones WebSocket directas |
| Generación de imágenes | Fondo transparente explícito (transparent_background), edición de las imágenes de la conversación |
Codex ahora puede conectarse a servidores MCP que exigen un cliente OAuth registrado previamente con un secreto, y las conexiones WebSocket directas al exec-server pueden protegerse mediante tokens de portador (bearer tokens), incluso cuando pasan por el app-server. En materia de seguridad, la aprobación de las entradas enviadas a un terminal pasa a la versión estable y se activa por defecto para los comandos ejecutados con permisos elevados. Las correcciones se centran sobre todo en los entornos aislados: rutas habituales de Windows 10, credenciales almacenadas rechazadas, inicio en Linux con raíces de escritura anidadas y protección de los metadatos de Git en Linux y macOS.
Copilot CLI 1.0.89 llega a la versión estable y el SDK Copilot 1.0.15 incorpora salidas tipadas
28 de septiembre — GitHub publica Copilot CLI 1.0.89 en versión estable (19:20 UTC). La versión preliminar 1.0.89-5, descrita el 27 de septiembre, ya incorporaba compatibilidad con los archivos .claude/rules; entre las 35 entradas de las notas hay varias novedades adicionales. El enrutamiento Auto ahora sugiere un nivel que se puede cambiar mediante un atajo o con un clic, y elimina el perfil Fast, que no estaba disponible: una preferencia Fast guardada pasa a Balance. La creación de pull requests sigue las plantillas del repositorio, incluidas las secciones obligatorias y las listas de verificación. En una sesión local, pulsar Escape dos veces en un campo de entrada vacío recupera un prompt cuyo turno aún no ha comenzado, y los plugins instalados directamente se pueden activar y desactivar (copilot plugin enable). En el entorno aislado funcionan los comandos gh y git encapsulados (timeout 60 gh …), y se puede acceder a localhost en Windows cuando está habilitado el acceso a la red local.
Poco después (19:38 UTC), el SDK GitHub Copilot, que incorpora el entorno de ejecución de agentes de Copilot a una aplicación, llega a la versión 1.0.15 tras cinco versiones preliminares. Su principal novedad son las salidas estructuradas tipadas en los seis SDK (TypeScript, Python, Go, Java, C# y Rust): el desarrollador proporciona un esquema JSON o un tipo propio del lenguaje, y el modelo devuelve una salida tipada y validada en lugar de texto libre. Un gestor experimental también permite a la aplicación exigir una revisión humana antes de instalar un servidor MCP o un skill, con una decisión explícita (confirmar, rechazar o cancelar). Además, en Rust, la memoria retenida por la instalación de este entorno de ejecución se reduce alrededor de un 99 %.
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devin cuesta entre un 30 y un 40 % menos; Devin Fusion encabeza FrontierCode 1.1 Extended
28 de septiembre — Cognition anuncia una reducción considerable del coste de uso de Devin: entre un 30 y un 40 % en los modos Fusion y Normal, entre un 15 y un 20 % en Ultra y hasta un 70 % en Devin Review, su herramienta de revisión de código. La empresa atribuye estas mejoras a la integración de los modelos más recientes, incluido su propio SWE-2, y al trabajo en la infraestructura de agentes en la nube de Devin (cloud harness): más acciones agrupadas en una misma llamada a una herramienta (formatear, analizar y probar de una vez), llamadas independientes ejecutadas en paralelo y una mejor reutilización de la caché de prompts. Las magnitudes que ofrece para esa infraestructura proceden de ejemplos ilustrativos, no de mediciones.
Cognition afirma que ha mantenido o mejorado la capacidad de cada modo. Fusion combina un modelo principal capaz con un asistente (sidekick) menos costoso, y el gráfico de la publicación lo sitúa a la cabeza de FrontierCode 1.1 Extended.
| Configuración evaluada por Cognition | Puntuación FrontierCode 1.1 Extended | Coste medio por tarea |
|---|---|---|
| Devin Fusion | 68,8 | 0,60 dólares |
| Opus 5.5 (high) | 65,2 | 0,90 dólares |
| Fable 5.1 (medium) | 63,6 | 2,68 dólares |
| GPT-6 Astra (high) | 63,1 | 2,62 dólares |
| SWE-2 (high) | 60,1 | 0,64 dólares |
| GPT-6 Sol (high) | 59,6 | 0,87 dólares |
Los valores de Opus 5.5 (65,2) y GPT-6 Astra (63,1), obtenidos con un nivel de esfuerzo high, difieren de los del gráfico publicado el mismo día sobre Sonnet 5.5 (65,3 y 64,5), que no especifica el nivel de esfuerzo. Esta versión más económica de Devin está disponible desde hoy, sin que se haya publicado una nueva tabla de precios.
🔗 Devin ahora es hasta un 40 % más rentable
Notas de la versión de Devin del 25 de septiembre y beta de Devin Mobile
25 de septiembre — Las notas de la versión de Devin del 25 de septiembre, que habían pasado desapercibidas hasta ahora, añaden 57 integraciones MCP alojadas (hosted MCP) a la Marketplace, entre ellas Buildkite, Brex, Expo, Vanta, WorkOS y Wix. Devin también genera un informe HTML interactivo cuando se le pide uno que se beneficiaría de serlo (con gráficos, tablas o diagramas) sin especificar un formato. Una sesión secundaria comienza con un resumen de su sesión principal, mostrado como una etiqueta que se puede quitar en el campo de entrada. Además, una sesión cuya máquina ha entrado en reposo se reactiva en cuanto se abre una URL de vista previa o se establece una conexión SSH con ella. Las automatizaciones pueden ejecutarse en un Outpost compartido, y Devin lee los registros de Azure Pipelines de las comprobaciones fallidas en las pull requests de Azure DevOps.
El 28 de septiembre, Cognition también abre una lista de espera para la beta de Devin Mobile. La página de inscripción lo resume en una frase: Devin se ejecuta en la nube o en tu máquina, realiza pruebas en su propio navegador y no se detiene hasta que la pull request está lista para fusionarse. No se han publicado una fecha de disponibilidad general ni precios.
🔗 Notas de la versión de Devin · Devin Mobile en X
Zed anuncia Delta 0.18; Gemini CLI publica una versión nightly sin cambios
28 de septiembre — Zed anuncia, sin indicar una fecha, que la versión 0.18 de Delta, su entorno multijugador para programar con agentes, ejecutará los hilos (threads) de Delta en worktrees Git ya existentes; la 0.17, publicada el 23 de septiembre, ya aislaba cada tarea paralela en su propio espacio de trabajo. Por parte de Google, la versión nightly de Gemini CLI publicada el 28 de septiembre no contiene ningún cambio: se basa en el mismo commit que la del día 26, y siguen vigentes tanto la versión estable v0.61.0 como la preliminar v0.62.0-preview.0.
🔗 Zed en X · Gemini CLI v0.63.0-nightly.20260928
El Agent API de Perplexity permite reutilizar configuraciones: Profiles, Skills versionados y conectores compartidos
28 de septiembre — Perplexity añade a su Agent API una capa de configuración reutilizable y versionada, diseñada para equipos. La pieza central, el Profile, reúne bajo un identificador único y versionado todo lo que define a un agente: modelo, instrucciones, herramientas, Skills, conectores y ajustes de ejecución. Un administrador del proyecto configura el agente una vez y lo pone a disposición de los desarrolladores autorizados; cada aplicación solo aporta sus propios datos.
Los Skills personalizados empaquetan instrucciones, procedimientos y archivos de apoyo en una versión: un equipo de plataforma puede guardar en ellos sus controles de despliegue, criterios de reversión (rollback) y formato de informe, y después publicar una nueva versión en vez de modificar cada aplicación. Los conectores gestionados (managed connectors), lanzados a finales de agosto, se convierten en un recurso que el administrador comparte con todo el proyecto: las aplicaciones hacen referencia a ellos sin tener que almacenar cada una sus credenciales ni sus definiciones de herramientas.
| Recurso añadido | Función en el Agent API | Disponibilidad anunciada |
|---|---|---|
| Profiles | Modelo, instrucciones, herramientas, Skills, conectores y ajustes de ejecución bajo un identificador versionado | Disponible |
| Skills personalizados | Instrucciones, procedimientos y archivos de apoyo versionados, utilizados por los miembros del proyecto | Disponible |
| Conectores gestionados | Integraciones aprobadas que comparte el administrador (GitHub, Slack, Google Drive, Datadog, Linear, Notion) | Versión preliminar |
Todo se configura desde la API Console, y los miembros acceden a estos recursos con una clave de API del mismo proyecto; la publicación no anuncia precios. Ese mismo día, una entrada del registro de cambios de la API cambia el ajuste predefinido xhigh del Agent API de GPT-5.6 Sol (openai/gpt-5.6-sol) a Claude Opus 5.5 (anthropic/claude-opus-5-5), sin modificar los prompts, el esfuerzo de razonamiento, las herramientas, los presupuestos de tokens ni los límites de pasos. Tres días antes, los ajustes predefinidos low, medium y high habían pasado a GPT-6.
🔗 El Agent API ahora admite agentes reutilizables · Registro de cambios de la API de Perplexity
SpaceXAI lanza Team Bots, Grok Bots compartidos por todo un equipo
28 de septiembre — SpaceXAI lanza Team Bots, Grok Bots creados en torno a una función o un flujo de trabajo de equipo y compartidos por todos sus miembros, aunque cada uno también puede trabajar individualmente con el Bot. El Bot es común, pero las conversaciones siguen siendo privadas: el contexto y las memorias se mantienen separados por usuario, mientras que los skills se comparten con el equipo. Cada Team Bot tiene su propio identificador en Slack y puede ser invitado a un canal donde todo el equipo puede hacerle preguntas.
| Componente del Bot | Función descrita por SpaceXAI |
|---|---|
| Contexto | Archivos, instrucciones y skills |
| Plugins | Trabajo en Salesforce, Notion o GitHub, conectados individualmente o para el equipo |
| Credenciales | Acceso a API de terceros que no tienen plugin |
| Memorias | Lo que el Bot recuerda para mejorar en su función, separado por usuario |
SpaceXAI describe sus propios usos. Cada cuenta comercial importante tiene un Team Bot que analiza durante la noche las noticias del cliente, las llamadas de Gong, los documentos de Notion y los hilos de Slack, y publica un resumen por la mañana en Slack. El Bot de ingeniería, conectado a Notion, Linear, Hex, Datadog y Cursor, ha dirigido cientos de Cloud Agents: un equipo de cinco personas entregó así más de 100 pull requests al día y lanzó Team Bots en unas semanas. Entre los clientes, la aseguradora Harper afirma haber creado en 24 horas un Team Bot que ayuda a sus clientes a restablecer sus pólizas vencidas, con un ahorro para ellos de más de 120 000 dólares, según su director general.
Team Bots está disponible desde hoy en beta pública para los planes Teams y Enterprise, con Team Bots preconfigurados para ventas, gestión de productos, marketing y análisis de datos. SpaceXAI no comunica precios ni cuotas.
🔗 Team Bots (SpaceXAI) · Anuncio de @bot en X
H Company publica Holo4, modelos de agentes de pesos abiertos de 27B y 35B-A3B
28 de septiembre — H Company publica Holo4, su nueva serie de modelos de agentes, en dos tamaños: un modelo denso de 27 000 millones de parámetros y una mezcla de expertos (Mixture of Experts) 35B-A3B. Ambos están disponibles a través de la API H Models y publicados en Hugging Face en BF16, FP8, NVFP4 y GGUF de 4 bits. H añade Holotron4 Nano, obtenido al aplicar su método de posentrenamiento a Nemotron 3 Nano Omni de NVIDIA. Un mismo modelo actúa a través de la interfaz gráfica, el código, MCP o las API, en el ordenador, la web, Android o un entorno aislado de código; H lo entrenó mediante aprendizaje supervisado y después por refuerzo, en particular con unas 10 000 tareas verificables que su Agentic Task Factory genera a partir de documentación sencilla.
| Modelo evaluado | Base y licencia | Puntuación publicada |
|---|---|---|
| Holo4 27B | Qwen3.8-27B, CC-BY-NC-4.0 (no comercial) | 61,7 % en OSWorld 2.0; 85,2 % en OSWorld a 0,08 dólares por tarea |
| Holo4 35B-A3B | Qwen3.6-35B-A3B, Apache-2.0 | 30,9 % en OSWorld 2.0 |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni, NVIDIA Open Model Agreement | mejoras respecto al modelo base mostradas únicamente en un gráfico |
| Claude Opus 5.5 (referencia citada por H) | modelo cerrado | 81,8 % en OSWorld 2.0 |
H precisa las condiciones: Holo4 se mide con su propia infraestructura de evaluación, con una sola ejecución en OSWorld 2.0, y se compara con puntuaciones públicas obtenidas con otras infraestructuras y niveles de esfuerzo; en AutomationBench, 480 de las 600 tareas públicas pertenecen a la partición utilizada para recopilar los datos de entrenamiento. H publica todas las trayectorias que sustentan sus puntuaciones públicas, que se pueden consultar paso a paso o descargar en Hugging Face, y anuncia borradores de DSpark para acelerar la inferencia en los próximos días.
🔗 Publicación sobre Holo4 en Hugging Face · Anuncio de H Company
Robótica: SAIL de Sakana AI pasa del 25 al 73 % de éxito; ProjectSim cuestiona la medición en simulación
28 de septiembre — Sakana AI presenta SAIL (Scaling In-Context Imitation Learning), un trabajo realizado con la Universidad de Tokio y aceptado en la conferencia IROS 2026; el artículo tiene un identificador de arXiv de marzo de 2026, y la novedad de hoy es su presentación pública. La pregunta que plantea es si se pueden obtener movimientos robóticos fiables de un modelo de visión y lenguaje (VLM) existente, sin volver a entrenarlo, asignándole más capacidad de cómputo durante la inferencia.
SAIL genera una trayectoria completa a partir de unas pocas demostraciones exitosas incluidas en el contexto y la ejecuta en simulación; un segundo VLM estima entonces, a partir del vídeo, el avance de la tarea, y esa información guía una búsqueda de árbol de Montecarlo (MCTS). Solo la trayectoria seleccionada se envía al robot real. Gemini Robotics-ER 1.5 desempeña ambas funciones, sin modificar sus pesos.
| Método evaluado | Nodos de búsqueda | Éxito medio en seis tareas simuladas |
|---|---|---|
| Generación única | 1 | 25 % |
| Búsqueda en profundidad | 15 | 37 % |
| Búsqueda en anchura | 15 | 51 % |
| SAIL | 6 | 55 % |
| SAIL | 15 | 65 % |
| SAIL | 45 | 73 % |
Estos porcentajes cuentan las configuraciones (20 por tarea, en el simulador ALOHA) para las que se encuentra una trayectoria exitosa dentro del presupuesto; el éxito lo verifica el simulador, no el VLM. Con un brazo LeRobot SO-101, SAIL logra 5 de 6 intentos al colocar un bloque en un cuenco, con un presupuesto de 15 trayectorias candidatas, y una política de imitación entrenada con las trayectorias encontradas también logra 5 de 6, ejecutándose más rápido. Sakana reconoce las limitaciones: ejecución en bucle abierto, cómputo adicional para la búsqueda y evaluación en el mundo real limitada a una tarea y seis intentos por método.
🔗 Publicación de Sakana AI · Página del proyecto SAIL
ProjectSim analiza el estado de los bancos de pruebas en robótica
28 de septiembre — La diferencia entre las puntuaciones simuladas y las reales es precisamente el tema del primer experimento de ProjectSim. En un artículo de síntesis sin resultados propios, Luca Cilio repasa los bancos de pruebas de manipulación, desde MetaWorld y LIBERO hasta pruebas físicas compartidas como RoboChallenge, y recuerda, con cifras de RoboCasa365, que GR00T N1.5, ajustado con 30 000 demostraciones, supera el 43 % de las habilidades aisladas, pero cae al 4,4 % en combinaciones ausentes de su ajuste. El experimento de ProjectSim busca determinar si unas escenas simuladas más fieles (con geometría, apariencia y propiedades físicas reconstruidas) acercan las puntuaciones de simulación a las medidas en un robot real; todavía no se han publicado resultados.
Mistral abre en Múnich un centro dedicado a la IA industrial y a la IA para la física
28 de septiembre — Mistral abre un centro en Múnich. El lugar acogerá equipos de investigación en IA para la física (Physics AI) e IA industrial (Industrial AI), junto con ingenieros de aplicaciones que trabajan directamente para las empresas asociadas: Mistral se presenta allí como socio tecnológico a largo plazo, más que como proveedor de software.
| Socio citado por Mistral | Trabajo anunciado |
|---|---|
| BMW | Simulación de choques e IA para ingeniería |
| Siemens Energy | Aplicaciones de IA industrial |
| Universidad Técnica de Múnich (TUM) | Gemelos digitales en túnel de viento para aerodinámica automotriz |
Este centro da continuidad a la adquisición de Emmi AI en mayo de 2026, que incorporó a Mistral a más de 30 físicos, investigadores e ingenieros especializados en dinámica de fluidos computacional (CFD), mecánica estructural y simulaciones multifísicas. Con la TUM y el profesor Nikolaus A. Adams, Mistral desarrollará gemelos digitales para la aerodinámica automotriz, combinando las mediciones de los sensores del túnel de viento en tiempo real con simulaciones CFD calculadas sin conexión para obtener predicciones aerodinámicas precisas en tiempo real.
El artículo retoma el argumento de la soberanía (pesos accesibles para el cliente, modelos ejecutados en su propia infraestructura y sujetos al derecho europeo, sin que los datos salgan de la organización) e indica que Mistral construirá un gigavatio de capacidad de cómputo europea de aquí a 2030. Cita al ministro federal alemán de Transformación Digital, Karsten Wildberger, y al jefe de la Cancillería del Estado de Baviera, Florian Herrmann. Mistral está contratando en la región de Múnich, sin indicar la plantilla prevista ni el importe de la inversión.
🔗 Hallo, Deutschland! (Mistral AI)
NVIDIA y Nscale miden DSX MaxLPS: un 37 % más de GPU y un 49 % más de rendimiento con el mismo presupuesto eléctrico
27 de septiembre — NVIDIA publica una evaluación cuantitativa de DSX MaxLPS, su software que distribuye la potencia entre los recursos de una fábrica de IA según las políticas del operador, realizada con Nscale. Según NVIDIA, permite desplegar hasta un 40 % más de GPU con el mismo presupuesto eléctrico aprobado; el artículo subraya que se trata de una asignación coordinada, no de un aumento del suministro eléctrico del centro.
La prueba se ejecutó en equipos GB300 NVL72 en el centro de datos de Nscale del campus Verne, en Keflavík (Islandia), alimentado íntegramente con energía renovable, con Kimi K2.5 en FP4, NVIDIA Dynamo y TensorRT LLM. Con el mismo presupuesto asignado de 264,4 kW, la flota pasa de 140 a 192 GPU sin que disminuya el rendimiento de las instancias existentes.
| Indicador medido | Base estática | Con DSX MaxLPS | Diferencia registrada |
|---|---|---|---|
| GPU gestionadas | 140 | 192 | +37,1 % |
| Rendimiento agregado normalizado | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| Potencia total medida | 166,2 kW | 198,9 kW | +19,7 % |
| Uso del presupuesto eléctrico | 62,9 % | 75,2 % | +12,3 puntos |
| Rendimiento por vatio asignado | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
El artículo no oculta la contrapartida: aunque las latencias mediana y P75 se mantienen a menos del 5 % de la referencia, el P99 del tiempo hasta el primer token aumenta un 17 %, desde una base de 15,7 segundos. NVIDIA recomienda a los operadores una validación en cinco etapas, desde la delimitación del perímetro eléctrico hasta la fijación de los límites de producción. Esta evaluación sigue a la validación realizada por Lambda en HGX B200, presentada el 15 de septiembre (19 nodos con el presupuesto previsto para 16); las proyecciones para Vera Rubin, con refrigeración líquida a 45 °C en la entrada, se presentan por separado.
Breves
- DeepSeek Harness 0.2.0-rc.1 — Primera versión candidata de la serie 0.2.0 y 23.ª versión preliminar del entorno de agentes de DeepSeek, todavía sin versión estable: las conversaciones sobre los modelos de la cuenta DeepSeek buscan en la web sin una clave de API adicional, y las tareas automatizadas pasan a un paquete opcional de plugins. 🔗 fuente
- Pixel Canary en Vercel AI Gateway — Desde el 25 de septiembre, Vercel ofrece gratuitamente, durante su fase discreta, este modelo de código de un desarrollador no identificado: 28 tareas Next.js de 31 en pass@4, igual que GPT-6 Astra (high), y 30 de 31 con la documentación facilitada mediante AGENTS.md; no ofrece retención cero de datos. 🔗 fuente
- Runners autohospedados de GitHub Actions — En GitHub Enterprise Cloud, la aplicación completa de las versiones mínimas comienza el 29 de septiembre: por debajo de la versión 2.329.0, un runner ya no puede registrarse, y un runner por debajo del mínimo de ejecución deja de aceptar trabajos; una nueva API REST proporciona las fechas de fin de soporte. GitHub Enterprise Server no se ve afectado. 🔗 fuente
- NexteraBERT — Rikka Botan publica un codificador bidireccional de 212,6 millones de parámetros, preentrenado con 130 000 millones de tokens (unas 15 veces menos que ModernBERT): 87,90 en GLUE frente a 87,97 de ModernBERT-base, 54,70 frente a 53,63 en MTEB v2 y un rendimiento 5,22 veces superior con 65 536 tokens, según sus propias mediciones; código con licencia MIT. 🔗 fuente
- LTX-2.5 en tiempo real — Un artículo de la comunidad hace que este modelo de audio y vídeo de 22 000 millones de parámetros pase de 90 segundos por clip a generar más rápido que la reproducción: 1,83 segundos para un clip de 5 segundos en una tarjeta de 96 GB, gracias a 4 etapas en lugar de 8, al cálculo NVFP4 y a CUDA Graph; código con licencia Apache-2.0. 🔗 fuente
- SCRIBE — Adalat AI, que desarrolla reconocimiento de voz para los tribunales indios, publica en PyPI esta herramienta de evaluación de código abierto (artículo en Interspeech 2026) que puntúa por separado palabras, números, puntuación y términos especializados, mientras que la tasa de error por palabra asigna un 100 % a una frase en malayalam que ningún corrector modificaría. 🔗 fuente
- 228 proyectos JEV — Eric Kang, responsable de la lista Awesome JEV, selecciona 228 proyectos de código abierto (10 tipos, un mínimo de 50 estrellas, cada uno fijado en un commit) entre los 13 473 repositorios que devuelve una búsqueda de «jev» en GitHub, cifra que incluye proyectos no relacionados: es una selección manual, no un censo independiente. 🔗 fuente
- HeyGen y Jev — HeyGen publica en X una guía que sitúa a Jev, el modelo de decisión de TypeSafe AI, delante de su servidor MCP: Jev clasifica unos cuarenta clientes potenciales (vídeo o no, enfoque, idioma, adecuación), Claude escribe los guiones y después el MCP de HeyGen genera el lote, la única etapa que consume créditos y requiere aprobación. 🔗 fuente
- Cuatro creaciones con Gemini 3.8 Flash — El blog de Google presenta cuatro proyectos construidos con el modelo lanzado el 2 de septiembre: un seguimiento en directo de satélites creado con Antigravity, olas Seigaiha animadas, un esqueleto 3D de tiranosaurio y una caja de cambios automática con 10 vistas de cámara; no aporta cifras ni novedades de producto. 🔗 fuente
- Un servicio de catering de Brooklyn y Gemini — El blog de Google cuenta cómo Edy Massih, propietario de la tienda de alimentación Edy’s Grocer en Greenpoint, usa Gemini para adaptar sus recetas a 200 comensales, generar listas de la compra y ajustar sus menús a distintas dietas; no se anuncia ninguna función nueva. 🔗 fuente
- Lenfest Institute — OpenAI compromete 5 millones de dólares, más hasta 5 millones de dólares en créditos de software y apoyo de ingeniería, para la siguiente fase del programa de becarios de IA del Lenfest Institute, iniciado en 2024 en 11 redacciones estadounidenses: el doble de su apoyo anterior. 🔗 fuente
- Pestaña Salud de ChatGPT — Al seleccionar un gráfico, una métrica o un expediente en la pestaña Health, ahora se obtienen explicaciones personalizadas, a veces con un gráfico interactivo, sin escribir un prompt; Health sigue disponible únicamente en Estados Unidos (mayores de 18 años, planes Free, Go, Plus y Pro, web e iOS). 🔗 fuente
- Ganadores del WebMCP Challenge — OpenAI Developers presenta los diez proyectos ganadores del hackatón iniciado a finales de agosto (MASIL, Alza, ArchMorph, Aisle, Roque Nights, Mandate, Observatory, Bouquet Studio, Faraday, JupyterLite WebMCP), sin clasificación ni importe por proyecto. 🔗 fuente
- Corrección de seguridad en macOS — El 25 de septiembre, la versión 26.924.20706 de la aplicación de escritorio para macOS, incluida en la sección de la aplicación Codex del registro de cambios de ChatGPT y Codex, corrigió la vulnerabilidad CVE-2026-100754 notificada por Patrick Wardle (Objective-See Foundation), sin describir el fallo. 🔗 fuente
Qué significa
El precio del token ya no cambia; lo que baja es el número de tokens. Sonnet 5.5 mantiene el precio de Sonnet 5, pero, según Anthropic, cuesta hasta un 30 % menos por tarea porque consume menos; Devin pasa a ser entre un 30 % y un 40 % más barato al integrar sus últimos modelos, incluido SWE-2, y agrupar sus llamadas a herramientas; Manus anuncia un coste de ejecución un 32 % menor con su nuevo entorno de agentes, en una configuración probada. El factor decisivo ya no es el precio anunciado, sino la cantidad de trabajo consumida, tanto por el modelo como por el entorno de agentes, y la gama media alcanza a la alta: en Terminal-Bench 4.0, Sonnet 5.5 supera la puntuación de Opus 5.5 medida con el nivel de esfuerzo Xhigh.
Los agentes ganan autonomía por defecto y las salvaguardas se sitúan fuera de su alcance. Claude Code ahora se inicia en modo auto en todos los planes, mientras que NVIDIA instala la supervisión en una DPU a la que el agente no puede acceder y somete por defecto a aprobación humana cualquier regla de acceso que este proponga. Las herramientas siguen la misma línea: Codex CLI solicita aprobación para las entradas en el terminal de comandos con permisos elevados, y el SDK de Copilot permite exigir una revisión humana antes de instalar un servidor MCP o un skill. Cuanto más actúa el agente por su cuenta, más necesario es que el control resida fuera del propio agente.
El agente también se convierte en un miembro del equipo, con identidad propia. Los Profiles de Perplexity convierten a un agente en una configuración versionada que puede reutilizar todo un proyecto; los Team Bots de SpaceXAI tienen su propio identificador de Slack y conservan memorias separadas para cada usuario; y los agentes de Cue reciben una dirección de correo electrónico, un número de teléfono y una cartera. Un agente que puede pagar, llamar o escribir en nombre de alguien vuelve muy concretas las cuestiones de control que NVIDIA plantea ese mismo día.
Por último, las cifras del día requieren una lectura atenta. Devin mide Sonnet 5.5 con una variante de FrontierCode que su publicación en X y su gráfico denominan de manera distinta, y dos gráficos de Cognition publicados el mismo día dan puntuaciones diferentes para Opus 5.5; Holo4 se mide en el entorno de agentes de H, en una sola ejecución de OSWorld 2.0; el 73 % de SAIL se obtiene en simulación, y la diferencia entre simulación y realidad es precisamente el objeto del primer experimento de ProjectSim. En el ámbito multimedia, Eleven v4 se apoya en una clasificación externa y pruebas a ciegas, mientras que Kling 4.0 llega sin benchmark ni precio y deja parte de sus funciones para más adelante.
Fuentes
- Presentación de Claude Sonnet 5.5 (Anthropic)
- Guía de migración a Claude Sonnet 5.5
- @ClaudeDevs: recomendaciones de esfuerzo para Sonnet 5.5
- Claude Sonnet 5.5 en GitHub Copilot
- Modelos y precios de GitHub Copilot
- Claude Sonnet 5.5 en Devin
- @cognition: Sonnet 5.5 en FrontierCode 1.1 Main
- @cursor_ai: Sonnet 5.5 en Cursor
- @v0: Sonnet 5.5 en v0
- NVIDIA lanza Open Agent Safety Platform (comunicado)
- Arquitectura de Open Agent Safety Platform (NVIDIA)
- Añadir controles de ejecución a agentes de IA con NVIDIA OpenShell
- @NVIDIAAI: Jensen Huang en CNBC
- @togethercompute: socio de lanzamiento
- @perplexity_ai: colaboración con NVIDIA
- Presentación de Manus 2.0
- @ManusAI: lanzamiento de Cue
- @ManusAI: números de teléfono de los agentes
- Presentación de Eleven v4 (ElevenLabs)
- @ElevenLabs: hilo de anuncio de Eleven v4
- Notas de la versión de Kling 4.0
- @Kling_ai: anuncio de Kling 4.0
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- Devin ahora es hasta un 40 % más eficiente en costes
- Notas de la versión de Devin del 25 de septiembre
- @cognition: beta de Devin Mobile
- @zeddotdev: Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- La Agent API ya admite agentes reutilizables (Perplexity)
- Registro de cambios de la API de Perplexity
- Team Bots (SpaceXAI)
- @bot: anuncio de Team Bots
- Holo4 en el blog de Hugging Face
- Holo4 (H Company)
- SAIL (Sakana AI)
- Página del proyecto SAIL
- Evaluación comparativa en robótica: situación actual y próximos pasos (ProjectSim)
- Hallo, Deutschland! (Mistral AI)
- Cómo NVIDIA DSX MaxLPS maximiza el rendimiento y la eficiencia de las fábricas de IA
- DeepSeek Harness 0.2.0-rc.1
- Pixel Canary en Vercel AI Gateway
- Se ha cambiado la fecha de aplicación de las versiones de los runners autohospedados (GitHub)
- Informe técnico de NexteraBERT
- Personajes parlantes en tiempo real a partir de un modelo de difusión de vídeo de 22 000 millones de parámetros
- SCRIBE (Adalat AI)
- JEV: 228 proyectos seleccionados (Eric Kang)
- @HeyGen: guía de Jev y MCP HeyGen
- Descubre lo que crean cuatro desarrolladores con Gemini 3.8 Flash (Google)
- Tres formas en que este tendero cocina para 200 invitados con Gemini (Google)
- Lenfest AI Collaborative: nueva fase (OpenAI)
- Notas de la versión de ChatGPT
- @OpenAIDevs: ganadores del WebMCP Challenge
- Registro de cambios de ChatGPT y Codex: CVE-2026-100754