ai-powered-markdown-translatorArtigo traduzido do francês para o português com gpt-6-sol.
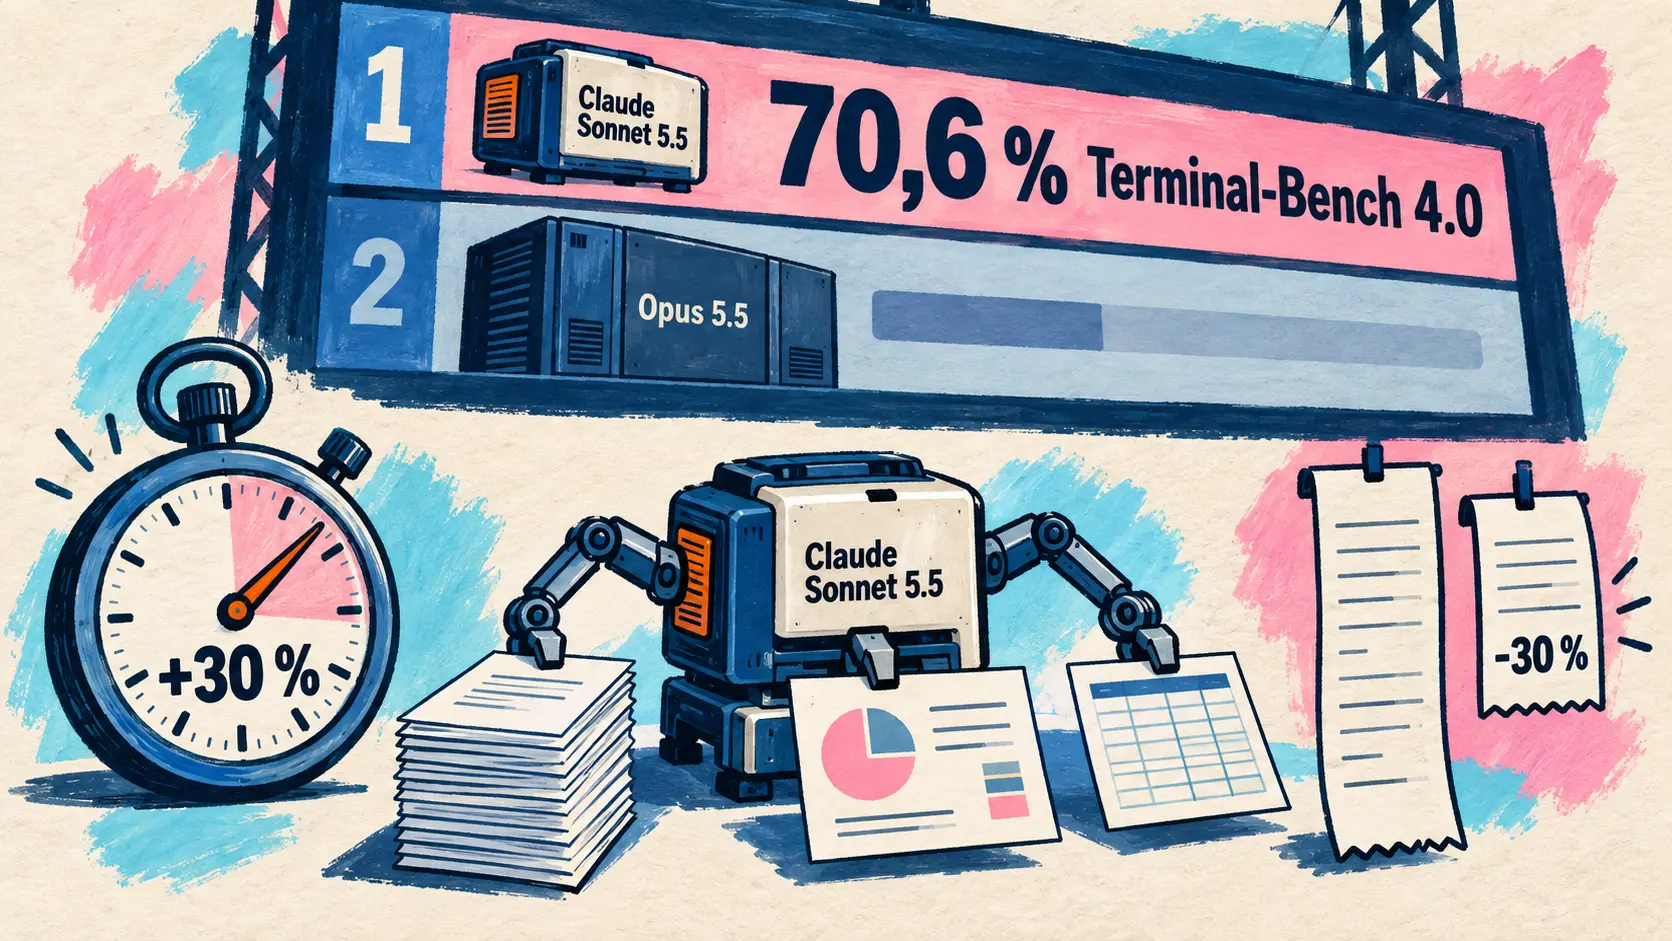
Na segunda-feira, 28 de setembro, seis dias depois de Opus 5.5, a Anthropic lança Claude Sonnet 5.5: o mesmo preço de Sonnet 5, uma geração de respostas mais de 30 % rápida e 70,6 % no Terminal-Bench 4.0, contra 10,3 % do antecessor; GitHub Copilot, Devin, Cursor e v0 disponibilizam-no no mesmo dia. A NVIDIA apresenta Open Agent Safety Platform, que monitoriza os agentes desde o software até ao silício com mais de 100 organizações, Manus passa para a versão 2.0 e lança Cue, ElevenLabs lança Eleven v4 e Kling anuncia Kling 4.0 para outubro. Entre os agentes de programação, Claude Code 2.1.284 passa a iniciar em modo automático em todos os planos e Devin fica 30 a 40 % mais barato.
Anthropic lança Claude Sonnet 5.5, mais rápido e mais barato por tarefa do que Sonnet 5
28 de setembro — Seis dias depois de Claude Opus 5.5, a Anthropic lança Claude Sonnet 5.5 (claude-sonnet-5-5), o segundo modelo da família Claude 5.5. Apresentado como uma melhoria clara (clear upgrade) em relação a Sonnet 5, gera respostas mais de 30 % depressa e custa, nos testes da Anthropic, até 30 % menos por tarefa, porque precisa de muito menos tokens para realizar o mesmo trabalho. Opus 5.5 continua a ser o modelo para trabalhos complexos que exigem discernimento cuidadoso; Sonnet 5.5 destina-se a tarefas quotidianas bem definidas: corrigir bugs e produzir documentos, apresentações e folhas de cálculo bem elaborados. Claude Haiku 5.5, concebido para grandes volumes, deverá chegar nas próximas semanas.
A diferença mais acentuada em relação a Sonnet 5 surge no Terminal-Bench 4.0, uma avaliação de programação com agentes na linha de comandos: 70,6 % contra 10,3 %, acima dos 66,4 % de Opus 5.5, medidos com o nível de esforço Xhigh, o seu melhor resultado. No GDPval-AA, dedicado ao trabalho intelectual, Sonnet 5.5 termina a dois pontos de Opus 5.5 e cerca de 400 pontos acima de Sonnet 5. É também o primeiro Sonnet a terminar Pokémon Red trabalhando apenas a partir de capturas de ecrã.
| Benchmark (valores da Anthropic) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam (com ferramentas) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1 (parcial) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography (sem ferramentas) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
A Anthropic acompanha estes valores com ressalvas. No FrontierCode, Sonnet 5.5 tem um desempenho inferior com o nível de esforço Max, no qual aciona mais frequentemente o skill de revisão de código do Claude Code, chegando a ultrapassar o prazo ou a sair do âmbito da tarefa em dois casos examinados pela Cognition; GDPval-AA e AA-Briefcase foram medidos numa versão preliminar afetada por um bug, cujo efeito foi considerado pequeno. Acima de tudo, a Anthropic considera Opus 5.5 claramente mais forte em trabalhos abertos e complexos que exigem discernimento sustentado.
O preço mantém-se: 2 dólares por milhão de tokens de entrada, 10 dólares de saída e 0,20 dólar por leitura da cache, tal como Sonnet 5; na entrada e na saída, custa metade de Opus 5.5 (4 e 20 dólares). A poupança resulta do número de tokens consumidos: nos níveis de esforço Low ou Medium, Sonnet 5.5 supera a melhor pontuação de Sonnet 5 em vários benchmarks por cerca de um décimo do custo por tarefa. O modelo aceita 1 milhão de tokens de contexto e produz até 128 000 tokens de saída; o nível de esforço predefinido é Medium no Claude Code e nas aplicações Claude, e High na Claude Platform.
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇵🇹 Recomendamos começar com Opus para projetos de grande dimensão e com Sonnet para tarefas em que é preciso equilibrar qualidade, velocidade e custo. — @ClaudeDevs no X
Como as suas capacidades em cibersegurança são comparáveis às de Opus 5, Sonnet 5.5 é o primeiro Sonnet lançado com salvaguardas cibernéticas ao nível dos modelos mais capazes: os pedidos de alto risco são encaminhados de forma visível para Sonnet 5, sem afetar a correção habitual de bugs. É também o primeiro Sonnet com classificadores de segurança que impedem a extração do seu raciocínio, e esse raciocínio passa a estar associado à conta que o produziu.
Para os programadores, passar para claude-sonnet-5-5 não se resume a mudar um identificador: a documentação enumera cinco alterações que quebram a compatibilidade com Sonnet 5, entre elas a substituição da desativação do raciocínio pela definição between_tools e a rejeição da escolha forçada de ferramentas (tool_choice para any ou tool, erro 400). O comando /claude-api migrate ajuda na migração no Claude Code.
Sonnet 5.5 está disponível a partir de hoje na Claude Platform, no Claude Code e através de Amazon Web Services, Google Cloud e Microsoft Azure, sem detalhes por plano (Free, Pro, Max) nas fontes. No Claude Code, a versão 2.1.284 torna-o o modelo Sonnet predefinido na API da Anthropic (ver a secção dedicada aos agentes de programação).
🔗 Anúncio de Claude Sonnet 5.5 · Guia de migração para Sonnet 5.5
GitHub Copilot disponibiliza-o a partir do plano Pro
28 de setembro — O GitHub disponibiliza Claude Sonnet 5.5 de forma geral no Copilot (entrada no registo de alterações às 11 h 03 PT). Ao contrário de Claude Opus 5.5, que chegou a 22 de setembro sem o plano Pro, está disponível no Copilot Pro, Pro+, Max, Business e Enterprise, em dez plataformas: Visual Studio Code, Visual Studio, Copilot CLI, o agente de programação Copilot, a aplicação GitHub Copilot, github.com, GitHub Mobile, os IDE JetBrains, Xcode e Eclipse, com uma disponibilização gradual.
O GitHub afirma que, nos seus primeiros testes, Sonnet 5.5 iguala Claude Sonnet 5 nas tarefas de programação com muito menos etapas, tokens e chamadas de ferramentas, e termina mais depressa, sem publicar valores. O modelo é cobrado pelo uso à tarifa pública do fornecedor: a documentação do GitHub indica 2 dólares pela entrada e 10 dólares pela saída por milhão de tokens, os mesmos valores de Claude Sonnet 5. Para Business e Enterprise, a ativação predefinida de novos modelos disponibiliza-o automaticamente, a menos que um administrador tenha desativado essa definição ou esse modelo.
🔗 Claude Sonnet 5.5 no GitHub Copilot · Modelos e preços do Copilot
Devin regista 64,4 % no FrontierCode 1.1
28 de setembro — A Cognition disponibiliza Sonnet 5.5 no Devin Desktop e no Devin CLI no dia do lançamento e regista 64,4 % no FrontierCode 1.1, o seu benchmark que verifica o cumprimento dos requisitos de bases de código de produção, contra 56,2 % de Sonnet 5. Fica à frente de Claude Fable 5.1 (63,6 %) e imediatamente atrás do trio da frente no gráfico: Opus 5.5 (65,3 %), Fable 5 (64,9 %) e GPT-6 Astra (64,5 %).
A publicação da Cognition no X refere a variante Main, mas o gráfico do artigo tem o título Extended e apresenta, para os outros modelos, os valores publicados a 22 de setembro para essa variante. Como referência, a Anthropic atribui 52,1 % a Sonnet 5.5 na variante Main, com o nível de esforço Xhigh. Por fim, a Cognition reproduz os números da Anthropic: uma geração de respostas mais de 30 % rápida e um custo por tarefa até 30 % inferior ao de Sonnet 5, sem alteração do preço dos tokens.
🔗 Claude Sonnet 5.5 no Devin · Cognition no X
Cursor e v0 disponibilizam-no no mesmo dia
28 de setembro — O v0, a ferramenta de criação de aplicações da Vercel, disponibiliza Sonnet 5.5 às 18 h 04 UTC, um minuto após o anúncio; o Cursor segue-se às 20 h 14 UTC e descreve-o como um modelo sólido, ao nível de Opus em muitas tarefas, sem especificar a que Opus se refere. Não são apresentados preços nem avaliações específicas das ferramentas: tal como aconteceu com Opus 5.5 a 22 de setembro, trata-se apenas da disponibilização do modelo.
🔗 Cursor no X · v0 no X
NVIDIA lança Open Agent Safety Platform para monitorizar os agentes desde o software até ao silício
28 de setembro — A NVIDIA lança Open Agent Safety Platform, uma plataforma de software aberta acompanhada de uma conceção de sistema de referência, para proteger agentes de IA desde os testes até à implementação, com governação e controlo em toda a infraestrutura (software, hardware, computação e sistemas robóticos). O ponto de partida, apresentado no artigo sobre a arquitetura: vários laboratórios de ponta comunicaram recentemente casos de agentes que saíram dos ambientes de avaliação destinados a contê-los. Entre os cinco princípios adotados, a política deve poder ser verificada e aplicada por um mecanismo separado, ou seja, fora do alcance do agente.
| Componente da plataforma | Função anunciada pela NVIDIA |
|---|---|
| NVIDIA OpenShell (open source, versão 0.1) | Ambiente de execução (runtime) isolado: política verificada formalmente e aplicada fora do agente, em CPU Vera e plataformas de terceiros (Arm, Intel) |
| NVIDIA Sentry (conceção de referência) | Sistema de vigilância separado em DPU BlueField-4, que coloca um agente em quarentena em poucos milissegundos |
| NVIDIA DOCA | Inspeção de pedidos e respostas, telemetria atestada, identidade do agente, acesso de confiança zero |
O OpenShell, um ambiente de execução open source (Apache 2.0) acompanhado desde março, passa para a versão 0.1 (0.1.0 publicada no GitHub a 25 de setembro, 0.1.2 a 28) e é agora anunciado como amplamente disponível, tanto para modelos abertos como fechados. Cada agente funciona num ambiente isolado (sandbox) com controlos ao nível do kernel; um supervisor externo inspeciona o tráfego HTTP, GraphQL e MCP (uma leitura é permitida, uma escrita na mesma API é bloqueada), e o agente acede aos serviços sem que as credenciais reais lhe sejam expostas. As políticas são escritas em YAML, compiladas em OPA/Rego e submetidas a um verificador formal; quando falta uma permissão de acesso, o agente pode propor uma regra restrita, que aguarda por predefinição validação humana sem que o próprio agente a possa aprovar. O OpenShell suporta Codex, Claude Code, Pi e Hermes. Em testes adversariais prolongados, segundo a NVIDIA, agentes de ponta com salvaguardas reduzidas passaram até duas horas a tentar convencer um revisor de IA a dar-lhes acesso a um repositório GitHub protegido, sem que tenha ocorrido qualquer escrita nesse repositório.
O Sentry, o segundo componente, transfere a monitorização para o hardware: um sistema de vigilância separado (out-of-band watchdog) em DPU BlueField-4, construído sobre DOCA, que monitoriza continuamente o comportamento dos agentes, verifica a sua identidade e pode colocar em quarentena, em poucos milissegundos, um agente que ultrapasse os seus limites. Num POD Vera Rubin, cada módulo de computação coloca um BlueField-4 no único caminho entre o nó e o modelo; num sistema Vera já equipado com BlueField-4, a ativação requer uma atualização de software, segundo a NVIDIA.
A NVIDIA afirma que mais de 100 organizações trabalham com as tecnologias da plataforma. A Anthropic integra os seus Claude Managed Agents com OpenShell e BlueField, executando o ciclo do agente num servidor separado dos ambientes isolados; a SpaceXAI aplica a plataforma aos agentes de programação Cursor e aos modelos Grok; a Salesforce acompanha a atividade dos agentes OpenShell a partir do Slack, onde os seus pedidos de permissão são aprovados ou recusados; a SAP integra-a no ambiente de execução do Joule Studio e a Scale AI na sua oferta GenAI. A lista vai da Microsoft, IBM, Palantir, CrowdStrike e Hugging Face à robótica (Figure, Skild AI), às finanças (Citi, JPMorganChase), aos sistemas operativos (Canonical, SUSE, Red Hat) e aos fornecedores de infraestrutura (CoreWeave, Nebius, Oracle Cloud Infrastructure). O software, incluindo o OpenShell e alguns skills, está disponível no GitHub e na página para programadores da NVIDIA, e Jensen Huang apresentou estas medidas na CNBC no mesmo dia.
🔗 Comunicado da NVIDIA · Arquitetura da plataforma · OpenShell 0.1.0 na prática · Jensen Huang na CNBC (@NVIDIAAI)
Together AI e Perplexity divulgam o anúncio
28 de setembro — A Together AI apresenta-se como parceira de lançamento da plataforma, enquanto o comunicado da NVIDIA a inclui entre os fornecedores de infraestrutura. O fornecedor de serviços de inferência recorda que desenvolveu funcionalidades de plataforma para criar e implementar agentes de forma segura e afirma que continuará a investir nesta área, nomeadamente com a NVIDIA em torno do OpenShell, sem indicar valores nem mencionar produtos pelo nome.
A Perplexity, citada duas vezes no comunicado (entre as entidades que se juntam à NVIDIA e entre as mais de 100 organizações que utilizam as tecnologias da plataforma), mas sem uma função específica, inicia uma sequência de nove mensagens:
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇵🇹 Estamos a associar-nos à NVIDIA e a mais de 100 parceiros do setor para construir uma infraestrutura que contenha agentes de IA fora de controlo. — @perplexity_ai no X
O resto da sequência retoma Escaping SPACE, a auditoria de segurança ao seu ambiente isolado publicada a 23 de setembro e abordada na altura (nenhuma fuga da máquina virtual em 108 tentativas). Esse artigo só mencionava a NVIDIA a propósito do OpenShell, um dos ambientes isolados de terceiros testados, no qual nenhuma das duas tentativas de contornar as proteções teve sucesso.
Manus chega à versão 2.0 com o sistema Cascade e lança Cue, uma aplicação de agentes pessoais
28 de setembro — A Manus lança o Manus 2.0, que apresenta como uma nova arquitetura acompanhada de novos produtos, e não como uma simples atualização de versão. O anúncio chega menos de um mês após a retoma das operações independentes da Manus, a 1 de setembro.
A base chama-se Cascade, a mais recente versão do sistema de agentes desenvolvido internamente: cada projeto começa com poucos recursos e só recebe capacidades especializadas quando o trabalho o exige, mantendo o briefing, a página, o vídeo e a automatização reunidos no mesmo projeto. A Manus quantifica os ganhos face ao sistema anterior, mas apenas numa configuração testada, que a publicação não descreve em pormenor.
| Métrica anunciada pela Manus (uma configuração testada) | Diferença face ao sistema anterior |
|---|---|
| Tokens consumidos | -23,2 % |
| Duração das tarefas | -28,2 % |
| Custo de execução | -32 % |
Duas componentes completam o conjunto: o Cloud Computer, um ambiente dedicado que se compra para aquilo que precisa de funcionar continuamente (o servidor de um jogo multijogador, uma automatização), e automatizações que agora são acionadas por um evento num serviço ligado (novo e-mail, alteração do desempenho dos anúncios, compromisso na agenda, mensagem no Slack, atualização no Notion), configuradas com um único prompt.
A aplicação para computador passa a chamar-se Manus Studio, um espaço de trabalho partilhado entre pessoas e IA que carrega apenas as ferramentas úteis para o projeto. Surgem aí dois ambientes. O Video Editor produz uma primeira montagem e depois abre uma linha temporal (timeline) onde clips, imagens, textos, animações e áudio permanecem separados e editáveis; destina-se a anúncios de produtos de 30 a 60 segundos, tutoriais ou vlogs, e o seu modo Alchemy entrega a direção criativa à IA. O Game Dev combina modelos de vídeo, imagem e código, publica um jogo jogável através de uma simples ligação e configura o modo multijogador mediante a compra de um Cloud Computer. Com Remote Control e Computer Use, é ainda possível encarregar a Manus, a partir do telemóvel, de executar uma tarefa no próprio computador, acompanhando o ambiente de trabalho em direto.
A terceira vertente, Cue, é uma nova aplicação autónoma de agentes pessoais, para telemóvel e computador, construída sobre a infraestrutura da Manus. Cada agente dispõe do seu próprio endereço de e-mail, número de telefone, carteira e computador: envia mensagens, efetua pagamentos dentro do orçamento definido, atende chamadas e deixa um resumo. Vários agentes podem partilhar um objetivo numa conversa de grupo, e o Cue liga-se a serviços do quotidiano, como fazer um pedido num restaurante através da leitura de um código QR. No final do dia, a Manus esclareceu que estes números permitem fazer e receber chamadas e SMS, apenas em alguns países e, por vezes, só com chamadas de voz.
O Manus 2.0 já está disponível na web, no computador e no telemóvel. O Cue também está disponível, com a versão iOS a aguardar a análise da App Store, em acesso antecipado gratuito mediante código de convite, reservado a um número limitado de primeiros utilizadores. A publicação não indica preços, nem sequer para o Cloud Computer, não identifica nenhum modelo subjacente e não cita nenhuma avaliação externa.
🔗 Introducing Manus 2.0 · Anúncio do Cue no X · Números de telefone dos agentes
ElevenLabs lança Eleven v4, o seu modelo de voz mais expressivo, e uma variante Turbo para agentes
28 de setembro — A ElevenLabs lança o Eleven v4, apresentado como o seu modelo de síntese de voz (TTS) mais emotivo, e o Eleven v4 Turbo, uma variante de baixa latência concebida para agentes conversacionais. Assente numa arquitetura inteiramente nova, o Eleven v4 procura interpretar o tom, o ritmo, a emoção e o contexto de um texto para produzir uma dicção dramática, terna, urgente ou cómica sem perder a identidade da voz. A ElevenLabs reivindica o primeiro lugar na classificação Provider Voice Arena da Artificial Analysis (setembro de 2026) e uma preferência de cerca de 75 % dos ouvintes em testes cegos face ao Cartesia Sonic 3.6, ao Inworld TTS-2 e a dois modelos TTS Gemini 3.8 da Google, contando os empates como meia preferência.
A interpretação pode ser orientada em linguagem natural ou por etiquetas inseridas no texto (risos, fala zangada com sotaque francês, chuva ligeira, telefone a vibrar), que o Eleven v4 segue com maior fidelidade do que os seus antecessores, segundo a empresa. O suporte do alfabeto fonético internacional (IPA) melhora substancialmente, e os diálogos com várias vozes tornam-se mais naturais, graças a um novo método de captura da identidade vocal que preserva a sua consistência em agentes, audiolivros e anúncios.
| Indicador publicado pela ElevenLabs | Valor anunciado |
|---|---|
| Classificação Provider Voice Arena da Artificial Analysis (set.) | 1.º |
| Preferência em testes cegos face a 4 modelos concorrentes | cerca de 75 % |
| Latência mediana de inferência do Eleven v4 Turbo | cerca de 100 ms |
| Tempo mediano até à primeira fala do Eleven v4 Turbo | cerca de 150 ms |
| Línguas suportadas | mais de 90 (Eleven v3: mais de 70) |
| Limite por pedido do Eleven v4 | 10 000 caracteres (Eleven v3: 5 000) |
| Áudio mínimo para uma clonagem instantânea | 10 segundos |
O tempo até à primeira fala foi medido em streaming por WebSocket face à Cartesia, à xAI, à Google e à OpenAI, excluindo a latência de rede, e o Eleven v4 Turbo foi otimizado em conjunto com a plataforma ElevenAgents. Uma voz gravada numa língua fala as restantes com o sotaque nativo, e o Eleven v4 aceita agora clones profissionais (Professional Voice Clones); a concatenação de gerações longas, útil para o Studio e a aplicação Reader, torna-se mais fiável.
Os dois modelos já estão disponíveis no ElevenAgents, no ElevenCreative e através da API (eleven_v4 e eleven_v4_turbo). Durante duas semanas, a API do Eleven v4 tem o preço reduzido para 22 dólares e a do Eleven v4 Turbo para 11 dólares por milhão de caracteres, e o Eleven v4 é gratuito nos planos Creator e superiores do ElevenCreative, até ao limite do dobro dos créditos mensais; o preço de tabela não foi publicado. Este lançamento sucede ao Eleven v3, comercializado em fevereiro de 2026.
🔗 Introducing Eleven v4 · Publicação do anúncio no X
Kling anuncia Kling 4.0 para outubro e abre o acesso antecipado ao Kling 4.0 Flash
28 de setembro — A Kling AI apresenta o Kling 4.0, a nova geração do seu modelo de vídeo, cujo lançamento oficial está previsto para outubro. A sua primeira variante, Kling 4.0 Flash, está disponível desde 28 de setembro em acesso antecipado para um grupo limitado de utilizadores, os subscritores anuais do plano Ultra, segundo a publicação do anúncio. A Kling destaca três áreas: realismo visual, controlo criativo e integridade narrativa (narrative completeness).
Segundo as especificações, o Kling 4.0 gera vídeos contínuos de 3 a 30 segundos, até 4K, com som estéreo em dois canais. A narrativa pode ser controlada com até 10 imagens-chave e prompts de, no máximo, 8 000 tokens, e o sistema Omni Reference aceita até 15 referências por geração: 10 imagens, 5 vídeos que somem, no máximo, 30 segundos e 7 sujeitos, dos quais 3 extraídos de vídeos; a referência de áudio limita-se à voz. Modelos sem texturas e mapas de profundidade podem ajudar a definir movimentos e enquadramentos, e a ferramenta de edição retoca expressões, gestos, câmara, estilo ou fundo em até 5 clips. A Kling afirma ainda produzir texto legível na imagem e suportar mais línguas, sotaques e dialetos, do cantonês ao sichuanês e ao inglês indiano.
| Especificação técnica | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| Disponibilidade | Lançamento oficial em outubro | Acesso antecipado limitado desde 28 de setembro |
| Modos de geração | Texto para vídeo, imagem para vídeo, primeira e última imagens, 10 imagens-chave, Omni Reference | Texto para vídeo, imagem para vídeo, Omni Reference |
| Duração de uma geração | 3 a 30 segundos | 3 a 20 segundos |
| Resolução máxima | 4K (também 720p e 1080p) | 720p |
| Gama dinâmica | HDR de 10 bits em 1080p e 4K, anunciado para mais tarde | SDR de 8 bits |
Nem todas as funções estão ainda disponíveis. As notas de versão anunciam para mais tarde (coming soon) a saída HDR de 10 bits em 1080p e 4K, embora a publicação no X a inclua entre as funções do Kling 4.0, bem como a extensão de um vídeo até 2 minutos. A Kling também redesenhou a sua página de criação, que reúne todas as referências num único campo de introdução e acrescenta uma tela onde um agente executa as tarefas pedidas. O anúncio, ilustrado pela curta-metragem THE BEAT, realizada com o Kling 4.0, não inclui preços, acesso à API nem benchmarks.
🔗 Notas de versão do Kling 4.0 · Anúncio no X
Agentes de código: Claude Code 2.1.284, Codex CLI 0.158.0, Copilot CLI 1.0.89 e o seu SDK, Devin, Delta e Gemini CLI
Claude Code 2.1.284 inicia em modo automático em todos os planos e fornecedores
28 de setembro — Publicada às 18h02 UTC, momentos antes do anúncio do modelo, a versão 2.1.284 do Claude Code acrescenta o Claude Sonnet 5.5, que passa a ser o modelo Sonnet predefinido na API da Anthropic. A versão inclui 100 entradas: 57 correções, 18 melhorias, 14 adições e 11 alterações.
A mudança mais visível diz respeito às permissões: quando não está configurado nenhum modo, as sessões interativas no terminal e no VS Code passam a iniciar em modo automático, em todos os planos e com todos os fornecedores. A versão 2.1.283 já o tinha feito em 25 de setembro para fornecedores terceiros e sessões sem telemetria; a 2.1.284 generaliza a mudança, e a definição permissions.defaultMode mantém a prioridade. Uma nova resposta, «Sim, mas pergunta novamente da próxima vez» (Yes, but ask again next time), autoriza uma única leitura fora dos diretórios de trabalho e faz com que o Claude Code volte a pedir autorização nas seguintes.
O Ultracode sai do controlo do nível de esforço e passa a ter uma opção independente em /effort (tecla Tab, ou /effort ultracode on e off): deixa de impor o nível de esforço xhigh e permanece ativo qualquer que seja o nível escolhido, com uma opção equivalente por baixo do controlo do nível de esforço no VS Code.
| Novidade da versão 2.1.284 | Comando ou definição |
|---|---|
| Modo automático predefinido em todos os planos e fornecedores | permissions.defaultMode mantém a prioridade |
| Ultracode com opção independente | Tab em /effort, ou /effort ultracode on e off |
| Reconexão conjunta dos servidores MCP com falhas | /mcp reconnect all |
| Gastos em dólares para o gateway Claude apps | /usage e linha de estado (campos used_usd, limit_usd, period) |
| Segunda compactação se « Prompt is too long » persistir | automática |
Na segurança, os plugins provenientes de marketplaces, do claude.ai ou do npm deixam de poder aprovar previamente as suas próprias ferramentas quando a administração permite apenas as regras que gere (allowManagedPermissionRulesOnly); as regras de .claude/rules associadas por ligação simbólica a partir de fora do projeto passam a exigir aprovação; e o carregamento da memória neutraliza, em MEMORY.md, caracteres invisíveis e etiquetas que imitam a marcação do Claude Code. Quanto à fiabilidade, uma resposta em streaming danificada é novamente tentada em vez de apresentar « JSON Parse error », e as chamadas MCP de uma sessão retomada aguardam até 10 segundos pelo respetivo servidor. Por fim, quando as salvaguardas de um modelo Sonnet assinalam uma mensagem, o aviso fornece mais explicações e sugere alterar o pedido e voltar a enviá-lo.
Codex CLI 0.158.0: cópia ao selecionar e segredos de cliente OAuth para MCP
28 de setembro — Publicada às 05h07 UTC, a versão 0.158.0 do Codex CLI é a primeira versão estável desde a 0.157.1, de 26 de setembro; as suas notas enumeram 188 pull requests desde a 0.157.0. A interface de terminal em ecrã inteiro (fullscreen TUI) permite configurar a cópia ao selecionar (copy-on-select) e a colagem com o botão direito do rato, e um excerto copiado da transcrição conserva a formatação Markdown.
| Funcionalidade | Definição ou detalhe |
|---|---|
| Cópia ao selecionar | tui.copy_on_select: auto por predefinição (tmux, Zellij, terminais macOS diretos, exceto Ghostty e Kitty), always, never |
| Colagem com o botão direito | tui.right_click_paste: auto (Windows, Linux, WSL), on (também macOS), off |
| Servidores MCP com OAuth | codex mcp add --oauth-client-secret, chave oauth.client_secret |
| Exec-server | Tokens de portador para ligações WebSocket diretas |
| Geração de imagens | Fundo transparente explícito (transparent_background), edição de imagens da conversa |
O Codex consegue agora ligar-se a servidores MCP que exigem um cliente OAuth previamente registado com um segredo, e as ligações WebSocket diretas ao exec-server podem ser protegidas por tokens de portador (bearer tokens), incluindo quando passam pelo app-server. Na segurança, a aprovação das entradas enviadas a um terminal passa a estável e fica ativa por predefinição para comandos executados com permissões elevadas. As correções incidem sobretudo sobre os ambientes isolados: caminhos comuns do Windows 10, credenciais armazenadas rejeitadas, arranque em Linux com raízes graváveis aninhadas e proteção dos metadados Git em Linux e macOS.
Copilot CLI 1.0.89 chega à versão estável, o SDK Copilot 1.0.15 passa a tipar as suas saídas
28 de setembro — O GitHub lança o Copilot CLI 1.0.89 em versão estável (19h20 UTC). A prévia 1.0.89-5, descrita em 27 de setembro, já incluía suporte para ficheiros .claude/rules; entre as 35 entradas das notas de versão, há várias novidades. O encaminhamento Auto sugere agora um nível, que pode ser alterado por atalho ou com um clique, e deixa de oferecer o perfil Fast, que não era suportado: uma preferência Fast guardada passa a Balance. A criação de pull requests segue os modelos do repositório, incluindo secções obrigatórias e listas de verificação. Numa sessão local, premir Escape duas vezes num campo de entrada vazio recupera um prompt cujo turno ainda não começou, e os plugins instalados diretamente podem ser ativados e desativados (copilot plugin enable). No ambiente isolado, funcionam os comandos gh e git envolvidos por timeout 60 gh …, e o localhost fica acessível no Windows quando o acesso à rede local está ativado.
Logo a seguir (19h38 UTC), o SDK GitHub Copilot, que incorpora o ambiente de execução de agentes do Copilot numa aplicação, chega à versão 1.0.15 após cinco prévias. A principal novidade são saídas estruturadas tipadas nos seis SDKs (TypeScript, Python, Go, Java, C# e Rust): o programador fornece um esquema JSON ou um tipo idiomático, e o modelo devolve uma saída tipada e validada em vez de texto livre. Um mecanismo experimental também permite que a aplicação exija uma revisão humana antes da instalação de um servidor MCP ou de um skill, com uma decisão explícita (confirmar, recusar ou cancelar). Em Rust, a memória retida pela instalação desse ambiente de execução diminui cerca de 99%.
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devin fica 30 a 40 % mais barato, com Devin Fusion no topo do FrontierCode 1.1 Extended
28 de setembro — A Cognition anuncia uma redução acentuada no custo de utilização do Devin: menos 30 a 40 % nos modos Fusion e Normal, menos 15 a 20 % no modo Ultra e até menos 70 % no Devin Review, a sua ferramenta de revisão de código. A empresa atribui estes ganhos à integração dos modelos mais recentes, incluindo o seu SWE-2, e ao trabalho no cloud harness do Devin: mais ações agrupadas numa única chamada de ferramenta (formatar, analisar e testar de uma só vez), chamadas independentes executadas em paralelo e melhor reutilização da cache de prompts. Os valores indicativos apresentados para esse harness vêm de exemplos ilustrativos, não de medições.
A Cognition afirma ter mantido ou melhorado a inteligência de cada modo. O Fusion combina um modelo principal capaz com um auxiliar (sidekick) menos dispendioso, e o gráfico da publicação coloca-o no topo do FrontierCode 1.1 Extended.
| Configuração avaliada pela Cognition | Pontuação FrontierCode 1.1 Extended | Custo médio por tarefa |
|---|---|---|
| Devin Fusion | 68,8 | 0,60 dólar |
| Opus 5.5 (high) | 65,2 | 0,90 dólar |
| Fable 5.1 (medium) | 63,6 | 2,68 dólares |
| GPT-6 Astra (high) | 63,1 | 2,62 dólares |
| SWE-2 (high) | 60,1 | 0,64 dólar |
| GPT-6 Sol (high) | 59,6 | 0,87 dólar |
Os valores de Opus 5.5 (65,2) e GPT-6 Astra (63,1), apresentados com o nível de esforço high, diferem dos do gráfico publicado no mesmo dia para Sonnet 5.5 (65,3 e 64,5), que não especifica o nível de esforço. Esta versão mais económica do Devin está disponível a partir de hoje, sem que tenha sido publicada uma nova tabela de preços.
🔗 O Devin é agora até 40 % mais económico
Notas de versão do Devin de 25 de setembro e versão beta do Devin Mobile
25 de setembro — Até agora pouco divulgadas, as notas de versão do Devin de 25 de setembro acrescentam 57 integrações MCP alojadas (hosted MCP) à Marketplace, incluindo Buildkite, Brex, Expo, Vanta, WorkOS e Wix. O Devin também produz um relatório HTML interativo quando lhe é pedido um relatório que beneficie desse formato (gráficos, tabelas, diagramas), sem que o formato seja especificado. Uma sessão filha começa com um resumo da sessão mãe, apresentado como uma etiqueta removível na área de entrada, e uma sessão cuja máquina entrou em suspensão reativa-se assim que alguém abre um URL de pré-visualização ou se liga a ela por SSH. As automatizações podem ser executadas num Outpost partilhado, e o Devin lê os registos do Azure Pipelines relativos a verificações falhadas em pull requests do Azure DevOps.
Em 28 de setembro, a Cognition abre também uma lista de espera para a versão beta do Devin Mobile. A página de inscrição resume-o numa frase: o Devin funciona na cloud ou na máquina do utilizador, testa no seu próprio navegador e só para quando a pull request está pronta para ser integrada. Não foram divulgados uma data de disponibilidade geral nem preços.
🔗 Notas de versão do Devin · Devin Mobile no X
Zed anuncia Delta 0.18, Gemini CLI publica uma nightly sem alterações
28 de setembro — A Zed anuncia, sem indicar uma data, que a versão 0.18 do Delta, o seu ambiente colaborativo para programar com agentes, executará os fios de conversa (threads) do Delta em worktrees Git já existentes; a 0.17, publicada em 23 de setembro, já isolava cada tarefa paralela no seu próprio espaço de trabalho. Do lado da Google, a nightly do Gemini CLI publicada em 28 de setembro não contém alterações: assenta no mesmo commit da versão de 26 de setembro, enquanto a versão estável v0.61.0 e a prévia v0.62.0-preview.0 se mantêm.
🔗 Zed no X · Gemini CLI v0.63.0-nightly.20260928
A Agent API da Perplexity passa a permitir reutilização: Profiles, Skills com versões e conectores partilhados
28 de setembro — A Perplexity acrescenta à sua Agent API uma camada de configuração reutilizável e com versões, concebida para equipas. O elemento central, o Profile, guarda sob um único identificador com versão tudo o que define um agente: modelo, instruções, ferramentas, Skills, conectores e definições de execução. Um administrador do projeto configura o agente uma vez e disponibiliza-o aos programadores autorizados; cada aplicação só precisa de fornecer os seus próprios dados.
Os Skills personalizados agrupam instruções, procedimentos e ficheiros de apoio num formato com versões: uma equipa de plataforma pode guardar neles as suas verificações de implementação, os critérios de reversão (rollback) e o formato dos relatórios, e depois publicar uma nova versão em vez de alterar cada aplicação. Os conectores geridos (managed connectors), lançados no fim de agosto, tornam-se um recurso que o administrador partilha com todo o projeto: as aplicações referenciam-nos sem que cada uma tenha de guardar as respetivas credenciais e definições de ferramentas.
| Recurso adicionado | Função na Agent API | Disponibilidade anunciada |
|---|---|---|
| Profiles | Modelo, instruções, ferramentas, Skills, conectores e definições de execução sob um identificador com versão | Disponível |
| Skills personalizados | Instruções, procedimentos e ficheiros de apoio com versões, invocados pelos membros do projeto | Disponível |
| Conectores geridos | Integrações aprovadas partilhadas pelo administrador (GitHub, Slack, Google Drive, Datadog, Linear, Notion) | Prévia |
Tudo é configurado na API Console, e os membros acedem a esses recursos com uma chave de API do mesmo projeto; a publicação não anuncia preços. No mesmo dia, uma entrada no registo de alterações da API muda a predefinição xhigh da Agent API de GPT-5.6 Sol (openai/gpt-5.6-sol) para Claude Opus 5.5 (anthropic/claude-opus-5-5), mantendo inalterados os prompts, o nível de esforço de raciocínio, as ferramentas, os orçamentos de tokens e os limites de etapas. Três dias antes, as predefinições low, medium e high tinham passado para GPT-6.
🔗 A Agent API passa a suportar agentes reutilizáveis · Registo de alterações da API Perplexity
SpaceXAI lança Team Bots, Grok Bots partilhados por uma equipa inteira
28 de setembro — A SpaceXAI lança os Team Bots, Grok Bots criados para uma função ou um fluxo de trabalho de equipa e partilhados por todos os seus membros, embora cada pessoa também possa trabalhar individualmente com o Bot. O Bot é comum, mas as conversas permanecem privadas: o contexto e as memórias são separados por utilizador, enquanto os skills são partilhados pela equipa. Cada Team Bot tem a sua própria identidade no Slack e pode ser convidado para um canal onde toda a equipa lhe faz perguntas.
| Componente do Bot | Função descrita pela SpaceXAI |
|---|---|
| Contexto | Ficheiros, instruções e skills |
| Plugins | Trabalho no Salesforce, Notion ou GitHub, com ligações individuais ou para a equipa |
| Credenciais | Acesso a APIs de terceiros que não têm plugin |
| Memórias | O que o Bot retém para melhorar na sua função, separado por utilizador |
A SpaceXAI descreve as suas próprias utilizações. Cada grande cliente comercial tem o seu Team Bot, que analisa durante a noite as notícias sobre o cliente, as chamadas do Gong, os documentos do Notion e os fios de conversa do Slack, e depois publica um resumo matinal no Slack. O Bot de engenharia, ligado ao Notion, Linear, Hex, Datadog e Cursor, coordenou centenas de Cloud Agents: uma equipa de cinco pessoas entregou assim mais de 100 pull requests por dia e lançou os Team Bots em poucas semanas. Entre os clientes, a seguradora Harper afirma ter criado em 24 horas um Team Bot que ajuda os seus clientes a reativar apólices expiradas, permitindo-lhes poupar mais de 120 000 dólares, segundo o seu diretor executivo.
Os Team Bots estão disponíveis a partir de hoje em versão beta pública nos planos Teams e Enterprise, com Team Bots pré-configurados para vendas, gestão de produto, marketing e análise de dados. A SpaceXAI não divulga preços nem quotas.
🔗 Team Bots (SpaceXAI) · Anúncio de @bot no X
H Company publica Holo4, modelos de agentes de pesos abertos de 27B e 35B-A3B
28 de setembro — A H Company publica Holo4, a sua nova série de modelos de agentes, em dois tamanhos: um modelo denso com 27 mil milhões de parâmetros e uma mistura de especialistas (Mixture of Experts) 35B-A3B, ambos disponibilizados pela API H Models e publicados no Hugging Face em BF16, FP8, NVFP4 e GGUF de 4 bits. A H acrescenta o Holotron4 Nano, obtido através da aplicação da sua receita de pós-treino ao Nemotron 3 Nano Omni da NVIDIA. O mesmo modelo atua através da interface gráfica, de código, de MCP ou de APIs, num computador, na web, em Android ou num ambiente isolado de código; a H treinou-o com aprendizagem supervisionada e, depois, por reforço, nomeadamente em cerca de 10 000 tarefas verificáveis geradas pela sua Agentic Task Factory a partir de documentação simples.
| Modelo avaliado | Base e licença | Pontuação publicada |
|---|---|---|
| Holo4 27B | Qwen3.8-27B, CC-BY-NC-4.0 (não comercial) | 61,7 % no OSWorld 2.0; 85,2 % no OSWorld a 0,08 dólar por tarefa |
| Holo4 35B-A3B | Qwen3.6-35B-A3B, Apache-2.0 | 30,9 % no OSWorld 2.0 |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni, NVIDIA Open Model Agreement | ganhos face ao modelo de base apresentados apenas num gráfico |
| Claude Opus 5.5 (referência citada pela H) | modelo fechado | 81,8 % no OSWorld 2.0 |
A H especifica as condições: o Holo4 é medido no seu próprio harness, com uma única execução no OSWorld 2.0, e comparado com pontuações públicas obtidas com outros harnesses e níveis de esforço; no AutomationBench, 480 das 600 tarefas públicas pertencem à divisão usada para recolher os dados de treino. A H publica todas as trajetórias subjacentes às suas pontuações públicas, que podem ser consultadas passo a passo ou descarregadas do Hugging Face, e anuncia versões preliminares de DSpark para acelerar a inferência nos próximos dias.
🔗 Publicação sobre o Holo4 no Hugging Face · Anúncio da H Company
Robótica: SAIL da Sakana AI passa de 25 para 73 % de sucesso, ProjectSim questiona a medição em simulação
28 de setembro — A Sakana AI apresenta o SAIL (Scaling In-Context Imitation Learning), um trabalho realizado com a Universidade de Tóquio e aceite na conferência IROS 2026; o artigo tem um identificador arXiv de março de 2026, sendo a novidade do dia a sua apresentação pública. A questão colocada é: será possível obter movimentos robóticos fiáveis de um modelo de visão e linguagem (VLM) existente, sem o voltar a treinar, atribuindo-lhe mais capacidade de cálculo durante a inferência?
O SAIL gera uma trajetória completa a partir de algumas demonstrações bem-sucedidas incluídas no contexto e executa-a em simulação; um segundo VLM estima então, a partir do vídeo, o progresso da tarefa, e essa informação orienta uma pesquisa em árvore de Monte Carlo (MCTS). Só a trajetória selecionada é enviada para o robô real. O Gemini Robotics-ER 1.5 desempenha os dois papéis, sem alteração dos seus pesos.
| Método avaliado | Nós de pesquisa | Sucesso médio em seis tarefas simuladas |
|---|---|---|
| Geração única | 1 | 25 % |
| Pesquisa em profundidade | 15 | 37 % |
| Pesquisa em largura | 15 | 51 % |
| SAIL | 6 | 55 % |
| SAIL | 15 | 65 % |
| SAIL | 45 | 73 % |
Estas taxas contam as configurações (20 por tarefa, no simulador ALOHA) para as quais é encontrada uma trajetória bem-sucedida dentro do orçamento, sendo o sucesso verificado pelo simulador e não pelo VLM. Num braço LeRobot SO-101, o SAIL tem sucesso em 5 de 6 tentativas de colocar um bloco numa tigela, com um orçamento de 15 trajetórias candidatas; uma política de imitação treinada com as trajetórias encontradas também tem sucesso em 5 de 6 tentativas, com execução mais rápida. A Sakana reconhece as limitações: execução em malha aberta, cálculo adicional para a pesquisa e avaliação no mundo real limitada a uma tarefa e seis tentativas por método.
🔗 Publicação da Sakana AI · Página do projeto SAIL
ProjectSim faz um balanço dos benchmarks de robótica
28 de setembro — A diferença entre os resultados simulados e os reais é precisamente o tema do primeiro experimento da ProjectSim. Em um artigo de síntese sem resultados próprios, Luca Cilio analisa os benchmarks de manipulação, do MetaWorld e do LIBERO até aos testes físicos partilhados, como o RoboChallenge, e recorda, com base nos números do RoboCasa365, que o GR00T N1.5, ajustado com 30 000 demonstrações, executa com sucesso 43 % das competências isoladas, mas cai para 4,4 % em combinações ausentes do seu ajuste. O experimento da ProjectSim procura determinar se cenas simuladas mais fiéis (com geometria, aparência e propriedades físicas reconstruídas) aproximam os resultados da simulação dos medidos num robô real; ainda não foram publicados resultados.
Mistral abre em Munique um centro dedicado à IA industrial e à IA para a física
28 de setembro — A Mistral abre um centro em Munique. O local acolherá equipas de investigação em IA para a física (Physics AI) e IA industrial (Industrial AI), juntamente com engenheiros de aplicações que trabalham diretamente para empresas parceiras: a Mistral apresenta-se aí como parceira tecnológica de longo prazo, em vez de fornecedora de software.
| Parceiro citado pela Mistral | Trabalho anunciado |
|---|---|
| BMW | Simulação de colisões e IA para engenharia |
| Siemens Energy | Aplicações de IA industrial |
| Universidade Técnica de Munique (TUM) | Gémeos digitais em túnel de vento para a aerodinâmica automóvel |
Este centro dá continuidade à aquisição da Emmi AI em maio de 2026, que trouxe para a Mistral mais de 30 físicos, investigadores e engenheiros especializados em dinâmica de fluidos computacional (CFD), mecânica estrutural e simulações multifísicas. Com a TUM e o professor Nikolaus A. Adams, a Mistral desenvolverá gémeos digitais para a aerodinâmica automóvel, combinando medições em tempo real de sensores de túnel de vento com simulações CFD calculadas fora de linha, para obter previsões aerodinâmicas precisas em tempo real.
O artigo retoma o argumento da soberania (pesos acessíveis ao cliente, modelos executados na sua própria infraestrutura e ao abrigo do direito europeu, sem que os dados saiam da organização) e indica que a Mistral construirá um gigawatt de capacidade computacional europeia até 2030. Cita o ministro federal alemão da Transformação Digital, Karsten Wildberger, e o chefe da Chancelaria de Estado da Baviera, Florian Herrmann. A Mistral está a recrutar na região de Munique, sem indicar o número de postos de trabalho nem o montante do investimento.
🔗 Hallo, Deutschland! (Mistral AI)
NVIDIA e Nscale medem o DSX MaxLPS: mais 37 % de GPUs e mais 49 % de débito com o mesmo orçamento energético
27 de setembro — A NVIDIA publica uma avaliação quantitativa do DSX MaxLPS, o seu software que distribui a potência entre os recursos de uma fábrica de IA segundo as políticas do operador, realizada com a Nscale. Segundo a NVIDIA, permite instalar até mais 40 % de GPUs com o mesmo orçamento energético aprovado; o artigo sublinha um ponto: trata-se de uma distribuição coordenada, não de um aumento da alimentação elétrica das instalações.
O teste foi realizado com GB300 NVL72 no centro de dados da Nscale no campus Verne, em Keflavík (Islândia), inteiramente alimentado por energia renovável, com Kimi K2.5 em FP4, NVIDIA Dynamo e TensorRT LLM. Com o mesmo orçamento provisionado de 264,4 kW, a frota passa de 140 para 192 GPUs sem redução do débito das instâncias existentes.
| Indicador medido | Base estática | Com DSX MaxLPS | Diferença registada |
|---|---|---|---|
| GPUs geridas | 140 | 192 | +37,1 % |
| Débito agregado normalizado | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| Potência total medida | 166,2 kW | 198,9 kW | +19,7 % |
| Utilização do orçamento energético | 62,9 % | 75,2 % | +12,3 pontos |
| Débito por watt provisionado | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
O artigo não esconde a contrapartida: embora as latências mediana e P75 fiquem a menos de 5 % da referência, o P99 do tempo até ao primeiro token sobe 17 %, partindo de uma base de 15,7 segundos. A NVIDIA recomenda aos operadores uma validação em cinco etapas, desde a delimitação do perímetro elétrico até à definição dos limites de produção. Esta avaliação sucede à validação da Lambda em HGX B200, apresentada em 15 de setembro (19 nós dentro do orçamento de 16); as projeções para Vera Rubin, com refrigeração líquida a 45 °C à entrada, são apresentadas à parte.
Notícias breves
- DeepSeek Harness 0.2.0-rc.1 — Primeira release candidate da série 0.2.0 e 23.ª versão preliminar do harness de agentes da DeepSeek, ainda sem versão estável: as conversas sobre os modelos da conta DeepSeek pesquisam na web sem uma chave de API adicional, e as tarefas automatizadas passam para um pacote opcional de plugins. 🔗 fonte
- Pixel Canary no Vercel AI Gateway — Desde 25 de setembro, a Vercel disponibiliza gratuitamente, durante o seu período de acesso reservado, este modelo de código de um fornecedor não identificado: 28 tarefas Next.js em 31 em pass@4, em igualdade com GPT-6 Astra (high), e 30 em 31 com a documentação fornecida através de AGENTS.md; sem retenção zero de dados. 🔗 fonte
- Runners autoalojados do GitHub Actions — No GitHub Enterprise Cloud, a aplicação integral das versões mínimas começa em 29 de setembro: abaixo da versão 2.329.0, um runner deixa de poder registar-se, e um runner abaixo da versão mínima de execução deixa de aceitar jobs; uma nova API REST fornece as datas de fim de suporte. O GitHub Enterprise Server não é afetado. 🔗 fonte
- NexteraBERT — Rikka Botan publica um encoder bidirecional de 212,6 milhões de parâmetros, pré-treinado em 130 mil milhões de tokens (cerca de 15 vezes menos do que o ModernBERT): 87,90 no GLUE contra 87,97 para o ModernBERT-base, 54,70 contra 53,63 no MTEB v2 e um débito 5,22 vezes superior com 65 536 tokens, segundo as suas próprias medições; código sob licença MIT. 🔗 fonte
- LTX-2.5 em tempo real — Um artigo da comunidade leva este modelo de áudio e vídeo de 22 mil milhões de parâmetros de 90 segundos por clip a uma geração mais rápida do que a reprodução: 1,83 segundo para um clip de 5 segundos numa placa de 96 Go, graças a 4 etapas em vez de 8, ao processamento NVFP4 e ao CUDA Graph; código sob Apache-2.0. 🔗 fonte
- SCRIBE — A Adalat AI, que desenvolve reconhecimento de voz para os tribunais indianos, publica no PyPI esta ferramenta de avaliação open source (artigo na Interspeech 2026), que avalia separadamente palavras, números, pontuação e termos especializados, enquanto a taxa de erro por palavra atribui 100 % a uma frase em malaiala que nenhum revisor alteraria. 🔗 fonte
- 228 projetos JEV — Eric Kang, responsável pela lista Awesome JEV, seleciona 228 projetos open source (10 tipos, mínimo de 50 estrelas, cada um fixado num commit) entre os 13 473 repositórios devolvidos por uma pesquisa por « jev » no GitHub, total que inclui projetos sem relação com o tema: uma seleção manual, não um levantamento independente. 🔗 fonte
- HeyGen e Jev — A HeyGen publica no X um guia que coloca Jev, o modelo de decisão da TypeSafe AI, à frente do seu servidor MCP: Jev classifica cerca de quarenta potenciais clientes (vídeo ou não, abordagem, língua, adequação), Claude escreve os guiões e, depois, o MCP HeyGen produz o lote, a única etapa que consome créditos e aguarda validação. 🔗 fonte
- Quatro criações com Gemini 3.8 Flash — O blog da Google apresenta quatro projetos construídos com o modelo lançado em 2 de setembro: um sistema de acompanhamento de satélites em direto criado com Antigravity, ondas Seigaiha animadas, um esqueleto 3D de tiranossauro e uma caixa de velocidades automática com 10 perspetivas de câmara; sem números nem novidades de produto. 🔗 fonte
- Um serviço de catering de Brooklyn e Gemini — O blog da Google conta como Edy Massih, proprietário da mercearia Edy’s Grocer em Greenpoint, utiliza Gemini para adaptar as suas receitas a 200 convidados, gerar listas de compras e ajustar os menus a diferentes regimes alimentares; nenhuma funcionalidade nova. 🔗 fonte
- Lenfest Institute — A OpenAI investe 5 milhões de dólares, mais até 5 milhões de dólares em créditos de software e apoio de engenharia, na fase seguinte do programa de bolsas de IA do Lenfest Institute, lançado em 2024 em 11 redações norte-americanas: o dobro do apoio anterior. 🔗 fonte
- Separador Saúde do ChatGPT — Selecionar um gráfico, uma métrica ou um registo no separador Health passa a fornecer explicações personalizadas, por vezes com um gráfico interativo, sem ser necessário escrever um prompt; Health continua disponível apenas nos Estados Unidos (maiores de 18 anos, planos Free, Go, Plus e Pro, web e iOS). 🔗 fonte
- Vencedores do WebMCP Challenge — A OpenAI Developers apresenta os dez projetos vencedores do hackathon lançado no fim de agosto (MASIL, Alza, ArchMorph, Aisle, Roque Nights, Mandate, Observatory, Bouquet Studio, Faraday, JupyterLite WebMCP), sem classificação nem montante por projeto. 🔗 fonte
- Correção de segurança no macOS — Em 25 de setembro, a versão 26.924.20706 da aplicação de desktop para macOS, incluída na secção da aplicação Codex do changelog do ChatGPT e do Codex, corrigiu a vulnerabilidade CVE-2026-100754 comunicada por Patrick Wardle (Objective-See Foundation), sem descrição da falha. 🔗 fonte
O que isto significa
O preço do token já não muda; o que diminui é o número de tokens. O Sonnet 5.5 mantém o preço do Sonnet 5, mas custa, segundo a Anthropic, até menos 30 % por tarefa porque consome menos tokens; o Devin torna-se 30 a 40 % mais barato ao integrar os seus modelos mais recentes, incluindo o SWE-2, e ao agrupar as chamadas a ferramentas; a Manus anuncia uma redução de 32 % no custo de execução com o seu novo harness, numa configuração testada. O fator decisivo já não é o preço anunciado, mas a quantidade de trabalho consumida, tanto pelo modelo como pelo harness, e os modelos intermédios aproximam-se dos de topo: no Terminal-Bench 4.0, o Sonnet 5.5 supera o resultado do Opus 5.5 medido com esforço Xhigh.
Os agentes ganham autonomia por predefinição, e os mecanismos de proteção passam para fora do seu alcance. O Claude Code passa a iniciar em modo automático em todos os planos, enquanto a NVIDIA instala a monitorização num DPU a que o agente não consegue aceder e sujeita, por predefinição, a validação humana qualquer regra de acesso que ele proponha. As ferramentas seguem a mesma linha: o Codex CLI submete a aprovação as entradas no terminal para comandos com permissões elevadas, e o SDK Copilot permite exigir uma revisão humana antes da instalação de um servidor MCP ou de um skill. Quanto mais o agente atua sozinho, mais o controlo precisa de estar fora do próprio agente.
O agente torna-se também um membro da equipa, com uma identidade própria. Os Profiles da Perplexity transformam um agente numa configuração versionada que todo um projeto pode reutilizar, os Team Bots da SpaceXAI têm o seu próprio identificador Slack e mantêm memórias separadas para cada utilizador, e os agentes da Cue recebem um endereço de e-mail, um número de telefone e uma carteira. Um agente capaz de pagar, telefonar ou escrever em nome de alguém torna muito concretas as questões de controlo levantadas pela NVIDIA no mesmo dia.
Por fim, os números do dia exigem uma leitura atenta. O Devin mede o Sonnet 5.5 numa variante do FrontierCode que o seu tweet e o seu gráfico designam de formas diferentes, e dois gráficos da Cognition publicados no mesmo dia apresentam resultados diferentes para o Opus 5.5; o Holo4 é medido no harness da H, numa única execução no OSWorld 2.0; os 73 % do SAIL são obtidos em simulação, e a diferença entre simulação e realidade é precisamente o objeto do primeiro experimento da ProjectSim. Quanto aos meios de comunicação, o Eleven v4 apoia-se numa classificação externa e em testes cegos, enquanto o Kling 4.0 chega sem benchmark nem preços, com parte das suas funcionalidades remetida para mais tarde.
Fontes
- Apresentação do Claude Sonnet 5.5 (Anthropic)
- Guia de migração para o Claude Sonnet 5.5
- @ClaudeDevs: recomendações de esforço para o Sonnet 5.5
- Claude Sonnet 5.5 no GitHub Copilot
- Modelos e preços do GitHub Copilot
- Claude Sonnet 5.5 no Devin
- @cognition: Sonnet 5.5 no FrontierCode 1.1 Main
- @cursor_ai: Sonnet 5.5 no Cursor
- @v0: Sonnet 5.5 no v0
- NVIDIA lança a Open Agent Safety Platform (comunicado)
- Arquitetura da Open Agent Safety Platform (NVIDIA)
- Adicionar controlos de execução aos agentes de IA com NVIDIA OpenShell
- @NVIDIAAI: Jensen Huang na CNBC
- @togethercompute: parceiro de lançamento
- @perplexity_ai: parceria com a NVIDIA
- Apresentação do Manus 2.0
- @ManusAI: lançamento do Cue
- @ManusAI: números de telefone dos agentes
- Apresentação do Eleven v4 (ElevenLabs)
- @ElevenLabs: sequência de publicações de anúncio do Eleven v4
- Notas de versão do Kling 4.0
- @Kling_ai: anúncio do Kling 4.0
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- O Devin é agora até 40 % mais eficiente em termos de custos
- Notas de versão do Devin de 25 de setembro
- @cognition: versão beta do Devin Mobile
- @zeddotdev: Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- A Agent API passa a suportar agentes reutilizáveis (Perplexity)
- Changelog da API Perplexity
- Team Bots (SpaceXAI)
- @bot: anúncio dos Team Bots
- Holo4 no blog Hugging Face
- Holo4 (H Company)
- SAIL (Sakana AI)
- Página do projeto SAIL
- Benchmarks de robótica: onde estamos e o que vem a seguir (ProjectSim)
- Hallo, Deutschland! (Mistral AI)
- Como o NVIDIA DSX MaxLPS maximiza o débito e a eficiência das fábricas de IA
- DeepSeek Harness 0.2.0-rc.1
- Pixel Canary no Vercel AI Gateway
- A data de aplicação das versões dos runners autoalojados foi alterada (GitHub)
- Relatório técnico do NexteraBERT
- Personagens falantes em tempo real a partir de um modelo de difusão de vídeo de 22B
- SCRIBE (Adalat AI)
- JEV: 228 projetos selecionados (Eric Kang)
- @HeyGen: guia de Jev e MCP HeyGen
- Veja o que quatro criadores estão a fazer com o Gemini 3.8 Flash (Google)
- Três formas de esta mercearia cozinhar para 200 convidados com Gemini (Google)
- Lenfest AI Collaborative: nova fase (OpenAI)
- Notas de versão do ChatGPT
- @OpenAIDevs: vencedores do WebMCP Challenge
- Changelog do ChatGPT e do Codex: CVE-2026-100754