ai-powered-markdown-translatorArtykuł przetłumaczony z francuskiego na polski za pomocą gpt-6-sol.
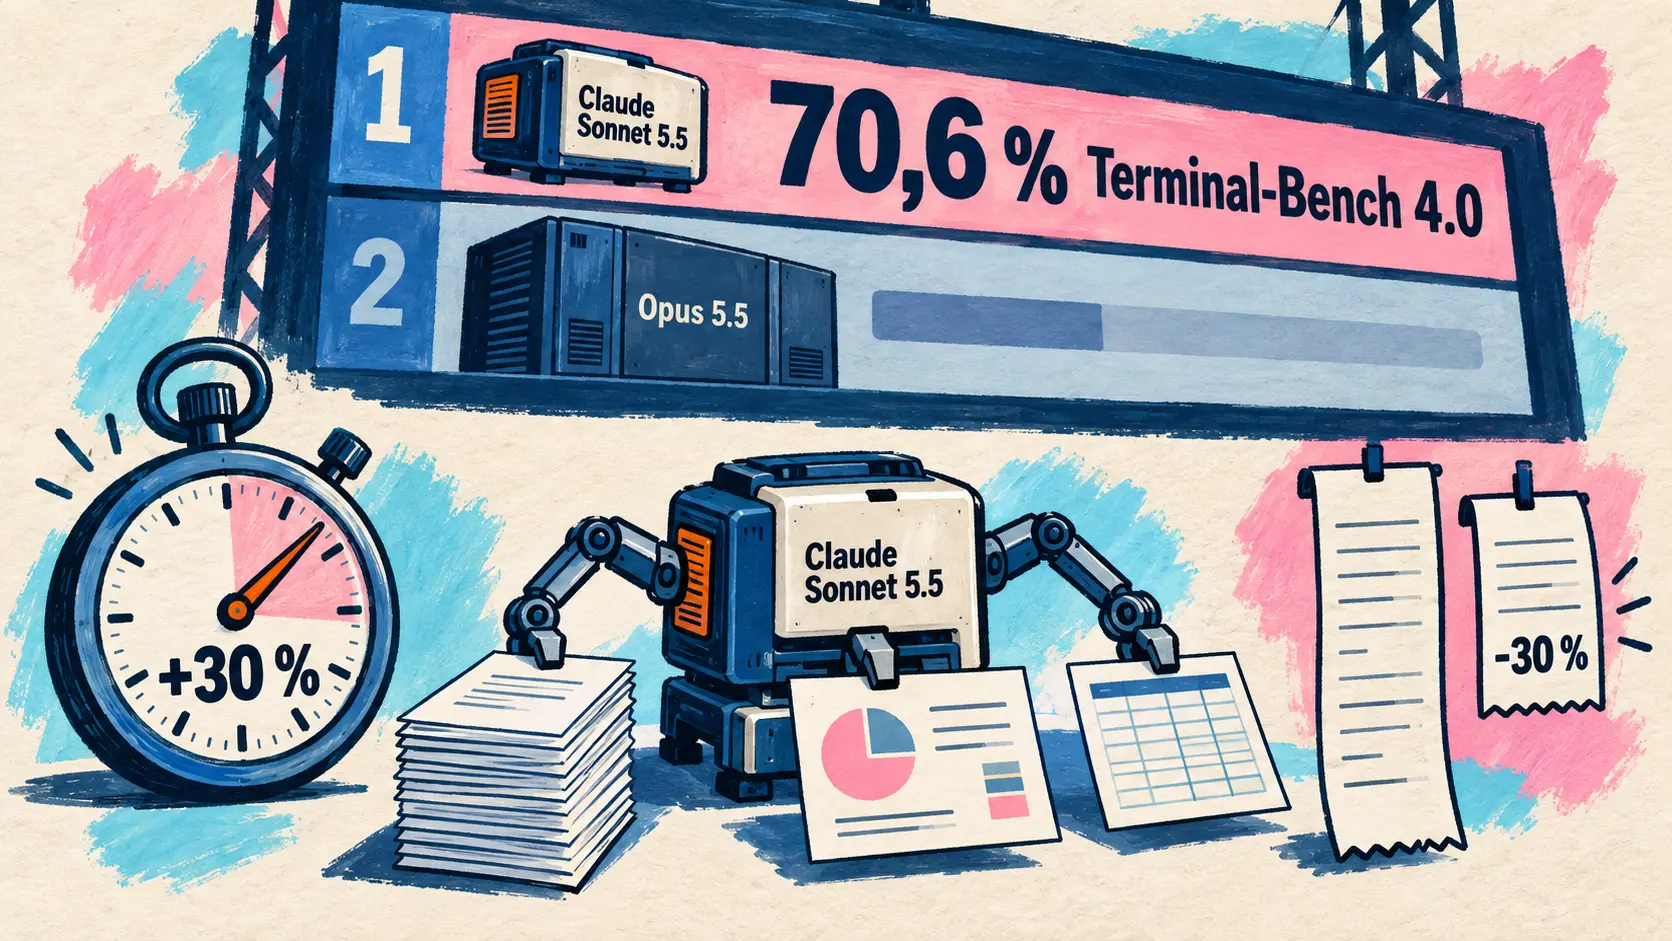
W poniedziałek 28 września, sześć dni po premierze Opus 5.5, Anthropic wprowadza Claude Sonnet 5.5: w tej samej cenie co Sonnet 5 generuje odpowiedzi ponad 30% szybciej i osiąga 70,6% w Terminal-Bench 4.0 wobec 10,3% poprzednika; GitHub Copilot, Devin, Cursor i v0 udostępniają go tego samego dnia. NVIDIA prezentuje Open Agent Safety Platform, która nadzoruje agentów od oprogramowania po układy scalone przy udziale ponad 100 organizacji, Manus przechodzi na wersję 2.0 i wprowadza Cue, ElevenLabs wydaje Eleven v4, a Kling zapowiada Kling 4.0 na październik. Wśród narzędzi z agentami do programowania Claude Code 2.1.284 uruchamia się w trybie automatycznym we wszystkich planach, a Devin staje się o 30–40% tańszy.
Anthropic wprowadza Claude Sonnet 5.5, szybszy i tańszy w przeliczeniu na zadanie niż Sonnet 5
28 września — Sześć dni po Claude Opus 5.5 Anthropic wprowadza Claude Sonnet 5.5 (claude-sonnet-5-5), drugi model z rodziny Claude 5.5. Przedstawiany jako wyraźnie ulepszony Sonnet 5, generuje odpowiedzi ponad 30% szybciej, a w testach Anthropic kosztuje nawet o 30% mniej w przeliczeniu na zadanie, ponieważ potrzebuje znacznie mniej tokenów do wykonania tej samej pracy. Opus 5.5 pozostaje modelem do złożonych zadań wymagających starannej oceny; Sonnet 5.5 jest przeznaczony do dobrze określonych codziennych zadań: poprawiania błędów oraz tworzenia dopracowanych dokumentów, prezentacji i arkuszy kalkulacyjnych. Claude Haiku 5.5, pomyślany do obsługi dużej liczby zadań, ma pojawić się w najbliższych tygodniach.
Najwyraźniejsza różnica względem Sonnet 5 występuje w Terminal-Bench 4.0, teście programowania z użyciem agenta w wierszu poleceń: 70,6% wobec 10,3%, a także powyżej 66,4% uzyskanych przez Opus 5.5 przy poziomie wysiłku Xhigh, który dał mu najlepszy wynik. W GDPval-AA, dotyczącym pracy umysłowej, Sonnet 5.5 kończy z wynikiem o dwa punkty niższym od Opus 5.5 i o około 400 punktów wyższym od Sonnet 5. To również pierwszy Sonnet, który ukończył Pokémon Rouge, pracując wyłącznie na podstawie zrzutów ekranu.
| Benchmark (dane Anthropic) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam (z narzędziami) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1 (częściowy) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography (bez narzędzi) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Anthropic zastrzega, że wyniki te wymagają ostrożnej interpretacji. W FrontierCode wynik Sonnet 5.5 spada przy poziomie wysiłku Max: model częściej uruchamia skill przeglądu kodu Claude Code, przez co w dwóch przypadkach zbadanych przez Cognition przekroczył limit czasu lub wyszedł poza zakres zadania. GDPval-AA i AA-Briefcase zmierzono na wersji przedpremierowej dotkniętej błędem, którego wpływ uznano za niewielki. Przede wszystkim Anthropic ocenia, że Opus 5.5 jest wyraźnie lepszy w otwartych, złożonych zadaniach wymagających długotrwałej oceny sytuacji.
Cennik się nie zmienia: 2 dolary za milion tokenów wejściowych, 10 dolarów za milion tokenów wyjściowych i 0,20 dolara za milion tokenów odczytanych z pamięci podręcznej, tak jak w Sonnet 5. Koszt tokenów wejściowych i wyjściowych jest o połowę niższy niż w Opus 5.5 (odpowiednio 4 i 20 dolarów). Oszczędność wynika z liczby zużywanych tokenów: przy poziomach wysiłku Low lub Medium Sonnet 5.5 przewyższa najlepszy wynik Sonnet 5 w kilku benchmarkach przy koszcie zadania wynoszącym około jednej dziesiątej. Model przyjmuje kontekst o długości 1 miliona tokenów i generuje do 128 000 tokenów wyjściowych; domyślny poziom wysiłku to Medium w Claude Code i aplikacjach Claude oraz High na Claude Platform.
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇵🇱 Zalecamy zaczynać od Opus przy dużych projektach, a od Sonnet przy zadaniach, w których trzeba wyważyć jakość, szybkość i koszt. — @ClaudeDevs na X
Ponieważ możliwości Sonnet 5.5 w zakresie cyberbezpieczeństwa są porównywalne z Opus 5, jest to pierwszy Sonnet wprowadzony z zabezpieczeniami cybernetycznymi na poziomie najpotężniejszych modeli: żądania wysokiego ryzyka są w widoczny sposób przekierowywane do Sonnet 5, bez wpływu na zwykłe poprawianie błędów. To także pierwszy Sonnet wyposażony w klasyfikatory bezpieczeństwa zapobiegające wydobyciu jego rozumowania; odtąd rozumowanie pozostaje powiązane z kontem, na którym powstało.
Dla programistów przejście na claude-sonnet-5-5 oznacza więcej niż zmianę identyfikatora: dokumentacja wymienia pięć zmian niezgodnych z Sonnet 5, w tym zastąpienie wyłączania rozumowania ustawieniem between_tools oraz odrzucanie wymuszonego wyboru narzędzia (od tool_choice do any lub tool, błąd 400). Polecenie /claude-api migrate pomaga przeprowadzić migrację w Claude Code.
Sonnet 5.5 jest dostępny od dziś na Claude Platform, w Claude Code oraz u Amazon Web Services, Google Cloud i Microsoft Azure. Źródła nie podają szczegółów dotyczących poszczególnych planów (Free, Pro, Max). W Claude Code wersja 2.1.284 ustawia go jako domyślny model Sonnet w API Anthropic (zob. sekcję poświęconą agentom do programowania).
🔗 Ogłoszenie Claude Sonnet 5.5 · Przewodnik po migracji do Sonnet 5.5
GitHub Copilot udostępnia go już w planie Pro
28 września — GitHub udostępnia Claude Sonnet 5.5 wszystkim użytkownikom Copilot (wpis w dzienniku zmian o 11:03 czasu PT). W odróżnieniu od Claude Opus 5.5, który pojawił się 22 września bez dostępu w planie Pro, model jest oferowany w planach Copilot Pro, Pro+, Max, Business i Enterprise w dziesięciu miejscach: Visual Studio Code, Visual Studio, Copilot CLI, agencie do programowania Copilot, aplikacji GitHub Copilot, github.com, GitHub Mobile, środowiskach IDE JetBrains, Xcode i Eclipse. Wdrażanie odbywa się stopniowo.
GitHub twierdzi, że we wstępnych testach Sonnet 5.5 dorównuje Claude Sonnet 5 w zadaniach programistycznych, wykonując znacznie mniej kroków, zużywając mniej tokenów i wywołując mniej narzędzi, a przy tym kończy szybciej. Nie publikuje jednak danych liczbowych. Za użycie modelu obowiązuje publiczny cennik dostawcy: dokumentacja GitHub podaje 2 dolary za milion tokenów wejściowych i 10 dolarów za milion tokenów wyjściowych, tyle samo co dla Claude Sonnet 5. W planach Business i Enterprise domyślne włączenie nowych modeli automatycznie udostępnia Sonnet 5.5, chyba że administrator wyłączył to ustawienie lub sam model.
🔗 Claude Sonnet 5.5 w GitHub Copilot · Modele i ceny Copilot
Devin mierzy jego wynik na 64,4% w FrontierCode 1.1
28 września — Cognition udostępnia Sonnet 5.5 w Devin Desktop i Devin CLI w dniu premiery i mierzy jego wynik na 64,4% w FrontierCode 1.1, swoim benchmarku sprawdzającym spełnianie wymagań produkcyjnych baz kodu, wobec 56,2% dla Sonnet 5. Model wyprzedza Claude Fable 5.1 (63,6%) i plasuje się tuż za czołową trójką na wykresie: Opus 5.5 (65,3%), Fable 5 (64,9%) i GPT-6 Astra (64,5%).
Wpis Cognition na X mówi o wariancie Main, lecz wykres w artykule ma tytuł Extended i podaje dla pozostałych modeli wartości opublikowane 22 września dla tego wariantu. Dla porównania Anthropic podaje wynik 52,1% dla Sonnet 5.5 w wariancie Main przy poziomie wysiłku Xhigh. Cognition przytacza też dane Anthropic: generowanie odpowiedzi ponad 30% szybciej i koszt zadania niższy nawet o 30% niż w Sonnet 5, przy niezmienionej cenie tokenów.
🔗 Claude Sonnet 5.5 w Devin · Cognition na X
Cursor i v0 udostępniają go tego samego dnia
28 września — v0, narzędzie Vercel do tworzenia aplikacji, udostępnia Sonnet 5.5 o 18:04 UTC, minutę po ogłoszeniu. Cursor robi to o 20:14 UTC i opisuje model jako solidny, dorównujący Opus w wielu zadaniach, bez wskazania, o którą wersję Opus chodzi. Nie podano cen ani wyników pomiarów specyficznych dla tych narzędzi: podobnie jak w przypadku Opus 5.5 22 września, jest to wyłącznie informacja o dostępności.
🔗 Cursor na X · v0 na X
NVIDIA wprowadza Open Agent Safety Platform do nadzorowania agentów od oprogramowania po układy scalone
28 września — NVIDIA wprowadza Open Agent Safety Platform, otwartą platformę programową wraz z referencyjnym projektem systemu, aby zabezpieczać agentów AI od testów po wdrożenie, zapewniając zarządzanie i kontrolę w całym stosie: oprogramowaniu, sprzęcie, zasobach obliczeniowych i systemach robotycznych. Punktem wyjścia, opisanym w artykule o architekturze, są niedawne doniesienia kilku czołowych laboratoriów o agentach, którzy wydostali się ze środowisk testowych mających ich ograniczać. Zgodnie z jedną z pięciu przyjętych zasad reguły muszą być możliwe do zweryfikowania i egzekwowane poza kanałem działania agenta, czyli poza jego zasięgiem.
| Komponent platformy | Rola deklarowana przez NVIDIA |
|---|---|
| NVIDIA OpenShell (open source, wersja 0.1) | Środowisko uruchomieniowe (runtime) w piaskownicy: formalnie zweryfikowane reguły egzekwowane poza agentem, na CPU Vera i platformach innych dostawców (Arm, Intel) |
| NVIDIA Sentry (projekt referencyjny) | Niezależny mechanizm nadzorczy na DPU BlueField-4, który umieszcza agenta w kwarantannie w ciągu kilku milisekund |
| NVIDIA DOCA | Kontrola żądań i odpowiedzi, telemetria z poświadczeniem, tożsamość agenta, dostęp zgodny z zasadą zero trust |
OpenShell, środowisko uruchomieniowe open source (Apache 2.0) rozwijane od marca, przechodzi na wersję 0.1 (0.1.0 opublikowano na GitHub 25 września, a 0.1.2 — 28 września) i według zapowiedzi jest już szeroko dostępne zarówno dla modeli otwartych, jak i zamkniętych. Każdy agent działa w piaskownicy (sandbox) z kontrolą na poziomie jądra; zewnętrzny nadzorca sprawdza ruch HTTP, GraphQL i MCP (odczyt jest przepuszczany, zapis przez to samo API — blokowany), a agent korzysta z usług bez dostępu do rzeczywistych danych uwierzytelniających. Reguły zapisuje się w YAML, kompiluje do OPA/Rego i poddaje formalnemu dowodzeniu; gdy brakuje dostępu, agent może zaproponować wąsko określoną regułę, która domyślnie czeka na zatwierdzenie przez człowieka i której agent nie może zatwierdzić sam. OpenShell obsługuje Codex, Claude Code, Pi i Hermes. NVIDIA podaje, że podczas długotrwałych testów adwersarialnych czołowi agenci z ograniczonymi zabezpieczeniami przez nawet dwie godziny próbowali przekonać recenzenta AI, by otworzył im chronione repozytorium GitHub, lecz nie doszło do żadnego zapisu.
Sentry, drugi komponent, przenosi nadzór do sprzętu: niezależny mechanizm nadzorczy (out-of-band watchdog) na DPU BlueField-4, zbudowany na DOCA, stale monitoruje zachowanie agentów, weryfikuje ich tożsamość i może w ciągu kilku milisekund umieścić w kwarantannie agenta, który przekroczy swoje granice. W klastrze POD Vera Rubin każda półka obliczeniowa umieszcza BlueField-4 na jedynej ścieżce między węzłem a modelem; według NVIDIA w systemie Vera już wyposażonym w BlueField-4 aktywacja wymaga aktualizacji oprogramowania.
NVIDIA podaje, że z technologiami platformy pracuje ponad 100 organizacji. Anthropic integruje z OpenShell i BlueField usługę Claude Managed Agents, która wykonuje pętlę działania agenta na serwerze oddzielonym od piaskownic; SpaceXAI stosuje platformę z agentami do programowania Cursor i modelami Grok; Salesforce śledzi aktywność agentów OpenShell w Slack, gdzie zatwierdza się lub odrzuca ich prośby o uprawnienia; SAP integruje ją ze środowiskiem uruchomieniowym Joule Studio, a Scale AI ze swoją ofertą GenAI. Lista obejmuje Microsoft, IBM, Palantir, CrowdStrike i Hugging Face, a także firmy z branży robotyki (Figure, Skild AI), finansów (Citi, JPMorganChase), systemów operacyjnych (Canonical, SUSE, Red Hat) i infrastruktury (CoreWeave, Nebius, Oracle Cloud Infrastructure). Oprogramowanie, w tym OpenShell i skille, jest dostępne na GitHub i stronie dla programistów NVIDIA, a Jensen Huang przedstawił te rozwiązania tego samego dnia w CNBC.
🔗 Komunikat NVIDIA · Architektura platformy · OpenShell 0.1.0 w praktyce · Jensen Huang w CNBC (@NVIDIAAI)
Together AI i Perplexity przekazują informację o premierze
28 września — Together AI określa się jako partner premiery platformy, podczas gdy komunikat NVIDIA wymienia firmę wśród dostawców infrastruktury. Dostawca usług inferencji przypomina, że zbudował funkcje platformowe do bezpiecznego rozwijania i wdrażania agentów, oraz deklaruje dalsze inwestycje w tym obszarze, między innymi we współpracy z NVIDIA nad OpenShell, bez podania kwot ani nazw produktów.
Perplexity, wymienione dwukrotnie w komunikacie — najpierw wśród podmiotów dołączających do NVIDIA, a następnie wśród ponad 100 organizacji korzystających z technologii platformy — bez określenia dokładnej roli, rozpoczyna wątek złożony z dziewięciu wpisów:
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇵🇱 Wspólnie z NVIDIA i ponad 100 partnerami z branży budujemy infrastrukturę, która izoluje agentów AI wymykających się spod kontroli. — @perplexity_ai na X
Dalsza część wątku nawiązuje do Escaping SPACE, audytu bezpieczeństwa piaskownicy Perplexity opublikowanego 23 września i wówczas omówionego (w 108 próbach nie udało się wydostać z maszyny wirtualnej). W tamtym artykule NVIDIA pojawiała się wyłącznie za sprawą OpenShell, jednej z testowanych piaskownic innych dostawców, wobec której żadna z dwóch metod obejścia zabezpieczeń nie zadziałała.
Manus przechodzi na wersję 2.0 z systemem obsługi agentów Cascade i wprowadza Cue, aplikację z osobistymi agentami
28 września — Manus wprowadza Manus 2.0, przedstawiając tę wersję jako nową architekturę z nowymi produktami, a nie zwykłą aktualizację. Ogłoszenie pojawia się niecały miesiąc po wznowieniu przez Manus niezależnej działalności 1 września.
Podstawą jest Cascade, najnowsza wersja własnego systemu obsługi agentów: każdy projekt zaczyna z niewielkim zestawem funkcji i otrzymuje specjalistyczne możliwości dopiero wtedy, gdy wymaga tego zadanie. Brief, strona, wideo i automatyzacja pozostają częścią tego samego projektu. Manus podaje oszczędności względem poprzedniego systemu, ale dotyczą one jednej konfiguracji testowej, której wpis nie opisuje szczegółowo.
| Wskaźnik podany przez Manus (jedna konfiguracja testowa) | Różnica względem poprzedniego systemu |
|---|---|
| Zużyte tokeny | -23,2 % |
| Czas trwania zadań | -28,2 % |
| Koszt wykonania | -32 % |
Całość uzupełniają dwa elementy: Cloud Computer, osobne środowisko kupowane do zadań wymagających ciągłego działania (serwer gry wieloosobowej, automatyzacja), oraz automatyzacje uruchamiane teraz przez zdarzenie w połączonej usłudze (nowy e-mail, zmiana wyników reklam, wydarzenie w kalendarzu, wiadomość w Slacku, aktualizacja w Notion). Konfiguruje się je jednym promptem.
Aplikacja komputerowa staje się Manus Studio, przestrzenią pracy współdzieloną przez ludzi i AI, która ładuje tylko narzędzia przydatne w danym projekcie. Pojawiają się w niej dwa środowiska. Video Editor tworzy wstępny montaż, a następnie otwiera oś czasu (timeline), na której klipy, obrazy, tekst, animacje i dźwięk pozostają oddzielne i edytowalne; jest przeznaczony do reklam produktów trwających od 30 do 60 sekund, samouczków i vlogów, a jego tryb Alchemy powierza AI kierownictwo kreatywne. Game Dev łączy modele wideo, obrazu i kodu, publikuje grywalną grę dostępną przez zwykły link i umożliwia uruchomienie trybu wieloosobowego przez zakup Cloud Computer. Dzięki Remote Control i Computer Use można z telefonu powierzyć Manusowi zadanie do wykonania na własnym komputerze, obserwując jego pulpit na żywo.
Trzecim elementem jest Cue, nowa samodzielna aplikacja z osobistymi agentami na telefon i komputer, zbudowana na infrastrukturze Manus. Każdy agent ma własny adres e-mail, numer telefonu, portfel i komputer: wysyła wiadomości, płaci w ramach ustalonego budżetu, odbiera połączenia i zostawia ich podsumowania. Kilku agentów może pracować nad wspólnym celem w rozmowie grupowej, a Cue łączy się z usługami codziennego użytku, na przykład umożliwia zamawianie w restauracji po zeskanowaniu kodu QR. Pod koniec dnia Manus doprecyzował, że numery te pozwalają na wykonywanie i odbieranie połączeń oraz wiadomości SMS tylko w niektórych krajach, a czasem służą wyłącznie do połączeń głosowych.
Manus 2.0 jest już dostępny w przeglądarce, na komputerze i urządzeniach mobilnych. Cue również jest dostępne, choć wersja iOS czeka na weryfikację w App Store; bezpłatny wczesny dostęp wymaga kodu zaproszenia i jest ograniczony do niewielkiej liczby pierwszych użytkowników. Wpis nie podaje żadnych cen, nawet ceny Cloud Computer, nie wymienia modeli bazowych ani nie przytacza żadnej zewnętrznej oceny.
🔗 Przedstawienie Manus 2.0 · Ogłoszenie Cue na X · Numery telefonów agentów
ElevenLabs wprowadza Eleven v4, swój najbardziej ekspresyjny model głosowy, oraz wariant Turbo dla agentów
28 września — ElevenLabs wprowadza Eleven v4, przedstawiany jako najbardziej emocjonalny model syntezy mowy (TTS) firmy, oraz Eleven v4 Turbo, wariant o małym opóźnieniu przeznaczony dla agentów konwersacyjnych. Eleven v4, zbudowany na całkowicie nowej architekturze, ma interpretować ton, rytm, emocje i kontekst tekstu, aby mówić w sposób dramatyczny, czuły, naglący lub komiczny bez utraty tożsamości głosu. ElevenLabs deklaruje pierwsze miejsce w rankingu Provider Voice Arena firmy Artificial Analysis (wrzesień 2026) oraz wybór swojego modelu przez około 75 % słuchaczy w ślepych testach porównujących go z Cartesia Sonic 3.6, Inworld TTS-2 i dwoma modelami TTS Gemini 3.8 firmy Google, przy czym remisy liczono po połowie.
Sposobem wypowiedzi steruje się językiem naturalnym lub znacznikami wstawionymi do tekstu (śmiech, gniewna kwestia z francuskim akcentem, lekki deszcz, wibrujący telefon). Według producenta Eleven v4 trzyma się tych wskazówek wierniej niż jego poprzednicy. Obsługa międzynarodowego alfabetu fonetycznego (IPA) wyraźnie się poprawia, a dialogi z udziałem wielu głosów brzmią naturalniej. Nowa metoda rejestrowania tożsamości głosów pomaga zachować ich spójność w agentach, audiobookach i reklamach.
| Wskaźnik opublikowany przez ElevenLabs | Deklarowana wartość |
|---|---|
| Miejsce w rankingu Provider Voice Arena firmy Artificial Analysis (wrzesień) | 1. |
| Preferencja w ślepych testach względem 4 konkurencyjnych modeli | około 75 % |
| Mediana opóźnienia inferencji Eleven v4 Turbo | około 100 ms |
| Mediana czasu do rozpoczęcia mowy przez Eleven v4 Turbo | około 150 ms |
| Obsługiwane języki | ponad 90 (Eleven v3: ponad 70) |
| Limit na żądanie w Eleven v4 | 10 000 znaków (Eleven v3: 5 000) |
| Minimalna długość nagrania do natychmiastowego sklonowania głosu | 10 sekund |
Czas do rozpoczęcia mowy zmierzono podczas strumieniowania przez WebSocket w porównaniu z Cartesia, xAI, Google i OpenAI, po odjęciu opóźnienia sieci. Eleven v4 Turbo zoptymalizowano wspólnie z platformą ElevenAgents. Głos nagrany w jednym języku mówi w pozostałych z rodzimym akcentem, a Eleven v4 obsługuje teraz profesjonalne klony głosu (Professional Voice Clones). Łączenie długich generacji, przydatne w Studio i aplikacji Reader, staje się bardziej niezawodne.
Oba modele są już dostępne w ElevenAgents, ElevenCreative i przez API (eleven_v4 oraz eleven_v4_turbo). Przez dwa tygodnie cena korzystania z API Eleven v4 jest obniżona do 22 dolarów, a z API Eleven v4 Turbo do 11 dolarów za milion znaków. Eleven v4 jest bezpłatny w planach Creator i wyższych w ElevenCreative, do limitu wynoszącego dwukrotność miesięcznej puli kredytów; ceny katalogowej nie opublikowano. Premiera następuje po Eleven v3, wprowadzonym na rynek w lutym 2026 roku.
🔗 Przedstawienie Eleven v4 · Wątek z ogłoszeniem na X
Kling zapowiada Kling 4.0 na październik i udostępnia Kling 4.0 Flash we wczesnym dostępie
28 września — Kling AI przedstawia Kling 4.0, nową generację swojego modelu wideo, której oficjalna premiera jest planowana na październik. Pierwszy wariant, Kling 4.0 Flash, od 28 września jest dostępny we wczesnym dostępie dla ograniczonej grupy użytkowników — według wpisu zapowiadającego dla posiadaczy rocznej subskrypcji Ultra. Kling podkreśla trzy obszary: realizm obrazu, kontrolę twórczą i kompletność narracji (narrative completeness).
Według zapowiedzi Kling 4.0 generuje w jednym ujęciu filmy trwające od 3 do 30 sekund, w rozdzielczości do 4K, z dwukanałowym dźwiękiem stereo. Narracją można sterować za pomocą maksymalnie 10 klatek kluczowych i promptów o długości do 8 000 tokenów. System Omni Reference przyjmuje do 15 materiałów referencyjnych na generację: 10 obrazów, 5 filmów o łącznej długości do 30 sekund oraz 7 postaci lub obiektów, z których 3 mogą pochodzić z filmów; materiał dźwiękowy służy wyłącznie jako wzorzec głosu. Modele bez tekstur i mapy głębi mogą pomóc ustawić ruch i kadrowanie, a narzędzia montażowe pozwalają zmieniać mimikę, gesty, pracę kamery, styl lub tło w maksymalnie 5 klipach. Kling deklaruje też czytelny tekst w obrazie oraz obsługę większej liczby języków, akcentów i dialektów, od kantońskiego i syczuańskiego po indyjski angielski.
| Specyfikacja techniczna | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| Dostępność | Oficjalna premiera w październiku | Ograniczony wczesny dostęp od 28 września |
| Tryby generowania | Tekst na wideo, obraz na wideo, pierwsza i ostatnia klatka, 10 klatek kluczowych, Omni Reference | Tekst na wideo, obraz na wideo, Omni Reference |
| Długość jednej generacji | 3 do 30 sekund | 3 do 20 sekund |
| Maksymalna rozdzielczość | 4K (także 720p i 1080p) | 720p |
| Zakres dynamiczny | 10-bitowy HDR w 1080p i 4K, zapowiedziany na później | 8-bitowy SDR |
Nie wszystkie funkcje są już dostępne. Informacje o wersji zapowiadają na później (coming soon) 10-bitowy obraz HDR w 1080p i 4K, choć wpis na X zalicza go do funkcji Kling 4.0, a także wydłużanie filmów do 2 minut. Kling przebudowuje również stronę tworzenia: skupia wszystkie materiały referencyjne w jednym polu wprowadzania i dodaje obszar roboczy, w którym agent wykonuje zlecone zadania. Ogłoszeniu nie towarzyszą ceny, dostęp do API ani wyniki testów porównawczych; ilustruje je film krótkometrażowy THE BEAT zrealizowany przy użyciu Kling 4.0.
🔗 Informacje o wersji Kling 4.0 · Ogłoszenie na X
Agenci kodujący: Claude Code 2.1.284, Codex CLI 0.158.0, Copilot CLI 1.0.89 i jego SDK, Devin, Delta oraz Gemini CLI
Claude Code 2.1.284 uruchamia się w trybie automatycznym we wszystkich planach i u wszystkich dostawców
28 września — Wersja Claude Code 2.1.284, opublikowana o 18:02 UTC, kilka chwil przed ogłoszeniem modelu, dodaje Claude Sonnet 5.5, który staje się domyślnym modelem Sonnet w API Anthropic. Lista zmian obejmuje 100 pozycji: 57 poprawek, 18 usprawnień, 14 nowych funkcji i 11 zmian.
Najbardziej widoczna zmiana dotyczy uprawnień: gdy nie skonfigurowano żadnego trybu, interaktywne sesje w terminalu i VS Code uruchamiają się teraz w trybie automatycznym we wszystkich planach i u wszystkich dostawców. Wersja 2.1.283 wprowadziła to już 25 września dla dostawców zewnętrznych i sesji bez telemetrii; wersja 2.1.284 rozszerza tę zmianę na pozostałe przypadki, a ustawienie permissions.defaultMode zachowuje pierwszeństwo. Nowa odpowiedź „Tak, ale zapytaj ponownie następnym razem” (Yes, but ask again next time) pozwala na jednorazowy odczyt spoza katalogów roboczych, po czym Claude Code ponownie pyta o zgodę przy kolejnych próbach.
Ultracode znika z suwaka poziomu wysiłku i staje się osobnym przełącznikiem w /effort (klawisz Tab lub /effort ultracode on i off): nie wymusza już poziomu xhigh i pozostaje aktywny niezależnie od wybranego poziomu. Odpowiada mu przełącznik pod suwakiem poziomu wysiłku w VS Code.
| Nowość w wersji 2.1.284 | Polecenie lub ustawienie |
|---|---|
| Domyślny tryb automatyczny we wszystkich planach i u wszystkich dostawców | permissions.defaultMode zachowuje pierwszeństwo |
| Ultracode jako osobny przełącznik | Tab w /effort albo /effort ultracode on i off |
| Grupowe ponowne łączenie z serwerami MCP po błędzie | /mcp reconnect all |
| Wydatki w dolarach dla bramy Claude apps | /usage i pasek stanu (pola used_usd, limit_usd, period) |
| Ponowna kompakcja, jeśli błąd „Prompt is too long” nadal występuje | automatycznie |
W obszarze bezpieczeństwa pluginy pochodzące z katalogów, claude.ai lub npm nie mogą już wstępnie zatwierdzać własnych narzędzi, gdy administrator dopuszcza wyłącznie zarządzane przez siebie reguły (allowManagedPermissionRulesOnly). Reguły .claude/rules podłączone dowiązaniem symbolicznym spoza projektu wymagają zatwierdzenia, a podczas ładowania pamięci w MEMORY.md neutralizowane są niewidoczne znaki i znaczniki imitujące składnię Claude Code. Dla większej niezawodności uszkodzony strumień odpowiedzi jest ponawiany zamiast wyświetlać błąd „JSON Parse error”, a wywołania MCP we wznowionej sesji czekają na serwer do 10 sekund. Jeśli zabezpieczenia modelu Sonnet zgłoszą problem z wiadomością, komunikat podaje teraz więcej wyjaśnień i proponuje zmianę żądania oraz ponowienie próby.
Codex CLI 0.158.0: kopiowanie przy zaznaczeniu i sekrety klientów OAuth dla MCP
28 września — Codex CLI 0.158.0, opublikowany o 05:07 UTC, jest pierwszą stabilną wersją od 0.157.1 z 26 września; informacje o wydaniu wymieniają 188 pull requests od wersji 0.157.0. Pełnoekranowy interfejs tekstowy (fullscreen TUI) pozwala skonfigurować kopiowanie przy zaznaczeniu (copy-on-select) i wklejanie prawym przyciskiem myszy, a fragment skopiowany z transkrypcji zachowuje formatowanie Markdown.
| Funkcja | Ustawienie lub szczegóły |
|---|---|
| Kopiowanie przy zaznaczeniu | tui.copy_on_select: domyślnie auto (tmux, Zellij, terminale macOS używane bezpośrednio z wyjątkiem Ghostty i Kitty), always, never |
| Wklejanie prawym przyciskiem myszy | tui.right_click_paste: auto (Windows, Linux, WSL), on (także macOS), off |
| Serwery MCP z OAuth | codex mcp add --oauth-client-secret, klucz oauth.client_secret |
| Exec-server | Tokeny okaziciela do bezpośrednich połączeń WebSocket |
| Generowanie obrazów | Jawnie określone przezroczyste tło (transparent_background), edytowanie obrazów z rozmowy |
Codex może teraz łączyć się z serwerami MCP, które wymagają wcześniej zarejestrowanego klienta OAuth z sekretem. Bezpośrednie połączenia WebSocket z exec-server można chronić tokenami okaziciela (bearer tokens), także wtedy, gdy przechodzą przez app-server. W obszarze bezpieczeństwa zatwierdzanie danych wejściowych wysyłanych do terminala osiąga status stabilny i jest domyślnie włączone dla poleceń uruchamianych z podwyższonymi uprawnieniami. Poprawki dotyczą przede wszystkim środowisk izolowanych: zwykłych ścieżek w Windows 10, odrzuconych zapisanych danych uwierzytelniających, uruchamiania w Linuxie z zagnieżdżonymi katalogami głównymi z prawem zapisu oraz ochrony metadanych Git w Linuxie i macOS.
Copilot CLI 1.0.89 trafia do wersji stabilnej, a Copilot SDK 1.0.15 wprowadza typowane wyniki
28 września — GitHub udostępnia stabilną wersję Copilot CLI 1.0.89 (19:20 UTC). Wersja przedpremierowa 1.0.89-5, opisana 27 września, obsługiwała już pliki .claude/rules; kilka spośród 35 pozycji w informacjach o wydaniu to jednak nowe funkcje. Tryb Auto sugeruje teraz poziom, który można zmienić skrótem klawiszowym lub kliknięciem. Usunięto z niego nieobsługiwany profil Fast: zapisana preferencja Fast zostaje zastąpiona przez Balance. Tworzenie pull requestów uwzględnia szablony repozytorium, w tym obowiązkowe sekcje i listy kontrolne. W sesji lokalnej dwukrotne naciśnięcie klawisza Escape przy pustym polu wprowadzania przywraca prompt, którego obsługa jeszcze się nie rozpoczęła, a pluginy instalowane bezpośrednio można włączać i wyłączać (copilot plugin enable). W środowisku izolowanym działają opakowane (timeout 60 gh …) polecenia gh i git, a w systemie Windows można uzyskać dostęp do localhost, gdy włączono dostęp do sieci lokalnej.
Niedługo później (19:38 UTC) GitHub Copilot SDK, który osadza agentowe środowisko wykonawcze Copilot w aplikacji, trafia do wersji 1.0.15 po pięciu wersjach przedpremierowych. Główną nowością są typowane wyniki strukturalne we wszystkich sześciu SDK (TypeScript, Python, Go, Java, C# i Rust): programista dostarcza schemat JSON lub typ właściwy dla danego języka, a model zwraca typowany i zweryfikowany wynik zamiast swobodnego tekstu. Eksperymentalny mechanizm pozwala też aplikacji wymagać przeglądu przez człowieka przed instalacją serwera MCP lub skilla, z wyraźną decyzją (potwierdzenie, odmowa lub anulowanie). W Rust ilość pamięci zajmowanej przez instalację tego środowiska wykonawczego spada o około 99%.
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devin tanieje o 30–40%, a Devin Fusion prowadzi w FrontierCode 1.1 Extended
28 września — Cognition ogłasza wyraźny spadek kosztu korzystania z Devin: o 30–40% w trybach Fusion i Normal, o 15–20% w trybie Ultra oraz o nawet 70% w przypadku Devin Review, narzędzia do przeglądu kodu. Firma przypisuje te oszczędności integracji najnowszych modeli, w tym własnego SWE-2, oraz pracom nad chmurowym środowiskiem agentowym Devin (cloud harness): grupowaniu większej liczby działań w jednym wywołaniu narzędzia (formatowania, analizy i testowania za jednym razem), równoległemu uruchamianiu niezależnych wywołań i lepszemu ponownemu wykorzystaniu pamięci podręcznej promptów. Podane wielkości dotyczące tego środowiska pochodzą z przykładów ilustracyjnych, a nie z pomiarów.
Cognition zapewnia, że zachowało lub poprawiło możliwości każdego trybu. Fusion łączy wydajny model główny z tańszym modelem pomocniczym (sidekick), a wykres zamieszczony we wpisie stawia go na czele FrontierCode 1.1 Extended.
| Konfiguracja oceniona przez Cognition | Wynik FrontierCode 1.1 Extended | Średni koszt zadania |
|---|---|---|
| Devin Fusion | 68,8 | 0,60 dolara |
| Opus 5.5 (high) | 65,2 | 0,90 dolara |
| Fable 5.1 (medium) | 63,6 | 2,68 dolara |
| GPT-6 Astra (high) | 63,1 | 2,62 dolara |
| SWE-2 (high) | 60,1 | 0,64 dolara |
| GPT-6 Sol (high) | 59,6 | 0,87 dolara |
Wyniki Opus 5.5 (65,2) i GPT-6 Astra (63,1), podane dla poziomu wysiłku high, różnią się od wartości z opublikowanego tego samego dnia wykresu dotyczącego Sonnet 5.5 (65,3 i 64,5), na którym nie określono poziomu wysiłku. Ta oszczędniejsza wersja Devin jest dostępna od dziś, choć nie opublikowano nowego cennika.
🔗 Devin jest teraz nawet o 40% bardziej opłacalny
Informacje o wydaniu Devin z 25 września i beta Devin Mobile
25 września — Przeoczone dotąd informacje o wydaniu Devin z 25 września opisują dodanie do Marketplace 57 hostowanych integracji MCP (hosted MCP), w tym Buildkite, Brex, Expo, Vanta, WorkOS i Wix. Devin tworzy też interaktywny raport HTML, gdy użytkownik prosi o raport, któremu służy taka forma (wykresy, tabele, diagramy), ale nie wskazuje formatu. Sesja potomna rozpoczyna się od podsumowania sesji nadrzędnej, wyświetlanego jako usuwalna etykieta w polu wprowadzania. Sesja, której maszyna przeszła w stan uśpienia, budzi się po otwarciu adresu URL podglądu lub po nawiązaniu połączenia SSH. Automatyzacje mogą działać na współdzielonym Outpost, a Devin odczytuje logi Azure Pipelines z kontroli zakończonych niepowodzeniem przy pull requestach w Azure DevOps.
28 września Cognition uruchamia także listę oczekujących na betę Devin Mobile. Strona zapisów opisuje ją jednym zdaniem: Devin działa w chmurze lub na komputerze użytkownika, testuje we własnej przeglądarce i nie kończy pracy, dopóki pull request nie jest gotowy do scalenia. Nie podano daty ogólnej dostępności ani ceny.
🔗 Informacje o wydaniach Devin · Devin Mobile na X
Zed zapowiada Delta 0.18, Gemini CLI publikuje nocną kompilację bez zmian
28 września — Zed zapowiada, bez podania daty, że Delta 0.18, jego środowisko do wspólnego programowania z agentami, będzie uruchamiać wątki (threads) Delta w istniejących już worktrees Git. Wersja 0.17, wydana 23 września, izolowała już każde równoległe zadanie we własnym obszarze roboczym. Tymczasem nocna kompilacja Gemini CLI opublikowana 28 września nie zawiera żadnych zmian: opiera się na tym samym commicie co kompilacja z 26 września, a stabilna wersja v0.61.0 i przedpremierowa v0.62.0-preview.0 pozostają bez zmian.
🔗 Zed na X · Gemini CLI v0.63.0-nightly.20260928
Agent API od Perplexity zyskuje elementy wielokrotnego użytku: Profiles, wersjonowane Skills i współdzielone konektory
28 września — Perplexity dodaje do swojego Agent API warstwę konfiguracji wielokrotnego użytku z wersjonowaniem, przeznaczoną dla zespołów. Jej głównym elementem jest Profile, który pod jednym, unikalnym identyfikatorem z wersją zapisuje wszystko, co definiuje agenta: model, instrukcje, narzędzia, Skills, konektory i ustawienia wykonania. Administrator projektu konfiguruje agenta raz i udostępnia go uprawnionym programistom; każda aplikacja dostarcza już tylko własne dane.
Niestandardowe Skills pakują instrukcje, procedury i pliki pomocnicze w wersjonowany zasób: zespół platformowy może umieścić w nim kontrole wdrożenia, kryteria wycofania zmian (rollback) i format raportu, a potem opublikować nową wersję zamiast poprawiać każdą aplikację. Zarządzane konektory (managed connectors), wprowadzone pod koniec sierpnia, stają się zasobem udostępnianym przez administratora całemu projektowi: aplikacje odwołują się do nich bez osobnego przechowywania danych uwierzytelniających i definicji narzędzi.
| Dodany zasób | Rola w Agent API | Zapowiedziana dostępność |
|---|---|---|
| Profiles | Model, instrukcje, narzędzia, Skills, konektory i ustawienia wykonania pod identyfikatorem z wersją | Dostępne |
| Niestandardowe Skills | Wersjonowane instrukcje, procedury i pliki pomocnicze wywoływane przez członków projektu | Dostępne |
| Zarządzane konektory | Zatwierdzone integracje udostępniane przez administratora (GitHub, Slack, Google Drive, Datadog, Linear, Notion) | Wersja przedpremierowa |
Wszystko konfiguruje się w API Console, a członkowie projektu wywołują te zasoby kluczem API tego samego projektu; we wpisie nie podano cen. Tego samego dnia wpis w dzienniku zmian API informuje o zmianie modelu w ustawieniu wstępnym xhigh Agent API z GPT-5.6 Sol (openai/gpt-5.6-sol) na Claude Opus 5.5 (anthropic/claude-opus-5-5). Prompty, poziom wysiłku rozumowania, narzędzia, budżety tokenów i limity kroków pozostają bez zmian. Trzy dni wcześniej ustawienia wstępne low, medium i high przeniesiono na GPT-6.
🔗 Agent API obsługuje teraz agentów wielokrotnego użytku · Dziennik zmian API Perplexity
SpaceXAI wprowadza Team Bots, Grok Bots współdzielone przez cały zespół
28 września — SpaceXAI wprowadza Team Bots, czyli Grok Bots tworzone z myślą o roli lub przebiegu pracy zespołu i udostępniane wszystkim jego członkom. Każdy może też pracować z Botem indywidualnie. Bot jest wspólny, ale rozmowy pozostają prywatne: kontekst i pamięć są oddzielne dla każdego użytkownika, natomiast skille są wspólne dla zespołu. Każdy Team Bot ma własny identyfikator w Slack i można zaprosić go do kanału, w którym cały zespół zadaje mu pytania.
| Składnik Bota | Rola opisana przez SpaceXAI |
|---|---|
| Kontekst | Pliki, instrukcje i skille |
| Plugins | Praca w Salesforce, Notion lub GitHub, połączonych indywidualnie albo dla całego zespołu |
| Dane uwierzytelniające | Dostęp do zewnętrznych API, dla których nie ma pluginu |
| Pamięć | Informacje zapamiętywane przez Bota, by lepiej pełnił swoją rolę, oddzielnie dla każdego użytkownika |
SpaceXAI opisuje własne zastosowania. Każdy duży klient biznesowy ma swojego Team Bota, który nocą analizuje wiadomości o kliencie, rozmowy Gong, dokumenty Notion i wątki Slack, a rano publikuje podsumowanie w Slack. Bot zespołu inżynierów, połączony z Notion, Linear, Hex, Datadog i Cursor, kierował setkami Cloud Agents: pięcioosobowy zespół dostarczał dzięki temu ponad 100 pull requestów dziennie i uruchomił Team Bots w ciągu kilku tygodni. Wśród klientów firma ubezpieczeniowa Harper twierdzi, że w 24 godziny zbudowała Team Bota pomagającego klientom przywracać wygasłe polisy; według jej prezesa pozwoliło im to zaoszczędzić ponad 120 000 dolarów.
Team Bots jest dostępny od dziś w publicznej becie w planach Teams i Enterprise, wraz ze wstępnie skonfigurowanymi Team Bots dla sprzedaży, zarządzania produktem, marketingu i analizy danych. SpaceXAI nie podaje cen ani limitów.
🔗 Team Bots (SpaceXAI) · Ogłoszenie @bot na X
H Company publikuje Holo4, agentowe modele z otwartymi wagami 27B i 35B-A3B
28 września — H Company publikuje Holo4, nową serię modeli agentowych w dwóch rozmiarach: gęsty model o 27 miliardach parametrów oraz model typu mieszanka ekspertów (Mixture of Experts) 35B-A3B. Oba są udostępniane przez API H Models i publikowane na Hugging Face w formatach BF16, FP8, NVFP4 i 4-bitowym GGUF. H dodaje też Holotron4 Nano, uzyskany przez zastosowanie własnej metody potreningowej do Nemotron 3 Nano Omni od NVIDIA. Ten sam model działa przez interfejs graficzny, kod, MCP lub API — na komputerze, w internecie, na Androidzie lub w izolowanym środowisku do uruchamiania kodu. H trenowało go najpierw metodą nadzorowaną, a następnie przez uczenie ze wzmocnieniem, między innymi na około 10 000 weryfikowalnych zadań generowanych przez Agentic Task Factory na podstawie samej dokumentacji.
| Oceniany model | Model bazowy i licencja | Opublikowany wynik |
|---|---|---|
| Holo4 27B | Qwen3.8-27B, CC-BY-NC-4.0 (niekomercyjna) | 61,7% w OSWorld 2.0; 85,2% w OSWorld przy 0,08 dolara za zadanie |
| Holo4 35B-A3B | Qwen3.6-35B-A3B, Apache-2.0 | 30,9% w OSWorld 2.0 |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni, NVIDIA Open Model Agreement | poprawę względem modelu bazowego pokazano tylko na wykresie |
| Claude Opus 5.5 (punkt odniesienia podany przez H) | model zamknięty | 81,8% w OSWorld 2.0 |
H wyjaśnia warunki pomiaru: Holo4 oceniono we własnym środowisku testowym, wykonując jeden przebieg OSWorld 2.0, a wynik porównano z publicznymi wynikami uzyskanymi przy użyciu innych środowisk testowych i poziomów wysiłku. W AutomationBench 480 z 600 publicznych zadań należy do części zbioru wykorzystanej do gromadzenia danych treningowych. H publikuje wszystkie trajektorie stojące za swoimi publicznymi wynikami; można je przeglądać krok po kroku lub pobrać z Hugging Face. Zapowiada też szkice DSpark, które w najbliższych dniach mają przyspieszyć inferencję.
🔗 Wpis o Holo4 na Hugging Face · Ogłoszenie H Company
Robotyka: SAIL od Sakana AI zwiększa skuteczność z 25% do 73%, ProjectSim kwestionuje sposób pomiaru w symulacji
28 września — Sakana AI prezentuje SAIL (Scaling In-Context Imitation Learning), projekt prowadzony z Uniwersytetem Tokijskim i przyjęty na konferencję IROS 2026. Artykuł ma identyfikator arXiv z marca 2026 roku; dzisiejszą nowością jest jego publiczna prezentacja. Postawione pytanie brzmi: czy z istniejącego modelu łączącego obraz i język (VLM) można uzyskać niezawodne ruchy robota bez ponownego trenowania modelu, przeznaczając więcej mocy obliczeniowej na inferencję?
SAIL generuje pełną trajektorię na podstawie kilku udanych demonstracji umieszczonych w kontekście i wykonuje ją w symulacji. Następnie drugi VLM ocenia na podstawie nagrania postęp zadania, a ta informacja kieruje wyszukiwaniem metodą drzew Monte Carlo (MCTS). Do prawdziwego robota trafia tylko wybrana trajektoria. Gemini Robotics-ER 1.5 pełni obie role bez zmiany wag modelu.
| Oceniana metoda | Węzły wyszukiwania | Średnia skuteczność w sześciu symulowanych zadaniach |
|---|---|---|
| Pojedyncze generowanie | 1 | 25% |
| Przeszukiwanie w głąb | 15 | 37% |
| Przeszukiwanie wszerz | 15 | 51% |
| SAIL | 6 | 55% |
| SAIL | 15 | 65% |
| SAIL | 45 | 73% |
Odsetki te obejmują konfiguracje (po 20 na zadanie w symulatorze ALOHA), dla których w ramach wyznaczonego budżetu znaleziono skuteczną trajektorię; powodzenie sprawdza symulator, a nie VLM. Na ramieniu LeRobot SO-101 SAIL w 5 z 6 prób umieszcza klocek w misce przy budżecie 15 trajektorii kandydujących. Polityka uczenia przez naśladowanie wytrenowana na znalezionych trajektoriach również osiąga wynik 5 na 6, działając szybciej. Sakana przyznaje, że metoda ma ograniczenia: wykonanie w otwartej pętli, dodatkowy koszt obliczeniowy wyszukiwania oraz ocenę na rzeczywistym robocie ograniczoną do jednego zadania i sześciu prób na metodę.
🔗 Wpis Sakana AI · Strona projektu SAIL
ProjectSim podsumowuje stan benchmarków w robotyce
28 września — Rozbieżność między wynikami w symulacji a wynikami w rzeczywistości jest właśnie przedmiotem pierwszego eksperymentu ProjectSim. W artykule przeglądowym, który nie przedstawia własnych wyników, Luca Cilio omawia benchmarki manipulacji — od MetaWorld i LIBERO po wspólne testy fizyczne, takie jak RoboChallenge. Przypomina też, powołując się na dane RoboCasa365, że GR00T N1.5 dostrojony na 30 000 demonstracji radzi sobie z 43 % pojedynczych umiejętności, ale osiąga tylko 4,4 % przy kombinacjach nieobecnych podczas dostrajania. Eksperyment ProjectSim ma ustalić, czy wierniej odtworzone sceny symulowane (zrekonstruowana geometria, wygląd i właściwości fizyczne) zbliżają wyniki symulacji do wyników mierzonych na rzeczywistym robocie; wyników jeszcze nie opublikowano.
Mistral otwiera w Monachium centrum poświęcone przemysłowej AI i AI w fizyce
28 września — Mistral otwiera centrum w Monachium. Będą tam pracować zespoły badawcze zajmujące się AI w fizyce (Physics AI) i przemysłową AI (Industrial AI) oraz inżynierowie wdrożeniowi współpracujący bezpośrednio z firmami partnerskimi. Mistral przedstawia się przy tym jako długoterminowy partner technologiczny, a nie dostawca oprogramowania.
| Partner wymieniony przez Mistral | Zapowiedziane prace |
|---|---|
| BMW | Symulacja zderzeń i AI w inżynierii |
| Siemens Energy | Zastosowania przemysłowej AI |
| Uniwersytet Techniczny w Monachium (TUM) | Cyfrowe bliźniaki tuneli aerodynamicznych dla aerodynamiki samochodowej |
Centrum rozwija działalność rozpoczętą przejęciem Emmi AI w maju 2026 roku. Dzięki tej transakcji do Mistral dołączyło ponad 30 fizyków, badaczy i inżynierów specjalizujących się w obliczeniowej mechanice płynów (CFD), mechanice konstrukcji i symulacjach wielofizycznych. Wraz z TUM i profesorem Nikolausem A. Adamsem Mistral opracuje cyfrowe bliźniaki do aerodynamiki samochodowej. Połączą one pomiary z czujników tunelu aerodynamicznego zbierane w czasie rzeczywistym z symulacjami CFD obliczanymi wcześniej, aby uzyskiwać dokładne prognozy aerodynamiczne w czasie rzeczywistym.
Artykuł przywołuje argument suwerenności: klient ma dostęp do wag, uruchamia modele we własnej infrastrukturze i podlega prawu europejskiemu, a dane nie opuszczają organizacji. Podaje też, że Mistral zbuduje do 2030 roku europejskie moce obliczeniowe o poborze mocy jednego gigawata. Cytuje niemieckiego federalnego ministra transformacji cyfrowej Karstena Wildbergera oraz szefa Kancelarii Stanu Bawarii Floriana Herrmanna. Mistral prowadzi rekrutację w regionie Monachium, ale nie podaje liczby planowanych pracowników ani wartości inwestycji.
NVIDIA i Nscale mierzą DSX MaxLPS: o 37 % więcej GPU i o 49 % większa przepustowość przy tym samym budżecie mocy
27 września — NVIDIA publikuje przeprowadzoną z Nscale ocenę liczbową DSX MaxLPS, swojego oprogramowania rozdzielającego moc między zasoby infrastruktury AI zgodnie z zasadami operatora. Według NVIDIA pozwala ono wdrożyć do 40 % więcej GPU przy tym samym zatwierdzonym budżecie mocy. Artykuł podkreśla, że chodzi o skoordynowany przydział mocy, a nie zwiększenie zasilania obiektu.
Test przeprowadzono na GB300 NVL72 w centrum danych Nscale na kampusie Verne w Keflavíku (Islandia), zasilanym wyłącznie energią odnawialną. Wykorzystano Kimi K2.5 w FP4, NVIDIA Dynamo i TensorRT LLM. Przy tym samym przydzielonym budżecie 264,4 kW liczba GPU rośnie ze 140 do 192 bez spadku przepustowości istniejących instancji.
| Mierzony wskaźnik | Konfiguracja statyczna | Z DSX MaxLPS | Odnotowana zmiana |
|---|---|---|---|
| Zarządzane GPU | 140 | 192 | +37,1 % |
| Znormalizowana łączna przepustowość | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| Zmierzona moc całkowita | 166,2 kW | 198,9 kW | +19,7 % |
| Wykorzystanie budżetu mocy | 62,9 % | 75,2 % | +12,3 punktu |
| Przepustowość na wat przydzielonej mocy | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
Artykuł wskazuje też koszt tej poprawy: choć mediana opóźnienia i P75 pozostają w granicach 5 % wartości odniesienia, P99 czasu do pierwszego tokena rośnie o 17 % względem poziomu bazowego 15,7 sekundy. NVIDIA zaleca operatorom pięcioetapową walidację, od określenia zakresu budżetu mocy po ustalenie limitów produkcyjnych. Ocena ta następuje po walidacji Lambda na HGX B200, przedstawionej 15 września (19 węzłów przy budżecie przewidzianym na 16). Prognozy dla Vera Rubin, z chłodzeniem cieczą o temperaturze 45 °C na wejściu, przedstawiono osobno.
Krótkie wiadomości
- DeepSeek Harness 0.2.0-rc.1 — Pierwsza wersja kandydująca serii 0.2.0 i 23. wersja wstępna środowiska agentowego DeepSeek, nadal bez wersji stabilnej: rozmowy korzystające z modeli na koncie DeepSeek przeszukują internet bez dodatkowego klucza API, a zadania automatyczne przeniesiono do opcjonalnego pakietu pluginów. 🔗 źródło
- Pixel Canary w Vercel AI Gateway — Od 25 września Vercel udostępnia bezpłatnie na czas niejawnej fazy testowej ten model do programowania od niewymienionego z nazwy dostawcy: 28 z 31 zadań Next.js przy pass@4, tyle samo co GPT-6 Astra (high), oraz 30 z 31 z dokumentacją dostarczoną przez AGENTS.md; brak opcji zerowej retencji danych. 🔗 źródło
- Runnery GitHub Actions hostowane we własnej infrastrukturze — W GitHub Enterprise Cloud pełne egzekwowanie minimalnych wersji zaczyna się 29 września: runner starszy niż 2.329.0 nie może się już zarejestrować, a runner poniżej minimalnej wersji wykonawczej przestaje przyjmować zadania; nowe REST API podaje daty końca wsparcia. Zmiana nie dotyczy GitHub Enterprise Server. 🔗 źródło
- NexteraBERT — Rikka Botan publikuje dwukierunkowy encoder o 212,6 miliona parametrów, wstępnie wytrenowany na 130 miliardach tokenów (około 15 razy mniej niż ModernBERT): 87,90 w GLUE wobec 87,97 dla ModernBERT-base, 54,70 wobec 53,63 w MTEB v2 oraz 5,22 razy większa przepustowość przy 65 536 tokenach, według własnych pomiarów autora; kod na licencji MIT. 🔗 źródło
- LTX-2.5 w czasie rzeczywistym — Wpis społecznościowy pokazuje, jak model audio i wideo o 22 miliardach parametrów przechodzi od 90 sekund generowania na klip do tempa szybszego niż odtwarzanie: 1,83 sekundy na pięciosekundowy klip na karcie z 96 Go pamięci dzięki 4 krokom zamiast 8, obliczeniom NVFP4 i CUDA Graph; kod na licencji Apache-2.0. 🔗 źródło
- SCRIBE — Adalat AI, firma tworząca rozpoznawanie mowy dla indyjskich sądów, publikuje w PyPI to narzędzie oceny open source (artykuł na Interspeech 2026). Osobno ocenia ono słowa, liczby, interpunkcję i terminologię branżową, podczas gdy współczynnik błędów słów daje 100 % dla zdania w języku malajalam, którego żaden korektor by nie zmienił. 🔗 źródło
- 228 projektów JEV — Eric Kang, prowadzący listę Awesome JEV, wybrał ręcznie 228 projektów open source (10 typów, minimum 50 gwiazdek, każdy przypisany do konkretnego commitu) spośród 13 473 repozytoriów zwróconych przez wyszukiwanie „jev” w GitHub, które obejmuje też projekty niezwiązane z tematem; nie jest to niezależny spis. 🔗 źródło
- HeyGen i Jev — HeyGen publikuje w X poradnik, w którym Jev, model decyzyjny TypeSafe AI, działa przed serwerem MCP firmy: Jev klasyfikuje około czterdziestu potencjalnych klientów (czy potrzebują wideo, jaki przyjąć punkt widzenia i język oraz stopień dopasowania), Claude pisze skrypty, a następnie MCP HeyGen generuje całą partię. Tylko ostatni etap zużywa kredyty i wymaga zatwierdzenia. 🔗 źródło
- Cztery projekty z Gemini 3.8 Flash — Blog Google przedstawia cztery realizacje zbudowane przy użyciu modelu udostępnionego 2 września: śledzenie satelitów na żywo stworzone z Antigravity, animowane fale Seigaiha, szkielet tyranozaura w 3D i automatyczną skrzynię biegów z 10 ujęciami kamery; bez danych liczbowych i nowości produktowych. 🔗 źródło
- Firma cateringowa z Brooklynu i Gemini — Blog Google opisuje, jak Edy Massih, właściciel sklepu spożywczego Edy’s Grocer w Greenpoint, używa Gemini do skalowania przepisów na 200 gości, tworzenia list zakupów i dostosowywania menu do diet; bez nowych funkcji. 🔗 źródło
- Lenfest Institute — OpenAI przeznacza 5 milionów dolarów oraz do 5 milionów dolarów w kredytach na oprogramowanie i wsparciu inżynieryjnym na kolejną fazę programu stypendystów AI Lenfest Institute, uruchomionego w 2024 roku w 11 amerykańskich redakcjach. To dwukrotność wcześniejszego wsparcia. 🔗 źródło
- Karta Health w ChatGPT — Wybranie wykresu, wskaźnika lub dokumentacji w karcie Health daje teraz spersonalizowane wyjaśnienia, czasem z interaktywnym wykresem, bez pisania promptu. Health nadal jest dostępna tylko w Stanach Zjednoczonych (dla osób od 18 lat, w planach Free, Go, Plus i Pro, w przeglądarce i na iOS). 🔗 źródło
- Laureaci WebMCP Challenge — OpenAI Developers przedstawia dziesięć zwycięskich projektów hackathonu rozpoczętego pod koniec sierpnia (MASIL, Alza, ArchMorph, Aisle, Roque Nights, Mandate, Observatory, Bouquet Studio, Faraday, JupyterLite WebMCP), bez rankingu i kwot przypisanych do projektów. 🔗 źródło
- Poprawka bezpieczeństwa na macOS — Wydana 25 września wersja 26.924.20706 aplikacji desktopowej na macOS, umieszczona w sekcji aplikacji Codex w dzienniku zmian ChatGPT i Codex, naprawiła lukę CVE-2026-100754 zgłoszoną przez Patricka Wardle’a (Objective-See Foundation); nie opisano charakteru luki. 🔗 źródło
Co to oznacza
Cena tokena pozostaje bez zmian, ale maleje liczba zużywanych tokenów. Sonnet 5.5 zachowuje cenę Sonnet 5, lecz według Anthropic kosztuje nawet o 30 % mniej na zadanie, ponieważ zużywa mniej tokenów. Devin staje się tańszy o 30–40 % dzięki integracji najnowszych modeli, w tym SWE-2, i grupowaniu wywołań narzędzi. Manus ogłasza spadek kosztu wykonania o 32 % dzięki nowemu środowisku agentowemu w przetestowanej konfiguracji. O koszcie decyduje już przede wszystkim ilość zużytej pracy, zarówno po stronie modelu, jak i środowiska agentowego. Modele ze średniej półki doganiają czołówkę: w Terminal-Bench 4.0 Sonnet 5.5 przewyższa wynik Opus 5.5 zmierzony przy poziomie wysiłku Xhigh.
Agenci zyskują domyślnie większą autonomię, a zabezpieczenia trafiają poza ich zasięg. Claude Code uruchamia się teraz w trybie automatycznym we wszystkich planach, podczas gdy NVIDIA umieszcza nadzór w DPU niedostępnym dla agenta i domyślnie wymaga zatwierdzenia przez człowieka każdej zaproponowanej przez niego reguły dostępu. Narzędzia podążają tą samą drogą: Codex CLI kieruje polecenia terminalowe wymagające podwyższonych uprawnień do zatwierdzenia, a Copilot SDK pozwala wymagać przeglądu przez człowieka przed instalacją serwera MCP lub skilla. Im więcej agent robi samodzielnie, tym bardziej kontrola musi znajdować się poza nim.
Agent staje się też członkiem zespołu z własną tożsamością. Profiles od Perplexity pozwalają całemu projektowi ponownie wykorzystywać wersjonowaną konfigurację agenta. Team Bots od SpaceXAI mają własny identyfikator Slack i przechowują osobną pamięć dla każdego użytkownika, a agenci Cue otrzymują adres e-mail, numer telefonu i portfel. Agent, który może płacić, dzwonić lub pisać w czyimś imieniu, nadaje bardzo konkretny wymiar kwestiom kontroli poruszonym tego samego dnia przez NVIDIA.
Dane liczbowe z tego dnia wymagają uważnej lektury. Devin mierzy Sonnet 5.5 na wariancie FrontierCode, który w jego wpisie w X i na wykresie ma różne nazwy, a dwa wykresy Cognition opublikowane tego samego dnia podają różne wyniki Opus 5.5. Holo4 zmierzono w środowisku agentowym H, w jednym przebiegu OSWorld 2.0. Wynik 73 % dla SAIL uzyskano w symulacji, a rozbieżność między symulacją a rzeczywistością jest właśnie przedmiotem pierwszego eksperymentu ProjectSim. W obszarze mediów Eleven v4 opiera swoje wyniki na zewnętrznym rankingu i ślepych testach, podczas gdy Kling 4.0 pojawia się bez benchmarku i cennika, a część jego funkcji zapowiedziano na później.
Źródła
- Przedstawiamy Claude Sonnet 5.5 (Anthropic)
- Przewodnik migracji do Claude Sonnet 5.5
- @ClaudeDevs: zalecane poziomy wysiłku dla Sonnet 5.5
- Claude Sonnet 5.5 w GitHub Copilot
- Modele i ceny GitHub Copilot
- Claude Sonnet 5.5 w Devin
- @cognition: Sonnet 5.5 w FrontierCode 1.1 Main
- @cursor_ai: Sonnet 5.5 w Cursor
- @v0: Sonnet 5.5 w v0
- NVIDIA wprowadza Open Agent Safety Platform (komunikat)
- Architektura Open Agent Safety Platform (NVIDIA)
- Dodawanie mechanizmów kontroli działania agentów AI za pomocą NVIDIA OpenShell
- @NVIDIAAI: Jensen Huang w CNBC
- @togethercompute: partner przy uruchomieniu
- @perplexity_ai: partnerstwo z NVIDIA
- Przedstawiamy Manus 2.0
- @ManusAI: uruchomienie Cue
- @ManusAI: numery telefonów agentów
- Przedstawiamy Eleven v4 (ElevenLabs)
- @ElevenLabs: wątek z ogłoszeniem Eleven v4
- Informacje o wersji Kling 4.0
- @Kling_ai: ogłoszenie Kling 4.0
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- Devin jest teraz nawet o 40 % bardziej opłacalny
- Informacje o wersji Devin z 25 września
- @cognition: wersja beta Devin Mobile
- @zeddotdev: Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- Agent API obsługuje teraz agentów wielokrotnego użytku (Perplexity)
- Dziennik zmian API Perplexity
- Team Bots (SpaceXAI)
- @bot: ogłoszenie Team Bots
- Holo4 na blogu Hugging Face
- Holo4 (H Company)
- SAIL (Sakana AI)
- Strona projektu SAIL
- Benchmarki robotyczne: obecny stan i dalsze kroki (ProjectSim)
- Witaj, Niemcy! (Mistral AI)
- Jak NVIDIA DSX MaxLPS maksymalizuje przepustowość i wydajność infrastruktury AI
- DeepSeek Harness 0.2.0-rc.1
- Pixel Canary w Vercel AI Gateway
- Przesunięto datę egzekwowania wersji runnerów hostowanych we własnej infrastrukturze (GitHub)
- Raport techniczny NexteraBERT
- Postacie mówiące w czasie rzeczywistym dzięki modelowi dyfuzyjnemu wideo 22B
- SCRIBE (Adalat AI)
- JEV: 228 wybranych projektów (Eric Kang)
- @HeyGen: przewodnik po Jev i MCP HeyGen
- Zobacz, co czterech twórców buduje z Gemini 3.8 Flash (Google)
- Trzy sposoby, w jakie właściciel sklepu spożywczego gotuje dla 200 gości z Gemini (Google)
- Lenfest AI Collaborative: nowa faza (OpenAI)
- Informacje o wersjach ChatGPT
- @OpenAIDevs: laureaci WebMCP Challenge
- Dziennik zmian ChatGPT i Codex: CVE-2026-100754