ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-6-sol.
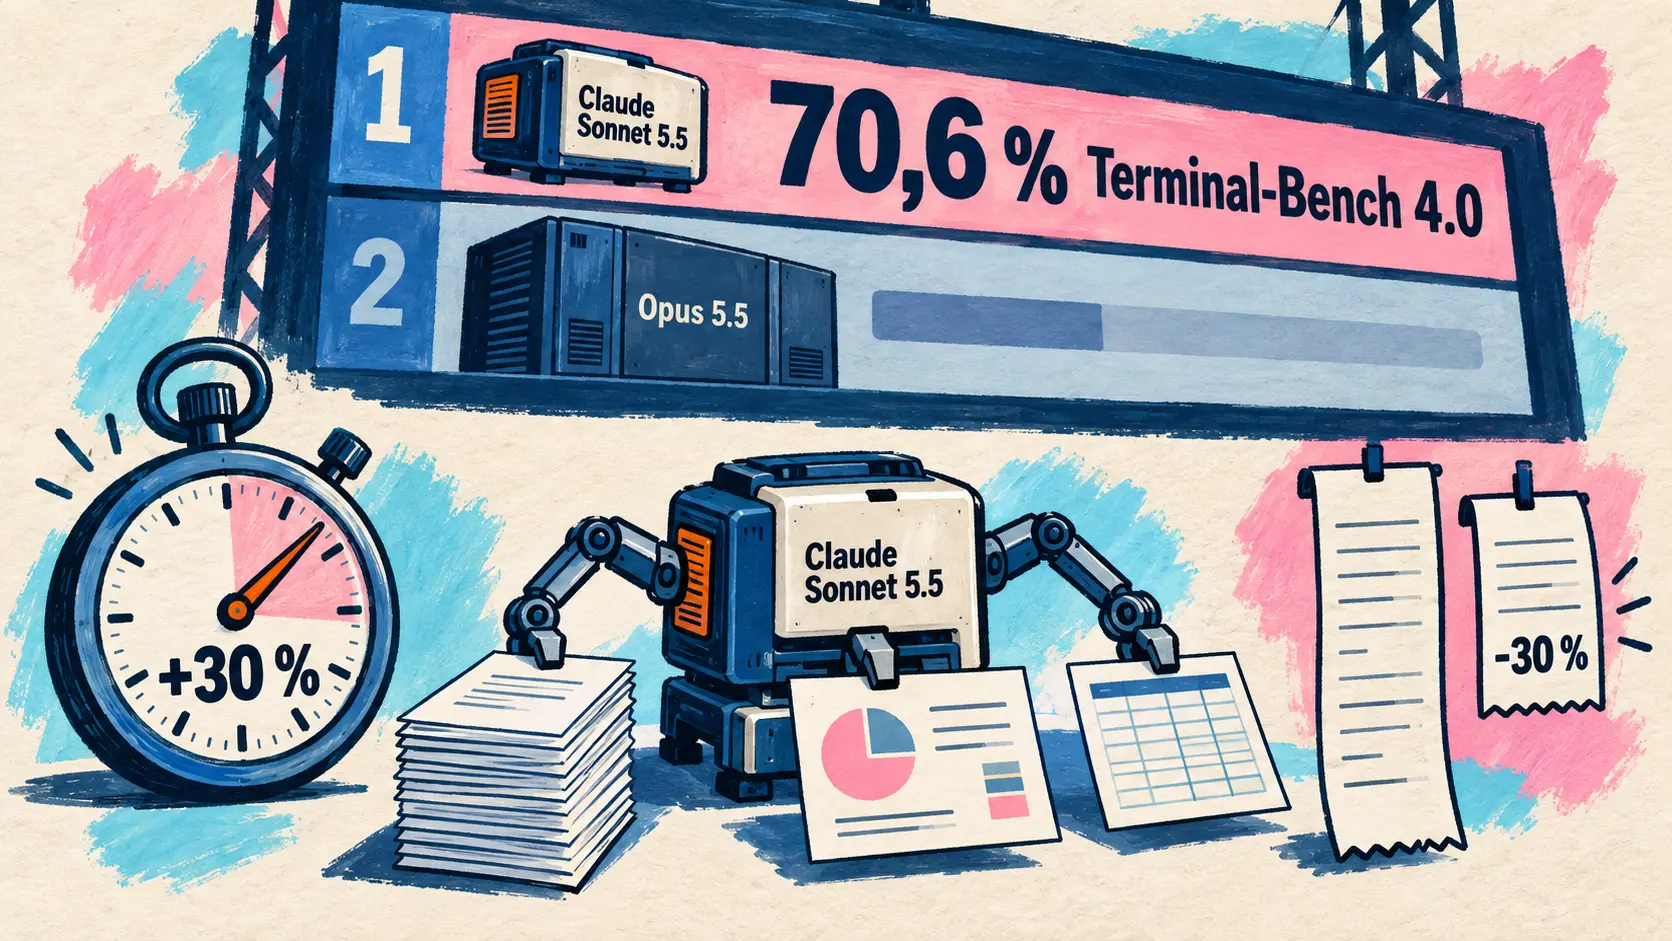
Luni, 28 septembrie, la șase zile după Opus 5.5, Anthropic lansează Claude Sonnet 5.5: același tarif ca Sonnet 5, o generare cu peste 30 % mai rapidă și un scor de 70,6 % pe Terminal-Bench 4.0, față de 10,3 % pentru predecesorul său; GitHub Copilot, Devin, Cursor și v0 îl pun la dispoziție în aceeași zi. NVIDIA prezintă Open Agent Safety Platform, care monitorizează agenții de la software până la nivelul siliciului, alături de peste 100 de organizații, Manus trece la 2.0 și lansează Cue, ElevenLabs lansează Eleven v4, iar Kling anunță Kling 4.0 pentru octombrie. În zona agenților de programare, Claude Code 2.1.284 pornește în modul auto pe toate abonamentele, iar Devin devine cu 30–40 % mai ieftin.
Anthropic lansează Claude Sonnet 5.5, mai rapid și mai ieftin per sarcină decât Sonnet 5
28 septembrie — La șase zile după Claude Opus 5.5, Anthropic lansează Claude Sonnet 5.5 (claude-sonnet-5-5), al doilea model din familia Claude 5.5. Prezentat drept o îmbunătățire clară (clear upgrade) față de Sonnet 5, generează răspunsuri cu peste 30 % mai repede și costă, în testele Anthropic, cu până la 30 % mai puțin per sarcină, deoarece are nevoie de mult mai puțini tokeni pentru aceeași muncă. Opus 5.5 rămâne modelul pentru activități complexe care cer o judecată atentă; Sonnet 5.5 vizează sarcinile cotidiene bine definite: corectarea erorilor, realizarea de documente, prezentări și foi de calcul îngrijite. Claude Haiku 5.5, conceput pentru volume mari, urmează să apară în săptămânile următoare.
Cea mai mare diferență față de Sonnet 5 apare pe Terminal-Bench 4.0, o evaluare a programării agentice în linia de comandă: 70,6 % față de 10,3 %, peste cele 66,4 % obținute de Opus 5.5 la nivelul de efort Xhigh, cel mai bun rezultat al său. Pe GDPval-AA, dedicat muncii intelectuale, Sonnet 5.5 termină la două puncte de Opus 5.5 și cu aproximativ 400 de puncte peste Sonnet 5. Este și primul Sonnet care termină Pokémon Rouge lucrând numai pe baza capturilor de ecran.
| Benchmark (cifre Anthropic) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam (cu instrumente) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1 (parțial) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography (fără instrumente) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Anthropic însoțește aceste cifre de câteva rezerve. Pe FrontierCode, performanța Sonnet 5.5 scade la nivelul de efort Max, unde apelează mai des skillul de revizuire a codului din Claude Code, ajungând să depășească timpul limită sau să iasă din perimetrul sarcinii în două cazuri examinate de Cognition; GDPval-AA și AA-Briefcase au fost măsurate pe o versiune preliminară afectată de un bug, al cărui efect a fost considerat redus. Mai ales, Anthropic consideră că Opus 5.5 este considerabil mai puternic pentru activități complexe și deschise, care cer judecată susținută.
Tariful rămâne neschimbat: 2 dolari per milion de tokeni la intrare, 10 dolari la ieșire și 0,20 dolari pentru citirea din cache, la fel ca Sonnet 5; pentru intrare și ieșire, costă jumătate față de Opus 5.5 (4 și 20 de dolari). Economia vine din numărul de tokeni consumați: la nivelurile de efort Low sau Medium, Sonnet 5.5 depășește cel mai bun scor al Sonnet 5 pe mai multe benchmarkuri, cu un cost per sarcină de aproximativ zece ori mai mic. Modelul acceptă 1 milion de tokeni în context și produce până la 128 000 de tokeni la ieșire; nivelul de efort implicit este Medium în Claude Code și în aplicațiile Claude, respectiv High pe Claude Platform.
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇷🇴 Recomandăm să începeți cu Opus pentru proiectele mari și cu Sonnet pentru sarcinile în care trebuie echilibrate calitatea, viteza și costul. — @ClaudeDevs pe X
Întrucât capacitățile sale de securitate cibernetică sunt comparabile cu cele ale Opus 5, Sonnet 5.5 este primul Sonnet lansat cu măsuri de protecție cibernetică de nivelul celor mai capabile modele: cererile cu risc ridicat sunt redirecționate în mod vizibil către Sonnet 5, fără a afecta corectarea obișnuită a erorilor. Este și primul Sonnet dotat cu clasificatori de securitate care împiedică extragerea raționamentului său, iar raționamentul rămâne de acum asociat contului care l-a produs.
Pentru dezvoltatori, trecerea la claude-sonnet-5-5 presupune mai mult decât schimbarea unui identificator: documentația enumeră cinci modificări incompatibile cu Sonnet 5, printre care înlocuirea dezactivării raționamentului cu setarea between_tools și refuzul selectării forțate a unui instrument (tool_choice la any sau tool, eroare 400). Comanda /claude-api migrate ajută la migrarea în Claude Code.
Sonnet 5.5 este disponibil de astăzi pe Claude Platform, în Claude Code și prin Amazon Web Services, Google Cloud și Microsoft Azure, fără detalii despre abonamentele (Free, Pro, Max) din surse. În Claude Code, versiunea 2.1.284 îl stabilește ca model Sonnet implicit pe API-ul Anthropic (vezi secțiunea dedicată agenților de programare).
🔗 Anunțul Claude Sonnet 5.5 · Ghidul de migrare la Sonnet 5.5
GitHub Copilot îl oferă începând cu abonamentul Pro
28 septembrie — GitHub oferă Claude Sonnet 5.5 la disponibilitate generală în Copilot (înregistrare în jurnalul de modificări la 11:03 PT). Spre deosebire de Claude Opus 5.5, sosit pe 22 septembrie fără abonamentul Pro, acesta este oferit abonaților Copilot Pro, Pro+, Max, Business și Enterprise, pe zece platforme: Visual Studio Code, Visual Studio, Copilot CLI, agentul de programare Copilot, aplicația GitHub Copilot, github.com, GitHub Mobile, IDE-urile JetBrains, Xcode și Eclipse, printr-o lansare treptată.
GitHub afirmă că, în primele sale teste, Sonnet 5.5 egalează Claude Sonnet 5 la sarcinile de programare, folosind semnificativ mai puțini pași, tokeni și apeluri către instrumente, și termină mai repede, fără să publice cifre. Modelul este facturat în funcție de utilizare, la tariful public al furnizorului: documentația GitHub indică 2 dolari la intrare și 10 dolari la ieșire per milion de tokeni, același tarif ca pentru Claude Sonnet 5. Pentru Business și Enterprise, activarea implicită a modelelor noi îl pune automat la dispoziție, cu excepția cazului în care un administrator a dezactivat această setare sau modelul.
🔗 Claude Sonnet 5.5 în GitHub Copilot · Modelele și tarifele Copilot
Devin îi măsoară un scor de 64,4 % pe FrontierCode 1.1
28 septembrie — Cognition pune Sonnet 5.5 la dispoziție în Devin Desktop și Devin CLI în ziua lansării și îi măsoară un scor de 64,4 % pe FrontierCode 1.1, benchmarkul său care verifică respectarea cerințelor din baze de cod de producție, față de 56,2 % pentru Sonnet 5. Se situează înaintea Claude Fable 5.1 (63,6 %) și imediat în urma primelor trei modele din grafic: Opus 5.5 (65,3 %), Fable 5 (64,9 %) și GPT-6 Astra (64,5 %).
Postarea Cognition de pe X vorbește despre varianta Main, dar graficul din articol este intitulat Extended și reia, pentru celelalte modele, valorile publicate pe 22 septembrie pentru această variantă. Ca punct de reper, Anthropic indică 52,1 % pentru Sonnet 5.5 pe varianta Main, la nivelul de efort Xhigh. Cognition transmite și cifrele Anthropic: o generare cu peste 30 % mai rapidă și un cost per sarcină cu până la 30 % mai mic decât Sonnet 5, la un preț neschimbat per token.
🔗 Claude Sonnet 5.5 în Devin · Cognition pe X
Cursor și v0 îl pun la dispoziție în aceeași zi
28 septembrie — v0, instrumentul Vercel pentru crearea de aplicații, pune Sonnet 5.5 la dispoziție la 18:04 UTC, la un minut după anunț; Cursor urmează la 20:14 UTC și îl descrie drept un model solid, la nivelul Opus pentru multe sarcini, fără să precizeze despre care Opus este vorba. Nu sunt comunicate tarife sau măsurători proprii instrumentelor: la fel ca în cazul Opus 5.5 pe 22 septembrie, este vorba doar despre disponibilitate.
🔗 Cursor pe X · v0 pe X
NVIDIA lansează Open Agent Safety Platform pentru monitorizarea agenților de la software până la nivelul siliciului
28 septembrie — NVIDIA lansează Open Agent Safety Platform, o platformă software deschisă, însoțită de un proiect de sistem de referință, pentru a securiza agenții IA de la testare până la implementare, cu guvernanță și control asupra întregului sistem (software, hardware, calcul și sisteme robotice). Premisa expusă în articolul despre arhitectură: mai multe laboratoare de vârf au raportat recent agenți care au ieșit din mediile de evaluare menite să îi țină sub control. Printre cele cinci principii adoptate, politica trebuie să poată fi verificată și aplicată în afara canalului agentului, adică în afara accesului acestuia.
| Componenta platformei | Rolul anunțat de NVIDIA |
|---|---|
| NVIDIA OpenShell (open source, versiunea 0.1) | Mediu de execuție (runtime) în sandbox: politică verificată formal și aplicată în afara agentului, pe CPU Vera și pe platforme terțe (Arm, Intel) |
| NVIDIA Sentry (proiect de referință) | Sistem de supraveghere independent pe DPU BlueField-4, care plasează un agent în carantină în câteva milisecunde |
| NVIDIA DOCA | Inspectarea cererilor și răspunsurilor, telemetrie atestată, identitatea agentului, acces cu model de încredere zero |
OpenShell, mediul de execuție open source (Apache 2.0) urmărit din martie, ajunge la versiunea 0.1 (0.1.0 publicată pe GitHub pe 25 septembrie, 0.1.2 pe 28) și este acum anunțat ca disponibil pe scară largă, atât pentru modele deschise, cât și pentru cele închise. Fiecare agent rulează într-un sandbox (sandbox) cu controale la nivel de kernel; un supraveghetor extern inspectează traficul HTTP, GraphQL și MCP (o citire este permisă, o scriere pe același API este blocată), iar agentul accesează serviciile fără ca datele reale de autentificare să îi fie expuse. Politicile sunt scrise în YAML, compilate în OPA/Rego și trec printr-un instrument de verificare formală; când lipsește un drept de acces, agentul poate propune o regulă strict delimitată, care așteaptă implicit aprobarea unui om, fără ca agentul să o poată aproba singur. OpenShell acceptă Codex, Claude Code, Pi și Hermes. În timpul unor teste adverse de lungă durată, relatează NVIDIA, agenți de vârf cu măsuri de protecție reduse au petrecut până la două ore încercând să convingă un evaluator IA să le deschidă accesul la un depozit GitHub protejat, fără să aibă loc vreo scriere în acesta.
Sentry, a doua componentă, mută monitorizarea în hardware: un sistem de supraveghere independent (out-of-band watchdog) pe DPU BlueField-4, construit pe DOCA, care urmărește continuu comportamentul agenților, le verifică identitatea și îl poate plasa în carantină în câteva milisecunde pe cel care își depășește limitele. Într-un POD Vera Rubin, fiecare modul de calcul plasează un BlueField-4 pe singura cale dintre nod și model; pe un sistem Vera deja echipat cu BlueField-4, activarea necesită o actualizare software, potrivit NVIDIA.
NVIDIA afirmă că peste 100 de organizații lucrează cu tehnologiile platformei. Anthropic integrează Claude Managed Agents cu OpenShell și BlueField; acești agenți execută bucla agentului pe un server separat de sandboxuri. SpaceXAI aplică platforma agenților de programare Cursor și modelelor Grok; Salesforce urmărește activitatea agenților OpenShell din Slack, unde cererile lor de permisiuni pot fi aprobate sau refuzate; SAP o integrează în mediul de execuție Joule Studio, iar Scale AI în oferta sa GenAI. Lista cuprinde Microsoft, IBM, Palantir, CrowdStrike și Hugging Face, precum și organizații din robotică (Figure, Skild AI), finanțe (Citi, JPMorganChase), sisteme de operare (Canonical, SUSE, Red Hat) și infrastructură (CoreWeave, Nebius, Oracle Cloud Infrastructure). Software-ul, inclusiv OpenShell și diverse skilluri, este disponibil pe GitHub și pe pagina pentru dezvoltatori a NVIDIA, iar Jensen Huang a prezentat aceste măsuri la CNBC în aceeași zi.
🔗 Comunicatul NVIDIA · Arhitectura platformei · OpenShell 0.1.0 în practică · Jensen Huang la CNBC (@NVIDIAAI)
Together AI și Perplexity preiau anunțul
28 septembrie — Together AI se declară partener de lansare al platformei, în timp ce comunicatul NVIDIA îl include printre furnizorii de infrastructură. Furnizorul de servicii de inferență amintește că a construit funcții de platformă pentru dezvoltarea și implementarea securizată a agenților și spune că va continua să investească în acest domeniu, inclusiv împreună cu NVIDIA în jurul OpenShell, fără cifre sau produse numite.
Perplexity, menționat de două ori în comunicat (printre organizațiile care se alătură NVIDIA, apoi printre cele peste 100 care folosesc tehnologiile platformei), dar fără un rol precis, publică un fir de nouă mesaje:
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇷🇴 Ne asociem cu NVIDIA și cu peste 100 de parteneri din industrie pentru a construi o infrastructură care ține sub control agenții IA scăpați de sub control. — @perplexity_ai pe X
Restul firului reia Escaping SPACE, auditul de securitate al sandboxului său publicat pe 23 septembrie și prezentat atunci (nicio evadare din mașina virtuală în 108 încercări). Articolul respectiv menționa NVIDIA doar prin OpenShell, unul dintre sandboxurile terțe testate, în cazul căruia niciuna dintre cele două metode de ocolire nu reușise.
Manus trece la versiunea 2.0 cu infrastructura Cascade și lansează Cue, o aplicație cu agenți personali
28 septembrie — Manus lansează Manus 2.0, pe care îl prezintă ca pe o nouă arhitectură însoțită de produse noi. Anunțul vine la mai puțin de o lună după reluarea operațiunilor independente ale Manus, pe 1 septembrie.
La bază se află Cascade, cea mai recentă versiune a infrastructurii proprii pentru agenți: fiecare proiect pornește cu resurse reduse și primește capacități specializate doar când munca le cere, iar brief-ul, pagina, videoclipul și automatizarea rămân reunite în același proiect. Manus cuantifică îmbunătățirea față de sistemul anterior, însă doar pentru o singură configurație testată, pe care articolul nu o detaliază.
| Indicator raportat de Manus (o configurație testată) | Diferență față de sistemul anterior |
|---|---|
| Tokenuri consumate | -23,2 % |
| Durata sarcinilor | -28,2 % |
| Cost de execuție | -32 % |
Două componente completează ansamblul: Cloud Computer, un mediu dedicat care se achiziționează pentru activitățile ce trebuie să ruleze permanent (serverul unui joc multiplayer, o automatizare), și automatizări care se declanșează acum la un eveniment dintr-un serviciu conectat (e-mail nou, schimbare a performanței reclamelor, întâlnire în calendar, mesaj Slack, actualizare Notion), configurate printr-un singur prompt.
Aplicația desktop devine Manus Studio, un spațiu de lucru comun pentru oameni și IA, care încarcă doar instrumentele utile proiectului. Aici apar două medii. Video Editor produce un prim montaj, apoi deschide o cronologie (timeline) în care clipurile, imaginile, textele, animațiile și sunetul rămân separate și pot fi modificate; este destinat reclamelor pentru produse de 30 până la 60 de secunde, tutorialelor sau vlogurilor, iar modul său Alchemy încredințează direcția creativă IA. Game Dev combină modele video, de imagine și de cod, publică un joc care poate fi accesat printr-un simplu link și permite jocul multiplayer prin achiziționarea unui Cloud Computer. Cu Remote Control și Computer Use, utilizatorul îi poate încredința în sfârșit lui Manus, de pe telefon, o sarcină de îndeplinit pe propriul computer, urmărind desktopul în direct.
A treia componentă, Cue, este o nouă aplicație independentă cu agenți personali, pentru telefon și computer, construită pe infrastructura Manus. Fiecare agent are propria adresă de e-mail, propriul număr de telefon, propriul portofel și propriul computer: trimite mesaje, efectuează plăți în limita bugetului stabilit, preia apeluri și lasă un rezumat al acestora. Mai mulți agenți pot urmări un obiectiv comun într-o conversație de grup, iar Cue se conectează la servicii folosite zi de zi, precum comandarea mâncării la restaurant prin scanarea unui cod QR. La sfârșitul zilei, Manus a precizat că aceste numere permit efectuarea și primirea de apeluri și SMS-uri, doar în anumite țări și, uneori, numai pentru apeluri vocale.
Manus 2.0 este disponibil acum pe web, desktop și mobil. Cue este și el disponibil, versiunea iOS așteptând verificarea în App Store, în acces anticipat gratuit pe bază de cod de invitație, pentru un număr limitat de utilizatori inițiali. Articolul nu oferă niciun preț, nici măcar pentru Cloud Computer, nu numește niciun model de bază și nu citează nicio evaluare externă.
🔗 Prezentarea Manus 2.0 · Anunțul Cue pe X · Numerele de telefon ale agenților
ElevenLabs lansează Eleven v4, cel mai expresiv model vocal al său, și varianta Turbo pentru agenți
28 septembrie — ElevenLabs lansează Eleven v4, prezentat drept cel mai expresiv model al său de sinteză vocală (TTS), și Eleven v4 Turbo, o variantă cu latență redusă concepută pentru agenți conversaționali. Construit pe o arhitectură complet nouă, Eleven v4 ar trebui să interpreteze tonul, ritmul, emoția și contextul unui text pentru a produce o rostire dramatică, tandră, urgentă sau comică fără a pierde identitatea vocii. ElevenLabs revendică primul loc în clasamentul Provider Voice Arena al Artificial Analysis (septembrie 2026) și preferința a aproximativ 75 % dintre ascultători în teste fără indicarea identității modelelor, în comparație cu Cartesia Sonic 3.6, Inworld TTS-2 și două modele TTS Gemini 3.8 de la Google, egalitățile fiind contabilizate cu jumătate de punct.
Interpretarea poate fi dirijată prin limbaj natural sau prin etichete inserate în text (râsete, replică furioasă cu accent francez, ploaie ușoară, telefon care vibrează), pe care Eleven v4 le urmează mai fidel decât predecesorii săi, potrivit companiei. Suportul pentru alfabetul fonetic internațional (IPA) se îmbunătățește considerabil, iar dialogurile cu mai multe voci devin mai naturale, cu o nouă metodă de captare a identității vocilor pentru a le păstra consecvența în agenți, cărți audio și reclame.
| Indicator publicat de ElevenLabs | Valoare anunțată |
|---|---|
| Clasamentul Provider Voice Arena al Artificial Analysis (sept.) | Locul 1 |
| Preferință în teste fără indicarea modelelor față de 4 concurenți | aproximativ 75 % |
| Latența mediană de inferență a Eleven v4 Turbo | aproximativ 100 ms |
| Timpul median până la primul cuvânt al Eleven v4 Turbo | aproximativ 150 ms |
| Limbi acceptate | peste 90 (Eleven v3: peste 70) |
| Limita per solicitare pentru Eleven v4 | 10 000 de caractere (Eleven v3: 5 000) |
| Durata minimă a înregistrării pentru o clonă instantanee | 10 secunde |
Timpul până la primul cuvânt a fost măsurat în streaming WebSocket în comparație cu Cartesia, xAI, Google și OpenAI, după eliminarea latenței rețelei, iar Eleven v4 Turbo a fost optimizat împreună cu platforma ElevenAgents. O voce înregistrată într-o limbă le poate vorbi pe celelalte cu accent nativ, iar Eleven v4 acceptă acum clone vocale profesionale (Professional Voice Clones); înlănțuirea generărilor lungi, utilă în Studio și în aplicația Reader, devine mai fiabilă.
Ambele modele sunt disponibile acum în ElevenAgents, ElevenCreative și prin API (eleven_v4 și eleven_v4_turbo). Timp de două săptămâni, prețul API pentru Eleven v4 este redus la 22 de dolari, iar cel pentru Eleven v4 Turbo la 11 dolari per milion de caractere; Eleven v4 este gratuit pentru abonamentele Creator și superioare din ElevenCreative, în limita a de două ori numărul de credite lunare. Prețul de listă nu este publicat. Lansarea urmează după Eleven v3, pus în vânzare în februarie 2026.
🔗 Prezentarea Eleven v4 · Firul anunțului pe X
Kling anunță Kling 4.0 pentru octombrie și deschide accesul anticipat la Kling 4.0 Flash
28 septembrie — Kling AI prezintă Kling 4.0, noua generație a modelului său video, a cărui lansare oficială este prevăzută pentru octombrie. Prima sa variantă, Kling 4.0 Flash, este disponibilă din 28 septembrie în acces anticipat pentru un grup limitat de utilizatori, abonații Ultra cu plată anuală, potrivit postării de anunț. Kling evidențiază trei direcții: realismul vizual, controlul creativ și coerența narațiunii (narrative completeness).
Conform specificațiilor, Kling 4.0 generează videoclipuri continue de 3 până la 30 de secunde, la rezoluție de până la 4K, cu sunet stereo pe două canale. Narațiunea poate fi dirijată cu până la 10 imagini-cheie și prompturi de cel mult 8 000 de tokenuri, iar sistemul Omni Reference acceptă până la 15 referințe per generare: 10 imagini, 5 videoclipuri cu o durată cumulată de cel mult 30 de secunde și 7 subiecte, dintre care 3 extrase din videoclipuri; referința audio este limitată la voce. Modelele vizuale fără texturi și hărțile de adâncime pot ajuta la stabilirea mișcărilor și a încadrărilor, iar funcția de editare modifică expresii, gesturi, cameră, stil sau fundal în până la 5 clipuri. Kling revendică și text lizibil în imagine, precum și suport pentru mai multe limbi, accente și dialecte, de la cantoneză la dialectul din Sichuan și engleza indiană.
| Specificație tehnică | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| Disponibilitate | Lansare oficială în octombrie | Acces anticipat limitat din 28 septembrie |
| Moduri de generare | Text în video, imagine în video, prima și ultima imagine, 10 imagini-cheie, Omni Reference | Text în video, imagine în video, Omni Reference |
| Durata unei generări | 3 până la 30 de secunde | 3 până la 20 de secunde |
| Rezoluție maximă | 4K (și 720p și 1080p) | 720p |
| Gamă dinamică | HDR pe 10 biți la 1080p și 4K, anunțat pentru mai târziu | SDR pe 8 biți |
Nu toate funcțiile sunt încă disponibile. Notele versiunii anunță pentru mai târziu (coming soon) ieșirea HDR pe 10 biți la 1080p și 4K, deși postarea o include printre funcțiile Kling 4.0, precum și extinderea unui videoclip până la 2 minute. Kling își reproiectează și pagina de creare, care reunește toate referințele într-un singur câmp de introducere și adaugă un spațiu de lucru vizual în care un agent execută sarcinile cerute. Anunțul, ilustrat de scurtmetrajul THE BEAT realizat cu Kling 4.0, nu este însoțit de vreun preț, de acces la API sau de vreun benchmark.
🔗 Notele versiunii Kling 4.0 · Anunțul pe X
Agenți de cod: Claude Code 2.1.284, Codex CLI 0.158.0, Copilot CLI 1.0.89 și SDK-ul său, Devin, Delta și Gemini CLI
Claude Code 2.1.284 pornește în modul automat pentru toate abonamentele și la toți furnizorii
28 septembrie — Publicată la 18:02 UTC, cu câteva clipe înainte de anunțarea modelului, versiunea Claude Code 2.1.284 adaugă Claude Sonnet 5.5, care devine modelul Sonnet implicit în API Anthropic. Versiunea cuprinde 100 de intrări: 57 de corecții, 18 îmbunătățiri, 14 adăugiri și 11 modificări.
Cea mai vizibilă schimbare privește permisiunile: când nu este configurat niciun mod, sesiunile interactive din terminal și VS Code pornesc acum în modul automat, pentru toate abonamentele și la toți furnizorii. Versiunea 2.1.283 făcuse deja acest lucru pe 25 septembrie pentru furnizorii terți și sesiunile fără telemetrie; versiunea 2.1.284 extinde comportamentul la toți, iar setarea permissions.defaultMode are în continuare prioritate. Un nou răspuns, „Da, dar întreabă din nou data viitoare” (Yes, but ask again next time), permite o singură citire în afara directoarelor de lucru și îi cere lui Claude Code să solicite din nou permisiunea pentru citirile următoare.
Ultracode este scos din selectorul nivelului de efort și devine un comutator separat în /effort (tasta Tab sau /effort ultracode on și off): nu mai impune nivelul de efort xhigh și rămâne activ indiferent de nivelul ales, cu un comutator echivalent sub selectorul nivelului de efort din VS Code.
| Noutate în versiunea 2.1.284 | Comandă sau setare |
|---|---|
| Mod automat implicit, pentru toate abonamentele și furnizorii | permissions.defaultMode are prioritate |
| Ultracode ca opțiune independentă | Tab în /effort sau /effort ultracode on și off |
| Reconectarea în grup a serverelor MCP cu erori | /mcp reconnect all |
| Cheltuieli în dolari pentru gateway-ul aplicațiilor Claude | /usage și linia de stare (câmpurile used_usd, limit_usd, period) |
| A doua compactare dacă „Prompt is too long” persistă | automată |
În privința securității, pluginurile provenite din marketplace-uri, de pe claude.ai sau din npm nu își mai pot preaproba propriile instrumente atunci când administratorii permit doar regulile gestionate de ei (allowManagedPermissionRulesOnly); regulile din .claude/rules legate simbolic din afara proiectului necesită aprobare, iar încărcarea memoriei neutralizează în MEMORY.md caracterele invizibile și etichetele care imită marcajele Claude Code. Pentru fiabilitate, un flux de răspuns deteriorat este reîncercat în loc să afișeze „JSON Parse error”, iar apelurile MCP ale unei sesiuni reluate așteaptă până la 10 secunde serverul. În sfârșit, când mecanismele de protecție ale unui model Sonnet semnalează un mesaj, notificarea oferă mai multe explicații și propune modificarea solicitării și retrimiterea ei.
Codex CLI 0.158.0: copiere la selectare și secrete de client OAuth pentru MCP
28 septembrie — Publicată la 05:07 UTC, versiunea Codex CLI 0.158.0 este prima versiune stabilă de după 0.157.1 din 26 septembrie; notele sale enumeră 188 de pull requests de la 0.157.0 încoace. Interfața terminalului pe tot ecranul (fullscreen TUI) permite configurarea copierii la selectare (copy-on-select) și a lipirii cu clic dreapta, iar un fragment copiat din transcriere își păstrează formatarea Markdown.
| Funcție vizată | Setare sau detaliu |
|---|---|
| Copiere la selectare | tui.copy_on_select: auto implicit (tmux, Zellij, terminale macOS directe, cu excepția Ghostty și Kitty), always, never |
| Lipire cu clic dreapta | tui.right_click_paste: auto (Windows, Linux, WSL), on (și macOS), off |
| Servere MCP cu OAuth | codex mcp add --oauth-client-secret, cheia oauth.client_secret |
| Exec-server | Tokenuri bearer pentru conexiunile WebSocket directe |
| Generarea imaginilor | Fundal transparent explicit (transparent_background), editarea imaginilor din conversație |
Codex se poate conecta acum la servere MCP care necesită un client OAuth preînregistrat cu secret, iar conexiunile WebSocket directe la exec-server pot fi protejate cu tokenuri bearer (bearer tokens), inclusiv când trec prin app-server. În privința securității, aprobarea datelor introduse într-un terminal ajunge în versiunea stabilă și este activată implicit pentru comenzile lansate cu permisiuni ridicate. Corecțiile vizează în principal mediile izolate: căile obișnuite din Windows 10, datele de autentificare stocate care erau respinse, pornirea pe Linux cu rădăcini inscriptibile imbricate și protejarea metadatelor Git pe Linux și macOS.
Copilot CLI 1.0.89 ajunge la versiunea stabilă, iar SDK Copilot 1.0.15 oferă ieșiri tipizate
28 septembrie — GitHub lansează versiunea stabilă Copilot CLI 1.0.89 (19:20 UTC). Preversiunea 1.0.89-5, prezentată pe 27 septembrie, oferea deja suport pentru fișierele .claude/rules; dintre cele 35 de intrări din notele de lansare, câteva funcții sunt noi. Rutarea Auto sugerează acum un nivel, care poate fi schimbat printr-o comandă rapidă sau printr-un clic, și elimină profilul Fast, care nu era acceptat: o preferință Fast salvată revine la Balance. Crearea de pull request-uri urmează șabloanele depozitului, inclusiv secțiunile obligatorii și listele de verificare. Într-o sesiune locală, apăsarea de două ori a tastei Esc într-un câmp de introducere gol reia un prompt a cărui tură nu a început, iar pluginurile instalate direct pot fi activate și dezactivate (copilot plugin enable). În sandbox, funcționează comenzile gh și git incluse în timeout 60 gh …, iar localhost devine accesibil pe Windows când este activat accesul la rețeaua locală.
La scurt timp după aceea (19:38 UTC), SDK-ul GitHub Copilot, care integrează mediul de execuție pentru agenți al Copilot într-o aplicație, ajunge la versiunea 1.0.15 după cinci preversiuni. Principala noutate: ieșiri structurate și tipizate în toate cele șase SDK-uri (TypeScript, Python, Go, Java, C# și Rust); dezvoltatorul furnizează o schemă JSON sau un tip specific limbajului, iar modelul returnează o ieșire tipizată și validată în locul unui text liber. Un mecanism experimental permite și aplicației să impună o revizuire umană înainte de instalarea unui server MCP sau a unui skill, cu o decizie explicită (confirmare, refuz sau anulare), iar în Rust, memoria ocupată de instalarea acestui mediu de execuție scade cu aproximativ 99 %.
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devin devine cu 30–40 % mai ieftin, iar Devin Fusion conduce în FrontierCode 1.1 Extended
28 septembrie — Cognition anunță o reducere semnificativă a costului de utilizare a Devin: cu 30–40 % în modurile Fusion și Normal, cu 15–20 % în modul Ultra și cu până la 70 % pentru Devin Review, instrumentul său de revizuire a codului. Compania atribuie aceste economii integrării celor mai noi modele, inclusiv propriul SWE-2, și îmbunătățirilor aduse infrastructurii cloud a Devin (cloud harness): mai multe acțiuni grupate într-un singur apel de instrument (formatare, analiză și testare deodată), apeluri independente lansate în paralel și reutilizarea mai eficientă a cache-ului de prompturi. Cifrele orientative prezentate pentru această infrastructură provin din exemple ilustrative, nu din măsurători.
Cognition susține că a menținut sau a îmbunătățit capacitatea fiecărui mod. Fusion combină un model principal capabil cu un asistent (sidekick) mai ieftin, iar graficul din articol îl plasează pe primul loc în FrontierCode 1.1 Extended.
| Configurație evaluată de Cognition | Scor FrontierCode 1.1 Extended | Cost mediu per sarcină |
|---|---|---|
| Devin Fusion | 68,8 | 0,60 dolari |
| Opus 5.5 (high) | 65,2 | 0,90 dolari |
| Fable 5.1 (medium) | 63,6 | 2,68 dolari |
| GPT-6 Astra (high) | 63,1 | 2,62 dolari |
| SWE-2 (high) | 60,1 | 0,64 dolari |
| GPT-6 Sol (high) | 59,6 | 0,87 dolari |
Valorile pentru Opus 5.5 (65,2) și GPT-6 Astra (63,1), raportate la nivelul de efort high, diferă de cele din graficul publicat în aceeași zi pentru Sonnet 5.5 (65,3 și 64,5), care nu precizează nivelul de efort. Această versiune mai economică a Devin este disponibilă de astăzi, fără o nouă grilă de prețuri publicată.
🔗 Devin este acum cu până la 40 % mai eficient din punctul de vedere al costurilor
Notele de lansare Devin din 25 septembrie și versiunea beta Devin Mobile
25 septembrie — Trecute până acum neobservate, notele de lansare Devin din 25 septembrie adaugă 57 de integrări MCP găzduite (hosted MCP) în Marketplace, printre care Buildkite, Brex, Expo, Vanta, WorkOS și Wix. Devin produce și un raport HTML interactiv când i se cere un raport care ar beneficia de acest format (grafice, tabele, diagrame), fără ca formatul să fie specificat. O sesiune secundară începe cu un rezumat al sesiunii părinte, afișat ca o etichetă care poate fi eliminată din zona de introducere, iar o sesiune a cărei mașină a intrat în repaus se reactivează imediat ce este deschis un URL de previzualizare sau este stabilită o conexiune SSH la aceasta. Automatizările pot rula pe un Outpost partajat, iar Devin citește jurnalele Azure Pipelines pentru verificările eșuate ale pull request-urilor Azure DevOps.
Pe 28 septembrie, Cognition deschide și o listă de așteptare pentru versiunea beta Devin Mobile. Pagina de înscriere o rezumă într-o frază: Devin rulează în cloud sau pe mașina utilizatorului, testează în propriul browser și nu se oprește până când pull request-ul este gata de fuzionare. Nu au fost publicate nici o dată pentru disponibilitatea generală, nici un tarif.
🔗 Notele de lansare Devin · Devin Mobile pe X
Zed anunță Delta 0.18, Gemini CLI publică o versiune nightly fără schimbări
28 septembrie — Zed anunță, fără a preciza o dată, că versiunea 0.18 a Delta, mediul său colaborativ pentru programarea cu agenți, va rula firele (threads) Delta în worktree-uri Git deja existente; versiunea 0.17, publicată pe 23 septembrie, izola deja fiecare sarcină paralelă în propriul spațiu de lucru. În tabăra Google, versiunea nightly a Gemini CLI publicată pe 28 septembrie nu conține nicio schimbare: se bazează pe același commit ca versiunea din 26 septembrie, iar versiunea stabilă v0.61.0 și preversiunea v0.62.0-preview.0 rămân în vigoare.
🔗 Zed pe X · Gemini CLI v0.63.0-nightly.20260928
Agent API de la Perplexity devine reutilizabil: Profiles, Skills versionate și conectori partajați
28 septembrie — Perplexity adaugă în Agent API un nivel de configurare reutilizabil și versionat, conceput pentru echipe. Elementul central, Profile, stochează sub un identificator versionat unic tot ce definește un agent: modelul, instrucțiunile, instrumentele, Skills, conectorii și setările de execuție. Un administrator de proiect configurează agentul o singură dată și îl pune la dispoziția dezvoltatorilor autorizați; fiecare aplicație aduce apoi doar propriile date.
Skills personalizate împachetează instrucțiuni, proceduri și fișiere de suport într-o formă versionată: o echipă de platformă își poate păstra acolo verificările pentru implementare, criteriile de revenire la versiunea anterioară (rollback) și formatul rapoartelor, apoi poate publica o versiune nouă în loc să modifice fiecare aplicație. Conectorii gestionați (managed connectors), lansați la sfârșitul lunii august, devin o resursă pe care administratorul o partajează cu întregul proiect: aplicațiile îi folosesc prin referință, fără ca fiecare să își stocheze propriile credențiale sau definiții ale instrumentelor.
| Resursă adăugată | Rol în Agent API | Disponibilitate anunțată |
|---|---|---|
| Profiles | Model, instrucțiuni, instrumente, Skills, conectori și setări de execuție sub un identificator versionat | Disponibil |
| Skills personalizate | Instrucțiuni, proceduri și fișiere de suport versionate, invocate de membrii proiectului | Disponibil |
| Conectori gestionați | Integrări aprobate, partajate de administrator (GitHub, Slack, Google Drive, Datadog, Linear, Notion) | Preversiune |
Totul se configurează din API Console, iar membrii apelează aceste resurse cu o cheie API din același proiect; articolul nu anunță niciun tarif. În aceeași zi, o intrare din jurnalul de modificări al API-ului schimbă modelul prestabilit pentru nivelul xhigh din Agent API, de la GPT-5.6 Sol (openai/gpt-5.6-sol) la Claude Opus 5.5 (anthropic/claude-opus-5-5), în timp ce prompturile, efortul de raționament, instrumentele, bugetele de tokenuri și limitele de pași rămân neschimbate. Cu trei zile mai devreme, nivelurile prestabilite low, medium și high trecuseră la GPT-6.
🔗 Agent API acceptă acum agenți reutilizabili · Jurnalul de modificări al API-ului Perplexity
SpaceXAI lansează Team Bots, Grok Bots partajați de o echipă întreagă
28 septembrie — SpaceXAI lansează Team Bots, Grok Bots construiți în jurul unui rol sau al unui flux de lucru al echipei și partajați de toți membrii ei, fiecare putând să lucreze și individual cu Bot-ul. Bot-ul este comun, dar conversațiile rămân private: contextul și memoriile sunt separate pentru fiecare utilizator, în timp ce skills sunt comune echipei. Fiecare Team Bot are propriul identificator în Slack și poate fi invitat într-un canal unde întreaga echipă îi poate pune întrebări.
| Componentă a Bot-ului | Rol descris de SpaceXAI |
|---|---|
| Context | Fișiere, instrucțiuni și skills |
| Plugins | Lucru în Salesforce, Notion sau GitHub, conectate individual sau pentru echipă |
| Credențiale | Acces la API-uri terțe care nu au plugin |
| Memorii | Ce reține Bot-ul pentru a progresa în rolul său, separat pentru fiecare utilizator |
SpaceXAI descrie propriile utilizări. Fiecare client comercial important are propriul Team Bot, care analizează peste noapte știrile despre client, apelurile Gong, documentele Notion și conversațiile Slack, apoi publică dimineața o informare în Slack. Bot-ul pentru inginerie, conectat la Notion, Linear, Hex, Datadog și Cursor, a coordonat sute de Cloud Agents: astfel, o echipă de cinci persoane a livrat peste 100 de pull request-uri pe zi și a lansat Team Bots în câteva săptămâni. Dintre clienți, asigurătorul Harper spune că a construit în 24 de ore un Team Bot care își ajută clienții să își reactiveze polițele expirate, economisindu-le peste 120 000 de dolari, potrivit directorului său general.
Team Bots este disponibil de astăzi în versiune beta publică pentru planurile Teams și Enterprise, cu Team Bots preconfigurați pentru vânzări, managementul produselor, marketing și analiza datelor. SpaceXAI nu comunică nici prețuri, nici cote de utilizare.
🔗 Team Bots (SpaceXAI) · Anunțul @bot pe X
H Company publică Holo4, modele pentru agenți cu ponderi deschise de 27B și 35B-A3B
28 septembrie — H Company publică Holo4, noua sa serie de modele pentru agenți, în două dimensiuni: un model dens cu 27 de miliarde de parametri și un amestec de experți (Mixture of Experts) 35B-A3B, ambele disponibile prin H Models API și publicate pe Hugging Face în formatele BF16, FP8, NVFP4 și GGUF pe 4 biți. H adaugă Holotron4 Nano, obținut prin aplicarea metodei sale de antrenare ulterioară asupra Nemotron 3 Nano Omni de la NVIDIA. Același model acționează prin interfața grafică, cod, MCP sau API-uri, pe computer, pe web, pe Android sau într-un sandbox de cod; H l-a antrenat prin învățare supervizată, apoi prin învățare prin recompensă, inclusiv pe aproximativ 10 000 de sarcini verificabile generate de Agentic Task Factory din simpla documentație.
| Model evaluat | Model de bază și licență | Scor publicat |
|---|---|---|
| Holo4 27B | Qwen3.8-27B, CC-BY-NC-4.0 (necomercială) | 61,7 % pe OSWorld 2.0; 85,2 % pe OSWorld la 0,08 dolari per sarcină |
| Holo4 35B-A3B | Qwen3.6-35B-A3B, Apache-2.0 | 30,9 % pe OSWorld 2.0 |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni, NVIDIA Open Model Agreement | îmbunătățirile față de modelul de bază sunt prezentate doar grafic |
| Claude Opus 5.5 (referință citată de H) | model închis | 81,8 % pe OSWorld 2.0 |
H precizează condițiile evaluării: Holo4 este măsurat în propria infrastructură de testare, cu o singură rulare pe OSWorld 2.0, și comparat cu scoruri publice obținute cu alte infrastructuri și niveluri de efort; pe AutomationBench, 480 dintre cele 600 de sarcini publice aparțin partiției folosite pentru colectarea datelor de antrenament. H publică toate traiectoriile care stau la baza scorurilor sale publice, disponibile pentru consultare pas cu pas sau descărcare de pe Hugging Face, și anunță proiecte preliminare DSpark pentru accelerarea inferenței în zilele următoare.
🔗 Articolul despre Holo4 pe Hugging Face · Anunțul H Company
Robotică: SAIL de la Sakana AI crește rata de succes de la 25 la 73 %, iar ProjectSim pune sub semnul întrebării măsurarea în simulare
28 septembrie — Sakana AI prezintă SAIL (Scaling In-Context Imitation Learning), un proiect realizat împreună cu Universitatea din Tokyo și acceptat la conferința IROS 2026; lucrarea are un identificator arXiv din martie 2026, noutatea zilei fiind prezentarea sa publică. Întrebarea este: se pot obține mișcări fiabile ale unui robot dintr-un model vizual și lingvistic (VLM) existent, fără reantrenarea acestuia, alocându-i mai multă putere de calcul la inferență?
SAIL generează o traiectorie completă pornind de la câteva demonstrații reușite oferite în context și o execută în simulare; un al doilea VLM estimează apoi, pe baza videoclipului, progresul sarcinii, iar acest feedback ghidează o căutare arborescentă Monte Carlo (MCTS). Doar traiectoria selectată este trimisă robotului real. Gemini Robotics-ER 1.5 îndeplinește ambele roluri, fără modificarea ponderilor sale.
| Metodă evaluată | Noduri de căutare | Rata medie de succes pentru șase sarcini simulate |
|---|---|---|
| Generare unică | 1 | 25 % |
| Căutare în adâncime | 15 | 37 % |
| Căutare în lățime | 15 | 51 % |
| SAIL | 6 | 55 % |
| SAIL | 15 | 65 % |
| SAIL | 45 | 73 % |
Aceste rate reprezintă configurațiile (20 per sarcină, în simulatorul ALOHA) pentru care este găsită o traiectorie reușită în limita bugetului, succesul fiind verificat de simulator, nu de VLM. Pe un braț LeRobot SO-101, SAIL reușește în 5 din 6 încercări să pună un bloc într-un bol, cu un buget de 15 traiectorii candidate, iar o politică de imitare antrenată pe traiectoriile găsite reușește tot în 5 din 6 încercări, executându-se mai repede. Sakana recunoaște limitele: execuție în buclă deschisă, calcul suplimentar pentru căutare, evaluare în lumea reală limitată la o singură sarcină și șase încercări pentru fiecare metodă.
🔗 Articolul Sakana AI · Pagina proiectului SAIL
ProjectSim prezintă stadiul testelor comparative în robotică
28 septembrie — Diferența dintre scorurile obținute în simulare și cele obținute în realitate este chiar subiectul primului experiment ProjectSim. Într-un articol de sinteză care nu prezintă rezultate proprii, Luca Cilio trece în revistă testele comparative de manipulare, de la MetaWorld și LIBERO până la testele fizice comune precum RoboChallenge. El amintește, pe baza cifrelor RoboCasa365, că GR00T N1.5, ajustat pe 30 000 de demonstrații, reușește 43 % dintre abilitățile izolate, dar scade la 4,4 % pentru combinațiile care nu au fost incluse în ajustare. Experimentul ProjectSim urmărește să afle dacă scenele simulate mai fidele (cu geometrie, aspect și proprietăți fizice reconstruite) apropie scorurile din simulare de cele măsurate pe un robot real; încă nu au fost publicate rezultate.
Mistral deschide la München un centru dedicat IA industriale și IA pentru fizică
28 septembrie — Mistral deschide un centru la München. Acesta va găzdui echipe de cercetare în IA pentru fizică (Physics AI) și IA industrială (Industrial AI), alături de ingineri care lucrează direct cu companiile partenere: Mistral se prezintă aici drept partener tehnologic pe termen lung, nu doar ca furnizor de software.
| Partener menționat de Mistral | Activitate anunțată |
|---|---|
| BMW | Simularea accidentelor și IA pentru inginerie |
| Siemens Energy | Aplicații de IA industrială |
| Universitatea Tehnică din München (TUM) | Gemeni digitali în tunel aerodinamic pentru aerodinamica auto |
Acest centru continuă direcția deschisă prin achiziția Emmi AI în mai 2026, care a adus la Mistral peste 30 de fizicieni, cercetători și ingineri specializați în mecanica computațională a fluidelor (CFD), mecanica structurilor și simulări multifizice. Împreună cu TUM și profesorul Nikolaus A. Adams, Mistral va dezvolta gemeni digitali pentru aerodinamica auto, combinând măsurătorile în timp real ale senzorilor din tunelul aerodinamic cu simulări CFD calculate offline, pentru a obține predicții aerodinamice precise în timp real.
Articolul reia argumentul suveranității (ponderi accesibile clientului, modele rulate pe propria infrastructură și sub jurisdicție europeană, fără ca datele să părăsească organizația) și arată că Mistral va construi până în 2030 un gigawatt de capacitate de calcul europeană. Îi citează pe ministrul federal german al transformării digitale, Karsten Wildberger, și pe șeful Cancelariei de Stat a Bavariei, Florian Herrmann. Mistral face angajări în regiunea München, fără să precizeze numărul de posturi sau valoarea investiției.
🔗 Hallo, Deutschland! (Mistral AI)
NVIDIA și Nscale măsoară DSX MaxLPS: cu 37 % mai multe GPU și un debit cu 49 % mai mare în același buget de putere electrică
27 septembrie — NVIDIA publică o evaluare cantitativă a DSX MaxLPS, software-ul său care distribuie puterea între resursele unei fabrici de IA potrivit politicilor operatorului, realizată împreună cu Nscale. Potrivit NVIDIA, acesta permite instalarea cu până la 40 % mai multe GPU în cadrul aceluiași buget de putere electrică aprobat; articolul subliniază că este vorba despre o alocare coordonată, fără creșterea alimentării electrice a amplasamentului.
Testul a rulat pe GB300 NVL72 în centrul de date Nscale din campusul Verne, la Keflavík (Islanda), alimentat integral cu energie regenerabilă, folosind Kimi K2.5 în FP4, NVIDIA Dynamo și TensorRT LLM. În același buget alocat de 264,4 kW, flota crește de la 140 la 192 GPU fără scăderea debitului instanțelor existente.
| Indicator măsurat | Bază statică | Cu DSX MaxLPS | Diferență observată |
|---|---|---|---|
| GPU gestionate | 140 | 192 | +37,1 % |
| Debit agregat normalizat | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| Putere totală măsurată | 166,2 kW | 198,9 kW | +19,7 % |
| Utilizarea bugetului de putere electrică | 62,9 % | 75,2 % | +12,3 puncte |
| Debit per watt alocat | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
Articolul nu ascunde compromisul: deși latențele mediană și P75 rămân la mai puțin de 5 % de referință, P99 al timpului până la primul token crește cu 17 %, pornind de la o valoare de bază de 15,7 secunde. NVIDIA le recomandă operatorilor o validare în cinci etape, de la delimitarea bugetului de putere electrică până la stabilirea limitelor pentru producție. Această evaluare urmează validării făcute de Lambda pe HGX B200, prezentată la 15 septembrie (19 noduri în bugetul prevăzut pentru 16); proiecțiile pentru Vera Rubin, cu răcire cu lichid la o temperatură de intrare de 45 °C, sunt prezentate separat.
Pe scurt
- DeepSeek Harness 0.2.0-rc.1 — Prima versiune candidată din seria 0.2.0 și a 23-a versiune preliminară a infrastructurii de agenți DeepSeek, încă fără o versiune stabilă: conversațiile pe modelele din contul DeepSeek pot căuta pe web fără o cheie API suplimentară, iar sarcinile automatizate trec într-un pachet opțional de pluginuri. 🔗 sursă
- Pixel Canary pe Vercel AI Gateway — Din 25 septembrie, Vercel oferă gratuit, pe durata perioadei sale de testare discretă, acest model pentru cod al unui furnizor nenumit: 28 din 31 de sarcini Next.js la pass@4, la egalitate cu GPT-6 Astra (high), și 30 din 31 cu documentația furnizată prin AGENTS.md; nu oferă retenție zero a datelor. 🔗 sursă
- Runnere auto-găzduite GitHub Actions — Pe GitHub Enterprise Cloud, aplicarea integrală a cerințelor privind versiunile minime începe la 29 septembrie: sub versiunea 2.329.0, un runner nu se mai poate înregistra, iar unul sub versiunea minimă de execuție nu mai preia joburi; un nou API REST furnizează datele la care încetează suportul. GitHub Enterprise Server nu este afectat. 🔗 sursă
- NexteraBERT — Rikka Botan publică un encoder bidirecțional cu 212,6 milioane de parametri, preantrenat pe 130 de miliarde de tokenuri (de aproximativ 15 ori mai puține decât ModernBERT): 87,90 pe GLUE față de 87,97 pentru ModernBERT-base, 54,70 față de 53,63 pe MTEB v2 și un debit de 5,22 ori mai mare la 65 536 de tokenuri, potrivit propriilor măsurători; codul este sub licență MIT. 🔗 sursă
- LTX-2.5 în timp real — Un articol al comunității accelerează acest model audio și video cu 22 de miliarde de parametri, de la 90 de secunde per clip la o generare mai rapidă decât redarea: 1,83 secunde pentru un clip de 5 secunde pe o placă de 96 Go, datorită folosirii a 4 pași în loc de 8, calculului NVFP4 și CUDA Graph; codul este sub licență Apache-2.0. 🔗 sursă
- SCRIBE — Adalat AI, care dezvoltă recunoaștere vocală pentru instanțele din India, publică pe PyPI acest instrument open source de evaluare (lucrare la Interspeech 2026), care notează separat cuvintele, numerele, punctuația și termenii de specialitate, în timp ce rata de eroare pe cuvânt atribuie 100 % unei propoziții în malayalam pe care niciun corector nu ar modifica-o. 🔗 sursă
- 228 de proiecte JEV — Eric Kang, care întreține lista Awesome JEV, selectează 228 de proiecte open source (10 tipuri, minimum 50 de stele, fiecare fixat la un commit) dintre cele 13 473 de depozite returnate de o căutare „jev” pe GitHub, total care include și proiecte fără legătură: este o selecție manuală, nu un recensământ independent. 🔗 sursă
- HeyGen și Jev — HeyGen publică pe X un ghid care plasează Jev, modelul decizional TypeSafe AI, înaintea serverului său MCP: Jev sortează aproximativ patruzeci de potențiali clienți (video sau nu, abordare, limbă, potrivire), Claude scrie scenariile, apoi MCP HeyGen generează lotul, singura etapă care consumă credite și necesită validare. 🔗 sursă
- Patru creații cu Gemini 3.8 Flash — Blogul Google prezintă patru proiecte realizate cu modelul lansat la 2 septembrie: urmărirea în direct a sateliților construită cu Antigravity, valuri Seigaiha animate, un schelet 3D de tiranozaur și o cutie de viteze automată cu 10 perspective de cameră; fără cifre și fără noutăți despre produs. 🔗 sursă
- Un furnizor de catering din Brooklyn și Gemini — Blogul Google povestește cum Edy Massih, proprietarul băcăniei Edy’s Grocer din Greenpoint, folosește Gemini pentru a adapta rețetele la 200 de invitați, a genera listele de cumpărături și a ajusta meniurile pentru diferite regimuri alimentare; nicio funcție nouă. 🔗 sursă
- Lenfest Institute — OpenAI alocă 5 milioane de dolari, plus până la 5 milioane de dolari în credite software și sprijin tehnic, pentru următoarea etapă a programului de burse pentru IA al Lenfest Institute, lansat în 2024 în 11 redacții americane: dublul sprijinului acordat anterior. 🔗 sursă
- Fila Sănătate din ChatGPT — Selectarea unui grafic, a unei metrici sau a unui dosar în fila Health oferă acum explicații personalizate, uneori însoțite de un grafic interactiv, fără a scrie un prompt; Health rămâne disponibil doar în Statele Unite (pentru persoane de cel puțin 18 ani, cu abonamente Free, Go, Plus și Pro, pe web și iOS). 🔗 sursă
- Câștigătorii WebMCP Challenge — OpenAI Developers prezintă cele zece proiecte câștigătoare ale hackathonului lansat la sfârșitul lunii august (MASIL, Alza, ArchMorph, Aisle, Roque Nights, Mandate, Observatory, Bouquet Studio, Faraday, JupyterLite WebMCP), fără clasament sau sumă acordată fiecărui proiect. 🔗 sursă
- Remediere de securitate pe macOS — La 25 septembrie, versiunea 26.924.20706 a aplicației desktop pentru macOS, inclusă la rubrica aplicației Codex din jurnalul de modificări ChatGPT și Codex, a remediat vulnerabilitatea CVE-2026-100754 raportată de Patrick Wardle (Objective-See Foundation), fără o descriere a vulnerabilității. 🔗 sursă
Ce înseamnă toate acestea
Prețul per token rămâne stabil; scade numărul de tokenuri consumate. Sonnet 5.5 păstrează tariful Sonnet 5, dar costă, potrivit Anthropic, cu până la 30 % mai puțin per sarcină deoarece consumă mai puține tokenuri; Devin devine cu 30 până la 40 % mai ieftin prin integrarea celor mai noi modele ale sale, inclusiv SWE-2, și prin gruparea apelurilor către instrumente; Manus anunță un cost de execuție cu 32 % mai mic datorită noii sale infrastructuri, într-o configurație testată. Factorul decisiv este acum volumul de resurse consumate pentru lucru, atât de model, cât și de infrastructură, iar gama medie o ajunge din urmă pe cea superioară: pe Terminal-Bench 4.0, Sonnet 5.5 depășește scorul Opus 5.5 măsurat la nivelul de efort Xhigh.
Agenții primesc implicit mai multă autonomie, iar măsurile de protecție sunt plasate în afara controlului lor. Claude Code pornește acum în modul auto pe toate abonamentele, în timp ce NVIDIA instalează monitorizarea într-un DPU la care agentul nu poate ajunge și supune implicit validării umane orice regulă de acces propusă de acesta. Instrumentele urmează aceeași direcție: Codex CLI cere aprobare pentru introducerea în terminal a comenzilor care necesită permisiuni ridicate, iar Copilot SDK permite impunerea unei verificări umane înainte de instalarea unui server MCP sau a unui skill. Cu cât agentul acționează mai mult pe cont propriu, cu atât controlul trebuie să se afle mai departe de agentul însuși.
Agentul devine și un membru al echipei, cu o identitate proprie. Profiles de la Perplexity transformă un agent într-o configurație versionată, reutilizată de întregul proiect; Team Bots de la SpaceXAI au propriul identificator Slack și păstrează memorii separate pentru fiecare utilizator; iar agenții Cue primesc o adresă de e-mail, un număr de telefon și un portofel. Un agent care poate plăti, suna sau scrie în numele cuiva face foarte concrete întrebările despre control ridicate de NVIDIA în aceeași zi.
În sfârșit, cifrele zilei cer o lectură atentă. Devin măsoară Sonnet 5.5 pe o variantă de FrontierCode pe care tweetul și graficul său o denumesc diferit, iar două grafice Cognition publicate în aceeași zi dau scoruri diferite pentru Opus 5.5; Holo4 este măsurat în infrastructura H, într-o singură rulare pe OSWorld 2.0; cele 73 % ale SAIL sunt obținute în simulare, iar diferența dintre simulare și realitate este chiar subiectul primului experiment ProjectSim. În domeniul media, Eleven v4 se bazează pe un clasament extern și pe teste în orb, în timp ce Kling 4.0 sosește fără benchmark sau tarif, cu o parte dintre funcții amânate.
Surse
- Prezentarea Claude Sonnet 5.5 (Anthropic)
- Ghid de migrare la Claude Sonnet 5.5
- @ClaudeDevs: recomandări privind nivelul de efort pentru Sonnet 5.5
- Claude Sonnet 5.5 în GitHub Copilot
- Modele și tarife GitHub Copilot
- Claude Sonnet 5.5 în Devin
- @cognition: Sonnet 5.5 pe FrontierCode 1.1 Main
- @cursor_ai: Sonnet 5.5 în Cursor
- @v0: Sonnet 5.5 în v0
- NVIDIA lansează Open Agent Safety Platform (comunicat)
- Arhitectura Open Agent Safety Platform (NVIDIA)
- Adăugarea controalelor la rulare pentru agenții IA cu NVIDIA OpenShell
- @NVIDIAAI: Jensen Huang la CNBC
- @togethercompute: partener de lansare
- @perplexity_ai: parteneriat cu NVIDIA
- Prezentarea Manus 2.0
- @ManusAI: lansarea Cue
- @ManusAI: numerele de telefon ale agenților
- Prezentarea Eleven v4 (ElevenLabs)
- @ElevenLabs: firul de anunț al Eleven v4
- Notele de versiune Kling 4.0
- @Kling_ai: anunțul Kling 4.0
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- Devin este acum cu până la 40 % mai eficient din punctul de vedere al costurilor
- Notele de versiune Devin din 25 septembrie
- @cognition: versiunea beta Devin Mobile
- @zeddotdev: Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- Agent API acceptă acum agenți reutilizabili (Perplexity)
- Jurnalul de modificări al API-ului Perplexity
- Team Bots (SpaceXAI)
- @bot: anunțul Team Bots
- Holo4 pe blogul Hugging Face
- Holo4 (H Company)
- SAIL (Sakana AI)
- Pagina proiectului SAIL
- Testele comparative în robotică: unde ne aflăm și ce urmează (ProjectSim)
- Hallo, Deutschland! (Mistral AI)
- Cum maximizează NVIDIA DSX MaxLPS debitul și eficiența fabricilor de IA
- DeepSeek Harness 0.2.0-rc.1
- Pixel Canary pe Vercel AI Gateway
- Data aplicării cerințelor privind versiunile runnerelor auto-găzduite a fost schimbată (GitHub)
- Raportul tehnic NexteraBERT
- Personaje vorbitoare în timp real dintr-un model video de difuzie de 22B
- SCRIBE (Adalat AI)
- JEV: 228 de proiecte selectate (Eric Kang)
- @HeyGen: ghid pentru Jev și MCP HeyGen
- Vedeți ce creează patru dezvoltatori cu Gemini 3.8 Flash (Google)
- Trei moduri în care acest băcan gătește pentru 200 de invitați cu Gemini (Google)
- Lenfest AI Collaborative: o nouă etapă (OpenAI)
- Notele de versiune ChatGPT
- @OpenAIDevs: câștigătorii WebMCP Challenge
- Jurnalul de modificări ChatGPT și Codex: CVE-2026-100754