ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-6-sol.
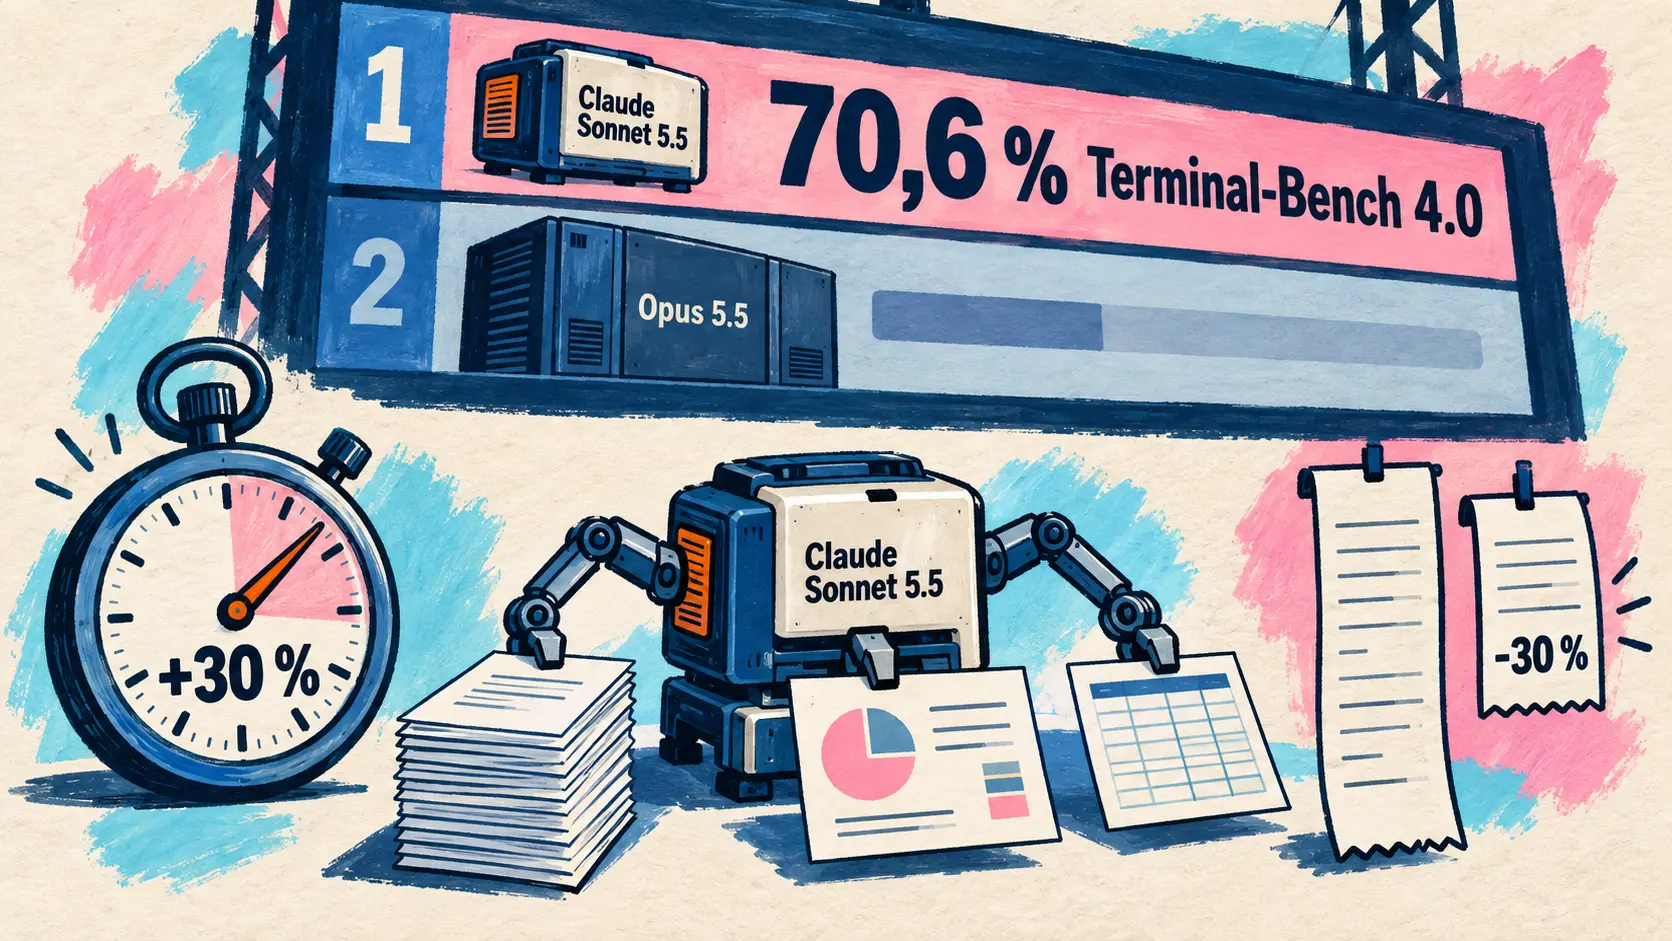
Op maandag 28 september, zes dagen na Opus 5.5, lanceert Anthropic Claude Sonnet 5.5: hetzelfde tarief als Sonnet 5, ruim 30 % snellere generatie en een score van 70,6 % op Terminal-Bench 4.0, tegenover 10,3 % voor zijn voorganger. GitHub Copilot, Devin, Cursor en v0 maken het model diezelfde dag beschikbaar. NVIDIA presenteert Open Agent Safety Platform, dat agents van software tot op chipniveau bewaakt met meer dan 100 organisaties. Manus stapt over op 2.0 en lanceert Cue, ElevenLabs brengt Eleven v4 uit en Kling kondigt Kling 4.0 aan voor oktober. Bij de codeagents start Claude Code 2.1.284 op alle abonnementen in de automatische modus en wordt Devin 30 tot 40 % goedkoper.
Anthropic lanceert Claude Sonnet 5.5, sneller en goedkoper per taak dan Sonnet 5
28 september — Zes dagen na Claude Opus 5.5 lanceert Anthropic Claude Sonnet 5.5 (claude-sonnet-5-5), het tweede model in de Claude 5.5-familie. Het wordt gepresenteerd als een duidelijke verbetering (clear upgrade) ten opzichte van Sonnet 5: het genereert antwoorden ruim 30 % sneller en kost volgens tests van Anthropic tot 30 % minder per taak, omdat het voor hetzelfde werk veel minder tokens nodig heeft. Opus 5.5 blijft het model voor complex werk dat zorgvuldig oordeel vereist; Sonnet 5.5 richt zich op duidelijk afgebakende dagelijkse taken: bugs oplossen en verzorgde documenten, presentaties en spreadsheets maken. Claude Haiku 5.5, bedoeld voor grote volumes, moet in de komende weken volgen.
Het grootste verschil met Sonnet 5 blijkt uit Terminal-Bench 4.0, een evaluatie van agentgestuurd programmeren via de commandoregel: 70,6 % tegenover 10,3 %, ook boven de 66,4 % van Opus 5.5, gemeten bij het inspanningsniveau Xhigh, zijn beste resultaat. Op GDPval-AA, gericht op kenniswerk, eindigt Sonnet 5.5 twee punten achter Opus 5.5 en ongeveer 400 punten boven Sonnet 5. Het is ook het eerste Sonnet-model dat Pokémon Red uitspeelt door uitsluitend op basis van schermafbeeldingen te werken.
| Benchmark (cijfers van Anthropic) | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % (Xhigh) | — |
| FrontierCode 1.1 Main | 52,1 % (Xhigh), 46,2 % (Max) | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | — |
| GDPval-AA v2.1 | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam (met tools) | 64,5 % | 54,9 % | 67,7 % | — |
| OSWorld 2.1 (gedeeltelijk) | 80,1 % | 57,0 % | 81,8 % | — |
| Chartography (zonder tools) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Anthropic plaatst kanttekeningen bij deze cijfers. Op FrontierCode scoort Sonnet 5.5 lager bij het inspanningsniveau Max, waarbij het vaker de skill voor codereview van Claude Code start. In twee door Cognition onderzochte gevallen leidde dat tot overschrijding van de tijdslimiet of tot werk buiten de taak. GDPval-AA en AA-Briefcase zijn gemeten op een voorlopige versie met een bug, waarvan het effect als klein wordt beschouwd. Bovenal acht Anthropic Opus 5.5 duidelijk sterker voor open en complex werk dat langdurig oordeelsvermogen vraagt.
Het tarief verandert niet: 2 dollar per miljoen tokens voor invoer, 10 dollar voor uitvoer en 0,20 dollar voor het lezen uit de cache, net als bij Sonnet 5. Voor invoer en uitvoer is dat de helft van Opus 5.5 (4 en 20 dollar). De besparing komt door het aantal verbruikte tokens: bij de inspanningsniveaus Low en Medium overtreft Sonnet 5.5 op verschillende benchmarks de beste score van Sonnet 5 voor ongeveer een tiende van de kosten per taak. Het model accepteert een context van 1 miljoen tokens en produceert maximaal 128 000 uitvoertokens; het standaardniveau is Medium in Claude Code en de Claude-apps, en High op de Claude Platform.
We recommend starting with Opus for large projects and Sonnet for tasks where you need to balance quality with speed and cost.
🇳🇱 We raden aan om voor grote projecten met Opus te beginnen en voor taken waarbij kwaliteit, snelheid en kosten in balans moeten zijn met Sonnet. — @ClaudeDevs op X
Omdat de mogelijkheden van Sonnet 5.5 op het gebied van cyberbeveiliging vergelijkbaar zijn met die van Opus 5, is het het eerste Sonnet-model dat wordt uitgebracht met cyberbeveiligingsmaatregelen van hetzelfde niveau als de krachtigste modellen: verzoeken met een hoog risico worden zichtbaar doorgeschakeld naar Sonnet 5, zonder gevolgen voor het gewone oplossen van bugs. Het is ook het eerste Sonnet-model met beveiligingsclassificatoren die voorkomen dat zijn redenering wordt geëxtraheerd. Die redenering blijft voortaan gekoppeld aan het account dat haar heeft voortgebracht.
Voor ontwikkelaars is overstappen op claude-sonnet-5-5 meer dan alleen een andere identifier gebruiken: de documentatie noemt vijf wijzigingen die de compatibiliteit met Sonnet 5 verbreken, waaronder het vervangen van het uitschakelen van redeneren door de instelling between_tools en het weigeren van geforceerde toolkeuze (tool_choice ingesteld op any of tool, fout 400). Het commando /claude-api migrate helpt bij de migratie in Claude Code.
Sonnet 5.5 is vanaf vandaag beschikbaar op de Claude Platform, in Claude Code en bij Amazon Web Services, Google Cloud en Microsoft Azure. De bronnen geven geen details per abonnement (Free, Pro, Max). In Claude Code maakt versie 2.1.284 het model standaard voor Sonnet op de Anthropic API (zie de sectie over codeagents).
🔗 Aankondiging van Claude Sonnet 5.5 · Migratiehandleiding voor Sonnet 5.5
GitHub Copilot maakt het beschikbaar vanaf het Pro-abonnement
28 september — GitHub maakt Claude Sonnet 5.5 algemeen beschikbaar in Copilot (changelogbericht om 11.03 uur PT). Anders dan Claude Opus 5.5, dat op 22 september zonder het Pro-abonnement verscheen, is het beschikbaar voor Copilot Pro, Pro+, Max, Business en Enterprise, op tien platformen: Visual Studio Code, Visual Studio, Copilot CLI, de Copilot-codeagent, de GitHub Copilot-app, github.com, GitHub Mobile, de JetBrains-IDE’s, Xcode en Eclipse. De uitrol verloopt geleidelijk.
Volgens GitHub evenaart Sonnet 5.5 in de eerste tests Claude Sonnet 5 bij codetaken met duidelijk minder stappen, tokens en toolaanroepen, en rondt het taken sneller af. GitHub publiceert daarvoor geen cijfers. Voor het gebruik geldt het openbare tarief van de aanbieder: de documentatie van GitHub vermeldt 2 dollar voor invoer en 10 dollar voor uitvoer per miljoen tokens, hetzelfde tarief als voor Claude Sonnet 5. Voor Business en Enterprise wordt het model automatisch beschikbaar als nieuwe modellen standaard zijn ingeschakeld, tenzij een beheerder die instelling of dit model heeft uitgeschakeld.
🔗 Claude Sonnet 5.5 in GitHub Copilot · Modellen en tarieven van Copilot
Devin meet een score van 64,4 % op FrontierCode 1.1
28 september — Cognition maakt Sonnet 5.5 op de dag van de release beschikbaar in Devin Desktop en Devin CLI en meet een score van 64,4 % op FrontierCode 1.1, zijn benchmark die controleert of aan de vereisten van productiecodebases wordt voldaan, tegenover 56,2 % voor Sonnet 5. Daarmee passeert het Claude Fable 5.1 (63,6 %) en komt het net achter de drie koplopers in de grafiek: Opus 5.5 (65,3 %), Fable 5 (64,9 %) en GPT-6 Astra (64,5 %).
De post van Cognition spreekt over de variant Main, maar de grafiek in het artikel draagt de titel Extended en gebruikt voor de andere modellen de waarden die op 22 september voor die variant zijn gepubliceerd. Ter vergelijking: Anthropic geeft Sonnet 5.5 een score van 52,1 % op de variant Main, bij het inspanningsniveau Xhigh. Cognition verwijst tot slot naar de cijfers van Anthropic: een ruim 30 % snellere generatie en tot 30 % lagere kosten per taak dan Sonnet 5, bij ongewijzigde tokenprijzen.
🔗 Claude Sonnet 5.5 in Devin · Cognition op X
Cursor en v0 maken het model diezelfde dag beschikbaar
28 september — v0, de tool van Vercel om apps te maken, maakt Sonnet 5.5 om 18.04 uur UTC beschikbaar, een minuut na de aankondiging. Cursor volgt om 20.14 uur UTC en omschrijft het als een sterk model, op veel taken op het niveau van Opus, zonder aan te geven welke Opus-versie het bedoelt. Er worden geen tarieven of metingen voor de tools genoemd: net als bij Opus 5.5 op 22 september gaat het alleen om de beschikbaarheid.
🔗 Cursor op X · v0 op X
NVIDIA lanceert Open Agent Safety Platform om agents van software tot op chipniveau te bewaken
28 september — NVIDIA lanceert Open Agent Safety Platform, een open softwareplatform met een referentiesysteemontwerp, om AI-agents van test tot ingebruikname te beveiligen, met governance en controle over de volledige stack (software, hardware, rekenkracht en robotsystemen). Het architectuurartikel begint met de constatering dat verschillende toonaangevende laboratoria onlangs hebben gemeld dat agents ontsnapten uit de evaluatieomgevingen die hen moesten binnenhouden. Een van de vijf gekozen principes is dat beleid verifieerbaar moet zijn en buiten het bereik van de agent moet worden gehandhaafd.
| Platformonderdeel | Door NVIDIA aangekondigde rol |
|---|---|
| NVIDIA OpenShell (open source, versie 0.1) | Uitvoeringsomgeving (runtime) in een sandbox: formeel geverifieerd beleid dat buiten de agent wordt gehandhaafd, op Vera-CPU’s en platformen van derden (Arm, Intel) |
| NVIDIA Sentry (referentieontwerp) | Waakhond buiten het bereik van de agent op de BlueField-4-DPU, die een agent binnen enkele milliseconden in quarantaine plaatst |
| NVIDIA DOCA | Inspectie van verzoeken en antwoorden, geattesteerde telemetrie, identiteit van de agent, toegang op basis van zero trust |
OpenShell, een open source uitvoeringsomgeving (Apache 2.0) die sinds maart wordt gevolgd, gaat naar versie 0.1 (0.1.0 verscheen op 25 september op GitHub, 0.1.2 op 28 september) en wordt nu aangekondigd als breed beschikbaar, voor zowel open als gesloten modellen. Elke agent draait in een sandbox met controles op kernelniveau; een externe toezichthouder inspecteert HTTP-, GraphQL- en MCP-verkeer (lezen is toegestaan, schrijven via dezelfde API wordt geblokkeerd), en de agent krijgt toegang tot diensten zonder de echte inloggegevens te zien. Het beleid wordt in YAML geschreven, naar OPA/Rego gecompileerd en door een formele prover gecontroleerd. Als toegang ontbreekt, kan de agent een beperkte regel voorstellen, die standaard op menselijke goedkeuring wacht zonder dat de agent die zelf kan geven. OpenShell ondersteunt Codex, Claude Code, Pi en Hermes. Tijdens langdurige adversariële tests, aldus NVIDIA, probeerden geavanceerde agents met afgezwakte beveiligingsmaatregelen tot twee uur lang een AI-beoordelaar over te halen hun toegang te geven tot een beveiligde GitHub-repository, zonder dat daarin iets werd geschreven.
Sentry, het tweede onderdeel, verplaatst het toezicht naar de hardware: een waakhond buiten het bereik van de agent (out-of-band watchdog) op een BlueField-4-DPU, gebouwd op DOCA, die het gedrag van agents voortdurend bewaakt, hun identiteit controleert en een agent die zijn grenzen overschrijdt binnen enkele milliseconden in quarantaine kan plaatsen. In een Vera Rubin-POD plaatst elke rekeneenheid een BlueField-4 op het enige pad van het knooppunt naar het model. Volgens NVIDIA kan Sentry op een Vera-systeem dat al met BlueField-4 is uitgerust via een software-update worden geactiveerd.
NVIDIA zegt dat meer dan 100 organisaties met de technologieën van het platform werken. Anthropic integreert zijn Claude Managed Agents met OpenShell en BlueField; deze voeren de agentlus uit op een andere server dan de sandboxes. SpaceXAI past het platform toe op de Cursor-codeagents en de Grok-modellen. Salesforce volgt de activiteit van OpenShell-agents vanuit Slack, waar hun verzoeken om rechten worden goedgekeurd of afgewezen. SAP integreert het in de uitvoeringsomgeving van Joule Studio en Scale AI in zijn GenAI-aanbod. De lijst loopt van Microsoft, IBM, Palantir, CrowdStrike en Hugging Face tot robotica (Figure, Skild AI), de financiële sector (Citi, JPMorganChase), besturingssystemen (Canonical, SUSE, Red Hat) en infrastructuuraanbieders (CoreWeave, Nebius, Oracle Cloud Infrastructure). De software, waaronder OpenShell en skills, is beschikbaar op GitHub en op de ontwikkelaarspagina van NVIDIA. Jensen Huang lichtte de maatregelen diezelfde dag toe op CNBC.
🔗 Persbericht van NVIDIA · Architectuur van het platform · OpenShell 0.1.0 in de praktijk · Jensen Huang op CNBC (@NVIDIAAI)
Together AI en Perplexity delen de aankondiging
28 september — Together AI noemt zich een lanceringspartner van het platform, terwijl NVIDIA het in zijn persbericht onder de infrastructuuraanbieders schaart. De aanbieder van inferentiediensten wijst erop dat hij platformfuncties heeft gebouwd om agents veilig te ontwikkelen en in te zetten, en zegt hierin te blijven investeren, onder meer samen met NVIDIA rond OpenShell, zonder cijfers of een specifiek product te noemen.
Perplexity wordt twee keer in het persbericht genoemd (eerst bij de partijen die zich bij NVIDIA aansluiten, daarna bij de meer dan 100 organisaties die de platformtechnologieën gebruiken), maar zonder specifieke rol. Het plaatst een reeks van negen berichten:
We’re partnering with Nvidia and 100+ industry partners to build infrastructure that contains rogue AI agents.
🇳🇱 We werken samen met NVIDIA en meer dan 100 partners uit de sector om infrastructuur te bouwen die onbeheerste AI-agents binnen de perken houdt. — @perplexity_ai op X
De rest van de reeks verwijst opnieuw naar Escaping SPACE, de beveiligingsaudit van zijn sandbox die op 23 september werd gepubliceerd en toen al werd behandeld (geen enkele ontsnapping uit de virtuele machine in 108 pogingen). In dat artikel werd NVIDIA alleen genoemd via OpenShell, een van de geteste sandboxes van derden, waarbij geen van de twee omzeilingspogingen was geslaagd.
Manus stapt over op 2.0 met het Cascade-harnas en lanceert Cue, een app voor persoonlijke agents
28 september — Manus lanceert Manus 2.0, dat het bedrijf presenteert als een nieuwe architectuur met nieuwe producten. De aankondiging komt minder dan een maand nadat Manus op 1 september de zelfstandige activiteiten hervatte.
De basis heet Cascade, de nieuwste versie van het eigen agentharnas: elk project begint licht en krijgt pas gespecialiseerde mogelijkheden wanneer het werk daarom vraagt. De briefing, de pagina, de video en de automatisering blijven daarbij binnen hetzelfde project. Manus becijfert de winst ten opzichte van zijn vorige systeem, maar alleen voor één geteste configuratie, die in het bericht niet nader wordt beschreven.
| Door Manus gemeten waarde (één geteste configuratie) | Verschil met het vorige systeem |
|---|---|
| Verbruikte tokens | -23,2 % |
| Taakduur | -28,2 % |
| Uitvoeringskosten | -32 % |
Twee onderdelen vullen dit aan: de Cloud Computer, een aparte omgeving die je aanschaft voor taken die voortdurend moeten draaien (de server van een multiplayergame, een automatisering), en automatiseringen die voortaan worden geactiveerd door een gebeurtenis in een gekoppelde dienst (nieuwe e-mail, verandering in advertentieprestaties, agenda-afspraak, Slack-bericht, Notion-update). Ze zijn met één prompt in te stellen.
De desktopapp wordt Manus Studio, een gedeelde werkruimte voor mensen en AI die alleen de tools laadt die voor het project nodig zijn. Daarin verschijnen twee omgevingen. Video Editor maakt een eerste montage en opent daarna een tijdlijn (timeline) waarop clips, afbeeldingen, teksten, animaties en audio gescheiden en bewerkbaar blijven; de omgeving is bedoeld voor productadvertenties van 30 tot 60 seconden, tutorials of vlogs. In de modus Alchemy krijgt de AI de creatieve regie. Game Dev combineert video-, beeld- en codemodellen, publiceert een speelbare game via een eenvoudige link en maakt multiplayer mogelijk door een Cloud Computer aan te schaffen. Met Remote Control en Computer Use kun je Manus vanaf je telefoon een taak op je eigen computer laten uitvoeren, terwijl je het bureaublad live volgt.
Het derde onderdeel, Cue, is een nieuwe zelfstandige app voor persoonlijke agents op telefoon en computer, gebouwd op de infrastructuur van Manus. Elke agent heeft een eigen e-mailadres, telefoonnummer, portemonnee en computer: hij verstuurt berichten, betaalt binnen het ingestelde budget, neemt gesprekken aan en vat ze samen. Meerdere agents kunnen in een groepsgesprek aan hetzelfde doel werken, en Cue sluit aan op alledaagse diensten, zoals bestellen in een restaurant door een QR-code te scannen. Later die dag verduidelijkte Manus dat deze nummers in sommige landen kunnen worden gebruikt om te bellen en gebeld te worden en om sms-berichten te versturen en ontvangen; soms zijn alleen spraakoproepen mogelijk.
Manus 2.0 is nu beschikbaar op het web, desktop en mobiel. Cue is eveneens beschikbaar, al wacht de iOS-versie nog op beoordeling door de App Store. De gratis vroege toegang is alleen met een uitnodigingscode beschikbaar voor een beperkt aantal eerste gebruikers. Het bericht vermeldt geen prijzen, ook niet voor de Cloud Computer, noemt geen onderliggende modellen en verwijst niet naar externe evaluaties.
🔗 Introductie van Manus 2.0 · Aankondiging van Cue op X · Telefoonnummers van agents
ElevenLabs lanceert Eleven v4, zijn meest expressieve spraakmodel, en een Turbo-variant voor agents
28 september — ElevenLabs lanceert Eleven v4, dat het presenteert als zijn meest emotionele model voor tekst-naar-spraak (TTS), en Eleven v4 Turbo, een variant met lage latentie voor gespreksagents. Eleven v4 is gebouwd op een volledig nieuwe architectuur en moet de toon, het ritme, de emotie en de context van een tekst interpreteren om een dramatische, tedere, dringende of komische voordracht te produceren zonder de stemidentiteit te verliezen. ElevenLabs claimt de eerste plaats op de Provider Voice Arena-ranglijst van Artificial Analysis (september 2026) en zegt dat ongeveer 75 % van de luisteraars in blinde tests de voorkeur gaf aan Eleven v4 boven Cartesia Sonic 3.6, Inworld TTS-2 en twee Gemini 3.8 TTS-modellen van Google, waarbij gelijke beoordelingen voor de helft meetelden.
De voordracht wordt gestuurd met natuurlijke taal of met tags in de tekst (gelach, een boze repliek met een Frans accent, lichte regen, een trillende telefoon), die Eleven v4 volgens het bedrijf nauwkeuriger volgt dan zijn voorgangers. De ondersteuning voor het Internationaal Fonetisch Alfabet (IPA) is duidelijk verbeterd en dialogen met meerdere stemmen klinken natuurlijker. Een nieuwe methode om de identiteit van stemmen vast te leggen moet ze consistent houden in agents, audioboeken en advertenties.
| Door ElevenLabs gepubliceerde indicator | Opgegeven waarde |
|---|---|
| Plaats op de Provider Voice Arena-ranglijst van Artificial Analysis (sept.) | 1e |
| Voorkeur in blinde tests tegenover 4 concurrerende modellen | ongeveer 75 % |
| Mediane inferentielatentie van Eleven v4 Turbo | ongeveer 100 ms |
| Mediane tijd tot de eerste spraak van Eleven v4 Turbo | ongeveer 150 ms |
| Ondersteunde talen | meer dan 90 (Eleven v3: meer dan 70) |
| Limiet per verzoek van Eleven v4 | 10 000 tekens (Eleven v3: 5 000) |
| Minimale audio voor een instantkloon | 10 seconden |
De tijd tot de eerste spraak is gemeten via WebSocket-streaming tegenover Cartesia, xAI, Google en OpenAI, zonder netwerklatentie. Eleven v4 Turbo is samen met het ElevenAgents-platform geoptimaliseerd. Een stem die in één taal is opgenomen, spreekt de andere talen met een moedertaalaccent. Eleven v4 ondersteunt nu ook professionele stemklonen (Professional Voice Clones); het achter elkaar genereren van langere stukken audio, nuttig voor Studio en de Reader-app, is betrouwbaarder geworden.
Beide modellen zijn nu beschikbaar in ElevenAgents, ElevenCreative en via de API (eleven_v4 en eleven_v4_turbo). Twee weken lang kost de Eleven v4-API met korting 22 dollar en de Eleven v4 Turbo-API 11 dollar per miljoen tekens. Eleven v4 is gratis voor Creator-abonnementen en hoger bij ElevenCreative, tot maximaal twee keer het maandelijkse aantal credits; de standaardprijs is niet gepubliceerd. Deze release volgt op Eleven v3, dat in februari 2026 op de markt kwam.
🔗 Introductie van Eleven v4 · Aankondigingsbericht op X
Kling kondigt Kling 4.0 aan voor oktober en opent vroege toegang tot Kling 4.0 Flash
28 september — Kling AI presenteert Kling 4.0, zijn nieuwe generatie videomodellen, waarvan de officiële release voor oktober gepland staat. De eerste variant, Kling 4.0 Flash, is sinds 28 september in vroege toegang beschikbaar voor een beperkte groep gebruikers: volgens het aankondigingsbericht op X zijn dat houders van een jaarabonnement op Ultra. Kling benadrukt drie punten: visueel realisme, creatieve controle en een afgerond verhaal (narrative completeness).
Volgens de specificaties genereert Kling 4.0 video’s van 3 tot 30 seconden in één keer, tot 4K, met tweekanaals stereogeluid. Het verhaal is te sturen met maximaal 10 keyframes en prompts van hoogstens 8 000 tokens. Omni Reference accepteert maximaal 15 referenties per generatie: 10 afbeeldingen, 5 video’s met een gezamenlijke duur van hoogstens 30 seconden en 7 onderwerpen, waarvan 3 uit video’s; audioreferenties zijn beperkt tot stemmen. Modellen zonder textuur en dieptekaarten kunnen bewegingen en camerakaders helpen vastleggen, en met de editor zijn uitdrukkingen, gebaren, camera, stijl of achtergrond aan te passen in maximaal 5 clips. Kling claimt ook leesbare tekst in beeld en ondersteuning voor meer talen, accenten en dialecten, van Kantonees tot Sichuanees en Indiaas Engels.
| Technische specificatie | Kling 4.0 | Kling 4.0 Flash |
|---|---|---|
| Beschikbaarheid | Officiële release in oktober | Beperkte vroege toegang sinds 28 september |
| Generatiemodi | Tekst naar video, afbeelding naar video, eerste en laatste afbeelding, 10 keyframes, Omni Reference | Tekst naar video, afbeelding naar video, Omni Reference |
| Duur per generatie | 3 tot 30 seconden | 3 tot 20 seconden |
| Maximale resolutie | 4K (ook 720p en 1080p) | 720p |
| Dynamisch bereik | 10-bits HDR in 1080p en 4K, aangekondigd voor later | 8-bits SDR |
Nog niet alles is beschikbaar. De release notes kondigen 10-bits HDR-uitvoer in 1080p en 4K voor later aan (coming soon), hoewel het bericht op X die functie al bij Kling 4.0 noemt. Ook het verlengen van een video tot 2 minuten volgt later. Kling vernieuwt daarnaast zijn creatiepagina: alle referenties staan nu in één invoerveld en er komt een canvas waarop een agent de gevraagde taken uitvoert. Bij de aankondiging staan geen prijzen, informatie over API-toegang of benchmarks. Ze wordt geïllustreerd met THE BEAT, een korte film die met Kling 4.0 is gemaakt.
🔗 Release notes van Kling 4.0 · Aankondiging op X
Codeagents: Claude Code 2.1.284, Codex CLI 0.158.0, Copilot CLI 1.0.89 en zijn SDK, Devin, Delta en Gemini CLI
Claude Code 2.1.284 start in automatische modus bij alle abonnementen en aanbieders
28 september — Claude Code 2.1.284, uitgebracht om 18.02 uur UTC, enkele ogenblikken voor de aankondiging van het model, voegt Claude Sonnet 5.5 toe. Dat wordt het standaard Sonnet-model via de Anthropic API. De versie telt 100 vermeldingen: 57 bugfixes, 18 verbeteringen, 14 toevoegingen en 11 wijzigingen.
De opvallendste wijziging betreft de machtigingen: wanneer er geen modus is ingesteld, starten interactieve sessies in de terminal en VS Code voortaan in automatische modus, bij alle abonnementen en alle aanbieders. Versie 2.1.283 deed dat sinds 25 september al voor externe aanbieders en sessies zonder telemetrie; versie 2.1.284 trekt dit breder, waarbij de instelling permissions.defaultMode voorrang houdt. Een nieuw antwoord, ‘Ja, maar vraag het de volgende keer opnieuw’ (Yes, but ask again next time), staat één keer lezen buiten de werkmappen toe en laat Claude Code voor volgende keren opnieuw toestemming vragen.
Ultracode verdwijnt uit de inspanningsschuifregelaar en wordt een aparte schakelaar in /effort (de Tab-toets, of /effort ultracode on en off): het dwingt het inspanningsniveau xhigh niet langer af en blijft actief ongeacht het gekozen niveau. Een vergelijkbare schakelaar staat onder de inspanningsschuifregelaar in VS Code.
| Nieuw in 2.1.284 | Opdracht of instelling |
|---|---|
| Automatische modus standaard bij alle abonnementen en aanbieders | permissions.defaultMode houdt voorrang |
| Ultracode als aparte schakelaar | Tab in /effort, of /effort ultracode on en off |
| Mislukte MCP-serververbindingen tegelijk herstellen | /mcp reconnect all |
| Uitgaven in dollars voor de Claude apps-gateway | /usage en statusregel (velden used_usd, limit_usd, period) |
| Tweede compactie als ‘Prompt is too long’ aanhoudt | automatisch |
Op beveiligingsgebied kunnen plugins uit marketplaces, claude.ai of npm hun eigen tools niet meer vooraf goedkeuren wanneer de beheerder alleen beheerde regels toestaat (allowManagedPermissionRulesOnly). Voor regels uit .claude/rules die via een symbolische link van buiten het project komen, wordt om goedkeuring gevraagd. Bij het laden van het geheugen neutraliseert Claude Code in MEMORY.md onzichtbare tekens en tags die de opmaak van Claude Code nabootsen. Voor de betrouwbaarheid wordt een beschadigde antwoordstroom opnieuw geprobeerd in plaats van ‘JSON Parse error’ te tonen, en wachten MCP-aanroepen in een hervatte sessie maximaal 10 seconden op hun server. Als de beveiligingsfilters van een Sonnet-model een bericht signaleren, geeft de melding meer uitleg en stelt ze voor de aanvraag aan te passen en opnieuw te versturen.
Codex CLI 0.158.0: kopiëren bij selectie en OAuth-clientgeheimen voor MCP
28 september — Codex CLI 0.158.0, uitgebracht om 05.07 uur UTC, is de eerste stabiele versie sinds 0.157.1 van 26 september; de release notes vermelden 188 pull requests sinds 0.157.0. In de schermvullende interface (fullscreen TUI) zijn kopiëren bij selectie (copy-on-select) en plakken met de rechtermuisknop instelbaar. Een uit de transcriptie gekopieerde passage behoudt zijn Markdown-opmaak.
| Functie | Instelling of bijzonderheid |
|---|---|
| Kopiëren bij selectie | tui.copy_on_select: standaard auto (tmux, Zellij, directe macOS-terminals behalve Ghostty en Kitty), always, never |
| Plakken met rechtermuisknop | tui.right_click_paste: auto (Windows, Linux, WSL), on (ook macOS), off |
| MCP-servers met OAuth | codex mcp add --oauth-client-secret, sleutel oauth.client_secret |
| Exec-server | Bearer tokens voor directe WebSocket-verbindingen |
| Beeldgeneratie | Expliciet transparante achtergrond (transparent_background), afbeeldingen uit het gesprek bewerken |
Codex kan nu verbinding maken met MCP-servers die een vooraf geregistreerde OAuth-client met geheim vereisen. Directe WebSocket-verbindingen met de exec-server kunnen met bearer tokens worden beveiligd, ook wanneer ze via de app-server lopen. Op beveiligingsgebied is goedkeuring van invoer die naar een terminal wordt gestuurd nu stabiel en standaard ingeschakeld voor opdrachten met verhoogde machtigingen. De bugfixes richten zich vooral op de sandboxes: gewone Windows 10-paden, geweigerde opgeslagen inloggegevens, opstarten onder Linux met geneste beschrijfbare hoofdmaplocaties en bescherming van Git-metadata op Linux en macOS.
Copilot CLI 1.0.89 wordt stabiel uitgebracht, Copilot SDK 1.0.15 voorziet uitvoer van typen
28 september — GitHub brengt Copilot CLI 1.0.89 uit als stabiele versie (19.20 uur UTC). De previewversie 1.0.89-5, die op 27 september werd beschreven, ondersteunde al .claude/rules-bestanden; verschillende van de 35 vermeldingen in de release notes zijn nieuw. Auto-routing stelt nu een niveau voor dat met een sneltoets of een klik kan worden gewijzigd, en verliest het niet-ondersteunde Fast-profiel: een opgeslagen Fast-voorkeur valt terug op Balance. Bij het aanmaken van pull requests worden de sjablonen van de repository gevolgd, inclusief verplichte secties en checklists. In een lokale sessie haalt tweemaal op Escape drukken in een leeg invoerveld een prompt terug waarvan de beurt nog niet is begonnen, en rechtstreeks geïnstalleerde plugins kunnen worden in- en uitgeschakeld (copilot plugin enable). In de sandbox werken verpakte commando’s gh en git (timeout 60 gh …), en onder Windows wordt localhost bereikbaar wanneer toegang tot het lokale netwerk is ingeschakeld.
Kort daarna (19.38 uur UTC) verschijnt versie 1.0.15 van de GitHub Copilot SDK, die de agentruntime van Copilot in een applicatie integreert, na vijf previewversies. De belangrijkste vernieuwing is getypeerde, gestructureerde uitvoer in alle zes SDK’s (TypeScript, Python, Go, Java, C# en Rust): de ontwikkelaar levert een JSON-schema of een taalgebonden type aan, waarna het model gevalideerde, getypeerde uitvoer teruggeeft in plaats van vrije tekst. Met een experimentele handler kan de applicatie ook een menselijke beoordeling vereisen voordat een MCP-server of skill wordt geïnstalleerd, met een expliciete beslissing (bevestigen, weigeren of annuleren). In Rust daalt het geheugengebruik bij de installatie van deze runtime met ongeveer 99 %.
🔗 Copilot CLI v1.0.89 · Copilot SDK v1.0.15
Devin wordt 30 tot 40 % goedkoper, Devin Fusion voert FrontierCode 1.1 Extended aan
28 september — Cognition kondigt aan dat Devin aanzienlijk goedkoper wordt in gebruik: 30 tot 40 % goedkoper in de modi Fusion en Normal, 15 tot 20 % in de modus Ultra en tot 70 % voor Devin Review, zijn tool voor codebeoordeling. Het bedrijf schrijft de besparingen toe aan de integratie van de nieuwste modellen, waaronder zijn eigen SWE-2, en aan verbeteringen aan Devins cloud harness: meer acties gebundeld in één toolaanroep (opmaken, analyseren en testen tegelijk), onafhankelijke aanroepen die parallel worden uitgevoerd en beter hergebruik van de promptcache. De genoemde ordegroottes voor deze harness komen uit illustratieve voorbeelden, niet uit metingen.
Cognition zegt dat de intelligentie van elke modus behouden of verbeterd is. Fusion combineert een capabel hoofdmodel met een goedkopere assistent (sidekick); in de grafiek bij het bericht staat deze modus bovenaan FrontierCode 1.1 Extended.
| Door Cognition beoordeelde configuratie | Score FrontierCode 1.1 Extended | Gemiddelde kosten per taak |
|---|---|---|
| Devin Fusion | 68,8 | 0,60 dollar |
| Opus 5.5 (high) | 65,2 | 0,90 dollar |
| Fable 5.1 (medium) | 63,6 | 2,68 dollar |
| GPT-6 Astra (high) | 63,1 | 2,62 dollar |
| SWE-2 (high) | 60,1 | 0,64 dollar |
| GPT-6 Sol (high) | 59,6 | 0,87 dollar |
De waarden voor Opus 5.5 (65,2) en GPT-6 Astra (63,1), gemeten bij inspanningsniveau high, verschillen van die in de grafiek die dezelfde dag voor Sonnet 5.5 werd gepubliceerd (65,3 en 64,5); daarin wordt het inspanningsniveau niet vermeld. Deze goedkopere Devin is vanaf vandaag beschikbaar, zonder dat een nieuwe prijslijst is gepubliceerd.
🔗 Devin is nu tot 40 % kostenefficiënter
Release notes van Devin van 25 september en bèta van Devin Mobile
25 september — De tot nu toe onopgemerkte release notes van Devin van 25 september voegen 57 gehoste MCP-integraties (hosted MCP) toe aan de Marketplace, waaronder Buildkite, Brex, Expo, Vanta, WorkOS en Wix. Devin maakt ook een interactief HTML-rapport wanneer om een rapport wordt gevraagd waarvoor dat nuttig is (grafieken, tabellen, diagrammen), zonder dat een formaat is opgegeven. Een onderliggende sessie begint met een samenvatting van de bovenliggende sessie, die als verwijderbare badge in het invoerveld verschijnt. Een sessie waarvan de machine in slaapstand is gegaan, wordt weer actief zodra iemand een preview-URL opent of via SSH verbinding maakt. Automatiseringen kunnen op een gedeelde Outpost draaien en Devin leest de Azure Pipelines-logs van mislukte controles bij Azure DevOps-pull requests.
Op 28 september opent Cognition ook een wachtlijst voor de bèta van Devin Mobile. De aanmeldpagina vat het in één zin samen: Devin draait in de cloud of op uw machine, test in zijn eigen browser en stopt pas wanneer de pull request klaar is om te worden samengevoegd. Er zijn geen datum voor algemene beschikbaarheid of prijzen bekendgemaakt.
🔗 Release notes van Devin · Devin Mobile op X
Zed kondigt Delta 0.18 aan, Gemini CLI publiceert een nightly zonder wijzigingen
28 september — Zed kondigt zonder datum aan dat Delta 0.18, zijn multiplayeromgeving om met agents te programmeren, Delta-threads in bestaande Git-worktrees zal uitvoeren. Versie 0.17, uitgebracht op 23 september, plaatste elke parallelle taak al in een eigen werkruimte. Bij Google bevat de op 28 september gepubliceerde nightly van Gemini CLI geen wijzigingen: die is gebaseerd op dezelfde commit als de nightly van de 26e. Ook de stabiele versie v0.61.0 en previewversie v0.62.0-preview.0 blijven ongewijzigd.
🔗 Zed op X · Gemini CLI v0.63.0-nightly.20260928
De Agent API van Perplexity wordt herbruikbaar: Profiles, Skills met versies en gedeelde connectors
28 september — Perplexity voegt aan zijn Agent API een herbruikbare configuratielaag met versiebeheer toe, bedoeld voor teams. Het centrale onderdeel, het Profile, slaat onder één unieke identifier met versie alle eigenschappen van een agent op: model, instructies, tools, Skills, connectors en uitvoeringsinstellingen. Een projectbeheerder configureert de agent één keer en stelt deze beschikbaar aan bevoegde ontwikkelaars; elke applicatie hoeft alleen nog eigen gegevens aan te leveren.
Aangepaste Skills bundelen instructies, procedures en ondersteunende bestanden in versies. Een platformteam kan er zijn implementatiecontroles, criteria voor terugdraaien (rollback) en rapportindeling in vastleggen, en vervolgens een nieuwe versie publiceren in plaats van elke applicatie aan te passen. Beheerde connectors (managed connectors), eind augustus gelanceerd, worden een voorziening die de beheerder met het hele project deelt: applicaties verwijzen ernaar zonder elk afzonderlijk hun inloggegevens of tooldefinities op te slaan.
| Toegevoegde voorziening | Rol in de Agent API | Aangekondigde beschikbaarheid |
|---|---|---|
| Profiles | Model, instructies, tools, Skills, connectors en uitvoeringsinstellingen onder een identifier met versie | Beschikbaar |
| Aangepaste Skills | Instructies, procedures en ondersteunende bestanden met versies, aangeroepen door projectleden | Beschikbaar |
| Beheerde connectors | Goedgekeurde integraties die de beheerder deelt (GitHub, Slack, Google Drive, Datadog, Linear, Notion) | Preview |
Alles wordt ingesteld via de API Console en leden roepen deze voorzieningen aan met een API-sleutel van hetzelfde project; in het bericht worden geen prijzen aangekondigd. Op dezelfde dag meldt een vermelding in de API-changelog dat de xhigh-preset van de Agent API overgaat van GPT-5.6 Sol (openai/gpt-5.6-sol) naar Claude Opus 5.5 (anthropic/claude-opus-5-5). Prompts, redeneerinspanning, tools, tokenbudgetten en limieten voor het aantal stappen blijven gelijk. Drie dagen eerder waren de presets low, medium en high overgegaan op GPT-6.
🔗 Agent API ondersteunt nu herbruikbare agents · Changelog van de Perplexity API
SpaceXAI lanceert Team Bots, Grok Bots die door een heel team worden gedeeld
28 september — SpaceXAI lanceert Team Bots: Grok Bots die rond een rol of teamworkflow zijn gebouwd en door alle teamleden worden gedeeld. Ieder teamlid kan ook afzonderlijk met de Bot werken. De Bot is gemeenschappelijk, maar gesprekken blijven privé: context en herinneringen zijn per gebruiker gescheiden, terwijl skills met het team worden gedeeld. Elke Team Bot heeft een eigen identiteit in Slack en kan worden uitgenodigd in een kanaal waar het hele team vragen kan stellen.
| Onderdeel van de Bot | Door SpaceXAI beschreven rol |
|---|---|
| Context | Bestanden, instructies en skills |
| Plugins | Werken in Salesforce, Notion of GitHub, gekoppeld per persoon of per team |
| Inloggegevens | Toegang tot externe API’s waarvoor geen plugin bestaat |
| Herinneringen | Wat de Bot onthoudt om beter te worden in zijn rol, gescheiden per gebruiker |
SpaceXAI beschrijft zijn eigen toepassingen. Elke grote zakelijke klant heeft een Team Bot die ‘s nachts het nieuws over de klant, Gong-gesprekken, Notion-documenten en Slack-threads analyseert en ‘s ochtends een update in Slack plaatst. De engineering-Bot, gekoppeld aan Notion, Linear, Hex, Datadog en Cursor, heeft honderden Cloud Agents aangestuurd. Zo leverde een team van vijf mensen meer dan 100 pull requests per dag op en lanceerde het Team Bots binnen enkele weken. Bij de klanten zegt verzekeraar Harper in 24 uur een Team Bot te hebben gebouwd die klanten helpt hun verlopen polissen te herstellen; volgens zijn CEO bespaarden zij daarmee samen meer dan 120.000 dollar.
Team Bots is vanaf vandaag als openbare bèta beschikbaar voor de abonnementen Teams en Enterprise, met vooraf geconfigureerde Team Bots voor verkoop, productmanagement, marketing en gegevensanalyse. SpaceXAI maakt geen prijzen of quota bekend.
🔗 Team Bots (SpaceXAI) · Aankondiging van @bot op X
H Company publiceert Holo4, agentmodellen met open gewichten van 27B en 35B-A3B
28 september — H Company publiceert Holo4, zijn nieuwe reeks agentmodellen, in twee groottes: een dicht model met 27 miljard parameters en een mixture-of-experts-model (Mixture of Experts) van 35B-A3B. Beide zijn beschikbaar via de H Models API en gepubliceerd op Hugging Face in BF16, FP8, NVFP4 en 4-bit GGUF. H voegt daar Holotron4 Nano aan toe, verkregen door zijn recept voor natraining toe te passen op Nemotron 3 Nano Omni van NVIDIA. Eén en hetzelfde model werkt via de grafische interface, code, MCP of API’s, op een computer, op het web, op Android of in een code-sandbox. H trainde het eerst met begeleid leren en daarna met reinforcement learning, onder meer op ongeveer 10.000 verifieerbare taken die zijn Agentic Task Factory genereert uit eenvoudige documentatie.
| Beoordeeld model | Basis en licentie | Gepubliceerde score |
|---|---|---|
| Holo4 27B | Qwen3.8-27B, CC-BY-NC-4.0 (niet-commercieel) | 61,7 % op OSWorld 2.0; 85,2 % op OSWorld voor 0,08 dollar per taak |
| Holo4 35B-A3B | Qwen3.6-35B-A3B, Apache-2.0 | 30,9 % op OSWorld 2.0 |
| Holotron4 Nano (Holotron4-30B-A3B) | Nemotron 3 Nano Omni, NVIDIA Open Model Agreement | verbeteringen ten opzichte van het basismodel alleen in een grafiek |
| Claude Opus 5.5 (door H aangehaalde referentie) | gesloten model | 81,8 % op OSWorld 2.0 |
H licht de meetomstandigheden toe: Holo4 wordt gemeten met H’s eigen harness, met één run op OSWorld 2.0, en vergeleken met openbare scores die met andere harnesses en inspanningsniveaus zijn behaald. Op AutomationBench behoren 480 van de 600 openbare taken tot de verdeling die is gebruikt om de trainingsgegevens te verzamelen. H publiceert alle trajecten achter zijn openbare scores; ze zijn stap voor stap te bekijken of te downloaden via Hugging Face. Het bedrijf kondigt ook DSpark-concepten aan om de inferentie de komende dagen te versnellen.
🔗 Bericht over Holo4 op Hugging Face · Aankondiging van H Company
Robotica: SAIL van Sakana AI stijgt van 25 naar 73 % succes, ProjectSim stelt meting in simulatie ter discussie
28 september — Sakana AI presenteert SAIL (Scaling In-Context Imitation Learning), een onderzoek uitgevoerd met de Universiteit van Tokio en geaccepteerd voor de conferentie IROS 2026. De paper heeft een arXiv-identifier uit maart 2026; het nieuws van vandaag is de openbare presentatie. De onderzoeksvraag: kunnen bestaande vision-language models (VLM’s) betrouwbare robotbewegingen opleveren zonder hertraining, door ze tijdens inferentie meer rekenkracht te geven?
SAIL genereert op basis van enkele geslaagde demonstraties in de context een volledig traject en voert dat in simulatie uit. Een tweede VLM schat vervolgens op basis van de video de voortgang van de taak; die feedback stuurt een Monte Carlo tree search (MCTS). Alleen het gekozen traject gaat naar de echte robot. Gemini Robotics-ER 1.5 vervult beide rollen, zonder wijziging van zijn gewichten.
| Beoordeelde methode | Zoekknopen | Gemiddeld succes bij zes gesimuleerde taken |
|---|---|---|
| Eén generatie | 1 | 25 % |
| Diepte-eerst zoeken | 15 | 37 % |
| Breedte-eerst zoeken | 15 | 51 % |
| SAIL | 6 | 55 % |
| SAIL | 15 | 65 % |
| SAIL | 45 | 73 % |
Deze percentages tellen de configuraties (20 per taak in de ALOHA-simulator) waarvoor binnen het budget een geslaagd traject wordt gevonden; het succes wordt door de simulator vastgesteld, niet door het VLM. Met een LeRobot SO-101-arm slaagt SAIL er in 5 van de 6 pogingen in een blok in een kom te leggen, met een budget van 15 kandidaattrajecten. Een op de gevonden trajecten getraind imitatiebeleid slaagt eveneens 5 van de 6 keer en voert de taak sneller uit. Sakana erkent de beperkingen: uitvoering zonder terugkoppeling, extra rekenwerk voor de zoekprocedure en een praktijkevaluatie die beperkt is tot één taak en zes pogingen per methode.
🔗 Bericht van Sakana AI · SAIL-projectpagina
ProjectSim maakt de balans op van benchmarks in de robotica
28 september — De kloof tussen scores in simulaties en scores in de praktijk is precies het onderwerp van het eerste experiment van ProjectSim. In een overzichtsartikel zonder eigen resultaten bespreekt Luca Cilio benchmarks voor manipulatie, van MetaWorld en LIBERO tot gedeelde fysieke tests zoals RoboChallenge. Aan de hand van cijfers uit RoboCasa365 laat hij zien dat GR00T N1.5, verfijnd met 30.000 demonstraties, 43 % van de afzonderlijke vaardigheden beheerst, maar terugvalt tot 4,4 % bij combinaties die niet in de verfijningsdata voorkwamen. ProjectSim onderzoekt of getrouwer nagebouwde simulatiescènes (geometrie, uiterlijk en fysische eigenschappen) de scores in simulaties dichter bij die van een echte robot brengen; er zijn nog geen resultaten gepubliceerd.
Mistral opent in München een hub voor industriële AI en AI voor natuurkunde
28 september — Mistral opent een hub in München. De locatie zal teams huisvesten die onderzoek doen naar AI voor natuurkunde (Physics AI) en industriële AI (Industrial AI), naast toegepaste ingenieurs die rechtstreeks met partnerbedrijven samenwerken. Mistral presenteert zich daar als technologische partner voor de lange termijn, in plaats van als softwareleverancier.
| Door Mistral genoemde partner | Aangekondigd werk |
|---|---|
| BMW | Crashsimulatie en AI voor engineering |
| Siemens Energy | Toepassingen van industriële AI |
| Technische Universiteit München (TUM) | Digitale tweelingen in de windtunnel voor autoaerodynamica |
De hub bouwt voort op de overname van Emmi AI in mei 2026, waarmee meer dan 30 natuurkundigen, onderzoekers en ingenieurs gespecialiseerd in computationele vloeistofdynamica (CFD), constructiemechanica en multiphysische simulaties bij Mistral kwamen. Samen met de TUM en professor Nikolaus A. Adams zal Mistral digitale tweelingen voor autoaerodynamica ontwikkelen. Daarbij worden realtime metingen van windtunnelsensoren gecombineerd met offline berekende CFD-simulaties om nauwkeurige aerodynamische voorspellingen in realtime te leveren.
Het artikel herhaalt het argument van digitale soevereiniteit (modelgewichten die toegankelijk zijn voor klanten, modellen die op hun eigen infrastructuur en onder Europees recht draaien, zonder dat gegevens de organisatie verlaten) en stelt dat Mistral tegen 2030 één gigawatt aan Europese rekencapaciteit zal bouwen. Het citeert de Duitse bondsminister voor Digitale Transformatie, Karsten Wildberger, en de hoofd van de Beierse Staatskanselarij, Florian Herrmann. Mistral werft personeel in de regio München, zonder aantallen medewerkers of een investeringsbedrag te noemen.
🔗 Hallo, Deutschland! (Mistral AI)
NVIDIA en Nscale meten DSX MaxLPS: 37 % meer GPU’s en 49 % meer doorvoer binnen hetzelfde stroombudget
27 september — NVIDIA publiceert een cijfermatige evaluatie van DSX MaxLPS, zijn software die het vermogen volgens het beleid van de operator verdeelt over de middelen van een AI-fabriek. De evaluatie is samen met Nscale uitgevoerd. Volgens NVIDIA maakt de software het mogelijk om binnen hetzelfde goedgekeurde stroombudget tot 40 % meer GPU’s in te zetten. Het artikel benadrukt dat dit gebeurt door gecoördineerde toewijzing van vermogen, zonder de stroomtoevoer van de locatie te verhogen.
De test draaide op GB300 NVL72-systemen in het datacenter van Nscale op de Verne-campus in Keflavík (IJsland), dat volledig op hernieuwbare energie werkt. Daarbij werden Kimi K2.5 in FP4, NVIDIA Dynamo en TensorRT LLM gebruikt. Binnen hetzelfde gereserveerde budget van 264,4 kW groeit de vloot van 140 naar 192 GPU’s, zonder dat de doorvoer van bestaande instances afneemt.
| Gemeten indicator | Statische basis | Met DSX MaxLPS | Gemeten verschil |
|---|---|---|---|
| Beheerde GPU’s | 140 | 192 | +37,1 % |
| Genormaliseerde totale doorvoer | 1 084 503 tokens/s | 1 618 443 tokens/s | +49,2 % |
| Totaal gemeten vermogen | 166,2 kW | 198,9 kW | +19,7 % |
| Benutting van het stroombudget | 62,9 % | 75,2 % | +12,3 punten |
| Doorvoer per gereserveerde watt | 4,10 tokens/s/W | 6,12 tokens/s/W | +49,2 % |
Het artikel vermeldt ook het nadeel: de mediane latentie en P75 blijven binnen 5 % van de referentie, maar de P99 van de tijd tot het eerste token stijgt met 17 %, vanaf een uitgangswaarde van 15,7 seconden. NVIDIA raadt operators een validatie in vijf stappen aan, van het afbakenen van het stroombudget tot het vaststellen van productielimieten. Deze evaluatie volgt op de validatie door Lambda op HGX B200, gepresenteerd op 15 september (19 nodes binnen het budget voor 16). De prognoses voor Vera Rubin, met vloeistofkoeling en een inlaattemperatuur van 45 °C, worden afzonderlijk gepresenteerd.
🔗 Technisch artikel van NVIDIA
Korte berichten
- DeepSeek Harness 0.2.0-rc.1 — De eerste release candidate van de 0.2.0-serie en de 23e preview van de agentharness van DeepSeek, nog steeds zonder stabiele versie: gesprekken over modellen van het DeepSeek-account kunnen het web doorzoeken zonder extra API-sleutel, en automatiseringstaken zijn ondergebracht in een optioneel pluginpakket. 🔗 bron
- Pixel Canary op Vercel AI Gateway — Sinds 25 september biedt Vercel dit codemodel van een niet bij naam genoemde aanbieder gratis aan tijdens de stille introductie: 28 van de 31 Next.js-taken met pass@4, gelijk aan GPT-6 Astra (high), en 30 van de 31 met documentatie via AGENTS.md; er is geen zero data retention. 🔗 bron
- Zelf gehoste runners van GitHub Actions — Op GitHub Enterprise Cloud begint de volledige handhaving van minimumversies op 29 september: een runner met een versie lager dan 2.329.0 kan zich niet meer registreren, en een runner onder de minimale uitvoeringsversie neemt geen jobs meer aan. Een nieuwe REST API geeft de einddatums van de ondersteuning. GitHub Enterprise Server valt hierbuiten. 🔗 bron
- NexteraBERT — Rikka Botan publiceert een bidirectionele encoder met 212,6 miljoen parameters, vooraf getraind op 130 miljard tokens (ongeveer 15 keer minder dan ModernBERT): 87,90 op GLUE tegenover 87,97 voor ModernBERT-base, 54,70 tegenover 53,63 op MTEB v2 en een 5,22 keer hogere doorvoer bij 65 536 tokens, volgens eigen metingen; de code heeft een MIT-licentie. 🔗 bron
- LTX-2.5 in realtime — Een artikel uit de community versnelt dit audio- en videomodel met 22 miljard parameters van 90 seconden per clip tot generatie die sneller gaat dan afspelen: 1,83 seconde voor een clip van 5 seconden op een kaart van 96 GB, dankzij 4 stappen in plaats van 8, NVFP4-berekeningen en CUDA Graph; de code heeft een Apache-2.0-licentie. 🔗 bron
- SCRIBE — Adalat AI, dat spraakherkenning voor Indiase rechtbanken ontwikkelt, publiceert op PyPI deze open source evaluatietool (met een artikel op Interspeech 2026). De tool beoordeelt woorden, getallen, interpunctie en vaktermen afzonderlijk, terwijl het foutenpercentage per woord een Malayalam-zin die geen enkele corrector zou aanpassen als 100 % fout aanmerkt. 🔗 bron
- 228 JEV-projecten — Eric Kang, beheerder van de lijst Awesome JEV, selecteert 228 open source projecten (10 typen, minimaal 50 sterren, elk vastgelegd op één commit) uit de 13 473 repositories die een zoekopdracht naar « jev » op GitHub oplevert. Dat totaal bevat ook niet-gerelateerde projecten: het gaat om een handmatige selectie, niet om een onafhankelijke inventarisatie. 🔗 bron
- HeyGen en Jev — HeyGen publiceert op X een handleiding waarin Jev, het beslismodel van TypeSafe AI, vóór zijn MCP-server wordt geplaatst: Jev sorteert ongeveer veertig potentiële klanten (wel of geen video, invalshoek, taal en geschiktheid), Claude schrijft de scripts en daarna produceert de HeyGen MCP de reeks. Alleen die laatste stap verbruikt credits en wacht op goedkeuring. 🔗 bron
- Vier creaties met Gemini 3.8 Flash — De blog van Google toont vier projecten die zijn gebouwd met het op 2 september gelanceerde model: een live tracker voor satellieten, gebouwd met Antigravity, geanimeerde Seigaiha-golven, een 3D-skelet van een tyrannosaurus en een automatische versnellingsbak met 10 camerastandpunten; zonder cijfers of productnieuws. 🔗 bron
- Een cateraar uit Brooklyn en Gemini — De blog van Google vertelt hoe Edy Massih, eigenaar van delicatessenwinkel Edy’s Grocer in Greenpoint, Gemini gebruikt om zijn recepten op te schalen voor 200 gasten, boodschappenlijsten te maken en menu’s aan dieetwensen aan te passen; er is geen nieuwe functie. 🔗 bron
- Lenfest Institute — OpenAI investeert 5 miljoen dollar, plus maximaal 5 miljoen dollar aan softwarecredits en technische ondersteuning, in de volgende fase van het AI-fellowshipprogramma van het Lenfest Institute. Dat programma ging in 2024 van start bij 11 Amerikaanse redacties; de steun is daarmee verdubbeld ten opzichte van de vorige bijdrage. 🔗 bron
- Gezondheidstabblad van ChatGPT — Wie in het tabblad Health een grafiek, meetwaarde of dossier selecteert, krijgt nu persoonlijke uitleg, soms met een interactieve grafiek, zonder een prompt te schrijven. Health blijft beperkt tot de Verenigde Staten (18 jaar en ouder, abonnementen Free, Go, Plus en Pro, web en iOS). 🔗 bron
- Winnaars van de WebMCP Challenge — OpenAI Developers presenteert de tien winnende projecten van de hackathon die eind augustus begon (MASIL, Alza, ArchMorph, Aisle, Roque Nights, Mandate, Observatory, Bouquet Studio, Faraday, JupyterLite WebMCP), zonder ranglijst of bedrag per project. 🔗 bron
- Beveiligingspatch voor macOS — Op 25 september verhielp versie 26.924.20706 van de macOS-desktopapp, vermeld onder de Codex-app in de changelog van ChatGPT en Codex, de door Patrick Wardle (Objective-See Foundation) gemelde kwetsbaarheid CVE-2026-100754. Een beschrijving van de kwetsbaarheid ontbreekt. 🔗 bron
Wat dit betekent
De prijs per token verandert niet meer; het aantal verbruikte tokens daalt. Sonnet 5.5 behoudt het tarief van Sonnet 5, maar kost volgens Anthropic tot 30 % minder per taak doordat het minder tokens verbruikt. Devin wordt 30 tot 40 % goedkoper door zijn nieuwste modellen, waaronder SWE-2, te integreren en toolaanroepen te bundelen. Manus meldt in een geteste configuratie 32 % lagere uitvoeringskosten met zijn nieuwe harness. De doorslaggevende factor is nu de hoeveelheid verbruikt werk, zowel bij het model als bij de harness, en de middenklasse haalt de top in: op Terminal-Bench 4.0 overtreft Sonnet 5.5 de score die Opus 5.5 bij inspanning Xhigh behaalde.
Agents krijgen standaard meer autonomie en de veiligheidsmaatregelen worden buiten hun bereik geplaatst. Claude Code start nu bij alle abonnementen in de automatische modus, terwijl NVIDIA de bewaking onderbrengt in een DPU waar de agent niet bij kan en elke voorgestelde toegangsregel standaard aan menselijke goedkeuring onderwerpt. De tools volgen dezelfde lijn: Codex CLI vraagt goedkeuring voor terminalinvoer bij opdrachten met verhoogde rechten, en met de Copilot SDK kan een menselijke beoordeling worden vereist voordat een MCP-server of skill wordt geïnstalleerd. Hoe zelfstandiger de agent handelt, hoe meer de controle buiten de agent zelf moet liggen.
De agent wordt ook een teamlid met een eigen identiteit. De Profiles van Perplexity maken van een agent een versiebeheerbare configuratie die een heel project kan hergebruiken. De Team Bots van SpaceXAI hebben een eigen Slack-identiteit en bewaren voor elke gebruiker aparte herinneringen. Agents van Cue krijgen een e-mailadres, een telefoonnummer en een wallet. Een agent die namens iemand kan betalen, bellen of schrijven, maakt de vragen over controle die NVIDIA diezelfde dag stelt heel concreet.
Tot slot vragen de cijfers van de dag om zorgvuldige lezing. Devin meet Sonnet 5.5 op een variant van FrontierCode die in zijn tweet en grafiek verschillend wordt genoemd, en twee grafieken die Cognition op dezelfde dag publiceerde geven uiteenlopende scores voor Opus 5.5. Holo4 is gemeten met de harness van H, in één enkele run op OSWorld 2.0. De 73 % van SAIL is behaald in een simulatie, en het verschil tussen simulatie en werkelijkheid is nu juist het onderwerp van het eerste experiment van ProjectSim. Bij de mediamodellen steunt Eleven v4 op een externe ranglijst en blinde tests, terwijl Kling 4.0 verschijnt zonder benchmark of prijs, met een deel van de functies pas later beschikbaar.
Bronnen
- Introductie van Claude Sonnet 5.5 (Anthropic)
- Migratiehandleiding voor Claude Sonnet 5.5
- @ClaudeDevs: aanbevelingen voor het inspanningsniveau van Sonnet 5.5
- Claude Sonnet 5.5 in GitHub Copilot
- Modellen en prijzen van GitHub Copilot
- Claude Sonnet 5.5 in Devin
- @cognition: Sonnet 5.5 op FrontierCode 1.1 Main
- @cursor_ai: Sonnet 5.5 in Cursor
- @v0: Sonnet 5.5 in v0
- NVIDIA lanceert Open Agent Safety Platform (persbericht)
- Architectuur van Open Agent Safety Platform (NVIDIA)
- Voeg met NVIDIA OpenShell runtimecontroles toe aan AI-agents
- @NVIDIAAI: Jensen Huang op CNBC
- @togethercompute: lanceringspartner
- @perplexity_ai: samenwerking met NVIDIA
- Introductie van Manus 2.0
- @ManusAI: lancering van Cue
- @ManusAI: telefoonnummers van agents
- Introductie van Eleven v4 (ElevenLabs)
- @ElevenLabs: aankondigingsreeks over Eleven v4
- Releaseopmerkingen voor Kling 4.0
- @Kling_ai: aankondiging van Kling 4.0
- Claude Code v2.1.284
- Codex CLI 0.158.0
- Copilot CLI v1.0.89
- Copilot SDK v1.0.15
- Devin is nu tot 40 % kostenefficiënter
- Releaseopmerkingen van Devin van 25 september
- @cognition: bèta van Devin Mobile
- @zeddotdev: Delta 0.18
- Gemini CLI v0.63.0-nightly.20260928
- Agent API ondersteunt nu herbruikbare agents (Perplexity)
- Changelog van de Perplexity API
- Team Bots (SpaceXAI)
- @bot: aankondiging van Team Bots
- Holo4 op de blog van Hugging Face
- Holo4 (H Company)
- SAIL (Sakana AI)
- Projectpagina van SAIL
- Robotica benchmarken: waar we staan en wat volgt (ProjectSim)
- Hallo, Deutschland! (Mistral AI)
- Hoe NVIDIA DSX MaxLPS de doorvoer en efficiëntie van AI-fabrieken maximaliseert
- DeepSeek Harness 0.2.0-rc.1
- Pixel Canary op Vercel AI Gateway
- Datum voor handhaving van versies van zelf gehoste runners verschoven (GitHub)
- Technisch rapport NexteraBERT
- Realtime pratende personages met een videodiffusiemodel van 22B
- SCRIBE (Adalat AI)
- JEV: 228 geselecteerde projecten (Eric Kang)
- @HeyGen: handleiding voor Jev en HeyGen MCP
- Bekijk wat 4 makers bouwen met Gemini 3.8 Flash (Google)
- 3 manieren waarop deze delicatessenhandelaar met Gemini kookt voor 200 gasten (Google)
- Lenfest AI Collaborative: nieuwe fase (OpenAI)
- Releaseopmerkingen van ChatGPT
- @OpenAIDevs: winnaars van de WebMCP Challenge
- Changelog van ChatGPT en Codex: CVE-2026-100754