ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-6.1-sol.
Spraak wordt een manier om agents aan te sturen: OpenMOSS presenteert MOSS-Live, een systeem dat tegelijk luistert, spreekt en tools start, en Antigravity licht zijn spraakmodus op basis van Gemini Live toe, zowel in de applicatie als in de terminal. NVIDIA versterkt de softwarelaag van zijn GPU’s met CUDA 13.5, de collectieve bewerking Reshard voor bekrachtigingsleren en FLUX 3 Image Klein, versneld op Blackwell. GitHub beschrijft Rubicon, zijn nieuwe Git-opslag die met 5 000 agents op één repository is getest, en maakt van Copilot een teamtool, met code review die via een API kan worden aangestuurd en @GitHub dat algemeen beschikbaar wordt in Slack en Teams.
Spraak stuurt agents aan: MOSS-Live van OpenMOSS en de Gemini Live-spraakmodus van Antigravity
De twee aankondigingen delen dezelfde architectuur: een model voert op de voorgrond een gesprek terwijl een agent op de achtergrond werkt, zoals bij de spraakchat die Cursor op 6 november op basis van Grok Voice beschikbaar stelde.
OpenMOSS presenteert MOSS-Live, een full-duplex spraaksysteem dat ziet, luistert en tools start
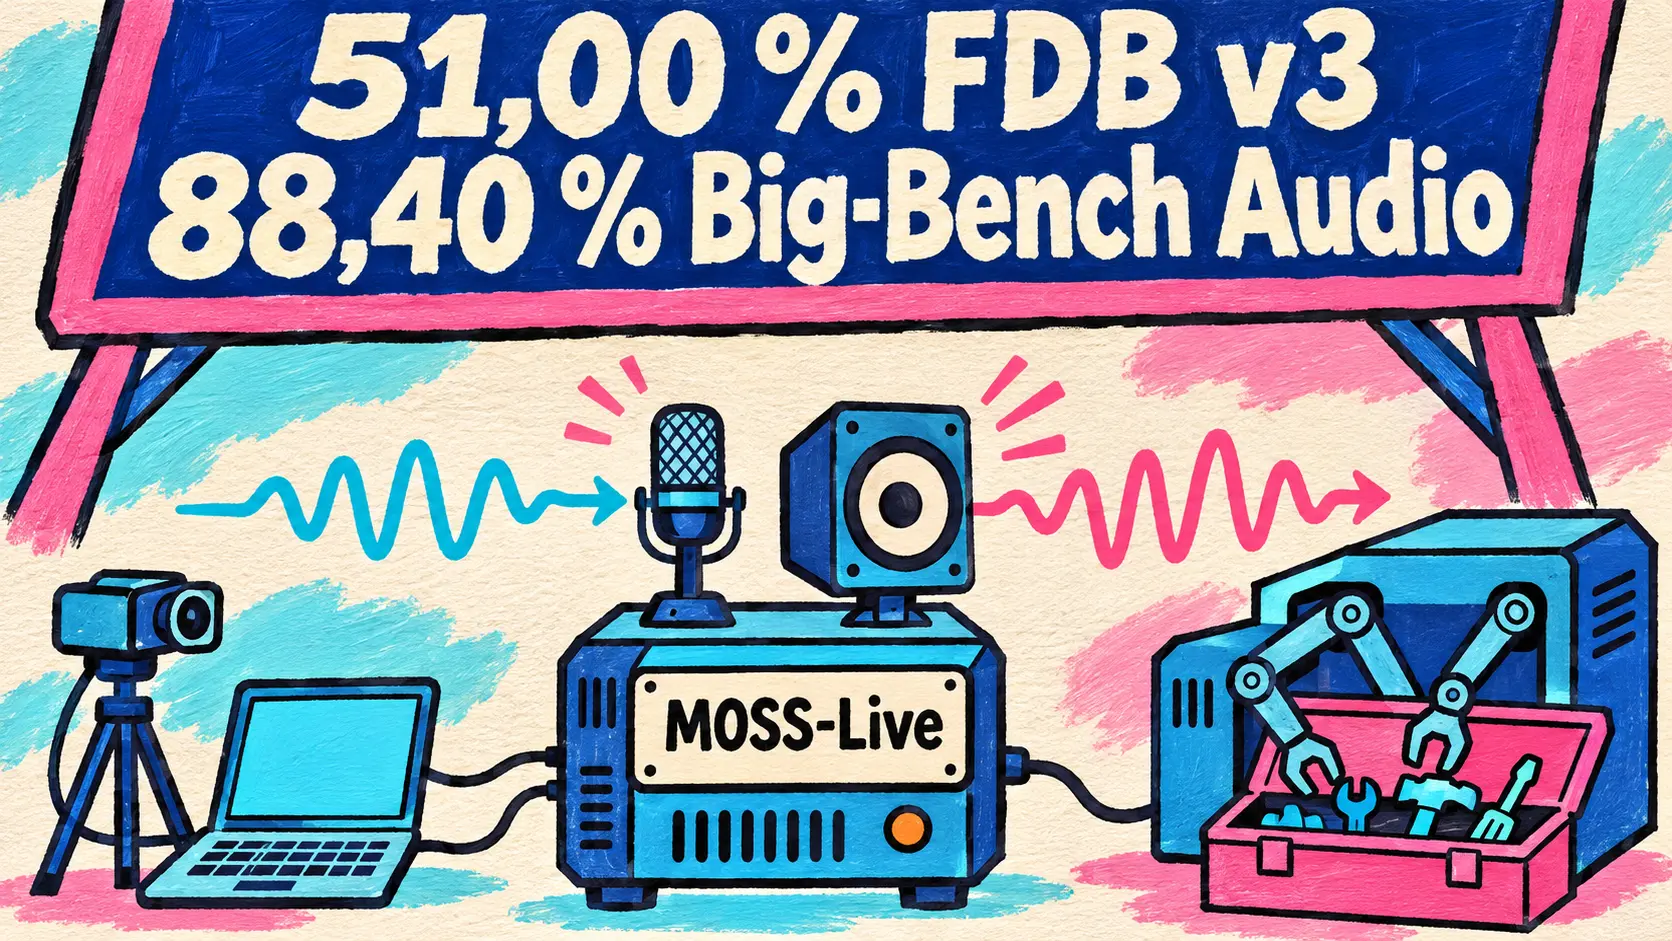
7 november — Het OpenMOSS-team presenteert MOSS-Live, een systeem voor realtimegesprekken dat tegelijk luistert en spreekt (volledig duplex, full-duplex), begrijpt wat de camera of het gedeelde scherm laat zien en zoekopdrachten en langdurige taken aan een tweede model overlaat zonder het gesprek te onderbreken. In het artikel van Chen Yang op de communityblog van Hugging Face beslist een interactiemodel op de voorgrond of het antwoordt, wacht of het woord geeft, redeneert een achtergrondmodel en roept het tools aan, en deelt een coördinatielaag het geheugen en de taakstatus. MOSS-Live moet een bevestigend « mm-hmm » onderscheiden van een echte onderbreking, spraak negeren die niet tot het systeem gericht is en simultaanvertaling verzorgen.
| Benchmark en meetwaarde (volgens OpenMOSS) | Score van MOSS-Live | Beste genoemde concurrent |
|---|---|---|
| FDB v3, geslaagde toolaanroepen | 51,00 % | 51,00 % (Doubao SeedDuplex) |
| τ-Voice, taken met meerdere gespreksbeurten (pass¹) | 57,93 % | 67,68 % (GPT-Live-1) |
| τ-Voice, selectiviteit bij niet-gerichte spraak | 78,90 % | 66,99 % (GPT-Live-1) |
| Big-Bench Audio, nauwkeurigheid | 88,40 % | 90,50 % (Doubao SeedDuplex) |
| FDB v3, latentie bij een toolscenario | 2,36 s | 1,61 s (GPT Realtime 2.1) |
MOSS-Live is geen open model: de GitHub-repository bevat alleen documentatie, zonder licentie of gewichten. Het systeem kan worden uitgeprobeerd in een online testomgeving (playground) en geïntegreerd via een realtime-API op het MOSS-platform.
🔗 MOSS-Live op de Hugging Face-blog · Documentatie van MOSS-Live op het MOSS-platform
Antigravity licht zijn Gemini Live-spraakmodus toe, in de applicatie en in Antigravity CLI 1.5.0
6 november — De blog van Antigravity licht de spraakmodus (voice mode) toe, waarvan de uitrol op 3 november met applicatieversie 2.29.0 was begonnen. Gemini Live hoort de stem rechtstreeks, zonder tussenliggende transcriptie, antwoordt in realtime en laat zich onderbreken: je geeft een taak, stuurt die tijdens de uitvoering bij (« Wat doe je? », « stop ») en beantwoordt toestemmingsverzoeken mondeling. Het artikel voegt iets toe wat niet in de changelog stond: de modus werkt ook in Antigravity CLI, vanaf versie 1.5.0.
Destructive actions, such as deleting files, running commands with elevated privileges, or force-pushing to a Git remote, can’t be approved by voice.
🇳🇱 Destructieve acties, zoals bestanden verwijderen, opdrachten met verhoogde rechten uitvoeren of een push naar een externe Git-repository forceren, kunnen niet met de stem worden goedgekeurd. — Antigravity-blog, Spraakmodus in Antigravity
| Instelling of limiet | Door Antigravity opgegeven waarde |
|---|---|
| Starten in de CLI | /voice live of F6 ; agy mic-serve via SSH |
| Stemmen en spreeksnelheid | 9 stemmen ; van 0,75x tot 2x in de applicatie, van 0,5 tot 3 in de CLI |
| Voortgangsupdate op verzoek | ongeveer elke 30 seconden (« houd me op de hoogte ») |
| Gesprekken in de spraakmodus | één tegelijk, uitsluitend lokaal |
De spraakmodus werkt niet in Remote Control, in gesprekken die in de cloud worden uitgevoerd of in een sessie met een externe agent, en de microfoonaudio wordt naar de servers van Google gestuurd. Er wordt geen abonnement genoemd: de documentatie waarschuwt alleen dat de modus mogelijk nog niet voor alle accounts beschikbaar is.
🔗 Aankondiging van @antigravity op X · Documentatie van de spraakmodus
De software voor NVIDIA-GPU’s: CUDA 13.5, NCCL M2N Reshard en FLUX 3 Image Klein op Blackwell
CUDA 13.5 maakt ondersteuning voor Vera Rubin algemeen beschikbaar
4 november — NVIDIA brengt CUDA 13.5 uit. De belangrijkste vernieuwing: ondersteuning voor de Vera Rubin-architectuur gaat van vroege toegang voor ontwikkelaars naar algemene beschikbaarheid (general availability), volgens NVIDIA klaar voor productiegebruik in bedrijven. Windows on Arm, algemeen beschikbaar sinds CUDA 13.4, wordt uitgebreid naar de DGX Station onder Windows, en op Rubin verdwijnt de TCC-modus ten gunste van WDDM en MCDM. Voor het delen van GPU’s gaat MPS over naar versie 3 (gewogen tijdsloten, het uitlenen en lenen van multiprocessors (SM) tussen partities, routering via cgroup v2); CUDA Tile krijgt communicatie tussen meerdere GPU’s in de kernels.
| Bibliotheek of tool | Door NVIDIA aangekondigde vernieuwing |
|---|---|
| CCCL 3.5 | Top-K in batches, al geïntegreerd in FlashInfer ; reproduceerbare floating-pointscans |
| cuBLAS | snellere NVFP4- en MXFP8-vermenigvuldigingen op Vera Rubin, zonder cijfers |
| cuSPARSE | vermenigvuldigingen van ijle matrices die 1,65 tot 2,27 keer sneller zijn |
| Nsight Perf SDK for AI | publieke preview, doorlopende profilering van langdurige trainingen |
| Compute Sanitizer | skill om codeeragents te helpen geheugenfouten te diagnosticeren |
🔗 NVIDIA CUDA 13.5 brengt GA-ondersteuning voor NVIDIA Vera Rubin
NCCL M2N Reshard versnelt de overdracht van gewichten bij bekrachtigingsleren met een factor 2,7 tot 5,7
6 november — Bij bekrachtigingsleren (reinforcement learning, RL) moeten de inferentie-GPU’s die de trajecten genereren regelmatig de door de trainings-GPU’s bijgewerkte gewichten ontvangen: dit is het bijwerken van de gewichten (refit). De gebruikelijke methode verzamelt elke parameter en verspreidt die vervolgens (gather-and-broadcast), waardoor bij elke stap ongeveer tweemaal de modelomvang wordt overgedragen, bijna 11,2 To voor Kimi K3 volgens NVIDIA. Reshard, een nieuw type collectieve communicatiebewerking, behandelt deze update als het opnieuw verdelen van een gedistribueerde tensor: elke GPU ontvangt alleen zijn eigen deel, per NVLink-domein gaat slechts één kopie over het netwerk, waarna de GPU’s elkaar via NVLink aanvullen.
De referentie-implementatie, NCCL M2N Reshard, is open source en geïntegreerd in NeMo RL, waar ze de gewichten van de feedforwardlagen (feed-forward) overdraagt, ongeveer 95 % van de parameters. Volgens NVIDIA wordt het bijwerken van de gewichten 2,7 tot 5,7 keer sneller:
| Testplatform | Getraind model | Klassieke methode | Met Reshard |
|---|---|---|---|
| DGX H100 | Qwen 3 235B | 6,4 s | 1,9 s |
| DGX H100 | DeepSeek V3 671B | 14,9 s | 2,6 s |
| DGX GB200 | DeepSeek V3 671B | 6,1 s | 2,3 s |
| DGX GB200 | Nemotron Ultra v3 | 8,2 s | 2,3 s |
🔗 Het bijwerken van gewichten bij bekrachtigingsleren versnellen met de collectieve bewerking Reshard · Repository NVIDIA/nccl-extensions
FLUX 3 Image Klein tot 4,45 keer sneller op Blackwell met TensorRT LLM VisualGen
6 november — NVIDIA publiceert een tutorial over FLUX 3 Image Klein, het beeldmodel met open gewichten van Black Forest Labs, in TensorRT LLM VisualGen, de runtime van TensorRT LLM voor visuele generatie. Op één B200-GPU, bij 2048x2048, maakt de combinatie van optimalisaties (compilatie, NVFP4-gewichten, sparse attention met Sol-Attention, Cache-DiT-cache) Klein Base tot 3,46 keer sneller bij tekst naar beeld en 4,45 keer sneller bij beeld naar beeld, vergeleken met ongecompileerde BF16-inferentie.
| Gemeten configuratie (2048x2048) | Ongecompileerde BF16-inferentie | Na optimalisaties | Gemeten winst |
|---|---|---|---|
| Tekst naar beeld, Klein Base, 1 B200 | 22,36 s | 6,46 s | 3,46x |
| Beeld naar beeld, Klein Base, 1 B200 | 54,64 s | 12,28 s | 4,45x |
NVIDIA meet het visuele verschil met de LPIPS-score (hoe lager die is, hoe dichter het beeld bij de referentie blijft): 0,095 bij tekst naar beeld en 0,045 bij beeld naar beeld. Bij de overstap van één naar acht B200’s daalt de mediane latentie van Klein Base bij tekst naar beeld van 14,90 naar 3,00 seconden; op een RTX PRO 6000 Blackwell Server Edition lopen de snelheidswinsten uiteen van 1,73 tot 3,25 keer. De tutorial biedt een TensorRT LLM-container, YAML-configuraties en een OpenAI-compatibel endpoint via trtllm-serve.
🔗 Versnel beeldgeneratie met FLUX 3 Image Klein op NVIDIA Blackwell-GPU’s
GitHub licht Rubicon toe, zijn nieuwe Git-opslagarchitectuur die met 5 000 agents op één repository is getest
5 november — GitHub publiceert het derde artikel in zijn reeks over een Git-infrastructuur die op agents is toegesneden, na de artikelen van 6 en 21 oktober, en deelt het op 6 november op X. Karthik Raman en Brian Celenza beschrijven daarin Rubicon, de nieuwe Git-opslagarchitectuur die op GitHub Universe is aangekondigd. De actiefste repositories ontvangen tegenwoordig hooguit enkele tientallen schrijfbewerkingen per seconde, in pieken; GitHub verwacht binnen een jaar een aanhoudend tempo, en een ander artikel geeft de schaal aan: meer dan 1,2 miljard commits in één week in oktober.
Through internal testing, we’ve demonstrated the ability to support 5,000 concurrent agents working on a repository, sending 7,200 pushes per second to a repo, all while serving read traffic with consistently low latency.
🇳🇱 Bij interne tests hebben we aangetoond dat we 5 000 agents kunnen ondersteunen die tegelijk aan één repository werken en 7 200 verzendingen (push) per seconde naar één repository uitvoeren, terwijl we leesverkeer met een voortdurend lage latentie afhandelen. — @github op X
Spokes blijft verzoeken routeren, maar naar virtuele replica’s die na gebruik worden weggegooid en waarvan de lokale schijf alleen als cache dient. Git-packs staan in Azure Blob Storage, referenties in Ref-CAS (Reference Compare-and-Swap), een gerepliceerd logboek waarin elke update door een quorum wordt gevalideerd: een eerste prototype dat volledig op blobs berustte, bleef steken op enkele honderden schrijfbewerkingen per seconde, terwijl Ref-CAS er tienduizenden verwerkt. Rubicon bevindt zich in een beperkte besloten preview, met een bredere uitrol gepland voor begin volgend jaar.
🔗 Een kijkje in de nieuwe Git-opslagarchitectuur van GitHub
Copilot voor teams: code review wordt via een API aangestuurd, @GitHub wordt algemeen beschikbaar in Slack en Teams
Copilot code review kan via de REST- en GraphQL-API’s worden ingesteld en krijgt een compactere samenvatting
6 november — Nadat reviews in oktober via een API konden worden gestart, maakt GitHub het nu mogelijk om de instellingen van Copilot code review via de REST- en GraphQL-API’s te lezen en te wijzigen, van het ondernemingsbeleid tot aan de repository. De antwoorden geven ook aan wat Copilot heeft geschreven, welk inspanningsniveau is gebruikt en welke skills, MCP-servers en instructies het als bronnen aanhaalt.
| Instellingsniveau | Wat via de API kan worden ingesteld |
|---|---|
| Onderneming | review voor alle organisaties in- of uitschakelen, of hun zelf de keuze laten |
| Organisatie | inschakeling, standaardinspanning, runners, zonder de keuzes van de onderneming te overschrijven |
| Repository | inspanningsniveau, gebruik van aangepaste instructies en MCP-tools |
Beperking: de endpoints op ondernemings- en organisatieniveau accepteren geen GitHub Apps of fijnmazige persoonlijke toegangstokens (fine-grained PAT), die alleen door de endpoints op repositoryniveau worden geaccepteerd. De samenvattende reactie wordt compacter (inspanningsniveau en peilingen in de voettekst, één enkele sectie « Niet beoordeelde bestanden »), reviewsessies tonen de verbruikte AI-credits en bij inspanningsniveau Balanced worden voortaan drie reviewmodellen gebruikt, waarna een ander model hun bevindingen samenvoegt. Een mislukte review wordt één keer opnieuw gestart, waarbij eventueel naar een ander model wordt overgeschakeld. Abonnementen Pro, Pro+, Max, Business en Enterprise.
🔗 Copilot code review: API-beheer en updates van het reviewoverzicht
@GitHub wordt algemeen beschikbaar in Slack en Microsoft Teams, met Canvas in Teams
6 november — Na een publieke preview die op 21 augustus begon, wordt de @GitHub-agent algemeen beschikbaar in Slack en Microsoft Teams. Je vermeldt hem in een gesprek om een bug te onderzoeken, een issue aan te maken, een wijziging te implementeren of een pull request te openen, zonder van tool te wisselen. De enige functionele vernieuwing is Canvas in Teams: implementatieplannen, codewijzigingen en previews verschijnen naast het gesprek, waar het team erop kan reageren en het werk verder kan ontwikkelen.
De rest bestaat uit aanpassingen: de repository wordt uit het bericht afgeleid zonder dat die opnieuw hoeft te worden geselecteerd, het probleem waarbij vervolgberichten onbeantwoord konden blijven is verholpen, en issues en pull requests die vanuit een gesprek worden aangemaakt, dragen de naam van de persoon die erom heeft gevraagd. De pagina vermeldt niet voor welke abonnementen dit geldt en geeft geen gebruikscijfers.
🔗 @GitHub in Slack en Teams is algemeen beschikbaar, en meer
Kort nieuws
Agents en codeertools
- Copilot CLI 1.0.108-0 en 1.0.108-1 — Twee prereleases gepubliceerd op 7 november, een dag na de stabiele versie 1.0.107: /index-commando’s en gedeelde tgrep-indexering standaard ingeschakeld voor repositories die daarvoor in aanmerking komen, een CLI die vragen over zijn eigen werking beantwoordt op basis van zijn documentatie, en 72 bugfixes, waaronder MCP-weigeringsregels die ook met
--allow-all-toolsworden toegepast. 🔗 bron - Qwen Code v0.27.0 — Stabiele versie van 7 november, een dag na v0.26.9, zonder breaking changes: 73 vermeldingen, waaronder FileChanged-meldingen voor hooks van lokale sessies, een filter voor GitHub-repositorygebeurtenissen (toestaan en blokkeren) voor kanalen en gelijktijdige vragen van onderliggende agents van de Managed Agent. 🔗 bron
- Agents op afstand van Antigravity — Eén project combineert een GitHub-repository en een Google Drive-map, met lees- en schrijftoegang; een taak die op het web wordt gestart, kan in de app worden voortgezet en machtigingen kunnen via de telefoon worden verleend. De tweet noemt alle betaalde consumentenabonnementen, de documentatie noemt Google AI Pro en Ultra, met uitsluiting van Google AI Plus en zakelijke accounts. 🔗 bron
- Ondersteuning in de Agent van Replit — Bij een vraag om ondersteuning controleert de Agent eerst lopende incidenten, de documentatie en bekende beperkingen van het platform, zonder het gesprek te verlaten; als het probleem aanhoudt, dient hij binnen het Pro-abonnement zelf het ticket in, met de debuggegevens van de omgeving. 🔗 bron
- Showcase van OpenAI Developers — De OpenAI Developers-plugin krijgt een Showcase-tabblad: starterprojecten voor de API (agents, creatieve tools, datavisualisatie, spraak) die in Codex kunnen worden geopend; de pagina API demos telt er twaalf, waarvan er acht rechtstreeks in Codex kunnen worden geopend of kunnen worden gedownload. 🔗 bron
GitHub Copilot
- Overzicht van de GitHub Copilot-app — Het wekelijkse overzicht van 6 november beschrijft vernieuwingen in de app: Agent Merge wordt vanuit de pull request ingesteld en blijft actief terwijl controles nog in afwachting zijn, gesprekken worden gecomprimeerd zodra de contextlimiet is bereikt, CSV en TSV worden als tabellen geopend, en persoonlijke instructies voor ondersteunde goedkeuring zijn beschikbaar via opt-in. 🔗 bron
- Copilot impact dashboard — Het dashboard volgt negen Copilot-ervaringen in plaats van zeven, met Copilot Chat en het Agents-venster van VS Code; het cohort « Passieve gebruikers » wordt « Gebruikers die met chat beginnen », zonder wijzigingen aan de adoptiefasen of de omvang van de cohorten. 🔗 bron
- 1,2 miljard commits in één week — In een gids over agentische engineering (agentic engineering) zonder productnieuws, geschreven door Nick Liffen en Philip Holleran, meldt GitHub in oktober meer dan 1,2 miljard commits in één week te hebben geregistreerd, ruim 400 % meer dan een jaar eerder. 🔗 bron
Inferentie, ranglijsten en open modellen
- Together Compiler — De op 4 november gepresenteerde agents van Together AI, die de kernels van elke klant continu optimaliseren, komen terug met één nieuw cijfer: een mediane toename van +12 tot +20 % tokens per seconde op serverloze endpoints (serverless) die al handmatig waren geoptimaliseerd, volgens Together AI. 🔗 bron
- MiniMax M3.1 Flash op Fireworks — MiniMax kondigt in een tweet aan dat M3.1 Flash beschikbaar is op Fireworks AI en nodigt uit voor een avond in San Francisco op 10 november; prijs en doorvoer worden niet vermeld. 🔗 bron
- Construction AI Leaderboard — ONESTRUCTION publiceert een ranglijst van modellen voor de bouw, op basis van het gemiddelde van vijf benchmarks (bouwtekeningen, BIM-modellen, kostenraming, IDS-generatie): Claude Opus 5.5 staat bovenaan met 73,7 punten, een tiende vóór Gemini 4 Argon (73,6), gevolgd door Claude Opus 5 (72,7) en GPT-6.1 Sol (70,2). Metingen van de ontwikkelaar. 🔗 bron
- kniv v7.1 — Dragonscale zegt zijn zes extractie-encoders, gepresenteerd op 2 november, zonder enige hertraining te hebben verbeterd: in Claude Code ontdekte Claude Opus 5.5 een limiet van 50 antecedenten bij coreferentie, die in de ONNX-graaf is verhoogd naar 100; de coreferentie verbetert bij alle zes modellen en wordt 7 tot 16 % sneller berekend. 🔗 bron
Open robotica
- Robotica bij Hugging Face — Volgens Clément Delangue telt de Hub bijna 100 000 openbare roboticadatasets (+48 %) en meer dan 30 000 modellen (+41 %), heeft LeRobot meer dan een miljoen downloads en zouden Microduck en Reachy Mini tegen het einde van het jaar waarschijnlijk de grens van 50 000 verkochte en 20 000 geleverde exemplaren overschrijden. 🔗 bron
- HapTile in FiftyOne — Harpreet Sahota (Voxel51) zet de HapTile-dataset om voor FiftyOne: 1 699 episodes en 12,36 uur van een op afstand bediende UR5e-arm, met tactiele gelsensoren, twee RGB-D-camera’s en het niveau van haptische feedback dat de bediener ervaart, onder de CC BY 4.0-licentie. 🔗 bron
Bedrijven en toepassingen
- Harper en Grok Bot — Op 5 november beschrijft verzekeringsmakelaar Harper de ambient agents, gebouwd op Grok Bot, die zijn backoffice draaiende houden en door een e-mail of een deadline worden geactiveerd. Volgens Harper heeft een van deze agents sinds september geholpen om meer dan 200 kleine bedrijven weer aan hun verplichtingen tegenover hun financieringsinstantie te laten voldoen, zonder enige opzegging. 🔗 bron
- Replit en Plaid — In een tweet met een video belicht Replit zijn Plaid-connector, die financiële rekeningen koppelt om de Agent zonder code tools voor persoonlijke geldzaken te laten bouwen; Plaid wijdt hieraan een gesprek met Michele Catasta, president van Replit. Volgens de documentatie van Replit is de connector voorbehouden aan betaalde abonnementen met een teamruimte, waar een beheerder eenmalig de Plaid-inloggegevens instelt, en biedt hij toegang tot saldi, transacties en beleggingen. 🔗 bron · 🔗 documentatie
- Gids van Perplexity over toegankelijkheid — Perplexity publiceert een gids over IA voor mensen met een beperking en over de toegankelijkheid van IA-tools zelf, zonder een product of eigen cijfers te presenteren; de gids verwijst naar een test van Microsoft waarin 12 % van de zonder instructie gegenereerde pagina’s de geautomatiseerde controles doorstaat, tegenover 86 % wanneer de modellen hun code testen en corrigeren. 🔗 bron
Wat dit betekent
Spraak wordt een interface voor agents, met een architectuur die telkens terugkeert: een model voert op de voorgrond een gesprek, terwijl een agent op de achtergrond handelt. MOSS-Live maakt dit tot de kern van zijn systeem met een coördinatielaag tussen de twee modellen, Antigravity past dit toe in zowel de app als de terminal, op dezelfde dag waarop Cursor zijn spraakchat openstelde. De beperkingen blijven duidelijk: Antigravity beperkt de spraakmodus tot één lokaal gesprek tegelijk en behoudt de klik voor destructieve acties; MOSS-Live publiceert geen gewichten of licentie en scoort volgens zijn eigen cijfers lager dan GPT-Live-1 op de multiturn-taken van τ-Voice.
De infrastructuur wordt opnieuw afgestemd op de belasting door agents. GitHub dimensioneert Rubicon voor schrijfpieken die naar verwachting een continu ritme zullen worden, test 5 000 agents op één repository en telde in oktober meer dan 1,2 miljard commits in één week. Dezelfde beweging raakt de organisatie van het werk: de code review van Copilot kan via API worden ingesteld, van bedrijfsniveau tot repositoryniveau, zoals elk ander infrastructuurbeleid, en @GitHub krijgt een plek in Slack en Teams, waar teams al bespreken wat er moet worden opgelost.
De winst komt ook uit de software. CUDA 13.5 maakt ondersteuning voor Vera Rubin algemeen beschikbaar en versnelt bibliotheken zoals cuSPARSE, Reshard maakt de overdracht van gewichten bij reinforcement learning 2,7 tot 5,7 keer sneller, en het combineren van optimalisaties maakt FLUX 3 Image Klein tot 4,45 keer sneller op één B200. Together AI claimt op zijn beurt een 12 tot 20 % hogere mediane doorvoer met agents die de kernels continu optimaliseren. Al deze cijfers zijn afkomstig van de aanbieders en gemeten op hun eigen configuraties.
Bronnen
- MOSS-Live (Hugging Face-blog, OpenMOSS)
- Documentatie van MOSS-Live (MOSS-platform)
- Spraakmodus in Antigravity (Antigravity-blog)
- Aankondiging van de spraakmodus door @antigravity
- Documentatie van de spraakmodus van Antigravity
- NVIDIA CUDA 13.5 biedt GA-ondersteuning voor NVIDIA Vera Rubin (NVIDIA)
- Weight Refit bij reinforcement learning versnellen met de Reshard Collective (NVIDIA)
- Repository NVIDIA/nccl-extensions
- Beeldgeneratie versnellen met FLUX 3 Image Klein op NVIDIA Blackwell-GPU’s (NVIDIA)
- Een kijkje in de nieuwe Git-opslagarchitectuur van GitHub (GitHub Blog)
- @github: Rubicon in een X Article
- Copilot code review: API-beheer en updates van het reviewoverzicht (GitHub Changelog)
- @GitHub in Slack en Teams is algemeen beschikbaar en meer (GitHub Changelog)
- Copilot CLI 1.0.108-0
- Qwen Code v0.27.0
- Thread van @antigravity over agents op afstand
- Changelog van Replit van 6 november
- Showcase van de OpenAI Developers-plugin (@OpenAIDevs)
- Wekelijkse releases van GitHub Copilot, 2 november (GitHub Changelog)
- Copilot impact dashboard voegt gebruik van chat en VS Code-agents toe (GitHub Changelog)
- Voorbij codegeneratie: een ontwikkelaarsgids voor agentic engineering (GitHub Blog)
- Together Compiler (@togethercompute)
- M3.1 Flash op Fireworks AI (@MiniMax_AI)
- Construction AI Leaderboard (Hugging Face-blog, ONESTRUCTION)
- kniv v7.1 (Hugging Face-blog, Dragonscale)
- Open robotica bij Hugging Face (@ClementDelangue)
- HapTile in FiftyOne (Hugging Face-blog)
- Ambient agents (Harper Engineering)
- Replit en Plaid (@Replit)
- Plaid-connector (Replit-documentatie)
- Toegankelijkheid van AI (Perplexity)