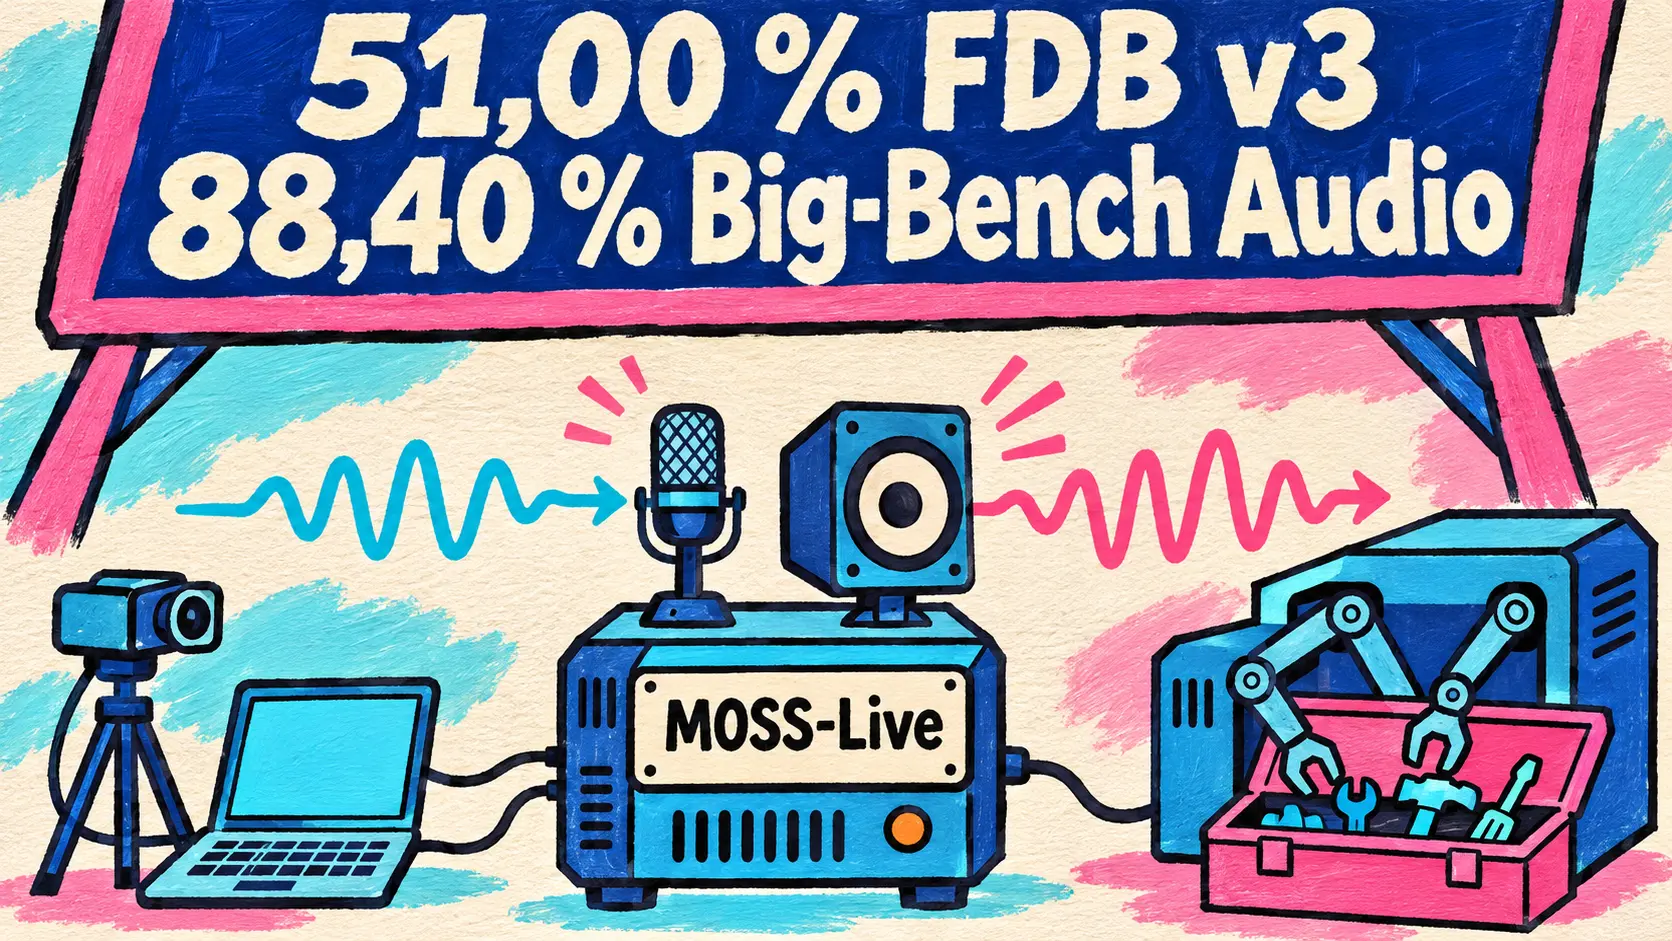
La voix devient une façon de piloter les agents : OpenMOSS présente MOSS-Live, un système qui écoute, parle et lance des outils en même temps, et Antigravity détaille son mode vocal sur Gemini Live, dans l’application comme dans le terminal. NVIDIA consolide la couche logicielle de ses GPU avec CUDA 13.5, la collective Reshard pour l’apprentissage par renforcement et FLUX 3 Image Klein accéléré sur Blackwell. GitHub décrit Rubicon, son nouveau stockage Git testé avec 5 000 agents sur un dépôt, et fait de Copilot un outil d’équipe, avec une code review pilotable par API et @GitHub en disponibilité générale dans Slack et Teams.
La voix pilote les agents : MOSS-Live d’OpenMOSS et le mode vocal Gemini Live d’Antigravity
Les deux annonces partagent la même architecture : un modèle converse au premier plan pendant qu’un agent travaille derrière, comme dans le chat vocal que Cursor a ouvert le 6 novembre sur Grok Voice.
OpenMOSS présente MOSS-Live, un système vocal en duplex intégral qui voit, écoute et lance des outils
7 novembre — L’équipe OpenMOSS présente MOSS-Live, un système de conversation en temps réel qui écoute et parle en même temps (duplex intégral, full-duplex), comprend ce que montrent la caméra ou le partage d’écran et confie recherches et tâches longues à un second modèle sans couper l’échange. Dans le billet signé Chen Yang sur le blog communautaire de Hugging Face, un modèle d’interaction au premier plan décide de répondre, d’attendre ou de céder la parole, un modèle d’arrière-plan raisonne et appelle les outils, et une couche de coordination partage la mémoire et l’état des tâches. MOSS-Live doit distinguer un « mm-hmm » d’une vraie interruption, ignorer la parole qui ne lui est pas adressée et assurer l’interprétation simultanée.
| Banc et métrique (selon OpenMOSS) | Score de MOSS-Live | Meilleur concurrent cité |
|---|---|---|
| FDB v3, réussite des appels d’outils | 51,00 % | 51,00 % (Doubao SeedDuplex) |
| τ-Voice, tâches multitours (pass¹) | 57,93 % | 67,68 % (GPT-Live-1) |
| τ-Voice, sélectivité face à la parole non adressée | 78,90 % | 66,99 % (GPT-Live-1) |
| Big-Bench Audio, exactitude | 88,40 % | 90,50 % (Doubao SeedDuplex) |
| FDB v3, latence en scénario d’outil | 2,36 s | 1,61 s (GPT Realtime 2.1) |
MOSS-Live n’est pas un modèle ouvert : le dépôt GitHub ne contient que la documentation, sans licence ni poids. Le système s’essaie dans un espace de test en ligne (playground) et s’intègre par une API temps réel sur la plateforme MOSS.
🔗 MOSS-Live sur le blog Hugging Face · Documentation de MOSS-Live sur la plateforme MOSS
Antigravity détaille son mode vocal Gemini Live, dans l’application et dans Antigravity CLI 1.5.0
6 novembre — Le blog d’Antigravity détaille le mode vocal (voice mode) dont l’application 2.29.0 avait amorcé le déploiement le 3 novembre. Gemini Live entend directement la voix, sans passer par une transcription, répond en temps réel et se laisse interrompre : on confie une tâche, on la réoriente pendant qu’elle tourne (« What are you doing? », « stop ») et on répond aux demandes d’autorisation à l’oral. Le billet ajoute ce que le changelog ne disait pas : le mode fonctionne aussi dans Antigravity CLI, à partir de la version 1.5.0.
Destructive actions, such as deleting files, running commands with elevated privileges, or force-pushing to a Git remote, can’t be approved by voice.
🇫🇷 Les actions destructrices, comme supprimer des fichiers, exécuter des commandes avec des privilèges élevés ou forcer un envoi vers un dépôt Git distant, ne peuvent pas être approuvées à la voix. — Blog Antigravity, Voice mode in Antigravity
| Réglage ou limite | Valeur indiquée par Antigravity |
|---|---|
| Démarrage dans la CLI | /voice live ou F6 ; agy mic-serve en SSH |
| Voix et débit de parole | 9 voix ; de 0,75x à 2x dans l’application, de 0,5 à 3 dans la CLI |
| Point d’avancement sur demande | environ toutes les 30 secondes (« keep me posted ») |
| Conversations en mode vocal | une seule à la fois, locales uniquement |
Le mode vocal ne fonctionne ni en Remote Control, ni dans les conversations exécutées dans le cloud, ni dans une session avec un agent distant, et l’audio du micro part vers les serveurs de Google. Aucun forfait n’est cité : la documentation prévient seulement que le mode peut ne pas être encore disponible pour tous les comptes.
🔗 Annonce de @antigravity sur X · Documentation du mode vocal
Le logiciel des GPU NVIDIA : CUDA 13.5, NCCL M2N Reshard et FLUX 3 Image Klein sur Blackwell
CUDA 13.5 fait passer la prise en charge de Vera Rubin en disponibilité générale
4 novembre — NVIDIA publie CUDA 13.5. Principale nouveauté : la prise en charge de l’architecture Vera Rubin quitte l’accès anticipé réservé aux développeurs pour passer en disponibilité générale (general availability), prête pour la production en entreprise selon NVIDIA. Windows on Arm, en disponibilité générale depuis CUDA 13.4, s’étend à la DGX Station sous Windows, et sur Rubin le mode TCC est abandonné au profit de WDDM et MCDM. Pour le partage des GPU, MPS passe en version 3 (tranches de temps pondérées, prêt et emprunt de multiprocesseurs (SM) entre partitions, routage par cgroup v2) ; CUDA Tile gagne la communication multi-GPU dans les noyaux.
| Bibliothèque ou outil | Nouveauté annoncée par NVIDIA |
|---|---|
| CCCL 3.5 | Top-K par lots, déjà intégré à FlashInfer ; scans flottants reproductibles |
| cuBLAS | multiplications NVFP4 et MXFP8 plus rapides sur Vera Rubin, sans chiffre |
| cuSPARSE | produits de matrices creuses de 1,65 à 2,27 fois plus rapides |
| Nsight Perf SDK for AI | préversion publique, profilage continu des longs entraînements |
| Compute Sanitizer | skill pour aider les agents de codage à diagnostiquer les erreurs mémoire |
🔗 NVIDIA CUDA 13.5 Brings NVIDIA Vera Rubin GA Support
NCCL M2N Reshard accélère de 2,7 à 5,7 fois le transfert des poids en apprentissage par renforcement
6 novembre — En apprentissage par renforcement (reinforcement learning, RL), les GPU d’inférence qui génèrent les trajectoires doivent régulièrement recevoir les poids mis à jour par les GPU d’entraînement : c’est la remise à jour des poids (refit). La méthode habituelle rassemble chaque paramètre puis le diffuse (gather-and-broadcast), ce qui fait circuler environ deux fois la taille du modèle à chaque étape, près de 11,2 To pour Kimi K3 selon NVIDIA. Reshard, nouveau type de communication collective, traite cette remise à jour comme le redécoupage d’un tenseur distribué : chaque GPU ne reçoit que sa portion, une seule copie traverse le réseau par domaine NVLink, puis les GPU se complètent par NVLink.
L’implémentation de référence, NCCL M2N Reshard, est open source et intégrée à NeMo RL, où elle transporte les poids des couches à propagation avant (feed-forward), environ 95 % des paramètres. Selon NVIDIA, la remise à jour des poids devient de 2,7 à 5,7 fois plus rapide :
| Plateforme de test | Modèle entraîné | Méthode classique | Avec Reshard |
|---|---|---|---|
| DGX H100 | Qwen 3 235B | 6,4 s | 1,9 s |
| DGX H100 | DeepSeek V3 671B | 14,9 s | 2,6 s |
| DGX GB200 | DeepSeek V3 671B | 6,1 s | 2,3 s |
| DGX GB200 | Nemotron Ultra v3 | 8,2 s | 2,3 s |
🔗 Accelerating Reinforcement Learning Weight Refit with the Reshard Collective · Dépôt NVIDIA/nccl-extensions
FLUX 3 Image Klein jusqu’à 4,45 fois plus rapide sur Blackwell avec TensorRT LLM VisualGen
6 novembre — NVIDIA publie un tutoriel consacré à FLUX 3 Image Klein, le modèle d’image à poids ouverts de Black Forest Labs, dans TensorRT LLM VisualGen, le runtime de TensorRT LLM dédié à la génération visuelle. Sur un seul GPU B200, en 2048x2048, l’empilement des optimisations (compilation, poids NVFP4, attention clairsemée Sol-Attention, cache Cache-DiT) rend Klein Base jusqu’à 3,46 fois plus rapide en texte vers image et 4,45 fois plus rapide en image vers image, par rapport à une inférence BF16 non compilée.
| Configuration mesurée (2048x2048) | Inférence BF16 non compilée | Après optimisations | Gain mesuré |
|---|---|---|---|
| Texte vers image, Klein Base, 1 B200 | 22,36 s | 6,46 s | 3,46x |
| Image vers image, Klein Base, 1 B200 | 54,64 s | 12,28 s | 4,45x |
NVIDIA mesure l’écart visuel avec le score LPIPS (plus il est bas, plus l’image reste proche de la référence) : 0,095 en texte vers image et 0,045 en image vers image. En passant d’un à huit B200, la latence médiane de Klein Base en texte vers image descend de 14,90 à 3,00 secondes ; sur une RTX PRO 6000 Blackwell Server Edition, les gains vont de 1,73 à 3,25 fois. Le tutoriel fournit un conteneur TensorRT LLM, des configurations YAML et un point d’accès compatible OpenAI via trtllm-serve.
🔗 Speed Up Image Generation with FLUX 3 Image Klein on NVIDIA Blackwell GPUs
GitHub détaille Rubicon, sa nouvelle architecture de stockage Git testée avec 5 000 agents sur un dépôt
5 novembre — GitHub publie le troisième billet de sa série sur une infrastructure Git taillée pour les agents, après ceux du 6 et du 21 octobre, et le relaie le 6 novembre sur X. Karthik Raman et Brian Celenza y décrivent Rubicon, la nouvelle architecture de stockage Git annoncée à GitHub Universe. Les dépôts les plus actifs reçoivent aujourd’hui au plus quelques dizaines d’écritures par seconde, par rafales ; GitHub s’attend à un rythme continu d’ici un an, et un autre de ses billets donne l’échelle : plus de 1,2 milliard de commits en une semaine en octobre.
Through internal testing, we’ve demonstrated the ability to support 5,000 concurrent agents working on a repository, sending 7,200 pushes per second to a repo, all while serving read traffic with consistently low latency.
🇫🇷 Lors de tests internes, nous avons démontré la capacité de prendre en charge 5 000 agents travaillant en même temps sur un dépôt, effectuant 7 200 envois (push) par seconde vers un dépôt, tout en servant le trafic de lecture avec une latence constamment basse. — @github sur X
Spokes continue de router les requêtes, mais vers des répliques virtuelles jetables dont le disque local n’est qu’un cache. Les packs Git vivent dans Azure Blob Storage, les références dans Ref-CAS (Reference Compare-and-Swap), un journal répliqué où chaque mise à jour est validée par un quorum : un premier prototype tout-blob plafonnait à quelques centaines d’écritures par seconde, Ref-CAS en traite des dizaines de milliers. Rubicon est en préversion privée limitée, avec un déploiement plus large prévu au début de l’année prochaine.
🔗 Inside GitHub’s new Git storage architecture
Copilot en équipe : la code review se pilote par API, @GitHub passe en disponibilité générale dans Slack et Teams
La code review de Copilot se configure par les API REST et GraphQL et compacte sa synthèse
6 novembre — Après le déclenchement des revues par API en octobre, GitHub ouvre la lecture et la modification des réglages de Copilot code review par les API REST et GraphQL, de la politique d’entreprise jusqu’au dépôt. Les réponses identifient aussi ce qu’a écrit Copilot, l’effort utilisé et les skills, serveurs MCP et instructions qu’il cite comme sources.
| Niveau de réglage | Ce que l’API permet de régler |
|---|---|
| Entreprise | activer ou couper la revue pour toutes les organisations, ou leur laisser le choix |
| Organisation | activation, effort par défaut, runners, sans surcharger les choix de l’entreprise |
| Dépôt | effort, usage des instructions personnalisées et des outils MCP |
Limite : les points d’accès d’entreprise et d’organisation refusent les GitHub Apps et les jetons d’accès personnels à granularité fine (fine-grained PAT), que seuls ceux de dépôt acceptent. Le commentaire de synthèse devient plus compact (effort et sondages en pied de page, une seule section « Files not reviewed »), les sessions de revue affichent les crédits IA consommés et l’effort Balanced passe à trois modèles de revue, et un autre modèle combine leurs constats. Une revue en échec est relancée une fois, avec bascule possible vers un autre modèle. Forfaits Pro, Pro+, Max, Business et Enterprise.
🔗 Copilot code review: API management and review overview updates
@GitHub passe en disponibilité générale dans Slack et Microsoft Teams, avec Canvas dans Teams
6 novembre — Après une préversion publique ouverte le 21 août, l’agent @GitHub passe en disponibilité générale dans Slack et Microsoft Teams. On le mentionne dans une conversation pour enquêter sur un bogue, créer une issue, implémenter un changement ou ouvrir une pull request, sans changer d’outil. La seule nouveauté fonctionnelle est Canvas dans Teams : plans d’implémentation, modifications de code et aperçus s’affichent à côté de la discussion, où l’équipe peut les commenter et faire évoluer le travail.
Le reste tient en ajustements : le dépôt est déduit du message sans nouvelle sélection, les messages de suivi qui pouvaient rester sans réponse sont corrigés, et les issues et pull requests créées depuis une conversation portent le nom de la personne qui les a demandées. La page ne précise ni les forfaits concernés ni de chiffres d’usage.
🔗 @GitHub in Slack and Teams is generally available and more
Brèves
Agents et outils de code
- Copilot CLI 1.0.108-0 et 1.0.108-1 — Deux préversions publiées le 7 novembre, au lendemain de la stable 1.0.107 : commandes /index et indexation tgrep partagée activée par défaut sur les dépôts éligibles, CLI qui répond aux questions sur son propre fonctionnement à partir de sa documentation, et 72 correctifs, dont des règles de refus MCP appliquées même avec
--allow-all-tools. 🔗 source - Qwen Code v0.27.0 — Version stable du 7 novembre, au lendemain de la v0.26.9, sans changement cassant : 73 entrées, dont des notifications FileChanged pour les hooks des sessions locales, un filtre d’événements de dépôt GitHub (autorisation et blocage) pour les canaux et des questions concurrentes des agents enfants du Managed Agent. 🔗 source
- Agents distants d’Antigravity — Un même projet réunit un dépôt GitHub et un dossier Google Drive, en lecture et en écriture ; une tâche lancée sur le web se reprend dans l’application, et les autorisations se débloquent depuis le téléphone. Le tweet cite tous les forfaits grand public payants, la documentation Google AI Pro et Ultra, hors Google AI Plus et comptes professionnels. 🔗 source
- Support dans l’Agent de Replit — Interrogé sur le support, l’Agent vérifie d’abord les incidents en cours, la documentation et les limites connues de la plateforme, sans quitter la conversation ; si le problème persiste, il soumet lui-même le ticket avec les détails de débogage de l’environnement, sur l’offre Pro. 🔗 source
- Showcase d’OpenAI Developers — Le plugin OpenAI Developers gagne un onglet Showcase : des projets de démarrage pour l’API (agents, outils créatifs, visualisation de données, voix) à ouvrir dans Codex ; la page API demos en recense douze, dont huit à ouvrir directement dans Codex ou à télécharger. 🔗 source
GitHub Copilot
- Récapitulatif de l’app GitHub Copilot — Le récapitulatif hebdomadaire du 6 novembre détaille des nouveautés de l’app : Agent Merge configuré depuis la pull request et maintenu pendant les vérifications en attente, compactage de la conversation au plafond de contexte, CSV et TSV ouverts en tableaux, et instructions personnelles d’approbation assistée, sur adhésion. 🔗 source
- Copilot impact dashboard — Le tableau de bord suit neuf expériences Copilot au lieu de sept, avec Copilot Chat et la fenêtre Agents de VS Code ; la cohorte « Passive users » devient « Chat-first users », sans changer les phases d’adoption ni la taille des cohortes. 🔗 source
- 1,2 milliard de commits en une semaine — Dans un guide de l’ingénierie agentique (agentic engineering) sans nouveauté produit, signé Nick Liffen et Philip Holleran, GitHub indique avoir enregistré en octobre plus de 1,2 milliard de commits en une semaine, plus de 400 % de plus qu’un an plus tôt. 🔗 source
Inférence, classements et modèles ouverts
- Together Compiler — Présentés le 4 novembre, les agents de Together AI qui optimisent en continu les kernels de chaque client reviennent avec un seul chiffre nouveau : +12 à +20 % de tokens par seconde en médiane sur des points d’accès sans serveur (serverless) déjà optimisés à la main, selon Together AI. 🔗 source
- MiniMax M3.1 Flash sur Fireworks — MiniMax annonce dans un tweet que M3.1 Flash est disponible sur Fireworks AI, en invitant à une soirée à San Francisco le 10 novembre ; ni tarif ni débit ne sont précisés. 🔗 source
- Construction AI Leaderboard — ONESTRUCTION publie un classement des modèles pour le bâtiment, moyenne de cinq bancs (plans, maquettes BIM, estimation des coûts, génération IDS) : Claude Opus 5.5 mène avec 73,7 points, un dixième devant Gemini 4 Argon (73,6), puis viennent Claude Opus 5 (72,7) et GPT-6.1 Sol (70,2). Mesures de l’éditeur. 🔗 source
- kniv v7.1 — Dragonscale dit avoir amélioré sans aucun réentraînement ses six encodeurs d’extraction, présentés le 2 novembre : dans Claude Code, Claude Opus 5.5 a repéré une limite de 50 antécédents en coréférence, portée à 100 dans le graphe ONNX ; la coréférence progresse sur les six modèles et se calcule de 7 à 16 % plus vite. 🔗 source
Robotique ouverte
- Robotique chez Hugging Face — Selon Clément Delangue, le Hub compte près de 100 000 jeux de données robotiques publics (+48 %) et plus de 30 000 modèles (+41 %), LeRobot dépasse le million de téléchargements, et Microduck et Reachy Mini dépasseraient probablement 50 000 unités vendues et 20 000 livrées d’ici la fin de l’année. 🔗 source
- HapTile dans FiftyOne — Harpreet Sahota (Voxel51) convertit pour FiftyOne le jeu HapTile : 1 699 épisodes et 12,36 heures d’un bras UR5e téléopéré, avec capteurs tactiles à gel, deux caméras RGB-D et le niveau de retour haptique ressenti par l’opérateur, sous licence CC BY 4.0. 🔗 source
Entreprises et usages
- Harper et Grok Bot — Le 5 novembre, le courtier en assurance Harper décrit les agents ambiants, bâtis sur Grok Bot, qui font tourner son back-office, réveillés par un e-mail ou une échéance. Selon Harper, l’un d’eux a aidé depuis septembre à remettre à jour plus de 200 petites entreprises auprès de leur organisme de financement, sans aucune annulation. 🔗 source
- Replit et Plaid — Dans un tweet accompagné d’une vidéo, Replit met en avant son connecteur Plaid, qui relie des comptes financiers pour faire bâtir par l’Agent, sans code, des outils autour de son argent ; Plaid y consacre un entretien avec Michele Catasta, président de Replit. Selon la documentation de Replit, le connecteur est réservé aux forfaits payants avec un espace d’équipe, où un administrateur configure une fois les identifiants Plaid, et donne accès aux soldes, aux transactions et aux placements. 🔗 source · 🔗 documentation
- Guide de Perplexity sur l’accessibilité — Perplexity publie un guide sur l’IA au service des personnes handicapées et sur l’accessibilité des outils d’IA eux-mêmes, sans produit ni chiffre propre ; il cite un test de Microsoft où 12 % des pages générées sans consigne passent les contrôles automatisés, contre 86 % quand les modèles testent et corrigent leur code. 🔗 source
Ce que ça signifie
La voix devient une interface d’agent, avec une architecture qui se répète : un modèle converse au premier plan, un agent agit en arrière-plan. MOSS-Live en fait le cœur de son système avec une couche de coordination entre les deux modèles, Antigravity la place dans l’application comme dans le terminal, le jour même où Cursor ouvrait son chat vocal. Les limites restent nettes : Antigravity réserve le mode vocal à une conversation locale à la fois et garde le clic pour les actions destructrices ; MOSS-Live ne publie ni poids ni licence, et ses propres scores le placent derrière GPT-Live-1 sur les tâches multitours de τ-Voice.
L’infrastructure se recalibre pour la charge des agents. GitHub dimensionne Rubicon pour des rafales d’écritures appelées à devenir un rythme continu, teste 5 000 agents sur un seul dépôt et a compté en octobre plus de 1,2 milliard de commits en une semaine. Le même mouvement touche l’organisation du travail : la code review de Copilot se règle par API de l’entreprise jusqu’au dépôt, comme n’importe quelle politique d’infrastructure, et @GitHub s’installe dans Slack et Teams, là où les équipes discutent déjà de ce qu’il faut corriger.
Le gain vient aussi du logiciel. CUDA 13.5 fait passer la prise en charge de Vera Rubin en disponibilité générale et accélère des bibliothèques comme cuSPARSE, Reshard rend le transfert des poids de 2,7 à 5,7 fois plus rapide en apprentissage par renforcement, et l’empilement des optimisations rend FLUX 3 Image Klein jusqu’à 4,45 fois plus rapide sur un seul B200. Together AI revendique de son côté 12 à 20 % de débit médian en plus avec des agents qui optimisent les kernels en continu. Tous ces chiffres sont ceux des éditeurs, mesurés sur leurs propres configurations.
Sources
- MOSS-Live (blog Hugging Face, OpenMOSS)
- Documentation de MOSS-Live (plateforme MOSS)
- Voice mode in Antigravity (blog Antigravity)
- Annonce du mode vocal par @antigravity
- Documentation du mode vocal d’Antigravity
- NVIDIA CUDA 13.5 Brings NVIDIA Vera Rubin GA Support (NVIDIA)
- Accelerating Reinforcement Learning Weight Refit with the Reshard Collective (NVIDIA)
- Dépôt NVIDIA/nccl-extensions
- Speed Up Image Generation with FLUX 3 Image Klein on NVIDIA Blackwell GPUs (NVIDIA)
- Inside GitHub’s new Git storage architecture (GitHub Blog)
- @github : Rubicon en X Article
- Copilot code review: API management and review overview updates (GitHub Changelog)
- @GitHub in Slack and Teams is generally available and more (GitHub Changelog)
- Copilot CLI 1.0.108-0
- Qwen Code v0.27.0
- Fil de @antigravity sur les agents distants
- Changelog Replit du 6 novembre
- Showcase du plugin OpenAI Developers (@OpenAIDevs)
- GitHub Copilot weekly releases, November 2 (GitHub Changelog)
- Copilot impact dashboard adds chat and VS Code agent usage (GitHub Changelog)
- Beyond code generation: A developer’s guide to agentic engineering (GitHub Blog)
- Together Compiler (@togethercompute)
- M3.1 Flash sur Fireworks AI (@MiniMax_AI)
- Construction AI Leaderboard (blog Hugging Face, ONESTRUCTION)
- kniv v7.1 (blog Hugging Face, Dragonscale)
- Robotique ouverte chez Hugging Face (@ClementDelangue)
- HapTile dans FiftyOne (blog Hugging Face)
- Ambient agents (Harper Engineering)
- Replit et Plaid (@Replit)
- Connecteur Plaid (documentation Replit)
- AI accessibility (Perplexity)