ai-powered-markdown-translatorArticolo tradotto dal fr all’it con gpt-6.1-sol.
La voce diventa un modo per guidare gli agenti: OpenMOSS presenta MOSS-Live, un sistema che ascolta, parla e avvia strumenti contemporaneamente, e Antigravity illustra la sua modalità vocale basata su Gemini Live, sia nell’applicazione sia nel terminale. NVIDIA consolida il livello software delle sue GPU con CUDA 13.5, l’operazione collettiva Reshard per l’apprendimento per rinforzo e FLUX 3 Image Klein accelerato su Blackwell. GitHub descrive Rubicon, il suo nuovo sistema di archiviazione Git testato con 5 000 agenti su un repository, e fa di Copilot uno strumento per il team, con una code review gestibile tramite API e @GitHub in disponibilità generale su Slack e Teams.
La voce guida gli agenti: MOSS-Live di OpenMOSS e la modalità vocale Gemini Live di Antigravity
I due annunci condividono la stessa architettura: un modello conversa in primo piano mentre un agente lavora in background, come nella chat vocale che Cursor ha reso disponibile il 6 novembre su Grok Voice.
OpenMOSS presenta MOSS-Live, un sistema vocale full-duplex che vede, ascolta e avvia strumenti
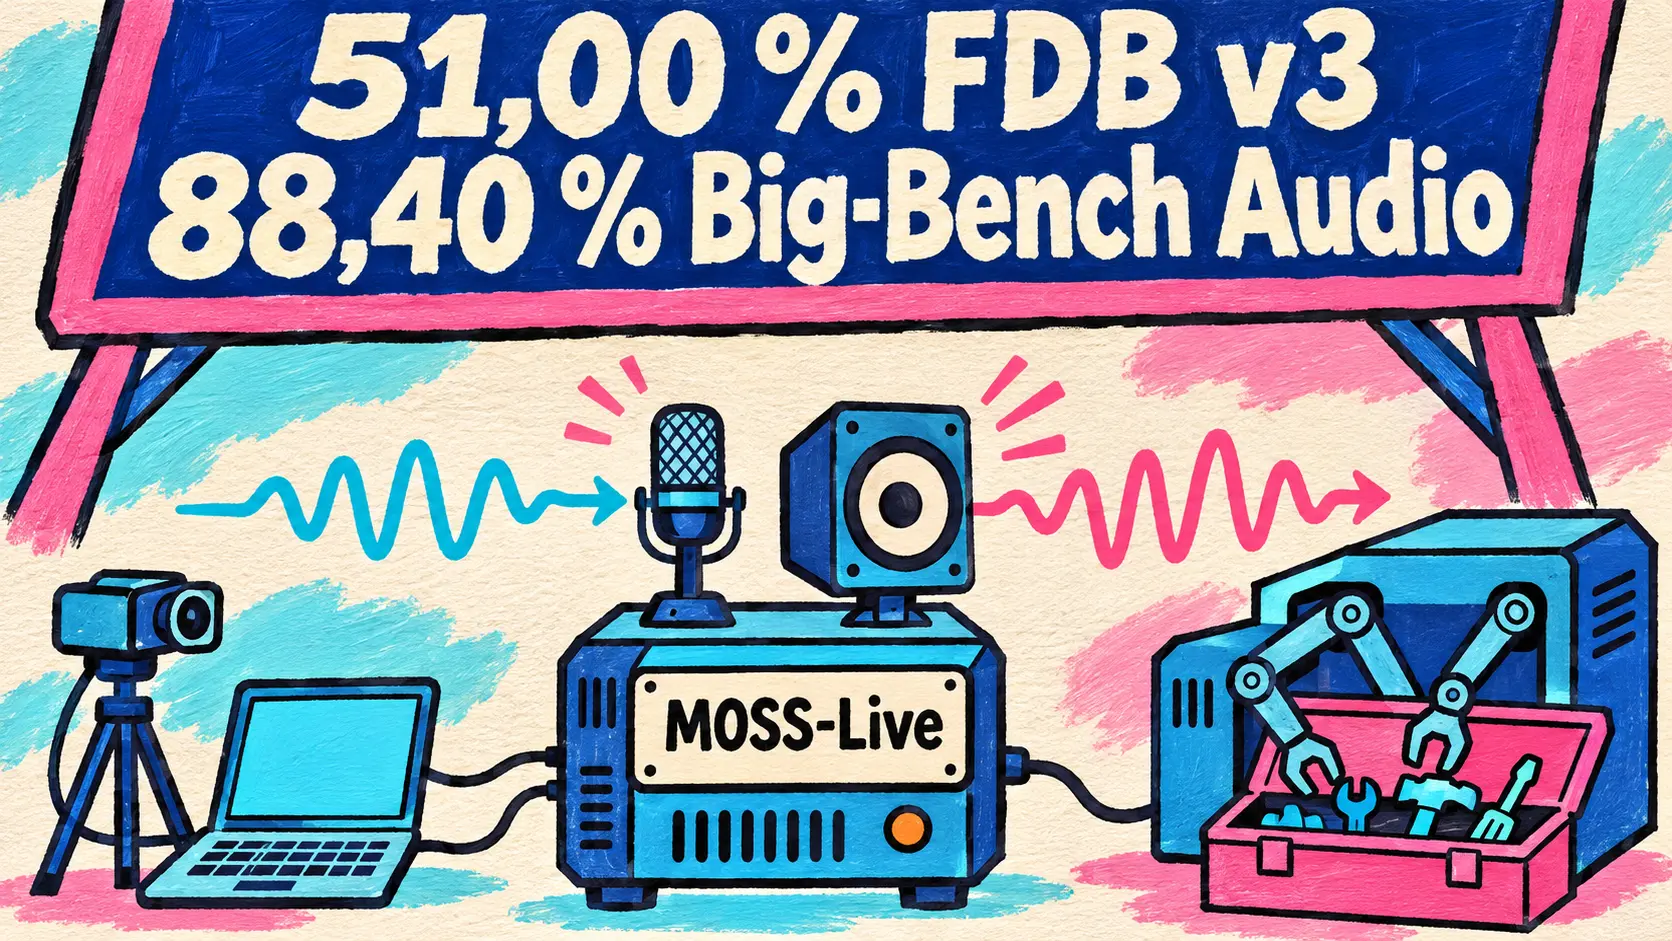
7 novembre — Il team OpenMOSS presenta MOSS-Live, un sistema di conversazione in tempo reale che ascolta e parla contemporaneamente (duplex integrale, full-duplex), comprende ciò che mostrano la videocamera o la condivisione dello schermo e affida ricerche e attività lunghe a un secondo modello senza interrompere lo scambio. Nel post firmato da Chen Yang sul blog della community di Hugging Face, un modello di interazione in primo piano decide se rispondere, attendere o cedere la parola, un modello in background ragiona e richiama gli strumenti, e un livello di coordinamento condivide la memoria e lo stato delle attività. MOSS-Live deve distinguere un «mm-hmm» da una vera interruzione, ignorare le parole che non gli sono rivolte e garantire l’interpretazione simultanea.
| Benchmark e metrica (secondo OpenMOSS) | Punteggio di MOSS-Live | Miglior concorrente citato |
|---|---|---|
| FDB v3, riuscita delle chiamate agli strumenti | 51,00 % | 51,00 % (Doubao SeedDuplex) |
| τ-Voice, attività su più turni (pass¹) | 57,93 % | 67,68 % (GPT-Live-1) |
| τ-Voice, selettività rispetto alle parole non rivolte al sistema | 78,90 % | 66,99 % (GPT-Live-1) |
| Big-Bench Audio, accuratezza | 88,40 % | 90,50 % (Doubao SeedDuplex) |
| FDB v3, latenza in uno scenario con strumenti | 2,36 s | 1,61 s (GPT Realtime 2.1) |
MOSS-Live non è un modello aperto: il repository GitHub contiene soltanto la documentazione, senza licenza né pesi. Il sistema si può provare in un ambiente di test online (playground) e si integra tramite un’API in tempo reale sulla piattaforma MOSS.
🔗 MOSS-Live sul blog di Hugging Face · Documentazione di MOSS-Live sulla piattaforma MOSS
Antigravity illustra la sua modalità vocale Gemini Live, nell’applicazione e in Antigravity CLI 1.5.0
6 novembre — Il blog di Antigravity illustra la modalità vocale (voice mode) di cui l’applicazione 2.29.0 aveva avviato il rilascio il 3 novembre. Gemini Live ascolta direttamente la voce, senza passare per una trascrizione, risponde in tempo reale e si lascia interrompere: gli si affida un’attività, la si riorienta mentre è in esecuzione («Che cosa stai facendo?», «fermati») e si risponde alle richieste di autorizzazione a voce. Il post aggiunge ciò che il changelog non diceva: la modalità funziona anche in Antigravity CLI, a partire dalla versione 1.5.0.
Destructive actions, such as deleting files, running commands with elevated privileges, or force-pushing to a Git remote, can’t be approved by voice.
🇮🇹 Le azioni distruttive, come eliminare file, eseguire comandi con privilegi elevati o forzare un invio verso un repository Git remoto, non possono essere approvate a voce. — Blog di Antigravity, Modalità vocale in Antigravity
| Impostazione o limite | Valore indicato da Antigravity |
|---|---|
| Avvio nella CLI | /voice live o F6; agy mic-serve in SSH |
| Voci e velocità del parlato | 9 voci; da 0,75x a 2x nell’applicazione, da 0,5 a 3 nella CLI |
| Aggiornamento sullo stato di avanzamento su richiesta | circa ogni 30 secondi («tienimi aggiornato») |
| Conversazioni in modalità vocale | una sola alla volta, esclusivamente locali |
La modalità vocale non funziona in Remote Control, nelle conversazioni eseguite nel cloud o in una sessione con un agente remoto, e l’audio del microfono viene inviato ai server di Google. Non viene citato alcun piano: la documentazione avverte soltanto che la modalità potrebbe non essere ancora disponibile per tutti gli account.
🔗 Annuncio di @antigravity su X · Documentazione della modalità vocale
Il software delle GPU NVIDIA: CUDA 13.5, NCCL M2N Reshard e FLUX 3 Image Klein su Blackwell
CUDA 13.5 porta il supporto di Vera Rubin alla disponibilità generale
4 novembre — NVIDIA pubblica CUDA 13.5. La novità principale: il supporto dell’architettura Vera Rubin passa dall’accesso anticipato riservato agli sviluppatori alla disponibilità generale (general availability), pronto per la produzione in azienda secondo NVIDIA. Windows on Arm, in disponibilità generale da CUDA 13.4, si estende alla DGX Station con Windows, e su Rubin la modalità TCC viene abbandonata a favore di WDDM e MCDM. Per la condivisione delle GPU, MPS passa alla versione 3 (intervalli di tempo ponderati, prestito e acquisizione di multiprocessori (SM) tra partizioni, instradamento tramite cgroup v2); CUDA Tile acquisisce la comunicazione multi-GPU nei kernel.
| Libreria o strumento | Novità annunciata da NVIDIA |
|---|---|
| CCCL 3.5 | Top-K in batch, già integrato in FlashInfer; scan in virgola mobile riproducibili |
| cuBLAS | moltiplicazioni NVFP4 e MXFP8 più rapide su Vera Rubin, senza cifre |
| cuSPARSE | prodotti di matrici sparse da 1,65 a 2,27 volte più rapidi |
| Nsight Perf SDK for AI | anteprima pubblica, profilazione continua degli addestramenti lunghi |
| Compute Sanitizer | skill per aiutare gli agenti di coding a diagnosticare gli errori di memoria |
🔗 NVIDIA CUDA 13.5 introduce il supporto di NVIDIA Vera Rubin in disponibilità generale
NCCL M2N Reshard accelera da 2,7 a 5,7 volte il trasferimento dei pesi nell’apprendimento per rinforzo
6 novembre — Nell’apprendimento per rinforzo (reinforcement learning, RL), le GPU di inferenza che generano le traiettorie devono ricevere regolarmente i pesi aggiornati dalle GPU di addestramento: è il riallineamento dei pesi (refit). Il metodo abituale raccoglie ogni parametro e poi lo distribuisce (gather-and-broadcast), facendo circolare circa il doppio delle dimensioni del modello a ogni passaggio, quasi 11,2 To per Kimi K3 secondo NVIDIA. Reshard, un nuovo tipo di comunicazione collettiva, tratta questo riallineamento come una ripartizione di un tensore distribuito: ogni GPU riceve soltanto la propria porzione, una sola copia attraversa la rete per ciascun dominio NVLink, poi le GPU si scambiano le parti mancanti tramite NVLink.
L’implementazione di riferimento, NCCL M2N Reshard, è open source e integrata in NeMo RL, dove trasferisce i pesi dei livelli a propagazione in avanti (feed-forward), circa il 95 % dei parametri. Secondo NVIDIA, il riallineamento dei pesi diventa da 2,7 a 5,7 volte più rapido:
| Piattaforma di test | Modello addestrato | Metodo classico | Con Reshard |
|---|---|---|---|
| DGX H100 | Qwen 3 235B | 6,4 s | 1,9 s |
| DGX H100 | DeepSeek V3 671B | 14,9 s | 2,6 s |
| DGX GB200 | DeepSeek V3 671B | 6,1 s | 2,3 s |
| DGX GB200 | Nemotron Ultra v3 | 8,2 s | 2,3 s |
🔗 Accelerare il riallineamento dei pesi nell’apprendimento per rinforzo con l’operazione collettiva Reshard · Repository NVIDIA/nccl-extensions
FLUX 3 Image Klein fino a 4,45 volte più rapido su Blackwell con TensorRT LLM VisualGen
6 novembre — NVIDIA pubblica un tutorial dedicato a FLUX 3 Image Klein, il modello di immagini a pesi aperti di Black Forest Labs, in TensorRT LLM VisualGen, il runtime di TensorRT LLM dedicato alla generazione visiva. Su una sola GPU B200, a 2048x2048, la combinazione delle ottimizzazioni (compilazione, pesi NVFP4, attenzione sparsa Sol-Attention, cache Cache-DiT) rende Klein Base fino a 3,46 volte più rapido nella generazione da testo a immagine e 4,45 volte più rapido da immagine a immagine, rispetto a un’inferenza BF16 non compilata.
| Configurazione misurata (2048x2048) | Inferenza BF16 non compilata | Dopo le ottimizzazioni | Guadagno misurato |
|---|---|---|---|
| Da testo a immagine, Klein Base, 1 B200 | 22,36 s | 6,46 s | 3,46x |
| Da immagine a immagine, Klein Base, 1 B200 | 54,64 s | 12,28 s | 4,45x |
NVIDIA misura la differenza visiva con il punteggio LPIPS (più è basso, più l’immagine rimane vicina al riferimento): 0,095 da testo a immagine e 0,045 da immagine a immagine. Passando da una a otto B200, la latenza mediana di Klein Base da testo a immagine scende da 14,90 a 3,00 secondi; su una RTX PRO 6000 Blackwell Server Edition, i guadagni vanno da 1,73 a 3,25 volte. Il tutorial fornisce un container TensorRT LLM, configurazioni YAML e un endpoint compatibile con OpenAI tramite trtllm-serve.
🔗 Accelerare la generazione di immagini con FLUX 3 Image Klein sulle GPU NVIDIA Blackwell
GitHub illustra Rubicon, la sua nuova architettura di archiviazione Git testata con 5 000 agenti su un repository
5 novembre — GitHub pubblica il terzo post della sua serie su un’infrastruttura Git progettata per gli agenti, dopo quelli del 6 e del 21 ottobre, e lo rilancia il 6 novembre su X. Karthik Raman e Brian Celenza vi descrivono Rubicon, la nuova architettura di archiviazione Git annunciata a GitHub Universe. I repository più attivi ricevono oggi al massimo qualche decina di scritture al secondo, a raffiche; GitHub si aspetta un ritmo continuo entro un anno, e un altro dei suoi post dà un’idea della scala: oltre 1,2 miliardi di commit in una settimana a ottobre.
Through internal testing, we’ve demonstrated the ability to support 5,000 concurrent agents working on a repository, sending 7,200 pushes per second to a repo, all while serving read traffic with consistently low latency.
🇮🇹 Durante i test interni, abbiamo dimostrato la capacità di supportare 5 000 agenti che lavorano contemporaneamente su un repository, effettuando 7 200 invii (push) al secondo verso un repository, continuando a servire il traffico di lettura con una latenza costantemente bassa. — @github su X
Spokes continua a instradare le richieste, ma verso repliche virtuali usa e getta il cui disco locale è soltanto una cache. I pack Git risiedono in Azure Blob Storage, i riferimenti in Ref-CAS (Reference Compare-and-Swap), un log replicato in cui ogni aggiornamento viene convalidato da un quorum: un primo prototipo basato interamente su blob si fermava a qualche centinaio di scritture al secondo, mentre Ref-CAS ne gestisce decine di migliaia. Rubicon è in anteprima privata limitata, con un rilascio più ampio previsto all’inizio del prossimo anno.
🔗 Dentro la nuova architettura di archiviazione Git di GitHub
Copilot in team: la code review si gestisce tramite API, @GitHub passa alla disponibilità generale su Slack e Teams
La code review di Copilot si configura tramite le API REST e GraphQL e rende più compatto il riepilogo
6 novembre — Dopo l’introduzione dell’avvio delle revisioni tramite API a ottobre, GitHub rende disponibili la lettura e la modifica delle impostazioni di Copilot code review tramite le API REST e GraphQL, dalle policy aziendali fino al repository. Le risposte identificano anche ciò che ha scritto Copilot, il livello di impegno utilizzato e le skill, i server MCP e le istruzioni che cita come fonti.
| Livello di impostazione | Cosa permette di impostare l’API |
|---|---|
| Azienda | attivare o disattivare la revisione per tutte le organizzazioni, oppure lasciare loro la scelta |
| Organizzazione | attivazione, livello di impegno predefinito, runner, senza sovrascrivere le scelte aziendali |
| Repository | livello di impegno, uso delle istruzioni personalizzate e degli strumenti MCP |
Limite: gli endpoint aziendali e delle organizzazioni rifiutano le GitHub Apps e i token di accesso personali a granularità fine (fine-grained PAT), accettati soltanto dagli endpoint dei repository. Il commento di riepilogo diventa più compatto (livello di impegno e sondaggi a piè di pagina, un’unica sezione «File non esaminati»), le sessioni di revisione mostrano i crediti IA consumati e il livello di impegno Balanced passa a tre modelli di revisione, con un altro modello che ne combina le osservazioni. Una revisione non riuscita viene rilanciata una volta, con la possibilità di passare a un altro modello. Piani Pro, Pro+, Max, Business ed Enterprise.
🔗 Copilot code review: gestione tramite API e aggiornamenti della panoramica delle revisioni
@GitHub passa alla disponibilità generale su Slack e Microsoft Teams, con Canvas in Teams
6 novembre — Dopo un’anteprima pubblica aperta il 21 agosto, l’agente @GitHub passa alla disponibilità generale su Slack e Microsoft Teams. Lo si menziona in una conversazione per indagare su un bug, creare una issue, implementare una modifica o aprire una pull request, senza cambiare strumento. L’unica novità funzionale è Canvas in Teams: piani di implementazione, modifiche al codice e anteprime vengono visualizzati accanto alla discussione, dove il team può commentarli e far avanzare il lavoro.
Il resto consiste in alcuni aggiustamenti: il repository viene dedotto dal messaggio senza una nuova selezione, sono stati corretti i casi in cui i messaggi successivi potevano rimanere senza risposta, e le issue e le pull request create da una conversazione riportano il nome della persona che le ha richieste. La pagina non specifica né i piani interessati né dati di utilizzo.
🔗 @GitHub su Slack e Teams è in disponibilità generale e altre novità
In breve
Agenti e strumenti per il codice
- Copilot CLI 1.0.108-0 e 1.0.108-1 — Due versioni preliminari pubblicate il 7 novembre, il giorno dopo la versione stabile 1.0.107: comandi /index e indicizzazione tgrep condivisa attivata per impostazione predefinita sui repository idonei, CLI che risponde alle domande sul proprio funzionamento basandosi sulla propria documentazione e 72 correzioni, tra cui regole di rifiuto MCP applicate anche con
--allow-all-tools. 🔗 fonte - Qwen Code v0.27.0 — Versione stabile del 7 novembre, il giorno dopo la v0.26.9, senza modifiche incompatibili: 73 voci, tra cui notifiche FileChanged per gli hook delle sessioni locali, un filtro degli eventi dei repository GitHub (autorizzazione e blocco) per i canali e domande simultanee degli agenti figli del Managed Agent. 🔗 fonte
- Agenti remoti di Antigravity — Uno stesso progetto riunisce un repository GitHub e una cartella Google Drive, con accesso in lettura e scrittura; un’attività avviata sul web si riprende nell’applicazione e le autorizzazioni si sbloccano dal telefono. Il tweet cita tutti i piani a pagamento per il pubblico generale, mentre la documentazione indica Google AI Pro e Ultra, escludendo Google AI Plus e gli account professionali. 🔗 fonte
- Supporto nell’Agent di Replit — Quando gli viene chiesta assistenza, l’Agent verifica prima gli incidenti in corso, la documentazione e i limiti noti della piattaforma, senza uscire dalla conversazione; se il problema persiste, invia autonomamente il ticket con i dettagli di debug dell’ambiente, nel piano Pro. 🔗 fonte
- Showcase di OpenAI Developers — Il plugin OpenAI Developers aggiunge una scheda Showcase: progetti iniziali per l’API (agenti, strumenti creativi, visualizzazione dei dati, voce) da aprire in Codex; la pagina API demos ne elenca dodici, di cui otto da aprire direttamente in Codex o da scaricare. 🔗 fonte
GitHub Copilot
- Riepilogo dell’app GitHub Copilot — Il riepilogo settimanale del 6 novembre illustra le novità dell’app: Agent Merge configurato dalla pull request e mantenuto durante le verifiche in attesa, compattazione della conversazione al raggiungimento del limite di contesto, CSV e TSV aperti come tabelle e istruzioni personali per l’approvazione assistita, su adesione volontaria. 🔗 fonte
- Copilot impact dashboard — Il dashboard monitora nove esperienze Copilot invece di sette, con Copilot Chat e la finestra Agents di VS Code; la coorte «Utenti passivi» diventa «Utenti che privilegiano la chat», senza modificare le fasi di adozione né le dimensioni delle coorti. 🔗 fonte
- 1,2 miliardi di commit in una settimana — In una guida all’ingegneria agentica (agentic engineering) senza novità di prodotto, firmata da Nick Liffen e Philip Holleran, GitHub dichiara di aver registrato in ottobre oltre 1,2 miliardi di commit in una settimana, oltre il 400 % in più rispetto a un anno prima. 🔗 fonte
Inferenza, classifiche e modelli aperti
- Together Compiler — Presentati il 4 novembre, gli agenti di Together AI che ottimizzano continuamente i kernel di ogni cliente tornano con un solo dato nuovo: da +12 a +20 % di token al secondo in mediana su endpoint senza server (serverless) già ottimizzati manualmente, secondo Together AI. 🔗 fonte
- MiniMax M3.1 Flash su Fireworks — MiniMax annuncia in un tweet che M3.1 Flash è disponibile su Fireworks AI, invitando a una serata a San Francisco il 10 novembre; non vengono specificati né prezzi né throughput. 🔗 fonte
- Construction AI Leaderboard — ONESTRUCTION pubblica una classifica dei modelli per l’edilizia, basata sulla media di cinque benchmark (planimetrie, modelli BIM, stima dei costi, generazione IDS): Claude Opus 5.5 è in testa con 73,7 punti, un decimo davanti a Gemini 4 Argon (73,6), seguito da Claude Opus 5 (72,7) e GPT-6.1 Sol (70,2). Misurazioni del produttore. 🔗 fonte
- kniv v7.1 — Dragonscale afferma di aver migliorato senza alcun riaddestramento i suoi sei encoder di estrazione, presentati il 2 novembre: in Claude Code, Claude Opus 5.5 ha individuato un limite di 50 antecedenti nella coreferenza, portato a 100 nel grafo ONNX; la coreferenza migliora su tutti e sei i modelli e viene calcolata dal 7 al 16 % più velocemente. 🔗 fonte
Robotica aperta
- Robotica in Hugging Face — Secondo Clément Delangue, l’Hub conta quasi 100 000 dataset pubblici di robotica (+48 %) e oltre 30 000 modelli (+41 %), LeRobot supera il milione di download e Microduck e Reachy Mini dovrebbero probabilmente superare le 50 000 unità vendute e le 20 000 consegnate entro la fine dell’anno. 🔗 fonte
- HapTile in FiftyOne — Harpreet Sahota (Voxel51) converte per FiftyOne il dataset HapTile: 1 699 episodi e 12,36 ore di un braccio UR5e teleoperato, con sensori tattili a gel, due telecamere RGB-D e il livello di feedback aptico percepito dall’operatore, con licenza CC BY 4.0. 🔗 fonte
Aziende e utilizzi
- Harper e Grok Bot — Il 5 novembre, il broker assicurativo Harper descrive gli agenti ambientali, basati su Grok Bot, che gestiscono il suo back-office, attivati da un’e-mail o da una scadenza. Secondo Harper, da settembre uno di questi ha contribuito a regolarizzare la posizione di oltre 200 piccole imprese presso il rispettivo ente finanziatore, senza alcun annullamento. 🔗 fonte
- Replit e Plaid — In un tweet accompagnato da un video, Replit mette in evidenza il suo connettore Plaid, che collega conti finanziari per far creare all’Agent, senza codice, strumenti per gestire il proprio denaro; Plaid gli dedica un’intervista con Michele Catasta, presidente di Replit. Secondo la documentazione di Replit, il connettore è riservato ai piani a pagamento con uno spazio di team, in cui un amministratore configura una sola volta le credenziali Plaid, e dà accesso a saldi, transazioni e investimenti. 🔗 fonte · 🔗 documentazione
- Guida di Perplexity sull’accessibilità — Perplexity pubblica una guida sull’IA al servizio delle persone con disabilità e sull’accessibilità degli stessi strumenti di IA, senza prodotti né dati propri; cita un test di Microsoft in cui il 12 % delle pagine generate senza istruzioni supera i controlli automatizzati, contro l’86 % quando i modelli testano e correggono il proprio codice. 🔗 fonte
Che cosa significa
La voce diventa un’interfaccia per gli agenti, con un’architettura che si ripete: un modello conversa in primo piano, un agente agisce in background. MOSS-Live ne fa il cuore del proprio sistema con uno strato di coordinamento tra i due modelli, Antigravity la integra sia nell’applicazione sia nel terminale, lo stesso giorno in cui Cursor rendeva disponibile la sua chat vocale. I limiti restano chiari: Antigravity riserva la modalità vocale a una sola conversazione locale alla volta e mantiene il clic per le azioni distruttive; MOSS-Live non pubblica né pesi né licenza e i suoi stessi punteggi lo collocano dietro GPT-Live-1 nelle attività a più turni di τ-Voice.
L’infrastruttura si ricalibra per il carico degli agenti. GitHub dimensiona Rubicon per picchi di scritture destinati a diventare un ritmo continuo, testa 5 000 agenti su un solo repository e in ottobre ha contato oltre 1,2 miliardi di commit in una settimana. Lo stesso movimento riguarda l’organizzazione del lavoro: la code review di Copilot si configura tramite API dal livello aziendale fino al repository, come qualsiasi politica infrastrutturale, e @GitHub si insedia in Slack e Teams, dove i team discutono già di ciò che va corretto.
Il guadagno viene anche dal software. CUDA 13.5 porta il supporto per Vera Rubin alla disponibilità generale e accelera librerie come cuSPARSE, Reshard rende il trasferimento dei pesi da 2,7 a 5,7 volte più rapido nell’apprendimento per rinforzo e la combinazione delle ottimizzazioni rende FLUX 3 Image Klein fino a 4,45 volte più rapido su un solo B200. Together AI, dal canto suo, dichiara un throughput mediano dal 12 al 20 % superiore grazie ad agenti che ottimizzano continuamente i kernel. Tutti questi dati provengono dai produttori e sono stati misurati sulle loro configurazioni.
Fonti
- MOSS-Live (blog Hugging Face, OpenMOSS)
- Documentazione di MOSS-Live (piattaforma MOSS)
- Modalità vocale in Antigravity (blog Antigravity)
- Annuncio della modalità vocale da parte di @antigravity
- Documentazione della modalità vocale di Antigravity
- NVIDIA CUDA 13.5 introduce il supporto GA per NVIDIA Vera Rubin (NVIDIA)
- Accelerare il refit dei pesi nell’apprendimento per rinforzo con l’operazione collettiva Reshard (NVIDIA)
- Repository NVIDIA/nccl-extensions
- Accelerare la generazione di immagini con FLUX 3 Image Klein sulle GPU NVIDIA Blackwell (NVIDIA)
- Dentro la nuova architettura di storage Git di GitHub (GitHub Blog)
- @github: Rubicon in un articolo su X
- Code review di Copilot: aggiornamenti alla gestione tramite API e alla panoramica delle review (GitHub Changelog)
- @GitHub in Slack e Teams raggiunge la disponibilità generale e altre novità (GitHub Changelog)
- Copilot CLI 1.0.108-0
- Qwen Code v0.27.0
- Thread di @antigravity sugli agenti remoti
- Changelog di Replit del 6 novembre
- Showcase del plugin OpenAI Developers (@OpenAIDevs)
- Rilasci settimanali di GitHub Copilot, 2 novembre (GitHub Changelog)
- Copilot impact dashboard aggiunge l’utilizzo della chat e degli agenti di VS Code (GitHub Changelog)
- Oltre la generazione di codice: una guida all’ingegneria agentica per sviluppatori (GitHub Blog)
- Together Compiler (@togethercompute)
- M3.1 Flash su Fireworks AI (@MiniMax_AI)
- Construction AI Leaderboard (blog Hugging Face, ONESTRUCTION)
- kniv v7.1 (blog Hugging Face, Dragonscale)
- Robotica aperta in Hugging Face (@ClementDelangue)
- HapTile in FiftyOne (blog Hugging Face)
- Agenti ambientali (Harper Engineering)
- Replit e Plaid (@Replit)
- Connettore Plaid (documentazione Replit)
- Accessibilità dell’IA (Perplexity)