ai-powered-markdown-translatorgpt-6.1-sol을 사용하여 프랑스어에서 한국어로 번역한 기사.
음성이 에이전트를 제어하는 수단으로 자리 잡고 있다. OpenMOSS는 듣고 말하면서 동시에 도구를 실행하는 MOSS-Live를 공개했고, Antigravity는 애플리케이션과 터미널에서 사용하는 Gemini Live 기반 음성 모드를 상세히 소개했다. NVIDIA는 CUDA 13.5, 강화 학습용 Reshard 집단 통신 연산, Blackwell에서 가속되는 FLUX 3 Image Klein으로 GPU 소프트웨어 계층을 강화했다. GitHub는 하나의 저장소에서 에이전트 5 000개로 시험한 새로운 Git 저장소 시스템 Rubicon을 설명하고, API로 제어하는 코드 리뷰와 Slack 및 Teams에서 정식 출시된 @GitHub를 통해 Copilot을 팀 도구로 확장했다.
음성으로 에이전트 제어: OpenMOSS의 MOSS-Live와 Antigravity의 Gemini Live 음성 모드
두 발표는 같은 아키텍처를 공유한다. 전면에서는 모델이 대화하고, 후면에서는 에이전트가 작업한다. Cursor가 11월 6일 Grok Voice 기반으로 공개한 음성 채팅과 같은 구조다.
OpenMOSS, 보고 듣고 도구를 실행하는 전이중 음성 시스템 MOSS-Live 공개
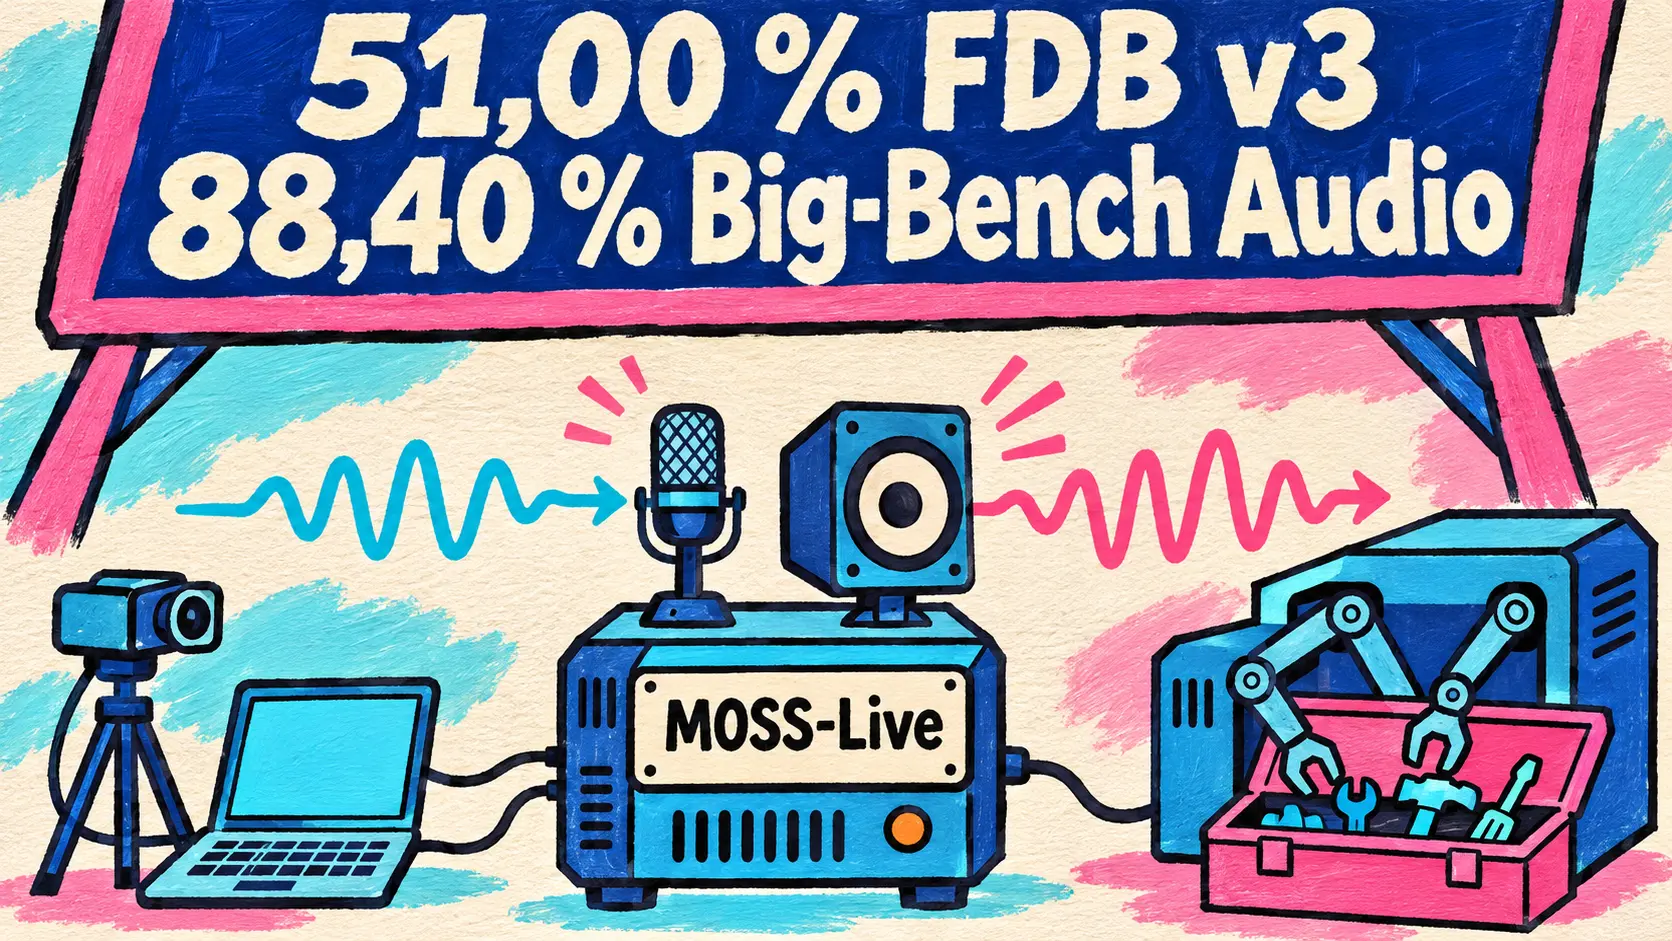
11월 7일 — OpenMOSS 팀이 MOSS-Live를 공개했다. 이 실시간 대화 시스템은 동시에 듣고 말하며(전이중, full-duplex), 카메라나 화면 공유에 표시된 내용을 이해하고, 대화를 끊지 않은 채 검색과 장시간 작업을 두 번째 모델에 맡긴다. Hugging Face 커뮤니티 블로그에 Chen Yang이 작성한 글에 따르면, 전면의 상호작용 모델은 응답할지, 기다릴지, 발언권을 넘길지 결정하고, 후면 모델은 추론과 도구 호출을 수행하며, 조정 계층은 메모리와 작업 상태를 공유한다. MOSS-Live는 “응응” 같은 맞장구와 실제 끼어들기를 구분하고, 자신에게 하는 말이 아닌 발화를 무시하며, 동시통역도 수행해야 한다.
| 벤치마크 및 지표(OpenMOSS 기준) | MOSS-Live 점수 | 언급된 최고 경쟁 모델 |
|---|---|---|
| FDB v3, 도구 호출 성공률 | 51,00 % | 51,00 % (Doubao SeedDuplex) |
| τ-Voice, 다중 턴 작업(pass¹) | 57,93 % | 67,68 % (GPT-Live-1) |
| τ-Voice, 자신에게 하지 않은 발화에 대한 선택성 | 78,90 % | 66,99 % (GPT-Live-1) |
| Big-Bench Audio, 정확도 | 88,40 % | 90,50 % (Doubao SeedDuplex) |
| FDB v3, 도구 사용 시나리오의 지연 시간 | 2,36 s | 1,61 s (GPT Realtime 2.1) |
MOSS-Live는 공개 모델이 아니다. GitHub 저장소에는 문서만 있으며, 라이선스나 가중치는 없다. 온라인 테스트 공간(플레이그라운드)에서 시스템을 체험할 수 있고, MOSS 플랫폼의 실시간 API로 통합할 수 있다.
🔗 Hugging Face 블로그의 MOSS-Live 소개 · MOSS 플랫폼의 MOSS-Live 문서
Antigravity, 애플리케이션과 Antigravity CLI 1.5.0의 Gemini Live 음성 모드 상세 소개
11월 6일 — Antigravity 블로그가 애플리케이션 2.29.0에서 11월 3일 배포를 시작한 음성 모드(음성 대화 모드)를 상세히 소개했다. Gemini Live는 전사 과정을 거치지 않고 음성을 직접 듣고 실시간으로 응답하며, 사용자가 중간에 끼어들 수 있다. 작업을 맡기고, 실행 중에 방향을 바꾸며(“무슨 작업을 하고 있어?”, “멈춰”), 권한 승인 요청에도 음성으로 답할 수 있다. 이번 글은 변경 기록에 없던 내용도 덧붙였다. 이 모드는 Antigravity CLI에서도 1.5.0 버전부터 작동한다.
Destructive actions, such as deleting files, running commands with elevated privileges, or force-pushing to a Git remote, can’t be approved by voice.
🇰🇷 파일 삭제, 높은 권한으로 명령 실행, 원격 Git 저장소로 강제 푸시 같은 파괴적 작업은 음성으로 승인할 수 없습니다. — Antigravity 블로그, Antigravity의 음성 모드
| 설정 또는 제한 | Antigravity가 명시한 값 |
|---|---|
| CLI에서 시작 | /voice live 또는 F6 ; SSH에서는 agy mic-serve |
| 음성과 말하기 속도 | 음성 9종 ; 애플리케이션에서 0,75x |
| 요청 시 진행 상황 안내 | 약 30초마다(“계속 알려 줘”) |
| 음성 모드 대화 | 한 번에 하나만, 로컬에서만 가능 |
음성 모드는 Remote Control, 클라우드에서 실행되는 대화, 원격 에이전트 세션에서는 작동하지 않으며, 마이크 음성은 Google 서버로 전송된다. 특정 요금제는 언급되지 않았다. 문서는 아직 모든 계정에서 이 모드를 사용할 수 있는 것은 아니라고만 안내한다.
🔗 X의 @antigravity 발표 · 음성 모드 문서
NVIDIA GPU 소프트웨어: CUDA 13.5, NCCL M2N Reshard와 Blackwell의 FLUX 3 Image Klein
CUDA 13.5, Vera Rubin 지원 정식 출시
11월 4일 — NVIDIA가 CUDA 13.5를 출시했다. 가장 큰 변화는 Vera Rubin 아키텍처 지원이 개발자 대상 사전 접근 단계를 벗어나 정식 출시(일반 공개)된 것이다. NVIDIA에 따르면 기업의 실제 운영 환경에 투입할 준비가 됐다. CUDA 13.4부터 정식 지원된 Windows on Arm은 Windows를 실행하는 DGX Station으로 확대되며, Rubin에서는 TCC 모드가 폐지되고 WDDM과 MCDM으로 대체된다. GPU 공유를 위한 MPS는 버전 3으로 올라갔다. 가중치를 적용한 시간 할당, 파티션 간 멀티프로세서(SM) 대여와 차용, cgroup v2 기반 라우팅을 지원한다. CUDA Tile에는 커널 내 다중 GPU 통신 기능이 추가됐다.
| 라이브러리 또는 도구 | NVIDIA가 발표한 새로운 기능 |
|---|---|
| CCCL 3.5 | 배치 Top-K, 이미 FlashInfer에 통합 ; 재현 가능한 부동소수점 스캔 |
| cuBLAS | Vera Rubin에서 NVFP4 및 MXFP8 곱셈 가속, 수치는 미공개 |
| cuSPARSE | 희소 행렬 곱셈 속도 1,65~2,27배 향상 |
| Nsight Perf SDK for AI | 공개 미리보기, 장시간 학습의 연속 프로파일링 |
| Compute Sanitizer | 코딩 에이전트의 메모리 오류 진단을 돕는 스킬 |
🔗 NVIDIA CUDA 13.5, NVIDIA Vera Rubin 정식 지원 제공
NCCL M2N Reshard, 강화 학습의 가중치 전송을 2,7~5,7배 가속
11월 6일 — 강화 학습(reinforcement learning, RL)에서는 궤적을 생성하는 추론 GPU가 학습 GPU에서 갱신한 가중치를 주기적으로 받아야 한다. 이것이 가중치 재적용(refit)이다. 기존 방식은 각 매개변수를 모은 뒤 전체에 배포하는 방식(gather-and-broadcast)으로, 단계마다 모델 크기의 약 두 배에 해당하는 데이터가 이동한다. NVIDIA에 따르면 Kimi K3에서는 약 11,2 TB에 달한다. 새로운 집단 통신 연산인 Reshard는 이 갱신을 분산 텐서의 재분할로 처리한다. 각 GPU는 자신에게 필요한 부분만 받고, NVLink 도메인당 사본 하나만 네트워크를 통과한 뒤 GPU들이 NVLink로 나머지를 서로 전달한다.
참조 구현인 NCCL M2N Reshard는 오픈 소스로 공개됐으며 NeMo RL에 통합됐다. 여기서 전체 매개변수의 약 95 %를 차지하는 순전파(feed-forward) 계층의 가중치를 전송한다. NVIDIA에 따르면 가중치 재적용 속도는 2,7~5,7배 빨라진다.
| 테스트 플랫폼 | 학습 모델 | 기존 방식 | Reshard 사용 |
|---|---|---|---|
| DGX H100 | Qwen 3 235B | 6,4 s | 1,9 s |
| DGX H100 | DeepSeek V3 671B | 14,9 s | 2,6 s |
| DGX GB200 | DeepSeek V3 671B | 6,1 s | 2,3 s |
| DGX GB200 | Nemotron Ultra v3 | 8,2 s | 2,3 s |
🔗 Reshard 집단 통신 연산으로 강화 학습 가중치 재적용 가속 · NVIDIA/nccl-extensions 저장소
TensorRT LLM VisualGen으로 Blackwell에서 FLUX 3 Image Klein 최대 4,45배 가속
11월 6일 — NVIDIA가 TensorRT LLM의 시각 콘텐츠 생성 전용 런타임인 TensorRT LLM VisualGen에서 Black Forest Labs의 가중치 공개 이미지 모델 FLUX 3 Image Klein을 사용하는 튜토리얼을 공개했다. B200 GPU 한 개에서 2048x2048 해상도로 실행할 때 최적화 기법을 차례로 적용하면(컴파일, NVFP4 가중치, Sol-Attention 희소 어텐션, Cache-DiT 캐시), 컴파일하지 않은 BF16 추론 대비 Klein Base의 텍스트 기반 이미지 생성은 최대 3,46배, 이미지 기반 이미지 생성은 최대 4,45배 빨라진다.
| 측정 구성(2048x2048) | 컴파일하지 않은 BF16 추론 | 최적화 후 | 측정된 향상 폭 |
|---|---|---|---|
| 텍스트 기반 이미지 생성, Klein Base, 1 B200 | 22,36 s | 6,46 s | 3,46x |
| 이미지 기반 이미지 생성, Klein Base, 1 B200 | 54,64 s | 12,28 s | 4,45x |
NVIDIA는 시각적 차이를 LPIPS 점수로 측정했다. 점수가 낮을수록 이미지가 기준 이미지에 더 가깝다. 텍스트 기반 이미지 생성에서는 0,095, 이미지 기반 이미지 생성에서는 0,045를 기록했다. B200을 한 개에서 여덟 개로 늘리면 Klein Base의 텍스트 기반 이미지 생성 지연 시간 중앙값이 14,90초에서 3,00초로 줄어든다. RTX PRO 6000 Blackwell Server Edition에서는 1,73~3,25배의 성능 향상을 보인다. 튜토리얼은 TensorRT LLM 컨테이너, YAML 설정, trtllm-serve을 통한 OpenAI 호환 엔드포인트를 제공한다.
🔗 NVIDIA Blackwell GPU에서 FLUX 3 Image Klein으로 이미지 생성 가속
GitHub, 하나의 저장소에서 에이전트 5 000개로 시험한 새 Git 저장소 아키텍처 Rubicon 상세 소개
11월 5일 — GitHub가 10월 6일과 21일에 이어 에이전트에 맞춘 Git 인프라 시리즈의 세 번째 글을 공개하고, 11월 6일 X에 공유했다. Karthik Raman과 Brian Celenza는 이 글에서 GitHub Universe에서 발표한 새로운 Git 저장소 아키텍처 Rubicon을 설명한다. 현재 가장 활동이 활발한 저장소도 순간적으로 몰릴 때 초당 수십 건 이하의 쓰기 요청을 받는다. GitHub는 1년 안에 이런 속도의 요청이 지속적으로 이어질 것으로 예상한다. 다른 글에서는 그 규모를 보여 준다. 10월의 한 주 동안 커밋이 12억 건을 넘었다.
Through internal testing, we’ve demonstrated the ability to support 5,000 concurrent agents working on a repository, sending 7,200 pushes per second to a repo, all while serving read traffic with consistently low latency.
🇰🇷 내부 테스트에서 하나의 저장소에 에이전트 5 000개가 동시에 작업하며 초당 7 200회의 푸시를 수행하는 동안에도 읽기 요청을 지속적으로 낮은 지연 시간으로 처리할 수 있음을 입증했습니다. — X의 @github
Spokes는 계속 요청을 라우팅하지만, 이제 로컬 디스크가 캐시 역할만 하는 일회성 가상 복제본으로 보낸다. Git 팩은 Azure Blob Storage에 저장되고, 참조는 각 갱신을 쿼럼으로 승인하는 복제 로그인 Ref-CAS(Reference Compare-and-Swap)에 저장된다. 모든 데이터를 블롭에 저장하던 초기 프로토타입은 초당 수백 건의 쓰기가 한계였지만, Ref-CAS는 수만 건을 처리한다. Rubicon은 제한된 비공개 미리보기 단계이며, 내년 초 더 넓게 배포될 예정이다.
🔗 GitHub의 새로운 Git 저장소 아키텍처 내부 살펴보기
팀용 Copilot: API로 코드 리뷰 제어, Slack과 Teams에서 @GitHub 정식 출시
REST 및 GraphQL API로 Copilot 코드 리뷰 설정, 요약은 더 간결하게
11월 6일 — GitHub는 10월 API를 통한 리뷰 시작 기능을 제공한 데 이어, REST 및 GraphQL API로 기업부터 저장소까지 Copilot 코드 리뷰 설정을 조회하고 수정할 수 있도록 했다. 응답에는 Copilot이 작성한 내용, 사용한 추론 수준, 출처로 인용한 스킬과 MCP 서버 및 지침도 표시된다.
| 설정 수준 | API로 설정할 수 있는 항목 |
|---|---|
| 기업 | 모든 조직의 리뷰를 활성화하거나 비활성화하거나, 조직이 선택하도록 허용 |
| 조직 | 기업 설정을 덮어쓰지 않는 범위에서 활성화 여부, 기본 추론 수준, 러너 설정 |
| 저장소 | 추론 수준, 사용자 지정 지침 및 MCP 도구 사용 여부 |
제한 사항도 있다. 기업 및 조직 엔드포인트는 GitHub Apps와 세분화된 개인 액세스 토큰(fine-grained PAT)을 허용하지 않으며, 저장소 엔드포인트만 이를 허용한다. 요약 댓글은 더 간결해진다. 추론 수준과 설문은 하단으로 이동하고, “검토하지 않은 파일” 섹션은 하나로 통합된다. 리뷰 세션에는 사용한 AI 크레딧이 표시되며, Balanced 추론 수준에서는 세 개의 모델이 리뷰하고 다른 모델 하나가 그 결과를 종합한다. 실패한 리뷰는 한 번 재시도하며, 다른 모델로 전환할 수도 있다. Pro, Pro+, Max, Business 및 Enterprise 요금제에 제공된다.
🔗 Copilot 코드 리뷰: API 관리 및 리뷰 개요 업데이트
Slack과 Microsoft Teams에서 @GitHub 정식 출시, Teams에는 Canvas 추가
11월 6일 — 8월 21일 공개 미리보기를 시작한 @GitHub 에이전트가 Slack과 Microsoft Teams에서 정식 출시됐다. 대화에서 에이전트를 언급하면 도구를 바꾸지 않고도 버그 조사, 이슈 생성, 변경 사항 구현, 풀 리퀘스트 열기를 요청할 수 있다. 유일하게 새로 추가된 기능은 Teams의 Canvas다. 구현 계획, 코드 변경 사항, 미리보기가 대화 옆에 표시되며, 팀은 그곳에서 의견을 남기고 작업을 발전시킬 수 있다.
나머지는 사용성 조정이다. 저장소를 다시 선택할 필요 없이 메시지에서 추론하고, 후속 메시지에 응답하지 않던 문제를 수정했으며, 대화에서 생성한 이슈와 풀 리퀘스트에는 요청한 사람의 이름이 표시된다. 페이지에는 대상 요금제나 사용량 수치가 명시되어 있지 않다.
🔗 Slack과 Teams에서 @GitHub 정식 출시 및 추가 업데이트
단신
코딩 에이전트 및 도구
- Copilot CLI 1.0.108-0 및 1.0.108-1 — 정식 버전 1.0.107 출시 다음 날인 11월 7일에 공개된 두 가지 사전 출시 버전이다. 해당 조건을 충족하는 저장소에서 /index 명령과 공유 tgrep 인덱싱이 기본으로 활성화되고, CLI가 자체 문서를 바탕으로 자신의 작동 방식에 관한 질문에 답하며,
--allow-all-tools사용 시에도 MCP 거부 규칙이 적용되도록 하는 등 72건이 수정됐다. 🔗 출처 - Qwen Code v0.27.0 — v0.26.9 출시 다음 날인 11월 7일에 공개된 정식 버전으로, 호환성을 깨는 변경은 없다. 로컬 세션의 훅을 위한 FileChanged 알림, 채널용 GitHub 저장소 이벤트 필터(허용 및 차단), Managed Agent 하위 에이전트들의 동시 질문 등 73개 항목이 포함됐다. 🔗 출처
- Antigravity 원격 에이전트 — 하나의 프로젝트에서 GitHub 저장소와 Google Drive 폴더를 함께 읽고 쓸 수 있다. 웹에서 시작한 작업은 앱에서 이어서 진행할 수 있고, 휴대전화에서 권한을 허용할 수 있다. 게시물에서는 모든 유료 개인용 요금제를 언급하지만, 문서에서는 Google AI Pro와 Ultra를 명시하며 Google AI Plus와 업무용 계정은 제외한다. 🔗 출처
- Replit Agent의 고객 지원 — 지원 관련 질문을 받으면 Agent는 대화를 벗어나지 않고 먼저 현재 발생 중인 장애, 문서, 플랫폼의 알려진 제약을 확인한다. Pro 요금제에서는 문제가 지속될 경우 환경의 디버깅 세부 정보를 첨부해 직접 지원 요청을 제출한다. 🔗 출처
- OpenAI Developers의 Showcase — OpenAI Developers 플러그인에 Showcase 탭이 추가됐다. Codex에서 열 수 있는 API 시작용 프로젝트로, 에이전트, 창작 도구, 데이터 시각화, 음성 등을 다룬다. API demos 페이지에는 프로젝트 열두 개가 소개돼 있으며, 그중 여덟 개는 Codex에서 바로 열거나 다운로드할 수 있다. 🔗 출처
GitHub Copilot
- GitHub Copilot 앱 업데이트 요약 — 11월 6일 주간 요약에서는 앱의 새로운 기능을 자세히 소개했다. 풀 리퀘스트에서 설정하고 검사가 대기 중인 동안에도 유지되는 Agent Merge, 컨텍스트 한도에 도달했을 때의 대화 압축, CSV와 TSV의 표 형식 열기, 참여에 동의한 사용자를 위한 승인 보조용 개인 지침이 포함된다. 🔗 출처
- Copilot impact dashboard — 대시보드가 추적하는 Copilot 사용 경험이 일곱 가지에서 아홉 가지로 늘었으며, Copilot Chat과 VS Code의 Agents 창이 추가됐다. « 수동적 사용자 » 집단의 이름은 « 채팅 우선 사용자 »로 바뀌지만, 도입 단계와 집단 규모는 달라지지 않는다. 🔗 출처
- 일주일 동안 커밋 12억 건 — 닉 리펜과 필립 홀러런이 작성한 에이전트 기반 엔지니어링(에이전트 엔지니어링) 안내서에서 GitHub는 10월 중 한 주 동안 12억 건이 넘는 커밋을 기록했으며, 이는 1년 전보다 400 % 이상 증가한 수치라고 밝혔다. 새로운 제품 발표는 없다. 🔗 출처
추론, 순위 및 개방형 모델
- Together Compiler — 11월 4일 공개된, 고객별 커널을 지속적으로 최적화하는 Together AI 에이전트가 새로운 수치 하나를 제시했다. Together AI에 따르면 이미 수작업으로 최적화한 서버 없는(서버리스) 엔드포인트에서 중앙값 기준 초당 토큰 수가 +12~+20 % 증가했다. 🔗 출처
- Fireworks의 MiniMax M3.1 Flash — MiniMax는 게시물을 통해 M3.1 Flash를 Fireworks AI에서 사용할 수 있다고 발표하며, 11월 10일 샌프란시스코에서 열리는 저녁 행사에 초대했다. 가격이나 처리량은 명시하지 않았다. 🔗 출처
- Construction AI Leaderboard — ONESTRUCTION이 도면, BIM 모델, 비용 추정, IDS 생성 등 다섯 가지 벤치마크의 평균을 기준으로 건설 분야 모델 순위를 공개했다. Claude Opus 5.5가 73.7점으로 Gemini 4 Argon(73.6)을 0.1점 차로 앞섰으며, Claude Opus 5(72.7)와 GPT-6.1 Sol(70.2)이 뒤를 이었다. 개발사 자체 측정치다. 🔗 출처
- kniv v7.1 — Dragonscale은 11월 2일 소개한 추출 인코더 여섯 개를 재학습 없이 개선했다고 밝혔다. Claude Code에서 Claude Opus 5.5가 동일 지시 처리의 선행 표현 수가 50개로 제한된 점을 찾아냈고, ONNX 그래프에서 이를 100개로 늘렸다. 여섯 모델 모두 동일 지시 처리 성능이 향상됐으며 계산 속도도 7~16 % 빨라졌다. 🔗 출처
개방형 로보틱스
- Hugging Face의 로보틱스 — 클레망 들랑그에 따르면 Hub에는 약 10만 개의 공개 로봇 데이터셋(+48 %)과 3만 개 이상의 모델(+41 %)이 있으며, LeRobot은 다운로드 100만 회를 넘어섰다. Microduck과 Reachy Mini는 연말까지 판매량 5만 대와 배송량 2만 대를 넘어설 가능성이 높다고 한다. 🔗 출처
- FiftyOne의 HapTile — 하프리트 사호타(Voxel51)가 HapTile 데이터셋을 FiftyOne용으로 변환했다. 원격 조작 UR5e 로봇 팔의 에피소드 1,699개와 12.36시간 분량으로, 젤 기반 촉각 센서, RGB-D 카메라 두 대, 조작자가 느끼는 햅틱 피드백 수준을 포함하며 CC BY 4.0 라이선스로 제공된다. 🔗 출처
기업 및 활용 사례
- Harper와 Grok Bot — 11월 5일 보험 중개사 Harper는 이메일이나 기한을 계기로 작동하며 내부 업무를 처리하는 Grok Bot 기반 앰비언트 에이전트를 소개했다. Harper에 따르면 그중 하나는 9월부터 소기업 200곳 이상이 자금 제공 기관과의 업무를 최신 상태로 정리하도록 도왔으며, 취소는 한 건도 없었다. 🔗 출처
- Replit과 Plaid — Replit은 동영상이 첨부된 게시물에서 금융 계좌를 연결하는 Plaid 커넥터를 소개했다. 이를 통해 코드 작성 없이 Agent가 사용자의 자금과 관련된 도구를 만들도록 할 수 있다. Plaid는 이를 주제로 Replit 사장 미켈레 카타스타와의 인터뷰를 공개했다. Replit 문서에 따르면 이 커넥터는 팀 작업 공간이 있는 유료 요금제에서만 사용할 수 있으며, 관리자가 Plaid 인증 정보를 한 번 설정하면 잔액, 거래 내역, 투자 내역에 접근할 수 있다. 🔗 출처 · 🔗 문서
- Perplexity의 접근성 안내서 — Perplexity가 장애인을 돕는 AI와 AI 도구 자체의 접근성을 다루는 안내서를 공개했다. 자체 제품이나 수치를 제시하지는 않았다. 안내서는 별도 지시 없이 생성한 페이지의 12 %가 자동 검사를 통과한 반면, 모델이 자신의 코드를 테스트하고 수정했을 때는 86 %가 통과한 Microsoft 실험을 인용한다. 🔗 출처
이것이 의미하는 바
음성이 에이전트의 인터페이스로 자리 잡으면서 반복되는 구조가 나타나고 있다. 전면에서는 모델이 대화하고, 뒤에서는 에이전트가 작업한다. MOSS-Live는 두 모델 사이에 조정 계층을 두는 방식을 시스템의 핵심으로 삼았고, Antigravity는 Cursor가 음성 채팅을 공개한 바로 그날 앱과 터미널에 이 구조를 도입했다. 한계도 분명하다. Antigravity는 음성 모드를 한 번에 하나의 로컬 대화로 제한하고 파괴적 작업에는 클릭 조작을 유지한다. MOSS-Live는 가중치와 라이선스를 공개하지 않았으며, 자체 평가 점수에서도 τ-Voice의 다중 턴 작업에서 GPT-Live-1에 뒤처진다.
인프라도 에이전트의 부하에 맞춰 조정되고 있다. GitHub는 순간적으로 몰리는 쓰기 요청이 앞으로 지속적인 흐름이 될 것에 대비해 Rubicon의 규모를 조정하고, 단일 저장소에서 에이전트 5,000개를 테스트하며, 10월 중 한 주 동안 12억 건이 넘는 커밋을 집계했다. 같은 변화가 업무 구성에도 나타난다. Copilot의 코드 검토는 다른 인프라 정책처럼 기업부터 저장소 수준까지 API로 설정할 수 있고, @GitHub는 팀들이 이미 수정할 내용을 논의하는 Slack과 Teams에 들어서고 있다.
성능 향상은 소프트웨어에서도 나온다. CUDA 13.5는 Vera Rubin 지원을 정식 제공 단계로 전환하고 cuSPARSE 같은 라이브러리를 가속한다. Reshard는 강화 학습에서 가중치 전송을 2.75.7배 빠르게 하며, 여러 최적화를 함께 적용하면 단일 B200에서 FLUX 3 Image Klein의 속도가 최대 4.45배 빨라진다. Together AI도 커널을 지속적으로 최적화하는 에이전트를 통해 중앙값 처리량이 1220 % 증가했다고 주장한다. 이 수치는 모두 개발사들이 자체 구성에서 측정한 결과다.
출처
- MOSS-Live (Hugging Face 블로그, OpenMOSS)
- MOSS-Live 문서 (MOSS 플랫폼)
- Antigravity의 음성 모드 (Antigravity 블로그)
- @antigravity의 음성 모드 발표
- Antigravity 음성 모드 문서
- NVIDIA CUDA 13.5, NVIDIA Vera Rubin 정식 지원 (NVIDIA)
- Reshard 집합 통신으로 강화 학습 가중치 재적용 가속화 (NVIDIA)
- NVIDIA/nccl-extensions 저장소
- NVIDIA Blackwell GPU에서 FLUX 3 Image Klein으로 이미지 생성 가속화 (NVIDIA)
- GitHub의 새로운 Git 저장 아키텍처 내부 (GitHub 블로그)
- @github: X 아티클로 소개한 Rubicon
- Copilot 코드 검토: API 관리 및 검토 개요 업데이트 (GitHub 변경 기록)
- Slack과 Teams의 @GitHub 정식 출시 및 기타 소식 (GitHub 변경 기록)
- Copilot CLI 1.0.108-0
- Qwen Code v0.27.0
- 원격 에이전트에 관한 @antigravity의 게시물 모음
- Replit 11월 6일 변경 기록
- OpenAI Developers 플러그인의 Showcase (@OpenAIDevs)
- GitHub Copilot 주간 출시 소식, 11월 2일 (GitHub 변경 기록)
- Copilot impact dashboard에 채팅 및 VS Code 에이전트 사용량 추가 (GitHub 변경 기록)
- 코드 생성을 넘어: 개발자를 위한 에이전트 엔지니어링 안내서 (GitHub 블로그)
- Together Compiler (@togethercompute)
- Fireworks AI의 M3.1 Flash (@MiniMax_AI)
- Construction AI Leaderboard (Hugging Face 블로그, ONESTRUCTION)
- kniv v7.1 (Hugging Face 블로그, Dragonscale)
- Hugging Face의 개방형 로보틱스 (@ClementDelangue)
- FiftyOne의 HapTile (Hugging Face 블로그)
- 앰비언트 에이전트 (Harper Engineering)
- Replit과 Plaid (@Replit)
- Plaid 커넥터 (Replit 문서)
- AI 접근성 (Perplexity)