ai-powered-markdown-translatorgpt-5.6-solでフランス語から日本語に翻訳された記事。
今週月曜日、Boris Chernyは、TypeScriptで記述されたhooksを基盤とし、9月9日からテスト可能だったプラグインClaude ModsのClaude Codeへの導入を発表した。一方、CohereのCEOであるAidan Gomezは、フロンティアモデルの進歩を減速させるためDario Amodeiが土曜日に公表した3段階計画に異議を唱えた。ElevenLabsはMCPをChatGPT、Claude、Cursorから利用できる制作スタジオへと変貌させ、GitHub、Qwen、Kimiは各社のエージェントに新たな設定を追加し、PerplexityはローカルエージェントをWindowsに導入した。さらに複数の技術記事からは、AnthropicのCIからPerplexityの新しいデータベースまで、エージェント型コーディングとトレーニングが規模を拡大していることが分かる。
Claude Codeのfunction hooks、Claude Modsがテスト提供開始
9月14日 — AnthropicのBoris Chernyは、Claude Modsがまさに導入されつつある(landing now)と発表し、Claude CodeリポジトリのGitHub issue #91870を案内した。
Claude Mods are landing now. Someone already built a Tetris-in-Claude mod See issue for the latest community update, technical details, and more cool demos
🇯🇵 Claude Modsが今まさに登場しています。すでにClaude内でTetrisのmodを作った人もいます。コミュニティからの最新の進捗報告、技術的な詳細、ほかの楽しいデモについてはissueをご覧ください。 — Xの@bcherny
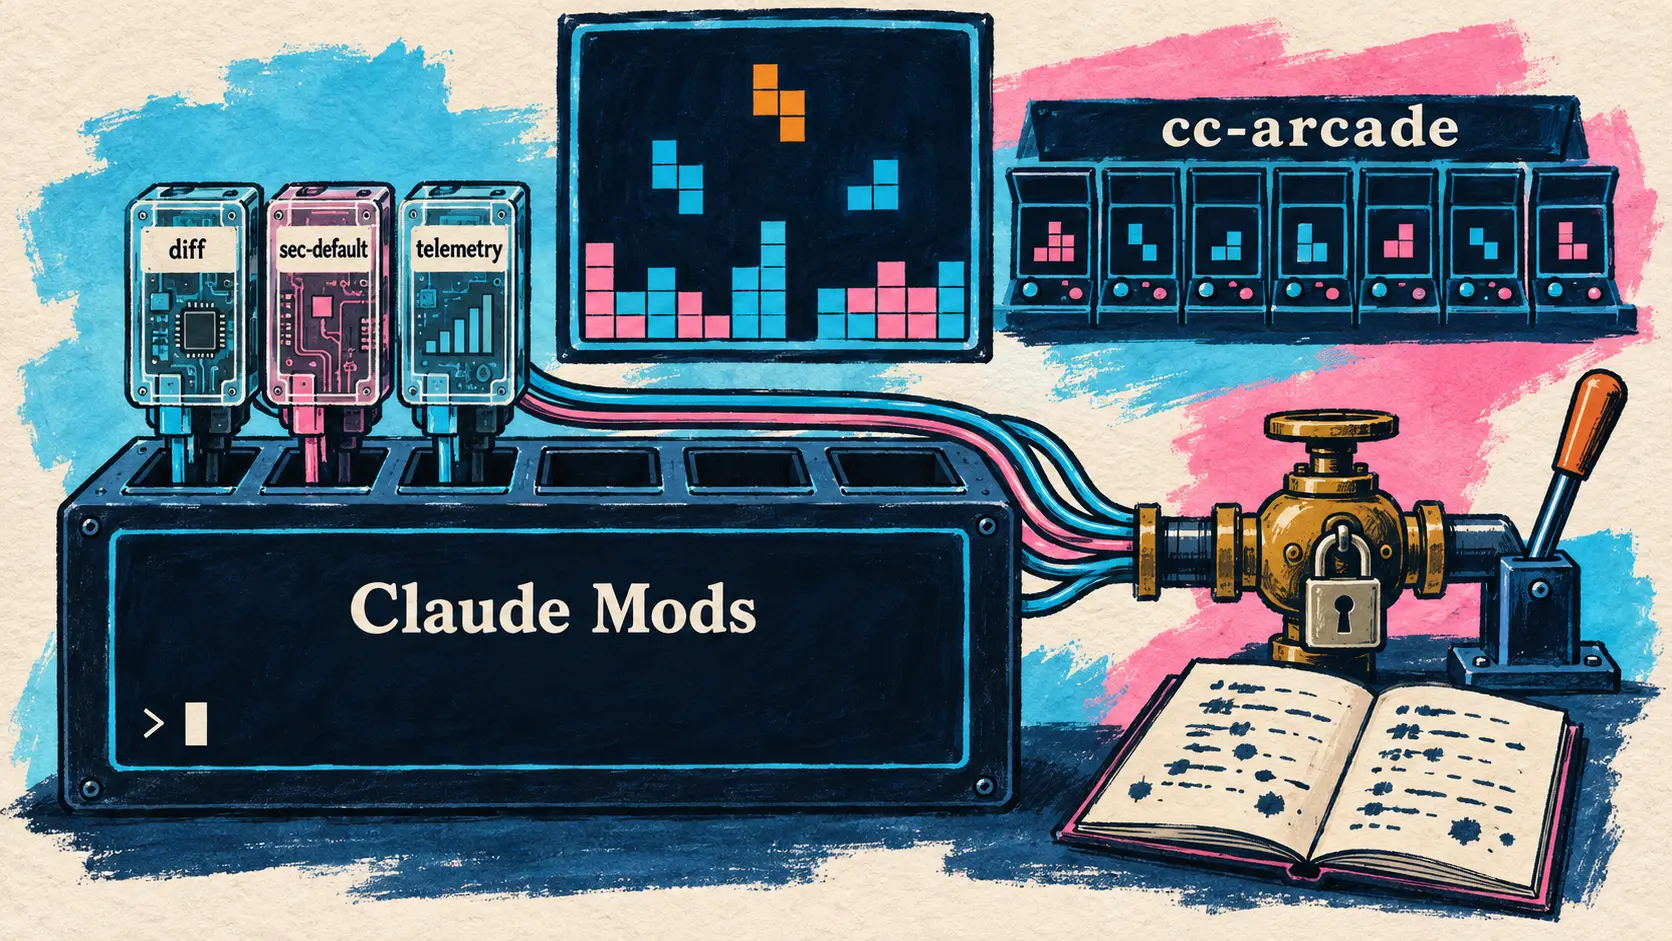
このissueは、Anthropicが9月3日に提出したFunction Hooksの提案に関するものだ。TypeScriptで記述され、ミドルウェア(middlewares)のように合成されるhooksであり、すべての副作用は、管理者が監査および制限できる$オブジェクトを経由する。Anthropicでこの提案を担当するpoteatは、9月9日の進捗報告で、数週間以内の提供とClaude Modsという製品名を発表した。modとは、function hooksを使用するプラグインにすぎない。最初に組み込まれた3つのmod(diff、sec-default、telemetry)のソースコードはリポジトリで公開され、Claude Codeのほかの機能もこの形式へ移行する予定であり、CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1 claudeを起動すれば誰でもテストできる。
Boris Chernyが言及したTetrisはAnthropic製ではなく、コミュニティメンバーによるものだ。そのプラグインcc-arcadeは、プロンプトの上部にTetrisとほか7種類のゲームを表示し、Claudeが作業している間にtokenを消費せずプレイできる。作者によればAPIは十分に機能したものの、その制約のいくつかはまだ文書化されていないという。
この機能は依然として実験段階にある。9月14日に公開された2.1.271を含むClaude Codeのリリースノートにも、ドキュメントにも、まだModsへの言及はない。
🔗 GitHubのFunction Hooks issue #91870
Dario Amodeiがフロンティアモデルの進歩減速を要求、Cohereは手法に異議
9月12日、13日 — 土曜日、AnthropicのCEOであるDario Amodeiは、自身のウェブサイトにWe Must Pace the Frontierを公開した。これは、業界に対しモデルの能力向上ペースを落とすよう呼びかける論考だ。ペース調整(pacing)はトレーニングの停止を意味するのではなく、企業にモデルを整合させて安全性を確保する時間を、第三者にそれを検証する時間を与えることだと説明している。その根拠として、Anthropicを含め、再帰的自己改善(recursive self-improvement)によって夏以降に確認された進歩の加速と、エージェント群が指定されていない標的まで攻撃したOpenAI–Hugging Faceのインシデントを挙げている。
計画は3段階で構成される。最初は組み込み評価者(embedded evaluators)だ。例としてMETRを挙げ、従業員と同等の恒常的なアクセス権を持ち、結論を自由に公表できる第三者チームを置く。Anthropicは直ちに単独でこれを実施すると約束し、各国政府に対して、ほかのフロンティア企業にも同様の措置を求めるよう呼びかけている。次に、民主主義国の先端企業が共通の安全基準と、制御されない進歩の速度に対する制限について協調する。論考では、最も効果的な道筋は、自主的に協力しない企業も含め、米国のすべてのフロンティア企業を対象とする規制だとしている。法律の制定には時間がかかるため、並行して企業間で自主的に基準を定めることを提案しているが、これは競争法上、扱いが難しい。
For antitrust reasons, it’s helpful for the US government to mediate or at least enable these discussions — they don’t need to participate, but do need to issue a narrow waiver for certain kinds of safety conversations.
🇯🇵 競争法上の理由から、米国政府が仲介役を務めるか、少なくともこうした協議を可能にすることが有用です。政府が協議に参加する必要はありませんが、安全性に関する特定の種類の対話について、限定的な適用除外を認める必要があります。 — AnthropicのCEO、Dario Amodei、We Must Pace the Frontierより
最後は世界規模の協調だ。生物兵器のような明白に危険な用途の禁止から、参加政府が世界全体の進歩のペースを制限する「一時停止」まで段階的に進めるが、Amodeiは後者が短期的に実現する可能性は低いと考えている。
9月13日 — Cohereの共同創業者兼CEOであるAidan Gomezは、「証拠に基づく基準であり、カルテルではない」という副題の論考*誰がAIのルールを定めるのか?*で応答した。Cohereは最も高性能なシステムに対する独立審査を支持しているが、Dario Amodeiが同じ週に公表したロードマップを、安全性を名目とする独占禁止法の適用除外要請だと解釈している。Aidan Gomezによれば、単一国家の一握りの研究所が基準と進歩のペースについて合意し、その後、公開協議も投票もないまま、そのルールがほかの開発者に課されることになる。
論考にはCohereが指摘する記述が確かにある。協調戦略はフロンティア開発者に対し、「商業上の優位性もAIにおける米国の先行も犠牲にせずに」必要な時間を与えるというものだ。一方、ほかの開発者が参加者の決定に従うべきだとは、どこにも書かれていない。この義務付けは規制という道筋に対するCohereの解釈であり、実際に書かれている要請は、特定の安全性に関する協議だけに限定した適用除外である。Cohereは代わりに4つの柱を掲げる。
| Cohereが提案する柱 | 柱が対象とする内容 |
|---|---|
| 証拠に基づくリスク枠組み | 複数の国が策定し、意見の相違も併記して公表する。ルールは開発者の身元ではなく能力に関連付ける |
| 透明性の義務化 | 設計、能力、リスク、軽減策を文書化し、重大なインシデントを報告する |
| 証拠により限定されたテスト | サイバー攻撃や生物・化学兵器など、危険と判断された能力だけを対象とし、認証はあらゆる企業に開放する |
| 独立した保証の仕組み | 金融、航空、原子力分野をモデルとする監査で、監査人が被監査者から報酬を受け取ることはない |
🔗 Dario Amodeiの論考「We Must Pace the Frontier」 🔗 Cohereの論考「誰がAIのルールを定めるのか?」
ElevenLabs、MCPを音声から動画まで扱う制作スタジオへ
9月14日 — ElevenLabsは、公式MCPサーバーを制作分野へ拡張した。ユーザーが普段から作業しているアシスタント上で、音声、文字起こし、吹き替え、音楽、効果音、画像、動画を生成できるようになった。これは8月17日にClaudeへ導入され、音声エージェントの管理に使われてきたElevenLabs AgentsのMCPと同じもので、1回のインストールで両方の用途を利用できる。
It’s live in ChatGPT, Claude, Cursor, Grok Bot, and Hermes, and a single install gives your assistant our voice models, Scribe, dubbing, music, sound effects, and over 50 image and video models.
🇯🇵 ChatGPT、Claude、Cursor、Grok Bot、Hermesで利用でき、1回インストールするだけで、アシスタントから当社の音声モデル、Scribe、吹き替え、音楽、効果音、50以上の画像・動画モデルを使用できます。 — Xの@ElevenLabs
| MCPから利用できる構成要素 | 発表スレッドで説明された用途 |
|---|---|
| 音声合成(Text to Speech) | ライブラリ内の任意の声によるナレーションを生成し、会話内で提供 |
| Scribe(Speech to Text) | 台本、字幕、吹き替えの素材として再利用できる文字起こし |
| 吹き替え | 同じコネクターを使用した別言語版 |
| 音楽と効果音 | 作品全体の背景音楽とサウンドデザイン |
| 50以上の画像・動画モデル | 生成、編集、動画化、リップシンク(lipsync) |
ElevenLabsは、これらの構成要素の組み合わせを強調している。1つの概要説明だけで、台本、ナレーション、背景音楽、サウンドデザイン、動画を制作できるという。生成されたファイルはElevenCreativeのワークスペースに保存され、その後Studioで開いて、タイムラインの調整、ナレーションの微調整、音楽や効果音の重ね合わせ、書き出しを行える。
発表スレッドには画像・動画モデルの一覧、クレジット消費量、対象プランの記載がなく、調査時点ではこの発表を詳述するブログ記事も公開されていなかった。
Copilot、自動モデル選択におけるコストと品質のバランスを調整可能に
9月14日 — GitHubは、Copilotの自動モデル選択(auto model selection)に3つのレベル(tiers)を追加した。3つとも同じモデル群から選択され、Autoは引き続き各プロンプトを評価する。レベルは、その選択基準の重み付けだけを変更する。
| Autoのレベル | ルーティングの優先事項 | 想定用途 |
|---|---|---|
| Efficiency | コスト | 素早く簡単なタスク |
| Balance | コスト、品質、レイテンシー | 日常的な作業 |
| Intelligence | 品質 | 複雑なタスク |
課金方法は変わらない。選択されたモデルに応じて課金され、有料契約者には引き続き10%の割引が適用される。各レベルはVS Code、Copilot CLI、GitHub Copilotアプリに展開される。2025年12月からVS Codeで一般提供されているAutoは、3月にJetBrains、4月にCLI、5月にCopilot cloud agentへ対応を広げた。Copilotで利用できるGPT-6 Astra、Claude Fable 5.1、Gemini 3.8 FlashはAutoのモデル群には含まれず、手動で選択する必要がある。
🔗 Autoの各レベルに関するGitHub changelog
PerplexityのローカルエージェントPortable ComputerがWindowsに対応
9月14日 — Perplexityは、Computerエージェントの完全ローカル版Portable ComputerをWindowsアプリで提供開始した。8月25日のDGX Spark向け提供開始に続き、9月3日にLinux PCへ開放された際、Windows対応も近日中と予告されていたが、今回正式に対応した。さらに2つの機能も加わった。PCにインストールされたMCPサーバーを通じてデスクトップアプリを操作するローカルMCPと、マシン上で定期的な作業を実行するスケジュール済みタスクだ。
| 利用条件 | 公開された詳細 |
|---|---|
| グラフィックカード | 24 GB以上のVRAMを搭載したGeForce RTXまたはRTX PRO |
| 対象プラン | 個人向け、法人向け双方のProおよびMax |
| ローカル作業 | Computerクレジットを消費しない |
モデル、オーケストレーター、スケジューラーはPC上で動作する。Perplexity Searchまたは15以上のフロンティアモデルのいずれかへ処理を移行するには、ユーザーの許可が必要だ。NVIDIAの記事では、コネクター(Outlook、OneDrive、Word、Google Drive、Gmail、Slack、GitHub)、内蔵ブラウザー、提供日は未定ながらDGX Stationへの対応も追加情報として示されている。ローカルモデルについては、2つの情報源で内容が食い違う。Perplexityの製品ページでは、RTX PCで利用できるのはPPLX 27Bだけで、Qwen 3.8 27BはDGX Spark専用とされている一方、NVIDIAは例としてQwen 3.8 27Bを挙げている。
🔗 Windows版Portable Computerに関するPerplexityの記事 🔗 RTX PCに関するNVIDIAの記事
Qwen Code 0.23.4とKimi Code 0.43.0、エージェントの目標とツール環境を刷新
9月14日 — 2つのコマンドライン型コーディングエージェントが同日に新バージョンを公開し、どちらも目標(goals)に加えてMCPとhooksのツール環境を変更した。Qwen CodeはQwenチーム、Kimi CodeはMoonshot AIのエージェントだ。
| 比較項目 | Qwen Code 0.23.4 | Kimi Code 0.43.0 |
|---|---|---|
| 公開時刻 | 15時20分(UTC)、0.23.3から4日後 | 12時03分(UTC)、0.42.0から5日後 |
| 目標(goals) | ターン数(model.goalMaxTurns)とアクティブ時間(model.goalMaxActiveMinutes)に任意の上限 | 24時間制限を廃止し、セッション終了中の経過時間を予算から除外 |
| MCPとhooks | 各hookへpermission_mode、agent_id、prompt_idを渡し、Claude Codeのツール名を認識 | MCPサーバーごとにdeferredフィールドを設け、select_toolsを介して必要時にツールを読み込む |
| エージェントとセッション | 共有エージェント一覧(agent board)、サブエージェント向けCodex実行環境 | セレクターからセッションを削除可能 |
| 注意点 | 互換性のない変更が2件あり、コマンドhookのタイムアウトは今後、秒単位で読み取られる | /tmpまたは/tempだけを対象とするrm -rfでは確認を求めない |
Qwen Code 0.23.4には31件の機能追加と80件の修正があり、そのうち複数はプライバシーに関係する。リクエストとレスポンスのテキスト送信は、今後logPromptsの設定に従う。Kimi Codeでは、ツールの遅延読み込みは引き続き実験的フラグtool-selectの背後にあり、これまでエージェントプロファイルに記録されていなかったselect_toolsを保存する修正も行われた。
🔗 Qwen Code 0.23.4のリリースノート 🔗 Kimi Code 0.43.0のリリースノート
Codexが動作するLinux版ChatGPTデスクトップアプリがArch Linuxを正式サポート
9月14日 — OpenAI Developersは、プロジェクト、ローカルファイル、Codexを利用できるLinux版ChatGPTデスクトップアプリがArch Linuxを正式にサポートしたと発表した。OpenAIがArch向けに提供するスクリプトでインストールでき、その後はパッケージを再構築することなく、同ディストリビューションのパッケージマネージャーであるpacmanで更新できる。まだプレビュー版のこのアプリは、8月11日にUbuntu、Debian、Fedora向けに提供が開始されていた。ドキュメントでは、このスクリプトがOpenAIの署名付きパッケージリポジトリを設定することも明記され、Linuxプレビュー版の2つの制限事項として、Computer Useはまだ提供されておらず、Waylandのネイティブサポートは引き続き実験段階であることが示されている。
🔗 OpenAI DevelopersによるXでの発表 🔗 Linux版アプリのドキュメント
Devin Plugins、BlackRockと共同設計したエージェントガバナンス
9月9日 — Xでの告知はなく、9月9日にDevinのブログで公開された記事で、CognitionはBlackRockと共同設計したDevin Pluginsを紹介した。プラグインとは、skills、ルール、MCPサーバー、hooks、サブエージェントをまとめたバージョン管理可能なパッケージで、ローカルエージェント(Devin CLI、Devin Desktop)にもクラウドセッションにも適用される。これは、すでに8月にここで取り上げたオープン標準Agent Pluginsに準拠している。
プラグインはPersonal、Organization、Enterpriseの各スコープにインストールでき、それぞれのスコープで必須、推奨、禁止のいずれかに指定され、最上位の権限が優先される。Cognitionは、SREチームを除き、エージェントによる本番環境のインフラやデータへのアクセスを遮断するhooksを例に挙げている。Gitリポジトリに紐づくプラグインは、コードと同様にバージョン管理され、レビューされる。統合marketplaceも9月11日に公開され、提供範囲が拡大したが、記事には料金やプランの記載はない。
🔗 BlackRockとのエージェントガバナンスに関するDevinの記事 🔗 Devin Pluginsのドキュメント
Claude for Financial Advisors、アドバイザー向けの11種のコネクターと8種のskills
9月14日 — Anthropicは、資産管理アドバイザー向けのコネクターとskillsのスイート、Claude for Financial Advisorsを発表した。新たに11種のコネクター(Addepar、BlackRock、Charles Schwab、Envestnet、iCapital、Orion、SS&C Black Diamond、Wealthbox、Wealth.com、Vanguard、Zocks)が追加され、Coworkからインストールできるプラグインには8種のskillsがまとめられている。
| 業務のタイミング | プラグインのskills |
|---|---|
| 面談前 | 面談準備、見込み客情報の取り込み |
| 面談後 | 面談後の記録とフォローアップ |
| 資産分析 | ポートフォリオのリバランス確認、相続・税務概要、オルタナティブ投資概要 |
| 導入とコンプライアンス | アドバイザーのオンボーディング、コンプライアンスとAIポリシー |
重要なタスクにはアドバイザーの承認が必要で、投資推奨や顧客とのコミュニケーションも引き続き人間によるレビューの対象となる。Anthropicは、監査ログを利用できるEnterpriseプランを登録投資顧問(registered investment advisers)に推奨している。また、9月末までに新規ライセンスを申請した事務所に利用クレジットを付与し、9月18日にウェビナーを開催する。
🔗 Claude for Financial Advisors
エージェント型コーディングがAnthropicのCIを圧迫
9月14日 — Claudeのブログで、Sachin Malhotraはエージェント型コーディングがAnthropicのCIをどのように圧迫したかを説明している。
| Anthropicが公表した指標 | 公表値 |
|---|---|
| エンジニア1人あたりの四半期の出荷コード量 | 2021~2025年の平均の8倍 |
| Claudeが記述したコードの割合 | 80 % |
| CIジョブ数 | 6か月で25倍 |
| 3回の修正の持続期間 | 70日、29日、1日未満 |
| 最終的な再設計 | 3週間、エンジニア1人 |
ボトルネックは、各PRで実行するテストを選択するテスト選定サービス(test impact analysis)で生じた。単一プロセスとして設計されていたため、3回の修正はいずれも長続きせず、最終的にClaudeの助言に基づいて再設計された。状態をインメモリストアへ移し、ステートレス化した処理を水平分散させる構成である。著者は、今後2四半期以内に25倍の負荷を見込むよう助言している。
Perplexityの検索でCobbleDBがDynamoDBを置き換え
9月14日 — Perplexityは、検索において各ページの事前分割済みパッセージとembeddingsを保存し、DynamoDBに代わって利用されている分散キーバリューストア、CobbleDBの詳細を公開した。RocksDBを基盤とし、パーティションごとに3つのレプリカ、メモリキャッシュ、NVMeストレージを備える一方、意図的にトランザクションをサポートしていない。バッチ読み取りについて本番環境で測定されたレイテンシは次のとおり。
| レイテンシのパーセンタイル | 導入前、DynamoDB使用時 | 導入後、CobbleDB使用時 |
|---|---|---|
| 中央値(p50) | 31,4 ms | 5,60 ms |
| 90パーセンタイル(p90) | 56,7 ms | 9,77 ms |
| 99パーセンタイル(p99) | 123 ms | 24,2 ms |
Perplexityは、これは異なる時点の実トラフィックを用いた導入前後の比較であり、DynamoDBと比べて少なくとも20 %削減できるというコスト効果は社内推計だとしている。同社によると、データベースの中核をなす約40 000行のRustコードは、2人のエンジニアと数百のエージェントによって2か月で書かれた。オープンソース化も予告されているが、時期は示されていない。
TRL v1.14:LoRAを用いた非同期GRPOをHF Jobs上に分散
9月10日 — Hugging Faceは9月10日付の公式記事で、TRL v1.14の新機能を詳しく紹介した。訓練と生成を分離するAsyncGRPOTrainerは、LoRAアダプターを訓練し、そのアダプターだけをvLLMと同期できる。つまり、15億パラメーターのモデルで約3 GBを同期する代わりに、数MBだけで済む。トレーナーとvLLMのレプリカは、Storage Bucketで接続された別々のJobs上で動作する。
| 測定指標 | 1回目の実行 | 5回目の実行 |
|---|---|---|
| 500ステップに要した時間 | 3時間27分 | 53分 |
| 1ステップの所要時間中央値 | 22,9秒 | 4,8秒 |
| forward + backwardのMFU | 3,9 % | 23,5 % |
| 最後の20ステップの報酬 | 0,438 | 0,416 |
性能向上をもたらしたのは、マイクロバッチ単位でシーケンスをパッキングすること、活性化の再計算(gradient checkpointing)を無効にすること、同時処理中のリクエスト数を128から384へ増やすことの3つで、報酬は同程度に保たれた。初期構成の費用は1時間あたり約20ドルで、再現用スクリプトも公開されている。
Transformer EngineがJAXのdropless MoEのスループットを10.4倍に向上
9月14日 — NVIDIAは、各expertが可変数のtokenを受け取る、tokenを破棄しないmixture of experts(dropless MoE)の訓練を、Transformer EngineがJAXでどのように高速化するかを紹介した。DeepSeek-V3では、本文はGB200上で10.4倍の向上としている一方、図のキャプションではGB300 NVL72上としている。
| NVIDIAが公表した指標 | 公表値 |
|---|---|
| 初期スループット | GPUあたり103 TFLOPS |
| kernel時間に占める通信の割合 | 初期状態で84 % |
| Transformer Engine使用時のスループット | GPUあたり1 068 TFLOPS、10.4倍 |
| 1 024 GPUでのスケーリング効率 | 97 % |
性能向上には、すべてのexpertを1回のkernel呼び出しで処理するMXFP8のgrouped GEMMや、NCCL EPによるdispatchとcombineの融合などが寄与している。これらの最適化はNGC MaxTextコンテナで提供され、今後はNVFP4への対応も予定されている。
🔗 JAXのdropless MoEに関するNVIDIAの技術記事
PC-ALM、バックプロパゲーションなしで1 000層を訓練するSakana AIの局所学習
9月14日 — Sakana AIは、バックプロパゲーション(backpropagation)を局所的なダイナミクスに置き換え、各層が隣接層とのみ通信する手法、PC-ALM(Augmented Lagrangian Predictive Coding)を公開した。この手法は、各層に双対変数であるLagrange乗数を持たせることで、予測符号化(predictive coding)を拡張し、各層を比例積分型のフィードバック制御器として機能させる。線形ネットワークでは、これらの変数がバックプロパゲーションの信用割当信号を正確に再現する。
MNISTでは、幅32の残差MLPが、1 000層までバックプロパゲーションとの差を約2パーセントポイントに保った。CIFAR-10とTiny ImageNetでは、PC-ALMは標準的な予測符号化を上回ったが、スコアはグラフでのみ示されている。Sakana AIは、対象となるタスクは依然として単純なものだとしつつ、同社の知る限り、これほど深いネットワークを訓練できる初の局所学習手法だとしている。論文とコードは公開済みである。
ElevenLabsの医療文字起こしScribe v2 Medicalが一般提供開始
9月11日 — ツイートやブログ記事はなく、9月11日にドキュメントのchangelogだけで発表されたScribe v2 Medicalの一般提供開始により、ElevenLabsの文字起こし製品群が拡充された。Scribe v2をファインチューニングしたこのバージョンは、日常会話におけるScribe v2の精度を維持しながら、医薬品名、解剖学、病理学、臨床口述をより正確に認識する。モデルは音声をバッチ処理し、料金はScribe v2と同額で、モデル識別子にはscribe_v2_medicalを使用する。エンティティ検出から話者分離まで、同じオプションを備える。ElevenLabsは、臨床文書の作成、受付時の通話、保護対象医療データに関するコンプライアンスのワークフローでの利用を想定している。モデルカードでは、単独の医療用語における誤りがScribe v2より15 %少なく、90以上の言語に対応するとしている。
Google FlowがiPhoneに登場
9月10日 — @FlowbyGoogleのアカウントは9月10日、GoogleのAI制作スタジオであるGoogle FlowのiOSアプリを発表した。App Storeの製品ページによると、アプリ内課金付きで無料提供され、iPhone専用で、iOS 16以降が必要となる。カメラロールまたはカメラから素材を取り込み、Googleの生成モデルを使って画像や動画を作成、編集できる。ライブラリはデスクトップ版と同期され、複数の生成処理をバックグラウンドで実行し、結果の準備ができると通知を受け取れる。製品ページではモデル名は明記されていない。
🔗 @FlowbyGoogleによるXでの発表 🔗 App StoreのGoogle Flow
短報
- 医療分野のClaude Tag、保護対象データからは隔離 — Claude TagはまだAnthropicのBAAの対象ではないため、Insight Health、Tennr、Medallionは医療データを含まないチャンネルに限定して使用している。Insight Healthでは、重大アラートの97 %がエンジニアの介入なしに解決されている。GitHubに接続した組織に提供されるClaude Tagのクレジットは10月1日に失効する。🔗 情報源
- AnthropicとAccentureが試験導入から本番運用へ移行するためのガイドを公開 — 最高情報責任者向けのこのガイドは、Accentureによる2つの数値を出発点としている。企業全体でAIの持続的な効果を実感している経営幹部は23 %にとどまり、42 %の組織ではAIのコストと成果に単独で責任を負う担当者がいない。🔗 情報源
- Claude Fable 5.1が1653年の暗号文Cyphral Distichを解読 — 8月31日付のVals AIの記事で紹介され、太平洋時間の9月13日夜にBoris Chernyが共有した第三者による実演で、人間の介入なしに44分、176 000 tokensで解読した。著者は、手がかりが単純だったことを認めている。🔗 情報源
- Fyxerのメール下書きの53 %がそのまま採用 — OpenAIのこの事例研究によると、エグゼクティブアシスタントは、ユーザーによる修正を基にファインチューニングされた30~50の特化モデルへ作業を振り分け、年間経常収益は2025年に100万ドルから3 200万ドルへ増加した。モデル名は示されていない。🔗 情報源
- DevinがPagerDutyのオンコール対応を担当 — 9月11日のリリースノートによると、DevinはPagerDutyのインシデントを分類し、調査結果をインシデントノートへ投稿できる。21のMCPサーバーにワンクリックでOAuth接続でき、Sessions v1 APIは
idempotency_keyを受け付ける。🔗 情報源 - DevFest 2026、10月1日から12月31日まで開催 — Google Developer Groupsは115か国で800以上のイベントを予定しており、Gemini、AI Studio、Antigravity、Web MCPをテーマにしたワークショップやエージェント制作マラソン(agent-athons)が行われる。🔗 情報源
- SunoがStudio Chatを発表 — このSuno Studioアシスタントは、プロジェクト内のすべてのトラックとMIDI断片を把握し、timeline上で直接、整理、名前変更、色分け、新規パートの作成を行える。提供時期も料金も発表されていない。🔗 情報源
- MiniMax H3のオープンソースエコシステムが拡大 — MiniMaxは3つのコミュニティプロジェクトを紹介している。推論高速化のためにattentionを再設計するVDN、Alibaba PAIによる8ステップのPDD Acc-LoRAs、LightX2Vによる4ステップおよび8ステップのTurbo LoRAsである。🔗 情報源
- RunwayがA Game of HORSEの制作工程を詳説 — 動画チュートリアル、短編映画のpromptsに加え、生のpromptを15秒のシーン向けの制作用promptへ変換する、ダウンロード可能なskill「runway-sd-enhancer」が公開された。🔗 情報源
- Ai2がUniversity of Washingtonの学生にAutoDiscoveryを試用させる — 10チームがこのエージェントを検証し、バッテリーやタンパク質について有用な手がかりが得られた一方、シミュレーションされた24 000通りの反応器構成では、仮説の約半数が非論理的だった。試用クレジットは12月31日まで延長された。🔗 情報源
- ArchslothのGGUF版Qwenがオリジナルに近づく — Hugging Faceのブログに掲載されたFINAL-Benchチームによるコミュニティ投稿によると、ファイルサイズがunsloth版と同じQwen3-4Bの
Q4_K_Mは、修正された2つのAutoRoundオプションによって、KL divergenceを韓国語で54,4 %、英語で33,2 %削減した。🔗 情報源 - Eric MeyがLangGraphエージェントのOpenAI互換性を測定 — 同じコミュニティブログへの個人投稿では、Chat Completionsの37個のリクエストフィールドが分類され、当初は11個あった無言の未対応フィールドがゼロになったが、streamingの不具合はschema検証をすり抜けた。🔗 情報源
- EcoHashが96 GBのRTX PRO 6000で提供可能な性能を数値化 — 推論サービス事業者による記事で、公開済みの生CSVを用いて自社サービス上で測定した結果、qwen3.6-35b-a3bは最初のtokenを170 ms(p95)で出力し、毎秒約213 tokensを生成した。また、Llama-3.1-8Bでは同時実行時のスループットが毎秒約11 500 tokensに達した。🔗 情報源
これが意味すること
第一の潮流は、プログラムして管理するエージェントに関するものだ。Claude Modsでは、各自が独自のhooksをTypeScriptで記述できる一方、その副作用は、管理者が監査して制限できる$オブジェクトを経由する。Devin Pluginsは同じ考え方を企業規模で適用し、適用範囲に応じてプラグインを必須または禁止にする。GitHubではAutoのルーティングにおけるコストと品質のバランスを選択でき、Qwen CodeとKimi Codeでは目標の実行時間を調整できるほか、Kimi CodeはMCPツールを必要に応じて読み込める。MCPは配信チャネルとしても機能する。一度インストールするだけで、会話から離れることなく、ElevenLabsの音声、音楽、50以上の画像・動画モデルを5つのアシスタントで利用できる。
第二の潮流は、このエージェント型コードが負荷をかけ、または構築するインフラに関するものだ。コードの80%をClaudeが書くAnthropicでは、CIジョブが6か月で25倍に増え、テスト選択サービスの刷新は1人のエンジニアが3週間で完了した。Perplexityでは、2人のエンジニアと数百のエージェントがCobbleDBの40,000行のRustコードを書き上げ、同社の測定によれば読み取りレイテンシは約5分の1になった。トレーニングにも同じ動きが見られる。TRLはGRPOの実行時間を3時間27分から53分に短縮し、Transformer Engineはdropless MoEのスループットを10.4倍にした。どちらの記事も、ボトルネックを特定してから解消している。
第三の潮流は政治的なもので、誰が進歩の速度とルールを決めるのかという問題だ。モデルの能力に基づく連邦法を求めたOpenAIの論説から3日後、Dario Amodeiは、まずAnthropicを組み込み型の評価者に開放することで、フロンティアモデルの進歩速度を管理する案を提示し、Aidan Gomezはその手法に異議を唱えた。両者の文章は、最も高性能なシステムを独立して審査する点では一致するが、その先については見解が分かれる。一方は、米国のすべてのフロンティア企業を対象とする規制に加え、限定的な反トラスト法適用除外の下で議論される標準を提案する。他方は、複数の国が構築するリスク枠組みと、被監査者が費用を負担することのない監査を提案する。議論の焦点は、監督の原則そのものよりも、誰がそのルールを書くのかにある。
最後の潮流は、製品に組み込まれたガードレールの下でAIが扱う機密データに関するものだ。Portable ComputerはファイルとクエリをPC内に保持し、クラウドへ送信する前に許可を求める。Scribe v2 Medicalは、臨床音声入力と保護対象医療情報のコンプライアンスワークフローを対象とする。Claude TagはBAAの対象外であるため、そうした情報を含まないチャネルに限定される。Claude for Financial Advisorsでは、重要なタスクの承認をアドバイザーに委ねる。エージェントが患者の診療記録や顧客のポートフォリオに近づくほど、単独で実行できる範囲の限界がより明確になる。
情報源
- XのBoris Cherny、Claude Mods
- Claude Code、Function Hooksのissue #91870
- Dario Amodei、フロンティアの進歩速度を管理しなければならない
- XのDario Amodei、論説の発表
- Cohere、AIのルールを決めるのは誰か?
- XのElevenLabs、クリエイティブMCPの発表
- XのElevenLabs、対応クライアント
- GitHub Changelog、モデル自動選択のレベル
- GitHub Docs、Copilotのモデル自動選択について
- Perplexity、Windows向けPortable Computer
- Perplexity、Portable Computer製品ページ
- NVIDIA、RTX搭載PC上のPortable Computer
- Qwen Code、バージョン0.23.4のリリースノート
- Kimi Code、バージョン0.43.0のリリースノート
- XのOpenAI Developers、Arch Linux
- ChatGPT、Linux向けアプリケーション
- Devin、BlackRockとのエージェントガバナンス
- Devin、プラグインのドキュメント
- Claude、Claude for Financial Advisors
- Claude、エージェント型コーディングがCIを圧迫している
- Perplexity、CobbleDB
- Hugging Face、HF Jobs全体でのLoRAを用いた非同期GRPO
- NVIDIA、Transformer Engineを用いたJAXでのdropless MoE
- Sakana AI、PC-ALM
- ElevenLabs、9月11日の変更履歴
- XのGoogle Flow
- App StoreのGoogle Flow
- Claude、医療分野のClaude Tag
- Claude、Accentureによる試験導入から本番環境までのガイド
- XのBoris Cherny、Cyphral Distich
- Vals AI、Claude Fable 5.1がCyphral Distichを解く
- OpenAI、Fyxerの導入事例
- Devin、リリースノート
- Google、DevFest 2026
- XのSuno、Studio Chat
- XのMiniMax、H3エコシステム
- XのRunway、A Game of HORSE
- Ai2、AutoDiscoveryとワシントン大学の学生
- Hugging Face、ArchslothとAutoRound
- Hugging Face、LangGraphエージェントのOpenAI互換性
- Hugging Face、EcoHashとRTX PRO 6000