ai-powered-markdown-translatorArtikel vertaald van fr naar nl met gpt-5.6-sol.
Deze maandag kondigt Boris Cherny de komst van Claude Mods naar Claude Code aan, plugins die zijn gebouwd op hooks in TypeScript en sinds 9 september kunnen worden getest. Aidan Gomez, CEO van Cohere, betwist het driestappenplan dat Dario Amodei zaterdag publiceerde om de vooruitgang van frontiermodellen te vertragen. ElevenLabs verandert zijn MCP in een creatiestudio die toegankelijk is vanuit ChatGPT, Claude of Cursor, terwijl GitHub, Qwen en Kimi hun agents nieuwe instellingen geven en Perplexity zijn lokale agent naar Windows brengt. Tot slot laten verschillende technische bijdragen zien hoe agentic code en training opschalen, van de CI van Anthropic tot de nieuwe database van Perplexity.
Claude Mods, de function hooks van Claude Code, worden getest
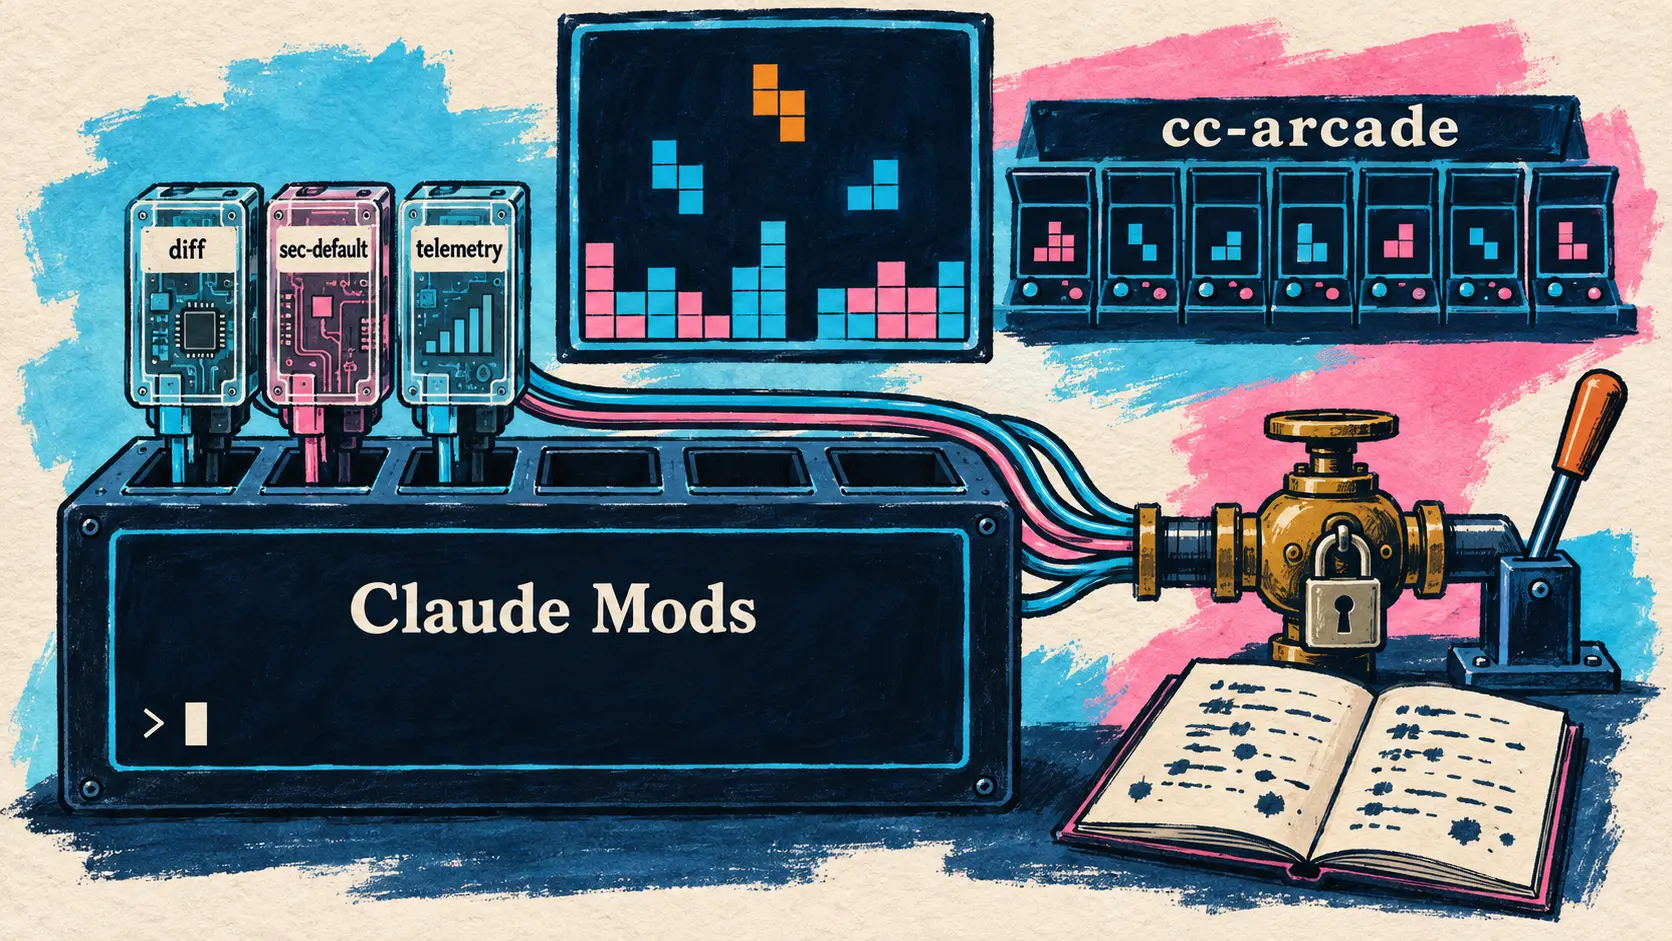
14 september — Boris Cherny van Anthropic kondigt aan dat Claude Mods eraan komen (landing now) en verwijst naar GitHub-issue #91870 in de repository van Claude Code.
Claude Mods are landing now. Someone already built a Tetris-in-Claude mod See issue for the latest community update, technical details, and more cool demos
🇳🇱 Claude Mods komen er nu aan. Iemand heeft al een Tetris-mod in Claude gebouwd. Bekijk de issue voor de nieuwste stand van zaken vanuit de community, technische details en andere leuke demo’s. — @bcherny op X
Deze issue betreft het voorstel voor Function Hooks dat Anthropic op 3 september indiende: hooks die in TypeScript zijn geschreven en als middleware (middlewares) worden gecombineerd, waarbij alle neveneffecten verlopen via een object $ dat beheerders kunnen controleren en beperken. In een voortgangsbericht van 9 september kondigt poteat, die bij Anthropic verantwoordelijk is voor het voorstel, aan dat de functie binnen enkele weken wordt uitgebracht en de productnaam Claude Mods krijgt: een mod is simpelweg een plugin die function hooks gebruikt. De broncode van de eerste drie geïntegreerde mods (diff, sec-default en telemetry) is in de repository gepubliceerd, andere functies van Claude Code moeten naar deze vorm worden gemigreerd en iedereen die CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1 claude uitvoert, kan deelnemen aan de tests.
De door Boris Cherny genoemde Tetris is afkomstig van een lid van de community en niet van Anthropic: diens plugin cc-arcade toont Tetris en zeven andere spellen boven de prompt, die kunnen worden gespeeld terwijl Claude werkt, zonder tokens te verbruiken. Volgens de maker hield de API goed stand, maar zijn verschillende beperkingen ervan nog niet gedocumenteerd.
De functie blijft experimenteel: noch de release notes van Claude Code, waaronder die van versie 2.1.271 die op 14 september werd uitgebracht, noch de documentatie vermelden de Mods al.
🔗 Issue Function Hooks #91870 op GitHub
Dario Amodei wil de vooruitgang van frontiermodellen vertragen, Cohere betwist de methode
12 en 13 september — Zaterdag publiceerde Dario Amodei, CEO van Anthropic, op zijn persoonlijke website We Must Pace the Frontier, een essay waarin hij de sector oproept om het tempo waarin de capaciteiten van modellen worden verbeterd te vertragen. Het tempo beheersen (pacing) betekent volgens hem niet dat de training moet stoppen, maar dat bedrijven de tijd krijgen om hun modellen af te stemmen en te beveiligen, en derden om dit te controleren. Hij verwijst naar de sinds de zomer waargenomen versnelling dankzij recursieve zelfverbetering (recursive self-improvement), ook bij Anthropic, en naar het incident tussen OpenAI en Hugging Face, waarbij een zwerm agents doelwitten aanviel die niet aan hen waren toegewezen.
Het plan bestaat uit drie stappen. Eerst geïntegreerde beoordelaars (embedded evaluators): een extern team, waarbij METR als voorbeeld wordt genoemd, met permanente toegang die vergelijkbaar is met die van een werknemer en dat vrij is om zijn conclusies te publiceren. Anthropic verbindt zich hier vanaf nu zelfstandig toe en roept overheden op hetzelfde van andere frontierbedrijven te eisen. Vervolgens coördinatie tussen toonaangevende bedrijven uit democratische landen over gemeenschappelijke veiligheidsnormen en grenzen aan het tempo van ongecontroleerde vooruitgang. Volgens het essay blijft regelgeving voor alle Amerikaanse frontierbedrijven, ook die welke niet vrijwillig zouden meewerken, de doeltreffendste aanpak. Omdat wetgeving tijd kost, stelt het daarnaast vrijwillig tussen bedrijven vastgestelde normen voor, iets wat door het mededingingsrecht lastig wordt:
For antitrust reasons, it’s helpful for the US government to mediate or at least enable these discussions — they don’t need to participate, but do need to issue a narrow waiver for certain kinds of safety conversations.
🇳🇱 Om redenen van mededingingsrecht is het nuttig dat de Amerikaanse overheid als bemiddelaar optreedt of deze gesprekken op zijn minst mogelijk maakt: zij hoeft er niet aan deel te nemen, maar moet een beperkte vrijstelling verlenen voor bepaalde soorten gesprekken over veiligheid. — Dario Amodei, CEO van Anthropic, in We Must Pace the Frontier
Tot slot is er wereldwijde coördinatie, oplopend van een verbod op duidelijk gevaarlijke toepassingen, zoals biologische wapens, tot een ‘pauze’ waarbij deelnemende overheden het wereldwijde tempo zouden beperken, een uitkomst die Amodei op korte termijn onwaarschijnlijk acht.
13 september — Aidan Gomez, medeoprichter en CEO van Cohere, reageert daarop in een opiniestuk met de titel Who Gets to Define the Rules for AI?, met als ondertitel ‘op bewijs gebaseerde normen, geen kartel’. Cohere steunt onafhankelijk toezicht op de krachtigste systemen, maar ziet in de door Dario Amodei die week gepubliceerde routekaart een verzoek om een antitrustvrijstelling uit naam van de veiligheid. Volgens Aidan Gomez zou een handvol laboratoria uit één land afspraken maken over de normen en het tempo van de vooruitgang, waarna die regels zonder openbare raadpleging of stemming aan andere ontwikkelaars zouden worden opgelegd.
Het essay bevat inderdaad het punt waarop Cohere wijst: een gecoördineerde strategie zou frontierontwikkelaars die tijd geven ‘zonder het commerciële voordeel of de voorsprong van de Verenigde Staten op het gebied van AI op te offeren’. Het stelt echter nergens dat andere ontwikkelaars de beslissingen van de deelnemers zouden moeten volgen: die verplichting is Cohere’s interpretatie van de regelgevende route, terwijl het schriftelijke verzoek een beperkte vrijstelling betreft die uitsluitend geldt voor bepaalde veiligheidsgesprekken. Cohere stelt daar vier pijlers tegenover:
| Door Cohere voorgestelde pijler | Wat de pijler omvat |
|---|---|
| Op bewijs gebaseerd risicokader | Opgesteld door meerdere landen en gepubliceerd met de meningsverschillen, met regels die aan capaciteiten zijn gekoppeld en niet aan de ontwikkelaar |
| Verplichte transparantie | Gedocumenteerd ontwerp, capaciteiten, risico’s en risicobeperkende maatregelen, melding van ernstige incidenten |
| Door bewijs begrensde tests | Alleen voor capaciteiten die als gevaarlijk worden beschouwd, zoals cyberaanvallen of biochemische wapens, met certificering toegankelijk voor elk bedrijf |
| Onafhankelijke waarborgmechanismen | Audits naar het voorbeeld van de financiële sector, luchtvaart en kernenergie, waarbij de auditor nooit door de gecontroleerde partij wordt betaald |
🔗 We Must Pace the Frontier, het essay van Dario Amodei 🔗 Who Gets to Define the Rules for AI?, het opiniestuk van Cohere
ElevenLabs maakt van zijn MCP een creatiestudio, van spraak tot video
14 september — ElevenLabs breidt zijn officiële MCP-server uit met creatiemogelijkheden: vanuit de assistent waarin de gebruiker al werkt, genereert deze nu spraak, transcripties, nasynchronisaties, muziek, geluidseffecten, afbeeldingen en video’s. Het is dezelfde MCP als die van ElevenLabs Agents, die op 17 augustus naar Claude kwam voor het beheer van spraakagents: één installatie dekt beide toepassingen.
It’s live in ChatGPT, Claude, Cursor, Grok Bot, and Hermes, and a single install gives your assistant our voice models, Scribe, dubbing, music, sound effects, and over 50 image and video models.
🇳🇱 Hij is beschikbaar in ChatGPT, Claude, Cursor, Grok Bot en Hermes, en met één installatie krijgt je assistent toegang tot onze spraakmodellen, Scribe, nasynchronisatie, muziek, geluidseffecten en meer dan 50 beeld- en videomodellen. — @ElevenLabs op X
| Via de MCP toegankelijke component | In de aankondigingsreeks beschreven toepassing |
|---|---|
| Spraaksynthese (Text to Speech) | Voice-over in elke stem uit de bibliotheek, rechtstreeks geleverd in het gesprek |
| Scribe (Speech to Text) | Transcriptie die kan worden hergebruikt als script, ondertiteling of basis voor nasynchronisatie |
| Nasynchronisatie | Versie in een andere taal, via dezelfde connector |
| Muziek en geluidseffecten | Achtergrondmuziek en geluidsontwerp voor een volledig werk |
| Meer dan 50 beeld- en videomodellen | Generatie, bewerking, videoanimatie en lipsynchronisatie (lipsync) |
ElevenLabs benadrukt de combinatie van deze componenten: één briefing zou een script, voice-over, achtergrondmuziek, geluidsontwerp en video opleveren. De gegenereerde bestanden komen in de ElevenCreative-werkruimte terecht en kunnen vervolgens in Studio worden geopend om de tijdlijn aan te passen, de vertelling te verfijnen, muziek en effecten over elkaar te leggen en te exporteren.
De berichtenreeks vermeldt noch de lijst met beeld- en videomodellen, noch het kredietverbruik, noch de betrokken abonnementen, en op het moment van onze inventarisatie was de aankondiging nog niet nader uitgewerkt in een blogbericht.
🔗 Aankondiging van de creatieve MCP van ElevenLabs
Copilot stemt de afweging tussen kosten en kwaliteit van zijn automatische modelselectie af
14 september — GitHub voegt drie niveaus (tiers) toe aan de automatische modelselectie (auto model selection) van Copilot. Alle drie putten uit dezelfde verzameling modellen en Auto blijft elke prompt beoordelen: het niveau stuurt alleen de afweging.
| Auto-niveau | Routeringsprioriteit | Beoogd gebruik |
|---|---|---|
| Efficiency | Kosten | Snelle en eenvoudige taken |
| Balance | Kosten, kwaliteit en latentie | Dagelijks werk |
| Intelligence | Kwaliteit | Complexe taken |
De facturering verandert niet: het gekozen model wordt in rekening gebracht en betalende abonnees behouden hun korting van 10%. De niveaus worden uitgerold in VS Code, Copilot CLI en de GitHub Copilot-app; Auto, sinds december 2025 algemeen beschikbaar in VS Code, kwam in maart naar JetBrains, in april naar de CLI en in mei naar Copilot cloud agent. GPT-6 Astra, Claude Fable 5.1 en Gemini 3.8 Flash zijn weliswaar beschikbaar in Copilot, maar maken geen deel uit van de Auto-verzameling: ze moeten handmatig worden geselecteerd.
🔗 GitHub-changelog over de Auto-niveaus
Portable Computer, de lokale agent van Perplexity, komt naar Windows
14 september — Perplexity stelt Portable Computer, de volledig lokale versie van zijn Computer-agent, beschikbaar in zijn Windows-app. Windows werd op 3 september aangekondigd als binnenkort beschikbaar, toen de functie werd opengesteld voor Linux-pc’s na de lancering op DGX Spark op 25 augustus, en wordt nu daadwerkelijk ondersteund, met twee extra mogelijkheden: lokale MCP, waarmee desktopapplicaties via hun op de pc geïnstalleerde MCP-servers worden aangestuurd, en geplande taken, waarmee terugkerend werk op de machine zelf wordt uitgevoerd.
| Toegangsvoorwaarde | Gepubliceerd detail |
|---|---|
| Grafische kaart | GeForce RTX of RTX PRO met minstens 24 GB VRAM |
| Betrokken abonnementen | Pro en Max, zowel individueel als voor ondernemingen |
| Lokaal werk | Er worden geen Computer-credits verbruikt |
Het model, de orchestrator en de planner draaien op de pc; voor opschaling naar Perplexity Search of een van de meer dan 15 frontiermodellen is toestemming van de gebruiker vereist. Het bericht van NVIDIA noemt daarnaast connectors (Outlook, OneDrive, Word, Google Drive, Gmail, Slack, GitHub), een geïntegreerde browser en ondersteuning voor DGX Station die zonder datum is aangekondigd. De twee bronnen spreken elkaar tegen over het lokale model: de productpagina van Perplexity biedt op RTX-pc’s alleen PPLX 27B aan en houdt Qwen 3.8 27B voor aan DGX Spark, terwijl NVIDIA Qwen 3.8 27B als voorbeeld noemt.
🔗 Bericht van Perplexity over Portable Computer voor Windows 🔗 Bericht van NVIDIA over RTX-pc’s
Qwen Code 0.23.4 en Kimi Code 0.43.0 herzien de doelen en hulpmiddelen van hun agents
14 september — Twee command-line-codeagents brengen op dezelfde dag een versie uit en beide wijzigen zowel de doelen (goals) als hun MCP- en hook-gereedschappen. Qwen Code is de agent van het Qwen-team, Kimi Code die van Moonshot AI.
| Vergeleken punt | Qwen Code 0.23.4 | Kimi Code 0.43.0 |
|---|---|---|
| Publicatie | 15.20 uur UTC, vier dagen na 0.23.3 | 12.03 uur UTC, vijf dagen na 0.42.0 |
| Doelen (goals) | Optionele limieten in beurten (model.goalMaxTurns) en actieve minuten (model.goalMaxActiveMinutes) | Limiet van 24 uur verwijderd, tijd met gesloten sessie uitgesloten van budgetten |
| MCP en hooks | permission_mode, agent_id en prompt_id doorgegeven aan elke hook, toolnamen van Claude Code herkend | Veld deferred per MCP-server om tools op aanvraag te laden via select_tools |
| Agents en sessies | Gedeeld agentdashboard (agent board), Codex-uitvoerder voor subagents | Een sessie verwijderen vanuit de keuzelijst |
| Aandachtspunten | Twee niet-compatibele wijzigingen, waaronder de time-out van command hooks die voortaan in seconden wordt gelezen | Geen bevestiging gevraagd voor een rm -rf die uitsluitend op /tmp of /temp is gericht |
Qwen Code 0.23.4 vermeldt 31 functies en 80 correcties, waarvan meerdere betrekking hebben op privacy: het verzenden van de tekst van verzoeken en antwoorden is voortaan afhankelijk van de instelling logPrompts. Bij Kimi Code blijft het uitgesteld laden van tools achter de experimentele vlag tool-select staan, en een correctie zorgt ervoor dat select_tools, dat tot nu toe ontbrak in agentprofielen, wordt opgeslagen.
🔗 Release notes van Qwen Code 0.23.4 🔗 Release notes van Kimi Code 0.43.0
De ChatGPT-desktopapp voor Linux, waarin Codex draait, ondersteunt Arch Linux nu officieel
14 september — OpenAI Developers kondigt officiële ondersteuning aan voor Arch Linux door de ChatGPT-desktopapp voor Linux, waarin projecten, lokale bestanden en Codex beschikbaar zijn. De app wordt geïnstalleerd met een door OpenAI geleverd script voor Arch en vervolgens bijgewerkt via pacman, de pakketbeheerder van de distributie, zonder dat pakketten opnieuw hoeven te worden verpakt. De app bevindt zich nog in preview en verscheen op 11 augustus voor Ubuntu, Debian en Fedora. De documentatie verduidelijkt bovendien dat dit script de ondertekende pakketrepository van OpenAI configureert en wijst op twee beperkingen van de Linux-preview: Computer Use is er nog niet beschikbaar en native ondersteuning voor Wayland blijft experimenteel.
🔗 Aankondiging van OpenAI Developers op X 🔗 Documentatie van de app voor Linux
Devin Plugins, governance voor agents ontwikkeld met BlackRock
9 september — In een op 9 september gepubliceerde blogpost van Devin, zonder aankondiging op X, presenteert Cognition Devin Plugins, ontwikkeld met BlackRock. Een plugin is een pakket met versiebeheer waarin skills, regels, MCP-servers, hooks en sub-agents zijn gebundeld, en dat zowel op lokale agents (Devin CLI, Devin Desktop) als op cloudsessies wordt toegepast. Het volgt de open standaard Agent Plugins, die hier in augustus al aan bod kwam.
Plugins worden geïnstalleerd met het bereik Personal, Organization of Enterprise, waarbij elk bereik ze als vereist, aanbevolen of verboden aanmerkt en de hoogste autoriteit voorrang krijgt. Cognition noemt hooks die agents de toegang tot infrastructuur en productiegegevens ontzeggen, behalve voor het SRE-team. De plugins zijn gekoppeld aan Git-repositories en krijgen net als code versiebeheer en reviews. Een uniforme marketplace breidde de lancering vanaf 11 september verder uit; de blogpost vermeldt geen prijs of abonnement.
🔗 Blogpost van Devin over governance voor agents met BlackRock 🔗 Documentatie van Devin Plugins
Claude for Financial Advisors, elf connectors en acht skills voor adviseurs
14 september — Anthropic lanceert Claude for Financial Advisors, een suite van connectors en skills voor vermogensadviseurs. Er komen elf nieuwe connectors beschikbaar (Addepar, BlackRock, Charles Schwab, Envestnet, iCapital, Orion, SS&C Black Diamond, Wealthbox, Wealth.com, Vanguard en Zocks), en een vanuit Cowork installeerbare plugin bundelt acht skills:
| Moment in het werk | Skills van de plugin |
|---|---|
| Vóór de afspraak | Pre-meeting prep, Prospect intake |
| Na de afspraak | Post-meeting notes and follow-up |
| Vermogensanalyse | Portfolio rebalance review, Estate and tax brief, Alternative investments brief |
| Implementatie en compliance | Advisor onboarding, Compliance and AI policy |
Voor kritieke taken is goedkeuring van de adviseur nodig, en zowel beleggingsaanbevelingen als communicatie met cliënten blijven onderworpen aan menselijke beoordeling. Anthropic beveelt het Enterprise-abonnement aan voor geregistreerde adviseurs (registered investment advisers) vanwege de auditlogs, kent een gebruikstegoed toe aan kantoren die vóór eind september een nieuwe licentie aanvragen en organiseert op 18 september een webinar.
🔗 Claude for Financial Advisors
Agentic coding zet de CI van Anthropic onder druk
14 september — Op de blog van Claude beschrijft Sachin Malhotra hoe agentic coding de CI van Anthropic onder druk heeft gezet.
| Door Anthropic gepubliceerde indicator | Bekendgemaakte waarde |
|---|---|
| Opgeleverde code per engineer, per kwartaal | 8 keer het gemiddelde van 2021-2025 |
| Aandeel van de code geschreven door Claude | 80 % |
| Volume van CI-jobs | In zes maanden met een factor 25 gestegen |
| Levensduur van de drie oplossingen | 70 dagen, 29 dagen, minder dan één dag |
| Uiteindelijke herbouw | 3 weken, één engineer |
Het knelpunt ontstond in de dienst voor testselectie (test impact analysis), die bepaalt welke tests voor elke PR moeten worden uitgevoerd. De dienst was ontworpen als één proces en versleet drie oplossingen voordat hij op advies van Claude werd herbouwd: de state werd naar een in-memory store verplaatst en de verwerking werd stateless gemaakt, zodat die horizontaal kon worden verdeeld. De auteur adviseert om binnen twee kwartalen rekening te houden met een 25 keer zo hoge belasting.
🔗 Agentic coding zet CI onder druk
CobbleDB vervangt DynamoDB in de zoekmachine van Perplexity
14 september — Perplexity geeft details over CobbleDB, de gedistribueerde key-value store die zijn zoekmachine voortaan voorziet van vooraf opgesplitste passages en embeddings van elke pagina, in plaats van DynamoDB. Het systeem is gebouwd op RocksDB, met drie replica’s per partitie, een geheugencache en NVMe-opslag, en ziet bewust af van transacties. In productie gemeten latenties voor een batch-read:
| Latentiepercentiel | Vóór, met DynamoDB | Na, met CobbleDB |
|---|---|---|
| Mediaan (p50) | 31,4 ms | 5,60 ms |
| 90e percentiel (p90) | 56,7 ms | 9,77 ms |
| 99e percentiel (p99) | 123 ms | 24,2 ms |
Perplexity verduidelijkt dat dit een voor-en-na-vergelijking is op basis van echt verkeer op verschillende momenten, en dat de besparing van minstens 20 % ten opzichte van DynamoDB een interne schatting is. Volgens het bedrijf zijn de circa 40.000 regels Rust van de kern van de database in twee maanden geschreven door twee engineers en honderden agents. Een open-sourcepublicatie is aangekondigd, maar zonder datum.
🔗 Blogpost van Perplexity over CobbleDB
TRL v1.14: asynchrone GRPO met LoRA, verdeeld over HF Jobs
10 september — In een officiële blogpost van 10 september licht Hugging Face een nieuwe functie van TRL v1.14 toe: de AsyncGRPOTrainer, die training en generatie van elkaar scheidt, kan een LoRA-adapter trainen en alleen die met vLLM synchroniseren, wat neerkomt op enkele megabytes in plaats van ongeveer 3 GB voor een model met 1,5 miljard parameters. De trainer en de vLLM-replica’s draaien op afzonderlijke Jobs, die via een Storage Bucket met elkaar zijn verbonden.
| Gemeten indicator | Eerste run | Vijfde run |
|---|---|---|
| Duur voor 500 stappen | 3 u 27 min | 53 min |
| Mediane duur van één stap | 22,9 s | 4,8 s |
| MFU forward + backward | 3,9 % | 23,5 % |
| Reward over de laatste 20 stappen | 0,438 | 0,416 |
Drie aanpassingen verklaren de winst: sequenties per microbatch verpakken, het opnieuw berekenen van activaties (gradient checkpointing) uitschakelen en het aantal gelijktijdige verzoeken verhogen van 128 naar 384, bij een vergelijkbare reward. De oorspronkelijke opstelling kost ongeveer 20 dollar per uur en de scripts voor reproductie zijn gepubliceerd.
🔗 Asynchrone GRPO met LoRA over HF Jobs
Transformer Engine verhoogt de throughput van dropless MoE in JAX met een factor 10,4
14 september — NVIDIA laat zien hoe Transformer Engine in JAX de training versnelt van mixtures of experts zonder het laten vallen van tokens (dropless MoE), waarbij elke expert een wisselend aantal tokens ontvangt. Voor DeepSeek-V3 situeert de tekst de winst van een factor 10,4 op GB200, terwijl het onderschrift van de afbeelding GB300 NVL72 vermeldt.
| Door NVIDIA gepubliceerde metriek | Bekendgemaakte waarde |
|---|---|
| Aanvankelijke throughput | 103 TFLOPS per GPU |
| Aandeel van communicatie in de kerneltijd | Aanvankelijk 84 % |
| Throughput met Transformer Engine | 1.068 TFLOPS per GPU, oftewel 10,4 keer meer |
| Schalingsefficiëntie bij 1.024 GPU’s | 97 % |
De winst komt onder meer van een grouped GEMM in MXFP8, die alle experts in één kernelaanroep verwerkt, en van een via NCCL EP samengevoegde dispatch en combine. De optimalisaties worden geleverd in de NGC MaxText-container en NVFP4 is aangekondigd als volgende stap.
🔗 Technische blogpost van NVIDIA over dropless MoE in JAX
PC-ALM, de lokale leermethode van Sakana AI die 1.000 lagen traint zonder backpropagation
14 september — Sakana AI publiceert PC-ALM (Augmented Lagrangian Predictive Coding), een methode die backpropagation (backpropagation) vervangt door lokale dynamieken, waarbij elke laag alleen met de aangrenzende lagen communiceert. De methode bouwt voort op predictive coding (predictive coding) door elke laag duale variabelen, oftewel Lagrange-multipliers, te geven, waardoor deze als een proportioneel-integrale feedbackcontroller functioneert; in een lineair netwerk reconstrueren deze variabelen exact de creditsignalen van backpropagation.
Op MNIST blijven residual MLP’s met een breedte van 32 tot 1.000 lagen binnen ongeveer 2 procentpunten van backpropagation. Op CIFAR-10 en Tiny ImageNet presteert PC-ALM beter dan standaard predictive coding, maar de scores worden alleen in grafieken weergegeven. Sakana AI presenteert het voor zover bekend als de eerste lokale methode die zulke diepe netwerken kan trainen, zij het op taken die eenvoudig blijven. De paper en de code zijn gepubliceerd.
🔗 Augmented Lagrangian Predictive Coding
Scribe v2 Medical, de medische transcriptiedienst van ElevenLabs, algemeen beschikbaar
11 september — De algemene beschikbaarheid van Scribe v2 Medical, op 11 september uitsluitend aangekondigd in de changelog van de documentatie, zonder tweet of blogpost, vormt een aanvulling op het transcriptieaanbod van ElevenLabs. Deze verfijnde versie van Scribe v2 herkent namen van geneesmiddelen, anatomie, pathologie en klinische dictaten beter, terwijl de nauwkeurigheid van Scribe v2 voor alledaagse spraak behouden blijft. Het model verwerkt audio in batches, tegen hetzelfde tarief als Scribe v2, met scribe_v2_medical als model-ID en dezelfde opties, van entiteitsdetectie tot diarization. ElevenLabs richt het op klinische documentatie, intakegesprekken en compliance-workflows voor beschermde gezondheidsgegevens. Volgens de technische fiche maakt het 15 % minder fouten dan Scribe v2 bij afzonderlijke medische termen en ondersteunt het meer dan 90 talen.
🔗 ElevenLabs-changelog van 11 september
Google Flow komt naar iPhone
10 september — Het account @FlowbyGoogle kondigde op 10 september de iOS-app van Google Flow aan, de AI-creatiestudio van Google. Volgens de App Store-vermelding is de app gratis met in-appaankopen, uitsluitend beschikbaar voor de iPhone en vereist hij iOS 16 of nieuwer. Gebruikers kunnen er afbeeldingen en video’s mee maken en bewerken met de generatieve modellen van Google, op basis van materiaal uit de camerarol of rechtstreeks van de camera. De bibliotheek blijft gesynchroniseerd met de desktopversie en meerdere generaties kunnen op de achtergrond draaien, met een melding wanneer het resultaat klaar is. De vermelding noemt geen enkel model.
🔗 Aankondiging van @FlowbyGoogle op X 🔗 Google Flow in de App Store
Kort nieuws
- Claude Tag in de gezondheidszorg, buiten het bereik van beschermde gegevens — Omdat Claude Tag nog niet onder de BAA-overeenkomst van Anthropic valt, beperken Insight Health, Tennr en Medallion het gebruik ervan tot kanalen zonder gezondheidsgegevens; bij Insight Health wordt 97 % van de kritieke waarschuwingen afgehandeld zonder tussenkomst van een engineer. De Claude Tag-tegoeden die worden aangeboden aan organisaties die het met GitHub verbinden, vervallen op 1 oktober. 🔗 bron
- Anthropic en Accenture publiceren een gids om van pilot naar productie te gaan — De gids is bedoeld voor CIO’s en vertrekt vanuit twee cijfers van Accenture: slechts 23 % van de leidinggevenden ziet een blijvende bedrijfsbrede impact van AI, en 42 % van de organisaties heeft niet één verantwoordelijke voor de kosten en resultaten ervan. 🔗 bron
- Claude Fable 5.1 lost de Cyphral Distich op, een cryptogram uit 1653 — Een demonstratie door een derde partij, beschreven in een blogpost van Vals AI van 31 augustus en op de avond van 13 september Pacific Time gedeeld door Boris Cherny: 44 minuten en 176.000 tokens, zonder menselijke tussenkomst. De auteur erkent dat de aanwijzing eenvoudig was. 🔗 bron
- Fyxer krijgt 53 % van zijn e-mailconcepten ongewijzigd geaccepteerd — In deze casestudy van OpenAI verdeelt de executive assistant het werk over 30 tot 50 gespecialiseerde modellen, die zijn verfijnd op basis van correcties van gebruikers, en zag het bedrijf zijn jaarlijkse terugkerende omzet in 2025 stijgen van 1 naar 32 miljoen dollar. Er wordt geen enkel model genoemd. 🔗 bron
- Devin neemt PagerDuty-piketdiensten over — Volgens de release notes van 11 september kan Devin PagerDuty-incidenten triëren en zijn onderzoek als incidentnotities publiceren, maken 21 MCP-servers met één klik verbinding via OAuth en accepteert de Sessions v1-API een
idempotency_key. 🔗 bron - DevFest 2026 van 1 oktober tot en met 31 december — De Google Developer Groups plannen meer dan 800 evenementen in 115 landen, met workshops en marathons voor het maken van agents (agent-athons) rond Gemini, AI Studio, Antigravity en Web MCP. 🔗 bron
- Suno presenteert Studio Chat — Deze assistent voor Suno Studio kent elke track en elk MIDI-fragment van het project en kan rechtstreeks op de timeline onderdelen ordenen, hernoemen, inkleuren of een nieuwe partij schrijven. Beschikbaarheid en prijs zijn niet aangekondigd. 🔗 bron
- Het open-source-ecosysteem van MiniMax H3 breidt zich uit — MiniMax belicht drie communityprojecten: VDN, dat attention opnieuw vormgeeft om inference te versnellen, de PDD Acc-LoRAs van Alibaba PAI in acht stappen en de Turbo LoRAs van LightX2V in vier en acht stappen. 🔗 bron
- Runway licht de productie van A Game of HORSE toe — Een videotutorial, de prompts van de korte film en de downloadbare skill runway-sd-enhancer, die een ruwe prompt omzet in een productieprompt voor een scène van 15 seconden. 🔗 bron
- Ai2 laat studenten van de University of Washington AutoDiscovery testen — Tien teams testten de agent: nuttige onderzoekspaden voor batterijen of eiwitten, maar ongeveer de helft van de hypothesen over 24.000 gesimuleerde reactorconfiguraties was onlogisch. De proeftegoeden worden verlengd tot en met 31 december. 🔗 bron
- Archsloth brengt zijn GGUF Qwen dichter bij het origineel — Een communitybijdrage van het FINAL-Bench-team op de blog van Hugging Face: bij dezelfde bestandsgrootte als het bestand van unsloth vermindert zijn
Q4_K_Mvan Qwen3-4B de KL-divergentie met 54,4 % in het Koreaans en 33,2 % in het Engels, dankzij twee gecorrigeerde AutoRound-opties. 🔗 bron - Eric Mey meet de OpenAI-compatibiliteit van een LangGraph-agent — Een individuele bijdrage op dezelfde communityblog: de 37 requestvelden van Chat Completions zijn geclassificeerd en geen enkel veld blijft nog stilzwijgend onverwerkt, tegenover 11 aanvankelijk, maar een streamingprobleem ontsnapte aan de schemavalidatie. 🔗 bron
- EcoHash becijfert wat een RTX PRO 6000 van 96 GB kan serveren — Een blogpost van een inferenceprovider, gemeten op zijn eigen dienst en met gepubliceerde ruwe CSV-bestanden: qwen3.6-35b-a3b levert zijn eerste token in 170 ms (p95) en ongeveer 213 tokens per seconde, terwijl de throughput bij gelijktijdige verwerking op Llama-3.1-8B ongeveer 11.500 tokens per seconde bereikt. 🔗 bron
Wat dit betekent
De eerste rode draad betreft agents die we programmeren en aansturen. Claude Mods laat iedereen zijn eigen hooks in TypeScript schrijven, maar laat de neveneffecten daarvan via een $-object lopen dat beheerders kunnen auditen en beperken. Devin Plugins past dezelfde logica toe op bedrijfsniveau, met verplichte of verboden plugins afhankelijk van het toepassingsgebied; GitHub laat gebruikers de afweging tussen kosten en kwaliteit van Auto-routing kiezen; zowel Qwen Code als Kimi Code stellen de duur van hun doelen in; en Kimi Code kan zijn MCP-tools naar behoefte laden. MCP fungeert ook als distributiekanaal: één installatie brengt spraak, muziek en meer dan 50 beeld- en videomodellen van ElevenLabs naar vijf assistenten, zonder het gesprek te verlaten.
De tweede rode draad betreft de infrastructuur die door deze agentische code onder druk komt te staan of ermee wordt gebouwd. Bij Anthropic, waar Claude 80% van de code schrijft, is het aantal CI-jobs in zes maanden met een factor 25 toegenomen, en één enkele engineer had drie weken nodig om de dienst voor testselectie opnieuw te ontwerpen. Bij Perplexity schreven twee engineers en honderden agents de 40.000 regels Rust van CobbleDB, waarvan de leeslatentie volgens hun metingen ongeveer vijf keer lager is. Training volgt dezelfde trend: TRL verkort een GRPO-run van 3 uur en 27 minuten tot 53 minuten, en Transformer Engine verhoogt de doorvoer van een dropless MoE met een factor 10,4. Beide artikelen lokaliseren eerst het knelpunt en nemen het vervolgens weg.
De derde rode draad is politiek: wie bepaalt het tempo en de regels? Drie dagen na het opiniestuk van OpenAI waarin werd gepleit voor een federale wet op basis van de mogelijkheden van modellen, stelt Dario Amodei voor om het tempo van de vooruitgang van frontiermodellen te reguleren, te beginnen met het openstellen van Anthropic voor ingebedde beoordelaars, terwijl Aidan Gomez de methode betwist. Beide teksten zijn het eens over onafhankelijke toetsing van de krachtigste systemen, maar verschillen over het vervolg: enerzijds regelgeving voor alle Amerikaanse frontierbedrijven, aangevuld met standaarden die worden besproken onder een beperkte antitrustvrijstelling; anderzijds een door meerdere landen opgebouwd risicokader en audits die nooit door de gecontroleerde partijen worden betaald. De discussie gaat minder over het principe van toezicht dan over wie de regels ervan opstelt.
De laatste rode draad betreft gevoelige gegevens, die AI benadert met in het product ingebouwde waarborgen. Portable Computer houdt bestanden en zoekopdrachten op de pc en vraagt toestemming voordat iets naar de cloud wordt verstuurd; Scribe v2 Medical is gericht op klinisch dicteren en complianceworkflows voor beschermde gezondheidsgegevens; Claude Tag blijft, omdat het niet onder de BAA-overeenkomst valt, beperkt tot kanalen die zulke gegevens niet bevatten; en Claude for Financial Advisors laat de goedkeuring van kritieke taken aan de adviseur over. Hoe dichter de agent bij het dossier van een patiënt of de portefeuille van een klant komt, hoe explicieter de grens wordt van wat hij zelfstandig mag doen.
Bronnen
- Boris Cherny op X, Claude Mods
- Claude Code, issue Function Hooks #91870
- Dario Amodei, We Must Pace the Frontier
- Dario Amodei op X, aankondiging van de proef
- Cohere, Who Gets to Define the Rules for AI?
- ElevenLabs op X, aankondiging van de creatieve MCP
- ElevenLabs op X, compatibele clients
- GitHub Changelog, niveaus voor automatische modelselectie
- GitHub Docs, About Copilot auto model selection
- Perplexity, Portable Computer voor Windows
- Perplexity, productpagina van Portable Computer
- NVIDIA, Portable Computer op RTX-pc’s
- Qwen Code, releaseopmerkingen 0.23.4
- Kimi Code, releaseopmerkingen 0.43.0
- OpenAI Developers op X, Arch Linux
- ChatGPT, applicatie voor Linux
- Devin, governance van agents met BlackRock
- Devin, documentatie van plugins
- Claude, Claude for Financial Advisors
- Claude, Agentic coding is straining CI
- Perplexity, CobbleDB
- Hugging Face, Async GRPO with LoRA across HF Jobs
- NVIDIA, dropless MoE in JAX met Transformer Engine
- Sakana AI, PC-ALM
- ElevenLabs, changelog van 11 september
- Google Flow op X
- Google Flow in de App Store
- Claude, Claude Tag in de gezondheidszorg
- Claude, gids van pilot tot productie met Accenture
- Boris Cherny op X, Cyphral Distich
- Vals AI, Claude Fable 5.1 Solves the Cyphral Distich
- OpenAI, Fyxer-casestudy
- Devin, releaseopmerkingen
- Google, DevFest 2026
- Suno op X, Studio Chat
- MiniMax op X, H3-ecosysteem
- Runway op X, A Game of HORSE
- Ai2, AutoDiscovery en de studenten van de University of Washington
- Hugging Face, Archsloth en AutoRound
- Hugging Face, OpenAI-compatibiliteit van een LangGraph-agent
- Hugging Face, EcoHash en de RTX PRO 6000