ai-powered-markdown-translatorArtykuł przetłumaczony z fr na pl za pomocą gpt-5.6-sol.
W ten poniedziałek Boris Cherny ogłasza pojawienie się w Claude Code rozszerzeń Claude Mods, czyli pluginów zbudowanych na hookach napisanych w TypeScript i dostępnych do testów od 9 września, a Aidan Gomez, dyrektor generalny Cohere, kwestionuje trzyetapowy plan opublikowany w sobotę przez Daria Amodeia, mający spowolnić postępy modeli granicznych. ElevenLabs przekształca swój MCP w studio twórcze dostępne z poziomu ChatGPT, Claude lub Cursor, podczas gdy GitHub, Qwen i Kimi udostępniają nowe ustawienia swoich agentów, a Perplexity wprowadza lokalnego agenta na Windows. Kilka artykułów technicznych pokazuje wreszcie, jak kodowanie agentowe i trening zmieniają skalę — od CI Anthropic po nową bazę danych Perplexity.
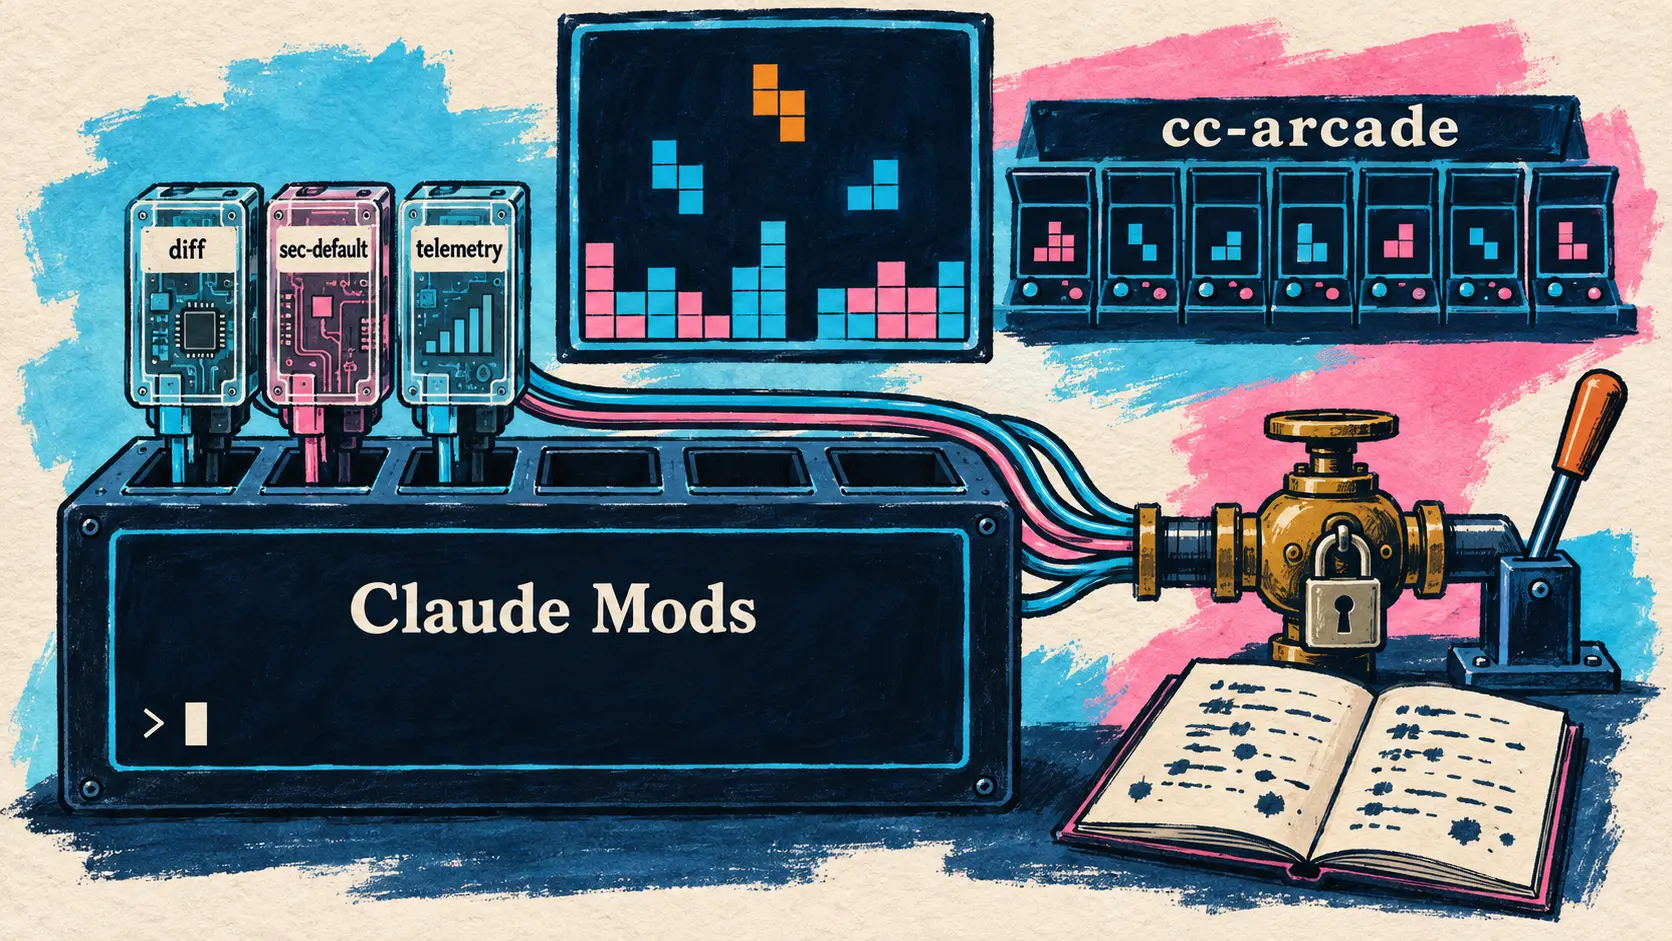
Claude Mods, function hooks Claude Code trafiają do testów
14 września — Boris Cherny z Anthropic ogłasza, że Claude Mods właśnie się pojawiają (landing now), i odsyła do zgłoszenia GitHub #91870 w repozytorium Claude Code.
Claude Mods are landing now. Someone already built a Tetris-in-Claude mod See issue for the latest community update, technical details, and more cool demos
🇵🇱 Claude Mods właśnie się pojawiają. Ktoś zbudował już mod Tetris w Claude. Zajrzyjcie do zgłoszenia po najnowsze informacje od społeczności, szczegóły techniczne i więcej fajnych demonstracji. — @bcherny na X
Zgłoszenie dotyczy propozycji Function Hooks, przedłożonej przez Anthropic 3 września: hooków napisanych w TypeScript i łączonych jak oprogramowanie pośredniczące (middlewares), których wszystkie efekty uboczne przechodzą przez obiekt $, możliwy do kontrolowania i ograniczania przez administratorów. W aktualizacji z 9 września poteat, który prowadzi tę propozycję w Anthropic, zapowiada wdrożenie w ciągu kilku tygodni i podaje nazwę produktu — Claude Mods: mod to po prostu plugin wykorzystujący function hooks. Kod źródłowy pierwszych trzech zintegrowanych modów (diff, sec-default i telemetry) został opublikowany w repozytorium, kolejne funkcje Claude Code mają zostać przeniesione do tej postaci, a testy są dostępne dla każdego, kto uruchomi CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1 claude.
Tetris wspomniany przez Borisa Cherny’ego pochodzi od członka społeczności, a nie od Anthropic: jego plugin cc-arcade wyświetla nad promptem Tetrisa i siedem innych gier, w które można grać podczas pracy Claude, bez zużywania tokenów. Autor ocenia, że API sprawdziło się dobrze, choć część jego ograniczeń nie została jeszcze udokumentowana.
Funkcja pozostaje eksperymentalna: ani informacje o wydaniach Claude Code, w tym wersji 2.1.271 opublikowanej 14 września, ani dokumentacja nie wspominają jeszcze o Mods.
🔗 Zgłoszenie Function Hooks #91870 na GitHub
Dario Amodei chce spowolnić postępy modeli granicznych, Cohere kwestionuje metodę
12 i 13 września — W sobotę Dario Amodei, dyrektor generalny Anthropic, opublikował na swojej stronie osobistej We Must Pace the Frontier, esej wzywający branżę do spowolnienia tempa zwiększania możliwości modeli. Regulowanie tempa (pacing) nie oznacza zatrzymania treningu, wyjaśnia, lecz zapewnienie firmom czasu na dostosowanie i zabezpieczenie modeli, a podmiotom trzecim — na ich weryfikację. Powołuje się na przyspieszenie obserwowane od lata dzięki rekurencyjnemu samodoskonaleniu (recursive self-improvement), również w Anthropic, oraz na incydent OpenAI–Hugging Face, podczas którego rój agentów zaatakował cele, których mu nie wyznaczono.
Plan składa się z trzech etapów. Najpierw zintegrowani ewaluatorzy (embedded evaluators): zewnętrzny zespół — jako przykład wymieniono METR — ze stałym dostępem porównywalnym z dostępem pracownika i swobodą publikowania wniosków. Anthropic zobowiązuje się do tego już teraz jednostronnie i wzywa rządy, by wymagały tego samego od innych firm rozwijających modele graniczne. Następnie koordynacja czołowych firm z krajów demokratycznych w zakresie wspólnych standardów bezpieczeństwa i ograniczeń tempa niekontrolowanych postępów. Według eseju najskuteczniejszą drogą pozostaje regulacja obejmująca wszystkie amerykańskie firmy rozwijające modele graniczne, również te, które nie podjęłyby dobrowolnej współpracy. Ponieważ przyjęcie ustawy wymaga czasu, autor proponuje równolegle dobrowolne ustalanie standardów między firmami, co komplikuje prawo konkurencji:
For antitrust reasons, it’s helpful for the US government to mediate or at least enable these discussions — they don’t need to participate, but do need to issue a narrow waiver for certain kinds of safety conversations.
🇵🇱 Ze względu na prawo konkurencji warto, aby rząd Stanów Zjednoczonych pośredniczył w tych rozmowach lub przynajmniej je umożliwił: nie musi w nich uczestniczyć, ale powinien przyznać wąskie wyłączenie dla niektórych rodzajów rozmów o bezpieczeństwie. — Dario Amodei, dyrektor generalny Anthropic, w We Must Pace the Frontier
Na końcu przewidziano globalną koordynację, stopniowaną od zakazu zastosowań ewidentnie niebezpiecznych, takich jak broń biologiczna, aż po „pauzę”, w ramach której uczestniczące rządy ograniczyłyby ogólne tempo postępów — rozwiązanie, które Amodei uważa za mało prawdopodobne w perspektywie krótkoterminowej.
13 września — Aidan Gomez, współzałożyciel i dyrektor generalny Cohere, odpowiada mu w artykule zatytułowanym Who Gets to Define the Rules for AI?, z podtytułem „standardy oparte na dowodach, a nie kartel”. Cohere popiera niezależną ocenę najbardziej zaawansowanych systemów, ale odczytuje opublikowany w tym tygodniu plan Daria Amodeia jako żądanie wyłączenia spod przepisów antymonopolowych w imię bezpieczeństwa. Według Aidana Gomeza garstka laboratoriów z jednego kraju uzgodniłaby standardy i tempo postępów, a następnie narzuciłaby te zasady pozostałym twórcom bez konsultacji społecznych ani głosowania.
Esej rzeczywiście zawiera punkt wskazany przez Cohere: skoordynowana strategia dałaby twórcom modeli granicznych ten czas „bez poświęcania przewagi handlowej ani pozycji Stanów Zjednoczonych jako lidera w AI”. Nigdzie jednak nie stwierdza, że pozostali twórcy mieliby podporządkować się decyzjom uczestników: taki obowiązek jest interpretacją ścieżki regulacyjnej dokonaną przez Cohere, a pisemny postulat dotyczy wąskiego wyłączenia, ograniczonego do określonych rozmów o bezpieczeństwie. Cohere proponuje cztery filary:
| Filar proponowany przez Cohere | Zakres filaru |
|---|---|
| Ramy ryzyka oparte na dowodach | Opracowane przez wiele krajów i opublikowane wraz z rozbieżnymi stanowiskami; zasady powiązane z możliwościami, a nie tożsamością twórcy |
| Obowiązkowa przejrzystość | Udokumentowane projekt, możliwości, ryzyka i środki zaradcze; zgłaszanie poważnych incydentów |
| Testy ograniczone przez dowody | Wyłącznie w odniesieniu do możliwości uznawanych za niebezpieczne, takich jak cyberataki lub broń biochemiczna; certyfikacja otwarta dla każdej firmy |
| Niezależne mechanizmy zapewniania | Audyty wzorowane na finansach, lotnictwie i energetyce jądrowej, w których audytor nigdy nie jest opłacany przez audytowanego |
🔗 We Must Pace the Frontier, esej Daria Amodeia 🔗 Who Gets to Define the Rules for AI?, artykuł Cohere
ElevenLabs zmienia swój MCP w studio twórcze — od głosu po wideo
14 września — ElevenLabs rozszerza swój oficjalny serwer MCP o funkcje twórcze: z poziomu używanego już asystenta można teraz generować mowę, transkrypcje, dubbing, muzykę, efekty dźwiękowe, obrazy i filmy. To ten sam MCP co w ElevenLabs Agents, który 17 sierpnia trafił do Claude, aby umożliwić zarządzanie agentami głosowymi: jedna instalacja obejmuje oba zastosowania.
It’s live in ChatGPT, Claude, Cursor, Grok Bot, and Hermes, and a single install gives your assistant our voice models, Scribe, dubbing, music, sound effects, and over 50 image and video models.
🇵🇱 Jest dostępny w ChatGPT, Claude, Cursor, Grok Bot i Hermes, a jedna instalacja zapewnia asystentowi dostęp do naszych modeli głosowych, Scribe, dubbingu, muzyki, efektów dźwiękowych oraz ponad 50 modeli obrazu i wideo. — @ElevenLabs na X
| Element dostępny przez MCP | Zastosowanie opisane w wątku z ogłoszeniem |
|---|---|
| Synteza mowy (Text to Speech) | Lektor wykorzystujący dowolny głos z biblioteki, dostarczany w rozmowie |
| Scribe (Speech to Text) | Transkrypcja do ponownego użycia jako scenariusz, napisy lub podstawa dubbingu |
| Dubbing | Wersja w innym języku tworzona przez ten sam konektor |
| Muzyka i efekty dźwiękowe | Podkład muzyczny i oprawa dźwiękowa kompletnego utworu |
| Ponad 50 modeli obrazu i wideo | Generowanie, retuszowanie, animowanie w formie wideo i synchronizacja ust (lipsync) |
ElevenLabs podkreśla możliwość łączenia tych elementów: pojedynczy brief pozwalałby stworzyć scenariusz, narrację lektorską, podkład muzyczny, oprawę dźwiękową i wideo. Wygenerowane pliki trafiają do przestrzeni roboczej ElevenCreative, a następnie można je otworzyć w Studio, aby dostosować oś czasu, dopracować narrację, nałożyć muzykę i efekty oraz wyeksportować materiał.
Wątek nie podaje ani listy modeli obrazu i wideo, ani zużycia kredytów, ani objętych ofertą planów, a w chwili naszego przeglądu żaden wpis na blogu nie opisywał szczegółowo tego ogłoszenia.
🔗 Ogłoszenie o kreatywnym MCP ElevenLabs
Copilot reguluje kompromis między kosztem a jakością automatycznego wyboru modelu
14 września — GitHub dodaje trzy poziomy (tiers) do automatycznego wyboru modelu (auto model selection) w Copilot. Wszystkie trzy korzystają z tej samej puli modeli, a Auto nadal ocenia każdy prompt: poziom jedynie ukierunkowuje wybór.
| Poziom Auto | Priorytet routingu | Docelowe zastosowanie |
|---|---|---|
| Wydajność | Koszt | Szybkie i proste zadania |
| Równowaga | Koszt, jakość i opóźnienie | Codzienna praca |
| Inteligencja | Jakość | Złożone zadania |
Zasady rozliczeń się nie zmieniają: opłata zależy od wybranego modelu, a płatni subskrybenci zachowują 10-procentową zniżkę. Poziomy są wdrażane w VS Code, Copilot CLI i aplikacji GitHub Copilot; Auto, ogólnie dostępne w VS Code od grudnia 2025 roku, trafiło do JetBrains w marcu, do CLI w kwietniu, a do agenta chmurowego Copilot w maju. GPT-6 Astra, Claude Fable 5.1 i Gemini 3.8 Flash, choć dostępne w Copilot, nie znajdują się w puli Auto: trzeba wybrać je ręcznie.
🔗 Dziennik zmian GitHub dotyczący poziomów Auto
Portable Computer, lokalny agent Perplexity, trafia na Windows
14 września — Perplexity udostępnia Portable Computer, całkowicie lokalną wersję swojego agenta Computer, w aplikacji na Windows. Obsługę Windows zapowiedziano jako nadchodzącą 3 września, podczas udostępnienia rozwiązania na komputery z Linux, które nastąpiło po premierze na DGX Spark 25 sierpnia. Teraz system Windows jest już faktycznie obsługiwany, a wraz z nim pojawiają się dwie dodatkowe funkcje: lokalny MCP, który steruje aplikacjami komputerowymi za pośrednictwem ich serwerów MCP zainstalowanych na komputerze, oraz zadania zaplanowane, wykonujące cykliczną pracę bezpośrednio na urządzeniu.
| Warunek dostępu | Opublikowane szczegóły |
|---|---|
| Karta graficzna | GeForce RTX lub RTX PRO z co najmniej 24 GB VRAM |
| Objęte subskrypcje | Pro i Max, zarówno indywidualne, jak i firmowe |
| Praca lokalna | Bez zużywania kredytów Computer |
Model, orkiestrator i harmonogram działają na komputerze; przełączenie na Perplexity Search lub jeden z ponad 15 modeli granicznych wymaga zgody użytkownika. Wpis NVIDIA wymienia ponadto konektory (Outlook, OneDrive, Word, Google Drive, Gmail, Slack, GitHub), zintegrowaną przeglądarkę i zapowiedzianą bez podania daty obsługę DGX Station. Oba źródła różnią się w kwestii modelu lokalnego: strona produktu Perplexity oferuje na komputerach RTX wyłącznie PPLX 27B, rezerwując Qwen 3.8 27B dla DGX Spark, podczas gdy NVIDIA podaje Qwen 3.8 27B jako przykład.
🔗 Wpis Perplexity o Portable Computer dla Windows 🔗 Wpis NVIDIA o komputerach RTX
Qwen Code 0.23.4 i Kimi Code 0.43.0 zmieniają cele oraz narzędzia swoich agentów
14 września — Dwaj agenci kodujący działający z poziomu wiersza poleceń publikują tego samego dnia nowe wersje, a obie wprowadzają zmiany w celach (goals), narzędziach MCP i hookach. Qwen Code jest agentem zespołu Qwen, a Kimi Code — Moonshot AI.
| Porównywany aspekt | Qwen Code 0.23.4 | Kimi Code 0.43.0 |
|---|---|---|
| Publikacja | 15:20 UTC, cztery dni po wersji 0.23.3 | 12:03 UTC, pięć dni po wersji 0.42.0 |
| Cele (goals) | Opcjonalne limity liczby tur (model.goalMaxTurns) i aktywnych minut (model.goalMaxActiveMinutes) | Usunięty limit 24 godzin; czas po zamknięciu sesji wyłączony z budżetów |
| MCP i hooki | permission_mode, agent_id i prompt_id przekazywane do każdego hooka; rozpoznawane nazwy narzędzi Claude Code | Pole deferred dla każdego serwera MCP do ładowania narzędzi na żądanie przez select_tools |
| Agenci i sesje | Wspólna tablica agentów (agent board), executor Codex dla subagentów | Usuwanie sesji z poziomu selektora |
| Kwestie wymagające uwagi | Dwie niekompatybilne zmiany, w tym limit czasu hooków poleceń odczytywany teraz w sekundach | Brak pytania o potwierdzenie dla rm -rf obejmującego wyłącznie /tmp lub /temp |
Qwen Code 0.23.4 zawiera 31 funkcji i 80 poprawek, z których kilka dotyczy prywatności: wysyłanie treści zapytań i odpowiedzi zależy teraz od ustawienia logPrompts. W Kimi Code odroczone ładowanie narzędzi pozostaje ukryte za eksperymentalną flagą tool-select, a poprawka sprawia, że zapisywane jest select_tools, dotychczas nieobecne w profilach agentów.
🔗 Informacje o wydaniu Qwen Code 0.23.4 🔗 Informacje o wydaniu Kimi Code 0.43.0
Aplikacja desktopowa ChatGPT dla systemu Linux, w której działa Codex, oficjalnie obsługuje Arch Linux
14 września — OpenAI Developers ogłasza oficjalne wsparcie Arch Linux przez aplikację desktopową ChatGPT dla systemu Linux, która zapewnia dostęp do projektów, lokalnych plików i Codex. W Arch instaluje się ją za pomocą skryptu dostarczonego przez OpenAI, a następnie aktualizuje przez pacman, menedżera pakietów tej dystrybucji, bez konieczności ponownego pakowania pakietu. Aplikacja, nadal dostępna w wersji zapoznawczej, pojawiła się 11 sierpnia na Ubuntu, Debianie i Fedorze. Dokumentacja precyzuje również, że skrypt konfiguruje podpisane repozytorium pakietów OpenAI, i przypomina o dwóch ograniczeniach wersji zapoznawczej dla systemu Linux: Computer Use nie jest jeszcze w niej dostępne, a natywna obsługa Wayland pozostaje eksperymentalna.
🔗 Ogłoszenie OpenAI Developers na X 🔗 Dokumentacja aplikacji dla systemu Linux
Devin Plugins, zarządzanie agentami opracowane z BlackRock
9 września — We wpisie opublikowanym 9 września na blogu Devin, bez ogłoszenia na X, Cognition przedstawia Devin Plugins, opracowane z BlackRock. Plugin jest wersjonowanym pakietem grupującym skills, reguły, serwery MCP, hooks i subagentów, stosowanym zarówno do agentów lokalnych (Devin CLI, Devin Desktop), jak i sesji w chmurze. Jest zgodny z otwartym standardem Agent Plugins, opisywanym już tutaj w sierpniu.
Pluginy instaluje się w zakresie Personal, Organization lub Enterprise, a w każdym zakresie można oznaczyć je jako wymagane, zalecane lub zabronione, przy czym nadrzędna decyzja ma pierwszeństwo. Cognition podaje przykład hooks blokujących agentom dostęp do infrastruktury i danych produkcyjnych, z wyjątkiem zespołu SRE. Pluginy, oparte na repozytoriach Git, są wersjonowane i poddawane przeglądom jak kod. Już 11 września premierę rozszerzono o ujednoliconą marketplace; wpis nie podaje ani ceny, ani szczegółów oferty.
🔗 Wpis Devin o zarządzaniu agentami z BlackRock 🔗 Dokumentacja Devin Plugins
Claude for Financial Advisors, jedenaście konektorów i osiem skills dla doradców
14 września — Anthropic wprowadza Claude for Financial Advisors, zestaw konektorów i skills dla doradców ds. zarządzania majątkiem. Pojawia się jedenaście nowych konektorów (Addepar, BlackRock, Charles Schwab, Envestnet, iCapital, Orion, SS&C Black Diamond, Wealthbox, Wealth.com, Vanguard i Zocks), a plugin instalowany z Cowork obejmuje osiem skills:
| Etap pracy | Skills pluginu |
|---|---|
| Przed spotkaniem | Pre-meeting prep, Prospect intake |
| Po spotkaniu | Post-meeting notes and follow-up |
| Analiza majątku | Portfolio rebalance review, Estate and tax brief, Alternative investments brief |
| Wdrożenie i zgodność | Advisor onboarding, Compliance and AI policy |
Krytyczne zadania wymagają zgody doradcy, a rekomendacje inwestycyjne i komunikacja z klientami nadal podlegają weryfikacji przez człowieka. Anthropic zaleca ofertę Enterprise zarejestrowanym doradcom inwestycyjnym (registered investment advisers) ze względu na dzienniki audytowe, przyznaje kredyt na korzystanie kancelariom, które wystąpią o nową licencję przed końcem września, i organizuje webinar 18 września.
🔗 Claude for Financial Advisors
Kod agentowy przeciąża CI Anthropic
14 września — Na blogu Claude Sachin Malhotra opisuje, jak kod agentowy wywarł presję na CI Anthropic.
| Wskaźnik opublikowany przez Anthropic | Ogłoszona wartość |
|---|---|
| Kod dostarczany przez inżyniera na kwartał | 8 razy więcej niż średnia z lat 2021–2025 |
| Udział kodu napisanego przez Claude | 80 % |
| Liczba zadań CI | Wzrost 25-krotny w ciągu sześciu miesięcy |
| Czas działania trzech poprawek | 70 dni, 29 dni, mniej niż jeden dzień |
| Ostateczna przebudowa | 3 tygodnie, jeden inżynier |
Wąskie gardło powstało w usłudze wyboru testów (test impact analysis), która określa testy uruchamiane dla każdego PR. Zaprojektowana jako pojedynczy proces, wyczerpała możliwości trzech kolejnych poprawek, zanim przeprowadzono przebudowę zgodnie z poradą Claude: stan przeniesiono do magazynu in-memory, a przetwarzanie, które stało się bezstanowe, rozłożono poziomo. Autor zaleca przygotowanie się na 25-krotnie większe obciążenie w ciągu dwóch kwartałów.
🔗 Kodowanie agentowe przeciąża CI
CobbleDB zastępuje DynamoDB w wyszukiwarce Perplexity
14 września — Perplexity szczegółowo opisuje CobbleDB, rozproszony magazyn klucz-wartość, który obecnie dostarcza jego wyszukiwarce wstępnie podzielone fragmenty i embeddings każdej strony, zastępując DynamoDB. Zbudowany na RocksDB, z trzema replikami na partycję, pamięcią podręczną i pamięcią masową NVMe, celowo rezygnuje z transakcji. Opóźnienia zmierzone w środowisku produkcyjnym dla odczytu grupowego:
| Percentyl opóźnienia | Wcześniej, z DynamoDB | Później, z CobbleDB |
|---|---|---|
| Mediana (p50) | 31,4 ms | 5,60 ms |
| 90. percentyl (p90) | 56,7 ms | 9,77 ms |
| 99. percentyl (p99) | 123 ms | 24,2 ms |
Perplexity zaznacza, że jest to porównanie stanu przed i po na podstawie rzeczywistego ruchu, wykonane w różnych momentach, a oszczędność wynosząca co najmniej 20 % względem DynamoDB jest wewnętrznym szacunkiem. Według firmy około 40 000 wierszy kodu w Rust tworzących rdzeń bazy napisali w dwa miesiące dwaj inżynierowie i setki agentów. Zapowiedziano publikację jako open source, bez podania daty.
TRL v1.14: asynchroniczne GRPO z LoRA rozproszone na HF Jobs
10 września — W oficjalnym wpisie z 10 września Hugging Face szczegółowo opisuje nowość w TRL v1.14: AsyncGRPOTrainer, który oddziela trening od generowania, może trenować adapter LoRA i synchronizować z vLLM wyłącznie ten adapter, czyli kilka megabajtów zamiast około 3 GB dla modelu o 1,5 miliarda parametrów. Trener i repliki vLLM działają jako osobne Jobs, połączone przez Storage Bucket.
| Zmierzony wskaźnik | Pierwszy run | Piąty run |
|---|---|---|
| Czas wykonania 500 kroków | 3 godz. 27 min | 53 min |
| Mediana czasu jednego kroku | 22,9 s | 4,8 s |
| MFU forward + backward | 3,9 % | 23,5 % |
| Nagroda z ostatnich 20 kroków | 0,438 | 0,416 |
Wzrost wydajności wyjaśniają trzy ustawienia: pakowanie sekwencji według micro-batch, wyłączenie ponownego obliczania aktywacji (gradient checkpointing) oraz zwiększenie liczby jednocześnie przetwarzanych żądań ze 128 do 384, przy porównywalnej nagrodzie. Początkowa konfiguracja kosztuje około 20 dolarów za godzinę, a skrypty umożliwiające odtworzenie wyników zostały opublikowane.
🔗 Asynchroniczne GRPO z LoRA na HF Jobs
Transformer Engine zwiększa 10,4-krotnie przepustowość dropless MoE w JAX
14 września — NVIDIA pokazuje, jak Transformer Engine przyspiesza w JAX trening mieszanin ekspertów bez odrzucania tokenów (dropless MoE), w których każdy ekspert otrzymuje zmienną liczbę tokenów. W przypadku DeepSeek-V3 tekst przypisuje 10,4-krotny wzrost platformie GB200, natomiast podpis pod ilustracją — GB300 NVL72.
| Metryka opublikowana przez NVIDIA | Ogłoszona wartość |
|---|---|
| Początkowa przepustowość | 103 TFLOPS na GPU |
| Udział komunikacji w czasie działania kernel | Początkowo 84 % |
| Przepustowość z Transformer Engine | 1 068 TFLOPS na GPU, czyli 10,4 razy więcej |
| Efektywność skalowania przy 1 024 GPU | 97 % |
Wzrost wynika między innymi z grouped GEMM w MXFP8, który przetwarza wszystkich ekspertów w jednym wywołaniu kernel, oraz ze scalonych operacji dispatch i combine przez NCCL EP. Optymalizacje są dostarczane w kontenerze NGC MaxText, a w dalszej kolejności zapowiedziano NVFP4.
🔗 Techniczny wpis NVIDIA o dropless MoE w JAX
PC-ALM, lokalne uczenie Sakana AI trenujące 1 000 warstw bez propagacji wstecznej
14 września — Sakana AI publikuje PC-ALM (Augmented Lagrangian Predictive Coding), metodę zastępującą propagację wsteczną (backpropagation) lokalną dynamiką, w której każda warstwa komunikuje się wyłącznie z sąsiednimi. Rozszerza ona kodowanie predykcyjne (predictive coding), wyposażając każdą warstwę w zmienne dualne — mnożniki Lagrange’a — które czynią z niej regulator proporcjonalno-całkujący ze sprzężeniem zwrotnym; w sieci liniowej zmienne te dokładnie odtwarzają sygnały przypisania zasług z propagacji wstecznej.
W przypadku MNIST rezydualne MLP o szerokości 32 pozostają około 2 punkty procentowe za propagacją wsteczną aż do 1 000 warstw. Na CIFAR-10 i Tiny ImageNet PC-ALM osiąga lepsze wyniki niż standardowe kodowanie predykcyjne, lecz rezultaty przedstawiono wyłącznie na wykresach. Sakana AI przedstawia ją jako pierwszą znaną firmie metodę lokalną zdolną trenować tak głębokie sieci, choć na zadaniach, które pozostają proste. Artykuł naukowy i kod zostały opublikowane.
🔗 Kodowanie predykcyjne ze wzmocnionym Lagrangianem
Scribe v2 Medical, transkrypcja medyczna ElevenLabs, jest ogólnie dostępna
11 września — Ogólna dostępność Scribe v2 Medical, ogłoszona 11 września wyłącznie w changelogu dokumentacji, bez tweeta ani wpisu, uzupełnia ofertę transkrypcji ElevenLabs. Ta dostrojona wersja Scribe v2 lepiej rozpoznaje nazwy leków, anatomię, patologię i dyktowanie kliniczne, zachowując jednocześnie dokładność Scribe v2 w przypadku mowy potocznej. Model przetwarza audio wsadowo, w tej samej cenie co Scribe v2, używa scribe_v2_medical jako identyfikatora modelu i oferuje te same opcje, od wykrywania encji po diaryzację. ElevenLabs przeznacza go do dokumentacji klinicznej, rozmów przy przyjęciu i procesów zgodności dotyczących chronionych danych zdrowotnych. Specyfikacja techniczna podaje o 15 % mniej błędów niż Scribe v2 w przypadku pojedynczych terminów medycznych oraz obsługę ponad 90 języków.
🔗 Changelog ElevenLabs z 11 września
Google Flow trafia na iPhone’a
10 września — Konto @FlowbyGoogle ogłosiło 10 września aplikację Google Flow na iOS, studio Google do tworzenia z użyciem AI. Według karty w App Store jest bezpłatna z zakupami w aplikacji, dostępna wyłącznie na iPhone’a i wymaga iOS 16 lub nowszego. Umożliwia tworzenie i edytowanie obrazów oraz filmów za pomocą modeli generatywnych Google, z wykorzystaniem galerii lub aparatu. Biblioteka pozostaje zsynchronizowana z wersją desktopową, a wiele procesów generowania może działać w tle, z powiadomieniem po przygotowaniu wyniku. Karta nie wymienia żadnego modelu.
🔗 Ogłoszenie @FlowbyGoogle na X 🔗 Google Flow w App Store
W skrócie
- Claude Tag w ochronie zdrowia, z dala od danych chronionych — Ponieważ Claude Tag nie jest jeszcze objęty umową BAA Anthropic, Insight Health, Tennr i Medallion ograniczają go do kanałów bez danych zdrowotnych; w Insight Health 97 % krytycznych alertów zostaje zamkniętych bez interwencji inżyniera. Kredyty Claude Tag oferowane organizacjom, które połączą go z GitHub, wygasają 1 października. 🔗 źródło
- Anthropic i Accenture publikują przewodnik dotyczący przejścia od pilotażu do produkcji — skierowany do dyrektorów IT, opiera się na dwóch danych Accenture: tylko 23 % kadry kierowniczej dostrzega trwały wpływ AI w skali całego przedsiębiorstwa, a 42 % organizacji nie ma jednej osoby odpowiedzialnej za jej koszty i wyniki. 🔗 źródło
- Claude Fable 5.1 rozwiązuje Cyphral Distich, kryptogram z 1653 roku — zewnętrzna demonstracja opisana we wpisie Vals AI z 31 sierpnia i udostępniona 13 września wieczorem czasu pacyficznego przez Borisa Cherny’ego: 44 minuty i 176 000 tokenów, bez interwencji człowieka. Autor przyznaje, że wskazówka była prosta. 🔗 źródło
- Fyxer uzyskuje akceptację 53 % swoich wersji roboczych e-maili bez zmian — w tym studium przypadku OpenAI asystent wykonawczy rozdziela pracę między 30 a 50 wyspecjalizowanych modeli, dostrojonych na podstawie poprawek użytkowników, a jego roczny przychód cykliczny wzrósł w 2025 roku z 1 do 32 milionów dolarów. Nie podano nazwy żadnego modelu. 🔗 źródło
- Devin przejmuje dyżury PagerDuty — według informacji o wydaniu z 11 września Devin może klasyfikować incydenty PagerDuty i publikować wyniki dochodzenia w notatkach dotyczących incydentu, 21 serwerów MCP łączy się jednym kliknięciem przez OAuth, a API Sessions v1 przyjmuje
idempotency_key. 🔗 źródło - DevFest 2026 od 1 października do 31 grudnia — Google Developer Groups planują ponad 800 wydarzeń w 115 krajach, obejmujących warsztaty i maratony tworzenia agentów (agent-athons) poświęcone Gemini, AI Studio, Antigravity i Web MCP. 🔗 źródło
- Suno przedstawia Studio Chat — ten asystent Suno Studio zna każdą ścieżkę i każdy fragment MIDI projektu oraz może porządkować, zmieniać nazwy, nadawać kolory lub pisać nową partię bezpośrednio na osi czasu. Nie ogłoszono ani dostępności, ani ceny. 🔗 źródło
- Ekosystem open source MiniMax H3 się rozrasta — MiniMax wyróżnia trzy projekty społecznościowe: VDN, który przeprojektowuje mechanizm attention, aby przyspieszyć inferencję, ośmioetapowe Acc-LoRAs PDD od Alibaba PAI oraz cztero- i ośmioetapowe Turbo LoRAs od LightX2V. 🔗 źródło
- Runway szczegółowo przedstawia realizację A Game of HORSE — samouczek wideo, prompty filmu krótkometrażowego oraz dostępna do pobrania skill runway-sd-enhancer, która przekształca surowy prompt w prompt produkcyjny dla 15-sekundowej sceny. 🔗 źródło
- Ai2 zleca studentom University of Washington przetestowanie AutoDiscovery — dziesięć zespołów przetestowało agenta: uzyskano przydatne tropy dotyczące baterii lub białek, ale około połowy hipotez dla 24 000 symulowanych konfiguracji reaktora była nielogiczna. Kredyty próbne przedłużono do 31 grudnia. 🔗 źródło
- Archsloth zbliża swoje modele GGUF Qwen do oryginału — społecznościowy wkład zespołu FINAL-Bench na blogu Hugging Face: przy takim samym rozmiarze jak plik unsloth jego
Q4_K_Mdla Qwen3-4B zmniejsza dywergencję KL o 54,4 % w języku koreańskim i o 33,2 % w języku angielskim dzięki dwóm poprawionym opcjom AutoRound. 🔗 źródło - Eric Mey mierzy zgodność agenta LangGraph z OpenAI — indywidualny wkład na tym samym blogu społecznościowym: sklasyfikowano wszystkie 37 pól żądania Chat Completions i żadne nie jest już po cichu ignorowane, w porównaniu z 11 na początku, jednak walidacja schematów nie wykryła błędu streamingu. 🔗 źródło
- EcoHash wylicza możliwości RTX PRO 6000 z 96 GB pamięci — wpis dostawcy inferencji oparty na pomiarach jego własnej usługi, z opublikowanymi surowymi plikami CSV: qwen3.6-35b-a3b dostarcza pierwszy token w 170 ms (p95) i około 213 tokenów na sekundę, a przy równoległym przetwarzaniu na Llama-3.1-8B przepustowość osiąga około 11 500 tokenów na sekundę. 🔗 źródło
Co to oznacza
Pierwszy wątek dotyczy agentów, których programujemy i nadzorujemy. Claude Mods pozwalają każdemu pisać własne hooki w TypeScript, ale kierują ich efekty uboczne przez obiekt $, który administratorzy mogą audytować i ograniczać. Devin Plugins stosuje tę samą logikę w skali przedsiębiorstwa, z pluginami wymaganymi lub zabronionymi zależnie od zakresu, GitHub pozwala wybrać kompromis między kosztem a jakością routingu Auto, zarówno Qwen Code, jak i Kimi Code umożliwiają ustawienie czasu trwania swoich celów, a Kimi Code może ładować narzędzia MCP na żądanie. MCP służy również jako kanał dystrybucji: pojedyncza instalacja udostępnia głos, muzykę oraz ponad 50 modeli obrazów i wideo ElevenLabs w pięciu asystentach, bez opuszczania rozmowy.
Drugi wątek dotyczy infrastruktury, którą ten agentowy kod poddaje presji lub sam buduje. W Anthropic, gdzie Claude pisze 80% kodu, liczba zadań CI wzrosła 25-krotnie w ciągu sześciu miesięcy, a przeprojektowanie usługi wyboru testów zajęło jednemu inżynierowi trzy tygodnie. W Perplexity dwóch inżynierów i setki agentów napisały 40 000 linii kodu CobbleDB w Rust, którego opóźnienie odczytu jest według przeprowadzonych pomiarów około pięciokrotnie niższe. Trenowanie podąża w tym samym kierunku: TRL skraca przebieg GRPO z 3 godz. 27 min do 53 min, a Transformer Engine zwiększa 10,4-krotnie przepustowość dropless MoE — oba wpisy najpierw lokalizują wąskie gardło, a następnie je usuwają.
Trzeci wątek ma charakter polityczny: kto wyznacza tempo i zasady. Trzy dni po artykule OpenAI wzywającym do uchwalenia prawa federalnego opartego na możliwościach modeli Dario Amodei proponuje kontrolowanie tempa rozwoju modeli frontier, zaczynając od otwarcia Anthropic na wbudowanych ewaluatorów, a Aidan Gomez kwestionuje tę metodę. Oba teksty są zgodne co do niezależnej oceny najpotężniejszych systemów, lecz różnią się w kwestii dalszych działań: z jednej strony regulacje obejmujące wszystkie amerykańskie firmy frontier, uzupełnione standardami omawianymi w ramach wąskiego wyłączenia antymonopolowego; z drugiej — ramy ryzyka opracowane przez wiele państw oraz audyty, za które nigdy nie płacą podmioty poddawane audytowi. Dyskusja dotyczy nie tyle samej zasady kontroli, ile tego, kto pisze jej reguły.
Ostatni wątek dotyczy danych wrażliwych, do których AI uzyskuje dostęp z zabezpieczeniami wbudowanymi w produkt. Portable Computer przechowuje pliki i zapytania na komputerze PC oraz prosi o zgodę przed wysłaniem czegokolwiek do chmury; Scribe v2 Medical jest przeznaczony do dyktowania klinicznego i procesów zgodności dotyczących chronionych danych zdrowotnych; Claude Tag, ponieważ nie jest objęty umową BAA, pozostaje ograniczony do kanałów, które nie zawierają takich danych; natomiast Claude for Financial Advisors pozostawia doradcy zatwierdzanie zadań krytycznych. Im bardziej agent zbliża się do dokumentacji pacjenta lub portfela klienta, tym wyraźniejsza staje się granica tego, co może robić samodzielnie.
Źródła
- Boris Cherny na X, Claude Mods
- Claude Code, zgłoszenie Function Hooks #91870
- Dario Amodei, We Must Pace the Frontier
- Dario Amodei na X, zapowiedź eseju
- Cohere, Who Gets to Define the Rules for AI?
- ElevenLabs na X, zapowiedź kreatywnego MCP
- ElevenLabs na X, kompatybilni klienci
- GitHub Changelog, poziomy automatycznego wyboru modelu
- GitHub Docs, About Copilot auto model selection
- Perplexity, Portable Computer dla Windows
- Perplexity, strona produktu Portable Computer
- NVIDIA, Portable Computer na komputerach PC RTX
- Qwen Code, informacje o wydaniu 0.23.4
- Kimi Code, informacje o wydaniu 0.43.0
- OpenAI Developers na X, Arch Linux
- ChatGPT, aplikacja dla Linux
- Devin, zarządzanie agentami z BlackRock
- Devin, dokumentacja pluginów
- Claude, Claude for Financial Advisors
- Claude, Agentic coding is straining CI
- Perplexity, CobbleDB
- Hugging Face, Async GRPO with LoRA across HF Jobs
- NVIDIA, dropless MoE w JAX z Transformer Engine
- Sakana AI, PC-ALM
- ElevenLabs, dziennik zmian z 11 września
- Google Flow na X
- Google Flow w App Store
- Claude, Claude Tag w ochronie zdrowia
- Claude, przewodnik od pilotażu do wdrożenia produkcyjnego z Accenture
- Boris Cherny na X, Cyphral Distich
- Vals AI, Claude Fable 5.1 Solves the Cyphral Distich
- OpenAI, studium przypadku Fyxer
- Devin, informacje o wydaniach
- Google, DevFest 2026
- Suno na X, Studio Chat
- MiniMax na X, ekosystem H3
- Runway na X, A Game of HORSE
- Ai2, AutoDiscovery i studenci University of Washington
- Hugging Face, Archsloth i AutoRound
- Hugging Face, zgodność agenta LangGraph z OpenAI
- Hugging Face, EcoHash i RTX PRO 6000