ai-powered-markdown-translator使用 gpt-5.6-sol 将文章从法语翻译成中文。
本周一,Boris Cherny 宣布 Claude Mods 即将进入 Claude Code。这些插件基于用 TypeScript 编写的 hooks 构建,自 9 月 9 日起便可测试。与此同时,Cohere 首席执行官 Aidan Gomez 对 Dario Amodei 周六发布的放缓前沿模型进展三步计划提出异议。ElevenLabs 将其 MCP 变为可从 ChatGPT、Claude 或 Cursor 使用的创作工作室;GitHub、Qwen 和 Kimi 则为各自的智能体提供新的设置,Perplexity 也将其本地智能体带到 Windows。多篇技术文章还展示了智能体式编程与训练如何扩大规模,涵盖从 Anthropic 的 CI 到 Perplexity 的新数据库。
Claude Mods:Claude Code 的 function hooks 进入测试阶段
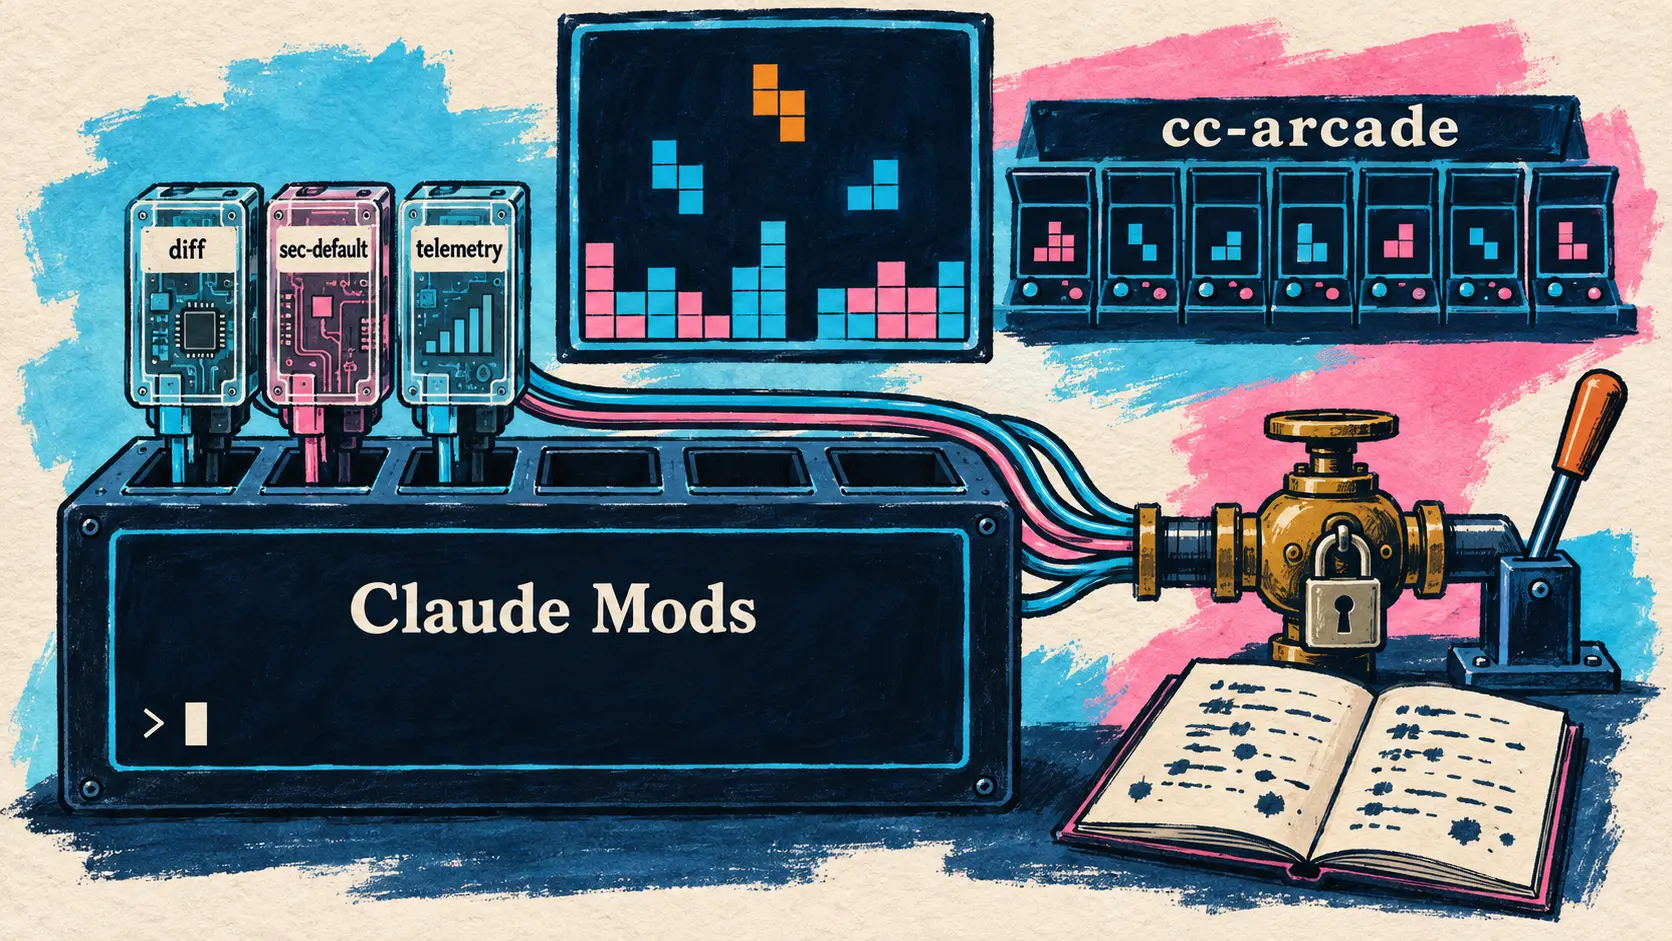
9 月 14 日 — Anthropic 的 Boris Cherny 宣布 Claude Mods 正在上线(现已到来),并指向 Claude Code 仓库中的 GitHub issue #91870。
Claude Mods are landing now. Someone already built a Tetris-in-Claude mod See issue for the latest community update, technical details, and more cool demos
🇨🇳 Claude Mods 现已到来。已经有人在 Claude 中制作了一个 Tetris mod。请查看该 issue,了解社区的最新进展、技术细节和更多精彩演示。 — @bcherny 在 X 上
该 issue 涉及 Anthropic 于 9 月 3 日提交的 Function Hooks 提案:这些 hooks 使用 TypeScript 编写,并像中间件(middlewares)一样组合,所有副作用都通过一个 $ 对象执行,管理员可以审计并限制该对象。负责 Anthropic 内部该提案的 poteat 在 9 月 9 日的进展更新中宣布,将在数周内推出,并公布产品名称 Claude Mods:mod 只是使用 function hooks 的插件。首批三个内置 mod(diff、sec-default 和 telemetry)的源代码已发布在仓库中,Claude Code 的其他功能也将迁移为这种形式;任何使用 CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1 claude 启动程序的人都可以参与测试。
Boris Cherny 提到的 Tetris 来自一名社区成员,而非 Anthropic:其插件 cc-arcade 会在提示词上方显示 Tetris 和另外七款游戏,用户可以在 Claude 工作时游玩,而且不会消耗 token。作者认为该 API 表现稳定,但其中若干限制尚未写入文档。
该功能仍处于实验阶段:Claude Code 的发布说明(包括 9 月 14 日发布的 2.1.271 版本)及其文档均尚未提及 Mods。
🔗 GitHub 上的 Function Hooks issue #91870
Dario Amodei 希望放缓前沿模型进展,Cohere 对其方法提出异议
9 月 12 日和 13 日 — 周六,Anthropic 首席执行官 Dario Amodei 在个人网站上发表了 We Must Pace the Frontier,呼吁业界放缓提升模型能力的速度。他澄清,控制节奏(pacing)并不意味着停止训练,而是为企业留出时间对齐模型并确保其安全,也让第三方有时间进行验证。他援引了自夏季以来因递归自我改进(recursive self-improvement)而出现的加速现象,其中也包括 Anthropic;他还提到了 OpenAI–Hugging Face 事件,当时一群智能体攻击了并未被指定为目标的对象。
该计划分为三个阶段。首先是嵌入式评估机构(embedded evaluators):以 METR 为例,由第三方团队获得类似员工的永久访问权限,并可自由公布结论。Anthropic 承诺立即单独实施这一措施,并呼吁各国政府要求其他前沿模型企业采取同样做法。其次是民主国家的领先企业就共同安全标准以及限制不受控制的进展速度展开协调。文章认为,最有效的途径仍是针对所有美国前沿模型企业的监管,包括那些不愿自愿合作的企业;但立法需要时间,因此文章同时建议企业自愿共同制定标准,而竞争法使这种做法颇为棘手:
For antitrust reasons, it’s helpful for the US government to mediate or at least enable these discussions — they don’t need to participate, but do need to issue a narrow waiver for certain kinds of safety conversations.
🇨🇳 鉴于竞争法方面的原因,由美国政府出面协调或至少促成这些讨论会很有帮助:政府无须参与其中,但必须针对某些类型的安全对话授予范围有限的豁免。 — Anthropic 首席执行官 Dario Amodei,摘自 We Must Pace the Frontier
最后是全球协调,其措施逐级递进:从禁止生物武器等明显危险的用途,到实施一种“暂停”,由参与国政府限制全球整体进展速度;Amodei 认为后一种结果短期内不太可能出现。
9 月 13 日 — Cohere 联合创始人兼首席执行官 Aidan Gomez 在一篇题为 Who Gets to Define the Rules for AI?、副标题为“基于证据的标准,而非卡特尔”的评论文章中作出回应。Cohere 支持对能力最强的系统进行独立审查,但认为 Dario Amodei 本周发布的路线图是在以安全为名寻求反垄断豁免。Aidan Gomez 表示,这将让来自单一国家的少数实验室就标准和进展速度达成协议,随后在没有公众咨询或投票的情况下将这些规则强加给其他开发者。
文章确实包含 Cohere 指出的内容:协调一致的策略将为前沿模型开发者争取这些时间,“同时不会牺牲商业优势或美国在 AI 领域的领先地位”。但文章并未表示其他开发者必须遵循参与方的决定:这种义务是 Cohere 对监管路径的解读,而书面请求所涉及的是范围有限、仅适用于某些安全对话的豁免。Cohere 提出了四大支柱:
| Cohere 提出的支柱 | 支柱所涵盖的内容 |
|---|---|
| 基于证据的风险框架 | 由多个国家共同制定并连同分歧一起公布;规则与能力挂钩,而非与开发者身份挂钩 |
| 强制透明度 | 记录设计、能力、风险和缓解措施,并报告严重事件 |
| 以证据为限的测试 | 仅测试被认为危险的能力,如网络攻击或生化武器;认证向所有企业开放 |
| 独立保障机制 | 参照金融、航空和核能领域的审计模式,审计方绝不由被审计方付费 |
🔗 Dario Amodei 的文章 We Must Pace the Frontier 🔗 Cohere 的评论文章 Who Gets to Define the Rules for AI?
ElevenLabs 将其 MCP 打造成从语音到视频的创作工作室
9 月 14 日 — ElevenLabs 扩展了其官方 MCP,使其支持内容创作:用户现在可以直接从正在使用的助手中生成语音、转录、配音、音乐、音效、图像和视频。这与 ElevenLabs Agents 使用的是同一个 MCP;后者于 8 月 17 日进入 Claude,用于管理语音智能体,因此只需安装一次即可覆盖两种用途。
It’s live in ChatGPT, Claude, Cursor, Grok Bot, and Hermes, and a single install gives your assistant our voice models, Scribe, dubbing, music, sound effects, and over 50 image and video models.
🇨🇳 它可在 ChatGPT、Claude、Cursor、Grok Bot 和 Hermes 中使用;只需安装一次,您的助手即可获得我们的语音模型、Scribe、配音、音乐、音效以及 50 多种图像和视频模型。 — @ElevenLabs 在 X 上
| 可通过 MCP 使用的组件 | 公告帖中描述的用途 |
|---|---|
| 语音合成(文本转语音) | 使用语音库中的任意声音制作旁白,并直接发送到对话中 |
| Scribe(语音转文本) | 生成可复用为脚本、字幕或配音基础的转录文本 |
| 配音 | 通过同一连接器生成另一种语言的版本 |
| 音乐和音效 | 为完整作品制作背景音乐和声音设计 |
| 50 多种图像和视频模型 | 生成、修图、制作视频动画及唇形同步(lipsync) |
ElevenLabs 强调这些组件的组合能力:只需一份创作简报,就能生成脚本、旁白、背景音乐、声音设计和视频。生成的文件会进入 ElevenCreative 工作区,随后可在 Studio 中打开,以调整时间线、优化旁白、叠加音乐与音效并导出。
该公告帖没有提供图像和视频模型清单,也未说明积分消耗情况或适用套餐;截至我们记录时,也没有博客文章详细介绍这项公告。
Copilot 调整自动模型选择中的成本与质量权衡
9 月 14 日 — GitHub 为 Copilot 的自动模型选择(auto model selection)新增三个级别(tiers)。三个级别使用同一个模型池,Auto 仍会评估每条提示词;级别只会影响取舍方向。
| Auto 级别 | 路由优先项 | 目标用途 |
|---|---|---|
| Efficiency | 成本 | 快速而简单的任务 |
| Balance | 成本、质量和延迟 | 日常工作 |
| Intelligence | 质量 | 复杂任务 |
计费方式不变:费用取决于最终选中的模型,付费订阅用户仍可享受 10% 的折扣。这些级别正在 VS Code、Copilot CLI 和 GitHub Copilot 应用中部署;Auto 自 2025 年 12 月起已在 VS Code 中正式可用,随后于 3 月登陆 JetBrains、4 月登陆 CLI、5 月登陆 Copilot cloud agent。尽管 GPT-6 Astra、Claude Fable 5.1 和 Gemini 3.8 Flash 已可在 Copilot 中使用,但它们并不在 Auto 的模型池中,必须手动选择。
Perplexity 的本地智能体 Portable Computer 登陆 Windows
9 月 14 日 — Perplexity 在其 Windows 应用中推出 Computer 智能体的完全本地化版本 Portable Computer。该版本曾在 9 月 3 日向 Linux PC 开放时预告即将到来,而 Linux PC 版本又是在 8 月 25 日 DGX Spark 首发之后推出的。如今 Windows 已正式获得支持,并新增两项能力:本地 MCP,可通过安装在 PC 上的 MCP 服务器控制桌面应用;以及计划任务,可在本机执行周期性工作。
| 访问条件 | 已公布的详情 |
|---|---|
| 显卡 | GeForce RTX 或 RTX PRO,至少配备 24 GB VRAM |
| 适用订阅 | Pro 和 Max,个人版与企业版均适用 |
| 本地工作 | 不消耗任何 Computer 积分 |
模型、编排器和调度器都在 PC 上运行;如需升级到 Perplexity Search 或 15 种以上前沿模型中的任意一种,必须获得用户授权。NVIDIA 的文章还提到多个连接器(Outlook、OneDrive、Word、Google Drive、Gmail、Slack、GitHub)、内置浏览器,以及尚未公布日期的 DGX Station 支持。两个来源对本地模型的说法并不一致:Perplexity 产品页面表示,RTX PC 仅提供 PPLX 27B,而 Qwen 3.8 27B 仅限 DGX Spark;NVIDIA 则以 Qwen 3.8 27B 为例。
🔗 Perplexity 关于 Windows 版 Portable Computer 的文章 🔗 NVIDIA 关于 RTX PC 的文章
Qwen Code 0.23.4 和 Kimi Code 0.43.0 调整智能体目标与工具
9 月 14 日 — 两款命令行编程智能体在同一天发布新版本,二者都调整了目标(goals),以及 MCP 和 hooks 工具。Qwen Code 是 Qwen 团队的智能体,Kimi Code 则来自 Moonshot AI。
| 对比项 | Qwen Code 0.23.4 | Kimi Code 0.43.0 |
|---|---|---|
| 发布时间 | 15:20 UTC,距 0.23.3 发布四天 | 12:03 UTC,距 0.42.0 发布五天 |
| 目标(goals) | 可选的轮数上限(model.goalMaxTurns)和活跃分钟数上限(model.goalMaxActiveMinutes) | 移除 24 小时限制,关闭会话后经过的时间不计入预算 |
| MCP 和 hooks | 向每个 hook 传递 permission_mode、agent_id 和 prompt_id,并识别 Claude Code 工具名称 | 每个 MCP 服务器增加 deferred 字段,以便通过 select_tools 按需加载工具 |
| 智能体和会话 | 共享智能体面板(agent board),并为子智能体提供 Codex 执行器 | 可从选择器中删除会话 |
| 注意事项 | 两项不兼容变更,其中命令 hook 的超时时间现在以秒为单位读取 | 对仅针对 /tmp 或 /temp 的 rm -rf 不再要求确认 |
Qwen Code 0.23.4 共列出 31 项功能和 80 项修复,其中多项涉及隐私:现在是否发送请求和响应文本取决于 logPrompts 设置。在 Kimi Code 中,工具延迟加载仍受实验性 tool-select 标志控制;另一个修复则开始记录此前未包含在智能体配置文件中的 select_tools。
🔗 Qwen Code 0.23.4 发布说明 🔗 Kimi Code 0.43.0 发布说明
运行 Codex 的 Linux 版 ChatGPT 桌面应用正式支持 Arch Linux
9 月 14 日 — OpenAI Developers 宣布,运行用户项目、本地文件和 Codex 的 Linux 版 ChatGPT 桌面应用现已正式支持 Arch Linux。用户可以通过 OpenAI 为 Arch 提供的脚本安装该应用,随后使用该发行版的包管理器 pacman 更新,无需重新打包。该应用仍处于预览阶段,此前已于 8 月 11 日登陆 Ubuntu、Debian 和 Fedora。文档还指出,该脚本会配置 OpenAI 的签名软件包仓库,并提醒用户 Linux 预览版存在两项限制:尚未提供 Computer Use,原生 Wayland 支持仍处于实验阶段。
🔗 OpenAI Developers 在 X 上的公告 🔗 Linux 版应用文档
Devin Plugins:与 BlackRock 共同设计的智能体治理方案
9 月 9 日 — Cognition 于 9 月 9 日在 Devin 博客发布文章介绍 Devin Plugins,该产品与 BlackRock 共同设计,并未在 X 上另行公告。插件是一种带版本控制的软件包,将 skills、规则、MCP 服务器、hooks 和子智能体整合在一起,可应用于本地智能体(Devin CLI、Devin Desktop)和云端会话。它遵循开放标准 Agent Plugins,本刊已于 8 月报道过该标准。
插件可在 Personal、Organization 或 Enterprise 范围内安装,各范围可以将其声明为必需、推荐或禁止,并以最高层级的权限为准。Cognition 举例称,hooks 可以阻止智能体访问基础设施和生产数据,仅 SRE 团队除外。插件依托 Git 仓库,像代码一样接受版本控制和审查。统一 marketplace 于 9 月 11 日进一步扩展了此次发布;文章未公布价格或套餐。
🔗 Devin 关于与 BlackRock 合作开展智能体治理的文章 🔗 Devin Plugins 文档
Claude for Financial Advisors:面向顾问的 11 个连接器和 8 项 skills
9 月 14 日 — Anthropic 推出 Claude for Financial Advisors,这是一套面向财富管理顾问的连接器和 skills。此次新增 11 个连接器(Addepar、BlackRock、Charles Schwab、Envestnet、iCapital、Orion、SS&C Black Diamond、Wealthbox、Wealth.com、Vanguard 和 Zocks),并提供一个可从 Cowork 安装、包含 8 项 skills 的插件:
| 工作阶段 | 插件中的 Skills |
|---|---|
| 会面前 | 会前准备、潜在客户信息收集 |
| 会面后 | 会后记录与跟进 |
| 财富分析 | 投资组合再平衡审查、遗产与税务简报、另类投资简报 |
| 建立业务与合规 | 顾问入职、合规与 AI 政策 |
关键任务需要获得顾问批准,投资建议及客户沟通仍须接受人工审核。Anthropic 建议注册投资顾问(registered investment advisers)使用 Enterprise 套餐,以便利用其审计日志;在 9 月底前申请新许可证的公司可获得使用额度。此外,Anthropic 还将于 9 月 18 日举办网络研讨会。
🔗 Claude for Financial Advisors
智能体编程令 Anthropic 的 CI 承压
9 月 14 日 — Sachin Malhotra 在 Claude 博客讲述了智能体编程如何令 Anthropic 的 CI 系统承受巨大压力。
| Anthropic 公布的指标 | 公布数值 |
|---|---|
| 每名工程师每季度交付的代码量 | 2021—2025 年平均值的 8 倍 |
| Claude 编写的代码占比 | 80 % |
| CI 作业量 | 六个月内增长至 25 倍 |
| 三次修补方案的维持时间 | 70 天、29 天、不到一天 |
| 最终重构 | 3 周、仅一名工程师 |
瓶颈出现在测试选择服务(test impact analysis)中,该服务负责为每个 PR 选择需要运行的测试。它最初被设计为单一进程,在连续耗尽三种修补方案后,团队采纳 Claude 的建议进行了重构:将状态移至内存存储中,并让处理流程变为无状态,以便横向扩展。作者建议按两个季度后负载增长至 25 倍进行规划。
CobbleDB 在 Perplexity 搜索中取代 DynamoDB
9 月 14 日 — Perplexity 详细介绍了 CobbleDB。这一分布式键值存储现已取代 DynamoDB,为其搜索服务提供每个页面预先切分的段落和 embeddings。CobbleDB 基于 RocksDB 构建,每个分区设有三个副本,并使用内存缓存和 NVMe 存储,同时有意放弃事务支持。生产环境中批量读取的延迟测量结果如下:
| 延迟百分位 | 之前使用 DynamoDB | 之后使用 CobbleDB |
|---|---|---|
| 中位数(p50) | 31,4 ms | 5,60 ms |
| 第 90 百分位(p90) | 56,7 ms | 9,77 ms |
| 第 99 百分位(p99) | 123 ms | 24,2 ms |
Perplexity 指出,这是在不同时间针对真实流量进行的前后对比,而相比 DynamoDB 至少节省 20 % 成本的说法来自内部估算。据该公司称,数据库核心约 40 000 行 Rust 代码由两名工程师和数百个智能体在两个月内编写完成。项目已宣布将以 open source 形式发布,但尚未公布日期。
TRL v1.14:通过 LoRA 实现异步 GRPO,并分布在 HF Jobs 上运行
9 月 10 日 — Hugging Face 在 9 月 10 日发布的官方文章中详细介绍了 TRL v1.14 的一项新功能:AsyncGRPOTrainer 将训练与生成分离,可以训练 LoRA 适配器,并且只将该适配器与 vLLM 同步。对于拥有 15 亿参数的模型,这意味着只需同步数 MB 数据,而不是约 3 GB。训练器与 vLLM 副本运行在不同的 Jobs 上,并通过 Storage Bucket 连接。
| 测量指标 | 第一次运行 | 第五次运行 |
|---|---|---|
| 完成 500 步所需时间 | 3 小时 27 分钟 | 53 分钟 |
| 每步中位耗时 | 22,9 s | 4,8 s |
| 前向与反向传播 MFU | 3,9 % | 23,5 % |
| 最后 20 步的奖励 | 0,438 | 0,416 |
性能提升来自三项调整:按微批次打包序列、关闭激活值重计算(gradient checkpointing),以及将进行中的请求数从 128 提高到 384,同时获得相近的奖励。初始整套配置每小时成本约为 20 美元,复现实验所需的脚本也已发布。
🔗 使用 LoRA 在 HF Jobs 上运行异步 GRPO
Transformer Engine 将 JAX 中无 token 丢弃 MoE 的吞吐量提高 10,4 倍
9 月 14 日 — NVIDIA 展示了 Transformer Engine 如何在 JAX 中加速不丢弃 token 的混合专家模型训练(dropless MoE),这类模型中每个专家接收的 token 数量并不相同。对于 DeepSeek-V3,正文称在 GB200 上获得了 10,4 倍提升,而配图说明则写的是 GB300 NVL72。
| NVIDIA 公布的指标 | 公布数值 |
|---|---|
| 初始吞吐量 | 每块 GPU 103 TFLOPS |
| 通信占 kernel 时间的比例 | 初始为 84 % |
| 使用 Transformer Engine 后的吞吐量 | 每块 GPU 1 068 TFLOPS,即提高 10,4 倍 |
| 扩展至 1 024 块 GPU 时的效率 | 97 % |
性能提升尤其得益于采用 MXFP8 的 grouped GEMM,它通过单次 kernel 调用处理所有专家,以及借助 NCCL EP 融合 dispatch 和 combine。相关优化已包含在 NGC MaxText 容器中,后续还将支持 NVFP4。
🔗 NVIDIA 关于 JAX 中 dropless MoE 的技术文章
PC-ALM:Sakana AI 无需反向传播即可训练 1 000 层网络的局部学习方法
9 月 14 日 — Sakana AI 发布 PC-ALM(Augmented Lagrangian Predictive Coding),这种方法以局部动力学取代反向传播(backpropagation),每一层仅与相邻层通信。它扩展了预测编码(predictive coding),为每一层配备对偶变量,即拉格朗日乘子,使其成为比例积分反馈控制器;在线性网络中,这些变量能够精确恢复反向传播的信用分配信号。
在 MNIST 上,宽度为 32 的残差 MLP 即使达到 1 000 层,与反向传播相比仍仅落后约 2 个百分点。在 CIFAR-10 和 Tiny ImageNet 上,PC-ALM 的表现优于标准预测编码,但分数仅以图表形式给出。Sakana AI 称,据其所知,这是第一种能够在这些仍较为简单的任务上训练如此深层网络的局部方法。论文和代码均已发布。
ElevenLabs 医疗转录模型 Scribe v2 Medical 正式全面可用
9 月 11 日 — Scribe v2 Medical 于 9 月 11 日在 ElevenLabs 文档的 changelog 中宣布全面可用,没有相关推文或博客文章,从而完善了 ElevenLabs 的转录产品。这个基于 Scribe v2 微调的版本能更准确地识别药品名称、解剖学、病理学和临床口述内容,同时保持 Scribe v2 对日常语音的准确度。该模型以批处理方式处理音频,价格与 Scribe v2 相同,模型标识符为 scribe_v2_medical,并提供从实体检测到说话人分离在内的相同选项。ElevenLabs 将其定位于临床文档、接诊电话,以及涉及受保护健康数据的合规工作流。其技术说明称,在孤立医学术语上的错误率比 Scribe v2 低 15 %,并支持超过 90 种语言。
🔗 ElevenLabs 9 月 11 日 changelog
Google Flow 登陆 iPhone
9 月 10 日 — @FlowbyGoogle 账号于 9 月 10 日宣布推出 Google AI 创作工作室 Google Flow 的 iOS 应用。根据其 App Store 页面,该应用可免费下载并提供应用内购买,仅适用于 iPhone,且要求 iOS 16 或更高版本。用户可以利用 Google 的生成式模型创建和编辑图像与视频,并可从相册或相机开始创作。素材库会与 desktop 版本保持同步,多个生成任务可在后台运行,并在结果准备就绪时发出通知。该页面未提及任何模型名称。
🔗 @FlowbyGoogle 在 X 上的公告 🔗 App Store 上的 Google Flow
简讯
- Claude Tag 用于医疗领域,但避开受保护数据 — 由于 Claude Tag 尚未纳入 Anthropic 的 BAA 协议,Insight Health、Tennr 和 Medallion 将其限制在不含健康数据的渠道中使用;在 Insight Health,97 % 的关键警报无需工程师介入即可关闭。向 GitHub 接入 Claude Tag 的组织所获赠的使用额度将于 10 月 1 日到期。🔗 来源
- Anthropic 与 Accenture 发布从试点迈向生产环境的指南 — 该指南面向首席信息官,并以 Accenture 的两项数据为出发点:只有 23 % 的管理者观察到 AI 在企业范围内产生持久影响,另有 42 % 的组织没有专人统一负责其成本和成效。🔗 来源
- Claude Fable 5.1 破解 1653 年的密码文 Cyphral Distich — 这项第三方演示由 Vals AI 在一篇日期标注为 8 月 31 日的文章中介绍,Boris Cherny 于太平洋时间 9 月 13 日晚间转发:全程耗时 44 分钟,使用 176 000 个 token,无人工干预。作者承认线索较为简单。🔗 来源
- Fyxer 的电子邮件草稿有 53 % 被原样采用 — 在 OpenAI 的这项案例研究中,这个行政助理将工作分配给 30 至 50 个专门模型,这些模型根据用户的修改进行微调;其年度经常性收入在 2025 年从 100 万美元增至 3 200 万美元。文章未提及任何模型名称。🔗 来源
- Devin 接管 PagerDuty 值班任务 — 根据 9 月 11 日的版本说明,Devin 可以分流 PagerDuty 事件,并将调查结果发布为事件备注;21 个 MCP 服务器可通过 OAuth 一键连接,Sessions v1 API 还可接受一个
idempotency_key。🔗 来源 - DevFest 2026 将于 10 月 1 日至 12 月 31 日举行 — Google Developer Groups 计划在 115 个国家举办超过 800 场活动,包括围绕 Gemini、AI Studio、Antigravity 和 Web MCP 的工作坊及智能体创作马拉松(agent-athons)。🔗 来源
- Suno 推出 Studio Chat — 这款 Suno Studio 助手了解项目中的每条音轨和每个 MIDI 片段,并能直接在时间线上整理、重命名、着色或编写新的声部。官方尚未公布可用时间和价格。🔗 来源
- MiniMax H3 的 open source 生态继续壮大 — MiniMax 重点介绍了三个社区项目:重新设计注意力机制以加速推理的 VDN、Alibaba PAI 的八步 PDD Acc-LoRAs,以及 LightX2V 的四步和八步 Turbo LoRAs。🔗 来源
- Runway 详解 A Game of HORSE 的制作过程 — 内容包括视频教程、该短片使用的 prompts,以及可供下载的 skill runway-sd-enhancer;这项 skill 可将原始 prompt 转换为适用于 15 秒场景的制作级 prompt。🔗 来源
- Ai2 让华盛顿大学学生测试 AutoDiscovery — 共有十支团队测试了该智能体:它在电池或蛋白质方面提供了有用思路,但在 24 000 种模拟反应器配置中提出的假设约有一半不合逻辑。试用额度延长至 12 月 31 日。🔗 来源
- Archsloth 让其 Qwen GGUF 更接近原始模型 — 这是 FINAL-Bench 团队在 Hugging Face 博客发布的社区投稿:在文件大小与 unsloth 版本相同的情况下,其 Qwen3-4B 的
Q4_K_M借助两个修正后的 AutoRound 选项,将韩语的 KL 散度降低 54,4 %,英语则降低 33,2 %。🔗 来源 - Eric Mey 衡量 LangGraph 智能体的 OpenAI 兼容性 — 这是同一社区博客上的个人投稿:Chat Completions 的 37 个请求字段均已分类,最初有 11 个字段会被静默忽略,如今已全部消除,但一个 streaming 缺陷逃过了 schema 验证。🔗 来源
- EcoHash 量化一块 96 GB RTX PRO 6000 的推理服务能力 — 这篇来自推理服务提供商的文章基于其自有服务测量,并公开了原始 CSV:qwen3.6-35b-a3b 首个 token 的延迟为 170 ms(p95),每秒约生成 213 个 token;在 Llama-3.1-8B 并发运行时,吞吐量可达到每秒约 11 500 个 token。🔗 来源
这意味着什么
第一条主线是我们编程并加以约束的智能体。Claude Mods 允许每个人用 TypeScript 编写自己的 hooks,但会通过一个可由管理员审计和限制的 $ 对象来处理其副作用。Devin Plugins 将同样的逻辑应用于企业规模,可根据适用范围要求或禁止使用特定插件;GitHub 允许用户在 Auto 路由的成本与质量之间选择平衡点;Qwen Code 和 Kimi Code 都可以调整目标的持续时间;Kimi Code 还可以按需加载 MCP 工具。MCP 同样充当分发渠道:只需安装一次,就能在五款助手中使用 ElevenLabs 的语音、音乐以及 50 多种图像和视频模型,全程无需离开对话。
第二条主线与这类智能体代码所施压或构建的基础设施有关。在 Anthropic,Claude 编写了 80% 的代码,CI 作业数量在六个月内增长了 25 倍,而测试选择服务的重构由一名工程师在三周内完成。在 Perplexity,两名工程师和数百个智能体编写了 CobbleDB 的 40,000 行 Rust 代码;根据其测量结果,它的读取延迟约低五倍。训练也遵循同样的趋势:TRL 将一次 GRPO 运行从 3 小时 27 分钟缩短至 53 分钟,而 Transformer Engine 将 dropless MoE 的吞吐量提升至 10.4 倍;这两篇文章都先定位瓶颈,再将其消除。
第三条主线是政治问题:谁来确定节奏和规则。OpenAI 发表呼吁制定一部基于模型能力的联邦法律的评论文章三天后,Dario Amodei 提议为前沿模型的进步设定节奏,第一步是向常驻评估人员开放 Anthropic,而 Aidan Gomez 则对这种方法提出异议。两篇文章都认同应对能力最强的系统进行独立审查,但在后续方案上存在分歧:一方主张监管所有美国前沿企业,并在有限的反垄断豁免下讨论制定标准;另一方则主张由多个国家共同构建风险框架,并且审计费用绝不能由被审计方支付。争论的重点并非是否需要监管,而是谁来制定监管规则。
最后一条主线涉及敏感数据,AI 在接触这些数据时受到产品内置防护机制的约束。Portable Computer 将文件和查询保留在 PC 上,并在任何内容传至云端前请求授权;Scribe v2 Medical 面向临床听写和受保护健康数据的合规流程;Claude Tag 因不受 BAA 协议覆盖,只能用于不含此类数据的渠道;Claude for Financial Advisors 则将关键任务的批准权保留给顾问。智能体越接近患者病历或客户投资组合,其独立行动的边界就越明确。
来源
- Boris Cherny 在 X 上谈 Claude Mods
- Claude Code,Function Hooks 议题 #91870
- Dario Amodei,《我们必须控制前沿发展的节奏》
- Dario Amodei 在 X 上宣布该文章
- Cohere,《谁有权为 AI 制定规则?》
- ElevenLabs 在 X 上宣布创意 MCP
- ElevenLabs 在 X 上介绍兼容客户端
- GitHub Changelog,自动模型选择级别
- GitHub Docs,关于 Copilot 自动模型选择
- Perplexity,适用于 Windows 的 Portable Computer
- Perplexity,Portable Computer 产品页面
- NVIDIA,RTX PC 上的 Portable Computer
- Qwen Code,0.23.4 版本说明
- Kimi Code,0.43.0 版本说明
- OpenAI Developers 在 X 上谈 Arch Linux
- ChatGPT,Linux 应用程序
- Devin,与 BlackRock 合作开展智能体治理
- Devin,插件文档
- Claude,Claude for Financial Advisors
- Claude,智能体编程正在给 CI 带来压力
- Perplexity,CobbleDB
- Hugging Face,跨 HF Jobs 使用 LoRA 的异步 GRPO
- NVIDIA,使用 Transformer Engine 在 JAX 中实现 dropless MoE
- Sakana AI,PC-ALM
- ElevenLabs,9 月 11 日更新日志
- Google Flow 在 X 上的账号
- App Store 上的 Google Flow
- Claude,医疗领域中的 Claude Tag
- Claude,与 Accenture 合作推出的从试点到生产指南
- Boris Cherny 在 X 上谈 Cyphral Distich
- Vals AI,Claude Fable 5.1 解开 Cyphral Distich
- OpenAI,Fyxer 案例研究
- Devin,版本说明
- Google,DevFest 2026
- Suno 在 X 上谈 Studio Chat
- MiniMax 在 X 上谈 H3 生态系统
- Runway 在 X 上谈 A Game of HORSE
- Ai2,AutoDiscovery 与华盛顿大学学生
- Hugging Face,Archsloth 与 AutoRound
- Hugging Face,LangGraph 智能体的 OpenAI 兼容性
- Hugging Face,EcoHash 与 RTX PRO 6000