ai-powered-markdown-translatorgpt-5.6-sol을 사용하여 프랑스어에서 한국어로 번역된 기사.
이번 월요일, Boris Cherny는 TypeScript로 작성된 hook을 기반으로 하며 9월 9일부터 테스트할 수 있었던 플러그인 Claude Mods가 Claude Code에 도입된다고 발표했다. Cohere의 CEO Aidan Gomez는 프런티어 모델의 발전을 늦추기 위해 Dario Amodei가 토요일에 발표한 3단계 계획에 반박했다. ElevenLabs는 자사 MCP를 ChatGPT, Claude 또는 Cursor에서 이용할 수 있는 창작 스튜디오로 탈바꿈시켰으며, GitHub, Qwen 및 Kimi는 각자의 agent에 새로운 설정을 추가했고 Perplexity는 로컬 agent를 Windows에 도입했다. 마지막으로 여러 기술 게시물은 Anthropic의 CI부터 Perplexity의 새로운 데이터베이스까지, agentic code와 학습이 규모를 확장하는 모습을 보여준다.
Claude Code의 function hook인 Claude Mods가 테스트를 시작하다
9월 14일 — Anthropic의 Boris Cherny는 Claude Mods가 이제 도입되고 있다며 GitHub의 Claude Code 저장소에 있는 issue #91870을 안내했다.
Claude Mods are landing now. Someone already built a Tetris-in-Claude mod See issue for the latest community update, technical details, and more cool demos
🇰🇷 Claude Mods가 지금 도입되고 있습니다. 누군가는 이미 Claude 안에 Tetris mod를 만들었습니다. 최신 커뮤니티 진행 상황과 기술 세부 정보, 그 밖의 멋진 데모는 issue를 확인하세요. — @bcherny의 X 게시물
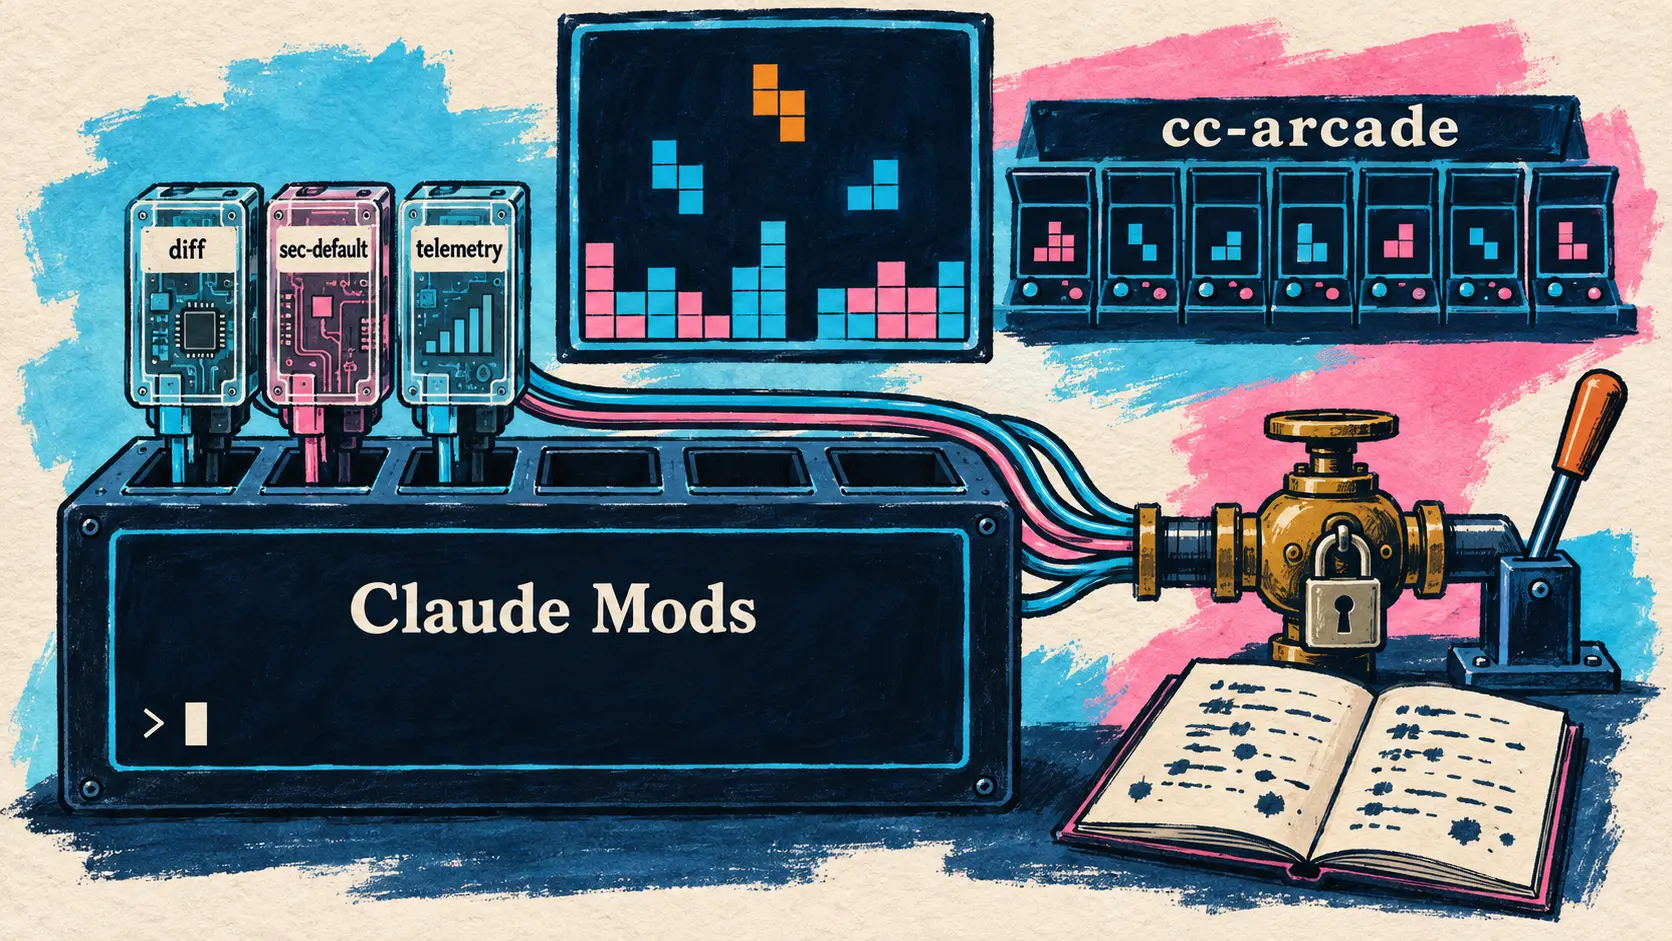
이 issue는 Anthropic이 9월 3일 제출한 Function Hooks 제안을 다룬다. 이는 TypeScript로 작성되고 middleware처럼 조합되는 hook으로, 모든 부수 효과는 관리자가 감사하고 제한할 수 있는 $ 객체를 거친다. Anthropic에서 이 제안을 이끄는 poteat는 9월 9일 진행 상황을 공유하며 몇 주 안에 출시될 예정이라고 밝히고 제품명 Claude Mods를 공개했다. mod는 function hook을 사용하는 플러그인일 뿐이다. 처음으로 내장된 세 가지 mod인 diff, sec-default 및 telemetry의 소스 코드가 저장소에 공개됐고, Claude Code의 다른 기능들도 이 형태로 이전될 예정이며, CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1 claude을 실행하는 사용자는 누구나 테스트할 수 있다.
Boris Cherny가 언급한 Tetris는 Anthropic이 아니라 커뮤니티 회원이 만들었다. 해당 사용자의 cc-arcade 플러그인은 프롬프트 위에 Tetris와 다른 게임 7개를 표시하며, Claude가 작업하는 동안 token을 소모하지 않고 플레이할 수 있게 한다. 제작자는 API가 안정적으로 작동했다고 평가했지만, 여러 제약 사항이 아직 문서화되지 않았다고 밝혔다.
이 기능은 여전히 실험 단계다. 9월 14일 공개된 2.1.271을 포함한 Claude Code 릴리스 노트와 공식 문서 어디에도 아직 Mods가 언급되지 않았다.
🔗 GitHub의 Function Hooks issue #91870
Dario Amodei가 프런티어 모델의 발전 속도 완화를 주장하고 Cohere는 그 방식을 반박하다
9월 12일과 13일 — 토요일, Anthropic CEO Dario Amodei는 개인 웹사이트에 업계가 모델 역량을 개선하는 속도를 늦춰야 한다고 촉구하는 에세이 We Must Pace the Frontier를 게시했다. 그가 설명하는 속도 조절은 학습을 중단한다는 의미가 아니라, 기업에는 모델을 정렬하고 안전하게 만들 시간을, 제3자에게는 이를 검증할 시간을 주는 것이다. 그는 Anthropic을 포함해 여름부터 recursive self-improvement 덕분에 나타난 발전 가속과 agent 무리가 지정되지 않은 표적까지 공격한 OpenAI–Hugging Face 사건을 근거로 들었다.
이 계획은 세 단계로 구성된다. 첫 번째는 embedded evaluator다. 사례로 언급된 METR 같은 제3자 팀에 직원과 비슷한 수준의 상시 접근 권한을 부여하고 결론을 자유롭게 발표할 수 있도록 하는 방식이다. Anthropic은 지금부터 단독으로 이를 시행하겠다고 약속하고, 각국 정부에도 다른 프런티어 기업에 같은 조치를 요구하라고 촉구한다. 다음 단계는 민주주의 국가의 선도 기업들이 공통 안전 표준과 통제되지 않는 발전 속도의 한계를 두고 협력하는 것이다. 에세이는 자발적으로 협력하지 않는 곳을 포함한 미국의 모든 프런티어 기업을 대상으로 하는 규제가 가장 효과적인 방안이라고 본다. 법률 제정에는 시간이 걸리므로 기업들이 자발적으로 표준을 정하는 방안도 병행해 제안하지만, 이는 경쟁법 때문에 까다롭다.
For antitrust reasons, it’s helpful for the US government to mediate or at least enable these discussions — they don’t need to participate, but do need to issue a narrow waiver for certain kinds of safety conversations.
🇰🇷 경쟁법상의 이유로 미국 정부가 이러한 논의를 중재하거나 최소한 가능하게 해 주는 것이 유용합니다. 정부가 논의에 참여할 필요는 없지만, 특정 유형의 안전 관련 대화에 대해서는 범위가 좁은 예외를 허용해야 합니다. — Anthropic CEO Dario Amodei, We Must Pace the Frontier
마지막 단계는 세계적 협력이다. 생물학 무기처럼 명백히 위험한 용도의 금지부터 참여국 정부가 전 세계적인 발전 속도를 제한하는 ‘일시 중단’까지 단계적으로 구성되며, Amodei는 단기적으로 후자가 실현될 가능성은 낮다고 본다.
9월 13일 — Cohere 공동 창업자이자 CEO인 Aidan Gomez는 ‘증거 기반 표준이지 카르텔이 아니다’라는 부제가 붙은 *Who Gets to Define the Rules for AI?*라는 기고문으로 이에 응답했다. Cohere는 최고 수준의 역량을 가진 시스템에 대한 독립적인 검토에는 동의하지만, Dario Amodei가 그 주에 발표한 로드맵을 안전을 명분으로 한 반독점법 면제 요구로 해석한다. Aidan Gomez에 따르면 한 국가의 소수 연구소가 표준과 발전 속도에 합의한 뒤, 공개 협의나 투표 없이 그 규칙을 다른 개발자들에게 강요하게 된다.
에세이에는 Cohere가 지적한 내용이 실제로 담겨 있다. 협력 전략은 프런티어 개발자들에게 “상업적 우위나 미국의 AI 선도 지위를 희생하지 않으면서” 이러한 시간을 제공한다는 것이다. 다만 다른 개발자들이 참여자의 결정을 따라야 한다고 명시한 부분은 어디에도 없다. 이는 Cohere가 규제 방안을 해석한 내용이며, 서면으로 제안된 것은 특정한 안전 관련 대화에만 한정된 범위가 좁은 예외다. Cohere는 이에 맞서 네 가지 원칙을 제시한다.
| Cohere가 제안한 원칙 | 원칙이 포괄하는 내용 |
|---|---|
| 증거 기반 위험 체계 | 여러 국가가 공동으로 구축하고 이견까지 함께 공개하며, 개발자의 정체성이 아닌 역량에 규칙을 연계 |
| 의무적 투명성 | 설계, 역량, 위험 및 완화 조치를 문서화하고 중대한 사고를 보고 |
| 증거에 의해 제한되는 테스트 | 사이버 공격이나 생화학 무기처럼 위험하다고 판단된 역량만을 대상으로 하며, 모든 기업에 인증을 개방 |
| 독립적인 보증 체계 | 금융, 항공 및 원자력 분야를 본떠 감사를 시행하고 피감사자가 감사인에게 대가를 지급하지 않도록 보장 |
🔗 Dario Amodei의 에세이 We Must Pace the Frontier 🔗 Cohere의 기고문 Who Gets to Define the Rules for AI?
ElevenLabs가 자사 MCP를 음성부터 영상까지 아우르는 창작 스튜디오로 만들다
9월 14일 — ElevenLabs는 공식 MCP 서버를 창작 영역으로 확장했다. 이제 사용자는 이미 작업 중인 assistant에서 음성, 전사, 더빙, 음악, 음향 효과, 이미지 및 영상을 생성할 수 있다. 이는 8월 17일 음성 agent 관리를 위해 Claude에 도입된 ElevenLabs Agents용 MCP와 동일하며, 한 번만 설치하면 두 용도를 모두 이용할 수 있다.
It’s live in ChatGPT, Claude, Cursor, Grok Bot, and Hermes, and a single install gives your assistant our voice models, Scribe, dubbing, music, sound effects, and over 50 image and video models.
🇰🇷 ChatGPT, Claude, Cursor, Grok Bot 및 Hermes에서 사용할 수 있으며, 한 번만 설치하면 assistant에서 당사의 음성 모델, Scribe, 더빙, 음악, 음향 효과와 50개가 넘는 이미지 및 영상 모델을 이용할 수 있습니다. — @ElevenLabs의 X 게시물
| MCP에서 이용할 수 있는 구성 요소 | 발표 게시물에 설명된 용도 |
|---|---|
| 음성 합성(Text to Speech) | 라이브러리의 어떤 음성으로든 voice-over를 만들어 대화 안에서 전달 |
| Scribe(Speech to Text) | 대본, 자막 또는 더빙 기반으로 재사용할 수 있는 전사 |
| 더빙 | 동일한 connector로 제작하는 다른 언어 버전 |
| 음악 및 음향 효과 | 완성된 작품의 배경음악과 사운드 디자인 |
| 50개가 넘는 이미지 및 영상 모델 | 생성, 수정, 영상 애니메이션 및 입 모양 동기화(lipsync) |
ElevenLabs는 이러한 구성 요소의 결합을 강조한다. 하나의 brief만으로 대본, voice-over, 배경음악, 사운드 디자인 및 영상을 제작할 수 있다는 것이다. 생성된 파일은 ElevenCreative 작업 공간에 저장되며, 이후 Studio에서 열어 timeline을 조정하고 내레이션을 다듬으며 음악과 효과를 겹쳐 넣은 다음 내보낼 수 있다.
해당 게시물에는 이미지 및 영상 모델 목록, credit 사용량, 적용 요금제가 제시되지 않았으며, 확인 당시 이 발표를 자세히 설명하는 블로그 게시물도 없었다.
Copilot이 자동 모델 선택의 비용과 품질 간 균형을 조정하다
9월 14일 — GitHub는 Copilot의 자동 모델 선택 기능에 세 가지 단계(tier)를 추가했다. 세 단계 모두 같은 모델 pool을 사용하며 Auto는 각 프롬프트를 계속 평가한다. 단계는 선택 기준의 우선순위만 조정한다.
| Auto 단계 | routing 우선순위 | 대상 용도 |
|---|---|---|
| Efficiency | 비용 | 빠르고 간단한 작업 |
| Balance | 비용, 품질 및 latency | 일반 작업 |
| Intelligence | 품질 | 복잡한 작업 |
과금 방식은 달라지지 않는다. 선택된 모델을 기준으로 요금이 부과되며 유료 구독자는 10% 할인을 그대로 받는다. 이 단계들은 VS Code, Copilot CLI 및 GitHub Copilot 애플리케이션에 배포된다. 2025년 12월부터 VS Code에서 정식 제공된 Auto는 3월에 JetBrains, 4월에 CLI, 5월에 Copilot cloud agent로 확대됐다. Copilot에서 사용할 수 있는 GPT-6 Astra, Claude Fable 5.1 및 Gemini 3.8 Flash는 Auto의 모델 pool에 포함되지 않으므로 수동으로 선택해야 한다.
Perplexity의 로컬 agent Portable Computer가 Windows에 도입되다
9월 14일 — Perplexity는 Computer agent의 완전한 로컬 버전인 Portable Computer를 Windows 애플리케이션에 공개했다. 8월 25일 DGX Spark에서 출시된 뒤 9월 3일 Linux PC로 확대되면서 곧 지원될 예정이라고 예고했던 Windows를 이제 실제로 지원하며, 두 가지 기능도 추가됐다. 로컬 MCP는 PC에 설치된 MCP 서버를 통해 desktop 애플리케이션을 제어하고, 예약 작업은 기기 자체에서 반복 작업을 실행한다.
| 이용 조건 | 공개된 세부 정보 |
|---|---|
| 그래픽 카드 | VRAM이 24GB 이상인 GeForce RTX 또는 RTX PRO |
| 대상 구독 | 개인 및 기업용 Pro와 Max |
| 로컬 작업 | Computer credit을 소모하지 않음 |
모델, orchestrator 및 scheduler는 PC에서 실행된다. Perplexity Search 또는 15개가 넘는 프런티어 모델 가운데 하나로 확대하려면 사용자의 승인이 필요하다. NVIDIA 게시물은 connector(Outlook, OneDrive, Word, Google Drive, Gmail, Slack, GitHub), 내장 브라우저 및 날짜가 정해지지 않은 DGX Station 지원 계획도 언급한다. 두 출처가 제시하는 로컬 모델은 서로 다르다. Perplexity 제품 페이지는 RTX PC에서 PPLX 27B만 제공하고 Qwen 3.8 27B는 DGX Spark 전용으로 안내하지만, NVIDIA는 Qwen 3.8 27B를 예시로 든다.
🔗 Windows용 Portable Computer에 관한 Perplexity 게시물 🔗 RTX PC에 관한 NVIDIA 게시물
Qwen Code 0.23.4와 Kimi Code 0.43.0이 agent의 목표와 도구 체계를 개편하다
9월 14일 — 두 command-line coding agent가 같은 날 새 버전을 공개했으며, 모두 목표(goal)와 MCP 및 hook 도구 체계를 변경했다. Qwen Code는 Qwen 팀의 agent이고 Kimi Code는 Moonshot AI의 agent다.
| 비교 항목 | Qwen Code 0.23.4 | Kimi Code 0.43.0 |
|---|---|---|
| 공개 | 0.23.3 출시 4일 뒤인 UTC 15시 20분 | 0.42.0 출시 5일 뒤인 UTC 12시 03분 |
| 목표(goal) | turn(model.goalMaxTurns) 및 활성 시간(model.goalMaxActiveMinutes)에 선택적으로 상한 설정 | 24시간 제한을 폐지하고 session이 닫힌 동안 경과한 시간을 budget에서 제외 |
| MCP 및 hook | 각 hook에 permission_mode, agent_id 및 prompt_id을 전달하고 Claude Code 도구 이름을 인식 | MCP 서버별 deferred 필드로 select_tools을 통해 필요할 때 도구를 불러옴 |
| Agent 및 session | 공유 agent board와 하위 agent용 Codex executor | 선택 화면에서 session 삭제 |
| 주의 사항 | command hook의 timeout을 이제 초 단위로 읽는 변경을 포함해 호환되지 않는 변경 사항 2개 | /tmp 또는 /temp만 대상으로 하는 rm -rf에는 확인을 요청하지 않음 |
Qwen Code 0.23.4에는 31개 기능과 80개 수정 사항이 기록돼 있으며, 그중 여러 항목이 개인정보 보호와 관련된다. 이제 요청 및 응답 text 전송 여부는 logPrompts 설정에 따라 결정된다. Kimi Code에서는 도구의 지연 로딩이 여전히 실험적 flag인 tool-select 뒤에 있으며, 수정 사항을 통해 지금까지 agent profile에 누락됐던 select_tools이 기록되도록 했다.
🔗 Qwen Code 0.23.4 릴리스 노트 🔗 Kimi Code 0.43.0 릴리스 노트
Codex가 실행되는 Linux용 ChatGPT 데스크톱 앱, Arch Linux 공식 지원
9월 14일 — OpenAI Developers가 프로젝트, 로컬 파일, Codex를 이용할 수 있는 Linux용 ChatGPT 데스크톱 앱의 Arch Linux 공식 지원을 발표했다. OpenAI가 Arch용으로 제공하는 스크립트로 설치한 뒤 배포판의 패키지 관리자인 pacman을 통해 업데이트할 수 있어 패키지를 다시 빌드할 필요가 없다. 아직 프리뷰 단계인 이 앱은 8월 11일 Ubuntu, Debian, Fedora에 먼저 출시됐다. 문서에 따르면 이 스크립트는 OpenAI의 서명된 패키지 저장소도 구성한다. 또한 Linux 프리뷰에는 두 가지 제한이 있다. Computer Use는 아직 제공되지 않으며 Wayland 네이티브 지원은 여전히 실험 단계다.
🔗 OpenAI Developers의 X 발표 🔗 Linux용 앱 문서
BlackRock과 함께 설계한 에이전트 거버넌스, Devin Plugins
9월 9일 — X 발표 없이 9월 9일 Devin 블로그에 게시된 글에서 Cognition은 BlackRock과 함께 설계한 Devin Plugins를 소개했다. 플러그인은 skills, 규칙, MCP 서버, hooks, 하위 에이전트를 묶은 버전 관리 패키지로, 로컬 에이전트(Devin CLI, Devin Desktop)와 클라우드 세션 모두에 적용된다. 이는 지난 8월 이곳에서 이미 다룬 개방형 Agent Plugins 표준을 따른다.
플러그인은 Personal, Organization, Enterprise 범위에 설치할 수 있으며, 각 범위에서 필수, 권장 또는 금지로 지정한다. 이때 가장 높은 수준의 권한이 우선한다. Cognition은 SRE 팀을 제외한 에이전트의 프로덕션 인프라 및 데이터 접근을 차단하는 hooks를 사례로 들었다. Git 저장소에 기반한 플러그인은 코드처럼 버전이 관리되고 검토된다. 9월 11일에는 통합 marketplace가 출시를 이어갔으며, 게시물에는 가격이나 요금제 정보가 없다.
🔗 BlackRock과의 에이전트 거버넌스에 관한 Devin 게시물 🔗 Devin Plugins 문서
자산관리사를 위한 11개 커넥터와 8개 skills, Claude for Financial Advisors
9월 14일 — Anthropic이 자산관리사를 위한 커넥터와 skills 모음인 Claude for Financial Advisors를 출시했다. 11개의 새로운 커넥터(Addepar, BlackRock, Charles Schwab, Envestnet, iCapital, Orion, SS&C Black Diamond, Wealthbox, Wealth.com, Vanguard, Zocks)가 추가됐으며, Cowork에서 설치할 수 있는 플러그인에는 8개의 skills가 포함된다.
| 업무 시점 | 플러그인의 Skills |
|---|---|
| 상담 전 | 상담 준비, 잠재 고객 접수 |
| 상담 후 | 상담 후 기록 및 후속 조치 |
| 자산 분석 | 포트폴리오 리밸런싱 검토, 상속 및 세금 요약, 대체투자 요약 |
| 도입 및 규정 준수 | 자문사 온보딩, 규정 준수 및 AI 정책 |
중요 작업에는 자산관리사의 승인이 필요하며, 투자 권고와 고객 커뮤니케이션도 계속 사람의 검토를 거쳐야 한다. Anthropic은 감사 로그 기능을 이유로 등록 투자자문사(registered investment advisers)에 Enterprise 요금제를 권장하며, 9월 말까지 신규 라이선스를 요청하는 회사에 사용 크레딧을 제공하고 9월 18일 웨비나를 개최한다.
🔗 Claude for Financial Advisors
에이전틱 코딩으로 과부하에 놓인 Anthropic의 CI
9월 14일 — Claude 블로그에서 Sachin Malhotra는 에이전틱 코딩이 Anthropic의 CI에 어떻게 부담을 가했는지 설명했다.
| Anthropic이 공개한 지표 | 발표된 수치 |
|---|---|
| 엔지니어 1인당 분기별 배포 코드량 | 2021~2025년 평균의 8배 |
| Claude가 작성한 코드의 비중 | 80 % |
| CI 작업량 | 6개월 동안 25배 증가 |
| 세 가지 수정안의 수명 | 70일, 29일, 하루 미만 |
| 최종 재설계 | 엔지니어 1명, 3주 |
병목은 각 PR에서 실행할 테스트를 선택하는 테스트 선택 서비스(test impact analysis)에서 발생했다. 단일 프로세스로 설계된 이 서비스는 세 차례의 수정안을 소진한 뒤 Claude의 조언에 따라 재설계됐다. 상태는 인메모리 저장소로 분리하고, 무상태로 바뀐 처리는 수평으로 분산했다. 저자는 두 분기 안에 25배의 부하를 감당할 수 있도록 대비하라고 조언한다.
Perplexity 검색에서 DynamoDB를 대체한 CobbleDB
9월 14일 — Perplexity가 이제 검색에서 DynamoDB 대신 각 페이지의 미리 분할된 구절과 embeddings를 제공하는 분산 키-값 저장소 CobbleDB를 자세히 소개했다. RocksDB를 기반으로 구축됐으며 파티션마다 3개의 replica, 메모리 cache, NVMe storage를 사용하고 의도적으로 transaction은 지원하지 않는다. 프로덕션에서 일괄 읽기의 지연 시간을 측정한 결과는 다음과 같다.
| 지연 시간 백분위수 | 이전, DynamoDB 사용 | 이후, CobbleDB 사용 |
|---|---|---|
| 중앙값 (p50) | 31,4 ms | 5,60 ms |
| 90백분위수 (p90) | 56,7 ms | 9,77 ms |
| 99백분위수 (p99) | 123 ms | 24,2 ms |
Perplexity는 이 수치가 서로 다른 시점의 실제 트래픽을 대상으로 한 전후 비교이며, DynamoDB 대비 최소 20 %의 비용 절감은 내부 추정치라고 명시했다. 회사에 따르면 데이터베이스 핵심부를 구성하는 약 40 000줄의 Rust 코드는 엔지니어 2명과 수백 개의 에이전트가 두 달 만에 작성했다. 오픈 소스 공개도 예고했지만 날짜는 밝히지 않았다.
TRL v1.14: HF Jobs에 분산된 LoRA 기반 비동기 GRPO
9월 10일 — Hugging Face는 9월 10일 공식 게시물에서 TRL v1.14의 새로운 기능을 자세히 소개했다. 학습과 생성을 분리하는 AsyncGRPOTrainer는 LoRA adapter를 학습하고 vLLM과는 이 adapter만 동기화할 수 있다. 이에 따라 매개변수 15억 개 모델에서 약 3 GB를 동기화하는 대신 수 MB만 동기화하면 된다. trainer와 vLLM replica는 Storage Bucket으로 연결된 별도의 Jobs에서 실행된다.
| 측정 지표 | 첫 번째 실행 | 다섯 번째 실행 |
|---|---|---|
| 500 step 소요 시간 | 3시간 27분 | 53분 |
| step당 중앙값 시간 | 22,9 s | 4,8 s |
| forward + backward MFU | 3,9 % | 23,5 % |
| 마지막 20 step의 reward | 0,438 | 0,416 |
성능 향상은 세 가지 설정에서 비롯됐다. micro-batch별로 sequence를 packing하고, activation 재계산(gradient checkpointing)을 비활성화하며, 비슷한 reward를 유지하면서 처리 중인 요청 수를 128개에서 384개로 늘렸다. 초기 구성 비용은 시간당 약 20달러이며 재현 스크립트도 공개됐다.
🔗 HF Jobs 전반의 LoRA 기반 비동기 GRPO
Transformer Engine, JAX에서 dropless MoE 처리량 10,4배 향상
9월 14일 — NVIDIA는 각 expert가 서로 다른 수의 token을 받는 token 미폐기 mixture of experts(dropless MoE) 학습을 Transformer Engine이 JAX에서 어떻게 가속하는지 보여줬다. DeepSeek-V3에서 본문은 GB200에서 10,4배 향상됐다고 설명하지만, 그림 설명에는 GB300 NVL72로 표기돼 있다.
| NVIDIA가 공개한 지표 | 발표된 수치 |
|---|---|
| 초기 처리량 | GPU당 103 TFLOPS |
| kernel 시간에서 통신이 차지하는 초기 비중 | 84 % |
| Transformer Engine 사용 시 처리량 | GPU당 1 068 TFLOPS, 즉 10,4배 향상 |
| GPU 1 024개에서의 확장 효율 | 97 % |
성능 향상의 주요 요인으로는 모든 expert를 단일 kernel 호출로 처리하는 MXFP8 기반 grouped GEMM과 NCCL EP를 통해 통합된 dispatch 및 combine이 있다. 최적화 기능은 NGC MaxText container에 포함됐으며, 향후 NVFP4 지원도 예고됐다.
🔗 JAX의 dropless MoE에 관한 NVIDIA 기술 게시물
역전파 없이 1 000개 layer를 학습하는 Sakana AI의 로컬 학습법, PC-ALM
9월 14일 — Sakana AI가 역전파(backpropagation)를 각 layer가 인접 layer와만 통신하는 로컬 동역학으로 대체하는 PC-ALM(Augmented Lagrangian Predictive Coding)을 공개했다. 이 방식은 각 layer에 이중 변수인 Lagrange multiplier를 부여해 비례-적분 피드백 controller로 작동하게 함으로써 예측 부호화(predictive coding)를 확장한다. 선형 network에서 이 변수들은 역전파의 credit signal을 정확히 재현한다.
MNIST에서 너비 32의 residual MLP는 최대 1 000개 layer까지 역전파와 약 2퍼센트포인트 이내의 격차를 유지한다. CIFAR-10과 Tiny ImageNet에서 PC-ALM은 표준 예측 부호화보다 우수하지만 점수는 그래프로만 제공된다. Sakana AI는 여전히 단순한 과제를 대상으로 한 결과이기는 하지만, 자사가 아는 한 이처럼 깊은 network를 학습할 수 있는 최초의 로컬 학습법이라고 소개한다. 논문과 코드가 공개됐다.
🔗 Augmented Lagrangian Predictive Coding
ElevenLabs의 의료 전사 모델 Scribe v2 Medical, 정식 출시
9월 11일 — 트윗이나 게시물 없이 9월 11일 문서 changelog에서만 발표된 Scribe v2 Medical의 정식 출시로 ElevenLabs의 전사 제품군이 확장됐다. Scribe v2를 미세 조정한 이 버전은 일반 음성에서 Scribe v2의 정확도를 유지하면서 의약품명, 해부학, 병리학, 임상 받아쓰기 인식 성능을 개선했다. 이 모델은 Scribe v2와 동일한 가격으로 audio를 batch 처리하며, 모델 식별자로 scribe_v2_medical을 사용하고 entity detection부터 diarization까지 같은 옵션을 제공한다. ElevenLabs는 이 모델을 임상 문서화, 환자 접수 전화, 보호 대상 의료 데이터의 규정 준수 workflow에 활용하도록 설계했다. 기술 자료에 따르면 독립된 의료 용어에서 Scribe v2보다 오류가 15 % 적고 90개가 넘는 언어를 지원한다.
iPhone에 출시된 Google Flow
9월 10일 — @FlowbyGoogle 계정이 9월 10일 Google의 AI 제작 studio인 Google Flow의 iOS 앱을 발표했다. App Store 페이지에 따르면 앱 내 구매가 포함된 무료 앱이며 iPhone 전용으로, iOS 16 이상이 필요하다. Google의 생성형 모델을 사용해 카메라 롤이나 카메라에서 가져온 이미지와 동영상을 생성하고 편집할 수 있다. library는 desktop 버전과 계속 동기화되며, 여러 생성 작업을 백그라운드에서 실행하고 결과가 준비되면 알림을 받을 수 있다. 페이지에는 모델명이 명시되지 않았다.
🔗 @FlowbyGoogle의 X 발표 🔗 App Store의 Google Flow
단신
- 보호 대상 데이터와 분리해 의료 분야에 쓰이는 Claude Tag — Claude Tag는 아직 Anthropic의 BAA 적용 대상이 아니므로 Insight Health, Tennr, Medallion은 의료 데이터가 없는 채널에서만 이를 사용한다. Insight Health에서는 중요 경고의 97 %가 엔지니어의 개입 없이 종결된다. Claude Tag를 GitHub에 연결한 조직에 제공되는 크레딧은 10월 1일 만료된다. 🔗 출처
- Anthropic과 Accenture, 시범 운영에서 프로덕션으로 전환하기 위한 가이드 공개 — CIO를 대상으로 한 이 가이드는 Accenture의 두 가지 수치에서 출발한다. 경영진 중 전사적 차원에서 AI의 지속적인 효과를 확인한 비율은 23 %에 불과하며, 조직의 42 %에는 AI 비용과 성과를 단독으로 책임지는 담당자가 없다. 🔗 출처
- Claude Fable 5.1, 1653년 암호문 Cyphral Distich 해독 — 8월 31일 자 Vals AI 게시물에 소개되고 태평양 표준시 기준 9월 13일 저녁 Boris Cherny가 공유한 제3자 시연이다. 사람의 개입 없이 44분과 176 000 tokens가 소요됐다. 저자는 단서가 간단했다는 점을 인정했다. 🔗 출처
- Fyxer의 이메일 초안, 53 %가 수정 없이 채택 — OpenAI의 이 사례 연구에서 비서 assistant는 사용자의 수정 사항으로 미세 조정된 30~50개의 전문 모델에 작업을 분배하며, 연간 반복 매출은 2025년에 100만 달러에서 3 200만 달러로 증가했다. 모델명은 공개되지 않았다. 🔗 출처
- Devin, PagerDuty 당직 업무 담당 — 9월 11일 release notes에 따르면 Devin은 PagerDuty incident를 분류하고 조사 결과를 incident note로 게시할 수 있다. MCP 서버 21개는 한 번의 클릭으로 OAuth에 연결되며 Sessions v1 API는
idempotency_key을 허용한다. 🔗 출처 - DevFest 2026, 10월 1일부터 12월 31일까지 개최 — Google Developer Groups는 115개국에서 800개가 넘는 행사를 열 계획이다. Gemini, AI Studio, Antigravity, Web MCP를 중심으로 workshop과 에이전트 제작 marathon(agent-athons)이 진행된다. 🔗 출처
- Suno, Studio Chat 공개 — 이 Suno Studio assistant는 프로젝트의 모든 track과 MIDI fragment를 파악하고 있으며, timeline에서 직접 정리, 이름 변경, 색상 지정 또는 새 part 작성을 수행할 수 있다. 출시 여부와 가격은 발표되지 않았다. 🔗 출처
- 확장되는 MiniMax H3 오픈 소스 생태계 — MiniMax는 세 가지 커뮤니티 프로젝트를 소개했다. attention을 재설계해 inference를 가속하는 VDN, Alibaba PAI의 8단계 PDD Acc-LoRAs, LightX2V의 4단계 및 8단계 Turbo LoRAs다. 🔗 출처
- Runway, A Game of HORSE 제작 과정 공개 — 동영상 tutorial과 단편 영화의 prompts, 다운로드 가능한 runway-sd-enhancer skill을 공개했다. 이 skill은 원시 prompt를 15초 장면용 프로덕션 prompt로 변환한다. 🔗 출처
- Ai2, University of Washington 학생들에게 AutoDiscovery 테스트 의뢰 — 10개 팀이 이 에이전트를 시험했다. 배터리나 단백질에 관한 유용한 연구 방향을 제시했지만, 시뮬레이션된 reactor 구성 24 000개에서는 가설의 약 절반이 비논리적이었다. 시험용 크레딧은 12월 31일까지 연장됐다. 🔗 출처
- Archsloth, GGUF Qwen을 원본에 더 가깝게 개선 — Hugging Face 블로그에 실린 FINAL-Bench 팀의 커뮤니티 기여다. unsloth 파일과 동일한 크기에서 Qwen3-4B용
Q4_K_M은 수정된 두 가지 AutoRound 옵션을 통해 KL divergence를 한국어에서 54,4 %, 영어에서 33,2 % 줄였다. 🔗 출처 - Eric Mey, LangGraph 에이전트의 OpenAI 호환성 측정 — 같은 커뮤니티 블로그에 실린 개인 기여다. Chat Completions의 요청 field 37개를 분류해 처음에는 11개였던 무응답 field를 하나도 남기지 않았지만, schema validation은 streaming 결함을 잡아내지 못했다. 🔗 출처
- EcoHash, 96 GB RTX PRO 6000의 서비스 성능 수치 공개 — inference 제공업체가 자체 서비스에서 측정하고 원시 CSV를 공개한 게시물이다. qwen3.6-35b-a3b는 첫 token을 170 ms (p95)에 출력하고 초당 약 213 tokens를 제공하며, Llama-3.1-8B의 동시 처리 환경에서는 처리량이 초당 약 11 500 tokens에 달한다. 🔗 출처
이것이 의미하는 것
첫 번째 흐름은 우리가 프로그래밍하고 통제하는 에이전트에 관한 것이다. Claude Mods에서는 누구나 자신만의 hook을 TypeScript로 작성할 수 있지만, 그 부수 효과는 관리자가 감사하고 제한할 수 있는 $ 객체를 거치도록 한다. Devin Plugins는 이와 같은 논리를 기업 규모로 적용하여 범위에 따라 plugin을 필수로 지정하거나 금지한다. GitHub에서는 Auto 라우팅의 비용과 품질 사이에서 절충점을 선택할 수 있고, Qwen Code와 Kimi Code는 목표 수행 시간을 조정하며, Kimi Code는 필요할 때 MCP 도구를 불러올 수 있다. MCP는 배포 채널 역할도 한다. 한 번 설치하면 대화를 벗어나지 않고도 다섯 개의 assistant에서 ElevenLabs의 음성, 음악, 50개가 넘는 이미지 및 동영상 모델을 사용할 수 있다.
두 번째 흐름은 이 에이전트 코드가 부담을 주거나 직접 구축하는 인프라에 관한 것이다. Claude가 코드의 80%를 작성하는 Anthropic에서는 6개월 동안 CI job이 25배로 늘었으며, 테스트 선택 서비스를 재설계하는 데 엔지니어 한 명이 3주를 들였다. Perplexity에서는 엔지니어 두 명과 수백 개의 에이전트가 CobbleDB의 Rust 코드 40,000줄을 작성했으며, 자체 측정에 따르면 읽기 지연 시간이 약 5배 낮다. 학습도 같은 흐름을 따른다. TRL은 GRPO run을 3시간 27분에서 53분으로 단축하고, Transformer Engine은 dropless MoE의 처리량을 10.4배로 높인다. 두 글 모두 병목 지점을 찾아낸 뒤 이를 해소하는 과정을 다룬다.
세 번째 흐름은 누가 속도와 규칙을 정하는가라는 정치적 문제다. 모델의 역량을 기준으로 한 연방법을 요구한 OpenAI의 기고문이 나온 지 사흘 뒤, Dario Amodei는 우선 Anthropic을 상주 평가자들에게 개방하는 방식으로 frontier 모델의 발전 속도를 조절하자고 제안했고, Aidan Gomez는 그 방법론에 이의를 제기했다. 두 글은 가장 강력한 시스템을 독립적으로 검토해야 한다는 점에서는 일치하지만 그다음 단계에서는 갈린다. 한쪽은 모든 미국 frontier 기업을 대상으로 하는 규제와 함께, 제한적인 antitrust 면책 아래 논의되는 표준을 제안한다. 다른 쪽은 여러 국가가 함께 구축하는 위험 체계와 피감사자가 비용을 부담하지 않는 감사를 제안한다. 논의의 초점은 통제의 원칙 자체보다 누가 그 규칙을 작성하는가에 더 가깝다.
마지막 흐름은 제품에 내장된 안전장치를 통해 AI가 접근하는 민감한 데이터에 관한 것이다. Portable Computer는 파일과 요청을 PC에 보관하고 cloud로 내보내기 전에 승인을 요청한다. Scribe v2 Medical은 임상 받아쓰기와 보호 대상 의료 데이터의 규정 준수 절차를 겨냥한다. Claude Tag는 BAA의 적용 대상이 아니므로 그런 데이터가 포함되지 않은 채널로 제한된다. Claude for Financial Advisors에서는 중요한 작업을 advisor가 승인하도록 한다. 에이전트가 환자의 진료 기록이나 고객의 portfolio에 가까이 다가갈수록, 혼자 수행할 수 있는 작업의 한계가 더욱 명확해진다.
출처
- X의 Boris Cherny, Claude Mods
- Claude Code, Function Hooks issue #91870
- Dario Amodei, frontier의 속도를 조절해야 한다
- X의 Dario Amodei, 시험 발표
- Cohere, AI의 규칙은 누가 정하는가?
- X의 ElevenLabs, 창작용 MCP 발표
- X의 ElevenLabs, 호환 client
- GitHub Changelog, 자동 모델 선택 단계
- GitHub Docs, Copilot 자동 모델 선택 정보
- Perplexity, Windows용 Portable Computer
- Perplexity, Portable Computer 제품 페이지
- NVIDIA, RTX PC의 Portable Computer
- Qwen Code, 0.23.4 release note
- Kimi Code, 0.43.0 release note
- X의 OpenAI Developers, Arch Linux
- ChatGPT, Linux용 application
- Devin, BlackRock과 함께하는 에이전트 governance
- Devin, plugin 문서
- Claude, Claude for Financial Advisors
- Claude, 에이전트 coding이 CI에 부담을 주고 있다
- Perplexity, CobbleDB
- Hugging Face, HF Jobs 전반에서 LoRA를 활용한 비동기 GRPO
- NVIDIA, Transformer Engine을 활용한 JAX의 dropless MoE
- Sakana AI, PC-ALM
- ElevenLabs, 9월 11일 changelog
- X의 Google Flow
- App Store의 Google Flow
- Claude, 의료 분야의 Claude Tag
- Claude, Accenture와 함께하는 pilot에서 production까지의 안내서
- X의 Boris Cherny, Cyphral Distich
- Vals AI, Claude Fable 5.1이 Cyphral Distich를 해결하다
- OpenAI, Fyxer 사례 연구
- Devin, release note
- Google, DevFest 2026
- X의 Suno, Studio Chat
- X의 MiniMax, H3 ecosystem
- X의 Runway, HORSE 게임
- Ai2, AutoDiscovery와 University of Washington 학생들
- Hugging Face, Archsloth와 AutoRound
- Hugging Face, LangGraph 에이전트의 OpenAI 호환성
- Hugging Face, EcoHash와 RTX PRO 6000