ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-5.6-sol.
Questo lunedì Boris Cherny annuncia l’arrivo su Claude Code dei Claude Mods, plugin basati su hook scritti in TypeScript e testabili dal 9 settembre, mentre Aidan Gomez, CEO di Cohere, contesta il piano in tre fasi pubblicato sabato da Dario Amodei per rallentare i progressi dei modelli di frontiera. ElevenLabs trasforma il suo MCP in uno studio creativo accessibile da ChatGPT, Claude o Cursor, mentre GitHub, Qwen e Kimi forniscono nuove impostazioni ai propri agenti e Perplexity porta il suo agente locale su Windows. Infine, diversi articoli tecnici mostrano come il codice agentico e l’addestramento stiano cambiando scala, dalla CI di Anthropic al nuovo database di Perplexity.
Claude Mods, i function hook di Claude Code arrivano in fase di test
14 settembre — Boris Cherny di Anthropic annuncia che i Claude Mods stanno arrivando (landing now) e rimanda all’issue GitHub #91870 del repository di Claude Code.
Claude Mods are landing now. Someone already built a Tetris-in-Claude mod See issue for the latest community update, technical details, and more cool demos
🇮🇹 I Claude Mods stanno arrivando. Qualcuno ha già creato una mod di Tetris in Claude. Consultate l’issue per l’ultimo aggiornamento della community, i dettagli tecnici e altre fantastiche demo. — @bcherny su X
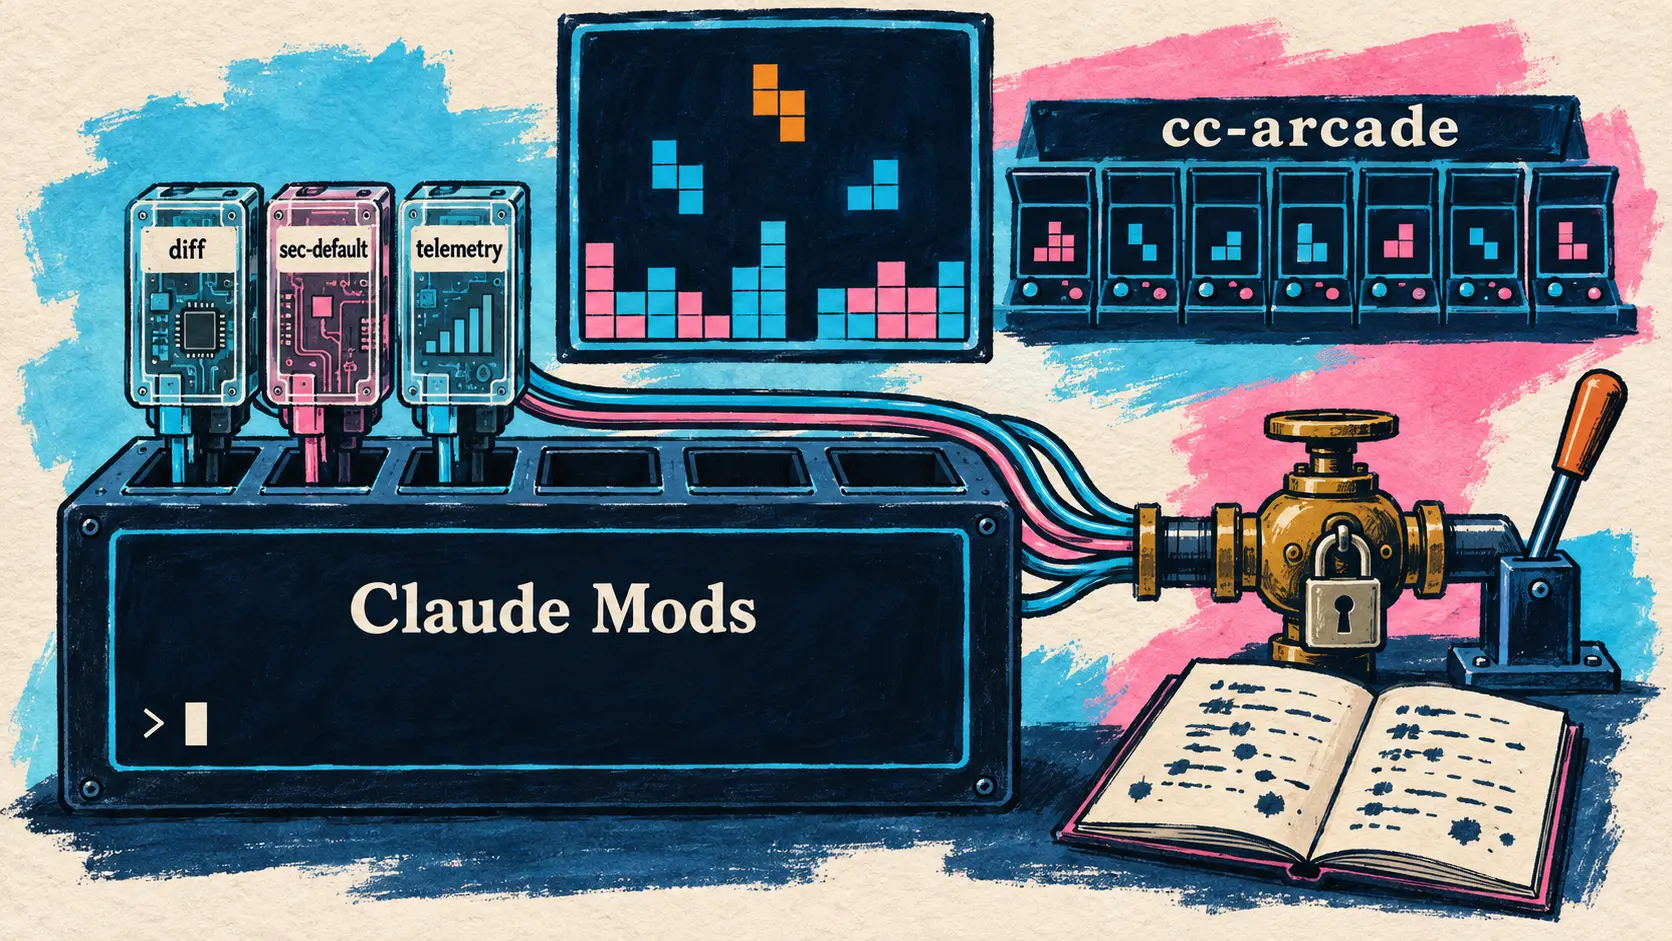
Questa issue riguarda la proposta Function Hooks presentata da Anthropic il 3 settembre: hook scritti in TypeScript e composti come middleware (middlewares), i cui effetti collaterali passano tutti attraverso un oggetto $ che gli amministratori possono sottoporre ad audit e limitare. In un aggiornamento del 9 settembre, poteat, responsabile della proposta presso Anthropic, annuncia un rilascio nell’arco di poche settimane e un nome di prodotto, Claude Mods: una mod è semplicemente un plugin che utilizza function hook. Il codice sorgente delle prime tre mod integrate (diff, sec-default e telemetry) è pubblicato nel repository, altre funzioni di Claude Code dovranno migrare a questa forma e i test sono aperti a chi avvia CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1 claude.
Il Tetris citato da Boris Cherny proviene da un membro della community, non da Anthropic: il suo plugin cc-arcade mostra Tetris e altri sette giochi sopra il prompt, utilizzabili mentre Claude lavora, senza consumare token. Il suo autore ritiene che l’API abbia retto bene, ma che molti dei suoi vincoli non siano ancora documentati.
La funzione rimane sperimentale: né le note di rilascio di Claude Code, comprese quelle della versione 2.1.271 pubblicata il 14 settembre, né la sua documentazione menzionano ancora le Mods.
🔗 Issue Function Hooks #91870 su GitHub
Dario Amodei vuole rallentare i progressi dei modelli di frontiera, Cohere contesta il metodo
12 e 13 settembre — Sabato Dario Amodei, CEO di Anthropic, ha pubblicato sul proprio sito personale We Must Pace the Frontier, un saggio che invita il settore a rallentare il ritmo con cui migliora le capacità dei propri modelli. Regolare il ritmo (pacing) non significa interrompere l’addestramento, precisa, ma concedere alle aziende il tempo di allineare e mettere in sicurezza i propri modelli e a soggetti terzi quello di verificarli. Cita l’accelerazione osservata dall’estate grazie all’auto-miglioramento ricorsivo (recursive self-improvement), anche presso Anthropic, e l’incidente OpenAI–Hugging Face, nel quale uno sciame di agenti ha attaccato obiettivi che non gli erano stati indicati.
Il piano prevede tre fasi. Innanzitutto, valutatori integrati (embedded evaluators): un team esterno, con METR citata come esempio, dotato di un accesso permanente paragonabile a quello di un dipendente e libero di pubblicare le proprie conclusioni. Anthropic assume fin da ora questo impegno unilateralmente e invita i governi a imporre lo stesso alle altre aziende di frontiera. Segue il coordinamento delle aziende di punta dei Paesi democratici su standard di sicurezza comuni e limiti al ritmo dei progressi non controllati. Il saggio ritiene che la strada più efficace rimanga una regolamentazione rivolta a tutte le aziende di frontiera statunitensi, comprese quelle che non collaborerebbero volontariamente; poiché una legge richiede tempo, propone parallelamente standard stabiliti volontariamente tra aziende, una soluzione resa delicata dal diritto della concorrenza:
For antitrust reasons, it’s helpful for the US government to mediate or at least enable these discussions — they don’t need to participate, but do need to issue a narrow waiver for certain kinds of safety conversations.
🇮🇹 Per ragioni legate al diritto della concorrenza, è utile che il governo statunitense faccia da mediatore o quantomeno renda possibili queste discussioni: non è necessario che vi partecipi, ma deve concedere una deroga limitata per alcuni tipi di conversazioni sulla sicurezza. — Dario Amodei, CEO di Anthropic, in We Must Pace the Frontier
Infine, un coordinamento mondiale, articolato gradualmente dal divieto di usi manifestamente pericolosi, come le armi biologiche, fino a una «pausa» durante la quale i governi partecipanti limiterebbero il ritmo globale, un esito che Amodei considera improbabile nel breve termine.
13 settembre — Aidan Gomez, cofondatore e CEO di Cohere, gli risponde in un articolo intitolato Who Gets to Define the Rules for AI?, sottotitolato «standard basati sulle prove, non un cartello». Cohere sostiene la valutazione indipendente dei sistemi più capaci, ma interpreta la tabella di marcia pubblicata durante la settimana da Dario Amodei come una richiesta di esenzione antitrust in nome della sicurezza. Secondo Aidan Gomez, una manciata di laboratori di un solo Paese si accorderebbe sugli standard e sul ritmo dei progressi, per poi imporre queste regole agli altri sviluppatori senza consultazione pubblica né voto.
Il saggio contiene effettivamente il punto evidenziato da Cohere: una strategia coordinata concederebbe questo tempo agli sviluppatori di frontiera «senza sacrificare il vantaggio commerciale né la leadership degli Stati Uniti nell’AI». Non afferma però in alcun punto che gli altri sviluppatori debbano seguire le decisioni dei partecipanti: quest’obbligo è l’interpretazione che Cohere dà della strada normativa, mentre la richiesta scritta riguarda una deroga limitata, circoscritta ad alcune conversazioni sulla sicurezza. Cohere contrappone quattro pilastri:
| Pilastro proposto da Cohere | Cosa comprende il pilastro |
|---|---|
| Quadro dei rischi basato sulle prove | Costruito da più Paesi e pubblicato insieme ai relativi dissensi, con regole legate alle capacità e non all’identità dello sviluppatore |
| Trasparenza obbligatoria | Progettazione, capacità, rischi e mitigazioni documentati, segnalazione degli incidenti gravi |
| Test limitati dalle prove | Solo sulle capacità ritenute pericolose, come gli attacchi informatici o le armi biochimiche, con certificazione aperta a qualsiasi azienda |
| Meccanismi di garanzia indipendenti | Audit sul modello della finanza, dell’aviazione e del nucleare, nei quali il revisore non è mai pagato dal soggetto sottoposto ad audit |
🔗 We Must Pace the Frontier, il saggio di Dario Amodei 🔗 Who Gets to Define the Rules for AI?, l’articolo di Cohere
ElevenLabs trasforma il suo MCP in uno studio creativo, dalla voce al video
14 settembre — ElevenLabs estende il proprio server MCP ufficiale alla creazione: dall’assistente nel quale si sta già lavorando, ora genera parlato, trascrizioni, doppiaggi, musica, effetti sonori, immagini e video. È lo stesso MCP di ElevenLabs Agents, arrivato il 17 agosto in Claude per amministrare gli agenti vocali: una sola installazione copre entrambi gli utilizzi.
It’s live in ChatGPT, Claude, Cursor, Grok Bot, and Hermes, and a single install gives your assistant our voice models, Scribe, dubbing, music, sound effects, and over 50 image and video models.
🇮🇹 È disponibile in ChatGPT, Claude, Cursor, Grok Bot e Hermes, e una sola installazione offre al vostro assistente i nostri modelli vocali, Scribe, il doppiaggio, la musica, gli effetti sonori e più di 50 modelli di immagini e video. — @ElevenLabs su X
| Componente accessibile tramite MCP | Utilizzo descritto nel thread dell’annuncio |
|---|---|
| Sintesi vocale (Text to Speech) | Voce fuori campo con qualsiasi voce della libreria, consegnata nella conversazione |
| Scribe (Speech to Text) | Trascrizione riutilizzabile come copione, sottotitoli o base per il doppiaggio |
| Doppiaggio | Versione in un’altra lingua, tramite lo stesso connettore |
| Musica ed effetti sonori | Sottofondo musicale e sound design di un’opera completa |
| Più di 50 modelli di immagini e video | Generazione, ritocco, animazione video e sincronizzazione labiale (lipsync) |
ElevenLabs mette in risalto la combinazione di questi componenti: un unico brief produrrebbe copione, voce fuori campo, sottofondo musicale, sound design e video. I file generati arrivano nello spazio di lavoro ElevenCreative, quindi si aprono in Studio per regolare la timeline, perfezionare la narrazione, sovrapporre musica ed effetti ed esportare.
Il thread non fornisce né l’elenco dei modelli di immagini e video, né il consumo di crediti, né i piani interessati, e al momento della nostra rilevazione nessun articolo del blog illustrava in dettaglio l’annuncio.
🔗 Annuncio dell’MCP creativo di ElevenLabs
Copilot regola il compromesso tra costo e qualità della selezione automatica del modello
14 settembre — GitHub aggiunge tre livelli (tiers) alla selezione automatica del modello (auto model selection) di Copilot. Tutti e tre attingono allo stesso insieme di modelli e Auto continua a valutare ogni prompt: il livello orienta soltanto il compromesso.
| Livello di Auto | Priorità di instradamento | Utilizzo previsto |
|---|---|---|
| Efficiency | Costo | Attività rapide e semplici |
| Balance | Costo, qualità e latenza | Lavoro quotidiano |
| Intelligence | Qualità | Attività complesse |
La fatturazione non cambia: viene addebitato il modello selezionato e gli abbonati a pagamento mantengono lo sconto del 10%. I livelli vengono distribuiti in VS Code, Copilot CLI e nell’applicazione GitHub Copilot; Auto, disponibile a livello generale in VS Code da dicembre 2025, è arrivato su JetBrains a marzo, sulla CLI ad aprile e su Copilot cloud agent a maggio. GPT-6 Astra, Claude Fable 5.1 e Gemini 3.8 Flash, pur essendo disponibili in Copilot, non fanno parte dell’insieme di Auto: devono essere selezionati manualmente.
🔗 Changelog di GitHub sui livelli di Auto
Portable Computer, l’agente locale di Perplexity, arriva su Windows
14 settembre — Perplexity rende disponibile Portable Computer, la versione completamente locale del suo agente Computer, nella propria applicazione Windows. Annunciato come imminente il 3 settembre, in occasione dell’apertura ai PC Linux successiva al lancio su DGX Spark del 25 agosto, Windows è ora effettivamente supportato, con due capacità aggiuntive: l’MCP locale, che controlla le applicazioni desktop tramite i rispettivi server MCP installati sul PC, e le attività pianificate, che eseguono lavori ricorrenti direttamente sulla macchina.
| Condizione di accesso | Dettaglio pubblicato |
|---|---|
| Scheda grafica | GeForce RTX o RTX PRO con almeno 24 GB di VRAM |
| Abbonamenti inclusi | Pro e Max, sia individuali sia aziendali |
| Lavoro locale | Nessun credito Computer consumato |
Il modello, l’orchestratore e il pianificatore vengono eseguiti sul PC; un passaggio a Perplexity Search o a uno degli oltre 15 modelli di frontiera richiede l’autorizzazione dell’utente. L’articolo di NVIDIA aggiunge connettori (Outlook, OneDrive, Word, Google Drive, Gmail, Slack, GitHub), un browser integrato e il supporto per DGX Station annunciato senza una data. Le due fonti divergono sul modello locale: la pagina del prodotto di Perplexity propone soltanto PPLX 27B sui PC RTX e riserva Qwen 3.8 27B a DGX Spark, mentre NVIDIA cita Qwen 3.8 27B come esempio.
🔗 Articolo di Perplexity su Portable Computer per Windows 🔗 Articolo di NVIDIA sui PC RTX
Qwen Code 0.23.4 e Kimi Code 0.43.0 rivedono gli obiettivi e gli strumenti dei propri agenti
14 settembre — Due agenti di programmazione da riga di comando pubblicano una versione nello stesso giorno, ed entrambi intervengono sugli obiettivi (goals) oltre che sui rispettivi strumenti MCP e hook. Qwen Code è l’agente del team Qwen, Kimi Code quello di Moonshot AI.
| Aspetto confrontato | Qwen Code 0.23.4 | Kimi Code 0.43.0 |
|---|---|---|
| Pubblicazione | 15:20 UTC, quattro giorni dopo la 0.23.3 | 12:03 UTC, cinque giorni dopo la 0.42.0 |
| Obiettivi (goals) | Limiti facoltativi per numero di turni (model.goalMaxTurns) e minuti attivi (model.goalMaxActiveMinutes) | Limite di 24 ore rimosso, tempo trascorso a sessione chiusa escluso dai budget |
| MCP e hook | permission_mode, agent_id e prompt_id trasmessi a ogni hook, nomi degli strumenti di Claude Code riconosciuti | Campo deferred per server MCP per caricare gli strumenti su richiesta tramite select_tools |
| Agenti e sessioni | Bacheca condivisa degli agenti (agent board), esecutore Codex per i sotto-agenti | Eliminazione di una sessione dal selettore |
| Aspetti a cui prestare attenzione | Due modifiche incompatibili, tra cui il timeout degli hook dei comandi ora interpretato in secondi | Nessuna conferma richiesta per un rm -rf rivolto esclusivamente a /tmp o /temp |
Qwen Code 0.23.4 elenca 31 funzionalità e 80 correzioni, molte delle quali riguardano la riservatezza: l’invio del testo delle richieste e delle risposte dipende ora dall’impostazione logPrompts. In Kimi Code, il caricamento differito degli strumenti rimane dietro il flag sperimentale tool-select e una correzione fa registrare select_tools, fino ad allora assente dai profili degli agenti.
🔗 Note di rilascio di Qwen Code 0.23.4 🔗 Note di rilascio di Kimi Code 0.43.0
L’app desktop ChatGPT per Linux, su cui gira Codex, supporta ufficialmente Arch Linux
14 settembre — OpenAI Developers annuncia il supporto ufficiale di Arch Linux da parte dell’app desktop ChatGPT per Linux, dove si trovano i propri progetti, i file locali e Codex. Si installa tramite uno script fornito da OpenAI per Arch, quindi si aggiorna con pacman, il gestore di pacchetti della distribuzione, senza dover riconfezionare alcun pacchetto. Ancora in anteprima, l’app era arrivata l’11 agosto su Ubuntu, Debian e Fedora. La documentazione precisa inoltre che lo script configura il repository di pacchetti firmato da OpenAI e ricorda due limiti dell’anteprima Linux: Computer Use non è ancora disponibile e il supporto nativo di Wayland resta sperimentale.
🔗 Annuncio di OpenAI Developers su X 🔗 Documentazione dell’app per Linux
Devin Plugins, una governance degli agenti progettata con BlackRock
9 settembre — Pubblicato il 9 settembre sul blog di Devin, senza annunci su X, un articolo di Cognition presenta Devin Plugins, progettato con BlackRock. Un plugin è un pacchetto versionato che raggruppa skills, regole, server MCP, hooks e sotto-agenti, applicato sia agli agenti locali (Devin CLI, Devin Desktop) sia alle sessioni cloud. Segue lo standard aperto Agent Plugins, già trattato qui ad agosto.
I plugin si installano con ambito Personal, Organization o Enterprise e ciascun ambito li dichiara obbligatori, consigliati o vietati, con prevalenza dell’autorità più alta. Cognition cita hooks che impediscono agli agenti di accedere all’infrastruttura e ai dati di produzione, tranne che per il team SRE. Basati su repository Git, i plugin vengono versionati e sottoposti a revisione come il codice. Un marketplace unificato ha ampliato il lancio già dall’11 settembre; l’articolo non indica né prezzi né offerte.
🔗 Articolo di Devin sulla governance degli agenti con BlackRock 🔗 Documentazione di Devin Plugins
Claude for Financial Advisors, undici connettori e otto skills per i consulenti
14 settembre — Anthropic lancia Claude for Financial Advisors, una suite di connettori e skills per i consulenti patrimoniali. Arrivano undici nuovi connettori (Addepar, BlackRock, Charles Schwab, Envestnet, iCapital, Orion, SS&C Black Diamond, Wealthbox, Wealth.com, Vanguard e Zocks) e un plugin installabile da Cowork raggruppa otto skills:
| Fase del lavoro | Skills del plugin |
|---|---|
| Prima dell’incontro | Pre-meeting prep, Prospect intake |
| Dopo l’incontro | Post-meeting notes and follow-up |
| Analisi patrimoniale | Portfolio rebalance review, Estate and tax brief, Alternative investments brief |
| Avvio e conformità | Advisor onboarding, Compliance and AI policy |
Le attività critiche richiedono l’approvazione del consulente e sia le raccomandazioni d’investimento sia le comunicazioni ai clienti restano soggette a revisione umana. Anthropic consiglia l’offerta Enterprise ai consulenti registrati (registered investment advisers) per i suoi registri di audit, concede un credito d’uso agli studi che richiedono una nuova licenza entro la fine di settembre e organizza un webinar il 18 settembre.
🔗 Claude for Financial Advisors
Il codice agentico mette sotto pressione la CI di Anthropic
14 settembre — Sul blog di Claude, Sachin Malhotra racconta come il codice agentico abbia messo sotto pressione la CI di Anthropic.
| Indicatore pubblicato da Anthropic | Valore dichiarato |
|---|---|
| Codice distribuito per ingegnere, a trimestre | 8 volte la media del 2021-2025 |
| Quota di codice scritta da Claude | 80 % |
| Volume dei job di CI | Moltiplicato per 25 in sei mesi |
| Durata dei tre correttivi | 70 giorni, 29 giorni, meno di un giorno |
| Riprogettazione finale | 3 settimane, un solo ingegnere |
Il collo di bottiglia si è formato nel servizio di selezione dei test (test impact analysis), che sceglie i test da eseguire su ogni PR. Progettato come un unico processo, ha esaurito tre correttivi prima di una riprogettazione condotta su consiglio di Claude: lo stato viene spostato in un archivio in memoria e le elaborazioni, diventate stateless, vengono distribuite orizzontalmente. L’autore consiglia di prevedere un carico 25 volte superiore entro due trimestri.
🔗 Agentic coding is straining CI
CobbleDB sostituisce DynamoDB nella ricerca di Perplexity
14 settembre — Perplexity descrive nel dettaglio CobbleDB, l’archivio chiave-valore distribuito che ora fornisce alla sua ricerca i passaggi pre-segmentati e gli embeddings di ogni pagina, al posto di DynamoDB. Costruito su RocksDB, con tre repliche per partizione, una cache in memoria e storage NVMe, rinuncia intenzionalmente alle transazioni. Latenze misurate in produzione per una lettura in batch:
| Percentile di latenza | Prima, con DynamoDB | Dopo, con CobbleDB |
|---|---|---|
| Mediana (p50) | 31,4 ms | 5,60 ms |
| 90º percentile (p90) | 56,7 ms | 9,77 ms |
| 99º percentile (p99) | 123 ms | 24,2 ms |
Perplexity precisa che si tratta di un confronto prima/dopo su traffico reale, in momenti diversi, e che il risparmio di almeno il 20 % rispetto a DynamoDB deriva da una stima interna. Secondo l’azienda, le circa 40.000 righe di Rust che costituiscono il cuore del database sono state scritte in due mesi da due ingegneri e centinaia di agenti. È prevista una pubblicazione open source, senza una data.
🔗 Articolo di Perplexity su CobbleDB
TRL v1.14: GRPO asincrono con LoRA, distribuito su HF Jobs
10 settembre — In un articolo ufficiale del 10 settembre, Hugging Face descrive nel dettaglio una novità di TRL v1.14: AsyncGRPOTrainer, che separa addestramento e generazione, può addestrare un adattatore LoRA e sincronizzare con vLLM soltanto quest’ultimo, vale a dire pochi megabyte invece di circa 3 GB per un modello da 1,5 miliardi di parametri. Il trainer e le repliche vLLM vengono eseguiti su Jobs separati, collegati tramite uno Storage Bucket.
| Indicatore misurato | Prima esecuzione | Quinta esecuzione |
|---|---|---|
| Durata per 500 passaggi | 3 h 27 min | 53 min |
| Durata mediana di un passaggio | 22,9 s | 4,8 s |
| MFU forward + backward | 3,9 % | 23,5 % |
| Ricompensa negli ultimi 20 passaggi | 0,438 | 0,416 |
Tre impostazioni spiegano il miglioramento: raggruppare le sequenze per micro-batch, disattivare il ricalcolo delle attivazioni (gradient checkpointing) e aumentare da 128 a 384 il numero di richieste in corso, mantenendo una ricompensa comparabile. La configurazione iniziale costa circa 20 dollari l’ora e gli script di riproduzione sono pubblicati.
🔗 Async GRPO with LoRA across HF Jobs
Transformer Engine moltiplica per 10,4 il throughput del MoE dropless in JAX
14 settembre — NVIDIA mostra come Transformer Engine acceleri in JAX l’addestramento dei mixture of experts senza scarto di token (dropless MoE), in cui ogni expert riceve un numero variabile di token. Su DeepSeek-V3, il testo colloca il miglioramento di 10,4 volte su GB200, mentre la didascalia della figura lo colloca su GB300 NVL72.
| Metrica pubblicata da NVIDIA | Valore dichiarato |
|---|---|
| Throughput iniziale | 103 TFLOPS per GPU |
| Quota della comunicazione nel tempo del kernel | 84 % inizialmente |
| Throughput con Transformer Engine | 1.068 TFLOPS per GPU, ovvero 10,4 volte di più |
| Efficienza di scaling a 1.024 GPU | 97 % |
Il miglioramento deriva in particolare da un grouped GEMM in MXFP8, che elabora tutti gli experts con una sola chiamata al kernel, e da operazioni di dispatch e combine fuse tramite NCCL EP. Le ottimizzazioni sono incluse nel container NGC MaxText e NVFP4 è annunciato per il futuro.
🔗 Articolo tecnico di NVIDIA sul MoE dropless in JAX
PC-ALM, l’apprendimento locale di Sakana AI che addestra 1.000 layer senza backpropagation
14 settembre — Sakana AI pubblica PC-ALM (Augmented Lagrangian Predictive Coding), un metodo che sostituisce la retropropagazione (backpropagation) con dinamiche locali, nelle quali ogni layer comunica soltanto con quelli adiacenti. Estende il predictive coding (predictive coding) dotando ogni layer di variabili duali, i moltiplicatori di Lagrange, che lo trasformano in un controller a feedback proporzionale-integrale; in una rete lineare, queste variabili recuperano esattamente i segnali di credito della retropropagazione.
Su MNIST, gli MLP residuali con larghezza 32 restano a circa 2 punti percentuali dalla retropropagazione fino a 1.000 layer. Su CIFAR-10 e Tiny ImageNet, PC-ALM supera il predictive coding standard, ma i risultati sono forniti soltanto sotto forma di grafici. Sakana AI lo presenta come il primo metodo locale, per quanto ne sa, capace di addestrare reti così profonde, su attività che restano semplici. Il paper e il codice sono pubblicati.
🔗 Augmented Lagrangian Predictive Coding
Scribe v2 Medical, la trascrizione medica di ElevenLabs, è disponibile a livello generale
11 settembre — Annunciata l’11 settembre soltanto nel changelog della documentazione, senza tweet né articolo, la disponibilità generale di Scribe v2 Medical completa l’offerta di trascrizione di ElevenLabs. Questa versione perfezionata di Scribe v2 riconosce meglio i nomi dei farmaci, l’anatomia, la patologia e la dettatura clinica, mantenendo al contempo la precisione di Scribe v2 sul parlato comune. Il modello elabora l’audio in batch, allo stesso prezzo di Scribe v2, con scribe_v2_medical come identificatore del modello e le stesse opzioni, dal rilevamento delle entità alla diarizzazione. ElevenLabs lo destina alla documentazione clinica, alle chiamate di ammissione e ai flussi di conformità relativi ai dati sanitari protetti. La sua scheda tecnica dichiara il 15 % di errori in meno rispetto a Scribe v2 sui termini medici isolati e il supporto di oltre 90 lingue.
🔗 Changelog di ElevenLabs dell’11 settembre
Google Flow arriva su iPhone
10 settembre — L’account @FlowbyGoogle ha annunciato il 10 settembre l’app iOS di Google Flow, lo studio di creazione IA di Google. Secondo la sua scheda sull’App Store, è gratuita con acquisti in-app, disponibile esclusivamente per iPhone e richiede iOS 16 o versioni successive. Consente di creare e modificare immagini e video con i modelli generativi di Google, partendo dal rullino fotografico o dalla fotocamera. La libreria rimane sincronizzata con la versione desktop e più generazioni possono essere eseguite in background, con una notifica quando il risultato è pronto. La scheda non indica alcun modello.
🔗 Annuncio di @FlowbyGoogle su X 🔗 Google Flow sull’App Store
In breve
- Claude Tag nella sanità, tenuto lontano dai dati protetti — poiché Claude Tag non è ancora coperto dall’accordo BAA di Anthropic, Insight Health, Tennr e Medallion lo limitano a canali privi di dati sanitari; presso Insight Health, il 97 % degli avvisi critici viene chiuso senza l’intervento di un ingegnere. I crediti Claude Tag offerti alle organizzazioni che lo collegano a GitHub scadono il 1º ottobre. 🔗 fonte
- Anthropic e Accenture pubblicano una guida per passare dal progetto pilota alla produzione — destinata ai CIO, parte da due dati di Accenture: soltanto il 23 % dei dirigenti rileva un impatto duraturo dell’IA su scala aziendale e il 42 % delle organizzazioni non dispone di un unico responsabile dei relativi costi e risultati. 🔗 fonte
- Claude Fable 5.1 risolve il Cyphral Distich, un crittogramma del 1653 — dimostrazione di terze parti descritta in un articolo di Vals AI datato 31 agosto e rilanciato la sera del 13 settembre, ora del Pacifico, da Boris Cherny: 44 minuti e 176.000 token, senza intervento umano. L’autore riconosce che l’indizio era semplice. 🔗 fonte
- Fyxer fa accettare senza modifiche il 53 % delle sue bozze di e-mail — in questo caso di studio di OpenAI, l’assistente esecutivo distribuisce il lavoro tra 30 e 50 modelli specializzati, perfezionati sulle correzioni degli utenti, e ha visto i propri ricavi ricorrenti annuali passare da 1 a 32 milioni di dollari nel 2025. Non viene indicato alcun modello. 🔗 fonte
- Devin gestisce la reperibilità PagerDuty — secondo le note di rilascio dell’11 settembre, Devin può classificare gli incidenti PagerDuty e pubblicare la propria indagine nelle note dell’incidente, 21 server MCP si collegano tramite OAuth con un clic e l’API Sessions v1 accetta una
idempotency_key. 🔗 fonte - DevFest 2026 dal 1º ottobre al 31 dicembre — i Google Developer Groups prevedono oltre 800 eventi in 115 Paesi, con workshop e maratone di creazione di agenti (agent-athons) incentrati su Gemini, AI Studio, Antigravity e Web MCP. 🔗 fonte
- Suno presenta Studio Chat — questo assistente di Suno Studio conosce ogni traccia e ogni frammento MIDI del progetto e può organizzare, rinominare, colorare o scrivere una nuova parte direttamente sulla timeline. Non vengono annunciati né la disponibilità né il prezzo. 🔗 fonte
- L’ecosistema open source di MiniMax H3 si amplia — MiniMax mette in evidenza tre progetti della community: VDN, che ripensa l’attention per accelerare l’inference, le Acc-LoRAs PDD in otto passaggi di Alibaba PAI e le Turbo LoRAs in quattro e otto passaggi di LightX2V. 🔗 fonte
- Runway descrive nel dettaglio la realizzazione di A Game of HORSE — un video tutorial, i prompt del cortometraggio e la skill scaricabile runway-sd-enhancer, che trasforma un prompt grezzo in un prompt di produzione per una scena di 15 secondi. 🔗 fonte
- Ai2 fa testare AutoDiscovery agli studenti dell’Università di Washington — dieci team hanno testato l’agente: indicazioni utili sulle batterie o sulle proteine, ma circa la metà delle ipotesi era illogica su 24.000 configurazioni simulate di reattori. I crediti di prova sono prorogati fino al 31 dicembre. 🔗 fonte
- Archsloth avvicina i suoi GGUF Qwen all’originale — contributo della community del team FINAL-Bench sul blog di Hugging Face: a parità di dimensioni con il file di unsloth, il suo
Q4_K_Mdi Qwen3-4B riduce la divergenza KL del 54,4 % in coreano e del 33,2 % in inglese, grazie a due opzioni AutoRound corrette. 🔗 fonte - Eric Mey misura la compatibilità OpenAI di un agente LangGraph — contributo individuale sullo stesso blog della community: i 37 campi di richiesta di Chat Completions sono classificati e nessuno rimane silenzioso, rispetto agli 11 iniziali, ma un difetto di streaming è sfuggito alla convalida degli schemi. 🔗 fonte
- EcoHash quantifica ciò che può servire una RTX PRO 6000 da 96 GB — articolo di un fornitore di inference, misurato sul proprio servizio con i CSV grezzi pubblicati: qwen3.6-35b-a3b restituisce il primo token in 170 ms (p95) e circa 213 token al secondo, mentre il throughput raggiunge circa 11.500 token al secondo con richieste concorrenti su Llama-3.1-8B. 🔗 fonte
Cosa significa
Il primo filo conduttore è quello degli agenti che vengono programmati e supervisionati. Claude Mods consente a ciascuno di scrivere i propri hook in TypeScript, ma ne fa passare gli effetti collaterali attraverso un oggetto $ che gli amministratori possono controllare e limitare. Devin Plugins applica la stessa logica su scala aziendale, con plugin obbligatori o vietati in base all’ambito; GitHub permette di scegliere il compromesso tra costo e qualità del routing di Auto; sia Qwen Code sia Kimi Code regolano la durata dei propri obiettivi; e Kimi Code può caricare i propri strumenti MCP su richiesta. MCP funge anche da canale di distribuzione: un’unica installazione porta voce, musica e più di 50 modelli di immagini e video di ElevenLabs in cinque assistenti, senza uscire dalla conversazione.
Il secondo filo conduttore riguarda l’infrastruttura che questo codice agentico mette sotto pressione o costruisce. In Anthropic, dove Claude scrive l’80% del codice, i job di CI si sono moltiplicati per 25 in sei mesi e la riprogettazione del servizio di selezione dei test ha richiesto tre settimane a un solo ingegnere. In Perplexity, due ingegneri e centinaia di agenti hanno scritto le 40.000 righe di Rust di CobbleDB, la cui latenza di lettura è circa cinque volte inferiore secondo le sue misurazioni. L’addestramento segue lo stesso andamento: TRL riduce un run GRPO da 3 h 27 min a 53 min e Transformer Engine moltiplica per 10,4 il throughput di un MoE dropless, in due articoli che individuano il collo di bottiglia prima di eliminarlo.
Il terzo filo conduttore è politico: chi stabilisce il ritmo e le regole. Tre giorni dopo l’editoriale di OpenAI che chiedeva una legge federale basata sulle capacità dei modelli, Dario Amodei propone di scandire i progressi dei modelli di frontiera iniziando con l’aprire Anthropic a valutatori integrati, mentre Aidan Gomez contesta il metodo. I due testi concordano sulla valutazione indipendente dei sistemi più capaci e divergono su ciò che dovrebbe seguire: da un lato, una regolamentazione rivolta a tutte le aziende di frontiera statunitensi, accompagnata da standard discussi nell’ambito di una limitata esenzione antitrust; dall’altro, un quadro dei rischi elaborato da più Paesi e audit mai pagati dai soggetti sottoposti a verifica. La discussione verte meno sul principio di un controllo che su chi ne scrive le regole.
L’ultimo filo conduttore riguarda i dati sensibili, ai quali l’IA si avvicina con salvaguardie integrate nel prodotto. Portable Computer conserva file e richieste sul PC e chiede l’autorizzazione prima di qualsiasi trasferimento verso il cloud; Scribe v2 Medical è destinato alla dettatura clinica e ai flussi di conformità relativi ai dati sanitari protetti; Claude Tag, non essendo coperto dall’accordo BAA, resta limitato ai canali che non ne contengono; e Claude for Financial Advisors riserva al consulente l’approvazione delle attività critiche. Più l’agente si avvicina alla cartella di un paziente o al portafoglio di un cliente, più diventa esplicito il limite di ciò che può fare da solo.
Fonti
- Boris Cherny su X, Claude Mods
- Claude Code, issue Function Hooks #91870
- Dario Amodei, We Must Pace the Frontier
- Dario Amodei su X, annuncio della sperimentazione
- Cohere, Who Gets to Define the Rules for AI?
- ElevenLabs su X, annuncio dell’MCP creativo
- ElevenLabs su X, client compatibili
- GitHub Changelog, livelli della selezione automatica del modello
- GitHub Docs, About Copilot auto model selection
- Perplexity, Portable Computer per Windows
- Perplexity, pagina del prodotto Portable Computer
- NVIDIA, Portable Computer sui PC RTX
- Qwen Code, note di rilascio 0.23.4
- Kimi Code, note di rilascio 0.43.0
- OpenAI Developers su X, Arch Linux
- ChatGPT, applicazione per Linux
- Devin, governance degli agenti con BlackRock
- Devin, documentazione dei plugin
- Claude, Claude for Financial Advisors
- Claude, Agentic coding is straining CI
- Perplexity, CobbleDB
- Hugging Face, Async GRPO with LoRA across HF Jobs
- NVIDIA, MoE dropless in JAX con Transformer Engine
- Sakana AI, PC-ALM
- ElevenLabs, changelog dell’11 settembre
- Google Flow su X
- Google Flow sull’App Store
- Claude, Claude Tag nel settore sanitario
- Claude, guida dal progetto pilota alla produzione con Accenture
- Boris Cherny su X, Cyphral Distich
- Vals AI, Claude Fable 5.1 Solves the Cyphral Distich
- OpenAI, caso di studio Fyxer
- Devin, note di rilascio
- Google, DevFest 2026
- Suno su X, Studio Chat
- MiniMax su X, ecosistema H3
- Runway su X, A Game of HORSE
- Ai2, AutoDiscovery e gli studenti dell’Università di Washington
- Hugging Face, Archsloth e AutoRound
- Hugging Face, compatibilità con OpenAI di un agente LangGraph
- Hugging Face, EcoHash e RTX PRO 6000