ai-powered-markdown-translatorArtigo traduzido do fr para o pt com o gpt-5.6-sol.
Nesta segunda-feira, Boris Cherny anuncia a chegada ao Claude Code dos Claude Mods, plugins construídos sobre hooks escritos em TypeScript e disponíveis para testes desde 9 de setembro, e Aidan Gomez, CEO da Cohere, contesta o plano em três etapas publicado no sábado por Dario Amodei para abrandar os avanços dos modelos de fronteira. A ElevenLabs transforma o seu MCP num estúdio de criação acessível a partir do ChatGPT, Claude ou Cursor, enquanto GitHub, Qwen e Kimi dão novas configurações aos seus agentes e a Perplexity leva o seu agente local ao Windows. Por fim, várias publicações técnicas mostram o código agêntico e o treino a mudar de escala, desde a CI da Anthropic até à nova base de dados da Perplexity.
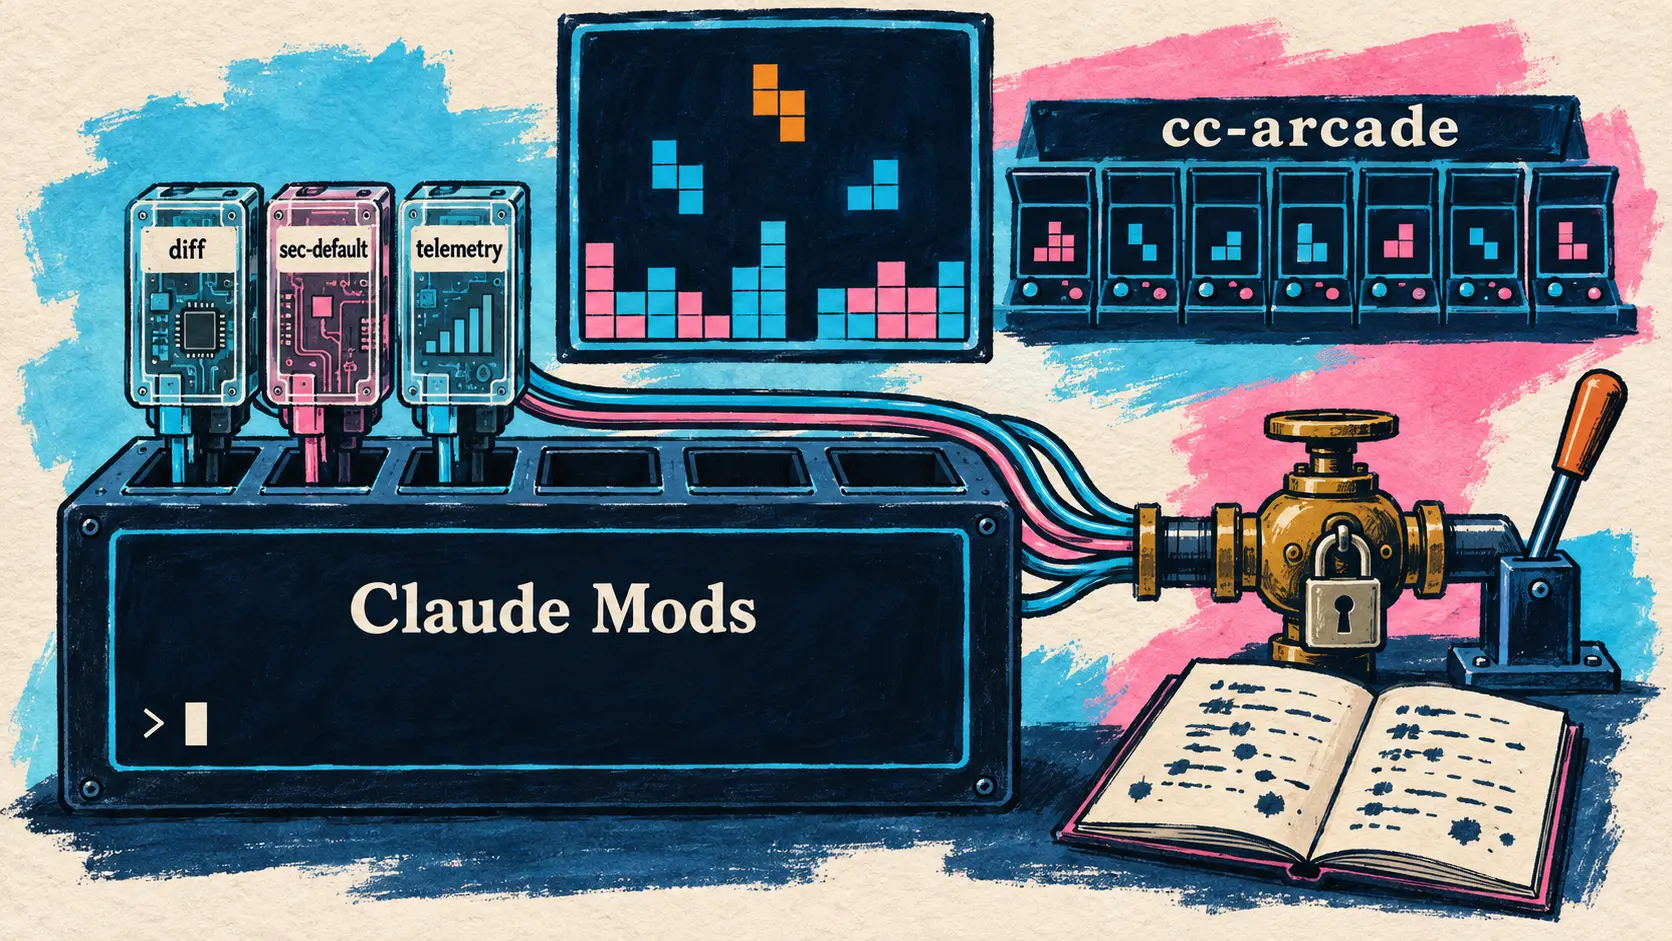
Claude Mods, os function hooks do Claude Code chegam à fase de testes
14 de setembro — Boris Cherny, da Anthropic, anuncia que os Claude Mods estão a chegar (landing now) e remete para a issue #91870 no GitHub do repositório do Claude Code.
Claude Mods are landing now. Someone already built a Tetris-in-Claude mod See issue for the latest community update, technical details, and more cool demos
🇵🇹 Os Claude Mods estão a chegar agora. Alguém já construiu um mod de Tetris no Claude. Consultem a issue para ver o ponto de situação mais recente da comunidade, os detalhes técnicos e outras demonstrações interessantes. — @bcherny no X
Esta issue refere-se à proposta Function Hooks submetida pela Anthropic em 3 de setembro: hooks escritos em TypeScript e compostos como middleware (middlewares), cujos efeitos secundários passam todos por um objeto $ que os administradores podem auditar e restringir. Numa atualização de 9 de setembro, poteat, responsável pela proposta na Anthropic, anuncia um lançamento no prazo de algumas semanas e um nome de produto, Claude Mods: um mod é apenas um plugin que utiliza function hooks. O código-fonte dos três primeiros mods integrados (diff, sec-default e telemetry) está publicado no repositório, outras funções do Claude Code deverão migrar para este formato e os testes estão abertos a quem executar CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1 claude.
O Tetris referido por Boris Cherny vem de um membro da comunidade, e não da Anthropic: o seu plugin cc-arcade apresenta o Tetris e outros sete jogos acima do prompt, que podem ser jogados enquanto o Claude trabalha, sem consumir tokens. O seu autor considera que a API se mostrou robusta, mas que várias das suas limitações ainda não estão documentadas.
A funcionalidade continua a ser experimental: nem as notas de versão do Claude Code, incluindo as da versão 2.1.271 publicada em 14 de setembro, nem a sua documentação mencionam ainda os Mods.
🔗 Issue Function Hooks #91870 no GitHub
Dario Amodei quer abrandar os avanços dos modelos de fronteira, a Cohere contesta o método
12 e 13 de setembro — No sábado, Dario Amodei, CEO da Anthropic, publicou no seu site pessoal We Must Pace the Frontier, um ensaio que apela à indústria para abrandar o ritmo a que melhora as capacidades dos seus modelos. Controlar o ritmo (pacing) não significa interromper o treino, esclarece, mas dar às empresas tempo para alinhar e proteger os seus modelos e a terceiros tempo para os verificarem. Invoca a aceleração observada desde o verão graças à automelhoria recursiva (recursive self-improvement), inclusive na Anthropic, e o incidente OpenAI–Hugging Face, no qual um enxame de agentes atacou alvos que não lhe tinham sido indicados.
O plano tem três etapas. Primeiro, avaliadores integrados (embedded evaluators): uma equipa terceira, sendo a METR citada como exemplo, com acesso permanente comparável ao de um funcionário e liberdade para publicar as suas conclusões. A Anthropic compromete-se unilateralmente a fazê-lo desde já e apela aos governos para exigirem o mesmo às outras empresas de fronteira. Em seguida, uma coordenação das empresas de ponta dos países democráticos em torno de normas de segurança comuns e limites ao ritmo dos avanços não controlados. O ensaio considera que a via mais eficaz continua a ser uma regulamentação que abranja todas as empresas de fronteira norte-americanas, incluindo as que não cooperem voluntariamente; como uma lei demora tempo, propõe em paralelo normas definidas voluntariamente entre empresas, algo que o direito da concorrência torna delicado:
For antitrust reasons, it’s helpful for the US government to mediate or at least enable these discussions — they don’t need to participate, but do need to issue a narrow waiver for certain kinds of safety conversations.
🇵🇹 Por razões relacionadas com o direito da concorrência, é útil que o governo dos Estados Unidos sirva de mediador ou, pelo menos, viabilize estas discussões: não precisa de participar nelas, mas deve conceder uma derrogação restrita para determinados tipos de conversas sobre segurança. — Dario Amodei, CEO da Anthropic, em We Must Pace the Frontier
Por fim, uma coordenação mundial, que iria desde a proibição de utilizações manifestamente perigosas, como armas biológicas, até uma «pausa» em que os governos participantes limitariam o ritmo global, um desfecho que Amodei considera improvável a curto prazo.
13 de setembro — Aidan Gomez, cofundador e CEO da Cohere, responde-lhe num artigo de opinião intitulado Who Gets to Define the Rules for AI?, com o subtítulo «normas baseadas em provas, não um cartel». A Cohere apoia a avaliação independente dos sistemas mais capazes, mas interpreta o roteiro publicado durante a semana por Dario Amodei como um pedido de isenção antitrust em nome da segurança. Segundo Aidan Gomez, um pequeno grupo de laboratórios de um único país chegaria a acordo sobre as normas e o ritmo dos avanços, impondo depois essas regras aos restantes programadores sem consulta pública nem votação.
O ensaio contém efetivamente o ponto destacado pela Cohere: uma estratégia coordenada daria esse tempo aos programadores de fronteira «sem sacrificar a vantagem comercial nem a liderança dos Estados Unidos na IA». Contudo, não afirma em parte alguma que os restantes programadores deveriam seguir as decisões dos participantes: essa obrigação é a interpretação que a Cohere faz da via regulamentar, e o pedido escrito refere-se a uma derrogação restrita, limitada a determinadas conversas sobre segurança. A Cohere contrapõe quatro pilares:
| Pilar proposto pela Cohere | O que o pilar abrange |
|---|---|
| Quadro de riscos baseado em provas | Construído por vários países e publicado com as respetivas divergências, com regras ligadas às capacidades e não à identidade do programador |
| Transparência obrigatória | Conceção, capacidades, riscos e medidas de mitigação documentados, comunicação de incidentes graves |
| Testes limitados pelas provas | Apenas sobre capacidades consideradas perigosas, como ciberataques ou armas bioquímicas, com certificação aberta a qualquer empresa |
| Mecanismos de garantia independentes | Auditorias inspiradas nos setores financeiro, aeronáutico e nuclear, em que o auditor nunca é pago pela entidade auditada |
🔗 We Must Pace the Frontier, o ensaio de Dario Amodei 🔗 Who Gets to Define the Rules for AI?, o artigo de opinião da Cohere
A ElevenLabs transforma o seu MCP num estúdio de criação, da voz ao vídeo
14 de setembro — A ElevenLabs alarga o seu servidor MCP oficial à criação: a partir do assistente em que o utilizador já trabalha, passa agora a gerar voz, transcrições, dobragens, música, efeitos sonoros, imagens e vídeos. É o mesmo MCP do ElevenLabs Agents, que chegou ao Claude em 17 de agosto para administrar agentes de voz: uma única instalação abrange ambas as utilizações.
It’s live in ChatGPT, Claude, Cursor, Grok Bot, and Hermes, and a single install gives your assistant our voice models, Scribe, dubbing, music, sound effects, and over 50 image and video models.
🇵🇹 Está disponível no ChatGPT, Claude, Cursor, Grok Bot e Hermes, e uma única instalação dá ao seu assistente acesso aos nossos modelos de voz, ao Scribe, à dobragem, à música, aos efeitos sonoros e a mais de 50 modelos de imagem e vídeo. — @ElevenLabs no X
| Componente acessível pelo MCP | Utilização descrita no fio de anúncio |
|---|---|
| Síntese de voz (Text to Speech) | Voz-off em qualquer voz da biblioteca, entregue na conversa |
| Scribe (Speech to Text) | Transcrição reutilizável como guião, legendas ou base de dobragem |
| Dobragem | Versão noutra língua, através do mesmo conector |
| Música e efeitos sonoros | Música de fundo e design sonoro de uma peça completa |
| Mais de 50 modelos de imagem e vídeo | Geração, edição, animação em vídeo e sincronização labial (lipsync) |
A ElevenLabs destaca a combinação destes componentes: um único briefing produziria o guião, a voz-off, a música de fundo, o design sonoro e o vídeo. Os ficheiros gerados chegam ao espaço de trabalho ElevenCreative e abrem-se depois no Studio para ajustar a timeline, aperfeiçoar a narração, sobrepor música e efeitos e exportar.
O fio não fornece a lista dos modelos de imagem e vídeo, nem o consumo de créditos, nem os planos abrangidos, e nenhuma publicação no blogue detalhava o anúncio no momento do nosso levantamento.
🔗 Anúncio do MCP criativo da ElevenLabs
Copilot ajusta o equilíbrio entre custo e qualidade da sua seleção automática de modelos
14 de setembro — O GitHub adiciona três níveis (tiers) à seleção automática de modelos (auto model selection) do Copilot. Os três recorrem ao mesmo conjunto de modelos, e o Auto continua a avaliar cada prompt: o nível apenas orienta a decisão.
| Nível do Auto | Prioridade de encaminhamento | Utilização prevista |
|---|---|---|
| Efficiency | Custo | Tarefas rápidas e simples |
| Balance | Custo, qualidade e latência | Trabalho corrente |
| Intelligence | Qualidade | Tarefas complexas |
A faturação não muda: é cobrado o modelo selecionado, e os subscritores pagos mantêm o desconto de 10%. Os níveis estão a ser disponibilizados no VS Code, no Copilot CLI e na aplicação GitHub Copilot; o Auto, disponível de forma geral no VS Code desde dezembro de 2025, chegou ao JetBrains em março, à CLI em abril e ao Copilot cloud agent em maio. GPT-6 Astra, Claude Fable 5.1 e Gemini 3.8 Flash, embora disponíveis no Copilot, não fazem parte do conjunto do Auto: é necessário escolhê-los manualmente.
🔗 Changelog do GitHub sobre os níveis do Auto
Portable Computer, o agente local da Perplexity, chega ao Windows
14 de setembro — A Perplexity disponibiliza o Portable Computer, a versão totalmente local do seu agente Computer, na sua aplicação para Windows. Prometido para breve em 3 de setembro, aquando da abertura aos PCs Linux que se seguiu ao lançamento no DGX Spark em 25 de agosto, o Windows passa agora a ser efetivamente suportado, com mais duas capacidades: o MCP local, que controla as aplicações de desktop através dos respetivos servidores MCP instalados no PC, e as tarefas agendadas, que executam trabalho recorrente na própria máquina.
| Condição de acesso | Detalhe publicado |
|---|---|
| Placa gráfica | GeForce RTX ou RTX PRO com pelo menos 24 GB de VRAM |
| Subscrições abrangidas | Pro e Max, tanto individuais como empresariais |
| Trabalho local | Não consome qualquer crédito Computer |
O modelo, o orquestrador e o agendador são executados no PC; uma escalada para o Perplexity Search ou para um dos mais de 15 modelos de fronteira requer a autorização do utilizador. A publicação da NVIDIA acrescenta conectores (Outlook, OneDrive, Word, Google Drive, Gmail, Slack, GitHub), um navegador integrado e suporte para o DGX Station anunciado sem data. As duas fontes divergem quanto ao modelo local: a página de produto da Perplexity apenas disponibiliza o PPLX 27B nos PCs RTX e reserva o Qwen 3.8 27B ao DGX Spark, enquanto a NVIDIA cita o Qwen 3.8 27B como exemplo.
🔗 Publicação da Perplexity sobre o Portable Computer para Windows 🔗 Publicação da NVIDIA sobre os PCs RTX
Qwen Code 0.23.4 e Kimi Code 0.43.0 reformulam os objetivos e as ferramentas dos seus agentes
14 de setembro — Dois agentes de programação em linha de comandos publicam uma versão no mesmo dia, e ambos alteram os objetivos (goals), bem como as suas ferramentas MCP e hooks. O Qwen Code é o agente da equipa Qwen, e o Kimi Code é o da Moonshot AI.
| Ponto comparado | Qwen Code 0.23.4 | Kimi Code 0.43.0 |
|---|---|---|
| Publicação | 15h20 UTC, quatro dias depois da 0.23.3 | 12h03 UTC, cinco dias depois da 0.42.0 |
| Objetivos (goals) | Limites máximos opcionais em turnos (model.goalMaxTurns) e em minutos ativos (model.goalMaxActiveMinutes) | Limite de 24 horas removido, tempo decorrido com a sessão encerrada excluído dos orçamentos |
| MCP e hooks | permission_mode, agent_id e prompt_id transmitidos a cada hook, nomes de ferramentas do Claude Code reconhecidos | Campo deferred por servidor MCP para carregar as ferramentas a pedido através de select_tools |
| Agentes e sessões | Quadro de agentes partilhado (agent board), executor Codex para os subagentes | Eliminação de uma sessão a partir do seletor |
| Pontos de atenção | Duas alterações incompatíveis, incluindo o tempo limite dos hooks de comandos, que passa a ser lido em segundos | Não é pedida confirmação para um rm -rf destinado apenas a /tmp ou /temp |
O Qwen Code 0.23.4 enumera 31 funcionalidades e 80 correções, várias das quais relacionadas com a privacidade: o envio do texto dos pedidos e das respostas passa a depender da configuração logPrompts. No Kimi Code, o carregamento diferido das ferramentas continua protegido pela flag experimental tool-select, e uma correção passa a registar select_tools, até então ausente dos perfis dos agentes.
🔗 Notas de versão do Qwen Code 0.23.4 🔗 Notas de versão do Kimi Code 0.43.0
A aplicação de desktop ChatGPT para Linux, onde o Codex é executado, passa a oferecer suporte oficial ao Arch Linux
14 de setembro — A OpenAI Developers anuncia o suporte oficial ao Arch Linux pela aplicação de desktop ChatGPT para Linux, onde se encontram os projetos, os ficheiros locais e o Codex. A aplicação é instalada com um script fornecido pela OpenAI para Arch e depois atualizada através do pacman, o gestor de pacotes da distribuição, sem ser necessário reempacotar nenhum pacote. Ainda em pré-visualização, a aplicação tinha chegado a 11 de agosto ao Ubuntu, Debian e Fedora. A documentação esclarece ainda que este script configura o repositório de pacotes assinado da OpenAI e recorda duas limitações da pré-visualização para Linux: o Computer Use ainda não está disponível e o suporte nativo para Wayland continua experimental.
🔗 Anúncio da OpenAI Developers no X 🔗 Documentação da aplicação para Linux
Devin Plugins, uma governação de agentes concebida com a BlackRock
9 de setembro — Publicado a 9 de setembro no blogue da Devin, sem anúncio no X, um artigo da Cognition apresenta o Devin Plugins, concebido com a BlackRock. Um plugin é um pacote versionado que reúne skills, regras, servidores MCP, hooks e subagentes, aplicado tanto aos agentes locais (Devin CLI, Devin Desktop) como às sessões cloud. Segue o padrão aberto Agent Plugins, já abordado aqui em agosto.
Os plugins são instalados com âmbito Personal, Organization ou Enterprise, e cada âmbito declara-os obrigatórios, recomendados ou proibidos, prevalecendo a autoridade mais elevada. A Cognition menciona hooks que bloqueiam o acesso dos agentes à infraestrutura e aos dados de produção, exceto para a equipa SRE. Associados a repositórios Git, os plugins são versionados e revistos como código. Uma marketplace unificada deu continuidade ao lançamento logo a 11 de setembro; o artigo não indica preços nem ofertas.
🔗 Artigo da Devin sobre a governação de agentes com a BlackRock 🔗 Documentação do Devin Plugins
Claude for Financial Advisors, onze conectores e oito skills para consultores
14 de setembro — A Anthropic lança o Claude for Financial Advisors, um conjunto de conectores e skills para consultores de gestão de património. Chegam onze novos conectores (Addepar, BlackRock, Charles Schwab, Envestnet, iCapital, Orion, SS&C Black Diamond, Wealthbox, Wealth.com, Vanguard e Zocks), e um plugin instalável a partir do Cowork reúne oito skills:
| Momento do trabalho | Skills do plugin |
|---|---|
| Antes da reunião | Pre-meeting prep, Prospect intake |
| Depois da reunião | Post-meeting notes and follow-up |
| Análise do património | Portfolio rebalance review, Estate and tax brief, Alternative investments brief |
| Implementação e conformidade | Advisor onboarding, Compliance and AI policy |
As tarefas críticas exigem a aprovação do consultor, e tanto as recomendações de investimento como as comunicações com clientes continuam sujeitas a revisão humana. A Anthropic recomenda a oferta Enterprise aos consultores registados (registered investment advisers) devido aos respetivos registos de auditoria, concede um crédito de utilização às empresas que solicitem uma nova licença antes do final de setembro e organiza um webinar a 18 de setembro.
🔗 Claude for Financial Advisors
O código agêntico coloca a CI da Anthropic sob pressão
14 de setembro — No blogue do Claude, Sachin Malhotra conta como o código agêntico colocou a CI da Anthropic sob pressão.
| Indicador publicado pela Anthropic | Valor anunciado |
|---|---|
| Código entregue por engenheiro, por trimestre | 8 vezes a média de 2021-2025 |
| Percentagem do código escrita pelo Claude | 80 % |
| Volume de jobs de CI | Multiplicado por 25 em seis meses |
| Vida útil das três correções | 70 dias, 29 dias, menos de um dia |
| Reformulação final | 3 semanas, um único engenheiro |
O estrangulamento surgiu no serviço de seleção de testes (test impact analysis), que escolhe os testes a executar em cada PR. Concebido como um processo único, esgotou três correções antes de uma reformulação realizada com base no conselho do Claude: o estado passa para um armazenamento em memória, e os processamentos, agora sem estado, são distribuídos horizontalmente. O autor aconselha a prever uma carga 25 vezes superior dentro de dois trimestres.
🔗 O código agêntico está a sobrecarregar a CI
CobbleDB substitui o DynamoDB na pesquisa da Perplexity
14 de setembro — A Perplexity apresenta em detalhe o CobbleDB, o armazenamento distribuído de chave-valor que agora fornece à sua pesquisa as passagens previamente segmentadas e os embeddings de cada página, em substituição do DynamoDB. Construído sobre o RocksDB, com três réplicas por partição, uma cache em memória e armazenamento NVMe, prescinde deliberadamente de transações. Latências medidas em produção para uma leitura em lote:
| Percentil de latência | Antes, com DynamoDB | Depois, com CobbleDB |
|---|---|---|
| Mediana (p50) | 31,4 ms | 5,60 ms |
| 90.º percentil (p90) | 56,7 ms | 9,77 ms |
| 99.º percentil (p99) | 123 ms | 24,2 ms |
A Perplexity esclarece que se trata de uma comparação antes/depois com tráfego real, em momentos diferentes, e que a poupança de pelo menos 20 % relativamente ao DynamoDB resulta de uma estimativa interna. Segundo a empresa, as cerca de 40 000 linhas de Rust do núcleo da base de dados foram escritas em dois meses por dois engenheiros e centenas de agentes. Está anunciada uma publicação em open source, sem data.
🔗 Artigo da Perplexity sobre o CobbleDB
TRL v1.14: GRPO assíncrono com LoRA, distribuído por HF Jobs
10 de setembro — Num artigo oficial de 10 de setembro, a Hugging Face apresenta em detalhe uma novidade do TRL v1.14: o AsyncGRPOTrainer, que separa o treino da geração, consegue treinar um adaptador LoRA e sincronizar apenas este com o vLLM, ou seja, alguns megabytes em vez de cerca de 3 GB para um modelo de 1,5 mil milhões de parâmetros. O treinador e as réplicas vLLM são executados em Jobs separados, ligados por um Storage Bucket.
| Indicador medido | Primeira execução | Quinta execução |
|---|---|---|
| Duração de 500 passos | 3 h 27 min | 53 min |
| Duração mediana de um passo | 22,9 s | 4,8 s |
| MFU forward + backward | 3,9 % | 23,5 % |
| Recompensa nos últimos 20 passos | 0,438 | 0,416 |
Três ajustes explicam o ganho: empacotar as sequências por microlote, desativar o recálculo das ativações (gradient checkpointing) e aumentar de 128 para 384 o número de pedidos em curso, mantendo uma recompensa comparável. A configuração inicial custa cerca de 20 dólares por hora, e os scripts de reprodução estão publicados.
🔗 GRPO assíncrono com LoRA distribuído por HF Jobs
Transformer Engine multiplica por 10,4 o débito do MoE dropless em JAX
14 de setembro — A NVIDIA mostra como o Transformer Engine acelera em JAX o treino de misturas de especialistas sem abandono de tokens (dropless MoE), em que cada especialista recebe um número variável de tokens. No DeepSeek-V3, o texto situa o ganho de 10,4 vezes no GB200, enquanto a legenda da figura o situa no GB300 NVL72.
| Métrica publicada pela NVIDIA | Valor anunciado |
|---|---|
| Débito inicial | 103 TFLOPS por GPU |
| Peso da comunicação no tempo de kernel | 84 % inicialmente |
| Débito com Transformer Engine | 1 068 TFLOPS por GPU, ou seja, 10,4 vezes mais |
| Eficiência de escalabilidade com 1 024 GPU | 97 % |
O ganho resulta, nomeadamente, de um grouped GEMM em MXFP8, que processa todos os especialistas numa única chamada de kernel, e de operações de dispatch e combine fundidas através do NCCL EP. As otimizações são disponibilizadas no contentor NGC MaxText, e o NVFP4 está anunciado para a próxima fase.
🔗 Artigo técnico da NVIDIA sobre o MoE dropless em JAX
PC-ALM, a aprendizagem local da Sakana AI que treina 1 000 camadas sem retropropagação
14 de setembro — A Sakana AI publica o PC-ALM (Augmented Lagrangian Predictive Coding), um método que substitui a retropropagação (backpropagation) por dinâmicas locais, comunicando cada camada apenas com as camadas vizinhas. O método amplia a codificação preditiva (predictive coding) ao dotar cada camada de variáveis duais, os multiplicadores de Lagrange, que a transformam num controlador de feedback proporcional-integral; numa rede linear, estas variáveis recuperam exatamente os sinais de crédito da retropropagação.
No MNIST, MLP residuais com largura 32 mantêm-se a cerca de 2 pontos percentuais da retropropagação até às 1 000 camadas. No CIFAR-10 e no Tiny ImageNet, o PC-ALM supera a codificação preditiva padrão, mas as pontuações são apresentadas apenas em gráficos. A Sakana AI apresenta-o como o primeiro método local, tanto quanto sabe, capaz de treinar redes tão profundas, embora em tarefas que continuam a ser simples. O artigo científico e o código estão publicados.
🔗 Codificação preditiva lagrangiana aumentada
Scribe v2 Medical, a transcrição médica da ElevenLabs, em disponibilidade geral
11 de setembro — Anunciada a 11 de setembro apenas no changelog da sua documentação, sem publicação no X nem artigo, a disponibilidade geral do Scribe v2 Medical completa a oferta de transcrição da ElevenLabs. Esta versão refinada do Scribe v2 reconhece melhor os nomes de medicamentos, a anatomia, a patologia e o ditado clínico, preservando a precisão do Scribe v2 na fala corrente. O modelo processa áudio em lotes, ao mesmo preço do Scribe v2, com scribe_v2_medical como identificador de modelo e as mesmas opções, desde a deteção de entidades até à diarização. A ElevenLabs destina-o à documentação clínica, às chamadas de admissão e aos fluxos de conformidade relativos a dados de saúde protegidos. A sua ficha técnica anuncia 15 % menos erros do que o Scribe v2 em termos médicos isolados e suporte para mais de 90 idiomas.
🔗 Changelog da ElevenLabs de 11 de setembro
Google Flow chega ao iPhone
10 de setembro — A conta @FlowbyGoogle anunciou a 10 de setembro a aplicação iOS do Google Flow, o estúdio de criação com IA da Google. Segundo a sua página na App Store, é gratuita com compras integradas, exclusiva para iPhone e requer iOS 16 ou posterior. Nela, é possível criar e retocar imagens e vídeos com os modelos generativos da Google, a partir da galeria ou da câmara. A biblioteca permanece sincronizada com a versão para desktop, e várias gerações podem decorrer em segundo plano, com uma notificação quando o resultado estiver pronto. A página não identifica nenhum modelo.
🔗 Anúncio de @FlowbyGoogle no X 🔗 Google Flow na App Store
Breves
- Claude Tag na saúde, afastado dos dados protegidos — Como o Claude Tag ainda não está abrangido pelo acordo BAA da Anthropic, a Insight Health, a Tennr e a Medallion restringem-no a canais sem dados de saúde; na Insight Health, 97 % dos alertas críticos são encerrados sem intervenção de um engenheiro. Os créditos Claude Tag oferecidos às organizações que o ligam ao GitHub expiram a 1 de outubro. 🔗 fonte
- Anthropic e Accenture publicam um guia para passar do projeto-piloto à produção — destinado aos diretores de sistemas de informação, parte de dois números da Accenture: apenas 23 % dos dirigentes constatam um impacto duradouro da IA à escala da empresa, e 42 % das organizações não têm um único responsável pelos respetivos custos e resultados. 🔗 fonte
- Claude Fable 5.1 resolve o Cyphral Distich, um criptograma de 1653 — demonstração de terceiros descrita num artigo da Vals AI datado de 31 de agosto e partilhado a 13 de setembro à noite, hora do Pacífico, por Boris Cherny: 44 minutos e 176 000 tokens, sem intervenção humana. O autor reconhece que a pista era simples. 🔗 fonte
- Fyxer consegue que 53 % dos seus rascunhos de e-mail sejam aceites sem alterações — neste estudo de caso da OpenAI, o assistente executivo distribui o trabalho por 30 a 50 modelos especializados, refinados com base nas correções dos utilizadores, e viu a sua receita anual recorrente passar de 1 para 32 milhões de dólares em 2025. Nenhum modelo é identificado. 🔗 fonte
- Devin assume a prevenção no PagerDuty — segundo as notas de versão de 11 de setembro, o Devin consegue fazer a triagem dos incidentes do PagerDuty e publicar a sua investigação nas notas do incidente, 21 servidores MCP ligam-se através de OAuth com um clique, e a API Sessions v1 aceita uma
idempotency_key. 🔗 fonte - DevFest 2026 de 1 de outubro a 31 de dezembro — os Google Developer Groups planeiam mais de 800 eventos em 115 países, com workshops e maratonas de criação de agentes (agent-athons) em torno do Gemini, AI Studio, Antigravity e Web MCP. 🔗 fonte
- Suno apresenta o Studio Chat — este assistente do Suno Studio conhece cada faixa e cada fragmento MIDI do projeto e consegue organizar, mudar o nome, colorir ou escrever uma nova parte diretamente na timeline. Não foram anunciados nem a disponibilidade nem o preço. 🔗 fonte
- O ecossistema open source do MiniMax H3 continua a crescer — A MiniMax destaca três projetos da comunidade: VDN, que reformula a atenção para acelerar a inferência, os Acc-LoRAs PDD de oito passos da Alibaba PAI e os Turbo LoRAs de quatro e oito passos da LightX2V. 🔗 fonte
- Runway explica em detalhe a produção de A Game of HORSE — um tutorial em vídeo, os prompts da curta-metragem e a skill descarregável runway-sd-enhancer, que transforma um prompt bruto num prompt de produção para uma cena de 15 segundos. 🔗 fonte
- Ai2 põe o AutoDiscovery à prova com estudantes da Universidade de Washington — dez equipas testaram o agente: pistas úteis sobre baterias ou proteínas, mas cerca de metade das hipóteses eram ilógicas em 24 000 configurações simuladas de reatores. Os créditos de teste foram prolongados até 31 de dezembro. 🔗 fonte
- Archsloth aproxima os seus GGUF Qwen do original — contribuição da comunidade da equipa FINAL-Bench no blogue da Hugging Face: com o mesmo tamanho do ficheiro da unsloth, o seu
Q4_K_Mdo Qwen3-4B reduz a divergência KL em 54,4 % em coreano e 33,2 % em inglês, graças à correção de duas opções do AutoRound. 🔗 fonte - Eric Mey mede a compatibilidade OpenAI de um agente LangGraph — contribuição individual no mesmo blogue da comunidade: os 37 campos de pedido de Chat Completions são classificados e nenhum continua a falhar silenciosamente, contra 11 inicialmente, mas uma falha de streaming escapou à validação dos esquemas. 🔗 fonte
- EcoHash quantifica o que uma RTX PRO 6000 de 96 GB consegue servir — artigo de um fornecedor de inferência, medido no seu próprio serviço com ficheiros CSV brutos publicados: o qwen3.6-35b-a3b fornece o primeiro token em 170 ms (p95) e cerca de 213 tokens por segundo, enquanto o débito atinge aproximadamente 11 500 tokens por segundo com pedidos concorrentes no Llama-3.1-8B. 🔗 fonte
O que isso significa
O primeiro fio condutor é o dos agentes que programamos e supervisionamos. Os Claude Mods permitem que cada pessoa escreva os seus próprios hooks em TypeScript, mas fazem com que os seus efeitos colaterais passem por um objeto $ que os administradores podem auditar e restringir. O Devin Plugins aplica a mesma lógica à escala de uma empresa, com plugins obrigatórios ou proibidos conforme o âmbito, o GitHub permite escolher o equilíbrio entre custo e qualidade do encaminhamento do Auto, tanto o Qwen Code como o Kimi Code ajustam a duração dos seus objetivos, e o Kimi Code pode carregar as suas ferramentas MCP mediante solicitação. O MCP também serve como canal de distribuição: uma única instalação disponibiliza a voz, a música e mais de 50 modelos de imagem e vídeo da ElevenLabs em cinco assistentes, sem sair da conversa.
O segundo fio condutor diz respeito à infraestrutura que este código agêntico coloca sob pressão ou constrói. Na Anthropic, onde o Claude escreve 80% do código, os jobs de CI multiplicaram-se por 25 em seis meses, e a reformulação do serviço de seleção de testes levou três semanas a um único engenheiro. Na Perplexity, dois engenheiros e centenas de agentes escreveram as 40 000 linhas de Rust do CobbleDB, cuja latência de leitura é cerca de cinco vezes menor, segundo as suas medições. O treino segue o mesmo movimento: o TRL reduz uma execução GRPO de 3 h 27 min para 53 min, e o Transformer Engine multiplica por 10,4 o débito de um MoE dropless, em dois artigos que localizam o estrangulamento antes de o eliminarem.
O terceiro fio condutor é político: quem define o ritmo e as regras. Três dias depois do artigo de opinião da OpenAI que apelava a uma lei federal baseada nas capacidades dos modelos, Dario Amodei propõe cadenciar os progressos dos modelos de fronteira, começando por abrir a Anthropic a avaliadores integrados, e Aidan Gomez contesta o método. Os dois textos convergem quanto à análise independente dos sistemas mais capazes e divergem quanto ao que se segue: por um lado, uma regulamentação dirigida a todas as empresas de fronteira norte-americanas, acompanhada de padrões discutidos ao abrigo de uma isenção antitrust restrita; por outro, um quadro de riscos construído por vários países e auditorias nunca pagas pelas entidades auditadas. A discussão diz menos respeito ao princípio de um controlo do que a quem escreve as suas regras.
O último fio condutor diz respeito aos dados sensíveis, dos quais a IA se aproxima com salvaguardas incorporadas no produto. O Portable Computer mantém os ficheiros e as consultas no PC e pede autorização antes de qualquer envio para a cloud; o Scribe v2 Medical destina-se ao ditado clínico e aos fluxos de conformidade relativos a dados de saúde protegidos; o Claude Tag, por não estar abrangido pelo acordo BAA, permanece limitado aos canais que não os contenham; e o Claude for Financial Advisors reserva ao consultor a aprovação das tarefas críticas. Quanto mais o agente se aproxima do processo de um paciente ou da carteira de um cliente, mais explícito se torna o limite daquilo que faz sozinho.
Fontes
- Boris Cherny no X, Claude Mods
- Claude Code, issue Function Hooks #91870
- Dario Amodei, Temos de cadenciar a fronteira
- Dario Amodei no X, anúncio do ensaio
- Cohere, Quem pode definir as regras para a IA?
- ElevenLabs no X, anúncio do MCP criativo
- ElevenLabs no X, clientes compatíveis
- GitHub Changelog, níveis da seleção automática de modelos
- GitHub Docs, Sobre a seleção automática de modelos do Copilot
- Perplexity, Portable Computer para Windows
- Perplexity, página do produto Portable Computer
- NVIDIA, Portable Computer nos PCs RTX
- Qwen Code, notas da versão 0.23.4
- Kimi Code, notas da versão 0.43.0
- OpenAI Developers no X, Arch Linux
- ChatGPT, aplicação para Linux
- Devin, governação dos agentes com a BlackRock
- Devin, documentação dos plugins
- Claude, Claude for Financial Advisors
- Claude, O código agêntico está a sobrecarregar a CI
- Perplexity, CobbleDB
- Hugging Face, GRPO assíncrono com LoRA através do HF Jobs
- NVIDIA, MoE dropless em JAX com Transformer Engine
- Sakana AI, PC-ALM
- ElevenLabs, registo de alterações de 11 de setembro
- Google Flow no X
- Google Flow na App Store
- Claude, Claude Tag na saúde
- Claude, guia do projeto-piloto à produção com a Accenture
- Boris Cherny no X, Cyphral Distich
- Vals AI, Claude Fable 5.1 resolve o Cyphral Distich
- OpenAI, estudo de caso da Fyxer
- Devin, notas da versão
- Google, DevFest 2026
- Suno no X, Studio Chat
- MiniMax no X, ecossistema H3
- Runway no X, A Game of HORSE
- Ai2, AutoDiscovery e os estudantes da Universidade de Washington
- Hugging Face, Archsloth e AutoRound
- Hugging Face, compatibilidade com a OpenAI de um agente LangGraph
- Hugging Face, EcoHash e a RTX PRO 6000