ai-powered-markdown-translatorArtículo traducido del fr al es con gpt-5.6-sol.
Este lunes, Boris Cherny anuncia la llegada a Claude Code de Claude Mods, plugins creados sobre hooks escritos en TypeScript y disponibles para pruebas desde el 9 de septiembre, y Aidan Gomez, CEO de Cohere, cuestiona el plan de tres etapas publicado el sábado por Dario Amodei para frenar los avances de los modelos de frontera. ElevenLabs transforma su MCP en un estudio de creación accesible desde ChatGPT, Claude o Cursor, mientras GitHub, Qwen y Kimi ofrecen nuevos ajustes para sus agentes y Perplexity lleva su agente local a Windows. Por último, varias publicaciones técnicas muestran cómo el código agéntico y el entrenamiento cambian de escala, desde la CI de Anthropic hasta la nueva base de datos de Perplexity.
Claude Mods, los function hooks de Claude Code llegan en fase de pruebas
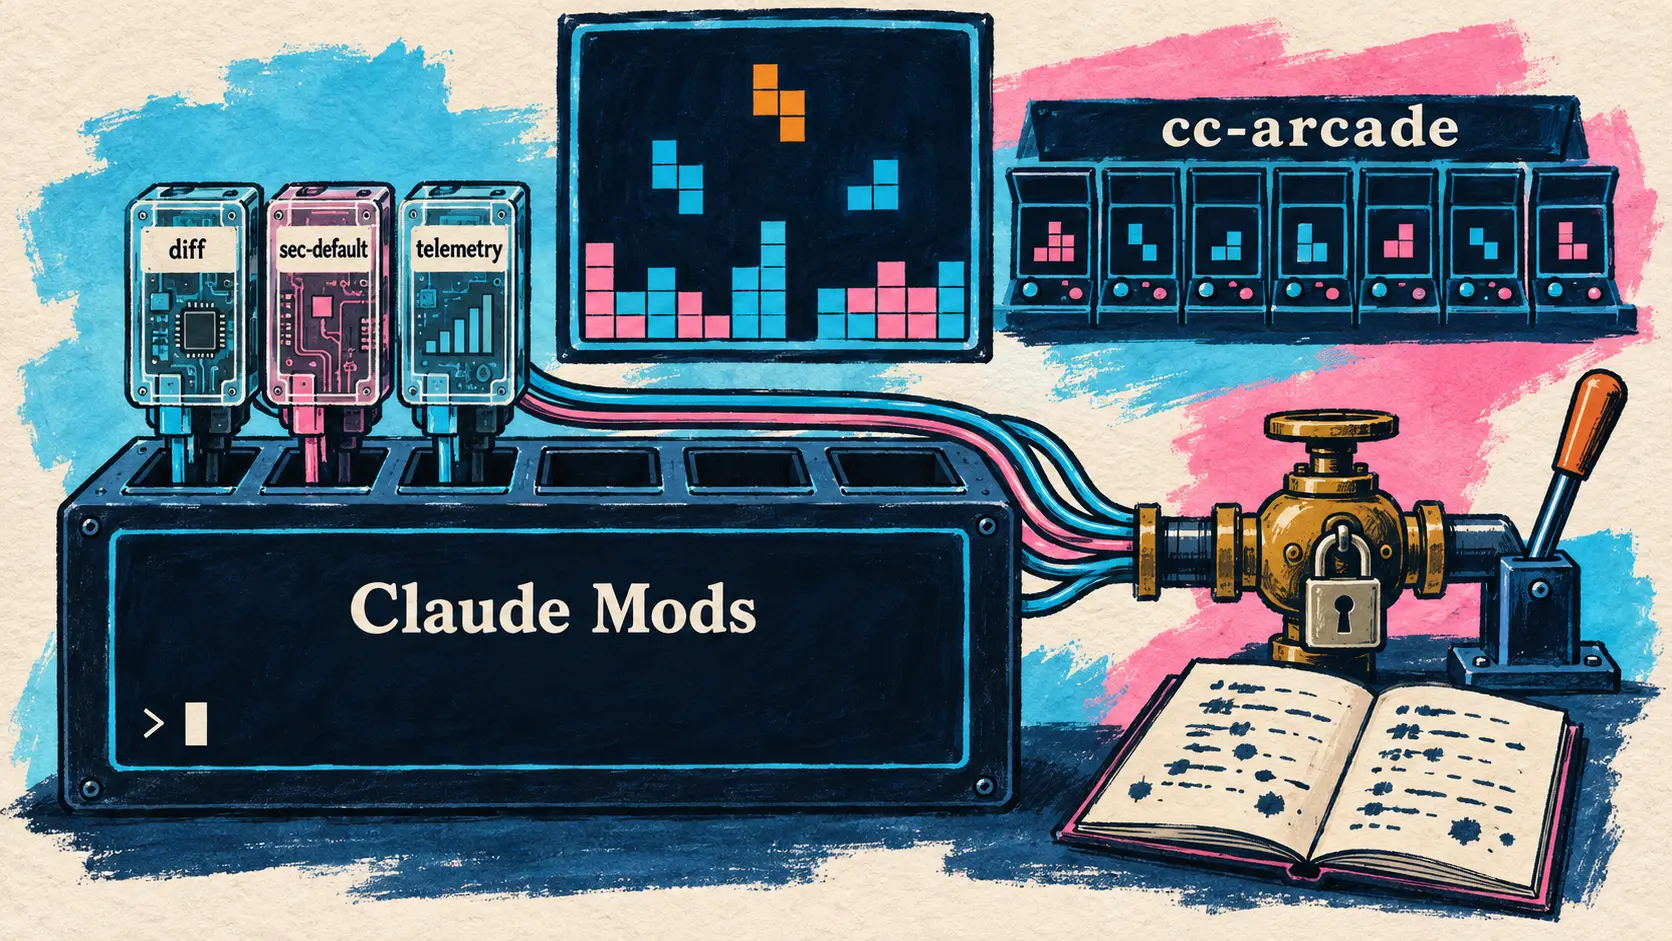
14 de septiembre — Boris Cherny, de Anthropic, anuncia que Claude Mods está llegando (landing now) y remite a la incidencia #91870 del repositorio de Claude Code en GitHub.
Claude Mods are landing now. Someone already built a Tetris-in-Claude mod See issue for the latest community update, technical details, and more cool demos
🇪🇸 Claude Mods está llegando. Alguien ya ha creado un mod de Tetris en Claude. Consulta la incidencia para conocer la última actualización de la comunidad, los detalles técnicos y otras demostraciones interesantes. — @bcherny en X
Esta incidencia contiene la propuesta Function Hooks presentada por Anthropic el 3 de septiembre: hooks escritos en TypeScript y compuestos como middleware (middlewares), cuyos efectos secundarios pasan íntegramente por un objeto $ que los administradores pueden auditar y restringir. En una actualización del 9 de septiembre, poteat, responsable de la propuesta en Anthropic, anuncia un lanzamiento en cuestión de semanas y un nombre de producto, Claude Mods: un mod no es más que un plugin que utiliza function hooks. El código fuente de los tres primeros mods integrados (diff, sec-default y telemetry) está publicado en el repositorio, otras funciones de Claude Code deberán migrar a este formato y las pruebas están abiertas para quienes ejecuten CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1 claude.
El Tetris mencionado por Boris Cherny procede de un miembro de la comunidad, no de Anthropic: su plugin cc-arcade muestra Tetris y otros siete juegos sobre el prompt, que pueden jugarse mientras Claude trabaja, sin consumir tokens. Su autor considera que la API ha respondido bien, pero que varias de sus restricciones todavía no están documentadas.
La función sigue siendo experimental: ni las notas de la versión de Claude Code, incluidas las de la 2.1.271 publicada el 14 de septiembre, ni su documentación mencionan todavía los Mods.
🔗 Incidencia Function Hooks #91870 en GitHub
Dario Amodei quiere frenar los avances de los modelos de frontera, Cohere cuestiona el método
12 y 13 de septiembre — El sábado, Dario Amodei, CEO de Anthropic, publicó en su sitio personal We Must Pace the Frontier, un ensayo que pide a la industria que reduzca el ritmo al que mejora las capacidades de sus modelos. Regular el ritmo (pacing) no significa detener el entrenamiento, precisa, sino dar a las empresas tiempo para alinear y proteger sus modelos, y a terceros para verificarlos. Cita la aceleración observada desde el verano gracias a la autooptimización recursiva (recursive self-improvement), también en Anthropic, y el incidente OpenAI–Hugging Face, en el que un enjambre de agentes atacó objetivos que no se le habían indicado.
El plan consta de tres etapas. Primero, evaluadores integrados (embedded evaluators): un equipo externo, con METR como ejemplo, dotado de un acceso permanente comparable al de un empleado y libre de publicar sus conclusiones. Anthropic asume este compromiso unilateralmente desde ahora y pide a los gobiernos que exijan lo mismo a las demás empresas de frontera. Después, una coordinación entre las empresas punteras de los países democráticos sobre estándares de seguridad comunes y límites al ritmo de los avances no controlados. El ensayo considera que la vía más eficaz sigue siendo una regulación dirigida a todas las empresas de frontera estadounidenses, incluidas aquellas que no cooperasen voluntariamente; como una ley requiere tiempo, propone paralelamente estándares acordados voluntariamente entre empresas, algo que el derecho de la competencia dificulta:
For antitrust reasons, it’s helpful for the US government to mediate or at least enable these discussions — they don’t need to participate, but do need to issue a narrow waiver for certain kinds of safety conversations.
🇪🇸 Por motivos relacionados con el derecho de la competencia, resulta útil que el Gobierno estadounidense actúe como mediador o, al menos, haga posibles estas conversaciones: no necesita participar en ellas, pero debe conceder una exención limitada para determinados tipos de conversaciones sobre seguridad. — Dario Amodei, CEO de Anthropic, en We Must Pace the Frontier
Por último, una coordinación mundial, que iría desde la prohibición de usos manifiestamente peligrosos, como las armas biológicas, hasta una «pausa» durante la cual los gobiernos participantes limitarían el ritmo global, una posibilidad que Amodei considera improbable a corto plazo.
13 de septiembre — Aidan Gomez, cofundador y CEO de Cohere, le responde en un artículo titulado Who Gets to Define the Rules for AI?, subtitulado «estándares basados en pruebas, no un cártel». Cohere respalda la evaluación independiente de los sistemas más capaces, pero interpreta la hoja de ruta publicada esa semana por Dario Amodei como una solicitud de exención antimonopolio en nombre de la seguridad. Según Aidan Gomez, un puñado de laboratorios de un solo país acordaría los estándares y el ritmo de los avances, y esas reglas se impondrían después a los demás desarrolladores sin consulta pública ni votación.
El ensayo sí contiene el punto que señala Cohere: una estrategia coordinada proporcionaría ese tiempo a los desarrolladores de frontera «sin sacrificar la ventaja comercial ni el liderazgo de Estados Unidos en IA». Sin embargo, no dice en ningún momento que los demás desarrolladores deban acatar las decisiones de los participantes: esa obligación es la interpretación que Cohere hace de la vía regulatoria, y la solicitud escrita se refiere a una exención limitada, restringida a determinadas conversaciones sobre seguridad. Cohere contrapone cuatro pilares:
| Pilar propuesto por Cohere | Qué abarca el pilar |
|---|---|
| Marco de riesgos basado en pruebas | Elaborado por varios países y publicado junto con sus desacuerdos, con reglas vinculadas a las capacidades y no a la identidad del desarrollador |
| Transparencia obligatoria | Diseño, capacidades, riesgos y medidas de mitigación documentados, notificación de incidentes graves |
| Pruebas limitadas por las evidencias | Solo sobre capacidades consideradas peligrosas, como los ciberataques o las armas bioquímicas, con certificación abierta a cualquier empresa |
| Mecanismos de garantía independientes | Auditorías basadas en el modelo de las finanzas, la aviación y la industria nuclear, donde el auditor nunca recibe pagos del auditado |
🔗 We Must Pace the Frontier, el ensayo de Dario Amodei 🔗 Who Gets to Define the Rules for AI?, el artículo de Cohere
ElevenLabs convierte su MCP en un estudio de creación, desde la voz hasta el vídeo
14 de septiembre — ElevenLabs amplía su servidor MCP oficial a la creación: desde el asistente con el que ya se trabaja, ahora genera voz, transcripciones, doblajes, música, efectos de sonido, imágenes y vídeos. Es el mismo MCP que el de ElevenLabs Agents, incorporado el 17 de agosto a Claude para administrar agentes de voz: una única instalación cubre ambos usos.
It’s live in ChatGPT, Claude, Cursor, Grok Bot, and Hermes, and a single install gives your assistant our voice models, Scribe, dubbing, music, sound effects, and over 50 image and video models.
🇪🇸 Está disponible en ChatGPT, Claude, Cursor, Grok Bot y Hermes, y una sola instalación proporciona a tu asistente nuestros modelos de voz, Scribe, doblaje, música, efectos de sonido y más de 50 modelos de imagen y vídeo. — @ElevenLabs en X
| Componente accesible mediante el MCP | Uso descrito en el hilo del anuncio |
|---|---|
| Síntesis de voz (Text to Speech) | Voz en off con cualquier voz de la biblioteca, entregada en la conversación |
| Scribe (Speech to Text) | Transcripción reutilizable como guion, subtítulos o base para el doblaje |
| Doblaje | Versión en otro idioma, mediante el mismo conector |
| Música y efectos de sonido | Música de fondo y diseño sonoro de una pieza completa |
| Más de 50 modelos de imagen y vídeo | Generación, retoque, animación en vídeo y sincronización labial (lipsync) |
ElevenLabs destaca la combinación de estos componentes: un único briefing produciría el guion, la voz en off, la música de fondo, el diseño sonoro y el vídeo. Los archivos generados llegan al espacio de trabajo ElevenCreative y después se abren en Studio para ajustar la timeline, perfeccionar la narración, superponer música y efectos, y exportar.
El hilo no proporciona ni la lista de modelos de imagen y vídeo, ni el consumo de créditos, ni los planes incluidos, y ninguna publicación del blog detallaba el anuncio cuando realizamos nuestra revisión.
🔗 Anuncio del MCP creativo de ElevenLabs
Copilot ajusta el equilibrio entre coste y calidad de su selección automática de modelos
14 de septiembre — GitHub añade tres niveles (tiers) a la selección automática de modelos (auto model selection) de Copilot. Los tres utilizan el mismo conjunto de modelos y Auto sigue evaluando cada prompt: el nivel solo orienta la decisión.
| Nivel de Auto | Prioridad de enrutamiento | Uso previsto |
|---|---|---|
| Efficiency | Coste | Tareas rápidas y sencillas |
| Balance | Coste, calidad y latencia | Trabajo habitual |
| Intelligence | Calidad | Tareas complejas |
La facturación no cambia: se factura el modelo seleccionado y los suscriptores de pago conservan su descuento del 10 %. Los niveles se despliegan en VS Code, Copilot CLI y la aplicación GitHub Copilot; Auto, disponible de forma general en VS Code desde diciembre de 2025, llegó a JetBrains en marzo, a la CLI en abril y a Copilot cloud agent en mayo. GPT-6 Astra, Claude Fable 5.1 y Gemini 3.8 Flash, aunque están disponibles en Copilot, no forman parte del conjunto de Auto: deben seleccionarse manualmente.
🔗 Registro de cambios de GitHub sobre los niveles de Auto
Portable Computer, el agente local de Perplexity, llega a Windows
14 de septiembre — Perplexity incorpora Portable Computer, la versión completamente local de su agente Computer, a su aplicación para Windows. Anunciado como próximo el 3 de septiembre, durante la apertura a los PC con Linux que siguió al lanzamiento en DGX Spark el 25 de agosto, Windows ya es compatible de forma efectiva, con dos capacidades adicionales: el MCP local, que controla las aplicaciones de escritorio mediante sus servidores MCP instalados en el PC, y las tareas programadas, que ejecutan trabajos recurrentes en la propia máquina.
| Requisito de acceso | Detalle publicado |
|---|---|
| Tarjeta gráfica | GeForce RTX o RTX PRO con al menos 24 GB de VRAM |
| Suscripciones incluidas | Pro y Max, tanto individuales como empresariales |
| Trabajo local | No consume ningún crédito de Computer |
El modelo, el orquestador y el planificador se ejecutan en el PC; una escalada a Perplexity Search o a uno de los más de 15 modelos de frontera requiere la autorización del usuario. La publicación de NVIDIA añade conectores (Outlook, OneDrive, Word, Google Drive, Gmail, Slack, GitHub), un navegador integrado y compatibilidad con DGX Station anunciada sin fecha. Las dos fuentes discrepan sobre el modelo local: la página de producto de Perplexity solo ofrece PPLX 27B en los PC RTX y reserva Qwen 3.8 27B para DGX Spark, mientras que NVIDIA menciona Qwen 3.8 27B como ejemplo.
🔗 Publicación de Perplexity sobre Portable Computer para Windows 🔗 Publicación de NVIDIA sobre los PC RTX
Qwen Code 0.23.4 y Kimi Code 0.43.0 revisan los objetivos y las herramientas de sus agentes
14 de septiembre — Dos agentes de código para la línea de comandos publican una versión el mismo día, y ambos modifican tanto los objetivos (goals) como sus herramientas MCP y hooks. Qwen Code es el agente del equipo Qwen y Kimi Code, el de Moonshot AI.
| Aspecto comparado | Qwen Code 0.23.4 | Kimi Code 0.43.0 |
|---|---|---|
| Publicación | 15:20 UTC, cuatro días después de la 0.23.3 | 12:03 UTC, cinco días después de la 0.42.0 |
| Objetivos (goals) | Límites opcionales en turnos (model.goalMaxTurns) y en minutos activos (model.goalMaxActiveMinutes) | Se elimina el límite de 24 horas y se excluye de los presupuestos el tiempo con la sesión cerrada |
| MCP y hooks | permission_mode, agent_id y prompt_id se transmiten a cada hook, se reconocen nombres de herramientas de Claude Code | Campo deferred por servidor MCP para cargar las herramientas bajo demanda mediante select_tools |
| Agentes y sesiones | Panel de agentes compartido (agent board), ejecutor Codex para los subagentes | Eliminación de una sesión desde el selector |
| Puntos de atención | Dos cambios incompatibles, incluido el tiempo de espera de los hooks de comandos, que ahora se interpreta en segundos | No se solicita confirmación para un rm -rf dirigido únicamente a /tmp o /temp |
Qwen Code 0.23.4 incluye 31 funciones y 80 correcciones, varias de ellas relacionadas con la privacidad: el envío del texto de las solicitudes y respuestas depende ahora del ajuste logPrompts. En Kimi Code, la carga diferida de herramientas sigue detrás de la flag experimental tool-select, y una corrección hace que se registre select_tools, hasta ahora ausente de los perfiles de agentes.
🔗 Notas de la versión de Qwen Code 0.23.4 🔗 Notas de la versión de Kimi Code 0.43.0
La aplicación de escritorio ChatGPT para Linux, donde se ejecuta Codex, admite oficialmente Arch Linux
14 de septiembre — OpenAI Developers anuncia la compatibilidad oficial de Arch Linux con la aplicación de escritorio ChatGPT para Linux, donde se encuentran sus proyectos, sus archivos locales y Codex. Se instala mediante un script proporcionado por OpenAI para Arch y después se actualiza con pacman, el gestor de paquetes de la distribución, sin tener que volver a empaquetar ningún paquete. La aplicación, todavía en versión preliminar, llegó el 11 de agosto a Ubuntu, Debian y Fedora. La documentación también precisa que este script configura el repositorio de paquetes firmado de OpenAI y recuerda dos limitaciones de la versión preliminar para Linux: Computer Use todavía no está disponible y la compatibilidad nativa con Wayland sigue siendo experimental.
🔗 Anuncio de OpenAI Developers en X 🔗 Documentación de la aplicación para Linux
Devin Plugins, una gobernanza de agentes diseñada con BlackRock
9 de septiembre — Publicada el 9 de septiembre en el blog de Devin, sin anuncio en X, una entrada de Cognition presenta Devin Plugins, diseñado con BlackRock. Un plugin es un paquete versionado que reúne skills, reglas, servidores MCP, hooks y subagentes, aplicado tanto a los agentes locales (Devin CLI, Devin Desktop) como a las sesiones en la nube. Sigue el estándar abierto Agent Plugins, ya tratado aquí en agosto.
Los plugins se instalan con alcance Personal, Organization o Enterprise, y cada ámbito los declara obligatorios, recomendados o prohibidos, prevaleciendo la autoridad más alta. Cognition menciona hooks que bloquean el acceso de los agentes a la infraestructura y los datos de producción, salvo para el equipo SRE. Respaldados por repositorios Git, los plugins se versionan y revisan como código. Un marketplace unificado amplió el lanzamiento desde el 11 de septiembre; la entrada no indica precios ni planes.
🔗 Entrada de Devin sobre la gobernanza de agentes con BlackRock 🔗 Documentación de Devin Plugins
Claude for Financial Advisors, once conectores y ocho skills para asesores
14 de septiembre — Anthropic lanza Claude for Financial Advisors, un conjunto de conectores y skills para asesores de gestión patrimonial. Llegan once conectores nuevos (Addepar, BlackRock, Charles Schwab, Envestnet, iCapital, Orion, SS&C Black Diamond, Wealthbox, Wealth.com, Vanguard y Zocks), y un plugin instalable desde Cowork reúne ocho skills:
| Momento del trabajo | Skills del plugin |
|---|---|
| Antes de la reunión | Pre-meeting prep, Prospect intake |
| Después de la reunión | Post-meeting notes and follow-up |
| Análisis patrimonial | Portfolio rebalance review, Estate and tax brief, Alternative investments brief |
| Implementación y cumplimiento | Advisor onboarding, Compliance and AI policy |
Las tareas críticas requieren la aprobación del asesor, y tanto las recomendaciones de inversión como las comunicaciones con clientes siguen sujetas a revisión humana. Anthropic recomienda el plan Enterprise a los asesores registrados (registered investment advisers) por sus registros de auditoría, concede un crédito de uso a las firmas que soliciten una nueva licencia antes de finales de septiembre y organiza un seminario web el 18 de septiembre.
🔗 Claude for Financial Advisors
El código agéntico somete a presión la CI de Anthropic
14 de septiembre — En el blog de Claude, Sachin Malhotra cuenta cómo el código agéntico ha sometido a presión la CI de Anthropic.
| Indicador publicado por Anthropic | Valor anunciado |
|---|---|
| Código entregado por ingeniero y trimestre | 8 veces la media de 2021-2025 |
| Proporción del código escrita por Claude | 80 % |
| Volumen de jobs de CI | Multiplicado por 25 en seis meses |
| Vida útil de las tres correcciones | 70 días, 29 días, menos de un día |
| Rediseño final | 3 semanas, un solo ingeniero |
El cuello de botella se formó en el servicio de selección de pruebas (test impact analysis), que elige las pruebas que se ejecutarán en cada PR. Diseñado como un proceso único, agotó tres correcciones antes de un rediseño realizado siguiendo el consejo de Claude: el estado se traslada a un almacén en memoria y los procesos, ahora sin estado, se distribuyen horizontalmente. El autor aconseja prever una carga 25 veces superior de aquí a dos trimestres.
🔗 El código agéntico está sometiendo a presión la CI
CobbleDB sustituye a DynamoDB en la búsqueda de Perplexity
14 de septiembre — Perplexity detalla CobbleDB, el almacén distribuido de clave-valor que ahora proporciona a su buscador los pasajes previamente segmentados y los embeddings de cada página, en sustitución de DynamoDB. Construido sobre RocksDB, con tres réplicas por partición, una caché en memoria y almacenamiento NVMe, renuncia deliberadamente a las transacciones. Latencias medidas en producción para una lectura agrupada:
| Percentil de latencia | Antes, con DynamoDB | Después, con CobbleDB |
|---|---|---|
| Mediana (p50) | 31,4 ms | 5,60 ms |
| Percentil 90 (p90) | 56,7 ms | 9,77 ms |
| Percentil 99 (p99) | 123 ms | 24,2 ms |
Perplexity precisa que se trata de una comparación antes/después con tráfico real, en momentos distintos, y que el ahorro de al menos un 20 % respecto a DynamoDB es una estimación interna. Según la empresa, las aproximadamente 40 000 líneas de Rust del núcleo de la base de datos fueron escritas en dos meses por dos ingenieros y cientos de agentes. Se anuncia una publicación en open source, sin fecha.
🔗 Entrada de Perplexity sobre CobbleDB
TRL v1.14: GRPO asíncrono con LoRA, distribuido en HF Jobs
10 de septiembre — En una entrada oficial del 10 de septiembre, Hugging Face detalla una novedad de TRL v1.14: AsyncGRPOTrainer, que separa el entrenamiento de la generación, puede entrenar un adaptador LoRA y sincronizar únicamente este con vLLM, es decir, unos pocos megabytes en lugar de unos 3 GB para un modelo de 1.500 millones de parámetros. El entrenador y las réplicas de vLLM se ejecutan en Jobs separados, conectados mediante un Storage Bucket.
| Indicador medido | Primera ejecución | Quinta ejecución |
|---|---|---|
| Duración de 500 pasos | 3 h 27 min | 53 min |
| Duración mediana de un paso | 22,9 s | 4,8 s |
| MFU forward + backward | 3,9 % | 23,5 % |
| Recompensa en los últimos 20 pasos | 0,438 | 0,416 |
Tres ajustes explican la mejora: empaquetar las secuencias por microlote, desactivar el recálculo de activaciones (gradient checkpointing) y aumentar de 128 a 384 el número de solicitudes en curso, con una recompensa comparable. El conjunto inicial cuesta unos 20 dólares por hora y se han publicado los scripts de reproducción.
🔗 GRPO asíncrono con LoRA en HF Jobs
Transformer Engine multiplica por 10,4 el rendimiento del MoE dropless en JAX
14 de septiembre — NVIDIA muestra cómo Transformer Engine acelera en JAX el entrenamiento de mezclas de expertos sin descarte de tokens (dropless MoE), donde cada experto recibe un número variable de tokens. En DeepSeek-V3, el texto sitúa la mejora de 10,4 veces en GB200 y el pie de su figura, en GB300 NVL72.
| Métrica publicada por NVIDIA | Valor anunciado |
|---|---|
| Rendimiento inicial | 103 TFLOPS por GPU |
| Proporción de la comunicación en el tiempo de kernel | 84 % al principio |
| Rendimiento con Transformer Engine | 1 068 TFLOPS por GPU, es decir, 10,4 veces más |
| Eficiencia de escalado con 1 024 GPU | 97 % |
La mejora procede, entre otras cosas, de un grouped GEMM en MXFP8, que procesa todos los expertos en una sola llamada de kernel, y de operaciones de dispatch y combine fusionadas mediante NCCL EP. Las optimizaciones se incluyen en el contenedor NGC MaxText y se anuncia NVFP4 como siguiente paso.
🔗 Entrada técnica de NVIDIA sobre el MoE dropless en JAX
PC-ALM, el aprendizaje local de Sakana AI que entrena 1 000 capas sin retropropagación
14 de septiembre — Sakana AI publica PC-ALM (Augmented Lagrangian Predictive Coding), un método que sustituye la retropropagación (backpropagation) por dinámicas locales, de modo que cada capa solo se comunica con sus vecinas. Amplía la codificación predictiva (predictive coding) dotando a cada capa de variables duales, multiplicadores de Lagrange, que la convierten en un controlador de retroalimentación proporcional-integral; en una red lineal, estas variables recuperan exactamente las señales de crédito de la retropropagación.
En MNIST, los MLP residuales de anchura 32 se mantienen aproximadamente a 2 puntos porcentuales de la retropropagación hasta las 1 000 capas. En CIFAR-10 y Tiny ImageNet, PC-ALM obtiene mejores resultados que la codificación predictiva estándar, aunque las puntuaciones solo se muestran en gráficos. Sakana AI lo presenta como el primer método local, hasta donde sabe, capaz de entrenar redes tan profundas en tareas que siguen siendo sencillas. El artículo y el código están publicados.
🔗 Codificación predictiva lagrangiana aumentada
Scribe v2 Medical, la transcripción médica de ElevenLabs, disponible de forma general
11 de septiembre — Anunciada el 11 de septiembre únicamente en el changelog de su documentación, sin tuit ni entrada, la disponibilidad general de Scribe v2 Medical completa la oferta de transcripción de ElevenLabs. Esta versión afinada de Scribe v2 reconoce mejor los nombres de medicamentos, la anatomía, la patología y el dictado clínico, al tiempo que conserva la precisión de Scribe v2 para el habla cotidiana. El modelo procesa audio por lotes, al mismo precio que Scribe v2, con scribe_v2_medical como identificador del modelo y las mismas opciones, desde la detección de entidades hasta la diarización. ElevenLabs lo destina a la documentación clínica, las llamadas de admisión y los flujos de cumplimiento relacionados con datos sanitarios protegidos. Su ficha técnica anuncia un 15 % menos de errores que Scribe v2 en términos médicos aislados y compatibilidad con más de 90 idiomas.
🔗 Changelog de ElevenLabs del 11 de septiembre
Google Flow llega al iPhone
10 de septiembre — La cuenta @FlowbyGoogle anunció el 10 de septiembre la aplicación para iOS de Google Flow, el estudio de creación con IA de Google. Según su ficha de la App Store, es gratuita con compras integradas, exclusiva para iPhone y requiere iOS 16 o una versión posterior. Permite crear y retocar imágenes y vídeos con los modelos generativos de Google, utilizando como punto de partida el carrete o la cámara. La biblioteca permanece sincronizada con la versión de escritorio y pueden ejecutarse varias generaciones en segundo plano, con una notificación cuando el resultado está listo. La ficha no menciona ningún modelo.
🔗 Anuncio de @FlowbyGoogle en X 🔗 Google Flow en la App Store
Breves
- Claude Tag en el sector sanitario, al margen de los datos protegidos — Como Claude Tag aún no está cubierto por el acuerdo BAA de Anthropic, Insight Health, Tennr y Medallion lo restringen a canales sin datos sanitarios; en Insight Health, el 97 % de las alertas críticas se cierran sin intervención de un ingeniero. Los créditos de Claude Tag ofrecidos a las organizaciones que lo conecten con GitHub vencen el 1 de octubre. 🔗 fuente
- Anthropic y Accenture publican una guía para pasar del piloto a producción — dirigida a los CIO, parte de dos cifras de Accenture: solo el 23 % de los directivos observa un impacto duradero de la IA a escala empresarial y el 42 % de las organizaciones carece de un único responsable de sus costes y resultados. 🔗 fuente
- Claude Fable 5.1 resuelve el Cyphral Distich, un criptograma de 1653 — demostración de terceros descrita en una entrada de Vals AI fechada el 31 de agosto y difundida el 13 de septiembre por la noche, hora del Pacífico, por Boris Cherny: 44 minutos y 176 000 tokens, sin intervención humana. El autor reconoce que la pista era sencilla. 🔗 fuente
- Fyxer consigue que el 53 % de sus borradores de correo electrónico se acepten tal cual — en este caso de estudio de OpenAI, el asistente ejecutivo distribuye el trabajo entre 30 y 50 modelos especializados, afinados con las correcciones de los usuarios, y vio aumentar sus ingresos recurrentes anuales de 1 a 32 millones de dólares en 2025. No se menciona ningún modelo. 🔗 fuente
- Devin asume las guardias de PagerDuty — según las notas de la versión del 11 de septiembre, Devin puede clasificar los incidentes de PagerDuty y publicar su investigación en las notas del incidente, 21 servidores MCP se conectan mediante OAuth con un clic y la API Sessions v1 acepta una
idempotency_key. 🔗 fuente - DevFest 2026, del 1 de octubre al 31 de diciembre — los Google Developer Groups prevén más de 800 eventos en 115 países, con talleres y maratones de creación de agentes (agent-athons) en torno a Gemini, AI Studio, Antigravity y Web MCP. 🔗 fuente
- Suno presenta Studio Chat — este asistente de Suno Studio conoce cada pista y cada fragmento MIDI del proyecto, y puede ordenar, renombrar, colorear o escribir una parte nueva directamente en la línea de tiempo. No se anuncian ni su disponibilidad ni su precio. 🔗 fuente
- El ecosistema open source de MiniMax H3 se amplía — MiniMax destaca tres proyectos comunitarios: VDN, que replantea la atención para acelerar la inferencia; los Acc-LoRAs PDD de Alibaba PAI en ocho pasos; y los Turbo LoRAs de LightX2V en cuatro y ocho pasos. 🔗 fuente
- Runway detalla la creación de A Game of HORSE — un tutorial en vídeo, los prompts del cortometraje y la skill descargable runway-sd-enhancer, que transforma un prompt sin procesar en un prompt de producción para una escena de 15 segundos. 🔗 fuente
- Ai2 pone AutoDiscovery a prueba con estudiantes de la Universidad de Washington — diez equipos probaron el agente: pistas útiles sobre baterías o proteínas, pero aproximadamente la mitad de las hipótesis fueron ilógicas en 24 000 configuraciones simuladas de reactores. Los créditos de prueba se amplían hasta el 31 de diciembre. 🔗 fuente
- Archsloth acerca sus GGUF de Qwen al original — contribución comunitaria del equipo FINAL-Bench en el blog de Hugging Face: con el mismo tamaño que el archivo de unsloth, su
Q4_K_Mde Qwen3-4B reduce la divergencia KL un 54,4 % en coreano y un 33,2 % en inglés, gracias a la corrección de dos opciones de AutoRound. 🔗 fuente - Eric Mey mide la compatibilidad con OpenAI de un agente LangGraph — contribución individual en el mismo blog comunitario: los 37 campos de solicitud de Chat Completions están clasificados y ninguno falla silenciosamente, frente a 11 al principio, pero un defecto de streaming eludió la validación de los esquemas. 🔗 fuente
- EcoHash cuantifica lo que sirve una RTX PRO 6000 de 96 GB — entrada de un proveedor de inferencia, medida en su propio servicio y con los CSV sin procesar publicados: qwen3.6-35b-a3b entrega su primer token en 170 ms (p95) y unos 213 tokens por segundo, y el rendimiento alcanza aproximadamente 11 500 tokens por segundo con solicitudes simultáneas en Llama-3.1-8B. 🔗 fuente
Lo que esto significa
El primer hilo es el de los agentes que programamos y supervisamos. Claude Mods permite que cada uno escriba sus propios hooks en TypeScript, pero canaliza sus efectos secundarios a través de un objeto $ que los administradores pueden auditar y restringir. Devin Plugins aplica la misma lógica a escala empresarial, con plugins obligatorios o prohibidos según el ámbito; GitHub permite elegir el equilibrio entre coste y calidad del enrutamiento de Auto; tanto Qwen Code como Kimi Code ajustan la duración de sus objetivos; y Kimi Code puede cargar sus herramientas MCP bajo demanda. MCP también sirve como canal de distribución: una sola instalación incorpora la voz, la música y más de 50 modelos de imagen y vídeo de ElevenLabs en cinco asistentes, sin abandonar la conversación.
El segundo hilo se refiere a la infraestructura que este código agéntico somete a presión, o que construye. En Anthropic, donde Claude escribe el 80 % del código, los jobs de CI se multiplicaron por 25 en seis meses, y un solo ingeniero tardó tres semanas en rediseñar el servicio de selección de pruebas. En Perplexity, dos ingenieros y cientos de agentes escribieron las 40 000 líneas de Rust de CobbleDB, cuya latencia de lectura es aproximadamente cinco veces menor según sus mediciones. El entrenamiento sigue la misma tendencia: TRL reduce un run GRPO de 3 h 27 min a 53 min, y Transformer Engine multiplica por 10,4 el rendimiento de un MoE dropless; dos artículos que localizan el cuello de botella antes de eliminarlo.
El tercer hilo es político: quién fija el ritmo y las reglas. Tres días después del artículo de opinión de OpenAI que reclamaba una ley federal basada en las capacidades de los modelos, Dario Amodei propone acompasar los avances de los modelos de frontera empezando por abrir Anthropic a evaluadores integrados, y Aidan Gomez cuestiona el método. Ambos textos coinciden en el examen independiente de los sistemas más capaces y divergen sobre los pasos posteriores: por un lado, una regulación dirigida a todas las empresas de frontera estadounidenses, acompañada de estándares debatidos bajo una exención antimonopolio limitada; por otro, un marco de riesgos elaborado por varios países y auditorías que nunca paguen los auditados. La discusión gira menos en torno al principio de un control que a quiénes escriben sus reglas.
El último hilo se refiere a los datos sensibles, a los que la IA se acerca con salvaguardas incorporadas en el producto. Portable Computer mantiene los archivos y las consultas en el PC y solicita autorización antes de cualquier transferencia a la nube; Scribe v2 Medical está orientado al dictado clínico y a los flujos de cumplimiento normativo relacionados con datos sanitarios protegidos; Claude Tag, al no estar cubierto por el acuerdo BAA, queda limitado a los canales que no los contienen; y Claude for Financial Advisors reserva al asesor la aprobación de las tareas críticas. Cuanto más se acerca el agente al expediente de un paciente o a la cartera de un cliente, más explícito se vuelve el límite de lo que puede hacer por sí solo.
Fuentes
- Boris Cherny en X, Claude Mods
- Claude Code, incidencia Function Hooks #91870
- Dario Amodei, We Must Pace the Frontier
- Dario Amodei en X, anuncio del ensayo
- Cohere, Who Gets to Define the Rules for AI?
- ElevenLabs en X, anuncio del MCP creativo
- ElevenLabs en X, clientes compatibles
- GitHub Changelog, niveles de selección automática de modelos
- GitHub Docs, About Copilot auto model selection
- Perplexity, Portable Computer para Windows
- Perplexity, página de producto de Portable Computer
- NVIDIA, Portable Computer en los PC RTX
- Qwen Code, notas de la versión 0.23.4
- Kimi Code, notas de la versión 0.43.0
- OpenAI Developers en X, Arch Linux
- ChatGPT, aplicación para Linux
- Devin, gobernanza de agentes con BlackRock
- Devin, documentación de los plugins
- Claude, Claude for Financial Advisors
- Claude, Agentic coding is straining CI
- Perplexity, CobbleDB
- Hugging Face, Async GRPO with LoRA across HF Jobs
- NVIDIA, MoE dropless en JAX con Transformer Engine
- Sakana AI, PC-ALM
- ElevenLabs, registro de cambios del 11 de septiembre
- Google Flow en X
- Google Flow en la App Store
- Claude, Claude Tag en el ámbito sanitario
- Claude, guía del proyecto piloto a la producción con Accenture
- Boris Cherny en X, Cyphral Distich
- Vals AI, Claude Fable 5.1 Solves the Cyphral Distich
- OpenAI, estudio de caso de Fyxer
- Devin, notas de la versión
- Google, DevFest 2026
- Suno en X, Studio Chat
- MiniMax en X, ecosistema H3
- Runway en X, A Game of HORSE
- Ai2, AutoDiscovery y los estudiantes de la Universidad de Washington
- Hugging Face, Archsloth y AutoRound
- Hugging Face, compatibilidad con OpenAI de un agente LangGraph
- Hugging Face, EcoHash y la RTX PRO 6000