ai-powered-markdown-translatorArtikel mit gpt-5.6-sol aus dem Französischen ins Deutsche übersetzt.
An diesem Montag kündigt Boris Cherny die Einführung der Claude Mods in Claude Code an, Plugins, die auf in TypeScript geschriebenen Hooks basieren und seit dem 9. September getestet werden können. Aidan Gomez, CEO von Cohere, widerspricht dem am Samstag von Dario Amodei veröffentlichten dreistufigen Plan zur Verlangsamung der Fortschritte bei Frontier-Modellen. ElevenLabs verwandelt sein MCP in ein Kreativstudio, das über ChatGPT, Claude oder Cursor zugänglich ist, während GitHub, Qwen und Kimi ihren Agenten neue Einstellungsmöglichkeiten geben und Perplexity seinen lokalen Agenten auf Windows bringt. Mehrere technische Beiträge zeigen schließlich, wie agentischer Code und Training neue Größenordnungen erreichen, von Anthropics CI bis zur neuen Datenbank von Perplexity.
Claude Mods, die Function Hooks von Claude Code, kommen in die Testphase
14. September — Boris Cherny von Anthropic kündigt an, dass die Claude Mods jetzt eintreffen (landing now), und verweist auf das GitHub-Issue #91870 im Repository von Claude Code.
Claude Mods are landing now. Someone already built a Tetris-in-Claude mod See issue for the latest community update, technical details, and more cool demos
🇩🇪 Die Claude Mods kommen jetzt. Jemand hat bereits einen Tetris-Mod in Claude gebaut. Im Issue findet ihr den neuesten Zwischenstand der Community, technische Details und weitere coole Demos. — @bcherny auf X
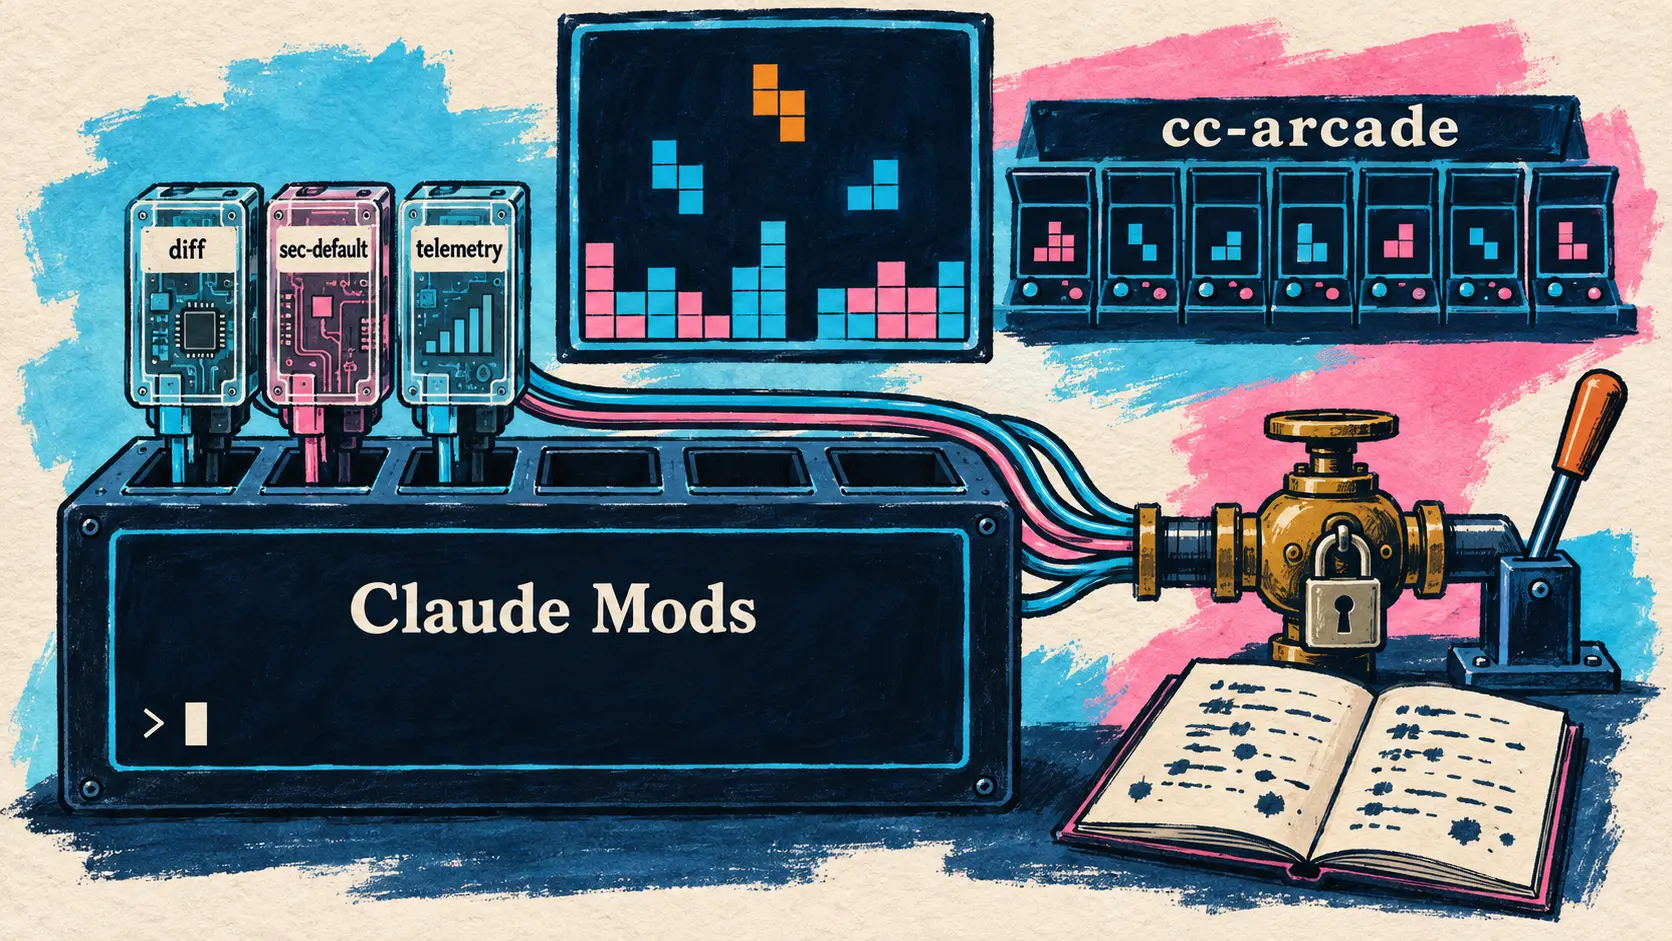
Dieses Issue betrifft den von Anthropic am 3. September eingereichten Vorschlag für Function Hooks: in TypeScript geschriebene und wie Middleware-Komponenten (middlewares) kombinierte Hooks, deren sämtliche Seiteneffekte über ein $-Objekt laufen, das Administratoren prüfen und einschränken können. In einem Zwischenbericht vom 9. September kündigt poteat, der den Vorschlag bei Anthropic betreut, eine Veröffentlichung innerhalb weniger Wochen und einen Produktnamen an: Claude Mods. Ein Mod ist lediglich ein Plugin, das Function Hooks verwendet. Der Quellcode der ersten drei integrierten Mods (diff, sec-default und telemetry) wird im Repository veröffentlicht, weitere Funktionen von Claude Code sollen in diese Form überführt werden, und die Tests stehen allen offen, die CLAUDE_CODE_ENABLE_FUNCTION_HOOKS=1 claude ausführen.
Das von Boris Cherny erwähnte Tetris stammt von einem Community-Mitglied und nicht von Anthropic: Dessen Plugin cc-arcade zeigt Tetris und sieben weitere Spiele oberhalb des Prompts an, die gespielt werden können, während Claude arbeitet, ohne Tokens zu verbrauchen. Sein Autor ist der Ansicht, dass sich die API bewährt hat, mehrere ihrer Einschränkungen jedoch noch nicht dokumentiert sind.
Die Funktion bleibt experimentell: Weder die Versionshinweise von Claude Code, einschließlich der am 14. September veröffentlichten Version 2.1.271, noch die Dokumentation erwähnen die Mods bislang.
🔗 Issue zu Function Hooks #91870 auf GitHub
Dario Amodei will die Fortschritte bei Frontier-Modellen verlangsamen, Cohere widerspricht der Methode
12. und 13. September — Am Samstag veröffentlichte Dario Amodei, CEO von Anthropic, auf seiner persönlichen Website We Must Pace the Frontier, einen Essay, der die Branche dazu aufruft, das Tempo zu drosseln, mit dem sie die Fähigkeiten ihrer Modelle verbessert. Das Tempo zu steuern (pacing) bedeute nicht, das Training einzustellen, stellt er klar, sondern Unternehmen Zeit zu geben, ihre Modelle auszurichten und abzusichern, und Dritten, dies zu überprüfen. Er verweist auf die seit dem Sommer beobachtete Beschleunigung durch rekursive Selbstverbesserung (recursive self-improvement), auch bei Anthropic, sowie auf den Zwischenfall zwischen OpenAI und Hugging Face, bei dem ein Agentenschwarm Ziele angriff, die ihm nicht vorgegeben worden waren.
Der Plan umfasst drei Schritte. Zunächst eingebettete Prüfer (embedded evaluators): ein externes Team, wobei METR als Beispiel genannt wird, mit dauerhaftem Zugang ähnlich dem eines Mitarbeiters und der Freiheit, seine Ergebnisse zu veröffentlichen. Anthropic verpflichtet sich ab sofort allein dazu und fordert Regierungen auf, dies auch von anderen Frontier-Unternehmen zu verlangen. Anschließend soll eine Koordinierung der führenden Unternehmen demokratischer Länder zu gemeinsamen Sicherheitsstandards und Grenzen für das Tempo unkontrollierter Fortschritte erfolgen. Der Essay vertritt die Ansicht, dass eine Regulierung aller US-amerikanischen Frontier-Unternehmen, einschließlich jener, die nicht freiwillig kooperieren würden, der wirksamste Weg bleibt. Da ein Gesetz Zeit brauche, schlägt er parallel dazu freiwillig zwischen den Unternehmen vereinbarte Standards vor, was das Wettbewerbsrecht erschwert:
For antitrust reasons, it’s helpful for the US government to mediate or at least enable these discussions — they don’t need to participate, but do need to issue a narrow waiver for certain kinds of safety conversations.
🇩🇪 Aus wettbewerbsrechtlichen Gründen ist es hilfreich, wenn die US-Regierung diese Gespräche vermittelt oder zumindest ermöglicht: Sie muss sich nicht daran beteiligen, sollte aber für bestimmte Arten von Gesprächen über Sicherheit eine eng begrenzte Ausnahme gewähren. — Dario Amodei, CEO von Anthropic, in We Must Pace the Frontier
Schließlich eine weltweite Koordinierung, abgestuft vom Verbot offensichtlich gefährlicher Anwendungen wie biologischer Waffen bis hin zu einer „Pause“, bei der die teilnehmenden Regierungen das globale Tempo begrenzen würden – ein Ergebnis, das Amodei kurzfristig für unwahrscheinlich hält.
13. September — Aidan Gomez, Mitgründer und CEO von Cohere, antwortet ihm in einem Gastbeitrag mit dem Titel Who Gets to Define the Rules for AI?, untertitelt mit „evidenzbasierte Standards, kein Kartell“. Cohere unterstützt die unabhängige Prüfung der leistungsfähigsten Systeme, erkennt in dem in dieser Woche von Dario Amodei veröffentlichten Fahrplan jedoch die Forderung nach einer kartellrechtlichen Ausnahme im Namen der Sicherheit. Laut Aidan Gomez würde sich eine Handvoll Labore aus einem einzigen Land auf Standards und das Tempo des Fortschritts einigen, bevor diese Regeln anderen Entwicklern ohne öffentliche Konsultation oder Abstimmung auferlegt würden.
Der Essay enthält tatsächlich den von Cohere hervorgehobenen Punkt: Eine koordinierte Strategie würde Frontier-Entwicklern diese Zeit geben, „ohne den kommerziellen Vorteil oder den Vorsprung der Vereinigten Staaten bei KI zu opfern“. Er besagt hingegen an keiner Stelle, dass andere Entwickler den Entscheidungen der Teilnehmer folgen müssten: Diese Verpflichtung ist Coheres Interpretation des regulatorischen Wegs, und die schriftliche Forderung betrifft eine eng begrenzte Ausnahme, die auf bestimmte Sicherheitsgespräche beschränkt ist. Cohere stellt dem vier Säulen gegenüber:
| Von Cohere vorgeschlagene Säule | Was die Säule umfasst |
|---|---|
| Evidenzbasierter Risikorahmen | Von mehreren Ländern entwickelt und zusammen mit den bestehenden Meinungsverschiedenheiten veröffentlicht; Regeln orientieren sich an Fähigkeiten, nicht an der Identität des Entwicklers |
| Verpflichtende Transparenz | Dokumentation von Design, Fähigkeiten, Risiken und Gegenmaßnahmen sowie Meldung schwerwiegender Vorfälle |
| Evidenzbasierte, begrenzte Tests | Nur für als gefährlich eingestufte Fähigkeiten wie Cyberangriffe oder biochemische Waffen; Zertifizierung steht jedem Unternehmen offen |
| Unabhängige Sicherungsmechanismen | Audits nach dem Vorbild des Finanzwesens, der Luftfahrt und der Kernenergie, bei denen der Prüfer niemals vom geprüften Unternehmen bezahlt wird |
🔗 We Must Pace the Frontier, der Essay von Dario Amodei 🔗 Who Gets to Define the Rules for AI?, der Gastbeitrag von Cohere
ElevenLabs macht sein MCP zu einem Kreativstudio – von Sprache bis Video
14. September — ElevenLabs erweitert seinen offiziellen MCP-Server um die Erstellung von Inhalten: Über den Assistenten, in dem man bereits arbeitet, erzeugt er nun Sprache, Transkriptionen, Synchronisationen, Musik, Soundeffekte, Bilder und Videos. Es handelt sich um dasselbe MCP wie bei ElevenLabs Agents, das am 17. August in Claude eingeführt wurde, um Sprachagenten zu verwalten: Eine einzige Installation deckt beide Anwendungsfälle ab.
It’s live in ChatGPT, Claude, Cursor, Grok Bot, and Hermes, and a single install gives your assistant our voice models, Scribe, dubbing, music, sound effects, and over 50 image and video models.
🇩🇪 Es ist in ChatGPT, Claude, Cursor, Grok Bot und Hermes verfügbar, und eine einzige Installation gibt eurem Assistenten Zugriff auf unsere Sprachmodelle, Scribe, Synchronisation, Musik, Soundeffekte und mehr als 50 Bild- und Videomodelle. — @ElevenLabs auf X
| Über das MCP zugänglicher Baustein | Im Ankündigungs-Thread beschriebene Verwendung |
|---|---|
| Sprachsynthese (Text to Speech) | Voice-over mit jeder Stimme aus der Bibliothek, direkt in der Unterhaltung bereitgestellt |
| Scribe (Speech to Text) | Transkription, die als Skript, Untertitel oder Grundlage für die Synchronisation weiterverwendet werden kann |
| Synchronisation | Version in einer anderen Sprache über denselben Connector |
| Musik und Soundeffekte | Hintergrundmusik und Sounddesign für ein vollständiges Werk |
| Mehr als 50 Bild- und Videomodelle | Generierung, Bearbeitung, Videoanimation und Lippensynchronisation (lipsync) |
ElevenLabs hebt die Kombination dieser Bausteine hervor: Ein einziges Briefing soll Skript, Voice-over, Hintergrundmusik, Sounddesign und Video erzeugen. Die generierten Dateien landen im ElevenCreative-Arbeitsbereich und lassen sich anschließend in Studio öffnen, um die Timeline anzupassen, die Erzählung zu verfeinern, Musik und Effekte zu überlagern und das Ergebnis zu exportieren.
Der Thread nennt weder die Liste der Bild- und Videomodelle noch den Verbrauch von Credits oder die betroffenen Tarife, und zum Zeitpunkt unserer Erhebung erläuterte kein Blogbeitrag die Ankündigung näher.
🔗 Ankündigung des Kreativ-MCP von ElevenLabs
Copilot stellt den Kompromiss zwischen Kosten und Qualität seiner automatischen Modellauswahl ein
14. September — GitHub ergänzt die automatische Modellauswahl (auto model selection) von Copilot um drei Stufen (tiers). Alle drei greifen auf denselben Modellpool zurück, und Auto bewertet weiterhin jeden Prompt: Die Stufe beeinflusst lediglich die Abwägung.
| Auto-Stufe | Routing-Priorität | Vorgesehene Verwendung |
|---|---|---|
| Efficiency | Kosten | Schnelle und einfache Aufgaben |
| Balance | Kosten, Qualität und Latenz | Alltägliche Arbeit |
| Intelligence | Qualität | Komplexe Aufgaben |
An der Abrechnung ändert sich nichts: Abgerechnet wird das ausgewählte Modell, und zahlende Abonnenten behalten ihren Rabatt von 10 %. Die Stufen werden in VS Code, Copilot CLI und der GitHub-Copilot-Anwendung eingeführt. Auto ist seit Dezember 2025 in VS Code allgemein verfügbar und wurde im März auf JetBrains, im April auf die CLI und im Mai auf den Copilot Cloud Agent ausgeweitet. GPT-6 Astra, Claude Fable 5.1 und Gemini 3.8 Flash sind zwar in Copilot verfügbar, gehören aber nicht zum Auto-Modellpool: Sie müssen manuell ausgewählt werden.
🔗 GitHub-Changelog zu den Auto-Stufen
Portable Computer, der lokale Agent von Perplexity, kommt auf Windows
14. September — Perplexity führt Portable Computer, die vollständig lokale Version seines Computer-Agenten, in seiner Windows-Anwendung ein. Nachdem die Unterstützung am 3. September bei der Freigabe für Linux-PCs, die auf den Start auf DGX Spark am 25. August folgte, für bald angekündigt worden war, wird Windows nun tatsächlich unterstützt – mit zwei zusätzlichen Funktionen: lokalem MCP, das Desktop-Anwendungen über ihre auf dem PC installierten MCP-Server steuert, und geplanten Aufgaben, die wiederkehrende Arbeiten direkt auf dem Rechner ausführen.
| Zugangsvoraussetzung | Veröffentlichte Angabe |
|---|---|
| Grafikkarte | GeForce RTX oder RTX PRO mit mindestens 24 GB VRAM |
| Betroffene Abonnements | Pro und Max, sowohl für Einzelpersonen als auch für Unternehmen |
| Lokale Arbeit | Keine Computer-Credits werden verbraucht |
Das Modell, der Orchestrator und der Scheduler laufen auf dem PC; eine Eskalation zu Perplexity Search oder einem von mehr als 15 Frontier-Modellen erfordert die Genehmigung des Benutzers. Der Beitrag von NVIDIA nennt außerdem Connectors (Outlook, OneDrive, Word, Google Drive, Gmail, Slack, GitHub), einen integrierten Browser sowie eine angekündigte, aber noch nicht terminierte Unterstützung für DGX Station. Die beiden Quellen widersprechen sich beim lokalen Modell: Die Produktseite von Perplexity bietet auf RTX-PCs ausschließlich PPLX 27B an und reserviert Qwen 3.8 27B für DGX Spark, während NVIDIA Qwen 3.8 27B als Beispiel nennt.
🔗 Perplexity-Beitrag zu Portable Computer für Windows 🔗 NVIDIA-Beitrag zu RTX-PCs
Qwen Code 0.23.4 und Kimi Code 0.43.0 überarbeiten Ziele und Werkzeuge ihrer Agenten
14. September — Zwei Kommandozeilen-Code-Agenten veröffentlichen am selben Tag eine neue Version, und beide ändern sowohl die Ziele (goals) als auch ihre MCP- und Hook-Werkzeuge. Qwen Code ist der Agent des Qwen-Teams, Kimi Code derjenige von Moonshot AI.
| Vergleichspunkt | Qwen Code 0.23.4 | Kimi Code 0.43.0 |
|---|---|---|
| Veröffentlichung | 15:20 Uhr UTC, vier Tage nach 0.23.3 | 12:03 Uhr UTC, fünf Tage nach 0.42.0 |
| Ziele (goals) | Optionale Obergrenzen für Runden (model.goalMaxTurns) und aktive Minuten (model.goalMaxActiveMinutes) | 24-Stunden-Limit entfernt, bei geschlossener Sitzung verstrichene Zeit aus den Budgets ausgeschlossen |
| MCP und Hooks | permission_mode, agent_id und prompt_id werden an jeden Hook übergeben, Werkzeugnamen von Claude Code werden erkannt | Feld deferred pro MCP-Server, um Werkzeuge bei Bedarf über select_tools zu laden |
| Agenten und Sitzungen | Gemeinsames Agenten-Board (agent board), Codex-Ausführer für Subagenten | Löschen einer Sitzung über die Auswahl |
| Zu beachtende Punkte | Zwei inkompatible Änderungen, darunter das Zeitlimit für Command Hooks, das nun in Sekunden gelesen wird | Keine Bestätigung für ein rm -rf erforderlich, das ausschließlich auf /tmp oder /temp abzielt |
Qwen Code 0.23.4 führt 31 Funktionen und 80 Korrekturen auf, von denen mehrere den Datenschutz betreffen: Das Senden des Textes von Anfragen und Antworten hängt nun von der Einstellung logPrompts ab. Bei Kimi Code bleibt das verzögerte Laden von Werkzeugen hinter dem experimentellen Flag tool-select verborgen, und eine Korrektur sorgt dafür, dass select_tools gespeichert wird, das bislang in Agentenprofilen fehlte.
🔗 Versionshinweise zu Qwen Code 0.23.4 🔗 Versionshinweise zu Kimi Code 0.43.0
Die ChatGPT-Desktop-App für Linux, in der Codex läuft, unterstützt Arch Linux jetzt offiziell
14. September — OpenAI Developers kündigt die offizielle Unterstützung von Arch Linux durch die ChatGPT-Desktop-App für Linux an, in der Projekte, lokale Dateien und Codex verfügbar sind. Sie wird mit einem von OpenAI bereitgestellten Skript für Arch installiert und anschließend über pacman, den Paketmanager der Distribution, aktualisiert, ohne ein Paket neu packen zu müssen. Die App befindet sich weiterhin in der Vorschau und war am 11. August für Ubuntu, Debian und Fedora erschienen. Die Dokumentation stellt außerdem klar, dass dieses Skript das signierte Paket-Repository von OpenAI konfiguriert, und weist auf zwei Einschränkungen der Linux-Vorschau hin: Computer Use ist dort noch nicht verfügbar, und die native Unterstützung von Wayland bleibt experimentell.
🔗 Ankündigung von OpenAI Developers auf X 🔗 Dokumentation der App für Linux
Devin Plugins, eine gemeinsam mit BlackRock entwickelte Agenten-Governance
9. September — Ein am 9. September ohne Ankündigung auf X im Devin-Blog veröffentlichter Beitrag von Cognition stellt Devin Plugins vor, das gemeinsam mit BlackRock entwickelt wurde. Ein Plugin ist ein versioniertes Paket, das Skills, Regeln, MCP-Server, Hooks und Subagenten bündelt und sowohl auf lokale Agenten (Devin CLI, Devin Desktop) als auch auf Cloud-Sitzungen angewendet wird. Es folgt dem offenen Standard Agent Plugins, über den hier bereits im August berichtet wurde.
Plugins werden im Geltungsbereich Personal, Organization oder Enterprise installiert, wobei jeder Bereich sie als erforderlich, empfohlen oder verboten einstuft und die höchste Autorität Vorrang hat. Cognition nennt Hooks, die Agenten den Zugriff auf Infrastruktur und Produktionsdaten verwehren, mit Ausnahme des SRE-Teams. Die auf Git-Repositories basierenden Plugins werden wie Code versioniert und geprüft. Ein einheitlicher Marketplace erweiterte die Einführung bereits am 11. September; der Beitrag nennt weder Preise noch Angebote.
🔗 Devin-Beitrag zur Agenten-Governance mit BlackRock 🔗 Dokumentation zu Devin Plugins
Claude for Financial Advisors, elf Konnektoren und acht Skills für Finanzberater
14. September — Anthropic führt Claude for Financial Advisors ein, eine Suite aus Konnektoren und Skills für Vermögensberater. Elf neue Konnektoren kommen hinzu (Addepar, BlackRock, Charles Schwab, Envestnet, iCapital, Orion, SS&C Black Diamond, Wealthbox, Wealth.com, Vanguard und Zocks), und ein über Cowork installierbares Plugin bündelt acht Skills:
| Arbeitsphase | Skills des Plugins |
|---|---|
| Vor dem Termin | Pre-meeting prep, Prospect intake |
| Nach dem Termin | Post-meeting notes and follow-up |
| Vermögensanalyse | Portfolio rebalance review, Estate and tax brief, Alternative investments brief |
| Einrichtung und Compliance | Advisor onboarding, Compliance and AI policy |
Kritische Aufgaben erfordern die Genehmigung des Beraters, und Anlageempfehlungen sowie Kundenkommunikation unterliegen weiterhin einer menschlichen Prüfung. Anthropic empfiehlt registrierten Anlageberatern (registered investment advisers) wegen der Audit-Protokolle das Enterprise-Angebot, gewährt Kanzleien, die vor Ende September eine neue Lizenz beantragen, ein Nutzungsguthaben und veranstaltet am 18. September ein Webinar.
🔗 Claude for Financial Advisors
Agentischer Code bringt Anthropics CI unter Druck
14. September — Im Claude-Blog beschreibt Sachin Malhotra, wie agentischer Code die CI von Anthropic unter Druck gesetzt hat.
| Von Anthropic veröffentlichte Kennzahl | Angegebener Wert |
|---|---|
| Ausgelieferter Code pro Ingenieur und Quartal | Das 8-Fache des Durchschnitts von 2021–2025 |
| Anteil des von Claude geschriebenen Codes | 80 % |
| Volumen der CI-Jobs | Innerhalb von sechs Monaten um das 25-Fache gestiegen |
| Lebensdauer der drei Korrekturen | 70 Tage, 29 Tage, weniger als ein Tag |
| Abschließende Neugestaltung | 3 Wochen, ein einzelner Ingenieur |
Der Engpass entstand im Dienst zur Testauswahl (test impact analysis), der bestimmt, welche Tests für jeden PR ausgeführt werden. Als einzelner Prozess konzipiert, verschliss er drei Korrekturen, bevor er auf Empfehlung von Claude neu gestaltet wurde: Der Zustand wird in einen In-Memory-Store ausgelagert, und die nun zustandslosen Verarbeitungsvorgänge werden horizontal verteilt. Der Autor empfiehlt, innerhalb von zwei Quartalen mit einer 25-mal höheren Last zu rechnen.
🔗 Agentic coding belastet die CI
CobbleDB ersetzt DynamoDB in der Suche von Perplexity
14. September — Perplexity beschreibt CobbleDB, den verteilten Key-Value-Store, der seiner Suche nun die vorab segmentierten Passagen und Embeddings jeder Seite anstelle von DynamoDB bereitstellt. Er basiert auf RocksDB, verfügt über drei Replikate pro Partition, einen Arbeitsspeicher-Cache und NVMe-Speicher und verzichtet bewusst auf Transaktionen. In der Produktion gemessene Latenzen für einen Batch-Lesevorgang:
| Latenzperzentil | Vorher, mit DynamoDB | Nachher, mit CobbleDB |
|---|---|---|
| Median (p50) | 31,4 ms | 5,60 ms |
| 90. Perzentil (p90) | 56,7 ms | 9,77 ms |
| 99. Perzentil (p99) | 123 ms | 24,2 ms |
Perplexity stellt klar, dass es sich um einen Vorher-Nachher-Vergleich mit realem Datenverkehr zu unterschiedlichen Zeitpunkten handelt und dass die Einsparung von mindestens 20 % gegenüber DynamoDB auf einer internen Schätzung beruht. Nach Angaben des Unternehmens wurden die rund 40.000 Rust-Codezeilen des Datenbankkerns innerhalb von zwei Monaten von zwei Ingenieuren und Hunderten Agenten geschrieben. Eine Veröffentlichung als Open Source ist angekündigt, jedoch ohne Termin.
🔗 Perplexity-Beitrag zu CobbleDB
TRL v1.14: asynchrones GRPO mit LoRA, verteilt über HF Jobs
10. September — In einem offiziellen Beitrag vom 10. September beschreibt Hugging Face eine Neuerung in TRL v1.14: Der AsyncGRPOTrainer, der Training und Generierung voneinander trennt, kann einen LoRA-Adapter trainieren und nur diesen mit vLLM synchronisieren – also wenige Megabyte statt etwa 3 GB bei einem Modell mit 1,5 Milliarden Parametern. Der Trainer und die vLLM-Replikate laufen in separaten Jobs, die über einen Storage Bucket miteinander verbunden sind.
| Gemessene Kennzahl | Erster Run | Fünfter Run |
|---|---|---|
| Dauer für 500 Schritte | 3 Std. 27 Min. | 53 Min. |
| Median-Dauer eines Schritts | 22,9 s | 4,8 s |
| MFU Forward + Backward | 3,9 % | 23,5 % |
| Belohnung über die letzten 20 Schritte | 0,438 | 0,416 |
Drei Einstellungen erklären den Gewinn: das Packen der Sequenzen pro Micro-Batch, das Deaktivieren der Neuberechnung von Aktivierungen (gradient checkpointing) und die Erhöhung der Anzahl gleichzeitig laufender Anfragen von 128 auf 384 – bei vergleichbarer Belohnung. Die anfängliche Konfiguration kostet etwa 20 Dollar pro Stunde, und die Reproduktionsskripte wurden veröffentlicht.
🔗 Asynchrones GRPO mit LoRA über HF Jobs
Transformer Engine steigert den Durchsatz von Dropless MoE in JAX um das 10,4-Fache
14. September — NVIDIA zeigt, wie Transformer Engine in JAX das Training von Mixture-of-Experts-Modellen ohne Token-Verwerfen (dropless MoE) beschleunigt, bei denen jeder Experte eine variable Anzahl von Tokens erhält. Für DeepSeek-V3 verortet der Text die 10,4-fache Steigerung auf GB200, die Bildunterschrift der Abbildung hingegen auf GB300 NVL72.
| Von NVIDIA veröffentlichte Kennzahl | Angegebener Wert |
|---|---|
| Anfänglicher Durchsatz | 103 TFLOPS pro GPU |
| Kommunikationsanteil an der Kernel-Laufzeit | Anfangs 84 % |
| Durchsatz mit Transformer Engine | 1.068 TFLOPS pro GPU, also 10,4-mal mehr |
| Skalierungseffizienz bei 1.024 GPUs | 97 % |
Der Gewinn entsteht insbesondere durch ein grouped GEMM in MXFP8, das alle Experten in einem einzigen Kernel-Aufruf verarbeitet, sowie durch ein über NCCL EP zusammengeführtes Dispatch und Combine. Die Optimierungen werden im NGC-MaxText-Container ausgeliefert, und NVFP4 ist als nächster Schritt angekündigt.
🔗 Technischer NVIDIA-Beitrag zu Dropless MoE in JAX
PC-ALM, das lokale Lernverfahren von Sakana AI, das 1.000 Schichten ohne Backpropagation trainiert
14. September — Sakana AI veröffentlicht PC-ALM (Augmented Lagrangian Predictive Coding), eine Methode, die Backpropagation (backpropagation) durch lokale Dynamiken ersetzt, wobei jede Schicht nur mit ihren Nachbarschichten kommuniziert. Sie erweitert Predictive Coding (predictive coding), indem jede Schicht duale Variablen – Lagrange-Multiplikatoren – erhält, die sie zu einem Proportional-Integral-Regler mit Rückkopplung machen; in einem linearen Netzwerk reproduzieren diese Variablen exakt die Credit-Signale der Backpropagation.
Auf MNIST bleiben residuale MLPs mit einer Breite von 32 bis zu 1.000 Schichten ungefähr 2 Prozentpunkte hinter Backpropagation. Auf CIFAR-10 und Tiny ImageNet schneidet PC-ALM besser ab als herkömmliches Predictive Coding, die Ergebnisse werden jedoch nur in Diagrammen angegeben. Sakana AI präsentiert es nach eigener Kenntnis als erste lokale Methode, die derart tiefe Netzwerke trainieren kann – allerdings für weiterhin einfache Aufgaben. Das Paper und der Code wurden veröffentlicht.
🔗 Augmented Lagrangian Predictive Coding
Scribe v2 Medical, die medizinische Transkription von ElevenLabs, ist allgemein verfügbar
11. September — Die allgemeine Verfügbarkeit von Scribe v2 Medical, die am 11. September ausschließlich im Changelog der Dokumentation und ohne Tweet oder Blogbeitrag angekündigt wurde, vervollständigt das Transkriptionsangebot von ElevenLabs. Diese feinabgestimmte Version von Scribe v2 erkennt Medikamentennamen, Anatomie, Pathologie und klinische Diktate besser und behält zugleich die Genauigkeit von Scribe v2 bei Alltagssprache bei. Das Modell verarbeitet Audio in Batches, zum selben Preis wie Scribe v2, mit scribe_v2_medical als Modellkennung und denselben Optionen, von der Entitätserkennung bis zur Sprecherdiarisierung. ElevenLabs sieht es für klinische Dokumentation, Aufnahmegespräche und Compliance-Workflows mit geschützten Gesundheitsdaten vor. Das Datenblatt nennt 15 % weniger Fehler als Scribe v2 bei isolierten medizinischen Begriffen sowie die Unterstützung von mehr als 90 Sprachen.
🔗 ElevenLabs-Changelog vom 11. September
Google Flow kommt auf das iPhone
10. September — Das Konto @FlowbyGoogle kündigte am 10. September die iOS-App von Google Flow an, Googles Studio für KI-gestützte Kreation. Laut App-Store-Eintrag ist sie kostenlos mit In-App-Käufen, ausschließlich für das iPhone verfügbar und erfordert iOS 16 oder neuer. Mit den generativen Modellen von Google lassen sich darin Bilder und Videos erstellen und bearbeiten, ausgehend von der Fotomediathek oder der Kamera. Die Bibliothek bleibt mit der Desktop-Version synchronisiert, und mehrere Generierungen können im Hintergrund ausgeführt werden; eine Benachrichtigung informiert, sobald das Ergebnis fertig ist. Im Eintrag wird kein Modell genannt.
🔗 Ankündigung von @FlowbyGoogle auf X 🔗 Google Flow im App Store
Kurzmeldungen
- Claude Tag im Gesundheitswesen, ferngehalten von geschützten Daten — Da Claude Tag noch nicht durch Anthropics BAA-Vereinbarung abgedeckt ist, beschränken Insight Health, Tennr und Medallion es auf Kanäle ohne Gesundheitsdaten; bei Insight Health werden 97 % der kritischen Warnmeldungen ohne Eingreifen eines Ingenieurs geschlossen. Die Claude-Tag-Guthaben, die Organisationen für die Verknüpfung mit GitHub erhalten, laufen am 1. Oktober ab. 🔗 Quelle
- Anthropic und Accenture veröffentlichen einen Leitfaden für den Übergang vom Pilotprojekt zur Produktion — Er richtet sich an CIOs und geht von zwei Zahlen von Accenture aus: Nur 23 % der Führungskräfte stellen eine nachhaltige unternehmensweite Wirkung von KI fest, und 42 % der Organisationen haben keine einzelne verantwortliche Person für deren Kosten und Ergebnisse. 🔗 Quelle
- Claude Fable 5.1 löst das Cyphral Distich, ein Kryptogramm von 1653 — Eine Demonstration eines Drittanbieters, beschrieben in einem auf den 31. August datierten Beitrag von Vals AI und am Abend des 13. September pazifischer Zeit von Boris Cherny weiterverbreitet: 44 Minuten und 176.000 Tokens, ohne menschliches Eingreifen. Der Autor räumt ein, dass der Hinweis einfach war. 🔗 Quelle
- Fyxer erreicht, dass 53 % seiner E-Mail-Entwürfe unverändert übernommen werden — In dieser Fallstudie von OpenAI verteilt der Executive Assistant die Arbeit auf 30 bis 50 spezialisierte Modelle, die anhand der Korrekturen der Nutzer feinabgestimmt werden, und steigerte seinen jährlich wiederkehrenden Umsatz 2025 von 1 auf 32 Millionen Dollar. Es wird kein Modell genannt. 🔗 Quelle
- Devin übernimmt den PagerDuty-Bereitschaftsdienst — Laut den Versionshinweisen vom 11. September kann Devin PagerDuty-Vorfälle sortieren und seine Untersuchung als Vorfallsnotizen veröffentlichen, 21 MCP-Server lassen sich mit einem Klick über OAuth verbinden, und die Sessions API v1 akzeptiert eine
idempotency_key. 🔗 Quelle - DevFest 2026 vom 1. Oktober bis 31. Dezember — Die Google Developer Groups planen mehr als 800 Veranstaltungen in 115 Ländern, mit Workshops und Agenten-Entwicklungsmarathons (agent-athons) rund um Gemini, AI Studio, Antigravity und Web MCP. 🔗 Quelle
- Suno stellt Studio Chat vor — Dieser Assistent für Suno Studio kennt jede Spur und jedes MIDI-Fragment des Projekts und kann direkt auf der Timeline ordnen, umbenennen, einfärben oder einen neuen Part schreiben. Weder Verfügbarkeit noch Preis wurden angekündigt. 🔗 Quelle
- Das Open-Source-Ökosystem von MiniMax H3 wächst — MiniMax hebt drei Community-Projekte hervor: VDN, das Attention zur Beschleunigung der Inferenz neu konzipiert, die achtstufigen PDD Acc-LoRAs von Alibaba PAI und die vier- und achtstufigen Turbo LoRAs von LightX2V. 🔗 Quelle
- Runway erläutert die Produktion von A Game of HORSE — Ein Video-Tutorial, die Prompts des Kurzfilms und der herunterladbare Skill runway-sd-enhancer, der einen Roh-Prompt in einen Produktions-Prompt für eine 15-sekündige Szene umwandelt. 🔗 Quelle
- Ai2 lässt AutoDiscovery von Studierenden der University of Washington erproben — Zehn Teams testeten den Agenten: nützliche Ansätze zu Batterien oder Proteinen, aber ungefähr die Hälfte der Hypothesen zu 24.000 simulierten Reaktorkonfigurationen war unlogisch. Die Testguthaben werden bis zum 31. Dezember verlängert. 🔗 Quelle
- Archsloth bringt seine Qwen-GGUFs näher an das Original — Ein Community-Beitrag des FINAL-Bench-Teams im Hugging-Face-Blog: Bei derselben Dateigröße wie die unsloth-Datei reduziert sein
Q4_K_Mvon Qwen3-4B dank zweier korrigierter AutoRound-Optionen die KL-Divergenz um 54,4 % im Koreanischen und um 33,2 % im Englischen. 🔗 Quelle - Eric Mey misst die OpenAI-Kompatibilität eines LangGraph-Agenten — Ein individueller Beitrag im selben Community-Blog: Die 37 Anfragefelder von Chat Completions wurden klassifiziert, und keines bleibt mehr ohne Rückmeldung, gegenüber 11 zu Beginn; ein Streaming-Fehler entging jedoch der Schema-Validierung. 🔗 Quelle
- EcoHash beziffert, was eine RTX PRO 6000 mit 96 GB leistet — Beitrag eines Inferenzanbieters, gemessen auf seinem eigenen Dienst und mit veröffentlichten Roh-CSV-Dateien: qwen3.6-35b-a3b liefert sein erstes Token in 170 ms (p95) und etwa 213 Tokens pro Sekunde; bei paralleler Ausführung auf Llama-3.1-8B erreicht der Durchsatz etwa 11.500 Tokens pro Sekunde. 🔗 Quelle
Was das bedeutet
Der erste rote Faden betrifft Agents, die man programmiert und einhegt. Claude Mods ermöglichen es jedem, eigene Hooks in TypeScript zu schreiben, leiten deren Seiteneffekte jedoch über ein $-Objekt, das Administratoren prüfen und einschränken können. Devin Plugins wendet dieselbe Logik auf Unternehmensebene an, wobei Plugins je nach Geltungsbereich vorgeschrieben oder verboten werden können; GitHub lässt den Kompromiss zwischen Kosten und Qualität des Auto-Routings wählen; Qwen Code und Kimi Code legen jeweils die Dauer ihrer Ziele fest; und Kimi Code kann seine MCP-Tools bei Bedarf laden. MCP dient auch als Vertriebskanal: Eine einzige Installation bringt Sprache, Musik und mehr als 50 Bild- und Videomodelle von ElevenLabs in fünf Assistenten, ohne dass man die Unterhaltung verlassen muss.
Der zweite rote Faden betrifft die Infrastruktur, die dieser agentische Code unter Druck setzt oder selbst aufbaut. Bei Anthropic, wo Claude 80 % des Codes schreibt, hat sich die Zahl der CI-Jobs innerhalb von sechs Monaten verfünfundzwanzigfacht, und die Überarbeitung des Dienstes zur Testauswahl dauerte bei nur einem Ingenieur drei Wochen. Bei Perplexity schrieben zwei Ingenieure und Hunderte Agents die 40.000 Rust-Codezeilen von CobbleDB, dessen Leselatenz nach eigenen Messungen etwa fünfmal niedriger ist. Beim Training zeigt sich dieselbe Entwicklung: TRL verkürzt einen GRPO-Run von 3 Std. 27 Min. auf 53 Min., und Transformer Engine erhöht den Durchsatz eines dropless MoE um das 10,4-Fache – zwei Beiträge, die den Engpass zunächst lokalisieren und anschließend beseitigen.
Der dritte rote Faden ist politischer Natur: Wer bestimmt das Tempo und die Regeln? Drei Tage nach dem Gastbeitrag von OpenAI, der ein auf den Fähigkeiten der Modelle basierendes Bundesgesetz forderte, schlägt Dario Amodei vor, das Tempo der Fortschritte bei Frontier-Modellen zu steuern, indem Anthropic zunächst integrierten Prüfern geöffnet wird, während Aidan Gomez diese Methode infrage stellt. Beide Texte stimmen darin überein, dass die leistungsfähigsten Systeme unabhängig geprüft werden sollten, unterscheiden sich jedoch beim weiteren Vorgehen: auf der einen Seite eine Regulierung aller amerikanischen Frontier-Unternehmen, ergänzt durch Standards, die im Rahmen einer eng begrenzten kartellrechtlichen Ausnahme erörtert werden; auf der anderen Seite ein von mehreren Ländern entwickelter Risikorahmen und Audits, die niemals von den Geprüften bezahlt werden. In der Debatte geht es weniger um den Grundsatz einer Kontrolle als darum, wer ihre Regeln verfasst.
Der letzte rote Faden betrifft sensible Daten, denen sich KI mit in das Produkt integrierten Schutzmechanismen nähert. Portable Computer behält Dateien und Abfragen auf dem PC und bittet vor jeder Übertragung in die Cloud um Erlaubnis; Scribe v2 Medical ist auf klinische Diktate und Compliance-Workflows für geschützte Gesundheitsdaten ausgerichtet; Claude Tag bleibt mangels Abdeckung durch die BAA-Vereinbarung auf Kanäle beschränkt, die keine solchen Daten enthalten; und Claude for Financial Advisors behält die Genehmigung kritischer Aufgaben dem Berater vor. Je näher ein Agent der Patientenakte oder dem Portfolio eines Kunden kommt, desto ausdrücklicher wird die Grenze dessen, was er allein erledigen darf.
Quellen
- Boris Cherny auf X, Claude Mods
- Claude Code, Issue Function Hooks #91870
- Dario Amodei, We Must Pace the Frontier
- Dario Amodei auf X, Ankündigung des Essays
- Cohere, Who Gets to Define the Rules for AI?
- ElevenLabs auf X, Ankündigung des kreativen MCP
- ElevenLabs auf X, kompatible Clients
- GitHub Changelog, Stufen der automatischen Modellauswahl
- GitHub Docs, About Copilot auto model selection
- Perplexity, Portable Computer für Windows
- Perplexity, Produktseite von Portable Computer
- NVIDIA, Portable Computer auf RTX-PCs
- Qwen Code, Versionshinweise 0.23.4
- Kimi Code, Versionshinweise 0.43.0
- OpenAI Developers auf X, Arch Linux
- ChatGPT, Anwendung für Linux
- Devin, Agent-Governance mit BlackRock
- Devin, Plugin-Dokumentation
- Claude, Claude for Financial Advisors
- Claude, Agentic coding is straining CI
- Perplexity, CobbleDB
- Hugging Face, Async GRPO with LoRA across HF Jobs
- NVIDIA, dropless MoE in JAX mit Transformer Engine
- Sakana AI, PC-ALM
- ElevenLabs, Changelog vom 11. September
- Google Flow auf X
- Google Flow im App Store
- Claude, Claude Tag im Gesundheitswesen
- Claude, Leitfaden vom Pilotprojekt bis zur Produktion mit Accenture
- Boris Cherny auf X, Cyphral Distich
- Vals AI, Claude Fable 5.1 Solves the Cyphral Distich
- OpenAI, Fallstudie Fyxer
- Devin, Versionshinweise
- Google, DevFest 2026
- Suno auf X, Studio Chat
- MiniMax auf X, H3-Ökosystem
- Runway auf X, A Game of HORSE
- Ai2, AutoDiscovery und die Studierenden der University of Washington
- Hugging Face, Archsloth und AutoRound
- Hugging Face, OpenAI-Kompatibilität eines LangGraph-Agent
- Hugging Face, EcoHash und die RTX PRO 6000