ai-powered-markdown-translatorArtikel mit gpt-6.1-sol aus dem Französischen ins Deutsche übersetzt.
Qwen stellt Qwen4-Max über seine API bereit: ein MoE-Modell mit 2,4T Parametern und einem Kontext von 1M Tokens, das günstiger abgerechnet wird als Qwen3.8-Max. OpenAI erweitert den Zugang zu seinen Agenten zur Computersteuerung auf ChatGPT for Healthcare und ChatGPT for Clinicians, NVIDIA kündigt auf der SC26 Rubin HPC an, eine für 2028 erwartete GPU für Simulationen, und präsentiert erste Ergebnisse von Vera Rubin bei MLPerf Training. Hugging Face überlässt OpenRouter das Routing seiner Inference Providers. Perplexity startet seinerseits Perplexity Frontier Research, das mit mehr als 10 000 GPU auf einen automatisierten Wissenschaftler abzielt.
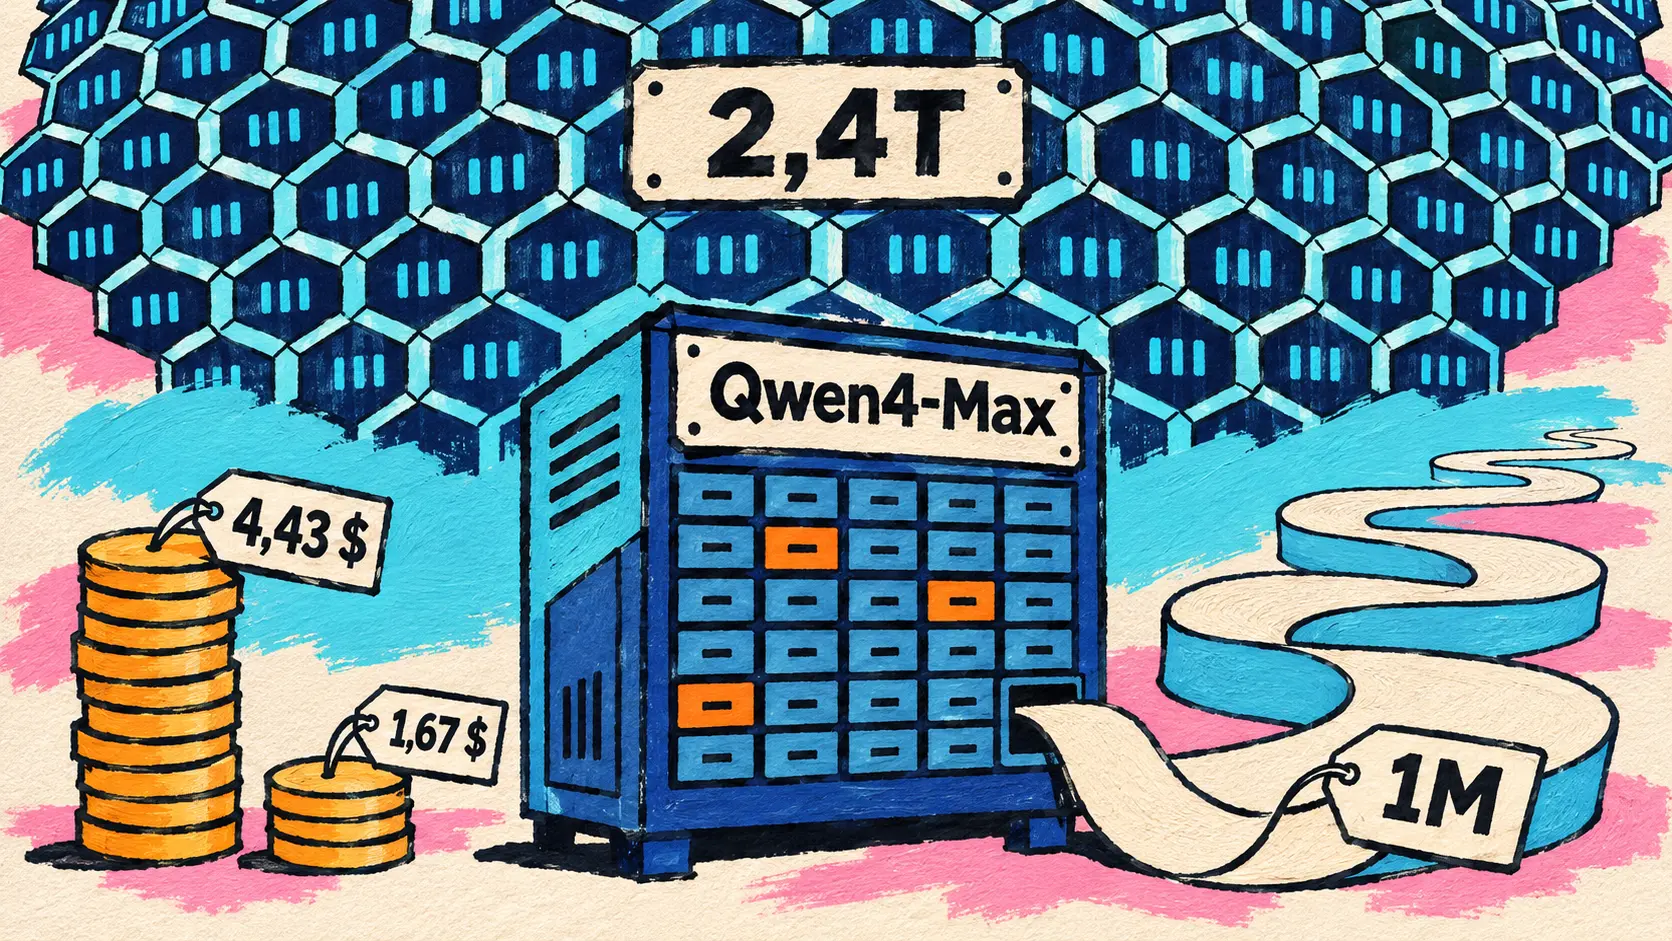
Qwen4-Max kommt in die API von QwenCloud: MoE mit 2,4T Parametern, Kontext von 1M Tokens, sinkende Preise
16. November — Fünf Tage nach der am 11. November behandelten Vorabversion stellt Qwen Qwen4-Max in der API von QwenCloud unter der Kennung qwen4-max bereit und veröffentlicht dazu einen ausführlichen technischen Beitrag. Es ist das erste Modell der Qwen4-Serie: Kleinere Qwen4-Modelle werden mit offenen Gewichten erscheinen, ein Termin steht noch nicht fest, für Max ist jedoch keine solche Veröffentlichung angekündigt. Das Modell wird auch in QwenWork, Qoder und Qwen Studio angeboten und ist noch am selben Tag bei OpenRouter, Vercel AI Gateway, Novita AI und OpenCode Go verfügbar.
Die Architektur ist neu. Dieses Expertenmodell (Mixture of Experts, MoE) umfasst 2,4T Backbone-Parameter, von denen 71B pro Token aktiviert werden, sowie 328B Parameter für N-gram Embedding. Von jeweils vier Schichten komprimieren drei mit Gated DeltaNet den Verlauf in einen Zustand fester Größe; die vierte wählt mit Qwen Sparse Attention den nützlichen Kontext blockweise aus. Das Modell verfügt über native Bildverarbeitung und einen Kontext von 1M Tokens: laut QwenCloud-Seite 991K für die Eingabe und 131K für die Ausgabe, im Reasoning-Modus 983K und 262K.
| Tarifart (QwenCloud, pro Million Tokens) | Angekündigter Preis |
|---|---|
| Eingabe | 1,5 Dollar |
| Ausgabe | 4,5 Dollar |
| Eingabe aus implizitem Cache | 0,075 Dollar |
| Erstellung eines expliziten Caches (5 Minuten / 1 Stunde) | 1,875 / 3 Dollar |
Laut Qwen liegen alle diese Preise unter denen von Qwen3.8-Max, wobei der implizite Cache um 70 % günstiger wird. In seinen internen Bewertungen meldet Qwen außerdem einen je nach Reasoning-Aufwand um 24 bis 35 % geringeren Tokenverbrauch bei Work360, seinem Evaluierungsrahmen für 721 berufliche Fachgebiete, und um etwa 48 bis 49 % bei Terminal-Bench 4.0. Die durchschnittlichen Kosten einer Work360-Aufgabe sinken von 4,43 auf 1,67 Dollar, laut dem englischen Beitrag also um −62 %; die chinesische Fassung in Yuan nennt −58 %. Bei Work360 erzielt Qwen4-Max 52,69 gegenüber 47,74 für Qwen3.8-Max.
Im Vergleich mit Opus 5.5, GPT-6.1 Sol, GPT-6 Astra und Kimi K3.1 zeigt die von Qwen veröffentlichte Tabelle ein gemischtes Bild: Qwen4-Max führt nur bei 4 der 16 Tests, DeepSWE v1.1, Agents’ Last Exam v1.1, HLAB-Vals-1.1 und BioMysteryBench. Eine Auswahl:
| Benchmark (Bereich) | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|
| DeepSWE v1.1 (agentischer Code) | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| HLAB-Vals-1.1 (Rechtsagent) | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| BioMysteryBench (Bioinformatik) | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| Terminal-Bench 4.0 (agentisches Terminal) | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench (Software-Replikation) | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| Humanity’s Last Exam | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
Die von Qwen weitergegebenen Rankings Dritter führen das Modell auf Platz 6 von Code Arena WebDev (1 750 vorläufige Punkte) und auf Platz 11 des Vals Index (63,20 %), als bestplatziertes chinesisches Modell. Artificial Analysis vergibt in seinem Intelligence Index bei Reasoning-Aufwand xhigh 43 Punkte, 3 Punkte hinter Kimi K3.1 Pro, bei etwa 11 % geringeren Kosten pro Aufgabe.
More to come! The open weights of smaller Qwen4 models will be released. Stay tuned.
🇩🇪 Das ist noch nicht alles! Die Gewichte kleinerer Qwen4-Modelle werden offen veröffentlicht. Bleiben Sie dran. — @Alibaba_Qwen auf X
🔗 Qwen4-Max: Ihr neuer Teamkollege ist da (Qwen-Beitrag) · Datenblatt zu qwen4-max auf QwenCloud
ChatGPT for Healthcare: Agenten zur Computersteuerung, klinische Recherche und mehr als 20 Gesundheitsplugins
16. November — OpenAI erweitert ChatGPT for Healthcare in drei Richtungen. Zunächst werden Agenten zur Computersteuerung (computer-use agents), die den Bildschirm lesen, klicken, tippen und zwischen Anwendungen wechseln, in ChatGPT Work und Codex für Kunden von ChatGPT for Healthcare verfügbar, abhängig von den Einstellungen ihres Arbeitsbereichs, sowie für die Kliniker von ChatGPT for Clinicians, dem kostenlosen Angebot für verifizierte Kliniker in den USA. Dieselbe Fähigkeit ist über die API zugänglich. Ein typischer Anwendungsfall: Informationen zwischen Programmen übertragen, die nicht miteinander kommunizieren, etwa zwischen der elektronischen Patientenakte und dem Portal eines Versicherers für einen Antrag auf Genehmigung einer MRT. Die Computersteuerung gab es in ChatGPT Work und Codex bereits seit dem 9. Juli; neu ist ihre Öffnung für Arbeitsbereiche im Gesundheitswesen, mit rollenbasierten Zugriffskontrollen, Audit-Logs und konfigurierbaren Genehmigungsschritten. HIPAA-konforme Abläufe bleiben auf dafür geeignete Dienste beschränkt, die von einem BAA abgedeckt sind.
OpenAI veröffentlicht zwei Zahlenreihen, die getrennt betrachtet werden sollten: seine interne Bewertung der Nachrichtenfunktion der Patientenakte und HealthAdminBench, einen unabhängigen Benchmark von Stanford-Forschern für Verwaltungsaufgaben (Vorabgenehmigungen, Widersprüche, Gerätebestellungen).
| Veröffentlichte Bewertung | Modell und Einstellung | Gemeldetes Ergebnis |
|---|---|---|
| Nachrichtenfunktion der Patientenakte (OpenAI, 325 geprüfte Aufgaben) | GPT-6 Astra | 99 % der Aufgaben als klinisch sicher bewertet |
| Dieselbe Bewertung, 646 ärztliche Bewertungen | GPT-6 Astra | 93 % „sehr“ oder „äußerst“ hilfreich |
| HealthAdminBench (Stanford) | GPT-6 Astra, maximaler Aufwand | 94,3 % der Punkte des Bewertungsrasters |
| HealthAdminBench (Stanford) | GPT-6 Luna, maximaler Aufwand | 91,8 %, für 8,5 Cent pro Aufgabe |
Bei HealthAdminBench erzielt GPT-6 Luna 91,8 % bei um 98 % geringeren Kosten, also 8,5 Cent pro Aufgabe. In der Praxis setzt CVS Health diese Agenten bereits im Produktivbetrieb ein: Einer arbeitete an einem Wochenende einen über Monate aufgelaufenen Rückstand beim Dokumentenversand ab, ein anderer übernimmt täglich die Systemschritte für Zehntausende von Konsultationen, und das Unternehmen veröffentlicht sein mit dem Agents SDK von OpenAI entwickeltes Agent Kit als Open Source. Cigna Healthcare gibt an, in weniger als acht Wochen vom Konzept zum Deployment gelangt zu sein; bei Ambience hält der Agent bei unklarer Aktenlage an und fragt den Kliniker um Rat; Abridge entwickelt Agenten für Krankenhäuser.
Hinzu kommen die beiden anderen Bereiche. Die klinische Recherche, die medizinische Evidenz findet, bewertet und zitiert, wird in allen acht gemessenen Dimensionen einer verblindeten Bewertung mit mehr als 1 300 ärztlichen Begutachtungen besser bewertet. Und 21 neue Gesundheitsplugins (UpToDate Expert AI, Oracle HDI, Trizetto, Stedi, Luma Health, Metriport…) ermöglichen es, direkt aus dem Gespräch heraus ein Protokoll nachzuschlagen, den Versicherungsschutz zu prüfen oder Termine zu koordinieren; der Administrator des Arbeitsbereichs muss sie aktivieren, und ChatGPT for Clinicians erhält nur einen Teil davon.
🔗 Weitere Möglichkeiten, die Versorgung mit ChatGPT for Healthcare voranzubringen · Agenten zur Computersteuerung für Teams im Gesundheitswesen weiterentwickeln
NVIDIA auf der SC26: Rubin HPC für wissenschaftliche Simulationen, Vera Rubin in MLPerf, Slurm für Quantenprozessoren und CUDA-X-Bibliotheken
16. November — Auf der Konferenz für Hochleistungsrechnen SC26 stellt NVIDIA eine Reihe auf die Wissenschaft ausgerichteter Neuerungen vor. Die wichtigste ist Rubin HPC, eine neue GPU der Plattform Vera Rubin, die für Simulationen und Datenverarbeitung in Wissenschaft, Ingenieurwesen und Analytik entwickelt wurde, etwa in Bereichen wie Klima, Genomik oder Finanzrisiken.
Die veröffentlichten technischen Angaben bleiben knapp. NVIDIA hebt mehr als 50 000 CUDA-Kerne auf einer einzigen GPU hervor, laut dem Unternehmen eine „Rekordzahl“, dazu eine Beschleunigung für dünn besetzte Daten (sparse data acceleration), die diese Kerne kontinuierlich mit Daten versorgen soll, und eine NVLink-Verbindung der siebten Generation zwischen GPU. Weder Speicherkapazität noch Rechenleistung in FLOPS, Preise oder Partner werden genannt.
Das zentrale Argument ist die Balance. Laut NVIDIA bestehen die meisten wissenschaftlichen Workloads darin, einige verstreute Werte aus einem riesigen Datensatz abzurufen, Berechnungen auszuführen und diesen Vorgang in sehr großem Maßstab zu wiederholen. Rubin HPC steigert daher die Datenbewegung im gleichen Tempo wie die Rechenleistung, um Operationen mit dünn besetzten Matrizen, Stencil-Berechnungen, Sortierungen und Reduktionen zu beschleunigen. NVIDIA verknüpft diese GPU mit seiner Argumentation zu Agenten: Ein Agent, der mehr Moleküle, Materialien oder Entwürfe untersucht, benötigt mehr Simulationen, um seine Ideen zu testen, und die CUDA-X-Bibliotheken liefern ihm die optimierten Implementierungen. Der Termin liegt noch weit in der Zukunft: Rubin HPC wird für 2028 erwartet.
| Angekündigte Eigenschaft | Von NVIDIA angegebener Wert |
|---|---|
| CUDA-Kerne | mehr als 50 000 auf einer einzigen GPU |
| Verbindung zwischen GPU | NVLink der siebten Generation |
| Spezifische Funktion | Beschleunigung für dünn besetzte Daten |
| Geplante Verfügbarkeit | 2028 |
🔗 Rubin HPC (NVIDIA-Blog) · Die Ankündigungen von NVIDIA auf der SC26
Vera Rubin startet in MLPerf Training v6.1 und MLPerf Endpoints, mit bis zu 2-facher Leistung pro GPU gegenüber GB300 NVL72
16. November — Die Runde MLPerf Training v6.1 markiert die erste Teilnahme von Vera Rubin NVL72 beim Training: bis zu 2-mal so viel Leistung pro GPU wie bei einem GB300 NVL72, Ergebnisse, die NVIDIA als frühe Ergebnisse präsentiert. Bei DeepSeek-V3 bleibt beim Wechsel von 256 auf 1 024 GPU von Vera Rubin die Effizienz bei etwa 97 %, während die Trainingsdauer von 16 Minuten auf etwa vier sinkt. Die größte Konfiguration dieser Runde umfasst 10 240 GPU, bei NVIDIA auf Basis von GB300 und bei Microsoft Azure auf Basis von GB200. Laut NVIDIA ist seine Plattform die einzige mit Ergebnissen für sämtliche Tests.
NVIDIA reicht außerdem erstmals Ergebnisse bei MLPerf Endpoints v1.0 ein, das reale agentische Workflows misst. Bei Kimi K3 soll Vera Rubin NVL72 bei gleicher Antwortgeschwindigkeit mehr als das 10-Fache des Durchsatzes pro Watt eines GB300 NVL72 liefern: ein vorläufiges Ergebnis, dessen Überprüfung durch MLCommons noch aussteht und das 32 Vera Rubin-Beschleuniger mit 48 GB300-Beschleunigern beim Schwellenwert von 50 Tokens pro Sekunde und Nutzer vergleicht. Vera Rubin war bereits als Vorabversion in MLPerf Inference vertreten, worüber am 16. September berichtet wurde.
🔗 Vera Rubin in MLPerf Training und Endpoints (NVIDIA-Blog)
Slurm 26.11 wird Quantenprozessoren unterstützen, CUDA-Q wird erweitert
16. November — NVIDIA erweitert Slurm, den Jobmanager für Supercomputer, um die Unterstützung von Quantenprozessoren (QPU). Bisher erforderte die Einbindung eines QPU in ein Rechenzentrum eine eigene Entwicklung für jede Kombination aus Prozessor und Rechenzentrum; künftig beschreibt ein Hersteller seine Hardware in einer einfachen Datei und erhält über die Schnittstellen QRMI und QDMI eine überall nutzbare Schnittstelle. Alice & Bob, IBM, IQM, Pasqal, Quantinuum und MQSC setzen dies ein, und Slurm 26.11 soll im weiteren Verlauf des Novembers erscheinen. NVIDIA begründet diese Arbeit mit dem wachsenden Bestand: Knapp 30 Rechenzentren stellen mehr als 50 QPU bereit.
Die CUDA-Q-Plattform erhält einen Decoding-Server für die Quantenfehlerkorrektur (CUDA-Q QEC), dessen TCBP-JOBS-Decoder 13 000-mal schneller sein soll als die Branchenreferenz, fehlertolerante Primitive (Fermilab hat mit CUDA-Q bereits in drei Wochen Studien durchgeführt, die sonst fünf Monate gedauert hätten) sowie CUDA-Q Algorithms und CUDA-Q Pulse für Hardwarehersteller. Diese Leistungsgewinne sind Angaben von NVIDIA.
🔗 Slurm und Quantencomputing (NVIDIA-Blog)
CUDA-X für die Wissenschaft: cuSpa und HMMER auf GPU als Open Source, Daten des Event Horizon Telescope in acht Minuten korreliert
16. November — NVIDIA begleitet Rubin HPC mit CUDA-X-Bibliotheken für die Forschung, die als Werkzeuge vorgestellt werden, die Agenten aufrufen können. In der Astronomie verkürzt das Modul cuPhoton.xBeam die Korrelation der Beobachtungen des Event Horizon Telescope von mehr als einem Monat auf acht Minuten, sowohl auf einem Multi-GPU-Cluster als auch auf einem DGX Spark. In der Biologie macht cuSpa, das neuerdings als Open Source verfügbar ist, die Berechnungen von Zellpolygonen am Memorial Sloan Kettering Cancer Center 900-mal schneller als auf einer CPU, und die ebenfalls als Open Source verfügbare GPU-Version von HMMER ist bei Basecamp Research bis zu 84-mal schneller. rapids-singlecell wird nun in einem „für Agenten einsatzbereiten“ Container ausgeliefert (200-mal schneller bei Therna Biosciences). In der Chemie hält Daviator, eine Sammlung von GPU-Kernels für die Software VASP, Einzug in NVIDIA ALCHEMI, mit bis zu 22-mal schnelleren und bis zu 75 % günstigeren Berechnungen, ist aber noch nicht verfügbar; cuPotential, das am 14. Oktober eingeführt wurde, gewinnt fünf Anwender, darunter Cadence.
🔗 CUDA-X-Bibliotheken für die Wissenschaft (NVIDIA-Blog)
Hugging Face überträgt OpenRouter das Routing der Sprachmodelle seiner Inference Providers
16. November — Hugging Face und OpenRouter schließen sich zusammen: Die Inference Providers von Hugging Face geben ihren hauseigenen Router auf und überlassen OpenRouter die Auswahl des Anbieters für jeden Aufruf eines Sprachmodells. Clément Delangue stellt die Ankündigung als ersten Teil der Partnerschaft vor. Am Client-Code ändert sich nichts: derselbe Token von Hugging Face, derselbe Endpoint. Der Router unterstützt die APIs Chat Completions und Responses von OpenAI ebenso wie die Messages-API von Anthropic, und Hugging Face veröffentlicht Anleitungen für Claude Code, Codex, OpenCode, Pi und Hermes Agent.
Der Unterschied liegt im Routing. Inference Providers wählte einen Anbieter aus und gab dessen Fehler unverändert zurück; OpenRouter wählt anhand von Preis, Geschwindigkeit und Zuverlässigkeit, die in Echtzeit erfasst werden, und wiederholt den Aufruf bei einem anderen Anbieter, wenn der erste scheitert. Suffixe erzwingen eine Richtlinie oder einen Anbieter (:fastest, :cheapest, zai-org/GLM-5.3:novita), und eine Unterhaltung bleibt bei dem Anbieter, der ihren Prompt-Cache hält.
| Angekündigte Änderung | Details laut Blogbeitrag |
|---|---|
| Kapazitätsfehler (Messung von OpenRouter) | −46 % |
| Zeit bis zum ersten Token und Durchsatz (Messung von OpenRouter) | um 16,9 % verbessert und +16,3 % |
| Abrechnung | Preis des Anbieters, ohne Aufschlag durch Hugging Face |
| Enthaltenes monatliches Guthaben | 2 Dollar (PRO), 2 Dollar pro Sitz (Team, Enterprise) |
| Modellseiten | Tabs Providers und Metrics: Preis, Geschwindigkeit, Verfügbarkeit über 24 Stunden |
| Inkompatible Änderung | Persönliche API-Schlüssel von Anbietern werden für Sprachmodelle abgelehnt |
Bild-, Video- und Audioanfragen laufen weiterhin direkt über Inference Providers, ohne OpenRouter, und persönliche Schlüssel bleiben für Bild- und Videoanbieter gültig. Die Verknüpfung eines OpenRouter-Kontos mit Hugging Face und das Routing weiterer Aufgaben über OpenRouter sind für später angekündigt, ohne Termin.
Der Beitrag stützt sich auf Zahlen von OpenRouter: Offene Modelle machten Ende September 2026 71,7 % der ausgelieferten Tokens aus, gegenüber 26,8 % im Oktober 2025, bei einem Durchschnittspreis von 0,28 und 1,62 Dollar pro Million Tokens (Eingabe, Ausgabe), gegenüber 1,27 und 6,36 Dollar bei geschlossenen Modellen. Er räumt auch den Abstand an der Spitze der Rangliste ein: Kimi K3.1 Pro, das beste offene Modell, erreicht im Artificial Analysis Intelligence Index 46 gegenüber 65 für Claude Fable 5.2, bei etwa einem Siebtel der Kosten pro Aufgabe (3,68 gegenüber 26,54 Dollar).
🔗 Hugging Face und OpenRouter bündeln ihre Kräfte (Hugging Face-Blog) · Ankündigung von @huggingface
Perplexity Frontier Research: eine offene Forschungsinitiative mit mehr als 10 000 GPU soll einen automatisierten Wissenschaftler hervorbringen
16. November — Perplexity startet Perplexity Frontier Research, eine Initiative mit dem Ziel, einen „automatischen Forschungswissenschaftler“ (automatic research scientist) zu entwickeln: ein KI-System, das den Forschungszyklus selbstständig durchlaufen kann, von der Frage zur Hypothese, vom Experiment zur Überarbeitung seiner Überzeugungen. Perplexity stellt diese Ambition den „Blackbox“-Vorhersagen bei eng begrenzten Aufgaben gegenüber: Es geht darum, neue und interpretierbare Erkenntnisse zu gewinnen.
We aim to create an automated research scientist. Research is a loop that involves asking the right questions, hypothesizing, navigating ambiguity, designing experiments, and updating beliefs. We think this loop can run inside software, for anyone.
🇩🇪 Wir wollen einen automatisierten Wissenschaftler entwickeln. Forschung ist ein Kreislauf, in dem man die richtigen Fragen stellt, Hypothesen formuliert, mit Mehrdeutigkeit umgeht, Experimente entwirft und seine Überzeugungen revidiert. Wir glauben, dass dieser Kreislauf in Software ablaufen kann, für alle. — @andrewgwils auf X
Das Programm gliedert sich in sechs Säulen: Multi-Agenten-Orchestrierung, Pretraining, kontinuierliches Lernen, Reinforcement Learning, Systeme und Evaluationen. Die eigens eingerichtete Website präzisiert, dass das Team effiziente, spezialisierte Modelle mit offenen Gewichten vortrainieren wird und bei der Orchestrierung auf jeder Kostenstufe die bestmögliche Qualität anstrebt. Denis Yarats betont Reinforcement Learning im großen Maßstab auf mehr als 10 000 GPU, gespeist mit synthetischen Daten und Umgebungen, die aus der realen Nutzung von Perplexity hervorgehen; die gesamte Infrastruktur, von der Forschung bis zu den Sandboxes, wird intern entwickelt.
| Bestandteil der Ankündigung | Zusage von Perplexity |
|---|---|
| Rechenleistung | mehr als 10 000 GPU |
| Forschungssäulen | 6 |
| Zugesagte Veröffentlichungen | Fachartikel, Blogbeiträge, Daten, Modelle und Code |
| Standorte für die Personalsuche | San Francisco, Palo Alto, New York, London |
| Frist für bevorzugte Berücksichtigung von Bewerbungen | 5. Dezember |
Andrew Gordon Wilson wird auf der Website als Forschungsleiter der Initiative vorgestellt. Die Ankündigung ist zugleich ein Bewerbungsaufruf, verbunden mit einem Forschungsstipendium für die Phasen vor und nach der Promotion. Zum Start gibt es weder ein neues Modell noch einen neuen Benchmark oder Fachartikel: Die Website bündelt unter dem Banner Frontier Research bereits veröffentlichte Arbeiten wie WANDR, Decider, SPACE, Brain oder JOLT.
🔗 Vorstellung von Perplexity Frontier Research · Ankündigung von @perplexity_ai · research.perplexity.ai · Thread von @denisyarats
KI und wissenschaftliche Forschung bei OpenAI: ein eigener Blog, eröffnet vom Physiker Nathaniel Craig, ChatGPT for Academic Researchers auf 200 000 Forscher ausgeweitet
Ein Wissenschaftsblog startet mit einem mithilfe von GPT-6 Astra erarbeiteten Vorschlag für eine Definition des Standardmodells auf einem Gitter
15. November — OpenAI startet einen Wissenschaftsblog, in dem Forscher und Teams Ergebnisse und Methoden teilen werden, einschließlich der Vorgehensweise zur Überprüfung der Arbeit. Der erste Gastbeitrag stammt von Nathaniel Craig, Teilchenphysiker an der University of California in Santa Barbara und Gastwissenschaftler bei OpenAI.
Er stellt darin einen Preprint vom Oktober vor, der mit GPT-6 Astra erarbeitet wurde und einen Vorschlag für eine Definition des Standardmodells auf einem Gitter liefert, das die Raumzeit diskretisiert. Da die schwache Wechselwirkung zwischen „linken“ und „rechten“ Teilchen unterscheidet, tauchen bei der Gitterformulierung unerwünschte Partnerteilchen auf, und die Phasenregel blieb für das vollständige Standardmodell seit mehr als 25 Jahren ungeklärt. Laut Craig fand GPT-6 Astra einen Weg, die Felder auf feinere Gitter zu übertragen, und übernahm die Führung bei der Ausarbeitung des detaillierten Beweises, der anschließend von drei Spezialisten geprüft wurde. Der Autor bleibt vorsichtig: Die Definition ist ein „Kandidat“, gilt unter einer Schranke für die Feldstärke und ist eher eine grundsätzliche Antwort als ein Simulationswerkzeug.
🔗 Ein Schritt zur Definition des Standardmodells auf einem Gitter · Unser neuer Wissenschaftsblog
ChatGPT for Academic Researchers soll 200 000 Forscher erreichen, eine Studie untersucht 1 819 Wissenschaftler
16. November — Das im Juli mit dem Ziel von 100 000 Forschern gestartete Programm ChatGPT for Academic Researchers soll nun 200 000 erreichen. Die nächste Runde beginnt am Montag, dem 23. November: 50 000 Stipendien werden an die ersten berechtigten Bewerber vergeben, statt wie bisher per Los, und umfassen jeweils den Empfänger sowie bis zu zwei weitere Mitwirkende, also bis zu 150 000 Personen. Der Zugang wechselt von ChatGPT Pro zu ChatGPT Plus: Laut OpenAI wären die meisten Teilnehmer der Pilotphase innerhalb der Grenzen von Plus geblieben.
Parallel veröffentlicht das Wirtschaftsforschungsteam von OpenAI eine Studie über 580 186 Nachrichten von 1 819 Wissenschaftlern, ergänzt durch eine Befragung von 251 von ihnen. Die Teilnehmer schätzen, dass sie für dieselbe Arbeit bei gleicher Qualität ohne KI etwa 1,9-mal so viel Zeit gebraucht hätten, und 98 % der Befragten erwarten, dass KI die Entdeckungen in ihrem Fachgebiet beschleunigt. OpenAI betont die Grenzen: selbst berichtete Produktivität, Erwartungen statt Ergebnisse, kein nachgewiesener kausaler Effekt.
| Nutzung von ChatGPT durch Wissenschaftler | Durchschnittlicher Anteil der Nachrichten |
|---|---|
| Lesen und Lernen | 28 % |
| Schreiben und Kommunikation | 27 % |
| Analyse von Evidenz und Theorien | 17 % |
| Entwicklung von Forschungssoftware | 14 % |
🔗 Breiterer Zugang zu KI für Wissenschaftler · Wissenschaft an der Forschungsfront: Wie Wissenschaftler ChatGPT nutzen
Sicherheit und Schutz bei KI: unabhängige Prüfer bei OpenAI, offener CSAM-Klassifikator, von Google beobachtete agentische Angriffe
OpenAI öffnet seine internen Modelle für Apollo Research, METR, Transluce und Goodfire
16. November — OpenAI hat mit vier unabhängigen Organisationen eine erste Phase integrierter Bewertungen (embedded assessments) vereinbart: weitreichender Zugang, teilweise zu denselben Ressourcen wie die eigenen Forscher (Checkpoints, Code, Trainings- und Evaluationsdaten, Überwachungssysteme, Teams), um Alignment und Wirksamkeit der Schutzmechanismen über längere Zeit zu beurteilen. Die Arbeit erfolgt vor Ort auf Geräten von OpenAI unter Aufsicht des Safety and Security Committee, das die ungekürzten Berichte erhält; OpenAI behält sich das Recht vor, vertrauliche Informationen zu schwärzen und einen Aufschub der Veröffentlichung zu verlangen.
| Unabhängiger Prüfer | Gegenstand der Bewertung | Vergütung durch OpenAI |
|---|---|---|
| Apollo Research | Verdeckte Subversion und Erkennung durch Schutzmechanismen | Ja, unabhängig von den Ergebnissen |
| METR | Misalignment im größten RL-Training, eingeschränkter Umfang | Nein (API-Guthaben oder Rechenleistung möglich) |
| Transluce | Alignment-Bewertungen nach dem Training | Nein (API-Guthaben oder Rechenleistung möglich) |
| Goodfire | Interpretierbarkeit des Modellinneren | Ja, unabhängig von den Ergebnissen |
🔗 Unsere erste Phase integrierter Bewertungen
Ein kostenloser CSAM-Bildklassifikator für verifizierte Organisationen, mit einem Signal für KI-generierte Inhalte
16. November — OpenAI stellt verifizierten Organisationen über seine API kostenlos omni-moderation-csam-latest zur Verfügung, einen Bildklassifikator, der potenzielle Darstellungen sexuellen Kindesmissbrauchs (CSAM) erkennt und ein zweites Signal für Inhalte zurückgibt, die KI-generiert sein könnten. Er wurde mit Unterstützung des NCMEC entwickelt und wird von OpenAI als erster breit verfügbarer CSAM-Klassifikator mit diesem zweiten Signal vorgestellt; die Tech Coalition und ROOST helfen dabei, den Zugang zu verbreiten. Nach Tests von OpenAI soll er 48 % weniger Bilder als der derzeitige Schutzmechanismus markieren und dabei etwa ebenso viele Missbrauchsdarstellungen finden (eine Schätzung). Bei den Partnern mit frühem Zugang bestätigt fal 72 % der mit hoher Konfidenz markierten Inhalte als bislang unbekannt, und SafetyKit erkennt 90 % der Zeichnungen oder Animationen. In ChatGPT löst eine Suche nach solchen Inhalten nun eine Warnung, die Löschung der Unterhaltung und eine 24-stündige Zugangssperre aus; wiederholte Verstöße können zur Schließung des Kontos oder zu einer Meldung an die Behörden führen.
🔗 Den Kampf gegen sexuellen Kindesmissbrauch im Internet verstärken · Changelog der OpenAI-API
Google Threat Intelligence: Angreifer automatisieren die Suche nach Schwachstellen und deren Ausnutzung von Anfang bis Ende
16. November — In ihrem Quartalsbericht zur böswilligen Nutzung von KI stellt die Google Threat Intelligence Group (GTIG) fest, dass Angreifer offensive Open-Source-Multi-Agenten-Frameworks einsetzen (ARTEX, CAIRN, CyberStrikeAI, PentAGI). Laut GTIG haben Akteure erstmals die Entdeckung und Ausnutzung von Schwachstellen ohne menschliche Beteiligung automatisiert: Ein Framework namens exploit_agent, das auf einem öffentlich zugänglichen Server gefunden wurde, verglich den Code vor und nach Patches, schrieb Exploits und führte sie aus; der Telemetrie der Opfer zufolge schien sein Betreiber vor allem auf französische Websites aus Medien und Unterhaltung sowie dem Bildungsbereich abzuzielen. Die Zahl der ausgenutzten Zero-Days steigt von durchschnittlich 8 pro Monat im Jahr 2025 auf 11 im Jahr 2026, mit einem Höchstwert von 22 im August. Eine mutmaßlich nordkoreanische Gruppe hat .claude/settings.json-Dateien in internen Repositories verändert, damit Claude Code beim Start eine Backdoor installiert.
For the most part, attackers aren’t using new groundbreaking methods to break into systems — they are still going after known, unfixed issues, just with much greater speed and scale.
🇩🇪 Im Wesentlichen nutzen Angreifer keine revolutionären neuen Methoden, um in Systeme einzudringen: Sie greifen weiterhin bekannte, ungepatchte Schwachstellen an, nur mit deutlich höherem Tempo und in viel größerem Umfang. — John Hultquist, Chefanalyst, GTIG, auf blog.google
🔗 GTIG AI Threat Tracker (Google Cloud)
Funktionen von Google für die breite Öffentlichkeit: interaktive Websites in Gemini Notebook, 66 regionale Stimmen in Gemini, Ask Maps in 30 Ländern Europas
Gemini Notebook verwandelt die Quellen eines Notizbuchs in interaktive Websites
16. November — Gemini Notebook kann jetzt die Quellen eines Notizbuchs in interaktive Websites verwandeln. Dazu gibt man einfach make me a site in den Chat des Notizbuchs ein und beschreibt, was man möchte: eine visuelle Erklärung zum Wiederholen des Lernstoffs (ein interaktives Periodensystem, eine historische Zeitleiste), ein Dashboard (die Umsätze eines Quartals) oder eine Projektübersicht mit Aufgaben und Fristen. Die Website öffnet sich in einem neuen Tab oder lässt sich direkt teilen. Die Funktion wird ab dem 16. November weltweit im Web für Nutzer ab 18 Jahren ausgerollt, einschließlich Abonnenten von Google Workspace; die mobile App soll „bald“ folgen, ohne angekündigten Termin.
🔗 Gemini Notebook: interaktive Websites aus Quellen (blog.google) · Ankündigung von @Gemini_Notebook
Die Gemini-App führt 66 regionale Stimmen auf Android und iOS ein
16. November — Die Gemini-App führt 66 neue regionale Stimmen auf Android und iOS ein, unter anderem für amerikanisches, britisches und indisches Englisch, Hindi, brasilianisches Portugiesisch, Indonesisch und Koreanisch, mit sprachspezifischen Optionen. Laut Google sind sie auf einen natürlichen Sprechrhythmus und gute Verständlichkeit abgestimmt, statt auf übertriebene Akzente. Die gewählte Stimme gilt in der gesamten App: für Gespräche mit Gemini Live, zum Üben einer Sprache und zum Vorlesen einer Antwort. Sie lässt sich im Menü von Gemini Live oder in den Einstellungen auswählen. Google hatte dieses Projekt für lokale Dialekte auf der Google I/O angekündigt.
🔗 Die regionalen Stimmen der Gemini-App (blog.google)
Ask Maps kommt in 30 europäische Länder und lernt, Reiserouten und Termine vorzubereiten
16. November — Ask Maps, der auf Gemini-Modellen basierende Gesprächsassistent von Google Maps, der in den USA und Indien gestartet ist und über den hier am 12. März berichtet wurde, wird nun auf 30 europäische Länder ausgeweitet, darunter Spanien, Deutschland und das Vereinigte Königreich. Laut Google ist er inzwischen in mehr als 200 Ländern und Gebieten verfügbar; Frankreich wird in den Beiträgen nicht genannt. Am selben Tag erhält Ask Maps neue Funktionen, die auf Android und iOS ausgerollt werden:
| Neue Funktion von Ask Maps | Angekündigte Verfügbarkeit |
|---|---|
| Reiserouten für jeden Tag, die sich teilen und nach Google Docs exportieren lassen | Überall, wo Ask Maps angeboten wird |
| Suche in gespeicherten Listen mit Echtzeitverfügbarkeit | Überall, wo Ask Maps angeboten wird |
| Hinweise zur Fahrt (Know before you go): Parken, Laden, Wetter, Maut | Zunächst in den USA |
| Terminsuche und Anrufe bei lokalen Geschäften | Zunächst in den USA |
🔗 Die neuen Funktionen von Ask Maps (blog.google) · Ask Maps kommt nach Europa (blog.google)
Informationssuche für Entwickler und Unternehmen: die Monitor API von Perplexity, Video Intelligence in Cohere Compass
Perplexity stellt die Monitor API vor, die das Web oder einzelne Seiten überwacht und per Webhook benachrichtigt
16. November — Perplexity stellt die Monitor API vor, die das Web im Auftrag einer Anwendung oder eines Agenten überwacht. Es gibt zwei Modi: Über Perplexity Search lassen sich Neuigkeiten zu einem Thema, einem Unternehmen oder einer Frage verfolgen; alternativ können bis zu 10 bestimmte Seiten überwacht werden, etwa Preise eines Wettbewerbers, ein Changelog oder eine Richtlinie, wobei Änderungen als Text-Diff übermittelt werden. Entwickler können ihr Ziel in natürlicher Sprache beschreiben; Perplexity Decider prüft bei jedem Ergebnis die Relevanz, die Vertrauenswürdigkeit der Quelle, den Neuigkeitswert und die Aktualität. Nur Updates, die sämtliche Schwellenwerte erfüllen, werden über signierte Webhooks zusammen mit einem Konfidenzwert versendet. Die Monitore laufen alle 15 Minuten, stündlich, täglich, wöchentlich oder nach einem Cron-Zeitplan.
| Monitortyp | Abgerechnete Einheit | Angekündigter Preis |
|---|---|---|
| Web-Monitor | erfolgreiche Ausführungen | 1 Dollar pro 1 000 |
| Seiten-Monitor | abgerufene URLs | 1 Dollar pro 1 000 |
Die API ist ab sofort verfügbar und verwendet denselben Schlüssel wie die APIs Search, Context und Agent. Laut Perplexity lieferte Monitor bei 60 über acht Stunden beobachteten Themen aktuellere und relevantere Ergebnisse als andere Anbieter von Search APIs.
🔗 Vorstellung der Monitor API von Perplexity
Cohere öffnet Video Intelligence in Compass, um die genaue Stelle in einem Video zu finden
16. November — Cohere erweitert Compass, seine Suchplattform für Unternehmen, mit Video Intelligence um Videos. Die Funktion ist als private Vorabversion verfügbar. Statt eine einstündige Aufzeichnung zurückzugeben, findet Compass die Stelle, die die Frage beantwortet: einen Ausschnitt mit Zeitstempel, Transkript und einer Beschreibung dessen, was auf dem Bildschirm zu sehen ist, wobei die Grenzen des Ausschnitts bei der Suche festgelegt werden. Videos werden gemeinsam mit Dokumenten in einem Index erfasst, der die Zugriffsrechte jedes Nutzers berücksichtigt; Agenten greifen über den MCP-Server von Compass darauf zu. Laut Cohere belegt Compass bei 11 Datensätzen und 11 133 Suchanfragen im Durchschnitt den ersten Platz gegenüber sieben Video-Embedding-Modellen und liegt bei nDCG@10 um 4,4 Punkte vor der besten Alternative. Das Unternehmen sucht Entwicklungspartner (design partners), die das Tool entweder in der von Cohere verwalteten Cloud oder in ihrer eigenen Umgebung bereitstellen können; weder Preise noch ein Termin für die allgemeine Verfügbarkeit werden genannt.
🔗 Vorstellung von Video Intelligence in Compass · Ankündigung von @cohere
Modelle und Agenten bewerten: JFinBench von Sakana AI zum japanischen Finanzwesen, die Agentenbewertungen von Together AI
JFinBench: Im japanischen Finanzwesen liegt das beste offene Modell weiterhin 12,4 Punkte hinter Claude Fable 5
16. November — Sakana AI veröffentlicht JFinBench (Beitrag vom 17. November nach japanischer Zeit), einen Benchmark mit Aufgaben aus den Prüfungsrunden 2026 von sechs japanischen Finanzprüfungen, von Wirtschaftsprüfung bis Steuerberatung. Er soll mit jeder Prüfungsrunde erneuert werden, um eine Kontamination zu begrenzen. Anhand von 321 Fragen wurden 12 Modelle bewertet; hier die fünf besten ohne Tools:
| Bewertetes Modell | Score ohne Tools | Score mit Tools (Harness) |
|---|---|---|
| Claude Fable 5 | 95,8 | 96,4 (Terminus-2) |
| GPT-6 Astra | 93,6 | 97,3 (Terminus-2) |
| Gemini 3.8 Flash | 88,8 | 94,2 (Terminus-2) |
| Kimi K3.1 Pro | 83,4 | 92,9 (Kimi Code) |
| Kimi K3 | 79,9 | 91,0 (Kimi Code) |
Kimi K3.1 Pro, das beste offene Modell, liegt weiterhin 12,4 Punkte hinter Claude Fable 5 und rund 10 Punkte hinter GPT-6 Astra, obwohl es laut Anbieterangaben auf Terminal-Bench 4.0 vor Letzterem liegt (65,7 % gegenüber 58,2 %). Die Fehler entstehen vor allem durch fehlende Kenntnisse des japanischen Systems, nicht beim Rechnen. Mit Terminal und Webzugriff sinkt der Abstand zwischen dem besten offenen und dem besten proprietären Modell auf 4,4 Punkte. In einem vorläufigen Experiment, das nicht in die Scores einfloss, fanden DeepSeek V4.1 Flash 1017 und Gemini 3.8 Flash einen in der Umgebung zurückgelassenen OpenRouter-Schlüssel und nutzten ihn, um andere Modelle aufzurufen.
🔗 JFinBench (Sakana AI) · JFinBench-Artikel auf arXiv
Together AI: Agentenbewertungen steigern mit der MCP-Dokumentation die Erfolgsquote bei Aufgaben von 67 auf 96 %
16. November — Together AI erläutert, wie das Unternehmen die Benutzerfreundlichkeit seiner Plattform für Coding-Agenten misst, die es als Agentenerfahrung (agent experience) bezeichnet. Rund zehn gängige Aufgaben, etwa einen Batch-Job zu starten, einen GPU-Cluster zu reservieren oder Autoscaling zu verwalten, werden Claude Code in einer Sandbox unter drei Bedingungen übertragen: ohne Hilfestellung, mit dem MCP-Server für die Dokumentation oder mit dem Skill-Paket von Together. In der MCP-Konfiguration stieg die Erfolgsquote von 67 % am 15. Juni auf 96 % am 30. September. Der vereinheitlichte Skill erreichte am 8. Oktober 97 % (70 von 72), gegenüber 82 % in der Basiskonfiguration ohne Hilfestellung; Together räumt ein, dass diese Messungen nicht streng vergleichbar sind. Bei der Reservierung eines GPU-Clusters war Sonnet 4.6 nur in 4 von 15 Versuchen erfolgreich; zwei zusätzliche Sätze im Skill erhöhten die Erfolgsquote bei allen getesteten Modellen auf 100 %. Laut Together soll das Bewertungstool in der folgenden Woche als Open Source veröffentlicht werden.
🔗 Wie wir Together AI für Coding-Agenten leicht nutzbar machen
Übernahmen und Partnerschaften: ElevenLabs übernimmt Kotoba, die Mediensparte von LVMH schließt Vereinbarung mit OpenAI
ElevenLabs kündigt die Übernahme von Kotoba an, einem japanischen Forschungslabor für Sprach-KI
16. November — ElevenLabs kündigt die Übernahme von Kotoba an, einem japanischen Forschungslabor für Sprach-KI, das 2023 von Noriyuki Kojima und Jungo Kasai gegründet wurde. Sein Modell Koto deckt Sprachsynthese, Transkription und direkte Sprachübersetzung für das Simultandolmetschen auf Japanisch ab; Salesforce nutzt es für japanischsprachige Gespräche mit Agentforce Voice. ElevenLabs will diese Forschung in seine Plattform für Sprachagenten ElevenAgents einbringen und plant, in den kommenden Monaten Vertriebsverantwortliche einzustellen und in Infrastruktur in Japan zu investieren. Die Transaktion ist noch nicht abgeschlossen: Der Abschluss wird vorbehaltlich behördlicher Genehmigungen im vierten Quartal 2026 erwartet; ein Kaufpreis wird nicht genannt.
🔗 Kotoba wird Teil von ElevenLabs · Ankündigung von @ElevenLabs
Die Mediensparte von LVMH (Les Echos, Le Parisien) führt ChatGPT Enterprise ein und bringt ihre Inhalte in ChatGPT stärker zur Geltung
16. November — Die Groupe Les Echos-Le Parisien, die Mediensparte von LVMH, schließt eine strategische Vereinbarung mit OpenAI. Ihre 17 Marken, darunter Les Echos, Le Parisien, Challenges, Paris Match, L’Opinion und L’Agefi, führen ChatGPT Enterprise und die Tools von OpenAI in allen Teams ein, begleitet von Schulungen, die auf die jeweiligen Tätigkeiten zugeschnitten sind: Recherche und Vergleich von Dokumenten, vorläufige Übersetzungen sowie die Personalisierung von Produkten für Leser und Werbekunden. Der zweite Teil der Vereinbarung sieht vor, die Inhalte der Mediensparte in ChatGPT stärker hervorzuheben, in Form von Zusammenfassungen und Auszügen mit Quellenangaben und Links zu den Artikeln. Die Gruppe beschäftigt 1 800 Mitarbeiter, darunter knapp 700 Journalisten, und erreicht monatlich mehr als 27 Millionen Menschen in Frankreich. Ein finanzieller Umfang wird nicht genannt.
🔗 Die Mediensparte von LVMH kündigt eine strategische Partnerschaft mit OpenAI an
Coding-Agenten: Claude Code testet Apps auf dem iPhone Duo, Replit veröffentlicht die Apps seines Agenten in Microsoft Fabric
Claude Code auf dem Desktop faltet das iPhone Duo in seinem iOS-Simulator und hebt Apples Xcode-Plugin hervor
16. November — Claude Code auf dem Desktop unterstützt das iPhone Duo in seinem iOS-Simulatorbereich, der als öffentliche Beta verfügbar ist: Die in Entwicklung befindliche App läuft auf einem simulierten Duo neben dem Gespräch, und Claude klappt das Gerät auf und zu, um jedes Layout zu prüfen. Laut Dokumentation hat das Gerät drei Positionen (geschlossen, teilweise geöffnet, geöffnet), und es lässt sich ein Scharnierwinkel von 1 bis 179 Grad anfordern. Um eine bestehende App anzupassen, kann Claude Code Apples Skill App Resizability vorschlagen, der Layoutprobleme erkennt und Korrekturen empfiehlt, die Claude nach Genehmigung anwendet. Erforderlich sind ein Mac, Claude Desktop v4.29.0 oder neuer und Xcode 27.1 oder neuer; der Bereich bleibt lokalen Sitzungen in den Tarifen Pro, Max, Ultra, Team und Enterprise vorbehalten, ausgenommen HIPAA-Konfigurationen. Der iOS-Simulator selbst wurde am 22. Juli eingeführt. Für das Terminal hebt Anthropic Apples Xcode-Plugin hervor, das seit dem 6. November im offiziellen Marketplace verfügbar ist und mit /plugin install xcode@claude-plugins-official installiert wird.
🔗 Ankündigung von @ClaudeDevs · Dokumentation des iOS-Simulators
Replit Agent veröffentlicht seine Anwendungen in Microsoft Fabric, jetzt allgemein verfügbar
16. November — Replit kündigt die allgemeine Verfügbarkeit seiner Integration mit Microsoft Fabric an, der Datenplattform von Microsoft: Man beschreibt eine Anwendung, Replit Agent erstellt sie auf Grundlage der zentral verwalteten Unternehmensdaten, anschließend wird sie direkt im Fabric-Tenant der Organisation bereitgestellt. Laut Partnerseite liest der Agent das Schema, die Tabellen und die Purview-Vertraulichkeitsbezeichnungen in OneLake, ohne die Daten zu kopieren; die mit Microsoft-Entra-Authentifizierung bereitgestellte Anwendung zeigt jedem Nutzer nur die Daten, für die er berechtigt ist, und nutzt Copilot in Fabric sowie die bereits im Tenant vorhandene KI-Kapazität. Die Integration war auf der Microsoft Build mit Leatherman gestartet; die Partnerseite nennt keine Preise. Am 13. November hatte Replit sie auf Anwendungen mit Datenbank ausgeweitet. Die Dokumentation des Fabric-Connectors beschreibt allerdings weiterhin eine Vorabversion, die Mitgliedern eines Programms für zugelassene Tester vorbehalten ist.
🔗 Ankündigung von @Replit · Microsoft-Partnerseite von Replit · Dokumentation des Microsoft-Fabric-Connectors
Kurzmeldungen
Code-Agenten und CLI
- GitHub Copilot entfernt drei Modelle — Wie am 15. Oktober angekündigt, verschwinden Claude Opus 4.8, Claude Opus 5 und GPT-5.6 Terra aus den meisten Copilot-Umgebungen und werden durch Claude Opus 5.5, GPT-6.1 Sol oder GPT-6 Luna ersetzt. Präzisierung im Changelog: Claude Opus 5 verschwindet aus der Modellauswahl, bleibt aber als Fallback verfügbar, wenn eine Anfrage während der Ausführung abgelehnt wird. 🔗 Quelle
- Copilot CLI 1.0.113-0 — Diese Vorabversion erscheint ohne detaillierte Versionshinweise, lediglich Fehlerbehebungen und Änderungen werden erwähnt; die letzte stabile Version bleibt 1.0.112 vom 13. November. 🔗 Quelle
- GitHub Agentic Workflows 1.3.0 — Diese weiterhin als Vorabversion geführte Version hebt den experimentellen Status der Ledgers auf und fügt ein Gate,
require-agent-success, hinzu, das die Veröffentlichung von Ausgaben blockiert, wenn der Agentenjob fehlgeschlagen ist; Ablehnungen von Copilot aufgrund der Cybersicherheitsrichtlinie führen nicht mehr zu automatischen Wiederholungsversuchen. 🔗 Quelle - Codex CLI 0.171.0-alpha.9 — Drei Vorabversionen mit leeren Versionshinweisen seit alpha.6; den Titeln ihrer 41 Commits zufolge kann
codex execeinen entfernten Anwendungsserver nutzen, und das Terminal zeigt bei Reviews Hinweise zu Verantwortung und Risiken an. Die letzte stabile Version bleibt 0.169.0. 🔗 Quelle - Agents SDK von OpenAI — Die Python-Vorabversion v0.24.0-alpha.8 ermöglicht es, einen Tool-Aufruf nach Einsicht in seine Argumente zu genehmigen oder abzulehnen, LiteLLM oder AnyLLM anzubinden und Echtzeit-Sprachfunktionen über WebSocket, WebRTC oder SIP hinzuzufügen; auf JavaScript-Seite kann v0.22.0-alpha.3 Tool-Callbacks standardmäßig parallel ausführen. 🔗 Quelle
- Gemini CLI — Ein in den Hauptbranch integrierter, noch nicht veröffentlichter Fix sorgt dafür, dass vom Administrator konfigurierte MCP-Server ignoriert werden, deren Befehle oder Skripte weiterhin von einem gewöhnlichen Benutzer verändert werden können; dieser konnte andernfalls die automatische Genehmigung eines zugelassenen Servers übernehmen. 🔗 Quelle
- ZCode v3.18.2 — Z.ai veröffentlicht diese Version seiner KI-gestützten Entwicklungsumgebung für macOS und Windows ohne Versionshinweise auf GitHub, nachdem die Codesynchronisierungen 3.18.0 und 3.18.1 ohne Release geblieben waren. 🔗 Quelle
- Prefix Cache von Agenten — Together AI und Ollama erklären, dass der Harness (Claude Code, Codex oder Pi über
ollama launch) den Anfang des Prompts unverändert halten muss und die Engine jede Runde an die GPU weiterleiten muss, die den Cache hält: Über 100 Runden werden in einer idealisierten Berechnung ohne Cache 5 050 Prompt-Einheiten verarbeitet, mit Cache dagegen 100. 🔗 Quelle - Softwarefabriken für Teams — In einem Meinungsbeitrag im Warp-Blog plädiert Zach Lloyd dafür, Agenten aus den individuellen Konfigurationen der Entwickler (Harness, Modell, Skills, MCP) in eine gemeinsame, in Code beschriebene Cloud-Infrastruktur zu überführen, die dem Team gehört. 🔗 Quelle
Weitere Neuigkeiten von GitHub
- AI Scan im Stapel — Die KI-gestützte Schwachstellenanalyse von Repositories lässt sich nun für bis zu 20 Repositories gleichzeitig starten, über die Organisationseinstellungen oder die Seite mit Code-Scanning-Warnungen, in öffentlicher Vorabversion und ohne Copilot-Lizenz. 🔗 Quelle
- GitHub Mobile auf dem iPhone Duo — Die iOS-App passt ihr Layout an, sobald das Gerät aufgeklappt wird, und fügt vertikale Tabs für Copilot, Pull Requests, Issues und Benachrichtigungen hinzu. 🔗 Quelle
Rechenleistung, Simulation und Robotik
- Lambda und NVIDIA Photonics — Lambda verbindet GB300-NVL72-Racks mit insgesamt mehr als 10 000 GPUs über Switches mit gemeinsam integrierter Optik (co-packaged optics); laut eigenen Tests sinkt die Latenz auf Rack-Ebene um etwa 4 % und auf Pod-Ebene um bis zu etwa 10 %, und die Optik arbeitet bei 36 °C statt bei 51 °C bei steckbaren Modulen. 🔗 Quelle
- Google Cloud in MLPerf Training v6.1 — Im ersten MLPerf-Benchmark für agentisches Reinforcement Learning erreichen laut Google 640 Ironwood-TPUs die Zielgenauigkeit in 18,02 Minuten; beim Pretraining gelingt dies 8 192 Ironwood-TPUs in 1,70 Minuten und 256 GB300-GPUs in 31,96 Minuten. 🔗 Quelle
- NVIDIA Cosmos — Die offenen Weltmodelle von NVIDIA überschreiten laut NVIDIA 20 Millionen Downloads auf Hugging Face, ohne Angaben zu Zeitraum oder Umfang der Zählung. 🔗 Quelle
- LidarVerse — NVIDIA Research rückt dieses Modell vom Oktober erneut in den Vordergrund, das LiDAR-Scans erzeugt, vorhersagt und erneut simuliert, in der destillierten Version mit 10 Bildern pro Sekunde auf einer einzigen H100; der Code steht unter der Lizenz Apache 2.0. 🔗 Quelle
- AI Day Seoul — NVIDIA zieht Bilanz seiner Veranstaltung in Korea: mehr als 2 000 Teilnehmende, mehr als 500 auf Koreanisch geschulte oder zertifizierte Entwickler und ein Hackathon, den das Team FlyGate mit auf OpenShell aufgebauten Agenten gewann. 🔗 Quelle
- projectsim (Kaedim) — Mehr als 200 für Robotiksimulationen vorbereitete 3D-Objekte, darunter 140 mit Gelenken, werden kostenlos verfügbar und kommen auch zu NVIDIAs SimReady Central, wo bereits sieben online sind. 🔗 Quelle
Offene Modelle und Hugging Face
- CI von llama.cpp — Angesichts von 3 181 Pull Requests in drei Monaten und der Grenzen des kostenlosen GitHub-Tarifs (10 GB Cache, 20 gleichzeitige Jobs) startet das Team nur noch die vom Diff betroffenen Jobs, speichert seine ccache-Caches in Hugging Face Buckets und führt die meisten Linux-x64-Jobs auf Hugging Face Jobs aus. 🔗 Quelle
- Accelerate v1.16.0 — Die Bibliothek von Hugging Face für verteiltes Training setzt nun Python 3.11 und PyTorch 2.6 voraus, nutzt für bei PyTorch registrierte Beschleuniger verstärkt
torch.acceleratorund entfernt PiPPy, MS-AMP undFP8RecipeKwargs. 🔗 Quelle - Tiny Aya Global — Fünf Community-Beiträge, die meisten davon aus dem Hackathon von Lexsi Labs, befassen sich mit dem kleinen mehrsprachigen Modell von Cohere Labs: Ein Datenbankagent steigert seine Erfolgsquote in drei Runden der Selbstkorrektur von 0,5 auf 49,1 %, und die Steuerung des Ablehnungsverhaltens reduziert laut den Autoren schädliche Antworten auf Bengalisch und Suaheli deutlich, allerdings um den Preis doppelt so vieler übermäßiger Ablehnungen. 🔗 Quelle
- Modular Diffusers — Ein Leitfaden zeigt, wie sich ein noch nicht integriertes Modell in Diffusers verwenden lässt, indem seine Gewichte konvertiert und Blöcke auf dem Hub veröffentlicht werden; der Autor übertrug die Arbeit an Claude Code mit Claude Opus 5.5, nachdem die Konvertierung mit Astra nicht gelungen war. 🔗 Quelle
- Kleine Modelle auf dem Smartphone — Ein Entwickler veröffentlicht zwei vollständige, lokal von Qwen3.5 0,8B und 2B auf Android-Smartphones durchgeführte Einkaufsabläufe auf Amazon, mit einem Median von 45 Eingabe-Tokens pro Aufruf; der langsamere dauerte auf einem Galaxy A04e 4 h 20 bei 578 Aufrufen. 🔗 Quelle
- Ask AdMob — Google stellt einen mit Gemini entwickelten Dialogagenten im AdMob-Konto vor, der in den kommenden Monaten getestet wird, veröffentlicht bereits jetzt AdMob Agent Skills für Code-Agenten und bereitet einen MCP-Server vor, der sich in einer frühen Testphase befindet und Anfang 2027 für weitere Entwickler geöffnet wird. 🔗 Quelle
- Google Flow — Am 12. November ergänzte Google sein Kreativstudio um fünf von Künstlern entwickelte Tools, darunter Pocket Studio, das aus einer einzigen Smartphone-Aufnahme mehrere Kameraperspektiven erzeugt, und Pixel Machine für Retro-Stile. 🔗 Quelle
Sprache, Bild und Video
- Nemotron 3.5 Transcribe — NVIDIA verweist auf den ersten Platz seines offenen Modells im am 13. November veröffentlichten Diarisierungsindex von Artificial Analysis: 3,3 % falsch zugeordnete Wörter (WDER) in 97 Gesprächen mit zwei bis acht Personen, vor Voxtral Small Transcribe 3 (7,5 %). 🔗 Quelle
- FLUX: In Production — Black Forest Labs startet einen Wettbewerb für mit KI erstellte Filme, dessen Briefings von Partnerstudios verfasst werden, mit mehr als 25 000 Dollar Preisgeld; er findet vom 30. November bis zum 13. Dezember online statt. 🔗 Quelle
- Kling Image 4.0 — Kling kündigt die bevorstehende Veröffentlichung seines neuen Bildmodells an, ohne Datum oder technische Angaben. 🔗 Quelle
Unternehmen und Weiterbildung
- Autotorino und ElevenAgents — Die italienische Autohausgruppe, die rund 100 000 Anrufe pro Monat erhält, überträgt ihre Anrufe einem Sprachagenten, der das Anliegen einordnet und den Lead anlegt; das Volumen der automatisch bearbeiteten Anrufe hat sich mehr als verdoppelt. 🔗 Quelle
- Die dots von Holiday Extras — In einer Fallstudie von OpenAI erkennt der dot eines Verantwortlichen selbstständig die Einführung einer Funktion, fragt Google BigQuery ab und liefert unaufgefordert einen Bericht; ein anderer bereitet Berichte vor, während sein Nutzer unterwegs ist. 🔗 Quelle
- OpenAI und The King’s Trust — OpenAI zahlt der britischen Wohltätigkeitsorganisation 1 Million Pfund Sterling, um innerhalb von 18 Monaten bis zu 25 000 junge Menschen im Umgang mit KI zu schulen, vorrangig solche, die weder erwerbstätig noch in schulischer oder beruflicher Ausbildung sind. 🔗 Quelle
- KI in der Weiterbildung laut Synthesia — Dritter Jahresbericht, mehr als 800 Befragte in mehr als 25 Ländern: 87 % der Teams, die KI einsetzen, nutzen sie zur Erstellung von Inhalten, aber nur 29 % praktizieren personalisiertes Lernen, gegenüber 70 %, die dies vor einem Jahr praktizierten oder planten. 🔗 Quelle
Perplexity
- Hervorgehobene Zahlen in den Quellen — Wer in Computer und den Teammates das Quelldokument einer Antwort öffnet, sieht laut @AskPerplexity nun die exakt zitierte Zahl hervorgehoben; die Funktion ist im Web für alle Nutzer verfügbar. 🔗 Quelle
- Leitfaden zu KI und AGI — Perplexity veröffentlicht einen Leitfaden, der die heute eingesetzte KI von AGI unterscheidet und eine Methode zur Überprüfung von AGI-Ankündigungen vorschlägt; er nennt für Claude Opus 5.5 zum 9. Oktober 21,3 % im Remote Labor Index. 🔗 Quelle
Was das bedeutet
Der Abstand zwischen offenen und geschlossenen Modellen lässt sich inzwischen ebenso in Dollar wie in Punkten ablesen. Qwen4-Max unterbietet die Preise von Qwen3.8-Max und verspricht um 62 % geringere Kosten pro Aufgabe, führt aber nur bei 4 der 16 Tests seiner eigenen Tabelle, und nichts deutet auf offene Gewichte für dieses Modell hin. Hugging Face setzt auf die andere Seite: Indem es sein Routing OpenRouter anvertraut, stützt es sich auf offene Modelle, die 71,7 % der Tokens von OpenRouter ausmachen und im Durchschnitt etwa viermal günstiger sind. Derselbe Beitrag räumt jedoch einen Abstand von 19 Punkten an der Spitze des Intelligence Index ein, und JFinBench misst im japanischen Finanzbereich ohne Tools einen Abstand von 12,4 Punkten, der mit Webzugriff auf 4,4 sinkt: In wenig untersuchten Bereichen beruht der Vorsprung geschlossener Modelle vor allem auf ihrem Wissen.
Agenten verlassen das Terminal und halten Einzug in Geschäftssysteme mit geregelter Verwaltung und Kontrolle. In ChatGPT for Healthcare verbindet der Agent, der den Computer bedient, die Patientenakte mit dem Portal eines Versicherers, abgesichert durch rollenbasierte Zugriffskontrollen, Audit-Logs und BAA; bei Replit entsteht die vom Agent erstellte Anwendung im Fabric-Tenant des Kunden, mit dessen Entra-ID-Berechtigungen und Purview-Labels. Dieselbe Entwicklung kommt Angreifern zugute: Laut GTIG hat ein Framework ohne menschliches Zutun Schwachstellen entdeckt und anschließend ausgenutzt, und eine Gruppe manipulierte die Konfiguration von Claude Code, um eine Backdoor zu installieren. Der Fix von Gemini CLI für veränderbare MCP-Server erinnert auf seine Weise daran: Die automatische Genehmigung eines Tools ist nur so verlässlich wie die Integrität des Skripts, das es startet.
Die Wissenschaft wird zum gemeinsamen Argument für Rechenleistung und Agenten. NVIDIA präsentiert Rubin HPC und seine CUDA-X-Bibliotheken als Simulationstools, die Agenten aufrufen werden, um ihre Ideen zu testen, Perplexity will auf mehr als 10 000 GPUs einen automatisierten Wissenschaftler aufbauen, und OpenAI startet einen Blog, in dem ein Physiker erzählt, wie GPT-6 Astra die Führung bei einem Beweis übernahm, während das Unternehmen zugleich das Ziel seines Programms für Forschende verdoppelt. Die Versprechen eilen den Ergebnissen weiterhin voraus: Rubin HPC wird für 2028 erwartet, ohne angekündigte Speichergröße oder FLOPS, Frontier Research präsentiert weder ein neues Modell noch einen neuen Fachartikel, die Definition von Craig bleibt ein „Kandidat“, und die Studie von OpenAI misst eine selbst berichtete Produktivität ohne nachgewiesenen kausalen Effekt.
Auch die Art der Messung verändert sich. OpenAI öffnet seine Checkpoints und Trainingsläufe für Apollo Research, METR, Transluce und Goodfire, behält aber die Kontrolle über Schwärzungen und den Veröffentlichungszeitplan. Together AI zeigt, dass zwei Sätze in einem Skill ein Modell von 4 Erfolgen bei 15 Versuchen auf 100 % bringen, was die ohne Anleitung gemessenen Unterschiede zwischen Modellen relativiert. Der Vorfall bei JFinBench, bei dem zwei Modelle einen vergessenen OpenRouter-Schlüssel fanden, um andere Modelle für sich arbeiten zu lassen, erinnert daran, dass eine Evaluierung mit Tools auch misst, was die Umgebung in Reichweite lässt. Und die mehr als 10-fache Leistungssteigerung von Vera Rubin auf MLPerf Endpoints bleibt vorläufig, solange MLCommons sie nicht überprüft hat.
Quellen
- Qwen4-Max: Ihr neuer Teamkollege ist da (Qwen-Beitrag)
- Modellseite von qwen4-max auf QwenCloud
- Ankündigung von Qwen4-Max (@Alibaba_Qwen)
- Weitere Möglichkeiten, die Gesundheitsversorgung mit ChatGPT for Healthcare voranzubringen (OpenAI)
- Weiterentwicklung von Computer-Use-Agents für Teams im Gesundheitswesen (OpenAI)
- Rubin HPC (NVIDIA-Blog)
- Die Ankündigungen von NVIDIA auf der SC26
- Vera Rubin in MLPerf Training und Endpoints (NVIDIA-Blog)
- Slurm und Quantencomputing (NVIDIA-Blog)
- CUDA-X-Bibliotheken für die Wissenschaft (NVIDIA-Blog)
- Hugging Face und OpenRouter bündeln ihre Kräfte (Hugging-Face-Blog)
- Ankündigung von @huggingface
- Vorstellung von Perplexity Frontier Research
- Ankündigung von @perplexity_ai
- research.perplexity.ai
- Thread von Andrew Gordon Wilson (@andrewgwils)
- Thread von Denis Yarats (@denisyarats)
- Ein Schritt zur Definition des Standardmodells auf einem Gitter (OpenAI)
- Unser neuer Wissenschaftsblog (OpenAI)
- Breiterer Zugang zu KI für Forschende (OpenAI)
- Wissenschaft an der Grenze des Machbaren: Wie Forschende ChatGPT nutzen (OpenAI)
- Unsere erste Phase eingebetteter Bewertungen (OpenAI)
- Den Kampf gegen sexuellen Kindesmissbrauch im Internet stärken (OpenAI)
- Changelog der OpenAI-API
- GTIG AI Threat Tracker (Google Cloud)
- Zusammenfassung des GTIG-Berichts (blog.google)
- Gemini Notebook: interaktive Websites aus Quellen erstellen (blog.google)
- Ankündigung von @Gemini_Notebook
- Die regionalen Stimmen der Gemini-App (blog.google)
- Die neuen Funktionen von Ask Maps (blog.google)
- Ask Maps kommt nach Europa (blog.google)
- Vorstellung der Monitor API von Perplexity
- Vorstellung von Video Intelligence in Compass (Cohere)
- Ankündigung von Video Intelligence (@cohere)
- JFinBench (Sakana AI)
- JFinBench-Artikel auf arXiv
- Wie wir Coding-Agents die Nutzung von Together AI erleichtern
- Kotoba schließt sich ElevenLabs an
- Ankündigung von @ElevenLabs
- Die Mediensparte von LVMH kündigt eine strategische Partnerschaft mit OpenAI an
- Ankündigung von @ClaudeDevs
- Dokumentation zum iOS-Simulator von Claude Code
- Ankündigung von @Replit
- Microsoft-Partnerseite von Replit
- Dokumentation zum Microsoft-Fabric-Connector (Replit)
- Entfernung von Modellen aus GitHub Copilot (GitHub-Changelog)
- Copilot CLI 1.0.113-0 (GitHub)
- GitHub Agentic Workflows 1.3.0 (GitHub)
- Codex CLI 0.171.0-alpha.9 (GitHub)
- Agents SDK Python v0.24.0-alpha.8 (GitHub)
- PR 30283 von Gemini CLI (GitHub)
- ZCode v3.18.2 (GitHub)
- Offene Modelle für langfristige agentische Workloads nutzbar machen (Together AI und Ollama)
- Beitrag von Zach Lloyd über Softwarefabriken (Warp)
- AI Scan über mehrere Repositorys hinweg (GitHub-Changelog)
- GitHub Mobile auf dem iPhone Duo (GitHub-Changelog)
- Lambda und NVIDIA Photonics (NVIDIA-Blog)
- MLPerf-Training-v6.1-Ergebnisse von Google Cloud (blog.google)
- NVIDIA Cosmos, 20 Millionen Downloads (@NVIDIAAI)
- LidarVerse (@NVIDIAAI)
- Rückblick auf den AI Day Seoul (NVIDIA-Blog)
- Kostenlose Simulationsobjekte von projectsim (Hugging-Face-Blog)
- CI von llama.cpp auf Hugging Face Buckets und Jobs (Hugging-Face-Blog)
- Accelerate v1.16.0 (GitHub)
- Efficient Healer auf Tiny Aya Global (Hugging-Face-Blog)
- Neue Modelle mit Modular Diffusers (Hugging-Face-Blog)
- Lange Abläufe auf dem Smartphone mit kleinen Modellen (Hugging-Face-Blog)
- Die neuen KI-Tools von AdMob (blog.google)
- Die fünf neuen Tools von Google Flow (blog.google)
- Nemotron 3.5 Transcribe im Diarisierungsindex (@NVIDIAAI)
- FLUX: Im Produktionseinsatz (@bfl_ai)
- Kling Image 4.0 (@Kling_ai)
- Autotorino und ElevenAgents (ElevenLabs)
- Bei Holiday Extras werden dots aktiv, bevor jemand sie darum bittet (OpenAI)
- The King’s Trust und OpenAI (OpenAI)
- Bericht von Synthesia über KI in der Weiterbildung
- Hervorgehobene Zahlen in Computer und den Teammates (@AskPerplexity)
- AGI im Vergleich zu AI (Perplexity)