ai-powered-markdown-translatorArtigo traduzido do fr para o pt com gpt-6.1-sol.
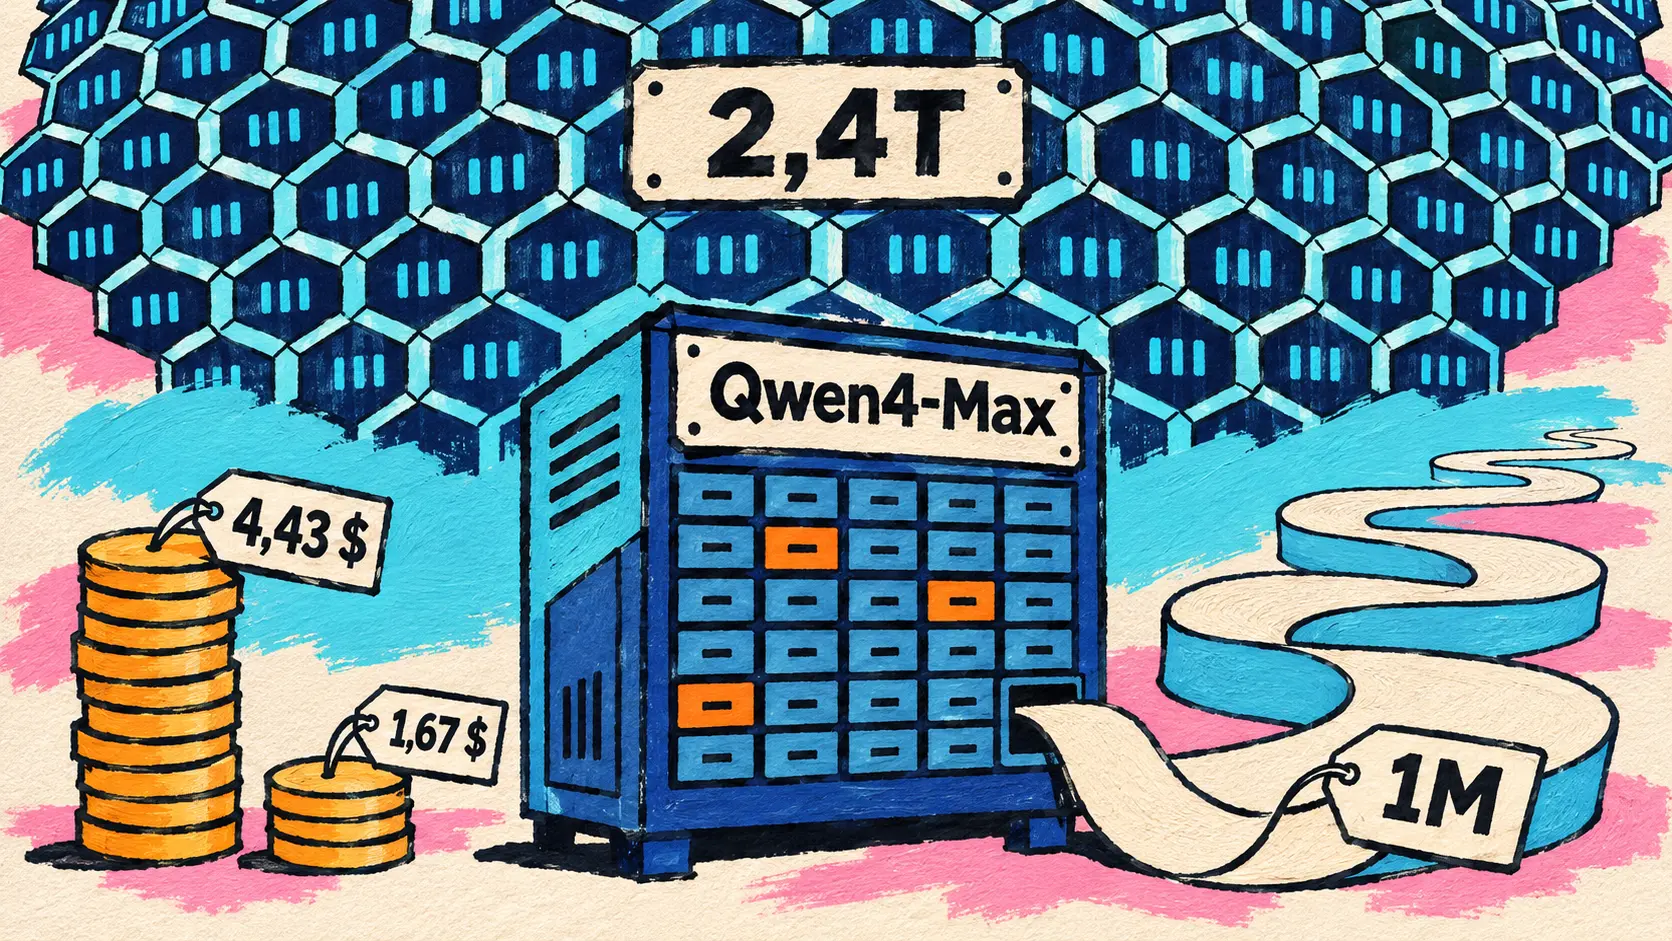
A Qwen disponibiliza o Qwen4-Max na sua API: um modelo MoE de 2,4T parâmetros, com um contexto de 1M tokens, a um preço inferior ao do Qwen3.8-Max. A OpenAI alarga os seus agentes que controlam o computador ao ChatGPT for Healthcare e ao ChatGPT for Clinicians, a NVIDIA anuncia na SC26 o Rubin HPC, um GPU de simulação previsto para 2028, com os primeiros resultados de Vera Rubin no MLPerf Training, e a Hugging Face confia à OpenRouter o encaminhamento dos seus Inference Providers. Por sua vez, a Perplexity lança o Perplexity Frontier Research, que visa criar um cientista automatizado com mais de 10 000 GPU.
Qwen4-Max chega à API da QwenCloud: MoE de 2,4T parâmetros, contexto de 1M tokens, preços mais baixos
16 de novembro — Cinco dias após a versão preliminar abordada a 11 de novembro, a Qwen disponibiliza o Qwen4-Max na API da QwenCloud com o identificador qwen4-max, acompanhado de um extenso artigo técnico. É o primeiro modelo da série Qwen4: serão lançados modelos Qwen4 mais pequenos com pesos abertos, sem data definida, mas não há qualquer anúncio nesse sentido para o Max. O modelo também está disponível no QwenWork, no Qoder e no Qwen Studio, e, desde o próprio dia, na OpenRouter, na Vercel AI Gateway, na Novita AI e no OpenCode Go.
A arquitetura é nova. Esta mistura de especialistas (Mixture of Experts, MoE) conta com 2,4T parâmetros na estrutura principal, dos quais 71B são ativados por token, mais 328B parâmetros de N-gram Embedding. Em cada quatro camadas, três Gated DeltaNet comprimem o histórico num estado de tamanho fixo; a quarta, com Qwen Sparse Attention, seleciona o contexto útil por blocos. O modelo tem visão nativa e um contexto de 1M tokens: 991K de entrada e 131K de saída, 983K e 262K em modo de raciocínio, segundo a página da QwenCloud.
| Tipo de tarifa (QwenCloud, por milhão de tokens) | Preço anunciado |
|---|---|
| Entrada | 1,5 dólar |
| Saída | 4,5 dólares |
| Entrada em cache implícita | 0,075 dólar |
| Criação de cache explícita (5 minutos / 1 hora) | 1,875 / 3 dólares |
Segundo a Qwen, todas estas tarifas são inferiores às do Qwen3.8-Max, com a cache implícita a baixar 70 %. Nas suas avaliações internas, a Qwen anuncia também uma redução do consumo de tokens de 24 a 35 %, consoante o nível de esforço, no Work360, o seu quadro de avaliação de 721 especialidades profissionais, e de cerca de 48 a 49 % no Terminal-Bench 4.0. O custo médio de uma tarefa Work360 passa de 4,43 para 1,67 dólares, ou seja, −62 % segundo o artigo em inglês; a versão chinesa, em yuans, indica −58 %. No Work360, o Qwen4-Max obtém 52,69 contra 47,74 do Qwen3.8-Max.
Perante o Opus 5.5, o GPT-6.1 Sol, o GPT-6 Astra e o Kimi K3.1, a tabela publicada pela Qwen apresenta resultados variados: o Qwen4-Max lidera apenas 4 dos 16 testes, DeepSWE v1.1, Agents’ Last Exam v1.1, HLAB-Vals-1.1 e BioMysteryBench. Seleção:
| Benchmark (área) | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|
| DeepSWE v1.1 (código agêntico) | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| HLAB-Vals-1.1 (agente jurídico) | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| BioMysteryBench (bioinformática) | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| Terminal-Bench 4.0 (terminal agêntico) | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench (replicação de software) | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| Humanity’s Last Exam | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
As classificações de terceiros divulgadas pela Qwen colocam-no em 6.º lugar no Code Arena WebDev (1 750 pontos preliminares) e em 11.º no Vals Index (63,20 %), como primeiro modelo chinês. A Artificial Analysis atribui-lhe 43 pontos no seu Intelligence Index com esforço xhigh, 3 pontos atrás do Kimi K3.1 Pro, com um custo por tarefa cerca de 11 % mais baixo.
More to come! The open weights of smaller Qwen4 models will be released. Stay tuned.
🇵🇹 Ainda não acabou! Serão publicados os pesos abertos de modelos Qwen4 mais pequenos. Fiquem atentos. — @Alibaba_Qwen no X
🔗 Qwen4-Max: O seu novo colega de equipa chegou (artigo da Qwen) · Ficha do qwen4-max na QwenCloud
ChatGPT for Healthcare: agentes que controlam o computador, investigação clínica e mais de 20 plugins de saúde
16 de novembro — A OpenAI expande o ChatGPT for Healthcare em três direções. Primeiro, os agentes de utilização do computador (computer-use agents), que leem o ecrã, clicam, escrevem e passam de uma aplicação para outra, chegam ao ChatGPT Work e ao Codex para os clientes do ChatGPT for Healthcare, consoante as definições do seu espaço de trabalho, e para os profissionais clínicos do ChatGPT for Clinicians, a oferta gratuita reservada a profissionais clínicos verificados nos Estados Unidos. A mesma capacidade está acessível na API. O caso típico: fazer circular informação entre programas que não comunicam entre si, como o processo clínico eletrónico e o portal de uma seguradora para um pedido de autorização de ressonância magnética. A utilização do computador já existia no ChatGPT Work e no Codex desde 9 de julho; a novidade é a sua disponibilização nos espaços de trabalho de saúde, com controlos de acesso por função, registos de auditoria e etapas de aprovação configuráveis. Os fluxos em conformidade com a HIPAA continuam limitados aos serviços elegíveis abrangidos por um BAA.
A OpenAI publica dois conjuntos de números, que devem ser lidos separadamente: a sua avaliação interna sobre as mensagens do processo clínico e o HealthAdminBench, um benchmark independente de investigadores de Stanford dedicado às tarefas administrativas (autorizações prévias, recursos, encomendas de equipamento).
| Avaliação publicada | Modelo e configuração | Resultado anunciado |
|---|---|---|
| Mensagens do processo clínico (OpenAI, 325 tarefas revistas) | GPT-6 Astra | 99 % das tarefas consideradas clinicamente seguras |
| Mesma avaliação, 646 classificações de médicos | GPT-6 Astra | 93 % «muito» ou «extremamente» útil |
| HealthAdminBench (Stanford) | GPT-6 Astra, esforço máximo | 94,3 % dos pontos da grelha |
| HealthAdminBench (Stanford) | GPT-6 Luna, esforço máximo | 91,8 %, por 8,5 cêntimos por tarefa |
No HealthAdminBench, o GPT-6 Luna obtém 91,8 % com um custo 98 % inferior, ou seja, 8,5 cêntimos por tarefa. No terreno, a CVS Health já utiliza estes agentes em produção: um eliminou num fim de semana um atraso no envio de documentos acumulado ao longo de meses, outro gere as etapas nos sistemas de dezenas de milhares de consultas por dia, e a empresa publica em open source o seu Agent Kit, construído com o Agents SDK da OpenAI. A Cigna Healthcare afirma ter passado do conceito à implementação em menos de oito semanas; na Ambience, o agente para e pede a opinião do profissional clínico quando o processo é ambíguo; a Abridge desenvolve agentes para o hospital.
Seguem-se as outras duas vertentes. A investigação clínica, que encontra, avalia e cita evidências médicas, recebe melhores classificações nas oito dimensões medidas numa avaliação cega com mais de 1 300 análises de médicos. E 21 novos plugins de saúde (UpToDate Expert AI, Oracle HDI, Trizetto, Stedi, Luma Health, Metriport…) permitem consultar um protocolo, verificar a elegibilidade de um seguro ou coordenar marcações a partir da conversa; o administrador do espaço de trabalho tem de os ativar, e o ChatGPT for Clinicians recebe apenas uma parte deles.
🔗 Mais formas de fazer avançar os cuidados com o ChatGPT for Healthcare · Avanços nos agentes de utilização do computador para equipas de saúde
NVIDIA na SC26: Rubin HPC para simulação científica, Vera Rubin no MLPerf, Slurm para processadores quânticos e bibliotecas CUDA-X
16 de novembro — Na conferência de computação de alto desempenho SC26, a NVIDIA lança uma série de anúncios orientados para a ciência. O principal é o Rubin HPC, um novo GPU da plataforma Vera Rubin concebido para simulação e processamento de dados em ciência, engenharia e análise de dados, em áreas como o clima, a genómica ou o risco financeiro.
A ficha publicada continua sucinta. A NVIDIA destaca mais de 50 000 núcleos CUDA num único GPU, um número «recorde» segundo a empresa, uma aceleração de dados esparsos (sparse data acceleration) destinada a manter esses núcleos alimentados e uma ligação NVLink de sétima geração entre GPU. Não são mencionados a capacidade de memória, a potência em FLOPS, o preço ou qualquer parceiro.
O argumento central é o equilíbrio. Segundo a NVIDIA, a maioria das cargas de trabalho científicas consiste em ir buscar alguns valores dispersos num enorme conjunto de dados, calcular e repetir o processo a uma escala muito grande. O Rubin HPC faz, por isso, crescer a movimentação de dados ao ritmo do cálculo, para acelerar operações sobre matrizes esparsas, cálculos de stencil, ordenações e reduções. A NVIDIA associa este GPU ao seu discurso sobre agentes: um agente que explora mais moléculas, materiais ou conceções precisa de mais simulações para testar as suas ideias, e as bibliotecas CUDA-X fornecem-lhe as implementações otimizadas. O horizonte é distante: o Rubin HPC está previsto para 2028.
| Característica anunciada | Valor indicado pela NVIDIA |
|---|---|
| Núcleos CUDA | mais de 50 000 num único GPU |
| Interligação entre GPU | NVLink de sétima geração |
| Função específica | aceleração de dados esparsos |
| Disponibilidade prevista | 2028 |
🔗 Rubin HPC (blog da NVIDIA) · Os anúncios da NVIDIA na SC26
Vera Rubin estreia-se no MLPerf Training v6.1 e no MLPerf Endpoints, com até 2 vezes o desempenho do GB300 NVL72 por GPU
16 de novembro — O ciclo MLPerf Training v6.1 marca a primeira participação do Vera Rubin NVL72 no treino: até 2 vezes o desempenho por GPU de um GB300 NVL72, resultados que a NVIDIA apresenta como preliminares. No DeepSeek-V3, passar de 256 para 1 024 GPU Vera Rubin mantém cerca de 97 % de eficiência e reduz o treino de 16 minutos para cerca de quatro. A maior configuração do ciclo conta com 10 240 GPU, em GB300 na NVIDIA e em GB200 na Microsoft Azure. Segundo a NVIDIA, a sua plataforma é a única com resultados em todos os testes.
A NVIDIA apresenta também a sua primeira submissão ao MLPerf Endpoints v1.0, que mede fluxos de trabalho agênticos reais. No Kimi K3, o Vera Rubin NVL72 proporcionaria mais de 10 vezes o débito por watt de um GB300 NVL72 à mesma velocidade de resposta: um resultado provisório, a aguardar verificação pela MLCommons, que compara 32 aceleradores Vera Rubin com 48 aceleradores GB300 no limiar de 50 tokens por segundo e por utilizador. O Vera Rubin já tinha aparecido em versão preliminar no MLPerf Inference, abordado a 16 de setembro.
🔗 Vera Rubin no MLPerf Training e no Endpoints (blog da NVIDIA)
Slurm 26.11 irá integrar os processadores quânticos, CUDA-Q ganha novas funcionalidades
16 de novembro — A NVIDIA alarga o Slurm, o gestor de tarefas dos supercomputadores, aos processadores quânticos (QPU). Até agora, ligar um QPU a um centro de computação exigia um desenvolvimento específico para cada par processador-centro; a partir de agora, um fabricante descreve o seu hardware num simples ficheiro e obtém uma interface válida em qualquer local, através das interfaces QRMI e QDMI. Alice & Bob, IBM, IQM, Pasqal, Quantinuum e MQSC adotam-na, e o Slurm 26.11 deverá ser lançado mais tarde em novembro. A NVIDIA justifica este trabalho com o crescimento da infraestrutura instalada: cerca de 30 centros de computação estão a implementar mais de 50 QPU.
A plataforma CUDA-Q ganha um servidor de descodificação para a correção de erros quânticos (CUDA-Q QEC), cujo descodificador TCBP-JOBS seria 13 000 vezes mais rápido do que a referência do setor, primitivas tolerantes a falhas (o Fermilab já realizou com CUDA-Q, em três semanas, estudos que teriam demorado cinco meses), bem como CUDA-Q Algorithms e CUDA-Q Pulse para os fabricantes de hardware. Estes ganhos são os anunciados pela NVIDIA.
🔗 Slurm e a computação quântica (blog da NVIDIA)
CUDA-X para a ciência: cuSpa e HMMER em GPU em open source, correlação dos dados do Event Horizon Telescope em oito minutos
16 de novembro — A NVIDIA acompanha o Rubin HPC com bibliotecas CUDA-X para investigação, apresentadas como ferramentas que os agentes podem invocar. Em astronomia, o módulo cuPhoton.xBeam reduz a correlação das observações do Event Horizon Telescope de mais de um mês para oito minutos, tanto num cluster multi-GPU como num DGX Spark. Em biologia, o cuSpa, agora em open source, torna os cálculos de polígonos celulares 900 vezes mais rápidos do que em CPU no Memorial Sloan Kettering Cancer Center, e a versão GPU do HMMER, também em open source, é até 84 vezes mais rápida na Basecamp Research. O rapids-singlecell é agora distribuído num contentor «pronto para agentes» (200 vezes mais rápido na Therna Biosciences). Em química, o Daviator, uma coleção de kernels GPU para o software VASP, chega ao NVIDIA ALCHEMI com cálculos até 22 vezes mais rápidos e até 75 % mais baratos, mas ainda não está disponível; o cuPotential, lançado a 14 de outubro, ganha cinco utilizadores, entre os quais a Cadence.
🔗 Bibliotecas CUDA-X para a ciência (blog da NVIDIA)
Hugging Face confia à OpenRouter o encaminhamento dos modelos de linguagem dos seus Inference Providers
16 de novembro — A Hugging Face e a OpenRouter unem-se: os Inference Providers da Hugging Face abandonam o seu router próprio e deixam a OpenRouter escolher o fornecedor de cada chamada a um modelo de linguagem. Clément Delangue apresenta o anúncio como a primeira parte da parceria. Nada muda no código cliente: o mesmo token Hugging Face, o mesmo endpoint. O router aceita as API Chat Completions e Responses da OpenAI, bem como a API Messages da Anthropic, e a Hugging Face publica guias para Claude Code, Codex, OpenCode, Pi e Hermes Agent.
A diferença está no encaminhamento. O Inference Providers escolhia um fornecedor e devolvia o erro tal como o recebia; a OpenRouter escolhe em função do preço, da velocidade e da fiabilidade medidos em tempo real, e repete a chamada noutro fornecedor se o primeiro falhar. Os sufixos impõem uma política ou um fornecedor (:fastest, :cheapest, zai-org/GLM-5.3:novita), e uma conversa permanece no fornecedor que detém a sua cache de prompt.
| Alteração anunciada | Detalhe segundo o artigo |
|---|---|
| Erros de capacidade (medição da OpenRouter) | −46 % |
| Tempo até ao primeiro token e débito (medição da OpenRouter) | melhorado em 16,9 % e +16,3 % |
| Faturação | preço do fornecedor, sem margem acrescentada pela Hugging Face |
| Créditos mensais incluídos | 2 dólares (PRO), 2 dólares por lugar (Team, Enterprise) |
| Páginas dos modelos | separadores Providers e Metrics: preço, velocidade, disponibilidade em 24 horas |
| Alteração incompatível | chaves API pessoais de fornecedores rejeitadas para modelos de linguagem |
A imagem, o vídeo e o áudio continuam a passar diretamente pelo Inference Providers, sem a OpenRouter, e as chaves pessoais continuam válidas para os fornecedores de imagem e vídeo. A ligação de uma conta OpenRouter à Hugging Face e o encaminhamento de outras tarefas através da OpenRouter estão anunciados para mais tarde, sem data.
O artigo baseia-se nos números da OpenRouter: os modelos abertos representavam 71,7 % dos tokens servidos no final de setembro de 2026, contra 26,8 % em outubro de 2025, a um preço médio de 0,28 e 1,62 dólares por milhão de tokens (entrada, saída), contra 1,27 e 6,36 dólares para os modelos fechados. Reconhece também a diferença no topo da classificação: Kimi K3.1 Pro, o melhor modelo aberto, obtém 46 no Artificial Analysis Intelligence Index contra 65 para Claude Fable 5.2, por cerca de um sétimo do custo por tarefa (3,68 contra 26,54 dólares).
🔗 Hugging Face e OpenRouter unem forças (blog da Hugging Face) · Anúncio de @huggingface
Perplexity Frontier Research: uma iniciativa de investigação aberta que visa um cientista automatizado, com mais de 10 000 GPU
16 de novembro — A Perplexity lança Perplexity Frontier Research, uma iniciativa cujo objetivo é construir um «investigador científico automático» (automatic research scientist): um sistema de IA capaz de conduzir sozinho o ciclo da investigação, da pergunta à hipótese, da experiência à revisão das suas convicções. A Perplexity contrapõe esta ambição às previsões de «caixa negra» em tarefas restritas: trata-se de produzir conhecimentos novos e interpretáveis.
We aim to create an automated research scientist. Research is a loop that involves asking the right questions, hypothesizing, navigating ambiguity, designing experiments, and updating beliefs. We think this loop can run inside software, for anyone.
🇵🇹 Queremos criar um investigador científico automatizado. A investigação é um ciclo que consiste em fazer as perguntas certas, formular hipóteses, lidar com a ambiguidade, conceber experiências e rever as convicções. Acreditamos que este ciclo pode funcionar num software, para todos. — @andrewgwils no X
O programa organiza-se em seis pilares: orquestração multiagente, pré-treino, aprendizagem contínua, aprendizagem por reforço, sistemas e avaliações. O site dedicado especifica que a equipa fará o pré-treino de modelos com pesos abertos, eficientes e especializados, e que procura obter, na orquestração, a melhor qualidade para cada nível de custo. Denis Yarats destaca a aprendizagem por reforço em grande escala, com mais de 10 000 GPU, alimentada por dados sintéticos e ambientes derivados da utilização real da Perplexity; toda a infraestrutura, da investigação às sandboxes, é desenvolvida internamente.
| Elemento do anúncio | Compromisso da Perplexity |
|---|---|
| Capacidade de computação | mais de 10 000 GPU |
| Pilares de investigação | 6 |
| Publicações prometidas | artigos, publicações no blog, dados, modelos e código |
| Cidades de recrutamento | San Francisco, Palo Alto, New York, Londres |
| Prazo prioritário de candidatura | 5 de dezembro |
Andrew Gordon Wilson é apresentado no site como responsável pela investigação da iniciativa. O anúncio é também um convite à apresentação de candidaturas, acompanhado de uma bolsa de investigação para percursos pré-doutorais e pós-doutorais. Nenhum modelo, benchmark ou artigo novo acompanha o lançamento: o site reúne sob a designação Frontier Research trabalhos já publicados, como WANDR, Decider, SPACE, Brain ou JOLT.
🔗 Apresentação de Perplexity Frontier Research · Anúncio de @perplexity_ai · research.perplexity.ai · Sequência de publicações de @denisyarats
IA e investigação científica na OpenAI: um blog dedicado inaugurado pelo físico Nathaniel Craig, ChatGPT for Academic Researchers alargado a 200 000 investigadores
Um blog científico, inaugurado por uma definição candidata do Modelo Padrão numa rede, construída com GPT-6 Astra
15 de novembro — A OpenAI inaugura um blog dedicado à ciência, onde investigadores e equipas partilharão resultados e métodos, incluindo a forma de verificar o trabalho. O primeiro artigo de um convidado é assinado por Nathaniel Craig, físico de partículas na Universidade da Califórnia em Santa Barbara e cientista convidado na OpenAI.
Nele apresenta um preprint de outubro, preparado com GPT-6 Astra, que propõe uma definição candidata do Modelo Padrão numa rede, uma grelha que discretiza o espaço-tempo. Como a força fraca distingue as partículas «esquerdas» das «direitas», a formulação numa rede faz surgir parceiros parasitas, e a regra de fase continuava em aberto para o Modelo Padrão completo há mais de 25 anos. Segundo Craig, GPT-6 Astra descobriu como transportar os campos para grelhas mais finas e assumiu a liderança da demonstração detalhada, posteriormente revista por três especialistas. O autor mantém a prudência: a definição é «candidata», válida sob um limite para a intensidade dos campos, e constitui mais uma resposta de princípio do que uma ferramenta de simulação.
🔗 Um passo para definir o Modelo Padrão numa rede · O nosso novo blog dedicado à ciência
ChatGPT for Academic Researchers visa 200 000 investigadores, um estudo abrange 1 819 cientistas
16 de novembro — Lançado em julho com um objetivo de 100 000 investigadores, o programa ChatGPT for Academic Researchers visa agora 200 000. A próxima fase abre na segunda-feira, 23 de novembro: 50 000 bolsas atribuídas aos primeiros candidatos elegíveis, deixando de ser por sorteio, cada uma abrangendo o titular e até dois colaboradores, ou seja, até 150 000 pessoas. O acesso passa de ChatGPT Pro para ChatGPT Plus: segundo a OpenAI, a maioria dos participantes do projeto-piloto terá permanecido dentro dos limites do Plus.
A equipa de investigação económica da OpenAI publica, em paralelo, um estudo sobre 580 186 mensagens de 1 819 cientistas, complementado por um inquérito a 251 deles. Os participantes estimam que o mesmo trabalho, com a mesma qualidade, lhes teria levado cerca de 1,9 vezes mais tempo sem IA, e 98 % dos inquiridos esperam que a IA acelere as descobertas na sua área. A OpenAI salienta as limitações: produtividade declarada, expectativas em vez de resultados, nenhum efeito causal estabelecido.
| Utilização do ChatGPT pelos cientistas | Proporção média das mensagens |
|---|---|
| Leitura e aprendizagem | 28 % |
| Escrita e comunicação | 27 % |
| Análise de provas e teorias | 17 % |
| Escrita de software de investigação | 14 % |
🔗 Alargar o acesso dos cientistas à IA · Ciência na fronteira: como os cientistas utilizam o ChatGPT
Segurança e proteção da IA: avaliadores independentes na OpenAI, classificador CSAM aberto, ataques agênticos observados pela Google
OpenAI dá acesso aos seus modelos internos à Apollo Research, METR, Transluce e Goodfire
16 de novembro — A OpenAI acordou com quatro organizações independentes uma primeira fase de avaliações integradas (embedded assessments): um acesso aprofundado, por vezes aos mesmos recursos que os seus investigadores (checkpoints, código, dados de treino e avaliação, sistemas de monitorização, equipas), para avaliar o alinhamento e a eficácia dos mecanismos de proteção ao longo do tempo. O trabalho decorre nas instalações, em dispositivos da OpenAI, sob a supervisão do Safety and Security Committee, que recebe os relatórios sem supressões; a OpenAI reserva-se o direito de suprimir informações confidenciais e de solicitar um adiamento da publicação.
| Avaliador independente | Objeto da avaliação | Remuneração pela OpenAI |
|---|---|---|
| Apollo Research | Subversão oculta e deteção pelos mecanismos de proteção | Sim, sem relação com os resultados |
| METR | Desalinhamento no maior treino RL, âmbito reduzido | Não (possíveis créditos API ou recursos de computação) |
| Transluce | Avaliações de alinhamento pós-treino | Não (possíveis créditos API ou recursos de computação) |
| Goodfire | Interpretabilidade dos mecanismos internos dos modelos | Sim, sem relação com os resultados |
🔗 A nossa primeira fase de avaliações integradas
Um classificador de imagens CSAM gratuito para organizações verificadas, com um sinal para conteúdos gerados por IA
16 de novembro — A OpenAI disponibiliza gratuitamente às organizações verificadas, através da sua API, omni-moderation-csam-latest, um classificador de imagens que identifica potenciais conteúdos de abuso sexual infantil (CSAM) e devolve um segundo sinal para os que possam ter sido gerados por IA. Concebido com a ajuda do NCMEC, é apresentado pela OpenAI como o primeiro classificador CSAM amplamente disponível com este segundo sinal; a Tech Coalition e a ROOST ajudam a alargar o acesso. Segundo os testes da OpenAI, sinalizaria menos 48 % de imagens do que a proteção atual, identificando aproximadamente o mesmo número de casos de abuso (uma estimativa). Entre os parceiros com acesso antecipado, a fal confirma como inéditos 72 % dos conteúdos sinalizados com elevado grau de confiança, e a SafetyKit deteta 90 % dos desenhos ou animações. No ChatGPT, uma pesquisa por este tipo de conteúdo desencadeia agora um aviso, a eliminação da conversa e uma suspensão do acesso durante 24 horas; a reincidência pode levar ao encerramento da conta ou a uma denúncia às autoridades.
🔗 Reforçar o combate ao abuso sexual infantil na Internet · Changelog da API OpenAI
Google Threat Intelligence: atacantes automatizam de ponta a ponta a pesquisa e a exploração de vulnerabilidades
16 de novembro — No seu balanço trimestral sobre a utilização maliciosa da IA, o Google Threat Intelligence Group (GTIG) constata que os atacantes utilizam frameworks ofensivos multiagente open source (ARTEX, CAIRN, CyberStrikeAI, PentAGI). Pela primeira vez, segundo o GTIG, os atacantes automatizaram a descoberta e a exploração de vulnerabilidades sem intervenção humana no ciclo: um framework denominado exploit_agent, encontrado num servidor exposto, comparava o código antes e depois das correções, escrevia os exploits e executava-os; segundo a telemetria das vítimas, o seu operador parecia visar sobretudo sites franceses de comunicação social e entretenimento, bem como de educação. As vulnerabilidades zero-day exploradas passam de 8 por mês, em média, em 2025 para 11 em 2026, com um pico de 22 em agosto. Um grupo supostamente norte-coreano modificou ficheiros .claude/settings.json em repositórios internos para que o Claude Code instalasse uma backdoor no arranque.
For the most part, attackers aren’t using new groundbreaking methods to break into systems — they are still going after known, unfixed issues, just with much greater speed and scale.
🇵🇹 Essencialmente, os atacantes não utilizam novos métodos revolucionários para entrar nos sistemas: continuam a atacar vulnerabilidades conhecidas e por corrigir, apenas com muito mais velocidade e escala. — John Hultquist, analista-chefe, GTIG, no blog.google
🔗 GTIG AI Threat Tracker (Google Cloud)
Funcionalidades da Google para o público em geral: sites interativos no Gemini Notebook, 66 vozes regionais no Gemini, Ask Maps em 30 países da Europa
Gemini Notebook transforma as fontes de um caderno em sites interativos
16 de novembro — O Gemini Notebook já consegue transformar as fontes de um caderno em sites interativos. Basta escrever make me a site no chat do caderno, com a descrição do que se pretende: uma explicação visual para rever a matéria (uma tabela periódica interativa, uma cronologia histórica), um painel de controlo (as vendas de um trimestre) ou um acompanhamento de projeto com as suas tarefas e os seus prazos. O site abre num novo separador ou pode ser partilhado diretamente. A funcionalidade começa a ser disponibilizada em todo o mundo na web a partir de 16 de novembro para os utilizadores com 18 anos ou mais, incluindo os subscritores do Google Workspace; a aplicação móvel chegará «em breve», sem data anunciada.
🔗 Gemini Notebook: sites interativos a partir das fontes (blog.google) · Anúncio de @Gemini_Notebook
A aplicação Gemini disponibiliza 66 vozes regionais no Android e iOS
16 de novembro — A aplicação Gemini disponibiliza 66 novas vozes regionais no Android e iOS, nomeadamente em inglês americano, britânico e indiano, em hindi, em português do Brasil, em indonésio e em coreano, com opções específicas para cada língua. A Google afirma que foram ajustadas para cadências naturais e uma boa clareza, em vez de sotaques exagerados. A voz escolhida aplica-se a toda a aplicação: conversas com Gemini Live, prática de uma língua, leitura de uma resposta em voz alta. É escolhida através do menu do Gemini Live ou nas definições. A Google já tinha anunciado este projeto de dialetos locais no Google I/O.
🔗 As vozes regionais da aplicação Gemini (blog.google)
Ask Maps chega a 30 países da Europa e aprende a preparar itinerários e marcações
16 de novembro — Ask Maps, o assistente de conversação do Google Maps baseado nos modelos Gemini, lançado nos Estados Unidos e na Índia e abordado aqui a 12 de março, começa a expandir-se para 30 países da Europa, incluindo Espanha, Alemanha e Reino Unido. A Google afirma que já está presente em mais de 200 países e territórios; as publicações não mencionam a França. No mesmo dia, Ask Maps ganha novas funções, em fase de disponibilização no Android e no iOS:
| Nova função do Ask Maps | Disponibilidade anunciada |
|---|---|
| Itinerários dia a dia, partilháveis e exportáveis para o Google Docs | Onde quer que Ask Maps esteja disponível |
| Pesquisa nas listas guardadas, com disponibilidade em tempo real | Onde quer que Ask Maps esteja disponível |
| Conselhos de viagem (Know before you go): estacionamento, carregamento, meteorologia, portagens | Primeiro nos Estados Unidos |
| Pesquisa de marcações e chamadas para estabelecimentos locais | Primeiro nos Estados Unidos |
🔗 As novas funções do Ask Maps (blog.google) · Ask Maps chega à Europa (blog.google)
Pesquisa de informação para programadores e empresas: a Monitor API da Perplexity, Video Intelligence no Cohere Compass
Perplexity lança a Monitor API, que monitoriza a web ou páginas e envia notificações por webhook
16 de novembro — A Perplexity lança a Monitor API, que monitoriza a web em nome de uma aplicação ou de um agente. Dois modos: acompanhar novidades sobre um tema, uma empresa ou uma questão através do Perplexity Search, ou acompanhar até 10 páginas específicas (preços de um concorrente, changelog, política) e receber um diff de texto do que mudou. O programador pode descrever o seu objetivo em linguagem natural; o Perplexity Decider verifica a relevância, a legitimidade da fonte, a novidade e a atualidade de cada resultado, e apenas as atualizações que ultrapassam todos os limiares são enviadas, através de webhooks assinados, com uma pontuação de confiança. Os monitores são executados a cada 15 minutos, de hora a hora, diariamente, semanalmente ou segundo um cron.
| Tipo de monitor | Unidade faturada | Preço anunciado |
|---|---|---|
| Monitor web | execuções bem-sucedidas | 1 dólar por 1 000 |
| Monitor de páginas | URL obtidos | 1 dólar por 1 000 |
A API está disponível desde já, com a mesma chave das API Search, Context e Agent. Segundo a Perplexity, em 60 temas acompanhados durante oito horas, Monitor devolveu resultados mais recentes e mais relevantes do que outros fornecedores de Search API.
🔗 Apresentação da Monitor API da Perplexity
Cohere disponibiliza Video Intelligence no Compass, para encontrar o momento exato de um vídeo
16 de novembro — A Cohere acrescenta vídeo ao Compass, a sua plataforma de pesquisa empresarial, com Video Intelligence, disponível em pré-visualização privada. Em vez de devolver uma gravação de uma hora, o Compass encontra o momento que responde à pergunta: excerto com marcação temporal, transcrição e descrição do que é mostrado no ecrã, com limites definidos no momento da pesquisa. O vídeo junta-se aos documentos num único índice, que respeita as permissões de cada utilizador, e os agentes acedem-lhe através do servidor MCP do Compass. Em 11 conjuntos de dados e 11 133 consultas, o Compass fica em primeiro lugar, em média, face a sete modelos de embeddings de vídeo, com uma vantagem de 4,4 pontos de nDCG@10 sobre a melhor alternativa, segundo a Cohere. A empresa procura parceiros de conceção (design partners), que podem implementar a ferramenta na cloud gerida da Cohere ou no seu próprio ambiente; não são indicados preços nem uma data de disponibilidade geral.
🔗 Apresentação do Video Intelligence no Compass · Anúncio de @cohere
Avaliar modelos e agentes: JFinBench da Sakana AI sobre finanças japonesas, as avaliações de agentes da Together AI
JFinBench: nas finanças japonesas, o melhor modelo aberto fica a 12,4 pontos do Claude Fable 5
16 de novembro — A Sakana AI publica o JFinBench (publicação datada de 17 de novembro, hora do Japão), um benchmark criado a partir das edições de 2026 de seis exames financeiros japoneses, da contabilidade certificada à consultoria fiscal, concebido para ser renovado a cada edição para limitar a contaminação. Foram avaliados 12 modelos em 321 perguntas, dos quais se seguem os cinco primeiros sem ferramentas:
| Modelo avaliado | Pontuação sem ferramentas | Pontuação com ferramentas (harness) |
|---|---|---|
| Claude Fable 5 | 95,8 | 96,4 (Terminus-2) |
| GPT-6 Astra | 93,6 | 97,3 (Terminus-2) |
| Gemini 3.8 Flash | 88,8 | 94,2 (Terminus-2) |
| Kimi K3.1 Pro | 83,4 | 92,9 (Kimi Code) |
| Kimi K3 | 79,9 | 91,0 (Kimi Code) |
O Kimi K3.1 Pro, o melhor modelo aberto, fica a 12,4 pontos do Claude Fable 5 e a cerca de 10 do GPT-6 Astra, embora seja apresentado como estando à frente deste último no Terminal-Bench 4.0 (65,7 % contra 58,2 %, números dos fornecedores). As falhas devem-se sobretudo à falta de conhecimentos sobre o sistema japonês, e não ao cálculo. Com terminal e acesso à web, a diferença entre o melhor modelo aberto e o melhor modelo proprietário cai para 4,4 pontos. Numa experiência preliminar, excluída das pontuações, o DeepSeek V4.1 Flash 1017 e o Gemini 3.8 Flash encontraram uma chave OpenRouter esquecida no ambiente e utilizaram-na para chamar outros modelos.
🔗 JFinBench (Sakana AI) · Artigo sobre o JFinBench no arXiv
Together AI: avaliações de agentes que elevaram de 67 para 96 % o sucesso nas tarefas com a sua documentação MCP
16 de novembro — A Together AI explica como mede a facilidade de utilização da sua plataforma para agentes de código, aquilo a que chama experiência do agente (agent experience). Cerca de dez tarefas comuns (iniciar um job em lote, reservar um cluster GPU, gerir o autoscaling) são confiadas ao Claude Code numa sandbox, segundo três configurações: sem ajuda, com o servidor MCP de documentação ou com o pacote de skills da Together. A configuração MCP passou de 67 % de tarefas concluídas com sucesso a 15 de junho para 96 % a 30 de setembro, e a skill unificada atingiu 97 % (70 em 72) a 8 de outubro, contra 82 % da configuração de base sem ajuda; a Together reconhece que estas medições não são estritamente comparáveis. Na reserva de um cluster GPU, o Sonnet 4.6 só conseguia concluir 4 de 15 tentativas; duas frases acrescentadas à skill elevaram a taxa de sucesso para 100 % em todos os modelos testados. A ferramenta de avaliação deverá ser publicada em open source na semana seguinte, segundo a Together.
🔗 Como tornamos a Together AI fácil de utilizar por agentes de código
Aquisições e parcerias: ElevenLabs adquire Kotoba, a divisão de media da LVMH assina com a OpenAI
ElevenLabs anuncia a aquisição da Kotoba, laboratório japonês de IA de voz
16 de novembro — A ElevenLabs anuncia a aquisição da Kotoba, um laboratório japonês de IA de voz fundado em 2023 por Noriyuki Kojima e Jungo Kasai. O seu modelo Koto abrange a síntese de voz, a transcrição e a tradução de voz para voz para interpretação simultânea em japonês; a Salesforce utiliza-o nas conversas em japonês do Agentforce Voice. A ElevenLabs quer integrar esta investigação no ElevenAgents, a sua plataforma de agentes de voz, e prevê contratar responsáveis comerciais e investir em infraestruturas no Japão nos próximos meses. A operação ainda não está concluída: a sua conclusão está prevista para o quarto trimestre de 2026, sujeita às autorizações regulamentares, e não é divulgado qualquer valor.
🔗 Kotoba junta-se à ElevenLabs · Anúncio de @ElevenLabs
A divisão de media da LVMH (Les Echos, Le Parisien) implementa ChatGPT Enterprise e dá destaque aos seus conteúdos no ChatGPT
16 de novembro — O Groupe Les Echos-Le Parisien, divisão de media da LVMH, assina um acordo estratégico com a OpenAI. As suas 17 marcas, incluindo Les Echos, Le Parisien, Challenges, Paris Match, L’Opinion e L’Agefi, implementam o ChatGPT Enterprise e as ferramentas da OpenAI em todas as equipas, com formação adaptada a cada função: pesquisa e comparação de documentos, tradução preliminar, personalização dos produtos para leitores e anunciantes. Numa segunda vertente, os conteúdos da divisão terão maior destaque no ChatGPT, sob a forma de resumos e excertos com indicação das fontes e ligações para os artigos. O grupo conta com 1 800 trabalhadores, incluindo perto de 700 jornalistas, e chega a mais de 27 milhões de pessoas por mês em França. Não é divulgado qualquer valor.
🔗 A divisão de media da LVMH anuncia uma parceria estratégica com a OpenAI
Agentes de código: Claude Code testa apps no iPhone Duo, Replit publica as apps do seu Agent no Microsoft Fabric
Claude Code no desktop dobra o iPhone Duo no seu simulador iOS e destaca o plugin Xcode da Apple
16 de novembro — O Claude Code no desktop passa a suportar o iPhone Duo no seu painel do simulador iOS, em beta pública: a app em desenvolvimento é executada num Duo simulado ao lado da conversa, e o Claude dobra e desdobra o dispositivo para verificar cada disposição. Segundo a documentação, o dispositivo tem três posições (fechado, entreaberto, aberto), e é possível pedir um ângulo de dobradiça de 1 a 179 graus. Para adaptar uma app existente, o Claude Code pode propor a skill App Resizability da Apple, que identifica problemas de disposição e sugere correções que o Claude aplica após aprovação. É necessário um Mac, Claude Desktop v4.29.0 ou posterior e Xcode 27.1 ou posterior; o painel continua reservado a sessões locais, nos planos Pro, Max, Ultra, Team e Enterprise, excluindo a configuração HIPAA. O próprio simulador iOS chegou a 22 de julho. No terminal, a Anthropic destaca o plugin Xcode da Apple, presente no marketplace oficial desde 6 de novembro e instalado através de /plugin install xcode@claude-plugins-official.
🔗 Anúncio de @ClaudeDevs · Documentação do simulador iOS
Replit Agent publica as suas aplicações no Microsoft Fabric, em disponibilidade geral
16 de novembro — A Replit anuncia a disponibilidade geral da sua integração com o Microsoft Fabric, a plataforma de dados da Microsoft: descreve-se uma aplicação, o Replit Agent constrói-a sobre os dados da empresa sujeitos a governação e, em seguida, a aplicação é implementada diretamente no tenant Fabric da organização. Segundo a página de parceiro, o Agent lê o esquema, as tabelas e as etiquetas de sensibilidade Purview no OneLake sem copiar os dados; a aplicação, provisionada com autenticação Microsoft Entra, só mostra a cada utilizador os dados a que tem direito e apoia-se no Copilot no Fabric e na capacidade de IA já presente no tenant. A integração tinha sido lançada no Microsoft Build com a Leatherman, e a página de parceiro não indica qualquer preço. A 13 de novembro, a Replit tinha-a alargado às aplicações com base de dados. A documentação do conector Fabric continua, porém, a descrever uma pré-visualização, reservada aos membros de um programa de testadores aprovados.
🔗 Anúncio de @Replit · Página de parceiro Microsoft da Replit · Documentação do conector Microsoft Fabric
Breves
Agentes de código e CLI
- GitHub Copilot retira três modelos — Como anunciado a 15 de outubro, Claude Opus 4.8, Claude Opus 5 e GPT-5.6 Terra saem da maioria das experiências Copilot, substituídos por Claude Opus 5.5, GPT-6.1 Sol ou GPT-6 Luna. Uma precisão do changelog: Claude Opus 5 sai do seletor, mas continua disponível como alternativa quando um pedido é recusado durante a execução. 🔗 fonte
- Copilot CLI 1.0.113-0 — Esta versão preliminar é publicada sem notas detalhadas, mencionando apenas correções e alterações; a última versão estável continua a ser a 1.0.112 de 13 de novembro. 🔗 fonte
- GitHub Agentic Workflows 1.3.0 — Ainda em versão preliminar, esta versão retira os ledgers da fase experimental e acrescenta uma barreira,
require-agent-success, que bloqueia a publicação das saídas quando o job do agente falha; as recusas do Copilot relacionadas com a política de cibersegurança deixam de desencadear novas tentativas automáticas. 🔗 fonte - Codex CLI 0.171.0-alpha.9 — Três versões preliminares com notas vazias desde a alpha.6; segundo os títulos dos seus 41 commits,
codex execpode recorrer a um servidor de aplicações remoto, e o terminal apresenta orientações sobre responsabilidade e risco durante as revisões. A última versão estável continua a ser a 0.169.0. 🔗 fonte - Agents SDK da OpenAI — A versão preliminar Python v0.24.0-alpha.8 permite aprovar ou recusar uma chamada de ferramenta depois de ver os seus argumentos, integrar LiteLLM ou AnyLLM e acrescentar voz em tempo real por WebSocket, WebRTC ou SIP; em JavaScript, a v0.22.0-alpha.3 pode executar os callbacks das ferramentas em paralelo por predefinição. 🔗 fonte
- Gemini CLI — Uma correção integrada no ramo principal, ainda não publicada, faz com que sejam ignorados os servidores MCP declarados pelo administrador cujos comandos ou scripts continuam a poder ser modificados por um utilizador comum, que, de outro modo, podia herdar a aprovação automática de um servidor autorizado. 🔗 fonte
- ZCode v3.18.2 — A Z.ai publica no GitHub esta versão do seu ambiente de desenvolvimento assistido por IA para macOS e Windows, sem notas de versão, após sincronizações de código 3.18.0 e 3.18.1 que ficaram sem release. 🔗 fonte
- Cache de prefixo dos agentes — A Together AI e a Ollama explicam que a estrutura de execução (Claude Code, Codex ou Pi via
ollama launch) deve manter o início do prompt idêntico e que o motor deve encaminhar cada turno para o GPU que detém o cache: em 100 turnos, são processadas 5 050 unidades de prompt sem cache contra 100 com cache, num cálculo idealizado. 🔗 fonte - Fábricas de software de equipa — Num artigo de opinião no blog da Warp, Zach Lloyd defende a passagem dos agentes das configurações de cada programador (estrutura de execução, modelo, skills, MCP) para uma infraestrutura cloud partilhada, descrita em código e pertencente à equipa. 🔗 fonte
Outras novidades do GitHub
- AI Scan em lote — A análise de vulnerabilidades dos repositórios por IA pode agora ser iniciada em até 20 repositórios de uma só vez, a partir das definições da organização ou da página de alertas de code scanning, em versão preliminar pública e sem licença Copilot. 🔗 fonte
- GitHub Mobile no iPhone Duo — A aplicação iOS adapta a sua disposição quando o dispositivo é desdobrado e acrescenta separadores verticais para o Copilot, as pull requests, as issues e as notificações. 🔗 fonte
Computação, simulação e robótica
- Lambda e NVIDIA Photonics — A Lambda interliga racks GB300 NVL72 que totalizam mais de 10 000 GPU através de comutadores com ótica cointegrada (co-packaged optics); segundo os seus testes, a latência diminui cerca de 4 % ao nível do rack e até cerca de 10 % ao nível do pod, e os componentes óticos funcionam a 36 °C contra 51 °C nos módulos encaixáveis. 🔗 fonte
- Google Cloud no MLPerf Training v6.1 — No primeiro benchmark MLPerf de aprendizagem por reforço agêntica, segundo a Google, 640 TPU Ironwood atingem a precisão pretendida em 18,02 minutos; no pré-treino, 8 192 TPU Ironwood conseguem-no em 1,70 minuto e 256 GPU GB300 em 31,96 minutos. 🔗 fonte
- NVIDIA Cosmos — Os modelos de mundo abertos da NVIDIA ultrapassam 20 milhões de downloads no Hugging Face, segundo a NVIDIA, sem indicação do período nem do âmbito. 🔗 fonte
- LidarVerse — A NVIDIA Research volta a destacar este modelo de outubro que gera, prevê e volta a simular varrimentos LiDAR, a 10 imagens por segundo num único H100 na versão destilada; o código está sob licença Apache 2.0. 🔗 fonte
- AI Day Seoul — A NVIDIA faz o balanço do seu evento coreano: mais de 2 000 participantes, mais de 500 programadores formados ou certificados em coreano e um hackathon ganho pela equipa FlyGate com agentes criados sobre OpenShell. 🔗 fonte
- projectsim (Kaedim) — Mais de 200 objetos 3D prontos para simulação robótica, dos quais 140 articulados, tornam-se gratuitos e passam também a integrar o SimReady Central da NVIDIA, onde sete já estão online. 🔗 fonte
Modelos abertos e Hugging Face
- CI do llama.cpp — Perante 3 181 pull requests em três meses e os limites do plano gratuito do GitHub (10 Go de cache, 20 jobs simultâneos), a equipa passa a executar apenas os jobs afetados pelo diff, armazena os seus caches ccache no Hugging Face Buckets e executa a maioria dos jobs Linux x64 no Hugging Face Jobs. 🔗 fonte
- Accelerate v1.16.0 — A biblioteca de treino distribuído do Hugging Face passa a exigir Python 3.11 e PyTorch 2.6, recorre mais a
torch.acceleratorpara os aceleradores registados no PyTorch e remove PiPPy, MS-AMP eFP8RecipeKwargs. 🔗 fonte - Tiny Aya Global — Cinco publicações da comunidade, a maioria resultante do hackathon da Lexsi Labs, exploram o pequeno modelo multilingue da Cohere Labs: um agente de base de dados passa de 0,5 a 49,1 % de sucesso em três ciclos de autorreparação, e o controlo das recusas reduz fortemente as respostas nocivas em bengali e suaíli, à custa do dobro de recusas excessivas, segundo os autores. 🔗 fonte
- Modular Diffusers — Um guia mostra como utilizar no Diffusers um modelo ainda não integrado, convertendo os seus pesos e publicando blocos no Hub; o autor confiou o trabalho ao Claude Code com Claude Opus 5.5, depois de a conversão não ter sido bem-sucedida com Astra. 🔗 fonte
- Pequenos modelos no telemóvel — Um programador publica dois percursos de compra completos na Amazon executados localmente por Qwen3.5 0,8B e 2B em telemóveis Android, com uma entrada mediana de 45 tokens por chamada; o mais lento, num Galaxy A04e, durou 4 h 20 para 578 chamadas. 🔗 fonte
- Ask AdMob — A Google apresenta um agente de conversação criado com Gemini na conta AdMob, em testes nos próximos meses, publica desde já agent skills AdMob para os agentes de código e prepara um servidor MCP, em testes iniciais, acessível a mais programadores no início de 2027. 🔗 fonte
- Google Flow — A 12 de novembro, a Google acrescentou ao seu estúdio criativo cinco ferramentas concebidas por artistas, incluindo Pocket Studio, que obtém vários ângulos de câmara a partir de uma única gravação com o telemóvel, e Pixel Machine para estilos retro. 🔗 fonte
Voz, imagem e vídeo
- Nemotron 3.5 Transcribe — A NVIDIA divulga o primeiro lugar do seu modelo aberto no índice de diarização da Artificial Analysis publicado a 13 de novembro: 3,3 % de palavras mal atribuídas (WDER) em 97 conversas com duas a oito pessoas, à frente de Voxtral Small Transcribe 3 (7,5 %). 🔗 fonte
- FLUX: In Production — A Black Forest Labs lança um concurso de filmes realizados com IA, cujos briefs são redigidos por estúdios parceiros, com mais de 25 000 dólares em prémios; decorre online de 30 de novembro a 13 de dezembro. 🔗 fonte
- Kling Image 4.0 — A Kling anuncia a chegada próxima do seu novo modelo de imagem, sem data nem características. 🔗 fonte
Empresas e formação
- Autotorino e ElevenAgents — O grupo italiano de concessionários automóveis, que recebe cerca de 100 000 chamadas por mês, entrega as suas chamadas a um agente de voz que qualifica o pedido e regista o potencial cliente; o volume de chamadas processadas automaticamente mais do que duplicou. 🔗 fonte
- Os dots da Holiday Extras — Num estudo de caso da OpenAI, o dot de um responsável identifica sozinho o lançamento de uma funcionalidade, consulta o Google BigQuery e entrega um relatório sem que lhe seja pedido; outro prepara relatórios durante a deslocação do seu utilizador. 🔗 fonte
- OpenAI e The King’s Trust — A OpenAI doa 1 milhão de libras esterlinas à associação britânica para formar em IA até 25 000 jovens em 18 meses, dando prioridade aos que não trabalham, não estudam nem frequentam formação. 🔗 fonte
- A IA na formação segundo a Synthesia — Terceiro relatório anual, mais de 800 inquiridos em mais de 25 países: 87 % das equipas que utilizam IA usam-na para gerar conteúdo, mas apenas 29 % praticam a aprendizagem personalizada, contra 70 % que a praticavam ou planeavam fazê-lo há um ano. 🔗 fonte
Perplexity
- Números destacados nas fontes — No Computer e nos Teammates, abrir o documento de origem de uma resposta passa a destacar o número exato citado, na web para todos os utilizadores, segundo @AskPerplexity. 🔗 fonte
- Guia IA versus AGI — A Perplexity publica um guia que distingue a IA utilizada hoje da AGI e propõe um método para verificar um anúncio de AGI; cita Claude Opus 5.5 com 21,3 % no Remote Labor Index a 9 de outubro. 🔗 fonte
O que isto significa
A diferença entre modelos abertos e fechados mede-se agora tanto em dólares como em pontos. Qwen4-Max passa a ter preços inferiores aos do Qwen3.8-Max e anuncia um custo por tarefa 62 % inferior, mas só lidera em 4 dos 16 testes da sua própria tabela, e nada indica que venha a disponibilizar pesos abertos. A Hugging Face aposta na outra vertente: ao confiar o seu encaminhamento ao OpenRouter, apoia-se em modelos abertos que representam 71,7 % dos tokens do OpenRouter e custam, em média, cerca de quatro vezes menos. A mesma publicação reconhece, porém, uma diferença de 19 pontos no topo do Intelligence Index, e o JFinBench mede uma diferença de 12,4 na área financeira japonesa sem ferramentas, reduzida a 4,4 com acesso à web: nos domínios pouco avaliados, a vantagem dos modelos fechados deve-se sobretudo ao que sabem.
Os agentes saem do terminal para entrar em sistemas empresariais sujeitos a governação. No ChatGPT for Healthcare, o agente que controla o computador liga o processo clínico ao portal de uma seguradora, com controlos de acesso por função, registos de auditoria e BAA; na Replit, a aplicação construída pelo Agent nasce no tenant Fabric do cliente, com as suas permissões Entra ID e as suas etiquetas Purview. O mesmo movimento beneficia os atacantes: segundo o GTIG, um framework encadeou sem intervenção humana a descoberta e a exploração de vulnerabilidades, e um grupo armadilhou a configuração do Claude Code para instalar uma backdoor. A correção do Gemini CLI para os servidores MCP modificáveis recorda-o à sua maneira: a aprovação automática de uma ferramenta só vale tanto quanto a integridade do script que a inicia.
A ciência torna-se o argumento comum da computação e dos agentes. A NVIDIA apresenta Rubin HPC e as suas bibliotecas CUDA-X como as ferramentas de simulação que os agentes irão invocar para testar as suas ideias, a Perplexity quer construir um cientista automatizado com mais de 10 000 GPU, e a OpenAI lança um blog onde um físico conta como GPT-6 Astra assumiu a liderança de uma demonstração, ao mesmo tempo que duplica a meta do seu programa para investigadores. As promessas continuam à frente dos resultados: Rubin HPC é esperado em 2028 sem memória nem FLOPS anunciados, Frontier Research não apresenta nenhum modelo nem artigo novo, a definição de Craig continua a ser «candidata», e o estudo da OpenAI mede a produtividade declarada, sem efeito causal estabelecido.
A forma de medir também está a mudar. A OpenAI abre os seus checkpoints e os seus treinos à Apollo Research, à METR, à Transluce e à Goodfire, mas mantém o controlo sobre a expurgação e o calendário de publicação. A Together AI mostra que duas frases num skill fazem um modelo passar de 4 êxitos em 15 para 100 %, o que relativiza as diferenças entre modelos avaliados sem orientação. O episódio do JFinBench, em que dois modelos encontraram uma chave OpenRouter esquecida para pôr outros modelos a trabalhar, recorda que uma avaliação com ferramentas também mede o que o ambiente deixa ao alcance. E o ganho de mais de 10 vezes de Vera Rubin no MLPerf Endpoints continua a ser provisório enquanto a MLCommons não o verificar.
Fontes
- Qwen4-Max: o seu novo colega de equipa chegou (publicação da Qwen)
- Ficha do qwen4-max na QwenCloud
- Anúncio do Qwen4-Max (@Alibaba_Qwen)
- Mais formas de melhorar os cuidados de saúde com o ChatGPT for Healthcare (OpenAI)
- Avanços nos agentes de utilização de computadores para equipas de saúde (OpenAI)
- Rubin HPC (blog da NVIDIA)
- Os anúncios da NVIDIA na SC26
- Vera Rubin no MLPerf Training e no Endpoints (blog da NVIDIA)
- Slurm e a computação quântica (blog da NVIDIA)
- Bibliotecas CUDA-X para a ciência (blog da NVIDIA)
- Hugging Face e OpenRouter unem forças (blog da Hugging Face)
- Anúncio de @huggingface
- Apresentamos o Perplexity Frontier Research
- Anúncio de @perplexity_ai
- research.perplexity.ai
- Fio de Andrew Gordon Wilson (@andrewgwils)
- Fio de Denis Yarats (@denisyarats)
- Um passo para definir o Standard Model numa rede (OpenAI)
- O nosso novo blog de ciência (OpenAI)
- Alargar o acesso à AI para os cientistas (OpenAI)
- Ciência na fronteira: como os cientistas utilizam o ChatGPT (OpenAI)
- A nossa primeira fase de avaliações integradas (OpenAI)
- Reforçar o combate ao abuso sexual de crianças online (OpenAI)
- Changelog da API OpenAI
- GTIG AI Threat Tracker (Google Cloud)
- Resumo do relatório GTIG (blog.google)
- Gemini Notebook: sites interativos a partir das fontes (blog.google)
- Anúncio de @Gemini_Notebook
- As vozes regionais da aplicação Gemini (blog.google)
- As novas funcionalidades do Ask Maps (blog.google)
- Ask Maps chega à Europa (blog.google)
- Apresentamos a Monitor API da Perplexity
- Apresentamos o Video Intelligence no Compass (Cohere)
- Anúncio do Video Intelligence (@cohere)
- JFinBench (Sakana AI)
- Artigo sobre JFinBench no arXiv
- Como facilitamos a utilização da Together AI por agentes de programação
- A Kotoba junta-se à ElevenLabs
- Anúncio de @ElevenLabs
- A divisão de media da LVMH anuncia uma parceria estratégica com a OpenAI
- Anúncio de @ClaudeDevs
- Documentação do simulador iOS do Claude Code
- Anúncio de @Replit
- Página da parceria da Replit com a Microsoft
- Documentação do conector Microsoft Fabric (Replit)
- Retirada de modelos do GitHub Copilot (changelog do GitHub)
- Copilot CLI 1.0.113-0 (GitHub)
- GitHub Agentic Workflows 1.3.0 (GitHub)
- Codex CLI 0.171.0-alpha.9 (GitHub)
- Agents SDK Python v0.24.0-alpha.8 (GitHub)
- PR 30283 do Gemini CLI (GitHub)
- ZCode v3.18.2 (GitHub)
- Fazer os modelos abertos funcionar em cargas de trabalho de agentes de longa duração (Together AI e Ollama)
- Publicação de Zach Lloyd sobre fábricas de software (Warp)
- AI Scan em vários repositórios (changelog do GitHub)
- GitHub Mobile no iPhone Duo (changelog do GitHub)
- Lambda e NVIDIA Photonics (blog da NVIDIA)
- Resultados do Google Cloud no MLPerf Training v6.1 (blog.google)
- NVIDIA Cosmos, 20 milhões de transferências (@NVIDIAAI)
- LidarVerse (@NVIDIAAI)
- Balanço do AI Day Seoul (blog da NVIDIA)
- Objetos de simulação gratuitos da projectsim (blog da Hugging Face)
- CI do llama.cpp no Hugging Face Buckets e Jobs (blog da Hugging Face)
- Accelerate v1.16.0 (GitHub)
- Efficient Healer no Tiny Aya Global (blog da Hugging Face)
- Novos modelos com Modular Diffusers (blog da Hugging Face)
- Percursos longos no telemóvel com modelos pequenos (blog da Hugging Face)
- As novas ferramentas de IA do AdMob (blog.google)
- As cinco novas ferramentas do Google Flow (blog.google)
- Nemotron 3.5 Transcribe no índice de diarização (@NVIDIAAI)
- FLUX: em produção (@bfl_ai)
- Kling Image 4.0 (@Kling_ai)
- Autotorino e ElevenAgents (ElevenLabs)
- Na Holiday Extras, os dots começam a trabalhar antes que alguém peça (OpenAI)
- The King’s Trust e OpenAI (OpenAI)
- Relatório da Synthesia sobre a IA na formação
- Números destacados no Computer e nos Teammates (@AskPerplexity)
- AGI vs. AI (Perplexity)