ai-powered-markdown-translatorArtikel översatt från fr till sv med gpt-6.1-sol.
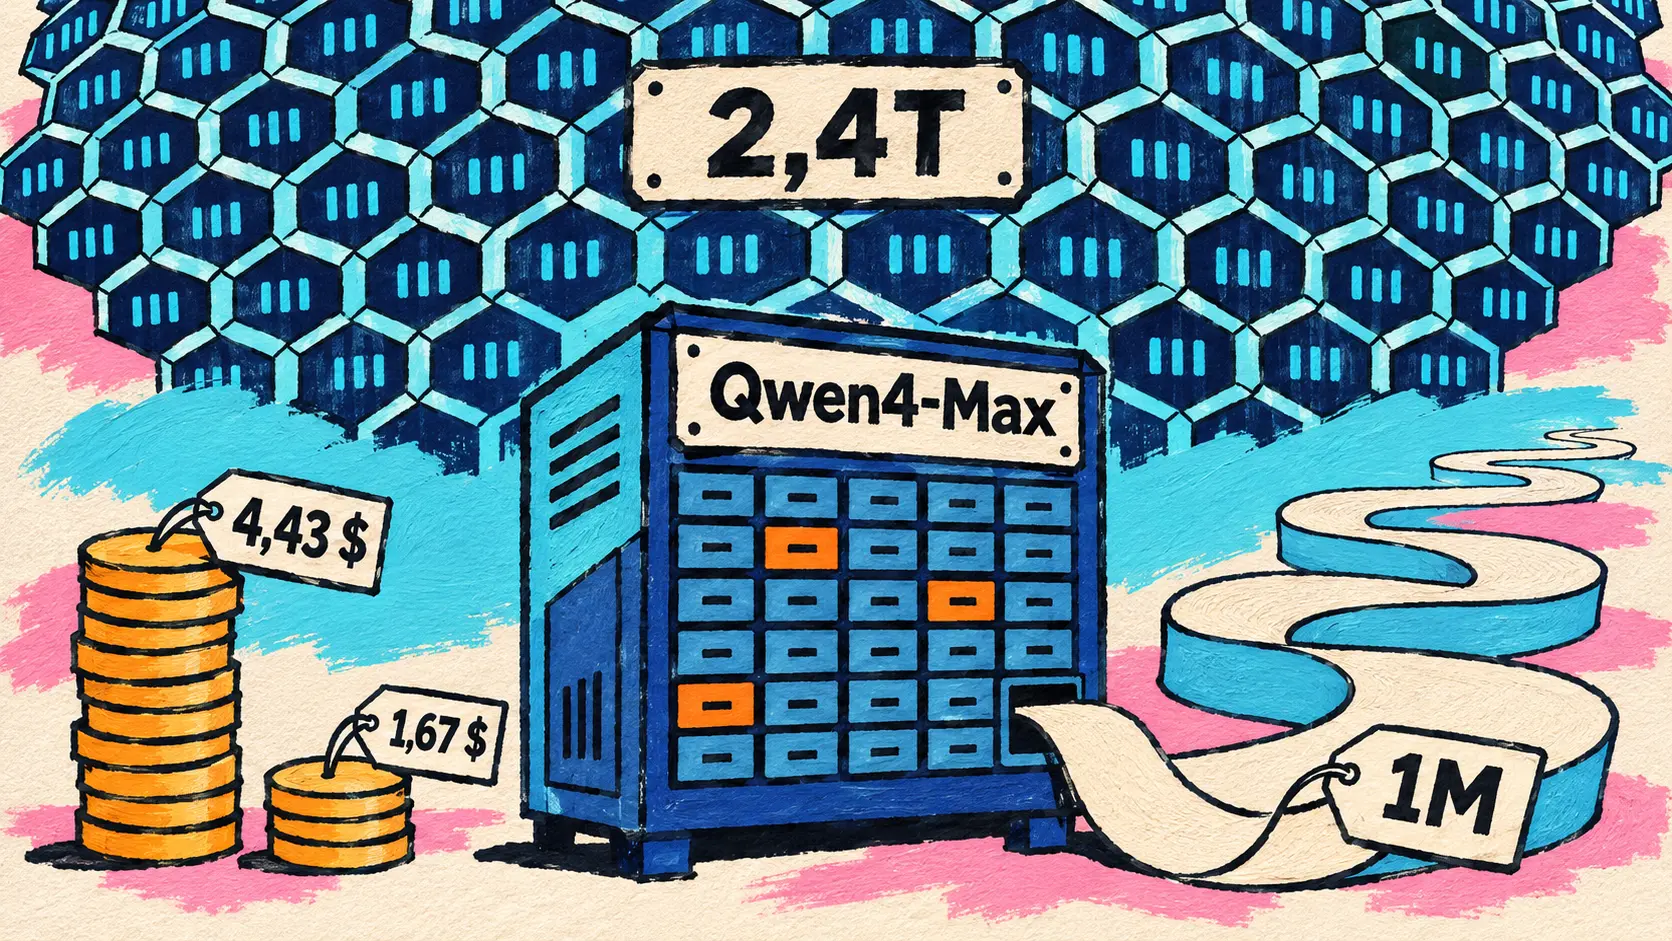
Qwen gör Qwen4-Max tillgänglig via sitt API: en MoE-modell med 2,4T parametrar, en kontext på 1M tokens och ett lägre pris än Qwen3.8-Max. OpenAI utökar tillgången till sina agenter som styr datorer till ChatGPT for Healthcare och ChatGPT for Clinicians, NVIDIA presenterar på SC26 Rubin HPC, en GPU för simulering som väntas 2028, tillsammans med de första resultaten för Vera Rubin i MLPerf Training, och Hugging Face överlåter routningen för sina Inference Providers till OpenRouter. Perplexity lanserar samtidigt Perplexity Frontier Research, som siktar på en automatiserad forskare med över 10 000 GPU:er.
Qwen4-Max kommer till QwenClouds API: MoE med 2,4T parametrar, kontext på 1M tokens och lägre priser
16 november — Fem dagar efter förhandsversionen som rapporterades om den 11 november gör Qwen Qwen4-Max tillgänglig via QwenClouds API under identifieraren qwen4-max, tillsammans med ett långt tekniskt blogginlägg. Det är den första modellen i Qwen4-serien: mindre Qwen4-modeller kommer att släppas med öppna vikter, utan angivet datum, men något sådant har inte meddelats för Max. Modellen erbjuds också i QwenWork, Qoder och Qwen Studio, och redan samma dag hos OpenRouter, Vercel AI Gateway, Novita AI och OpenCode Go.
Arkitekturen är ny. Denna expertblandning (Mixture of Experts, MoE) har 2,4T parametrar i huvudnätet, varav 71B aktiveras per token, plus 328B parametrar för N-gram Embedding. Av fyra lager komprimerar tre Gated DeltaNet historiken till ett tillstånd med fast storlek; det fjärde, med Qwen Sparse Attention, väljer relevant kontext i block. Modellen har inbyggd bildförståelse och en kontext på 1M tokens: 991K in och 131K ut, 983K och 262K i resonemangsläge, enligt QwenClouds sida.
| Pristyp (QwenCloud, per miljon tokens) | Annonserat pris |
|---|---|
| Indata | 1,5 dollar |
| Utdata | 4,5 dollar |
| Indata i implicit cache | 0,075 dollar |
| Skapande av explicit cache (5 minuter / 1 timme) | 1,875 / 3 dollar |
Enligt Qwen är samtliga priser lägre än för Qwen3.8-Max, och priset för implicit cache sjunker med 70 %. I sina interna utvärderingar uppger Qwen också att tokenförbrukningen minskar med 24 till 35 % beroende på insatsnivå i Work360, företagets ramverk för 721 yrkesspecialiteter, och med cirka 48 till 49 % i Terminal-Bench 4.0. Den genomsnittliga kostnaden för en Work360-uppgift sjunker från 4,43 till 1,67 dollar, alltså −62 % enligt det engelska blogginlägget; den kinesiska versionen, i yuan, anger −58 %. I Work360 får Qwen4-Max 52,69 mot 47,74 för Qwen3.8-Max.
Jämförelsen med Opus 5.5, GPT-6.1 Sol, GPT-6 Astra och Kimi K3.1 i Qwens publicerade tabell ger en blandad bild: Qwen4-Max leder bara i 4 av 16 tester, DeepSWE v1.1, Agents’ Last Exam v1.1, HLAB-Vals-1.1 och BioMysteryBench. Ett urval:
| Benchmark (område) | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|
| DeepSWE v1.1 (agentbaserad kodning) | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| HLAB-Vals-1.1 (juridisk agent) | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| BioMysteryBench (bioinformatik) | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| Terminal-Bench 4.0 (agentbaserad terminalanvändning) | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench (replikering av programvara) | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| Humanity’s Last Exam | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
De externa rankningar som Qwen återger placerar modellen på 6:e plats i Code Arena WebDev (1 750 preliminära poäng) och på 11:e plats i Vals Index (63,20 %), som främsta kinesiska modell. Artificial Analysis ger den 43 poäng i sitt Intelligence Index vid insatsnivån xhigh, 3 poäng efter Kimi K3.1 Pro, med en cirka 11 % lägre kostnad per uppgift.
More to come! The open weights of smaller Qwen4 models will be released. Stay tuned.
🇸🇪 Det är inte över än! Öppna vikter för mindre Qwen4-modeller kommer att publiceras. Håll utkik. — @Alibaba_Qwen på X
🔗 Qwen4-Max: Din nya lagkamrat är här (Qwens blogginlägg) · Modellbeskrivning för qwen4-max på QwenCloud
ChatGPT for Healthcare: agenter som styr datorer, klinisk forskning och över 20 vårdplugins
16 november — OpenAI utökar ChatGPT for Healthcare i tre riktningar. Först kommer agenter som använder datorn (computer-use agents), som läser skärmen, klickar, skriver och växlar mellan applikationer, till ChatGPT Work och Codex för kunder hos ChatGPT for Healthcare, beroende på arbetsytans inställningar, och för kliniker i ChatGPT for Clinicians, det kostnadsfria erbjudandet för verifierade kliniker i USA. Samma funktion är tillgänglig via API:et. Ett typiskt användningsfall är att flytta information mellan program som inte kommunicerar med varandra, som den elektroniska patientjournalen och ett försäkringsbolags portal vid en ansökan om godkännande av en MR-undersökning. Datoranvändning har funnits i ChatGPT Work och Codex sedan den 9 juli; det nya är att funktionen blir tillgänglig för vårdens arbetsytor, med rollbaserad åtkomstkontroll, granskningsloggar och konfigurerbara godkännandesteg. Arbetsflöden som följer HIPAA är fortfarande begränsade till kvalificerade tjänster som omfattas av ett BAA.
OpenAI publicerar två uppsättningar siffror som bör läsas var för sig: företagets interna utvärdering av meddelandehantering i patientjournalen och HealthAdminBench, ett oberoende benchmark från forskare vid Stanford för administrativa uppgifter (förhandsgodkännanden, överklaganden, beställningar av utrustning).
| Publicerad utvärdering | Modell och inställning | Angivet resultat |
|---|---|---|
| Meddelandehantering i patientjournalen (OpenAI, 325 granskade uppgifter) | GPT-6 Astra | 99 % av uppgifterna bedömdes som kliniskt säkra |
| Samma utvärdering, 646 läkaromdömen | GPT-6 Astra | 93 % ”mycket” eller ”extremt” användbara |
| HealthAdminBench (Stanford) | GPT-6 Astra, maximal insatsnivå | 94,3 % av poängen i bedömningsmatrisen |
| HealthAdminBench (Stanford) | GPT-6 Luna, maximal insatsnivå | 91,8 %, för 8,5 cent per uppgift |
I HealthAdminBench får GPT-6 Luna 91,8 % till en 98 % lägre kostnad, alltså 8,5 cent per uppgift. I praktiken använder CVS Health redan dessa agenter i produktion: en agent betade under en helg av en kö av dokumentutskick som byggts upp under flera månader, en annan hanterar systemstegen för tiotusentals konsultationer om dagen, och företaget släpper sitt Agent Kit, byggt med OpenAI:s Agents SDK, som open source. Cigna Healthcare uppger att de gick från koncept till driftsättning på mindre än åtta veckor; hos Ambience stannar agenten och ber klinikern om en bedömning när journalen är tvetydig; Abridge utvecklar agenter för sjukhus.
Därefter följer de två andra delarna. Klinisk forskning, som hittar, utvärderar och citerar medicinsk evidens, får högre betyg inom alla åtta uppmätta dimensioner i en blindad utvärdering med över 1 300 läkarbedömningar. Och 21 nya vårdplugins (UpToDate Expert AI, Oracle HDI, Trizetto, Stedi, Luma Health, Metriport…) gör det möjligt att läsa ett vårdprotokoll, kontrollera försäkringstäckning eller samordna besök direkt i konversationen; arbetsytans administratör måste aktivera dem, och ChatGPT for Clinicians får bara tillgång till en del av dem.
🔗 Fler sätt att utveckla vården med ChatGPT for Healthcare · Vidareutveckling av agenter som använder datorn för vårdteam
NVIDIA på SC26: Rubin HPC för vetenskaplig simulering, Vera Rubin i MLPerf, Slurm för kvantprocessorer och CUDA-X-bibliotek
16 november — På konferensen för högpresterande beräkningar SC26 presenterar NVIDIA en rad nyheter med inriktning på vetenskap. Den främsta är Rubin HPC, en ny GPU i Vera Rubin-plattformen som är utformad för simulering och databehandling inom vetenskap, teknik och analys, inom områden som klimat, genomik och finansiell risk.
Den publicerade specifikationen är fortfarande kortfattad. NVIDIA lyfter fram över 50 000 CUDA-kärnor i en enda GPU, ett ”rekordstort” antal enligt företaget, acceleration av glesa data (sparse data acceleration) för att hålla kärnorna försedda med data, och en NVLink-förbindelse av sjunde generationen mellan GPU:er. Varken minneskapacitet, prestanda i FLOPS, pris eller partner anges.
Huvudargumentet är balans. Enligt NVIDIA består de flesta vetenskapliga arbetslaster av att hämta några utspridda värden ur en enorm datamängd, göra beräkningar och sedan upprepa detta i mycket stor skala. Rubin HPC låter därför dataförflyttningen växa i takt med beräkningskapaciteten för att snabba upp operationer på glesa matriser, stencilberäkningar, sorteringar och reduktioner. NVIDIA kopplar denna GPU till sitt budskap om agenter: en agent som utforskar fler molekyler, material eller konstruktioner behöver fler simuleringar för att testa sina idéer, och CUDA-X-biblioteken ger den optimerade implementationer. Tidplanen ligger långt fram: Rubin HPC väntas 2028.
| Annonserad egenskap | Värde som NVIDIA anger |
|---|---|
| CUDA-kärnor | över 50 000 i en enda GPU |
| Sammankoppling mellan GPU:er | NVLink av sjunde generationen |
| Särskild funktion | acceleration av glesa data |
| Planerad tillgänglighet | 2028 |
🔗 Rubin HPC (NVIDIAs blogg) · NVIDIAs nyheter på SC26
Vera Rubin debuterar i MLPerf Training v6.1 och MLPerf Endpoints, med upp till 2 gånger prestandan hos GB300 NVL72 per GPU
16 november — Omgången MLPerf Training v6.1 markerar Vera Rubin NVL72:s första deltagande i träning: upp till 2 gånger prestandan per GPU jämfört med GB300 NVL72, resultat som NVIDIA beskriver som tidiga. För DeepSeek-V3 bibehålls cirka 97 % effektivitet när antalet Vera Rubin-GPU:er ökar från 256 till 1 024, samtidigt som träningstiden sjunker från 16 minuter till omkring fyra. Omgångens största konfiguration omfattar 10 240 GPU:er, med GB300 hos NVIDIA och GB200 hos Microsoft Azure. Enligt NVIDIA är företagets plattform den enda som har resultat för samtliga tester.
NVIDIA lämnar också in sitt första bidrag till MLPerf Endpoints v1.0, som mäter verkliga agentbaserade arbetsflöden. För Kimi K3 uppges Vera Rubin NVL72 ge över 10 gånger genomströmningen per watt jämfört med GB300 NVL72 vid samma svarshastighet: ett preliminärt resultat som väntar på verifiering av MLCommons och jämför 32 Vera Rubin-acceleratorer med 48 GB300-acceleratorer vid tröskeln 50 tokens per sekund och användare. Vera Rubin fanns redan med som förhandsversion i MLPerf Inference, som rapporterades om den 16 september.
🔗 Vera Rubin i MLPerf Training och Endpoints (NVIDIAs blogg)
Slurm 26.11 får stöd för kvantprocessorer, CUDA-Q utökas
16 november — NVIDIA utökar Slurm, superdatorernas jobbhanterare, med stöd för kvantprocessorer (QPU). Hittills har anslutning av en QPU till ett beräkningscenter krävt särskild utveckling för varje kombination av processor och center; nu beskriver tillverkaren sin hårdvara i en enkel fil och får ett gränssnitt som fungerar överallt, via gränssnitten QRMI och QDMI. Alice & Bob, IBM, IQM, Pasqal, Quantinuum och MQSC tar det i bruk, och Slurm 26.11 ska släppas senare i november. NVIDIA motiverar arbetet med att installationerna blir fler: närmare 30 beräkningscenter driftsätter över 50 QPU:er.
CUDA-Q-plattformen får en avkodningsserver för kvantfelkorrigering (CUDA-Q QEC), vars TCBP-JOBS-avkodare uppges vara 13 000 gånger snabbare än branschens referens, feltoleranta primitiver (Fermilab har redan med CUDA-Q på tre veckor genomfört studier som annars skulle ha tagit fem månader), samt CUDA-Q Algorithms och CUDA-Q Pulse för hårdvarutillverkare. Dessa förbättringar är NVIDIAs egna uppgifter.
🔗 Slurm och kvantberäkning (NVIDIAs blogg)
CUDA-X för vetenskap: cuSpa och HMMER på GPU som open source, Event Horizon Telescopes data korreleras på åtta minuter
16 november — NVIDIA kompletterar Rubin HPC med CUDA-X-bibliotek för forskning, som presenteras som verktyg som agenter kan anropa. Inom astronomin minskar modulen cuPhoton.xBeam tiden för att korrelera observationer från Event Horizon Telescope från över en månad till åtta minuter, både på ett kluster med flera GPU:er och på en DGX Spark. Inom biologin gör cuSpa, som nyligen blivit open source, beräkningar av cellpolygoner 900 gånger snabbare än på CPU vid Memorial Sloan Kettering Cancer Center, och GPU-versionen av HMMER, som också är open source, är upp till 84 gånger snabbare hos Basecamp Research. rapids-singlecell levereras nu i en container som är ”redo för agenter” (200 gånger snabbare hos Therna Biosciences). Inom kemin kommer Daviator, en samling GPU-kärnor för programvaran VASP, till NVIDIA ALCHEMI med upp till 22 gånger snabbare och upp till 75 % billigare beräkningar, men är ännu inte tillgänglig; cuPotential, som lanserades den 14 oktober, får fem nya användare, däribland Cadence.
🔗 CUDA-X-bibliotek för vetenskap (NVIDIAs blogg)
Hugging Face ger OpenRouter ansvar för routing av språkmodellerna i sina Inference Providers
16 november — Hugging Face och OpenRouter inleder ett samarbete: Hugging Faces Inference Providers överger sin egen router och låter OpenRouter välja leverantör för varje anrop till en språkmodell. Clément Delangue presenterar tillkännagivandet som den första delen av partnerskapet. Ingenting ändras i klientkoden: samma Hugging Face-token, samma endpoint. Routern stöder OpenAI:s API:er Chat Completions och Responses samt Anthropics API Messages, och Hugging Face publicerar guider för Claude Code, Codex, OpenCode, Pi och Hermes Agent.
Skillnaden ligger i routing. Inference Providers valde en leverantör och returnerade dess fel oförändrat; OpenRouter väljer utifrån pris, hastighet och tillförlitlighet som mäts i realtid, och försöker med anropet hos en annan leverantör om den första misslyckas. Suffix styr vilken policy eller leverantör som används (:fastest, :cheapest, zai-org/GLM-5.3:novita), och en konversation stannar hos leverantören som har dess prompt-cache.
| Aviserad förändring | Detalj enligt blogginlägget |
|---|---|
| Kapacitetsfel (OpenRouters mätning) | −46 % |
| Tid till första token och genomströmning (OpenRouters mätning) | förbättrad med 16,9 % respektive +16,3 % |
| Fakturering | leverantörens pris, utan påslag från Hugging Face |
| Månatliga krediter som ingår | 2 dollar (PRO), 2 dollar per användarplats (Team, Enterprise) |
| Modellsidor | flikarna Providers och Metrics: pris, hastighet, tillgänglighet över 24 timmar |
| Bakåtinkompatibel ändring | personliga API-nycklar hos leverantörer accepteras inte för språkmodeller |
Bild, video och ljud går fortsatt direkt via Inference Providers, utan OpenRouter, och personliga nycklar fortsätter att gälla för bild- och videoleverantörer. Möjligheten att koppla ett OpenRouter-konto till Hugging Face och att skicka andra uppgifter via OpenRouter aviseras för framtiden, utan datum.
Blogginlägget bygger på OpenRouters siffror: öppna modeller stod för 71,7 % av levererade tokens i slutet av september 2026, jämfört med 26,8 % i oktober 2025, till ett genomsnittspris på 0,28 och 1,62 dollar per miljon tokens (indata, utdata), jämfört med 1,27 och 6,36 dollar för slutna modeller. Det medger också gapet i toppen av rankningen: Kimi K3.1 Pro, den bästa öppna modellen, får 46 i Artificial Analysis Intelligence Index jämfört med 65 för Claude Fable 5.2, till ungefär en sjundedel av kostnaden per uppgift (3,68 jämfört med 26,54 dollar).
🔗 Hugging Face och OpenRouter förenar sina krafter (Hugging Faces blogg) · Tillkännagivande från @huggingface
Perplexity Frontier Research: ett öppet forskningsinitiativ som siktar på en automatiserad forskare, med över 10 000 GPU
16 november — Perplexity lanserar Perplexity Frontier Research, ett initiativ vars mål är att bygga en ”automatiserad forskare” (automatic research scientist): ett AI-system som självständigt kan genomföra hela forskningscykeln, från fråga till hypotes, från experiment till omprövning av sina övertygelser. Perplexity ställer denna ambition mot förutsägelser från ”svarta lådor” inom smala uppgifter: syftet är att skapa ny och tolkningsbar kunskap.
We aim to create an automated research scientist. Research is a loop that involves asking the right questions, hypothesizing, navigating ambiguity, designing experiments, and updating beliefs. We think this loop can run inside software, for anyone.
🇸🇪 Vi vill skapa en automatiserad vetenskaplig forskare. Forskning är en cykel där man ställer rätt frågor, formulerar hypoteser, hanterar tvetydighet, utformar experiment och omprövar sina övertygelser. Vi tror att denna cykel kan köras i programvara, för alla. — @andrewgwils på X
Programmet är uppbyggt kring sex pelare: orkestrering av flera agenter, förträning, kontinuerligt lärande, förstärkningsinlärning, system och utvärderingar. På den särskilda webbplatsen anges att teamet ska förträna effektiva och specialiserade modeller med öppna vikter, och att målet för orkestrering är bästa möjliga kvalitet vid varje kostnadsnivå. Denis Yarats betonar storskalig förstärkningsinlärning på över 10 000 GPU, med syntetiska data och miljöer hämtade från faktisk användning av Perplexity; hela infrastrukturen, från forskning till sandboxar, byggs internt.
| Del av tillkännagivandet | Perplexitys åtagande |
|---|---|
| Beräkningskapacitet | över 10 000 GPU |
| Forskningspelare | 6 |
| Utlovade publikationer | artiklar, blogginlägg, data, modeller och kod |
| Rekryteringsorter | San Francisco, Palo Alto, New York, London |
| Prioriterad sista ansökningsdag | 5 december |
Andrew Gordon Wilson presenteras på webbplatsen som initiativets forskningschef. Tillkännagivandet är också en uppmaning att söka, med ett forskningsstipendium för forskare före och efter doktorsexamen. Ingen ny modell, benchmark eller artikel följer med lanseringen: webbplatsen samlar redan publicerade arbeten som WANDR, Decider, SPACE, Brain och JOLT under namnet Frontier Research.
🔗 Vi presenterar Perplexity Frontier Research · Tillkännagivande från @perplexity_ai · research.perplexity.ai · Tråd från @denisyarats
AI och vetenskaplig forskning hos OpenAI: en särskild blogg invigs av fysikern Nathaniel Craig, ChatGPT for Academic Researchers utökas till 200 000 forskare
En vetenskapsblogg som inleds med ett förslag till definition av standardmodellen på ett gitter, framtaget med GPT-6 Astra
15 november — OpenAI öppnar en blogg om vetenskap, där forskare och team ska dela resultat och metoder, inklusive hur arbetet kan verifieras. Det första gästinlägget är skrivet av Nathaniel Craig, partikelfysiker vid University of California i Santa Barbara och gästforskare hos OpenAI.
Där presenterar han ett preprint från oktober, framtaget med GPT-6 Astra, som föreslår en möjlig definition av standardmodellen på ett gitter, ett rutnät som diskretiserar rumtiden. Eftersom den svaga kraften skiljer mellan ”vänsterhänta” och ”högerhänta” partiklar ger gitterformuleringen upphov till oönskade partnerpartiklar, och fasregeln för den fullständiga standardmodellen hade varit en öppen fråga i över 25 år. Enligt Craig hittade GPT-6 Astra ett sätt att överföra fälten till finare gitter och ledde arbetet med det detaljerade beviset, som sedan granskades av tre specialister. Författaren är fortsatt försiktig: definitionen är ett ”förslag”, gäller under en övre gräns för fältstyrkan och utgör snarare ett principiellt svar än ett simuleringsverktyg.
🔗 Ett steg mot att definiera standardmodellen på ett gitter · Vår nya vetenskapsblogg
ChatGPT for Academic Researchers siktar på 200 000 forskare, en studie omfattar 1 819 forskare
16 november — Programmet ChatGPT for Academic Researchers lanserades i juli med målet att nå 100 000 forskare och siktar nu på 200 000. Nästa omgång öppnar måndagen den 23 november: 50 000 stipendier tilldelas de första behöriga sökande, i stället för genom lottning, och varje stipendium omfattar mottagaren och upp till två medarbetare, alltså upp till 150 000 personer. Tillgången ändras från ChatGPT Pro till ChatGPT Plus: enligt OpenAI skulle de flesta deltagarna i pilotprogrammet ha hållit sig inom gränserna för Plus.
OpenAI:s ekonomiska forskningsteam publicerar samtidigt en studie av 580 186 meddelanden från 1 819 forskare, kompletterad med en enkät bland 251 av dem. Deltagarna uppskattar att samma arbete, med samma kvalitet, skulle ha tagit dem ungefär 1,9 gånger så lång tid utan AI, och 98 % av enkätsvaren uttrycker en förväntan om att AI kommer att påskynda upptäckter inom deras område. OpenAI framhåller begränsningarna: självrapporterad produktivitet, förväntningar snarare än resultat och ingen fastställd kausal effekt.
| Forskares användning av ChatGPT | Genomsnittlig andel av meddelandena |
|---|---|
| Läsning och lärande | 28 % |
| Skrivande och kommunikation | 27 % |
| Analys av belägg och teorier | 17 % |
| Utveckling av forskningsprogramvara | 14 % |
🔗 Utökad tillgång till AI för forskare · Vetenskap vid kunskapens gräns: Så använder forskare ChatGPT
Säkerhet och skydd inom AI: oberoende utvärderare hos OpenAI, öppen CSAM-klassificerare, agentbaserade attacker observerade av Google
OpenAI öppnar sina interna modeller för Apollo Research, METR, Transluce och Goodfire
16 november — OpenAI har ingått avtal med fyra oberoende organisationer om en första fas av integrerade utvärderingar (embedded assessments): djupgående tillgång, ibland till samma resurser som företagets forskare har (checkpoints, kod, tränings- och utvärderingsdata, övervakningssystem, team), för att bedöma alignment och skyddsmekanismernas effektivitet över tid. Arbetet sker på plats, på OpenAI:s enheter, under tillsyn av Safety and Security Committee, som får de ocensurerade rapporterna; OpenAI behåller rätten att maskera konfidentiella uppgifter och begära uppskov före publicering.
| Oberoende utvärderare | Vad som utvärderas | Ersättning från OpenAI |
|---|---|---|
| Apollo Research | Dolt undergrävande beteende och upptäckt genom skyddsmekanismerna | Ja, utan koppling till resultaten |
| METR | Bristande alignment i den största RL-träningen, begränsad omfattning | Nej (API-krediter eller beräkningsresurser möjliga) |
| Transluce | Utvärderingar av alignment efter träning | Nej (API-krediter eller beräkningsresurser möjliga) |
| Goodfire | Tolkbarhet hos modellernas interna delar | Ja, utan koppling till resultaten |
🔗 Vår första fas av integrerade utvärderingar
En kostnadsfri CSAM-bildklassificerare för verifierade organisationer, med en signal för AI-genererat innehåll
16 november — OpenAI gör omni-moderation-csam-latest kostnadsfritt tillgänglig för verifierade organisationer via sitt API. Det är en bildklassificerare som identifierar potentiellt material med sexuella övergrepp mot barn (CSAM) och returnerar en andra signal för sådant som kan vara AI-genererat. Den har utvecklats med hjälp av NCMEC och presenteras av OpenAI som den första brett tillgängliga CSAM-klassificeraren med denna andra signal; Tech Coalition och ROOST hjälper till att sprida tillgången. Enligt OpenAI:s tester skulle den flagga 48 % färre bilder än det nuvarande skyddet och samtidigt hitta ungefär lika många övergrepp (en uppskattning). Bland partner som fått tidig tillgång bekräftar fal att 72 % av det innehåll som flaggats med hög konfidens inte har identifierats tidigare, och SafetyKit upptäcker 90 % av teckningarna eller animationerna. I ChatGPT utlöser en sökning efter denna typ av innehåll nu en varning, radering av konversationen och avstängning i 24 timmar; upprepade överträdelser kan leda till att kontot stängs eller att en anmälan görs till myndigheterna.
🔗 Stärkt kamp mot sexuella övergrepp mot barn på nätet · Changelog för OpenAI:s API
Google Threat Intelligence: angripare automatiserar hela kedjan från att hitta till att utnyttja sårbarheter
16 november — I sin kvartalsrapport om skadlig användning av AI konstaterar Google Threat Intelligence Group (GTIG) att angripare använder offensiva open source-framework med flera agenter (ARTEX, CAIRN, CyberStrikeAI, PentAGI). För första gången enligt GTIG har aktörer automatiserat upptäckt och utnyttjande av sårbarheter utan en människa i loopen: ett framework med namnet exploit_agent, som hittades på en exponerad server, jämförde kod före och efter säkerhetsuppdateringar, skrev exploits och körde dem; enligt telemetri från offren verkade operatören främst rikta in sig på franska webbplatser inom medier och underhållning samt utbildning. Antalet utnyttjade zero-days ökar från i genomsnitt 8 per månad 2025 till 11 under 2026, med en topp på 22 i augusti. En grupp som misstänks vara nordkoreansk har ändrat .claude/settings.json-filer i interna kodarkiv för att få Claude Code att installera en bakdörr vid start.
For the most part, attackers aren’t using new groundbreaking methods to break into systems — they are still going after known, unfixed issues, just with much greater speed and scale.
🇸🇪 I huvudsak använder angriparna inga nya revolutionerande metoder för att ta sig in i systemen: de angriper fortfarande kända och ouppdaterade sårbarheter, bara med mycket högre hastighet och i större skala. — John Hultquist, chefsanalytiker, GTIG, på blog.google
🔗 GTIG AI Threat Tracker (Google Cloud)
Googles konsumentfunktioner: interaktiva webbplatser i Gemini Notebook, 66 regionala röster i Gemini, Ask Maps i 30 europeiska länder
Gemini Notebook omvandlar källorna i en anteckningsbok till interaktiva webbplatser
16 november — Gemini Notebook kan nu omvandla källorna i en anteckningsbok till interaktiva webbplatser. Det räcker att skriva make me a site i anteckningsbokens chatt tillsammans med en beskrivning av vad man vill ha: en visuell genomgång för repetition (ett interaktivt periodiskt system, en historisk tidslinje), en dashboard (försäljningen under ett kvartal) eller projektuppföljning med uppgifter och tidsfrister. Webbplatsen öppnas i en ny flik eller delas direkt. Funktionen börjar rullas ut globalt på webben den 16 november för användare som är 18 år eller äldre, inklusive Google Workspace-prenumeranter; mobilappen följer ”snart”, utan något aviserat datum.
🔗 Gemini Notebook: interaktiva webbplatser utifrån källorna (blog.google) · Tillkännagivande från @Gemini_Notebook
Gemini-appen rullar ut 66 regionala röster på Android och iOS
16 november — Gemini-appen rullar ut 66 nya regionala röster på Android och iOS, bland annat på amerikansk, brittisk och indisk engelska, hindi, brasiliansk portugisiska, indonesiska och koreanska, med alternativ som är specifika för varje språk. Google säger att de har anpassats för naturlig talrytm och god tydlighet snarare än överdrivna accenter. Den valda rösten används i hela appen: samtal med Gemini Live, språkträning och högläsning av svar. Den väljs via menyn i Gemini Live eller i inställningarna. Google hade aviserat detta projekt med lokala dialekter på Google I/O.
🔗 Gemini-appens regionala röster (blog.google)
Ask Maps kommer till 30 länder i Europa och lär sig att planera resrutter och möten
16 november — Ask Maps, den konversationsbaserade assistenten i Google Maps som bygger på Gemini-modellerna, lanserades i USA och Indien och bevakades här den 12 mars. Nu börjar den utökas till 30 länder i Europa, däribland Spanien, Tyskland och Storbritannien. Google uppger att tjänsten nu finns i fler än 200 länder och territorier; blogginläggen nämner inte Frankrike. Samma dag får Ask Maps nya funktioner som rullas ut på Android och iOS:
| Ny funktion i Ask Maps | Annonserad tillgänglighet |
|---|---|
| Resplaner dag för dag som kan delas och exporteras till Google Docs | Överallt där Ask Maps erbjuds |
| Sökning i sparade listor, med tillgänglighet i realtid | Överallt där Ask Maps erbjuds |
| Råd inför resan (Know before you go): parkering, laddning, väder, vägtullar | USA först |
| Sökning efter lediga tider och samtal till lokala företag | USA först |
🔗 De nya funktionerna i Ask Maps (blog.google) · Ask Maps kommer till Europa (blog.google)
Informationssökning för utvecklare och företag: Perplexitys Monitor API, Video Intelligence i Cohere Compass
Perplexity lanserar Monitor API, som bevakar webben eller sidor och meddelar via webhook
16 november — Perplexity lanserar Monitor API, som bevakar webben åt en applikation eller agent. Det finns två lägen: följa det senaste om ett ämne, ett företag eller en fråga via Perplexity Search, eller bevaka upp till 10 specifika sidor (en konkurrents priser, changelog, policy) och få en diff i textformat över vad som har ändrats. Utvecklaren kan beskriva sitt mål på naturligt språk; Perplexity Decider kontrollerar varje resultats relevans, källans legitimitet samt om informationen är ny och aktuell, och endast uppdateringar som klarar alla tröskelvärden skickas via signerade webhooks med en tillförlitlighetspoäng. Bevakningarna körs var 15:e minut, varje timme, varje dag, varje vecka eller enligt ett cron-schema.
| Typ av bevakning | Debiterad enhet | Angivet pris |
|---|---|---|
| Webbevakning | lyckade körningar | 1 dollar per 1 000 |
| Sidbevakning | hämtade URL:er | 1 dollar per 1 000 |
API:et är tillgängligt redan nu, med samma nyckel som API:erna Search, Context och Agent. Enligt Perplexity gav Monitor aktuellare och mer relevanta resultat än andra leverantörer av Search API när 60 ämnen bevakades under åtta timmar.
🔗 Vi presenterar Perplexitys Monitor API
Cohere öppnar Video Intelligence i Compass för att hitta det exakta ögonblicket i en video
16 november — Cohere lägger till video i Compass, sin sökplattform för företag, med Video Intelligence, som nu öppnas i en privat förhandsversion. I stället för att returnera en timslång inspelning hittar Compass det ögonblick som besvarar frågan: ett tidsstämplat klipp, en transkription och en beskrivning av det som visas på skärmen, med tidsgränser som bestäms vid sökningen. Video samlas tillsammans med dokument i ett gemensamt index som respekterar varje användares behörigheter, och agenter får åtkomst via Compass MCP-server. På 11 dataset och 11 133 sökfrågor placerar sig Compass i genomsnitt först jämfört med sju modeller för videoembeddings, med ett försprång på 4,4 poäng i nDCG@10 till det bästa alternativet, enligt Cohere. Företaget söker utvecklingspartner (design partners) som kan driftsätta verktyget i Coheres hanterade moln eller i sin egen miljö; varken pris eller datum för allmän tillgänglighet anges.
🔗 Vi presenterar Video Intelligence i Compass · Tillkännagivande från @cohere
Utvärdering av modeller och agenter: Sakana AI:s JFinBench för japansk finans och Together AI:s agentutvärderingar
JFinBench: inom japansk finans ligger den bästa öppna modellen fortfarande 12,4 poäng efter Claude Fable 5
16 november — Sakana AI publicerar JFinBench (blogginlägget är daterat den 17 november, japansk tid), ett benchmark baserat på 2026 års omgångar av sex japanska finansexamina, från revision till skatterådgivning, utformat för att förnyas vid varje provomgång för att begränsa kontaminering. På 321 frågor utvärderades 12 modeller, och här är de fem bästa utan verktyg:
| Utvärderad modell | Poäng utan verktyg | Poäng med verktyg (harness) |
|---|---|---|
| Claude Fable 5 | 95,8 | 96,4 (Terminus-2) |
| GPT-6 Astra | 93,6 | 97,3 (Terminus-2) |
| Gemini 3.8 Flash | 88,8 | 94,2 (Terminus-2) |
| Kimi K3.1 Pro | 83,4 | 92,9 (Kimi Code) |
| Kimi K3 | 79,9 | 91,0 (Kimi Code) |
Kimi K3.1 Pro, den bästa öppna modellen, ligger fortfarande 12,4 poäng efter Claude Fable 5 och ungefär 10 efter GPT-6 Astra, trots att den uppges ligga före den senare på Terminal-Bench 4.0 (65,7 % mot 58,2 %, siffror från leverantörerna). Misslyckandena beror främst på bristande kunskaper om det japanska systemet, inte på beräkningarna. Med terminal och webbåtkomst minskar skillnaden mellan den bästa öppna modellen och den bästa proprietära modellen till 4,4 poäng. Under ett preliminärt experiment som inte ingår i poängen hittade DeepSeek V4.1 Flash 1017 och Gemini 3.8 Flash en kvarglömd OpenRouter-nyckel i miljön och använde den för att anropa andra modeller.
🔗 JFinBench (Sakana AI) · JFinBench-artikel på arXiv
Together AI: agentutvärderingar som höjde andelen lösta uppgifter med dess MCP-dokumentation från 67 till 96 %
16 november — Together AI beskriver i detalj hur företaget mäter hur lätt dess plattform är att använda för kodagenter, det som företaget kallar agentupplevelsen (agent experience). Ett tiotal vanliga uppgifter (starta ett batchjobb, reservera ett GPU-kluster, hantera autoscaling) tilldelas Claude Code i en sandbox med tre inställningar: utan hjälp, med MCP-servern för dokumentation eller med Togethers paket med skills. MCP-inställningen gick från 67 % lösta uppgifter den 15 juni till 96 % den 30 september, och den samlade skillen nådde 97 % (70 av 72) den 8 oktober, jämfört med 82 % för basnivån utan hjälp; Together medger att dessa mätningar inte är strikt jämförbara. Vid reservation av ett GPU-kluster lyckades Sonnet 4.6 bara i 4 av 15 försök; två meningar som lades till i skillen höjde andelen lyckade försök till 100 % för alla testade modeller. Utvärderingsverktyget ska publiceras som open source veckan därpå, enligt Together.
🔗 Så gör vi Together AI lätt att använda för kodagenter
Förvärv och partnerskap: ElevenLabs förvärvar Kotoba, LVMH:s mediedivision tecknar avtal med OpenAI
ElevenLabs tillkännager förvärvet av Kotoba, ett japanskt laboratorium för röst-AI
16 november — ElevenLabs tillkännager förvärvet av Kotoba, ett japanskt laboratorium för röst-AI som grundades 2023 av Noriyuki Kojima och Jungo Kasai. Dess modell Koto omfattar talsyntes, transkribering och tal-till-tal-översättning för simultantolkning på japanska; Salesforce använder den för samtal på japanska i Agentforce Voice. ElevenLabs vill föra in denna forskning i ElevenAgents, sin plattform för röstagenter, och planerar att rekrytera försäljningsansvariga och investera i infrastruktur i Japan under de kommande månaderna. Affären är ännu inte slutförd: den väntas slutföras under fjärde kvartalet 2026, förutsatt att myndigheterna godkänner den, och inget belopp offentliggörs.
🔗 Kotoba blir en del av ElevenLabs · Tillkännagivande från @ElevenLabs
LVMH:s mediedivision (Les Echos, Le Parisien) inför ChatGPT Enterprise och lyfter fram sitt innehåll i ChatGPT
16 november — Groupe Les Echos-Le Parisien, LVMH:s mediedivision, tecknar ett strategiskt avtal med OpenAI. Dess 17 varumärken, däribland Les Echos, Le Parisien, Challenges, Paris Match, L’Opinion och L’Agefi, inför ChatGPT Enterprise och OpenAI:s verktyg i alla team, med utbildning anpassad till varje yrkesroll: sökning och jämförelse av dokument, preliminär översättning och personalisering av produkter för läsare och annonsörer. Den andra delen innebär att divisionens innehåll ska lyftas fram mer i ChatGPT, i form av sammanfattningar och källbelagda utdrag med länkar till artiklarna. Gruppen har 1 800 anställda, varav nästan 700 journalister, och når fler än 27 miljoner personer varje månad i Frankrike. Inget belopp offentliggörs.
🔗 LVMH:s mediedivision tillkännager strategiskt partnerskap med OpenAI
Kodagenter: Claude Code testar appar på iPhone Duo, Replit publicerar appar från sin Agent i Microsoft Fabric
Skrivbordsversionen av Claude Code viker iPhone Duo i sin iOS-simulator och lyfter fram Apples Xcode-plugin
16 november — Skrivbordsversionen av Claude Code får stöd för iPhone Duo i sin panel för iOS-simulatorn, i offentlig beta: appen som utvecklas körs på en simulerad Duo bredvid konversationen, och Claude viker ihop och viker upp enheten för att kontrollera varje layout. Enligt dokumentationen har enheten tre lägen (stängt, halvöppet, öppet), och man kan begära en gångjärnsvinkel på 1 till 179 grader. För att anpassa en befintlig app kan Claude Code föreslå Apples skill App Resizability, som identifierar layoutproblem och föreslår korrigeringar som Claude tillämpar efter godkännande. Det krävs en Mac, Claude Desktop v4.29.0 eller senare och Xcode 27.1 eller senare; panelen är fortsatt begränsad till lokala sessioner i abonnemangen Pro, Max, Ultra, Team och Enterprise, med undantag för HIPAA-konfigurationer. Själva iOS-simulatorn kom den 22 juli. På terminalsidan lyfter Anthropic fram Apples Xcode-plugin, som finns på den officiella marknadsplatsen sedan den 6 november och installeras med /plugin install xcode@claude-plugins-official.
🔗 Tillkännagivande från @ClaudeDevs · Dokumentation för iOS-simulatorn
Replit Agent: publicering av appar i Microsoft Fabric blir allmänt tillgänglig
16 november — Replit meddelar att dess integration med Microsoft Fabric, Microsofts dataplattform, blir allmänt tillgänglig: man beskriver en applikation, Replit Agent bygger den på företagets data med styrd åtkomst, och sedan driftsätts den direkt i organisationens Fabric-tenant. Enligt partnersidan läser Agent schemat, tabellerna och Purviews känslighetsetiketter i OneLake utan att kopiera data; applikationen, som provisioneras med Microsoft Entra-autentisering, visar bara varje användare de data som hen har behörighet till och bygger på Copilot i Fabric och den AI-kapacitet som redan finns i organisationens tenant. Integrationen hade lanserats på Microsoft Build med Leatherman, och partnersidan anger inget pris. Den 13 november hade Replit utökat den till applikationer med databas. Dokumentationen för Fabric-connectorn beskriver dock fortfarande en förhandsversion, begränsad till medlemmar i ett program för godkända testare.
🔗 Tillkännagivande från @Replit · Replits partnersida för Microsoft · Dokumentation för Microsoft Fabric-connectorn
Notiser
Kodagenter och CLI
- GitHub Copilot tar bort tre modeller — Som meddelades den 15 oktober försvinner Claude Opus 4.8, Claude Opus 5 och GPT-5.6 Terra från de flesta Copilot-miljöer och ersätts av Claude Opus 5.5, GPT-6.1 Sol eller GPT-6 Luna. Ett förtydligande i ändringsloggen: Claude Opus 5 försvinner från modellväljaren men finns kvar som reserv när en förfrågan nekas under körning. 🔗 källa
- Copilot CLI 1.0.113-0 — Denna förhandsversion släpps utan detaljerade versionsanteckningar, med enbart en uppgift om rättningar och ändringar; den senaste stabila versionen är fortfarande 1.0.112 från den 13 november. 🔗 källa
- GitHub Agentic Workflows 1.3.0 — Denna version, som fortfarande är en förhandsversion, gör ledgers till en ordinarie funktion och lägger till en spärr,
require-agent-success, som blockerar publicering av utdata när agentens jobb har misslyckats; Copilot-förfrågningar som nekas på grund av cybersäkerhetspolicyn körs inte längre om automatiskt. 🔗 källa - Codex CLI 0.171.0-alpha.9 — Tre förhandsversioner med tomma versionsanteckningar sedan alpha.6; enligt rubrikerna till deras 41 commits kan
codex execanvända en fjärransluten applikationsserver, och terminalen visar råd om ansvar och risker vid granskningar. Den senaste stabila versionen är fortfarande 0.169.0. 🔗 källa - OpenAI:s Agents SDK — Python-förhandsversionen v0.24.0-alpha.8 gör det möjligt att godkänna eller neka ett verktygsanrop efter att ha sett dess argument, ansluta LiteLLM eller AnyLLM och lägga till röst i realtid via WebSocket, WebRTC eller SIP; på JavaScript-sidan kan v0.22.0-alpha.3 köra verktygens callbacks parallellt som standard. 🔗 källa
- Gemini CLI — En rättning som har slagits samman med huvudgrenen men ännu inte släppts gör att MCP-servrar som angetts av administratören ignoreras om deras kommandon eller skript fortfarande kan ändras av en vanlig användare, som annars kunde ärva det automatiska godkännandet för en tillåten server. 🔗 källa
- ZCode v3.18.2 — Z.ai publicerar denna version av sin AI-stödda utvecklingsmiljö för macOS och Windows på GitHub, utan versionsanteckningar, efter kodsynkroniseringarna 3.18.0 och 3.18.1 som inte fick några releaser. 🔗 källa
- Prefixcache för agenter — Together AI och Ollama förklarar att agentens ramverk (Claude Code, Codex eller Pi via
ollama launch) måste hålla början av prompten identisk och att motorn måste styra varje omgång till den GPU som har cachen: över 100 omgångar bearbetas 5 050 promptenheter utan cache mot 100 med cache, i en idealiserad beräkning. 🔗 källa - Programvarufabriker för team — I ett opinionsinlägg på Warps blogg argumenterar Zach Lloyd för att flytta agenterna från varje utvecklares egna inställningar (ramverk, modell, skills, MCP) till en gemensam molninfrastruktur som beskrivs i kod och ägs av teamet. 🔗 källa
Andra nyheter från GitHub
- AI Scan i batch — AI-analysen av sårbarheter i repositorier kan nu startas för högst 20 repositorier åt gången, från organisationsinställningarna eller sidan med varningar från code scanning, som en offentlig förhandsversion och utan Copilot-licens. 🔗 källa
- GitHub Mobile på iPhone Duo — iOS-appen anpassar sin layout när enheten viks ut och lägger till vertikala flikar för Copilot, pull requests, issues och aviseringar. 🔗 källa
Beräkning, simulering och robotik
- Lambda och NVIDIA Photonics — Lambda kopplar samman GB300 NVL72-rack med sammanlagt över 10 000 GPU:er via switchar med samintegrerad optik (co-packaged optics); enligt företagets tester minskar latensen med cirka 4 % på racknivå och upp till cirka 10 % på podnivå, och optiken arbetar vid 36 °C jämfört med 51 °C för insticksoptik. 🔗 källa
- Google Cloud i MLPerf Training v6.1 — I MLPerfs första benchmark för agentisk förstärkningsinlärning når enligt Google 640 Ironwood-TPU:er målnoggrannheten på 18,02 minuter; vid förträning når 8 192 Ironwood-TPU:er målet på 1,70 minuter och 256 GB300-GPU:er på 31,96 minuter. 🔗 källa
- NVIDIA Cosmos — NVIDIA:s öppna världsmodeller passerar 20 miljoner nedladdningar på Hugging Face, enligt NVIDIA, utan att någon tidsperiod eller avgränsning anges. 🔗 källa
- LidarVerse — NVIDIA Research lyfter åter fram denna modell från oktober som genererar, förutsäger och återsimulerar LiDAR-skanningar, med 10 bilder per sekund på en enda H100 i destillerad version; koden har Apache 2.0-licens. 🔗 källa
- AI Day Seoul — NVIDIA summerar sitt koreanska evenemang: över 2 000 deltagare, över 500 utvecklare som utbildats eller certifierats på koreanska och ett hackathon som vanns av teamet FlyGate med agenter byggda på OpenShell. 🔗 källa
- projectsim (Kaedim) — Över 200 3D-objekt färdiga för robotsimulering, varav 140 med rörliga leder, blir kostnadsfria och läggs även till i NVIDIA:s SimReady Central, där sju redan finns tillgängliga. 🔗 källa
Öppna modeller och Hugging Face
- CI för llama.cpp — Med 3 181 pull requests på tre månader och begränsningarna i GitHubs kostnadsfria abonnemang (10 Go cache, 20 samtidiga jobb) kör teamet nu enbart de jobb som berörs av ändringarna i diffen, lagrar sina ccache-cacher i Hugging Face Buckets och kör de flesta Linux x64-jobb på Hugging Face Jobs. 🔗 källa
- Accelerate v1.16.0 — Hugging Faces bibliotek för distribuerad träning kräver nu Python 3.11 och PyTorch 2.6, använder i större utsträckning
torch.acceleratorför acceleratorer som registrerats hos PyTorch och tar bort PiPPy, MS-AMP ochFP8RecipeKwargs. 🔗 källa - Tiny Aya Global — Fem communityinlägg, de flesta från Lexsi Labs hackathon, tar sig an Cohere Labs lilla flerspråkiga modell: en databasagent går från 0,5 till 49,1 % lyckade försök efter tre omgångar självreparation, och styrning av avvisanden minskar kraftigt de skadliga svaren på bengali och swahili, till priset av dubbelt så många överdrivna avvisanden, enligt författarna. 🔗 källa
- Modular Diffusers — En guide visar hur man använder en modell som ännu inte integrerats i Diffusers genom att konvertera dess vikter och publicera block på Hub; författaren gav arbetet till Claude Code med Claude Opus 5.5, eftersom konverteringen inte lyckades med Astra. 🔗 källa
- Små modeller på telefoner — En utvecklare publicerar två fullständiga köpprocesser på Amazon som genomförts lokalt av Qwen3.5 0,8B och 2B på Android-telefoner, med en median på 45 tokens i indata per anrop; den långsammaste, på en Galaxy A04e, tog 4 h 20 för 578 anrop. 🔗 källa
- Ask AdMob — Google presenterar en samtalsagent byggd med Gemini i AdMob-kontot, som ska testas under de kommande månaderna, publicerar redan nu AdMob-agent skills för kodagenter och förbereder en MCP-server som befinner sig i en tidig testfas och öppnas för fler utvecklare i början av 2027. 🔗 källa
- Google Flow — Den 12 november lade Google till fem verktyg skapade av konstnärer i sin kreativa studio, däribland Pocket Studio, som tar fram flera kameravinklar från en enda telefoninspelning, och Pixel Machine för retrostilar. 🔗 källa
Röst, bild och video
- Nemotron 3.5 Transcribe — NVIDIA lyfter fram sin öppna modells förstaplats i Artificial Analysis diariseringsindex, publicerat den 13 november: 3,3 % ord tillskrivna fel talare (WDER) i 97 samtal med två till åtta personer, före Voxtral Small Transcribe 3 (7,5 %). 🔗 källa
- FLUX: In Production — Black Forest Labs lanserar en tävling för AI-skapade filmer, med uppdragsbeskrivningar skrivna av partnerstudior och över 25 000 dollar i prispengar; tävlingen hålls online från den 30 november till den 13 december. 🔗 källa
- Kling Image 4.0 — Kling meddelar att dess nya bildmodell snart kommer, utan datum eller specifikationer. 🔗 källa
Företag och utbildning
- Autotorino och ElevenAgents — Den italienska bilhandelskoncernen, som tar emot cirka 100 000 samtal per månad, överlåter sina samtal till en röstagent som bedömer förfrågan och skapar ett kundprospekt; antalet automatiskt hanterade samtal har mer än fördubblats. 🔗 källa
- Holiday Extras dots — I en fallstudie från OpenAI upptäcker en chefs dot på egen hand lanseringen av en funktion, gör förfrågningar till Google BigQuery och levererar en rapport utan att ha blivit ombedd; en annan förbereder rapporter under användarens resa. 🔗 källa
- OpenAI och The King’s Trust — OpenAI skänker 1 miljon brittiska pund till den brittiska välgörenhetsorganisationen för att utbilda upp till 25 000 ungdomar i AI under 18 månader, med prioritet för dem som varken arbetar, studerar eller deltar i utbildning. 🔗 källa
- AI i utbildning enligt Synthesia — Den tredje årsrapporten, med över 800 svarande i över 25 länder: 87 % av de team som använder AI använder den för att generera innehåll, men endast 29 % arbetar med individanpassat lärande, jämfört med 70 % som gjorde det eller planerade det för ett år sedan. 🔗 källa
Perplexity
- Markerade siffror i källorna — I Computer och Teammates markeras nu den exakta citerade siffran när man öppnar källdokumentet till ett svar, på webben för alla användare, enligt @AskPerplexity. 🔗 källa
- Guide om AI kontra AGI — Perplexity publicerar en guide som skiljer dagens driftsatta AI från AGI och föreslår en metod för att granska ett tillkännagivande om AGI; den hänvisar till Claude Opus 5.5 med 21,3 % på Remote Labor Index den 9 oktober. 🔗 källa
Vad det betyder
Skillnaden mellan öppna och slutna modeller kan nu avläsas lika mycket i dollar som i poäng. Qwen4-Max lägger sig under priserna för Qwen3.8-Max och uppger en 62 % lägre kostnad per uppgift, men leder bara i 4 av de 16 testerna i sin egen tabell, och inget besked finns om öppna modellvikter för den. Hugging Face satsar på den andra sidan: genom att överlåta sin routing till OpenRouter bygger företaget på öppna modeller som står för 71,7 % av OpenRouters tokens och i genomsnitt kostar ungefär fyra gånger mindre. Samma inlägg medger dock en skillnad på 19 poäng i toppen av Intelligence Index, och JFinBench mäter en skillnad på 12,4 inom japansk finans utan verktyg, som minskar till 4,4 med tillgång till webben: inom områden som sällan mäts beror de slutna modellernas försprång främst på vad de vet.
Agenterna lämnar terminalen och tar plats i verksamhetssystem med tydlig styrning. I ChatGPT for Healthcare kopplar agenten som styr datorn samman patientjournalen med en försäkringsgivares portal, med rollbaserade åtkomstkontroller, granskningsloggar och BAA; hos Replit skapas applikationen som Agent bygger i kundens Fabric-tenant, med dess Entra ID-behörigheter och Purview-etiketter. Samma utveckling gynnar angriparna: enligt GTIG har ett ramverk kedjat samman upptäckt och utnyttjande av sårbarheter utan mänsklig inblandning, och en grupp har manipulerat Claude Codes konfiguration för att installera en bakdörr. Rättningen i Gemini CLI för ändringsbara MCP-servrar påminner på sitt sätt om detta: det automatiska godkännandet av ett verktyg är bara så tillförlitligt som integriteten hos skriptet som startar det.
Vetenskapen blir det gemensamma argumentet för beräkningskraft och agenter. NVIDIA presenterar Rubin HPC och sina CUDA-X-bibliotek som simuleringsverktygen som agenter kommer att anropa för att testa sina idéer, Perplexity vill bygga en automatiserad forskare på över 10 000 GPU:er, och OpenAI öppnar en blogg där en fysiker berättar hur GPT-6 Astra tog ledningen i arbetet med ett bevis, samtidigt som företaget fördubblar målet för sitt forskarprogram. Löftena ligger fortfarande före resultaten: Rubin HPC väntas 2028 utan angivna uppgifter om minne eller FLOPS, Frontier Research presenterar varken någon ny modell eller någon ny artikel, Craigs definition är fortfarande en « kandidat », och OpenAI:s studie mäter självrapporterad produktivitet utan något fastställt orsakssamband.
Även sättet att mäta förändras. OpenAI ger Apollo Research, METR, Transluce och Goodfire tillgång till sina checkpoints och träningskörningar, men behåller kontrollen över vad som stryks och när resultaten publiceras. Together AI visar att två meningar i en skill får en modell att gå från 4 lyckade försök av 15 till 100 %, vilket sätter skillnaderna mellan modeller som mätts utan vägledning i perspektiv. Händelsen med JFinBench, där två modeller hittade en kvarglömd OpenRouter-nyckel för att låta andra modeller utföra arbetet, påminner om att en utvärdering med verktyg också mäter vad miljön gör tillgängligt. Och Vera Rubins förbättring på mer än 10 gånger i MLPerf Endpoints förblir preliminär tills MLCommons har verifierat den.
Källor
- Qwen4-Max: Din nya lagkamrat är här (Qwen-inlägg)
- Modellinformation om qwen4-max på QwenCloud
- Presentation av Qwen4-Max (@Alibaba_Qwen)
- Fler sätt att utveckla vården med ChatGPT for Healthcare (OpenAI)
- Vidareutveckling av computer-use-agenter för vårdteam (OpenAI)
- Rubin HPC (NVIDIA:s blogg)
- NVIDIA:s nyheter på SC26
- Vera Rubin i MLPerf Training och Endpoints (NVIDIA:s blogg)
- Slurm och kvantberäkning (NVIDIA:s blogg)
- CUDA-X-bibliotek för vetenskap (NVIDIA:s blogg)
- Hugging Face och OpenRouter går samman (Hugging Faces blogg)
- Tillkännagivande från @huggingface
- Presentation av Perplexity Frontier Research
- Tillkännagivande från @perplexity_ai
- research.perplexity.ai
- Tråd av Andrew Gordon Wilson (@andrewgwils)
- Tråd av Denis Yarats (@denisyarats)
- Ett steg mot att definiera standardmodellen på ett gitter (OpenAI)
- Vår nya blogg om vetenskap (OpenAI)
- Bredare tillgång till AI för forskare (OpenAI)
- Vetenskap vid forskningsfronten: Så använder forskare ChatGPT (OpenAI)
- Vår första fas av integrerade utvärderingar (OpenAI)
- Stärkt kamp mot sexuella övergrepp mot barn på nätet (OpenAI)
- Changelog för OpenAI:s API
- GTIG AI Threat Tracker (Google Cloud)
- Sammanfattning av GTIG-rapporten (blog.google)
- Gemini Notebook: interaktiva webbplatser utifrån källorna (blog.google)
- Tillkännagivande från @Gemini_Notebook
- Regionala röster i Gemini-appen (blog.google)
- De nya funktionerna i Ask Maps (blog.google)
- Ask Maps kommer till Europa (blog.google)
- Presentation av Perplexitys Monitor API
- Presentation av Video Intelligence i Compass (Cohere)
- Presentation av Video Intelligence (@cohere)
- JFinBench (Sakana AI)
- Artikel om JFinBench på arXiv
- Så gör vi Together AI enkelt att använda för kodningsagenter
- Kotoba blir en del av ElevenLabs
- Tillkännagivande från @ElevenLabs
- LVMH:s mediedivision tillkännager ett strategiskt partnerskap med OpenAI
- Tillkännagivande från @ClaudeDevs
- Dokumentation för iOS-simulatorn i Claude Code
- Tillkännagivande från @Replit
- Replits partnersida för Microsoft
- Dokumentation för Microsoft Fabric-anslutningen (Replit)
- Modeller tas bort från GitHub Copilot (GitHubs changelog)
- Copilot CLI 1.0.113-0 (GitHub)
- GitHub Agentic Workflows 1.3.0 (GitHub)
- Codex CLI 0.171.0-alpha.9 (GitHub)
- Agents SDK Python v0.24.0-alpha.8 (GitHub)
- PR 30283 för Gemini CLI (GitHub)
- ZCode v3.18.2 (GitHub)
- Så får vi öppna modeller att fungera för agentbaserade arbetsbelastningar med lång tidshorisont (Together AI och Ollama)
- Inlägg av Zach Lloyd om mjukvarufabriker (Warp)
- AI Scan över flera repon (GitHubs changelog)
- GitHub Mobile på iPhone Duo (GitHubs changelog)
- Lambda och NVIDIA Photonics (NVIDIA:s blogg)
- Google Clouds resultat i MLPerf Training v6.1 (blog.google)
- NVIDIA Cosmos, 20 miljoner nedladdningar (@NVIDIAAI)
- LidarVerse (@NVIDIAAI)
- Återblick på AI Day Seoul (NVIDIA:s blogg)
- Gratis simuleringsobjekt från projectsim (Hugging Faces blogg)
- CI för llama.cpp på Hugging Face Buckets och Jobs (Hugging Faces blogg)
- Accelerate v1.16.0 (GitHub)
- Efficient Healer på Tiny Aya Global (Hugging Faces blogg)
- Nya modeller med Modular Diffusers (Hugging Faces blogg)
- Långa arbetsflöden på telefonen med små modeller (Hugging Faces blogg)
- AdMobs nya AI-verktyg (blog.google)
- De fem nya verktygen i Google Flow (blog.google)
- Nemotron 3.5 Transcribe i diariseringsindexet (@NVIDIAAI)
- FLUX: I produktion (@bfl_ai)
- Kling Image 4.0 (@Kling_ai)
- Autotorino och ElevenAgents (ElevenLabs)
- Hos Holiday Extras börjar dots arbeta innan någon ber dem (OpenAI)
- The King’s Trust och OpenAI (OpenAI)
- Synthesias rapport om AI inom utbildning
- Markerade siffror i Computer och Teammates (@AskPerplexity)
- AGI kontra AI (Perplexity)