ai-powered-markdown-translatorArticolo tradotto dal francese all’italiano con gpt-6.1-sol.
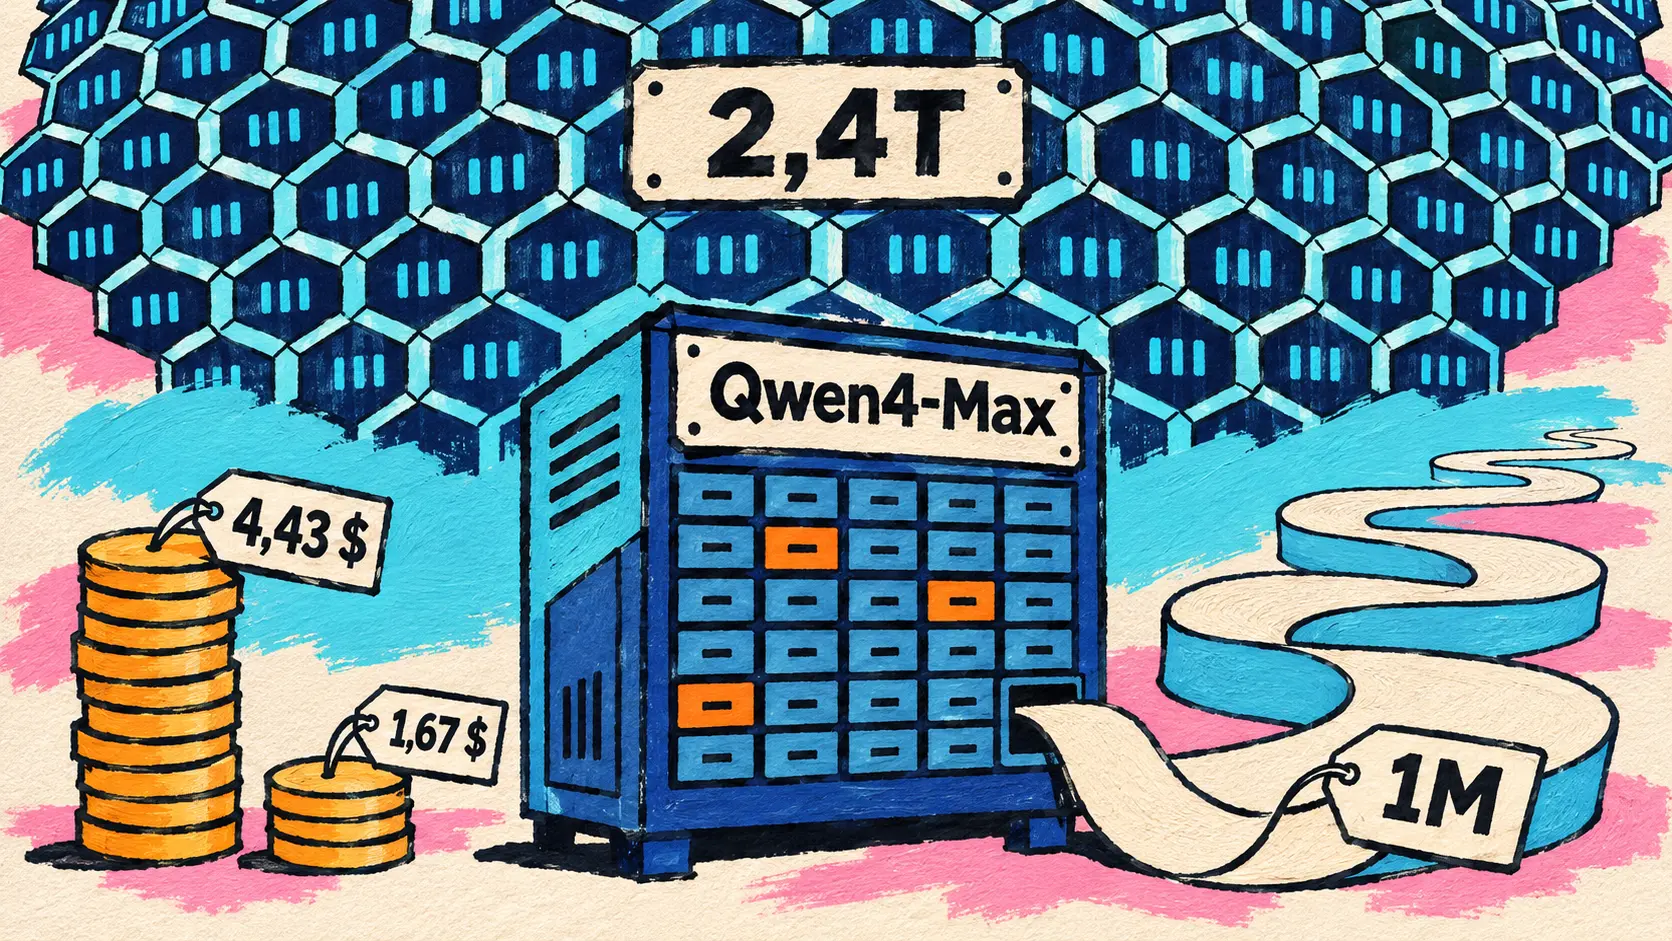
Qwen rende disponibile Qwen4-Max nella sua API: un modello MoE da 2,4T parametri, con un contesto di 1M tokens, a un prezzo inferiore rispetto a Qwen3.8-Max. OpenAI estende i suoi agenti che controllano il computer a ChatGPT for Healthcare e ChatGPT for Clinicians, NVIDIA annuncia a SC26 Rubin HPC, una GPU per la simulazione attesa nel 2028, insieme ai primi risultati di Vera Rubin in MLPerf Training, e Hugging Face affida a OpenRouter il routing dei suoi Inference Providers. Perplexity, dal canto suo, lancia Perplexity Frontier Research, che punta a uno scienziato automatizzato con oltre 10 000 GPU.
Qwen4-Max arriva nell’API di QwenCloud: MoE da 2,4T parametri, contesto di 1M tokens, tariffe in calo
16 novembre — Cinque giorni dopo l’anteprima trattata l’11 novembre, Qwen rende disponibile Qwen4-Max nell’API di QwenCloud con l’identificativo qwen4-max, accompagnato da un lungo post tecnico. È il primo modello della serie Qwen4: modelli Qwen4 più piccoli saranno distribuiti con pesi aperti, senza una data fissata, ma non ci sono annunci in tal senso per Max. Il modello è disponibile anche in QwenWork, Qoder e Qwen Studio, e già dallo stesso giorno su OpenRouter, Vercel AI Gateway, Novita AI e OpenCode Go.
L’architettura è nuova. Questo insieme di esperti (Mixture of Experts, MoE) conta 2,4T parametri di base, di cui 71B attivati per token, più 328B parametri di N-gram Embedding. Su quattro livelli, tre Gated DeltaNet comprimono la cronologia in uno stato di dimensioni fisse; il quarto, basato su Qwen Sparse Attention, seleziona il contesto utile per blocchi. Il modello dispone di visione nativa e di un contesto di 1M tokens: 991K in ingresso e 131K in uscita, 983K e 262K in modalità ragionamento, secondo la pagina QwenCloud.
| Tipo di tariffa (QwenCloud, per milione di tokens) | Prezzo annunciato |
|---|---|
| Ingresso | 1,5 dollari |
| Uscita | 4,5 dollari |
| Ingresso con cache implicita | 0,075 dollari |
| Creazione di cache esplicita (5 minuti / 1 ora) | 1,875 / 3 dollari |
Secondo Qwen, tutte queste tariffe sono inferiori a quelle di Qwen3.8-Max, con una riduzione del 70 % per la cache implicita. Nelle proprie valutazioni interne, Qwen annuncia anche un consumo di tokens ridotto dal 24 al 35 % a seconda del livello di sforzo su Work360, il suo framework che copre 721 specialità professionali, e di circa il 48-49 % su Terminal-Bench 4.0. Il costo medio di un’attività Work360 passa da 4,43 a 1,67 dollari, ossia −62 % secondo il post in inglese; la versione cinese, in yuan, indica −58 %. Su Work360, Qwen4-Max ottiene 52,69 contro 47,74 di Qwen3.8-Max.
Rispetto a Opus 5.5, GPT-6.1 Sol, GPT-6 Astra e Kimi K3.1, la tabella pubblicata da Qwen presenta un quadro eterogeneo: Qwen4-Max è in testa solo in 4 dei 16 test, DeepSWE v1.1, Agents’ Last Exam v1.1, HLAB-Vals-1.1 e BioMysteryBench. Una selezione:
| Benchmark (ambito) | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|
| DeepSWE v1.1 (codice agentico) | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| HLAB-Vals-1.1 (agente giuridico) | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| BioMysteryBench (bioinformatica) | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| Terminal-Bench 4.0 (terminale agentico) | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench (replicazione di software) | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| Humanity’s Last Exam | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
Le classifiche di terze parti riportate da Qwen lo collocano al 6º posto di Code Arena WebDev (1 750 punti preliminari) e all’11º del Vals Index (63,20 %), primo tra i modelli cinesi. Artificial Analysis gli assegna 43 punti nel suo Intelligence Index con livello di sforzo xhigh, 3 punti dietro Kimi K3.1 Pro, con un costo per attività inferiore di circa l’11 %.
More to come! The open weights of smaller Qwen4 models will be released. Stay tuned.
🇮🇹 Non è finita! Saranno pubblicati i pesi aperti di modelli Qwen4 più piccoli. Restate sintonizzati. — @Alibaba_Qwen su X
🔗 Qwen4-Max: è arrivato il tuo nuovo compagno di squadra (post di Qwen) · Scheda di qwen4-max su QwenCloud
ChatGPT for Healthcare: agenti che controllano il computer, ricerca clinica e oltre 20 plugin sanitari
16 novembre — OpenAI estende ChatGPT for Healthcare in tre direzioni. Anzitutto, gli agenti che usano il computer (computer-use agents), che leggono lo schermo, cliccano, digitano e passano da un’applicazione all’altra, arrivano in ChatGPT Work e Codex per i clienti di ChatGPT for Healthcare, in base alle impostazioni del loro spazio di lavoro, e per i clinici di ChatGPT for Clinicians, l’offerta gratuita riservata ai clinici verificati negli Stati Uniti. La stessa funzionalità è accessibile nell’API. Il caso tipico: trasferire informazioni tra software che non comunicano tra loro, come la cartella clinica elettronica e il portale di un assicuratore per una richiesta di autorizzazione a una risonanza magnetica. L’uso del computer era disponibile in ChatGPT Work e Codex dal 9 luglio; la novità è la sua apertura agli spazi di lavoro sanitari, con controlli degli accessi basati sui ruoli, log di audit e passaggi di approvazione configurabili. I flussi conformi a HIPAA restano limitati ai servizi idonei coperti da un BAA.
OpenAI pubblica due serie di dati, da leggere separatamente: la propria valutazione interna sulla messaggistica della cartella clinica e HealthAdminBench, un benchmark indipendente di ricercatori di Stanford dedicato alle attività amministrative (autorizzazioni preventive, ricorsi, ordini di attrezzature).
| Valutazione pubblicata | Modello e impostazione | Risultato annunciato |
|---|---|---|
| Messaggistica della cartella clinica (OpenAI, 325 attività revisionate) | GPT-6 Astra | 99 % delle attività giudicate clinicamente sicure |
| Stessa valutazione, 646 giudizi di medici | GPT-6 Astra | 93 % «molto» o «estremamente» utile |
| HealthAdminBench (Stanford) | GPT-6 Astra, sforzo massimo | 94,3 % dei punti della griglia |
| HealthAdminBench (Stanford) | GPT-6 Luna, sforzo massimo | 91,8 %, a 8,5 cents per attività |
Su HealthAdminBench, GPT-6 Luna ottiene il 91,8 % a un costo inferiore del 98 %, ossia 8,5 cents per attività. Sul campo, CVS Health utilizza già questi agenti in produzione: uno ha smaltito in un fine settimana un arretrato di invii di documenti accumulato per mesi, un altro gestisce i passaggi nei sistemi di decine di migliaia di visite al giorno, e l’azienda pubblica in open source il proprio Agent Kit, creato con l’Agents SDK di OpenAI. Cigna Healthcare afferma di essere passata dall’idea alla messa in produzione in meno di otto settimane; in Ambience, l’agente si ferma e chiede il parere del clinico quando la cartella è ambigua; Abridge sviluppa agenti per gli ospedali.
Seguono gli altri due ambiti. La ricerca clinica, che trova, valuta e cita le evidenze mediche, riceve giudizi migliori in tutte le otto dimensioni misurate in una valutazione in cieco comprendente oltre 1 300 revisioni di medici. E 21 nuovi plugin sanitari (UpToDate Expert AI, Oracle HDI, Trizetto, Stedi, Luma Health, Metriport…) consentono di consultare un protocollo, verificare l’idoneità a una copertura assicurativa o coordinare appuntamenti dalla conversazione; l’amministratore dello spazio di lavoro deve attivarli e ChatGPT for Clinicians ne riceve solo una parte.
🔗 Nuovi modi per far progredire l’assistenza con ChatGPT for Healthcare · Migliorare gli agenti che usano il computer per i team sanitari
NVIDIA a SC26: Rubin HPC per la simulazione scientifica, Vera Rubin in MLPerf, Slurm per i processori quantistici e librerie CUDA-X
16 novembre — Alla conferenza sul calcolo ad alte prestazioni SC26, NVIDIA presenta una serie di annunci rivolti alla scienza. Il principale è Rubin HPC, una nuova GPU della piattaforma Vera Rubin progettata per la simulazione e l’elaborazione dei dati nella scienza, nell’ingegneria e nell’analisi, in ambiti come il clima, la genomica o il rischio finanziario.
La scheda pubblicata resta breve. NVIDIA mette in evidenza oltre 50 000 core CUDA su una sola GPU, un numero «record» secondo l’azienda, un’accelerazione dei dati sparsi (sparse data acceleration) destinata a mantenere questi core alimentati e un collegamento NVLink di settima generazione tra GPU. Non vengono citati né la capacità di memoria, né la potenza in FLOPS, né il prezzo, né eventuali partner.
L’argomento centrale è l’equilibrio. Secondo NVIDIA, la maggior parte dei carichi di lavoro scientifici consiste nel recuperare pochi valori dispersi in un enorme insieme di dati, eseguire calcoli e poi ricominciare su vastissima scala. Rubin HPC aumenta quindi il movimento dei dati allo stesso ritmo del calcolo, per accelerare le operazioni su matrici sparse, i calcoli stencil, gli ordinamenti e le riduzioni. NVIDIA collega questa GPU alla propria visione degli agenti: un agente che esplora più molecole, materiali o progetti ha bisogno di più simulazioni per mettere alla prova le sue idee, e le librerie CUDA-X gli forniscono le implementazioni ottimizzate. I tempi sono lunghi: Rubin HPC è atteso nel 2028.
| Caratteristica annunciata | Valore indicato da NVIDIA |
|---|---|
| Core CUDA | oltre 50 000 su una sola GPU |
| Interconnessione tra GPU | NVLink di settima generazione |
| Funzione specifica | accelerazione dei dati sparsi |
| Disponibilità prevista | 2028 |
🔗 Rubin HPC (blog NVIDIA) · Gli annunci di NVIDIA a SC26
Vera Rubin debutta in MLPerf Training v6.1 e MLPerf Endpoints, con prestazioni per GPU fino a 2 volte quelle di GB300 NVL72
16 novembre — Il ciclo MLPerf Training v6.1 segna la prima partecipazione di Vera Rubin NVL72 all’addestramento: prestazioni per GPU fino a 2 volte quelle di un GB300 NVL72, risultati che NVIDIA presenta come preliminari. Su DeepSeek-V3, passare da 256 a 1 024 GPU Vera Rubin mantiene circa il 97 % di efficienza e riduce l’addestramento da 16 minuti a circa quattro. La configurazione più grande del ciclo conta 10 240 GPU, su GB300 in NVIDIA e su GB200 in Microsoft Azure. Secondo NVIDIA, la sua piattaforma è l’unica ad avere risultati in tutti i test.
NVIDIA presenta anche i suoi primi risultati a MLPerf Endpoints v1.0, che misura flussi di lavoro agentici reali. Su Kimi K3, Vera Rubin NVL72 fornirebbe oltre 10 volte il throughput per watt di un GB300 NVL72 a parità di velocità di risposta: un risultato provvisorio, in attesa di verifica da parte di MLCommons, che confronta 32 acceleratori Vera Rubin con 48 acceleratori GB300 alla soglia di 50 tokens al secondo per utente. Vera Rubin era già presente in anteprima in MLPerf Inference, trattato il 16 settembre.
🔗 Vera Rubin in MLPerf Training ed Endpoints (blog NVIDIA)
Slurm 26.11 supporterà i processori quantistici, CUDA-Q si arricchisce
16 novembre — NVIDIA estende Slurm, il gestore delle attività dei supercomputer, ai processori quantistici (QPU). Finora, collegare una QPU a un centro di calcolo richiedeva uno sviluppo specifico per ogni coppia processore-centro; ora un produttore descrive il proprio hardware in un semplice file e ottiene un’interfaccia valida ovunque, tramite le interfacce QRMI e QDMI. Alice & Bob, IBM, IQM, Pasqal, Quantinuum e MQSC lo adottano, e Slurm 26.11 dovrebbe uscire nel corso di novembre. NVIDIA giustifica questo lavoro con la crescita delle installazioni: quasi 30 centri di calcolo stanno installando oltre 50 QPU.
La piattaforma CUDA-Q acquisisce un server di decodifica per la correzione degli errori quantistici (CUDA-Q QEC), il cui decoder TCBP-JOBS sarebbe 13 000 volte più veloce del riferimento del settore, primitive tolleranti ai guasti (Fermilab ha già condotto con CUDA-Q, in tre settimane, studi che avrebbero richiesto cinque mesi), oltre a CUDA-Q Algorithms e CUDA-Q Pulse per i produttori di hardware. Questi miglioramenti sono quelli dichiarati da NVIDIA.
🔗 Slurm e il calcolo quantistico (blog NVIDIA)
CUDA-X per la scienza: cuSpa e HMMER su GPU in open source, correlazione dei dati dell’Event Horizon Telescope in otto minuti
16 novembre — NVIDIA accompagna Rubin HPC con librerie CUDA-X per la ricerca, presentate come strumenti che gli agenti possono richiamare. In astronomia, il modulo cuPhoton.xBeam riduce la correlazione delle osservazioni dell’Event Horizon Telescope da oltre un mese a otto minuti, sia su un cluster multi-GPU sia su un DGX Spark. In biologia, cuSpa, da poco open source, rende i calcoli dei poligoni cellulari 900 volte più veloci rispetto alla CPU al Memorial Sloan Kettering Cancer Center, e la versione GPU di HMMER, anch’essa open source, è fino a 84 volte più veloce in Basecamp Research. rapids-singlecell è ora distribuito in un container «pronto per gli agenti» (200 volte più veloce in Therna Biosciences). In chimica, Daviator, una raccolta di kernel GPU per il software VASP, arriva in NVIDIA ALCHEMI con calcoli fino a 22 volte più veloci e fino al 75 % meno costosi, ma non è ancora disponibile; cuPotential, lanciato il 14 ottobre, ottiene cinque nuovi utilizzatori, tra cui Cadence.
🔗 Librerie CUDA-X per la scienza (blog NVIDIA)
Hugging Face affida a OpenRouter il routing dei modelli linguistici dei suoi Inference Providers
16 novembre — Hugging Face e OpenRouter uniscono le forze: gli Inference Providers di Hugging Face abbandonano il loro router interno e lasciano che OpenRouter scelga il fornitore per ogni chiamata a un modello linguistico. Clément Delangue presenta l’annuncio come la prima parte della partnership. Nel codice client non cambia nulla: stesso token Hugging Face, stesso endpoint. Il router accetta le API Chat Completions e Responses di OpenAI e l’API Messages di Anthropic, e Hugging Face pubblica guide per Claude Code, Codex, OpenCode, Pi e Hermes Agent.
La differenza sta nel routing. Inference Providers sceglieva un fornitore e restituiva il suo errore così com’era; OpenRouter sceglie in base a prezzo, velocità e affidabilità misurati in tempo reale, e ripete la chiamata altrove se il primo fornitore fallisce. Alcuni suffissi impongono una politica o un fornitore (:fastest, :cheapest, zai-org/GLM-5.3:novita), e una conversazione rimane presso il fornitore che conserva la cache del suo prompt.
| Cambiamento annunciato | Dettaglio secondo il post |
|---|---|
| Errori di capacità (misurazione OpenRouter) | −46 % |
| Tempo al primo token e throughput (misurazione OpenRouter) | miglioramento del 16,9 % e +16,3 % |
| Fatturazione | prezzo del fornitore, senza margine aggiunto da Hugging Face |
| Crediti mensili inclusi | 2 dollari (PRO), 2 dollari per postazione (Team, Enterprise) |
| Pagine dei modelli | schede Providers e Metrics: prezzo, velocità, disponibilità su 24 ore |
| Modifica incompatibile | chiavi API personali dei fornitori rifiutate per i modelli linguistici |
Immagini, video e audio continuano a passare direttamente attraverso Inference Providers, senza OpenRouter, e le chiavi personali restano valide per i fornitori di immagini e video. Il collegamento di un account OpenRouter a Hugging Face e il routing di altre attività tramite OpenRouter sono annunciati per il futuro, senza una data.
Il post si basa sui dati di OpenRouter: i modelli aperti rappresentavano il 71,7 % dei token serviti a fine settembre 2026, contro il 26,8 % nell’ottobre 2025, a un prezzo medio di 0,28 e 1,62 dollari per milione di token (input, output), contro 1,27 e 6,36 dollari per i modelli chiusi. Riconosce anche il divario in cima alla classifica: Kimi K3.1 Pro, il miglior modello aperto, ottiene 46 nell’Artificial Analysis Intelligence Index contro 65 per Claude Fable 5.2, a circa un settimo del costo per attività (3,68 contro 26,54 dollari).
🔗 Hugging Face e OpenRouter uniscono le forze (blog Hugging Face) · Annuncio di @huggingface
Perplexity Frontier Research: un’iniziativa di ricerca aperta che punta a uno scienziato automatizzato, con oltre 10 000 GPU
16 novembre — Perplexity lancia Perplexity Frontier Research, un’iniziativa che mira a costruire un «ricercatore scientifico automatico» (automatic research scientist): un sistema di IA capace di svolgere autonomamente il ciclo della ricerca, dalla domanda all’ipotesi, dall’esperimento alla revisione delle proprie convinzioni. Perplexity contrappone questa ambizione alle previsioni «a scatola nera» su compiti circoscritti: l’obiettivo è produrre conoscenze nuove e interpretabili.
We aim to create an automated research scientist. Research is a loop that involves asking the right questions, hypothesizing, navigating ambiguity, designing experiments, and updating beliefs. We think this loop can run inside software, for anyone.
🇮🇹 Vogliamo creare un ricercatore scientifico automatizzato. La ricerca è un ciclo che consiste nel porre le domande giuste, formulare ipotesi, gestire l’ambiguità, progettare esperimenti e rivedere le proprie convinzioni. Pensiamo che questo ciclo possa svolgersi in un software, per tutti. — @andrewgwils su X
Il programma si articola in sei pilastri: orchestrazione multiagente, preaddestramento, apprendimento continuo, apprendimento per rinforzo, sistemi e valutazioni. Il sito dedicato precisa che il team preaddestrerà modelli a pesi aperti, efficienti e specializzati, e che nell’orchestrazione punta alla migliore qualità per ogni livello di costo. Denis Yarats insiste sull’apprendimento per rinforzo su larga scala, su oltre 10 000 GPU, alimentato da dati sintetici e ambienti ricavati dall’uso reale di Perplexity; tutta l’infrastruttura, dalla ricerca alle sandbox, è realizzata internamente.
| Elemento dell’annuncio | Impegno di Perplexity |
|---|---|
| Potenza di calcolo | oltre 10 000 GPU |
| Pilastri di ricerca | 6 |
| Pubblicazioni promesse | articoli, post, dati, modelli e codice |
| Città in cui si assume | San Francisco, Palo Alto, New York, Londra |
| Scadenza prioritaria per le candidature | 5 dicembre |
Andrew Gordon Wilson è presentato sul sito come responsabile della ricerca dell’iniziativa. L’annuncio è anche un invito a candidarsi, accompagnato da una borsa di ricerca per percorsi predottorali e postdottorali. Nessun modello, benchmark o nuovo articolo accompagna il lancio: il sito riunisce sotto il nome Frontier Research lavori già pubblicati, come WANDR, Decider, SPACE, Brain o JOLT.
🔗 Presentazione di Perplexity Frontier Research · Annuncio di @perplexity_ai · research.perplexity.ai · Thread di @denisyarats
IA e ricerca scientifica in OpenAI: un blog dedicato inaugurato dal fisico Nathaniel Craig, ChatGPT for Academic Researchers esteso a 200 000 ricercatori
Un blog scientifico, inaugurato da una definizione candidata del Modello standard su reticolo costruita con GPT-6 Astra
15 novembre — OpenAI apre un blog dedicato alla scienza, dove ricercatori e team condivideranno risultati e metodi, compreso il modo di verificare il lavoro. Il primo post ospite è firmato da Nathaniel Craig, fisico delle particelle all’Università della California a Santa Barbara e scienziato ospite presso OpenAI.
Vi presenta un preprint di ottobre, preparato con GPT-6 Astra, che propone una definizione candidata del Modello standard su reticolo, una griglia che discretizza lo spazio-tempo. Poiché l’interazione debole distingue le particelle «sinistre» e «destre», la formulazione su reticolo fa comparire partner parassiti, e la regola di fase restava una questione aperta per il Modello standard completo da oltre 25 anni. Secondo Craig, GPT-6 Astra ha trovato il modo di trasportare i campi su griglie più fini e ha guidato la dimostrazione dettagliata, poi riesaminata da tre specialisti. L’autore rimane prudente: la definizione è «candidata», valida entro un limite all’intensità dei campi, e costituisce più una risposta di principio che uno strumento di simulazione.
🔗 Un passo verso la definizione del Modello standard su reticolo · Il nostro nuovo blog dedicato alla scienza
ChatGPT for Academic Researchers punta a 200 000 ricercatori, uno studio riguarda 1 819 scienziati
16 novembre — Lanciato a luglio con l’obiettivo di 100 000 ricercatori, il programma ChatGPT for Academic Researchers punta ora a 200 000. La prossima tornata si apre lunedì 23 novembre: 50 000 borse assegnate ai primi candidati idonei, e non più tramite sorteggio, ciascuna destinata al titolare e a un massimo di due collaboratori, per un totale fino a 150 000 persone. L’accesso passa da ChatGPT Pro a ChatGPT Plus: secondo OpenAI, la maggior parte dei partecipanti al progetto pilota sarebbe rimasta entro i limiti di Plus.
Il team di ricerca economica di OpenAI pubblica in parallelo uno studio su 580 186 messaggi di 1 819 scienziati, integrato da un’indagine su 251 di loro. I partecipanti stimano che lo stesso lavoro, a parità di qualità, avrebbe richiesto circa 1,9 volte più tempo senza IA, e il 98 % degli intervistati si aspetta che l’IA acceleri le scoperte nel proprio campo. OpenAI ne sottolinea i limiti: produttività dichiarata, aspettative anziché risultati, nessun effetto causale accertato.
| Uso di ChatGPT da parte degli scienziati | Quota media dei messaggi |
|---|---|
| Lettura e apprendimento | 28 % |
| Scrittura e comunicazione | 27 % |
| Analisi delle evidenze e delle teorie | 17 % |
| Scrittura di software per la ricerca | 14 % |
🔗 Ampliare l’accesso all’IA per gli scienziati · Scienza alla frontiera: come gli scienziati usano ChatGPT
Sicurezza dell’IA e protezione dalle minacce: valutatori indipendenti in OpenAI, classificatore CSAM accessibile, attacchi agentici osservati da Google
OpenAI apre i suoi modelli interni ad Apollo Research, METR, Transluce e Goodfire
16 novembre — OpenAI ha concordato con quattro organismi indipendenti una prima fase di valutazioni integrate (embedded assessments): un accesso approfondito, talvolta alle stesse risorse dei suoi ricercatori (checkpoint, codice, dati di addestramento e valutazione, sistemi di monitoraggio, team), per giudicare nel tempo l’allineamento e l’efficacia delle misure di protezione. Il lavoro si svolge in sede, su dispositivi di OpenAI, sotto la supervisione del Safety and Security Committee, che riceve i rapporti integrali; OpenAI conserva il diritto di oscurare le informazioni riservate e di chiedere un rinvio della pubblicazione.
| Valutatore indipendente | Oggetto della valutazione | Compenso da OpenAI |
|---|---|---|
| Apollo Research | Sovversione nascosta e rilevamento da parte delle misure di protezione | Sì, senza legami con i risultati |
| METR | Disallineamento nel più grande addestramento RL, ambito ridotto | No (possibili crediti API o di calcolo) |
| Transluce | Valutazioni dell’allineamento dopo l’addestramento | No (possibili crediti API o di calcolo) |
| Goodfire | Interpretabilità dei componenti interni dei modelli | Sì, senza legami con i risultati |
🔗 La nostra prima fase di valutazioni integrate
Un classificatore di immagini CSAM gratuito per le organizzazioni verificate, con un segnale per i contenuti generati dall’IA
16 novembre — OpenAI rende disponibile gratuitamente alle organizzazioni verificate, tramite la sua API, omni-moderation-csam-latest, un classificatore di immagini che individua potenziali materiali di abuso sessuale su minori (CSAM) e restituisce un secondo segnale per quelli che potrebbero essere generati dall’IA. Progettato con l’aiuto del NCMEC, è presentato da OpenAI come il primo classificatore CSAM ampiamente disponibile dotato di questo secondo segnale; la Tech Coalition e ROOST contribuiscono ad ampliarne l’accesso. Secondo i test di OpenAI, segnalerebbe il 48 % di immagini in meno rispetto alla protezione attuale, rilevando all’incirca lo stesso numero di abusi (una stima). Tra i partner con accesso anticipato, fal conferma come inediti il 72 % dei contenuti segnalati con elevata confidenza, e SafetyKit rileva il 90 % dei disegni o delle animazioni. In ChatGPT, una ricerca di questo tipo di contenuti attiva ora un avvertimento, l’eliminazione della conversazione e una sospensione dell’accesso di 24 ore; la recidiva può portare alla chiusura dell’account o a una segnalazione alle autorità.
🔗 Rafforzare la lotta contro gli abusi sessuali sui minori online · Changelog dell’API OpenAI
Google Threat Intelligence: gli attaccanti automatizzano dall’inizio alla fine la ricerca e lo sfruttamento delle vulnerabilità
16 novembre — Nel suo rapporto trimestrale sull’uso malevolo dell’IA, il Google Threat Intelligence Group (GTIG) rileva che gli attaccanti impiegano framework offensivi multiagente open source (ARTEX, CAIRN, CyberStrikeAI, PentAGI). Per la prima volta secondo GTIG, alcuni attori hanno automatizzato la scoperta e lo sfruttamento delle vulnerabilità senza intervento umano nel processo: un framework chiamato exploit_agent, trovato su un server esposto, confrontava il codice prima e dopo le patch, scriveva gli exploit e li eseguiva; secondo la telemetria delle vittime, il suo operatore sembrava prendere di mira soprattutto siti francesi dei settori dei media e dell’intrattenimento, oltre a quello dell’istruzione. Le vulnerabilità zero-day sfruttate passano da una media di 8 al mese nel 2025 a 11 nel 2026, con un picco di 22 ad agosto. Un gruppo sospettato di essere nordcoreano ha modificato file .claude/settings.json in repository interni affinché Claude Code installasse una backdoor all’avvio.
For the most part, attackers aren’t using new groundbreaking methods to break into systems — they are still going after known, unfixed issues, just with much greater speed and scale.
🇮🇹 Per la maggior parte, gli attaccanti non usano nuovi metodi rivoluzionari per penetrare nei sistemi: continuano a colpire vulnerabilità note e non corrette, semplicemente con molta più velocità e su scala molto più ampia. — John Hultquist, analista capo, GTIG, su blog.google
🔗 GTIG AI Threat Tracker (Google Cloud)
Funzionalità di Google per il grande pubblico: siti interattivi in Gemini Notebook, 66 voci regionali in Gemini, Ask Maps in 30 paesi europei
Gemini Notebook trasforma le fonti di un taccuino in siti interattivi
16 novembre — Gemini Notebook ora può trasformare le fonti di un taccuino in siti interattivi. Basta digitare make me a site nella chat del taccuino, insieme alla descrizione di ciò che si desidera: una spiegazione visiva per ripassare (una tavola periodica interattiva, una linea del tempo storica), una dashboard (le vendite di un trimestre) o uno strumento di monitoraggio di un progetto con le sue attività e scadenze. Il sito si apre in una nuova scheda o può essere condiviso direttamente. La funzionalità viene distribuita in tutto il mondo sul web a partire dal 16 novembre per gli utenti di almeno 18 anni, inclusi gli abbonati a Google Workspace; l’app mobile seguirà «presto», senza una data annunciata.
🔗 Gemini Notebook: siti interattivi a partire dalle fonti (blog.google) · Annuncio di @Gemini_Notebook
L’app Gemini introduce 66 voci regionali su Android e iOS
16 novembre — L’app Gemini introduce 66 nuove voci regionali su Android e iOS, tra cui inglese americano, britannico e indiano, hindi, portoghese brasiliano, indonesiano e coreano, con opzioni specifiche per ogni lingua. Google afferma di averle calibrate per cadenze naturali e una buona chiarezza, anziché per accenti esagerati. La voce scelta si applica in tutta l’app: conversazioni con Gemini Live, pratica di una lingua, lettura ad alta voce di una risposta. Si seleziona dal menu di Gemini Live o nelle impostazioni. Google aveva annunciato questo progetto sui dialetti locali al Google I/O.
🔗 Le voci regionali dell’app Gemini (blog.google)
Ask Maps arriva in 30 paesi d’Europa e impara a preparare itinerari e appuntamenti
16 novembre — Ask Maps, l’assistente conversazionale di Google Maps basato sui modelli Gemini, lanciato negli Stati Uniti e in India e di cui abbiamo parlato qui il 12 marzo, inizia a espandersi in 30 paesi d’Europa, tra cui Spagna, Germania e Regno Unito. Google afferma che ora è presente in oltre 200 paesi e territori; i post non menzionano la Francia. Lo stesso giorno, Ask Maps acquisisce nuove funzionalità, in fase di distribuzione su Android e iOS:
| Nuova funzionalità di Ask Maps | Disponibilità annunciata |
|---|---|
| Itinerari giorno per giorno, condivisibili ed esportabili in Google Docs | Ovunque sia disponibile Ask Maps |
| Ricerca negli elenchi salvati, con disponibilità in tempo reale | Ovunque sia disponibile Ask Maps |
| Consigli di viaggio (Know before you go): parcheggio, ricarica, meteo, pedaggi | Prima negli Stati Uniti |
| Ricerca di appuntamenti e chiamate alle attività commerciali locali | Prima negli Stati Uniti |
🔗 Le nuove funzionalità di Ask Maps (blog.google) · Ask Maps arriva in Europa (blog.google)
Ricerca di informazioni per sviluppatori e aziende: la Monitor API di Perplexity, Video Intelligence in Cohere Compass
Perplexity lancia la Monitor API, che monitora il web o singole pagine e invia notifiche tramite webhook
16 novembre — Perplexity lancia la Monitor API, che monitora il web per conto di un’applicazione o di un agente. Due modalità: seguire le novità su un argomento, un’azienda o una domanda tramite Perplexity Search, oppure monitorare fino a 10 pagine specifiche (prezzi di un concorrente, changelog, policy) e ricevere un diff testuale delle modifiche. Lo sviluppatore può descrivere il proprio obiettivo in linguaggio naturale; Perplexity Decider verifica la pertinenza, la legittimità della fonte, la novità e l’attualità di ogni risultato, e vengono inviati solo gli aggiornamenti che superano tutte le soglie, tramite webhook firmati, con un punteggio di affidabilità. I monitor vengono eseguiti ogni 15 minuti, ogni ora, ogni giorno, ogni settimana o secondo un cron.
| Tipo di monitor | Unità fatturata | Prezzo annunciato |
|---|---|---|
| Monitor web | esecuzioni riuscite | 1 dollaro per 1 000 |
| Monitor di pagine | URL recuperati | 1 dollaro per 1 000 |
L’API è disponibile da subito, con la stessa chiave delle API Search, Context e Agent. Secondo Perplexity, su 60 argomenti monitorati per otto ore, Monitor ha restituito risultati più aggiornati e pertinenti rispetto ad altri fornitori di Search API.
🔗 Presentazione della Monitor API di Perplexity
Cohere apre Video Intelligence in Compass, per ritrovare il momento esatto di un video
16 novembre — Cohere aggiunge i video a Compass, la sua piattaforma di ricerca per le aziende, con Video Intelligence, disponibile in anteprima privata. Invece di restituire una registrazione di un’ora, Compass trova il momento che risponde alla domanda: un estratto con timestamp, una trascrizione e una descrizione di ciò che viene mostrato sullo schermo, con limiti definiti al momento della ricerca. I video si aggiungono ai documenti in un unico indice, che rispetta i diritti di accesso di ogni utente, e gli agenti vi accedono tramite il server MCP di Compass. Su 11 dataset e 11 133 query, Compass si classifica primo in media rispetto a sette modelli di embeddings video, con un vantaggio di 4,4 punti di nDCG@10 sulla migliore alternativa, secondo Cohere. L’azienda cerca partner di progettazione (design partners), che possono distribuire lo strumento nel cloud gestito di Cohere o nel proprio ambiente; non vengono indicati né prezzi né una data di disponibilità generale.
🔗 Presentazione di Video Intelligence in Compass · Annuncio di @cohere
Valutare modelli e agenti: JFinBench di Sakana AI sulla finanza giapponese, le valutazioni degli agenti di Together AI
JFinBench: nella finanza giapponese, il miglior modello aperto resta a 12,4 punti da Claude Fable 5
16 novembre — Sakana AI pubblica JFinBench (post datato 17 novembre, ora del Giappone), un benchmark ricavato dalle sessioni 2026 di sei esami finanziari giapponesi, dalla contabilità professionale alla consulenza fiscale, pensato per essere rinnovato a ogni sessione per limitare la contaminazione. Su 321 domande sono stati valutati 12 modelli, di cui ecco i primi cinque senza strumenti:
| Modello valutato | Punteggio senza strumenti | Punteggio con strumenti (harness) |
|---|---|---|
| Claude Fable 5 | 95,8 | 96,4 (Terminus-2) |
| GPT-6 Astra | 93,6 | 97,3 (Terminus-2) |
| Gemini 3.8 Flash | 88,8 | 94,2 (Terminus-2) |
| Kimi K3.1 Pro | 83,4 | 92,9 (Kimi Code) |
| Kimi K3 | 79,9 | 91,0 (Kimi Code) |
Kimi K3.1 Pro, il miglior modello aperto, resta a 12,4 punti da Claude Fable 5 e a circa 10 da GPT-6 Astra, sebbene venga indicato davanti a quest’ultimo su Terminal-Bench 4.0 (65,7 % contro 58,2 %, dati dei produttori). Gli errori derivano soprattutto dalla mancanza di conoscenze del sistema giapponese, non dal calcolo. Con terminal e accesso al web, il divario tra il miglior modello aperto e il miglior modello proprietario scende a 4,4 punti. Durante un esperimento preliminare, escluso dai punteggi, DeepSeek V4.1 Flash 1017 e Gemini 3.8 Flash hanno trovato una chiave OpenRouter dimenticata nell’ambiente e l’hanno usata per chiamare altri modelli.
🔗 JFinBench (Sakana AI) · Articolo su JFinBench su arXiv
Together AI: valutazioni degli agenti che hanno portato la sua documentazione MCP dal 67 al 96 % di attività riuscite
16 novembre — Together AI descrive come misura la facilità d’uso della propria piattaforma per gli agenti di programmazione, ciò che chiama esperienza dell’agente (agent experience). Una decina di attività comuni (avviare un job batch, prenotare un cluster GPU, gestire l’autoscaling) vengono affidate a Claude Code in una sandbox secondo tre configurazioni: senza assistenza, con il server MCP della documentazione o con il pacchetto di skill di Together. La configurazione MCP è passata dal 67 % di attività riuscite il 15 giugno al 96 % il 30 settembre, e la skill unificata ha raggiunto il 97 % (70 su 72) l’8 ottobre, contro l’82 % della configurazione di base senza assistenza; Together riconosce che queste rilevazioni non sono strettamente confrontabili. Nella prenotazione di un cluster GPU, Sonnet 4.6 riusciva solo in 4 tentativi su 15; due frasi aggiunte alla skill hanno portato il tasso di successo al 100 % per tutti i modelli testati. Lo strumento di valutazione dovrebbe essere pubblicato in open source la settimana successiva, secondo Together.
🔗 Come rendiamo Together AI facile da usare per gli agenti di programmazione
Acquisizioni e partnership: ElevenLabs acquisisce Kotoba, la divisione media di LVMH firma un accordo con OpenAI
ElevenLabs annuncia l’acquisizione di Kotoba, laboratorio giapponese di IA vocale
16 novembre — ElevenLabs annuncia l’acquisizione di Kotoba, un laboratorio giapponese di IA vocale fondato nel 2023 da Noriyuki Kojima e Jungo Kasai. Il suo modello Koto copre la sintesi vocale, la trascrizione e la traduzione da voce a voce per l’interpretazione simultanea in giapponese; Salesforce lo utilizza per le conversazioni in giapponese di Agentforce Voice. ElevenLabs vuole portare questa ricerca in ElevenAgents, la sua piattaforma di agenti vocali, e prevede di assumere responsabili commerciali e investire in infrastrutture in Giappone nei prossimi mesi. L’operazione non è ancora conclusa: il completamento è previsto nel quarto trimestre 2026, subordinatamente alle autorizzazioni normative, e non viene comunicato alcun importo.
🔗 Kotoba entra a far parte di ElevenLabs · Annuncio di @ElevenLabs
La divisione media di LVMH (Les Echos, Le Parisien) adotta ChatGPT Enterprise e dà risalto ai propri contenuti in ChatGPT
16 novembre — Groupe Les Echos-Le Parisien, la divisione media di LVMH, firma un accordo strategico con OpenAI. I suoi 17 marchi, tra cui Les Echos, Le Parisien, Challenges, Paris Match, L’Opinion e L’Agefi, adottano ChatGPT Enterprise e gli strumenti di OpenAI in tutti i team, con una formazione adeguata a ogni ruolo: ricerca e confronto di documenti, traduzione preliminare, personalizzazione dei prodotti per lettori e inserzionisti. Il secondo aspetto dell’accordo prevede che i contenuti della divisione ricevano maggiore risalto in ChatGPT, sotto forma di riassunti ed estratti corredati di fonti con link agli articoli. Il gruppo conta 1 800 dipendenti, di cui quasi 700 giornalisti, e raggiunge oltre 27 milioni di persone ogni mese in Francia. Non viene comunicato alcun importo.
🔗 La divisione media di LVMH annuncia una partnership strategica con OpenAI
Agenti di programmazione: Claude Code testa le app sull’iPhone Duo, Replit pubblica le app del suo Agent in Microsoft Fabric
Claude Code su desktop piega l’iPhone Duo nel suo simulatore iOS e mette in evidenza il plugin Xcode di Apple
16 novembre — Claude Code su desktop supporta l’iPhone Duo nel suo pannello del simulatore iOS, in beta pubblica: l’app in sviluppo gira su un Duo simulato accanto alla conversazione, e Claude piega e apre il dispositivo per verificare ogni layout. Secondo la documentazione, il dispositivo ha tre posizioni (chiuso, semiaperto, aperto), ed è possibile richiedere un angolo della cerniera da 1 a 179 gradi. Per adattare un’app esistente, Claude Code può proporre la skill App Resizability di Apple, che individua i problemi di layout e suggerisce correzioni che Claude applica dopo l’approvazione. Servono un Mac, Claude Desktop v4.29.0 o successivo e Xcode 27.1 o successivo; il pannello resta riservato alle sessioni locali, sui piani Pro, Max, Ultra, Team ed Enterprise, escluse le configurazioni HIPAA. Il simulatore iOS stesso è arrivato il 22 luglio. Sul fronte terminal, Anthropic mette in evidenza il plugin Xcode di Apple, presente nel marketplace ufficiale dal 6 novembre e installabile con /plugin install xcode@claude-plugins-official.
🔗 Annuncio di @ClaudeDevs · Documentazione del simulatore iOS
Replit Agent pubblica le sue applicazioni in Microsoft Fabric, ora in disponibilità generale
16 novembre — Replit annuncia la disponibilità generale della sua integrazione con Microsoft Fabric, la piattaforma dati di Microsoft: si descrive un’applicazione, Replit Agent la costruisce sui dati aziendali sottoposti a governance, poi l’applicazione viene distribuita direttamente nel tenant Fabric dell’organizzazione. Secondo la pagina del partner, l’Agent legge lo schema, le tabelle e le etichette di riservatezza Purview in OneLake senza copiare i dati; l’applicazione, predisposta con l’autenticazione Microsoft Entra, mostra a ogni utente solo i dati a cui ha diritto di accedere e si basa su Copilot in Fabric e sulla capacità di IA già presente nel tenant. L’integrazione era stata lanciata a Microsoft Build con Leatherman, e la pagina del partner non indica alcun prezzo. Il 13 novembre, Replit l’aveva estesa alle applicazioni con database. La documentazione del connettore Fabric descrive però ancora un’anteprima, riservata ai membri di un programma di tester approvati.
🔗 Annuncio di @Replit · Pagina Microsoft di Replit come partner · Documentazione del connettore Microsoft Fabric
Brevi
Agenti di codice e CLI
- GitHub Copilot ritira tre modelli — Come annunciato il 15 ottobre, Claude Opus 4.8, Claude Opus 5 e GPT-5.6 Terra vengono rimossi dalla maggior parte delle esperienze Copilot, sostituiti da Claude Opus 5.5, GPT-6.1 Sol o GPT-6 Luna. Una precisazione del changelog: Claude Opus 5 esce dal selettore, ma resta disponibile come fallback quando una richiesta viene rifiutata durante l’esecuzione. 🔗 fonte
- Copilot CLI 1.0.113-0 — Questa versione preliminare viene pubblicata senza note dettagliate, con la sola menzione di correzioni e modifiche; l’ultima versione stabile resta la 1.0.112 del 13 novembre. 🔗 fonte
- GitHub Agentic Workflows 1.3.0 — Ancora in anteprima, questa versione fa uscire i ledger dalla fase sperimentale e aggiunge un controllo,
require-agent-success, che blocca la pubblicazione degli output quando il job dell’agente è fallito; i rifiuti di Copilot legati alla politica di cybersicurezza non vengono più ritentati automaticamente. 🔗 fonte - Codex CLI 0.171.0-alpha.9 — Tre versioni preliminari con note vuote dall’alpha.6; secondo i titoli dei loro 41 commit,
codex execpuò appoggiarsi a un server applicativo remoto e il terminale mostra indicazioni su responsabilità e rischi durante le revisioni. L’ultima versione stabile resta la 0.169.0. 🔗 fonte - Agents SDK di OpenAI — La versione preliminare Python v0.24.0-alpha.8 permette di approvare o rifiutare una chiamata a uno strumento dopo averne visto gli argomenti, di collegare LiteLLM o AnyLLM e di aggiungere la voce in tempo reale tramite WebSocket, WebRTC o SIP; sul versante JavaScript, la v0.22.0-alpha.3 può eseguire i callback degli strumenti in parallelo per impostazione predefinita. 🔗 fonte
- Gemini CLI — Una correzione integrata nel branch principale, non ancora pubblicata, fa ignorare i server MCP dichiarati dall’amministratore i cui comandi o script restano modificabili da un utente ordinario, che altrimenti poteva ereditare l’approvazione automatica di un server autorizzato. 🔗 fonte
- ZCode v3.18.2 — Z.ai pubblica su GitHub questa versione del suo ambiente di sviluppo assistito dall’IA per macOS e Windows, senza note di rilascio, dopo le sincronizzazioni del codice 3.18.0 e 3.18.1 rimaste senza release. 🔗 fonte
- Cache del prefisso degli agenti — Together AI e Ollama spiegano che l’harness (Claude Code, Codex o Pi tramite
ollama launch) deve mantenere identico l’inizio del prompt e che il motore deve indirizzare ogni turno verso la GPU che detiene la cache: su 100 turni, 5 050 unità di prompt elaborate senza cache contro 100 con la cache, secondo un calcolo idealizzato. 🔗 fonte - Fabbriche software di team — In un articolo d’opinione sul blog di Warp, Zach Lloyd sostiene la necessità di spostare gli agenti dalle configurazioni di ogni sviluppatore (harness, modello, skills, MCP) a un’infrastruttura cloud condivisa, descritta tramite codice e di proprietà del team. 🔗 fonte
Altre novità di GitHub
- AI Scan in batch — L’analisi delle vulnerabilità dei repository tramite IA può ora essere avviata su un massimo di 20 repository alla volta, dalle impostazioni dell’organizzazione o dalla pagina degli avvisi di code scanning, in anteprima pubblica e senza licenza Copilot. 🔗 fonte
- GitHub Mobile su iPhone Duo — L’applicazione iOS adatta il layout una volta aperto il dispositivo e aggiunge schede verticali per Copilot, pull request, issue e notifiche. 🔗 fonte
Calcolo, simulazione e robotica
- Lambda e NVIDIA Photonics — Lambda collega rack GB300 NVL72 per un totale di oltre 10 000 GPU tramite switch con ottica co-integrata (co-packaged optics); secondo i suoi test, la latenza diminuisce di circa il 4 % a livello di rack e fino a circa il 10 % a livello di pod, e le ottiche funzionano a 36 °C contro i 51 °C di quelle innestabili. 🔗 fonte
- Google Cloud in MLPerf Training v6.1 — Nel primo benchmark MLPerf di apprendimento per rinforzo agentico, secondo Google, 640 TPU Ironwood raggiungono la precisione obiettivo in 18,02 minuti; nel pre-addestramento, 8 192 TPU Ironwood ci riescono in 1,70 minuti e 256 GPU GB300 in 31,96 minuti. 🔗 fonte
- NVIDIA Cosmos — I modelli del mondo aperti di NVIDIA superano i 20 milioni di download su Hugging Face, secondo NVIDIA, senza precisazioni sul periodo o sul perimetro. 🔗 fonte
- LidarVerse — NVIDIA Research torna a mettere in evidenza questo modello di ottobre che genera, predice e risimula scansioni LiDAR, a 10 immagini al secondo su un solo H100 nella versione distillata; il codice è sotto licenza Apache 2.0. 🔗 fonte
- AI Day Seoul — NVIDIA fa il bilancio del suo evento coreano: oltre 2 000 partecipanti, più di 500 sviluppatori formati o certificati in coreano e un hackathon vinto dal team FlyGate con agenti costruiti su OpenShell. 🔗 fonte
- projectsim (Kaedim) — Oltre 200 oggetti 3D pronti per la simulazione robotica, di cui 140 articolati, diventano gratuiti e approdano anche su SimReady Central di NVIDIA, dove sette sono già online. 🔗 fonte
Modelli aperti e Hugging Face
- CI di llama.cpp — Di fronte a 3 181 pull request in tre mesi e ai limiti del piano gratuito di GitHub (10 Go di cache, 20 job simultanei), il team avvia ormai solo i job interessati dal diff, archivia le proprie cache ccache in Hugging Face Buckets ed esegue la maggior parte dei job Linux x64 su Hugging Face Jobs. 🔗 fonte
- Accelerate v1.16.0 — La libreria di addestramento distribuito di Hugging Face richiede ora Python 3.11 e PyTorch 2.6, si appoggia maggiormente a
torch.acceleratorper gli acceleratori registrati presso PyTorch e rimuove PiPPy, MS-AMP eFP8RecipeKwargs. 🔗 fonte - Tiny Aya Global — Cinque articoli della community, per la maggior parte nati dall’hackathon di Lexsi Labs, si misurano con il piccolo modello multilingue di Cohere Labs: un agente per database passa dallo 0,5 al 49,1 % di successo in tre turni di autoriparazione, e il controllo del rifiuto riduce fortemente le risposte dannose in bengalese e swahili, al prezzo di un numero doppio di rifiuti eccessivi, secondo gli autori. 🔗 fonte
- Modular Diffusers — Una guida mostra come utilizzare in Diffusers un modello non ancora integrato, convertendone i pesi e pubblicando blocchi sull’Hub; l’autore ha affidato il lavoro a Claude Code con Claude Opus 5.5, poiché la conversione non era riuscita con Astra. 🔗 fonte
- Piccoli modelli sul telefono — Uno sviluppatore pubblica due percorsi d’acquisto completi su Amazon eseguiti in locale da Qwen3.5 0,8B e 2B su telefoni Android, con un input mediano di 45 token per chiamata; il più lento, su un Galaxy A04e, è durato 4 h 20 per 578 chiamate. 🔗 fonte
- Ask AdMob — Google presenta un agente conversazionale costruito con Gemini all’interno dell’account AdMob, in fase di test nei prossimi mesi, pubblica fin da ora agent skills AdMob per gli agenti di codice e prepara un server MCP, in fase di test iniziale, che sarà aperto a più sviluppatori all’inizio del 2027. 🔗 fonte
- Google Flow — Il 12 novembre, Google ha aggiunto al suo studio creativo cinque strumenti ideati da artisti, tra cui Pocket Studio, che ricava diverse angolazioni di ripresa da un’unica ripresa con il telefono, e Pixel Machine per gli stili rétro. 🔗 fonte
Voce, immagini e video
- Nemotron 3.5 Transcribe — NVIDIA rilancia il primo posto del suo modello aperto nell’indice di diarizzazione di Artificial Analysis pubblicato il 13 novembre: 3,3 % di parole attribuite erroneamente (WDER) su 97 conversazioni tra due e otto persone, davanti a Voxtral Small Transcribe 3 (7,5 %). 🔗 fonte
- FLUX: In Production — Black Forest Labs lancia un concorso di film realizzati con l’IA, con brief redatti da studi partner e oltre 25 000 dollari in premi; si svolge online dal 30 novembre al 13 dicembre. 🔗 fonte
- Kling Image 4.0 — Kling annuncia il prossimo arrivo del suo nuovo modello di immagini, senza date né caratteristiche. 🔗 fonte
Imprese e formazione
- Autotorino ed ElevenAgents — Il gruppo italiano di concessionarie automobilistiche, che riceve circa 100 000 chiamate al mese, affida le proprie chiamate a un agente vocale che qualifica la richiesta e crea il lead; il volume delle chiamate gestite automaticamente è più che raddoppiato. 🔗 fonte
- I dot di Holiday Extras — In un caso di studio di OpenAI, il dot di un responsabile individua da solo il lancio di una funzionalità, interroga Google BigQuery e consegna un rapporto senza che gli venga chiesto; un altro prepara rapporti durante il tragitto del suo utente. 🔗 fonte
- OpenAI e The King’s Trust — OpenAI versa 1 milione di sterline all’associazione britannica per formare all’IA fino a 25 000 giovani in 18 mesi, dando priorità a chi non lavora, non studia e non segue percorsi di formazione. 🔗 fonte
- L’IA nella formazione secondo Synthesia — Terzo rapporto annuale, oltre 800 rispondenti in più di 25 paesi: l’87 % dei team che utilizzano l’IA se ne serve per generare contenuti, ma solo il 29 % pratica l’apprendimento personalizzato, contro il 70 % che lo praticava o lo prevedeva un anno fa. 🔗 fonte
Perplexity
- Cifre evidenziate nelle fonti — In Computer e nei Teammates, aprire il documento fonte di una risposta evidenzia ora la cifra esatta citata, sul web per tutti gli utenti, secondo @AskPerplexity. 🔗 fonte
- Guida IA e AGI a confronto — Perplexity pubblica una guida che distingue l’IA in uso oggi dall’AGI e propone un metodo per verificare un annuncio di AGI; cita Claude Opus 5.5 al 21,3 % sul Remote Labor Index al 9 ottobre. 🔗 fonte
Che cosa significa
Il divario tra modelli aperti e chiusi si legge ormai in dollari tanto quanto in punti. Qwen4-Max scende sotto le tariffe di Qwen3.8-Max e annuncia un costo per attività ridotto del 62 %, ma è in testa solo in 4 dei 16 test della propria tabella e nulla annuncia pesi aperti per questo modello. Hugging Face punta sull’altro versante: affidando il proprio routing a OpenRouter, si appoggia a modelli aperti che rappresentano il 71,7 % dei token di OpenRouter e costano in media circa quattro volte meno. Lo stesso articolo riconosce però un divario di 19 punti ai vertici dell’Intelligence Index, e JFinBench ne misura 12,4 nella finanza giapponese senza strumenti, ridotti a 4,4 con l’accesso al web: nei settori poco misurati, il vantaggio dei modelli chiusi dipende anzitutto da ciò che sanno.
Gli agenti escono dal terminale per entrare in sistemi aziendali soggetti a regole di governance. In ChatGPT for Healthcare, l’agente che controlla il computer collega la cartella clinica al portale di un assicuratore, con controlli di accesso basati sui ruoli, log di audit e BAA; in Replit, l’applicazione costruita dall’Agent nasce nel tenant Fabric del cliente, con i relativi permessi Entra ID e le etichette Purview. Lo stesso movimento avvantaggia gli attaccanti: secondo GTIG, un framework ha concatenato senza intervento umano la scoperta e lo sfruttamento di vulnerabilità, e un gruppo ha manomesso la configurazione di Claude Code per installare una backdoor. La correzione di Gemini CLI sui server MCP modificabili lo ricorda a modo suo: l’affidabilità dell’approvazione automatica di uno strumento dipende dall’integrità dello script che lo avvia.
La scienza diventa l’argomento comune al calcolo e agli agenti. NVIDIA presenta Rubin HPC e le sue librerie CUDA-X come gli strumenti di simulazione che gli agenti chiameranno per testare le proprie idee, Perplexity vuole costruire uno scienziato automatizzato su oltre 10 000 GPU e OpenAI apre un blog in cui un fisico racconta come GPT-6 Astra abbia assunto la guida di una dimostrazione, raddoppiando al contempo l’obiettivo del suo programma per ricercatori. Le promesse precedono ancora i risultati: Rubin HPC è atteso nel 2028 senza memoria né FLOPS annunciati, Frontier Research non presenta alcun modello o articolo nuovo, la definizione di Craig resta «candidata» e lo studio di OpenAI misura una produttività dichiarata, senza un effetto causale accertato.
Anche il modo di misurare sta cambiando. OpenAI apre i propri checkpoint e i propri addestramenti ad Apollo Research, METR, Transluce e Goodfire, ma mantiene il controllo sugli omissis e sul calendario di pubblicazione. Together AI mostra che due frasi in uno skill fanno passare un modello da 4 successi su 15 al 100 %, il che ridimensiona i divari tra modelli misurati senza indicazioni. L’episodio di JFinBench, in cui due modelli hanno trovato una chiave OpenRouter dimenticata per far lavorare altri modelli, ricorda che una valutazione con strumenti misura anche ciò che l’ambiente lascia a portata di mano. E il guadagno di oltre 10 volte di Vera Rubin su MLPerf Endpoints resta provvisorio finché MLCommons non lo avrà verificato.
Fonti
- Qwen4-Max: il tuo nuovo compagno di squadra è arrivato (post di Qwen)
- Scheda di qwen4-max su QwenCloud
- Annuncio di Qwen4-Max (@Alibaba_Qwen)
- Più modi per migliorare l’assistenza con ChatGPT for Healthcare (OpenAI)
- Progressi negli agenti computer-use per i team sanitari (OpenAI)
- Rubin HPC (blog NVIDIA)
- Gli annunci di NVIDIA a SC26
- Vera Rubin in MLPerf Training e Endpoints (blog NVIDIA)
- Slurm e il calcolo quantistico (blog NVIDIA)
- Librerie CUDA-X per la scienza (blog NVIDIA)
- Hugging Face e OpenRouter uniscono le forze (blog Hugging Face)
- Annuncio di @huggingface
- Presentazione di Perplexity Frontier Research
- Annuncio di @perplexity_ai
- research.perplexity.ai
- Thread di Andrew Gordon Wilson (@andrewgwils)
- Thread di Denis Yarats (@denisyarats)
- Un passo verso la definizione del Modello Standard su un reticolo (OpenAI)
- Il nostro nuovo blog dedicato alla scienza (OpenAI)
- Ampliare l’accesso all’AI per gli scienziati (OpenAI)
- La scienza alla frontiera: come gli scienziati usano ChatGPT (OpenAI)
- La nostra prima fase di valutazioni integrate (OpenAI)
- Rafforzare la lotta contro gli abusi sessuali sui minori online (OpenAI)
- Changelog dell’API OpenAI
- GTIG AI Threat Tracker (Google Cloud)
- Sintesi del rapporto GTIG (blog.google)
- Gemini Notebook: siti interattivi a partire dalle fonti (blog.google)
- Annuncio di @Gemini_Notebook
- Le voci regionali dell’applicazione Gemini (blog.google)
- Le nuove funzioni di Ask Maps (blog.google)
- Ask Maps arriva in Europa (blog.google)
- Presentazione della Monitor API di Perplexity
- Presentazione di Video Intelligence in Compass (Cohere)
- Annuncio di Video Intelligence (@cohere)
- JFinBench (Sakana AI)
- Articolo su JFinBench su arXiv
- Come rendiamo Together AI facile da usare per gli agenti di coding
- Kotoba entra a far parte di ElevenLabs
- Annuncio di @ElevenLabs
- La divisione media di LVMH annuncia una partnership strategica con OpenAI
- Annuncio di @ClaudeDevs
- Documentazione del simulatore iOS di Claude Code
- Annuncio di @Replit
- Pagina della partnership tra Replit e Microsoft
- Documentazione del connettore Microsoft Fabric (Replit)
- Ritiro di modelli in GitHub Copilot (changelog GitHub)
- Copilot CLI 1.0.113-0 (GitHub)
- GitHub Agentic Workflows 1.3.0 (GitHub)
- Codex CLI 0.171.0-alpha.9 (GitHub)
- Agents SDK Python v0.24.0-alpha.8 (GitHub)
- PR 30283 di Gemini CLI (GitHub)
- ZCode v3.18.2 (GitHub)
- Far funzionare i modelli open per workload agentici di lunga durata (Together AI e Ollama)
- Post di Zach Lloyd sulle fabbriche di software (Warp)
- AI Scan su più repository (changelog GitHub)
- GitHub Mobile su iPhone Duo (changelog GitHub)
- Lambda e NVIDIA Photonics (blog NVIDIA)
- Risultati di Google Cloud in MLPerf Training v6.1 (blog.google)
- NVIDIA Cosmos, 20 milioni di download (@NVIDIAAI)
- LidarVerse (@NVIDIAAI)
- Bilancio dell’AI Day Seoul (blog NVIDIA)
- Oggetti di simulazione gratuiti di projectsim (blog Hugging Face)
- CI di llama.cpp su Hugging Face Buckets e Jobs (blog Hugging Face)
- Accelerate v1.16.0 (GitHub)
- Efficient Healer su Tiny Aya Global (blog Hugging Face)
- Nuovi modelli con Modular Diffusers (blog Hugging Face)
- Lunghe sequenze di operazioni sul telefono con modelli piccoli (blog Hugging Face)
- I nuovi strumenti IA di AdMob (blog.google)
- I cinque nuovi strumenti di Google Flow (blog.google)
- Nemotron 3.5 Transcribe nell’indice di diarizzazione (@NVIDIAAI)
- FLUX: in produzione (@bfl_ai)
- Kling Image 4.0 (@Kling_ai)
- Autotorino e ElevenAgents (ElevenLabs)
- Da Holiday Extras, i dots si mettono al lavoro prima ancora che qualcuno lo chieda (OpenAI)
- The King’s Trust e OpenAI (OpenAI)
- Rapporto di Synthesia sull’IA nella formazione
- Numeri evidenziati in Computer e nei Teammates (@AskPerplexity)
- AGI e AI a confronto (Perplexity)