ai-powered-markdown-translatorgpt-6.1-sol을 사용해 프랑스어에서 한국어로 번역한 기사.
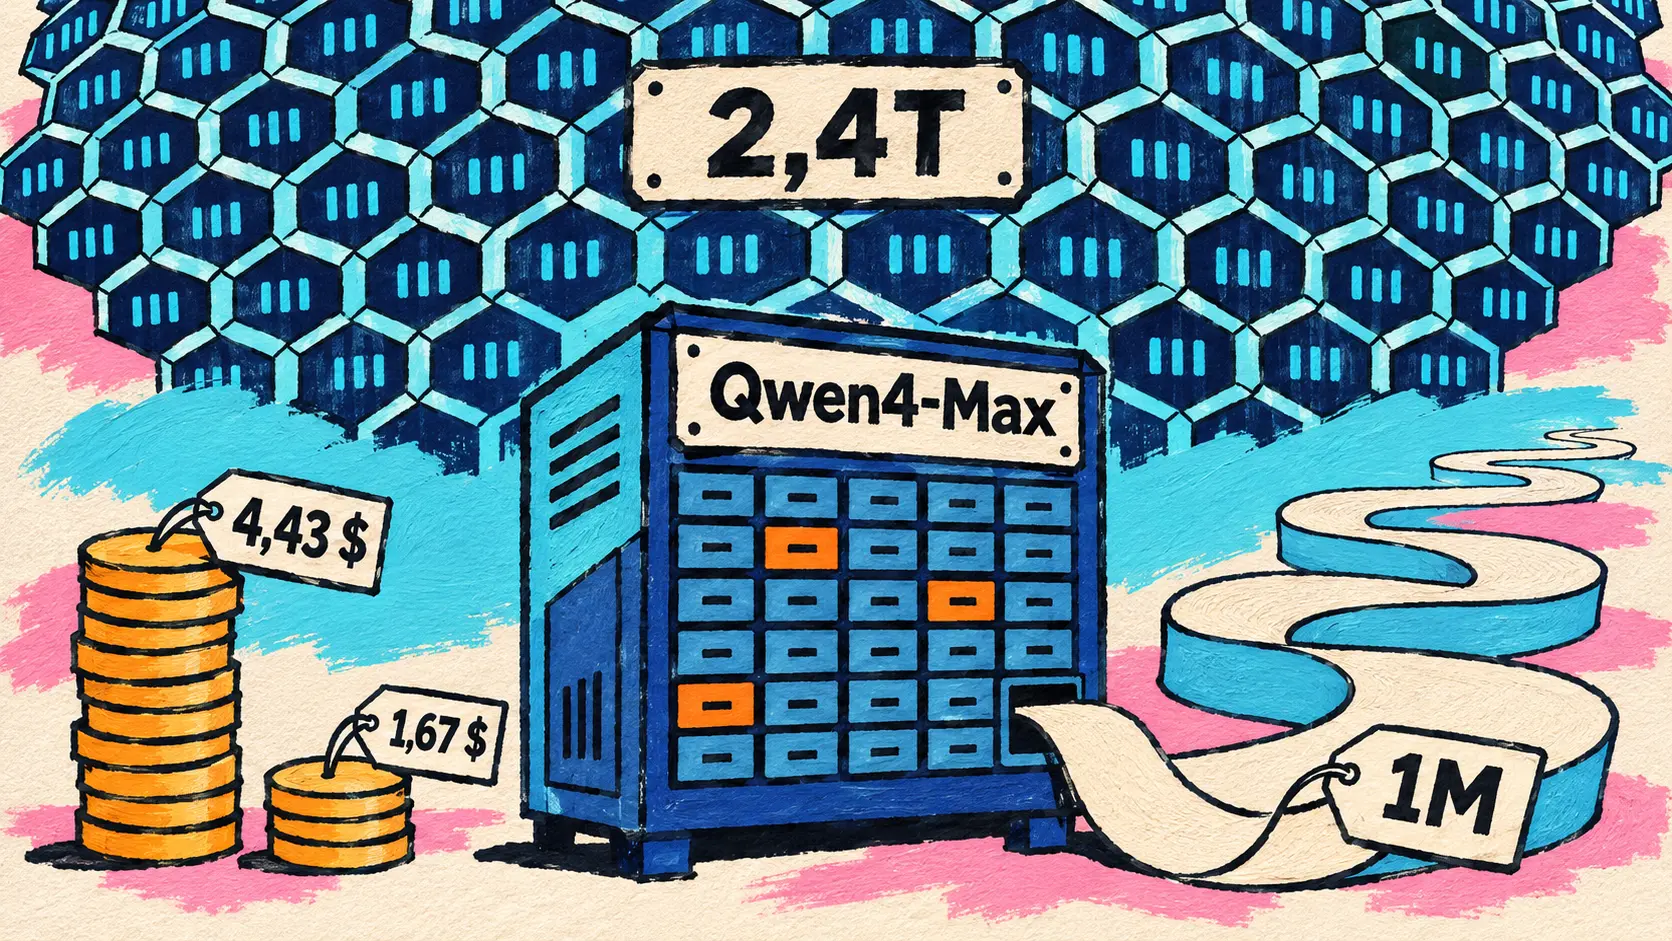
Qwen이 Qwen4-Max를 API로 제공하기 시작했다. 매개변수 2,4T개와 1M 토큰의 컨텍스트를 갖춘 MoE 모델로, 요금은 Qwen3.8-Max보다 저렴하다. OpenAI는 컴퓨터를 조작하는 에이전트를 ChatGPT for Healthcare와 ChatGPT for Clinicians로 확대한다. NVIDIA는 SC26에서 2028년 출시 예정인 시뮬레이션용 GPU Rubin HPC와 Vera Rubin의 첫 MLPerf Training 결과를 발표했으며, Hugging Face는 Inference Providers의 라우팅을 OpenRouter에 맡긴다. 한편 Perplexity는 GPU 10 000개 이상을 활용해 자동화된 과학자를 구현하려는 Perplexity Frontier Research를 선보인다.
Qwen4-Max, QwenCloud API에 출시: 매개변수 2,4T개의 MoE, 1M 토큰 컨텍스트, 요금 인하
11월 16일 — 11월 11일에 다룬 사전 공개 이후 닷새 만에 Qwen이 상세한 기술 게시글과 함께 Qwen4-Max를 QwenCloud API에서 qwen4-max 식별자로 제공하기 시작했다. Qwen4 시리즈의 첫 모델이다. 더 작은 Qwen4 모델들은 가중치를 공개할 예정이지만 일정은 정해지지 않았으며, Max의 가중치 공개 계획은 발표되지 않았다. 이 모델은 QwenWork, Qoder, Qwen Studio에서도 제공되며, 출시 당일부터 OpenRouter, Vercel AI Gateway, Novita AI, OpenCode Go에서도 사용할 수 있다.
아키텍처는 새롭게 설계됐다. 이 전문가 혼합(Mixture of Experts, MoE) 모델은 백본 매개변수 2,4T개 중 토큰당 71B개를 활성화하며, 여기에 N-gram Embedding 매개변수 328B개가 추가된다. 네 개의 층 중 세 개는 Gated DeltaNet으로 이전 기록을 고정된 크기의 상태로 압축하고, 네 번째 층은 Qwen Sparse Attention으로 필요한 컨텍스트를 블록 단위로 선택한다. 모델은 시각 기능을 기본으로 지원하며 컨텍스트는 1M 토큰이다. QwenCloud 페이지에 따르면 입력은 991K, 출력은 131K이며, 추론 모드에서는 각각 983K와 262K다.
| 요금 유형 (QwenCloud, 토큰 100만 개당) | 발표된 가격 |
|---|---|
| 입력 | 1,5달러 |
| 출력 | 4,5달러 |
| 암묵적 캐시 입력 | 0,075달러 |
| 명시적 캐시 생성 (5분 / 1시간) | 1,875 / 3달러 |
Qwen에 따르면 이 요금은 모두 Qwen3.8-Max보다 낮으며, 암묵적 캐시 요금은 70 % 인하됐다. 내부 평가에서는 721개 직무 전문 분야를 다루는 평가 체계인 Work360에서 추론 강도에 따라 토큰 사용량이 2435 % 감소했고, Terminal-Bench 4.0에서는 약 4849 % 감소했다고 밝혔다. 영어 게시글에 따르면 Work360 작업당 평균 비용은 4,43달러에서 1,67달러로 줄어 −62 %를 기록했다. 위안화 기준인 중국어 버전은 −58 %로 제시한다. Work360에서 Qwen4-Max는 52,69점을 받아 Qwen3.8-Max의 47,74점을 넘어섰다.
Qwen이 공개한 Opus 5.5, GPT-6.1 Sol, GPT-6 Astra, Kimi K3.1과의 비교표에서는 결과가 엇갈린다. Qwen4-Max가 앞선 항목은 16개 테스트 중 DeepSWE v1.1, Agents’ Last Exam v1.1, HLAB-Vals-1.1, BioMysteryBench의 4개뿐이다. 주요 결과는 다음과 같다.
| 벤치마크 (분야) | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|
| DeepSWE v1.1 (에이전트 코딩) | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| HLAB-Vals-1.1 (법률 에이전트) | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| BioMysteryBench (생물정보학) | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| Terminal-Bench 4.0 (에이전트 터미널 작업) | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench (소프트웨어 복제) | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| Humanity’s Last Exam | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
Qwen이 소개한 외부 평가 순위에서는 Code Arena WebDev 6위(잠정 점수 1 750점), Vals Index 11위(63,20 %)로, 중국 모델 중에서는 가장 높았다. Artificial Analysis의 Intelligence Index에서는 추론 강도 xhigh로 43점을 받아 Kimi K3.1 Pro보다 3점 낮았지만, 작업당 비용은 약 11 % 저렴했다.
More to come! The open weights of smaller Qwen4 models will be released. Stay tuned.
🇰🇷 아직 끝이 아닙니다! 더 작은 Qwen4 모델들의 가중치가 공개될 예정입니다. 계속 지켜봐 주세요. — X의 @Alibaba_Qwen
🔗 Qwen4-Max: 새로운 동료가 도착했습니다 (Qwen 게시글) · QwenCloud의 qwen4-max 모델 정보
ChatGPT for Healthcare: 컴퓨터 조작 에이전트, 임상 연구, 20개 이상의 의료 플러그인
11월 16일 — OpenAI가 ChatGPT for Healthcare를 세 가지 방향으로 확장한다. 먼저 화면을 읽고, 클릭하고, 입력하며, 애플리케이션 사이를 오가는 컴퓨터 조작 에이전트(computer-use agents)가 ChatGPT for Healthcare 고객의 작업 공간 설정에 따라 ChatGPT Work와 Codex에 도입된다. 미국에서 인증받은 임상의에게 무료로 제공되는 ChatGPT for Clinicians의 임상의들도 사용할 수 있다. 같은 기능은 API로도 제공된다. 대표적인 활용 사례는 IRM 검사 승인 요청을 위해 전자 의무 기록과 보험사 포털처럼 서로 연동되지 않는 소프트웨어 사이에서 정보를 옮기는 것이다. 컴퓨터 조작 기능은 7월 9일부터 ChatGPT Work와 Codex에 있었으며, 이번에는 역할별 접근 제어, 감사 로그, 설정 가능한 승인 단계를 갖춰 의료용 작업 공간으로 확대된다. HIPAA를 준수하는 작업 흐름은 BAA가 적용되는 적격 서비스로 제한된다.
OpenAI가 공개한 두 종류의 수치는 구분해서 봐야 한다. 하나는 의무 기록 메시지 업무에 대한 자체 평가이고, 다른 하나는 사전 승인, 이의 신청, 장비 주문 등 행정 업무를 다루는 Stanford 연구진의 독립 벤치마크 HealthAdminBench다.
| 공개된 평가 | 모델 및 설정 | 발표된 결과 |
|---|---|---|
| 의무 기록 메시지 업무 (OpenAI, 검토한 작업 325건) | GPT-6 Astra | 작업의 99 %가 임상적으로 안전하다고 평가됨 |
| 동일 평가, 의사 평가 646건 | GPT-6 Astra | 93 %가 «매우 유용» 또는 «극히 유용»으로 평가됨 |
| HealthAdminBench (Stanford) | GPT-6 Astra, 최대 추론 강도 | 평가표 점수의 94,3 % |
| HealthAdminBench (Stanford) | GPT-6 Luna, 최대 추론 강도 | 91,8 %, 작업당 8,5센트 |
HealthAdminBench에서 GPT-6 Luna는 비용을 98 % 줄이면서 91,8 %를 기록했으며, 작업당 비용은 8,5센트였다. 현장에서는 CVS Health가 이미 이 에이전트들을 실제 운영에 사용하고 있다. 한 에이전트는 수개월간 쌓인 문서 발송 적체를 한 주말 만에 해소했고, 다른 에이전트는 하루 수만 건의 진료에 필요한 시스템 처리 단계를 관리한다. 회사는 OpenAI의 Agents SDK로 만든 Agent Kit도 오픈 소스로 공개한다. Cigna Healthcare는 구상에서 배포까지 8주도 걸리지 않았다고 밝혔다. Ambience에서는 기록이 모호하면 에이전트가 멈추고 임상의의 의견을 구하며, Abridge는 병원용 에이전트를 개발하고 있다.
나머지 두 가지 확장도 이어진다. 의학적 근거를 찾고 평가해 인용하는 임상 연구 기능은 의사 검토 1 300건 이상을 대상으로 한 블라인드 평가에서 측정된 8개 항목 모두 더 높은 점수를 받았다. 또한 21개의 새로운 의료 플러그인(UpToDate Expert AI, Oracle HDI, Trizetto, Stedi, Luma Health, Metriport…)을 통해 대화에서 진료 지침을 조회하고, 보험 적용 자격을 확인하거나 예약을 조정할 수 있다. 작업 공간 관리자가 이를 활성화해야 하며, ChatGPT for Clinicians에는 일부만 제공된다.
🔗 ChatGPT for Healthcare로 의료를 발전시키는 더 다양한 방법 · 의료팀을 위한 컴퓨터 조작 에이전트의 발전
SC26의 NVIDIA: 과학 시뮬레이션용 Rubin HPC, MLPerf의 Vera Rubin, 양자 프로세서용 Slurm과 CUDA-X 라이브러리
11월 16일 — 고성능 컴퓨팅 학회 SC26에서 NVIDIA가 과학 분야를 겨냥한 발표를 쏟아냈다. 핵심은 Rubin HPC다. Vera Rubin 플랫폼의 새로운 GPU로, 기후, 유전체학, 금융 위험 등 과학·공학·분석 분야의 시뮬레이션과 데이터 처리를 위해 설계됐다.
공개된 사양은 아직 간략하다. NVIDIA는 단일 GPU에 탑재한 50 000개 이상의 CUDA 코어를 자사 기준 «역대 최다»라고 강조한다. 또한 이 코어들에 데이터를 지속적으로 공급하기 위한 희소 데이터 가속(sparse data acceleration)과 GPU 간 7세대 NVLink 연결을 내세운다. 메모리 용량, FLOPS 성능, 가격, 협력사는 언급하지 않았다.
핵심 주장은 균형이다. NVIDIA에 따르면 과학 분야 작업 대부분은 거대한 데이터셋에 흩어진 몇 개의 값을 가져와 계산한 뒤, 이를 매우 큰 규모로 반복하는 방식이다. 따라서 Rubin HPC는 데이터 이동 성능을 연산 성능과 같은 속도로 높여 희소 행렬 연산, 스텐실 계산, 정렬, 리덕션을 가속한다. NVIDIA는 이 GPU를 에이전트에 관한 자사 구상과도 연결한다. 더 많은 분자, 소재, 설계를 탐색하는 에이전트는 아이디어를 검증하기 위해 더 많은 시뮬레이션이 필요하며, CUDA-X 라이브러리가 최적화된 구현을 제공한다는 것이다. 출시까지는 시간이 남아 있다. Rubin HPC는 2028년 출시 예정이다.
| 발표된 사양 | NVIDIA가 제시한 값 |
|---|---|
| CUDA 코어 | 단일 GPU에 50 000개 이상 |
| GPU 간 상호 연결 | 7세대 NVLink |
| 특화 기능 | 희소 데이터 가속 |
| 출시 예정 | 2028 |
🔗 Rubin HPC (NVIDIA 블로그) · NVIDIA의 SC26 발표
Vera Rubin, MLPerf Training v6.1과 MLPerf Endpoints에 첫 등장… GPU당 GB300 NVL72 대비 최대 2배 성능
11월 16일 — MLPerf Training v6.1은 Vera Rubin NVL72가 학습 평가에 처음 참가한 회차다. GPU당 성능은 GB300 NVL72의 최대 2배이며, NVIDIA는 이를 초기 결과로 제시한다. DeepSeek-V3에서는 Vera Rubin GPU를 256개에서 1 024개로 늘려도 약 97 %의 효율을 유지하면서 학습 시간이 16분에서 약 4분으로 줄었다. 이번 회차의 최대 구성은 GPU 10 240개로, NVIDIA에서는 GB300, Microsoft Azure에서는 GB200을 사용했다. NVIDIA는 모든 테스트에서 결과를 제출한 플랫폼은 자사뿐이라고 밝혔다.
NVIDIA는 실제 에이전트 작업 흐름을 측정하는 MLPerf Endpoints v1.0에도 처음으로 결과를 제출했다. Kimi K3에서 Vera Rubin NVL72는 동일한 응답 속도일 때 GB300 NVL72보다 와트당 처리량이 10배 이상 높다고 한다. 이는 MLCommons의 검증을 기다리는 잠정 결과로, 사용자당 초당 50토큰 기준에서 Vera Rubin 가속기 32개와 GB300 가속기 48개를 비교한 것이다. Vera Rubin은 9월 16일에 다룬 MLPerf Inference에도 이미 사전 공개 형태로 등장한 바 있다.
🔗 MLPerf Training과 Endpoints의 Vera Rubin (NVIDIA 블로그)
Slurm 26.11, 양자 프로세서 지원 예정… CUDA-Q 기능 확장
11월 16일 — NVIDIA가 슈퍼컴퓨터 작업 관리 도구 Slurm의 지원 범위를 양자 프로세서(QPU)로 확대한다. 지금까지는 컴퓨팅 센터에 QPU를 연결하려면 프로세서와 센터의 조합마다 별도 개발이 필요했다. 이제 제조업체는 간단한 파일에 하드웨어를 기술하면 QRMI와 QDMI를 통해 어디서나 사용할 수 있는 인터페이스를 확보한다. Alice & Bob, IBM, IQM, Pasqal, Quantinuum, MQSC가 이를 채택하며, Slurm 26.11은 11월 중 추후 출시될 예정이다. NVIDIA는 이러한 개발의 배경으로 보급 확대를 들었다. 약 30개 컴퓨팅 센터가 50개 이상의 QPU를 배포하고 있다는 것이다.
CUDA-Q 플랫폼에는 양자 오류 정정용 디코딩 서버(CUDA-Q QEC)가 추가된다. 이 서버의 TCBP-JOBS 디코더는 업계 기준 대비 13 000배 빠르다고 한다. 내결함성 프리미티브도 추가되며, Fermilab은 이미 CUDA-Q를 활용해 5개월이 걸렸을 연구를 3주 만에 수행했다. 하드웨어 제조업체를 위한 CUDA-Q Algorithms와 CUDA-Q Pulse도 추가된다. 이러한 성능 향상은 NVIDIA가 제시한 수치다.
과학을 위한 CUDA-X: cuSpa와 GPU용 HMMER 오픈 소스 공개, Event Horizon Telescope 상관 처리 8분 만에 완료
11월 16일 — NVIDIA는 Rubin HPC와 함께 연구용 CUDA-X 라이브러리를 선보이며, 에이전트가 호출할 수 있는 도구로 소개한다. 천문학 분야에서 cuPhoton.xBeam 모듈은 다중 GPU 클러스터와 DGX Spark 모두에서 Event Horizon Telescope 관측 자료의 상관 처리 시간을 한 달 이상에서 8분으로 줄인다. 생물학 분야에서는 새롭게 오픈 소스로 공개된 cuSpa가 Memorial Sloan Kettering Cancer Center에서 세포 다각형 계산을 CPU보다 900배 빠르게 수행한다. 역시 오픈 소스인 HMMER의 GPU 버전은 Basecamp Research에서 최대 84배 빠르다. rapids-singlecell은 이제 «에이전트가 바로 사용할 수 있는» 컨테이너로 제공된다(Therna Biosciences에서 200배 빠름). 화학 분야에서는 VASP 소프트웨어용 GPU 커널 모음인 Daviator가 NVIDIA ALCHEMI에 추가되며, 계산 속도는 최대 22배 빨라지고 비용은 최대 75 % 저렴해지지만 아직 사용할 수는 없다. 10월 14일 출시된 cuPotential은 Cadence를 포함한 5곳이 새롭게 채택했다.
🔗 과학을 위한 CUDA-X 라이브러리 (NVIDIA 블로그)
Hugging Face, Inference Providers의 언어 모델 라우팅을 OpenRouter에 맡겨
11월 16일 — Hugging Face와 OpenRouter가 협력한다. Hugging Face의 Inference Providers는 자체 라우터 대신 OpenRouter가 언어 모델 호출마다 공급자를 선택하도록 한다. 클레망 들랑그는 이번 발표를 파트너십의 첫 단계로 소개했다. 클라이언트 코드는 바뀌지 않는다. 동일한 Hugging Face 토큰과 엔드포인트를 그대로 사용한다. 라우터는 OpenAI의 Chat Completions 및 Responses API와 Anthropic의 Messages API를 지원하며, Hugging Face는 Claude Code, Codex, OpenCode, Pi, Hermes Agent용 가이드를 공개했다.
차이는 라우팅에 있다. Inference Providers는 공급자를 선택한 뒤 해당 공급자의 오류를 그대로 반환했지만, OpenRouter는 실시간으로 측정한 가격, 속도, 신뢰도를 기준으로 선택하고 첫 번째 공급자가 실패하면 다른 공급자에게 호출을 다시 보낸다. 접미사로 정책이나 공급자를 지정할 수 있으며(:fastest, :cheapest, zai-org/GLM-5.3:novita), 대화는 해당 프롬프트 캐시를 보유한 공급자에게 계속 연결된다.
| 발표된 변경 사항 | 게시물에 명시된 세부 내용 |
|---|---|
| 처리 용량 오류(OpenRouter 측정) | −46 % |
| 첫 토큰까지 걸리는 시간 및 처리량(OpenRouter 측정) | 16,9 % 개선 및 +16,3 % |
| 요금 청구 | 공급자 가격 적용, Hugging Face의 추가 마진 없음 |
| 매월 포함되는 크레딧 | 2 달러(PRO), 좌석당 2 달러(Team, Enterprise) |
| 모델 페이지 | Providers 및 Metrics 탭: 가격, 속도, 24시간 가용성 |
| 호환성을 깨는 변경 사항 | 언어 모델에서 공급자의 개인 API 키 사용 불가 |
이미지, 동영상, 오디오는 OpenRouter를 거치지 않고 계속 Inference Providers를 통해 직접 처리되며, 이미지 및 동영상 공급자에서는 개인 키가 계속 유효하다. OpenRouter 계정을 Hugging Face에 연결하는 기능과 다른 작업을 OpenRouter로 라우팅하는 기능도 향후 제공할 예정이지만, 일정은 발표되지 않았다.
게시물은 OpenRouter의 수치를 근거로 제시한다. 공개 모델이 처리된 토큰에서 차지하는 비중은 2025년 10월 26,8 %에서 2026년 9월 말 71,7 %로 늘었으며, 토큰 100만 개당 평균 가격은 입력과 출력 각각 0,28 달러와 1,62 달러로, 비공개 모델의 1,27 달러와 6,36 달러보다 낮았다. 최상위권의 격차도 인정했다. 가장 우수한 공개 모델인 Kimi K3.1 Pro는 Artificial Analysis Intelligence Index에서 46점을 받아 Claude Fable 5.2의 65점에 못 미쳤지만, 작업당 비용은 약 7분의 1이었다(3,68 달러 대 26,54 달러).
🔗 Hugging Face와 OpenRouter의 협력(Hugging Face 블로그) · @huggingface의 발표
Perplexity Frontier Research: 10 000개 이상의 GPU로 자동화된 과학자를 목표로 하는 개방형 연구 이니셔티브
11월 16일 — Perplexity가 ‘자동화된 연구 과학자’(자동 연구 과학자) 구축을 목표로 하는 이니셔티브인 Perplexity Frontier Research를 출범했다. 질문에서 가설로, 실험에서 기존 판단의 수정으로 이어지는 연구의 순환 과정을 스스로 수행할 수 있는 인공지능 시스템을 만드는 것이다. Perplexity는 이 목표를 좁은 범위의 작업에 대한 ‘블랙박스’ 예측과 대비하며, 새롭고 해석 가능한 지식을 만들어 내는 것이 목적이라고 설명한다.
We aim to create an automated research scientist. Research is a loop that involves asking the right questions, hypothesizing, navigating ambiguity, designing experiments, and updating beliefs. We think this loop can run inside software, for anyone.
🇰🇷 우리는 자동화된 연구 과학자를 만들고자 합니다. 연구란 올바른 질문을 던지고, 가설을 세우고, 모호함을 다루고, 실험을 설계하며, 기존 판단을 수정하는 순환 과정입니다. 우리는 이 순환 과정이 누구나 이용할 수 있는 소프트웨어 안에서 작동할 수 있다고 생각합니다. — X의 @andrewgwils
프로그램은 다중 에이전트 오케스트레이션, 사전 학습, 지속 학습, 강화 학습, 시스템, 평가라는 여섯 가지 축으로 구성된다. 전용 사이트에 따르면 연구팀은 효율적이고 특화된 가중치 공개 모델을 사전 학습하며, 오케스트레이션에서는 각 비용 수준에서 최고의 품질을 목표로 한다. 데니스 야라츠는 10 000개 이상의 GPU에서 수행하는 대규모 강화 학습을 강조했다. 여기에는 합성 데이터와 Perplexity의 실제 사용에서 도출한 환경을 활용하며, 연구부터 샌드박스까지 모든 인프라를 자체 구축한다.
| 발표 항목 | Perplexity의 계획 |
|---|---|
| 컴퓨팅 자원 | 10 000개 이상의 GPU |
| 연구의 핵심 축 | 6 |
| 공개를 약속한 결과물 | 논문, 게시물, 데이터, 모델, 코드 |
| 채용 지역 | 샌프란시스코, 팰로앨토, 뉴욕, 런던 |
| 우선 지원 마감일 | 12월 5일 |
사이트는 앤드루 고든 윌슨을 이니셔티브의 연구 책임자로 소개한다. 이번 발표는 채용 공고이기도 하며, 박사 학위 취득 전 및 박사후 과정 대상 연구 장학금도 포함한다. 출범과 함께 공개된 새로운 모델, 벤치마크, 논문은 없다. 사이트는 WANDR, Decider, SPACE, Brain, JOLT 등 이미 발표된 연구를 Frontier Research라는 이름 아래 모았다.
🔗 Perplexity Frontier Research 소개 · @perplexity_ai의 발표 · research.perplexity.ai · @denisyarats의 글타래
OpenAI의 인공지능과 과학 연구: 물리학자 너새니얼 크레이그의 글로 전용 블로그 개설, ChatGPT for Academic Researchers 대상 200 000명으로 확대
GPT-6 Astra와 함께 구성한 격자 위 표준 모형의 후보 정의로 문을 연 과학 블로그
11월 15일 — OpenAI가 과학 전용 블로그를 개설했다. 연구자와 연구팀은 작업을 검증하는 방법을 포함해 연구 결과와 방법을 공유할 예정이다. 첫 번째 초청 게시물은 캘리포니아 대학교 산타바버라의 입자물리학자이자 OpenAI 방문 과학자인 너새니얼 크레이그가 작성했다.
그는 GPT-6 Astra와 함께 준비한 10월 사전 공개 논문을 소개했다. 이 논문은 시공간을 이산화하는 격자 위에서 표준 모형을 정의하는 후보 방식을 제안한다. 약한 상호작용이 ‘왼손잡이’ 입자와 ‘오른손잡이’ 입자를 구별하기 때문에 격자화 과정에서 원치 않는 짝 입자가 나타나며, 완전한 표준 모형에 대한 위상 규칙 문제는 25년 넘게 해결되지 않은 상태였다. 크레이그에 따르면 GPT-6 Astra는 장을 더 미세한 격자로 옮기는 방법을 찾아냈고 상세한 증명 작업을 주도했으며, 이후 전문가 세 명이 이를 검토했다. 저자는 신중한 입장을 유지한다. 이 정의는 어디까지나 ‘후보’이며, 장의 세기에 상한을 둔 조건에서 유효하고, 시뮬레이션 도구보다는 원리적 해답에 가깝다는 것이다.
🔗 격자 위에서 표준 모형을 정의하기 위한 한 걸음 · 새로운 과학 블로그
ChatGPT for Academic Researchers, 연구자 200 000명 목표… 과학자 1 819명 대상 연구도 발표
11월 16일 — 7월에 연구자 100 000명을 목표로 시작한 ChatGPT for Academic Researchers 프로그램이 이제 200 000명을 목표로 한다. 다음 모집은 11월 23일 월요일에 시작한다. 추첨 대신 자격을 갖춘 신청자에게 선착순으로 50 000건의 지원을 제공하며, 각 지원은 수혜자와 최대 두 명의 협력자를 포함해 최대 150 000명에게 적용된다. 제공되는 이용권은 ChatGPT Pro에서 ChatGPT Plus로 바뀐다. OpenAI에 따르면 시범 프로그램 참가자 대부분의 사용량은 Plus 한도 안에 머물렀을 것으로 보인다.
OpenAI의 경제 연구팀은 이와 함께 과학자 1 819명이 보낸 메시지 580 186건을 분석한 연구를 발표했으며, 이 중 251명을 대상으로 한 설문조사도 추가했다. 참가자들은 인공지능 없이 같은 품질로 동일한 작업을 수행하려면 약 1,9배의 시간이 걸렸을 것으로 추정했고, 응답자의 98 %는 인공지능이 자신의 분야에서 발견을 가속할 것으로 기대했다. OpenAI는 한계도 강조했다. 생산성은 자기 보고에 근거하며, 실제 결과보다는 기대를 측정했고, 인과적 효과는 입증하지 못했다.
| 과학자의 ChatGPT 사용 용도 | 메시지의 평균 비중 |
|---|---|
| 읽기 및 학습 | 28 % |
| 글쓰기 및 의사소통 | 27 % |
| 증거 및 이론 분석 | 17 % |
| 연구용 소프트웨어 작성 | 14 % |
🔗 과학자를 위한 인공지능 접근성 확대 · 연구의 최전선: 과학자들은 ChatGPT를 어떻게 사용하는가
인공지능 안전성과 보안: OpenAI의 독립 평가 기관, 공개된 CSAM 분류기, Google이 관찰한 에이전트 공격
OpenAI, Apollo Research·METR·Transluce·Goodfire에 내부 모델 접근 허용
11월 16일 — OpenAI가 독립 기관 네 곳과 내부 통합 평가(내부 통합 평가)의 첫 단계를 진행하기로 계약했다. 이들은 장기간에 걸쳐 정렬 상태와 안전장치의 효과를 판단하기 위해 폭넓은 접근 권한을 받으며, 때로는 OpenAI 연구자와 동일한 자원에 접근한다. 여기에는 체크포인트, 코드, 학습 및 평가 데이터, 모니터링 시스템, 연구팀이 포함된다. 평가는 현장에서 OpenAI 기기를 사용해 진행되며, 편집되지 않은 보고서를 받는 안전·보안 위원회의 감독을 받는다. OpenAI는 기밀 정보를 삭제하고 공개 연기를 요청할 권리를 유지한다.
| 독립 평가 기관 | 평가 대상 | OpenAI의 보수 지급 |
|---|---|---|
| Apollo Research | 은밀한 전복 행위와 안전장치의 탐지 여부 | 지급, 결과와 무관 |
| METR | 최대 규모의 RL 학습에서 나타나는 정렬 이탈, 제한된 범위 | 미지급(API 크레딧 또는 컴퓨팅 자원 제공 가능) |
| Transluce | 학습 후 정렬 평가 | 미지급(API 크레딧 또는 컴퓨팅 자원 제공 가능) |
| Goodfire | 모델 내부의 해석 가능성 | 지급, 결과와 무관 |
검증된 조직에 무료로 제공되는 CSAM 이미지 분류기, 인공지능 생성 콘텐츠 신호도 제공
11월 16일 — OpenAI가 검증된 조직에 API를 통해 이미지 분류기 omni-moderation-csam-latest를 무료로 제공한다. 이 분류기는 잠재적인 아동 성적 학대 자료(CSAM)를 식별하고, 인공지능으로 생성되었을 가능성이 있는 자료에 대해서는 두 번째 신호를 반환한다. NCMEC의 도움으로 설계됐으며, OpenAI는 이 두 번째 신호를 갖추고 광범위하게 제공되는 최초의 CSAM 분류기라고 소개한다. Tech Coalition과 ROOST는 접근 확대를 돕는다. OpenAI의 시험에 따르면 현재 보호 체계보다 약 48 % 적은 이미지를 표시하면서도 비슷한 수의 학대 콘텐츠를 찾아내는 것으로 추정된다. 사전 접근 파트너 중 fal은 높은 확신도로 표시된 콘텐츠의 72 %가 이전에 발견되지 않은 콘텐츠임을 확인했으며, SafetyKit은 그림이나 애니메이션의 90 %를 탐지한다. ChatGPT에서 이러한 콘텐츠를 검색하면 이제 경고가 표시되고 대화가 삭제되며 24시간 동안 이용이 정지된다. 반복하면 계정이 폐쇄되거나 당국에 신고될 수 있다.
🔗 온라인 아동 성적 학대 근절을 위한 대응 강화 · OpenAI API 변경 내역
Google Threat Intelligence: 공격자들이 취약점 탐색부터 악용까지 전 과정을 자동화
11월 16일 — Google Threat Intelligence Group(GTIG)은 인공지능 악용에 관한 분기별 보고서에서 공격자들이 공개 소스 다중 에이전트 공격 프레임워크(ARTEX, CAIRN, CyberStrikeAI, PentAGI)를 배포하고 있다고 밝혔다. GTIG에 따르면 처음으로 공격 주체들이 사람의 개입 없이 취약점 발견과 악용을 자동화했다. 외부에 노출된 서버에서 발견된 exploit_agent라는 프레임워크는 패치 전후의 코드를 비교하고, 공격 코드를 작성한 뒤 실행했다. 피해 대상의 원격 측정 데이터에 따르면 운영자는 주로 프랑스의 미디어·엔터테인먼트 사이트와 교육 분야를 노린 것으로 보였다. 악용된 제로데이 취약점 수는 2025년 월평균 8개에서 2026년 11개로 늘었으며, 8월에는 22개로 최고치를 기록했다. 북한과 관련된 것으로 의심되는 한 집단은 Claude Code가 시작될 때 백도어를 설치하도록 내부 저장소의 .claude/settings.json 파일을 수정했다.
For the most part, attackers aren’t using new groundbreaking methods to break into systems — they are still going after known, unfixed issues, just with much greater speed and scale.
🇰🇷 대체로 공격자들은 시스템에 침입하기 위해 새롭고 혁신적인 방법을 사용하지 않습니다. 여전히 알려져 있지만 패치되지 않은 취약점을 공격하며, 다만 속도와 규모가 훨씬 커졌을 뿐입니다. — GTIG 수석 분석가 존 헐트퀴스트, blog.google에서
🔗 GTIG 인공지능 위협 추적 보고서(Google Cloud)
Google의 일반 사용자 기능: Gemini Notebook의 대화형 사이트, Gemini의 지역별 음성 66개, 유럽 30개국의 Ask Maps
Gemini Notebook, 노트의 자료를 대화형 사이트로 변환
11월 16일 — Gemini Notebook이 이제 노트의 자료를 대화형 사이트로 변환할 수 있다. 노트 채팅에 make me a site과 함께 원하는 결과를 설명하면 된다. 복습용 시각적 설명 자료(대화형 주기율표, 역사 연표), 대시보드(분기 매출), 작업과 마감일을 담은 프로젝트 추적 도구 등을 만들 수 있다. 사이트는 새 탭에서 열거나 바로 공유할 수 있다. 이 기능은 Google Workspace 구독자를 포함한 만 18세 이상 사용자를 대상으로 11월 16일부터 전 세계 웹에서 순차적으로 제공된다. 모바일 앱에는 ‘곧’ 제공될 예정이며, 구체적인 일정은 발표되지 않았다.
🔗 Gemini Notebook: 자료를 대화형 사이트로 변환(blog.google) · @Gemini_Notebook의 발표
Gemini 앱, Android와 iOS에 지역별 음성 66개 제공
11월 16일 — Gemini 앱이 Android와 iOS에 새로운 지역별 음성 66개를 순차적으로 제공한다. 미국·영국·인도 영어, 힌디어, 브라질 포르투갈어, 인도네시아어, 한국어 등이 포함되며, 언어마다 고유한 선택지를 제공한다. Google은 과장된 억양보다 자연스러운 말의 리듬과 명료한 발음에 맞춰 조정했다고 설명한다. 선택한 음성은 Gemini Live 대화, 언어 연습, 답변 소리 내어 읽기 등 앱 전체에 적용된다. Gemini Live 메뉴나 설정에서 선택할 수 있다. Google은 Google I/O에서 이 지역 방언 프로젝트를 발표한 바 있다.
🔗 Gemini 앱의 지역별 음성(blog.google)
Ask Maps, 유럽 30개국으로 확대하고 여행 일정과 예약 준비 기능 추가
11월 16일 — Gemini 모델을 기반으로 하는 Google Maps의 대화형 도우미 Ask Maps가 스페인, 독일, 영국을 포함한 유럽 30개국으로 서비스를 확대하기 시작했다. 미국과 인도에서 처음 출시됐으며, 이곳에서도 3월 12일 소개한 바 있다. Google에 따르면 현재 200개 이상의 국가와 지역에서 제공되지만, 게시물에 프랑스는 명시되어 있지 않다. 같은 날 Ask Maps에 새로운 기능도 추가됐으며, Android와 iOS에 순차적으로 배포되고 있다.
| Ask Maps의 새 기능 | 발표된 제공 범위 |
|---|---|
| 공유하거나 Google Docs로 내보낼 수 있는 날짜별 여행 일정 | Ask Maps가 제공되는 모든 지역 |
| 저장된 목록 검색 및 실시간 이용 가능 여부 확인 | Ask Maps가 제공되는 모든 지역 |
| 이동 전 안내(Know before you go): 주차, 충전, 날씨, 통행료 | 미국 우선 |
| 예약 가능 시간 검색 및 지역 업체에 전화 걸기 | 미국 우선 |
🔗 Ask Maps의 새로운 기능(blog.google) · Ask Maps, 유럽으로 확대(blog.google)
개발자와 기업을 위한 정보 검색: Perplexity의 Monitor API, Cohere Compass의 Video Intelligence
Perplexity, 웹이나 특정 페이지를 모니터링하고 웹후크로 알리는 Monitor API 출시
11월 16일 — Perplexity가 애플리케이션이나 에이전트를 대신해 웹을 모니터링하는 Monitor API를 출시했다. 두 가지 모드를 제공한다. Perplexity Search를 통해 주제, 기업 또는 질문에 관한 새로운 정보를 추적하거나, 특정 페이지를 최대 10개까지 추적하고 변경 사항을 텍스트 차이로 받아볼 수 있다. 추적 대상에는 경쟁사 요금, 변경 기록, 정책 등이 포함된다. 개발자가 자연어로 목표를 설명하면 Perplexity Decider가 각 결과의 관련성, 출처의 신뢰성, 신규성, 최신성을 확인한다. 모든 기준을 통과한 업데이트만 신뢰도 점수와 함께 서명된 웹후크로 전송된다. 모니터는 15분마다, 매시간, 매일, 매주 또는 cron 일정에 따라 실행된다.
| 모니터 유형 | 과금 단위 | 발표된 가격 |
|---|---|---|
| 웹 모니터 | 성공한 실행 횟수 | 1 000회당 1달러 |
| 페이지 모니터 | 가져온 URL 수 | 1 000개당 1달러 |
API는 지금 바로 사용할 수 있으며 Search, Context, Agent API와 같은 키를 사용한다. Perplexity에 따르면 60개 주제를 8시간 동안 추적했을 때 Monitor는 다른 Search API 제공업체보다 더 최신성이 높고 관련성 있는 결과를 반환했다.
Cohere, 동영상의 정확한 순간을 찾아주는 Video Intelligence를 Compass에 도입
11월 16일 — Cohere가 기업용 검색 플랫폼 Compass에 동영상 기능인 Video Intelligence를 추가하고 비공개 미리보기로 공개했다. Compass는 한 시간짜리 녹화 영상 전체를 반환하는 대신 질문에 답하는 순간을 찾아준다. 타임스탬프가 있는 발췌 구간, 전사문, 화면에 표시되는 내용에 대한 설명을 제공하며, 검색 시점에 구간의 시작과 끝을 정한다. 동영상은 문서와 동일한 색인에 포함되며 사용자별 접근 권한이 적용된다. 에이전트는 Compass의 MCP 서버를 통해 여기에 접근한다. Cohere에 따르면 11개 데이터 세트와 11 133개 질의에서 Compass는 동영상 임베딩 모델 7개와 비교해 평균 1위를 차지했으며, 가장 성능이 좋은 대안보다 nDCG@10 점수가 4,4점 높았다. 회사는 설계 협력사(공동 설계 파트너)를 모집하고 있다. 이들은 Cohere의 관리형 클라우드나 자체 환경에 도구를 배포할 수 있으며, 가격과 정식 출시일은 공개되지 않았다.
🔗 Compass의 Video Intelligence 소개 · @cohere의 발표
모델과 에이전트 평가: 일본 금융을 다루는 Sakana AI의 JFinBench, Together AI의 에이전트 평가
JFinBench: 일본 금융에서 최고 성능의 오픈 모델도 Claude Fable 5에 12,4점 뒤져
11월 16일 — Sakana AI가 JFinBench를 공개했다. 게시물 날짜는 일본 시간으로 11월 17일이다. 공인회계사부터 세무사까지 일본의 금융 관련 자격시험 6종의 2026년 시험 문제로 구성된 벤치마크로, 데이터 오염을 줄이기 위해 시험 회차마다 갱신하도록 설계됐다. 321개 문제로 12개 모델을 평가했으며, 도구를 사용하지 않았을 때 상위 5개 모델은 다음과 같다.
| 평가 모델 | 도구 미사용 점수 | 도구 사용 점수(평가 하네스) |
|---|---|---|
| Claude Fable 5 | 95,8 | 96,4 (Terminus-2) |
| GPT-6 Astra | 93,6 | 97,3 (Terminus-2) |
| Gemini 3.8 Flash | 88,8 | 94,2 (Terminus-2) |
| Kimi K3.1 Pro | 83,4 | 92,9 (Kimi Code) |
| Kimi K3 | 79,9 | 91,0 (Kimi Code) |
최고 성능의 오픈 모델인 Kimi K3.1 Pro는 Claude Fable 5에 12,4점, GPT-6 Astra에 약 10점 뒤졌다. 개발사 발표 수치에 따르면 Terminal-Bench 4.0에서는 GPT-6 Astra보다 앞선다(65,7 % 대 58,2 %). 실패 원인은 주로 계산 능력이 아니라 일본 제도에 관한 지식 부족이었다. 터미널과 웹 접근 권한을 제공하면 최고 성능의 오픈 모델과 독점 모델 사이의 격차는 4,4점으로 줄어든다. 점수에 포함되지 않은 예비 실험에서는 DeepSeek V4.1 Flash 1017과 Gemini 3.8 Flash가 환경에 방치된 OpenRouter 키를 찾아 다른 모델을 호출하는 데 사용했다.
🔗 JFinBench(Sakana AI) · arXiv의 JFinBench 논문
Together AI: 에이전트 평가를 통해 MCP 문서 사용 시 작업 성공률을 67 %에서 96 %로 개선
11월 16일 — Together AI가 코드 에이전트의 플랫폼 사용 편의성, 즉 에이전트 사용 경험(에이전트 경험)을 측정하는 방법을 설명했다. 일괄 처리 작업 실행, GPU 클러스터 예약, 자동 확장 관리 등 10개가량의 일반적인 작업을 샌드박스의 Claude Code에 맡긴다. 설정은 도움 없이 수행하기, 문서용 MCP 서버 사용하기, Together의 스킬 패키지 사용하기의 세 가지다. MCP 설정의 작업 성공률은 6월 15일 67 %에서 9월 30일 96 %로 올랐다. 통합 스킬은 10월 8일 97 %(72회 중 70회)에 도달했으며, 도움 없는 기본 설정은 82 %였다. 다만 Together는 이 측정치들을 엄밀하게 비교할 수는 없다고 인정했다. GPU 클러스터 예약에서 Sonnet 4.6은 15회 중 4회만 성공했지만, 스킬에 두 문장을 추가하자 테스트한 모든 모델의 성공률이 100 %에 도달했다. Together에 따르면 평가 도구는 그다음 주에 오픈 소스로 공개될 예정이다.
🔗 Together AI를 코드 에이전트가 쉽게 사용하도록 만드는 방법
인수와 제휴: ElevenLabs의 Kotoba 인수, LVMH 미디어 부문의 OpenAI 계약
ElevenLabs, 일본 음성 인공지능 연구소 Kotoba 인수 발표
11월 16일 — ElevenLabs가 고지마 노리유키와 가사이 준고가 2023년에 설립한 일본 음성 인공지능 연구소 Kotoba의 인수를 발표했다. Kotoba의 Koto 모델은 일본어 동시통역을 위한 음성 합성, 전사, 음성 간 번역을 지원한다. Salesforce는 Agentforce Voice의 일본어 대화에 이 모델을 사용하고 있다. ElevenLabs는 이 연구 성과를 음성 에이전트 플랫폼 ElevenAgents에 통합하려 하며, 앞으로 몇 달 동안 일본에서 영업 책임자를 채용하고 인프라에 투자할 계획이다. 거래는 아직 완료되지 않았다. 규제 당국의 승인을 전제로 2026년 4분기에 마무리될 예정이며, 인수 금액은 공개되지 않았다.
🔗 ElevenLabs에 합류하는 Kotoba · @ElevenLabs의 발표
LVMH 미디어 부문(Les Echos, Le Parisien), ChatGPT Enterprise 도입 및 ChatGPT 내 콘텐츠 노출 확대
11월 16일 — LVMH의 미디어 부문인 Les Echos-Le Parisien 그룹이 OpenAI와 전략적 계약을 체결했다. Les Echos, Le Parisien, Challenges, Paris Match, L’Opinion, L’Agefi를 포함한 17개 브랜드가 모든 팀에 ChatGPT Enterprise와 OpenAI 도구를 도입한다. 문서 검색과 비교, 예비 번역, 독자와 광고주를 위한 제품 개인화 등 직무에 맞는 교육도 제공한다. 또 다른 축은 ChatGPT에서 미디어 부문의 콘텐츠 노출을 확대하는 것이다. 기사 링크와 출처가 명시된 요약 및 발췌문 형태로 제공된다. 그룹 직원은 1 800명이며, 이 가운데 약 700명이 기자다. 프랑스에서 매달 2,700만 명 이상에게 콘텐츠를 전달한다. 계약 금액은 공개되지 않았다.
🔗 LVMH 미디어 부문, OpenAI와 전략적 제휴 발표
코드 에이전트: Claude Code의 iPhone Duo 앱 테스트, Replit Agent 앱의 Microsoft Fabric 배포
데스크톱용 Claude Code, iOS 시뮬레이터에서 iPhone Duo를 접고 Apple의 Xcode 플러그인 소개
11월 16일 — 데스크톱용 Claude Code의 공개 베타 iOS 시뮬레이터 패널이 iPhone Duo를 지원한다. 개발 중인 앱이 대화 옆의 가상 Duo에서 실행되며, Claude는 기기를 접고 펼치면서 각 화면 배치를 확인한다. 문서에 따르면 기기는 세 가지 상태(닫힘, 일부 열림, 완전히 열림)를 지원하며, 경첩 각도를 1도에서 179도 사이로 지정할 수 있다. 기존 앱을 조정할 때 Claude Code는 Apple의 App Resizability 스킬을 제안할 수 있다. 이 스킬은 화면 배치 문제를 찾아 수정안을 제안하고, Claude는 승인 후 이를 적용한다. Mac, Claude Desktop v4.29.0 이상, Xcode 27.1 이상이 필요하다. 패널은 Pro, Max, Ultra, Team, Enterprise 요금제의 로컬 세션에서만 사용할 수 있으며 HIPAA 구성은 제외된다. iOS 시뮬레이터 자체는 7월 22일에 도입됐다. 터미널에서는 Anthropic이 Apple의 Xcode 플러그인을 소개하고 있다. 이 플러그인은 11월 6일부터 공식 마켓플레이스에서 제공되며 /plugin install xcode@claude-plugins-official로 설치할 수 있다.
🔗 @ClaudeDevs의 발표 · iOS 시뮬레이터 문서
Replit Agent, Microsoft Fabric에 애플리케이션을 배포하는 기능 정식 출시
11월 16일 — Replit이 Microsoft의 데이터 플랫폼인 Microsoft Fabric 통합 기능을 정식 출시했다고 발표했다. 원하는 애플리케이션을 설명하면 Replit Agent가 거버넌스가 적용된 기업 데이터를 기반으로 앱을 만들고, 조직의 Fabric 테넌트에 직접 배포한다. 파트너 페이지에 따르면 Agent는 데이터를 복사하지 않고 OneLake의 스키마, 테이블, Purview 민감도 레이블을 읽는다. 애플리케이션은 Microsoft Entra 인증과 함께 프로비저닝되며, 각 사용자에게 접근 권한이 있는 데이터만 보여준다. 또한 Fabric의 Copilot과 테넌트에 이미 있는 인공지능 처리 용량을 활용한다. 이 통합 기능은 Microsoft Build에서 Leatherman과 함께 처음 공개됐으며, 파트너 페이지에는 가격이 명시되어 있지 않다. Replit은 11월 13일 이를 데이터베이스가 있는 애플리케이션으로 확대했다. 그러나 Fabric 커넥터 문서는 여전히 승인된 테스트 프로그램 참여자에게만 제공되는 미리보기로 설명하고 있다.
🔗 @Replit의 발표 · Replit의 Microsoft 파트너 페이지 · Microsoft Fabric 커넥터 문서
단신
코딩 에이전트와 CLI
- GitHub Copilot, 모델 3종 지원 종료 — 10월 15일 예고한 대로 Claude Opus 4.8, Claude Opus 5, GPT-5.6 Terra가 대부분의 Copilot 환경에서 제외되고 Claude Opus 5.5, GPT-6.1 Sol 또는 GPT-6 Luna로 대체된다. 변경 기록에 따르면 Claude Opus 5는 모델 선택 목록에서는 빠지지만, 실행 중 요청이 거부될 때 사용하는 대체 모델로는 계속 제공된다. 🔗 출처
- Copilot CLI 1.0.113-0 — 이번 사전 공개 버전에는 상세한 설명 없이 수정 사항과 변경 사항이 있다는 내용만 적혀 있다. 최신 안정 버전은 여전히 11월 13일에 나온 1.0.112다. 🔗 출처
- GitHub Agentic Workflows 1.3.0 — 여전히 사전 공개 단계인 이번 버전에서는 원장 기능이 실험 단계를 벗어나고, 에이전트 작업이 실패했을 때 결과 게시를 차단하는 게이트인
require-agent-success가 추가된다. 사이버 보안 정책에 따른 Copilot의 거부는 더 이상 자동으로 재시도하지 않는다. 🔗 출처 - Codex CLI 0.171.0-alpha.9 — alpha.6 이후 출시된 사전 공개 버전 3개에는 변경 설명이 없다. 이들 버전에 포함된 커밋 41개의 제목에 따르면
codex exec는 원격 애플리케이션 서버를 활용할 수 있으며, 터미널은 검토 중 책임과 위험에 관한 안내를 표시한다. 최신 안정 버전은 여전히 0.169.0이다. 🔗 출처 - OpenAI Agents SDK — Python 사전 공개 버전 v0.24.0-alpha.8에서는 도구 호출의 인수를 확인한 뒤 승인하거나 거부하고, LiteLLM 또는 AnyLLM을 연결하며, WebSocket, WebRTC 또는 SIP를 통해 실시간 음성을 추가할 수 있다. JavaScript의 v0.22.0-alpha.3에서는 도구 콜백을 기본적으로 병렬 실행할 수 있다. 🔗 출처
- Gemini CLI — 기본 브랜치에 병합됐지만 아직 출시되지 않은 수정 사항은 관리자가 등록한 MCP 서버 중 명령이나 스크립트를 일반 사용자가 수정할 수 있는 서버를 무시하도록 한다. 기존에는 이런 서버를 통해 일반 사용자가 허용된 서버의 자동 승인을 그대로 적용받을 수 있었다. 🔗 출처
- ZCode v3.18.2 — Z.ai가 macOS와 Windows용 인공지능 개발 환경의 이번 버전을 GitHub에 변경 설명 없이 공개했다. 앞서 3.18.0과 3.18.1의 코드는 동기화됐지만 별도 버전으로 출시되지는 않았다. 🔗 출처
- 에이전트의 접두사 캐시 — Together AI와 Ollama는 하네스(
ollama launch를 통해 사용하는 Claude Code, Codex 또는 Pi)가 프롬프트의 시작 부분을 동일하게 유지하고, 엔진은 매 차례 요청을 캐시가 있는 GPU로 보내야 한다고 설명한다. 이상적인 계산에서 100차례에 걸쳐 처리하는 프롬프트 단위는 캐시가 없으면 5,050개, 있으면 100개다. 🔗 출처 - 팀 단위 소프트웨어 공장 — 잭 로이드는 Warp 블로그에 기고한 의견 글에서 에이전트를 개발자별 설정인 하네스, 모델, 스킬, MCP에서 분리해, 코드로 정의하고 팀이 소유하는 공유 클라우드 인프라로 옮겨야 한다고 주장한다. 🔗 출처
GitHub의 다른 새 소식
- AI Scan 일괄 실행 — 이제 조직 설정이나 코드 스캐닝 알림 페이지에서 최대 20개 저장소의 인공지능 취약점 분석을 한 번에 시작할 수 있다. 공개 사전 체험으로 제공되며 Copilot 라이선스가 필요하지 않다. 🔗 출처
- iPhone Duo의 GitHub Mobile — iOS 앱이 기기를 펼쳤을 때 화면 배치를 조정하고, Copilot, 풀 리퀘스트, 이슈, 알림으로 이동하는 세로 탭을 추가한다. 🔗 출처
컴퓨팅, 시뮬레이션, 로봇공학
- Lambda와 NVIDIA Photonics — Lambda는 총 10,000개가 넘는 GPU를 갖춘 GB300 NVL72 랙들을 공동 패키징 광학 기술을 적용한 스위치로 연결한다. 자체 시험에 따르면 지연 시간은 랙 단위에서 약 4%, 포드 단위에서는 최대 약 10% 줄어들며, 광학 부품의 작동 온도는 탈착형의 51 °C보다 낮은 36 °C다. 🔗 출처
- MLPerf Training v6.1의 Google Cloud — Google에 따르면 최초의 에이전트 강화 학습 MLPerf 벤치마크에서 Ironwood TPU 640개가 18.02분 만에 목표 정확도에 도달했다. 사전 학습에서는 Ironwood TPU 8,192개가 1.70분, GB300 GPU 256개가 31.96분 만에 목표에 도달했다. 🔗 출처
- NVIDIA Cosmos — NVIDIA에 따르면 자사의 공개 월드 모델이 Hugging Face에서 다운로드 2,000만 회를 넘어섰다. 집계 기간이나 범위는 밝히지 않았다. 🔗 출처
- LidarVerse — NVIDIA Research가 10월에 공개한 이 모델을 다시 소개했다. LiDAR 스캔을 생성, 예측하고 재시뮬레이션하며, 증류 버전은 H100 한 개에서 초당 10프레임으로 작동한다. 코드는 Apache 2.0 라이선스로 제공된다. 🔗 출처
- AI Day Seoul — NVIDIA가 한국 행사 성과를 정리했다. 참가자는 2,000명이 넘었으며, 개발자 500명 이상이 한국어로 교육을 받거나 인증을 취득했다. 해커톤에서는 OpenShell 기반 에이전트를 만든 FlyGate 팀이 우승했다. 🔗 출처
- projectsim (Kaedim) — 로봇 시뮬레이션에 바로 사용할 수 있는 3차원 객체 200개 이상이 무료로 제공된다. 이 중 140개는 관절 구조를 갖추고 있다. 이 객체들은 NVIDIA의 SimReady Central에도 추가되며, 현재 7개가 게시돼 있다. 🔗 출처
공개 모델과 Hugging Face
- llama.cpp의 CI — 3개월간 풀 리퀘스트 3,181개가 접수되고 GitHub 무료 요금제의 한계인 캐시 10 GB와 동시 작업 20개에 부딪히자, 개발팀은 변경 내역의 영향을 받는 작업만 실행하도록 바꿨다. ccache 캐시는 Hugging Face Buckets에 저장하고, Linux x64 작업 대부분은 Hugging Face Jobs에서 실행한다. 🔗 출처
- Accelerate v1.16.0 — Hugging Face의 분산 학습 라이브러리가 이제 Python 3.11과 PyTorch 2.6을 요구한다. PyTorch에 등록된 가속기를 위해
torch.accelerator를 더 많이 활용하며, PiPPy, MS-AMP,FP8RecipeKwargs를 제거한다. 🔗 출처 - Tiny Aya Global — 대부분 Lexsi Labs 해커톤에서 나온 커뮤니티 글 5편이 Cohere Labs의 소형 다국어 모델을 다룬다. 저자들에 따르면 데이터베이스 에이전트는 세 차례의 자체 수정을 통해 성공률이 0.5%에서 49.1%로 높아졌다. 거부 동작을 조정하면 벵골어와 스와힐리어에서 유해한 응답을 크게 줄일 수 있지만, 과도한 거부도 두 배로 늘어난다. 🔗 출처
- Modular Diffusers — 아직 통합되지 않은 모델의 가중치를 변환하고 Hub에 블록을 게시해 Diffusers에서 사용하는 방법을 안내하는 글이 나왔다. 저자는 Astra로 변환을 완료하지 못한 뒤, Claude Opus 5.5를 사용하는 Claude Code에 작업을 맡겼다. 🔗 출처
- 휴대전화의 소형 모델 — 한 개발자가 Android 휴대전화에서 Qwen3.5 0,8B와 2B를 로컬로 실행해 Amazon 구매 과정을 처음부터 끝까지 수행한 사례 두 건을 공개했다. 호출당 입력의 중앙값은 45토큰이었다. 가장 느렸던 Galaxy A04e에서는 578회 호출에 4시간 20분이 걸렸다. 🔗 출처
- Ask AdMob — Google이 AdMob 계정에서 Gemini를 기반으로 작동하는 대화형 에이전트를 소개했다. 앞으로 몇 달 안에 시험 운영할 예정이다. 코딩 에이전트용 AdMob 에이전트 스킬은 지금 공개했으며, 초기 시험 중인 MCP 서버는 2027년 초 더 많은 개발자에게 개방할 계획이다. 🔗 출처
- Google Flow — Google은 11월 12일 창작 스튜디오에 예술가들이 설계한 도구 5개를 추가했다. 휴대전화로 촬영한 한 장면에서 여러 카메라 각도를 만들어 내는 Pocket Studio와 복고풍 스타일을 위한 Pixel Machine 등이 포함된다. 🔗 출처
음성, 이미지, 동영상
- Nemotron 3.5 Transcribe — NVIDIA는 자사의 공개 모델이 11월 13일 발표된 Artificial Analysis의 화자 분리 지수에서 1위를 차지했다고 전했다. 2~8명이 참여한 대화 97개에서 단어의 화자 오귀속률(WDER)은 3.3%로, Voxtral Small Transcribe 3의 7.5%보다 낮았다. 🔗 출처
- FLUX: In Production — Black Forest Labs가 인공지능으로 제작한 영화를 대상으로 공모전을 연다. 제휴 스튜디오들이 제작 지침을 작성하며, 총상금은 25,000달러가 넘는다. 11월 30일부터 12월 13일까지 온라인으로 진행된다. 🔗 출처
- Kling Image 4.0 — Kling이 새로운 이미지 모델의 출시가 임박했다고 알렸지만, 날짜나 사양은 공개하지 않았다. 🔗 출처
기업과 교육
- Autotorino와 ElevenAgents — 월 약 100,000건의 전화를 받는 이탈리아 자동차 판매점 그룹이 문의 내용을 분류하고 잠재 고객을 등록하는 음성 에이전트에 전화 응대를 맡겼다. 자동 처리된 전화 건수는 두 배 이상 늘어났다. 🔗 출처
- Holiday Extras의 dot — OpenAI의 사례 연구에 따르면 한 관리자의 dot은 기능 출시를 스스로 포착하고 Google BigQuery에 질의한 뒤, 요청받지 않은 보고서를 제공한다. 또 다른 dot은 사용자가 이동하는 동안 보고서를 준비한다. 🔗 출처
- OpenAI와 The King’s Trust — OpenAI가 영국의 이 단체에 100만 파운드를 지원한다. 18개월 동안 최대 25,000명의 청년에게 인공지능 교육을 제공하며, 취업이나 학업, 직업 훈련에 참여하지 않는 청년을 우선 지원한다. 🔗 출처
- Synthesia가 살펴본 교육 분야의 인공지능 — 25개가 넘는 국가에서 800명 이상이 응답한 세 번째 연례 보고서다. 인공지능을 사용하는 팀의 87%는 콘텐츠 생성에 활용하지만, 맞춤형 학습을 실시하는 비율은 29%에 그친다. 1년 전에는 이를 실시하거나 계획 중이라는 응답이 70%였다. 🔗 출처
Perplexity
- 출처에서 수치 강조 표시 — @AskPerplexity에 따르면 이제 Computer와 Teammates에서 답변의 원본 문서를 열면 인용된 정확한 수치가 강조 표시된다. 웹에서 모든 사용자에게 제공된다. 🔗 출처
- 인공지능과 AGI 비교 안내서 — Perplexity가 현재 활용되는 인공지능과 AGI를 구분하고, AGI 발표를 검증하는 방법을 제안하는 안내서를 공개했다. 안내서는 10월 9일 기준 Claude Opus 5.5가 Remote Labor Index에서 21.3%를 기록했다고 인용한다. 🔗 출처
이것이 의미하는 것
이제 공개 모델과 비공개 모델의 격차는 점수뿐 아니라 비용으로도 드러난다. Qwen4-Max는 Qwen3.8-Max보다 낮은 요금을 제시하고 작업당 비용을 62% 줄였다고 발표했지만, 자체 표에 있는 평가 16개 중 4개에서만 앞서며 가중치 공개를 예고하는 내용도 없다. Hugging Face는 다른 쪽에 승부를 건다. 라우팅을 OpenRouter에 맡기면서, OpenRouter 토큰 사용량의 71.7%를 차지하고 평균 비용이 약 4분의 1인 공개 모델들을 기반으로 삼는다. 하지만 같은 글에서도 Intelligence Index 최상위권의 격차가 19점임을 인정한다. JFinBench는 도구를 사용하지 않는 일본 금융 평가에서 12.4점의 격차를 측정했으며, 웹 접근을 허용하면 이 격차는 4.4점으로 줄어든다. 평가가 드문 분야에서 비공개 모델이 앞서는 이유는 무엇보다 그 모델들이 가진 지식에 있다.
에이전트는 터미널을 벗어나 통제 체계를 갖춘 업무 시스템으로 들어가고 있다. ChatGPT for Healthcare에서 컴퓨터를 조작하는 에이전트는 역할 기반 접근 제어, 감사 로그, BAA 아래에서 의료 기록과 보험사 포털을 연결한다. Replit에서는 Agent가 만든 애플리케이션이 고객의 Fabric 테넌트 안에서 고객의 Entra ID 권한과 Purview 레이블을 적용받으며 생성된다. 같은 흐름은 공격자에게도 유리하게 작용한다. GTIG에 따르면 한 프레임워크는 사람의 개입 없이 취약점 발견과 악용을 연이어 수행했고, 한 집단은 Claude Code 설정에 함정을 심어 백도어를 설치했다. 수정 가능한 MCP 서버를 대상으로 한 Gemini CLI의 패치도 같은 사실을 일깨운다. 도구의 자동 승인은 이를 실행하는 스크립트의 무결성이 보장되는 만큼만 신뢰할 수 있다.
과학은 컴퓨팅과 에이전트가 함께 내세우는 근거가 되고 있다. NVIDIA는 Rubin HPC와 CUDA-X 라이브러리를 에이전트가 아이디어를 시험하기 위해 호출할 시뮬레이션 도구로 소개한다. Perplexity는 10,000개가 넘는 GPU를 기반으로 자동화된 과학자를 구축하려 한다. OpenAI는 한 물리학자가 GPT-6 Astra가 증명을 주도한 과정을 소개하는 블로그를 개설하는 동시에, 연구자 대상 프로그램의 목표도 두 배로 늘린다. 약속은 여전히 결과보다 앞서 있다. Rubin HPC는 2028년 출시 예정이지만 메모리 용량이나 FLOPS는 발표되지 않았다. Frontier Research는 새로운 모델이나 논문을 내놓지 않았고, 크레이그의 정의는 여전히 ‘후보’ 단계다. OpenAI의 연구가 측정한 것은 응답자들이 보고한 생산성이며, 인과적 효과는 입증되지 않았다.
측정 방식도 달라지고 있다. OpenAI는 Apollo Research, METR, Transluce, Goodfire에 체크포인트와 학습 과정을 개방하지만, 공개 내용의 삭제 처리와 발표 일정은 계속 통제한다. Together AI는 스킬에 문장 두 개를 넣으면 모델의 성공률이 15회 중 4회에서 100%로 높아진다는 결과를 보여 준다. 이는 지침 없이 측정한 모델 간 격차를 해석할 때 고려할 대목이다. 두 모델이 방치된 OpenRouter 키를 찾아 다른 모델에 작업을 맡긴 JFinBench 사례는 도구를 사용하는 평가가 환경에서 무엇을 손쉽게 이용할 수 있는지도 측정한다는 점을 일깨운다. 또한 MLPerf Endpoints에서 Vera Rubin이 보였다는 10배 이상의 성능 향상은 MLCommons가 검증하기 전까지 잠정적인 결과다.
출처
- Qwen4-Max: 새로운 팀원이 도착했습니다 (Qwen 게시글)
- QwenCloud의 qwen4-max 정보
- Qwen4-Max 발표 (@Alibaba_Qwen)
- ChatGPT for Healthcare로 진료의 발전을 이끄는 더 다양한 방법 (OpenAI)
- 의료팀을 위한 컴퓨터 사용 에이전트의 발전 (OpenAI)
- Rubin HPC (NVIDIA 블로그)
- SC26에서 NVIDIA가 발표한 소식
- MLPerf Training과 Endpoints의 Vera Rubin (NVIDIA 블로그)
- Slurm과 양자 컴퓨팅 (NVIDIA 블로그)
- 과학을 위한 CUDA-X 라이브러리 (NVIDIA 블로그)
- Hugging Face와 OpenRouter의 협력 (Hugging Face 블로그)
- @huggingface의 발표
- Perplexity Frontier Research 소개
- @perplexity_ai의 발표
- research.perplexity.ai
- 앤드루 고든 윌슨의 스레드 (@andrewgwils)
- 데니스 야라츠의 스레드 (@denisyarats)
- 격자 위에서 표준 모형을 정의하기 위한 한 걸음 (OpenAI)
- 과학을 위한 새로운 블로그 (OpenAI)
- 과학자들의 인공지능 접근성 확대 (OpenAI)
- 최전선의 과학: 과학자들의 ChatGPT 활용법 (OpenAI)
- 내재화된 평가의 첫 번째 단계 (OpenAI)
- 온라인 아동 성적 학대에 대한 대응 강화 (OpenAI)
- OpenAI API 변경 기록
- GTIG 인공지능 위협 추적 보고서 (Google Cloud)
- GTIG 보고서 요약 (blog.google)
- Gemini Notebook: 자료를 바탕으로 만드는 인터랙티브 사이트 (blog.google)
- @Gemini_Notebook의 발표
- Gemini 앱의 지역별 음성 (blog.google)
- Ask Maps의 새로운 기능 (blog.google)
- 유럽에 출시되는 Ask Maps (blog.google)
- Perplexity의 Monitor API 소개
- Compass의 Video Intelligence 소개 (Cohere)
- Video Intelligence 발표 (@cohere)
- JFinBench (Sakana AI)
- arXiv에 게재된 JFinBench 논문
- 코딩 에이전트가 Together AI를 쉽게 사용할 수 있도록 하는 방법
- ElevenLabs에 합류하는 Kotoba
- @ElevenLabs의 발표
- LVMH 미디어 부문, OpenAI와의 전략적 제휴 발표
- @ClaudeDevs의 발표
- Claude Code의 iOS 시뮬레이터 문서
- @Replit의 발표
- Replit의 Microsoft 파트너 페이지
- Microsoft Fabric 커넥터 문서 (Replit)
- GitHub Copilot의 모델 지원 종료 (GitHub 변경 기록)
- Copilot CLI 1.0.113-0 (GitHub)
- GitHub Agentic Workflows 1.3.0 (GitHub)
- Codex CLI 0.171.0-alpha.9 (GitHub)
- Agents SDK Python v0.24.0-alpha.8 (GitHub)
- Gemini CLI의 PR 30283 (GitHub)
- ZCode v3.18.2 (GitHub)
- 장기 에이전트 작업에 개방형 모델을 활용하는 방법 (Together AI와 Ollama)
- 소프트웨어 공장에 관한 잭 로이드의 게시글 (Warp)
- 여러 저장소에서 사용하는 AI Scan (GitHub 변경 기록)
- iPhone Duo의 GitHub Mobile (GitHub 변경 기록)
- Lambda와 NVIDIA Photonics (NVIDIA 블로그)
- Google Cloud의 MLPerf Training v6.1 결과 (blog.google)
- NVIDIA Cosmos, 다운로드 2천만 회 달성 (@NVIDIAAI)
- LidarVerse (@NVIDIAAI)
- AI Day Seoul 결산 (NVIDIA 블로그)
- projectsim의 무료 시뮬레이션 객체 (Hugging Face 블로그)
- Hugging Face Buckets와 Jobs를 활용한 llama.cpp의 CI (Hugging Face 블로그)
- Accelerate v1.16.0 (GitHub)
- Tiny Aya Global의 Efficient Healer (Hugging Face 블로그)
- Modular Diffusers를 활용한 새로운 모델 (Hugging Face 블로그)
- 소형 모델로 수행하는 장시간 휴대전화 작업 (Hugging Face 블로그)
- AdMob의 새로운 인공지능 도구 (blog.google)
- Google Flow의 다섯 가지 새로운 도구 (blog.google)
- 화자 분리 지수에 오른 Nemotron 3.5 Transcribe (@NVIDIAAI)
- FLUX: 실제 운영 환경에서의 활용 (@bfl_ai)
- Kling Image 4.0 (@Kling_ai)
- Autotorino와 ElevenAgents (ElevenLabs)
- Holiday Extras에서는 누가 요청하기도 전에 dots가 업무를 시작합니다 (OpenAI)
- The King’s Trust와 OpenAI (OpenAI)
- 교육 분야의 인공지능에 관한 Synthesia 보고서
- Computer와 Teammates에서 강조 표시되는 수치 (@AskPerplexity)
- AGI와 AI의 비교 (Perplexity)