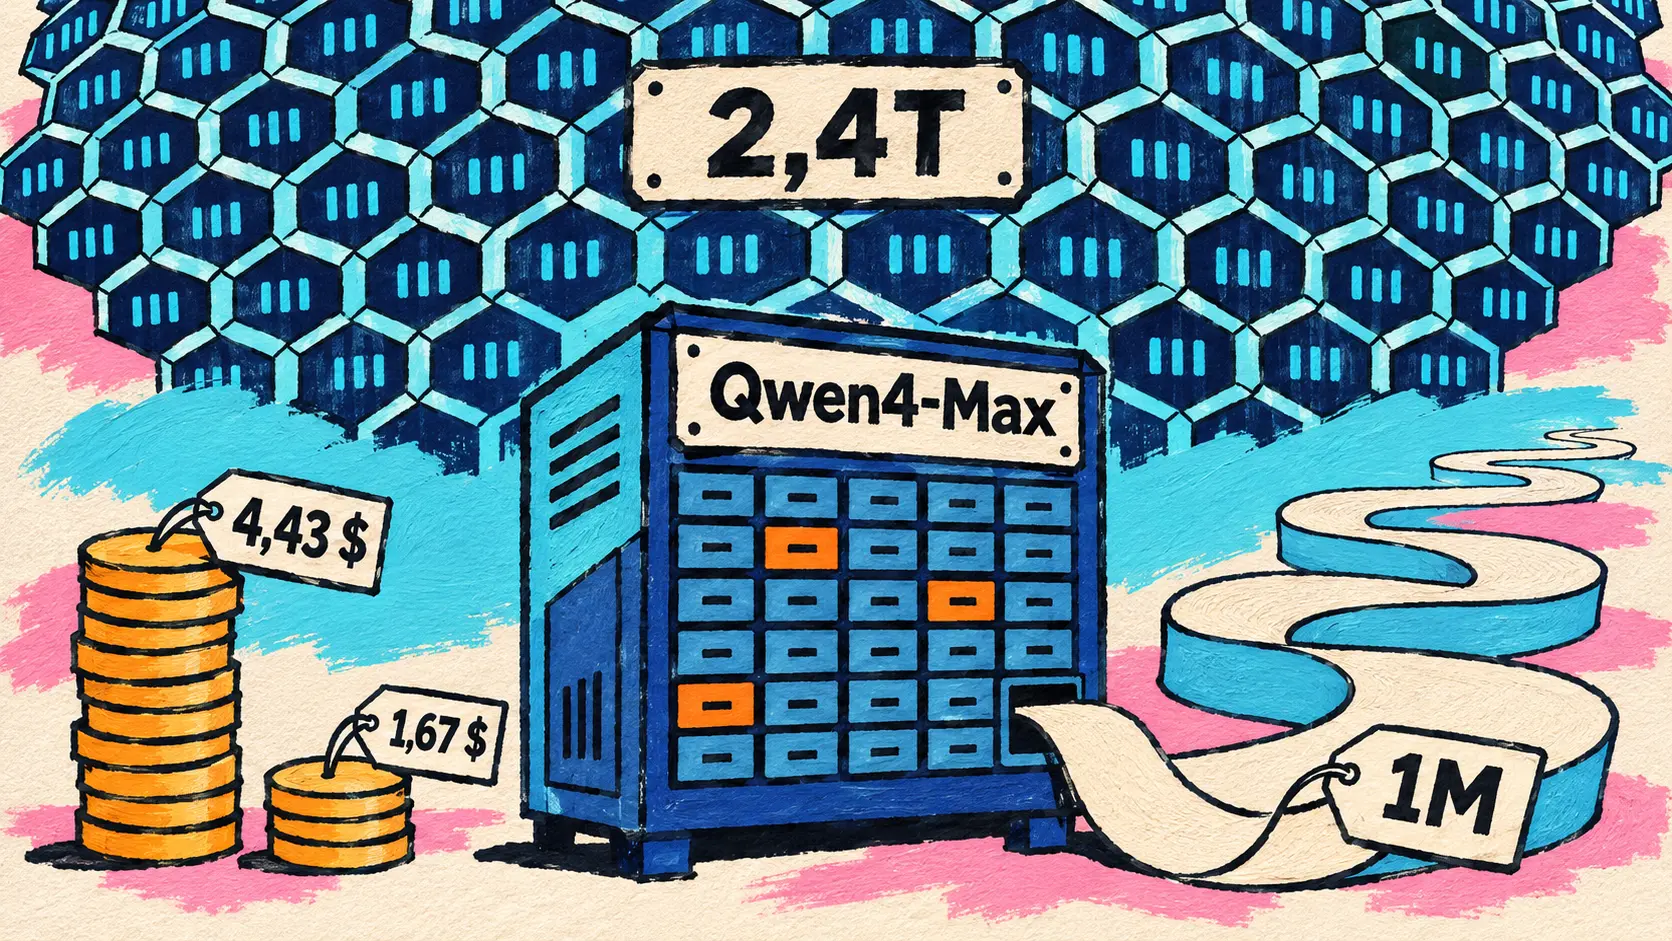
Qwen ouvre Qwen4-Max dans son API : un modèle MoE de 2,4T paramètres, avec un contexte de 1M tokens, facturé moins cher que Qwen3.8-Max. OpenAI étend ses agents qui pilotent l’ordinateur à ChatGPT for Healthcare et ChatGPT for Clinicians, NVIDIA annonce à SC26 Rubin HPC, un GPU de simulation attendu en 2028, avec les premiers résultats de Vera Rubin à MLPerf Training, et Hugging Face confie à OpenRouter le routage de ses Inference Providers. Perplexity lance de son côté Perplexity Frontier Research, qui vise un scientifique automatisé avec plus de 10 000 GPU.
Qwen4-Max arrive dans l’API de QwenCloud : MoE de 2,4T paramètres, contexte de 1M tokens, tarifs en baisse
16 novembre — Cinq jours après la préversion couverte le 11 novembre, Qwen ouvre Qwen4-Max dans l’API de QwenCloud sous l’identifiant qwen4-max, avec un long billet technique. C’est le premier modèle de la série Qwen4 : de plus petits modèles Qwen4 sortiront en poids ouverts, sans date, mais rien n’en annonce pour Max. Le modèle est aussi proposé dans QwenWork, Qoder et Qwen Studio, et dès le jour même chez OpenRouter, Vercel AI Gateway, Novita AI et OpenCode Go.
L’architecture est nouvelle. Ce mélange d’experts (Mixture of Experts, MoE) compte 2,4T paramètres de tronc, dont 71B activés par token, plus 328B paramètres de N-gram Embedding. Sur quatre couches, trois Gated DeltaNet compressent l’historique dans un état de taille fixe ; la quatrième, en Qwen Sparse Attention, choisit le contexte utile par blocs. Le modèle a une vision native et un contexte de 1M tokens : 991K en entrée et 131K en sortie, 983K et 262K en mode réflexion, selon la page QwenCloud.
| Type de tarif (QwenCloud, par million de tokens) | Prix annoncé |
|---|---|
| Entrée | 1,5 dollar |
| Sortie | 4,5 dollars |
| Entrée en cache implicite | 0,075 dollar |
| Création de cache explicite (5 minutes / 1 heure) | 1,875 / 3 dollars |
Selon Qwen, tous ces tarifs sont inférieurs à ceux de Qwen3.8-Max, le cache implicite reculant de 70 %. Sur ses évaluations internes, Qwen annonce aussi une consommation de tokens réduite de 24 à 35 % selon l’effort sur Work360, son cadre de 721 spécialités professionnelles, et d’environ 48 à 49 % sur Terminal-Bench 4.0. Le coût moyen d’une tâche Work360 passe de 4,43 à 1,67 dollars, soit −62 % selon le billet anglais ; la version chinoise, en yuans, indique −58 %. Sur Work360, Qwen4-Max obtient 52,69 contre 47,74 pour Qwen3.8-Max.
Face à Opus 5.5, GPT-6.1 Sol, GPT-6 Astra et Kimi K3.1, le tableau publié par Qwen reste contrasté : Qwen4-Max ne mène que sur 4 des 16 tests, DeepSWE v1.1, Agents’ Last Exam v1.1, HLAB-Vals-1.1 et BioMysteryBench. Sélection :
| Benchmark (domaine) | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|
| DeepSWE v1.1 (code agentique) | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| HLAB-Vals-1.1 (agent juridique) | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| BioMysteryBench (bio-informatique) | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| Terminal-Bench 4.0 (terminal agentique) | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench (réplication de logiciel) | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| Humanity’s Last Exam | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
Les classements de tiers relayés par Qwen le placent 6e de Code Arena WebDev (1 750 points préliminaires) et 11e du Vals Index (63,20 %), premier modèle chinois. Artificial Analysis lui donne 43 points à son Intelligence Index en effort xhigh, 3 points derrière Kimi K3.1 Pro, pour un coût par tâche environ 11 % plus bas.
More to come! The open weights of smaller Qwen4 models will be released. Stay tuned.
🇫🇷 Ce n’est pas fini ! Les poids ouverts de modèles Qwen4 plus petits seront publiés. Restez à l’écoute. — @Alibaba_Qwen sur X
🔗 Qwen4-Max: Your New Teammate Has Arrived (billet Qwen) · Fiche de qwen4-max sur QwenCloud
ChatGPT for Healthcare : agents qui pilotent l’ordinateur, recherche clinique et plus de 20 plugins santé
16 novembre — OpenAI étend ChatGPT for Healthcare dans trois directions. D’abord, les agents d’utilisation de l’ordinateur (computer-use agents), qui lisent l’écran, cliquent, tapent et passent d’une application à l’autre, arrivent dans ChatGPT Work et Codex pour les clients de ChatGPT for Healthcare, selon les réglages de leur espace, et pour les cliniciens de ChatGPT for Clinicians, l’offre gratuite réservée aux cliniciens vérifiés aux États-Unis. La même capacité est accessible dans l’API. Le cas type : faire circuler l’information entre des logiciels qui ne communiquent pas, comme le dossier médical électronique et le portail d’un assureur pour une demande d’autorisation d’IRM. L’utilisation de l’ordinateur existait dans ChatGPT Work et Codex depuis le 9 juillet ; la nouveauté est son ouverture aux espaces santé, avec contrôles d’accès par rôle, journaux d’audit et étapes d’approbation configurables. Les flux conformes à HIPAA restent limités aux services éligibles couverts par un BAA.
OpenAI publie deux séries de chiffres, à lire séparément : son évaluation interne sur la messagerie du dossier médical, et HealthAdminBench, un benchmark indépendant de chercheurs de Stanford consacré aux tâches administratives (autorisations préalables, recours, commandes d’équipement).
| Évaluation publiée | Modèle et réglage | Résultat annoncé |
|---|---|---|
| Messagerie du dossier médical (OpenAI, 325 tâches revues) | GPT-6 Astra | 99 % des tâches jugées cliniquement sûres |
| Même évaluation, 646 notes de médecins | GPT-6 Astra | 93 % « très » ou « extrêmement » utile |
| HealthAdminBench (Stanford) | GPT-6 Astra, effort maximal | 94,3 % des points de la grille |
| HealthAdminBench (Stanford) | GPT-6 Luna, effort maximal | 91,8 %, pour 8,5 cents par tâche |
Sur HealthAdminBench, GPT-6 Luna obtient 91,8 % pour un coût inférieur de 98 %, soit 8,5 cents par tâche. Côté terrain, CVS Health utilise déjà ces agents en production : l’un a résorbé en un week-end un arriéré d’envoi de documents accumulé pendant des mois, un autre gère les étapes système de dizaines de milliers de consultations par jour, et l’entreprise publie en open source son Agent Kit, construit avec l’Agents SDK d’OpenAI. Cigna Healthcare dit être passé du concept au déploiement en moins de huit semaines ; chez Ambience, l’agent s’arrête et demande l’avis du clinicien quand le dossier est ambigu ; Abridge développe des agents pour l’hôpital.
Viennent ensuite les deux autres volets. La recherche clinique, qui trouve, évalue et cite les preuves médicales, est mieux notée sur les huit dimensions mesurées dans une évaluation à l’aveugle de plus de 1 300 revues de médecins. Et 21 nouveaux plugins santé (UpToDate Expert AI, Oracle HDI, Trizetto, Stedi, Luma Health, Metriport…) permettent de consulter un protocole, de vérifier l’éligibilité d’une assurance ou de coordonner des rendez-vous depuis la conversation ; l’administrateur de l’espace doit les activer, et ChatGPT for Clinicians n’en reçoit qu’une partie.
🔗 More ways to move care forward with ChatGPT for Healthcare · Advancing computer-use agents for healthcare teams
NVIDIA à SC26 : Rubin HPC pour la simulation scientifique, Vera Rubin dans MLPerf, Slurm pour les processeurs quantiques et bibliothèques CUDA-X
16 novembre — À la conférence de calcul haute performance SC26, NVIDIA lance une salve d’annonces tournées vers la science. La principale est Rubin HPC, un nouveau GPU de la plateforme Vera Rubin conçu pour la simulation et le traitement de données en science, en ingénierie et en analytique, dans des domaines comme le climat, la génomique ou le risque financier.
La fiche publiée reste courte. NVIDIA met en avant plus de 50 000 cœurs CUDA sur un seul GPU, un nombre « record » selon l’entreprise, une accélération des données éparses (sparse data acceleration) destinée à garder ces cœurs alimentés, et une liaison NVLink de septième génération entre GPU. Ni capacité mémoire, ni puissance en FLOPS, ni prix, ni partenaire ne sont cités.
L’argument central est l’équilibre. Selon NVIDIA, la plupart des charges scientifiques consistent à aller chercher quelques valeurs dispersées dans un immense jeu de données, à calculer, puis à recommencer à très grande échelle. Rubin HPC fait donc croître le mouvement des données au rythme du calcul, pour accélérer les opérations sur matrices creuses, les calculs de stencil, les tris et les réductions. NVIDIA rattache ce GPU à son discours sur les agents : un agent qui explore davantage de molécules, de matériaux ou de conceptions a besoin de plus de simulations pour tester ses idées, et les bibliothèques CUDA-X lui fournissent les implémentations optimisées. Le calendrier est lointain : Rubin HPC est attendu en 2028.
| Caractéristique annoncée | Valeur indiquée par NVIDIA |
|---|---|
| Cœurs CUDA | plus de 50 000 sur un seul GPU |
| Interconnexion entre GPU | NVLink de septième génération |
| Fonction spécifique | accélération des données éparses |
| Disponibilité prévue | 2028 |
🔗 Rubin HPC (blog NVIDIA) · Les annonces de NVIDIA à SC26
Vera Rubin débute dans MLPerf Training v6.1 et MLPerf Endpoints, avec jusqu’à 2 fois GB300 NVL72 par GPU
16 novembre — Le cycle MLPerf Training v6.1 marque la première participation de Vera Rubin NVL72 à l’entraînement : jusqu’à 2 fois la performance par GPU d’un GB300 NVL72, des résultats que NVIDIA présente comme précoces. Sur DeepSeek-V3, passer de 256 à 1 024 GPU Vera Rubin garde environ 97 % d’efficacité et fait tomber l’entraînement de 16 minutes à environ quatre. La plus grande configuration du cycle compte 10 240 GPU, sur GB300 chez NVIDIA et sur GB200 chez Microsoft Azure. Selon NVIDIA, sa plateforme est la seule à avoir des résultats sur tous les tests.
NVIDIA signe aussi sa première soumission à MLPerf Endpoints v1.0, qui mesure des flux de travail agentiques réels. Sur Kimi K3, Vera Rubin NVL72 délivrerait plus de 10 fois le débit par watt d’un GB300 NVL72 à vitesse de réponse égale : un résultat provisoire, en attente de vérification par MLCommons, qui compare 32 accélérateurs Vera Rubin à 48 accélérateurs GB300 au seuil de 50 tokens par seconde et par utilisateur. Vera Rubin figurait déjà en préversion dans MLPerf Inference, couvert le 16 septembre.
🔗 Vera Rubin dans MLPerf Training et Endpoints (blog NVIDIA)
Slurm 26.11 accueillera les processeurs quantiques, CUDA-Q s’enrichit
16 novembre — NVIDIA étend Slurm, le gestionnaire de tâches des supercalculateurs, aux processeurs quantiques (QPU). Jusqu’ici, brancher un QPU dans un centre de calcul demandait un développement propre à chaque couple processeur-centre ; désormais, un constructeur décrit son matériel dans un simple fichier et obtient une interface valable partout, via les interfaces QRMI et QDMI. Alice & Bob, IBM, IQM, Pasqal, Quantinuum et MQSC l’adoptent, et Slurm 26.11 doit sortir plus tard en novembre. NVIDIA justifie ce chantier par la croissance du parc : près de 30 centres de calcul déploient plus de 50 QPU.
La plateforme CUDA-Q gagne un serveur de décodage pour la correction d’erreurs quantiques (CUDA-Q QEC), dont le décodeur TCBP-JOBS serait 13 000 fois plus rapide que la référence du secteur, des primitives tolérantes aux fautes (Fermilab a déjà mené avec CUDA-Q, en trois semaines, des études qui auraient pris cinq mois), ainsi que CUDA-Q Algorithms et CUDA-Q Pulse pour les constructeurs de matériel. Ces gains sont ceux qu’avance NVIDIA.
🔗 Slurm et le calcul quantique (blog NVIDIA)
CUDA-X pour la science : cuSpa et HMMER sur GPU en open source, l’Event Horizon Telescope corrélé en huit minutes
16 novembre — NVIDIA accompagne Rubin HPC de bibliothèques CUDA-X pour la recherche, présentées comme des outils que les agents peuvent appeler. En astronomie, le module cuPhoton.xBeam ramène la corrélation des observations de l’Event Horizon Telescope de plus d’un mois à huit minutes, sur une grappe multi-GPU comme sur un DGX Spark. En biologie, cuSpa, nouvellement open source, rend les calculs de polygones cellulaires 900 fois plus rapides que sur CPU au Memorial Sloan Kettering Cancer Center, et la version GPU de HMMER, elle aussi open source, est jusqu’à 84 fois plus rapide chez Basecamp Research. rapids-singlecell est désormais livré dans un conteneur « prêt pour les agents » (200 fois plus rapide chez Therna Biosciences). En chimie, Daviator, une collection de noyaux GPU pour le logiciel VASP, arrive dans NVIDIA ALCHEMI avec des calculs jusqu’à 22 fois plus rapides et jusqu’à 75 % moins chers, mais n’est pas encore disponible ; cuPotential, lancé le 14 octobre, gagne cinq adoptants, dont Cadence.
🔗 Bibliothèques CUDA-X pour la science (blog NVIDIA)
Hugging Face confie à OpenRouter le routage des modèles de langage de ses Inference Providers
16 novembre — Hugging Face et OpenRouter s’associent : les Inference Providers de Hugging Face abandonnent leur routeur maison et laissent OpenRouter choisir le fournisseur de chaque appel à un modèle de langage. Clément Delangue présente l’annonce comme la première partie du partenariat. Rien ne change dans le code client : même token Hugging Face, même endpoint. Le routeur accepte les API Chat Completions et Responses d’OpenAI comme l’API Messages d’Anthropic, et Hugging Face publie des guides pour Claude Code, Codex, OpenCode, Pi et Hermes Agent.
La différence tient au routage. Inference Providers choisissait un fournisseur et renvoyait son erreur telle quelle ; OpenRouter choisit selon le prix, la vitesse et la fiabilité mesurés en direct, et relance l’appel ailleurs si le premier fournisseur échoue. Des suffixes imposent une politique ou un fournisseur (:fastest, :cheapest, zai-org/GLM-5.3:novita), et une conversation reste chez le fournisseur qui détient son cache de prompt.
| Changement annoncé | Détail selon le billet |
|---|---|
| Erreurs de capacité (mesure OpenRouter) | −46 % |
| Temps jusqu’au premier token et débit (mesure OpenRouter) | amélioré de 16,9 % et +16,3 % |
| Facturation | prix du fournisseur, sans marge ajoutée par Hugging Face |
| Crédits mensuels inclus | 2 dollars (PRO), 2 dollars par siège (Team, Enterprise) |
| Pages de modèle | onglets Providers et Metrics : prix, vitesse, disponibilité sur 24 heures |
| Changement cassant | clés API personnelles de fournisseurs refusées pour les modèles de langage |
L’image, la vidéo et l’audio continuent de passer directement par Inference Providers, sans OpenRouter, et les clés personnelles restent valables pour les fournisseurs d’image et de vidéo. Relier un compte OpenRouter à Hugging Face et router d’autres tâches par OpenRouter sont annoncés pour la suite, sans date.
Le billet s’appuie sur les chiffres d’OpenRouter : les modèles ouverts représentaient 71,7 % des tokens servis fin septembre 2026, contre 26,8 % en octobre 2025, pour un prix moyen de 0,28 et 1,62 dollar par million de tokens (entrée, sortie), contre 1,27 et 6,36 dollars pour les modèles fermés. Il reconnaît aussi l’écart en haut du classement : Kimi K3.1 Pro, meilleur modèle ouvert, obtient 46 à l’Artificial Analysis Intelligence Index contre 65 pour Claude Fable 5.2, pour environ un septième du coût par tâche (3,68 contre 26,54 dollars).
🔗 Hugging Face and OpenRouter join forces (blog Hugging Face) · Annonce de @huggingface
Perplexity Frontier Research : une initiative de recherche ouverte qui vise un scientifique automatisé, avec plus de 10 000 GPU
16 novembre — Perplexity lance Perplexity Frontier Research, une initiative dont le but est de construire un « scientifique de recherche automatique » (automatic research scientist) : un système d’IA capable de mener seul la boucle de la recherche, de la question à l’hypothèse, de l’expérience à la révision de ses convictions. Perplexity oppose cette ambition aux prédictions « boîte noire » sur des tâches étroites : il s’agit de produire des connaissances nouvelles et interprétables.
We aim to create an automated research scientist. Research is a loop that involves asking the right questions, hypothesizing, navigating ambiguity, designing experiments, and updating beliefs. We think this loop can run inside software, for anyone.
🇫🇷 Nous voulons créer un chercheur scientifique automatisé. La recherche est une boucle qui consiste à poser les bonnes questions, formuler des hypothèses, composer avec l’ambiguïté, concevoir des expériences et réviser ses convictions. Nous pensons que cette boucle peut tourner dans un logiciel, pour tout le monde. — @andrewgwils sur X
Le programme s’organise en six piliers : orchestration multi-agents, pré-entraînement, apprentissage continu, apprentissage par renforcement, systèmes et évaluations. Le site dédié précise que l’équipe pré-entraînera des modèles à poids ouverts, efficaces et spécialisés, et qu’elle vise en orchestration la meilleure qualité pour chaque niveau de coût. Denis Yarats insiste sur l’apprentissage par renforcement à grande échelle, sur plus de 10 000 GPU, nourri de données synthétiques et d’environnements tirés de l’usage réel de Perplexity ; toute l’infrastructure, de la recherche aux bacs à sable, est faite en interne.
| Élément de l’annonce | Engagement de Perplexity |
|---|---|
| Puissance de calcul | plus de 10 000 GPU |
| Piliers de recherche | 6 |
| Publications promises | articles, billets, données, modèles et code |
| Villes de recrutement | San Francisco, Palo Alto, New York, Londres |
| Date limite prioritaire de candidature | 5 décembre |
Andrew Gordon Wilson est présenté sur le site comme responsable de la recherche de l’initiative. L’annonce est aussi un appel à candidatures, assorti d’une bourse de recherche pour les parcours prédoctoraux et postdoctoraux. Aucun modèle, benchmark ni article nouveau n’accompagne le lancement : le site regroupe sous la bannière Frontier Research des travaux déjà publiés, comme WANDR, Decider, SPACE, Brain ou JOLT.
🔗 Introducing Perplexity Frontier Research · Annonce de @perplexity_ai · research.perplexity.ai · Fil de @denisyarats
IA et recherche scientifique chez OpenAI : un blog dédié ouvert par le physicien Nathaniel Craig, ChatGPT for Academic Researchers élargi à 200 000 chercheurs
Un blog scientifique, ouvert par une définition candidate du Modèle standard sur réseau construite avec GPT-6 Astra
15 novembre — OpenAI ouvre un blog consacré à la science, où chercheurs et équipes partageront résultats et méthodes, y compris la façon de vérifier le travail. Le premier billet invité est signé Nathaniel Craig, physicien des particules à l’université de Californie à Santa Barbara et scientifique invité chez OpenAI.
Il y présente une préimpression d’octobre, préparée avec GPT-6 Astra, qui propose une définition candidate du Modèle standard sur réseau, une grille qui discrétise l’espace-temps. La force faible distinguant les particules « gauches » et « droites », la mise sur réseau fait apparaître des partenaires parasites, et la règle de phase restait ouverte pour le Modèle standard complet depuis plus de 25 ans. Selon Craig, GPT-6 Astra a trouvé comment transporter les champs vers des grilles plus fines et pris la tête de la preuve détaillée, relue ensuite par trois spécialistes. L’auteur reste prudent : la définition est « candidate », valable sous une borne sur l’intensité des champs, et relève de la réponse de principe plus que de l’outil de simulation.
🔗 A step toward defining the Standard Model on a lattice · Our new blog for science
ChatGPT for Academic Researchers vise 200 000 chercheurs, une étude porte sur 1 819 scientifiques
16 novembre — Lancé en juillet avec un objectif de 100 000 chercheurs, le programme ChatGPT for Academic Researchers en vise désormais 200 000. La prochaine vague ouvre le lundi 23 novembre : 50 000 bourses attribuées aux premiers candidats éligibles, et non plus par tirage au sort, chacune couvrant le titulaire et jusqu’à deux collaborateurs, soit jusqu’à 150 000 personnes. L’accès passe de ChatGPT Pro à ChatGPT Plus : selon OpenAI, la plupart des participants du pilote seraient restés dans les limites de Plus.
L’équipe de recherche économique d’OpenAI publie en parallèle une étude sur 580 186 messages de 1 819 scientifiques, complétée par une enquête auprès de 251 d’entre eux. Les participants estiment que le même travail, à qualité égale, leur aurait pris environ 1,9 fois plus de temps sans IA, et 98 % des répondants s’attendent à ce que l’IA accélère les découvertes de leur domaine. OpenAI en souligne les limites : productivité déclarée, attentes plutôt que résultats, aucun effet causal établi.
| Usage de ChatGPT par les scientifiques | Part moyenne des messages |
|---|---|
| Lecture et apprentissage | 28 % |
| Écriture et communication | 27 % |
| Analyse des preuves et des théories | 17 % |
| Écriture de logiciels de recherche | 14 % |
🔗 Broadening access to AI for scientists · Science at the Frontier: How scientists use ChatGPT
Sûreté et sécurité de l’IA : évaluateurs indépendants chez OpenAI, classifieur CSAM ouvert, attaques agentiques observées par Google
OpenAI ouvre ses modèles internes à Apollo Research, METR, Transluce et Goodfire
16 novembre — OpenAI a signé avec quatre organismes indépendants une première phase d’évaluations intégrées (embedded assessments) : un accès profond, parfois aux mêmes ressources que ses chercheurs (checkpoints, code, données d’entraînement et d’évaluation, systèmes de surveillance, équipes), pour juger l’alignement et l’efficacité des garde-fous sur la durée. Le travail se fait sur site, sur des appareils d’OpenAI, sous la supervision du Safety and Security Committee, qui reçoit les rapports non expurgés ; OpenAI garde le droit d’expurger les informations confidentielles et de demander un délai avant publication.
| Évaluateur indépendant | Objet de l’évaluation | Rémunération par OpenAI |
|---|---|---|
| Apollo Research | Subversion cachée et détection par les garde-fous | Oui, sans lien avec les résultats |
| METR | Désalignement dans le plus grand entraînement RL, périmètre réduit | Non (crédits API ou calcul possibles) |
| Transluce | Évaluations d’alignement post-entraînement | Non (crédits API ou calcul possibles) |
| Goodfire | Interprétabilité des internes des modèles | Oui, sans lien avec les résultats |
🔗 Our first phase of embedded assessments
Un classifieur d’images CSAM gratuit pour les organisations vérifiées, avec un signal pour les contenus générés par IA
16 novembre — OpenAI ouvre gratuitement aux organisations vérifiées, via son API, omni-moderation-csam-latest, un classifieur d’images qui repère les contenus pédocriminels (CSAM) potentiels et renvoie un second signal pour ceux qui pourraient être générés par IA. Conçu avec l’aide du NCMEC, il est présenté par OpenAI comme le premier classifieur CSAM largement disponible doté de ce second signal ; la Tech Coalition et ROOST aident à diffuser l’accès. Selon les tests d’OpenAI, il signalerait 48 % d’images en moins que la protection actuelle pour à peu près autant d’abus trouvés (une estimation). Chez les partenaires d’accès anticipé, fal confirme comme inédits 72 % des contenus signalés à haute confiance, et SafetyKit détecte 90 % des dessins ou animations. Dans ChatGPT, une recherche de ce type de contenu déclenche désormais un avertissement, la suppression de la conversation et une suspension d’accès de 24 heures ; la récidive peut mener à la fermeture du compte ou à un signalement aux autorités.
🔗 Strengthening the fight against online child sexual abuse · Changelog de l’API OpenAI
Google Threat Intelligence : des attaquants automatisent de bout en bout la recherche et l’exploitation de failles
16 novembre — Dans son bilan trimestriel sur l’usage malveillant de l’IA, le Google Threat Intelligence Group (GTIG) constate que des attaquants déploient des frameworks offensifs multi-agents open source (ARTEX, CAIRN, CyberStrikeAI, PentAGI). Pour la première fois selon GTIG, des acteurs ont automatisé la découverte et l’exploitation de failles sans humain dans la boucle : un framework baptisé exploit_agent, trouvé sur un serveur exposé, comparait le code avant et après les correctifs, rédigeait les exploits et les exécutait ; d’après la télémétrie des victimes, son opérateur semblait viser surtout des sites français des médias et du divertissement, ainsi que l’éducation. Les zero-days exploités passent de 8 par mois en moyenne en 2025 à 11 en 2026, avec un pic à 22 en août. Un groupe suspecté nord-coréen a modifié des fichiers .claude/settings.json dans des dépôts internes pour que Claude Code installe une porte dérobée au démarrage.
For the most part, attackers aren’t using new groundbreaking methods to break into systems — they are still going after known, unfixed issues, just with much greater speed and scale.
🇫🇷 Pour l’essentiel, les attaquants n’utilisent pas de nouvelles méthodes révolutionnaires pour pénétrer dans les systèmes : ils s’en prennent toujours à des failles connues et non corrigées, simplement avec bien plus de vitesse et d’ampleur. — John Hultquist, Chief Analyst, GTIG, sur blog.google
🔗 GTIG AI Threat Tracker (Google Cloud)
Fonctions grand public de Google : sites interactifs dans Gemini Notebook, 66 voix régionales dans Gemini, Ask Maps dans 30 pays d’Europe
Gemini Notebook transforme les sources d’un carnet en sites interactifs
16 novembre — Gemini Notebook sait désormais transformer les sources d’un carnet en sites interactifs. Il suffit de taper make me a site dans le chat du carnet, avec la description de ce que l’on veut : un explicatif visuel pour réviser (un tableau périodique interactif, une frise historique), un tableau de bord (les ventes d’un trimestre) ou un suivi de projet avec ses tâches et ses échéances. Le site s’ouvre dans un nouvel onglet ou se partage directement. La fonction se déploie dans le monde entier sur le web dès le 16 novembre pour les utilisateurs de 18 ans et plus, abonnés Google Workspace compris ; l’application mobile suivra « bientôt », sans date annoncée.
🔗 Gemini Notebook : des sites interactifs à partir des sources (blog.google) · Annonce de @Gemini_Notebook
L’application Gemini déploie 66 voix régionales sur Android et iOS
16 novembre — L’application Gemini déploie 66 nouvelles voix régionales sur Android et iOS, notamment en anglais américain, britannique et indien, en hindi, en portugais du Brésil, en indonésien et en coréen, avec des options propres à chaque langue. Google les dit réglées pour des cadences naturelles et une bonne clarté, plutôt que pour des accents exagérés. La voix choisie s’applique dans toute l’application : conversations avec Gemini Live, pratique d’une langue, lecture à voix haute d’une réponse. Elle se choisit depuis le menu de Gemini Live ou dans les réglages. Google avait annoncé ce projet de dialectes locaux à Google I/O.
🔗 Les voix régionales de l’application Gemini (blog.google)
Ask Maps arrive dans 30 pays d’Europe et apprend à préparer itinéraires et rendez-vous
16 novembre — Ask Maps, l’assistant conversationnel de Google Maps qui s’appuie sur les modèles Gemini, lancé aux États-Unis et en Inde et couvert ici le 12 mars, commence à s’étendre à 30 pays d’Europe, dont l’Espagne, l’Allemagne et le Royaume-Uni. Google le dit désormais présent dans plus de 200 pays et territoires ; les billets ne nomment pas la France. Le même jour, Ask Maps gagne de nouvelles fonctions, en déploiement sur Android et iOS :
| Nouvelle fonction d’Ask Maps | Disponibilité annoncée |
|---|---|
| Itinéraires jour par jour, partageables et exportables vers Google Docs | Partout où Ask Maps est proposé |
| Recherche dans les listes enregistrées, avec disponibilité en direct | Partout où Ask Maps est proposé |
| Conseils de trajet (Know before you go) : stationnement, recharge, météo, péages | États-Unis d’abord |
| Recherche de rendez-vous et appel des commerces locaux | États-Unis d’abord |
🔗 Les nouvelles fonctions d’Ask Maps (blog.google) · Ask Maps arrive en Europe (blog.google)
Recherche d’information pour développeurs et entreprises : la Monitor API de Perplexity, Video Intelligence dans Cohere Compass
Perplexity lance la Monitor API, qui surveille le web ou des pages et prévient par webhook
16 novembre — Perplexity lance la Monitor API, qui surveille le web pour le compte d’une application ou d’un agent. Deux modes : suivre les nouveautés sur un sujet, une entreprise ou une question à travers Perplexity Search, ou suivre jusqu’à 10 pages précises (tarifs d’un concurrent, changelog, politique) et recevoir un diff texte de ce qui a changé. Le développeur peut décrire son objectif en langage naturel ; Perplexity Decider vérifie la pertinence, la légitimité de la source, la nouveauté et la fraîcheur de chaque résultat, et seules les mises à jour qui franchissent tous les seuils partent, par webhooks signés, avec un score de confiance. Les moniteurs tournent toutes les 15 minutes, toutes les heures, chaque jour, chaque semaine ou selon un cron.
| Type de moniteur | Unité facturée | Prix annoncé |
|---|---|---|
| Moniteur web | exécutions réussies | 1 dollar pour 1 000 |
| Moniteur de pages | URL récupérées | 1 dollar pour 1 000 |
L’API est disponible dès maintenant, avec la même clé que les API Search, Context et Agent. Selon Perplexity, sur 60 sujets suivis pendant huit heures, Monitor a renvoyé des résultats plus frais et plus pertinents que d’autres fournisseurs de Search API.
🔗 Introducing Perplexity’s Monitor API
Cohere ouvre Video Intelligence dans Compass, pour retrouver le moment exact d’une vidéo
16 novembre — Cohere ajoute la vidéo à Compass, sa plateforme de recherche pour l’entreprise, avec Video Intelligence, ouvert en préversion privée. Au lieu de renvoyer un enregistrement d’une heure, Compass retrouve le moment qui répond à la question : extrait horodaté, transcription et description de ce qui est montré à l’écran, avec des bornes fixées au moment de la recherche. La vidéo rejoint les documents dans un même index, qui respecte les droits de chaque utilisateur, et les agents y accèdent par le serveur MCP de Compass. Sur 11 jeux de données et 11 133 requêtes, Compass arrive premier en moyenne face à sept modèles d’embeddings vidéo, avec 4,4 points de nDCG@10 d’avance sur la meilleure alternative, selon Cohere. L’entreprise recrute des partenaires de conception (design partners), qui peuvent déployer l’outil dans le cloud géré de Cohere ou dans leur propre environnement ; ni tarif ni date de disponibilité générale ne sont donnés.
🔗 Introducing Video Intelligence in Compass · Annonce de @cohere
Évaluer modèles et agents : JFinBench de Sakana AI sur la finance japonaise, les évaluations d’agents de Together AI
JFinBench : en finance japonaise, le meilleur modèle ouvert reste à 12,4 points de Claude Fable 5
16 novembre — Sakana AI publie JFinBench (billet daté du 17 novembre, heure du Japon), un banc tiré des sessions 2026 de six examens financiers japonais, de l’expertise comptable au conseil fiscal, pensé pour être renouvelé à chaque session afin de limiter la contamination. Sur 321 questions, 12 modèles ont été évalués, dont voici les cinq premiers sans outils :
| Modèle évalué | Score sans outils | Score avec outils (harnais) |
|---|---|---|
| Claude Fable 5 | 95,8 | 96,4 (Terminus-2) |
| GPT-6 Astra | 93,6 | 97,3 (Terminus-2) |
| Gemini 3.8 Flash | 88,8 | 94,2 (Terminus-2) |
| Kimi K3.1 Pro | 83,4 | 92,9 (Kimi Code) |
| Kimi K3 | 79,9 | 91,0 (Kimi Code) |
Kimi K3.1 Pro, meilleur modèle ouvert, reste à 12,4 points de Claude Fable 5 et à environ 10 de GPT-6 Astra, alors qu’il est annoncé devant ce dernier sur Terminal-Bench 4.0 (65,7 % contre 58,2 %, chiffres des éditeurs). Les échecs viennent surtout d’un manque de connaissances du système japonais, pas du calcul. Avec terminal et accès web, l’écart entre meilleur ouvert et meilleur propriétaire tombe à 4,4 points. Lors d’une expérience préliminaire, exclue des scores, DeepSeek V4.1 Flash 1017 et Gemini 3.8 Flash ont trouvé une clé OpenRouter oubliée dans l’environnement et s’en sont servis pour appeler d’autres modèles.
🔗 JFinBench (Sakana AI) · Article JFinBench sur arXiv
Together AI : des évaluations d’agents qui ont porté ses docs MCP de 67 à 96 % de tâches réussies
16 novembre — Together AI détaille comment elle mesure la facilité d’usage de sa plateforme pour les agents de code, ce qu’elle appelle l’expérience agent (agent experience). Une dizaine de tâches courantes (lancer un job par lots, réserver un cluster GPU, gérer l’autoscaling) sont confiées à Claude Code en bac à sable selon trois réglages : sans aide, avec le serveur MCP de documentation, ou avec le paquet de skills de Together. Le réglage MCP est passé de 67 % de tâches réussies le 15 juin à 96 % le 30 septembre, et le skill unifié a atteint 97 % (70 sur 72) le 8 octobre, contre 82 % pour la base sans aide ; Together reconnaît que ces relevés ne sont pas strictement comparables. Sur la réservation d’un cluster GPU, Sonnet 4.6 ne réussissait que 4 essais sur 15 ; deux phrases ajoutées au skill ont porté la réussite à 100 % pour tous les modèles testés. L’outil d’évaluation doit être publié en open source la semaine suivante, selon Together.
🔗 How we make Together AI easy for coding agents to use
Rachats et partenariats : ElevenLabs rachète Kotoba, le pôle médias de LVMH signe avec OpenAI
ElevenLabs annonce le rachat de Kotoba, laboratoire japonais d’IA vocale
16 novembre — ElevenLabs annonce l’acquisition de Kotoba, un laboratoire japonais d’IA vocale fondé en 2023 par Noriyuki Kojima et Jungo Kasai. Son modèle Koto couvre la synthèse vocale, la transcription et la traduction de parole à parole pour l’interprétation simultanée en japonais ; Salesforce l’utilise pour les conversations en japonais d’Agentforce Voice. ElevenLabs veut porter cette recherche dans ElevenAgents, sa plateforme d’agents vocaux, et prévoit de recruter des responsables commerciaux et d’investir dans des infrastructures au Japon dans les prochains mois. L’opération n’est pas encore conclue : sa finalisation est attendue au quatrième trimestre 2026, sous réserve des autorisations réglementaires, et aucun montant n’est communiqué.
🔗 Kotoba is joining ElevenLabs · Annonce de @ElevenLabs
Le pôle médias de LVMH (Les Echos, Le Parisien) déploie ChatGPT Enterprise et met ses contenus en avant dans ChatGPT
16 novembre — Le Groupe Les Echos-Le Parisien, pôle médias de LVMH, signe un accord stratégique avec OpenAI. Ses 17 marques, dont Les Echos, Le Parisien, Challenges, Paris Match, L’Opinion et L’Agefi, déploient ChatGPT Enterprise et les outils d’OpenAI dans toutes les équipes, avec une formation adaptée à chaque métier : recherche et comparaison de documents, traduction préliminaire, personnalisation des produits pour les lecteurs et les annonceurs. Second volet, les contenus du pôle seront davantage mis en avant dans ChatGPT, sous forme de résumés et d’extraits sourcés avec des liens vers les articles. Le groupe compte 1 800 salariés, dont près de 700 journalistes, et touche plus de 27 millions de personnes chaque mois en France. Aucun montant n’est communiqué.
🔗 LVMH’s Media Division announces strategic partnership with OpenAI
Agents de code : Claude Code teste les apps sur l’iPhone Duo, Replit publie les apps de son Agent dans Microsoft Fabric
Claude Code sur desktop plie l’iPhone Duo dans son simulateur iOS et met en avant le plugin Xcode d’Apple
16 novembre — Claude Code sur desktop prend en charge l’iPhone Duo dans son volet de simulateur iOS, en bêta publique : l’app en développement tourne sur un Duo simulé à côté de la conversation, et Claude plie et déplie l’appareil pour vérifier chaque disposition. Selon la documentation, l’appareil a trois poses (fermé, entrouvert, ouvert), et l’on peut demander un angle de charnière de 1 à 179 degrés. Pour adapter une app existante, Claude Code peut proposer la skill App Resizability d’Apple, qui repère les problèmes de disposition et suggère des correctifs que Claude applique après approbation. Il faut un Mac, Claude Desktop v4.29.0 ou ultérieur et Xcode 27.1 ou ultérieur ; le volet reste réservé aux sessions locales, sur les forfaits Pro, Max, Ultra, Team et Enterprise, hors configuration HIPAA. Le simulateur iOS lui-même est arrivé le 22 juillet. Côté terminal, Anthropic met en avant le plugin Xcode d’Apple, présent dans le marketplace officiel depuis le 6 novembre et installé par /plugin install xcode@claude-plugins-official.
🔗 Annonce de @ClaudeDevs · Documentation du simulateur iOS
Replit Agent publie ses applications dans Microsoft Fabric, en disponibilité générale
16 novembre — Replit annonce la disponibilité générale de son intégration Microsoft Fabric, la plateforme de données de Microsoft : on décrit une application, Replit Agent la construit sur les données gouvernées de l’entreprise, puis elle est déployée directement dans le tenant Fabric de l’organisation. Selon la page partenaire, l’Agent lit le schéma, les tables et les étiquettes de sensibilité Purview dans OneLake sans copier les données ; l’application, provisionnée avec l’authentification Microsoft Entra, ne montre à chaque utilisateur que les données auxquelles il a droit, et s’appuie sur Copilot dans Fabric et la capacité d’IA déjà présente dans le tenant. L’intégration avait été lancée à Microsoft Build avec Leatherman, et la page partenaire n’indique aucun tarif. Le 13 novembre, Replit l’avait étendue aux applications avec base de données. La documentation du connecteur Fabric décrit pourtant encore une préversion, réservée aux membres d’un programme de testeurs approuvés.
🔗 Annonce de @Replit · Page partenaire Microsoft de Replit · Documentation du connecteur Microsoft Fabric
Brèves
Agents de code et CLI
- GitHub Copilot retire trois modèles — Comme annoncé le 15 octobre, Claude Opus 4.8, Claude Opus 5 et GPT-5.6 Terra quittent la plupart des expériences Copilot, remplacés par Claude Opus 5.5, GPT-6.1 Sol ou GPT-6 Luna. Précision du changelog : Claude Opus 5 sort du sélecteur, mais reste disponible comme repli quand une requête est refusée à l’exécution. 🔗 source
- Copilot CLI 1.0.113-0 — Cette préversion paraît sans notes détaillées, avec pour seule mention des correctifs et des changements ; la dernière version stable reste la 1.0.112 du 13 novembre. 🔗 source
- GitHub Agentic Workflows 1.3.0 — Toujours en préversion, cette version sort les ledgers de l’expérimental et ajoute une porte,
require-agent-success, qui bloque la publication des sorties quand le job de l’agent a échoué ; les refus de Copilot liés à la politique de cybersécurité ne sont plus relancés automatiquement. 🔗 source - Codex CLI 0.171.0-alpha.9 — Trois préversions aux notes vides depuis l’alpha.6 ; selon les titres de leurs 41 commits,
codex execpeut s’appuyer sur un serveur d’application distant, et le terminal affiche des conseils de responsabilité et de risque lors des revues. La dernière stable reste la 0.169.0. 🔗 source - Agents SDK d’OpenAI — La préversion Python v0.24.0-alpha.8 permet d’approuver ou de refuser un appel d’outil après avoir vu ses arguments, de brancher LiteLLM ou AnyLLM et d’ajouter la voix temps réel par WebSocket, WebRTC ou SIP ; côté JavaScript, la v0.22.0-alpha.3 peut exécuter les callbacks d’outils en parallèle par défaut. 🔗 source
- Gemini CLI — Un correctif fusionné sur la branche principale, pas encore publié, fait ignorer les serveurs MCP déclarés par l’administrateur dont les commandes ou scripts restent modifiables par un utilisateur ordinaire, qui pouvait sinon hériter de l’approbation automatique d’un serveur autorisé. 🔗 source
- ZCode v3.18.2 — Z.ai publie sur GitHub cette version de son poste de développement assisté par IA pour macOS et Windows, sans notes de version, après des synchronisations de code 3.18.0 et 3.18.1 restées sans release. 🔗 source
- Cache de préfixe des agents — Together AI et Ollama expliquent que le harnais (Claude Code, Codex ou Pi via
ollama launch) doit garder le début du prompt identique et que le moteur doit renvoyer chaque tour vers le GPU qui détient le cache : sur 100 tours, 5 050 unités de prompt traitées sans cache contre 100 avec, en calcul idéalisé. 🔗 source - Usines logicielles d’équipe — Dans un billet d’opinion sur le blog de Warp, Zach Lloyd plaide pour sortir les agents des réglages de chaque développeur (harnais, modèle, skills, MCP) vers une infrastructure cloud partagée, décrite en code et détenue par l’équipe. 🔗 source
Autres nouveautés de GitHub
- AI Scan en lot — L’analyse de vulnérabilités par IA des dépôts se lance désormais sur 20 dépôts au plus en une fois, depuis le réglage d’organisation ou la page des alertes de code scanning, en préversion publique et sans licence Copilot. 🔗 source
- GitHub Mobile sur iPhone Duo — L’application iOS adapte sa mise en page une fois l’appareil déplié et ajoute des onglets verticaux vers Copilot, les pull requests, les issues et les notifications. 🔗 source
Calcul, simulation et robotique
- Lambda et NVIDIA Photonics — Lambda relie des racks GB300 NVL72 totalisant plus de 10 000 GPU par des commutateurs à optique co-intégrée (co-packaged optics) ; selon ses tests, la latence baisse d’environ 4 % au rack et jusqu’à environ 10 % au pod, et les optiques tournent à 36 °C contre 51 °C en enfichable. 🔗 source
- Google Cloud dans MLPerf Training v6.1 — Sur le premier benchmark MLPerf d’apprentissage par renforcement agentique, selon Google, 640 TPU Ironwood atteignent la précision cible en 18,02 minutes ; en pré-entraînement, 8 192 TPU Ironwood y parviennent en 1,70 minute et 256 GPU GB300 en 31,96 minutes. 🔗 source
- NVIDIA Cosmos — Les modèles du monde ouverts de NVIDIA dépassent 20 millions de téléchargements sur Hugging Face, selon NVIDIA, sans période ni périmètre précisés. 🔗 source
- LidarVerse — NVIDIA Research remet en avant ce modèle d’octobre qui génère, prédit et resimule des balayages LiDAR, à 10 images par seconde sur un seul H100 en version distillée ; le code est sous licence Apache 2.0. 🔗 source
- AI Day Seoul — NVIDIA dresse le bilan de son événement coréen : plus de 2 000 participants, plus de 500 développeurs formés ou certifiés en coréen, et un hackathon gagné par l’équipe FlyGate avec des agents bâtis sur OpenShell. 🔗 source
- projectsim (Kaedim) — Plus de 200 objets 3D prêts pour la simulation robotique, dont 140 articulés, deviennent gratuits et rejoignent aussi SimReady Central de NVIDIA, où sept sont déjà en ligne. 🔗 source
Modèles ouverts et Hugging Face
- CI de llama.cpp — Face à 3 181 pull requests en trois mois et aux limites du plan gratuit de GitHub (10 Go de cache, 20 jobs simultanés), l’équipe ne lance plus que les jobs touchés par le diff, stocke ses caches ccache dans Hugging Face Buckets et fait tourner la plupart des jobs Linux x64 sur Hugging Face Jobs. 🔗 source
- Accelerate v1.16.0 — La bibliothèque d’entraînement distribué de Hugging Face exige désormais Python 3.11 et PyTorch 2.6, s’appuie davantage sur
torch.acceleratorpour les accélérateurs déclarés auprès de PyTorch, et retire PiPPy, MS-AMP etFP8RecipeKwargs. 🔗 source - Tiny Aya Global — Cinq billets communautaires, la plupart issus du hackathon de Lexsi Labs, s’attaquent au petit modèle multilingue de Cohere Labs : un agent de base de données passe de 0,5 à 49,1 % de réussite en trois tours d’autoréparation, et le pilotage du refus réduit fortement les réponses nuisibles en bengali et en swahili, au prix de deux fois plus de refus excessifs, selon les auteurs. 🔗 source
- Modular Diffusers — Un guide montre comment utiliser dans Diffusers un modèle pas encore intégré, en convertissant ses poids et en publiant des blocs sur le Hub ; l’auteur a confié le travail à Claude Code avec Claude Opus 5.5, la conversion n’ayant pas abouti avec Astra. 🔗 source
- Petits modèles sur téléphone — Un développeur publie deux parcours d’achat complets sur Amazon menés en local par Qwen3.5 0,8B et 2B sur des téléphones Android, avec une entrée médiane de 45 tokens par appel ; le plus lent, sur un Galaxy A04e, a duré 4 h 20 pour 578 appels. 🔗 source
- Ask AdMob — Google présente un agent conversationnel bâti avec Gemini dans le compte AdMob, en test dans les prochains mois, publie dès maintenant des agent skills AdMob pour les agents de code et prépare un serveur MCP, en test précoce, ouvert à plus de développeurs début 2027. 🔗 source
- Google Flow — Le 12 novembre, Google a ajouté à son studio créatif cinq outils conçus par des artistes, dont Pocket Studio, qui tire plusieurs angles de caméra d’une seule prise au téléphone, et Pixel Machine pour les styles rétro. 🔗 source
Voix, image et vidéo
- Nemotron 3.5 Transcribe — NVIDIA relaie la première place de son modèle ouvert dans l’indice de diarisation d’Artificial Analysis publié le 13 novembre : 3,3 % de mots mal attribués (WDER) sur 97 conversations de deux à huit personnes, devant Voxtral Small Transcribe 3 (7,5 %). 🔗 source
- FLUX: In Production — Black Forest Labs lance un concours de films réalisés avec l’IA, dont les briefs sont rédigés par des studios partenaires, avec plus de 25 000 dollars de prix ; il se tient en ligne du 30 novembre au 13 décembre. 🔗 source
- Kling Image 4.0 — Kling annonce l’arrivée prochaine de son nouveau modèle d’image, sans date ni caractéristiques. 🔗 source
Entreprises et formation
- Autotorino et ElevenAgents — Le groupe italien de concessions automobiles, qui reçoit environ 100 000 appels par mois, confie ses appels à un agent vocal qui qualifie la demande et crée le prospect ; le volume d’appels traités automatiquement a plus que doublé. 🔗 source
- Les dots de Holiday Extras — Dans une étude de cas d’OpenAI, le dot d’un responsable repère seul le lancement d’une fonction, interroge Google BigQuery et livre un rapport sans qu’on le lui demande ; un autre prépare des rapports pendant le trajet de son utilisateur. 🔗 source
- OpenAI et The King’s Trust — OpenAI verse 1 million de livres sterling à l’association britannique pour former à l’IA jusqu’à 25 000 jeunes en 18 mois, en priorité ceux qui ne sont ni en emploi, ni en études, ni en formation. 🔗 source
- L’IA dans la formation selon Synthesia — Troisième rapport annuel, plus de 800 répondants dans plus de 25 pays : 87 % des équipes qui utilisent l’IA s’en servent pour générer du contenu, mais 29 % seulement pratiquent l’apprentissage personnalisé, contre 70 % qui le pratiquaient ou le prévoyaient il y a un an. 🔗 source
Perplexity
- Chiffres surlignés dans les sources — Dans Computer et les Teammates, ouvrir le document source d’une réponse surligne désormais le chiffre exact cité, sur le web pour tous les utilisateurs, selon @AskPerplexity. 🔗 source
- Guide IA contre AGI — Perplexity publie un guide qui distingue l’IA déployée aujourd’hui de l’AGI et propose une méthode pour vérifier une annonce d’AGI ; il cite Claude Opus 5.5 à 21,3 % sur le Remote Labor Index au 9 octobre. 🔗 source
Ce que ça signifie
L’écart entre modèles ouverts et fermés se lit désormais en dollars autant qu’en points. Qwen4-Max passe sous les tarifs de Qwen3.8-Max et annonce un coût par tâche réduit de 62 %, mais ne mène que sur 4 des 16 tests de son propre tableau, et rien n’annonce de poids ouverts pour lui. Hugging Face mise sur l’autre versant : en confiant son routage à OpenRouter, il s’adosse à des modèles ouverts qui pèsent 71,7 % des tokens d’OpenRouter et coûtent environ quatre fois moins cher en moyenne. Le même billet reconnaît pourtant 19 points d’écart en haut de l’Intelligence Index, et JFinBench en mesure 12,4 en finance japonaise sans outils, ramenés à 4,4 avec un accès au web : sur les domaines peu mesurés, l’avance des modèles fermés tient d’abord à ce qu’ils savent.
Les agents sortent du terminal pour entrer dans des systèmes métier gouvernés. Dans ChatGPT for Healthcare, l’agent qui pilote l’ordinateur relie le dossier médical au portail d’un assureur, sous contrôles d’accès par rôle, journaux d’audit et BAA ; chez Replit, l’application construite par l’Agent naît dans le tenant Fabric du client, avec ses droits Entra ID et ses étiquettes Purview. Le même mouvement profite aux attaquants : selon GTIG, un framework a enchaîné sans humain la découverte et l’exploitation de failles, et un groupe a piégé la configuration de Claude Code pour installer une porte dérobée. Le correctif de Gemini CLI sur les serveurs MCP modifiables le rappelle à sa manière : l’approbation automatique d’un outil ne vaut que ce que vaut l’intégrité du script qui le lance.
La science devient l’argument commun du calcul et des agents. NVIDIA présente Rubin HPC et ses bibliothèques CUDA-X comme les outils de simulation que des agents appelleront pour tester leurs idées, Perplexity veut bâtir un scientifique automatisé sur plus de 10 000 GPU, et OpenAI ouvre un blog où un physicien raconte comment GPT-6 Astra a pris la tête d’une preuve, tout en doublant l’objectif de son programme pour chercheurs. Les promesses devancent encore les résultats : Rubin HPC est attendu en 2028 sans mémoire ni FLOPS annoncés, Frontier Research ne présente aucun modèle ni article nouveau, la définition de Craig reste « candidate », et l’étude d’OpenAI mesure une productivité déclarée, sans effet causal établi.
La façon de mesurer bouge elle aussi. OpenAI ouvre ses checkpoints et ses entraînements à Apollo Research, METR, Transluce et Goodfire, mais garde la main sur l’expurgation et le calendrier de publication. Together AI montre que deux phrases dans un skill font passer un modèle de 4 réussites sur 15 à 100 %, ce qui relativise les écarts entre modèles mesurés sans guidage. L’épisode de JFinBench, où deux modèles ont trouvé une clé OpenRouter oubliée pour faire travailler d’autres modèles, rappelle qu’une évaluation avec outils mesure aussi ce que l’environnement laisse à portée de main. Et le gain de plus de 10 fois de Vera Rubin sur MLPerf Endpoints reste provisoire tant que MLCommons ne l’a pas vérifié.
Sources
- Qwen4-Max: Your New Teammate Has Arrived (billet Qwen)
- Fiche de qwen4-max sur QwenCloud
- Annonce de Qwen4-Max (@Alibaba_Qwen)
- More ways to move care forward with ChatGPT for Healthcare (OpenAI)
- Advancing computer-use agents for healthcare teams (OpenAI)
- Rubin HPC (blog NVIDIA)
- Les annonces de NVIDIA à SC26
- Vera Rubin dans MLPerf Training et Endpoints (blog NVIDIA)
- Slurm et le calcul quantique (blog NVIDIA)
- Bibliothèques CUDA-X pour la science (blog NVIDIA)
- Hugging Face and OpenRouter join forces (blog Hugging Face)
- Annonce de @huggingface
- Introducing Perplexity Frontier Research
- Annonce de @perplexity_ai
- research.perplexity.ai
- Fil d’Andrew Gordon Wilson (@andrewgwils)
- Fil de Denis Yarats (@denisyarats)
- A step toward defining the Standard Model on a lattice (OpenAI)
- Our new blog for science (OpenAI)
- Broadening access to AI for scientists (OpenAI)
- Science at the Frontier: How scientists use ChatGPT (OpenAI)
- Our first phase of embedded assessments (OpenAI)
- Strengthening the fight against online child sexual abuse (OpenAI)
- Changelog de l’API OpenAI
- GTIG AI Threat Tracker (Google Cloud)
- Résumé du rapport GTIG (blog.google)
- Gemini Notebook : des sites interactifs à partir des sources (blog.google)
- Annonce de @Gemini_Notebook
- Les voix régionales de l’application Gemini (blog.google)
- Les nouvelles fonctions d’Ask Maps (blog.google)
- Ask Maps arrive en Europe (blog.google)
- Introducing Perplexity’s Monitor API
- Introducing Video Intelligence in Compass (Cohere)
- Annonce de Video Intelligence (@cohere)
- JFinBench (Sakana AI)
- Article JFinBench sur arXiv
- How we make Together AI easy for coding agents to use
- Kotoba is joining ElevenLabs
- Annonce de @ElevenLabs
- LVMH’s Media Division announces strategic partnership with OpenAI
- Annonce de @ClaudeDevs
- Documentation du simulateur iOS de Claude Code
- Annonce de @Replit
- Page partenaire Microsoft de Replit
- Documentation du connecteur Microsoft Fabric (Replit)
- Retrait de modèles dans GitHub Copilot (changelog GitHub)
- Copilot CLI 1.0.113-0 (GitHub)
- GitHub Agentic Workflows 1.3.0 (GitHub)
- Codex CLI 0.171.0-alpha.9 (GitHub)
- Agents SDK Python v0.24.0-alpha.8 (GitHub)
- PR 30283 de Gemini CLI (GitHub)
- ZCode v3.18.2 (GitHub)
- Making open models work for long-horizon agentic workloads (Together AI et Ollama)
- Billet de Zach Lloyd sur les usines logicielles (Warp)
- AI Scan sur plusieurs dépôts (changelog GitHub)
- GitHub Mobile sur iPhone Duo (changelog GitHub)
- Lambda et NVIDIA Photonics (blog NVIDIA)
- Résultats MLPerf Training v6.1 de Google Cloud (blog.google)
- NVIDIA Cosmos, 20 millions de téléchargements (@NVIDIAAI)
- LidarVerse (@NVIDIAAI)
- Bilan de l’AI Day Seoul (blog NVIDIA)
- Objets de simulation gratuits de projectsim (blog Hugging Face)
- CI de llama.cpp sur Hugging Face Buckets et Jobs (blog Hugging Face)
- Accelerate v1.16.0 (GitHub)
- Efficient Healer sur Tiny Aya Global (blog Hugging Face)
- Nouveaux modèles avec Modular Diffusers (blog Hugging Face)
- Longs parcours sur téléphone avec de petits modèles (blog Hugging Face)
- Les nouveaux outils IA d’AdMob (blog.google)
- Les cinq nouveaux outils de Google Flow (blog.google)
- Nemotron 3.5 Transcribe dans l’indice de diarisation (@NVIDIAAI)
- FLUX: In Production (@bfl_ai)
- Kling Image 4.0 (@Kling_ai)
- Autotorino et ElevenAgents (ElevenLabs)
- At Holiday Extras, dots get to work before anyone asks (OpenAI)
- The King’s Trust and OpenAI (OpenAI)
- Rapport de Synthesia sur l’IA en formation
- Chiffres surlignés dans Computer et les Teammates (@AskPerplexity)
- AGI vs. AI (Perplexity)