ai-powered-markdown-translatorمقال مترجم من الفرنسية إلى العربية باستخدام gpt-6.1-sol.
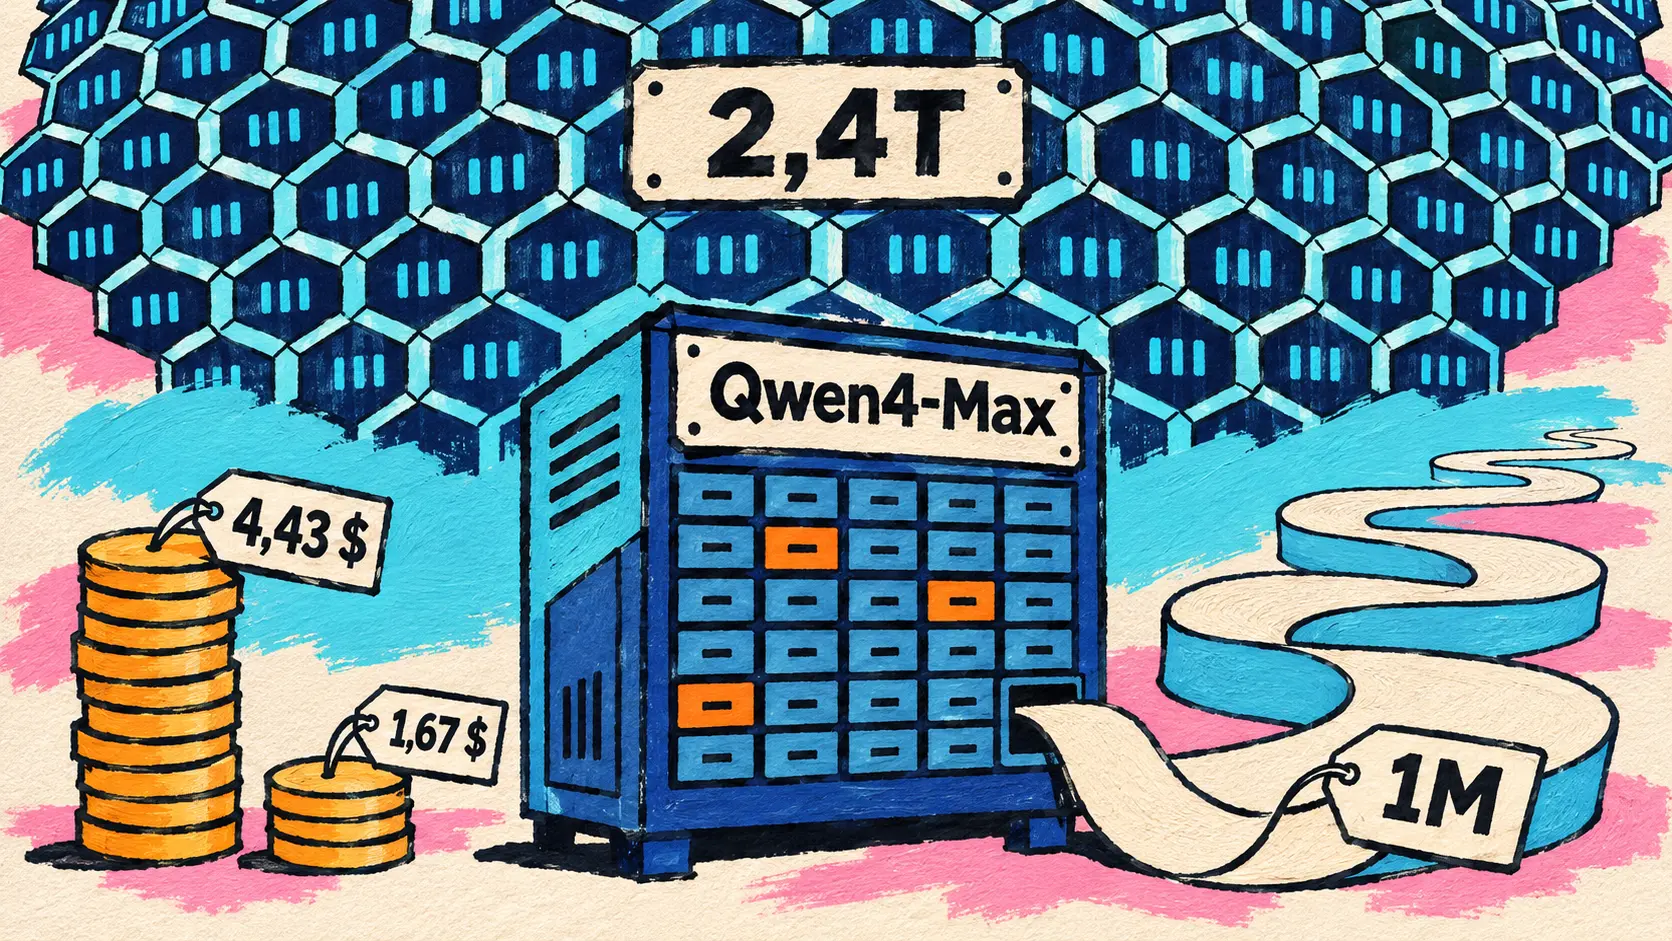
تتيح Qwen نموذج Qwen4-Max عبر API الخاص بها: نموذج MoE يضم 2,4T من المعلمات، مع سياق بسعة 1M tokens، وبتكلفة أقل من Qwen3.8-Max. وتوسّع OpenAI إتاحة وكلائها الذين يتحكمون في الكمبيوتر لتشمل ChatGPT for Healthcare وChatGPT for Clinicians، وتعلن NVIDIA في SC26 عن Rubin HPC، وهو GPU للمحاكاة يُتوقع وصوله في 2028، مع أولى نتائج Vera Rubin في MLPerf Training، فيما تسند Hugging Face إلى OpenRouter توجيه Inference Providers لديها. ومن جانبها، تطلق Perplexity مبادرة Perplexity Frontier Research، التي تهدف إلى إنشاء عالِم آلي باستخدام أكثر من 10 000 GPU.
Qwen4-Max متاح عبر API الخاص بـQwenCloud: نموذج MoE يضم 2,4T من المعلمات، وسياق بسعة 1M tokens، وأسعار أقل
16 نوفمبر — بعد خمسة أيام من النسخة التجريبية التي تناولناها في 11 نوفمبر، تتيح Qwen نموذج Qwen4-Max عبر API الخاص بـQwenCloud تحت المعرّف qwen4-max، مع تدوينة تقنية مطوّلة. وهو أول نموذج في سلسلة Qwen4: ستصدر نماذج Qwen4 أصغر بأوزان مفتوحة، من دون تحديد موعد، لكن لا يوجد أي إعلان عن ذلك بالنسبة إلى Max. ويتوفر النموذج أيضًا في QwenWork وQoder وQwen Studio، ومن اليوم نفسه لدى OpenRouter وVercel AI Gateway وNovita AI وOpenCode Go.
تعتمد البنية تصميمًا جديدًا. يضم مزيج الخبراء هذا (Mixture of Experts، MoE) 2,4T من معلمات البنية الأساسية، يُفعّل منها 71B لكل token، إضافة إلى 328B من معلمات N-gram Embedding. ومن بين كل أربع طبقات، تضغط ثلاث طبقات Gated DeltaNet السجل في حالة ذات حجم ثابت؛ وتختار الرابعة، باستخدام Qwen Sparse Attention، السياق المفيد على هيئة كتل. ويدعم النموذج الرؤية بصورة أصلية، مع سياق بسعة 1M tokens: منها 991K للإدخال و131K للإخراج، و983K و262K في وضع التفكير، وفقًا لصفحة QwenCloud.
| نوع التسعير (QwenCloud، لكل مليون tokens) | السعر المعلن |
|---|---|
| الإدخال | 1,5 دولار |
| الإخراج | 4,5 دولارات |
| الإدخال من التخزين المؤقت الضمني | 0,075 دولار |
| إنشاء تخزين مؤقت صريح (5 دقائق / 1 ساعة) | 1,875 / 3 دولارات |
وفقًا لـQwen، تقل جميع هذه الأسعار عن أسعار Qwen3.8-Max، مع انخفاض سعر التخزين المؤقت الضمني بنسبة 70 %. وفي تقييماتها الداخلية، تعلن Qwen أيضًا عن خفض استهلاك tokens بنسبة تتراوح من 24 إلى 35 % بحسب مستوى الجهد على Work360، وهو إطارها الذي يغطي 721 تخصصًا مهنيًا، وبنحو 48 إلى 49 % على Terminal-Bench 4.0. وينخفض متوسط تكلفة المهمة في Work360 من 4,43 إلى 1,67 دولار، أي −62 % وفقًا للتدوينة الإنجليزية؛ أما النسخة الصينية، المقوّمة باليوان، فتشير إلى −58 %. وفي Work360، يحقق Qwen4-Max نتيجة 52,69 مقابل 47,74 لـQwen3.8-Max.
مقارنةً بـOpus 5.5 وGPT-6.1 Sol وGPT-6 Astra وKimi K3.1، يعرض الجدول الذي نشرته Qwen نتائج متباينة: لا يتصدر Qwen4-Max سوى 4 من أصل 16 اختبارًا، وهي DeepSWE v1.1 وAgents’ Last Exam v1.1 وHLAB-Vals-1.1 وBioMysteryBench. وفيما يلي مجموعة مختارة:
| اختبار الأداء (المجال) | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|
| DeepSWE v1.1 (البرمجة باستخدام الوكلاء) | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| HLAB-Vals-1.1 (وكيل قانوني) | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| BioMysteryBench (المعلوماتية الحيوية) | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| Terminal-Bench 4.0 (استخدام الطرفية بواسطة الوكلاء) | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench (إعادة إنتاج البرمجيات) | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| Humanity’s Last Exam | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
تضعه تصنيفات الجهات الخارجية التي نقلتها Qwen في المرتبة السادسة في Code Arena WebDev (1 750 نقطة مبدئية) والحادية عشرة في Vals Index (63,20 %)، بوصفه النموذج الصيني الأول. وتمنحه Artificial Analysis نتيجة 43 نقطة في Intelligence Index عند مستوى الجهد xhigh، بفارق 3 نقاط خلف Kimi K3.1 Pro، مع تكلفة لكل مهمة أقل بنحو 11 %.
More to come! The open weights of smaller Qwen4 models will be released. Stay tuned.
🇸🇦 لم ننتهِ بعد! ستُنشر الأوزان المفتوحة لنماذج Qwen4 أصغر. ترقّبوا المزيد. — @Alibaba_Qwen على X
🔗 Qwen4-Max: وصل زميلك الجديد (تدوينة Qwen) · بطاقة qwen4-max على QwenCloud
ChatGPT for Healthcare: وكلاء يتحكمون في الكمبيوتر، وبحث سريري، وأكثر من 20 إضافة صحية
16 نوفمبر — توسّع OpenAI خدمة ChatGPT for Healthcare في ثلاثة اتجاهات. أولًا، تصل وكلاء استخدام الكمبيوتر (computer-use agents)، التي تقرأ الشاشة وتنقر وتكتب وتتنقل بين التطبيقات، إلى ChatGPT Work وCodex لعملاء ChatGPT for Healthcare، بحسب إعدادات مساحة عملهم، وللممارسين السريريين المشتركين في ChatGPT for Clinicians، وهي الخدمة المجانية المخصصة للممارسين السريريين المعتمَدين في الولايات المتحدة. وتتوفر القدرة نفسها عبر API. ومن الأمثلة النموذجية: نقل المعلومات بين برمجيات لا تتواصل فيما بينها، مثل السجل الطبي الإلكتروني وبوابة شركة تأمين لتقديم طلب موافقة على التصوير بالرنين المغناطيسي. وكانت إمكانية استخدام الكمبيوتر متوفرة في ChatGPT Work وCodex منذ 9 يوليو؛ والجديد هو إتاحتها لمساحات العمل الصحية، مع ضوابط وصول بحسب الدور، وسجلات تدقيق، وخطوات موافقة قابلة للتهيئة. وتظل مسارات العمل المتوافقة مع HIPAA مقتصرة على الخدمات المؤهلة المشمولة باتفاقية BAA.
تنشر OpenAI مجموعتين من الأرقام ينبغي قراءتهما بصورة منفصلة: تقييمها الداخلي لمراسلات السجل الطبي، وHealthAdminBench، وهو اختبار أداء مستقل وضعه باحثون من ستانفورد للمهام الإدارية (الموافقات المسبقة، والتظلمات، وطلبات المعدات).
| التقييم المنشور | النموذج والإعداد | النتيجة المعلنة |
|---|---|---|
| مراسلات السجل الطبي (OpenAI، مراجعة 325 مهمة) | GPT-6 Astra | اعتُبرت 99 % من المهام آمنة سريريًا |
| التقييم نفسه، 646 تقديرًا من أطباء | GPT-6 Astra | اعتُبرت 93 % «مفيدة جدًا» أو «مفيدة للغاية» |
| HealthAdminBench (ستانفورد) | GPT-6 Astra، أقصى جهد | 94,3 % من نقاط سلّم التقييم |
| HealthAdminBench (ستانفورد) | GPT-6 Luna، أقصى جهد | 91,8 %، بتكلفة 8,5 سنتات لكل مهمة |
في HealthAdminBench، يحقق GPT-6 Luna نتيجة 91,8 % بتكلفة أقل بنسبة 98 %، أي 8,5 سنتات لكل مهمة. وعلى أرض الواقع، تستخدم CVS Health هذه الوكلاء بالفعل في بيئة الإنتاج: فقد عالج أحدها خلال عطلة نهاية أسبوع تراكمًا في إرسال المستندات امتد لأشهر، بينما يتولى آخر خطوات العمل داخل الأنظمة لعشرات الآلاف من الاستشارات يوميًا، وتنشر الشركة Agent Kit الخاص بها بمصدر مفتوح، وقد بُني باستخدام Agents SDK من OpenAI. وتقول Cigna Healthcare إنها انتقلت من الفكرة إلى النشر في أقل من ثمانية أسابيع؛ ولدى Ambience، يتوقف الوكيل ويطلب رأي الممارس السريري عندما يكون السجل ملتبسًا؛ وتطوّر Abridge وكلاء للمستشفيات.
ثم يأتي المحوران الآخران. يحصل البحث السريري، الذي يعثر على الأدلة الطبية ويقيّمها ويستشهد بها، على تقييمات أفضل في الأبعاد الثمانية المقاسة ضمن تقييم أعمى شمل أكثر من 1 300 مراجعة أجراها أطباء. وتتيح 21 إضافة صحية جديدة (UpToDate Expert AI وOracle HDI وTrizetto وStedi وLuma Health وMetriport…) الاطلاع على بروتوكول، أو التحقق من أهلية التغطية التأمينية، أو تنسيق المواعيد من داخل المحادثة؛ ويجب أن يفعّلها مسؤول مساحة العمل، ولا يحصل ChatGPT for Clinicians إلا على جزء منها.
🔗 مزيد من السبل للارتقاء بالرعاية مع ChatGPT for Healthcare · تطوير وكلاء استخدام الكمبيوتر لفرق الرعاية الصحية
NVIDIA في SC26: Rubin HPC للمحاكاة العلمية، وVera Rubin في MLPerf، وSlurm للمعالجات الكمية، ومكتبات CUDA-X
16 نوفمبر — في مؤتمر الحوسبة عالية الأداء SC26، تطلق NVIDIA سلسلة إعلانات موجّهة نحو العلوم. وأبرزها Rubin HPC، وهو GPU جديد ضمن منصة Vera Rubin، صُمّم للمحاكاة ومعالجة البيانات في العلوم والهندسة والتحليلات، في مجالات مثل المناخ وعلم الجينوم والمخاطر المالية.
تظل المواصفات المنشورة موجزة. تبرز NVIDIA وجود أكثر من 50 000 نواة CUDA على GPU واحد، وهو عدد «قياسي» بحسب الشركة، وتسريع البيانات المتناثرة (sparse data acceleration) لضمان استمرار تزويد هذه الأنوية بالبيانات، وربط NVLink من الجيل السابع بين وحدات GPU. ولم تُذكر سعة الذاكرة، أو القدرة بوحدة FLOPS، أو السعر، أو أي شريك.
تتمثل الحجة الأساسية في التوازن. وفقًا لـNVIDIA، تتكون معظم أعباء العمل العلمية من جلب عدد قليل من القيم المتناثرة في مجموعة بيانات هائلة، وإجراء الحسابات، ثم تكرار ذلك على نطاق واسع جدًا. ولذلك، يزيد Rubin HPC حركة البيانات بالتوازي مع القدرة الحسابية، لتسريع العمليات على المصفوفات المتناثرة، وحسابات stencil، والفرز، والاختزال. وتربط NVIDIA هذا GPU بطرحها حول الوكلاء: فالوكيل الذي يستكشف مزيدًا من الجزيئات أو المواد أو التصاميم يحتاج إلى مزيد من المحاكاة لاختبار أفكاره، وتوفّر له مكتبات CUDA-X تطبيقات برمجية محسّنة. أما الموعد فما زال بعيدًا: يُتوقع وصول Rubin HPC في 2028.
| الخاصية المعلنة | القيمة التي تذكرها NVIDIA |
|---|---|
| أنوية CUDA | أكثر من 50 000 على GPU واحد |
| الربط بين وحدات GPU | NVLink من الجيل السابع |
| الوظيفة الخاصة | تسريع البيانات المتناثرة |
| التوفر المتوقع | 2028 |
🔗 Rubin HPC (مدونة NVIDIA) · إعلانات NVIDIA في SC26
Vera Rubin يشارك لأول مرة في MLPerf Training v6.1 وMLPerf Endpoints، بأداء لكل GPU يصل إلى ضعفي GB300 NVL72
16 نوفمبر — تمثل دورة MLPerf Training v6.1 أول مشاركة لـVera Rubin NVL72 في التدريب: أداء لكل GPU يصل إلى ضعفي أداء GB300 NVL72، وهي نتائج تصفها NVIDIA بأنها مبكرة. وعلى DeepSeek-V3، يحافظ الانتقال من 256 إلى 1 024 GPU من Vera Rubin على كفاءة تقارب 97 %، ويخفض مدة التدريب من 16 دقيقة إلى نحو أربع دقائق. وتضم أكبر تهيئة في الدورة 10 240 GPU، باستخدام GB300 لدى NVIDIA وGB200 لدى Microsoft Azure. ووفقًا لـNVIDIA، فإن منصتها هي الوحيدة التي لديها نتائج في جميع الاختبارات.
وتقدم NVIDIA أيضًا أول مشاركة لها في MLPerf Endpoints v1.0، الذي يقيس مسارات عمل فعلية للوكلاء. وعلى Kimi K3، يُقال إن Vera Rubin NVL72 يحقق معدل إنتاجية لكل واط يزيد بأكثر من 10 مرات على GB300 NVL72 عند سرعة استجابة متساوية: وهي نتيجة مؤقتة، تنتظر التحقق منها من جانب MLCommons، وتقارن 32 مسرّعًا من Vera Rubin بـ48 مسرّعًا من GB300 عند عتبة 50 tokens في الثانية لكل مستخدم. وكان Vera Rubin قد ظهر بالفعل في نسخة تجريبية ضمن MLPerf Inference، الذي تناولناه في 16 سبتمبر.
🔗 Vera Rubin في MLPerf Training وEndpoints (مدونة NVIDIA)
Slurm 26.11 سيدعم المعالجات الكمية، وCUDA-Q يضيف قدرات جديدة
16 نوفمبر — توسّع NVIDIA نطاق Slurm، مدير المهام في الحواسيب الفائقة، ليشمل المعالجات الكمية (QPU). حتى الآن، كان توصيل QPU بمركز حوسبة يتطلب تطويرًا خاصًا بكل اقتران بين المعالج والمركز؛ أما الآن، فيصف المصنّع عتاده في ملف بسيط ويحصل على واجهة صالحة للاستخدام في كل مكان، عبر واجهتَي QRMI وQDMI. وتعتمده Alice & Bob وIBM وIQM وPasqal وQuantinuum وMQSC، ومن المقرر صدور Slurm 26.11 في وقت لاحق من نوفمبر. وتبرر NVIDIA هذا المشروع بتزايد عدد الأنظمة: إذ ينشر نحو 30 مركز حوسبة أكثر من 50 QPU.
تضيف منصة CUDA-Q خادمًا لفك الترميز من أجل تصحيح الأخطاء الكمية (CUDA-Q QEC)، ويُقال إن مفكك الترميز TCBP-JOBS فيه أسرع بـ13 000 مرة من المرجع المعتمد في القطاع، وعمليات أولية متحمّلة للأعطال (وقد أنجز Fermilab بالفعل باستخدام CUDA-Q، في ثلاثة أسابيع، دراسات كانت ستستغرق خمسة أشهر)، إلى جانب CUDA-Q Algorithms وCUDA-Q Pulse لمصنّعي العتاد. وهذه التحسينات هي الأرقام التي تعلنها NVIDIA.
🔗 Slurm والحوسبة الكمية (مدونة NVIDIA)
CUDA-X للعلوم: cuSpa وHMMER على GPU بمصدر مفتوح، ومعالجة ترابط بيانات Event Horizon Telescope في ثماني دقائق
16 نوفمبر — ترافق NVIDIA إطلاق Rubin HPC بمكتبات CUDA-X للأبحاث، وتقدمها بوصفها أدوات يمكن للوكلاء استدعاؤها. ففي علم الفلك، تخفض وحدة cuPhoton.xBeam زمن حساب الترابط بين أرصاد Event Horizon Telescope من أكثر من شهر إلى ثماني دقائق، سواء على عنقود يضم عدة وحدات GPU أو على DGX Spark. وفي علم الأحياء، تجعل cuSpa، التي أصبحت مؤخرًا مفتوحة المصدر، حسابات مضلعات الخلايا أسرع بـ900 مرة مقارنةً بـCPU في مركز ميموريال سلون كيترينغ للسرطان، بينما تكون نسخة HMMER المخصصة لـGPU، والمفتوحة المصدر أيضًا، أسرع بما يصل إلى 84 مرة لدى Basecamp Research. وأصبحت rapids-singlecell تُوزّع في حاوية «جاهزة للوكلاء» (أسرع بـ200 مرة لدى Therna Biosciences). وفي الكيمياء، تنضم Daviator، وهي مجموعة من أنوية GPU لبرنامج VASP، إلى NVIDIA ALCHEMI، مع حسابات أسرع بما يصل إلى 22 مرة وأقل تكلفة بما يصل إلى 75 %، لكنها ليست متاحة بعد؛ أما cuPotential، التي أُطلقت في 14 أكتوبر، فقد تبنّتها خمس جهات، من بينها Cadence.
🔗 مكتبات CUDA-X للعلوم (مدونة NVIDIA)
Hugging Face تُسند إلى OpenRouter توجيه نماذج اللغة لدى Inference Providers
16 نوفمبر — تتعاون Hugging Face وOpenRouter: تتخلى خدمة Inference Providers من Hugging Face عن الموجّه الذي طوّرته داخليًا، وتترك لـ OpenRouter اختيار المزوّد لكل استدعاء لنموذج لغة. ويقدّم كليمان ديلانغ الإعلان بوصفه الجزء الأول من الشراكة. لا يتغيّر شيء في كود العميل: رمز الوصول نفسه من Hugging Face، ونقطة النهاية نفسها. يقبل الموجّه واجهتَي API Chat Completions وResponses من OpenAI، وكذلك واجهة API Messages من Anthropic، وتنشر Hugging Face أدلة لاستخدام Claude Code وCodex وOpenCode وPi وHermes Agent.
يكمن الاختلاف في التوجيه. كانت Inference Providers تختار مزوّدًا وتعيد الخطأ الصادر عنه كما هو؛ أما OpenRouter فيختار وفق السعر والسرعة والموثوقية المقاسة مباشرةً، ويعيد محاولة الاستدعاء لدى مزوّد آخر إذا أخفق المزوّد الأول. وتفرض لواحق سياسةً أو مزوّدًا محددًا (:fastest، :cheapest، zai-org/GLM-5.3:novita)، وتبقى المحادثة لدى المزوّد الذي يحتفظ بذاكرة التخزين المؤقت لموجّهها.
| التغيير المُعلن | التفاصيل وفق التدوينة |
|---|---|
| أخطاء السعة الاستيعابية (قياس OpenRouter) | −46 % |
| الزمن حتى أول رمز ومعدل الإنتاجية (قياس OpenRouter) | تحسّن بنسبة 16,9 % و+16,3 % |
| الفوترة | سعر المزوّد، دون هامش إضافي من Hugging Face |
| الأرصدة الشهرية المشمولة | 2 دولار (PRO)، و2 دولار لكل مقعد (Team، Enterprise) |
| صفحات النماذج | علامتا التبويب Providers وMetrics: السعر والسرعة والتوافر على مدى 24 ساعة |
| تغيير يكسر التوافق | رفض مفاتيح API الشخصية للمزوّدين عند استخدام نماذج اللغة |
تستمر الصور والفيديو والصوت في المرور مباشرةً عبر Inference Providers، دون OpenRouter، وتظل المفاتيح الشخصية صالحة لمزوّدي الصور والفيديو. وأُعلن عن خطط لاحقة لربط حساب OpenRouter بـ Hugging Face وتوجيه مهام أخرى عبر OpenRouter، دون تحديد موعد.
تستند التدوينة إلى أرقام OpenRouter: شكّلت النماذج المفتوحة 71,7 % من الرموز المقدَّمة في نهاية سبتمبر 2026، مقابل 26,8 % في أكتوبر 2025، بمتوسط سعر قدره 0,28 و1,62 دولار لكل مليون رمز (إدخال، إخراج)، مقابل 1,27 و6,36 دولار للنماذج المغلقة. وتقرّ أيضًا بالفجوة في صدارة الترتيب: يحقق Kimi K3.1 Pro، أفضل نموذج مفتوح، 46 نقطة على مؤشر الذكاء لدى Artificial Analysis، مقابل 65 لـ Claude Fable 5.2، بتكلفة لكل مهمة تعادل نحو السُّبع (3,68 مقابل 26,54 دولار).
🔗 Hugging Face وOpenRouter يتعاونان (مدونة Hugging Face) · إعلان @huggingface
Perplexity Frontier Research: مبادرة بحثية مفتوحة تهدف إلى بناء عالِم آلي، باستخدام أكثر من 10 000 GPU
16 نوفمبر — تُطلق Perplexity مبادرة Perplexity Frontier Research، التي تهدف إلى بناء «عالِم بحث آلي» (عالِم بحث آلي): نظام ذكاء اصطناعي قادر على تنفيذ دورة البحث بمفرده، من السؤال إلى الفرضية، ومن التجربة إلى مراجعة قناعاته. وتطرح Perplexity هذا الطموح في مقابل تنبؤات «الصندوق الأسود» في المهام المحدودة: فالغاية هي إنتاج معرفة جديدة قابلة للتفسير.
We aim to create an automated research scientist. Research is a loop that involves asking the right questions, hypothesizing, navigating ambiguity, designing experiments, and updating beliefs. We think this loop can run inside software, for anyone.
🇸🇦 نريد إنشاء باحث علمي آلي. البحث دورة تتضمن طرح الأسئلة الصحيحة، وصياغة الفرضيات، والتعامل مع الغموض، وتصميم التجارب، ومراجعة القناعات. ونعتقد أن هذه الدورة يمكن أن تعمل داخل برنامج، ويستفيد منها الجميع. — @andrewgwils على X
ينتظم البرنامج حول ست ركائز: تنسيق الوكلاء المتعددين، والتدريب المسبق، والتعلّم المستمر، والتعلّم المعزّز، والأنظمة، والتقييمات. ويوضح الموقع المخصص أن الفريق سيُجري تدريبًا مسبقًا لنماذج مفتوحة الأوزان وفعّالة ومتخصصة، وأنه يسعى في مجال التنسيق إلى تحقيق أفضل جودة عند كل مستوى من التكلفة. ويؤكد دينيس ياراتس أهمية التعلّم المعزّز واسع النطاق، باستخدام أكثر من 10 000 GPU، وتغذيته ببيانات اصطناعية وبيئات مستمدة من الاستخدام الفعلي لـ Perplexity؛ وتُطوَّر البنية التحتية بأكملها داخليًا، من البحث إلى بيئات العزل.
| عنصر الإعلان | التزام Perplexity |
|---|---|
| القدرة الحاسوبية | أكثر من 10 000 GPU |
| ركائز البحث | 6 |
| المنشورات الموعودة | أوراق بحثية وتدوينات وبيانات ونماذج وكود |
| مدن التوظيف | سان فرانسيسكو، بالو ألتو، نيويورك، لندن |
| الموعد النهائي للتقديم ذي الأولوية | 5 ديسمبر |
يقدّم الموقع أندرو غوردون ويلسون بوصفه رئيس الأبحاث في المبادرة. ويشكّل الإعلان أيضًا دعوة إلى التقديم، مصحوبة بزمالة بحثية لمسارات ما قبل الدكتوراه وما بعدها. ولا يرافق الإطلاق أي نموذج أو اختبار معياري أو ورقة بحثية جديدة: إذ يجمع الموقع تحت اسم Frontier Research أعمالًا سبق نشرها، مثل WANDR وDecider وSPACE وBrain وJOLT.
🔗 تقديم Perplexity Frontier Research · إعلان @perplexity_ai · research.perplexity.ai · سلسلة منشورات @denisyarats
الذكاء الاصطناعي والبحث العلمي لدى OpenAI: مدونة مخصصة يفتتحها الفيزيائي ناثانيال كريغ، وتوسيع ChatGPT for Academic Researchers ليشمل 200 000 باحث
مدونة علمية تفتتح بتعريف مقترح للنموذج المعياري على شبكة، جرى بناؤه باستخدام GPT-6 Astra
15 نوفمبر — تفتتح OpenAI مدونة مخصصة للعلوم، يشارك فيها الباحثون والفرق نتائجهم وأساليبهم، بما في ذلك كيفية التحقق من العمل. وأول تدوينة ضيف يكتبها ناثانيال كريغ، أستاذ فيزياء الجسيمات في جامعة كاليفورنيا في سانتا باربرا، والعالِم الزائر لدى OpenAI.
يعرض فيها مسودة بحثية نُشرت في أكتوبر وأُعدّت باستخدام GPT-6 Astra، تقترح تعريفًا مرشحًا للنموذج المعياري على شبكة، وهي بنية تقسم الزمكان إلى وحدات منفصلة. ولأن القوة الضعيفة تميّز بين الجسيمات «اليسارية» و«اليمينية»، يؤدي وضعها على شبكة إلى ظهور جسيمات شريكة غير مرغوب فيها، وقد ظلت قاعدة الطور للنموذج المعياري الكامل مسألة مفتوحة لأكثر من 25 عامًا. ووفقًا لكريغ، وجد GPT-6 Astra طريقة لنقل الحقول إلى شبكات أدق، وقاد بناء البرهان المفصل، الذي راجعه لاحقًا ثلاثة متخصصين. ويظل الكاتب حذرًا: فالتعريف «مرشح»، وصالح ضمن حدّ لشدة الحقول، ويمثل إجابة من حيث المبدأ أكثر مما يمثل أداة للمحاكاة.
🔗 خطوة نحو تعريف النموذج المعياري على شبكة · مدونتنا الجديدة للعلوم
ChatGPT for Academic Researchers يستهدف 200 000 باحث، ودراسة تشمل 1 819 عالِمًا
16 نوفمبر — يستهدف برنامج ChatGPT for Academic Researchers الآن 200 000 باحث، بعدما أُطلق في يوليو بهدف الوصول إلى 100 000 باحث. وتُفتح الجولة التالية يوم الاثنين 23 نوفمبر: تُمنح 50 000 منحة لأوائل المتقدمين المؤهلين، بعد أن كانت تُوزَّع بالقرعة، وتغطي كل منها صاحبها وما يصل إلى متعاونَين اثنين، أي ما يصل إلى 150 000 شخص. وينتقل الاشتراك من ChatGPT Pro إلى ChatGPT Plus: فوفقًا لـ OpenAI، كان استخدام معظم المشاركين في المرحلة التجريبية سيظل ضمن حدود Plus.
وبالتوازي، ينشر فريق الأبحاث الاقتصادية في OpenAI دراسةً تتناول 580 186 رسالة من 1 819 عالِمًا، مدعومة باستطلاع شمل 251 منهم. ويقدّر المشاركون أن إنجاز العمل نفسه، بالجودة نفسها، كان سيستغرق منهم نحو 1,9 ضعف الوقت دون الذكاء الاصطناعي، ويتوقع 98 % من المستجيبين أن يسرّع الذكاء الاصطناعي الاكتشافات في مجالاتهم. وتوضح OpenAI حدود الدراسة: إنتاجية يصرّح بها المشاركون، وتوقعات أكثر منها نتائج، وعدم إثبات أي أثر سببي.
| استخدام العلماء لـ ChatGPT | متوسط حصة الرسائل |
|---|---|
| القراءة والتعلّم | 28 % |
| الكتابة والتواصل | 27 % |
| تحليل الأدلة والنظريات | 17 % |
| كتابة برمجيات البحث | 14 % |
🔗 توسيع وصول العلماء إلى الذكاء الاصطناعي · العلم عند حدود المعرفة: كيف يستخدم العلماء ChatGPT
سلامة الذكاء الاصطناعي وأمنه: جهات تقييم مستقلة لدى OpenAI، وإتاحة مصنّف CSAM، وهجمات ينفّذها وكلاء ترصدها Google
OpenAI تتيح نماذجها الداخلية لـ Apollo Research وMETR وTransluce وGoodfire
16 نوفمبر — أبرمت OpenAI اتفاقًا مع أربع جهات مستقلة لتنفيذ مرحلة أولى من التقييمات المدمجة (التقييمات المدمجة): وصول معمّق، وأحيانًا إلى الموارد نفسها المتاحة لباحثيها، مثل نقاط الحفظ والكود وبيانات التدريب والتقييم وأنظمة المراقبة والفرق، للحكم على المواءمة وفعالية آليات الحماية على المدى الطويل. ويُنفَّذ العمل في الموقع، على أجهزة OpenAI، تحت إشراف لجنة السلامة والأمن، التي تتلقى التقارير دون حجب؛ وتحتفظ OpenAI بحق حجب المعلومات السرية وطلب مهلة قبل النشر.
| جهة التقييم المستقلة | موضوع التقييم | التعويض المالي من OpenAI |
|---|---|---|
| Apollo Research | التقويض الخفي ورصده بواسطة آليات الحماية | نعم، دون ارتباط بالنتائج |
| METR | اختلال المواءمة في أكبر عملية تدريب باستخدام RL، ضمن نطاق محدود | لا (مع إمكانية توفير أرصدة API أو قدرة حاسوبية) |
| Transluce | تقييمات المواءمة بعد التدريب | لا (مع إمكانية توفير أرصدة API أو قدرة حاسوبية) |
| Goodfire | قابلية تفسير البنى الداخلية للنماذج | نعم، دون ارتباط بالنتائج |
🔗 مرحلتنا الأولى من التقييمات المدمجة
مصنّف صور CSAM مجاني للمؤسسات المتحقَّق منها، مع إشارة للمحتوى المولَّد بالذكاء الاصطناعي
16 نوفمبر — تتيح OpenAI مجانًا للمؤسسات المتحقَّق منها، عبر واجهة API الخاصة بها، omni-moderation-csam-latest، وهو مصنّف صور يرصد المحتوى المحتمل للاعتداء الجنسي على الأطفال (CSAM)، ويعيد إشارة ثانية للمحتوى الذي قد يكون مولَّدًا بالذكاء الاصطناعي. وقد صُمّم بمساعدة NCMEC، وتقدّمه OpenAI بوصفه أول مصنّف CSAM متاح على نطاق واسع يتضمن هذه الإشارة الثانية؛ وتساعد Tech Coalition وROOST في توسيع الوصول إليه. ووفقًا لاختبارات OpenAI، يُقدَّر أنه يعلّم صورًا أقل بنسبة 48 % من نظام الحماية الحالي، مع العثور على قدر مماثل تقريبًا من مواد الاعتداء. ولدى شركاء الوصول المبكر، تؤكد fal أن 72 % من المحتوى المعلَّم بدرجة ثقة مرتفعة لم يسبق رصده، وتكتشف SafetyKit ما نسبته 90 % من الرسوم أو الرسوم المتحركة. وفي ChatGPT، يؤدي البحث عن هذا النوع من المحتوى الآن إلى إظهار تحذير، وحذف المحادثة، وتعليق الوصول لمدة 24 ساعة؛ وقد تؤدي المخالفة المتكررة إلى إغلاق الحساب أو إبلاغ السلطات.
🔗 تعزيز مكافحة الاعتداء الجنسي على الأطفال عبر الإنترنت · سجل تغييرات واجهة API من OpenAI
Google Threat Intelligence: مهاجمون يؤتمتون اكتشاف الثغرات واستغلالها من البداية إلى النهاية
16 نوفمبر — في تقريره الفصلي عن الاستخدام الخبيث للذكاء الاصطناعي، يرصد Google Threat Intelligence Group (GTIG) نشر المهاجمين أطر عمل هجومية مفتوحة المصدر ومتعددة الوكلاء (ARTEX، CAIRN، CyberStrikeAI، PentAGI). وللمرة الأولى، وفقًا لـ GTIG، أتمت جهاتٌ اكتشاف الثغرات واستغلالها دون تدخل بشري ضمن الدورة: إذ كان إطار عمل يُدعى exploit_agent، عُثر عليه على خادم مكشوف، يقارن الكود قبل التصحيحات وبعدها، ويكتب شيفرات الاستغلال وينفّذها؛ ووفقًا لبيانات القياس عن بُعد لدى الضحايا، بدا أن مشغّله يستهدف خصوصًا مواقع فرنسية في قطاعات الإعلام والترفيه، وكذلك التعليم. وارتفع عدد ثغرات اليوم صفر المستغلّة من متوسط 8 شهريًا في 2025 إلى 11 في 2026، مع ذروة بلغت 22 في أغسطس. وعدّلت مجموعة يُشتبه في أنها كورية شمالية ملفات .claude/settings.json داخل مستودعات داخلية، لجعل Claude Code يثبّت بابًا خلفيًا عند بدء التشغيل.
For the most part, attackers aren’t using new groundbreaking methods to break into systems — they are still going after known, unfixed issues, just with much greater speed and scale.
🇸🇦 في الغالب، لا يستخدم المهاجمون أساليب ثورية جديدة لاختراق الأنظمة: فهم ما زالوا يستهدفون ثغرات معروفة لم تُصحَّح، لكن بسرعة أكبر بكثير وعلى نطاق أوسع. — جون هولتكويست، كبير المحللين لدى GTIG، على blog.google
🔗 متتبّع تهديدات الذكاء الاصطناعي لدى GTIG (Google Cloud)
ميزات Google للمستخدمين: مواقع تفاعلية في Gemini Notebook، و66 صوتًا إقليميًا في Gemini، وAsk Maps في 30 دولة أوروبية
Gemini Notebook يحوّل مصادر دفتر الملاحظات إلى مواقع تفاعلية
16 نوفمبر — أصبح Gemini Notebook قادرًا على تحويل مصادر دفتر الملاحظات إلى مواقع تفاعلية. ويكفي كتابة make me a site في محادثة الدفتر، مع وصف المطلوب: شرح مرئي للمراجعة، مثل جدول دوري تفاعلي أو خط زمني تاريخي، أو لوحة معلومات لمبيعات ربع سنة، أو أداة لتتبّع مشروع بمهامه ومواعيده النهائية. ويُفتح الموقع في علامة تبويب جديدة أو يمكن مشاركته مباشرةً. ويبدأ طرح الميزة عالميًا على الويب اعتبارًا من 16 نوفمبر للمستخدمين الذين تبلغ أعمارهم 18 عامًا فأكثر، بمن فيهم مشتركو Google Workspace؛ وستصل إلى تطبيق الهاتف المحمول «قريبًا»، دون موعد معلن.
🔗 Gemini Notebook: مواقع تفاعلية انطلاقًا من المصادر (blog.google) · إعلان @Gemini_Notebook
تطبيق Gemini يطرح 66 صوتًا إقليميًا على Android وiOS
16 نوفمبر — يطرح تطبيق Gemini 66 صوتًا إقليميًا جديدًا على Android وiOS، تشمل الإنجليزية الأمريكية والبريطانية والهندية، والهندية، والبرتغالية البرازيلية، والإندونيسية، والكورية، مع خيارات خاصة بكل لغة. وتقول Google إنها ضُبطت لتقديم إيقاع طبيعي ووضوح جيد، بدلًا من المبالغة في اللكنات. ويُطبَّق الصوت المختار في جميع أنحاء التطبيق: محادثات Gemini Live، وممارسة لغة، وقراءة إجابة بصوت عالٍ. ويمكن اختياره من قائمة Gemini Live أو من الإعدادات. وكانت Google قد أعلنت مشروع اللهجات المحلية هذا في Google I/O.
🔗 الأصوات الإقليمية في تطبيق Gemini (blog.google)
وصول Ask Maps إلى 30 دولة أوروبية وتعلّمه إعداد مسارات الرحلات والمواعيد
16 نوفمبر — يبدأ Ask Maps، المساعد الحواري في Google Maps الذي يعتمد على نماذج Gemini، التوسع إلى 30 دولة أوروبية، منها إسبانيا وألمانيا والمملكة المتحدة، بعدما أُطلق في الولايات المتحدة والهند وتناولناه هنا في 12 مارس. وتقول Google إنه بات متاحًا في أكثر من 200 دولة وإقليم؛ ولا تذكر التدوينات فرنسا بالاسم. وفي اليوم نفسه، يحصل Ask Maps على وظائف جديدة يجري طرحها على Android وiOS:
| الوظيفة الجديدة في Ask Maps | التوفّر المعلن |
|---|---|
| مسارات رحلات مفصّلة يومًا بيوم، قابلة للمشاركة والتصدير إلى Google Docs | حيثما يتوفّر Ask Maps |
| البحث في القوائم المحفوظة، مع معلومات التوفّر المباشرة | حيثما يتوفّر Ask Maps |
| نصائح الرحلة (ما ينبغي معرفته قبل الانطلاق) : مواقف السيارات، والشحن، والطقس، ورسوم الطرق | الولايات المتحدة أولًا |
| البحث عن مواعيد والاتصال بالأنشطة التجارية المحلية | الولايات المتحدة أولًا |
🔗 وظائف Ask Maps الجديدة (blog.google) · وصول Ask Maps إلى أوروبا (blog.google)
البحث عن المعلومات للمطورين والشركات: Monitor API من Perplexity، وVideo Intelligence في Cohere Compass
Perplexity تطلق Monitor API لمراقبة الويب أو صفحات محددة وإرسال التنبيهات عبر webhook
16 نوفمبر — تطلق Perplexity واجهة Monitor API التي تراقب الويب لحساب تطبيق أو وكيل. وتوفّر وضعين: متابعة المستجدات حول موضوع أو شركة أو سؤال عبر Perplexity Search، أو متابعة ما يصل إلى 10 صفحات محددة (أسعار منافس، أو changelog، أو سياسة) وتلقّي diff نصي يوضح ما تغيّر. ويمكن للمطور وصف هدفه بلغة طبيعية؛ ويتحقق Perplexity Decider من مدى صلة كل نتيجة بالموضوع، وموثوقية مصدرها، وجدّتها وحداثتها، ولا تُرسَل سوى التحديثات التي تتجاوز جميع العتبات، عبر webhooks موقّعة، مع درجة ثقة. وتعمل أدوات المراقبة كل 15 دقيقة، أو كل ساعة، أو يوميًا، أو أسبوعيًا، أو وفق جدول cron.
| نوع أداة المراقبة | وحدة الفوترة | السعر المعلن |
|---|---|---|
| أداة مراقبة الويب | عمليات التنفيذ الناجحة | 1 دولار لكل 1 000 |
| أداة مراقبة الصفحات | عناوين URL التي جرى جلبها | 1 دولار لكل 1 000 |
الواجهة متاحة الآن، وتستخدم المفتاح نفسه المستخدم مع واجهات Search وContext وAgent. ووفقًا لـPerplexity، قدّمت Monitor نتائج أحدث وأكثر صلة بالموضوع من مزودين آخرين لواجهات Search API، عند متابعة 60 موضوعًا لمدة ثماني ساعات.
🔗 التعريف بواجهة Monitor API من Perplexity
Cohere تتيح Video Intelligence في Compass للعثور على اللحظة الدقيقة داخل الفيديو
16 نوفمبر — تضيف Cohere الفيديو إلى Compass، منصتها للبحث المؤسسي، عبر Video Intelligence، المتاحة في معاينة خاصة. وبدلًا من إرجاع تسجيل مدته ساعة، يعثر Compass على اللحظة التي تجيب عن السؤال: مقطع مرفق بطابع زمني، وتفريغ نصي، ووصف لما يظهر على الشاشة، مع تحديد حدود المقطع وقت البحث. وتنضم مقاطع الفيديو إلى المستندات في فهرس واحد يراعي صلاحيات كل مستخدم، وتصل إليه الوكلاء عبر خادم MCP الخاص بـCompass. ووفقًا لـCohere، يحتل Compass المرتبة الأولى في المتوسط مقارنةً بسبعة نماذج embeddings للفيديو، عبر 11 مجموعة بيانات و11 133 استعلامًا، متقدمًا على أفضل بديل بمقدار 4,4 نقاط في nDCG@10. وتستقطب الشركة شركاء للمشاركة في التصميم (شركاء التصميم)، يمكنهم نشر الأداة في سحابة Cohere المُدارة أو في بيئتهم الخاصة؛ ولم تُعلن أسعارًا أو موعدًا للإتاحة العامة.
🔗 التعريف بـVideo Intelligence في Compass · إعلان @cohere
تقييم النماذج والوكلاء: JFinBench من Sakana AI في التمويل الياباني، وتقييمات الوكلاء من Together AI
JFinBench: في التمويل الياباني، لا يزال أفضل نموذج مفتوح متأخرًا عن Claude Fable 5 بمقدار 12,4 نقطة
16 نوفمبر — تنشر Sakana AI معيار JFinBench (في تدوينة مؤرخة في 17 نوفمبر بتوقيت اليابان)، المستمد من دورات عام 2026 لستة امتحانات مالية يابانية، تغطي مجالات من المحاسبة القانونية إلى الاستشارات الضريبية، والمصمم ليُجدَّد مع كل دورة امتحانات للحد من تلوّث بيانات التقييم. وقد خضع 12 نموذجًا للتقييم على 321 سؤالًا، وفيما يلي النماذج الخمسة الأولى دون أدوات:
| النموذج المُقيَّم | النتيجة دون أدوات | النتيجة مع أدوات (إطار التشغيل) |
|---|---|---|
| Claude Fable 5 | 95,8 | 96,4 (Terminus-2) |
| GPT-6 Astra | 93,6 | 97,3 (Terminus-2) |
| Gemini 3.8 Flash | 88,8 | 94,2 (Terminus-2) |
| Kimi K3.1 Pro | 83,4 | 92,9 (Kimi Code) |
| Kimi K3 | 79,9 | 91,0 (Kimi Code) |
لا يزال Kimi K3.1 Pro، أفضل نموذج مفتوح، متأخرًا عن Claude Fable 5 بمقدار 12,4 نقطة، وعن GPT-6 Astra بنحو 10 نقاط، رغم الإعلان عن تفوقه على الأخير في Terminal-Bench 4.0 (65,7 % مقابل 58,2 %، وفق أرقام الجهات المطوّرة). وترجع الإخفاقات أساسًا إلى نقص المعرفة بالنظام الياباني، لا إلى الحساب. ومع إتاحة الطرفية والوصول إلى الويب، تنخفض الفجوة بين أفضل نموذج مفتوح وأفضل نموذج احتكاري إلى 4,4 نقاط. وفي تجربة أولية لم تُحتسب ضمن النتائج، عثر DeepSeek V4.1 Flash 1017 وGemini 3.8 Flash على مفتاح OpenRouter منسي في البيئة، واستخدماه لاستدعاء نماذج أخرى.
🔗 JFinBench (Sakana AI) · ورقة JFinBench على arXiv
Together AI: تقييمات للوكلاء رفعت نسبة نجاح المهام باستخدام وثائق MCP من 67 إلى 96 %
16 نوفمبر — تشرح Together AI بالتفصيل كيف تقيس سهولة استخدام منصتها بالنسبة إلى وكلاء البرمجة، وهو ما تسميه تجربة الوكيل (تجربة الوكيل). وتُسنَد نحو عشر مهام شائعة (تشغيل مهمة دفعية، وحجز عنقود GPU، وإدارة التوسع التلقائي) إلى Claude Code داخل بيئة معزولة، وفق ثلاثة إعدادات: دون مساعدة، أو مع خادم MCP للوثائق، أو مع حزمة مهارات Together. وارتفعت نسبة نجاح المهام في إعداد MCP من 67 % في 15 يونيو إلى 96 % في 30 سبتمبر، وبلغت المهارة الموحّدة 97 % (70 من 72) في 8 أكتوبر، مقابل 82 % للإعداد الأساسي دون مساعدة؛ وتقرّ Together بأن هذه القياسات ليست قابلة للمقارنة الصارمة. وفي مهمة حجز عنقود GPU، لم يكن Sonnet 4.6 ينجح إلا في 4 محاولات من أصل 15؛ وأدّت إضافة جملتين إلى المهارة إلى رفع نسبة النجاح إلى 100 % لدى جميع النماذج المختبرة. ووفقًا لـTogether، من المقرر نشر أداة التقييم بمصدر مفتوح في الأسبوع التالي.
🔗 كيف نجعل Together AI سهلة الاستخدام لوكلاء البرمجة
الاستحواذات والشراكات: ElevenLabs تستحوذ على Kotoba، وقطاع الإعلام في LVMH يوقّع اتفاقًا مع OpenAI
ElevenLabs تعلن الاستحواذ على Kotoba، المختبر الياباني للذكاء الاصطناعي الصوتي
16 نوفمبر — تعلن ElevenLabs الاستحواذ على Kotoba، وهو مختبر ياباني للذكاء الاصطناعي الصوتي أسسه نورييوكي كوجيما وجونغو كاساي في 2023. ويغطي نموذجه Koto توليد الكلام، والتفريغ النصي، والترجمة من كلام إلى كلام لأغراض الترجمة الفورية باليابانية؛ وتستخدمه Salesforce للمحادثات اليابانية في Agentforce Voice. وتريد ElevenLabs نقل هذه الأبحاث إلى ElevenAgents، منصتها للوكلاء الصوتيين، وتخطط لتوظيف مسؤولين تجاريين والاستثمار في البنية التحتية في اليابان خلال الأشهر المقبلة. ولم تُستكمل الصفقة بعد: إذ يُتوقع إتمامها في الربع الرابع من 2026، رهنًا بالحصول على الموافقات التنظيمية، ولم يُعلن أي مبلغ.
🔗 Kotoba تنضم إلى ElevenLabs · إعلان @ElevenLabs
قطاع الإعلام في LVMH (Les Echos وLe Parisien) ينشر ChatGPT Enterprise ويعزّز ظهور محتواه في ChatGPT
16 نوفمبر — توقّع مجموعة Les Echos-Le Parisien، قطاع الإعلام في LVMH، اتفاقًا استراتيجيًا مع OpenAI. وتنشر علاماتها الـ17، ومنها Les Echos وLe Parisien وChallenges وParis Match وL’Opinion وL’Agefi، خدمة ChatGPT Enterprise وأدوات OpenAI في جميع الفرق، مع تدريب ملائم لكل مجال عمل: البحث في المستندات ومقارنتها، والترجمة الأولية، وتخصيص المنتجات للقراء والمعلنين. وفي الجانب الثاني من الاتفاق، سيحظى محتوى القطاع بظهور أكبر في ChatGPT، على هيئة ملخصات ومقتطفات موثّقة بالمصادر مع روابط إلى المقالات. وتضم المجموعة 1 800 موظف، منهم قرابة 700 صحفي، وتصل إلى أكثر من 27 مليون شخص شهريًا في فرنسا. ولم يُعلن أي مبلغ.
🔗 قطاع الإعلام في LVMH يعلن شراكة استراتيجية مع OpenAI
وكلاء البرمجة: Claude Code يختبر التطبيقات على iPhone Duo، وReplit ينشر تطبيقات وكيله في Microsoft Fabric
Claude Code على سطح المكتب يطوي iPhone Duo داخل محاكي iOS ويسلّط الضوء على إضافة Xcode من Apple
16 نوفمبر — يدعم Claude Code على سطح المكتب جهاز iPhone Duo في لوحة محاكي iOS، ضمن نسخة تجريبية عامة: يعمل التطبيق قيد التطوير على جهاز Duo مُحاكى بجوار المحادثة، ويطوي Claude الجهاز ويفتحه للتحقق من كل تخطيط. ووفقًا للوثائق، للجهاز ثلاثة أوضاع (مغلق، ومفتوح جزئيًا، ومفتوح)، ويمكن طلب زاوية للمفصل تتراوح بين 1 و179 درجة. ولتكييف تطبيق موجود، يمكن أن يقترح Claude Code مهارة App Resizability من Apple، التي ترصد مشكلات التخطيط وتقترح إصلاحات يطبّقها Claude بعد الموافقة عليها. ويتطلب ذلك جهاز Mac، وClaude Desktop v4.29.0 أو إصدارًا أحدث، وXcode 27.1 أو إصدارًا أحدث؛ وتظل اللوحة مقصورة على الجلسات المحلية، ضمن خطط Pro وMax وUltra وTeam وEnterprise، باستثناء إعداد HIPAA. وكان محاكي iOS نفسه قد وصل في 22 يوليو. وعلى صعيد الطرفية، تسلّط Anthropic الضوء على إضافة Xcode من Apple، المتاحة في السوق الرسمية منذ 6 نوفمبر، والتي تُثبَّت عبر /plugin install xcode@claude-plugins-official.
🔗 إعلان @ClaudeDevs · وثائق محاكي iOS
Replit Agent ينشر تطبيقاته في Microsoft Fabric مع الإتاحة العامة
16 نوفمبر — تعلن Replit الإتاحة العامة لتكاملها مع Microsoft Fabric، منصة البيانات من Microsoft: يصف المستخدم تطبيقًا، فيبنيه Replit Agent اعتمادًا على بيانات المؤسسة الخاضعة للحوكمة، ثم يُنشر مباشرةً في tenant Fabric الخاص بالمؤسسة. ووفقًا لصفحة الشريك، يقرأ الوكيل المخطط والجداول وتسميات الحساسية في Purview داخل OneLake دون نسخ البيانات؛ ولا يعرض التطبيق، المُجهَّز بمصادقة Microsoft Entra، لكل مستخدم سوى البيانات التي يحق له الوصول إليها، ويعتمد على Copilot في Fabric وقدرة الذكاء الاصطناعي الموجودة أصلًا في tenant. وكان التكامل قد أُطلق في Microsoft Build بالتعاون مع Leatherman، ولا تذكر صفحة الشريك أي أسعار. وفي 13 نوفمبر، كانت Replit قد وسّعته ليشمل التطبيقات التي تحتوي على قاعدة بيانات. ومع ذلك، لا تزال وثائق موصّل Fabric تصفه بأنه معاينة، مقصورة على أعضاء برنامج للمختبرين المعتمدين.
🔗 إعلان @Replit · صفحة Replit الشريكة لدى Microsoft · وثائق موصّل Microsoft Fabric
أخبار موجزة
وكلاء البرمجة وCLI
- GitHub Copilot يسحب ثلاثة نماذج — كما أُعلن في 15 أكتوبر، تغادر Claude Opus 4.8 وClaude Opus 5 وGPT-5.6 Terra معظم تجارب Copilot، لتحل محلها Claude Opus 5.5 أو GPT-6.1 Sol أو GPT-6 Luna. ويوضح سجل التغييرات أن Claude Opus 5 يخرج من قائمة الاختيار، لكنه يظل متاحًا كخيار احتياطي عندما يُرفض طلب أثناء التنفيذ. 🔗 المصدر
- Copilot CLI 1.0.113-0 — يصدر هذا الإصدار التجريبي من دون ملاحظات تفصيلية، ولا يذكر سوى إصلاحات وتغييرات؛ ويظل أحدث إصدار مستقر هو 1.0.112 الصادر في 13 نوفمبر. 🔗 المصدر
- GitHub Agentic Workflows 1.3.0 — لا يزال هذا الإصدار تجريبيًا، لكنه يُخرج دفاتر السجلات من المرحلة الاختبارية ويضيف بوابة،
require-agent-success، تمنع نشر المخرجات عند فشل مهمة الوكيل؛ ولم تعد طلبات Copilot المرفوضة بسبب سياسة الأمن السيبراني تُعاد محاولتها تلقائيًا. 🔗 المصدر - Codex CLI 0.171.0-alpha.9 — صدرت ثلاثة إصدارات تجريبية بملاحظات فارغة منذ alpha.6؛ وبحسب عناوين عمليات الإيداع الـ41 فيها، يمكن لـ
codex execالاستعانة بخادم تطبيق بعيد، وتعرض الطرفية إرشادات بشأن المسؤولية والمخاطر أثناء المراجعات. ويظل أحدث إصدار مستقر هو 0.169.0. 🔗 المصدر - Agents SDK من OpenAI — يتيح الإصدار التجريبي Python v0.24.0-alpha.8 الموافقة على استدعاء أداة أو رفضه بعد الاطلاع على وسيطاته، وربط LiteLLM أو AnyLLM، وإضافة الصوت في الزمن الحقيقي عبر WebSocket أو WebRTC أو SIP؛ أما في JavaScript، فيمكن للإصدار v0.22.0-alpha.3 تنفيذ دوال رد النداء للأدوات بالتوازي افتراضيًا. 🔗 المصدر
- Gemini CLI — يجعل تصحيح دُمج في الفرع الرئيسي، ولم يُنشر بعد، النظام يتجاهل خوادم MCP التي يحددها المسؤول إذا ظلت أوامرها أو نصوصها البرمجية قابلة للتعديل من مستخدم عادي، كان يستطيع لولا ذلك الاستفادة من الموافقة التلقائية الممنوحة لخادم مصرح به. 🔗 المصدر
- ZCode v3.18.2 — تنشر Z.ai على GitHub هذا الإصدار من بيئة التطوير بمساعدة الذكاء الاصطناعي لنظامَي macOS وWindows، من دون ملاحظات إصدار، بعد مزامنتي الشيفرة 3.18.0 و3.18.1 اللتين لم تُنشرا كإصدارين. 🔗 المصدر
- ذاكرة التخزين المؤقت لبادئات الوكلاء — توضح Together AI وOllama أن إطار التشغيل (Claude Code أو Codex أو Pi عبر
ollama launch) يجب أن يُبقي بداية المطالبة مطابقة، وأن المحرك يجب أن يوجّه كل جولة إلى وحدة GPU التي تحتوي على ذاكرة التخزين المؤقت: على امتداد 100 جولة، تُعالج 5 050 وحدة مطالبة من دون تخزين مؤقت مقابل 100 معه، وفق حساب مثالي. 🔗 المصدر - مصانع البرمجيات للفرق — يدعو زاك لويد، في مقال رأي على مدونة Warp، إلى نقل الوكلاء من إعدادات كل مطوّر على حدة (إطار التشغيل والنموذج والمهارات وMCP) إلى بنية تحتية سحابية مشتركة، موصوفة بالشيفرة ويملكها الفريق. 🔗 المصدر
مستجدات أخرى من GitHub
- AI Scan على دفعات — بات بالإمكان تشغيل تحليل ثغرات المستودعات بالذكاء الاصطناعي على ما يصل إلى 20 مستودعًا دفعة واحدة، من إعدادات المؤسسة أو صفحة تنبيهات فحص الشيفرة، ضمن معاينة عامة ومن دون ترخيص Copilot. 🔗 المصدر
- GitHub Mobile على iPhone Duo — يتكيف تصميم تطبيق iOS عند فتح الجهاز القابل للطي، ويضيف علامات تبويب عمودية للوصول إلى Copilot وطلبات السحب والمشكلات والإشعارات. 🔗 المصدر
الحوسبة والمحاكاة والروبوتات
- Lambda وNVIDIA Photonics — تربط Lambda رفوف GB300 NVL72 التي تضم إجمالًا أكثر من 10 000 وحدة GPU بمبدّلات ذات بصريات مدمجة في الحزمة (بصريات مشتركة التغليف)؛ وبحسب اختباراتها، ينخفض زمن الاستجابة بنحو 4 % على مستوى الرف وحتى نحو 10 % على مستوى مجموعة الرفوف، وتعمل الوحدات البصرية عند 36 °C مقابل 51 °C للوحدات القابلة للتوصيل. 🔗 المصدر
- Google Cloud في MLPerf Training v6.1 — في أول اختبار قياسي من MLPerf للتعلم المعزز الوكيلي، تبلغ 640 وحدة TPU Ironwood الدقة المستهدفة في 18,02 دقيقة، بحسب Google؛ وفي التدريب المسبق، تحقق 8 192 وحدة TPU Ironwood ذلك في 1,70 دقيقة و256 وحدة GPU GB300 في 31,96 دقيقة. 🔗 المصدر
- NVIDIA Cosmos — تتجاوز تنزيلات نماذج العالم المفتوحة من NVIDIA على Hugging Face 20 مليونًا، بحسب NVIDIA، من دون تحديد الفترة أو النطاق. 🔗 المصدر
- LidarVerse — تعيد NVIDIA Research تسليط الضوء على هذا النموذج الصادر في أكتوبر، الذي يولّد مسوحات LiDAR ويتنبأ بها ويعيد محاكاتها، بمعدل 10 إطارات في الثانية على وحدة H100 واحدة في النسخة المقطّرة؛ والشيفرة متاحة بترخيص Apache 2.0. 🔗 المصدر
- AI Day Seoul — تستعرض NVIDIA حصيلة فعاليتها الكورية: أكثر من 2 000 مشارك، وأكثر من 500 مطوّر تلقوا تدريبًا أو شهادة باللغة الكورية، وهاكاثون فاز به فريق FlyGate بوكلاء مبنيين على OpenShell. 🔗 المصدر
- projectsim (Kaedim) — أصبح أكثر من 200 عنصر ثلاثي الأبعاد جاهز للمحاكاة الروبوتية، منها 140 عنصرًا مفصليًا، متاحًا مجانًا، وتنضم هذه العناصر أيضًا إلى SimReady Central من NVIDIA، حيث أُتيح سبعة منها بالفعل. 🔗 المصدر
النماذج المفتوحة وHugging Face
- CI في llama.cpp — أمام 3 181 طلب سحب خلال ثلاثة أشهر وحدود خطة GitHub المجانية (10 غيغابايت من ذاكرة التخزين المؤقت، و20 مهمة متزامنة)، لم يعد الفريق يشغّل إلا المهام المتأثرة بالفروق بين التعديلات، ويخزّن ذاكرات ccache المؤقتة في Hugging Face Buckets ويشغّل معظم مهام Linux x64 على Hugging Face Jobs. 🔗 المصدر
- Accelerate v1.16.0 — باتت مكتبة التدريب الموزّع من Hugging Face تتطلب Python 3.11 وPyTorch 2.6، وتعتمد أكثر على
torch.acceleratorللمسرّعات المسجّلة لدى PyTorch، وتزيل PiPPy وMS-AMP وFP8RecipeKwargs. 🔗 المصدر - Tiny Aya Global — تختبر خمس تدوينات مجتمعية، معظمها من هاكاثون Lexsi Labs، النموذج الصغير متعدد اللغات من Cohere Labs: ترتفع نسبة نجاح وكيل قواعد بيانات من 0,5 إلى 49,1 % خلال ثلاث جولات من الإصلاح الذاتي، ويقلّل توجيه الرفض بدرجة كبيرة الاستجابات الضارة بالبنغالية والسواحيلية، مقابل تضاعف حالات الرفض المفرط، بحسب المؤلفين. 🔗 المصدر
- Modular Diffusers — يوضح دليل كيفية استخدام نموذج لم يُدمج بعد في Diffusers، عبر تحويل أوزانه ونشر وحدات على Hub؛ وقد أوكل المؤلف العمل إلى Claude Code مع Claude Opus 5.5، بعدما لم ينجح التحويل باستخدام Astra. 🔗 المصدر
- نماذج صغيرة على الهاتف — ينشر مطوّر مساري شراء كاملين على Amazon نفّذهما محليًا Qwen3.5 0,8B و2B على هواتف Android، بحجم وسيط للمدخلات يبلغ 45 رمزًا لكل استدعاء؛ واستغرق الأبطأ، على Galaxy A04e، 4 ساعات و20 دقيقة لتنفيذ 578 استدعاء. 🔗 المصدر
- Ask AdMob — تقدّم Google وكيلًا حواريًا بُني باستخدام Gemini داخل حساب AdMob، وسيخضع للاختبار في الأشهر المقبلة، وتنشر من الآن مهارات AdMob لوكلاء البرمجة، وتُعد خادم MCP قيد الاختبار المبكر، سيتاح لمزيد من المطوّرين في مطلع 2027. 🔗 المصدر
- Google Flow — أضافت Google في 12 نوفمبر إلى استوديو الإبداع الخاص بها خمس أدوات صممها فنانون، منها Pocket Studio، الذي يستخرج زوايا كاميرا متعددة من لقطة واحدة بالهاتف، وPixel Machine للأنماط ذات الطابع القديم. 🔗 المصدر
الصوت والصورة والفيديو
- Nemotron 3.5 Transcribe — تنقل NVIDIA خبر تصدّر نموذجها المفتوح مؤشر تمييز المتحدثين الخاص بـArtificial Analysis المنشور في 13 نوفمبر: 3,3 % من الكلمات منسوبة إلى المتحدث الخطأ (WDER) عبر 97 محادثة تضم من شخصين إلى ثمانية أشخاص، متقدمًا على Voxtral Small Transcribe 3 (7,5 %). 🔗 المصدر
- FLUX: In Production — تطلق Black Forest Labs مسابقة لأفلام مُنتجة بالذكاء الاصطناعي، تكتب استوديوهات شريكة موجزاتها الإبداعية، بجوائز تتجاوز 25 000 دولار؛ وتُقام عبر الإنترنت من 30 نوفمبر إلى 13 ديسمبر. 🔗 المصدر
- Kling Image 4.0 — تعلن Kling قرب وصول نموذج الصور الجديد الخاص بها، من دون موعد أو مواصفات. 🔗 المصدر
الشركات والتدريب
- Autotorino وElevenAgents — تُسند مجموعة وكالات السيارات الإيطالية، التي تتلقى نحو 100 000 مكالمة شهريًا، مكالماتها إلى وكيل صوتي يصنّف الطلب وينشئ سجل العميل المحتمل؛ وقد أصبح حجم المكالمات المعالجة آليًا أكثر من ضعف ما كان عليه. 🔗 المصدر
- وكلاء dots لدى Holiday Extras — في دراسة حالة من OpenAI، يرصد وكيل dot الخاص بأحد المسؤولين إطلاق ميزة من تلقاء نفسه، ويستعلم من Google BigQuery ويقدّم تقريرًا من دون أن يُطلب منه ذلك؛ ويُعدّ آخر تقارير أثناء تنقّل مستخدمه. 🔗 المصدر
- OpenAI وThe King’s Trust — تقدّم OpenAI مبلغ 1 مليون جنيه إسترليني للجمعية البريطانية لتدريب ما يصل إلى 25 000 شاب على الذكاء الاصطناعي خلال 18 شهرًا، مع إعطاء الأولوية لمن لا يعملون ولا يدرسون ولا يتلقون تدريبًا. 🔗 المصدر
- الذكاء الاصطناعي في التدريب بحسب Synthesia — تقرير سنوي ثالث، وأكثر من 800 مشارك في أكثر من 25 دولة: تستخدم 87 % من الفرق التي تعتمد الذكاء الاصطناعي هذه التقنية لتوليد المحتوى، لكن 29 % فقط تطبّق التعلم المخصص، مقابل 70 % كانت تطبّقه أو تخطط له قبل عام. 🔗 المصدر
Perplexity
- تظليل الأرقام في المصادر — في Computer وTeammates، بات فتح المستند المصدر لإجابة يظلّل الرقم المقتبس بعينه، على الويب لجميع المستخدمين، بحسب @AskPerplexity. 🔗 المصدر
- دليل مقارنة الذكاء الاصطناعي بـAGI — تنشر Perplexity دليلًا يميّز الذكاء الاصطناعي المستخدم اليوم عن AGI، ويقترح منهجًا للتحقق من إعلان عن بلوغ AGI؛ ويذكر حصول Claude Opus 5.5 على 21,3 % في Remote Labor Index بتاريخ 9 أكتوبر. 🔗 المصدر
ما الذي يعنيه ذلك
باتت الفجوة بين النماذج المفتوحة والمغلقة تُقاس بالدولارات بقدر ما تُقاس بالنقاط. تنخفض أسعار Qwen4-Max عن أسعار Qwen3.8-Max ويعلن خفض التكلفة لكل مهمة بنسبة 62 %، لكنه لا يتصدر إلا 4 من أصل 16 اختبارًا في جدوله الخاص، ولا يوجد ما يشير إلى إتاحة أوزانه بشكل مفتوح. وتراهن Hugging Face على الجانب الآخر: بإسناد التوجيه إلى OpenRouter، تستند إلى نماذج مفتوحة تمثّل 71,7 % من رموز OpenRouter وتبلغ تكلفتها في المتوسط نحو ربع التكلفة. غير أن التدوينة نفسها تُقرّ بفارق 19 نقطة في صدارة Intelligence Index، ويقيس JFinBench فجوة قدرها 12,4 نقطة في التمويل الياباني من دون أدوات، تنخفض إلى 4,4 مع الوصول إلى الويب: في المجالات التي قلّما تُقاس، يعود تقدم النماذج المغلقة أولًا إلى ما تعرفه.
يغادر الوكلاء الطرفية ليدخلوا أنظمة الأعمال الخاضعة للحوكمة. في ChatGPT for Healthcare، يربط الوكيل الذي يتحكم في الحاسوب السجل الطبي ببوابة شركة تأمين، في ظل ضوابط وصول حسب الأدوار وسجلات تدقيق واتفاقية BAA؛ ولدى Replit، ينشأ التطبيق الذي يبنيه Agent داخل مستأجر Fabric الخاص بالعميل، بصلاحيات Entra ID وتسميات Purview الخاصة به. ويستفيد المهاجمون من هذا التحول أيضًا: بحسب GTIG، نفّذ إطار عمل سلسلة من اكتشاف الثغرات واستغلالها من دون تدخل بشري، وحوّلت مجموعة إعدادات Claude Code إلى فخ لتثبيت باب خلفي. ويذكّر تصحيح Gemini CLI المتعلق بخوادم MCP القابلة للتعديل بذلك بطريقته: قيمة الموافقة التلقائية على أداة مرهونة بسلامة النص البرمجي الذي يشغّلها.
بات العلم الحجة المشتركة للحوسبة والوكلاء. تقدّم NVIDIA منتج Rubin HPC ومكتباتها CUDA-X بوصفها أدوات المحاكاة التي سيستدعيها الوكلاء لاختبار أفكارهم، وتريد Perplexity بناء عالِم آلي يعمل على أكثر من 10 000 وحدة GPU، وتطلق OpenAI مدونة يروي فيها فيزيائي كيف قاد GPT-6 Astra العمل على برهان، مع مضاعفة هدف برنامجها للباحثين. ولا تزال الوعود تسبق النتائج: يُنتظر Rubin HPC في 2028 من دون إعلان عن الذاكرة أو FLOPS، ولا تقدّم Frontier Research نموذجًا أو ورقة بحثية جديدة، ولا يزال تعريف كريغ «مرشحًا»، وتقيس دراسة OpenAI إنتاجية مُبلّغًا عنها ذاتيًا، من دون إثبات أثر سببي.
وتتغير طريقة القياس أيضًا. تتيح OpenAI نقاط حفظ نماذجها وعمليات تدريبها لـApollo Research وMETR وTransluce وGoodfire، لكنها تحتفظ بالتحكم في ما يُحجب من المحتوى ومواعيد النشر. تُظهر Together AI أن جملتين في مهارة ترفعان أداء نموذج من 4 حالات نجاح من أصل 15 إلى 100 %، ما يحدّ من دلالة الفروق بين النماذج المقاسة من دون توجيه. وتذكّر واقعة JFinBench، التي عثر فيها نموذجان على مفتاح OpenRouter منسي لتشغيل نماذج أخرى، بأن التقييم باستخدام الأدوات يقيس أيضًا ما تضعه البيئة في متناول اليد. ويظل تحسّن أداء Vera Rubin بأكثر من 10 أضعاف في MLPerf Endpoints نتيجة أولية إلى أن تتحقق منه MLCommons.
المصادر
- Qwen4-Max: وصل زميلك الجديد (تدوينة Qwen)
- بطاقة qwen4-max على QwenCloud
- الإعلان عن Qwen4-Max (@Alibaba_Qwen)
- مزيد من الطرق لدفع الرعاية قدمًا باستخدام ChatGPT for Healthcare (OpenAI)
- تطوير وكلاء استخدام الحاسوب للفرق الصحية (OpenAI)
- Rubin HPC (مدونة NVIDIA)
- إعلانات NVIDIA في SC26
- Vera Rubin في MLPerf Training وEndpoints (مدونة NVIDIA)
- Slurm والحوسبة الكمية (مدونة NVIDIA)
- مكتبات CUDA-X للعلوم (مدونة NVIDIA)
- Hugging Face وOpenRouter يوحّدان جهودهما (مدونة Hugging Face)
- إعلان @huggingface
- تقديم Perplexity Frontier Research
- إعلان @perplexity_ai
- research.perplexity.ai
- سلسلة منشورات أندرو غوردون ويلسون (@andrewgwils)
- سلسلة منشورات دينيس ياراتس (@denisyarats)
- خطوة نحو تعريف النموذج المعياري على شبكة (OpenAI)
- مدونتنا الجديدة للعلوم (OpenAI)
- توسيع إتاحة الذكاء الاصطناعي للعلماء (OpenAI)
- العلوم عند آفاقها المتقدمة: كيف يستخدم العلماء ChatGPT (OpenAI)
- مرحلتنا الأولى من التقييمات المدمجة (OpenAI)
- تعزيز مكافحة الاعتداء الجنسي على الأطفال عبر الإنترنت (OpenAI)
- سجل تغييرات API من OpenAI
- متتبّع تهديدات الذكاء الاصطناعي من GTIG (Google Cloud)
- ملخص تقرير GTIG (blog.google)
- Gemini Notebook: مواقع تفاعلية انطلاقًا من المصادر (blog.google)
- إعلان @Gemini_Notebook
- الأصوات الإقليمية في تطبيق Gemini (blog.google)
- الوظائف الجديدة في Ask Maps (blog.google)
- وصول Ask Maps إلى أوروبا (blog.google)
- تقديم Monitor API من Perplexity
- تقديم Video Intelligence في Compass (Cohere)
- الإعلان عن Video Intelligence (@cohere)
- JFinBench (Sakana AI)
- ورقة JFinBench على arXiv
- كيف نجعل استخدام Together AI سهلًا لوكلاء البرمجة
- انضمام Kotoba إلى ElevenLabs
- إعلان @ElevenLabs
- قطاع الإعلام في LVMH يعلن عن شراكة استراتيجية مع OpenAI
- إعلان @ClaudeDevs
- وثائق محاكي iOS في Claude Code
- إعلان @Replit
- صفحة شراكة Replit مع Microsoft
- وثائق موصّل Microsoft Fabric (Replit)
- إيقاف نماذج في GitHub Copilot (سجل تغييرات GitHub)
- Copilot CLI 1.0.113-0 (GitHub)
- GitHub Agentic Workflows 1.3.0 (GitHub)
- Codex CLI 0.171.0-alpha.9 (GitHub)
- Agents SDK Python v0.24.0-alpha.8 (GitHub)
- PR 30283 في Gemini CLI (GitHub)
- ZCode v3.18.2 (GitHub)
- تهيئة النماذج المفتوحة لتنفيذ مهام الوكلاء طويلة الأمد (Together AI وOllama)
- تدوينة زاك لويد حول مصانع البرمجيات (Warp)
- AI Scan عبر مستودعات متعددة (سجل تغييرات GitHub)
- GitHub Mobile على iPhone Duo (سجل تغييرات GitHub)
- Lambda وNVIDIA Photonics (مدونة NVIDIA)
- نتائج Google Cloud في MLPerf Training v6.1 (blog.google)
- NVIDIA Cosmos، 20 مليون عملية تنزيل (@NVIDIAAI)
- LidarVerse (@NVIDIAAI)
- حصيلة فعالية AI Day Seoul (مدونة NVIDIA)
- عناصر محاكاة مجانية من projectsim (مدونة Hugging Face)
- CI لمشروع llama.cpp على Hugging Face Buckets وJobs (مدونة Hugging Face)
- Accelerate v1.16.0 (GitHub)
- Efficient Healer على Tiny Aya Global (مدونة Hugging Face)
- نماذج جديدة باستخدام Modular Diffusers (مدونة Hugging Face)
- مسارات طويلة على الهاتف باستخدام نماذج صغيرة (مدونة Hugging Face)
- أدوات الذكاء الاصطناعي الجديدة في AdMob (blog.google)
- الأدوات الخمس الجديدة في Google Flow (blog.google)
- Nemotron 3.5 Transcribe في مؤشر تمييز المتحدثين (@NVIDIAAI)
- FLUX: في بيئة الإنتاج (@bfl_ai)
- Kling Image 4.0 (@Kling_ai)
- Autotorino وElevenAgents (ElevenLabs)
- في Holiday Extras، تبدأ dots العمل قبل أن يطلب منها أحد ذلك (OpenAI)
- The King’s Trust وOpenAI (OpenAI)
- تقرير Synthesia حول الذكاء الاصطناعي في التدريب
- إبراز الأرقام في Computer وTeammates (@AskPerplexity)
- AGI مقابل AI (Perplexity)