ai-powered-markdown-translatorArtículo traducido del fr al es con gpt-6.1-sol.
Qwen habilita Qwen4-Max en su API: un modelo MoE de 2,4T parámetros, con un contexto de 1M tokens, a un precio inferior al de Qwen3.8-Max. OpenAI amplía sus agentes que manejan el ordenador a ChatGPT for Healthcare y ChatGPT for Clinicians, NVIDIA anuncia en SC26 Rubin HPC, una GPU de simulación prevista para 2028, junto con los primeros resultados de Vera Rubin en MLPerf Training, y Hugging Face confía a OpenRouter el enrutamiento de sus Inference Providers. Por su parte, Perplexity lanza Perplexity Frontier Research, que aspira a crear un científico automatizado con más de 10 000 GPU.
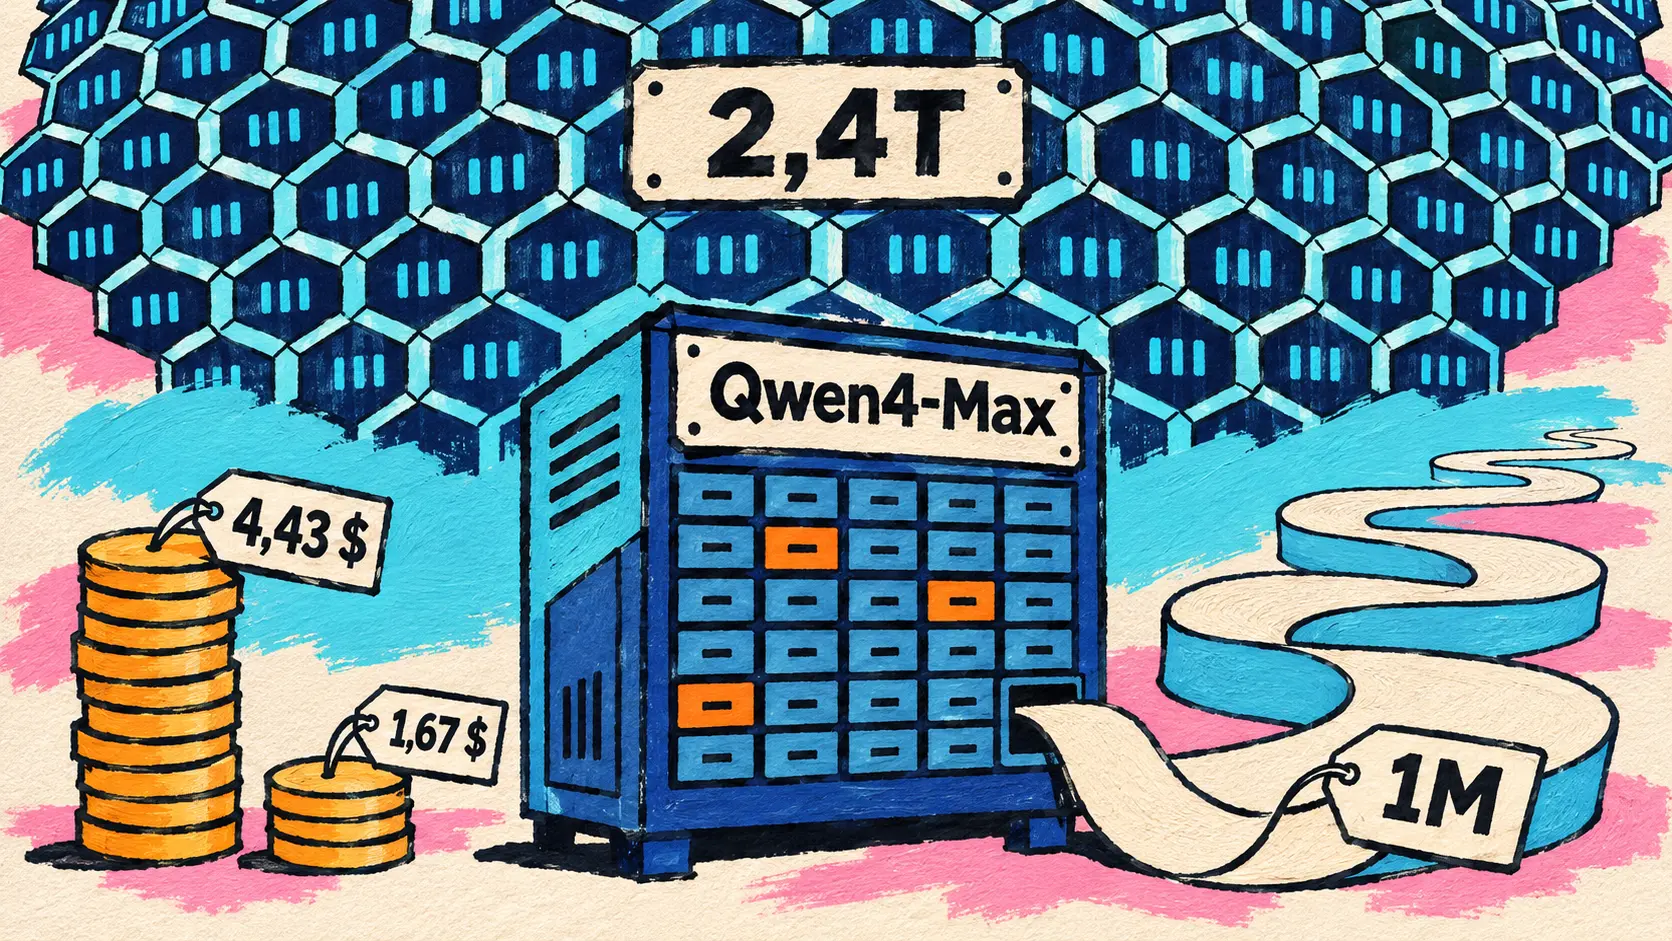
Qwen4-Max llega a la API de QwenCloud: MoE de 2,4T parámetros, contexto de 1M tokens y precios más bajos
16 de noviembre — Cinco días después de la versión preliminar cubierta el 11 de noviembre, Qwen habilita Qwen4-Max en la API de QwenCloud con el identificador qwen4-max, acompañado de una extensa entrada técnica. Es el primer modelo de la serie Qwen4: se publicarán modelos Qwen4 más pequeños con pesos abiertos, sin fecha, pero no se ha anunciado lo mismo para Max. El modelo también se ofrece en QwenWork, Qoder y Qwen Studio, y desde ese mismo día en OpenRouter, Vercel AI Gateway, Novita AI y OpenCode Go.
La arquitectura es nueva. Este modelo de mezcla de expertos (Mixture of Experts, MoE) cuenta con 2,4T parámetros en su estructura principal, de los que se activan 71B por token, más 328B parámetros de N-gram Embedding. De cada cuatro capas, tres Gated DeltaNet comprimen el historial en un estado de tamaño fijo; la cuarta, basada en Qwen Sparse Attention, selecciona el contexto útil por bloques. El modelo dispone de visión nativa y un contexto de 1M tokens: 991K de entrada y 131K de salida, 983K y 262K en modo de razonamiento, según la página de QwenCloud.
| Tipo de tarifa (QwenCloud, por millón de tokens) | Precio anunciado |
|---|---|
| Entrada | 1,5 dólares |
| Salida | 4,5 dólares |
| Entrada con cache implícito | 0,075 dólares |
| Creación de cache explícito (5 minutos / 1 hora) | 1,875 / 3 dólares |
Según Qwen, todas estas tarifas son inferiores a las de Qwen3.8-Max, y el cache implícito baja un 70 %. En sus evaluaciones internas, Qwen también anuncia una reducción del consumo de tokens de entre el 24 y el 35 % según el nivel de esfuerzo en Work360, su marco de 721 especialidades profesionales, y de alrededor del 48 al 49 % en Terminal-Bench 4.0. El coste medio de una tarea de Work360 pasa de 4,43 a 1,67 dólares, es decir, −62 % según la entrada en inglés; la versión en chino, en yuanes, indica −58 %. En Work360, Qwen4-Max obtiene 52,69 frente a 47,74 de Qwen3.8-Max.
Frente a Opus 5.5, GPT-6.1 Sol, GPT-6 Astra y Kimi K3.1, la tabla publicada por Qwen sigue mostrando resultados desiguales: Qwen4-Max solo lidera 4 de las 16 pruebas, DeepSWE v1.1, Agents’ Last Exam v1.1, HLAB-Vals-1.1 y BioMysteryBench. Selección:
| Benchmark (ámbito) | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|
| DeepSWE v1.1 (código agéntico) | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| HLAB-Vals-1.1 (agente jurídico) | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| BioMysteryBench (bioinformática) | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| Terminal-Bench 4.0 (terminal agéntico) | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench (replicación de software) | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| Humanity’s Last Exam | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
Las clasificaciones de terceros citadas por Qwen lo sitúan en el 6.º puesto de Code Arena WebDev (1 750 puntos preliminares) y en el 11.º del Vals Index (63,20 %), como primer modelo chino. Artificial Analysis le otorga 43 puntos en su Intelligence Index con esfuerzo xhigh, 3 puntos por detrás de Kimi K3.1 Pro, con un coste por tarea aproximadamente un 11 % menor.
More to come! The open weights of smaller Qwen4 models will be released. Stay tuned.
🇪🇸 ¡Esto aún no ha terminado! Se publicarán los pesos abiertos de modelos Qwen4 más pequeños. Estad atentos. — @Alibaba_Qwen en X
🔗 Qwen4-Max: Tu nuevo compañero de equipo ha llegado (entrada de Qwen) · Ficha de qwen4-max en QwenCloud
ChatGPT for Healthcare: agentes que manejan el ordenador, investigación clínica y más de 20 plugins de salud
16 de noviembre — OpenAI amplía ChatGPT for Healthcare en tres direcciones. Primero, los agentes de uso del ordenador (computer-use agents), que leen la pantalla, hacen clic, escriben y pasan de una aplicación a otra, llegan a ChatGPT Work y Codex para los clientes de ChatGPT for Healthcare, según la configuración de su espacio de trabajo, y para los profesionales clínicos de ChatGPT for Clinicians, la oferta gratuita reservada a profesionales clínicos verificados en Estados Unidos. La misma capacidad está disponible en la API. El caso típico: trasladar información entre programas que no se comunican, como la historia clínica electrónica y el portal de una aseguradora para una solicitud de autorización de IRM. El uso del ordenador ya existía en ChatGPT Work y Codex desde el 9 de julio; la novedad es su apertura a los espacios de salud, con controles de acceso por rol, registros de auditoría y pasos de aprobación configurables. Los flujos conformes con HIPAA siguen limitados a los servicios elegibles cubiertos por un BAA.
OpenAI publica dos series de cifras, que deben leerse por separado: su evaluación interna de la mensajería de la historia clínica y HealthAdminBench, un benchmark independiente de investigadores de Stanford dedicado a las tareas administrativas (autorizaciones previas, recursos, pedidos de equipamiento).
| Evaluación publicada | Modelo y configuración | Resultado anunciado |
|---|---|---|
| Mensajería de la historia clínica (OpenAI, 325 tareas revisadas) | GPT-6 Astra | 99 % de las tareas consideradas clínicamente seguras |
| Misma evaluación, 646 valoraciones de médicos | GPT-6 Astra | 93 % «muy» o «extremadamente» útil |
| HealthAdminBench (Stanford) | GPT-6 Astra, esfuerzo máximo | 94,3 % de los puntos de la rúbrica |
| HealthAdminBench (Stanford) | GPT-6 Luna, esfuerzo máximo | 91,8 %, por 8,5 centavos por tarea |
En HealthAdminBench, GPT-6 Luna obtiene un 91,8 % con un coste un 98 % inferior, es decir, 8,5 centavos por tarea. En la práctica, CVS Health ya utiliza estos agentes en producción: uno resolvió en un fin de semana el trabajo pendiente de envío de documentos acumulado durante meses, otro gestiona los pasos del sistema de decenas de miles de consultas al día, y la empresa publica en open source su Agent Kit, creado con el Agents SDK de OpenAI. Cigna Healthcare afirma haber pasado del concepto al despliegue en menos de ocho semanas; en Ambience, el agente se detiene y pide la opinión del profesional clínico cuando la historia clínica es ambigua; Abridge desarrolla agentes para el hospital.
Después vienen las otras dos áreas. La investigación clínica, que encuentra, evalúa y cita la evidencia médica, recibe mejores puntuaciones en las ocho dimensiones medidas en una evaluación a ciegas de más de 1 300 revisiones realizadas por médicos. Y 21 nuevos plugins de salud (UpToDate Expert AI, Oracle HDI, Trizetto, Stedi, Luma Health, Metriport…) permiten consultar un protocolo, comprobar la elegibilidad de un seguro o coordinar citas desde la conversación; el administrador del espacio de trabajo debe activarlos, y ChatGPT for Clinicians solo recibe una parte de ellos.
🔗 Más formas de impulsar la atención con ChatGPT for Healthcare · Avances en los agentes de uso del ordenador para los equipos sanitarios
NVIDIA en SC26: Rubin HPC para la simulación científica, Vera Rubin en MLPerf, Slurm para los procesadores cuánticos y bibliotecas CUDA-X
16 de noviembre — En la conferencia de computación de alto rendimiento SC26, NVIDIA lanza una serie de anuncios orientados a la ciencia. El principal es Rubin HPC, una nueva GPU de la plataforma Vera Rubin diseñada para la simulación y el procesamiento de datos en ciencia, ingeniería y analítica, en ámbitos como el clima, la genómica o el riesgo financiero.
La ficha publicada es escueta. NVIDIA destaca más de 50 000 núcleos CUDA en una sola GPU, una cifra «récord» según la empresa, una aceleración de datos dispersos (sparse data acceleration) destinada a mantener alimentados esos núcleos, y un enlace NVLink de séptima generación entre GPU. No se citan la capacidad de memoria, la potencia en FLOPS, el precio ni ningún socio.
El argumento central es el equilibrio. Según NVIDIA, la mayoría de las cargas científicas consisten en buscar unos pocos valores dispersos en un enorme conjunto de datos, calcular y repetir a muy gran escala. Por eso, Rubin HPC aumenta el movimiento de datos al ritmo del cálculo, para acelerar las operaciones con matrices dispersas, los cálculos de stencil, las ordenaciones y las reducciones. NVIDIA vincula esta GPU con su discurso sobre los agentes: un agente que explora más moléculas, materiales o diseños necesita más simulaciones para poner a prueba sus ideas, y las bibliotecas CUDA-X le proporcionan implementaciones optimizadas. La fecha queda lejos: Rubin HPC se espera para 2028.
| Característica anunciada | Valor indicado por NVIDIA |
|---|---|
| Núcleos CUDA | más de 50 000 en una sola GPU |
| Interconexión entre GPU | NVLink de séptima generación |
| Función específica | aceleración de datos dispersos |
| Disponibilidad prevista | 2028 |
🔗 Rubin HPC (blog de NVIDIA) · Los anuncios de NVIDIA en SC26
Vera Rubin debuta en MLPerf Training v6.1 y MLPerf Endpoints, con hasta 2 veces el rendimiento de GB300 NVL72 por GPU
16 de noviembre — El ciclo MLPerf Training v6.1 marca la primera participación de Vera Rubin NVL72 en el entrenamiento: hasta 2 veces el rendimiento por GPU de un GB300 NVL72, unos resultados que NVIDIA presenta como preliminares. En DeepSeek-V3, pasar de 256 a 1 024 GPU Vera Rubin mantiene una eficiencia de alrededor del 97 % y reduce el entrenamiento de 16 minutos a unos cuatro. La mayor configuración del ciclo cuenta con 10 240 GPU, con GB300 en NVIDIA y con GB200 en Microsoft Azure. Según NVIDIA, su plataforma es la única que tiene resultados en todas las pruebas.
NVIDIA también presenta sus primeros resultados en MLPerf Endpoints v1.0, que mide flujos de trabajo agénticos reales. En Kimi K3, Vera Rubin NVL72 ofrecería más de 10 veces el rendimiento por vatio de un GB300 NVL72 a la misma velocidad de respuesta: un resultado provisional, pendiente de verificación por MLCommons, que compara 32 aceleradores Vera Rubin con 48 aceleradores GB300 en el umbral de 50 tokens por segundo y por usuario. Vera Rubin ya aparecía en versión preliminar en MLPerf Inference, del que se informó el 16 de septiembre.
🔗 Vera Rubin en MLPerf Training y Endpoints (blog de NVIDIA)
Slurm 26.11 incorporará los procesadores cuánticos, CUDA-Q se amplía
16 de noviembre — NVIDIA amplía Slurm, el gestor de tareas de los superordenadores, a los procesadores cuánticos (QPU). Hasta ahora, conectar una QPU a un centro de cálculo exigía un desarrollo específico para cada combinación de procesador y centro; ahora, un fabricante describe su hardware en un simple archivo y obtiene una interfaz válida en todas partes, a través de las interfaces QRMI y QDMI. Alice & Bob, IBM, IQM, Pasqal, Quantinuum y MQSC lo adoptan, y Slurm 26.11 debería publicarse más adelante en noviembre. NVIDIA justifica este trabajo por el crecimiento del parque: cerca de 30 centros de cálculo despliegan más de 50 QPU.
La plataforma CUDA-Q incorpora un servidor de decodificación para la corrección de errores cuánticos (CUDA-Q QEC), cuyo decodificador TCBP-JOBS sería 13 000 veces más rápido que la referencia del sector, primitivas tolerantes a fallos (Fermilab ya ha realizado con CUDA-Q, en tres semanas, estudios que habrían llevado cinco meses), así como CUDA-Q Algorithms y CUDA-Q Pulse para los fabricantes de hardware. Estas cifras de mejora proceden de NVIDIA.
🔗 Slurm y la computación cuántica (blog de NVIDIA)
CUDA-X para la ciencia: cuSpa y HMMER en GPU en open source, correlación del Event Horizon Telescope en ocho minutos
16 de noviembre — NVIDIA acompaña Rubin HPC con bibliotecas CUDA-X para la investigación, presentadas como herramientas que los agentes pueden invocar. En astronomía, el módulo cuPhoton.xBeam reduce la correlación de las observaciones del Event Horizon Telescope de más de un mes a ocho minutos, tanto en un clúster multi-GPU como en un DGX Spark. En biología, cuSpa, recientemente publicado en open source, hace que los cálculos de polígonos celulares sean 900 veces más rápidos que en CPU en el Memorial Sloan Kettering Cancer Center, y la versión GPU de HMMER, también en open source, es hasta 84 veces más rápida en Basecamp Research. rapids-singlecell ahora se distribuye en un contenedor «listo para los agentes» (200 veces más rápido en Therna Biosciences). En química, Daviator, una colección de kernels GPU para el software VASP, llega a NVIDIA ALCHEMI con cálculos hasta 22 veces más rápidos y hasta un 75 % más baratos, pero aún no está disponible; cuPotential, lanzado el 14 de octubre, logra que lo adopten cinco entidades, entre ellas Cadence.
🔗 Bibliotecas CUDA-X para la ciencia (blog de NVIDIA)
Hugging Face confía a OpenRouter el enrutamiento de los modelos de lenguaje de sus Inference Providers
16 de noviembre — Hugging Face y OpenRouter se asocian: los Inference Providers de Hugging Face abandonan su enrutador propio y dejan que OpenRouter elija el proveedor de cada llamada a un modelo de lenguaje. Clément Delangue presenta el anuncio como la primera parte de la colaboración. Nada cambia en el código cliente: el mismo token de Hugging Face, el mismo endpoint. El enrutador acepta las API Chat Completions y Responses de OpenAI, así como la API Messages de Anthropic, y Hugging Face publica guías para Claude Code, Codex, OpenCode, Pi y Hermes Agent.
La diferencia está en el enrutamiento. Inference Providers elegía un proveedor y devolvía su error tal cual; OpenRouter elige según el precio, la velocidad y la fiabilidad medidos en tiempo real, y vuelve a intentar la llamada en otro proveedor si el primero falla. Unos sufijos imponen una política o un proveedor (:fastest, :cheapest, zai-org/GLM-5.3:novita), y cada conversación permanece en el proveedor que conserva su caché de prompt.
| Cambio anunciado | Detalle según el artículo |
|---|---|
| Errores de capacidad (medición de OpenRouter) | −46 % |
| Tiempo hasta el primer token y rendimiento (medición de OpenRouter) | mejorado un 16,9 % y +16,3 % |
| Facturación | precio del proveedor, sin margen añadido por Hugging Face |
| Créditos mensuales incluidos | 2 dólares (PRO), 2 dólares por puesto (Team, Enterprise) |
| Páginas de modelos | pestañas Providers y Metrics: precio, velocidad, disponibilidad en 24 horas |
| Cambio incompatible | se rechazan las claves API personales de proveedores para los modelos de lenguaje |
La imagen, el vídeo y el audio siguen pasando directamente por Inference Providers, sin OpenRouter, y las claves personales siguen siendo válidas para los proveedores de imagen y vídeo. La vinculación de una cuenta de OpenRouter con Hugging Face y el enrutamiento de otras tareas a través de OpenRouter se anuncian para más adelante, sin fecha.
El artículo se basa en las cifras de OpenRouter: los modelos abiertos representaban el 71,7 % de los tokens servidos a finales de septiembre de 2026, frente al 26,8 % en octubre de 2025, con un precio medio de 0,28 y 1,62 dólares por millón de tokens (entrada, salida), frente a 1,27 y 6,36 dólares para los modelos cerrados. También reconoce la diferencia en la parte alta de la clasificación: Kimi K3.1 Pro, el mejor modelo abierto, obtiene 46 en el Artificial Analysis Intelligence Index frente a 65 de Claude Fable 5.2, por aproximadamente una séptima parte del coste por tarea (3,68 frente a 26,54 dólares).
🔗 Hugging Face y OpenRouter unen fuerzas (blog de Hugging Face) · Anuncio de @huggingface
Perplexity Frontier Research: una iniciativa de investigación abierta que aspira a crear un científico automatizado, con más de 10 000 GPU
16 de noviembre — Perplexity lanza Perplexity Frontier Research, una iniciativa cuyo objetivo es construir un «científico investigador automático» (científico investigador automático): un sistema de IA capaz de llevar a cabo por sí solo el ciclo de investigación, de la pregunta a la hipótesis, del experimento a la revisión de sus convicciones. Perplexity contrapone esta ambición a las predicciones de «caja negra» en tareas limitadas: se trata de producir conocimientos nuevos e interpretables.
We aim to create an automated research scientist. Research is a loop that involves asking the right questions, hypothesizing, navigating ambiguity, designing experiments, and updating beliefs. We think this loop can run inside software, for anyone.
🇪🇸 Queremos crear un investigador científico automatizado. La investigación es un ciclo que consiste en plantear las preguntas adecuadas, formular hipótesis, lidiar con la ambigüedad, diseñar experimentos y revisar las propias convicciones. Creemos que este ciclo puede ejecutarse en un software, para todo el mundo. — @andrewgwils en X
El programa se organiza en seis pilares: orquestación multiagente, preentrenamiento, aprendizaje continuo, aprendizaje por refuerzo, sistemas y evaluaciones. El sitio específico precisa que el equipo preentrenará modelos de pesos abiertos, eficientes y especializados, y que en la orquestación busca la mejor calidad para cada nivel de coste. Denis Yarats insiste en el aprendizaje por refuerzo a gran escala, con más de 10 000 GPU, alimentado con datos sintéticos y entornos derivados del uso real de Perplexity; toda la infraestructura, desde la investigación hasta los sandboxes, se desarrolla internamente.
| Elemento del anuncio | Compromiso de Perplexity |
|---|---|
| Potencia de cálculo | más de 10 000 GPU |
| Pilares de investigación | 6 |
| Publicaciones prometidas | artículos, entradas de blog, datos, modelos y código |
| Ciudades de contratación | San Francisco, Palo Alto, Nueva York, Londres |
| Fecha límite prioritaria para presentar candidaturas | 5 de diciembre |
Andrew Gordon Wilson figura en el sitio como responsable de investigación de la iniciativa. El anuncio también es una convocatoria de candidaturas, acompañada de una beca de investigación para trayectorias predoctorales y posdoctorales. Ningún modelo, benchmark ni artículo nuevo acompaña el lanzamiento: el sitio agrupa bajo la denominación Frontier Research trabajos ya publicados, como WANDR, Decider, SPACE, Brain o JOLT.
🔗 Presentación de Perplexity Frontier Research · Anuncio de @perplexity_ai · research.perplexity.ai · Hilo de @denisyarats
IA e investigación científica en OpenAI: un blog específico inaugurado por el físico Nathaniel Craig, ChatGPT for Academic Researchers se amplía a 200 000 investigadores
Un blog científico, inaugurado con una definición candidata del Modelo Estándar en una red construida con GPT-6 Astra
15 de noviembre — OpenAI abre un blog dedicado a la ciencia, donde investigadores y equipos compartirán resultados y métodos, incluida la forma de verificar el trabajo. La primera entrada invitada la firma Nathaniel Craig, físico de partículas de la Universidad de California en Santa Bárbara y científico visitante en OpenAI.
En ella presenta una prepublicación de octubre, preparada con GPT-6 Astra, que propone una definición candidata del Modelo Estándar en una red, una cuadrícula que discretiza el espacio-tiempo. Como la fuerza débil distingue entre partículas «izquierdas» y «derechas», la formulación en una red hace aparecer partículas asociadas parásitas, y la regla de fase seguía sin resolverse para el Modelo Estándar completo desde hacía más de 25 años. Según Craig, GPT-6 Astra encontró cómo transportar los campos a cuadrículas más finas y lideró la demostración detallada, revisada después por tres especialistas. El autor mantiene la cautela: la definición es «candidata», válida bajo una cota de intensidad de los campos, y constituye más una respuesta de principio que una herramienta de simulación.
🔗 Un paso hacia la definición del Modelo Estándar en una red · Nuestro nuevo blog de ciencia
ChatGPT for Academic Researchers aspira a llegar a 200 000 investigadores, un estudio analiza a 1 819 científicos
16 de noviembre — Lanzado en julio con un objetivo de 100 000 investigadores, el programa ChatGPT for Academic Researchers aspira ahora a llegar a 200 000. La próxima convocatoria se abre el lunes 23 de noviembre: 50 000 becas concedidas a los primeros candidatos que cumplan los requisitos, y ya no mediante sorteo, cada una de las cuales cubre al titular y hasta dos colaboradores, es decir, hasta 150 000 personas. El acceso pasa de ChatGPT Pro a ChatGPT Plus: según OpenAI, la mayoría de los participantes del piloto se habrían mantenido dentro de los límites de Plus.
El equipo de investigación económica de OpenAI publica en paralelo un estudio sobre 580 186 mensajes de 1 819 científicos, complementado con una encuesta a 251 de ellos. Los participantes estiman que el mismo trabajo, con la misma calidad, les habría llevado aproximadamente 1,9 veces más tiempo sin IA, y el 98 % de los encuestados espera que la IA acelere los descubrimientos en su campo. OpenAI señala sus limitaciones: productividad declarada, expectativas en lugar de resultados y ningún efecto causal demostrado.
| Uso de ChatGPT por los científicos | Proporción media de los mensajes |
|---|---|
| Lectura y aprendizaje | 28 % |
| Escritura y comunicación | 27 % |
| Análisis de pruebas y teorías | 17 % |
| Desarrollo de software de investigación | 14 % |
🔗 Ampliar el acceso a la IA para los científicos · La ciencia en la frontera: cómo utilizan ChatGPT los científicos
Seguridad y protección de la IA: evaluadores independientes en OpenAI, clasificador CSAM abierto, ataques agénticos observados por Google
OpenAI abre sus modelos internos a Apollo Research, METR, Transluce y Goodfire
16 de noviembre — OpenAI ha acordado con cuatro organismos independientes una primera fase de evaluaciones integradas (embedded assessments): un acceso profundo, en ocasiones a los mismos recursos que sus investigadores (checkpoints, código, datos de entrenamiento y evaluación, sistemas de supervisión, equipos), para evaluar la alineación y la eficacia de las salvaguardas a lo largo del tiempo. El trabajo se realiza presencialmente, en dispositivos de OpenAI, bajo la supervisión del Safety and Security Committee, que recibe los informes íntegros; OpenAI conserva el derecho de ocultar la información confidencial y de solicitar un aplazamiento antes de su publicación.
| Evaluador independiente | Objeto de la evaluación | Remuneración por OpenAI |
|---|---|---|
| Apollo Research | Subversión encubierta y detección por las salvaguardas | Sí, sin relación con los resultados |
| METR | Desalineación en el mayor entrenamiento RL, alcance reducido | No (posibles créditos API o de cálculo) |
| Transluce | Evaluaciones de alineación posteriores al entrenamiento | No (posibles créditos API o de cálculo) |
| Goodfire | Interpretabilidad de los mecanismos internos de los modelos | Sí, sin relación con los resultados |
🔗 Nuestra primera fase de evaluaciones integradas
Un clasificador de imágenes CSAM gratuito para organizaciones verificadas, con un indicador para los contenidos generados por IA
16 de noviembre — OpenAI pone a disposición de las organizaciones verificadas, de forma gratuita y a través de su API, omni-moderation-csam-latest, un clasificador de imágenes que identifica posibles contenidos de abuso sexual infantil (CSAM) y devuelve un segundo indicador para los que podrían haberse generado con IA. Diseñado con la ayuda del NCMEC, OpenAI lo presenta como el primer clasificador CSAM ampliamente disponible que incorpora este segundo indicador; la Tech Coalition y ROOST ayudan a ampliar el acceso. Según las pruebas de OpenAI, señalaría un 48 % menos de imágenes que la protección actual y encontraría aproximadamente la misma cantidad de abusos (una estimación). Entre los socios con acceso anticipado, fal confirma como inéditos el 72 % de los contenidos señalados con alta confianza, y SafetyKit detecta el 90 % de los dibujos o animaciones. En ChatGPT, la búsqueda de este tipo de contenido activa ahora una advertencia, la eliminación de la conversación y una suspensión del acceso durante 24 horas; la reincidencia puede llevar al cierre de la cuenta o a una notificación a las autoridades.
🔗 Reforzar la lucha contra el abuso sexual infantil en línea · Registro de cambios de la API de OpenAI
Google Threat Intelligence: los atacantes automatizan de principio a fin la búsqueda y explotación de vulnerabilidades
16 de noviembre — En su informe trimestral sobre el uso malicioso de la IA, el Google Threat Intelligence Group (GTIG) constata que los atacantes despliegan frameworks ofensivos multiagente de código abierto (ARTEX, CAIRN, CyberStrikeAI, PentAGI). Por primera vez, según GTIG, algunos actores han automatizado el descubrimiento y la explotación de vulnerabilidades sin intervención humana: un framework denominado exploit_agent, encontrado en un servidor expuesto, comparaba el código antes y después de los parches, redactaba los exploits y los ejecutaba; según la telemetría de las víctimas, su operador parecía dirigirse sobre todo a sitios franceses de medios de comunicación y entretenimiento, así como del sector educativo. Los zero-days explotados pasan de una media de 8 al mes en 2025 a 11 en 2026, con un pico de 22 en agosto. Un grupo presuntamente norcoreano modificó archivos .claude/settings.json en repositorios internos para que Claude Code instalara una puerta trasera al iniciarse.
For the most part, attackers aren’t using new groundbreaking methods to break into systems — they are still going after known, unfixed issues, just with much greater speed and scale.
🇪🇸 En general, los atacantes no utilizan métodos nuevos y revolucionarios para penetrar en los sistemas: siguen aprovechando vulnerabilidades conocidas y sin corregir, simplemente con mucha más velocidad y a mayor escala. — John Hultquist, analista jefe, GTIG, en blog.google
🔗 Seguimiento de amenazas de IA de GTIG (Google Cloud)
Funciones de Google para el público general: sitios interactivos en Gemini Notebook, 66 voces regionales en Gemini, Ask Maps en 30 países de Europa
Gemini Notebook transforma las fuentes de un cuaderno en sitios interactivos
16 de noviembre — Gemini Notebook ya puede transformar las fuentes de un cuaderno en sitios interactivos. Basta con escribir make me a site en el chat del cuaderno, junto con la descripción de lo que se quiere: una explicación visual para repasar (una tabla periódica interactiva, una cronología histórica), un panel de control (las ventas de un trimestre) o un seguimiento de proyecto con sus tareas y plazos. El sitio se abre en una nueva pestaña o se comparte directamente. La función se despliega en todo el mundo en la web desde el 16 de noviembre para los usuarios de 18 años en adelante, incluidos los suscriptores de Google Workspace; llegará a la aplicación móvil «pronto», sin fecha anunciada.
🔗 Gemini Notebook: sitios interactivos a partir de las fuentes (blog.google) · Anuncio de @Gemini_Notebook
La aplicación Gemini incorpora 66 voces regionales en Android e iOS
16 de noviembre — La aplicación Gemini incorpora 66 nuevas voces regionales en Android e iOS, entre ellas en inglés estadounidense, británico e indio, en hindi, en portugués de Brasil, en indonesio y en coreano, con opciones propias de cada idioma. Google afirma que están ajustadas para ofrecer ritmos naturales y buena claridad, en lugar de acentos exagerados. La voz elegida se aplica en toda la aplicación: conversaciones con Gemini Live, práctica de un idioma, lectura en voz alta de una respuesta. Se elige desde el menú de Gemini Live o en los ajustes. Google había anunciado este proyecto de dialectos locales en Google I/O.
🔗 Las voces regionales de la aplicación Gemini (blog.google)
Ask Maps llega a 30 países de Europa y aprende a preparar itinerarios y citas
16 de noviembre — Ask Maps, el asistente conversacional de Google Maps basado en los modelos Gemini, lanzado en Estados Unidos y la India y del que hablamos aquí el 12 de marzo, comienza a expandirse a 30 países de Europa, entre ellos España, Alemania y el Reino Unido. Google afirma que ya está presente en más de 200 países y territorios; las publicaciones no mencionan a Francia. Ese mismo día, Ask Maps incorpora nuevas funciones, que están llegando a Android e iOS:
| Nueva función de Ask Maps | Disponibilidad anunciada |
|---|---|
| Itinerarios día a día, que se pueden compartir y exportar a Google Docs | Dondequiera que se ofrezca Ask Maps |
| Búsqueda en las listas guardadas, con disponibilidad en tiempo real | Dondequiera que se ofrezca Ask Maps |
| Consejos para el trayecto (Know before you go): aparcamiento, recarga, tiempo, peajes | Primero en Estados Unidos |
| Búsqueda de citas y llamadas a comercios locales | Primero en Estados Unidos |
🔗 Las nuevas funciones de Ask Maps (blog.google) · Ask Maps llega a Europa (blog.google)
Búsqueda de información para desarrolladores y empresas: la Monitor API de Perplexity, Video Intelligence en Cohere Compass
Perplexity lanza la Monitor API, que supervisa la web o páginas concretas y avisa mediante webhook
16 de noviembre — Perplexity lanza la Monitor API, que supervisa la web por cuenta de una aplicación o un agente. Ofrece dos modos: seguir las novedades sobre un tema, una empresa o una pregunta a través de Perplexity Search, o seguir hasta 10 páginas concretas (tarifas de un competidor, changelog, política) y recibir un diff de texto con los cambios. El desarrollador puede describir su objetivo en lenguaje natural; Perplexity Decider comprueba la pertinencia, la legitimidad de la fuente, la novedad y la actualidad de cada resultado, y solo se envían las actualizaciones que superan todos los umbrales, mediante webhooks firmados y con una puntuación de confianza. Los monitores se ejecutan cada 15 minutos, cada hora, cada día, cada semana o según un cron.
| Tipo de monitor | Unidad facturada | Precio anunciado |
|---|---|---|
| Monitor web | ejecuciones correctas | 1 dólar por 1 000 |
| Monitor de páginas | URL recuperadas | 1 dólar por 1 000 |
La API ya está disponible, con la misma clave que las API Search, Context y Agent. Según Perplexity, en 60 temas supervisados durante ocho horas, Monitor devolvió resultados más recientes y pertinentes que otros proveedores de Search API.
🔗 Presentación de la Monitor API de Perplexity
Cohere abre Video Intelligence en Compass para encontrar el momento exacto de un vídeo
16 de noviembre — Cohere añade el vídeo a Compass, su plataforma de búsqueda empresarial, con Video Intelligence, disponible en versión preliminar privada. En lugar de devolver una grabación de una hora, Compass encuentra el momento que responde a la pregunta: un fragmento con marca de tiempo, una transcripción y una descripción de lo que se muestra en pantalla, con límites definidos en el momento de la búsqueda. El vídeo se une a los documentos en un mismo índice, que respeta los permisos de cada usuario, y los agentes acceden a él mediante el servidor MCP de Compass. En 11 conjuntos de datos y 11 133 consultas, Compass ocupa el primer puesto en promedio frente a siete modelos de embeddings de vídeo, con una ventaja de 4,4 puntos de nDCG@10 sobre la mejor alternativa, según Cohere. La empresa busca socios de diseño (design partners), que pueden desplegar la herramienta en el cloud gestionado de Cohere o en su propio entorno; no se indican precios ni fecha de disponibilidad general.
🔗 Presentación de Video Intelligence en Compass · Anuncio de @cohere
Evaluar modelos y agentes: JFinBench de Sakana AI sobre las finanzas japonesas, las evaluaciones de agentes de Together AI
JFinBench: en finanzas japonesas, el mejor modelo abierto sigue a 12,4 puntos de Claude Fable 5
16 de noviembre — Sakana AI publica JFinBench (publicación fechada el 17 de noviembre, hora de Japón), un benchmark extraído de las convocatorias de 2026 de seis exámenes financieros japoneses, desde la contabilidad profesional hasta la asesoría fiscal, diseñado para renovarse en cada convocatoria y limitar así la contaminación. Se evaluaron 12 modelos con 321 preguntas; estos son los cinco mejores sin herramientas:
| Modelo evaluado | Puntuación sin herramientas | Puntuación con herramientas (arnés) |
|---|---|---|
| Claude Fable 5 | 95,8 | 96,4 (Terminus-2) |
| GPT-6 Astra | 93,6 | 97,3 (Terminus-2) |
| Gemini 3.8 Flash | 88,8 | 94,2 (Terminus-2) |
| Kimi K3.1 Pro | 83,4 | 92,9 (Kimi Code) |
| Kimi K3 | 79,9 | 91,0 (Kimi Code) |
Kimi K3.1 Pro, el mejor modelo abierto, sigue a 12,4 puntos de Claude Fable 5 y a unos 10 de GPT-6 Astra, pese a que se anuncia por delante de este último en Terminal-Bench 4.0 (65,7 % frente a 58,2 %, cifras de sus desarrolladores). Los fallos se deben sobre todo a la falta de conocimientos sobre el sistema japonés, no al cálculo. Con terminal y acceso web, la diferencia entre el mejor modelo abierto y el mejor propietario se reduce a 4,4 puntos. En un experimento preliminar, excluido de las puntuaciones, DeepSeek V4.1 Flash 1017 y Gemini 3.8 Flash encontraron una clave de OpenRouter olvidada en el entorno y la utilizaron para llamar a otros modelos.
🔗 JFinBench (Sakana AI) · Artículo de JFinBench en arXiv
Together AI: evaluaciones de agentes que elevaron del 67 al 96 % las tareas completadas con éxito con su documentación MCP
16 de noviembre — Together AI detalla cómo mide la facilidad de uso de su plataforma para los agentes de código, lo que denomina experiencia del agente (agent experience). Se encarga a Claude Code una decena de tareas habituales (lanzar un job por lotes, reservar un clúster GPU, gestionar el autoscaling) en un entorno aislado y con tres configuraciones: sin ayuda, con el servidor MCP de documentación o con el paquete de skills de Together. La configuración MCP pasó del 67 % de tareas completadas con éxito el 15 de junio al 96 % el 30 de septiembre, y la skill unificada alcanzó el 97 % (70 de 72) el 8 de octubre, frente al 82 % de la configuración base sin ayuda; Together reconoce que estas mediciones no son estrictamente comparables. En la reserva de un clúster GPU, Sonnet 4.6 solo completaba con éxito 4 de 15 intentos; dos frases añadidas a la skill elevaron la tasa de éxito al 100 % para todos los modelos probados. La herramienta de evaluación se publicará como open source la semana siguiente, según Together.
🔗 Cómo facilitamos el uso de Together AI a los agentes de código
Adquisiciones y alianzas: ElevenLabs compra Kotoba, la división de medios de LVMH firma con OpenAI
ElevenLabs anuncia la adquisición de Kotoba, un laboratorio japonés de IA de voz
16 de noviembre — ElevenLabs anuncia la adquisición de Kotoba, un laboratorio japonés de IA de voz fundado en 2023 por Noriyuki Kojima y Jungo Kasai. Su modelo Koto abarca la síntesis de voz, la transcripción y la traducción de voz a voz para la interpretación simultánea en japonés; Salesforce lo utiliza para las conversaciones en japonés de Agentforce Voice. ElevenLabs quiere incorporar esta investigación a ElevenAgents, su plataforma de agentes de voz, y prevé contratar responsables comerciales e invertir en infraestructuras en Japón en los próximos meses. La operación aún no se ha cerrado: se espera que se complete en el cuarto trimestre de 2026, sujeta a las autorizaciones regulatorias, y no se ha comunicado ningún importe.
🔗 Kotoba se une a ElevenLabs · Anuncio de @ElevenLabs
La división de medios de LVMH (Les Echos, Le Parisien) despliega ChatGPT Enterprise y da mayor visibilidad a sus contenidos en ChatGPT
16 de noviembre — El Groupe Les Echos-Le Parisien, la división de medios de LVMH, firma un acuerdo estratégico con OpenAI. Sus 17 marcas, entre ellas Les Echos, Le Parisien, Challenges, Paris Match, L’Opinion y L’Agefi, despliegan ChatGPT Enterprise y las herramientas de OpenAI en todos los equipos, con formación adaptada a cada profesión: búsqueda y comparación de documentos, traducción preliminar y personalización de productos para lectores y anunciantes. Como segundo componente, los contenidos de la división tendrán mayor visibilidad en ChatGPT, en forma de resúmenes y fragmentos con fuentes y enlaces a los artículos. El grupo cuenta con 1 800 empleados, entre ellos cerca de 700 periodistas, y llega a más de 27 millones de personas cada mes en Francia. No se ha comunicado ningún importe.
🔗 La división de medios de LVMH anuncia una alianza estratégica con OpenAI
Agentes de código: Claude Code prueba las apps en el iPhone Duo, Replit publica las apps de su Agent en Microsoft Fabric
Claude Code para escritorio pliega el iPhone Duo en su simulador iOS y destaca el plugin Xcode de Apple
16 de noviembre — Claude Code para escritorio incorpora compatibilidad con el iPhone Duo en su panel del simulador iOS, en beta pública: la app en desarrollo se ejecuta en un Duo simulado junto a la conversación, y Claude pliega y despliega el dispositivo para comprobar cada disposición. Según la documentación, el dispositivo tiene tres posiciones (cerrado, entreabierto y abierto), y se puede solicitar un ángulo de bisagra de 1 a 179 grados. Para adaptar una app existente, Claude Code puede proponer la skill App Resizability de Apple, que detecta problemas de disposición y sugiere correcciones que Claude aplica tras su aprobación. Se necesita un Mac, Claude Desktop v4.29.0 o posterior y Xcode 27.1 o posterior; el panel sigue limitado a las sesiones locales, en los planes Pro, Max, Ultra, Team y Enterprise, excepto en la configuración HIPAA. El propio simulador iOS llegó el 22 de julio. En el terminal, Anthropic destaca el plugin Xcode de Apple, disponible en el marketplace oficial desde el 6 de noviembre y que se instala con /plugin install xcode@claude-plugins-official.
🔗 Anuncio de @ClaudeDevs · Documentación del simulador iOS
Replit Agent publica sus aplicaciones en Microsoft Fabric, con disponibilidad general
16 de noviembre — Replit anuncia la disponibilidad general de su integración con Microsoft Fabric, la plataforma de datos de Microsoft: se describe una aplicación, Replit Agent la construye a partir de los datos gobernados de la empresa y, después, se despliega directamente en el tenant de Fabric de la organización. Según la página de socios, Agent lee el esquema, las tablas y las etiquetas de confidencialidad de Purview en OneLake sin copiar los datos; la aplicación, aprovisionada con la autenticación de Microsoft Entra, solo muestra a cada usuario los datos a los que tiene derecho y se apoya en Copilot en Fabric y en la capacidad de IA ya presente en el tenant. La integración se había lanzado en Microsoft Build con Leatherman, y la página de socios no indica ningún precio. El 13 de noviembre, Replit la había ampliado a las aplicaciones con base de datos. Sin embargo, la documentación del conector Fabric todavía describe una versión preliminar, reservada a los miembros de un programa de probadores aprobados.
🔗 Anuncio de @Replit · Página de socios de Microsoft sobre Replit · Documentación del conector Microsoft Fabric
Breves
Agentes de código y CLI
- GitHub Copilot retira tres modelos — Como se anunció el 15 de octubre, Claude Opus 4.8, Claude Opus 5 y GPT-5.6 Terra dejan de estar disponibles en la mayoría de las experiencias de Copilot, sustituidos por Claude Opus 5.5, GPT-6.1 Sol o GPT-6 Luna. Una precisión del changelog: Claude Opus 5 desaparece del selector, pero sigue disponible como alternativa de respaldo cuando se rechaza una solicitud durante la ejecución. 🔗 fuente
- Copilot CLI 1.0.113-0 — Esta versión preliminar aparece sin notas detalladas, con la única mención de correcciones y cambios; la última versión estable sigue siendo la 1.0.112 del 13 de noviembre. 🔗 fuente
- GitHub Agentic Workflows 1.3.0 — Aún en versión preliminar, esta versión saca los ledgers de la fase experimental y añade un control,
require-agent-success, que bloquea la publicación de las salidas cuando el job del agente ha fallado; los rechazos de Copilot relacionados con la política de ciberseguridad ya no se reintentan automáticamente. 🔗 fuente - Codex CLI 0.171.0-alpha.9 — Tres versiones preliminares con notas vacías desde la alpha.6; según los títulos de sus 41 commits,
codex execpuede apoyarse en un servidor de aplicaciones remoto, y el terminal muestra consejos sobre responsabilidad y riesgo durante las revisiones. La última versión estable sigue siendo la 0.169.0. 🔗 fuente - Agents SDK de OpenAI — La versión preliminar de Python v0.24.0-alpha.8 permite aprobar o rechazar una llamada a una herramienta después de ver sus argumentos, conectar LiteLLM o AnyLLM y añadir voz en tiempo real mediante WebSocket, WebRTC o SIP; en JavaScript, la v0.22.0-alpha.3 puede ejecutar los callbacks de herramientas en paralelo de forma predeterminada. 🔗 fuente
- Gemini CLI — Una corrección integrada en la rama principal, aún sin publicar, hace que se ignoren los servidores MCP declarados por el administrador cuyos comandos o scripts sigan siendo modificables por un usuario normal, que de otro modo podía heredar la aprobación automática de un servidor autorizado. 🔗 fuente
- ZCode v3.18.2 — Z.ai publica en GitHub esta versión de su entorno de desarrollo asistido por IA para macOS y Windows, sin notas de versión, tras unas sincronizaciones de código 3.18.0 y 3.18.1 que no llegaron a publicarse como versiones. 🔗 fuente
- Caché de prefijos de los agentes — Together AI y Ollama explican que el arnés (Claude Code, Codex o Pi mediante
ollama launch) debe mantener idéntico el inicio del prompt y que el motor debe dirigir cada turno a la GPU que contiene la caché: en 100 turnos, se procesan 5 050 unidades de prompt sin caché frente a 100 con ella, según un cálculo idealizado. 🔗 fuente - Fábricas de software de equipo — En un artículo de opinión en el blog de Warp, Zach Lloyd aboga por trasladar los agentes desde las configuraciones de cada desarrollador (arnés, modelo, skills, MCP) a una infraestructura cloud compartida, descrita en código y propiedad del equipo. 🔗 fuente
Otras novedades de GitHub
- AI Scan por lotes — El análisis de vulnerabilidades de repositorios mediante IA ya se puede ejecutar en un máximo de 20 repositorios a la vez, desde la configuración de la organización o la página de alertas de code scanning, en versión preliminar pública y sin licencia de Copilot. 🔗 fuente
- GitHub Mobile en iPhone Duo — La aplicación de iOS adapta su diseño al desplegar el dispositivo y añade pestañas verticales para acceder a Copilot, las pull requests, las issues y las notificaciones. 🔗 fuente
Computación, simulación y robótica
- Lambda y NVIDIA Photonics — Lambda conecta racks GB300 NVL72 que suman más de 10 000 GPU mediante conmutadores con óptica cointegrada (co-packaged optics); según sus pruebas, la latencia se reduce aproximadamente un 4 % en el rack y hasta alrededor de un 10 % en el pod, y los componentes ópticos funcionan a 36 °C frente a los 51 °C de los enchufables. 🔗 fuente
- Google Cloud en MLPerf Training v6.1 — En el primer benchmark MLPerf de aprendizaje por refuerzo agéntico, según Google, 640 TPU Ironwood alcanzan la precisión objetivo en 18,02 minutos; en preentrenamiento, 8 192 TPU Ironwood lo consiguen en 1,70 minutos y 256 GPU GB300 en 31,96 minutos. 🔗 fuente
- NVIDIA Cosmos — Los modelos de mundo abiertos de NVIDIA superan los 20 millones de descargas en Hugging Face, según NVIDIA, sin que se especifique el periodo ni el alcance de la cifra. 🔗 fuente
- LidarVerse — NVIDIA Research vuelve a destacar este modelo de octubre que genera, predice y vuelve a simular barridos LiDAR, a 10 fotogramas por segundo en una sola H100 en su versión destilada; el código tiene licencia Apache 2.0. 🔗 fuente
- AI Day Seoul — NVIDIA hace balance de su evento coreano: más de 2 000 participantes, más de 500 desarrolladores formados o certificados en coreano y un hackathon ganado por el equipo FlyGate con agentes construidos sobre OpenShell. 🔗 fuente
- projectsim (Kaedim) — Más de 200 objetos 3D preparados para la simulación robótica, entre ellos 140 articulados, pasan a ser gratuitos y también se incorporan a SimReady Central de NVIDIA, donde siete ya están disponibles. 🔗 fuente
Modelos abiertos y Hugging Face
- CI de llama.cpp — Ante 3 181 pull requests en tres meses y las limitaciones del plan gratuito de GitHub (10 GB de caché, 20 jobs simultáneos), el equipo ejecuta únicamente los jobs afectados por el diff, almacena sus cachés ccache en Hugging Face Buckets y ejecuta la mayoría de los jobs Linux x64 en Hugging Face Jobs. 🔗 fuente
- Accelerate v1.16.0 — La biblioteca de entrenamiento distribuido de Hugging Face exige ahora Python 3.11 y PyTorch 2.6, se apoya más en
torch.acceleratorpara los aceleradores registrados en PyTorch y elimina PiPPy, MS-AMP yFP8RecipeKwargs. 🔗 fuente - Tiny Aya Global — Cinco artículos de la comunidad, la mayoría surgidos del hackathon de Lexsi Labs, exploran el pequeño modelo multilingüe de Cohere Labs: un agente de bases de datos pasa de un 0,5 a un 49,1 % de éxito en tres rondas de autorreparación, y el control del rechazo reduce considerablemente las respuestas dañinas en bengalí y suajili, a costa de duplicar los rechazos excesivos, según los autores. 🔗 fuente
- Modular Diffusers — Una guía muestra cómo utilizar en Diffusers un modelo aún no integrado, convirtiendo sus pesos y publicando bloques en el Hub; el autor encargó el trabajo a Claude Code con Claude Opus 5.5, ya que la conversión no había tenido éxito con Astra. 🔗 fuente
- Modelos pequeños en teléfonos — Un desarrollador publica dos procesos de compra completos en Amazon ejecutados en local por Qwen3.5 0,8B y 2B en teléfonos Android, con una mediana de entrada de 45 tokens por llamada; el más lento, en un Galaxy A04e, duró 4 h 20 para 578 llamadas. 🔗 fuente
- Ask AdMob — Google presenta un agente conversacional construido con Gemini dentro de la cuenta de AdMob, que se probará en los próximos meses, publica desde ahora agent skills de AdMob para los agentes de código y prepara un servidor MCP, en pruebas iniciales, que se abrirá a más desarrolladores a principios de 2027. 🔗 fuente
- Google Flow — El 12 de noviembre, Google añadió a su estudio creativo cinco herramientas diseñadas por artistas, entre ellas Pocket Studio, que obtiene varios ángulos de cámara a partir de una sola toma con el teléfono, y Pixel Machine para los estilos retro. 🔗 fuente
Voz, imagen y vídeo
- Nemotron 3.5 Transcribe — NVIDIA se hace eco del primer puesto de su modelo abierto en el índice de diarización de Artificial Analysis publicado el 13 de noviembre: un 3,3 % de palabras atribuidas erróneamente (WDER) en 97 conversaciones de entre dos y ocho personas, por delante de Voxtral Small Transcribe 3 (7,5 %). 🔗 fuente
- FLUX: In Production — Black Forest Labs lanza un concurso de películas realizadas con IA, cuyos briefs redactan estudios colaboradores, con más de 25 000 dólares en premios; se celebra en línea del 30 de noviembre al 13 de diciembre. 🔗 fuente
- Kling Image 4.0 — Kling anuncia la próxima llegada de su nuevo modelo de imagen, sin fecha ni características. 🔗 fuente
Empresas y formación
- Autotorino y ElevenAgents — El grupo italiano de concesionarios de automóviles, que recibe unas 100 000 llamadas al mes, confía sus llamadas a un agente de voz que clasifica la solicitud y crea el cliente potencial; el volumen de llamadas atendidas automáticamente se ha más que duplicado. 🔗 fuente
- Los dots de Holiday Extras — En un estudio de caso de OpenAI, el dot de un responsable detecta por sí solo el lanzamiento de una función, consulta Google BigQuery y entrega un informe sin que se lo pidan; otro prepara informes durante el trayecto de su usuario. 🔗 fuente
- OpenAI y The King’s Trust — OpenAI aporta 1 millón de libras esterlinas a la asociación británica para formar en IA a un máximo de 25 000 jóvenes en 18 meses, dando prioridad a quienes no trabajan, estudian ni reciben formación. 🔗 fuente
- La IA en la formación según Synthesia — Tercer informe anual, con más de 800 encuestados en más de 25 países: el 87 % de los equipos que utilizan IA la emplean para generar contenido, pero solo el 29 % aplica el aprendizaje personalizado, frente al 70 % que lo aplicaba o tenía previsto hacerlo hace un año. 🔗 fuente
Perplexity
- Cifras resaltadas en las fuentes — En Computer y los Teammates, al abrir el documento fuente de una respuesta ahora se resalta la cifra exacta citada, en la web para todos los usuarios, según @AskPerplexity. 🔗 fuente
- Guía sobre IA frente a AGI — Perplexity publica una guía que distingue la IA desplegada actualmente de la AGI y propone un método para verificar un anuncio de AGI; cita a Claude Opus 5.5 con un 21,3 % en el Remote Labor Index a fecha del 9 de octubre. 🔗 fuente
Qué significa esto
La brecha entre modelos abiertos y cerrados ya se mide tanto en dólares como en puntos. Qwen4-Max se sitúa por debajo de las tarifas de Qwen3.8-Max y anuncia una reducción del coste por tarea del 62 %, pero solo lidera 4 de las 16 pruebas de su propia tabla, y nada apunta a que vaya a ofrecer pesos abiertos. Hugging Face apuesta por la otra vertiente: al confiar su enrutamiento a OpenRouter, se apoya en modelos abiertos que representan el 71,7 % de los tokens de OpenRouter y cuestan de media alrededor de una cuarta parte. Sin embargo, el mismo artículo reconoce una diferencia de 19 puntos en la parte alta del Intelligence Index, y JFinBench mide una de 12,4 en finanzas japonesas sin herramientas, que se reduce a 4,4 con acceso a la web: en los ámbitos poco evaluados, la ventaja de los modelos cerrados se debe ante todo a lo que saben.
Los agentes salen del terminal para entrar en sistemas de negocio sujetos a controles. En ChatGPT for Healthcare, el agente que maneja el ordenador conecta el historial médico con el portal de una aseguradora, con controles de acceso por rol, registros de auditoría y BAA; en Replit, la aplicación construida por el Agent nace en el tenant Fabric del cliente, con sus permisos de Entra ID y sus etiquetas de Purview. El mismo movimiento beneficia a los atacantes: según GTIG, un framework encadenó sin intervención humana el descubrimiento y la explotación de vulnerabilidades, y un grupo manipuló la configuración de Claude Code para instalar una puerta trasera. La corrección de Gemini CLI sobre los servidores MCP modificables lo recuerda a su manera: la aprobación automática de una herramienta solo es tan fiable como la integridad del script que la ejecuta.
La ciencia se convierte en el argumento común de la computación y los agentes. NVIDIA presenta Rubin HPC y sus bibliotecas CUDA-X como las herramientas de simulación a las que recurrirán los agentes para poner a prueba sus ideas, Perplexity quiere construir un científico automatizado sobre más de 10 000 GPU y OpenAI abre un blog donde un físico cuenta cómo GPT-6 Astra tomó las riendas de una demostración, al tiempo que duplica el objetivo de su programa para investigadores. Las promesas siguen por delante de los resultados: Rubin HPC se espera para 2028 sin datos anunciados sobre memoria ni FLOPS, Frontier Research no presenta ningún modelo ni artículo nuevo, la definición de Craig sigue siendo «candidata» y el estudio de OpenAI mide una productividad declarada, sin que se haya establecido un efecto causal.
La forma de medir también cambia. OpenAI abre sus checkpoints y sus entrenamientos a Apollo Research, METR, Transluce y Goodfire, pero mantiene el control sobre la información que se omite y el calendario de publicación. Together AI muestra que dos frases en una skill hacen que un modelo pase de 4 aciertos de 15 al 100 %, lo que pone en perspectiva las diferencias entre modelos evaluados sin orientación. El episodio de JFinBench, en el que dos modelos encontraron una clave de OpenRouter olvidada para poner a trabajar a otros modelos, recuerda que una evaluación con herramientas también mide lo que el entorno deja al alcance. Y la mejora de más de 10 veces de Vera Rubin en MLPerf Endpoints sigue siendo provisional mientras MLCommons no la verifique.
Fuentes
- Qwen4-Max: Tu nuevo compañero de equipo ha llegado (publicación de Qwen)
- Ficha de qwen4-max en QwenCloud
- Anuncio de Qwen4-Max (@Alibaba_Qwen)
- Más formas de impulsar la atención sanitaria con ChatGPT for Healthcare (OpenAI)
- Impulsando los agentes de computer-use para los equipos sanitarios (OpenAI)
- Rubin HPC (blog de NVIDIA)
- Los anuncios de NVIDIA en SC26
- Vera Rubin en MLPerf Training y Endpoints (blog de NVIDIA)
- Slurm y la computación cuántica (blog de NVIDIA)
- Bibliotecas CUDA-X para la ciencia (blog de NVIDIA)
- Hugging Face y OpenRouter unen fuerzas (blog de Hugging Face)
- Anuncio de @huggingface
- Presentamos Perplexity Frontier Research
- Anuncio de @perplexity_ai
- research.perplexity.ai
- Hilo de Andrew Gordon Wilson (@andrewgwils)
- Hilo de Denis Yarats (@denisyarats)
- Un paso hacia la definición del modelo estándar en una red (OpenAI)
- Nuestro nuevo blog de ciencia (OpenAI)
- Ampliando el acceso a la IA para los científicos (OpenAI)
- Ciencia en la frontera: cómo usan ChatGPT los científicos (OpenAI)
- Nuestra primera fase de evaluaciones integradas (OpenAI)
- Reforzando la lucha contra el abuso sexual infantil en línea (OpenAI)
- Changelog de la API de OpenAI
- GTIG AI Threat Tracker (Google Cloud)
- Resumen del informe de GTIG (blog.google)
- Gemini Notebook: sitios interactivos a partir de las fuentes (blog.google)
- Anuncio de @Gemini_Notebook
- Las voces regionales de la aplicación Gemini (blog.google)
- Las nuevas funciones de Ask Maps (blog.google)
- Ask Maps llega a Europa (blog.google)
- Presentamos Monitor API de Perplexity
- Presentamos Video Intelligence en Compass (Cohere)
- Anuncio de Video Intelligence (@cohere)
- JFinBench (Sakana AI)
- Artículo de JFinBench en arXiv
- Cómo facilitamos a los agentes de programación el uso de Together AI
- Kotoba se une a ElevenLabs
- Anuncio de @ElevenLabs
- La división de medios de LVMH anuncia una alianza estratégica con OpenAI
- Anuncio de @ClaudeDevs
- Documentación del simulador de iOS de Claude Code
- Anuncio de @Replit
- Página de Replit como socio de Microsoft
- Documentación del conector de Microsoft Fabric (Replit)
- Retirada de modelos en GitHub Copilot (changelog de GitHub)
- Copilot CLI 1.0.113-0 (GitHub)
- GitHub Agentic Workflows 1.3.0 (GitHub)
- Codex CLI 0.171.0-alpha.9 (GitHub)
- Agents SDK Python v0.24.0-alpha.8 (GitHub)
- PR 30283 de Gemini CLI (GitHub)
- ZCode v3.18.2 (GitHub)
- Cómo hacer que los modelos abiertos funcionen con cargas de trabajo agénticas de larga duración (Together AI y Ollama)
- Publicación de Zach Lloyd sobre las fábricas de software (Warp)
- AI Scan en varios repositorios (changelog de GitHub)
- GitHub Mobile en iPhone Duo (changelog de GitHub)
- Lambda y NVIDIA Photonics (blog de NVIDIA)
- Resultados de Google Cloud en MLPerf Training v6.1 (blog.google)
- NVIDIA Cosmos, 20 millones de descargas (@NVIDIAAI)
- LidarVerse (@NVIDIAAI)
- Balance del AI Day Seoul (blog de NVIDIA)
- Objetos de simulación gratuitos de projectsim (blog de Hugging Face)
- CI de llama.cpp en Hugging Face Buckets y Jobs (blog de Hugging Face)
- Accelerate v1.16.0 (GitHub)
- Efficient Healer en Tiny Aya Global (blog de Hugging Face)
- Nuevos modelos con Modular Diffusers (blog de Hugging Face)
- Recorridos largos en teléfonos con modelos pequeños (blog de Hugging Face)
- Las nuevas herramientas de IA de AdMob (blog.google)
- Las cinco nuevas herramientas de Google Flow (blog.google)
- Nemotron 3.5 Transcribe en el índice de diarización (@NVIDIAAI)
- FLUX: en producción (@bfl_ai)
- Kling Image 4.0 (@Kling_ai)
- Autotorino y ElevenAgents (ElevenLabs)
- En Holiday Extras, los dots se ponen a trabajar antes de que nadie lo pida (OpenAI)
- The King’s Trust y OpenAI (OpenAI)
- Informe de Synthesia sobre la IA en la formación
- Cifras resaltadas en Computer y los Teammates (@AskPerplexity)
- AGI frente a AI (Perplexity)