ai-powered-markdown-translatorArticol tradus din fr în ro cu gpt-6.1-sol.
Qwen pune Qwen4-Max la dispoziție prin API-ul său: un model MoE cu 2,4T de parametri, cu un context de 1M de tokens, la un tarif mai mic decât Qwen3.8-Max. OpenAI extinde accesul la agenții săi care controlează computerul la ChatGPT for Healthcare și ChatGPT for Clinicians, NVIDIA anunță la SC26 Rubin HPC, un GPU pentru simulări așteptat în 2028, alături de primele rezultate Vera Rubin în MLPerf Training, iar Hugging Face încredințează OpenRouter rutarea pentru Inference Providers. Perplexity lansează, la rândul său, Perplexity Frontier Research, care urmărește să creeze un cercetător automatizat folosind peste 10 000 de GPU.
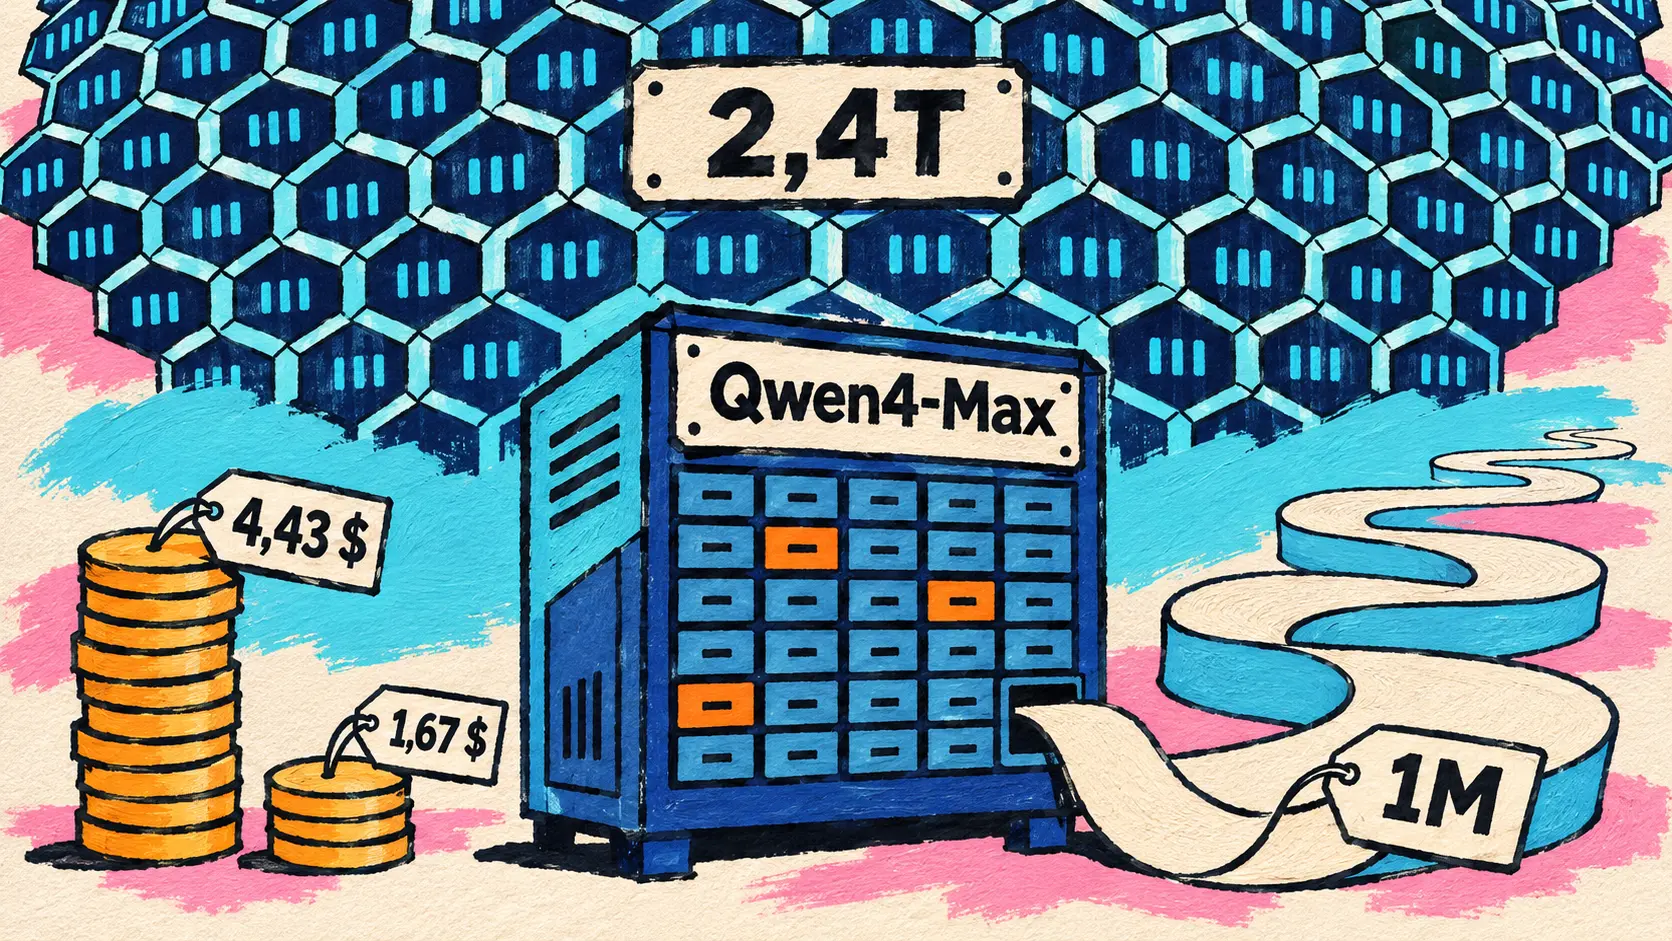
Qwen4-Max devine disponibil prin API-ul QwenCloud: MoE cu 2,4T de parametri, context de 1M de tokens, tarife în scădere
16 noiembrie — La cinci zile după versiunea preliminară prezentată pe 11 noiembrie, Qwen pune Qwen4-Max la dispoziție prin API-ul QwenCloud sub identificatorul qwen4-max, însoțit de o amplă postare tehnică. Este primul model din seria Qwen4: modele Qwen4 mai mici vor fi lansate cu ponderi deschise, fără o dată anunțată, dar nu există un astfel de anunț pentru Max. Modelul este oferit și în QwenWork, Qoder și Qwen Studio, iar din aceeași zi și prin OpenRouter, Vercel AI Gateway, Novita AI și OpenCode Go.
Arhitectura este nouă. Acest amestec de experți (Mixture of Experts, MoE) are 2,4T de parametri în structura de bază, dintre care 71B sunt activați per token, plus 328B de parametri de N-gram Embedding. Din patru straturi, trei Gated DeltaNet comprimă istoricul într-o stare de dimensiune fixă; al patrulea, bazat pe Qwen Sparse Attention, selectează contextul util pe blocuri. Modelul are capabilități vizuale native și un context de 1M de tokens: 991K la intrare și 131K la ieșire, 983K și 262K în modul de raționament, potrivit paginii QwenCloud.
| Tip de tarif (QwenCloud, per milion de tokens) | Preț anunțat |
|---|---|
| Intrare | 1,5 dolari |
| Ieșire | 4,5 dolari |
| Intrare în cache implicit | 0,075 dolari |
| Creare de cache explicit (5 minute / 1 oră) | 1,875 / 3 dolari |
Potrivit Qwen, toate aceste tarife sunt mai mici decât cele ale Qwen3.8-Max, tariful pentru cache implicit scăzând cu 70 %. În evaluările sale interne, Qwen anunță și un consum de tokens redus cu 24 până la 35 %, în funcție de efort, pe Work360, cadrul său care acoperă 721 de specialități profesionale, și cu aproximativ 48 până la 49 % pe Terminal-Bench 4.0. Costul mediu al unei sarcini Work360 scade de la 4,43 la 1,67 dolari, adică −62 % potrivit postării în engleză; versiunea chineză, în yuani, indică −58 %. Pe Work360, Qwen4-Max obține 52,69 față de 47,74 pentru Qwen3.8-Max.
În comparație cu Opus 5.5, GPT-6.1 Sol, GPT-6 Astra și Kimi K3.1, tabelul publicat de Qwen arată rezultate mixte: Qwen4-Max conduce doar la 4 dintre cele 16 teste, DeepSWE v1.1, Agents’ Last Exam v1.1, HLAB-Vals-1.1 și BioMysteryBench. Selecție:
| Benchmark (domeniu) | Qwen4-Max | Opus 5.5 | GPT-6.1 Sol | GPT-6 Astra | Kimi K3.1 |
|---|---|---|---|---|---|
| DeepSWE v1.1 (cod agentic) | 75,7 | 74,2 | 75,2 | 74,1 | 75,5 |
| HLAB-Vals-1.1 (agent juridic) | 21,3 | 9,2 | 6,3 | 7,1 | 11,7 |
| BioMysteryBench (bioinformatică) | 85,0 | 81,9 | 84,4 | 78,9 | 80,6 |
| Terminal-Bench 4.0 (terminal agentic) | 48,5 | 59,6 | 56,1 | 59,1 | 67,2 |
| ProgramBench (replicare de software) | 31,5 | 65,0 | 52,5 | 55,0 | 25,0 |
| Humanity’s Last Exam | 51,7 | 59,8 | 54,0 | 53,6 | 51,1 |
Clasamentele unor terți, preluate de Qwen, îl plasează pe locul 6 în Code Arena WebDev (1 750 de puncte preliminare) și pe locul 11 în Vals Index (63,20 %), fiind cel mai bine clasat model chinez. Artificial Analysis îi acordă 43 de puncte în Intelligence Index cu efort xhigh, cu 3 puncte în urma Kimi K3.1 Pro, pentru un cost per sarcină cu aproximativ 11 % mai mic.
More to come! The open weights of smaller Qwen4 models will be released. Stay tuned.
🇷🇴 Asta nu e tot! Vor fi publicate ponderile deschise ale unor modele Qwen4 mai mici. Rămâneți pe recepție. — @Alibaba_Qwen pe X
🔗 Qwen4-Max: Noul tău coleg de echipă a sosit (postare Qwen) · Fișa qwen4-max pe QwenCloud
ChatGPT for Healthcare: agenți care controlează computerul, cercetare clinică și peste 20 de pluginuri pentru sănătate
16 noiembrie — OpenAI extinde ChatGPT for Healthcare în trei direcții. Mai întâi, agenții de utilizare a computerului (computer-use agents), care citesc ecranul, fac clic, tastează și trec de la o aplicație la alta, ajung în ChatGPT Work și Codex pentru clienții ChatGPT for Healthcare, în funcție de setările spațiului lor de lucru, și pentru clinicienii din ChatGPT for Clinicians, oferta gratuită rezervată clinicienilor verificați din Statele Unite. Aceeași capabilitate este accesibilă prin API. Un caz tipic: transferul informațiilor între aplicații care nu comunică între ele, precum dosarul medical electronic și portalul unui asigurător, pentru o cerere de autorizare a unei investigații IRM. Utilizarea computerului exista în ChatGPT Work și Codex din 9 iulie; noutatea este accesul oferit spațiilor din domeniul sănătății, cu controale de acces în funcție de rol, jurnale de audit și etape de aprobare configurabile. Fluxurile de lucru conforme cu HIPAA rămân limitate la serviciile eligibile acoperite de un BAA.
OpenAI publică două seturi de cifre, care trebuie analizate separat: evaluarea sa internă privind mesageria dosarului medical și HealthAdminBench, un benchmark independent al unor cercetători de la Stanford, dedicat sarcinilor administrative (autorizări prealabile, contestații, comenzi de echipamente).
| Evaluare publicată | Model și setare | Rezultat anunțat |
|---|---|---|
| Mesageria dosarului medical (OpenAI, 325 de sarcini analizate) | GPT-6 Astra | 99 % dintre sarcini considerate sigure din punct de vedere clinic |
| Aceeași evaluare, 646 de aprecieri ale medicilor | GPT-6 Astra | 93 % « foarte » sau « extrem de » util |
| HealthAdminBench (Stanford) | GPT-6 Astra, efort maxim | 94,3 % din punctele grilei |
| HealthAdminBench (Stanford) | GPT-6 Luna, efort maxim | 91,8 %, pentru 8,5 cenți per sarcină |
Pe HealthAdminBench, GPT-6 Luna obține 91,8 % la un cost cu 98 % mai mic, adică 8,5 cenți per sarcină. În practică, CVS Health utilizează deja acești agenți în producție: unul a eliminat într-un weekend restanțele la trimiterea documentelor acumulate timp de luni de zile, altul gestionează pașii din sistem pentru zeci de mii de consultații pe zi, iar compania publică în regim open source propriul Agent Kit, construit cu Agents SDK de la OpenAI. Cigna Healthcare afirmă că a trecut de la concept la implementare în mai puțin de opt săptămâni; la Ambience, agentul se oprește și cere părerea clinicianului când dosarul este ambiguu; Abridge dezvoltă agenți pentru spitale.
Urmează celelalte două componente. Cercetarea clinică, care găsește, evaluează și citează dovezi medicale, primește note mai bune la toate cele opt dimensiuni măsurate într-o evaluare în orb cu peste 1 300 de evaluări realizate de medici. Iar 21 de noi pluginuri pentru sănătate (UpToDate Expert AI, Oracle HDI, Trizetto, Stedi, Luma Health, Metriport…) permit consultarea unui protocol, verificarea eligibilității unei asigurări sau coordonarea programărilor direct din conversație; administratorul spațiului trebuie să le activeze, iar ChatGPT for Clinicians primește doar o parte dintre ele.
🔗 Mai multe modalități de a îmbunătăți îngrijirea medicală cu ChatGPT for Healthcare · Dezvoltarea agenților de utilizare a computerului pentru echipele medicale
NVIDIA la SC26: Rubin HPC pentru simulare științifică, Vera Rubin în MLPerf, Slurm pentru procesoare cuantice și biblioteci CUDA-X
16 noiembrie — La conferința de calcul de înaltă performanță SC26, NVIDIA lansează o serie de anunțuri dedicate științei. Principalul este Rubin HPC, un nou GPU al platformei Vera Rubin, conceput pentru simulare și prelucrarea datelor în știință, inginerie și analiză, în domenii precum clima, genomica sau riscul financiar.
Fișa publicată rămâne sumară. NVIDIA pune în evidență peste 50 000 de nuclee CUDA pe un singur GPU, un număr « record » potrivit companiei, accelerarea datelor rare (sparse data acceleration) menită să mențină aceste nuclee alimentate cu date și o conexiune NVLink de generația a șaptea între GPU. Nu sunt menționate nici capacitatea memoriei, nici puterea în FLOPS, nici prețul, nici vreun partener.
Argumentul central este echilibrul. Potrivit NVIDIA, majoritatea sarcinilor de lucru științifice constau în preluarea câtorva valori dispersate într-un set de date uriaș, efectuarea calculelor și apoi repetarea operațiunii la scară foarte mare. Rubin HPC mărește astfel transferul de date în același ritm cu puterea de calcul, pentru a accelera operațiile pe matrice rare, calculele de tip stencil, sortările și reducerile. NVIDIA leagă acest GPU de discursul său despre agenți: un agent care explorează mai multe molecule, materiale sau proiecte are nevoie de mai multe simulări pentru a-și testa ideile, iar bibliotecile CUDA-X îi oferă implementările optimizate. Lansarea este încă departe: Rubin HPC este așteptat în 2028.
| Caracteristică anunțată | Valoare indicată de NVIDIA |
|---|---|
| Nuclee CUDA | peste 50 000 pe un singur GPU |
| Interconectare între GPU | NVLink de generația a șaptea |
| Funcție specifică | accelerarea datelor rare |
| Disponibilitate prevăzută | 2028 |
🔗 Rubin HPC (blogul NVIDIA) · Anunțurile NVIDIA la SC26
Vera Rubin debutează în MLPerf Training v6.1 și MLPerf Endpoints, cu performanțe per GPU de până la 2 ori mai mari decât GB300 NVL72
16 noiembrie — Ciclul MLPerf Training v6.1 marchează prima participare Vera Rubin NVL72 la antrenare: o performanță per GPU de până la 2 ori mai mare decât cea a unui GB300 NVL72, rezultate pe care NVIDIA le prezintă drept preliminare. Pe DeepSeek-V3, trecerea de la 256 la 1 024 de GPU Vera Rubin menține o eficiență de aproximativ 97 % și reduce timpul de antrenare de la 16 minute la aproximativ patru. Cea mai mare configurație din acest ciclu cuprinde 10 240 de GPU, cu GB300 la NVIDIA și cu GB200 la Microsoft Azure. Potrivit NVIDIA, platforma sa este singura care are rezultate la toate testele.
NVIDIA prezintă și prima sa participare la MLPerf Endpoints v1.0, care măsoară fluxuri de lucru agentice reale. Pe Kimi K3, Vera Rubin NVL72 ar oferi un debit per watt de peste 10 ori mai mare decât cel al unui GB300 NVL72, la aceeași viteză de răspuns: un rezultat provizoriu, în așteptarea verificării de către MLCommons, care compară 32 de acceleratoare Vera Rubin cu 48 de acceleratoare GB300 la pragul de 50 de tokens pe secundă și per utilizator. Vera Rubin apăruse deja în versiune preliminară în MLPerf Inference, prezentat pe 16 septembrie.
🔗 Vera Rubin în MLPerf Training și Endpoints (blogul NVIDIA)
Slurm 26.11 va accepta procesoare cuantice, CUDA-Q primește noi funcții
16 noiembrie — NVIDIA extinde Slurm, gestionarul de sarcini al supercalculatoarelor, la procesoarele cuantice (QPU). Până acum, conectarea unui QPU într-un centru de calcul necesita o dezvoltare specifică pentru fiecare pereche procesor-centru; acum, un producător își descrie hardware-ul într-un simplu fișier și obține o interfață utilizabilă oriunde, prin interfețele QRMI și QDMI. Alice & Bob, IBM, IQM, Pasqal, Quantinuum și MQSC adoptă această soluție, iar Slurm 26.11 urmează să fie lansat mai târziu în noiembrie. NVIDIA justifică acest demers prin extinderea infrastructurii: aproape 30 de centre de calcul pun în funcțiune peste 50 de QPU.
Platforma CUDA-Q primește un server de decodare pentru corectarea erorilor cuantice (CUDA-Q QEC), al cărui decodor TCBP-JOBS ar fi de 13 000 de ori mai rapid decât referința din industrie, primitive tolerante la erori (Fermilab a efectuat deja cu CUDA-Q, în trei săptămâni, studii care ar fi durat cinci luni), precum și CUDA-Q Algorithms și CUDA-Q Pulse pentru producătorii de hardware. Aceste câștiguri sunt cele raportate de NVIDIA.
🔗 Slurm și calculul cuantic (blogul NVIDIA)
CUDA-X pentru știință: cuSpa și HMMER pe GPU în regim open source, observațiile Event Horizon Telescope corelate în opt minute
16 noiembrie — NVIDIA completează Rubin HPC cu biblioteci CUDA-X pentru cercetare, prezentate drept instrumente pe care agenții le pot apela. În astronomie, modulul cuPhoton.xBeam reduce timpul de corelare a observațiilor Event Horizon Telescope de la peste o lună la opt minute, atât pe un cluster multi-GPU, cât și pe un DGX Spark. În biologie, cuSpa, devenit recent open source, accelerează calculele poligoanelor celulare de 900 de ori față de CPU la Memorial Sloan Kettering Cancer Center, iar versiunea GPU a HMMER, și ea open source, este de până la 84 de ori mai rapidă la Basecamp Research. rapids-singlecell este acum distribuit într-un container « pregătit pentru agenți » (de 200 de ori mai rapid la Therna Biosciences). În chimie, Daviator, o colecție de kerneluri GPU pentru software-ul VASP, ajunge în NVIDIA ALCHEMI cu calcule de până la 22 de ori mai rapide și cu până la 75 % mai ieftine, dar încă nu este disponibil; cuPotential, lansat pe 14 octombrie, este adoptat de încă cinci organizații, printre care Cadence.
🔗 Biblioteci CUDA-X pentru știință (blogul NVIDIA)
Hugging Face încredințează OpenRouter rutarea modelelor de limbaj din serviciul său Inference Providers
16 noiembrie — Hugging Face și OpenRouter își unesc forțele: Inference Providers de la Hugging Face renunță la routerul propriu și lasă OpenRouter să aleagă furnizorul pentru fiecare apel către un model de limbaj. Clément Delangue prezintă anunțul drept prima parte a parteneriatului. Nimic nu se schimbă în codul client: același token Hugging Face, același endpoint. Routerul acceptă API-urile Chat Completions și Responses de la OpenAI, precum și API-ul Messages de la Anthropic, iar Hugging Face publică ghiduri pentru Claude Code, Codex, OpenCode, Pi și Hermes Agent.
Diferența constă în rutare. Inference Providers alegea un furnizor și returna eroarea acestuia ca atare; OpenRouter alege în funcție de preț, viteză și fiabilitate, măsurate în timp real, și reîncearcă apelul la alt furnizor dacă primul eșuează. Anumite sufixe impun o politică sau un furnizor (:fastest, :cheapest, zai-org/GLM-5.3:novita), iar o conversație rămâne la furnizorul care îi deține cache-ul de prompt.
| Modificare anunțată | Detalii conform articolului |
|---|---|
| Erori de capacitate (măsurători OpenRouter) | −46 % |
| Timp până la primul token și debit (măsurători OpenRouter) | îmbunătățire de 16,9 % și +16,3 % |
| Facturare | prețul furnizorului, fără adaos din partea Hugging Face |
| Credite lunare incluse | 2 dolari (PRO), 2 dolari per loc (Team, Enterprise) |
| Pagini de modele | filele Providers și Metrics: preț, viteză, disponibilitate pe 24 de ore |
| Modificare incompatibilă | cheile API personale ale furnizorilor sunt respinse pentru modelele de limbaj |
Imaginile, videoclipurile și sunetul continuă să treacă direct prin Inference Providers, fără OpenRouter, iar cheile personale rămân valabile pentru furnizorii de imagini și videoclipuri. Conectarea unui cont OpenRouter la Hugging Face și rutarea altor sarcini prin OpenRouter sunt anunțate pentru o etapă ulterioară, fără o dată precizată.
Articolul se bazează pe cifrele OpenRouter: modelele deschise reprezentau 71,7 % din tokenurile procesate la sfârșitul lui septembrie 2026, față de 26,8 % în octombrie 2025, la un preț mediu de 0,28 și 1,62 dolari per milion de tokenuri (intrare, ieșire), față de 1,27 și 6,36 dolari pentru modelele închise. Articolul recunoaște și diferența din fruntea clasamentului: Kimi K3.1 Pro, cel mai bun model deschis, obține 46 la Artificial Analysis Intelligence Index, față de 65 pentru Claude Fable 5.2, la aproximativ o șeptime din costul per sarcină (3,68 față de 26,54 dolari).
🔗 Hugging Face și OpenRouter își unesc forțele (blogul Hugging Face) · Anunțul @huggingface
Perplexity Frontier Research: o inițiativă de cercetare deschisă care urmărește crearea unui cercetător științific automatizat, cu peste 10 000 GPU
16 noiembrie — Perplexity lansează Perplexity Frontier Research, o inițiativă al cărei scop este construirea unui „cercetător științific automatizat” (automatic research scientist): un sistem de IA capabil să parcurgă singur ciclul cercetării, de la întrebare la ipoteză, de la experiment la revizuirea propriilor convingeri. Perplexity opune această ambiție predicțiilor de tip „cutie neagră” pentru sarcini înguste: obiectivul este producerea de cunoștințe noi și interpretabile.
We aim to create an automated research scientist. Research is a loop that involves asking the right questions, hypothesizing, navigating ambiguity, designing experiments, and updating beliefs. We think this loop can run inside software, for anyone.
🇷🇴 Vrem să creăm un cercetător științific automatizat. Cercetarea este un ciclu care constă în a pune întrebările potrivite, a formula ipoteze, a gestiona ambiguitatea, a concepe experimente și a-ți revizui convingerile. Credem că acest ciclu poate rula într-un program, pentru toată lumea. — @andrewgwils pe X
Programul este organizat în jurul a șase piloni: orchestrare multi-agent, preantrenare, învățare continuă, învățare prin întărire, sisteme și evaluări. Site-ul dedicat precizează că echipa va preantrena modele cu ponderi deschise, eficiente și specializate și că, în orchestrare, urmărește cea mai bună calitate pentru fiecare nivel de cost. Denis Yarats pune accentul pe învățarea prin întărire la scară largă, pe peste 10 000 GPU, alimentată cu date sintetice și medii provenite din utilizarea reală a Perplexity; întreaga infrastructură, de la cercetare la sandbox-uri, este dezvoltată intern.
| Element al anunțului | Angajamentul Perplexity |
|---|---|
| Putere de calcul | peste 10 000 GPU |
| Piloni de cercetare | 6 |
| Publicații promise | articole, postări, date, modele și cod |
| Orașe în care se fac recrutări | San Francisco, Palo Alto, New York, Londra |
| Termen prioritar pentru candidaturi | 5 decembrie |
Andrew Gordon Wilson este prezentat pe site drept coordonatorul cercetării din cadrul inițiativei. Anunțul este și un apel la candidaturi, însoțit de o bursă de cercetare pentru parcursuri predoctorale și postdoctorale. Niciun model, benchmark sau articol nou nu însoțește lansarea: site-ul reunește sub titulatura Frontier Research lucrări deja publicate, precum WANDR, Decider, SPACE, Brain sau JOLT.
🔗 Prezentarea Perplexity Frontier Research · Anunțul @perplexity_ai · research.perplexity.ai · Seria de postări a lui @denisyarats
IA și cercetarea științifică la OpenAI: un blog dedicat inaugurat de fizicianul Nathaniel Craig, ChatGPT for Academic Researchers extins la 200 000 de cercetători
Un blog științific, inaugurat cu o definiție candidată a Modelului standard pe rețea, construită cu GPT-6 Astra
15 noiembrie — OpenAI deschide un blog dedicat științei, unde cercetătorii și echipele vor împărtăși rezultate și metode, inclusiv modul de verificare a lucrărilor. Primul articol al unui invitat este semnat de Nathaniel Craig, fizician al particulelor la Universitatea Californiei din Santa Barbara și cercetător invitat la OpenAI.
El prezintă o prepublicare din octombrie, pregătită cu GPT-6 Astra, care propune o definiție candidată a Modelului standard pe rețea, o grilă care discretizează spațiul-timp. Întrucât forța slabă distinge particulele „stângi” de cele „drepte”, formularea pe rețea face să apară parteneri paraziți, iar regula de fază rămăsese o problemă deschisă pentru Modelul standard complet de peste 25 de ani. Potrivit lui Craig, GPT-6 Astra a găsit cum să transporte câmpurile către grile mai fine și a condus elaborarea demonstrației detaliate, verificată apoi de trei specialiști. Autorul rămâne prudent: definiția este „candidată”, valabilă sub o limită impusă intensității câmpurilor și reprezintă mai degrabă un răspuns de principiu decât un instrument de simulare.
🔗 Un pas spre definirea Modelului standard pe o rețea · Noul nostru blog dedicat științei
ChatGPT for Academic Researchers vizează 200 000 de cercetători, un studiu analizează 1 819 oameni de știință
16 noiembrie — Lansat în iulie cu un obiectiv de 100 000 de cercetători, programul ChatGPT for Academic Researchers vizează acum 200 000. Următoarea rundă se deschide luni, 23 noiembrie: 50 000 de burse acordate primilor candidați eligibili, nu prin tragere la sorți ca până acum, fiecare acoperind titularul și până la doi colaboratori, adică până la 150 000 de persoane. Accesul trece de la ChatGPT Pro la ChatGPT Plus: potrivit OpenAI, majoritatea participanților la programul-pilot s-ar fi încadrat în limitele Plus.
Echipa de cercetare economică a OpenAI publică în paralel un studiu asupra a 580 186 de mesaje provenite de la 1 819 oameni de știință, completat de un sondaj în rândul a 251 dintre aceștia. Participanții estimează că aceeași muncă, la aceeași calitate, le-ar fi luat de aproximativ 1,9 ori mai mult timp fără IA, iar 98 % dintre respondenți se așteaptă ca IA să accelereze descoperirile din domeniul lor. OpenAI subliniază limitele studiului: productivitate declarată, așteptări mai degrabă decât rezultate, niciun efect cauzal demonstrat.
| Utilizarea ChatGPT de către oamenii de știință | Ponderea medie a mesajelor |
|---|---|
| Lectură și învățare | 28 % |
| Redactare și comunicare | 27 % |
| Analiza dovezilor și a teoriilor | 17 % |
| Scrierea de software pentru cercetare | 14 % |
🔗 Extinderea accesului oamenilor de știință la IA · Știința la frontieră: cum folosesc oamenii de știință ChatGPT
Siguranța și securitatea IA: evaluatori independenți la OpenAI, clasificator CSAM deschis, atacuri agentice observate de Google
OpenAI oferă Apollo Research, METR, Transluce și Goodfire acces la modelele sale interne
16 noiembrie — OpenAI a încheiat cu patru organizații independente acorduri pentru o primă etapă de evaluări integrate (embedded assessments): acces aprofundat, uneori la aceleași resurse ca cercetătorii săi (checkpoints, cod, date de antrenare și evaluare, sisteme de monitorizare, echipe), pentru a evalua alinierea și eficacitatea măsurilor de protecție în timp. Activitatea se desfășoară la sediu, pe dispozitive OpenAI, sub supravegherea Safety and Security Committee, care primește rapoartele integrale; OpenAI își păstrează dreptul de a elimina informațiile confidențiale și de a solicita o amânare înainte de publicare.
| Evaluator independent | Obiectul evaluării | Remunerație din partea OpenAI |
|---|---|---|
| Apollo Research | Subversiune ascunsă și detectarea prin măsurile de protecție | Da, fără legătură cu rezultatele |
| METR | Dezaliniere în cel mai amplu antrenament RL, domeniu restrâns | Nu (posibile credite API sau resurse de calcul) |
| Transluce | Evaluări ale alinierii după antrenare | Nu (posibile credite API sau resurse de calcul) |
| Goodfire | Interpretabilitatea mecanismelor interne ale modelelor | Da, fără legătură cu rezultatele |
🔗 Prima noastră etapă de evaluări integrate
Un clasificator de imagini CSAM gratuit pentru organizațiile verificate, cu un semnal pentru conținutul generat de IA
16 noiembrie — OpenAI pune gratuit la dispoziția organizațiilor verificate, prin API-ul său, omni-moderation-csam-latest, un clasificator de imagini care identifică potențialul conținut cu abuzuri sexuale asupra copiilor (CSAM) și returnează un al doilea semnal pentru materialele care ar putea fi generate de IA. Conceput cu sprijinul NCMEC, este prezentat de OpenAI drept primul clasificator CSAM disponibil pe scară largă care oferă acest al doilea semnal; Tech Coalition și ROOST ajută la extinderea accesului. Potrivit testelor OpenAI, ar semnala cu 48 % mai puține imagini decât sistemul de protecție actual, pentru aproximativ același număr de abuzuri identificate (o estimare). În rândul partenerilor cu acces anticipat, fal confirmă drept neidentificate anterior 72 % dintre conținuturile semnalate cu un grad ridicat de încredere, iar SafetyKit detectează 90 % dintre desene sau animații. În ChatGPT, căutarea acestui tip de conținut declanșează acum un avertisment, ștergerea conversației și suspendarea accesului timp de 24 de ore; repetarea abaterii poate duce la închiderea contului sau la sesizarea autorităților.
🔗 Consolidarea luptei împotriva abuzului sexual online asupra copiilor · Changelog-ul API-ului OpenAI
Google Threat Intelligence: atacatorii automatizează integral descoperirea și exploatarea vulnerabilităților
16 noiembrie — În bilanțul său trimestrial privind utilizarea rău intenționată a IA, Google Threat Intelligence Group (GTIG) constată că atacatorii folosesc framework-uri ofensive multi-agent open source (ARTEX, CAIRN, CyberStrikeAI, PentAGI). Pentru prima dată, potrivit GTIG, unii actori au automatizat descoperirea și exploatarea vulnerabilităților fără intervenție umană în proces: un framework numit exploit_agent, găsit pe un server expus, compara codul de dinainte și de după corecții, scria exploit-uri și le executa; potrivit telemetriei victimelor, operatorul său părea să vizeze în principal site-uri franceze din domeniul mass-media și al divertismentului, precum și din educație. Numărul vulnerabilităților zero-day exploatate crește de la o medie de 8 pe lună în 2025 la 11 în 2026, cu un vârf de 22 în august. Un grup suspectat că ar fi nord-coreean a modificat fișiere .claude/settings.json în depozite interne, astfel încât Claude Code să instaleze un backdoor la pornire.
For the most part, attackers aren’t using new groundbreaking methods to break into systems — they are still going after known, unfixed issues, just with much greater speed and scale.
🇷🇴 În esență, atacatorii nu folosesc metode noi, revoluționare, pentru a pătrunde în sisteme: vizează în continuare vulnerabilități cunoscute și neremediate, doar că o fac cu mult mai multă viteză și la o scară mult mai mare. — John Hultquist, analist-șef, GTIG, pe blog.google
🔗 GTIG AI Threat Tracker (Google Cloud)
Funcții Google pentru publicul larg: site-uri interactive în Gemini Notebook, 66 de voci regionale în Gemini, Ask Maps în 30 de țări din Europa
Gemini Notebook transformă sursele unui caiet de notițe în site-uri interactive
16 noiembrie — Gemini Notebook poate acum transforma sursele unui caiet de notițe în site-uri interactive. Este suficient să introduci make me a site în chatul caietului de notițe, împreună cu descrierea a ceea ce dorești: o explicație vizuală pentru recapitulare (un tabel periodic interactiv, o cronologie istorică), un tablou de bord (vânzările dintr-un trimestru) sau un instrument de urmărire a unui proiect, cu sarcinile și termenele sale. Site-ul se deschide într-o filă nouă sau poate fi partajat direct. Funcția este lansată treptat la nivel mondial pe web începând cu 16 noiembrie pentru utilizatorii de 18 ani și peste, inclusiv abonații Google Workspace; aplicația mobilă va urma „în curând”, fără o dată anunțată.
🔗 Gemini Notebook: site-uri interactive pornind de la surse (blog.google) · Anunțul @Gemini_Notebook
Aplicația Gemini lansează 66 de voci regionale pe Android și iOS
16 noiembrie — Aplicația Gemini lansează 66 de voci regionale noi pe Android și iOS, în special pentru engleza americană, britanică și indiană, hindi, portugheza braziliană, indoneziană și coreeană, cu opțiuni specifice fiecărei limbi. Google afirmă că sunt ajustate pentru un ritm natural și o bună claritate, mai degrabă decât pentru accente exagerate. Vocea aleasă se aplică în întreaga aplicație: conversații cu Gemini Live, exersarea unei limbi, citirea cu voce tare a unui răspuns. Poate fi selectată din meniul Gemini Live sau din setări. Google anunțase acest proiect de dialecte locale la Google I/O.
🔗 Vocile regionale ale aplicației Gemini (blog.google)
Ask Maps ajunge în 30 de țări din Europa și învață să pregătească itinerare și programări
16 noiembrie — Ask Maps, asistentul conversațional din Google Maps bazat pe modelele Gemini, lansat în Statele Unite și India și prezentat aici pe 12 martie, începe să se extindă în 30 de țări din Europa, printre care Spania, Germania și Regatul Unit. Google afirmă că acesta este acum prezent în peste 200 de țări și teritorii; articolele nu menționează Franța. În aceeași zi, Ask Maps primește funcții noi, în curs de lansare pe Android și iOS:
| Funcție nouă în Ask Maps | Disponibilitate anunțată |
|---|---|
| Itinerare pentru fiecare zi, care pot fi partajate și exportate în Google Docs | Oriunde este disponibil Ask Maps |
| Căutare în listele salvate, cu disponibilitate în timp real | Oriunde este disponibil Ask Maps |
| Sfaturi de călătorie (Ce trebuie să știi înainte să pleci): parcare, încărcare, vreme, taxe de drum | Mai întâi în Statele Unite |
| Căutarea programărilor disponibile și apelarea afacerilor locale | Mai întâi în Statele Unite |
🔗 Noile funcții Ask Maps (blog.google) · Ask Maps ajunge în Europa (blog.google)
Căutarea de informații pentru dezvoltatori și companii: Monitor API de la Perplexity, Video Intelligence în Cohere Compass
Perplexity lansează Monitor API, care monitorizează webul sau anumite pagini și trimite notificări prin webhook
16 noiembrie — Perplexity lansează Monitor API, care monitorizează webul pentru o aplicație sau un agent. Există două moduri: urmărirea noutăților despre un subiect, o companie sau o întrebare prin Perplexity Search ori urmărirea a până la 10 pagini specifice (tarifele unui concurent, changelog, politică) și primirea unui diff textual al modificărilor. Dezvoltatorul își poate descrie obiectivul în limbaj natural; Perplexity Decider verifică relevanța, legitimitatea sursei, noutatea și actualitatea fiecărui rezultat, iar numai actualizările care trec toate pragurile sunt trimise, prin webhooks semnate, împreună cu un scor de încredere. Monitoarele rulează la fiecare 15 minute, la fiecare oră, zilnic, săptămânal sau conform unei expresii cron.
| Tip de monitor | Unitate facturată | Preț anunțat |
|---|---|---|
| Monitor web | execuții reușite | 1 dolar pentru 1 000 |
| Monitor de pagini | URL-uri preluate | 1 dolar pentru 1 000 |
API-ul este disponibil chiar acum, cu aceeași cheie ca API-urile Search, Context și Agent. Potrivit Perplexity, pentru 60 de subiecte urmărite timp de opt ore, Monitor a furnizat rezultate mai recente și mai relevante decât alți furnizori de Search API.
🔗 Prezentarea Monitor API de la Perplexity
Cohere introduce Video Intelligence în Compass, pentru a găsi momentul exact dintr-un videoclip
16 noiembrie — Cohere adaugă conținutul video în Compass, platforma sa de căutare pentru companii, prin Video Intelligence, disponibil în previzualizare privată. În loc să returneze o înregistrare de o oră, Compass găsește momentul care răspunde la întrebare: un fragment cu marcaj temporal, transcriere și descrierea a ceea ce apare pe ecran, cu limite stabilite în momentul căutării. Conținutul video se alătură documentelor într-un singur index, care respectă drepturile fiecărui utilizator, iar agenții îl accesează prin serverul MCP al Compass. Pe 11 seturi de date și 11 133 de interogări, Compass ocupă în medie primul loc în comparație cu șapte modele de embeddings video, cu un avans de 4,4 puncte nDCG@10 față de cea mai bună alternativă, potrivit Cohere. Compania recrutează parteneri de dezvoltare (design partners), care pot implementa instrumentul în cloudul gestionat de Cohere sau în propriul mediu; nu sunt comunicate nici prețul, nici data disponibilității generale.
🔗 Prezentarea Video Intelligence în Compass · Anunțul @cohere
Evaluarea modelelor și agenților: JFinBench de la Sakana AI pentru finanțele japoneze, evaluările agenților de la Together AI
JFinBench: în finanțele japoneze, cel mai bun model deschis rămâne la 12,4 puncte în urma Claude Fable 5
16 noiembrie — Sakana AI publică JFinBench (articol datat 17 noiembrie, ora Japoniei), un benchmark alcătuit din întrebări din sesiunile din 2026 ale șase examene financiare japoneze, de la expertiză contabilă la consultanță fiscală, conceput pentru a fi reînnoit la fiecare sesiune pentru a limita contaminarea. Au fost evaluate 12 modele pe 321 de întrebări; iată primele cinci în clasamentul fără instrumente:
| Model evaluat | Scor fără instrumente | Scor cu instrumente (harness) |
|---|---|---|
| Claude Fable 5 | 95,8 | 96,4 (Terminus-2) |
| GPT-6 Astra | 93,6 | 97,3 (Terminus-2) |
| Gemini 3.8 Flash | 88,8 | 94,2 (Terminus-2) |
| Kimi K3.1 Pro | 83,4 | 92,9 (Kimi Code) |
| Kimi K3 | 79,9 | 91,0 (Kimi Code) |
Kimi K3.1 Pro, cel mai bun model deschis, rămâne la 12,4 puncte în urma Claude Fable 5 și la aproximativ 10 în urma GPT-6 Astra, deși este prezentat ca fiind înaintea acestuia din urmă pe Terminal-Bench 4.0 (65,7 % față de 58,2 %, cifre furnizate de producători). Eșecurile provin în principal din lipsa cunoștințelor despre sistemul japonez, nu din calcule. Cu terminal și acces web, diferența dintre cel mai bun model deschis și cel mai bun model proprietar scade la 4,4 puncte. Într-un experiment preliminar, exclus din scoruri, DeepSeek V4.1 Flash 1017 și Gemini 3.8 Flash au găsit o cheie OpenRouter uitată în mediu și au folosit-o pentru a apela alte modele.
🔗 JFinBench (Sakana AI) · Articolul JFinBench pe arXiv
Together AI: evaluări ale agenților care au crescut rata de reușită a sarcinilor cu documentația sa MCP de la 67 la 96 %
16 noiembrie — Together AI explică în detaliu cum măsoară ușurința de utilizare a platformei sale de către agenții de programare, ceea ce numește experiența agentului (agent experience). Aproximativ zece sarcini obișnuite (lansarea unui job în lot, rezervarea unui cluster GPU, gestionarea autoscaling) sunt încredințate lui Claude Code într-un mediu sandbox, în trei configurații: fără asistență, cu serverul MCP de documentație sau cu pachetul de skill-uri Together. Configurația MCP a trecut de la 67 % dintre sarcini reușite pe 15 iunie la 96 % pe 30 septembrie, iar skill-ul unificat a atins 97 % (70 din 72) pe 8 octombrie, față de 82 % pentru varianta de bază fără asistență; Together recunoaște că aceste măsurători nu sunt strict comparabile. La rezervarea unui cluster GPU, Sonnet 4.6 reușea doar în 4 încercări din 15; două fraze adăugate în skill au dus rata de reușită la 100 % pentru toate modelele testate. Instrumentul de evaluare urmează să fie publicat ca open source în săptămâna următoare, potrivit Together.
🔗 Cum facem Together AI ușor de utilizat de către agenții de programare
Achiziții și parteneriate: ElevenLabs achiziționează Kotoba, divizia media a LVMH semnează cu OpenAI
ElevenLabs anunță achiziția Kotoba, laborator japonez de IA vocală
16 noiembrie — ElevenLabs anunță achiziția Kotoba, un laborator japonez de IA vocală fondat în 2023 de Noriyuki Kojima și Jungo Kasai. Modelul său Koto acoperă sinteza vocală, transcrierea și traducerea din vorbire în vorbire pentru interpretare simultană în japoneză; Salesforce îl folosește pentru conversațiile în japoneză din Agentforce Voice. ElevenLabs dorește să integreze această cercetare în ElevenAgents, platforma sa de agenți vocali, și intenționează să recruteze responsabili comerciali și să investească în infrastructură în Japonia în lunile următoare. Tranzacția nu este încă încheiată: finalizarea sa este așteptată în al patrulea trimestru din 2026, sub rezerva aprobărilor autorităților de reglementare, iar valoarea nu este comunicată.
🔗 Kotoba se alătură ElevenLabs · Anunțul @ElevenLabs
Divizia media a LVMH (Les Echos, Le Parisien) implementează ChatGPT Enterprise și își promovează conținutul în ChatGPT
16 noiembrie — Groupe Les Echos-Le Parisien, divizia media a LVMH, semnează un acord strategic cu OpenAI. Cele 17 mărci ale sale, printre care Les Echos, Le Parisien, Challenges, Paris Match, L’Opinion și L’Agefi, implementează ChatGPT Enterprise și instrumentele OpenAI în toate echipele, cu instruire adaptată fiecărei profesii: căutarea și compararea documentelor, traducere preliminară, personalizarea produselor pentru cititori și agenții de publicitate. A doua componentă: conținutul diviziei va fi promovat mai mult în ChatGPT, sub formă de rezumate și fragmente cu indicarea sursei și linkuri către articole. Grupul are 1 800 de angajați, dintre care aproape 700 de jurnaliști, și ajunge la peste 27 de milioane de persoane în fiecare lună în Franța. Valoarea acordului nu este comunicată.
🔗 Divizia media a LVMH anunță un parteneriat strategic cu OpenAI
Agenți de programare: Claude Code testează aplicațiile pe iPhone Duo, Replit publică aplicațiile Agentului său în Microsoft Fabric
Claude Code pe desktop pliază iPhone Duo în simulatorul său iOS și promovează pluginul Xcode de la Apple
16 noiembrie — Claude Code pe desktop oferă suport pentru iPhone Duo în panoul său de simulator iOS, în versiune beta publică: aplicația în curs de dezvoltare rulează pe un Duo simulat lângă conversație, iar Claude pliază și depliază dispozitivul pentru a verifica fiecare aranjare a interfeței. Potrivit documentației, dispozitivul are trei poziții (închis, întredeschis, deschis) și se poate solicita un unghi al balamalei de la 1 la 179 de grade. Pentru a adapta o aplicație existentă, Claude Code poate propune skill-ul App Resizability de la Apple, care identifică problemele de aranjare a interfeței și sugerează corecții pe care Claude le aplică după aprobare. Sunt necesare un Mac, Claude Desktop v4.29.0 sau o versiune ulterioară și Xcode 27.1 sau o versiune ulterioară; panoul rămâne disponibil exclusiv pentru sesiunile locale, în planurile Pro, Max, Ultra, Team și Enterprise, cu excepția configurației HIPAA. Simulatorul iOS în sine a fost introdus pe 22 iulie. Pentru terminal, Anthropic promovează pluginul Xcode de la Apple, prezent în marketplace-ul oficial din 6 noiembrie și instalat prin /plugin install xcode@claude-plugins-official.
🔗 Anunțul @ClaudeDevs · Documentația simulatorului iOS
Replit Agent își publică aplicațiile în Microsoft Fabric, cu disponibilitate generală
16 noiembrie — Replit anunță disponibilitatea generală a integrării sale cu Microsoft Fabric, platforma de date Microsoft: utilizatorul descrie o aplicație, Replit Agent o construiește pe baza datelor guvernate ale companiei, apoi aceasta este implementată direct în tenantul Fabric al organizației. Potrivit paginii de partener, Agentul citește schema, tabelele și etichetele de sensibilitate Purview din OneLake fără a copia datele; aplicația, configurată cu autentificare Microsoft Entra, îi afișează fiecărui utilizator doar datele la care are drept de acces și se bazează pe Copilot în Fabric și pe capacitatea de IA deja existentă în tenant. Integrarea fusese lansată la Microsoft Build împreună cu Leatherman, iar pagina de partener nu indică niciun preț. Pe 13 noiembrie, Replit o extinsese la aplicațiile cu bază de date. Totuși, documentația conectorului Fabric descrie încă o versiune de previzualizare, rezervată membrilor unui program de testeri aprobați.
🔗 Anunțul @Replit · Pagina Replit ca partener Microsoft · Documentația conectorului Microsoft Fabric
Pe scurt
Agenți de programare și CLI
- GitHub Copilot retrage trei modele — După cum a anunțat pe 15 octombrie, Claude Opus 4.8, Claude Opus 5 și GPT-5.6 Terra sunt retrase din majoritatea experiențelor Copilot, fiind înlocuite cu Claude Opus 5.5, GPT-6.1 Sol sau GPT-6 Luna. Precizare din changelog: Claude Opus 5 dispare din selector, dar rămâne disponibil ca rezervă atunci când o cerere este respinsă la execuție. 🔗 sursă
- Copilot CLI 1.0.113-0 — Această versiune preliminară apare fără note detaliate, cu singura mențiune că include remedieri și modificări; cea mai recentă versiune stabilă rămâne 1.0.112 din 13 noiembrie. 🔗 sursă
- GitHub Agentic Workflows 1.3.0 — Aflată încă în fază preliminară, această versiune scoate ledgers din stadiul experimental și adaugă un mecanism de control,
require-agent-success, care blochează publicarea rezultatelor când jobul agentului a eșuat; refuzurile Copilot legate de politica de securitate cibernetică nu mai declanșează automat o nouă încercare. 🔗 sursă - Codex CLI 0.171.0-alpha.9 — Trei versiuni preliminare fără note de la alpha.6 încoace; potrivit titlurilor celor 41 de commituri ale acestora,
codex execpoate utiliza un server de aplicații la distanță, iar terminalul afișează recomandări privind responsabilitatea și riscurile în timpul review-urilor. Cea mai recentă versiune stabilă rămâne 0.169.0. 🔗 sursă - Agents SDK de la OpenAI — Versiunea preliminară Python v0.24.0-alpha.8 permite aprobarea sau respingerea unui apel de instrument după vizualizarea argumentelor sale, conectarea LiteLLM sau AnyLLM și adăugarea funcționalităților vocale în timp real prin WebSocket, WebRTC sau SIP; în JavaScript, v0.22.0-alpha.3 poate executa implicit în paralel callbackurile instrumentelor. 🔗 sursă
- Gemini CLI — O remediere integrată în ramura principală, încă nepublicată, face ca serverele MCP declarate de administrator să fie ignorate dacă comenzile sau scripturile lor pot fi în continuare modificate de un utilizator obișnuit, care altfel putea moșteni aprobarea automată a unui server autorizat. 🔗 sursă
- ZCode v3.18.2 — Z.ai publică pe GitHub această versiune a mediului său de dezvoltare asistată de IA pentru macOS și Windows, fără note de versiune, după sincronizările de cod 3.18.0 și 3.18.1 care nu au fost urmate de un release. 🔗 sursă
- Cache de prefix pentru agenți — Together AI și Ollama explică faptul că harnessul (Claude Code, Codex sau Pi prin
ollama launch) trebuie să păstreze începutul promptului identic, iar motorul trebuie să direcționeze fiecare rundă către GPU-ul care deține cache-ul: pentru 100 de runde, sunt procesate 5 050 de unități de prompt fără cache, față de 100 cu cache, într-un calcul idealizat. 🔗 sursă - Fabrici de software la nivel de echipă — Într-un articol de opinie pe blogul Warp, Zach Lloyd pledează pentru mutarea agenților din configurațiile fiecărui dezvoltator (harness, model, skills, MCP) într-o infrastructură cloud comună, descrisă în cod și deținută de echipă. 🔗 sursă
Alte noutăți de la GitHub
- AI Scan în lot — Analiza cu IA a vulnerabilităților din repository-uri poate fi lansată acum pentru cel mult 20 de repository-uri simultan, din setările organizației sau din pagina alertelor de code scanning, în versiune preliminară publică și fără licență Copilot. 🔗 sursă
- GitHub Mobile pe iPhone Duo — Aplicația iOS își adaptează aspectul după deschiderea dispozitivului și adaugă file verticale pentru Copilot, pull requests, issues și notificări. 🔗 sursă
Calcul, simulare și robotică
- Lambda și NVIDIA Photonics — Lambda conectează rackuri GB300 NVL72 care însumează peste 10 000 de GPU-uri prin switchuri cu optică cointegrată (co-packaged optics); potrivit testelor sale, latența scade cu aproximativ 4 % la nivel de rack și cu până la aproximativ 10 % la nivel de pod, iar componentele optice funcționează la 36 °C, față de 51 °C pentru cele detașabile. 🔗 sursă
- Google Cloud în MLPerf Training v6.1 — În primul benchmark MLPerf pentru învățare prin întărire agentică, potrivit Google, 640 de TPU-uri Ironwood ating precizia țintă în 18,02 minute; la preantrenare, 8 192 de TPU-uri Ironwood reușesc în 1,70 minute, iar 256 de GPU-uri GB300 în 31,96 minute. 🔗 sursă
- NVIDIA Cosmos — Modelele deschise ale lumii de la NVIDIA depășesc 20 de milioane de descărcări pe Hugging Face, potrivit NVIDIA, fără precizarea perioadei sau a sferei de măsurare. 🔗 sursă
- LidarVerse — NVIDIA Research readuce în atenție acest model din octombrie, care generează, prezice și resimulează scanări LiDAR, la 10 cadre pe secundă pe un singur H100 în versiunea distilată; codul este disponibil sub licența Apache 2.0. 🔗 sursă
- AI Day Seoul — NVIDIA prezintă bilanțul evenimentului său din Coreea: peste 2 000 de participanți, peste 500 de dezvoltatori instruiți sau certificați în coreeană și un hackathon câștigat de echipa FlyGate cu agenți construiți pe OpenShell. 🔗 sursă
- projectsim (Kaedim) — Peste 200 de obiecte 3D pregătite pentru simulare robotică, dintre care 140 articulate, devin gratuite și sunt adăugate și în SimReady Central de la NVIDIA, unde șapte sunt deja disponibile online. 🔗 sursă
Modele deschise și Hugging Face
- CI pentru llama.cpp — În fața celor 3 181 de pull requests din trei luni și a limitelor planului gratuit GitHub (10 Go de cache, 20 de joburi simultane), echipa mai lansează doar joburile afectate de diff, își stochează cache-urile ccache în Hugging Face Buckets și rulează majoritatea joburilor Linux x64 pe Hugging Face Jobs. 🔗 sursă
- Accelerate v1.16.0 — Biblioteca de antrenare distribuită de la Hugging Face necesită acum Python 3.11 și PyTorch 2.6, se bazează mai mult pe
torch.acceleratorpentru acceleratoarele înregistrate în PyTorch și elimină PiPPy, MS-AMP șiFP8RecipeKwargs. 🔗 sursă - Tiny Aya Global — Cinci articole ale comunității, majoritatea provenite din hackathonul Lexsi Labs, explorează micul model multilingv de la Cohere Labs: un agent de baze de date trece de la o rată de succes de 0,5 la 49,1 % în trei runde de autoreparare, iar controlul refuzurilor reduce puternic răspunsurile dăunătoare în bengaleză și swahili, cu prețul unui număr dublu de refuzuri excesive, potrivit autorilor. 🔗 sursă
- Modular Diffusers — Un ghid arată cum poate fi utilizat în Diffusers un model încă neintegrat, prin convertirea ponderilor sale și publicarea unor blocuri pe Hub; autorul a încredințat sarcina lui Claude Code cu Claude Opus 5.5, conversia nereușind cu Astra. 🔗 sursă
- Modele mici pe telefon — Un dezvoltator publică două fluxuri complete de cumpărare pe Amazon, realizate local de Qwen3.5 0,8B și 2B pe telefoane Android, cu o intrare mediană de 45 de tokens per apel; cel mai lent, pe un Galaxy A04e, a durat 4 h 20 pentru 578 de apeluri. 🔗 sursă
- Ask AdMob — Google prezintă un agent conversațional construit cu Gemini în contul AdMob, care va fi testat în lunile următoare, publică de acum agent skills AdMob pentru agenții de programare și pregătește un server MCP, aflat în testare timpurie, care va fi deschis mai multor dezvoltatori la începutul lui 2027. 🔗 sursă
- Google Flow — Pe 12 noiembrie, Google a adăugat în studioul său creativ cinci instrumente concepute de artiști, printre care Pocket Studio, care obține mai multe unghiuri de cameră dintr-o singură filmare cu telefonul, și Pixel Machine pentru stiluri retro. 🔗 sursă
Voce, imagine și video
- Nemotron 3.5 Transcribe — NVIDIA anunță primul loc ocupat de modelul său deschis în clasamentul de diarizare al Artificial Analysis, publicat pe 13 noiembrie: 3,3 % de cuvinte atribuite greșit (WDER) în 97 de conversații cu două până la opt persoane, înaintea Voxtral Small Transcribe 3 (7,5 %). 🔗 sursă
- FLUX: In Production — Black Forest Labs lansează un concurs de filme realizate cu IA, ale cărui briefuri sunt redactate de studiouri partenere, cu premii de peste 25 000 de dolari; concursul se desfășoară online între 30 noiembrie și 13 decembrie. 🔗 sursă
- Kling Image 4.0 — Kling anunță lansarea în curând a noului său model de imagine, fără dată sau caracteristici. 🔗 sursă
Companii și formare
- Autotorino și ElevenAgents — Grupul italian de dealeri auto, care primește aproximativ 100 000 de apeluri pe lună, își încredințează apelurile unui agent vocal care califică solicitarea și creează înregistrarea potențialului client; volumul apelurilor prelucrate automat a crescut de peste două ori. 🔗 sursă
- Dots de la Holiday Extras — Într-un studiu de caz OpenAI, dot-ul unui manager identifică singur lansarea unei funcții, interoghează Google BigQuery și livrează un raport fără să i se ceară; un altul pregătește rapoarte în timpul deplasării utilizatorului său. 🔗 sursă
- OpenAI și The King’s Trust — OpenAI oferă 1 milion de lire sterline organizației britanice pentru a instrui în IA până la 25 000 de tineri în 18 luni, acordând prioritate celor care nu lucrează, nu studiază și nu urmează un program de formare. 🔗 sursă
- IA în formare, potrivit Synthesia — Al treilea raport anual, cu peste 800 de respondenți din peste 25 de țări: 87 % dintre echipele care utilizează IA o folosesc pentru a genera conținut, dar numai 29 % practică învățarea personalizată, față de 70 % care o practicau sau o planificau în urmă cu un an. 🔗 sursă
Perplexity
- Valori numerice evidențiate în surse — În Computer și Teammates, deschiderea documentului-sursă al unui răspuns evidențiază acum valoarea numerică exactă citată, pe web pentru toți utilizatorii, potrivit @AskPerplexity. 🔗 sursă
- Ghid IA versus AGI — Perplexity publică un ghid care distinge IA utilizată astăzi de AGI și propune o metodă pentru verificarea unui anunț privind AGI; acesta menționează un scor de 21,3 % pentru Claude Opus 5.5 pe Remote Labor Index la data de 9 octombrie. 🔗 sursă
Ce înseamnă toate acestea
Diferența dintre modelele deschise și cele închise se măsoară acum în dolari la fel de mult ca în puncte. Qwen4-Max coboară sub tarifele Qwen3.8-Max și anunță o reducere cu 62 % a costului per sarcină, dar conduce doar la 4 dintre cele 16 teste din propriul tabel, iar nimic nu indică faptul că ponderile sale vor fi deschise. Hugging Face mizează pe cealaltă direcție: încredințându-și rutarea către OpenRouter, se bazează pe modele deschise care reprezintă 71,7 % din tokens de pe OpenRouter și costă, în medie, de aproximativ patru ori mai puțin. Același articol recunoaște totuși o diferență de 19 puncte în fruntea Intelligence Index, iar JFinBench măsoară o diferență de 12,4 puncte în finanțele japoneze fără instrumente, redusă la 4,4 cu acces la web: în domeniile puțin evaluate, avantajul modelelor închise ține în primul rând de ceea ce știu.
Agenții ies din terminal și intră în sisteme de afaceri cu reguli de guvernanță. În ChatGPT for Healthcare, agentul care controlează computerul conectează dosarul medical la portalul unui asigurător, cu controale de acces bazate pe roluri, jurnale de audit și BAA; la Replit, aplicația construită de Agent este creată în tenantul Fabric al clientului, cu drepturile sale Entra ID și etichetele sale Purview. Aceeași evoluție îi avantajează și pe atacatori: potrivit GTIG, un framework a înlănțuit fără intervenție umană descoperirea și exploatarea vulnerabilităților, iar un grup a modificat malițios configurația Claude Code pentru a instala un backdoor. Remedierea Gemini CLI privind serverele MCP modificabile reamintește acest lucru în felul său: aprobarea automată a unui instrument este la fel de fiabilă ca integritatea scriptului care îl lansează.
Știința devine argumentul comun al calculului și al agenților. NVIDIA prezintă Rubin HPC și bibliotecile sale CUDA-X ca instrumente de simulare pe care agenții le vor apela pentru a-și testa ideile, Perplexity vrea să construiască un cercetător automatizat pe peste 10 000 de GPU-uri, iar OpenAI lansează un blog în care un fizician povestește cum GPT-6 Astra a preluat conducerea elaborării unei demonstrații, dublând în același timp ținta programului său pentru cercetători. Promisiunile sunt încă înaintea rezultatelor: Rubin HPC este așteptat în 2028, fără specificații anunțate privind memoria sau FLOPS, Frontier Research nu prezintă niciun model și niciun articol nou, definiția lui Craig rămâne « candidată », iar studiul OpenAI măsoară productivitatea declarată, fără un efect cauzal demonstrat.
Se schimbă și modul de măsurare. OpenAI oferă Apollo Research, METR, Transluce și Goodfire acces la checkpointurile și la procesele sale de antrenare, dar păstrează controlul asupra eliminării informațiilor sensibile și a calendarului de publicare. Together AI arată că două fraze într-un skill fac un model să treacă de la 4 reușite din 15 la 100 %, ceea ce pune în perspectivă diferențele dintre modelele evaluate fără îndrumare. Episodul JFinBench, în care două modele au găsit o cheie OpenRouter uitată și au folosit-o pentru a pune alte modele la lucru, reamintește că o evaluare cu instrumente măsoară și ceea ce mediul lasă la îndemână. Iar avantajul de peste 10 ori al Vera Rubin pe MLPerf Endpoints rămâne provizoriu până când MLCommons îl va verifica.
Surse
- Qwen4-Max: Noul tău coleg de echipă a sosit (articol Qwen)
- Fișa qwen4-max pe QwenCloud
- Anunțul Qwen4-Max (@Alibaba_Qwen)
- Mai multe modalități de a îmbunătăți îngrijirea cu ChatGPT for Healthcare (OpenAI)
- Dezvoltarea agenților care utilizează computerul pentru echipele medicale (OpenAI)
- Rubin HPC (blogul NVIDIA)
- Anunțurile NVIDIA la SC26
- Vera Rubin în MLPerf Training și Endpoints (blogul NVIDIA)
- Slurm și calculul cuantic (blogul NVIDIA)
- Biblioteci CUDA-X pentru știință (blogul NVIDIA)
- Hugging Face și OpenRouter își unesc forțele (blogul Hugging Face)
- Anunțul @huggingface
- Prezentarea Perplexity Frontier Research
- Anunțul @perplexity_ai
- research.perplexity.ai
- Firul de postări al lui Andrew Gordon Wilson (@andrewgwils)
- Firul de postări al lui Denis Yarats (@denisyarats)
- Un pas spre definirea Modelului Standard pe o rețea (OpenAI)
- Noul nostru blog dedicat științei (OpenAI)
- Extinderea accesului la AI pentru oamenii de știință (OpenAI)
- Știința la frontieră: Cum folosesc oamenii de știință ChatGPT (OpenAI)
- Prima noastră etapă de evaluări integrate (OpenAI)
- Intensificarea luptei împotriva abuzului sexual asupra copiilor în mediul online (OpenAI)
- Changelog-ul API-ului OpenAI
- GTIG AI Threat Tracker (Google Cloud)
- Rezumatul raportului GTIG (blog.google)
- Gemini Notebook: site-uri interactive create pe baza surselor (blog.google)
- Anunțul @Gemini_Notebook
- Vocile regionale ale aplicației Gemini (blog.google)
- Noile funcții Ask Maps (blog.google)
- Ask Maps ajunge în Europa (blog.google)
- Prezentarea Monitor API de la Perplexity
- Prezentarea Video Intelligence în Compass (Cohere)
- Anunțul Video Intelligence (@cohere)
- JFinBench (Sakana AI)
- Articolul JFinBench pe arXiv
- Cum simplificăm utilizarea Together AI de către agenții de programare
- Kotoba se alătură ElevenLabs
- Anunțul @ElevenLabs
- Divizia media a LVMH anunță un parteneriat strategic cu OpenAI
- Anunțul @ClaudeDevs
- Documentația simulatorului iOS din Claude Code
- Anunțul @Replit
- Pagina Replit dedicată parteneriatului cu Microsoft
- Documentația conectorului Microsoft Fabric (Replit)
- Retragerea unor modele din GitHub Copilot (changelog-ul GitHub)
- Copilot CLI 1.0.113-0 (GitHub)
- GitHub Agentic Workflows 1.3.0 (GitHub)
- Codex CLI 0.171.0-alpha.9 (GitHub)
- Agents SDK Python v0.24.0-alpha.8 (GitHub)
- PR 30283 din Gemini CLI (GitHub)
- ZCode v3.18.2 (GitHub)
- Adaptarea modelelor deschise la sarcini agentice de lungă durată (Together AI și Ollama)
- Articolul lui Zach Lloyd despre fabricile de software (Warp)
- AI Scan pe mai multe depozite (changelog-ul GitHub)
- GitHub Mobile pe iPhone Duo (changelog-ul GitHub)
- Lambda și NVIDIA Photonics (blogul NVIDIA)
- Rezultatele Google Cloud la MLPerf Training v6.1 (blog.google)
- NVIDIA Cosmos, 20 de milioane de descărcări (@NVIDIAAI)
- LidarVerse (@NVIDIAAI)
- Bilanțul AI Day Seoul (blogul NVIDIA)
- Obiecte de simulare gratuite de la projectsim (blogul Hugging Face)
- CI pentru llama.cpp pe Hugging Face Buckets și Jobs (blogul Hugging Face)
- Accelerate v1.16.0 (GitHub)
- Efficient Healer pe Tiny Aya Global (blogul Hugging Face)
- Modele noi cu Modular Diffusers (blogul Hugging Face)
- Secvențe lungi de acțiuni pe telefon cu modele mici (blogul Hugging Face)
- Noile instrumente IA ale AdMob (blog.google)
- Cele cinci instrumente noi din Google Flow (blog.google)
- Nemotron 3.5 Transcribe în indicele de diarizare (@NVIDIAAI)
- FLUX: În producție (@bfl_ai)
- Kling Image 4.0 (@Kling_ai)
- Autotorino și ElevenAgents (ElevenLabs)
- La Holiday Extras, dots se pun la treabă înainte să le ceară cineva (OpenAI)
- The King’s Trust și OpenAI (OpenAI)
- Raportul Synthesia despre IA în formare
- Cifrele evidențiate în Computer și Teammates (@AskPerplexity)
- AGI vs. AI (Perplexity)