ai-powered-markdown-translatorgpt-6.1-sol का उपयोग करके फ़्रेंच से हिंदी में अनुवादित लेख।
शनिवार, 3 अक्टूबर को Aleph Alpha ने Apache 2.0 लाइसेंस के तहत 78,1 अरब पैरामीटर वाला, खुले वज़न का अंग्रेज़ी-जर्मन मॉडल Kolibri जारी किया। उसी शाम Cohere ने भी इसकी घोषणा साझा की, जिसका Aleph Alpha के साथ एकीकरण अभी भी नियामकीय मंज़ूरियों का इंतज़ार कर रहा है। एक दिन पहले Meta ने अपने सुरक्षा ढाँचे को मॉडलों के प्रशिक्षण तक विस्तारित किया था और OpenAI की Agents API में सैंडबॉक्स के तीन आकार जोड़े गए थे। Devin के 30 सितंबर के संस्करण विवरण उसे Jira का नेटिव एजेंट बनाते हैं, Qwen-Image-2.1-Pro प्रति छवि 0,04 डॉलर की कीमत पर API में उपलब्ध हुआ है, और Apron के डेवलपर बताते हैं कि कार्ड किराए पर लेने से पहले किसी खुले मॉडल की GPU मेमोरी का अनुमान कैसे लगाया जा सकता है।
Aleph Alpha ने Apache 2.0 के तहत 78 अरब पैरामीटर वाला अंग्रेज़ी-जर्मन मॉडल Kolibri जारी किया
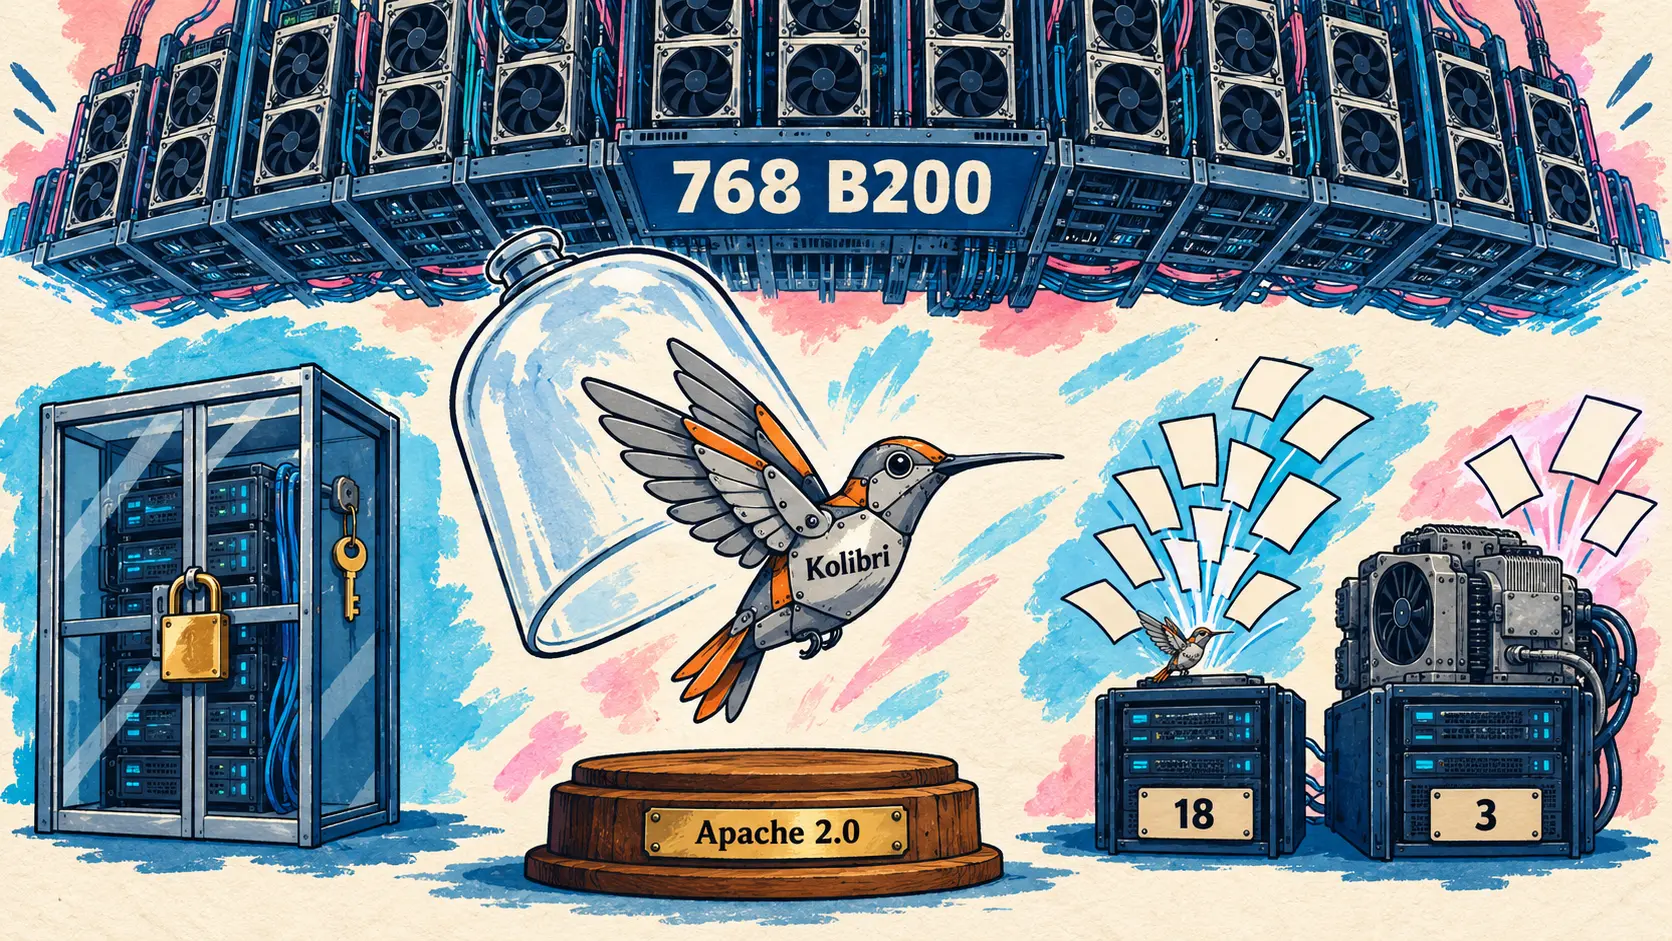
3 अक्टूबर — जर्मन एकता दिवस पर Aleph Alpha ने खुले वज़न वाला अंग्रेज़ी-जर्मन भाषा मॉडल Kolibri जारी किया। विशेषज्ञों के मिश्रण (Mixture-of-Experts) पर आधारित इस मॉडल में 78,1 अरब पैरामीटर हैं, जिनमें से प्रति टोकन 3,46 अरब सक्रिय होते हैं। इसके वज़न Apache 2.0 लाइसेंस के तहत Hugging Face पर उपलब्ध हैं। Aleph Alpha इसे विनियमित क्षेत्रों के संप्रभु कामकाज के लिए प्रस्तुत करता है: सार्वजनिक प्रशासन, उद्योग और विमानन।
इसकी संरचना का प्राथमिक लक्ष्य मॉडल चलाने की लागत है: 384 में से 6 विशेषज्ञ सक्रिय होते हैं, और 50 में से 40 परतें 512 टोकन की स्लाइडिंग विंडो तक सीमित हैं। मॉडल 1 048 576 टोकन तक स्वीकार करता है, लेकिन इसका प्रशिक्षण 262 144 टोकन तक हुआ है और इसके विवरण में इस लंबाई से आगे न जाने की सलाह दी गई है। ब्लॉग लेख के अनुसार, 123 अरब पैरामीटर वाला संस्करण दो H100 पर 256k टोकन वाले केवल 3 अनुरोध संभाल पाता था, जबकि चुने गए आकार का मॉडल 18 अनुरोध संभालता है। प्रशिक्षण में जर्मनी और फ़िनलैंड में 768 B200 GPU इस्तेमाल किए गए और लगभग 24T टोकन संसाधित हुए; पूर्व-प्रशिक्षण में जर्मन भाषा की हिस्सेदारी 21,3 % है।
Aleph Alpha के मापों के अनुसार, जिनमें उसका अपना मूल्यांकन ढाँचा और अधिकतम तर्क प्रयास इस्तेमाल हुआ, Kolibri समग्र स्कोर में Qwen3.5 35B-A3B और 12 अरब पैरामीटर सक्रिय करने वाले Nemotron 3 Super से आगे है, लेकिन सघन मॉडल Qwen3.8 27B लगभग हर माप में आगे बना हुआ है:
| बेंचमार्क (Aleph Alpha के माप) | Kolibri 78B-A3,46B | Qwen3.5 35B-A3B | Nemotron 3 Super 120B-A12B | Mistral Small 4 119B-A6B | Qwen3.8 27B (सघन) |
|---|---|---|---|---|---|
| समग्र स्कोर (अंग्रेज़ी) | 75,5 | 74,7 | 73,0 | 63,1 | 80,2 |
| समग्र स्कोर (जर्मन) | 70,8 | 69,8 | 67,9 | 61,4 | 79,9 |
| GPQA Diamond (अंग्रेज़ी) | 84,3 | 83,8 | 78,0 | 74,7 | 89,2 |
| AIME 2026 (अंग्रेज़ी) | 96,0 | 92,1 | 90,4 | 83,1 | 97,7 |
| SWE-Bench Verified | 66,4 | 71,6 | 60,2 | 60,8 | 72,6 |
इसलिए Aleph Alpha का तर्क पहला स्थान हासिल करना नहीं, बल्कि गुणवत्ता और मॉडल चलाने की लागत के बीच Pareto सीमा पर होना है। उत्तर देने से बचने के लिए प्रशिक्षित Kolibri, AA-Omniscience के जिन सवालों का सही जवाब नहीं दे पाता, उनमें से 44 % पर गलत जवाब देने के बजाय उत्तर देने से बचना या आंशिक उत्तर देना पसंद करता है। जर्मनी में « विदेशी नियंत्रण के बिना » (किसी विदेशी का नियंत्रण नहीं) विकसित यह मॉडल AI Act और RGPD को ध्यान में रखकर बनाया गया है और स्थानीय परिसर में चलाया जा सकता है; इसके जारी होने के साथ लगभग 200 पृष्ठों की एक तकनीकी रिपोर्ट भी दी गई है।
Cohere, जिसका Aleph Alpha के साथ एकीकरण का अंतिम समझौता अभी भी नियामकीय मंज़ूरियों के अधीन है, ने अपने मुख्य कार्यकारी अधिकारी एडन गोमेज़ की बधाई के बाद उसी शाम इसकी घोषणा साझा की; Kolibri अभी भी Aleph Alpha का मॉडल है।
New Apache 2.0 model from @Aleph__Alpha. It’s really good. If you like that, you’re going to love what we build together.
🇮🇳 Aleph Alpha का Apache 2.0 के तहत नया मॉडल। यह सचमुच अच्छा है। अगर आपको यह पसंद आया है, तो हम साथ मिलकर जो बनाएँगे, वह आपको बेहद पसंद आएगा। — X पर @cohere
🔗 Aleph Alpha का ब्लॉग लेख · Hugging Face पर वज़न
Meta ने अपना सुरक्षा ढाँचा प्रशिक्षण तक विस्तारित किया और खुले वज़न के लिए अपने नियम स्पष्ट किए
2 अक्टूबर — Meta Superintelligence Labs ने अपने Meta Superintelligence Scaling Framework को अपडेट किया है, जो प्रशिक्षण और उसके बाद तैनाती से पहले सुरक्षा संबंधी आवश्यकताएँ तय करता है। Meta के अनुसार, यह संस्करण इस सप्ताह व्हाइट हाउस में की गई प्रतिबद्धताओं को दर्शाता है। इनमें आंतरिक नियंत्रणों की जाँच कंपनी के भीतर एक स्वतंत्र टीम और किसी बाहरी लेखा परीक्षक या मूल्यांकनकर्ता से कराने का प्रावधान है।
नियंत्रण खोने (loss of control) के जोखिम के लिए अब प्रशिक्षण और मूल्यांकन के दौरान भी नियम लागू हैं, क्योंकि Meta के अनुसार साइबर सुरक्षा में सक्षम मॉडल अपने परिवेश की कमज़ोरियों का फ़ायदा उठा सकता है। जोखिम वाले पुनर्बलन प्रशिक्षण के लिए सत्यापित सैंडबॉक्स, विचार-श्रृंखला सहित अपरिवर्तनीय लॉग और प्रशिक्षण प्रक्रिया रोक सकने वाली स्वचालित निगरानी आवश्यक है।
खुले वज़न के लिए यह ढाँचा प्रकाशन के बाद संभव बदलावों को ध्यान में रखता है, जैसे फ़ाइन-ट्यूनिंग के ज़रिए इनकार करने का व्यवहार हटाना। आने वाले महीनों के लिए घोषित निदेशक मंडल की एक एआई समिति स्वतंत्र रूप से इस ढाँचे के पालन की जाँच करेगी। यह ढाँचा पुराना « Advanced AI Scaling Framework » ही है, जिसका नाम इस संस्करण 2.1 के साथ बदला गया है: अप्रैल में Muse Spark का मूल्यांकन इसी के तहत हुआ था।
🔗 सक्षम मॉडलों का ज़िम्मेदारी से विकास (Meta)
OpenAI की Agents API में सैंडबॉक्स के तीन आकार और परिवेशों का दोबारा इस्तेमाल जोड़ा गया
2 अक्टूबर — स्टीव (@stevendcoffey), जो X पर दी गई अपनी परिचय जानकारी के अनुसार OpenAI की API पर काम करते हैं, Agents API में इस सप्ताह जोड़ी गई सुविधाएँ गिनाते हैं। @OpenAIDevs ने भी इन्हें साझा किया है। DevDay की तीन बातों को दोहराने के अलावा चार नए बिंदु हैं। पहले की पुष्टि दस्तावेज़ों से होती है: सत्र बनाते समय तय किया जाने वाला पैरामीटर environment.container_size, OpenAI द्वारा होस्ट किए गए सैंडबॉक्स के CPU और मेमोरी का चयन करता है।
| कंटेनर का आकार | आवंटित vCPU | आवंटित मेमोरी |
|---|---|---|
| small | 1 | 1 Go |
| medium (डिफ़ॉल्ट) | 2 | 4 Go |
| large | 4 | 16 Go |
बाकी तीन बिंदु केवल ट्वीट में हैं: डैशबोर्ड से उप-एजेंट का कॉन्फ़िगरेशन, कई सत्रों में एक ही परिवेश का दोबारा इस्तेमाल और विश्वसनीयता में वृद्धि, जिसके मापन की विधि प्रकाशित नहीं की गई है।
Overall better reliability: 99.97% turn reliability, fewer SSE disconnects, 20% faster tool calls 🪨
🇮🇳 समग्र विश्वसनीयता में सुधार: प्रति टर्न 99,97 % विश्वसनीयता, SSE कनेक्शन टूटने की घटनाएँ कम, टूल कॉल 20 % तेज़। — X पर @stevendcoffey
कोड एजेंट: Jira में Devin, Antigravity CLI 1.2.13 और 1.2.14
Devin अब Jira का नेटिव एजेंट है और Devin Review के निष्कर्ष अपने सत्रों को सौंपता है
30 सितंबर — Devin के 30 सितंबर के संस्करण विवरण में 25 खंड हैं। मुख्य बदलाव Devin को Jira का नेटिव एजेंट (native agent) बनाता है: किसी प्रशासक द्वारा Devin for Jira ऐप इंस्टॉल करने के बाद, Devin को टिकट सौंपने या उसका उल्लेख करने से एक सत्र शुरू होता है, जिसे Jira के एजेंट पैनल में देखा जा सकता है। अगर Devin शुरू नहीं हो पाता, जैसे अनुमति न होने या उपयोग सीमा तक पहुँच जाने पर, तो Jira सामान्य त्रुटि के बजाय उसका कारण दिखाता है।
Devin के अभी भी सक्रिय सत्र द्वारा खोली गई पुल रिक्वेस्ट पर Devin Review पहले अपने निष्कर्ष (findings) उसी सत्र को भेजता है: स्वचालित सुधार (Auto-fix) के साथ Devin जो ठीक कर सकता है, उसे ठीक करता है और केवल बाकी निष्कर्ष प्रकाशित होते हैं। स्वचालन में प्रारंभिक जाँच (preflight checks) जोड़ी गई हैं: हर ट्रिगर के बाद और Devin के शुरू होने से पहले एक स्क्रिप्ट चलती है, जो घटना को सत्यापित कर सकती है, उसमें अतिरिक्त जानकारी जोड़ सकती है या उसे अनदेखा कर सकती है। किसी कीमत का उल्लेख नहीं किया गया है।
🔗 Devin के 30 सितंबर के संस्करण विवरण
Antigravity CLI 1.2.13 और 1.2.14: पुनः प्रयास का इंतज़ार समय, संदेशों की कतार, systemd के बिना Remote Control
29 और 30 सितंबर — Google की Antigravity CLI के बदलाव विवरण में दो संस्करण दिए गए हैं। संस्करण 1.2.13 हमेशा 5 सेकंड इंतज़ार करने के बजाय मॉडल की API द्वारा बताए गए पुनः प्रयास समय का पालन करता है। अगर यह समय 30 सेकंड से अधिक हो या पहुँची हुई सीमा दैनिक अथवा बिलिंग की अधिकतम सीमा हो, तो यह तुरंत प्रयास छोड़ देता है।
संस्करण 1.2.14 में 6 सुधार और 3 त्रुटि सुधार हैं। यह /config में Queued Messages विकल्प जोड़ता है: डिफ़ॉल्ट रूप से (Queue), एजेंट के काम करते समय भेजा गया संदेश टर्न खत्म होने तक इंतज़ार करता है; Send Immediately मोड में वह एजेंट को बीच में रोक देता है। systemd का उपयोगकर्ता सेवा प्रबंधक न रखने वाली Linux मशीनों पर, जैसे अधिकांश कंटेनरों में, Remote Control अपने डेमॉन को एक साधारण पृष्ठभूमि प्रक्रिया के रूप में शुरू करता है, जो क्रैश के बाद या सिस्टम चालू होने पर दोबारा शुरू नहीं होगी। विकल्प --json-schema अब सख्ती से लागू होता है: अमान्य स्कीमा से त्रुटि और निकास कोड 1 मिलता है। इसे कुछ दिनों में चरणबद्ध तरीके से उपलब्ध कराया जा रहा है।
Qwen-Image-2.1-Pro, Model Studio और QwenCloud की API में प्रति छवि 0,04 डॉलर पर उपलब्ध हुआ
2 अक्टूबर — Alibaba ने अपनी API प्लेटफ़ॉर्म Model Studio की सूची में International सेवा क्षेत्र के लिए Qwen-Image-2.1-Pro जोड़ा है। QwenCloud ने भी इसके लिए « NEW » चिह्न वाला विवरण पृष्ठ दिया है, जबकि Qwen की ओर से कोई ट्वीट या ब्लॉग लेख नहीं आया है। यह मॉडल 20 सितंबर को खुले वज़न के साथ जारी किए गए Qwen-Image-2.1 का विस्तार है: एक ही मॉडल में निर्माण और संपादन, दृश्य निर्माण के लिए 7 अरब पैरामीटर और पारदर्शी छवियों का मूल समर्थन। विवरण में यह नहीं बताया गया है कि सेवा में उपलब्ध संस्करण प्रकाशित वज़न से अलग है या नहीं।
| तुलना का पहलू | qwen-image-2.1-pro | qwen-image-2.0-pro |
|---|---|---|
| प्रति निर्मित छवि की कीमत | 0,04 डॉलर | 0,075 डॉलर |
| मुफ़्त कोटा | 10 छवियाँ | 100 छवियाँ |
कीमत लगभग आधी हो गई है, लेकिन मुफ़्त कोटा दस गुना छोटा है। QwenCloud पर मॉडल की सीमा प्रति मिनट 20 अनुरोध और एक साथ 10 कॉल है।
🔗 Model Studio के मॉडलों का बदलाव विवरण · QwenCloud का विवरण पृष्ठ
लेखक के अनुसार, Apron GPU किराए पर लेने से पहले 14 खुले मॉडलों की GPU मेमोरी का अनुमान लगाता है
3 अक्टूबर — Apron के डेवलपर व्लाद रिझकोव ने Hugging Face के सामुदायिक ब्लॉग पर यह ओपन सोर्स उपकरण प्रस्तुत किया है। यह GPU किराए पर लेने से पहले अनुमान लगाता है कि कोई खुला मॉडल मेमोरी में समाएगा और vLLM के किसी निश्चित संस्करण पर शुरू होगा या नहीं, फिर वास्तविक कार्ड पर इसकी जाँच करता है।
लेखक के अनुसार, RTX 4090 से लेकर आठ H200 तक के हार्डवेयर पर शुरू किए गए 14 में से 11 मॉडलों के लिए वज़न की अनुमानित मेमोरी और वास्तविक माप में अंतर 2 % से कम रहा। चार मॉडल शुरू होने में विफल हुए; एक सुधार ने उन्हें ठीक किया और दूसरी बार शुरू करके इसकी पुष्टि की गई। वहीं DeepSeek-V4.1-Flash डिफ़ॉल्ट रूप से होस्ट की 189 Gio मेमोरी लेता है, जो केवल GPU तक सीमित जाँच में दिखाई नहीं देती।
लेखक आगाह करते हैं कि हर मॉडल के लिए शुरू करने का केवल एक माप लिया गया है और इससे कोई रैंकिंग नहीं बनती। कमांड लाइन उपकरण बाहरी उपयोग के लिए तैयार नहीं है, और इसके रिपॉज़िटरी में अभी भी इसे बिना कार्यान्वयन वाला विनिर्देश बताया गया है।
🔗 व्लाद रिझकोव का ब्लॉग लेख (Hugging Face)
संक्षिप्त समाचार
- Copilot CLI 1.0.92-3 और Copilot SDK 1.0.17-preview.3 — Copilot CLI के पूर्वावलोकन संस्करण में एक चयनकर्ता जोड़ा गया है, जिसे बातचीत से पहले Ctrl+E दबाकर खोला जा सकता है और जिससे स्थानीय स्तर पर या क्लाउड में चलाने का विकल्प चुना जा सकता है; SDK का पूर्वावलोकन संस्करण प्रयोगात्मक रूप से जारी सत्र में क्लाइंट के टूल बदलने की सुविधा देता है। नवीनतम स्थिर संस्करण अभी भी 1.0.91 है। 🔗 CLI · 🔗 SDK
- API के ज़रिए Copilot code review — अब REST और GraphQL API के ज़रिए Copilot से समीक्षा का अनुरोध किया जा सकता है, जिसमें हर अनुरोध के लिए प्रयास का स्तर तय किया जाता है; यह सुविधा Pro, Pro+, Max, Business और Enterprise योजनाओं के लिए सामान्य रूप से उपलब्ध है। दस्तावेज़ों के अनुसार, एक समीक्षा की अनुमानित लागत Lite में 0,05 से 1 डॉलर के एआई क्रेडिट और प्रयास के डिफ़ॉल्ट स्तर Balanced में 0,25 से 5 डॉलर है। 🔗 स्रोत
- Gemini CLI का Nightly संस्करण — 3 अक्टूबर के v0.64.0-nightly में सिर्फ़ एक सुधार है: एंटर और स्पेस अब विकल्पों की सूचियों में चयन की पुष्टि भरोसेमंद तरीके से करते हैं, उन टर्मिनलों पर भी जो Kitty कीबोर्ड प्रोटोकॉल का समर्थन नहीं करते, जैसे Windows पर PyCharm का टर्मिनल, जहाँ किसी दूसरी कुंजी के 30 ms से कम समय बाद दबाया गया एंटर, Shift+Enter माना जाता था। स्थिर और पूर्वावलोकन संस्करण अपरिवर्तित हैं। 🔗 स्रोत
- DeepSeek Harness 0.2.1-alpha.1 — यह 25वाँ पूर्वावलोकन संस्करण है और अभी भी कोई स्थिर संस्करण नहीं है। इसमें Claude Code के मॉड के साथ अनुकूलता की एक प्रयोगात्मक परत जोड़ी गई है, जिसका उद्देश्य DeepSeek के अनुसार यह जाँचना है कि उनका API मोटे तौर पर Harness के प्लगइन की क्षमताओं का एक उपसमुच्चय है, पूर्ण अनुकूलता देना नहीं। 🔗 स्रोत
- Warp में GPT-6.1 Sol — 29 सितंबर की शाम Warp ने अपने एजेंट संचालित टर्मिनल में GPT-6.1 Sol उपलब्ध कराया, जिसे Codex या ChatGPT सदस्यता के साथ इस्तेमाल किया जा सकता है; घोषणा में न कोई कीमत दी गई है, न Warp से संबंधित कोई माप। 🔗 स्रोत
- grok-voice-transcribe-1.0 का अंत — SpaceXAI ने 2 अक्टूबर को API में अपने प्रतिलेखन मॉडल का पुराना संस्करण बंद कर दिया: अनुरोध अब grok-voice-transcribe-2.0 पर भेजे जाते हैं, जिसकी कीमत समान है और जो SpaceXAI के अनुसार अधिक सटीक है। पुराने संस्करण को अप्रचलित घोषित करने की सूचना 18 सितंबर को दी गई थी, लेकिन कोई तारीख नहीं बताई गई थी। 🔗 स्रोत
- OpenAI डेवलपरों के लिए सितंबर — @OpenAIDevs खाते ने X के एक लेख में सितंबर की डेवलपर घोषणाओं का पुनरावलोकन किया है, 29 तारीख के DevDay से लेकर GPT-6 Sol और Luna तक, बिना किसी नई घोषणा के; एकमात्र अतिरिक्त जानकारी यह है कि OpenAI का Decisions API, जो 29 सितंबर से सीमित पूर्वावलोकन में है, जल्द ही सामान्य रूप से उपलब्ध होगा, लेकिन कोई तारीख नहीं दी गई है। 🔗 स्रोत
- ElevenLabs एजेंटों की दो तैनातियाँ — Banner Health ने प्राथमिक स्वास्थ्य सेवा के लिए अपॉइंटमेंट तय करने का काम ElevenAgents को सौंपा है, जिसमें किसी मानव कर्मचारी को हस्तांतरण और HIPAA अनुपालन शामिल हैं; बीमा कंपनी Admiral ने अपने वॉइस एजेंटों को उत्पादन में तैनात करने का अनुभव साझा किया है, जहाँ हर बदलाव कई सप्ताह के बजाय कुछ घंटों में 1 % से 100 % ट्रैफ़िक तक पहुँचता है। दोनों में से किसी ने भी परिणामों के आँकड़े प्रकाशित नहीं किए हैं। 🔗 Banner Health · 🔗 Admiral
- Kling 4.0 की शुरुआती उपलब्धता — 30 सितंबर के Kling 4.0 परिचय लेख में बताया गया है कि पूरा मॉडल अक्टूबर में व्यापक रूप से उपलब्ध कराने से पहले शुरुआती पहुँच में आ रहा है, जबकि Kling 4.0 Flash, Ultra के वार्षिक सदस्यों के लिए 28 सितंबर से उपलब्ध है; कीमत, API या पहुँच के मानदंड बताए बिना 21:9 प्रारूप भी जोड़ा गया है। 🔗 स्रोत
- Runway Agent, Runway MCP और OpenAI के dots — Runway के बदलाव विवरण में X पर घोषणा किए बिना तीन नई चीज़ें दर्ज हैं: Runway Agent, Seedance 2.5 के Draft मोड का उपयोग करता है, जिसमें 480p के प्रारूप तैयार करके निर्माण के बाद उन्हें फिर से सँवारा जाता है; सशुल्क योजनाओं के लिए Ideogram 4.5 को Runway MCP में जोड़ा गया है; और Runway 1 अक्टूबर से OpenAI के dots में उपलब्ध है। क्रेडिट में कोई लागत नहीं बताई गई है। 🔗 स्रोत
- GitHub Apps के स्टेटलेस टोकन — एआई से अलग, GitHub ने सभी नए GitHub Apps स्थापना टोकन के लिए स्टेटलेस प्रारूप
ghs_APPID_JWTका वितरण पूरा कर लिया है, जो 27 अप्रैल को शुरू हुआ था: अब 40 के बजाय लगभग 520 वर्ण हैं, जबकि अनुमतियाँ और एक घंटे की समाप्ति अवधि अपरिवर्तित हैं; परीक्षण हेडरX-GitHub-Stateless-S2S-Tokenको 30 नवंबर 2026 को अप्रचलित घोषित किया जाएगा। 🔗 स्रोत - Rapidata में तत्काल मानवीय प्रतिक्रिया — Rapidata ने अपनी Flows सुविधा का वर्णन किया है, जो Flow-GRPO के पुरस्कार मॉडल की जगह वास्तविक समय में मनुष्यों द्वारा की जाने वाली जोड़ीवार तुलनाएँ इस्तेमाल करती है; विक्रेता के इस लेख में प्रशिक्षण का कोई मापा हुआ परिणाम प्रकाशित नहीं किया गया है। 🔗 स्रोत
- एजेंटों के बीच निर्भरता को मापना — बिना किसी प्रयोग या माप वाले एक निबंध में Anouar Imel ने बहु-एजेंट प्रणालियों का मूल्यांकन एजेंटों की संख्या के बजाय उनके बीच निर्भरता के आधार पर करने का प्रस्ताव दिया है, जिसमें हर चरण पर सटीकता, तर्कों की विविधता और एजेंटों के बीच जुड़ाव पर नज़र रखी जाए। 🔗 स्रोत
इसका क्या अर्थ है
Kolibri दिखाता है कि कोई खुला मॉडल पहला स्थान पाने का लक्ष्य रखे बिना भी प्रतिस्पर्धा में टिक सकता है। Aleph Alpha ने स्वयं ऐसे माप प्रकाशित किए हैं जिनमें सघन Qwen3.8 27B उसे लगभग हर जगह पीछे छोड़ता है, और एक अलग मानदंड पर ज़ोर दिया है: ऐसे लाइसेंस के तहत, जो सब कुछ अपने परिसर में होस्ट करने की अनुमति देता है, कम GPU पर अंग्रेज़ी और जर्मन दोनों में बड़ी संख्या में लंबे अनुरोधों को पूरा करना। AI Act और RGPD का पालन करने के लिए बाध्य किसी प्रशासनिक संस्था या औद्योगिक कंपनी के लिए यह संतुलन बेंचमार्क के कुछ अतिरिक्त अंकों से अधिक अहम हो सकता है। Cohere, जिसका Aleph Alpha के साथ जुड़ाव अभी भी नियामक मंज़ूरियों की प्रतीक्षा में है, अगले चरण का वादा अभी से कर रहा है।
खुले मॉडलों के लिए सेवा प्रदान करने की लागत एक केंद्रीय विषय बन रही है। 20 सितंबर को खुले वज़न के साथ जारी किया गया Qwen-Image-2.1, उसे स्वयं होस्ट न करने वालों के लिए Qwen-Image-2.1-Pro नाम से API में लौट आया है, जिसकी कीमत प्रति छवि 0,04 डॉलर है, पिछली पीढ़ी से लगभग आधी। वहीं Apron का लेख याद दिलाता है कि स्वयं होस्ट करने के लिए क्या चाहिए: vLLM की किसी सेटिंग के अभाव में मॉडल शुरू होते समय विफल हो सकता है, या 189 Gio होस्ट मेमोरी घेर सकता है, जिसे केवल GPU तक सीमित जाँच पहचान नहीं पाती।
Meta सुरक्षा को तैनाती से पहले के चरण में ले जा रहा है। जोखिम भरे प्रबलन प्रशिक्षण के लिए अब सत्यापित सैंडबॉक्स, अपरिवर्तनीय लॉग और स्वचालित रोक आवश्यक हैं, क्योंकि साइबर सुरक्षा में सक्षम मॉडल अपने ही परिवेश की कमज़ोरियों का फायदा उठा सकता है। निदेशक मंडल में घोषित एआई समिति को स्वतंत्र रूप से यह भी जाँचना होगा कि इन नियमों का पालन हो रहा है। व्हाइट हाउस में की गई प्रतिबद्धताओं के बारे में, जिनका अनुसरण करने की बात Meta कहता है, लेख केवल उनका मूल आशय बताता है: आंतरिक नियंत्रणों की जाँच कंपनी के भीतर एक स्वतंत्र टीम और किसी बाहरी लेखा परीक्षक या मूल्यांकनकर्ता द्वारा की जाए।
अंत में, एजेंट टूल और संचालन में एकीकृत हो रहे हैं। OpenAI सैंडबॉक्स का आकार चुनने और एक सत्र के परिवेश को दूसरे सत्र में फिर से इस्तेमाल करने की सुविधा देता है, Devin, Jira में जुड़ता है और अपनी समीक्षा के निष्कर्ष प्रकाशित करने से पहले उनमें बताई गई समस्याओं को सुधारता है, और Copilot code review को API के ज़रिए शुरू किया जा सकता है, जिसमें प्रयास के स्तर के अनुसार अनुमानित लागत दी जाती है। Antigravity CLI सर्वर द्वारा बताए गए दोबारा प्रयास करने के अंतराल का पालन करता है और Remote Control को कंटेनरों में चलाता है: ये आकर्षक सुविधाओं से अधिक संचालन से जुड़े समायोजन हैं, लेकिन जब कोई एजेंट लगातार चलता रहता है, तो इन्हीं की अहमियत होती है।
स्रोत
- Kolibri पर Aleph Alpha का लेख
- Hugging Face पर Kolibri-1
- @Aleph__Alpha द्वारा Kolibri की घोषणा
- Kolibri की तकनीकी रिपोर्ट (PDF)
- @cohere द्वारा साझा की गई Kolibri की घोषणा
- Aidan Gomez की बधाई
- Cohere और Aleph Alpha के बीच अंतिम समझौता
- सक्षम मॉडलों का ज़िम्मेदारी से विकास (Meta)
- Meta का अतिबुद्धिमत्ता विस्तार ढाँचा
- @stevendcoffey द्वारा Agents API की नई सुविधाओं की जानकारी
- @OpenAIDevs द्वारा साझा की गई जानकारी
- OpenAI द्वारा होस्ट किए गए सैंडबॉक्स (OpenAI दस्तावेज़)
- 30 सितंबर के Devin संस्करण का विवरण
- Antigravity का बदलाव विवरण
- Model Studio के मॉडलों का विवरण
- Model Studio की कीमतें
- QwenCloud पर qwen-image-2.1-pro की जानकारी
- मुझे पता है कि आप LLMs चलाते हैं। क्या यह शुरू होगा? (Hugging Face)
- GitHub पर Apron का रिपॉज़िटरी
- Copilot CLI v1.0.92-3
- GitHub Copilot SDK v1.0.17-preview.3
- Copilot code review: API समर्थन और प्रयास का नया डिफ़ॉल्ट स्तर (GitHub)
- 3 अक्टूबर का Gemini CLI Nightly v0.64.0 संस्करण
- DeepSeek Harness 0.2.1-alpha.1 संस्करण का विवरण
- Warp में GPT-6.1 Sol (@warpdotdev)
- SpaceXAI API के संस्करणों का विवरण
- OpenAI डेवलपरों के लिए सितंबर (@OpenAIDevs)
- Banner Health में ElevenLabs
- Admiral वेबिनार का पुनरावलोकन (ElevenLabs)
- Kling 4.0 का परिचय
- Runway का बदलाव विवरण
- स्टेटलेस GitHub App स्थापना टोकन का वितरण पूरा (GitHub)
- प्रशिक्षण चक्र में तत्काल मानवीय प्रतिक्रिया (Rapidata)
- जब एआई एजेंट एक-दूसरे के साक्ष्य बन जाते हैं (Anouar Imel)