ai-powered-markdown-translatorArticolo tradotto dal fr all’it con gpt-6.1-sol.
Sabato 3 ottobre, Aleph Alpha pubblica Kolibri, un modello inglese-tedesco a pesi aperti da 78,1 miliardi di parametri con licenza Apache 2.0, la cui uscita viene rilanciata la sera stessa da Cohere, la cui integrazione con Aleph Alpha attende ancora le autorizzazioni delle autorità competenti. Il giorno precedente, Meta aveva esteso il proprio quadro di sicurezza all’addestramento dei suoi modelli e l’API Agents di OpenAI aveva aggiunto tre dimensioni di sandbox. Le note di rilascio di Devin del 30 settembre lo rendono un agente nativo di Jira, Qwen-Image-2.1-Pro arriva via API a 0,04 dollari per immagine e lo sviluppatore di Apron spiega come prevedere la memoria GPU di un modello aperto prima di noleggiare una scheda.
Aleph Alpha pubblica Kolibri, un modello inglese-tedesco da 78 miliardi di parametri con licenza Apache 2.0
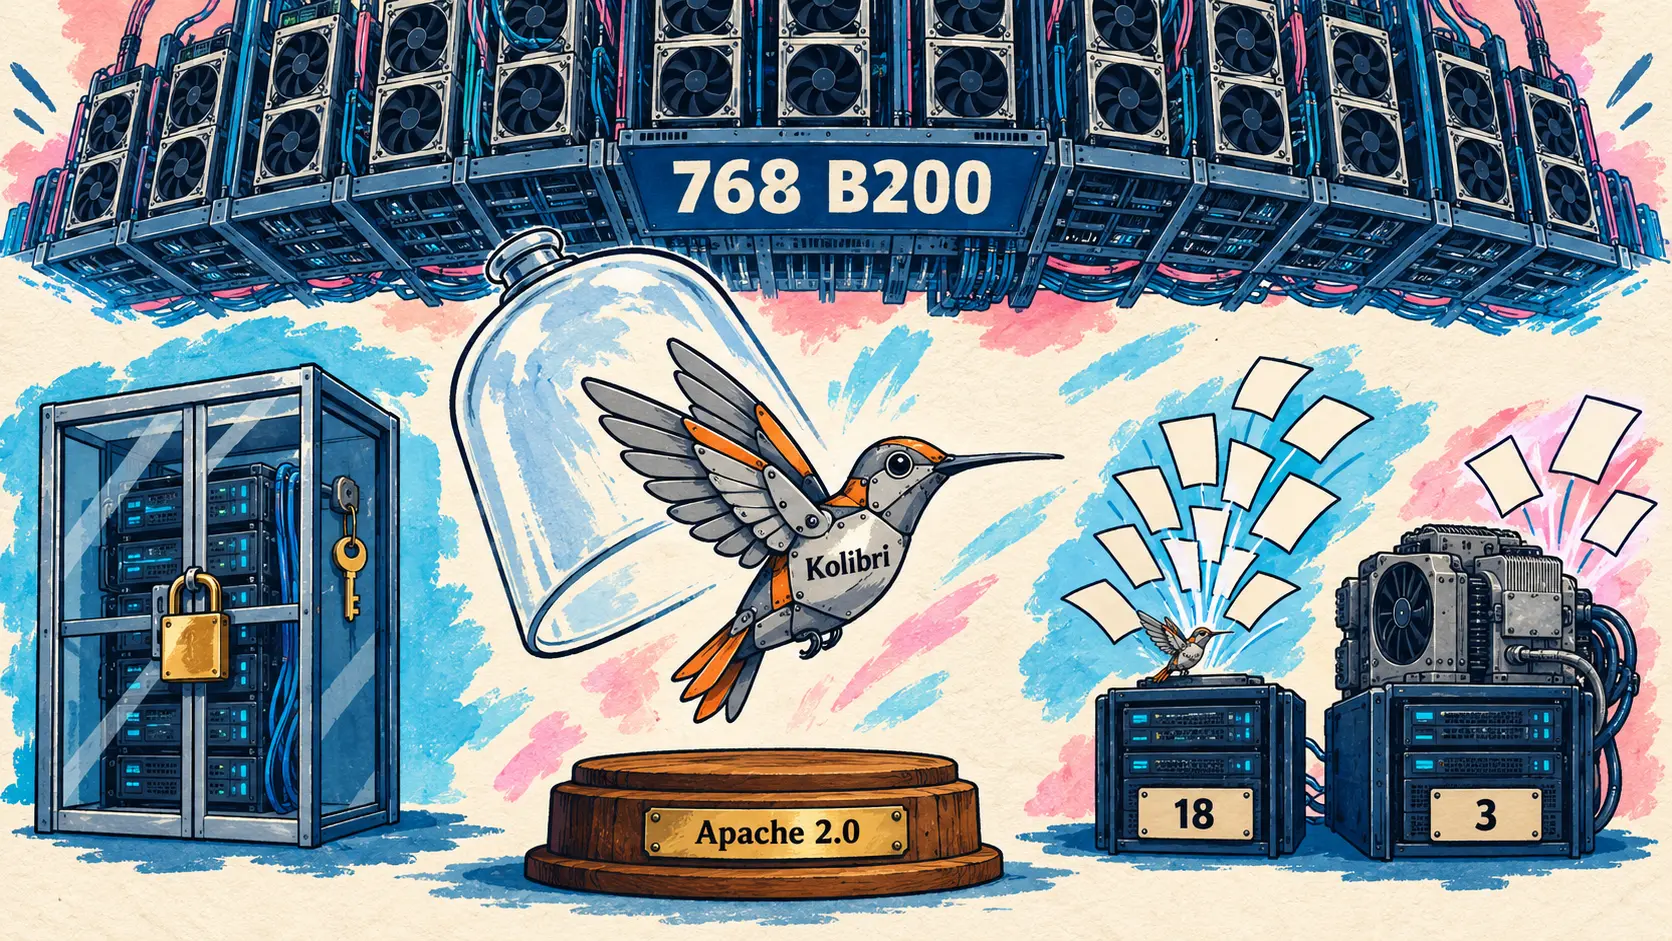
3 ottobre — Nel giorno della festa dell’Unità tedesca, Aleph Alpha pubblica Kolibri, un modello linguistico inglese-tedesco a pesi aperti. Questo modello a miscela di esperti (Mixture-of-Experts) conta 78,1 miliardi di parametri, di cui 3,46 miliardi attivi per token, e i suoi pesi sono disponibili su Hugging Face con licenza Apache 2.0. Aleph Alpha lo destina agli impieghi sovrani nei settori regolamentati: pubblica amministrazione, industria, aeronautica.
L’architettura punta anzitutto al costo di erogazione: 6 esperti attivi su 384 e 40 livelli su 50 limitati a una finestra scorrevole di 512 tokens. Il modello accetta fino a 1 048 576 tokens, ma è stato addestrato fino a 262 144, lunghezza che la sua scheda raccomanda di non superare. Secondo il post, una versione da 123 miliardi di parametri elaborava soltanto 3 richieste da 256k tokens su due H100, contro le 18 della dimensione scelta. L’addestramento ha impiegato 768 GPU B200 in Germania e in Finlandia, per quasi 24T tokens; il tedesco rappresenta il 21,3 % del pre-addestramento.
Secondo le misurazioni di Aleph Alpha (harness interno, massimo sforzo di ragionamento), Kolibri supera nel punteggio complessivo Qwen3.5 35B-A3B e Nemotron 3 Super, che attiva 12 miliardi di parametri, ma il modello denso Qwen3.8 27B resta in vantaggio quasi ovunque:
| Benchmark (misurazioni Aleph Alpha) | Kolibri 78B-A3,46B | Qwen3.5 35B-A3B | Nemotron 3 Super 120B-A12B | Mistral Small 4 119B-A6B | Qwen3.8 27B (denso) |
|---|---|---|---|---|---|
| Punteggio complessivo (inglese) | 75,5 | 74,7 | 73,0 | 63,1 | 80,2 |
| Punteggio complessivo (tedesco) | 70,8 | 69,8 | 67,9 | 61,4 | 79,9 |
| GPQA Diamond (inglese) | 84,3 | 83,8 | 78,0 | 74,7 | 89,2 |
| AIME 2026 (inglese) | 96,0 | 92,1 | 90,4 | 83,1 | 97,7 |
| SWE-Bench Verified | 66,4 | 71,6 | 60,2 | 60,8 | 72,6 |
L’argomento di Aleph Alpha non è dunque il primo posto, ma la frontiera di Pareto tra qualità e costo di erogazione. Addestrato ad astenersi, Kolibri preferisce anche astenersi o rispondere parzialmente anziché sbagliare sul 44 % delle domande di AA-Omniscience che non riesce a risolvere. Sviluppato in Germania «senza controllo straniero» (senza controllo straniero), progettato tenendo conto dell’AI Act e del RGPD, può essere eseguito in sede; un rapporto tecnico di quasi 200 pagine accompagna il rilascio.
Cohere, il cui accordo definitivo di integrazione con Aleph Alpha resta subordinato alle autorizzazioni delle autorità competenti, ha rilanciato l’uscita la sera stessa, dopo le congratulazioni del suo CEO Aidan Gomez; Kolibri resta un modello di Aleph Alpha.
New Apache 2.0 model from @Aleph__Alpha. It’s really good. If you like that, you’re going to love what we build together.
🇮🇹 Nuovo modello con licenza Apache 2.0 firmato Aleph Alpha. È davvero valido. Se questo vi piace, adorerete ciò che costruiremo insieme. — @cohere su X
🔗 Post di Aleph Alpha · Pesi su Hugging Face
Meta estende il proprio quadro di sicurezza all’addestramento e precisa le regole per i pesi aperti
2 ottobre — Meta Superintelligence Labs aggiorna il proprio Meta Superintelligence Scaling Framework, che stabilisce i requisiti di sicurezza prima dell’addestramento e poi del deployment. Secondo Meta, questa versione riflette gli impegni assunti questa settimana alla Casa Bianca, che prevedono controlli interni verificati da un team indipendente all’interno dell’azienda e da un revisore o valutatore esterno.
La perdita di controllo (loss of control) viene ora disciplinata durante l’addestramento e la valutazione, poiché un modello con elevate capacità in materia di cybersicurezza può, secondo Meta, sfruttare le vulnerabilità del proprio ambiente. Un addestramento per rinforzo a rischio richiede sandbox convalidati, log inalterabili, catena di pensiero compresa, e un monitoraggio automatico capace di arrestare il run.
Per i pesi aperti, il quadro tiene conto delle modifiche possibili dopo la pubblicazione, come eliminare il rifiuto tramite fine-tuning. Un comitato IA del consiglio di amministrazione, annunciato per i prossimi mesi, verificherà in modo indipendente il rispetto del quadro. Questo quadro è il precedente «Advanced AI Scaling Framework», rinominato con questa versione 2.1: quello secondo cui Muse Spark era stato valutato ad aprile.
🔗 Sviluppare modelli capaci in modo responsabile (Meta)
L’API Agents di OpenAI aggiunge tre dimensioni di sandbox e il riutilizzo degli ambienti
2 ottobre — Steve (@stevendcoffey), che secondo la sua bio su X lavora sull’API di OpenAI, elenca le novità della settimana dell’API Agents, rilanciate da @OpenAIDevs. Oltre a tre richiami al DevDay, quattro punti sono nuovi. Il primo è confermato dalla documentazione: il parametro environment.container_size, impostato alla creazione di una sessione, determina la CPU e la memoria del sandbox ospitato da OpenAI.
| Dimensione del container | vCPU allocate | Memoria allocata |
|---|---|---|
| small | 1 | 1 Go |
| medium (predefinito) | 2 | 4 Go |
| large | 4 | 16 Go |
Gli altri tre compaiono soltanto nel tweet: subagenti configurabili dalla dashboard, riutilizzo di un ambiente in più sessioni e maggiore affidabilità, senza un metodo di misurazione pubblicato.
Overall better reliability: 99.97% turn reliability, fewer SSE disconnects, 20% faster tool calls 🪨
🇮🇹 Affidabilità complessiva migliorata: 99,97 % di affidabilità per turno, meno disconnessioni SSE, chiamate agli strumenti più veloci del 20 %. — @stevendcoffey su X
Agenti di codice: Devin in Jira, Antigravity CLI 1.2.13 e 1.2.14
Devin diventa un agente nativo di Jira e affida alle proprie sessioni i rilievi di Devin Review
30 settembre — Le note di rilascio di Devin del 30 settembre comprendono 25 voci. La principale rende Devin un agente nativo (native agent) di Jira: una volta installata l’app Devin for Jira da un amministratore, assegnare un ticket a Devin o menzionarlo avvia una sessione, seguita nel pannello dell’agente di Jira. Se Devin non può avviarsi (autorizzazione mancante, limite di utilizzo), Jira mostra la sua spiegazione anziché un errore generico.
Su una pull request aperta da una sessione Devin ancora attiva, Devin Review trasmette prima i propri rilievi (findings) a quella sessione: con la correzione automatica (Auto-fix), Devin corregge ciò che può e vengono pubblicati soltanto i rilievi rimanenti. Le automazioni acquisiscono controlli preliminari (preflight checks): uno script viene eseguito dopo ogni trigger, prima di Devin, per convalidare, arricchire o ignorare l’evento. Non viene menzionato alcun prezzo.
🔗 Note di rilascio di Devin del 30 settembre
Antigravity CLI 1.2.13 e 1.2.14: tempi di attesa per i nuovi tentativi, coda dei messaggi, Remote Control senza systemd
29 e 30 settembre — Il changelog di Antigravity CLI di Google elenca due versioni. La 1.2.13 rispetta il tempo di attesa per un nuovo tentativo indicato dall’API del modello anziché attendere 5 secondi fissi, e rinuncia subito se questo tempo supera 30 secondi o se il limite raggiunto è un tetto giornaliero o di fatturazione.
La 1.2.14 (6 miglioramenti, 3 correzioni) aggiunge in /config l’opzione Queued Messages: per impostazione predefinita (Queue), un messaggio inviato mentre l’agente lavora attende la fine del turno; in modalità Send Immediately, lo interrompe. Sulle macchine Linux senza un gestore dei servizi utente systemd, come la maggior parte dei container, Remote Control avvia il proprio daemon come semplice processo in background, che non si riavvierà né dopo un crash né all’avvio. L’opzione --json-schema diventa rigorosa: uno schema non valido provoca un errore e il codice di uscita 1. Il rilascio è graduale, nell’arco di alcuni giorni.
Qwen-Image-2.1-Pro arriva via API su Model Studio e QwenCloud, a 0,04 dollari per immagine
2 ottobre — Alibaba aggiunge Qwen-Image-2.1-Pro al catalogo di Model Studio, la sua piattaforma API, per l’ambito di servizio International, e QwenCloud gli dedica una scheda contrassegnata «NEW», senza tweet né post di Qwen. Il modello prosegue Qwen-Image-2.1, pubblicato a pesi aperti il 20 settembre: creazione e ritocco in un solo modello, 7 miliardi di parametri per la generazione visiva, immagini trasparenti native. La scheda non indica se la versione erogata differisca dai pesi pubblicati.
| Elemento confrontato | qwen-image-2.1-pro | qwen-image-2.0-pro |
|---|---|---|
| Prezzo per immagine in output | 0,04 dollari | 0,075 dollari |
| Quota gratuita | 10 immagini | 100 immagini |
Il prezzo scende di quasi la metà, ma la quota gratuita è dieci volte più piccola. Su QwenCloud, il modello è limitato a 20 richieste al minuto e 10 chiamate simultanee.
🔗 Registro dei modelli di Model Studio · Scheda QwenCloud
Apron prevede la memoria GPU di 14 modelli aperti prima del noleggio, secondo il suo autore
3 ottobre — Vlad Ryzhkov, sviluppatore di Apron, presenta sul blog della community di Hugging Face questo strumento open source, che prevede prima del noleggio di una GPU se un modello aperto entrerà in memoria e si avvierà con una versione specifica di vLLM, per poi verificarlo su una scheda reale.
Secondo l’autore, la memoria dei pesi prevista si discosta di meno del 2 % dalla misurazione per 11 dei 14 modelli avviati, da una RTX 4090 a otto H200. Quattro modelli hanno fallito prima che una correzione, convalidata da un secondo avvio, li rendesse funzionanti, e DeepSeek-V4.1-Flash occupa per impostazione predefinita 189 Gio di memoria host, invisibili a una verifica limitata alla GPU.
L’autore avverte che è stato misurato un solo avvio per modello e che nulla costituisce una classifica. Lo strumento da riga di comando non è pronto per un utilizzo esterno, e il suo repository si descrive ancora come una specifica senza implementazione.
🔗 Post di Vlad Ryzhkov (Hugging Face)
In breve
- Copilot CLI 1.0.92-3 e SDK Copilot 1.0.17-preview.3 — L’anteprima di Copilot CLI aggiunge un selettore, aperto con Ctrl+E prima della conversazione, per scegliere un’esecuzione locale o nel cloud; quella dell’SDK consente, in via sperimentale, di sostituire gli strumenti del client in una sessione in corso. L’ultima versione stabile resta la 1.0.91. 🔗 CLI · 🔗 SDK
- Copilot code review tramite API — Ora è possibile richiedere una revisione di Copilot tramite le API REST e GraphQL, con un livello di impegno impostato per ogni richiesta, in disponibilità generale per i piani Pro, Pro+, Max, Business ed Enterprise; la documentazione stima il costo di una revisione da 0,05 a 1 dollaro in crediti IA con Lite e da 0,25 a 5 dollari con Balanced, il livello di impegno predefinito. 🔗 fonte
- Nightly di Gemini CLI — La v0.64.0-nightly del 3 ottobre contiene un solo correttivo: Invio e Spazio confermano in modo affidabile le liste di scelta, anche sui terminali senza protocollo di tastiera Kitty, come quello di PyCharm su Windows, dove la pressione di Invio a meno di 30 ms da un altro tasto veniva interpretata come Maiusc+Invio. La versione stabile e l’anteprima restano invariate. 🔗 fonte
- DeepSeek Harness 0.2.1-alpha.1 — Questa 25ª anteprima, ancora senza una versione stabile, aggiunge un livello sperimentale di compatibilità con i mods di Claude Code, destinato secondo DeepSeek a verificare che la loro API costituisca grosso modo un sottoinsieme di ciò che consentono i plugin di Harness, senza puntare a offrire una compatibilità completa. 🔗 fonte
- GPT-6.1 Sol in Warp — La sera del 29 settembre, Warp ha reso disponibile GPT-6.1 Sol nel suo terminale agentico, utilizzabile con un abbonamento Codex o ChatGPT; l’annuncio non indica né prezzi né misurazioni specifiche per Warp. 🔗 fonte
- Fine di grok-voice-transcribe-1.0 — Il 2 ottobre SpaceXAI ha dismesso la vecchia versione del suo modello di trascrizione tramite API: le richieste vengono reindirizzate a grok-voice-transcribe-2.0, allo stesso prezzo e con maggiore precisione secondo SpaceXAI. La deprecazione era stata annunciata il 18 settembre senza una data. 🔗 fonte
- Settembre per gli sviluppatori OpenAI — L’account @OpenAIDevs riepiloga in un articolo su X gli annunci di settembre per gli sviluppatori, dal DevDay del 29 a GPT-6 Sol e Luna, senza annunci inediti; l’unica precisazione riguarda l’API Decisions di OpenAI, in anteprima limitata dal 29 settembre, per la quale viene annunciata l’imminente disponibilità generale, senza una data. 🔗 fonte
- Due implementazioni di agenti ElevenLabs — Banner Health affida a ElevenAgents la prenotazione di appuntamenti per le cure primarie, con trasferimento a un operatore umano e conformità HIPAA; l’assicuratore Admiral racconta la messa in produzione dei suoi agenti vocali, per i quali ogni modifica viene estesa dall’1 % al 100 % del traffico in poche ore anziché in diverse settimane. Nessuno dei due pubblica dati sui risultati. 🔗 Banner Health · 🔗 Admiral
- Kling 4.0 in accesso anticipato — Il post di presentazione di Kling 4.0, datato 30 settembre, precisa che il modello completo entra in accesso anticipato prima di un rilascio più ampio in ottobre, mentre Kling 4.0 Flash è disponibile per gli abbonati Ultra annuali dal 28 settembre; si aggiunge il formato 21:9, senza indicazioni su prezzi, API o criteri di accesso. 🔗 fonte
- Runway Agent, Runway MCP e i dots di OpenAI — Il changelog di Runway elenca tre novità senza annunci su X: Runway Agent utilizza la modalità Draft di Seedance 2.5 (bozze in 480p rielaborate dopo la generazione), Ideogram 4.5 entra in Runway MCP per i piani a pagamento e Runway è disponibile dal 1º ottobre nei dots di OpenAI. Non viene precisato alcun costo in crediti. 🔗 fonte
- Token stateless delle GitHub Apps — Al di fuori dell’IA, GitHub completa il rilascio, iniziato il 27 aprile, del formato stateless
ghs_APPID_JWTper tutti i nuovi token di installazione delle GitHub Apps: circa 520 caratteri anziché 40, con permessi e scadenza di un’ora invariati; l’header di testX-GitHub-Stateless-S2S-Tokensarà deprecato il 30 novembre 2026. 🔗 fonte - Feedback umano in tempo reale da Rapidata — Rapidata descrive la sua funzione Flows, che sostituisce il modello di ricompensa di Flow-GRPO con confronti umani a coppie in tempo reale, in un post del fornitore che non pubblica alcun risultato misurato dell’addestramento. 🔗 fonte
- Misurare la dipendenza tra agenti — In un saggio senza esperimenti né misurazioni, Anouar Imel propone di valutare i sistemi multi-agente in base alla dipendenza tra agenti anziché al loro numero, monitorando a ogni turno l’accuratezza, la diversità dei ragionamenti e l’accoppiamento tra agenti. 🔗 fonte
Che cosa significa
Kolibri mostra che un modello aperto può reggere il confronto senza puntare al primo posto. Aleph Alpha pubblica direttamente misurazioni in cui il modello denso Qwen3.8 27B lo supera quasi ovunque e mette in evidenza un altro criterio: servire molte richieste lunghe con poche GPU, sia in inglese sia in tedesco, con una licenza che consente di ospitare tutto in sede. Per un’amministrazione o un’azienda industriale soggetta all’AI Act e al RGPD, questo compromesso può contare più di qualche punto nei benchmark. Cohere, la cui integrazione con Aleph Alpha attende ancora le autorizzazioni delle autorità di regolamentazione, promette già un seguito.
Il costo di erogazione del servizio si impone come tema centrale per i modelli aperti. Qwen-Image-2.1, pubblicato con pesi aperti il 20 settembre, torna tramite API con il nome Qwen-Image-2.1-Pro a 0,04 dollari per immagine, un prezzo quasi dimezzato rispetto alla generazione precedente, per chi preferisce non ospitarlo in proprio. Il post di Apron ricorda invece che cosa richiede l’hosting in proprio: un modello può non avviarsi per la mancanza di un’impostazione di vLLM, oppure occupare 189 Gio di memoria host che una verifica limitata alla GPU non rileva.
Meta sposta la sicurezza a monte del rilascio. Un addestramento per rinforzo a rischio richiede ora sandbox validate, log inalterabili e un arresto automatico, perché un modello competente in cybersicurezza può sfruttare le vulnerabilità del proprio ambiente. Il comitato IA annunciato all’interno del consiglio di amministrazione deve inoltre verificare in modo indipendente che queste regole vengano applicate. Quanto agli impegni presi alla Casa Bianca, che Meta afferma di rispecchiare, il post ne illustra soltanto lo spirito: controlli interni verificati da un team indipendente all’interno dell’azienda e da un revisore o valutatore esterno.
Gli agenti, infine, si integrano negli strumenti e nelle attività operative. OpenAI permette di scegliere le dimensioni della sandbox e di riutilizzare un ambiente da una sessione all’altra, Devin si integra in Jira e corregge i problemi rilevati dalla propria revisione prima di pubblicarli, e Copilot code review si avvia tramite API con un costo stimato per livello di impegno. Antigravity CLI rispetta i tempi di attesa indicati dal server per i nuovi tentativi e fa funzionare Remote Control nei container: impostazioni operative più che funzionalità spettacolari, ma sono queste a contare quando un agente funziona in continuo.
Fonti
- Post di Aleph Alpha su Kolibri
- Kolibri-1 su Hugging Face
- Annuncio di Kolibri da parte di @Aleph__Alpha
- Rapporto tecnico di Kolibri (PDF)
- Rilancio di Kolibri da parte di @cohere
- Congratulazioni di Aidan Gomez
- Accordo definitivo tra Cohere e Aleph Alpha
- Sviluppare modelli capaci in modo responsabile (Meta)
- Framework di scalabilità della superintelligenza di Meta
- Novità dell’API Agents da parte di @stevendcoffey
- Rilancio da parte di @OpenAIDevs
- Sandbox ospitate da OpenAI (documentazione OpenAI)
- Note di rilascio di Devin del 30 settembre
- Changelog di Antigravity
- Registro dei modelli di Model Studio
- Prezzi di Model Studio
- Scheda di qwen-image-2.1-pro su QwenCloud
- So che esegui LLMs. Si avvierà? (Hugging Face)
- Repository di Apron su GitHub
- Copilot CLI v1.0.92-3
- SDK GitHub Copilot v1.0.17-preview.3
- Copilot code review: supporto API e nuovo livello di impegno predefinito (GitHub)
- Nightly v0.64.0 del 3 ottobre di Gemini CLI
- Note di rilascio di DeepSeek Harness 0.2.1-alpha.1
- GPT-6.1 Sol in Warp (@warpdotdev)
- Note di rilascio dell’API SpaceXAI
- Settembre per gli sviluppatori OpenAI (@OpenAIDevs)
- ElevenLabs presso Banner Health
- Riepilogo del webinar Admiral (ElevenLabs)
- Presentazione di Kling 4.0
- Changelog di Runway
- Completato il rilascio dei token stateless di installazione delle GitHub App (GitHub)
- Feedback umano in tempo reale nel ciclo di addestramento (Rapidata)
- Quando gli agenti IA diventano prove gli uni per gli altri (Anouar Imel)