ai-powered-markdown-translatorArtigo traduzido do francês para o português com gpt-6.1-sol.
Sábado, 3 de outubro, a Aleph Alpha publica Kolibri, um modelo inglês-alemão de pesos abertos com 78,1 mil milhões de parâmetros sob licença Apache 2.0, divulgado nessa mesma noite pela Cohere, cuja união com a Aleph Alpha ainda aguarda as autorizações regulamentares. Na véspera, a Meta alargava o seu quadro de segurança ao treino dos seus modelos, e a API Agents da OpenAI acrescentava três tamanhos de sandbox. As notas de versão do Devin de 30 de setembro tornam-no um agente nativo do Jira, Qwen-Image-2.1-Pro chega à API a 0,04 dólar por imagem, e o programador do Apron explica como prever a memória GPU de um modelo aberto antes de alugar uma placa.
Aleph Alpha publica Kolibri, um modelo inglês-alemão de 78 mil milhões de parâmetros sob Apache 2.0
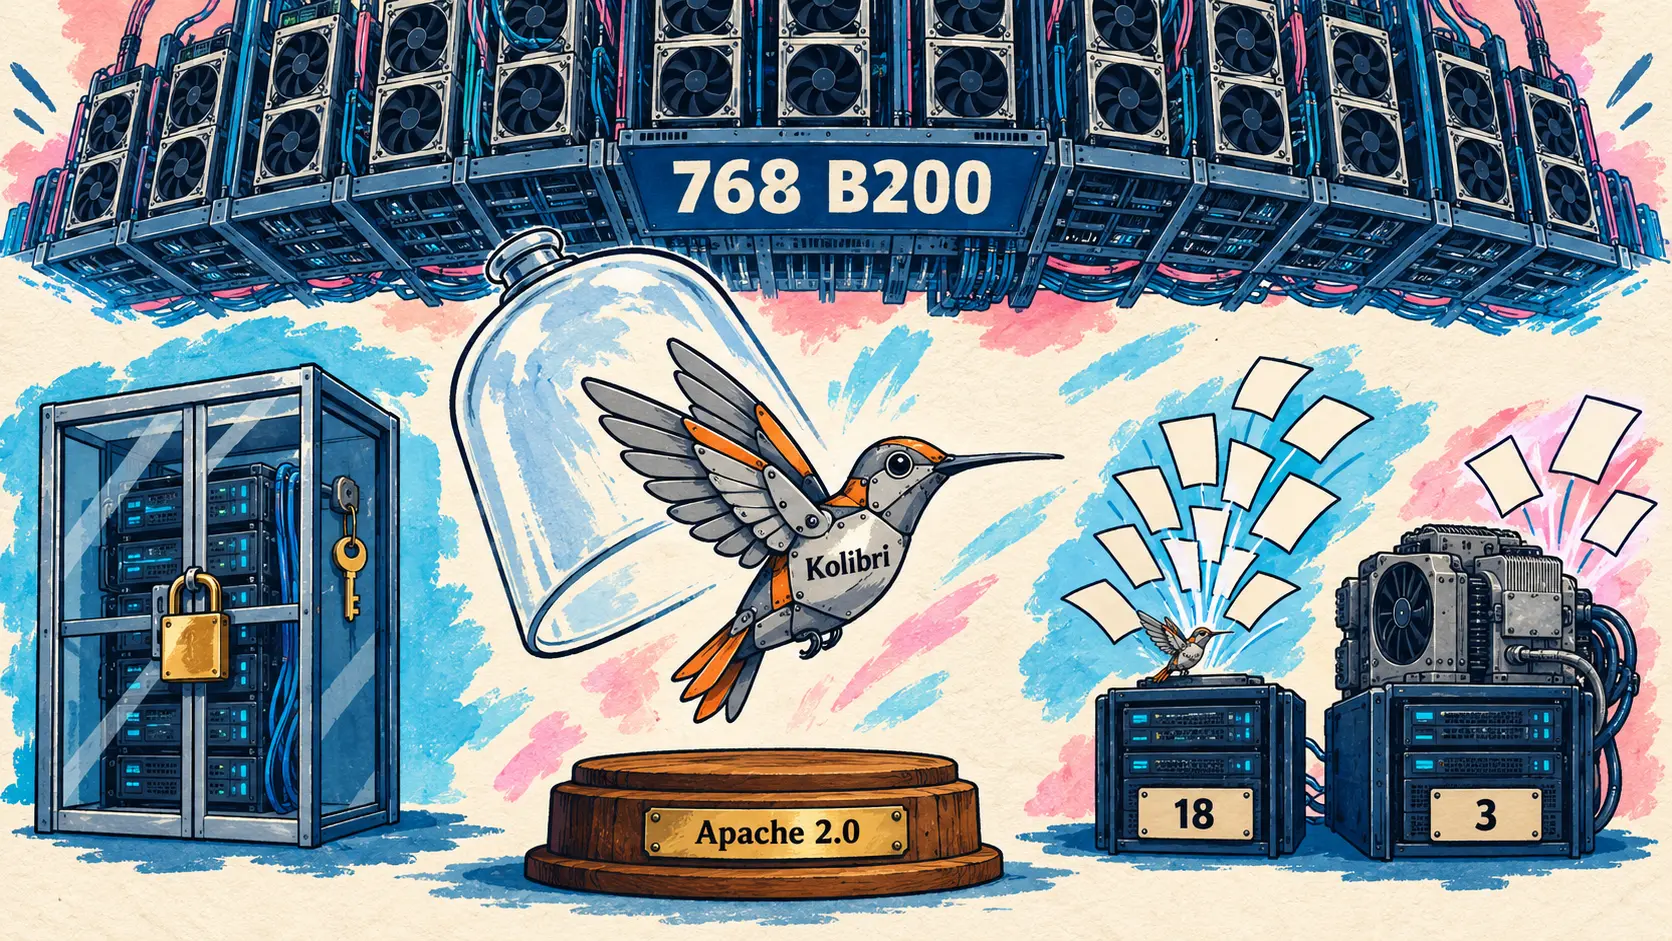
3 de outubro — No Dia da Unidade Alemã, a Aleph Alpha publica Kolibri, um modelo de linguagem inglês-alemão de pesos abertos. Este modelo de mistura de especialistas (Mixture-of-Experts) tem 78,1 mil milhões de parâmetros, dos quais 3,46 mil milhões ativos por token, e os seus pesos estão no Hugging Face sob licença Apache 2.0. A Aleph Alpha destina-o ao trabalho com soberania nos setores regulamentados: administração pública, indústria, aeronáutica.
A arquitetura visa sobretudo o custo de operação: 6 especialistas ativos entre 384, e 40 camadas entre 50 limitadas a uma janela deslizante de 512 tokens. O modelo aceita até 1 048 576 tokens, mas foi treinado até 262 144, comprimento que a sua ficha recomenda não ultrapassar. Segundo o artigo, uma versão de 123 mil milhões de parâmetros processava apenas 3 pedidos de 256k tokens em duas H100, contra 18 para o tamanho escolhido. O treino mobilizou 768 GPU B200 na Alemanha e na Finlândia, para cerca de 24T tokens; o alemão representa 21,3 % do pré-treino.
Segundo as medições da Aleph Alpha (sistema de avaliação próprio, esforço de raciocínio máximo), Kolibri supera na pontuação global Qwen3.5 35B-A3B e Nemotron 3 Super, que ativa 12 mil milhões de parâmetros, mas o modelo denso Qwen3.8 27B continua à frente em quase tudo:
| Benchmark (medições Aleph Alpha) | Kolibri 78B-A3,46B | Qwen3.5 35B-A3B | Nemotron 3 Super 120B-A12B | Mistral Small 4 119B-A6B | Qwen3.8 27B (denso) |
|---|---|---|---|---|---|
| Pontuação global (inglês) | 75,5 | 74,7 | 73,0 | 63,1 | 80,2 |
| Pontuação global (alemão) | 70,8 | 69,8 | 67,9 | 61,4 | 79,9 |
| GPQA Diamond (inglês) | 84,3 | 83,8 | 78,0 | 74,7 | 89,2 |
| AIME 2026 (inglês) | 96,0 | 92,1 | 90,4 | 83,1 | 97,7 |
| SWE-Bench Verified | 66,4 | 71,6 | 60,2 | 60,8 | 72,6 |
O argumento da Aleph Alpha é, portanto, a fronteira de Pareto entre qualidade e custo de operação, em vez do primeiro lugar. Treinado para se abster, Kolibri também prefere abster-se ou responder parcialmente a cometer um erro em 44 % das perguntas do AA-Omniscience a que não consegue responder corretamente. Desenvolvido na Alemanha «sem controlo estrangeiro» (sem controlo estrangeiro), concebido tendo em conta o AI Act e o RGPD, pode ser executado localmente; um relatório técnico de quase 200 páginas acompanha o lançamento.
A Cohere, cujo acordo definitivo de união com a Aleph Alpha continua sujeito a autorizações regulamentares, divulgou o lançamento nessa mesma noite, após as felicitações do seu CEO Aidan Gomez; Kolibri continua a ser um modelo da Aleph Alpha.
New Apache 2.0 model from @Aleph__Alpha. It’s really good. If you like that, you’re going to love what we build together.
🇵🇹 Novo modelo sob Apache 2.0 da Aleph Alpha. É mesmo bom. Se gostarem deste, vão adorar o que vamos construir juntos. — @cohere no X
🔗 Artigo da Aleph Alpha · Pesos no Hugging Face
Meta alarga o seu quadro de segurança ao treino e clarifica as suas regras para pesos abertos
2 de outubro — A Meta Superintelligence Labs atualiza o seu Meta Superintelligence Scaling Framework, que estabelece os seus requisitos de segurança antes de um treino e, posteriormente, de uma implementação. Segundo a Meta, esta versão reflete os compromissos assumidos esta semana na Casa Branca, que preveem controlos internos verificados por uma equipa independente dentro da empresa e por um auditor ou avaliador externo.
A perda de controlo (loss of control) passa a estar enquadrada durante o treino e a avaliação, pois um modelo forte em cibersegurança pode, segundo a Meta, explorar as vulnerabilidades do seu ambiente. Um treino por reforço de risco exige sandboxes validados, registos inalteráveis, incluindo a cadeia de pensamento, e monitorização automática capaz de parar o run.
Para os pesos abertos, o quadro tem em conta as modificações possíveis após a publicação, como remover a recusa através de ajuste fino. Um comité de IA do conselho de administração, anunciado para os próximos meses, verificará de forma independente o cumprimento do quadro. Este quadro é o antigo «Advanced AI Scaling Framework», cujo nome foi alterado nesta versão 2.1: o mesmo segundo o qual Muse Spark tinha sido avaliado em abril.
🔗 Desenvolver modelos capazes de forma responsável (Meta)
A API Agents da OpenAI acrescenta três tamanhos de sandbox e a reutilização de ambientes
2 de outubro — Steve (@stevendcoffey), que trabalha na API da OpenAI segundo a sua biografia no X, enumera as novidades da semana da API Agents, divulgadas por @OpenAIDevs. Além de três recapitulações do DevDay, há quatro pontos novos. O primeiro é confirmado pela documentação: o parâmetro environment.container_size, definido na criação de uma sessão, escolhe o CPU e a memória do sandbox alojado pela OpenAI.
| Tamanho do contentor | vCPU atribuídos | Memória atribuída |
|---|---|---|
| small | 1 | 1 Go |
| medium (predefinido) | 2 | 4 Go |
| large | 4 | 16 Go |
Os outros três aparecem apenas no tweet: subagentes configuráveis a partir do painel, reutilização de um ambiente em várias sessões e maior fiabilidade, sem método de medição publicado.
Overall better reliability: 99.97% turn reliability, fewer SSE disconnects, 20% faster tool calls 🪨
🇵🇹 Fiabilidade global melhorada: 99,97 % de fiabilidade por turno, menos desconexões SSE, chamadas de ferramentas 20 % mais rápidas. — @stevendcoffey no X
Agentes de código: Devin no Jira, Antigravity CLI 1.2.13 e 1.2.14
Devin torna-se um agente nativo do Jira e encaminha as constatações do Devin Review para as suas sessões
30 de setembro — As notas de versão do Devin de 30 de setembro incluem 25 secções. A principal torna Devin um agente nativo (native agent) do Jira: depois de um administrador instalar a app Devin for Jira, atribuir um ticket ao Devin ou mencioná-lo inicia uma sessão, acompanhada no painel de agente do Jira. Se Devin não conseguir arrancar (permissão em falta, limite de utilização), o Jira apresenta a sua explicação em vez de um erro genérico.
Numa pull request aberta por uma sessão Devin ainda ativa, Devin Review transmite primeiro as suas constatações (findings) a essa sessão: com a correção automática (Auto-fix), Devin corrige o que consegue e só as constatações restantes são publicadas. As automatizações ganham verificações prévias (preflight checks): um script é executado após cada acionador, antes do Devin, para validar, enriquecer ou ignorar o evento. Não é mencionado qualquer preço.
🔗 Notas de versão do Devin de 30 de setembro
Antigravity CLI 1.2.13 e 1.2.14: intervalos entre tentativas, fila de mensagens, Remote Control sem systemd
29 e 30 de setembro — O changelog da Antigravity CLI da Google enumera duas versões. A 1.2.13 respeita o intervalo de nova tentativa indicado pela API do modelo em vez de esperar 5 segundos fixos, e desiste imediatamente se esse intervalo ultrapassar 30 segundos ou se o limite atingido for um teto diário ou de faturação.
A 1.2.14 (6 melhorias, 3 correções) acrescenta a opção Queued Messages em /config: por predefinição (Queue), uma mensagem enviada enquanto o agente trabalha aguarda o fim do turno; no modo Send Immediately, interrompe-o. Nas máquinas Linux sem gestor de serviços de utilizador systemd, como a maioria dos contentores, Remote Control inicia o seu daemon como um simples processo em segundo plano, que não reiniciará após uma falha nem no arranque. A opção --json-schema passa a ser estrita: um esquema inválido provoca um erro e o código de saída 1. A disponibilização é gradual, ao longo de alguns dias.
Qwen-Image-2.1-Pro chega à API no Model Studio e no QwenCloud, a 0,04 dólar por imagem
2 de outubro — A Alibaba acrescenta Qwen-Image-2.1-Pro ao catálogo do Model Studio, a sua plataforma de API, para o âmbito de serviço International, e o QwenCloud dedica-lhe uma ficha marcada «NOVO», sem tweet nem artigo da Qwen. O modelo dá continuidade a Qwen-Image-2.1, publicado com pesos abertos em 20 de setembro: criação e edição num único modelo, 7 mil milhões de parâmetros para a geração visual, imagens transparentes nativas. A ficha não indica se a versão disponibilizada difere dos pesos publicados.
| Elemento comparado | qwen-image-2.1-pro | qwen-image-2.0-pro |
|---|---|---|
| Preço por imagem de saída | 0,04 dólar | 0,075 dólar |
| Quota gratuita | 10 imagens | 100 imagens |
O preço desce quase para metade, mas a quota gratuita é dez vezes menor. No QwenCloud, o modelo tem um limite de 20 pedidos por minuto e 10 chamadas simultâneas.
🔗 Registo de modelos do Model Studio · Ficha do QwenCloud
Apron prevê a memória GPU de 14 modelos abertos antes do aluguer, segundo o seu autor
3 de outubro — Vlad Ryzhkov, programador do Apron, apresenta no blogue da comunidade do Hugging Face esta ferramenta open source, que prevê, antes do aluguer de um GPU, se um modelo aberto caberá na memória e arrancará com uma versão específica do vLLM, e depois verifica-o numa placa real.
Segundo o autor, a memória dos pesos prevista fica a menos de 2 % da medição em 11 dos 14 modelos iniciados, desde uma RTX 4090 até oito H200. Quatro modelos falharam até que uma correção, validada por um segundo arranque, resolveu os problemas, e DeepSeek-V4.1-Flash ocupa por predefinição 189 Gio de memória do anfitrião, invisíveis numa verificação limitada ao GPU.
O autor avisa que há apenas um arranque medido por modelo e que nada constitui uma classificação. A ferramenta de linha de comandos não está pronta para utilização externa, e o seu repositório ainda se descreve como uma especificação sem implementação.
🔗 Artigo de Vlad Ryzhkov (Hugging Face)
Breves
- Copilot CLI 1.0.92-3 e SDK Copilot 1.0.17-preview.3 — A pré-versão do Copilot CLI acrescenta um seletor, aberto com Ctrl+E antes da conversa, para escolher uma execução local ou na cloud; a do SDK permite, em modo experimental, substituir as ferramentas do cliente numa sessão em curso. A versão estável mais recente continua a ser a 1.0.91. 🔗 CLI · 🔗 SDK
- Copilot code review por API — Uma revisão do Copilot pode agora ser solicitada através das API REST e GraphQL, com um nível de esforço definido para cada pedido, em disponibilidade geral para os planos Pro, Pro+, Max, Business e Enterprise; a documentação estima o custo de uma revisão entre 0,05 e 1 dólar de créditos de IA no Lite e entre 0,25 e 5 dólares no Balanced, o nível de esforço predefinido. 🔗 fonte
- Nightly do Gemini CLI — A v0.64.0-nightly de 3 de outubro contém apenas uma correção: Enter e Espaço confirmam de forma fiável as listas de opções, incluindo nos terminais sem o protocolo de teclado Kitty, como o do PyCharm no Windows, onde premir Enter menos de 30 ms depois de outra tecla era interpretado como Shift+Enter. A versão estável e a pré-versão permanecem inalteradas. 🔗 fonte
- DeepSeek Harness 0.2.1-alpha.1 — Esta 25.ª pré-versão, ainda sem versão estável, acrescenta uma camada experimental de compatibilidade com os mods do Claude Code, destinada, segundo a DeepSeek, a verificar que a API desses mods constitui, em linhas gerais, um subconjunto do que os plugins do Harness permitem, e não a oferecer compatibilidade completa. 🔗 fonte
- GPT-6.1 Sol no Warp — Na noite de 29 de setembro, o Warp disponibilizou o GPT-6.1 Sol no seu terminal agêntico, utilizável com uma subscrição do Codex ou do ChatGPT; o anúncio não indica preços nem métricas específicas do Warp. 🔗 fonte
- Fim do grok-voice-transcribe-1.0 — A SpaceXAI encerrou a 2 de outubro a antiga versão do seu modelo de transcrição por API: os pedidos são redirecionados para o grok-voice-transcribe-2.0, com o mesmo preço e maior precisão, segundo a SpaceXAI. A descontinuação tinha sido anunciada a 18 de setembro, sem data definida. 🔗 fonte
- Setembro para os developers da OpenAI — A conta @OpenAIDevs recapitula num artigo no X os anúncios de setembro para developers, do DevDay de dia 29 ao GPT-6 Sol e Luna, sem anúncios inéditos; o único pormenor adicional é que a API Decisions da OpenAI, em acesso preliminar limitado desde 29 de setembro, é anunciada como estando prestes a entrar em disponibilidade geral, sem data. 🔗 fonte
- Duas implementações de agentes ElevenLabs — A Banner Health confia ao ElevenAgents a marcação de consultas de cuidados de saúde primários, com transferência para um humano e conformidade com a HIPAA; a seguradora Admiral relata a entrada em produção dos seus agentes de voz, em que cada alteração passa de 1 % para 100 % do tráfego em poucas horas, em vez de várias semanas. Nenhuma das duas publica números sobre os resultados. 🔗 Banner Health · 🔗 Admiral
- Kling 4.0 em acesso antecipado — O artigo de apresentação do Kling 4.0, datado de 30 de setembro, esclarece que o modelo completo entra em acesso antecipado antes de uma disponibilização mais ampla em outubro, enquanto o Kling 4.0 Flash está disponível para os subscritores anuais Ultra desde 28 de setembro; acrescenta-se o formato 21:9, sem preços, API ou critérios de acesso. 🔗 fonte
- Runway Agent, Runway MCP e os dots da OpenAI — O changelog do Runway apresenta três novidades sem anúncio no X: o Runway Agent utiliza o modo Draft do Seedance 2.5 (rascunhos em 480p retrabalhados após a geração), o Ideogram 4.5 passa a integrar o Runway MCP nos planos pagos, e o Runway está disponível nos dots da OpenAI desde 1 de outubro. Não é indicado qualquer custo em créditos. 🔗 fonte
- Tokens sem estado das GitHub Apps — Fora da IA, o GitHub conclui a implementação, iniciada a 27 de abril, do formato sem estado
ghs_APPID_JWTpara todos os novos tokens de instalação das GitHub Apps: cerca de 520 caracteres em vez de 40, com as permissões e a expiração de uma hora inalteradas; o cabeçalho de testeX-GitHub-Stateless-S2S-Tokenserá descontinuado a 30 de novembro de 2026. 🔗 fonte - Feedback humano em direto na Rapidata — A Rapidata descreve a sua função Flows, que substitui o modelo de recompensa do Flow-GRPO por comparações humanas aos pares em tempo real, num artigo do fornecedor que não publica quaisquer resultados de treino medidos. 🔗 fonte
- Medir a dependência entre agentes — Num ensaio sem experiências nem medições, Anouar Imel propõe avaliar os sistemas multiagente pela dependência entre agentes, em vez do seu número, acompanhando em cada turno a exatidão, a diversidade dos raciocínios e o acoplamento entre agentes. 🔗 fonte
O que isto significa
O Kolibri mostra que um modelo aberto pode ser competitivo sem procurar o primeiro lugar. A própria Aleph Alpha publica medições em que o modelo denso Qwen3.8 27B o supera em quase tudo, e destaca outro critério: servir muitos pedidos longos com poucas GPU, tanto em inglês como em alemão, ao abrigo de uma licença que permite alojar tudo nas próprias instalações. Para uma administração pública ou uma empresa industrial sujeita ao AI Act e ao RGPD, este compromisso pode contar mais do que alguns pontos de benchmark. A Cohere, cuja aproximação à Aleph Alpha ainda aguarda as autorizações regulamentares, já promete os próximos passos.
O custo de execução impõe-se como um tema central para os modelos abertos. O Qwen-Image-2.1, disponibilizado com pesos abertos a 20 de setembro, regressa por API com o nome Qwen-Image-2.1-Pro a 0,04 dólar por imagem, quase metade do preço da geração anterior, para quem prefere não o alojar. O artigo do Apron recorda, por sua vez, o que exige o alojamento próprio: um modelo pode falhar no arranque por falta de uma configuração do vLLM, ou ocupar 189 Gio de memória do host que uma verificação limitada à GPU não deteta.
A Meta coloca a segurança numa fase anterior à implementação. Um treino por reforço que envolva riscos exige agora sandboxes validadas, logs inalteráveis e uma paragem automática, porque um modelo com fortes capacidades de cibersegurança pode explorar as vulnerabilidades do seu próprio ambiente. O comité de IA anunciado no âmbito do conselho de administração deve também verificar de forma independente que estas regras são aplicadas. Quanto aos compromissos assumidos na Casa Branca, que a Meta afirma refletir, o artigo apenas descreve os seus princípios: controlos internos verificados por uma equipa independente dentro da empresa e por um auditor ou avaliador externo.
Os agentes, por fim, integram-se nas ferramentas e nas operações. A OpenAI permite escolher o tamanho da sandbox e reutilizar um ambiente entre sessões, o Devin instala-se no Jira e corrige os problemas identificados pela sua própria revisão antes de publicar as conclusões, e o Copilot code review é acionado por API com um custo estimado por nível de esforço. O Antigravity CLI respeita os intervalos de nova tentativa definidos pelo servidor e executa o Remote Control em contentores: ajustes operacionais mais do que funções espetaculares, mas são eles que contam quando um agente funciona de forma contínua.
Fontes
- Artigo da Aleph Alpha sobre o Kolibri
- Kolibri-1 no Hugging Face
- Anúncio do Kolibri por @Aleph__Alpha
- Relatório técnico do Kolibri (PDF)
- Partilha do Kolibri por @cohere
- Felicitações de Aidan Gomez
- Acordo definitivo entre a Cohere e a Aleph Alpha
- Desenvolver modelos capazes de forma responsável (Meta)
- Framework de escalabilidade da superinteligência da Meta
- Novidades da API Agents por @stevendcoffey
- Partilha de @OpenAIDevs
- Sandboxes alojadas pela OpenAI (documentação da OpenAI)
- Notas de versão do Devin de 30 de setembro
- Changelog do Antigravity
- Registo dos modelos do Model Studio
- Preços do Model Studio
- Ficha do qwen-image-2.1-pro no QwenCloud
- Sei que executa LLMs. Vai arrancar? (Hugging Face)
- Repositório do Apron no GitHub
- Copilot CLI v1.0.92-3
- SDK GitHub Copilot v1.0.17-preview.3
- Copilot code review: suporte por API e novo nível de esforço predefinido (GitHub)
- Nightly v0.64.0 de 3 de outubro do Gemini CLI
- Notas de versão do DeepSeek Harness 0.2.1-alpha.1
- GPT-6.1 Sol no Warp (@warpdotdev)
- Notas de versão da API SpaceXAI
- Setembro para os developers da OpenAI (@OpenAIDevs)
- ElevenLabs na Banner Health
- Recapitulação do webinar da Admiral (ElevenLabs)
- Apresentação do Kling 4.0
- Changelog do Runway
- Disponibilizados os tokens de instalação sem estado das GitHub Apps (GitHub)
- Feedback humano em direto no ciclo de treino (Rapidata)
- Quando os agentes de IA passam a servir de prova uns para os outros (Anouar Imel)