ai-powered-markdown-translatorArtículo traducido del fr al es con gpt-6.1-sol.
El sábado 3 de octubre, Aleph Alpha publica Kolibri, un modelo en inglés y alemán de pesos abiertos con 78,1 mil millones de parámetros bajo licencia Apache 2.0, cuya publicación difundió esa misma noche Cohere, cuya integración con Aleph Alpha aún espera las autorizaciones regulatorias. El día anterior, Meta ampliaba su marco de seguridad al entrenamiento de sus modelos, y la API Agents de OpenAI añadía tres tamaños de sandbox. Las notas de versión de Devin del 30 de septiembre lo convierten en un agente nativo de Jira, Qwen-Image-2.1-Pro llega a la API a 0,04 dólares por imagen, y el desarrollador de Apron explica cómo prever la memoria GPU de un modelo abierto antes de alquilar una tarjeta.
Aleph Alpha publica Kolibri, un modelo en inglés y alemán de 78 mil millones de parámetros bajo Apache 2.0
3 de octubre — El Día de la Unidad Alemana, Aleph Alpha publica Kolibri, un modelo de lenguaje en inglés y alemán de pesos abiertos. Este modelo de mezcla de expertos (Mixture-of-Experts) cuenta con 78,1 mil millones de parámetros, de los cuales 3,46 mil millones están activos por token, y sus pesos están en Hugging Face bajo licencia Apache 2.0. Aleph Alpha lo destina al trabajo soberano de los sectores regulados: administración pública, industria y aeronáutica.
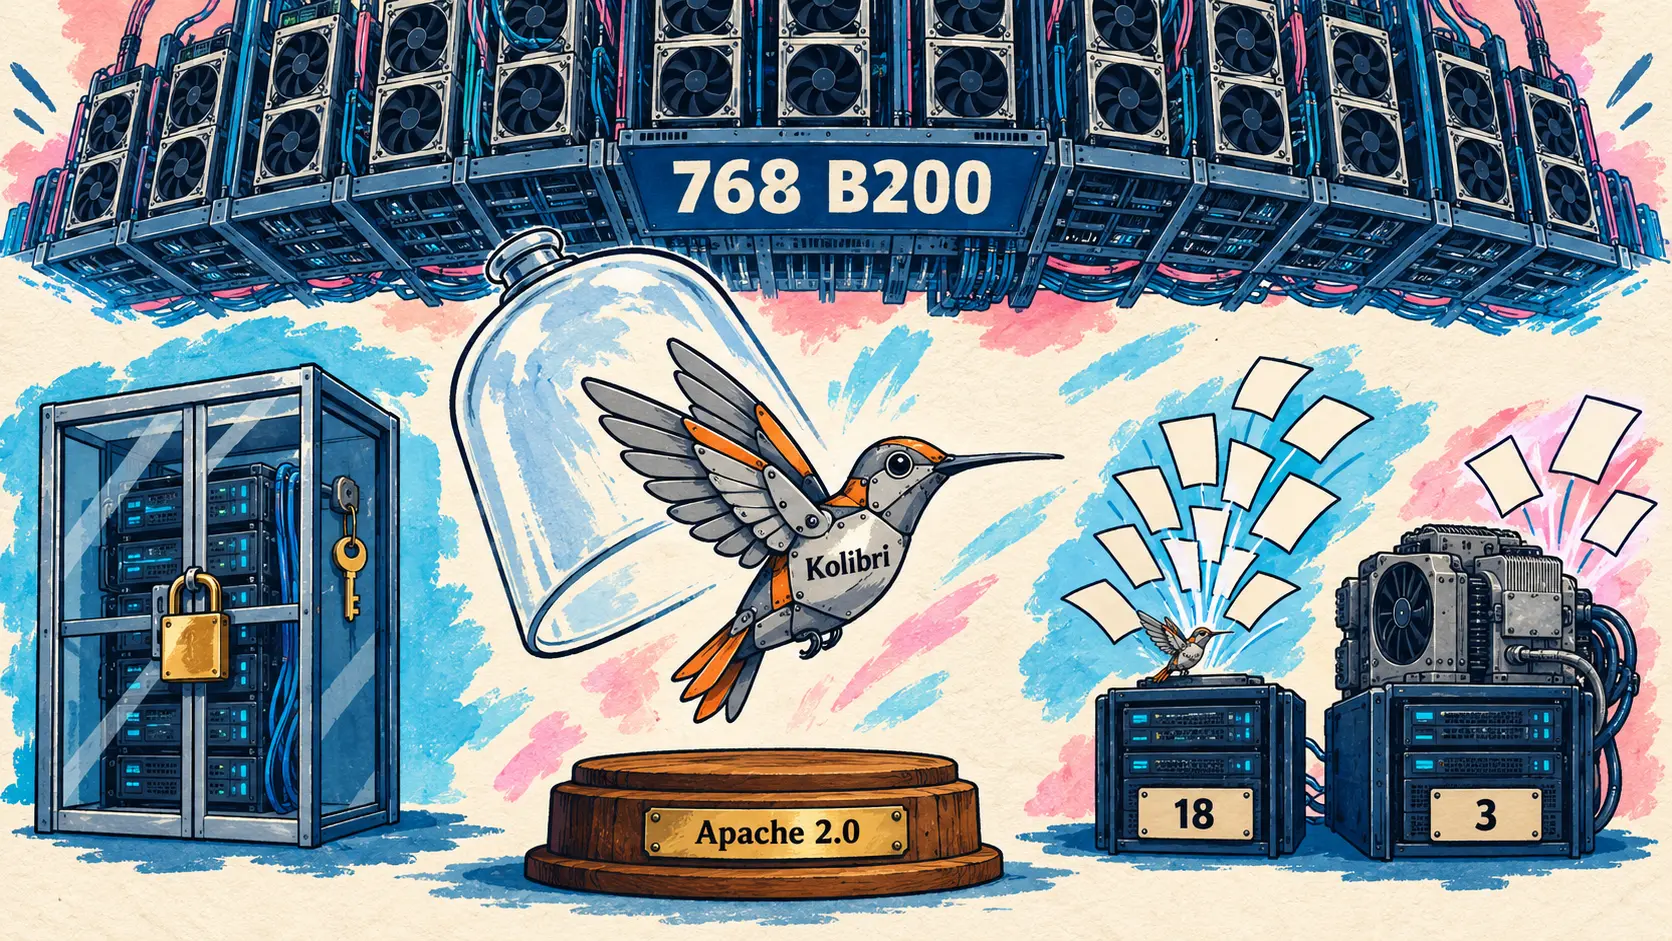
La arquitectura se centra ante todo en el coste de servicio: 6 expertos activos de 384, y 40 capas de 50 limitadas a una ventana deslizante de 512 tokens. El modelo acepta hasta 1 048 576 tokens, pero se entrenó hasta 262 144, longitud que su ficha recomienda no superar. Según la publicación, una versión de 123 mil millones de parámetros solo procesaba 3 solicitudes de 256k tokens en dos H100, frente a 18 con el tamaño elegido. El entrenamiento utilizó 768 GPU B200 en Alemania y Finlandia, para cerca de 24T tokens; el alemán representa el 21,3 % del preentrenamiento.
Según las mediciones de Aleph Alpha (herramienta de evaluación propia, esfuerzo de razonamiento máximo), Kolibri supera en puntuación global a Qwen3.5 35B-A3B y Nemotron 3 Super, que activa 12 mil millones de parámetros, pero el modelo denso Qwen3.8 27B sigue por delante en casi todas las pruebas:
| Benchmark (mediciones de Aleph Alpha) | Kolibri 78B-A3,46B | Qwen3.5 35B-A3B | Nemotron 3 Super 120B-A12B | Mistral Small 4 119B-A6B | Qwen3.8 27B (denso) |
|---|---|---|---|---|---|
| Puntuación global (inglés) | 75,5 | 74,7 | 73,0 | 63,1 | 80,2 |
| Puntuación global (alemán) | 70,8 | 69,8 | 67,9 | 61,4 | 79,9 |
| GPQA Diamond (inglés) | 84,3 | 83,8 | 78,0 | 74,7 | 89,2 |
| AIME 2026 (inglés) | 96,0 | 92,1 | 90,4 | 83,1 | 97,7 |
| SWE-Bench Verified | 66,4 | 71,6 | 60,2 | 60,8 | 72,6 |
El argumento de Aleph Alpha no es, por tanto, el primer puesto, sino la frontera de Pareto entre calidad y coste de servicio. Entrenado para abstenerse, Kolibri también prefiere abstenerse o responder parcialmente antes que equivocarse en el 44 % de las preguntas de AA-Omniscience que no logra resolver. Desarrollado en Alemania «sin control extranjero» (no foreign control), diseñado teniendo en cuenta el AI Act y el RGPD, puede ejecutarse en instalaciones propias; un informe técnico de cerca de 200 páginas acompaña el lanzamiento.
Cohere, cuyo acuerdo definitivo de integración con Aleph Alpha sigue sujeto a las autorizaciones regulatorias, difundió el lanzamiento esa misma noche, después de las felicitaciones de su CEO Aidan Gomez; Kolibri sigue siendo un modelo de Aleph Alpha.
New Apache 2.0 model from @Aleph__Alpha. It’s really good. If you like that, you’re going to love what we build together.
🇪🇸 Nuevo modelo bajo Apache 2.0 de Aleph Alpha. Es realmente bueno. Si este les gusta, les encantará lo que vamos a construir juntos. — @cohere en X
🔗 Publicación de Aleph Alpha · Pesos en Hugging Face
Meta amplía su marco de seguridad al entrenamiento y precisa sus reglas para los pesos abiertos
2 de octubre — Meta Superintelligence Labs actualiza su Meta Superintelligence Scaling Framework, que establece sus requisitos de seguridad antes de un entrenamiento y después de un despliegue. Según Meta, esta versión refleja los compromisos asumidos esta semana en la Casa Blanca, que prevén controles internos verificados por un equipo independiente dentro de la empresa y por un auditor o evaluador externo.
La pérdida de control (loss of control) pasa a estar regulada durante el entrenamiento y la evaluación, ya que un modelo con capacidades avanzadas en ciberseguridad puede, según Meta, explotar las vulnerabilidades de su entorno. Un entrenamiento por refuerzo de riesgo exige sandboxes validados, registros inalterables, incluida la cadena de pensamiento, y una supervisión automática capaz de detener el run.
Para los pesos abiertos, el marco tiene en cuenta las modificaciones posibles tras su publicación, como eliminar el rechazo mediante ajuste fino. Un comité de IA del consejo de administración, anunciado para los próximos meses, verificará de forma independiente el cumplimiento del marco. Este marco es el antiguo «Advanced AI Scaling Framework», renombrado con esta versión 2.1: el mismo con el que se había evaluado Muse Spark en abril.
🔗 Desarrollar modelos capaces de forma responsable (Meta)
La API Agents de OpenAI añade tres tamaños de sandbox y la reutilización de entornos
2 de octubre — Steve (@stevendcoffey), que trabaja en la API de OpenAI según su biografía en X, enumera las novedades de la semana de la API Agents, difundidas por @OpenAIDevs. Además de tres recordatorios del DevDay, hay cuatro puntos nuevos. El primero está confirmado por la documentación: el parámetro environment.container_size, establecido al crear una sesión, elige la CPU y la memoria del sandbox alojado por OpenAI.
| Tamaño del contenedor | vCPU asignadas | Memoria asignada |
|---|---|---|
| small | 1 | 1 Go |
| medium (por defecto) | 2 | 4 Go |
| large | 4 | 16 Go |
Los otros tres solo aparecen en el tweet: subagentes configurables desde el panel de control, reutilización de un entorno en varias sesiones y mayor fiabilidad, sin un método de medición publicado.
Overall better reliability: 99.97% turn reliability, fewer SSE disconnects, 20% faster tool calls 🪨
🇪🇸 Fiabilidad global mejorada: 99,97 % de fiabilidad por turno, menos desconexiones SSE, llamadas a herramientas un 20 % más rápidas. — @stevendcoffey en X
Agentes de código: Devin en Jira, Antigravity CLI 1.2.13 y 1.2.14
Devin se convierte en un agente nativo de Jira y envía los hallazgos de Devin Review a sus sesiones
30 de septiembre — Las notas de versión de Devin del 30 de septiembre incluyen 25 apartados. El principal convierte a Devin en un agente nativo (native agent) de Jira: una vez que un administrador instala la app Devin for Jira, asignar un ticket a Devin o mencionarlo inicia una sesión, cuyo seguimiento se realiza en el panel de agentes de Jira. Si Devin no puede iniciarse (falta de permisos, límite de uso), Jira muestra su explicación en lugar de un error genérico.
En una pull request abierta por una sesión de Devin que sigue activa, Devin Review envía primero sus hallazgos (findings) a esa sesión: con la corrección automática (Auto-fix), Devin corrige lo que puede y solo se publican los hallazgos restantes. Las automatizaciones incorporan comprobaciones previas (preflight checks): un script se ejecuta después de cada activador, antes de Devin, para validar, enriquecer o ignorar el evento. No se menciona ningún precio.
🔗 Notas de versión de Devin del 30 de septiembre
Antigravity CLI 1.2.13 y 1.2.14: tiempos de reintento, cola de mensajes, Remote Control sin systemd
29 y 30 de septiembre — El changelog de Antigravity CLI de Google enumera dos versiones. La 1.2.13 respeta el tiempo de reintento indicado por la API del modelo en lugar de esperar 5 segundos fijos, y abandona de inmediato si ese tiempo supera los 30 segundos o si el límite alcanzado es un tope diario o de facturación.
La 1.2.14 (6 mejoras, 3 correcciones) añade en /config la opción Queued Messages: por defecto (Queue), un mensaje enviado mientras el agente trabaja espera al final del turno; en modo Send Immediately, lo interrumpe. En las máquinas Linux sin gestor de servicios de usuario systemd, como la mayoría de los contenedores, Remote Control ejecuta su daemon como un simple proceso en segundo plano, que no se reiniciará tras un fallo ni al arrancar el sistema. La opción --json-schema pasa a ser estricta: un esquema inválido provoca un error y el código de salida 1. El despliegue es gradual, a lo largo de unos días.
Qwen-Image-2.1-Pro llega a la API de Model Studio y QwenCloud, a 0,04 dólares por imagen
2 de octubre — Alibaba añade Qwen-Image-2.1-Pro al catálogo de Model Studio, su plataforma de API, para el ámbito de servicio International, y QwenCloud le dedica una ficha marcada como «NEW», sin ningún tweet ni publicación de Qwen. El modelo da continuidad a Qwen-Image-2.1, publicado con pesos abiertos el 20 de septiembre: creación y edición en un único modelo, 7 mil millones de parámetros para la generación visual, imágenes transparentes nativas. La ficha no indica si la versión ofrecida difiere de los pesos publicados.
| Elemento comparado | qwen-image-2.1-pro | qwen-image-2.0-pro |
|---|---|---|
| Precio por imagen de salida | 0,04 dollar | 0,075 dollar |
| Cuota gratuita | 10 imágenes | 100 imágenes |
El precio baja casi a la mitad, pero la cuota gratuita es diez veces menor. En QwenCloud, el modelo tiene un límite de 20 solicitudes por minuto y 10 llamadas simultáneas.
🔗 Registro de modelos de Model Studio · Ficha de QwenCloud
Apron predice la memoria GPU de 14 modelos abiertos antes del alquiler, según su autor
3 de octubre — Vlad Ryzhkov, desarrollador de Apron, presenta en el blog comunitario de Hugging Face esta herramienta open source, que predice antes de alquilar una GPU si un modelo abierto cabrá en memoria y arrancará con una versión concreta de vLLM, y después lo verifica en una tarjeta real.
Según el autor, la predicción de la memoria de los pesos se sitúa a menos del 2 % del valor medido en 11 de los 14 modelos iniciados, desde una RTX 4090 hasta ocho H200. Cuatro modelos fallaron antes de que un parche, validado mediante un segundo arranque, los reparara, y DeepSeek-V4.1-Flash ocupa por defecto 189 Gio de memoria del host, invisibles para una comprobación limitada a la GPU.
El autor advierte de que solo hay un arranque medido por modelo y de que nada de esto constituye una clasificación. La herramienta de línea de comandos no está lista para su uso externo, y su repositorio aún se describe como una especificación sin implementación.
🔗 Publicación de Vlad Ryzhkov (Hugging Face)
Breves
- Copilot CLI 1.0.92-3 y SDK Copilot 1.0.17-preview.3 — La versión preliminar de Copilot CLI añade un selector, que se abre con Ctrl+E antes de la conversación, para elegir una ejecución local o en la nube; la del SDK permite, de forma experimental, sustituir las herramientas del cliente en una sesión en curso. La última versión estable sigue siendo la 1.0.91. 🔗 CLI · 🔗 SDK
- Copilot code review mediante API — Ahora se puede solicitar una revisión de Copilot mediante las API REST y GraphQL, con un nivel de esfuerzo establecido en cada solicitud, en disponibilidad general para los planes Pro, Pro+, Max, Business y Enterprise; la documentación estima el coste de una revisión entre 0,05 y 1 dólar de créditos de IA en Lite y entre 0,25 y 5 dólares en Balanced, el nivel de esfuerzo predeterminado. 🔗 fuente
- Nightly de Gemini CLI — La v0.64.0-nightly del 3 de octubre solo contiene una corrección: Intro y Espacio confirman de forma fiable las listas de opciones, incluso en terminales sin el protocolo de teclado Kitty, como el de PyCharm en Windows, donde una pulsación de Intro menos de 30 ms después de otra tecla se interpretaba como Mayús+Intro. La versión estable y la preliminar siguen sin cambios. 🔗 fuente
- DeepSeek Harness 0.2.1-alpha.1 — Esta 25.ª versión preliminar, todavía sin versión estable, añade una capa experimental de compatibilidad con los mods de Claude Code, destinada, según DeepSeek, a comprobar que su API constituye aproximadamente un subconjunto de lo que permiten los plugins de Harness, y no a ofrecer compatibilidad completa. 🔗 fuente
- GPT-6.1 Sol en Warp — La noche del 29 de septiembre, Warp habilitó GPT-6.1 Sol en su terminal agéntico, utilizable con una suscripción a Codex o ChatGPT; el anuncio no proporciona precios ni métricas propias de Warp. 🔗 fuente
- Fin de grok-voice-transcribe-1.0 — SpaceXAI retiró el 2 de octubre la antigua versión de su modelo de transcripción por API: las solicitudes se redirigen a grok-voice-transcribe-2.0, al mismo precio y con mayor precisión según SpaceXAI. La deprecación se había anunciado sin fecha el 18 de septiembre. 🔗 fuente
- Septiembre para desarrolladores de OpenAI — La cuenta @OpenAIDevs recapitula en un artículo de X los anuncios para desarrolladores de septiembre, desde el DevDay del día 29 hasta GPT-6 Sol y Luna, sin anuncios inéditos; la única precisión es que la API Decisions de OpenAI, en acceso preliminar limitado desde el 29 de septiembre, se anuncia allí como disponible próximamente para todos, sin fecha. 🔗 fuente
- Dos despliegues de agentes de ElevenLabs — Banner Health confía a ElevenAgents la gestión de citas de atención primaria, con transferencia a una persona y cumplimiento de HIPAA; la aseguradora Admiral cuenta la puesta en producción de sus agentes de voz, donde cada modificación pasa del 1 % al 100 % del tráfico en unas horas en lugar de varias semanas. Ninguna de las dos publica cifras de resultados. 🔗 Banner Health · 🔗 Admiral
- Kling 4.0 en acceso anticipado — La publicación de presentación de Kling 4.0, fechada el 30 de septiembre, precisa que el modelo completo entra en acceso anticipado antes de un despliegue más amplio en octubre, mientras que Kling 4.0 Flash está disponible para los suscriptores anuales de Ultra desde el 28 de septiembre; se añade el formato 21:9, sin precios, API ni criterios de acceso. 🔗 fuente
- Runway Agent, Runway MCP y los dots de OpenAI — El changelog de Runway recoge tres incorporaciones sin anuncio en X: Runway Agent utiliza el modo Draft de Seedance 2.5 (borradores en 480p retocados después de la generación), Ideogram 4.5 se incorpora a Runway MCP para los planes de pago, y Runway está disponible desde el 1 de octubre en los dots de OpenAI. No se precisa ningún coste en créditos. 🔗 fuente
- Tokens sin estado de las GitHub Apps — Fuera de la IA, GitHub completa el despliegue, iniciado el 27 de abril, del formato sin estado
ghs_APPID_JWTpara todos los nuevos tokens de instalación de las GitHub Apps: unos 520 caracteres en lugar de 40, con los permisos y la caducidad de una hora sin cambios; la cabecera de pruebaX-GitHub-Stateless-S2S-Tokense deprecará el 30 de noviembre de 2026. 🔗 fuente - Feedback humano en tiempo real en Rapidata — Rapidata describe su función Flows, que sustituye el modelo de recompensa de Flow-GRPO por comparaciones humanas por pares en tiempo real, en una publicación del proveedor que no presenta ningún resultado de entrenamiento medido. 🔗 fuente
- Medir la dependencia entre agentes — En un ensayo sin experimentos ni mediciones, Anouar Imel propone evaluar los sistemas multiagente según la dependencia entre agentes en lugar de su número, siguiendo en cada turno la exactitud, la diversidad de los razonamientos y el acoplamiento entre agentes. 🔗 fuente
Lo que esto significa
Kolibri muestra que un modelo abierto puede defenderse sin aspirar al primer puesto. Aleph Alpha publica sus propias mediciones, en las que el modelo denso Qwen3.8 27B lo supera en casi todo, y destaca otro criterio: atender muchas solicitudes largas con pocas GPU, tanto en inglés como en alemán, con una licencia que permite alojarlo todo en las propias instalaciones. Para una administración o una empresa industrial sujeta al AI Act y al RGPD, ese equilibrio puede pesar más que unos pocos puntos de benchmark. Cohere, cuya unión con Aleph Alpha todavía espera las autorizaciones regulatorias, ya promete la siguiente etapa.
El coste del servicio se impone como un tema central para los modelos abiertos. Qwen-Image-2.1, publicado con pesos abiertos el 20 de septiembre, vuelve por API bajo el nombre Qwen-Image-2.1-Pro a 0,04 dólares por imagen, casi la mitad que la generación anterior, para quien prefiera no alojarlo. La publicación de Apron recuerda, por su parte, lo que exige el autoalojamiento: un modelo puede fallar al arrancar por la falta de un ajuste de vLLM, o consumir 189 Gio de memoria del host que una comprobación limitada a la GPU no detecta.
Meta sitúa la seguridad antes del despliegue. Un entrenamiento por refuerzo que entrañe riesgos exige ahora entornos aislados validados, registros inalterables y una detención automática, porque un modelo competente en ciberseguridad puede explotar las vulnerabilidades de su propio entorno. El comité de IA anunciado dentro del consejo de administración debe, además, verificar de forma independiente que estas reglas se aplican. En cuanto a los compromisos asumidos en la Casa Blanca, que Meta afirma reflejar, la publicación solo recoge su espíritu: controles internos verificados por un equipo independiente dentro de la empresa y por un auditor o evaluador externo.
Los agentes, por último, se integran en las herramientas y en la operación. OpenAI permite elegir el tamaño del entorno aislado y reutilizar un entorno de una sesión a otra, Devin se instala en Jira y corrige los problemas detectados en su propia revisión antes de publicarlos, y Copilot code review se activa por API con un coste estimado por nivel de esfuerzo. Antigravity CLI respeta los tiempos de espera para los reintentos indicados por el servidor y ejecuta Remote Control en los contenedores: ajustes operativos más que funciones espectaculares, pero son los que cuentan cuando un agente funciona continuamente.
Fuentes
- Publicación de Aleph Alpha sobre Kolibri
- Kolibri-1 en Hugging Face
- Anuncio de Kolibri por @Aleph__Alpha
- Informe técnico de Kolibri (PDF)
- Difusión de Kolibri por @cohere
- Felicitaciones de Aidan Gomez
- Acuerdo definitivo entre Cohere y Aleph Alpha
- Desarrollo responsable de modelos capaces (Meta)
- Marco de escalado de la superinteligencia de Meta
- Novedades de la API Agents por @stevendcoffey
- Difusión por @OpenAIDevs
- Entornos aislados alojados por OpenAI (documentación de OpenAI)
- Notas de la versión de Devin del 30 de septiembre
- Changelog de Antigravity
- Registro de modelos de Model Studio
- Precios de Model Studio
- Ficha de qwen-image-2.1-pro en QwenCloud
- Sé que ejecutas LLMs. ¿Arrancará? (Hugging Face)
- Repositorio de Apron en GitHub
- Copilot CLI v1.0.92-3
- SDK GitHub Copilot v1.0.17-preview.3
- Copilot code review: compatibilidad con API y nuevo nivel de esfuerzo predeterminado (GitHub)
- Nightly v0.64.0 del 3 de octubre de Gemini CLI
- Notas de la versión de DeepSeek Harness 0.2.1-alpha.1
- GPT-6.1 Sol en Warp (@warpdotdev)
- Notas de las versiones de la API SpaceXAI
- Septiembre para desarrolladores de OpenAI (@OpenAIDevs)
- ElevenLabs en Banner Health
- Resumen del seminario web de Admiral (ElevenLabs)
- Presentación de Kling 4.0
- Changelog de Runway
- Completado el despliegue de los tokens de instalación sin estado de GitHub App (GitHub)
- Feedback humano en tiempo real en el ciclo de entrenamiento (Rapidata)
- Cuando los agentes de IA se convierten en pruebas unos para otros (Anouar Imel)