ai-powered-markdown-translatorArtikel vertaald van het Frans naar het Nederlands met gpt-6.1-sol.
Op zaterdag 3 oktober brengt Aleph Alpha Kolibri uit, een Engels-Duits model met open gewichten en 78,1 miljard parameters onder de Apache 2.0-licentie. Cohere, waarvan de samenvoeging met Aleph Alpha nog op goedkeuring van de toezichthouders wacht, deelt de aankondiging diezelfde avond. Een dag eerder breidde Meta zijn veiligheidskader uit naar de training van zijn modellen en voegde de Agents API van OpenAI drie sandboxgroottes toe. De release notes van Devin van 30 september maken het tot een native agent van Jira, Qwen-Image-2.1-Pro komt beschikbaar via een API voor 0,04 dollar per afbeelding en de ontwikkelaar van Apron legt uit hoe je het GPU-geheugengebruik van een open model kunt voorspellen voordat je een kaart huurt.
Aleph Alpha brengt Kolibri uit, een Engels-Duits model met 78 miljard parameters onder Apache 2.0
3 oktober — Op de Dag van de Duitse Eenheid brengt Aleph Alpha Kolibri uit, een Engels-Duits taalmodel met open gewichten. Dit model met een mix van experts (Mixture-of-Experts) telt 78,1 miljard parameters, waarvan 3,46 miljard actief zijn per token, en zijn gewichten staan op Hugging Face onder de Apache 2.0-licentie. Aleph Alpha richt het model op soeverein werken in gereguleerde sectoren: overheid, industrie en luchtvaart.
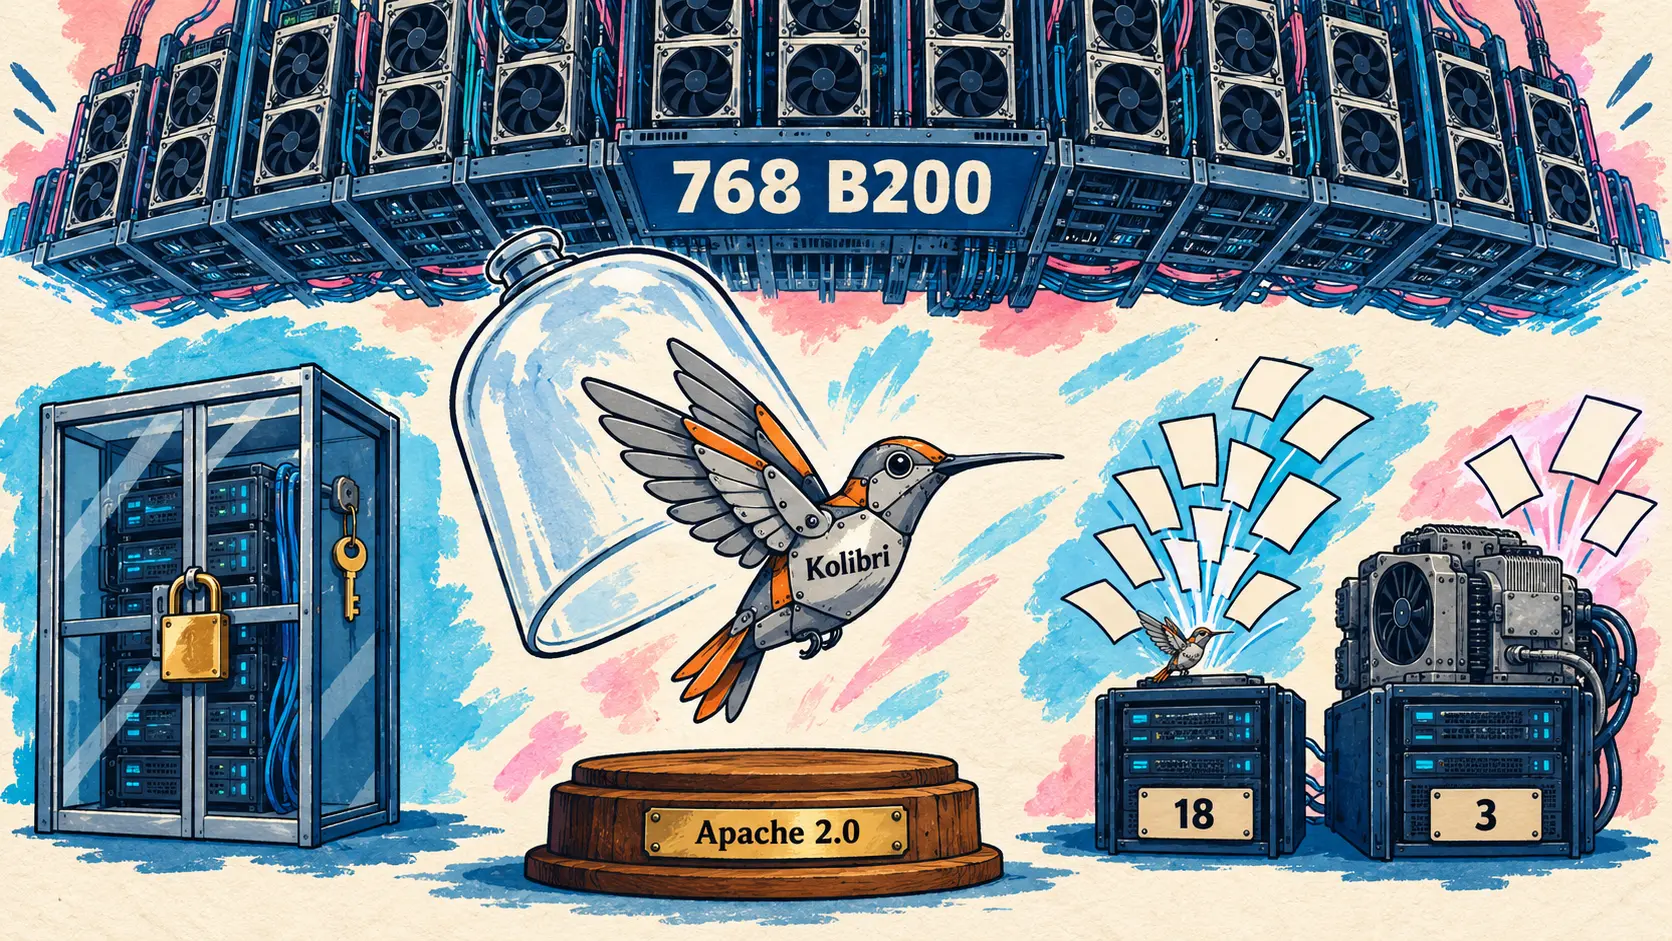
De architectuur richt zich vooral op de kosten om het model te draaien: 6 actieve experts van de 384, en 40 van de 50 lagen zijn beperkt tot een schuivend venster van 512 tokens. Het model accepteert maximaal 1 048 576 tokens, maar is getraind tot 262 144, een lengte die volgens de modelbeschrijving beter niet overschreden kan worden. Volgens het blogbericht verwerkte een versie met 123 miljard parameters slechts 3 verzoeken van 256k tokens op twee H100, tegenover 18 voor de gekozen omvang. Voor de training werden 768 B200-GPU’s in Duitsland en Finland ingezet, voor bijna 24T tokens; Duits vertegenwoordigt 21,3 % van de pretraining.
Volgens de metingen van Aleph Alpha (eigen evaluatieharnas, maximale redeneerinspanning) scoort Kolibri in totaal hoger dan Qwen3.5 35B-A3B en Nemotron 3 Super, dat 12 miljard parameters activeert, maar het dense model Qwen3.8 27B blijft vrijwel overal voorop:
| Benchmark (metingen van Aleph Alpha) | Kolibri 78B-A3,46B | Qwen3.5 35B-A3B | Nemotron 3 Super 120B-A12B | Mistral Small 4 119B-A6B | Qwen3.8 27B (dense) |
|---|---|---|---|---|---|
| Totaalscore (Engels) | 75,5 | 74,7 | 73,0 | 63,1 | 80,2 |
| Totaalscore (Duits) | 70,8 | 69,8 | 67,9 | 61,4 | 79,9 |
| GPQA Diamond (Engels) | 84,3 | 83,8 | 78,0 | 74,7 | 89,2 |
| AIME 2026 (Engels) | 96,0 | 92,1 | 90,4 | 83,1 | 97,7 |
| SWE-Bench Verified | 66,4 | 71,6 | 60,2 | 60,8 | 72,6 |
Het argument van Aleph Alpha is dus niet de eerste plaats, maar de Pareto-grens tussen kwaliteit en kosten om het model te draaien. Kolibri is getraind om zich van antwoorden te onthouden en geeft bij 44 % van de vragen van AA-Omniscience die het niet goed weet te beantwoorden ook liever geen of slechts een gedeeltelijk antwoord dan een fout antwoord. Het is ontwikkeld in Duitsland « zonder buitenlandse zeggenschap » (geen buitenlandse controle), ontworpen met de AI Act en de RGPD in gedachten en kan lokaal draaien; een technisch rapport van bijna 200 pagina’s begeleidt de release.
Cohere, waarvan de definitieve overeenkomst om samen te gaan met Aleph Alpha nog onderworpen is aan goedkeuring van de toezichthouders, deelde de aankondiging diezelfde avond, na de felicitaties van zijn CEO Aidan Gomez; Kolibri blijft een model van Aleph Alpha.
New Apache 2.0 model from @Aleph__Alpha. It’s really good. If you like that, you’re going to love what we build together.
🇳🇱 Een nieuw model onder Apache 2.0 van Aleph Alpha. Het is echt goed. Als dit model je bevalt, zul je geweldig vinden wat we samen gaan bouwen. — @cohere op X
🔗 Blogbericht van Aleph Alpha · Gewichten op Hugging Face
Meta breidt zijn veiligheidskader uit naar training en verduidelijkt zijn regels voor open gewichten
2 oktober — Meta Superintelligence Labs werkt zijn Meta Superintelligence Scaling Framework bij, dat zijn veiligheidseisen vóór training en vervolgens vóór uitrol vastlegt. Volgens Meta weerspiegelt deze versie de toezeggingen die deze week in het Witte Huis zijn gedaan. Die voorzien in interne controles die worden geverifieerd door een onafhankelijk team binnen het bedrijf en door een externe auditor of beoordelaar.
Controleverlies (loss of control) valt nu ook tijdens training en evaluatie onder het kader, omdat een model dat sterk is in cybersecurity volgens Meta kwetsbaarheden in zijn omgeving kan uitbuiten. Risicovolle reinforcement learning vereist gevalideerde sandboxes, onveranderbare logs, inclusief de chain of thought, en automatische bewaking die de run kan stoppen.
Voor open gewichten houdt het kader rekening met mogelijke wijzigingen na publicatie, zoals het verwijderen van weigeringsgedrag via fine-tuning. Een AI-comité van de raad van bestuur, aangekondigd voor de komende maanden, zal onafhankelijk controleren of het kader wordt nageleefd. Dit kader is het vroegere « Advanced AI Scaling Framework », dat met deze versie 2.1 een nieuwe naam krijgt: het kader waarmee Muse Spark in april werd geëvalueerd.
🔗 Krachtige modellen op verantwoorde wijze ontwikkelen (Meta)
De Agents API van OpenAI voegt drie sandboxgroottes en hergebruik van omgevingen toe
2 oktober — Steve (@stevendcoffey), die volgens zijn X-bio aan de API van OpenAI werkt, somt de vernieuwingen van deze week voor de Agents API op. @OpenAIDevs deelt zijn bericht. Naast drie herhalingen van DevDay-aankondigingen zijn vier punten nieuw. Het eerste wordt bevestigd door de documentatie: de parameter environment.container_size, die bij het aanmaken van een sessie wordt ingesteld, bepaalt de CPU en het geheugen van de door OpenAI gehoste sandbox.
| Containergrootte | Toegewezen vCPU’s | Toegewezen geheugen |
|---|---|---|
| small | 1 | 1 Go |
| medium (standaard) | 2 | 4 Go |
| large | 4 | 16 Go |
De drie andere staan alleen in de tweet: subagents die vanuit het dashboard kunnen worden geconfigureerd, hergebruik van een omgeving in meerdere sessies en een hogere betrouwbaarheid, zonder gepubliceerde meetmethode.
Overall better reliability: 99.97% turn reliability, fewer SSE disconnects, 20% faster tool calls 🪨
🇳🇱 Algehele betrouwbaarheid verbeterd: 99,97 % betrouwbaarheid per beurt, minder verbroken SSE-verbindingen, 20 % snellere toolaanroepen. — @stevendcoffey op X
Codeagents: Devin in Jira, Antigravity CLI 1.2.13 en 1.2.14
Devin wordt een native agent van Jira en geeft de bevindingen van Devin Review door aan zijn sessies
30 september — De release notes van Devin van 30 september bevatten 25 rubrieken. De belangrijkste maakt Devin tot een native agent (native agent) van Jira: zodra een beheerder de app Devin for Jira heeft geïnstalleerd, start het toewijzen van een ticket aan Devin of het vermelden van Devin een sessie, die in het agentpaneel van Jira wordt gevolgd. Als Devin niet kan starten (ontbrekende toestemming, gebruikslimiet), toont Jira zijn uitleg in plaats van een algemene foutmelding.
Bij een pull request die is geopend door een nog actieve Devin-sessie, geeft Devin Review zijn bevindingen (findings) eerst door aan die sessie: met de automatische correctie (Auto-fix) herstelt Devin wat het kan en worden alleen de resterende bevindingen gepubliceerd. Automatiseringen krijgen voorafgaande controles (preflight checks): na elke trigger wordt vóór Devin een script uitgevoerd om de gebeurtenis te valideren, te verrijken of te negeren. Er wordt geen prijs genoemd.
🔗 Release notes van Devin van 30 september
Antigravity CLI 1.2.13 en 1.2.14: wachttijden voor nieuwe pogingen, berichtenwachtrij, Remote Control zonder systemd
29 en 30 september — De changelog van Google’s Antigravity CLI vermeldt twee versies. Versie 1.2.13 volgt de wachttijd voor een nieuwe poging die de API van het model aangeeft, in plaats van altijd 5 seconden te wachten, en stopt meteen als die wachttijd meer dan 30 seconden bedraagt of als de bereikte limiet een daglimiet of factureringslimiet is.
Versie 1.2.14 (6 verbeteringen, 3 fixes) voegt in /config de optie Queued Messages toe: standaard (Queue) wacht een bericht dat wordt verstuurd terwijl de agent werkt tot het einde van de beurt; in de modus Send Immediately onderbreekt het de agent. Op Linux-machines zonder systemd-beheerder voor gebruikersservices, zoals de meeste containers, start Remote Control zijn daemon als een eenvoudig achtergrondproces, dat niet opnieuw start na een crash of bij het opstarten. De optie --json-schema wordt strikt: een ongeldig schema veroorzaakt een fout en exitcode 1. De uitrol verloopt geleidelijk, verspreid over enkele dagen.
Qwen-Image-2.1-Pro komt beschikbaar via een API op Model Studio en QwenCloud, voor 0,04 dollar per afbeelding
2 oktober — Alibaba voegt Qwen-Image-2.1-Pro toe aan de catalogus van Model Studio, zijn API-platform, voor het servicebereik International. QwenCloud geeft het model een eigen pagina met de markering « NIEUW », zonder tweet of blogbericht van Qwen. Het model bouwt voort op Qwen-Image-2.1, dat op 20 september met open gewichten werd uitgebracht: maken en bewerken in één model, 7 miljard parameters voor visuele generatie, native ondersteuning voor transparante afbeeldingen. De beschrijving vermeldt niet of de aangeboden versie verschilt van de gepubliceerde gewichten.
| Vergeleken onderdeel | qwen-image-2.1-pro | qwen-image-2.0-pro |
|---|---|---|
| Prijs per gegenereerde afbeelding | 0,04 dollar | 0,075 dollar |
| Gratis quotum | 10 afbeeldingen | 100 afbeeldingen |
De prijs daalt met bijna de helft, maar het gratis quotum is tien keer kleiner. Op QwenCloud geldt voor het model een maximum van 20 verzoeken per minuut en 10 gelijktijdige aanroepen.
🔗 Modellenlogboek van Model Studio · Modelbeschrijving op QwenCloud
Apron voorspelt volgens zijn auteur vóór het huren het GPU-geheugengebruik van 14 open modellen
3 oktober — Vlad Ryzhkov, de ontwikkelaar van Apron, presenteert deze open source-tool op de communityblog van Hugging Face. De tool voorspelt vóór het huren van een GPU of een open model in het geheugen past en onder een specifieke versie van vLLM zal starten, en controleert dat vervolgens op een echte kaart.
Volgens de auteur wijkt het voorspelde geheugengebruik voor de gewichten bij 11 van de 14 gestarte modellen minder dan 2 % af van de gemeten waarde, op hardware variërend van een RTX 4090 tot acht H200. Vier modellen liepen vast totdat een fix, gevalideerd met een tweede start, ze weer werkend maakte. DeepSeek-V4.1-Flash gebruikt standaard 189 Gio hostgeheugen, dat onzichtbaar blijft bij een controle die zich tot de GPU beperkt.
De auteur waarschuwt dat er per model slechts één start is gemeten en dat de resultaten geen ranglijst vormen. De commandlinetool is niet klaar voor gebruik door anderen en de repository beschrijft zichzelf nog als een specificatie zonder implementatie.
🔗 Blogbericht van Vlad Ryzhkov (Hugging Face)
Korte berichten
- Copilot CLI 1.0.92-3 en SDK Copilot 1.0.17-preview.3 — De preview van Copilot CLI voegt een keuzemenu toe, dat vóór het gesprek met Ctrl+E wordt geopend, om te kiezen tussen uitvoering lokaal of in de cloud; de preview van de SDK maakt het bij wijze van experiment mogelijk om de tools van de client tijdens een lopende sessie te vervangen. De nieuwste stabiele versie blijft 1.0.91. 🔗 CLI · 🔗 SDK
- Copilot code review via API — Een review door Copilot kan voortaan via de REST- en GraphQL-API’s worden aangevraagd, met een inspanningsniveau dat per verzoek wordt ingesteld. Dit is algemeen beschikbaar voor de abonnementen Pro, Pro+, Max, Business en Enterprise; de documentatie schat de kosten van een review op 0,05 tot 1 dollar aan IA-credits in Lite en op 0,25 tot 5 dollar in Balanced, het standaardniveau voor inspanning. 🔗 bron
- Nightly van Gemini CLI — De v0.64.0-nightly van 3 oktober bevat slechts één bugfix: Enter en Spatie bevestigen keuzelijsten betrouwbaar, ook in terminals zonder het Kitty-toetsenbordprotocol, zoals die van PyCharm onder Windows, waar een Enter die minder dan 30 ms na een andere toets werd ingedrukt als Shift+Enter werd opgevat. De stabiele versie en de preview zijn ongewijzigd. 🔗 bron
- DeepSeek Harness 0.2.1-alpha.1 — Deze 25e preview, nog steeds zonder stabiele versie, voegt een experimentele compatibiliteitslaag voor de mods van Claude Code toe. Die is volgens DeepSeek bedoeld om te controleren of hun API grofweg een deelverzameling vormt van wat de plugins van Harness mogelijk maken, en niet om volledige compatibiliteit te bieden. 🔗 bron
- GPT-6.1 Sol in Warp — Op de avond van 29 september stelde Warp GPT-6.1 Sol beschikbaar in zijn agentische terminal, te gebruiken met een Codex- of ChatGPT-abonnement; de aankondiging vermeldt geen prijs of metingen die specifiek voor Warp gelden. 🔗 bron
- Einde van grok-voice-transcribe-1.0 — SpaceXAI heeft op 2 oktober de oude versie van zijn transcriptiemodel via API beëindigd: verzoeken worden doorgestuurd naar grok-voice-transcribe-2.0, tegen dezelfde prijs en volgens SpaceXAI nauwkeuriger. De uitfasering was op 18 september zonder datum aangekondigd. 🔗 bron
- September voor OpenAI Developers — Het account @OpenAIDevs vat in een artikel op X de ontwikkelaarsaankondigingen van september samen, van DevDay op de 29e tot GPT-6 Sol en Luna, zonder nieuwe aankondigingen; de enige nadere informatie is dat de Decisions-API van OpenAI, die sinds 29 september in beperkte preview beschikbaar is, binnenkort algemeen beschikbaar wordt, zonder datum. 🔗 bron
- Twee implementaties van ElevenLabs-agents — Banner Health vertrouwt het plannen van afspraken in de eerstelijnszorg toe aan ElevenAgents, met overdracht aan een mens en naleving van HIPAA; verzekeraar Admiral beschrijft het in productie nemen van zijn spraakagents, waarbij elke wijziging binnen enkele uren in plaats van meerdere weken van 1 % naar 100 % van het verkeer wordt opgeschaald. Geen van beide publiceert resultaatcijfers. 🔗 Banner Health · 🔗 Admiral
- Kling 4.0 in vroege toegang — De introductieblog over Kling 4.0, gedateerd op 30 september, verduidelijkt dat het volledige model in vroege toegang beschikbaar komt vóór een bredere uitrol in oktober, terwijl Kling 4.0 Flash sinds 28 september beschikbaar is voor abonnees met een jaarlijks Ultra-abonnement; het formaat 21:9 wordt toegevoegd, zonder prijs, API of toegangscriteria. 🔗 bron
- Runway Agent, Runway MCP en de dots van OpenAI — De changelog van Runway vermeldt drie toevoegingen zonder aankondiging op X: Runway Agent gebruikt de Draft-modus van Seedance 2.5 (concepten in 480p die na het genereren worden bewerkt), Ideogram 4.5 wordt aan Runway MCP toegevoegd voor betaalde abonnementen, en Runway is sinds 1 oktober beschikbaar in de dots van OpenAI. Er worden geen kosten in credits vermeld. 🔗 bron
- Stateless tokens van GitHub Apps — Buiten IA rondt GitHub de op 27 april begonnen uitrol van het stateless formaat
ghs_APPID_JWTaf voor alle nieuwe installatietokens van GitHub Apps: ongeveer 520 tekens in plaats van 40, met ongewijzigde rechten en een geldigheidsduur van één uur; de testheaderX-GitHub-Stateless-S2S-Tokenwordt op 30 november 2026 uitgefaseerd. 🔗 bron - Live menselijke feedback bij Rapidata — Rapidata beschrijft zijn functie Flows, die het beloningsmodel van Flow-GRPO vervangt door realtime paarsgewijze vergelijkingen door mensen, in een blogpost van de leverancier die geen gemeten trainingsresultaten publiceert. 🔗 bron
- Afhankelijkheid tussen agents meten — In een essay zonder experimenten of metingen stelt Anouar Imel voor om systemen met meerdere agents te beoordelen op de afhankelijkheid tussen agents in plaats van op hun aantal, door bij elke beurt de juistheid, de diversiteit van de redeneringen en de koppeling tussen agents te volgen. 🔗 bron
Wat dit betekent
Kolibri laat zien dat een open model zich kan handhaven zonder naar de eerste plaats te streven. Aleph Alpha publiceert zelf metingen waarin de dense Qwen3.8 27B het bijna overal overtreft, en benadrukt een ander criterium: veel lange verzoeken verwerken op weinig GPU’s, zowel in het Engels als in het Duits, onder een licentie die het mogelijk maakt alles op locatie te hosten. Voor een overheidsinstantie of een industrieel bedrijf dat aan de AI Act en de RGPD gebonden is, kan die afweging zwaarder wegen dan een paar benchmarkpunten. Cohere, waarvan de toenadering tot Aleph Alpha nog op goedkeuring van de toezichthouders wacht, belooft al een vervolg.
De kosten van het aanbieden van open modellen worden een centraal thema. Qwen-Image-2.1, op 20 september uitgebracht met open gewichten, keert via API terug onder de naam Qwen-Image-2.1-Pro voor 0,04 dollar per afbeelding, bijna de helft goedkoper dan de vorige generatie, voor wie het liever niet zelf host. De blogpost van Apron herinnert op zijn beurt aan wat zelf hosten vereist: een model kan bij het opstarten vastlopen doordat een vLLM-instelling ontbreekt, of 189 Gio hostgeheugen innemen die bij een controle die zich tot de GPU beperkt onopgemerkt blijft.
Meta verplaatst veiligheidsmaatregelen naar de fase vóór de uitrol. Risicovolle training via reinforcement learning vereist voortaan goedgekeurde sandboxes, onveranderbare logs en een automatische stop, omdat een model dat sterk is in cybersecurity de kwetsbaarheden van zijn eigen omgeving kan misbruiken. De aangekondigde IA-commissie binnen de raad van bestuur moet bovendien onafhankelijk controleren of deze regels worden toegepast. Wat betreft de toezeggingen die bij het Witte Huis zijn gedaan en die Meta naar eigen zeggen weerspiegelt, geeft de blogpost alleen de strekking weer: interne controles die worden geverifieerd door een onafhankelijk team binnen het bedrijf en door een externe auditor of beoordelaar.
De agents worden ten slotte geïntegreerd in de tools en de operationele processen. OpenAI laat gebruikers de grootte van de sandbox kiezen en een omgeving tussen sessies hergebruiken, Devin integreert in Jira en verhelpt de bevindingen van zijn eigen review voordat hij ze publiceert, en Copilot code review wordt via API gestart met geschatte kosten per inspanningsniveau. Antigravity CLI respecteert de wachttijden van de server voor nieuwe pogingen en laat Remote Control in containers draaien: eerder operationele instellingen dan spectaculaire functies, maar juist die tellen wanneer een agent continu draait.
Bronnen
- Blogpost van Aleph Alpha over Kolibri
- Kolibri-1 op Hugging Face
- Aankondiging van Kolibri door @Aleph__Alpha
- Technisch rapport over Kolibri (PDF)
- Kolibri gedeeld door @cohere
- Felicitaties van Aidan Gomez
- Definitieve overeenkomst tussen Cohere en Aleph Alpha
- Capabele modellen verantwoord ontwikkelen (Meta)
- Meta Superintelligence Scaling Framework
- Nieuwe functies van de Agents-API door @stevendcoffey
- Gedeeld door @OpenAIDevs
- Door OpenAI gehoste sandboxes (OpenAI-documentatie)
- Release notes van Devin van 30 september
- Changelog van Antigravity
- Modellenlogboek van Model Studio
- Tarieven van Model Studio
- Informatie over qwen-image-2.1-pro op QwenCloud
- Ik weet dat je LLMs draait. Start het ook op? (Hugging Face)
- Repository van Apron op GitHub
- Copilot CLI v1.0.92-3
- SDK GitHub Copilot v1.0.17-preview.3
- Copilot code review: API-ondersteuning en nieuw standaardniveau voor inspanning (GitHub)
- Nightly v0.64.0 van 3 oktober van Gemini CLI
- Release notes van DeepSeek Harness 0.2.1-alpha.1
- GPT-6.1 Sol in Warp (@warpdotdev)
- Release notes van de SpaceXAI-API
- September voor OpenAI Developers (@OpenAIDevs)
- ElevenLabs bij Banner Health
- Samenvatting van het Admiral-webinar (ElevenLabs)
- Introductie van Kling 4.0
- Changelog van Runway
- Stateless installatietokens voor GitHub Apps uitgerold (GitHub)
- Live menselijke feedback in de trainingscyclus (Rapidata)
- Wanneer AI-agents elkaars bewijs worden (Anouar Imel)